LOB-Impact 基准:生成式限价订单簿模型中涌现的市场冲击 LOB-Impact Benchmark: Emergent Market Impact in Generative Limit Order Book Models
首个在元订单尺度测量生成式LOB模型市场冲击的基准,发现冲击涌现但形状过陡且不松弛
前置知识
限价订单簿(LOB)
交易所撮合的核心数据结构:买方出价和卖方要价按价格优先、时间优先排成两侧队列,每条消息(限价单、市价单、撤单)到达后更新账本状态并可能成交。消息级模拟器(如本文用的 JAX-LOB 引擎)逐条回放或生成这些消息来重建整个市场微观过程。
本文的全部实验都发生在消息层面:往生成器产出的消息流里注入执行式订单,再在撮合引擎里观察价格反应,不理解 LOB 撮合机制就无法理解注入协议和盲控制的设计。
元订单与市场冲击
机构不会一次下大单,而是把大单拆成许多子订单悄悄执行,这整个隐藏序列叫元订单。执行期间价格会朝订单方向移动,经验金融学总结为平方根定律 $I(Q) = \sigma Y \sqrt{Q/V}$,其中 $\sigma$ 是日波动率、$Q$ 是元订单量、$V$ 是日成交量,实测指数 $\beta \approx 0.5$、振幅 $Y \approx 0.5$,且执行停止后冲击会松弛到峰值的一半到三分之二。
平方根定律就是本基准用来检验生成模型的'物理参考答案':模型产生的冲击指数 $\delta$ 和振幅 $Y$ 是否落在真实市场区间,是判定模拟器能否当执行 agent 环境的核心标准。
参与率(Participation Rate)
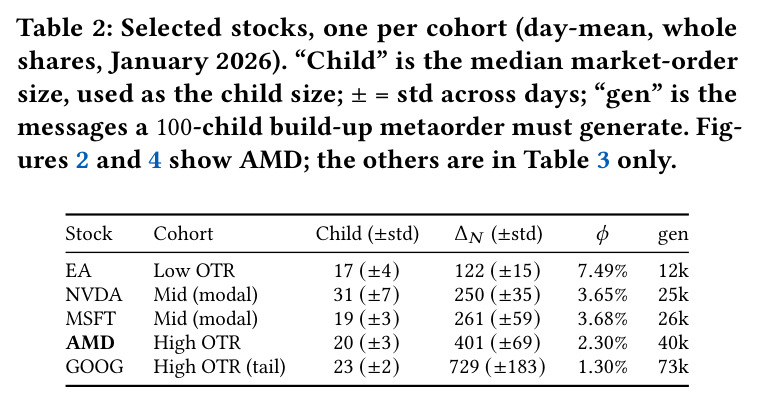
元订单成交量占市场总成交量的比例 $\eta$。本文固定目标 $\eta = 10\%$,落在经纪商数据库记录的 3%–40% 区间内。给定参与率,子订单之间的间隔由恒等式 $\eta = 1/(1 + \Delta N \phi)$ 决定,其中 $\phi$ 是市场订单占全部消息流的比例,由此推出间隔 $\Delta N = (\eta^{-1}-1)/\phi$。
参与率把'注入多少订单'标准化成跨股票可比的量:冲击以累计参与率 $q = Q/V$ 为自变量测量,不理解它就看不懂校准流程和 $\Delta N$(40 到 729 条消息)为何因股票而异。
自回归状态空间生成模型(S5/Mamba/GDN)
把订单簿消息流当'语言'逐 token 预测下一事件的生成模型。S5 是简化状态空间层,Mamba 是选择性状态空间骨干(线性复杂度、携带连续隐状态跨越长序列),Gated DeltaNet(GDN)用 Delta 规则改进 Mamba2。它们只训练下一 token 预测,从未被显式教过'别人下单时该怎样反应'。
本文的被测对象就是这五个神经生成器;理解它们'携带隐状态跨过生成与注入消息'这一点,才能明白作者所说的松弛机制本应在哪里、以及为什么上下文窗口长度成了松弛失败的嫌疑对象。
Hurst 指数与交易符号自相关
Hurst 指数 $H$ 刻画价格路径的扩散性质:$H = 0.5$ 为标准扩散(随机游走),$H > 0.5$ 为超扩散(有趋势)。交易符号自相关衰减指数 $\gamma_{flow}$ 衡量买卖方向的持续性,值越大记忆越长。理论上持续性的订单流必须被市场松弛抵消,价格才能保持扩散——两者必须平衡,否则市场内嵌'免费午餐'。
这对指标构成基准 Phase 1 的平衡检验 C1:真实 AMD 流 $\gamma_{flow} = 1.66$、$H = 0.54$ 恰好平衡,而所有五个生成器都打破了这条腿,是解读全文'可持续性无补偿'故事的前提。
反事实与盲控制
反事实实验问'如果注入元订单,价格会怎样',历史数据无法回答,只能靠模拟器。盲控制是其增强版:同一窗口、同一随机种子跑两次,可见运行中订单真实撮合,盲运行中订单在模拟器里成交但模型的任何输入(消息流、账本状态)都不携带它们,生成流当作元订单从未发生。
可见峰与盲底的比值(v/b)是把'账本力学造成的机械冲击'从'模型自身的间接冲击'中分离出来的唯一手段,直接支撑归因判定 C3,是本文方法设计最精妙的一步。
研究动机
生成式限价订单簿模型(GAN、循环与状态空间消息生成器、Transformer、扩散模型)目前的评判标准是分布保真度:LOB-Bench 等基准把生成流的价差、成交量、消息到达间隔、订单不平衡分布与历史数据逐一比较。这套分数对一个关键问题是盲的——当 agent 自己往里下单时,市场会如何反应。这类模拟器最大的用途是充当强化学习交易 agent 的世界模型,如果模拟器错误定价了订单冲击,agent 会学到在模拟器里最优、在真实市场亏钱的策略。已有工作只在极小尺度触碰过这个反事实:LOB-Bench 只测单个事件的响应;MarS 报告过注入 TWAP 订单呈平方根形状的响应;Bodor 与 Carlier 在十子订单元订单上测得指数 0.55。但这些实验都没有把机械冲击(注入订单直接吃掉账本档位)与间接冲击(其他参与者——在生成器里就是模型本身——对注入的反应)区分开,而后者恰恰是模拟器作为'市场'的灵魂。
本文的目标是本文要构建一个能在元订单尺度、对任何消息级生成器测量市场冲击响应的开放基准。具体目标有三层:一是设计三阶段协议(自由生成、元订单注入、执行后松弛窗口),把经验影响文献中成熟的估计器搬到生成模型评估里;二是用五个事前固定的可检验命题 C1–C5(流量-价格平衡、冲击存在性、冲击归因于模型本身、平方根定律形状、执行后松弛)把每个模型-股票单元约化成一串可核验的判定;三是提供自动的每股票校准和盲控制配对运行,让'谁制造了冲击'这个问题有明确数字答案。最终在五个神经生成器 × 五只 NASDAQ 股票共 25 个单元上执行完整战役。
与已有工作不同的是,本文的独特切入是从'分布比较'转向'干预式反事实测量',并补上归因这一环。分布基准永远无法回答'若下这笔单价格会怎样',而生成器可以:同样的条件窗口重复运行,一次带可见注入、一次盲注入,可见与盲的差就是模型的内生反应。设计上还有三个少见的严格性:一切下游(注入时间表、校准、估计器、判定阈值)都在任何模型运行之前由股票和协议固定,被测模型无法影响量尺;先测存在性再测大小,可识别性检验在真实噪声的点云上先做 500 次零假设试验确认零误报;用物理已知的核基线(Propagator 的幂律衰减、Obizhaeva-Wang 的指数韧性)端到端闭环校准估计器,而不是直接信任数字。
核心方法
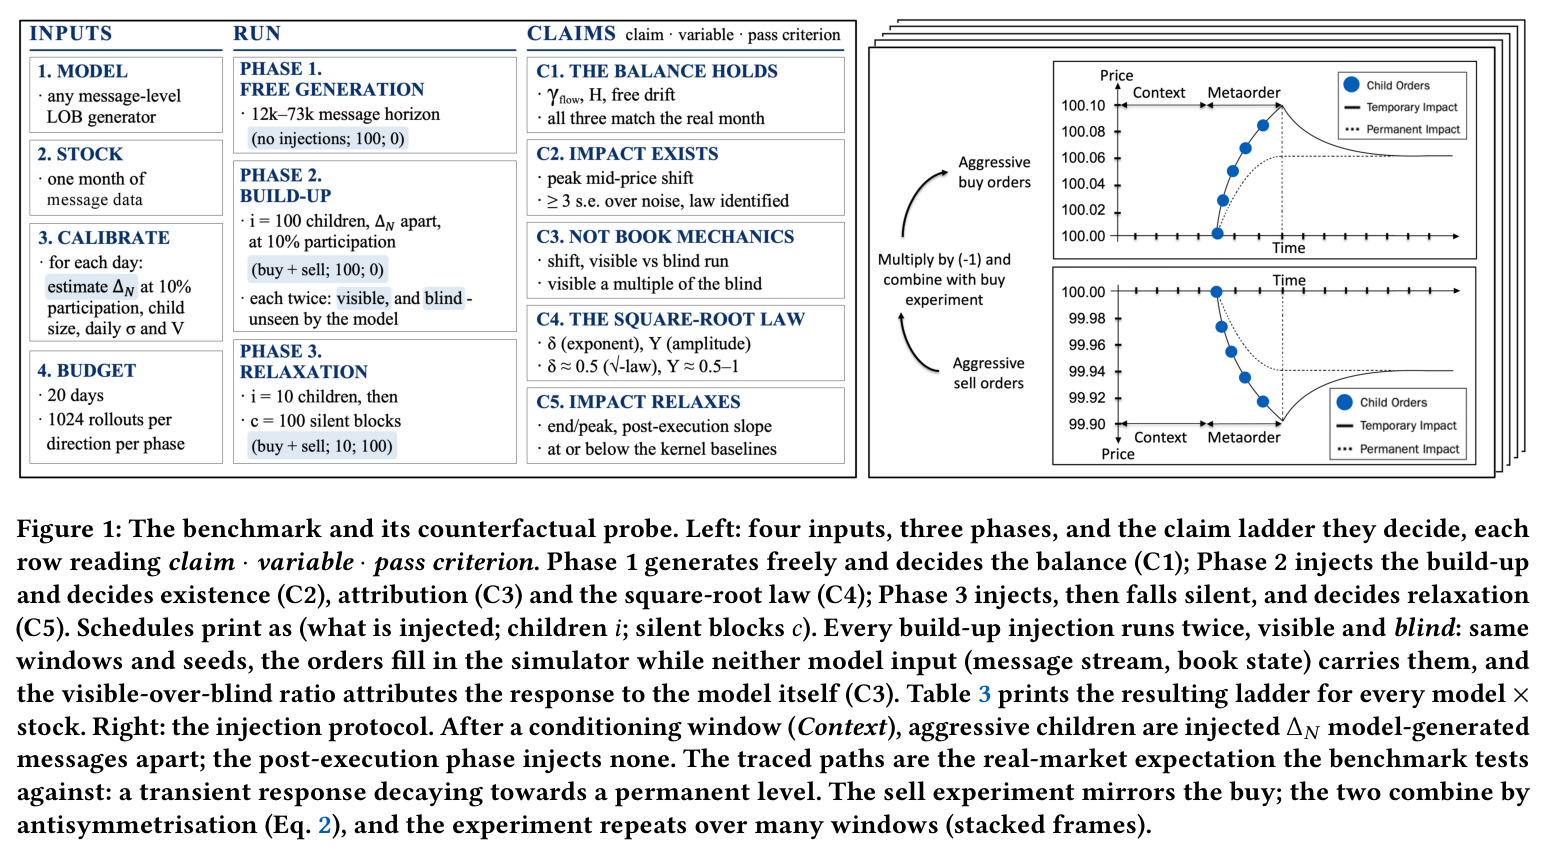
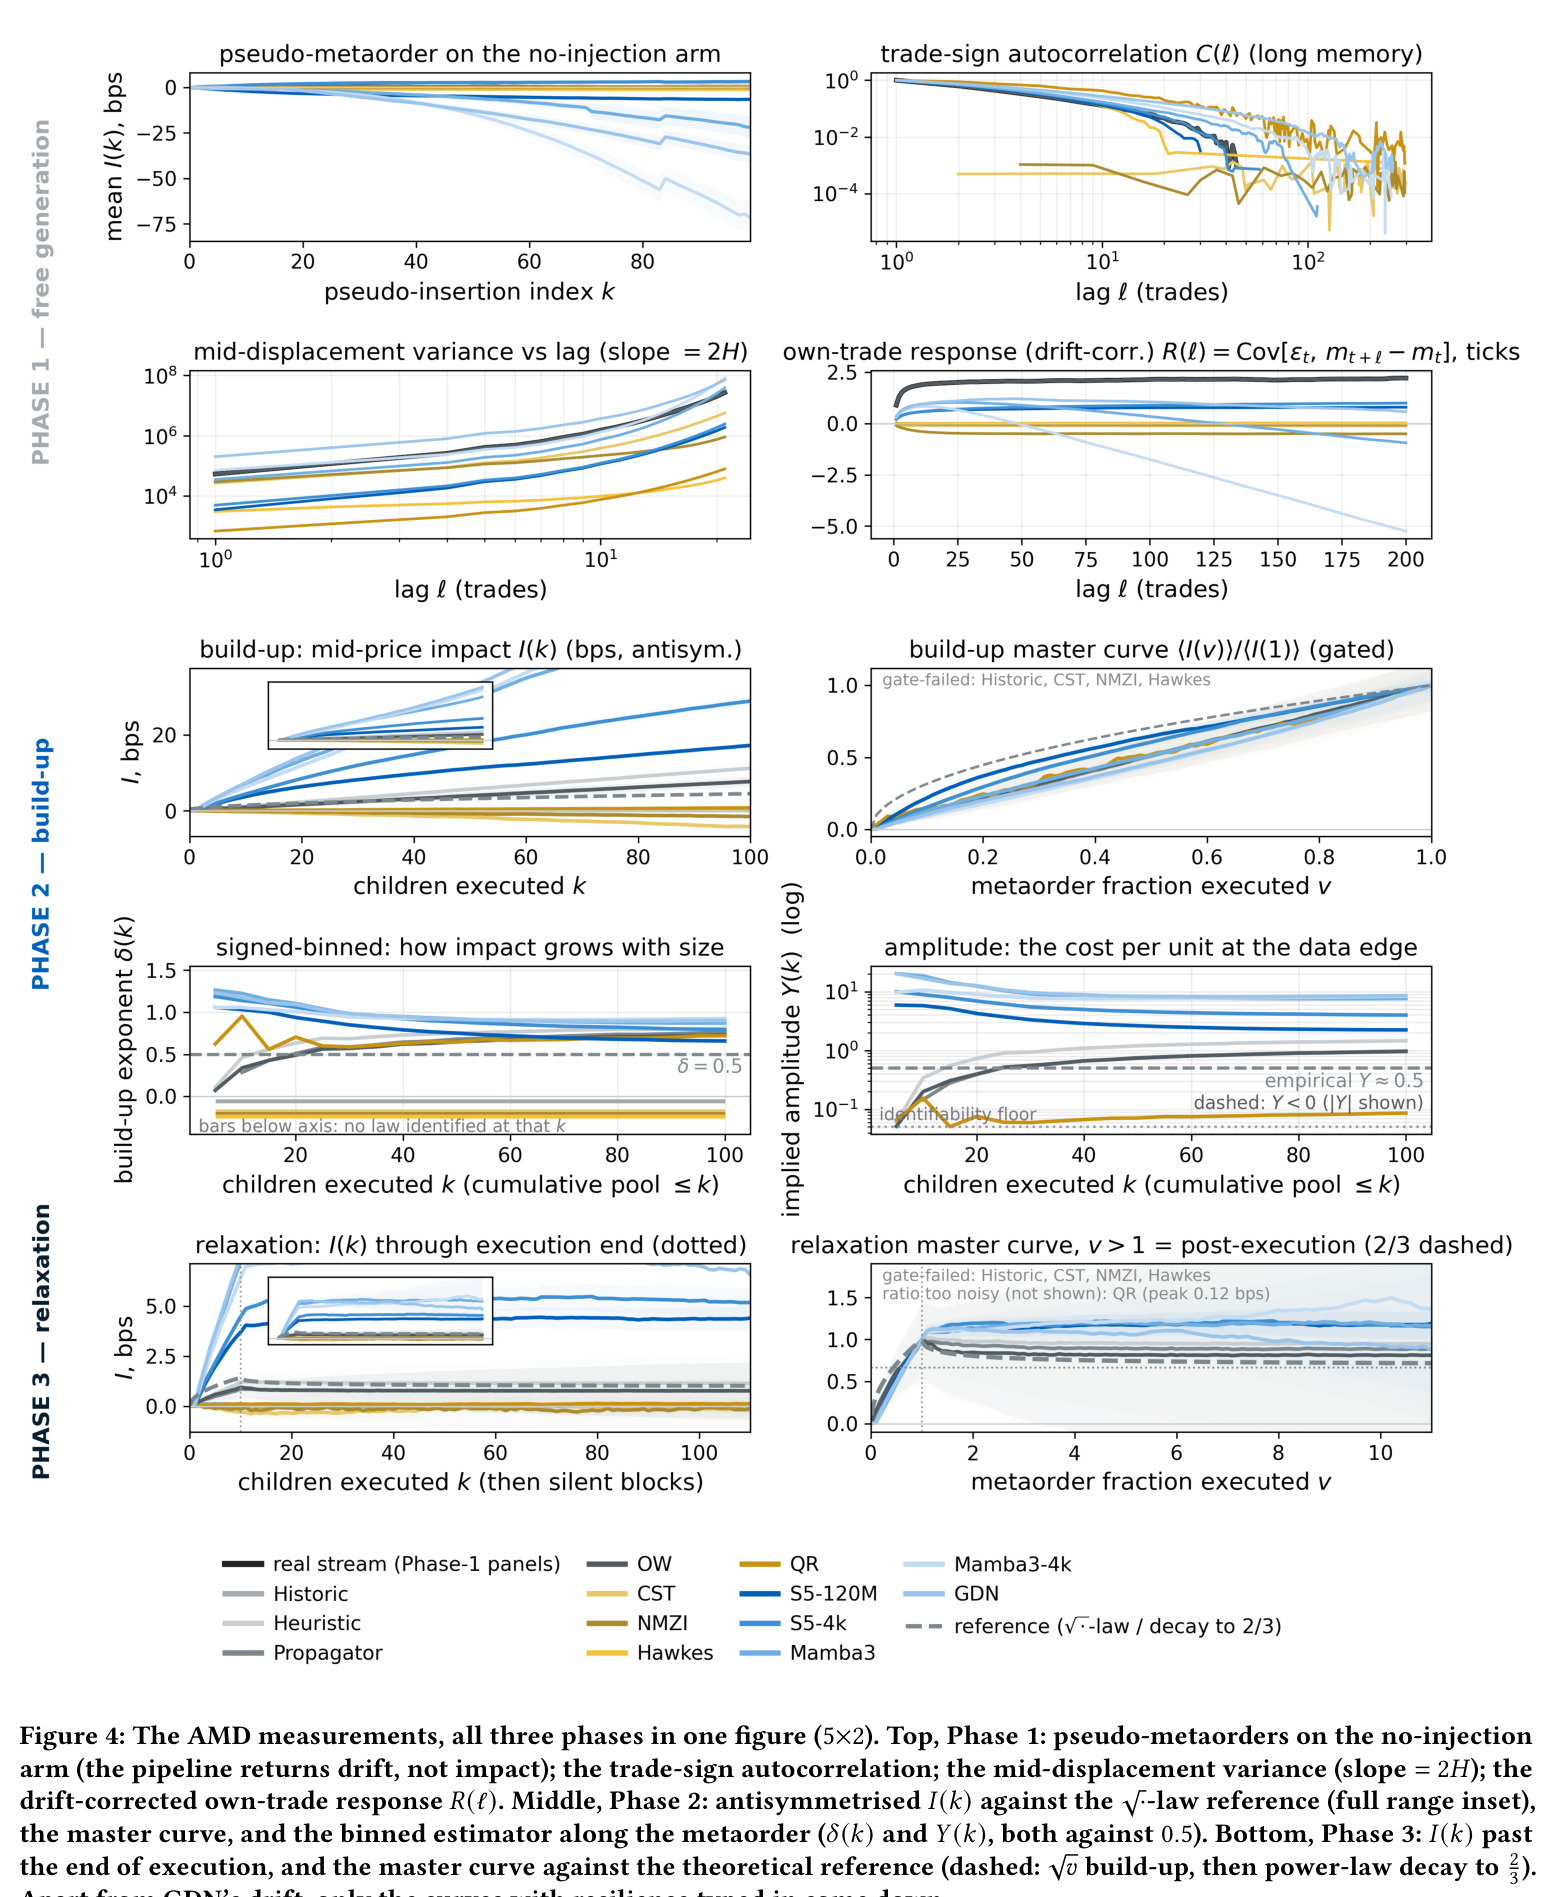
直觉上,要看一个'人造市场'是否有真实市场的价格形成物理,最直接的办法就是像机构交易员那样往里面执行一笔拆分大单,然后测量价格被推了多少、推完之后会不会退回来。技术上,基准有四个输入:被测模型、股票、从该股票自己的数据计算的校准、以及每方向每阶段的 rollout 预算——每股票 1024 个 rollout、铺在 20 个交易日上(约为子采样实验确定的最小需求的 1.4 倍)。协议分三阶段:Phase 1 让模型自由生成 12k–73k 条消息(跨越 AMD 约 40k 消息的 build-up 时间尺度),测交易符号自相关衰减指数 $\gamma_{flow}$、中间价 Hurst 指数 $H$ 和自由漂移;Phase 2 在真实流的条件窗口后交替注入一个激进子订单(中位市价单大小)和 $\Delta N$ 条生成消息以维持参与率 $\eta = 10\%$,共 100 个子订单,对累计参与率拟合幂律 $I = a q^{\delta}$;Phase 3 执行 10 个子订单后停手 100 个静默块,测冲击回落。每个 build-up 注入都配对一次可见运行和一次盲运行。所有判定标准事前固定,每股票一场战役,数量只在定律被识别时才报告。
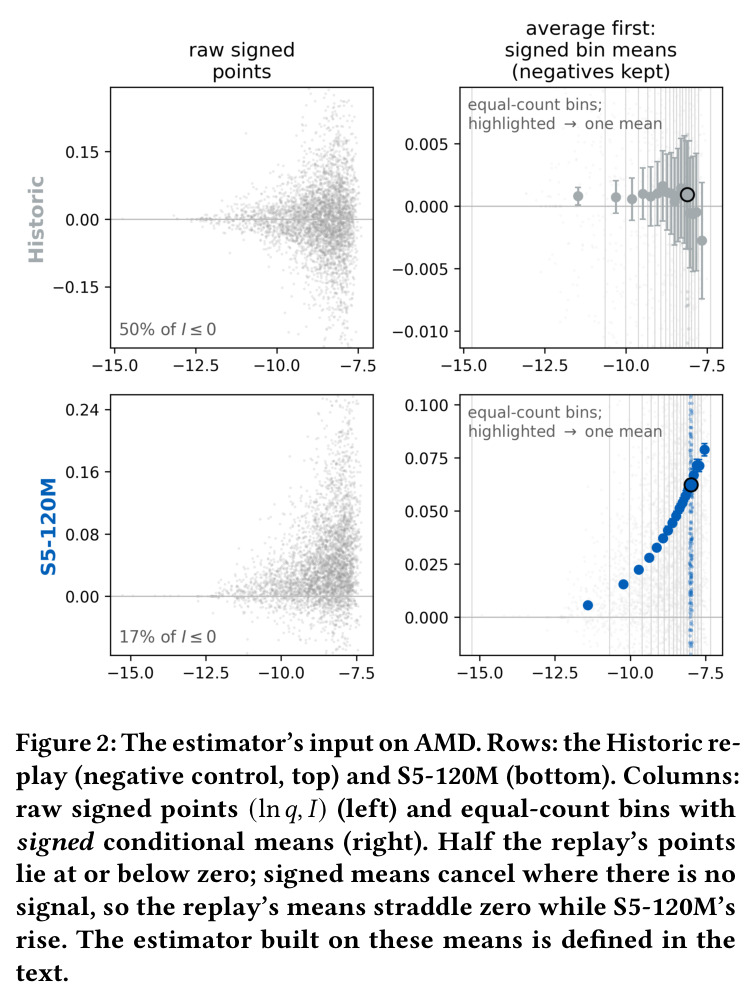
核心创新是盲控制与'存在性先于大小'的双重设计。盲控制解决归因:注入的订单在 JAX-LOB 撮合引擎里真实成交,但模型的任何输入(消息流、账本状态)都不携带它们,于是生成流按元订单从未发生过继续演化;可见峰与盲底的比值大于等于 3 才承认冲击是模型自己的间接反应(C3),否则可能是纯机械效应——论文中 replay 核在盲臂上也被识别出 $\delta = 0.73$–$0.81$,正说明不做这一步会把撮合规则误认为模型智能。存在性检验解决可识别性:对 $[0.05, 1.5]$ 步长 0.01 的每个 $\delta$,最优振幅有闭式解 $a^*(\delta) = \sum I_q q^{\delta} / \sum q^{2\delta}$,失配曲线在真实定律下呈尖锐极小、无信号时平坦且 $a \approx 0$;振幅低于 0.05 或最优 $\delta$ 落在网格边界即判'定律未识别',主曲线还要求 $\langle I(1) \rangle$ 超过三个标准误差,并有加权中位数 $L_1$ 版本抗离群点。这套纪律让 25 个神经单元的每一个结论都能从打印出的数字独立复核。
方法步骤详情
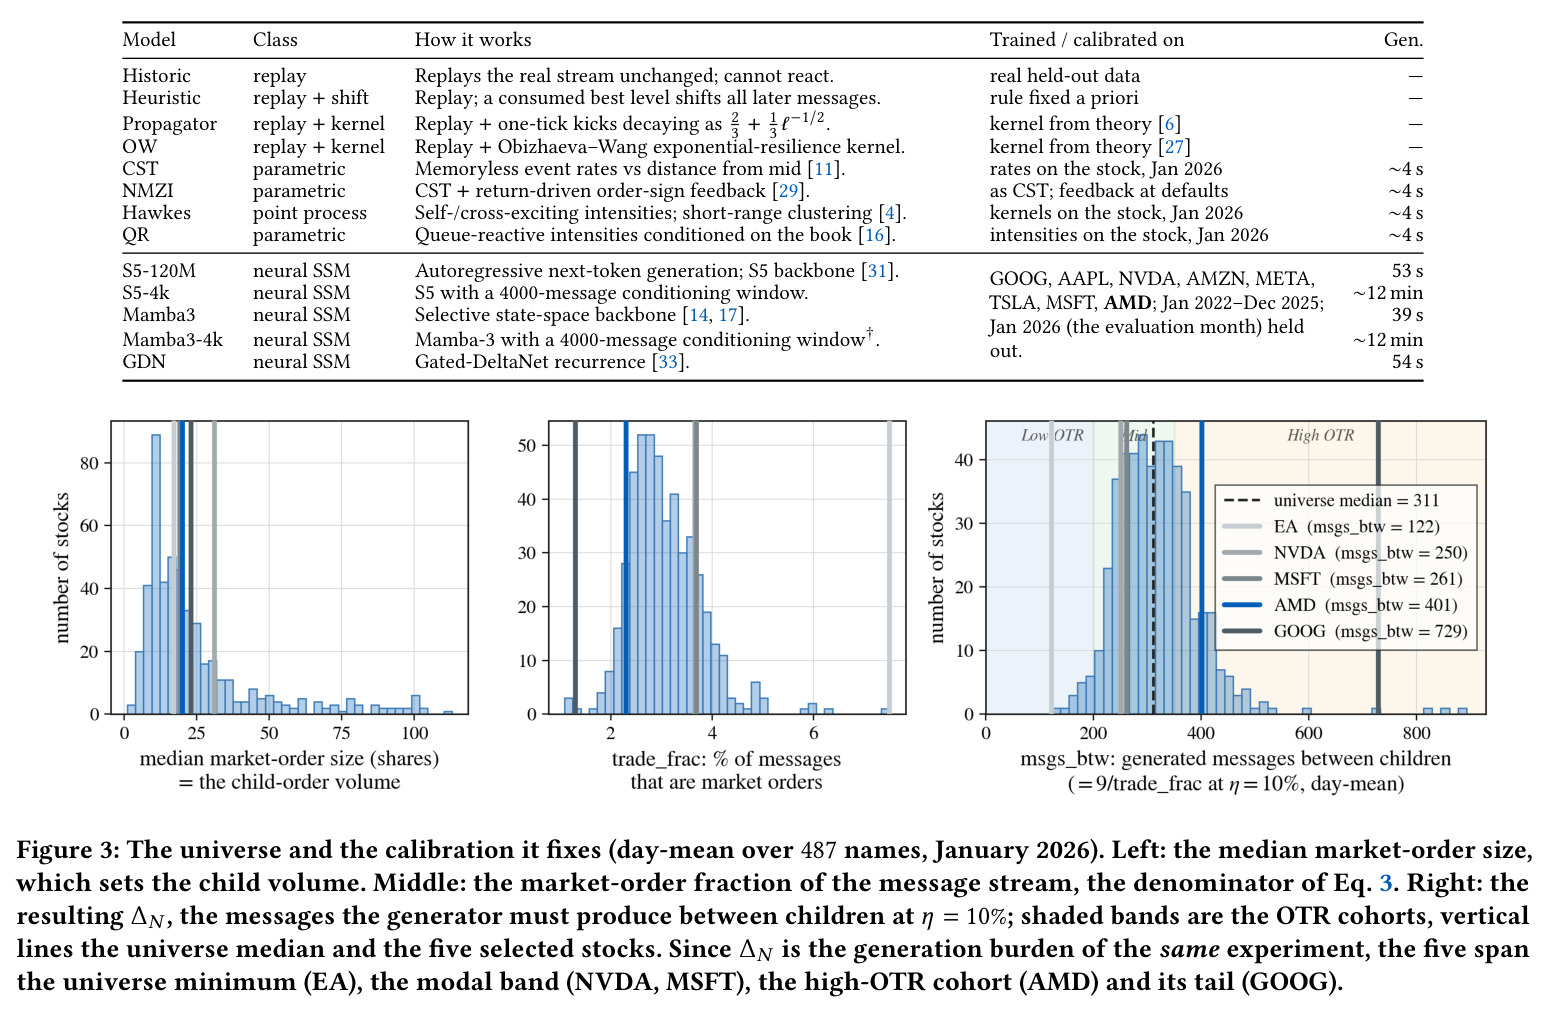
第一步,校准:从评估月(2026 年 1 月,held out 于训练)的 LOBSTER 数据为每只股票计算三个数——子订单大小取当日市价单中位数(EA 17 股到 GOOG 23 股)、日成交量 $V$、子订单间隔 $\Delta N = (\eta^{-1}-1)/\phi$($\phi$ 为市价单占消息流比例),得到 EA 122、NVDA 250、MSFT 261、AMD 401、GOOG 729 条消息,子订单数固定 $N = 100$(对应经验隐含单平均 96–98 笔成交)。第二步,Phase 1 自由生成:模型独立跑完一个 rollout 长度,读 $\gamma_{flow}$、$H$、自由漂移三个量,与股票自身 replay 对照,容差 0.10、0.02、5 ticks,通过判 C1。第三步,Phase 2 注入:条件窗口后按时间表交替注入激进子订单与 $\Delta N$ 条生成消息,买卖两方向分别跑并按 $I = \frac{1}{2}(I_{buy} - I_{sell})$ 反对称合成以消掉方向无关漂移;每个子订单贡献一个点 $(q_k, I_k)$,按生命周期约定在累计池 $q \le q_k$ 上拟合 $I = a q^{\delta}$;振幅换算成无量纲 $Y = a\, q_{ref}^{\delta - 1/2} / \kappa_P$($\kappa_P = \sqrt{4 \ln 2} \approx 1.665$,Parkinson 修正),可直接对照经验值 $Y \approx 0.5$;可见峰超过盲底 3 倍判 C3,$|\delta - 0.5| \le 0.10$ 且 $Y \in [0.5, 1]$ 判 C4。第四步,Phase 3 松弛:10 子订单后 100 个静默块,读终峰比 e/p 和执行后斜率,对照真实市场衰减到峰的 1/2–2/3 及 OW 核同表同一时间表的闭式值判 C5。第五步,估计器验证:在 replay 的真实噪声点云上植入已知指数定律,$\delta \in [0.5, 1.0]$ 全部恢复且偏差至多 0.11(向下),500 次空植试验零误报;核基线端到端恢复内置韧性排序。估计器对六种波动率归一(无归一及 Parkinson、Garman-Klass、Rogers-Satchell、close-to-close、Yang-Zhang)稳定,$\delta$ 移动不超过 0.05。
技术新颖性
技术新颖性在于把'干预实验 + 归因控制'的因果推断范式第一次完整搬进生成式市场模拟评估。与 LOB-Bench 的本质区别:LOB-Bench 只做分布比较和单事件响应,本文在元订单尺度(100 个子订单、跨约 40k 消息、远超 500 消息训练窗口)测量响应,且给出形状参数 $\delta$、振幅 $Y$、松弛比 e/p 三个可比较数字。与 MarS 和 Bodor-Carlier 的本质区别:后者报告的响应无法排除机械冲击,本文的盲控制把'账本吃掉档位'与'模型作为其他参与者的反应'严格分离,首次证明 25 个神经单元的超额冲击确实是模型内生行为(可见峰至少 3 倍于盲底、16 个单元超 10 倍)。工程上还有三处精巧:反对称合成公式让自由漂移在对称相减中抵消并单独入账恰好一次;声明阶梯 C1–C5 把模糊的'模拟器像不像市场'拆成五个可证伪命题,缺测量的单元显式标记'不可判定'而非读作缺陷;13 个模型的对照面板(从无反应的 Historic replay 到写入目标物理的核基线,再到参数化点过程与神经生成器)构成一条从'不该有冲击'到'该有正确冲击'的完整谱系。
实验结果
Phase 1(AMD,自由生成):真实 AMD 流平衡——$\gamma_{flow} = 1.66$ 的持续订单流配上 $H = 0.54$ 的扩散价格;五个生成器无一守住两条腿。S5 家族订单流记忆过长($\gamma_{flow}$ 1.90 与 1.83)但扩散性正确($H$ 0.55、0.54);Mamba3 与 Mamba3-4k 记忆接近真实(1.20、1.06)但价格过扩散($H$ 均 0.58);GDN 记忆最长(0.79)而价格欠扩散(0.49)。自由漂移从 +9(S5-4k)到 −251 ticks(Mamba3-4k),全部 C1 失败。Phase 2(元订单响应):可识别性检验在全部 25 个神经单元识别出定律,而在无法反应的 Historic replay 上失配曲线平坦、振幅为零——估计器诚实。AMD 的分箱指数:S5-120M 0.66、S5-4k 0.79、Mamba3 0.87、GDN 0.90、Mamba3-4k 0.93(日聚类 bootstrap 半宽 ±0.05–0.06);跨五股范围 0.63–1.21,全部 25 个区间排除 0.5。振幅是真正的重磅:AMD 上 $Y = 2.24$–$8.57$ 对经验 $Y \approx 0.5$,即每单位参与率真实元订单费用的四到十七倍;100 子订单元订单推动模拟价格 17–70 bps,而任何基线至多 11 bps。盲控制确认归因:可见峰至少 3 倍于盲底(v/b 全部 25 格)、16 格超 10 倍,这是被设计出来隔离的间接冲击。Phase 3(松弛):真实元订单在 1–2 个执行时长内回落到峰的约 2/3;核基线实测终峰比 Propagator 0.89、OW 0.81,紧贴闭式值 0.94 与 0.87,而神经面板 AMD 读数 1.19、1.15、1.16、1.36、0.88(GDN),执行后斜率 +0.6%、0.0%、+0.4%、+3.7%、−2.4%——四个模型在最后一个子订单成交后价格仍朝原方向移动。汇总成声明阶梯:25 个神经单元重复同一签名 C1✗ C2✓ C3✓ C4✗ C5✗。跨股票一致性极强:按 $\delta$ 或 $Y$ 给生成器排名,Kendall $W = 0.82$ 与 0.81,说明基准测到的是持久的模型特异成分;但分布保真度与冲击保真度解耦——LOB-Bench KS 排名与 $|\delta - 0.5|$ 排名的相关性在 GOOG 为 +0.54、在 MSFT 为 −0.71(p = 0.02),神经家族内部 MSFT 达 −0.90,'学得更像的市场'可以离真实冲击定律更远。分布外检验(EA,不在训练语料):定律不被破坏($\delta$ 0.84–1.12)但校准被摧毁,$Y = 12.23$–$49.52$。
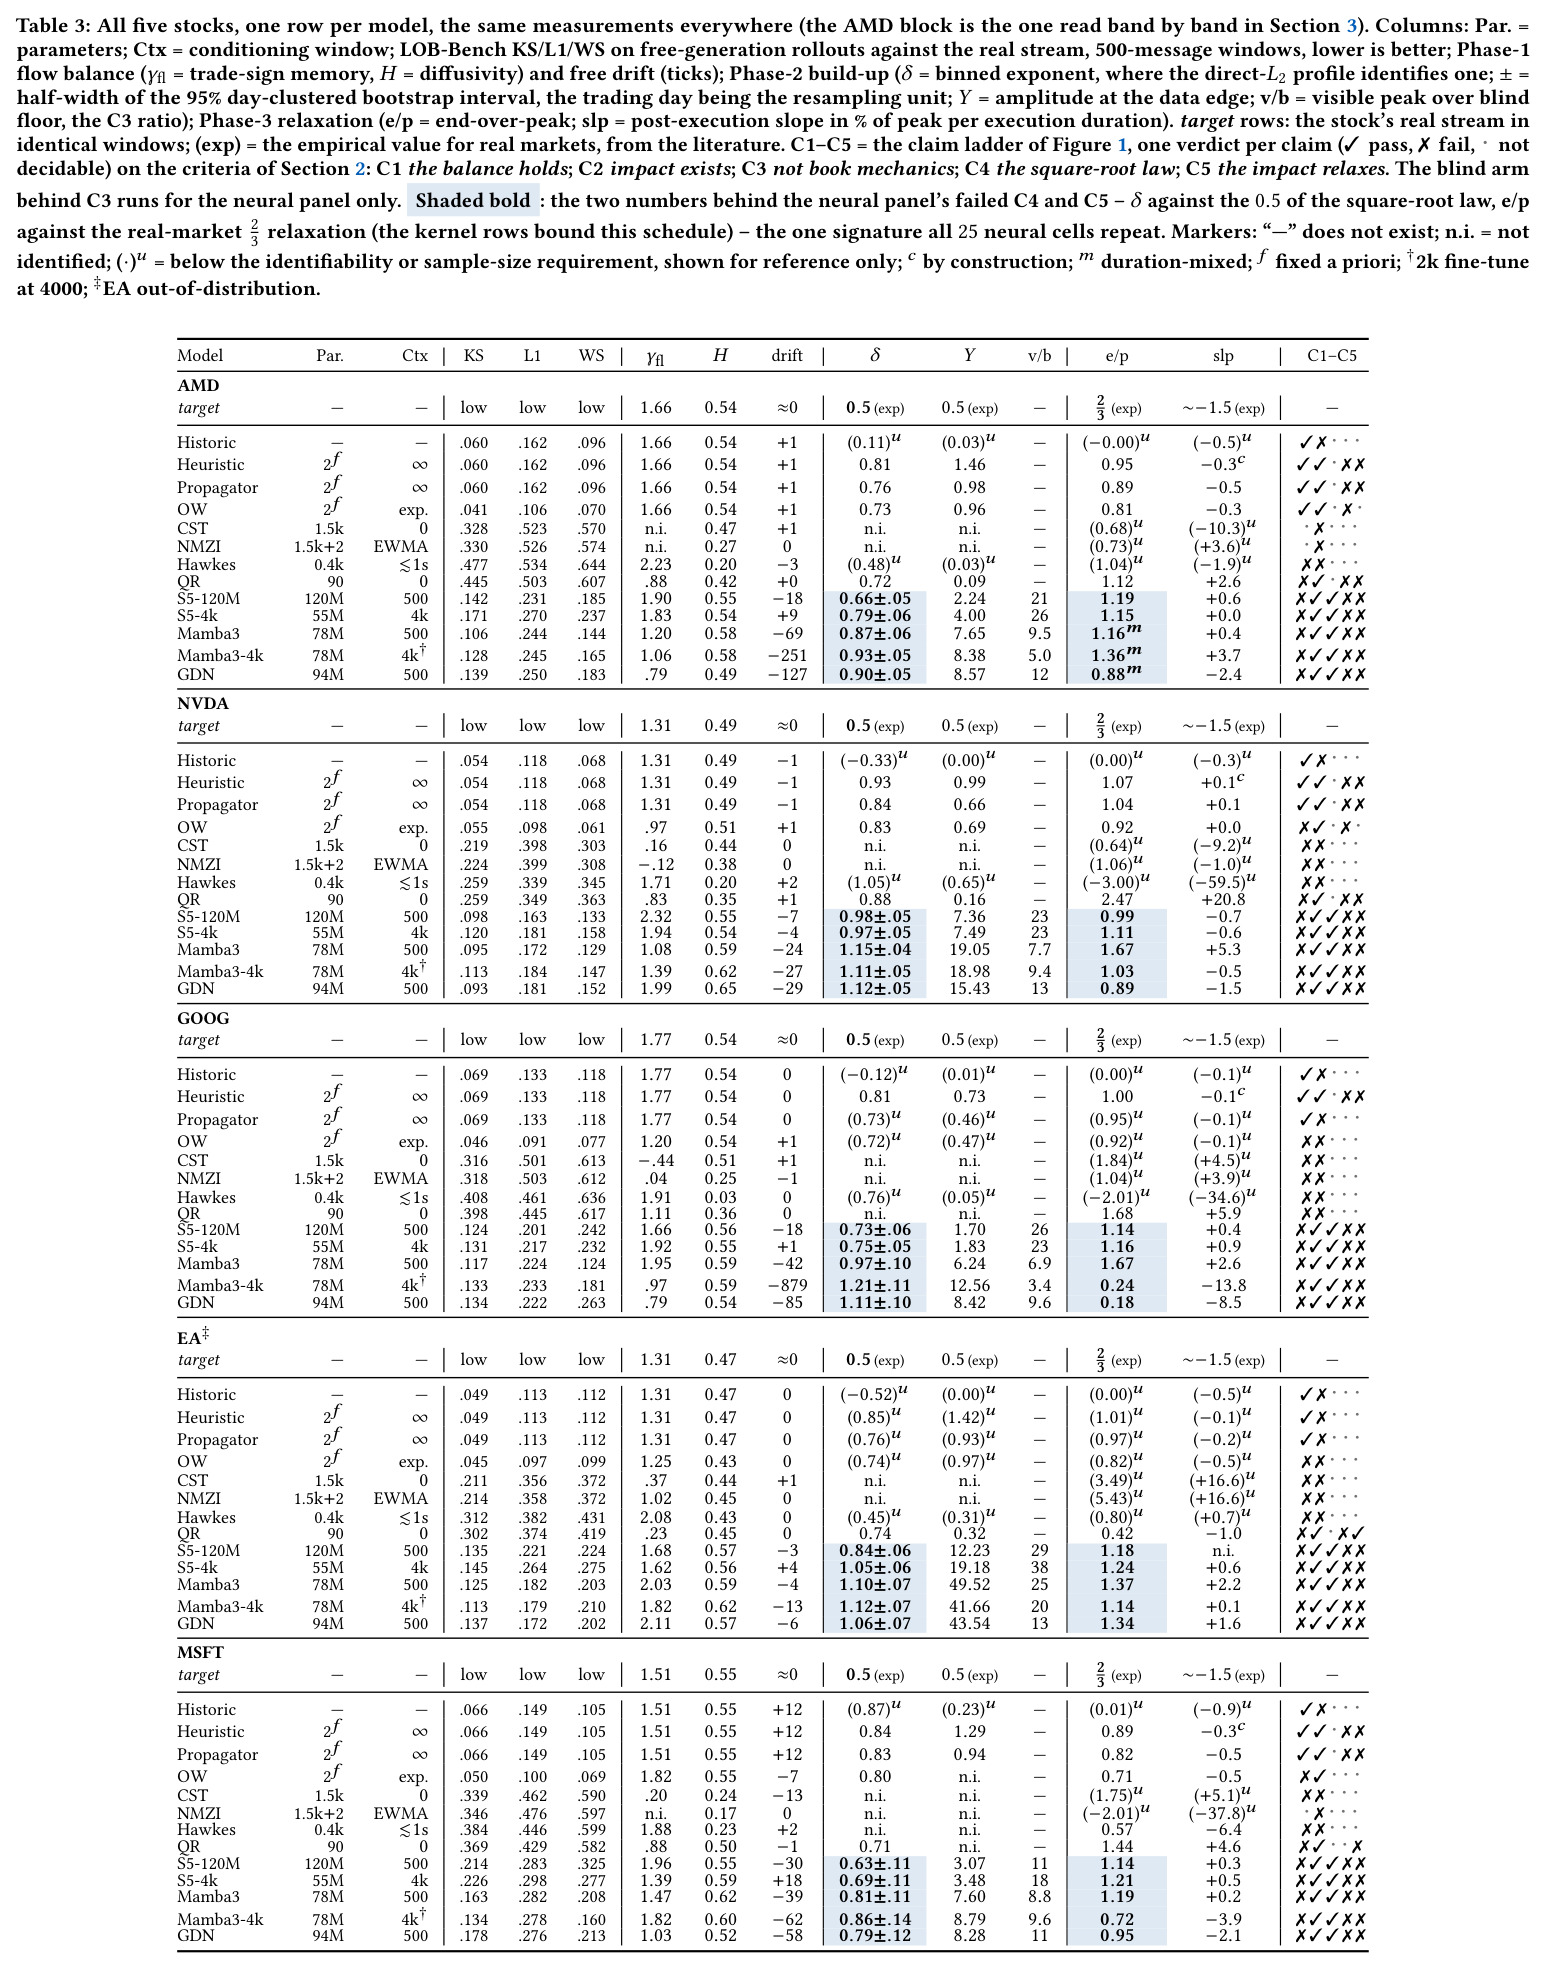
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 元订单冲击存在性与指数(AMD build-up,100 子订单,参与率 10%) | 冲击指数 δ(分箱估计,日聚类 95% 区间) | 五个神经生成器全部识别:S5-120M 0.66±.05、S5-4k 0.79±.06、Mamba3 0.87±.06、GDN 0.90±.05、Mamba3-4k 0.93±.05;跨五股 0.63–1.21,25/25 区间排除 0.5 | 经验平方根定律 δ = 0.5;可反应 replay 核 0.73–0.81;Historic replay 无定律(正确);判定阈值 |δ−0.5| ≤ 0.10 | 负向偏离:指数高出 0.5 达 0.16–0.43,C4 全部失败;估计器本身经植入定律验证偏差至多 0.11(向下) |
| 冲击振幅(每单位参与率的价格移动) | 无量纲振幅 Y(Parkinson 波动率归一,对照经验 Y ≈ 0.5) | 训练域内股票 Y ≈ 2.2–8.6(AMD)、1.7–19(NVDA/GOOG/MSFT);OOD 的 EA 达 12.23–49.52 | 真实市场 Y ≈ 0.5;核基线 Y = 0.96–1.46;判定带 Y ∈ [0.5, 1] | 训练域内超额 4–17 倍:100 子订单元订单推动模拟价格 17–70 bps,任何基线至多 11 bps |
| 冲击归因(模型内生反应 vs 账本机械冲击) | 可见峰 / 盲底比值(v/b,同窗口同种子配对) | 25 个神经单元全部 v/b ≥ 3(通过 C3),其中 16 个单元超过 10 倍 | 盲控制本身:无模型时 replay 核也被识别在 δ = 0.73–0.81、Y 至 1.46,说明机械冲击足以产生可识别定律 | 首次把间接冲击干净地归给生成器本身——不加盲控制则无法区分'模型会反应'与'撮合规则吃档位' |
| 执行后松弛(Phase 3,10 子订单 + 100 静默块) | 终峰比 e/p 与执行后斜率(每执行时长占峰百分比) | AMD:1.19(S5-120M)、1.15(S5-4k)、1.16(Mamba3)、1.36(Mamba3-4k)、0.88(GDN);斜率 +0.6/0.0/+0.4/+3.7/−2.4%;C5 零通过 | 真实市场回落到峰的 1/2–2/3;同时间表闭式值 Propagator 0.94、OW 0.87,实测 0.89、0.81;永久 Heuristic 0.95 | 负向:四个模型执行结束后价格继续朝元订单方向走;GDN 虽低于峰但自由漂移 −127 ticks 使归因不成立 |
| 流量-价格平衡(Phase 1 自由生成,AMD) | γ_flow(符号记忆)/ H(扩散性)/ 自由漂移(ticks) | 全部五模型失衡:S5 γ_flow 1.90/1.83 过记忆;Mamba3/4k H 0.58 过扩散;GDN γ_flow 0.79、H 0.49;漂移 +9 至 −251 ticks;C1 全败 | 真实 AMD 流 γ_flow = 1.66、H = 0.54、漂移 ≈ 0;容差 0.10 / 0.02 / 5 ticks | 负向:无一生成器同时守住持续流与扩散价,暴露'持续订单流无补偿'的结构缺陷 |
| 分布保真度与冲击保真度的独立性 | LOB-Bench KS 排名与 |δ−0.5| 排名的 Spearman 相关 | 跨股票不稳定:GOOG +0.54,MSFT −0.71(p = 0.02);神经家族内部 MSFT −0.90(p = 0.08);按 δ 或 Y 排名生成器则跨股票一致(Kendall W 0.82/0.81) | 若分布好即冲击对,两者应强正相关 | 证明'生成流更像历史'与'冲击物理正确'是两个必须分别测量的正交性质——分布基准对世界模型用途是不充分的 |
局限与改进
作者承认的局限:正文只对 AMD 逐带解读,其余四只股票仅以 Table 3 呈现;一切都在单一操作点测量——参与率固定 10%(真实执行参与率范围 3%–40%)、子订单取中位市价单大小、全是激进市价子订单、单一 build-up 形状、单一交易所单个月份,而 $\delta$ 依赖该操作点;极端成交量制度(经验上冲击从平方根转线性的区域)未探测;评估月份本身是样本,若该月偏离约一个月内标准差,指数的移动就可能超过半宽上限。我的补充观察:其一,松弛失败归因于上下文窗口太短只是尝试性结论——4k 上下文变体同样失败,但 4000 消息仍远短于约 40k 消息的元订单,'更长上下文能否修复'保持未检验而非被否定;其二,4k 变体用 2000 消息微调且参数量与 500 版本不同(55M 对 120M),窗口长度与模型容量存在混淆;其三,GDN 的 C5 判定被 −127 ticks 自由漂移污染,实际上没有任何神经单元给出过干净测得的韧性数字;其四,覆盖面限于 5 只美股与 4 个 SSM 家族,Transformer 与扩散生成器(论文引用的相关工作)未进面板,跨资产类别(期货、外汇上同样有平方根定律记录)的泛化完全未知。
独立分析的弱点
弱点一,协议刚性:单一参与率(10%)、单一子订单大小(中位市价单)、单一激进子订单形状,而真实机构执行大量使用被动限价子订单与 VWAP 日程,且参与率 3%–40% 跨越冲击从平方根转向线性的制度;改进方向是把操作点做成网格,报告冲击曲面 $\delta(\eta, \text{shape})$ 而非单点。弱点二,归因与判定的耦合污染:C5 依赖自由漂移低于 20 ticks 的前提,但五个模型漂移达 +9 到 −879 ticks(GOOG Mamba3-4k),使得最需要看松弛的模型恰恰最没有资格被判定,改进方向是先做漂移校正的松弛估计(论文在 Phase 1 已有漂移校正的自身交易响应 $R(\ell)$,可延伸到 Phase 3)。弱点三,OOD 灾难被轻描淡写:EA 上振幅 $Y$ 膨胀到 12–50(约真实市场 25–100 倍),说明定律的'存在'不等于'可用',改进方向是把 OOD 校准漂移作为独立声明 C6 报告,并在振幅估计中引入分位数稳健区间。弱点四,验证集与被测集时间重叠的潜在泄漏:校准用 2026 年 1 月数据、训练语料截至 2025 年 12 月,但仅一个月评估窗口使日间方差难以压低(作者自己指出区间估计需 5 天以上才可靠),改进方向是跨多个月份滚动评估并报告月间方差。弱点五,容量与窗口混淆(55M/4k 对 120M/500)使'更长上下文有用吗'这一核心问题未被干净回答。
未来方向
作者明确提出:在每个训练 checkpoint 上跑 Phase 1,以生成的 $\gamma_{flow}$ 和 $H$ 逼近该股票经验值为目标,且强调修复方向是'学习补充流动性而不是忘记持续性'——直接杀死订单流记忆会空洞地恢复平衡但摧毁微观结构;随后用 Phase 2 和 3 检验修复是否恢复真实的 build-up 与松弛;更长上下文与更大模型是自然的下一步(4k 变体的失败留待 40k 级窗口验证)。在此之上可以延伸:其一,把基准升级为执行 RL agent 环境的'认证套件',训练前先验 C1–C5,用本基准证明 MarS、LOB-Bench 生态中候选模拟器的执行成本模型可信;其二,把冲击形状或补充流动性机制作为辅助训练目标(如在生成损失中加入对注入实验的可微近似),实现'教物理'而非'事后测物理';其三,扩展到多资产联动冲击与跨市场(期货、外汇)平方根定律的普适性检验;其四,与 LOB-Bench 的分布分数合并成两轴'世界模型身份证',本文已证明两轴相关性不稳定,正需要联合报告;其五,盲控制范式本身可推广到其他反事实性质,如撤单风暴、闪崩恢复、跨品种传染的归因测量。
复现评估
复现条件较好但门槛不低。开源情况:全套协议、校准、估计器、控制与报告规则在 github.com/george-nigmatulin/lob-impact 单包发布,用户只需提供自己的模型和任意股票一个月 LOBSTER 格式数据即可运行,判定规则完全事前固定、Table 3 每个判定都能从打印数字独立复核,透明度很高。数据:LOBSTER 为商业付费数据(需 2022–2026 共约 4 年、8 只股票的消息级数据加评估月全部 487 只股票的宇宙统计),是最主要的获取障碍。算力:训练五个神经生成器(参数量 55M–120M,语料 Jan 2022–Dec 2025 八股)需要多卡训练数周量级;评估侧单次 build-up rollout 约 40k 消息,S5-120M/Mamba3/GDN 在单张 H100 上约 39–54 秒、4k 上下文变体约 12 分钟,而每股票每方向每阶段需 1024 个 rollout × 20 交易日,单一模型单股票约数十至百余 GPU 小时、五个模型五只股票的完整战役估计上千 H100 小时(作者用了 Isambard-AI 国家级资源)。依赖 JAX-LOB 撮合引擎(开源)与 replay 基线(CPU 即可,约 4 秒)。总体难度中高:复用官方代码在已有模型+已购数据上跑单股票战役约一至两周工程量;从零复现包括训练则需实验室级算力。
论文图表
被测的 13 个模型面板。上半部为非神经基线:Historic(原样回放真实流,无因果反应,阴性对照)、Heuristic(回放加位移:被消耗的最优档位使后续消息整体移位,永久冲击)、Propagator(一档冲击按 2/3 + 1/3·ℓ^(-1/2) 幂律衰减,阳性对照)、OW(Obizhaeva-Wang 指数韧性核)。中部为参数化点过程:CST(无记忆事件率)、NMZI(CST 加收益驱动的符号反馈)、Hawkes(自/交叉激发强度)、QR(队列反应强度)。下半部为五个神经 SSM 生成器:S5-120M、S5-4k、Mamba3、Mamba3-4k(2k 微调、4k 窗口)与 GDN,参数量 55M–120M,共享含 AMD 在内的八股语料(2022.1–2025.12,评估月 held out),500 或 4000 消息条件窗口。'Gen.' 列给出单次 build-up rollout 的墙钟时间:神经模型单张 H100 上 39 秒至约 12 分钟,参数化基线 CPU 约 4 秒。
基线面板的构造本身是方法贡献:从'不可能有冲击'的 Historic 到'写入目标物理'的 Propagator/OW,每级基线用来校准估计器的不同侧面;同时它记录了复现所需的全部模型配置与算力成本信息。