ACE-Brain-0.6:为物理基础模型扩展空间视觉定位 ACE-Brain-0.6: Scaling Spatial Grounding for Physical Foundation Models
用150万可验证定位数据微调9B模型,平均定位成绩超越GPT-6 Astra
前置知识
视觉定位(Visual Grounding)
视觉定位要求模型根据自然语言描述在图像中指出对应目标的位置,输出可以是点坐标、边界框、点列表,或在目标不存在时回答「无」。可靠的定位需要覆盖所有满足描述的区域并在无匹配时显式拒答,在杂乱、遮挡的具身场景中尤为困难。
本文训练与评测的全部任务(指认、计数、空间关系、自由空间、可供性)都是视觉定位的具体形式,理解任务定义与评分方式是读懂实验部分的前提。
视觉语言模型与指令微调(VLM + SFT)
视觉语言模型将图像编码与语言模型结合,能对图文混合输入做文本生成。指令微调(SFT)在其上用问答形式的监督继续训练,通常只对答案 token 计交叉熵损失,让模型学会按指令格式输出。本文冻结视觉编码器、只微调语言模型参数。
ACE-Brain-0.6 的全部训练就是一次 SFT:把各类定位任务统一为文本生成、只对答案 token 计损失,理解这一点才能看懂第 4 节的方法与训练设计。
开放词汇检测与分割(Grounding DINO / SAM)
开放词汇检测器(如 Grounding DINO)能按任意文本类别在图像中框出目标,不限于固定类别表;可提示分割模型(如 SAM 系列)则把框或点精修为像素级掩码。两者串联是当前自动标注图像数据的主流流水线。
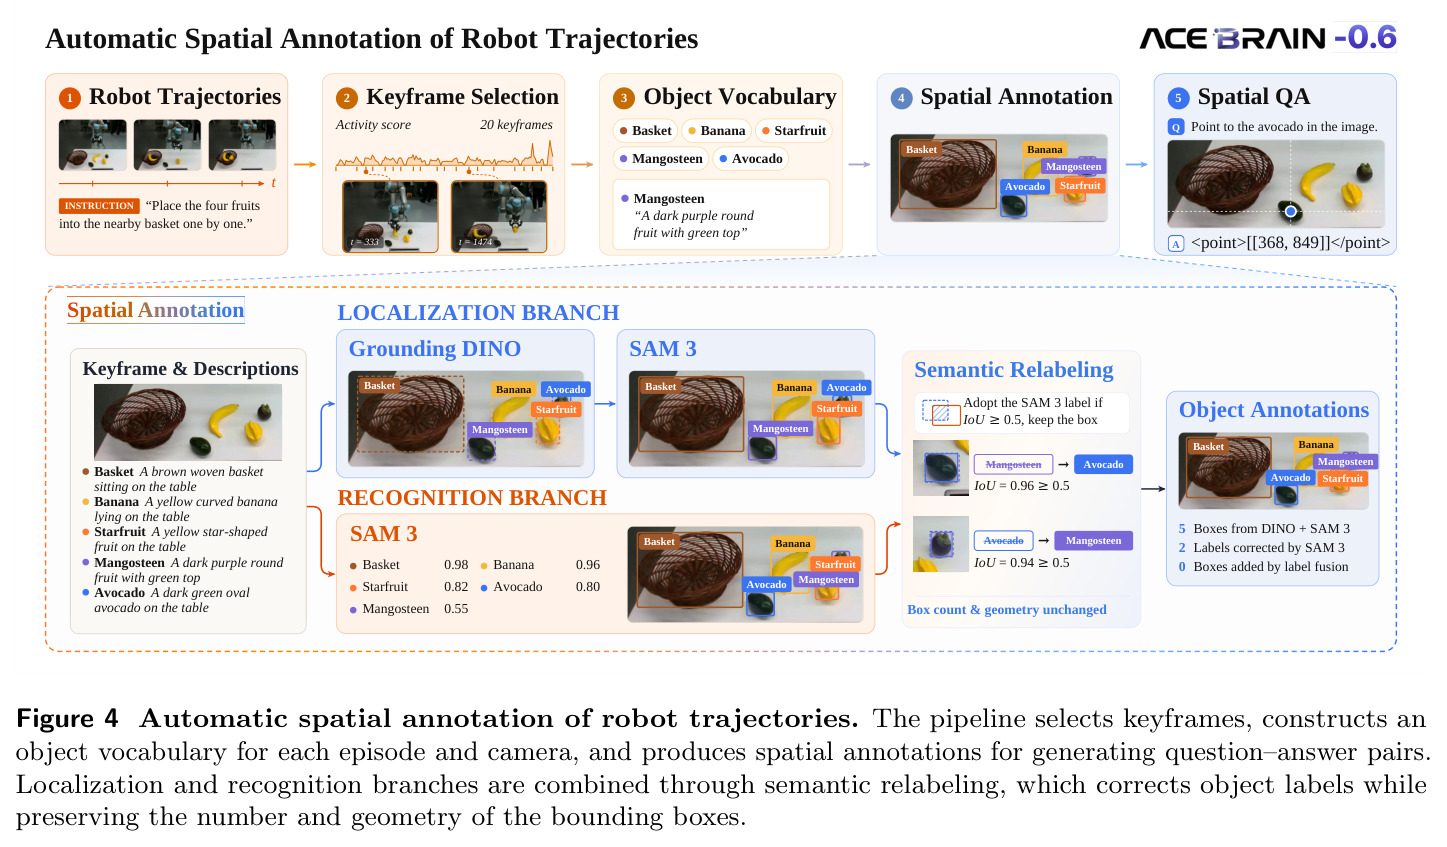
本文自动标注机器人轨迹的核心组件正是 Grounding DINO 检测加 SAM 3 精修与识别重标注,图 4 的整条标注管线完全建立在这两类模型之上。
数据缩放定律(Data Scaling Law)
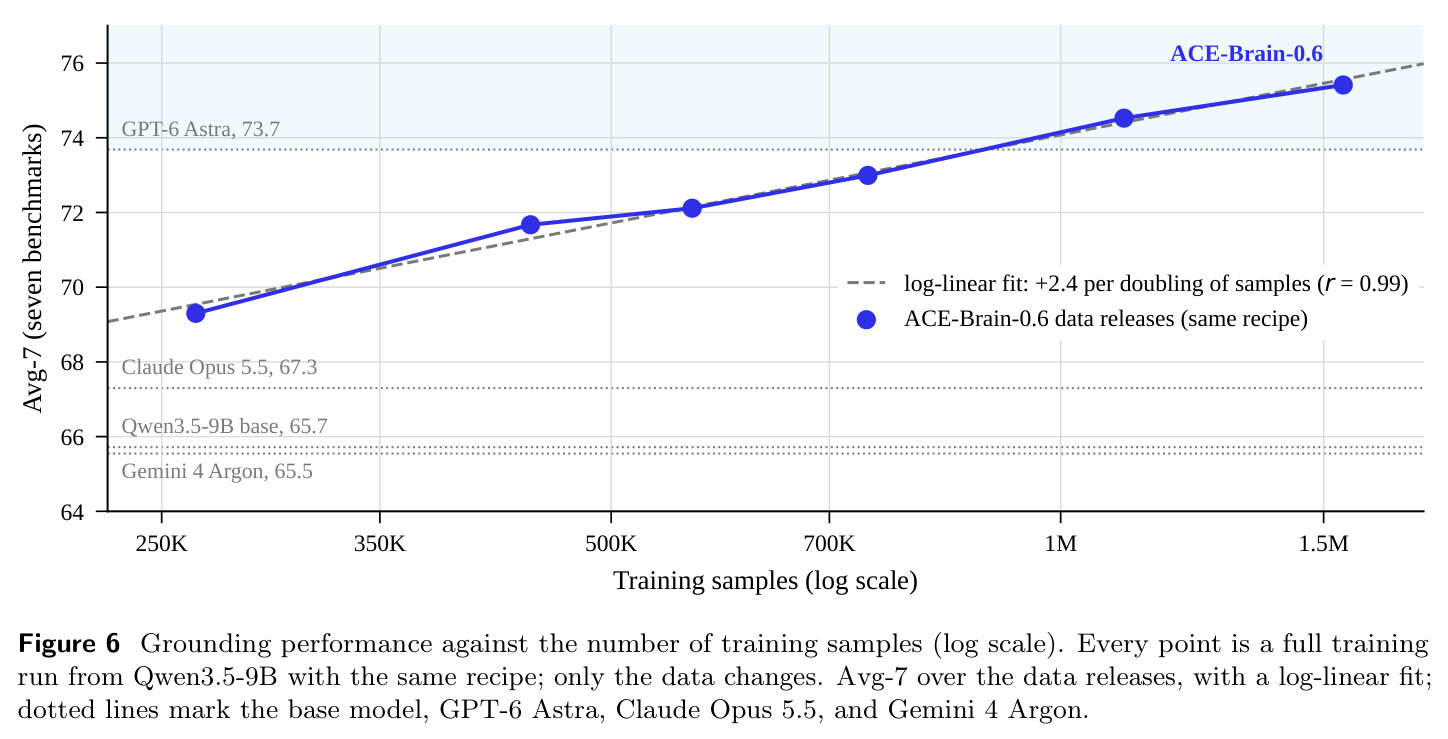
缩放定律描述性能随数据量、参数量或算力按幂律或对数线性趋势提升的现象。本文在固定底座与配方、只改变数据的条件下,发现七个基准平均分随训练样本数对数线性上升,约每翻倍提高 2.4 分(相关系数 r=0.99)。
标题中的「Scaling」即指数据缩放,第 5.4 节的缩放曲线与对照实验是本文最核心的实证贡献,需要缩放定律的概念来理解其方法论与含义。
可供性与自由空间(Affordance & Free Space)
可供性指物体上适合执行某动作的部位,如「可以握住的手柄」「适合切割的接触区」,通常用掩码或点标注;自由空间指场景中未被物体占用的区域,是放置类任务的目标。本文的自由空间监督只标记 2D 未占用区域,不保证 3D 可行性。
RoboAfford、ShareRobot、Where2Place 等评测基准与本文的主要优势项都围绕这两类目标展开,第 5.3 节的增益来源分析直接依赖这些概念。
研究动机
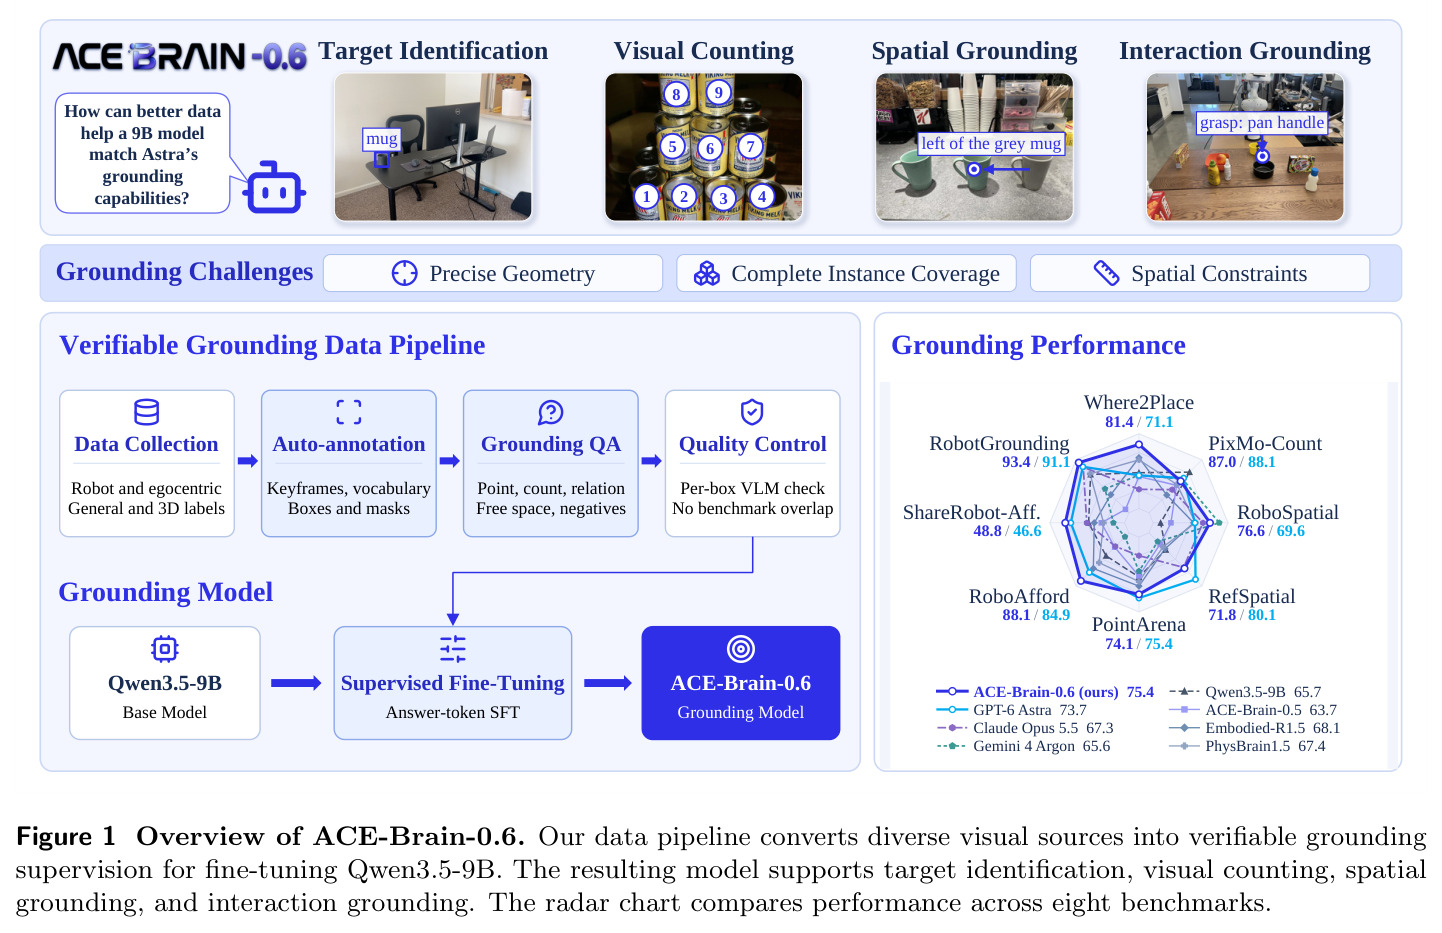
通用多模态模型正把能力扩展到具身操作,GPT-6 Astra 在杂乱场景中能准确定位与任务相关的交互目标,但作者第 3 节的案例分析显示其空间感知仍有两类系统性缺陷:一是细粒度几何定位不精确,例如被问到「该握住杯子的哪个部位才能提起」时,预测点虽贴近杯柄却落在参考掩码之外;二是空间约束下的自由空间定位失败,如「蒸汽机前方的空闲位置」被点到了右侧砧板上。同时,开源 9B 级模型与闭源旗舰差距明显:同规模最强的开源具身模型 Embodied-R1.5-8B 在七个公共定位基准上的平均分仅 68.10,而 Astra 为 73.68。此外,机器人操作轨迹数据虽然规模庞大,却普遍缺少物体级标注,无法直接用于训练定位能力,这构成了具身感知研究的数据瓶颈。
本文的目标是本文的核心问题是:在不改变模型架构和训练配方的前提下,仅靠扩大定位监督数据的规模与覆盖面,一个开源 9B 视觉语言模型能否追平甚至超越 GPT-6 Astra 的空间定位能力?为此作者设定了严格的实验设计:固定基座 Qwen3.5-9B,固定单一训练配方(峰值学习率只在早期数据版本上做一次四点扫描选定后不再调整),构建一条能将机器人操作录像、自我中心交互视频与通用视觉数据统一转化为可验证问答监督的数据管线,并让每一轮数据发布都新增任务类型或图像域,最终用约 154 万样本训练出 ACE-Brain-0.6,在七个公共基准与自建 RobotGrounding 基准上与 Astra 及其他 12 个开源、闭源模型全面对标。
与已有工作不同的是,已有定位数据工作各取一隅:PixMo 依赖人工标注点、GrIT 把字幕短语与预测框配对、SpatialVLM 借助分割与深度合成空间问答、RoboPoint 从仿真场景几何导出指点监督。本文的独特切入有三点:第一,把异构来源(30 多个机器人数据集家族、自我中心人-物交互、物体部件掩码、3D 场景)统一为同一个文本生成输出接口;第二,用自动标注链路给原本没有物体标签的机器人轨迹补上监督,并通过语义重标注在不移动框的前提下纠正类别名;第三,以控制变量的方式研究数据缩放——每个数据发布都用同一配方从同一基座重训,从而把性能差异完全归因于数据,并通过对照实验区分「覆盖新监督类型」与「重复旧数据」的贡献,得出覆盖度比数量更关键的结论。
核心方法
方法的直觉是:具身空间感知的短板不在模型架构而在监督数据,因此把全部精力投在数据管线上。管线分三层:其一,收集覆盖单臂、双臂、移动与人形本体的 30 多个机器人操作数据集家族作为目标域数据,并自动为其补上物体级标注;其二,补充自我中心人-物交互数据(手-物体掩码与接触区域)与通用指点定位数据(完整实例集、部件掩码、3D 标注、少量通用 VQA),弥补机器人数据缺失的能力维度;其三,把所有来源转写成可验证的问答对。模型侧将每个定位任务统一为条件文本生成:输出点是 $(x,y)$、点列表、框 $(x_1,y_1,x_2,y_2)$、整数计数或类别 token(yes/no/none),坐标归一化到 $[0,1000]$。最终约 154 万样本(341 万问答对、139 万张去重图像)用于对 Qwen3.5-9B 做单 epoch 全参数微调(冻结视觉编码器、关闭多 token 预测头),得到 ACE-Brain-0.6。
核心创新是「可验证监督」这一定义方式:每个答案都必须能对照其支撑标注机械地判定对错——计数与逐实例题只在实例集完整时才生成,否定题要对照图像词表确认目标确实不存在,自由空间目标只标记 2D 未占用区域而不宣称 3D 可行性。为防止模型学到问题措辞与答案形式之间的捷径,管线强制每个模板内任一答案形式占比不超过 70%、yes/no 答案平衡、点的数量与问题要求严格一致。自动标注方面,语义重标注机制让 SAM 3 识别分支只纠正检测框的类别名而保持框的数量与几何不变(IoU ≥ 0.5 才保留),兼顾标签质量与定位精度。缩放实验进一步给出本文最重要的经验发现:对固定底座和配方,推动定位性能的是监督类型的数量而非样本数量——只翻倍旧来源的对照实验增益不足 1 分,而每个新增任务族的数据发布都沿对数线性趋势稳步抬升。
方法步骤详情
第一步,数据收集:整合机器人操作轨迹、自我中心交互视频与通用定位/3D 数据。第二步,关键帧选择:按动作信号从每条轨迹选约 20 帧,优先夹爪状态切换与大幅动作变化,保留轨迹起、中、尾。第三步,开放词表构建:用 VLM 为每个片段与相机列出可见物体的短名称与外观描述。第四步,空间标注:Grounding DINO 按词表检测,SAM 3 精修框;SAM 3 识别分支做语义重标注,用 IoU 最高的概念纠正名称(IoU ≥ 0.5 才保留,框数与几何不变)。第五步,问答生成:从模板批量产生指点、框选、计数、自由空间、否定与跨视角问答,答案严格符合输出接口。第六步,质量控制:每个检测框经 VLM 核验,不匹配即丢弃,评测基准图像按匹配排除。第七步,训练:仅对答案 token 计交叉熵损失,对话打包进 16,384 token 序列,每全局步约 140 样本;AdamW(β=(0.9,0.95)),学习率 50 步升温至 $1\times10^{-5}$ 后余弦退火至 $1\times10^{-7}$,fp32 主权重、FSDP 加 FlashAttention-2,单 epoch。
技术新颖性
与检测器系(GLIP、Grounding DINO)和生成式系(Pix2Seq、Florence-2、Rex-Omni)相比,本文不提出新架构,而是把定位当作纯数据问题来研究,这在具身领域是少见的控制变量式实证。与 PixMo 的人工点标注、GrIT 的字幕-框配对、SpatialVLM 的分割加深度合成、RoboPoint 的仿真几何导出相比,本文首次把真实机器人轨迹经「关键帧选择—VLM 词表—检测与分割—语义重标注」的自动链路批量转成定位监督,避开了人工标注的成本瓶颈。可验证性约束与防捷径规则也区别于以往常见的「生成后再过滤」模式:监督在生成阶段就保证可判定、可核对。另外,把「每轮数据发布固定配方重训」作为实验设计,使缩放曲线(每翻倍约 +2.4 分,$r=0.99$)成为可归因于数据本身的干净结论,而非配方调优的副产品;对照实验进一步证明单纯复制旧来源几乎无效,这是对「数据多样性决定上限」的一次干净验证。
实验结果
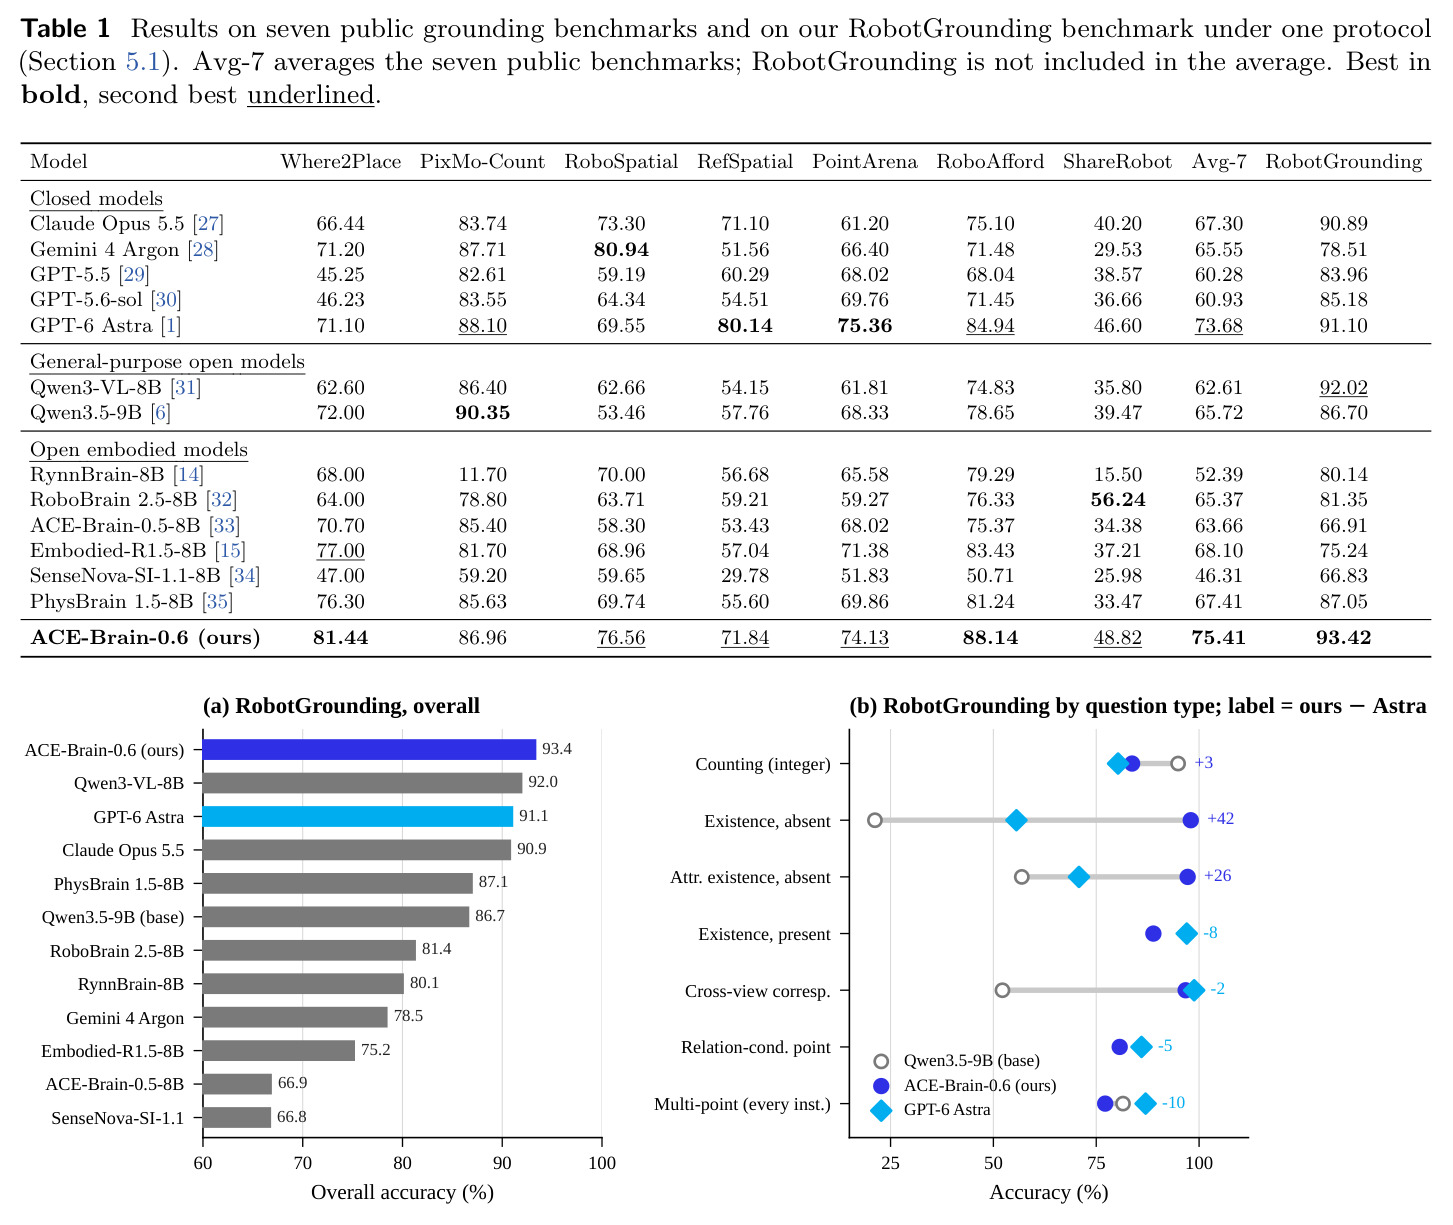
对闭源模型:七基准平均 75.41 超过 GPT-6 Astra 的 73.68,在 Where2Place、RoboSpatial、RoboAfford、ShareRobot 四项领先(81.44 对 71.10、76.56 对 69.55、88.14 对 84.94、48.82 对 46.60),PixMo-Count 与 PointArena 小幅落后(86.96 对 88.10、74.13 对 75.36),RefSpatial 明显落后(71.84 对 80.14)。对基座:Qwen3.5-9B 平均 65.72,微调提升近 10 分,但计数从 90.35 降至 86.96。对同规模开源:领先第二名 Embodied-R1.5-8B(68.10)超 7 分。机器人场景:RobotGrounding 93.42 居首(Astra 91.10),「存在-缺席」领先 42 分、「属性-缺席」领先 26 分,逐实例枚举落后 10 分。缩放:0.26M→1.55M 样本 Avg-7 由 69.3 升至 75.4,每翻倍约 +2.4 分,只翻倍旧来源的对照增益不足 1 分。
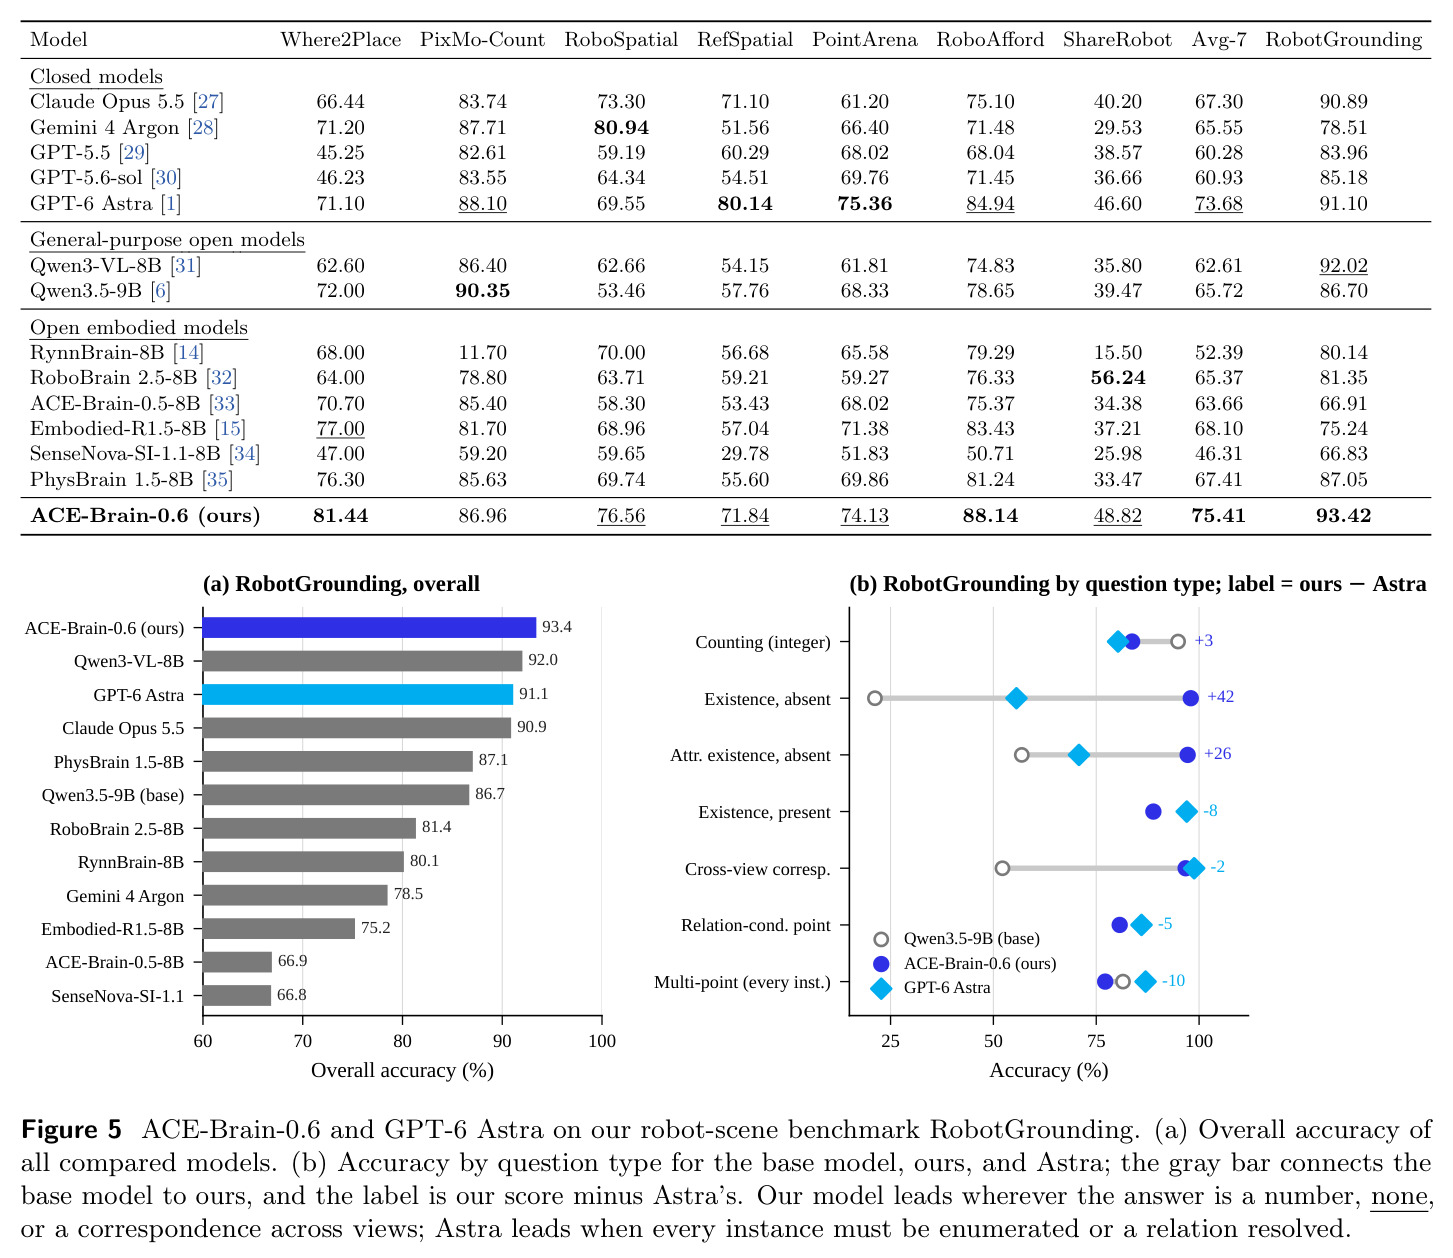
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 七基准平均(Avg-7) | 七个公共基准官方指标的平均 | 75.41 | GPT-6 Astra 73.68;基座 Qwen3.5-9B 65.72 | 对 Astra +1.73;对基座 +9.69 |
| Where2Place(自由空间指点) | 官方指标 | 81.44 | GPT-6 Astra 71.10 | +10.34 |
| RoboSpatial(空间关系与自由空间) | 官方指标 | 76.56 | GPT-6 Astra 69.55;基座 53.46 | 对 Astra +7.01;对基座 +23.10 |
| RoboAfford(功能可供性) | 官方指标 | 88.14 | GPT-6 Astra 84.94 | +3.20 |
| ShareRobot-Aff(可供性划分) | 官方指标 | 48.82 | GPT-6 Astra 46.60 | +2.22 |
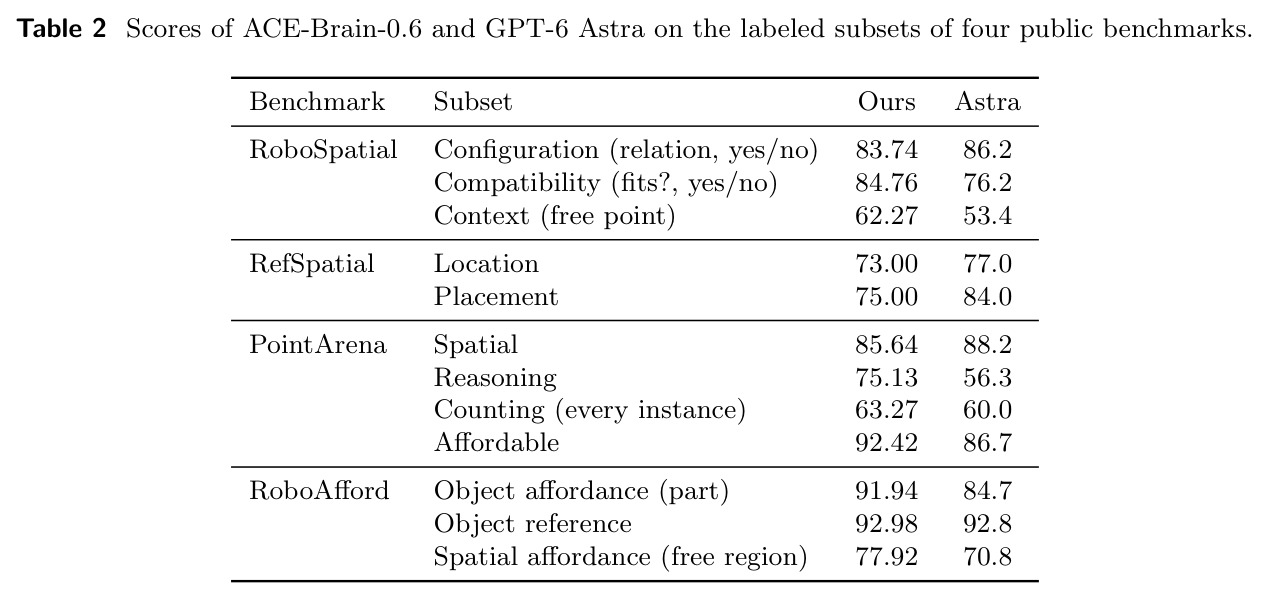
| RefSpatial(空间约束指代) | 官方指标 | 71.84 | GPT-6 Astra 80.14 | -8.30(落后,placement 子集差距最大:75.00 对 84.0) |
| PixMo-Count(多实例计数) | 官方指标 | 86.96 | GPT-6 Astra 88.10;基座 90.35 | 对 Astra -1.14,对基座 -3.39(均落后) |
| PointArena(指点精度与推理) | 官方指标 | 74.13 | GPT-6 Astra 75.36 | -1.23(推理子集反超:75.13 对 56.3) |
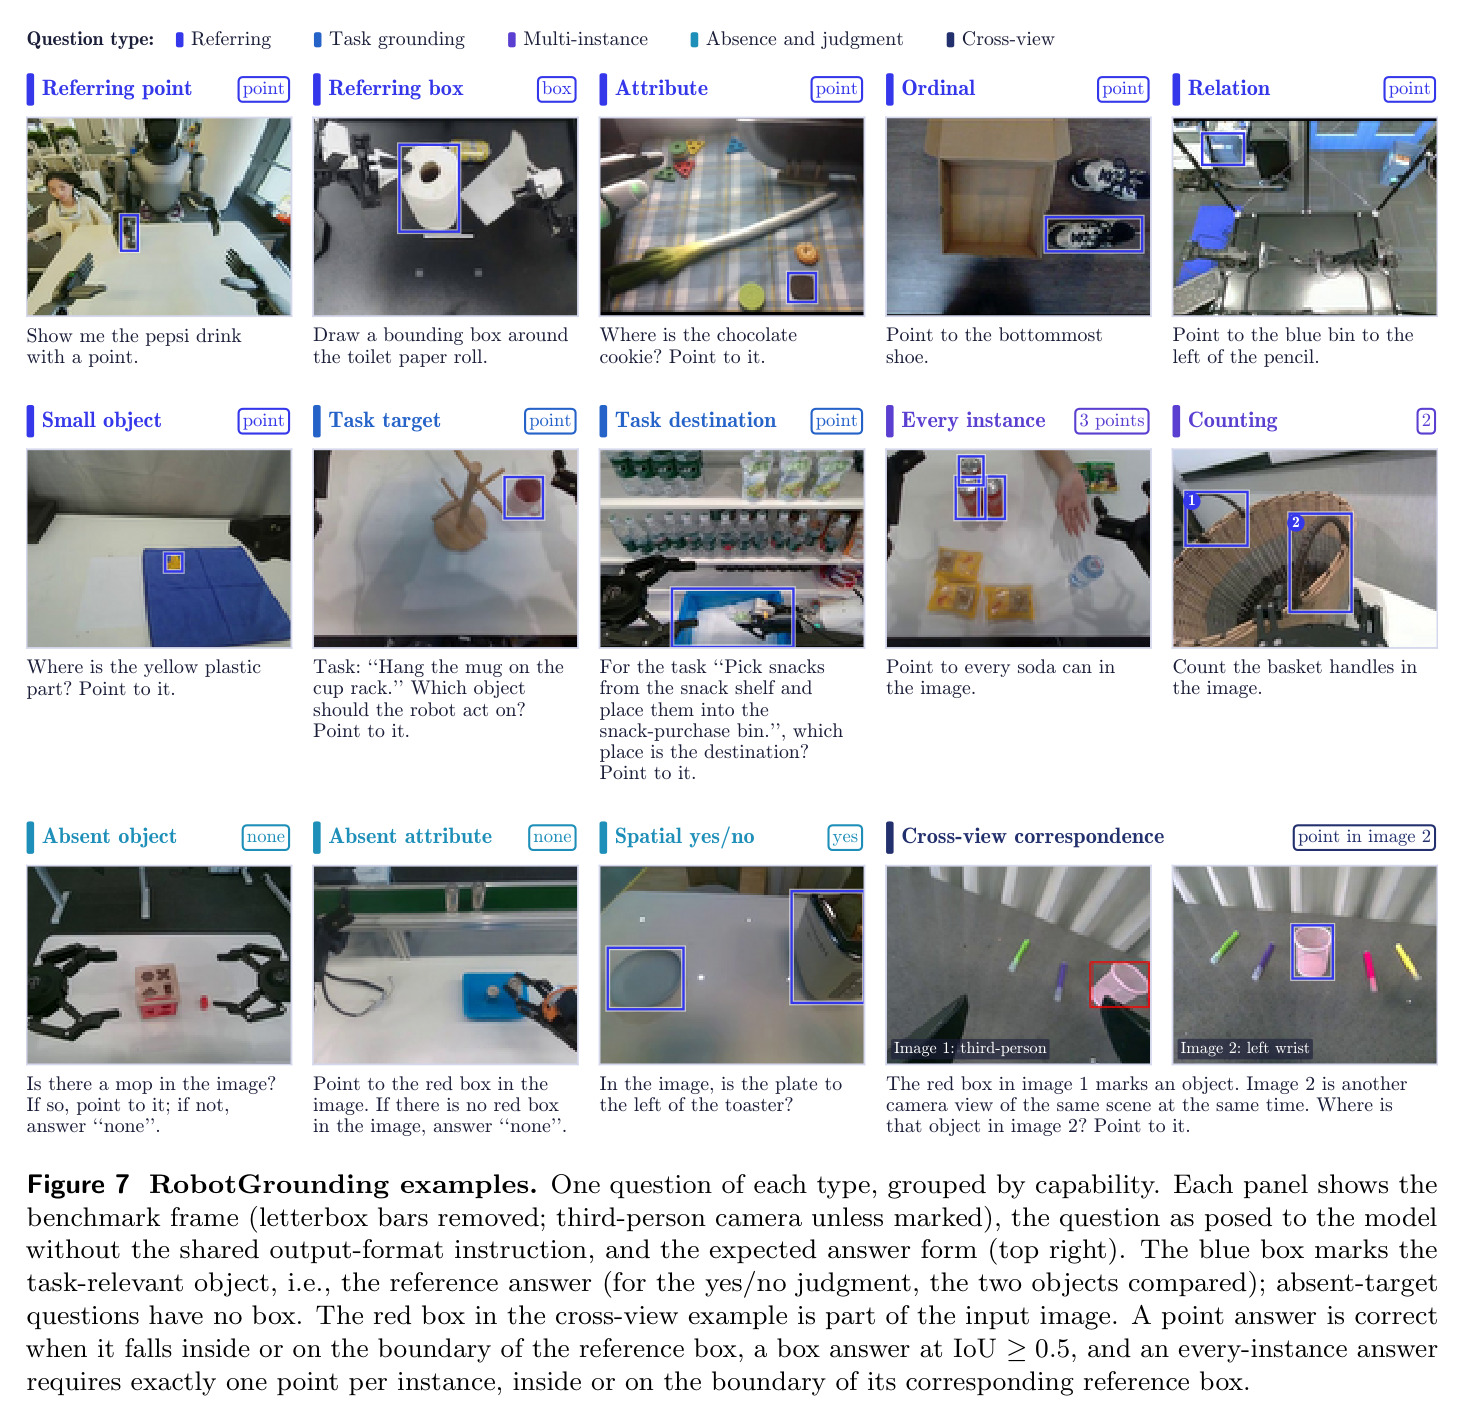
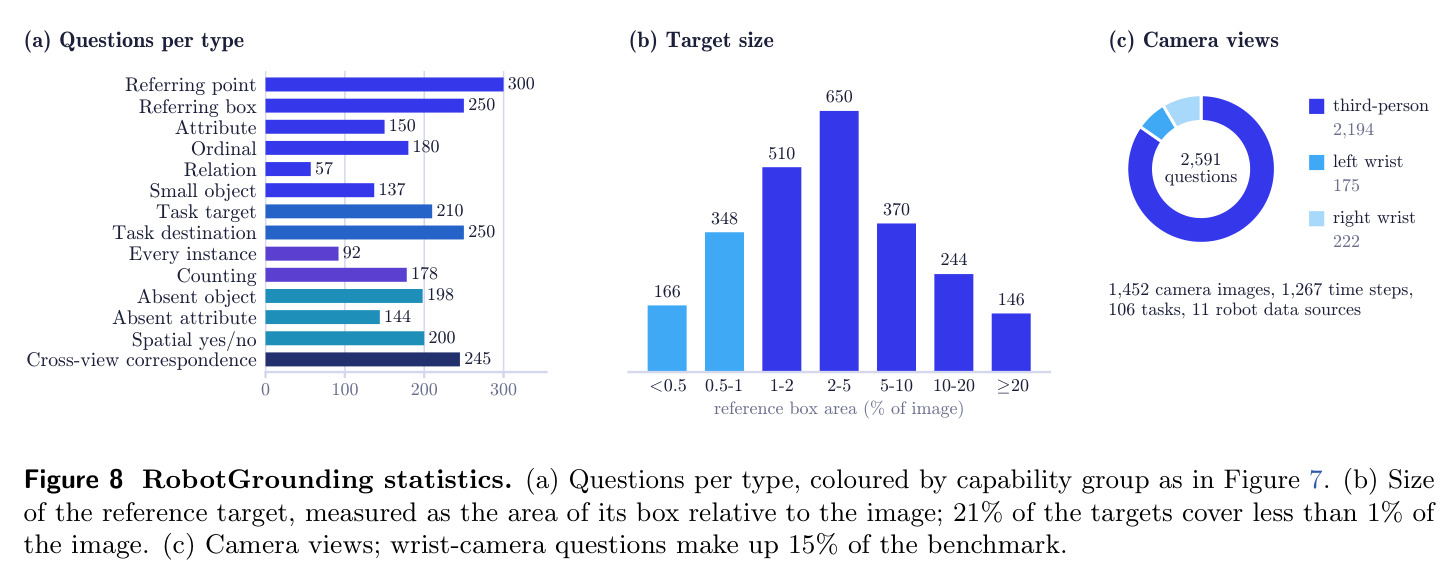
| RobotGrounding(自建机器人场景基准) | 14 题型宏平均 | 93.42 | GPT-6 Astra 91.10;第二名 Qwen3-VL-8B 92.02 | 对 Astra +2.32,超过全部 13 个对比模型 |
局限与改进
作者承认的局限有二:一是逐实例枚举能力不足,PixMo-Count 与 PointArena 多实例题落后,说明「完整实例集」监督的构造仍不够强;二是空间约束下的放置任务差距明显(RefSpatial placement 子集 75.00 对 Astra 的 84.0),因为自由空间监督只标记 2D 未占用区域、不验证 3D 可行性,加入数千条仅从 2D 掩码计算的放置题也未见改善。笔者的补充观察:其一,RobotGrounding 为自建基准,虽构建规范(人工框标注、14 组宏平均、正负题平衡),但主场优势难以完全排除;其二,微调损害了基座本已很强的计数能力(90.35 降至 86.96),提示任务间存在负迁移而文中未深入分析;其三,自动标注链路的误差(检测、分割、词表 VLM 三处串联)只靠末端逐框 VLM 核验控制,遮挡与小于 1% 画面的小目标可能存在系统性漏标;其四,缩放结论仅在 9B 一个底座规模上验证,未考察数据缩放与模型规模的交互效应。
独立分析的弱点
独立来看,本文有几处值得推敲。第一,监督上限受标注链路制约:Grounding DINO 检测、SAM 3 分割与词表 VLM 三者串联,任一环节在遮挡、相似干扰物或小物体上出错都会静默传播为错误监督,而末端逐框 VLM 核验只能拦住「框内内容与标签明显不符」的情形,改进方向是引入不确定性估计,对低置信框做人工或更强模型复核。第二,2D 自由空间监督与物理可行性脱节,这直接解释了 placement 子集约 9 分的差距,改进方向是接入深度、点云或仿真重排来生成经 3D 可行性验证的放置目标。第三,数据配比消融不足:缩放分析只比较相邻发布版的增量,无法回答「部件掩码与 3D 空间关系数据哪个更划算」,改进方向是按数据族做留一法实验。第四,防捷径规则(70% 占比上限、yes/no 平衡)是启发式的,可能仍残留模板级捷径,改进方向是用探测模型自动搜索残余捷径。第五,坐标量化到 $[0,1000]$ 的整数表示限制了亚像素级定位上限,与细粒度几何任务仍有差距的现象一致,可考虑连续回归头或多分辨率坐标编码。
未来方向
作者明确给出的方向是下一版管线要补两类新监督:完整的多实例目标标注(解决逐实例枚举短板)与经 3D 可行性验证的放置数据(解决空间约束短板),并认为缩放趋势表明「新监督类型」而非「更多旧数据」才是增长引擎。基于本文成果还可延伸出多条路线:其一,把 grounding 从孤立评测推向下游闭环,用真实操作成功率而非定位分数衡量监督质量;其二,利用答案可机械判定的特性,把定位任务作为强化学习的天然 reward 信号;其三,在更大底座上重复缩放实验,检验「覆盖度驱动」的结论是否随模型规模变化;其四,把关键帧标注扩展到时序维度,支持跨帧目标追踪与动态场景定位;其五,将跨视角对应能力与深度估计或点云等 3D 表示结合,补足从 2D 感知到 3D 几何推理的断层。
复现评估
复现难度中等偏高。有利条件:训练配方完全公开——AdamW 超参、学习率曲线(50 步升温至 $1\times10^{-5}$、余弦退火至 $1\times10^{-7}$)、16,384 token 序列打包、可变长注意力、FSDP 与 FlashAttention-2 等细节齐全;底座 Qwen3.5-9B 开源;评测的七个公共基准均有官方协议(温度 0.2、128 token 输出预算,PixMo-Count 为 1,024);RobotGrounding 的题型构成、评分标准(点落在框内即对、框 IoU ≥ 0.5、逐实例点数必须精确)与统计(1,452 张图、106 个任务、11 个数据源、15% 腕相机题)描述详尽,可照此自建。障碍:论文未明确说明训练数据与代码是否开源,自动标注链路依赖的具体词表 VLM(引用 [20])与 SAM 3 版本未完全指明;对 1.54M 样本做 9B 全参微调需要多卡高端 GPU(估计数十张 A100/H100 量级)训练数天。若数据不公开,第三方只能复现方法框架而难以复现精确数字,但「覆盖度比数量重要」这一定性结论可用自建数据独立验证。
论文图表
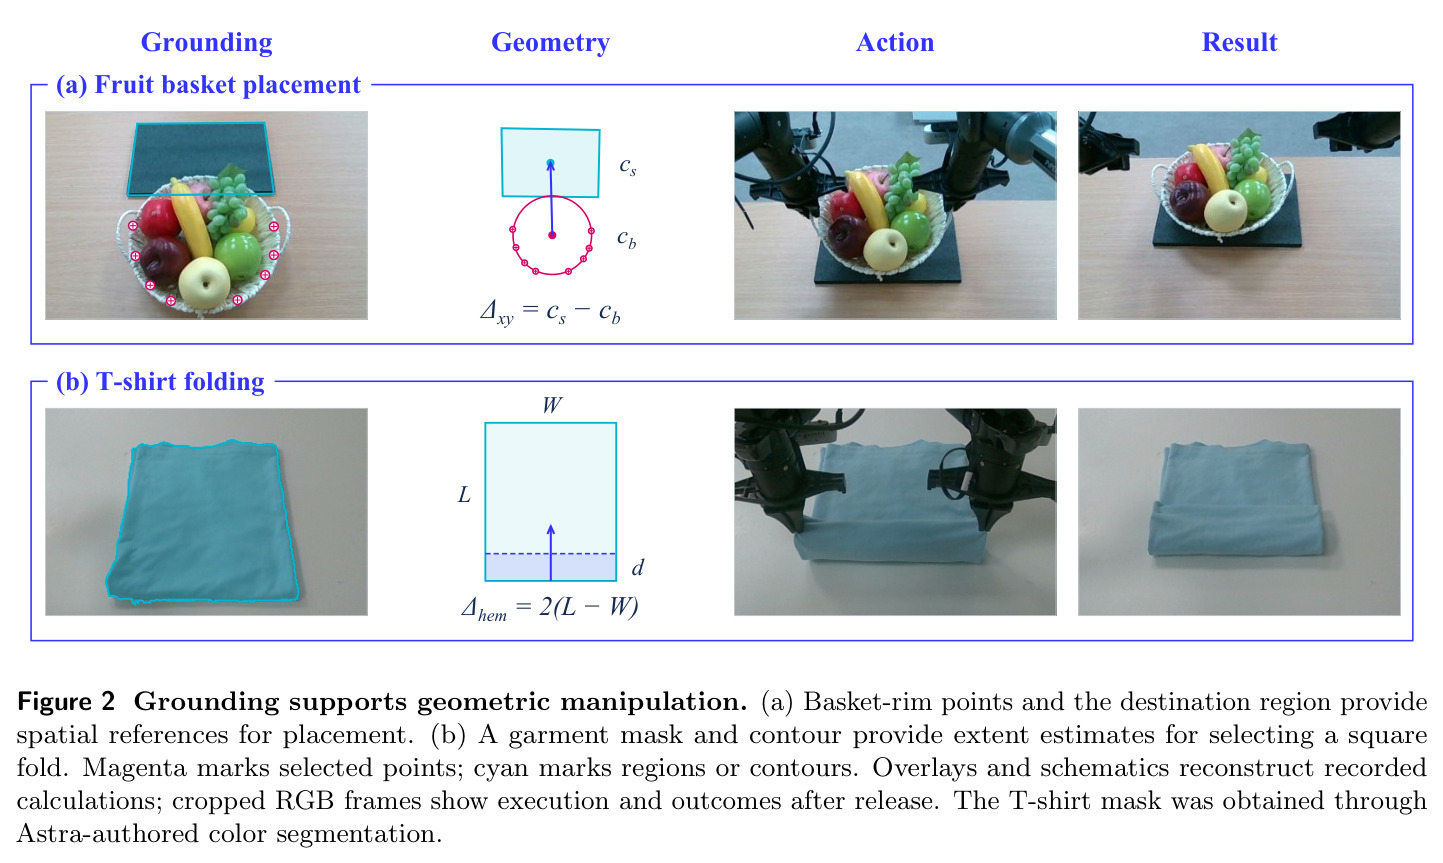
两个案例展示定位如何支撑几何操作:(a) 果篮放置中,模型沿篮沿和目的地表面选点,拟合平面后用 $Δ_{xy}=c_s-c_b$ 计算水平位移完成放置;(b) T 恤折叠中,从掩码轮廓估计衣长 $L≈363$mm、衣宽 $W≈300$mm,据此设计折叠深度 $d=L-W$、折边位移 $Δ_{hem}=2d≈125$mm。
该图论证了「空间感知是具身操作基础」这一核心动机,说明定位输出如何被下游几何计算消费,是全文立论的起点。
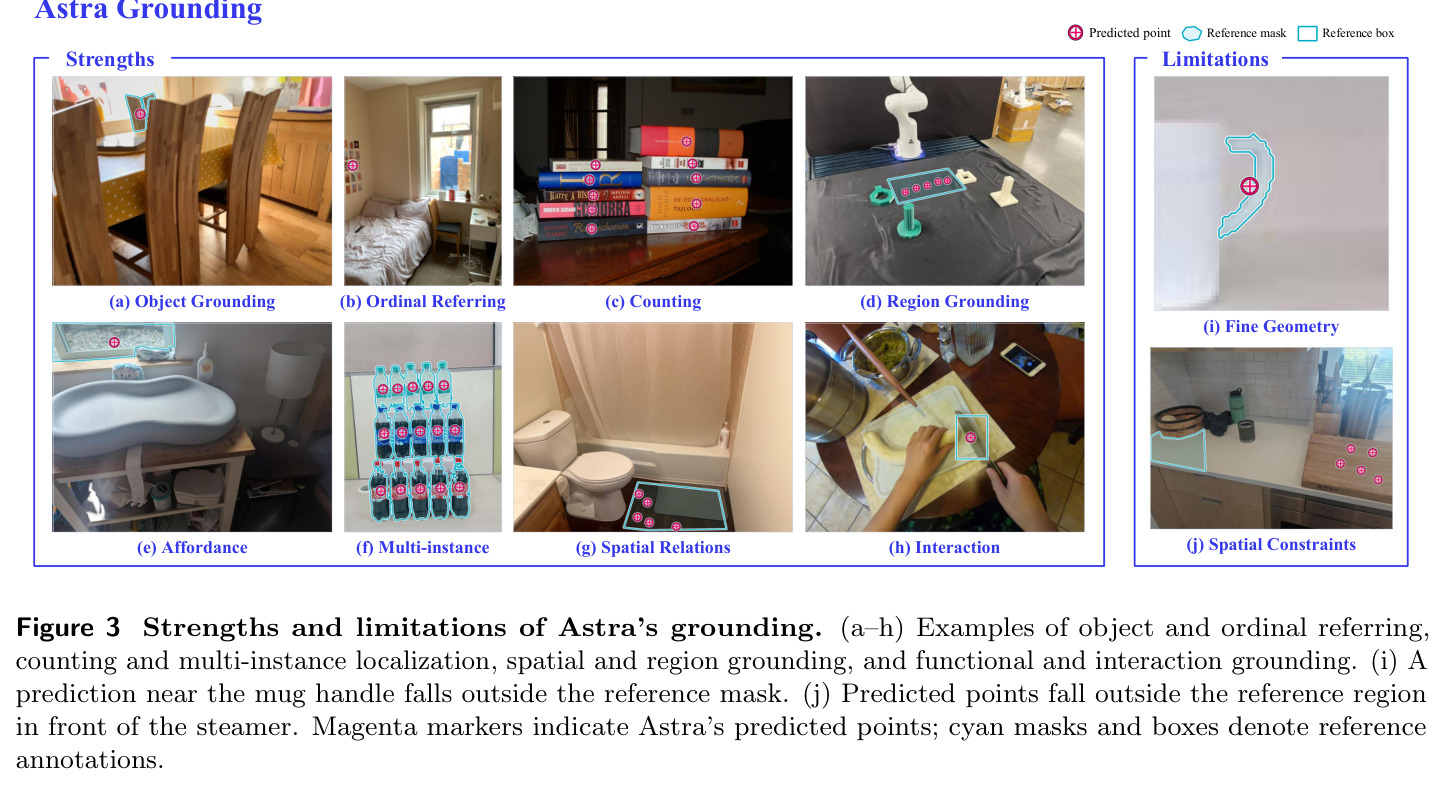
用十个例子剖析 GPT-6 Astra 的定位能力:八个强项(物体指认、序数指代、计数、区域定位、可供性、多实例、空间关系、交互定位)与两个失败案例——(i) 杯柄预测点落在参考掩码之外;(j) 「蒸汽机前方」的空闲位置被点到了砧板上,违反空间约束。
这是第 3 节对 Astra 系统性分析的可视化,直接定义了本文要追赶的参照系和要解决的具体失败模式(细粒度几何与空间约束),贯穿后续实验分析。