GroundingPI:以视觉基元构建面向物理智能的接地基础模型 GroundingPI: A Grounding Foundation Model towards Physical Intelligence with Visual Primitives
4B接地基础模型34项基准平均73.68%超GPT-6 Astra,显著增强机器人与驾驶迁移
前置知识
视觉接地
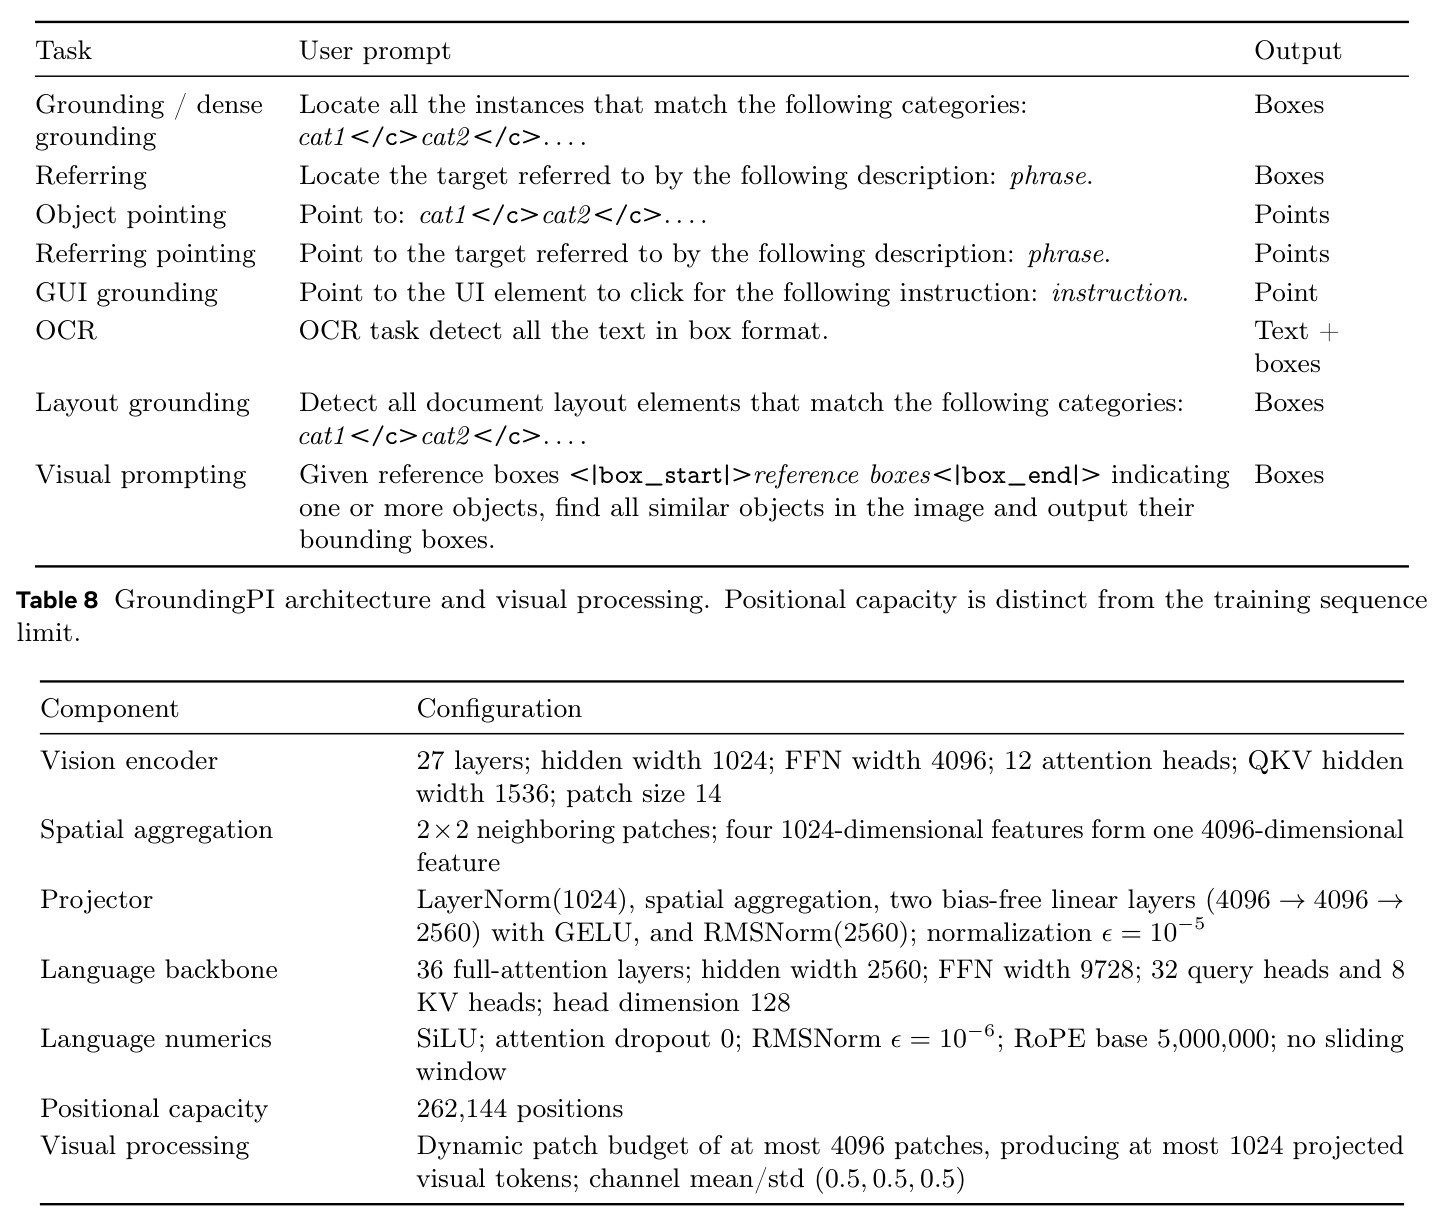
视觉接地指根据语言指令在图像中定位目标的能力:既回答“哪个物体是目标”(指代理解),也回答“它在哪里”(框或点坐标输出)。技术路线从封闭集检测器(DINO、DETR)到开放集检测(GroundingDINO),再到生成式接地模型(Rex-Omni、LocateAnything),后者用自回归解码直接生成“语义标签+坐标”序列。它是本文的核心对象:GroundingPI 把接地当作基础模型的“原生感知能力”来专门预训练,覆盖检测、指代、指向、OCR、GUI、文档版面与视觉提示共 11 类能力。
论文的全部实验围绕“接地质量”与“接地能力向动作迁移”两个轴展开,34 个接地基准是主要评测对象;不理解接地任务的形式(框/点/OCR/GUI/版面)就无法读懂其贡献、指标与实验设计。
VLA 与 WAM
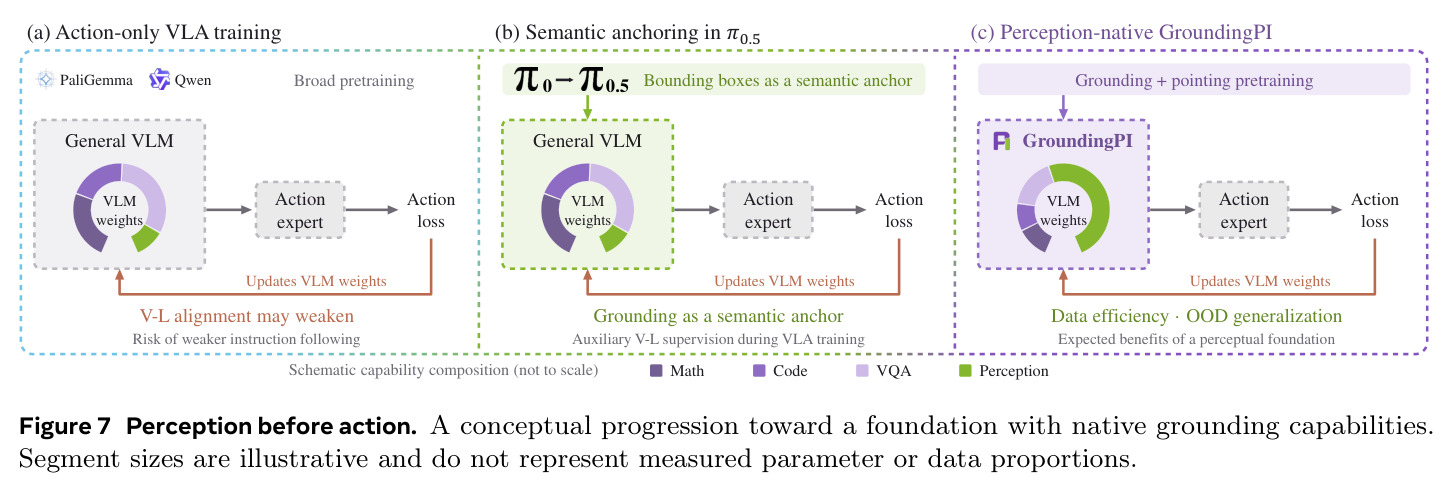
VLA(Vision-Language-Action)模型以视觉-语言骨干为底座、接上动作专家输出机器人连续控制,π0/π0.5 是典型代表;WAM(World-Action Model)则利用视频生成或世界模型的时空与动力学先验(如 Wan2.2、Cosmos)。两者的感知均继承自通用 VLM 或视频生成骨干,而这些骨干并未针对精确空间定位优化——本文称之为“预训练能力与动作学习之间的能力错配”。
本文的下游实验正是把 GroundingPI 与这些通用骨干放进同一套动作学习管线中做受控对比(通用 VLM / 视频生成 / 接地模型 / 具身基础模型四组),理解 VLA/WAM 的骨干继承关系才能看懂对比设计与结论的含义。
量化坐标词表(视觉基元)
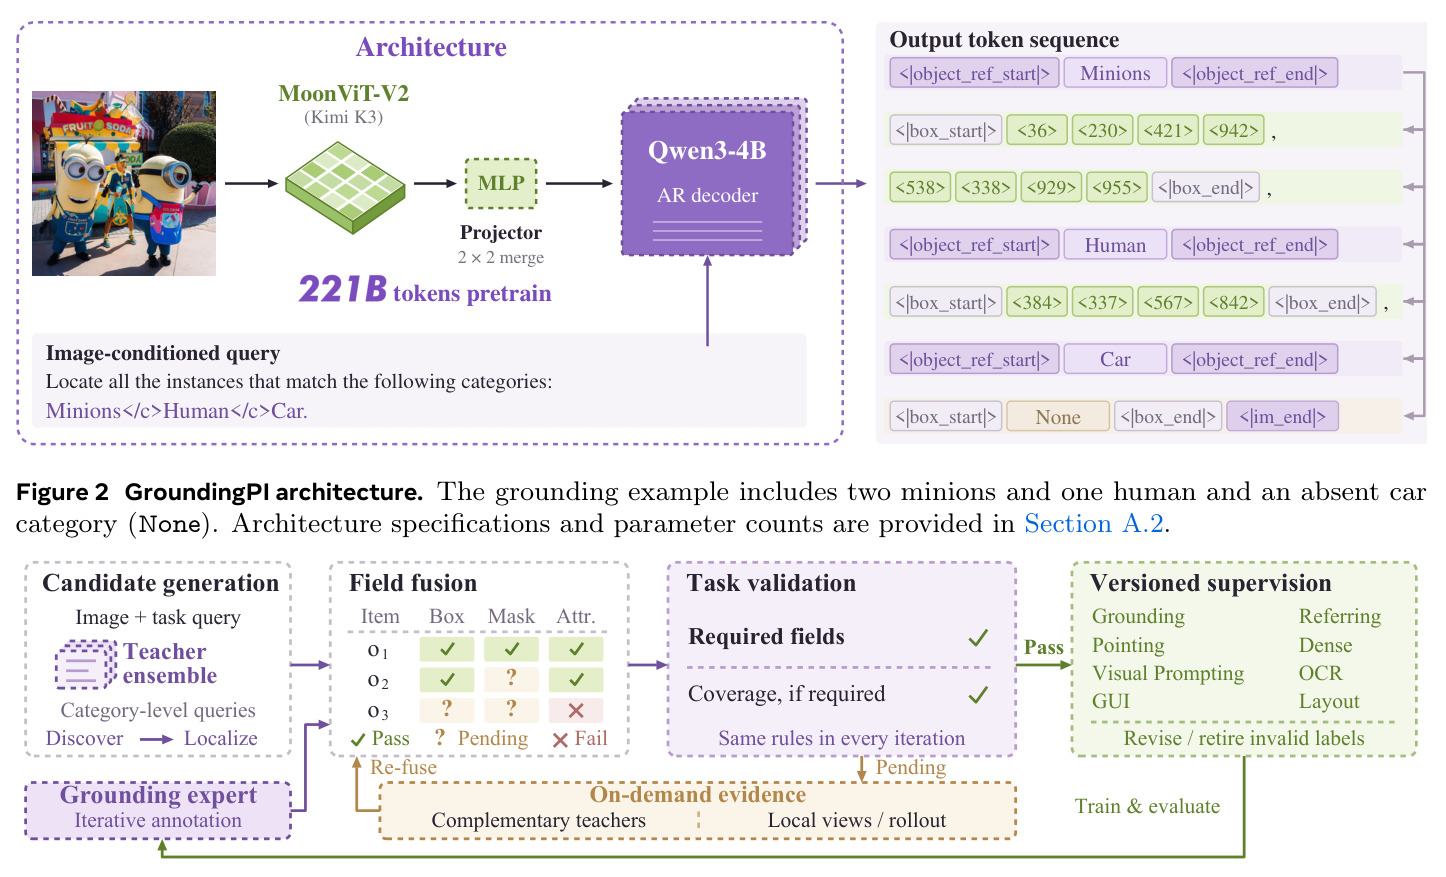
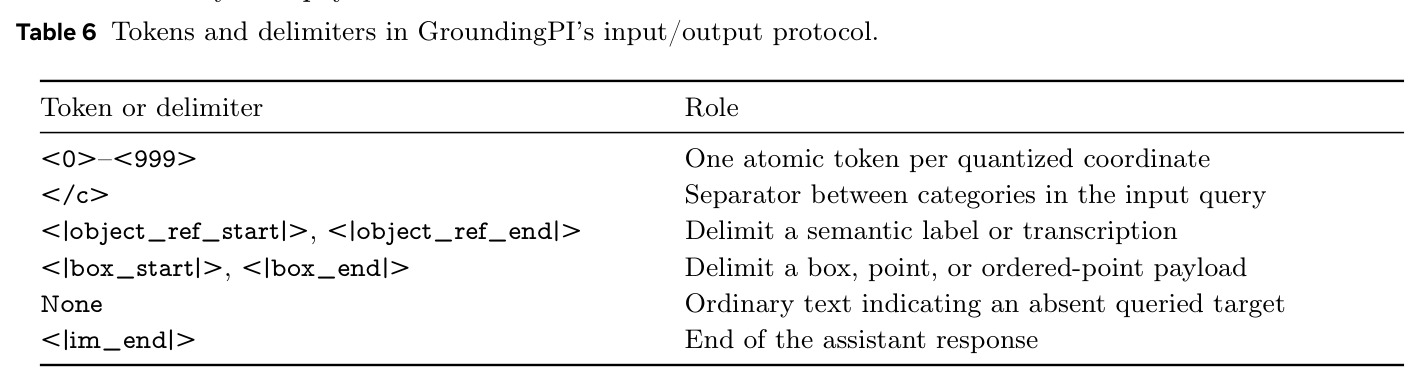
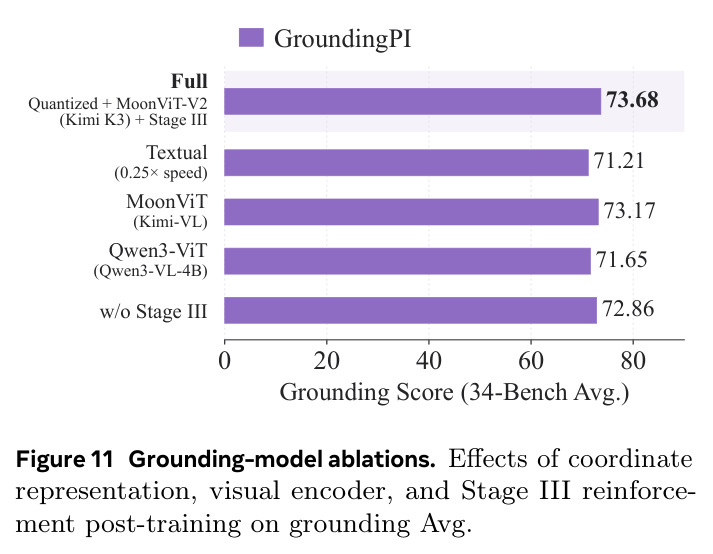
把归一化坐标离散成 1000 个原子 token($\langle 0\rangle$–$\langle 999\rangle$),与语义标签、协议标记共享同一个输出词表,由自回归解码器逐 token 生成:一个框等于 4 个坐标 token,一个点等于 2 个。相比用普通文本数字串表示坐标,原子 token 序列更短、解码更快,且让定位成为与语言生成完全同构的 next-token prediction;被查询但不存在的类别用普通文本 None 表示。
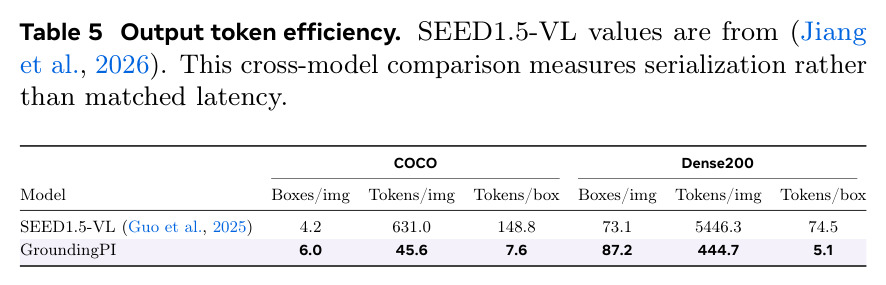
这是 GroundingPI 输出表示的基石:统一接口、密集场景的序列化效率(每框仅 5.1 token)以及量化坐标 vs 文本坐标的消融(相差 2.47 个百分点)都建立在这个设计之上。
GRPO(组相对策略优化)
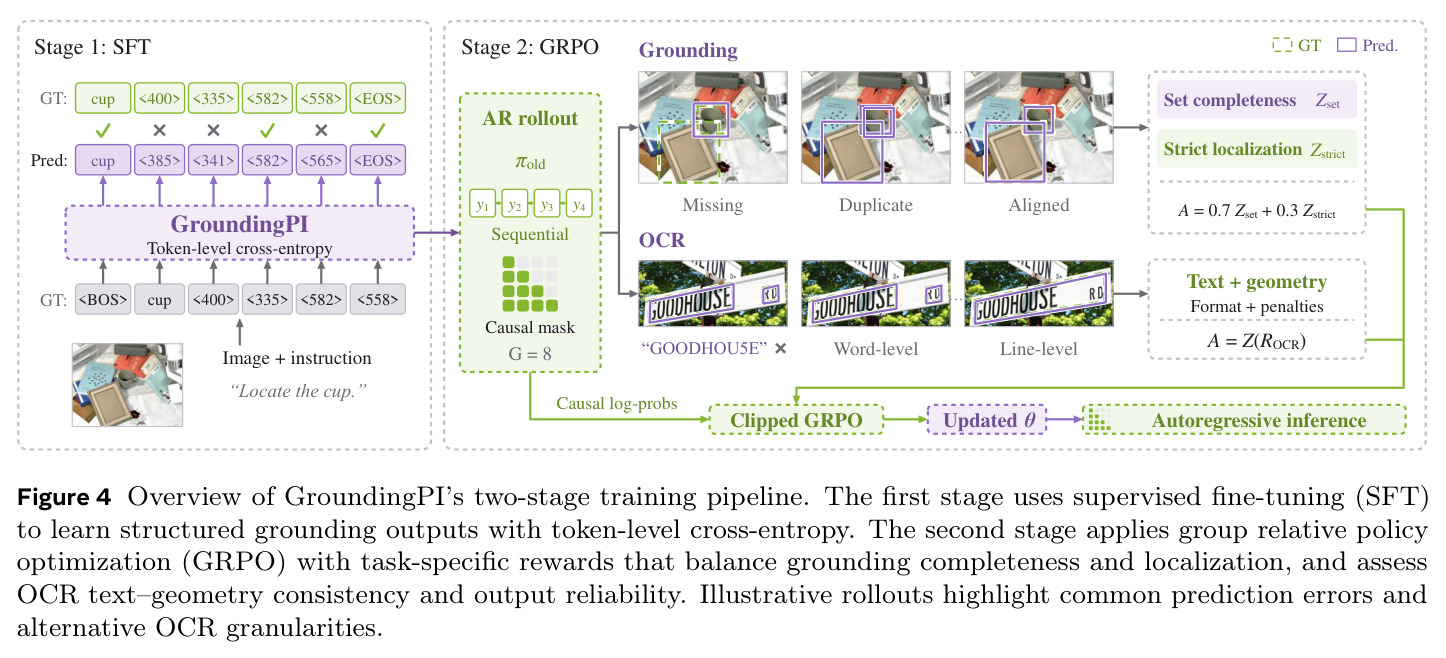
GRPO 是一种在线强化学习算法:对每个输入采样 $G$ 个回答(本文 $G=8$),用同一 prompt 内回答奖励的均值和标准差做组内标准化得到优势 $A$,从而替代价值网络,再以 PPO 式裁剪目标更新策略,并施加对冻结参考策略的 KL 惩罚 $d_{i,t}=\rho_{i,t}-\log\rho_{i,t}-1$。它适合优化 F1、IoU 这类不可导但可计算的指标。
GroundingPI 的第三阶段训练用 GRPO 直接优化定位覆盖率与严格定位精度(贡献 0.82pp),读懂其奖励设计(集合完整性 + 严格定位 0.7/0.3 加权)与最终消融必须先理解 GRPO 的机制。
Flow Matching 与 Action DiT
Flow matching 通过回归速度场学习去噪轨迹:构造 $a_t=(1-t)\epsilon+ta$,目标速度 $v^\star=a-\epsilon$,最小化 $\|\hat v_\theta(a_t,t)-v^\star\|_2^2$,推理时用少量 Euler 步从噪声积分出动作块;Action DiT 是承载该目标的 Diffusion Transformer 动作专家。本文给所有骨干配同一个 16 块 Action DiT(8 层交叉注意力 + 8 层自注意力,宽度 1024),骨干 8 个深度的隐层特征经共享重采样器压缩为条件 token 注入。
机器人操作的受控对比完全依赖这套统一的“骨干到动作”接口:架构、数据、训练预算全部固定,唯一变量是预训练骨干——明白这一点才能确认对比的公平性与结论的因果解释力。
研究动机
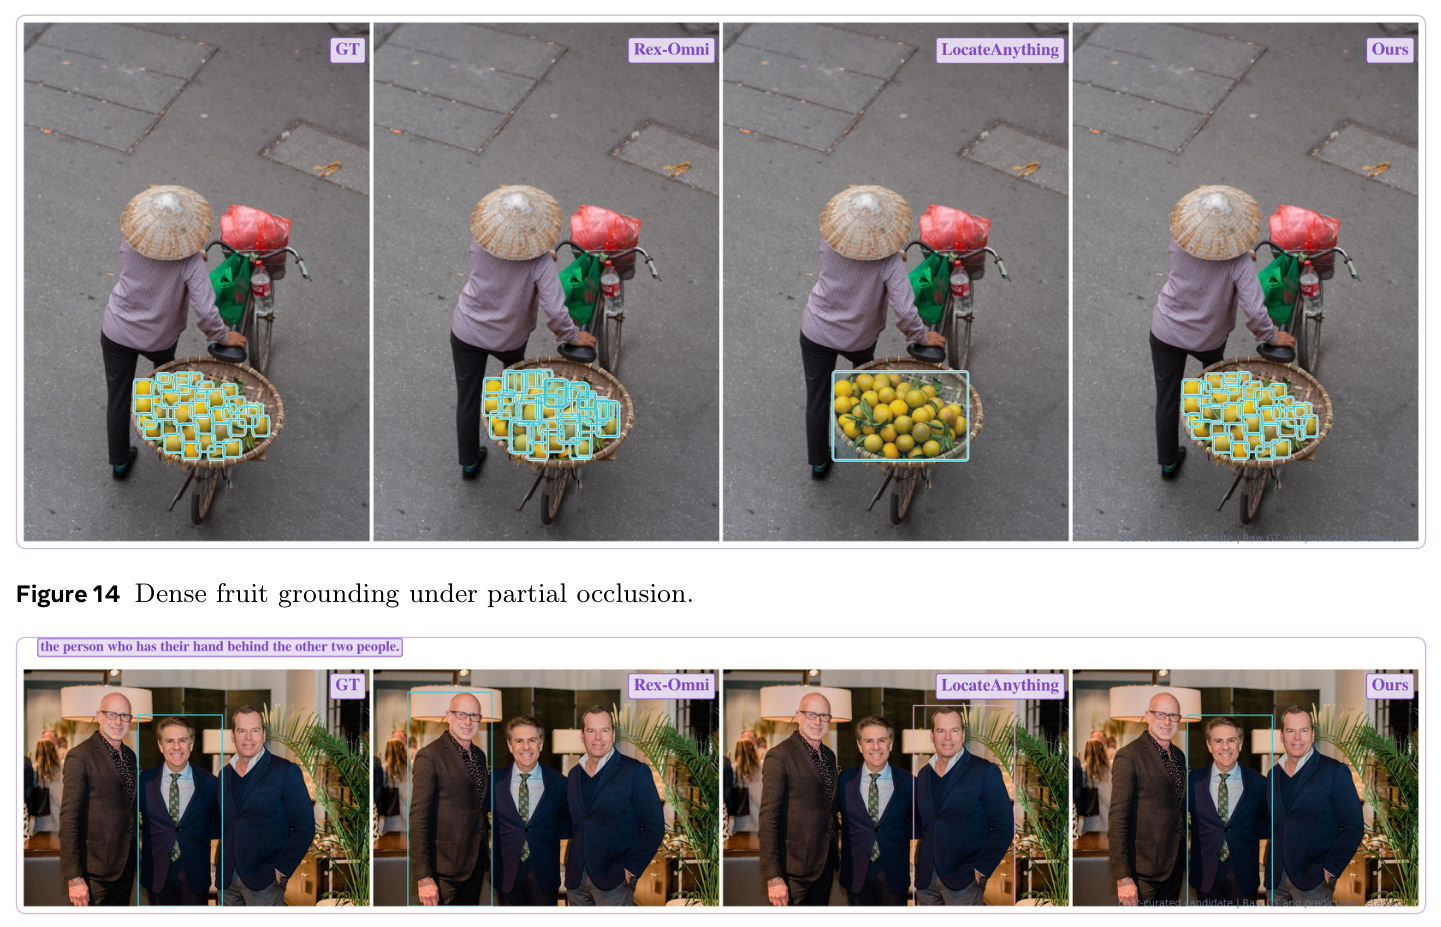
物理交互要求感知先回答“动谁、动在哪”:在杂乱桌面上找到马克杯及其把手、在一群人里锁定被指代的那一位、在无人机航拍或拥挤货架等密集小目标场景里分清相邻实例,而且推理要快到足以支撑闭环控制。然而当前 VLA/WAM 系统的感知继承自通用 VLM(如 Qwen3-VL、PaliGemma)或视频生成骨干(如 Wan2.2、Cosmos),这些骨干并未为精确定位优化。论文的评测量化了这一缺口:Qwen3-VL-4B 在密集目标基准 Dense200 上 F1mIoU 仅 14.02,更大的 Qwen3.7-Max 也只有 31.20,GPT-6 Astra 为 65.04;即便专用模型 Rex-Omni(53.29)、LocateAnything(50.07)仍有明显提升空间,VisDrone 上最好的 SenseNova-Vision 也只有 42.35。若感知不行,稀缺且昂贵的机器人动作演示数据就必须“一肩挑”地同时学感知和控制;而计算与延迟约束又不允许在执行回路里堆更大的骨干。感知由此成为下游动作学习的瓶颈。
本文的目标是本文围绕三个问题展开:Q1,一个紧凑的接地基础模型能把感知能力推到多强?Q2,更强的接地感知能给物理智能带来多少实际收益,尤其是分布外泛化与动作数据效率?Q3,哪些感知能力、哪种底座选择解释了这种迁移,对未来具身基础模型设计有何启示?具体目标是构建 GroundingPI:一个约 4B 参数、以点/框这类视觉基元为统一输出的接地基础模型,用同一接口覆盖 grounding、referring、pointing、OCR、GUI、文档版面与视觉提示 11 类感知能力,在 34 个基准、44 个基线中建立新的最优水平;随后把它的视觉表征作为共享感知底座,注入完全相同的 Action DiT 与轨迹解码器,在 RoboTwin 2.0、RoboCasa-GR1 机器人操作和 nuScenes 开环驾驶上做受控迁移评测,并系统消融预训练规模(88.4B 到 221B token)与数据配比(六个任务组的 leave-one-out)。
与已有工作不同的是,已有工作把感知当作动作学习的“附带品”:π0 到 π0.5 的演进是在 VLA 训练内部加入边界框预测作为语义锚,配合知识隔离配方;其他方法引入 affordance 表征、任务相关区域重建、空间辅助监督等——这些机制覆盖的感知信号有限,常依赖额外标注或策略专属组件,难以扩展到物理智能的多样场景与感知需求。本文的独特切入点是“感知原生”:不把接地当辅助损失,而是先独立训练一个接地基础模型,让精确空间感知成为骨干的固有能力,再让下游动作学习“站在感知之上”,而不是从任务代理目标中重新恢复感知。同时,作者把与更大的 GPT-6 Astra 的对比明确定位为“探索紧凑专用模型能把基础感知推到多接近前沿”,并提出 System 1/System 2 分工假说:广博推理交给前沿大模型做规划,精确接地模型专职快速感知-执行回路,二者互补而非替代。
核心方法
直觉上,GroundingPI 把所有感知任务都写成“语言条件下的结构化生成”:输入图像和查询,输出带协议标记的 token 序列,如 <|object_ref_start|>cup<|object_ref_end|><|box_start|><400><335><582><558><|box_end|>,坐标取自 1000 个原子 token,被查询但不存在的类别输出 None。技术路线分四步:(1) 底座为 MoonViT-V2 视觉编码器(27 层、patch 14、最多 4096 patch 经 2×2 合并为 1024 个视觉 token)加两层 MLP 投影器,接 Qwen3-4B 全注意力解码器(36 层、hidden 2560),总参数约 4.84B;(2) 四阶段监督训练:Stage 1 冻结双骨干只训投影器做图文对齐,Stage 2 全模块联合多模态预训练,Stage 3 做 32K 上下文的通用视觉/视频问答,Stage 4(SFT/坐标对齐)在 8 组空间任务上对齐坐标与视觉位置,总消耗 500.41B + 221.17B token;(3) GRPO 强化后训练,直接优化覆盖率与定位精度等不可导指标;(4) 数据侧由多教师融合的数据引擎产出字段级验证的大规模空间监督。
核心创新有三。其一是“视觉基元共享词表”:语义标签、协议标记与 1000 个量化坐标 token 在同一个 152,670 词表中由同一输出头预测,检测、指代、指向、OCR、GUI、版面、视觉提示统一为 next-token prediction,一个标签包装器可携带同类别多实例以摊薄开销——这与用文本数字串生成坐标的生成式接地模型有本质区别,消融显示量化坐标比文本坐标高 2.47pp 且解码速度为其 4 倍。其二是“感知原生”的训练哲学:接地不是动作训练里的辅助损失,而是先于动作的独立基础模型预训练,下游只换感知底座、复用同一动作学习器。其三是为不可导指标设计的 GRPO 奖励:接地优势为 $\tilde A_i = 0.7\,\mathcal{Z}(R_{\mathrm{set},i}) + 0.3\,\mathcal{Z}(R_{\mathrm{strict},i})$,其中 $R_{\mathrm{set}}$ 是按参考逐一最大 IoU 匹配并校验类别的 F1 型覆盖率 $R_{\mathrm{set}} = 2P_sR_s/(P_s+R_s+10^{-8})$,$R_{\mathrm{strict}}$ 融合多阈值 F1(权重 0.50)、匹配框 IoU(0.25)、格式/计数/排序(各 0.10/0.10/0.05)并惩罚超大框(−0.07)与重复框(−0.03);OCR 用匈牙利一对一匹配联合评分 $H = \tfrac{1}{10}\sum_{\tau\in\{0.50,\dots,0.95\}} H_\tau$。
方法步骤详情
第一步,数据引擎(输入:多教师模型预测;输出:字段级验证的实例标注):候选预测映射回原图做字段级融合,逐字段标记接受/拒绝/未决,全实例查询需通过区域覆盖校验,“目标不存在”本身也是待验证事实;已接受标注训练统一接地专家做迭代标注,用互补教师与局部裁剪观察消解不确定样本,修订向依赖任务传播。第二步,Stage 1–3 底座训练:Stage 1 冻结视觉与语言模型、仅用图文对齐投影器;Stage 2 解冻全部模块做文本+图文联合预训练(语言峰值学习率 $10^{-5}$,视觉与投影器 $10^{-6}$);Stage 3 在 32K 上下文做通用视觉/视频问答。第三步,Stage 4 坐标对齐(SFT):在检测、GUI、指代框、指代点、OCR、文档版面、密集点数与视觉提示 8 组任务上最小化 $\mathcal{L}_{\mathrm{SFT}} = -|S|^{-1}\sum_{t\in S}\log p_\theta(y_t \mid I, P, y_{–<999> 词表($x\in[-60,60]$、$y\in[-20,20]$ 米),用 response-only 交叉熵适配;机器人上把骨干 8 个深度的隐层投影、加深度嵌入并经共享重采样器压成每层 64 个 1024 维条件 token,注入固定 Action DiT 的 8 个交叉注意力块做流匹配去噪,每基准 4 万步。
技术新颖性
区别体现在三个层面。输出表示上,Rex-Omni、SEED1.5-VL 等用文本 token 串表示坐标,LocateAnything 探索并行框解码,GroundingPI 用原子量化坐标 token 序列化——COCO 每框仅 7.6 token、Dense200 上 5.1 token,比 SEED1.5-VL 的 148.8/74.5 少约 19.6×/14.6×。训练范式上,π0.5 等在 VLA 训练内部加框预测辅助目标,依赖稀缺动作数据顺便学感知;本文把接地预训练与动作适配彻底解耦,先修好“看”再学“动”,并证明该感知可跨双臂桌面、人形灵巧手两种本体与驾驶任务复用。评测方法上,作者构建 44 基线 × 34 基准 × 11 能力的系统对照,设计“固定 Action DiT、动作数据、优化预算、推理流程,只换预训练骨干”的受控迁移协议,把感知基础的价值从动作头工程差异中剥离,自评结果为 5 seed × 2 run 共 10 次平均——这种严格性在同类工作中少见。此外,论文对 OCR“感知催化剂”假设给出形式化框架:把 SFT 损失分解为框、转录、协议三部分,用梯度对齐不等式 $\mathcal{L}_g(\theta_v-\eta g_t)-\mathcal{L}_g(\theta_v) \le -\eta\langle g_g, g_t\rangle + \tfrac{H\eta^2}{2}\|g_t\|_2^2$ 说明转录梯度何时能局部降低非文本接地损失。
实验结果
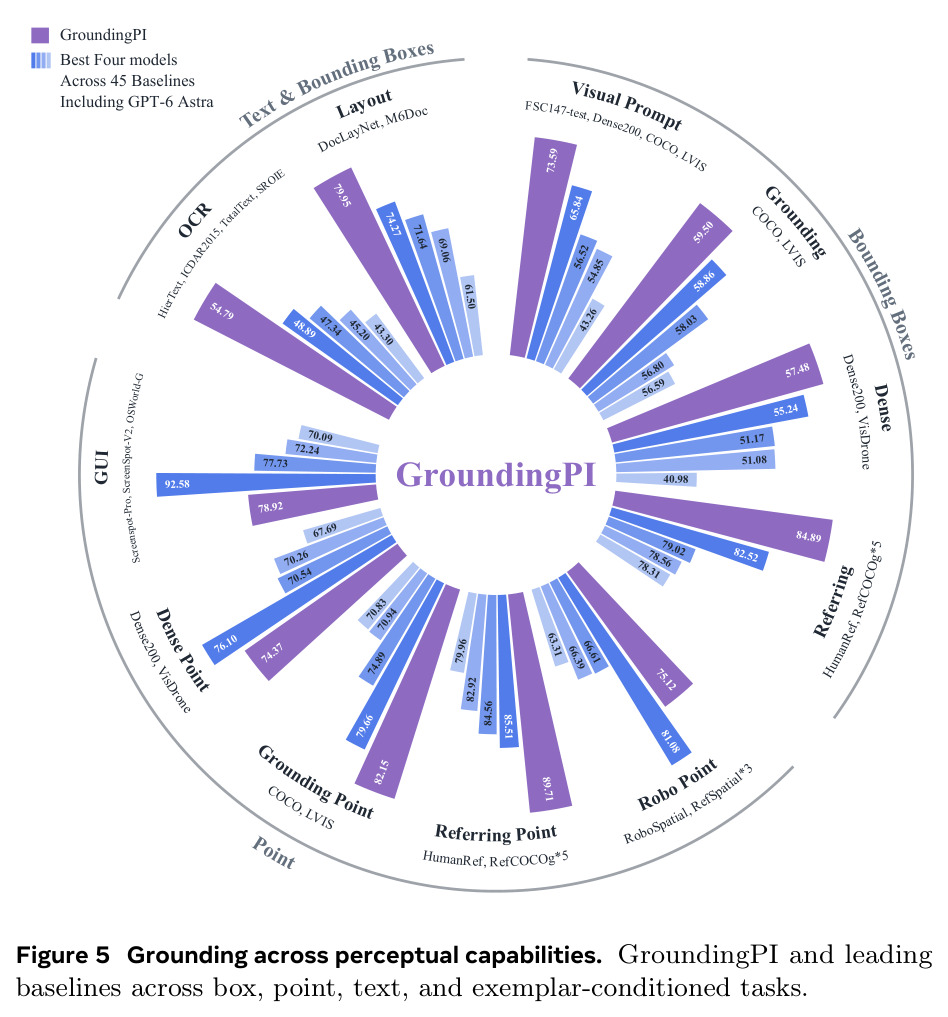
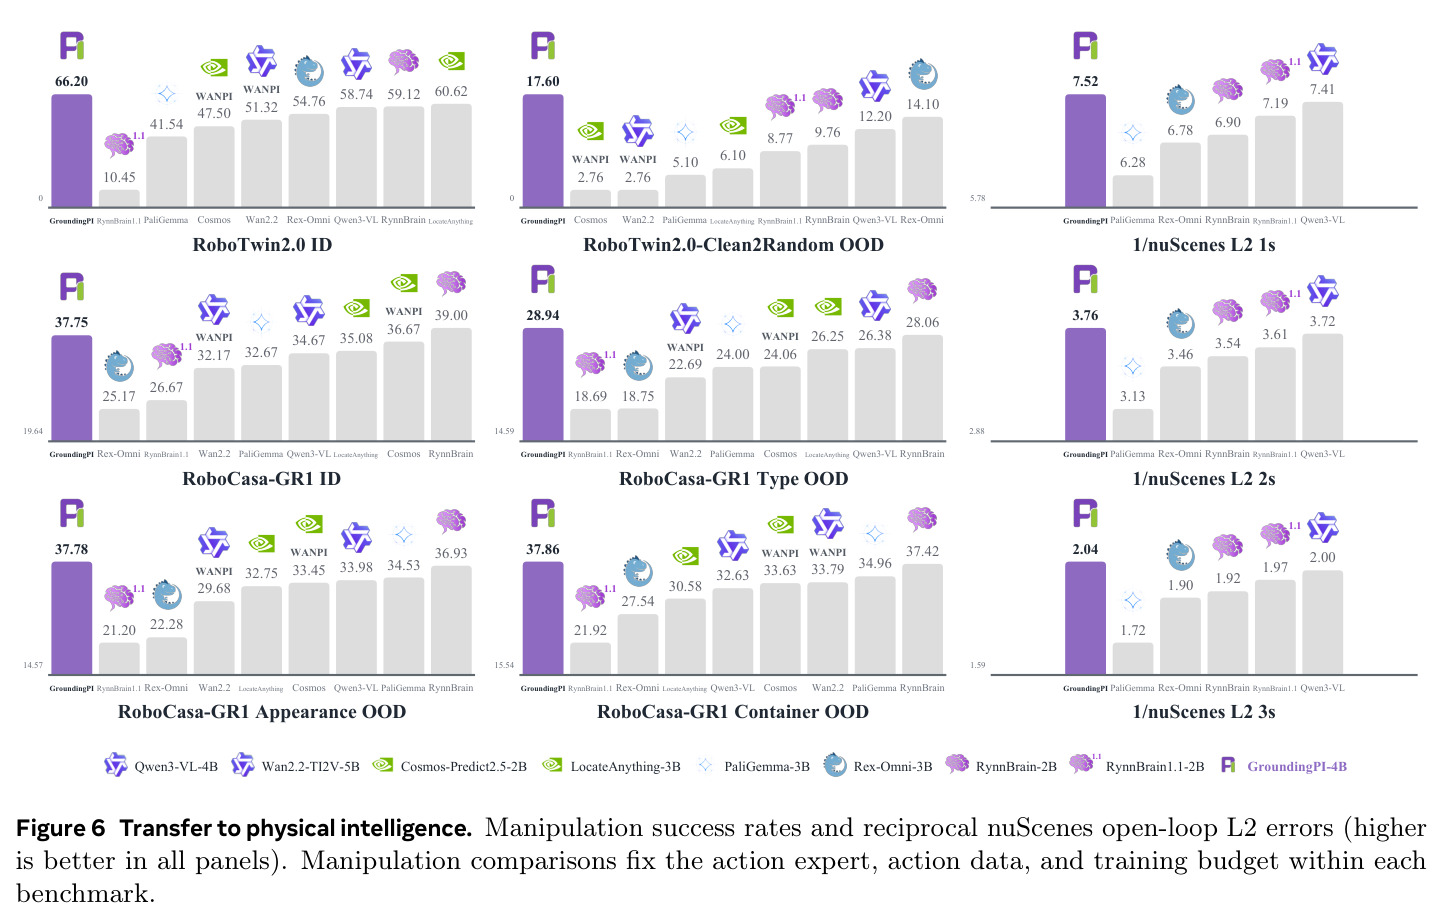
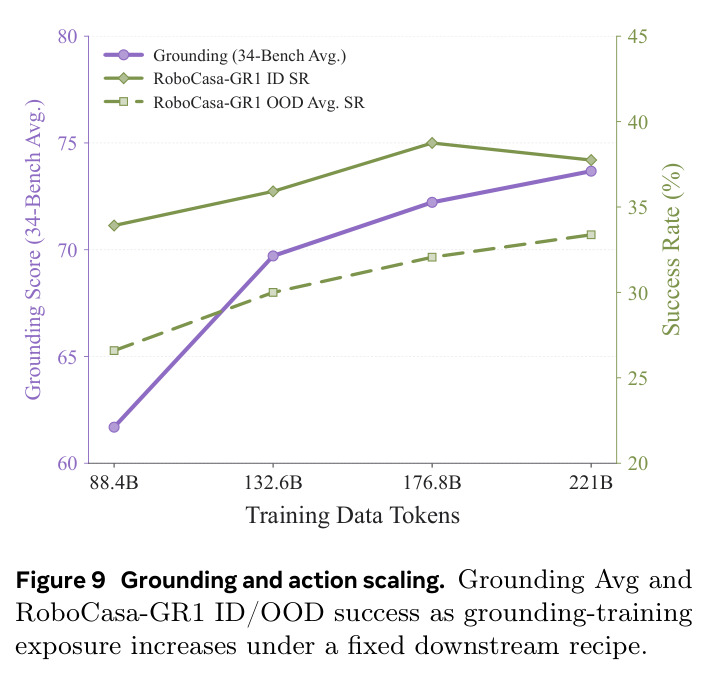
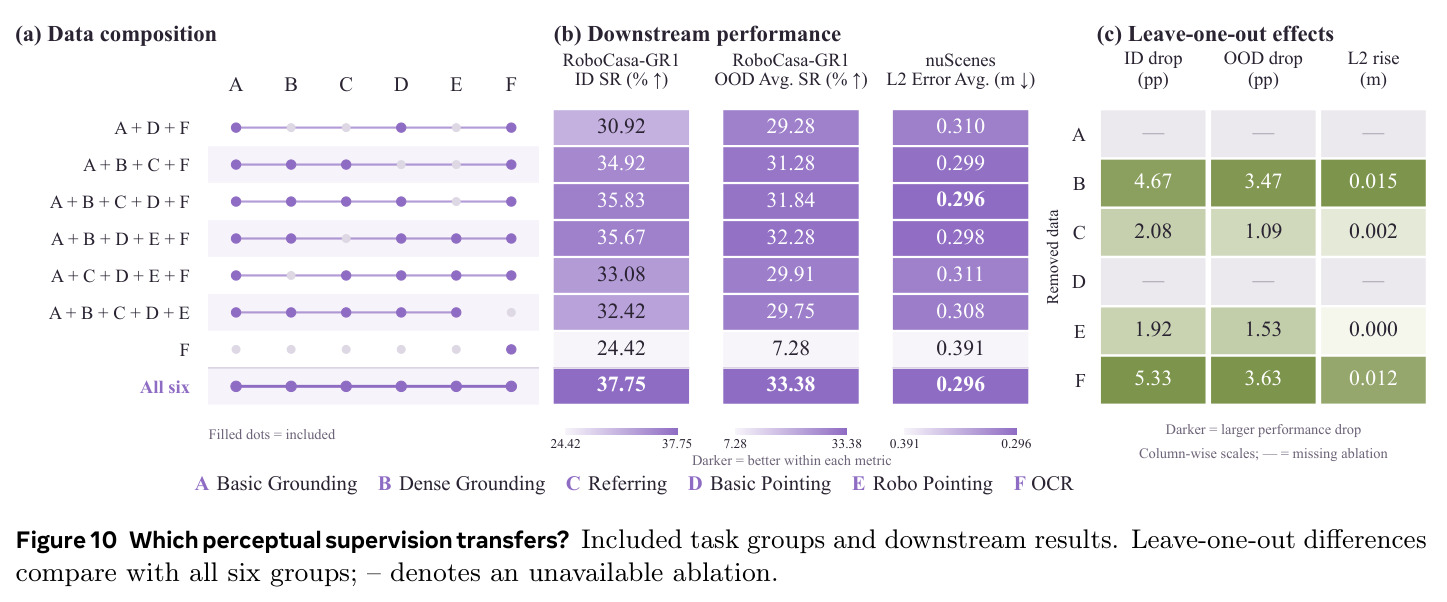
感知:GroundingPI 在 34 基准、11 类能力上平均 73.68%,超过 44 个基线与更大的 GPT-6 Astra(71.54%)。分项:Dense200 达 74.53,超 Astra 9.49pp、超次名 SenseNova-Vision 6.40pp,而 Qwen3-VL-4B 仅 14.02;COCO 62.98、LVIS 56.02 为紧凑模型第一;HumanRef 88.56、RefCOCO avg 83.92 显著领先;RoboSpatial 73.77、ScreenSpot-V2 96.15、OSWorld-G 74.82,但 ScreenSpot-Pro 65.78 远低于 Astra 93.17;OCR 的 SROIE 72.47(Astra 53.57)与 M6Doc 74.82(Astra 60.59)优势大,TotalText 49.32 低于 Astra 53.55;物体指向 7 列赢 6 列(HumanRef 88.79、RefCOCOg val 90.26),仅 Dense200 指向 81.27 不敌 Astra 86.57。迁移:固定 Action DiT 与训练预算的受控对比中 6 项评测 5 项第一、含全部 4 个 OOD——RoboTwin2.0 Full 66.20%,Clean2Random OOD 17.60%(次名 Rex-Omni 14.10%),RoboCasa-GR1 Full 37.75% 略低于 RynnBrain 39.00%,四个 OOD 相对最强基线提升最高达 24.8%;nuScenes 开环 L2 平均 0.296m,优于 Qwen3-VL-4B 0.301m 与 RynnBrain 0.308m。数据效率:RoboCasa-GR1 用 50% 演示达 28.75% SR,超过所有用 75% 演示的基线(最高 RynnBrain 27.75%)。消融:接地预训练从 88.4B 扩到 221B token,接地分 61.69→73.68(+11.99pp),OOD SR 26.59→33.38(+6.78pp);去密集接地掉 4.67/3.47pp 且 L2 恶化 0.015m,去 OCR 组在操作上掉最多(5.33/3.63pp)但 OCR 单独迁移最差,全六组混合最优。
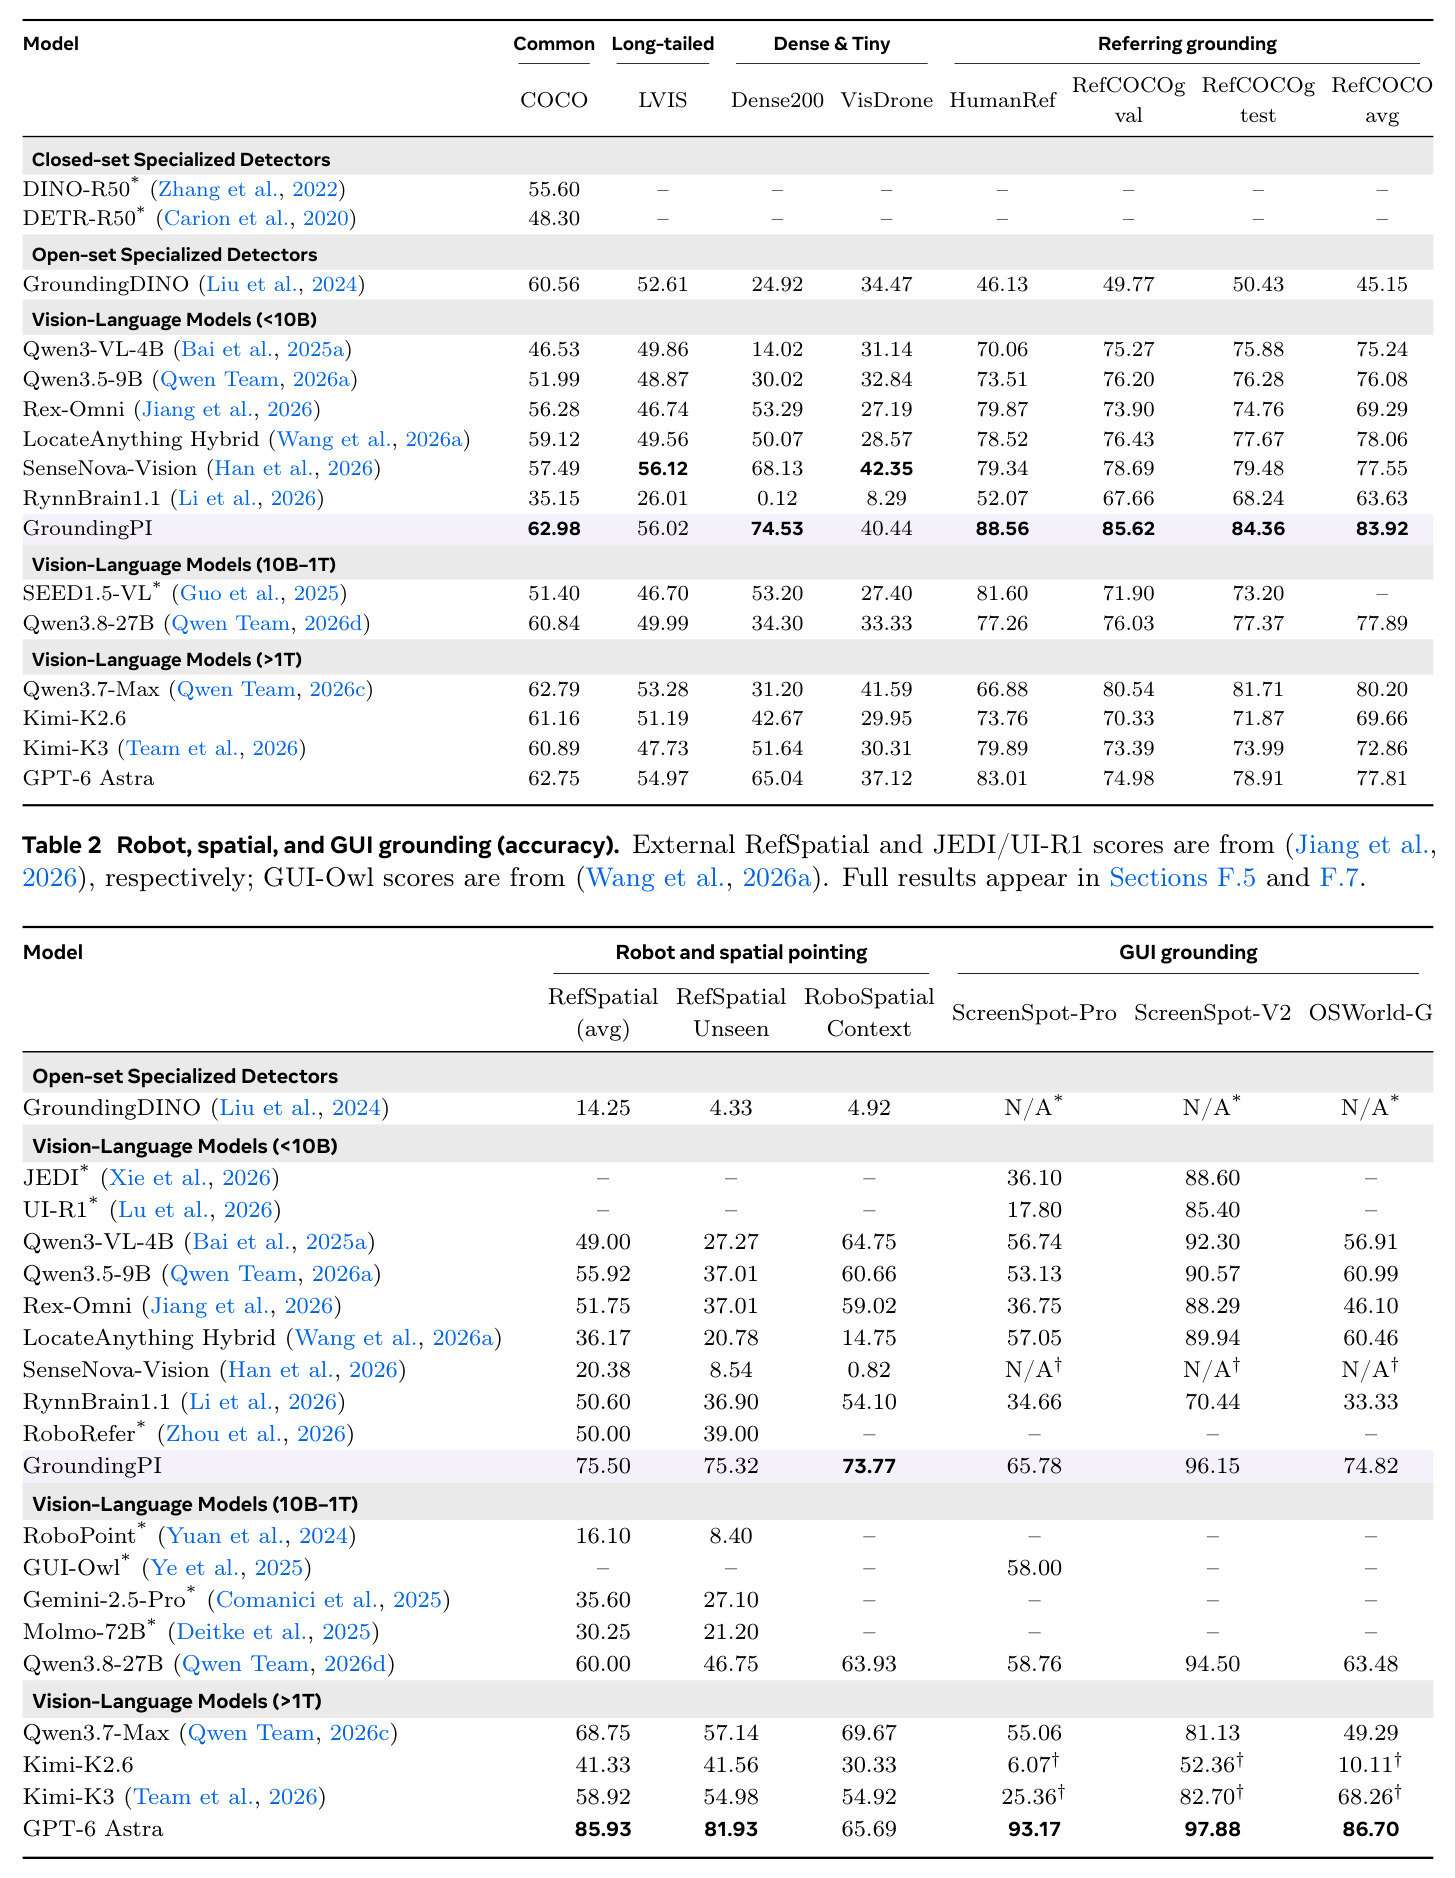
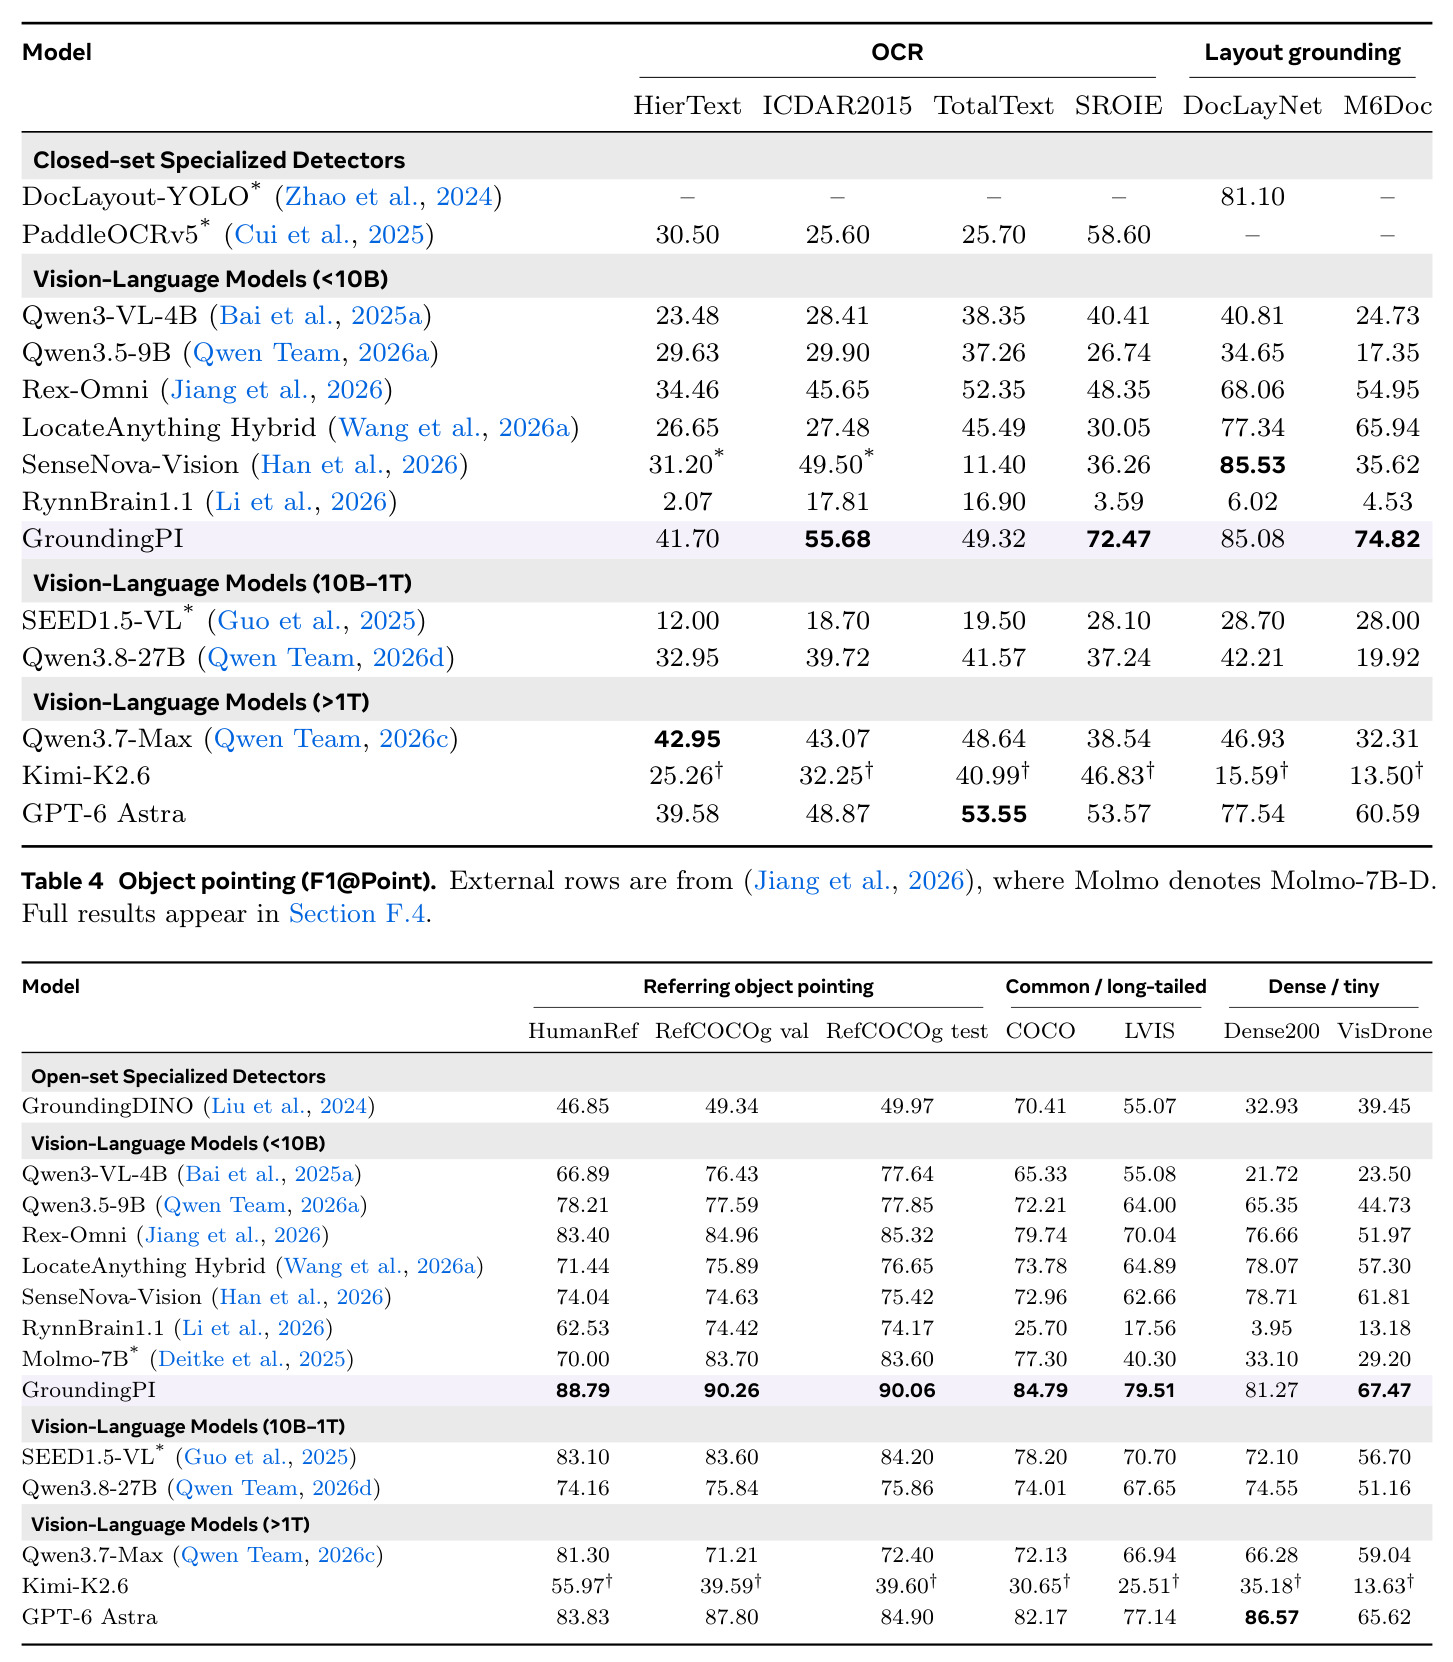
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 综合接地(34 基准/11 能力) | 平均分 (%) | 73.68 | GPT-6 Astra(>1T 前沿模型)71.54 | +2.14pp,且参数量小约三个数量级 |
| 密集小目标检测 Dense200 | F1mIoU | 74.53 | GPT-6 Astra 65.04;SenseNova-Vision 68.13;Qwen3-VL-4B 14.02 | 超最强基线 +6.40pp |
| 指代接地 RefCOCO 家族 | F1mIoU (avg) | 83.92 | LocateAnything Hybrid 78.06;Qwen3.5-9B 76.08 | +5.86pp |
| 机器人/空间指向 RefSpatial | 准确率 (avg) | 75.50 | GPT-6 Astra 85.93;Qwen3-VL-4B 49.00 | 紧凑模型中第一,仍落后 Astra 10.43pp |
| OCR 单据识别 SROIE | F1mIoU | 72.47 | GPT-6 Astra 53.57;Rex-Omni 48.35 | +18.90pp |
| 指人物体指向 HumanRef | F1@Point | 88.79 | GPT-6 Astra 83.83;Rex-Omni 83.40 | +4.96pp |
| 机器人操作 RoboTwin2.0 Full | 成功率 (%) | 66.20 | 全部对比骨干(同 Action DiT、同数据、同预算) | 6 项操作/驾驶评测中 5 项第一 |
| 机器人操作 4 项 OOD(RoboTwin Clean2Random、RoboCasa Type/Appearance/Container) | 成功率 (%) | 全部第一;如 RoboTwin Clean2Random 17.60 vs Rex-Omni 14.10 | Qwen3-VL-4B、Wan2.2、Cosmos、PaliGemma、LocateAnything、Rex-Omni、RynnBrain 等 | 相对最强基线最高 +24.8% |
| 自动驾驶 nuScenes 开环轨迹预测 | L2 Avg (m) | 0.296 | Qwen3-VL-4B 0.301;RynnBrain 0.308 | 降低 0.005–0.012m |
| RoboCasa-GR1 动作数据效率 | 成功率 (%) | 50% 演示达 28.75 | 75% 演示下最佳基线 RynnBrain 27.75 | 少用 25% 演示仍反超 |
局限与改进
作者承认的局限(Sec. E):优势并非全面碾压——微小框定位、高 IoU 边界精度(COCO 上 IoU 0.95 的 F1 仅 22.84)、TotalText OCR(49.32 < Astra 53.55)、FSC147 视觉提示与前沿级 GUI 接地(ScreenSpot-Pro 65.78 vs 93.17)仍有明显差距;部分基线因 prompt/解析器不兼容未评测;驾驶仅开环评测,未验证闭环控制与延迟;数据效率实验只在操作任务上做;OCR 因果机制与 Gated DeltaNet/DeepStack 等架构解释均为假设。我的补充观察:(1) “紧凑”只体现在参数量——监督阶段约 721.6B token、RL 用 256 GPU,论文未报告总算力对比;(2) 接地分与 ID 成功率并非单调(最大预训练步 ID SR 反降 1.00pp),4 个尺度点不足以支撑 scaling law 式结论;(3) 与 Astra 是 API 零样本对比(thinking effort=High)与本地全量微调模型的协议差异需谨慎解读;(4) 自建数据引擎与 Dense200 等评测间的潜在相关性(污染风险)未讨论;(5) 物理提示只是接口设想,无实验验证。
独立分析的弱点
弱点一:感知-动作迁移机制不透明。消融只有任务组级 leave-one-out(A 与 D 总是绑定出现,无法分离各自贡献),不能进一步分离物体尺寸、拥挤度、标注覆盖度的作用;OCR“催化剂”假设虽有梯度对齐不等式支撑,设计好的 box-only 对照实验却未实际运行。改进方向:做固定条件下的转录损失消融,并测量八深度条件 token 的动作梯度范数以检验特征可及性。弱点二:输出效率优势缺闭环证据。每框 5.1 token 是序列化长度而非实测时延,Figure 12 显示生成时间随框数持续增长(Dense200 平均 87.2 框/图),自回归解码难以支撑“快到足够闭环控制”的初衷;改进方向是报告端到端观测-动作延迟或引入并行框解码头。弱点三:ID 与 OOD 权衡未解释——RoboCasa Full 输给 RynnBrain(37.75 vs 39.00)而四个 OOD 全面领先,暗示感知基础可能牺牲部分域内拟合,论文未分析容量分配或过拟合机制。弱点四:VisDrone(40.44,低于 SenseNova 42.35)与 ScreenSpot-Pro(65.78 vs 93.17)暴露极端小目标与高分辨率 GUI 短板,1024 视觉 token 预算对超高清输入可能不足,可引入动态分辨率调度。弱点五:评测依赖自建解析器,部分基线分数引自外部论文且本地仅 3 次平均(自评 10 次),跨协议可比性有噪声。
未来方向
作者提出的方向(Sec. E 与 D.4):其一,物理提示——用点/框作为语言之外的交互指定接口,让动作模型直接接收“目标、位置、结构”基元,与语言指令并行;其二,双系统分工——Astra 级前沿模型负责 System 2 规划,感知原生基础模型负责 System 1 快速执行,并建议用“固定 planner 换感知底座”与“固定执行层换 planner”两组干预实验验证分工收益;其三,相对深度监督(如 [0,1] 场景归一化深度)替代绝对米制深度,作为培养空间智能的补充目标,因为绝对尺度在图像中本就不可判定;其四,OCR 催化剂假设的因果验证(box-only 对照、AdamW 实际更新的一阶诊断 $\langle g_g, \Delta\theta_v\rangle$);其五,共享 vs 深度专属投影器的匹配容量对比,以检验多级视觉注入与动作读出的兼容性假说。基于本文成果可自然延伸:(1) 把接地预训练扩展到 3D 基元(表面点、6D 位姿、affordance 区域)以直接服务抓取规划;(2) 在真机闭环与时延敏感场景验证数据效率和泛化优势能否兑现;(3) 建立“接地分→动作成功率”的定量预测关系,把感知质量变成动作学习的先行指标;(4) 用数据引擎思路自举具身难例(遮挡、透明体、反射面)的密集标注,进一步放大密集接地的优势。
复现评估
复现条件较好但完整成本很高。开源方面:论文承诺公开代码(github.com/groundingpi/GroundingPI)、模型权重(HuggingFace GroundingPI/GroundingPI)与评测数据;附录 A.1–A.6 给出输入/输出协议、词表 ID(坐标 token ID 151669–152668)、架构与参数明细(总计 4,843,664,384)、四阶段训练配置表与 RL 配置表,坐标量化公式 $q(v)=\lfloor(999v+500)/1000\rfloor$、奖励公式、匈牙利匹配细节均完整;附录 F 列出全部基准的逐项分数。算力方面:监督阶段每阶段 128 GPU(共 4 阶段、约 721.6B token),RL 阶段 256 GPU,下游每个骨干 40 加速器 × 4 万步——学术实验室端到端复现训练不现实,但若权重开源,复现下游迁移实验只需单节点规模。难度评估:基于官方权重做微调与评测是中等难度(标准 SFT/GRPO 栈、公开基准、指标定义清晰);最大缺口是数据引擎不可复现——多教师融合与专家迭代依赖未公开的教师模型组合与标注流程,从零重建 221B token 的空间预训练数据几乎不可行;另外部分基线分数引自外部论文,严格复现整张对比表需要本地重跑。总体判断:用官方权重验证下游结论容易,完整复现属工业级工程。
论文图表
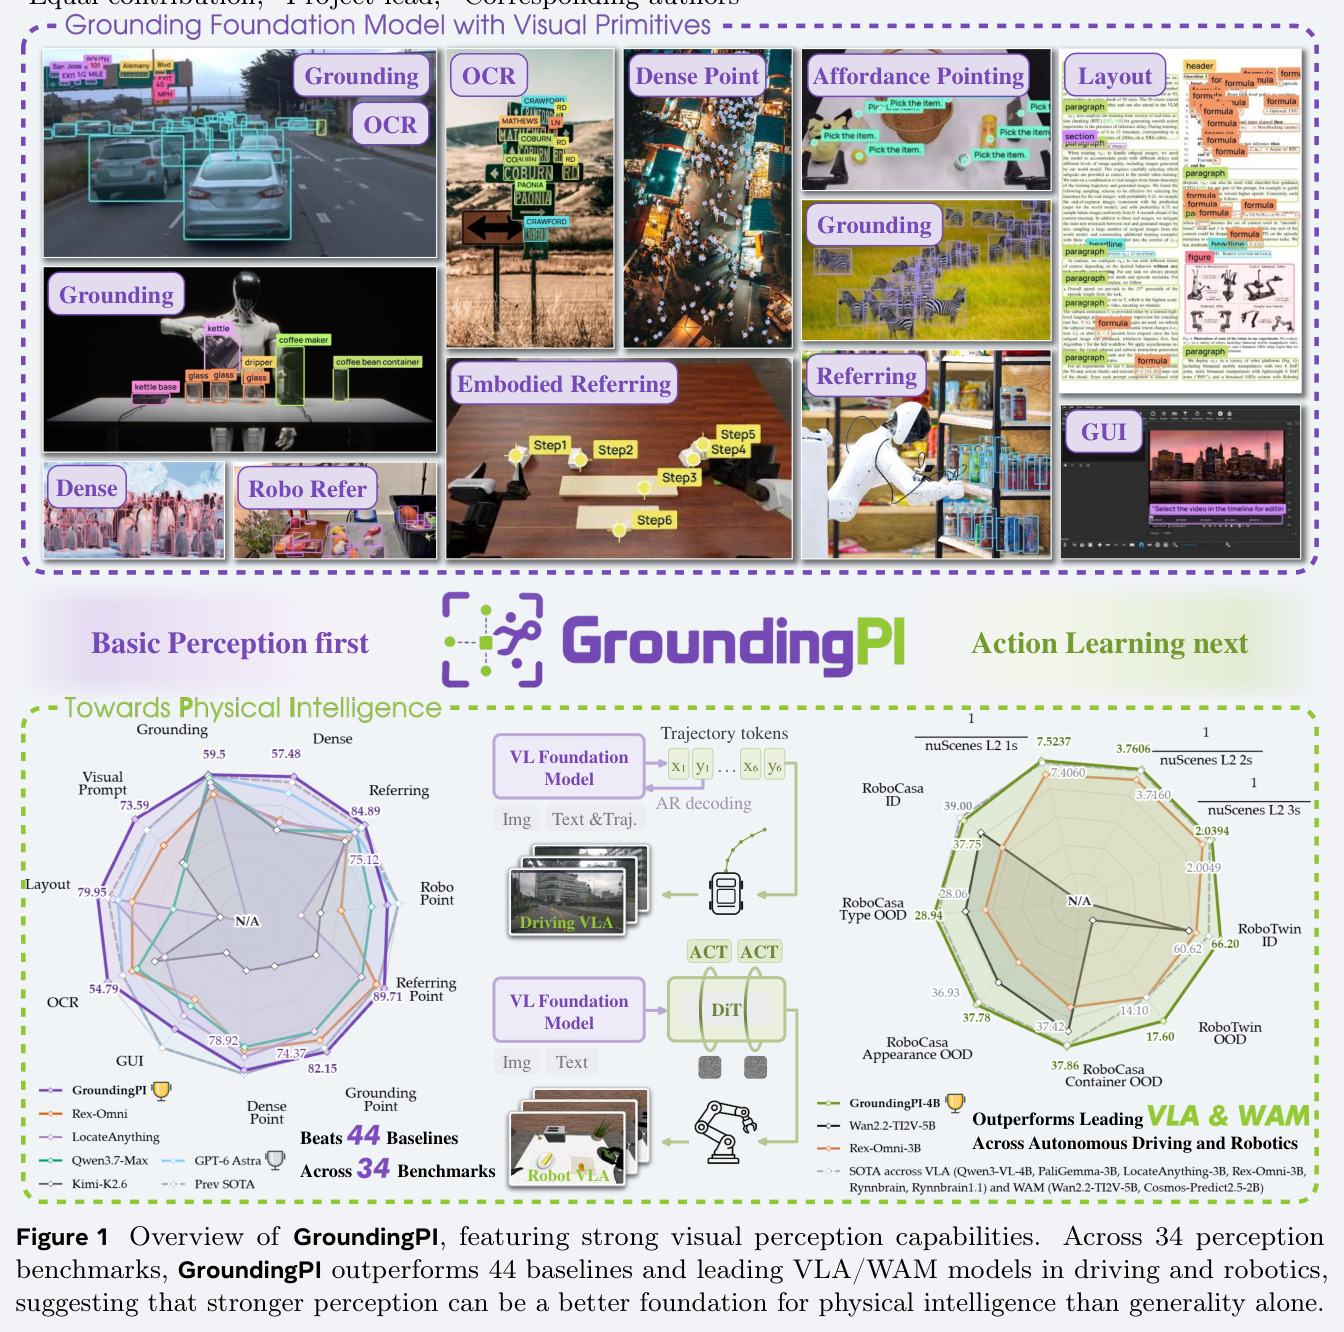
开篇全景图:上半部分展示接地、OCR、密集点、affordance 指向到版面的能力矩阵,标注在 34 个感知基准上超越 44 个基线;下半部分展示“基础感知在前、动作学习在后”的两段式路线图——VL 基础模型经 AR 解码生成轨迹 token($x_1y_1\dots x_6y_6$)服务驾驶 VLA,其视觉基础再接入 Action DiT 服务机器人 VLA,横幅宣称在自动驾驶与机器人上超越领先的 VLA/WAM 模型。
一图看懂论文的问题域、能力范围与核心主张——“更强感知是比泛化 alone 更好的物理智能基座”,是全文论证结构的缩影。
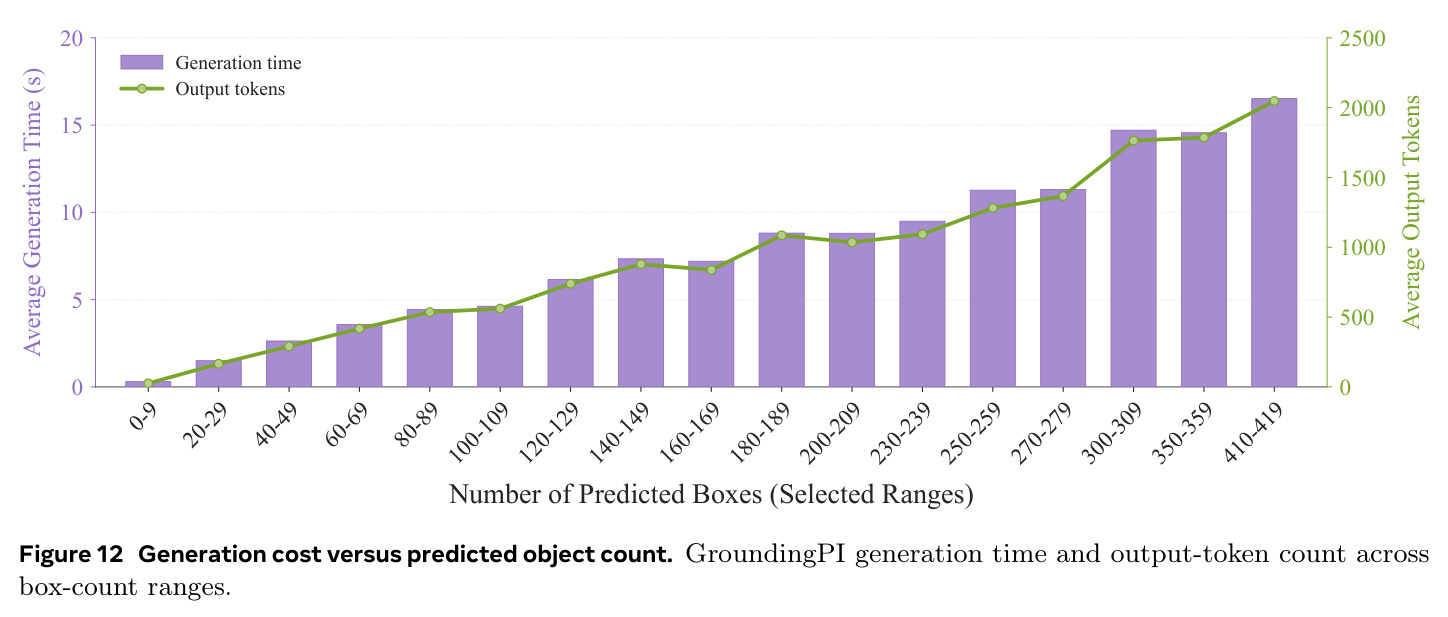
按预测框数区间(0-9 到 410-419)统计的生成时间与输出 token 数曲线:两者均随框数增长,平均协议开销在密集输出中被摊薄,但自回归生成的绝对成本仍随对象数上升,密集场景(数百框)时输出可达上千 token。
诚实地展示统一词表输出的计算代价,直接关联“能否支撑闭环控制”的部署可行性讨论,是理解局限性的重要补充。