物理递归自我改进能力从何而来:LLM 作为策略的观测性缩放律 Where is Physical RSI capability from? An Observational Scaling Law of LLM-as-policy
提出五轴指标量化物理自我改进,揭示空间推理管起步、感知管恢复的木桶假说
前置知识
Physical RSI(物理递归自我改进)
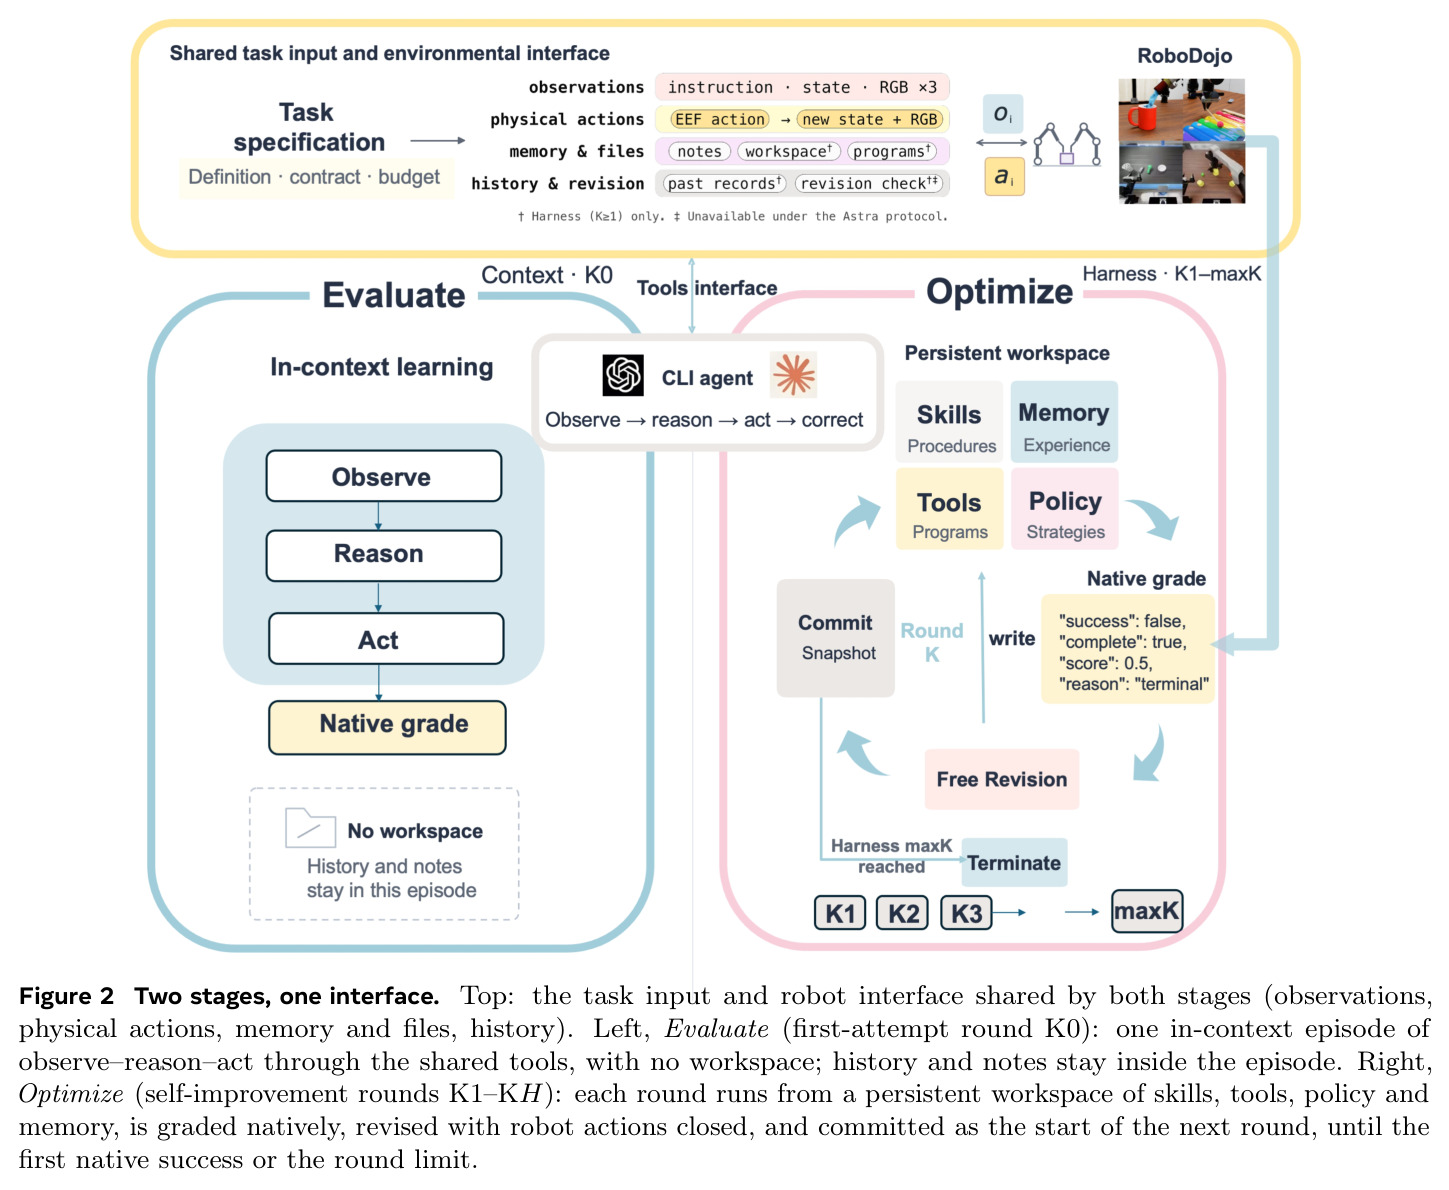
指 LLM 智能体在模型权重冻结的前提下,通过反复物理尝试改进自己:每轮在机器人上执行任务并获得原生评分与失败原因,然后在关闭机器人动作的修订窗口内更新持久 workspace(自写代码、工具、策略、记忆),提交为下一轮起点,循环直到成功或预算耗尽。每次修订必须经过一次被真实判分的物理尝试才能留下记录。
这是全文研究对象。理解『产生一个更新』与『真正从更新中受益』是两回事,才能理解为何需要五轴指标而非单一成功率。
LLM-as-policy(LLM 直接作为机器人策略)
让大语言模型不经专门训练直接输出机器人动作:模型接收观察(图像、状态 JSON),推理生成目标位姿或调用控制代码,每次调用返回执行结果与新观察,形成观察—推理—动作循环。VLM 的感知与空间推理能力直接决定它能否把观察映射为可行动作。
本文评估的 6 个系统全部以这种方式驱动 RoboDojo 双臂机器人,任务分数来自原生判分而非人工判断,这是所有结论的前提。
观测性缩放律(Observational Scaling Law)
沿用 Ruan et al. 2024 的思路:不训练一批模型来控制计算量,而是把已有系统的公开基准分数当作能力自变量,观测其与目标任务表现在跨模型维度上的关联,再用这些关系预测未见面系统的相对表现。结论是关联性、候选性的,不是因果的。
本文把这一范式从语言基准迁移到物理交互:预测变量是公共基准归一化秩,响应变量变成物理改进的幅度与时机。
木桶效应与 Physical Barrel Hypothesis
木桶盛水量由最短的板决定。物理版假说认为不同改进维度可能被不同能力卡住:空间推理决定起步好坏(A1/效率/预算),感知决定解读失败与恢复(A3/改进),编码能力强并不总能代偿其他短板。不同 RSI 轴对应不同的桶板组合,是可以定向干预检验的候选瓶颈。
这是论文对 Q1 的答案与全文核心假说,五轴设计、关联分析与干预检验都围绕它展开。
Weibull 增长曲线模板
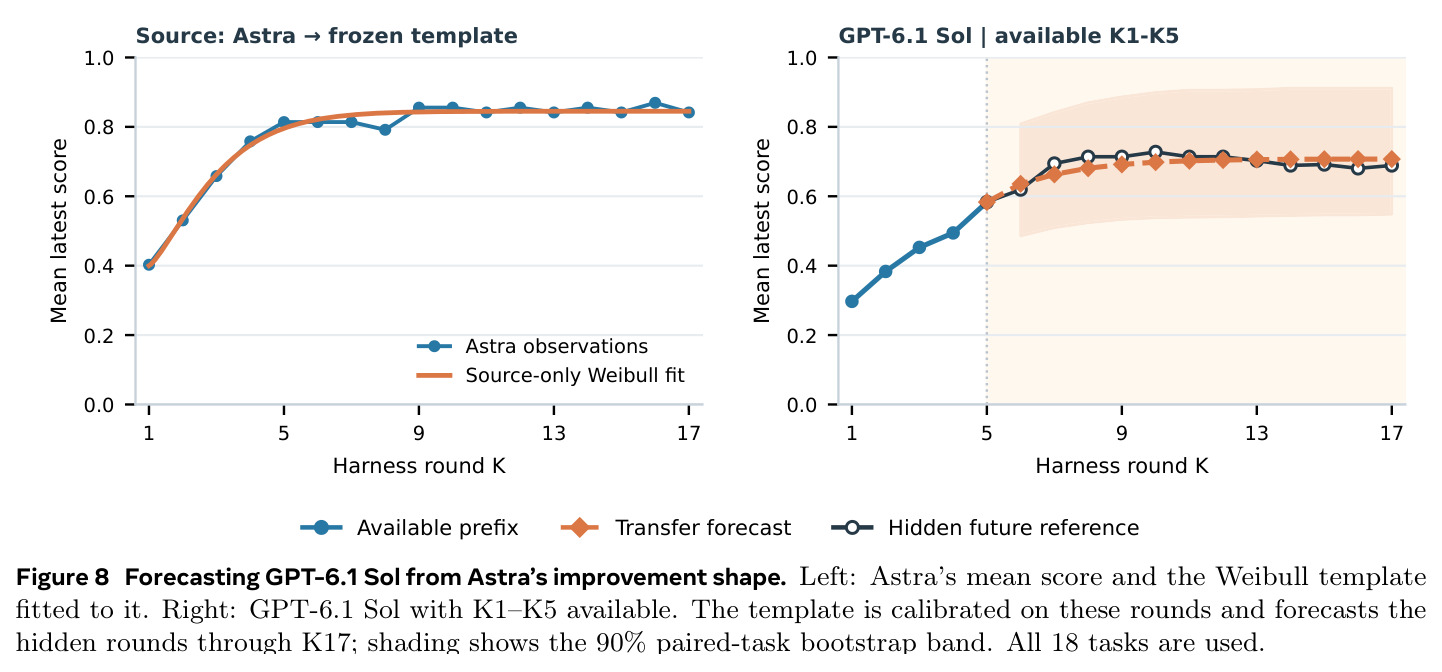
形如 $g_A(t)=1-\exp[-(t/\tau_A)^{p_A}]$ 的饱和增长函数,$\tau$ 控制时间尺度、$p$ 控制形状。论文先拟合到参考系统 Astra 的均分曲线并固定形状,再对目标系统只用前几轮校准起点 $u$、平台 $v$ 与相对速度 $\rho$,即可外推剩余轮次。
这是 Q2 中『用早期物理反馈预测后续增益』的技术核心,也是学习曲线理论进入物理 RSI 的桥梁。
研究动机
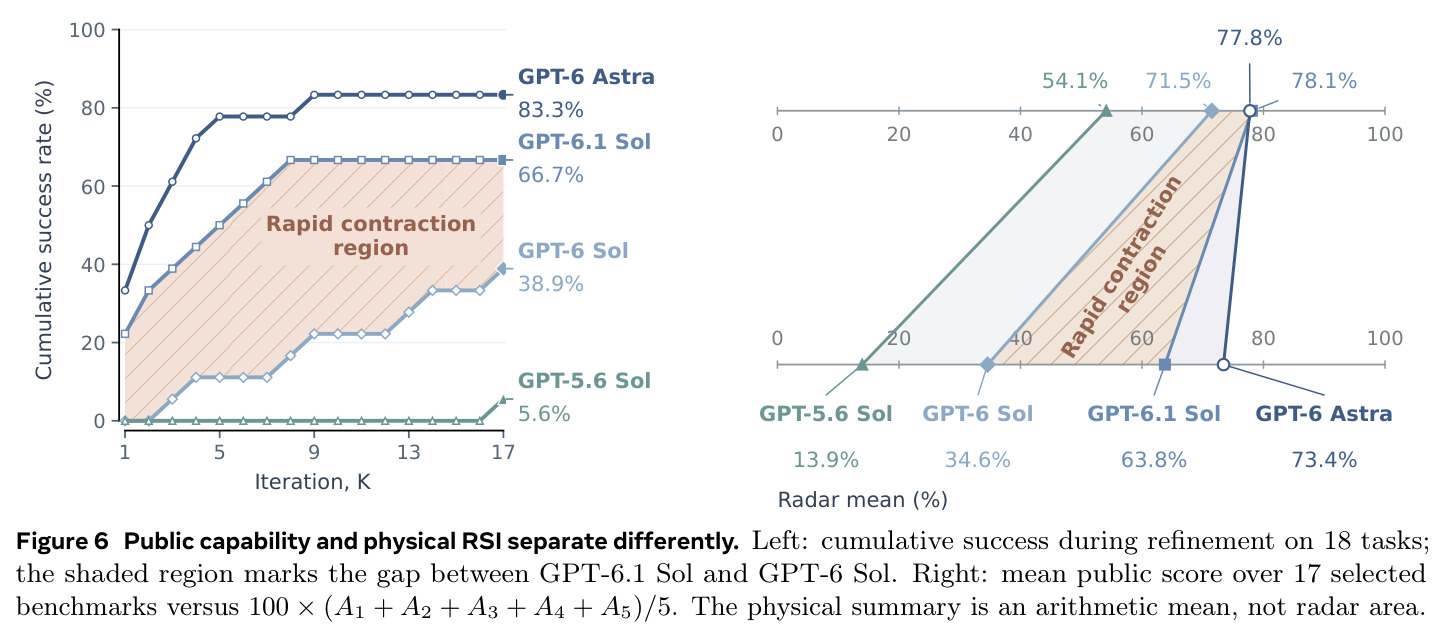
现有 LLM 具身评测几乎都只报告『端点分数』:每个任务跑若干独立 episode,统计最终成功率。当智能体借助持久 workspace 自我改进后,这种范式失效:它无法区分『第一次就好』与『反复试错后才成功』,无法回答收益何时出现(第 3 轮还是第 15 轮)、付出了多少物理代价,也无法判断分数上升是记住了训练场景还是学到了可复用方法。论文引用 Galbot 此前对 GPT-6 Astra 的研究:一个自写修复方案成功过一次,重复执行却失败,说明『找到解』与『稳定保持』是两回事。同时,社区对支撑物理 RSI 的底层能力只有直觉:GPT-5.6 Sol 在 LiveBench 代码生成与补全上超过 GPT-6 Astra,18 个操作任务却只解出 1 个,而 Astra 解出 15 个;4 个 GPT 系统公共基准均分跨度仅 24 分(54.1–78.1),物理五轴均分跨度却达 59.5 分(13.9–73.4),公共分数与物理改进能力严重脱节。
本文的目标是本文把『物理递归自我改进』变成可量化、可预测、可检验的对象,回答三个递进问题。Q1:能力从何而来——在感知、空间推理、编码、harness 使用等公共可测能力中,哪些真正解释了把物理反馈转化为更优策略的能力?Q2:如何量化物理 RSI 及其缩放行为——超越端点分数,分别度量起点、增益时机、终态分数、物理预算节省与失败恢复五个互补维度;并检验公共能力 profile 能否预测未见面系统的相对表现,以及前几轮物理反馈能否预测更大预算下的后续增益。Q3:改进反映过拟合还是泛化——通过清除历史、冻结 workspace 上未见布局、跨任务初始化三类干预,检验经验是场景特化还是可复用。研究在统一协议下完成:6 个『模型+运行配置』系统、18 个双臂操作任务、每任务固定 17 轮物理交互预算、全程冻结模型权重。
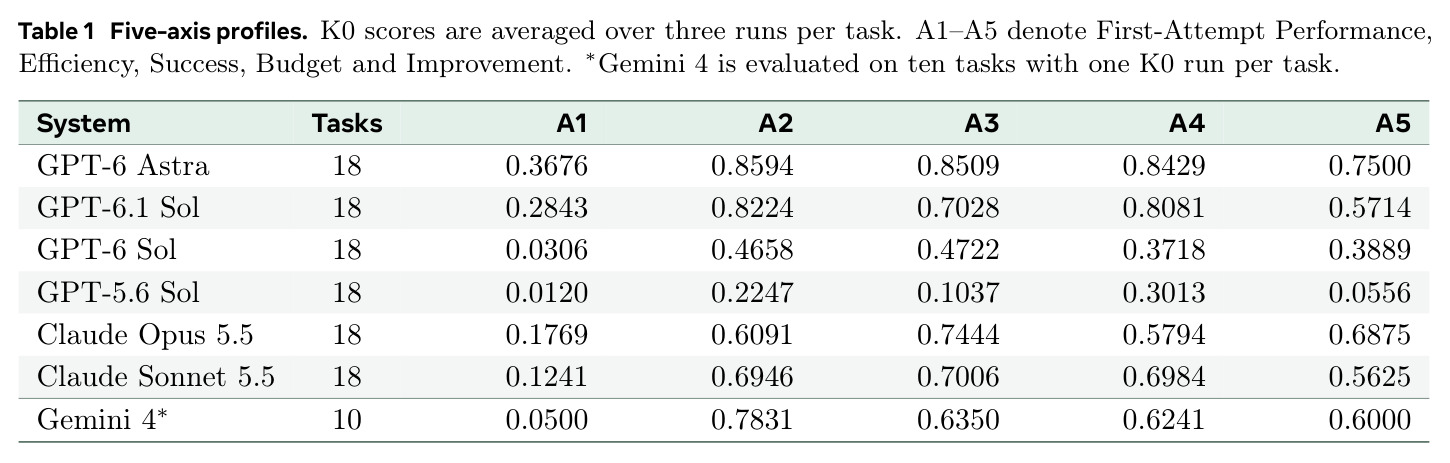
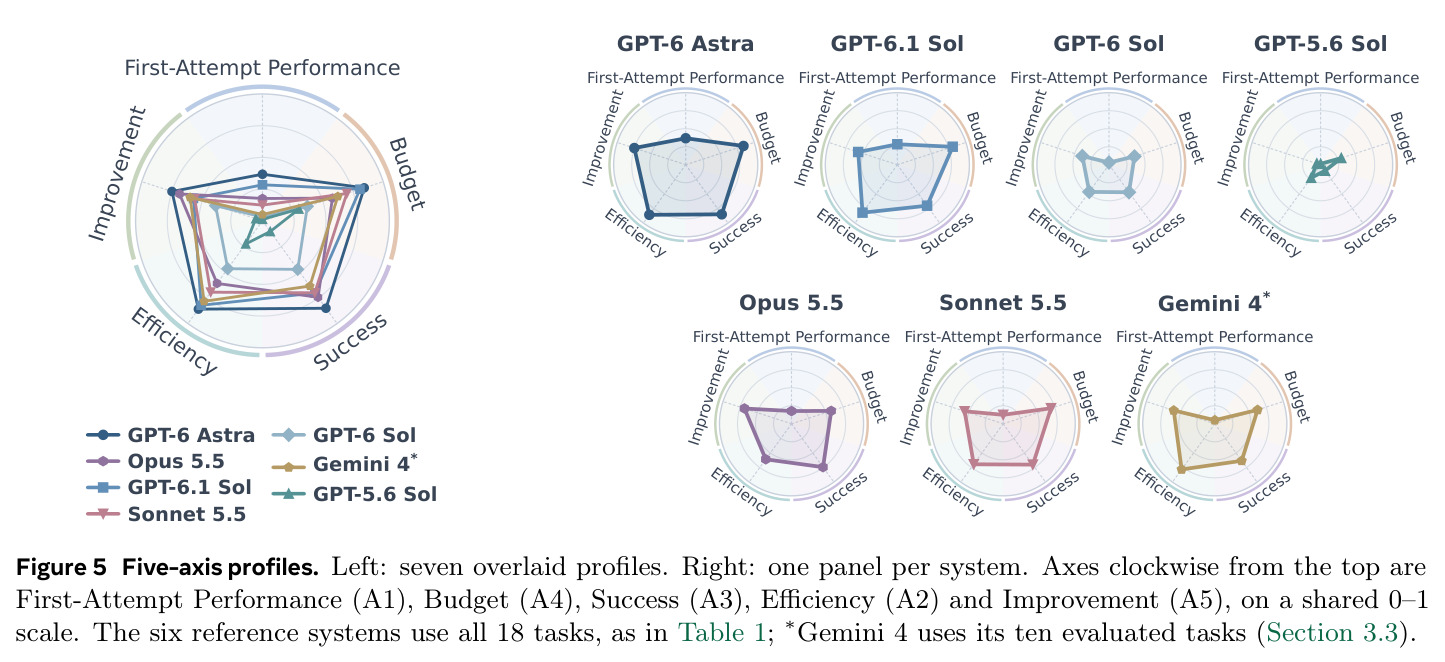
与已有工作不同的是,本文的独特切入角度有三点。第一,把『交互轮数』当作预算变量的学习曲线视角引入物理 RSI:不同于训练计算量缩放律,这里模型权重完全冻结,只有 workspace 可以变化,且每次修订必须锚定到一次被原生判分的物理尝试,使『改进』同时具备物理证据与物理成本,直接回应『反复尝试本身就能提高成功概率』的混淆。第二,五轴分离的度量设计:作者明确拒绝单一排名,用 A1–A5 暴露『高分、早收益、低成本不必同时出现』的权衡,例如 Opus 5.5 的 Success 分高于 GPT-6.1 Sol(0.744 对 0.703),但 Efficiency(0.609 对 0.822)与 Budget(0.579 对 0.808)都更低。第三,沿观测性缩放律的思路但换了因变量:不预测考试分数,而预测『改进的幅度与时机』(T50、$\bar q_{17}$),并用一个模型学到的改进曲线形状去预测另一个模型。作者诚实定位全部为观测性、探索性分析——只有 6 个封闭系统、无训练计算数据,只给可用干预检验的候选瓶颈。
核心方法
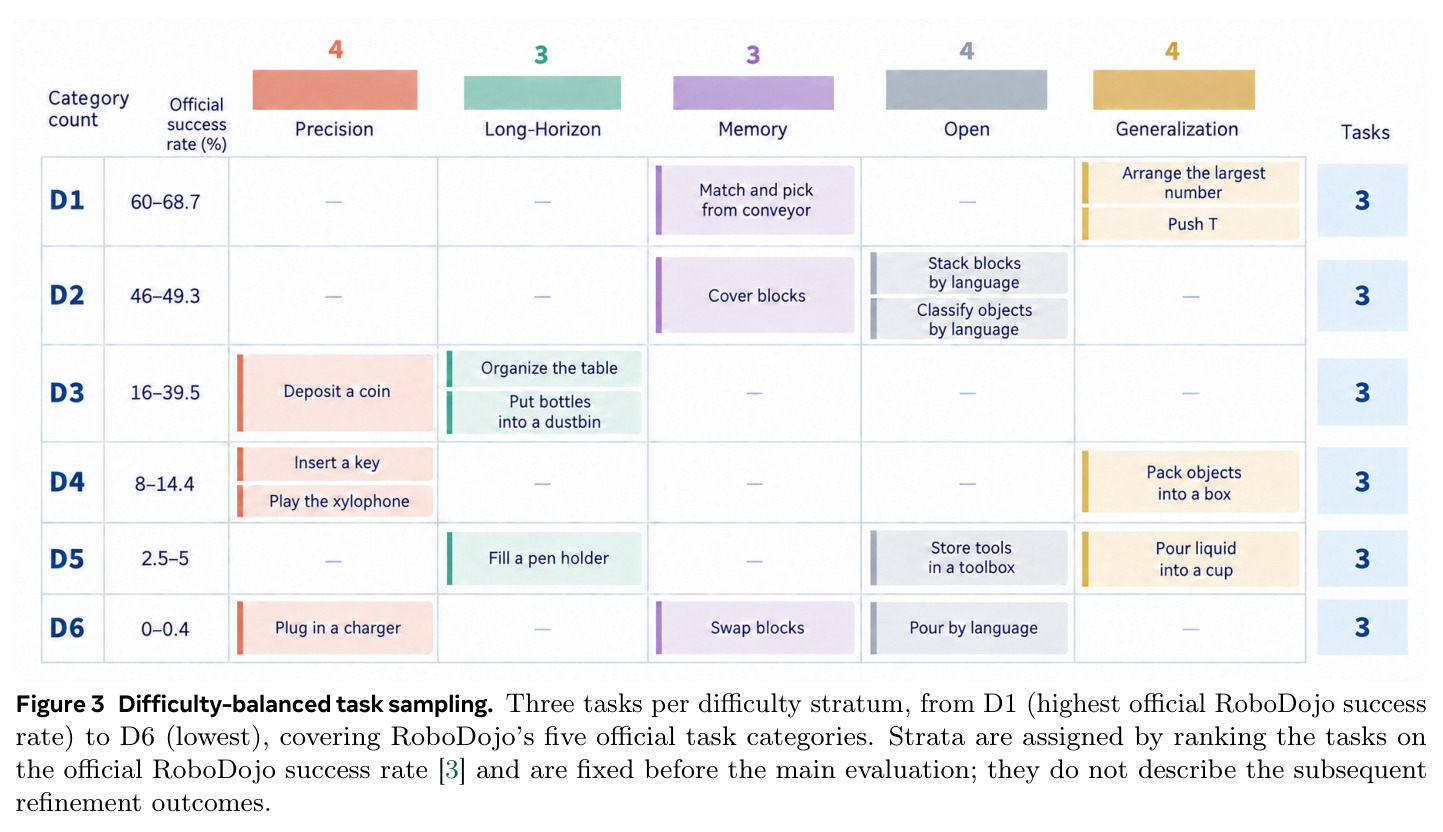
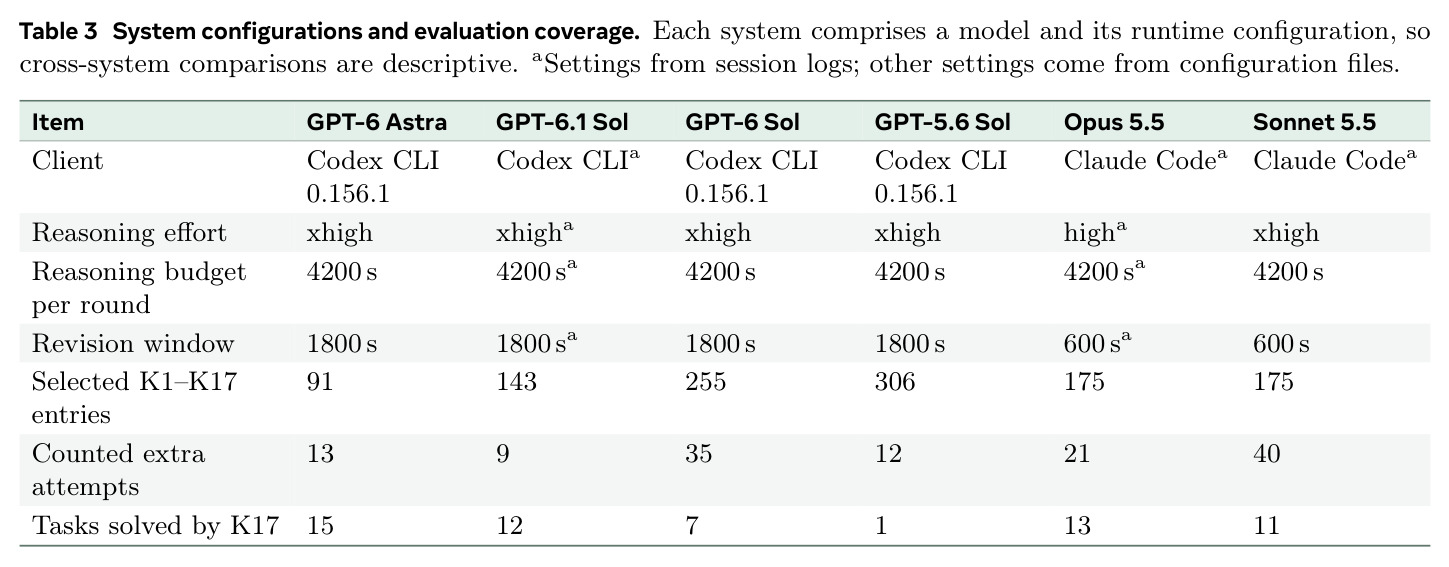
直觉上,研究一个『会写代码的机器人实习生』如何进步,不能只看期末成绩,还要看入学水平、进步快慢、最终高度、烧了多少台时、挂科后能否补考通过。PhysRSI-eval 因此设计为『两阶段、一接口』。评估阶段 K0:智能体只通过共享机器人接口做一次 in-context 的观察—推理—动作 episode,无 workspace,每任务独立跑 3 次取均值,得到起点 $q_0$。优化阶段 K1–K17($H=17$):每轮从持久 workspace(技能、工具、策略代码、记忆)出发执行一次物理尝试,返回原生分数、成功标志与失败原因;随后关闭机器人动作,在 4200 秒推理预算与 1800 秒(GPT 系)/600 秒(Claude 系)修订窗口内修订 workspace 并提交为下一轮起点,直到首次成功或轮数耗尽。18 个 RoboDojo 双臂操作任务按官方成功率切 6 个难度层、每层 3 个(D1 成功率 60–68.7% 到 D6 约 0–0.4%),保留 0–1 分级评分与 300–1300 步@25Hz 步限;成功任务停赛后保留 1 分,失败任务保留当前分,额外尝试计费但不产生新评分轮。
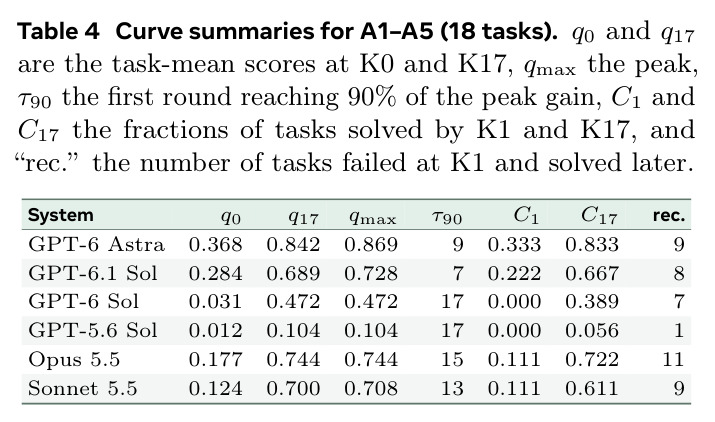
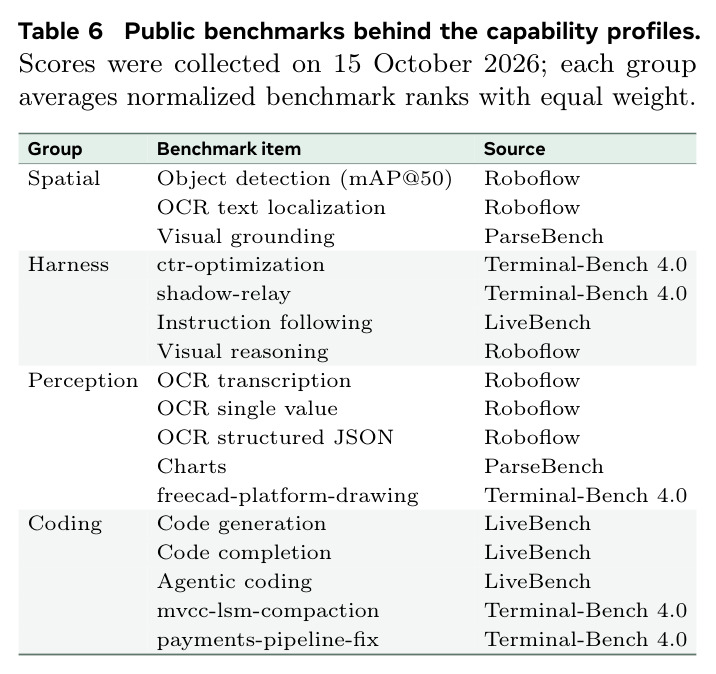
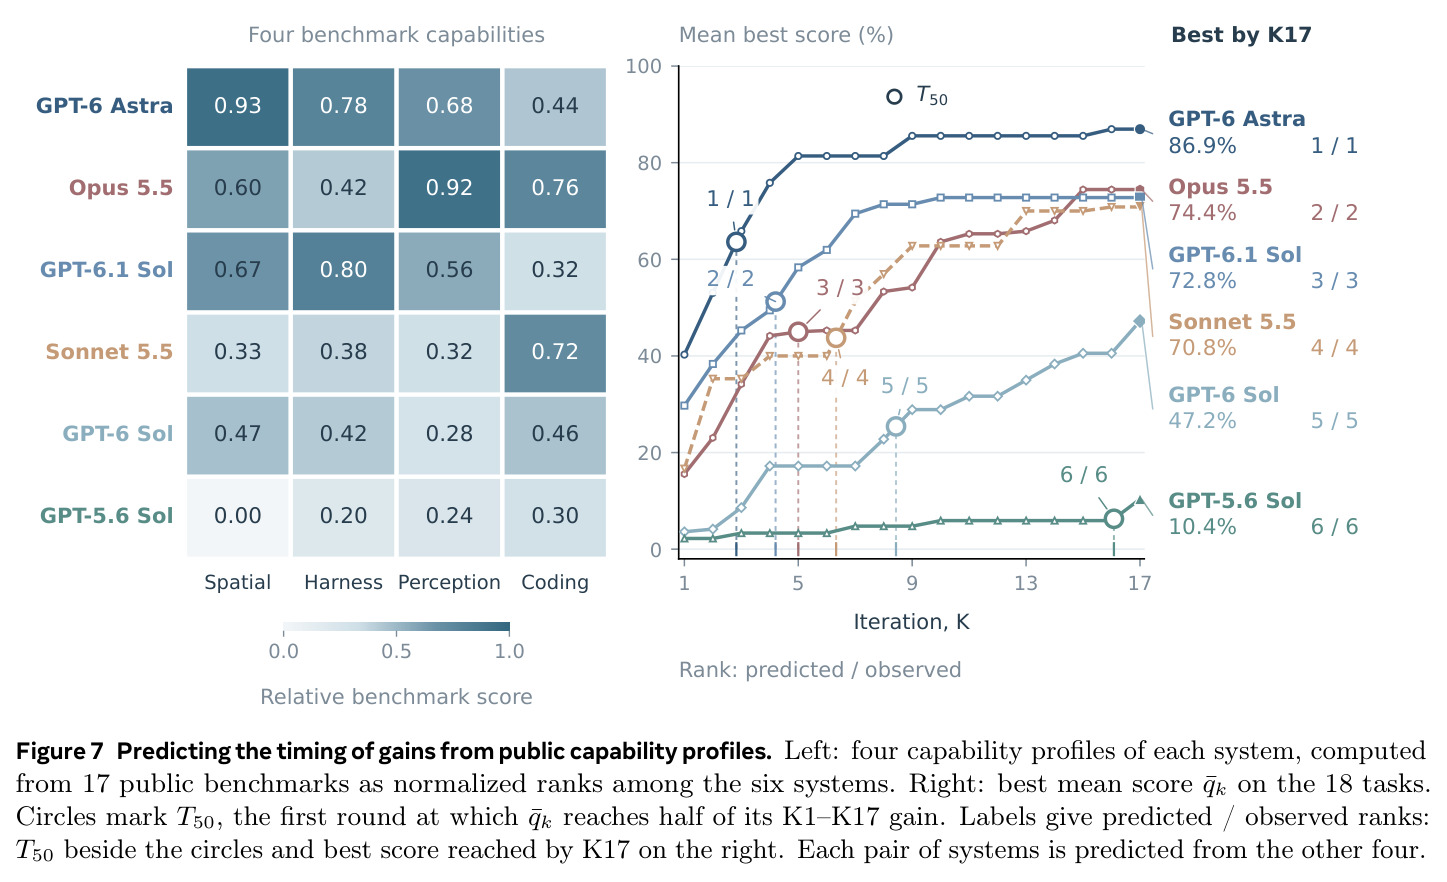
核心创新是『五轴 profile + 物理木桶假说 + 双观测性预测』,与端点式评测的本质区别在于:坚持把一次尝试、一次有效改进、一次低成本改进当作不同事件计分。五轴为:$A_1=q_0$(首次尝试均分);$A_2=\frac{\sum_{k=1}^{H-1}(q_k-q_0)}{(H-1)(q_H-q_0)}$(效率:归一化增益面积,早且持续的增长得分高);$A_3$(Success:$\tau_{90}=\min\{k: q_k\ge q_0+0.9(q_{\max}-q_0)\}$ 起的高分窗口均值,含部分分);$A_4$(Budget:已解任务上 $U_t=(W_t+Z_t)/L_t+e_t$ 的节省比例,超时轮按整步限额计费);$A_5=(C_H-C_1)/(1-C_1)$(K1 失败任务后续被解出的比例)。木桶假说把 17 个公共基准分为四组:空间推理与 A1 秩相关 0.94、与 A2/A4 达 0.83,感知与 A3/A5 达 0.94,编码全面不超过 0.37——起步靠空间推理、恢复靠感知,代码强不能代偿其他短板。
方法步骤详情
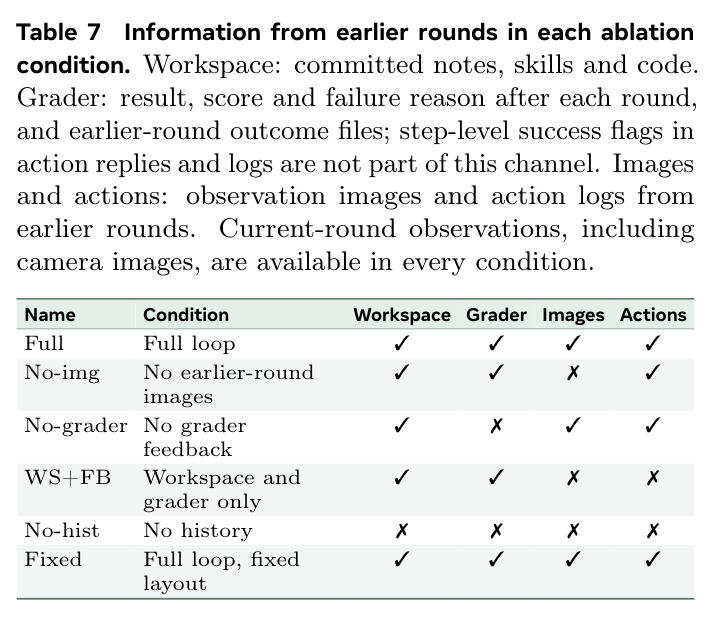
第一步,固定协议:每任务三次独立 K0 评估得 $q_0$,随后 K1–K17 Harness 轮,每轮一次物理尝试加一次关闭机器人后的 workspace 修订,物理预算为 $17\times$ 步限,超时与额外尝试计费。第二步,算五轴:对每个系统在 18 任务上平均出曲线 $q_k$ 并计算 A1–A5;Gemini 4 因只在 10 个任务上跑到 K20(均分 0.050→0.48)单独报告。第三步,能力关联:采集 17 个公共基准分并组内平均归一化秩,与 A1–A5 做 Spearman 关联(置换检验+BH 校正)。第四步,秩预测:对每对系统,用其余系统 profile 经核岭回归预测 T50,即最佳均分达到 K1–K17 增益一半的首轮。第五步,早期预测:把 Astra 均分拟合 Weibull 模板($\tau_A=2.18$,$p_A=1.30$)并固定,对 GPT-6.1 Sol 只用前 5 轮校准 $u,v,\rho$ 后外推其余 12 轮。第六步,干预:逐通道移除历史;冻结 K6 workspace 测 5 个未见布局;3 个后期任务用其余任务的 workspace 重新初始化。
技术新颖性
技术新颖性有四点。(1)评测对象从『策略』转向『改进过程』:已有具身与编码 agent 基准按 episode 或时间预算汇总结果,不追踪带持久 workspace 的分级尝试序列;PhysRSI-eval 让每次修订锚定到一次判分物理尝试,同时区分『产生更新』与『受益于更新』,并保留失败后的回退记录。(2)五轴指标族是新的:A2 用终态净增益归一化时机、A4 把推理超时折算成物理步数、A5 用条件恢复率刻画『哪些早期失败被克服』;作者还声明图 6 摘要是等权算术平均而非雷达面积。(3)木桶假说给出『同一系统在不同改进维度上瓶颈不同』的可检验表述,替代单一综合能力叙事,并明确其候选性(最小校正 q=0.11)而非因果性,配套定向干预方案。(4)把观测性缩放律从语言基准迁移到物理交互:预测变量是公共基准秩组,响应变量是改进幅度与时机(T50、$\bar q_{17}$),并用可迁移的 Weibull 形状模板做轨迹级预测——用别的模型的曲线形状加少量早期点预测新模型,这在物理 RSI 研究中是首次。
实验结果
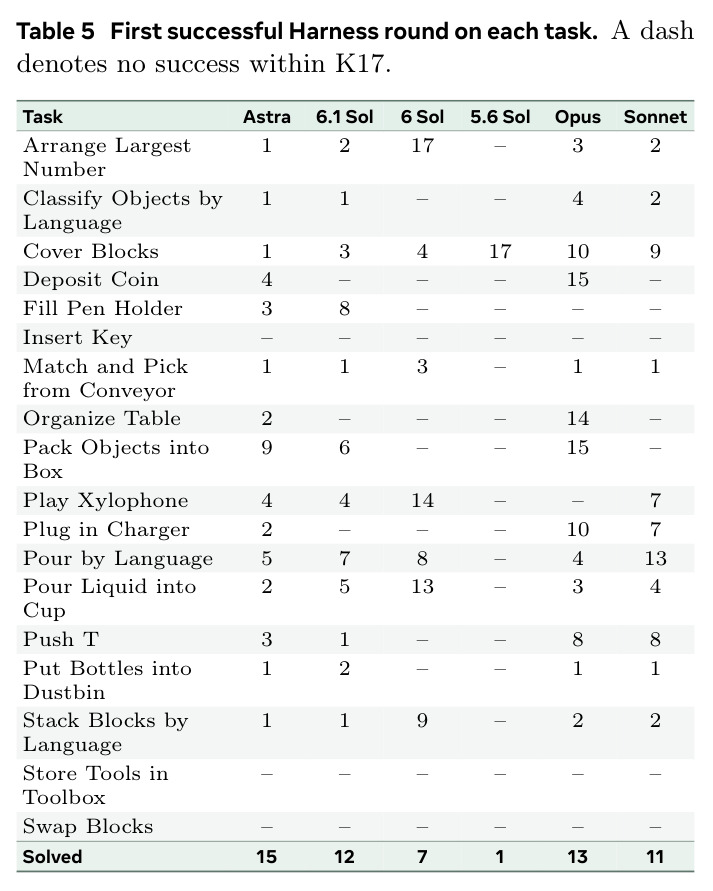
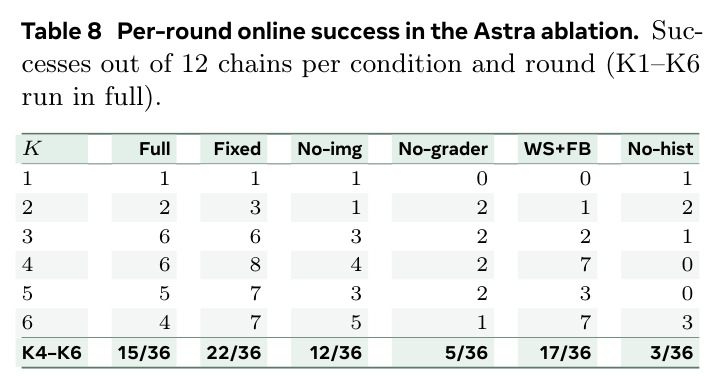
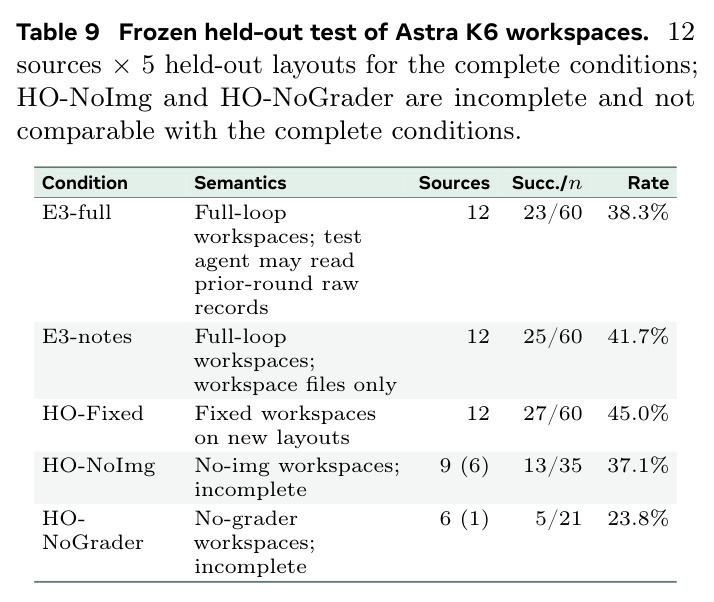
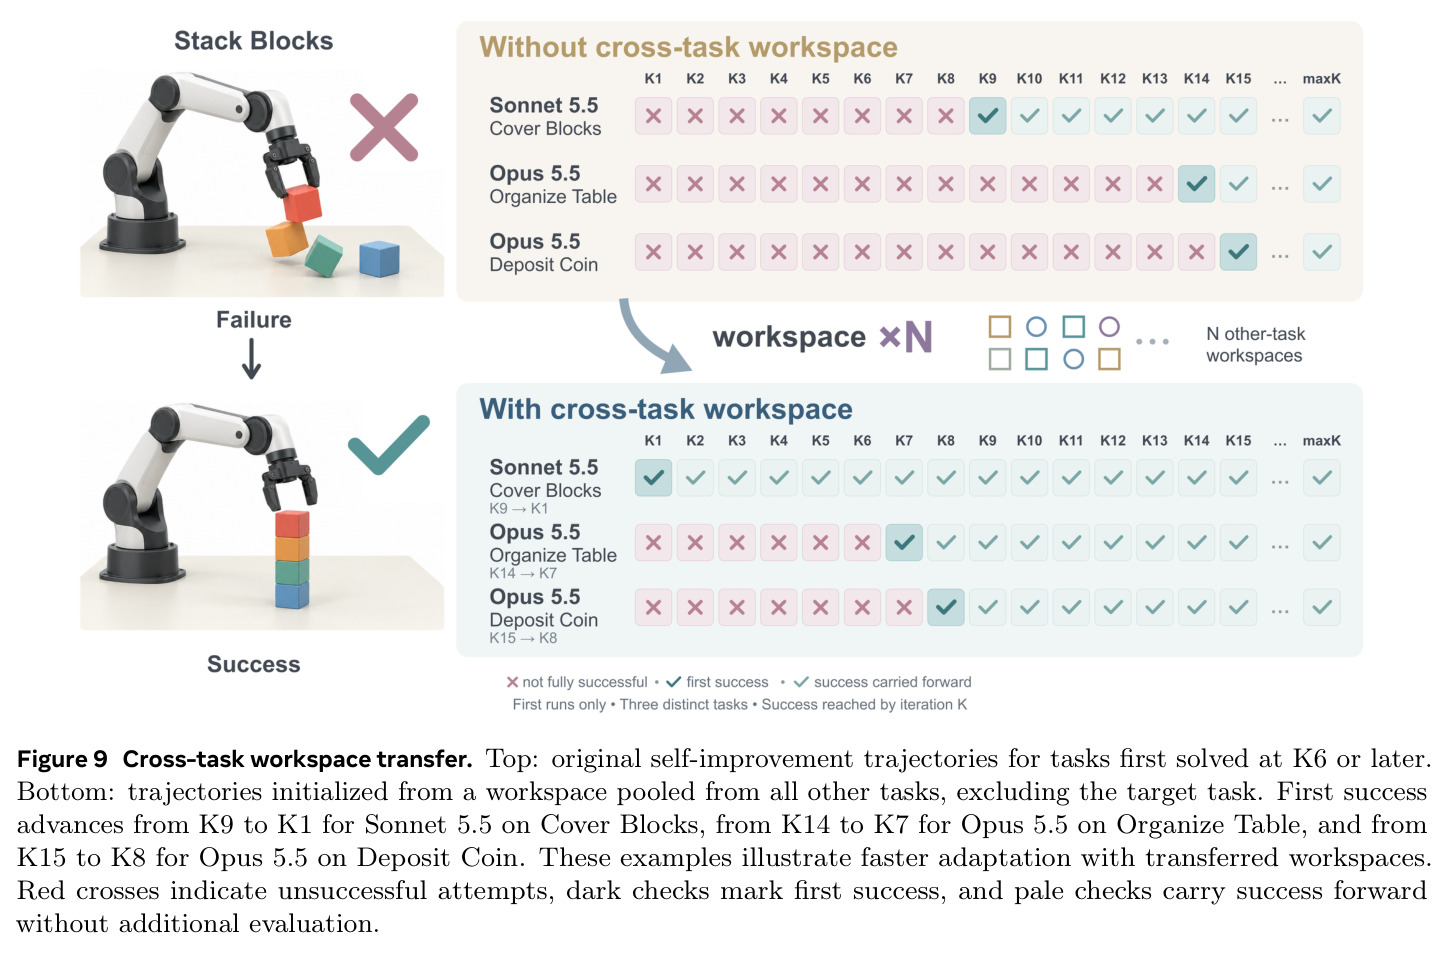
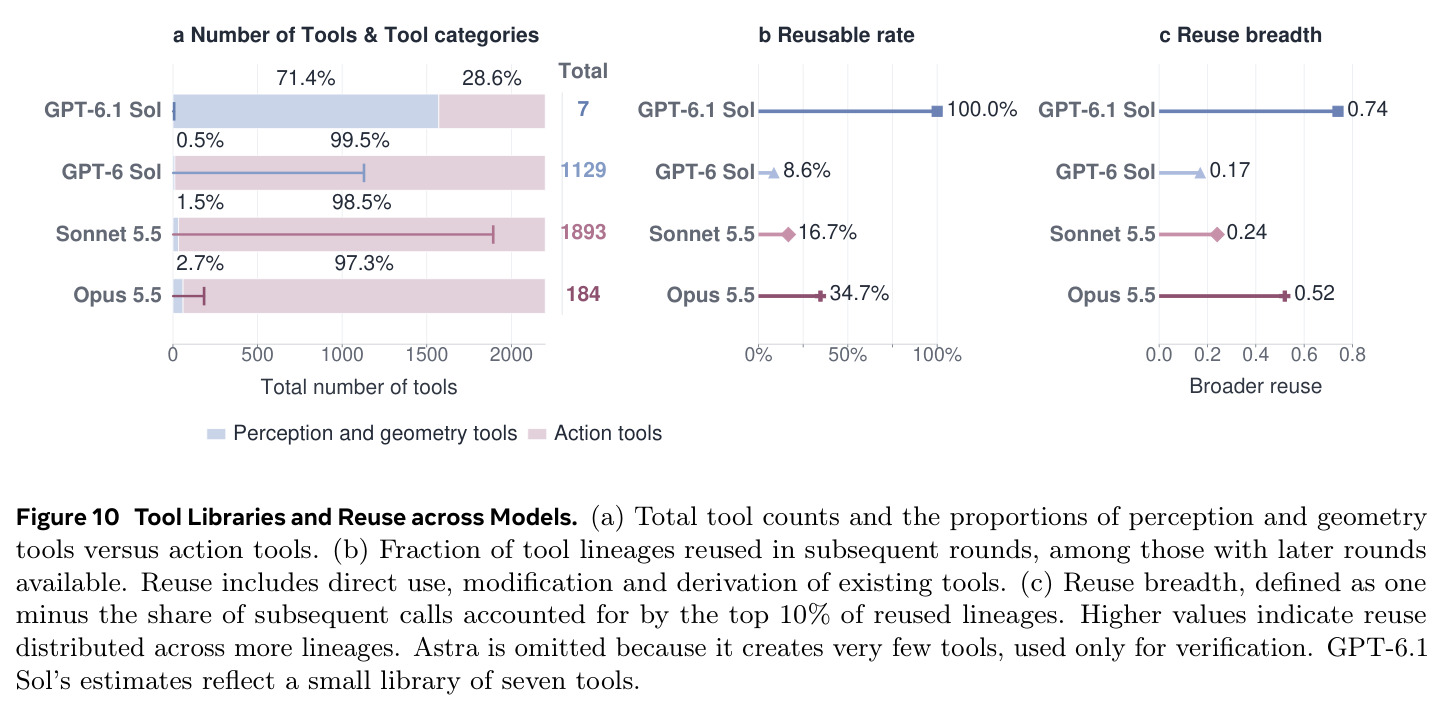
主对比(Table 1):18 任务均分从 K0 的 0.01–0.37 升至 0.10–0.84,解出 15/12/7/1/13/11 个;Astra 五轴全面领先,而 Opus Success 0.744 高于 6.1 Sol 0.703,Efficiency 却 0.609 对 0.822——高分、早收益、低成本可分离。能力关联(Figure 4):Spatial–A1 与 Perception–A3/A5 秩相关均 0.94,Coding 均≤0.37。公共均分脱节(Figure 6):24 分对 59.5 分。T50 预测(Figure 7):15 对排序全部恢复,$\tau_{90}$ 跨 K7–K17。早期预测(Figure 8):观测 K1–K5 后 Weibull 迁移预测 MAE 0.019 对基线 0.112,降约 83%。消融(Table 8):全环 K4–K6 成功 41.7%,无历史 8.3%,去反馈 13.9%。冻结泛化(Table 9):未见布局 25/60=41.7%,自身布局 88%。跨任务迁移(Figure 9):首次成功 K9→K1、K14→K7、K15→K8。工具谱系(Figure 10):Opus 复用率 0.347 最高,Astra 仅 7 工具、99% 动作直出。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 18 个 RoboDojo 任务上的物理 RSI 综合水平 | 100 × 五轴等权均值 (A1+…+A5)/5 | GPT-6 Astra 73.4 | GPT-5.6 Sol 13.9(全系统最低) | 系统间跨度 59.5 分,而同样 6 系统的 17 个公共基准均分跨度仅 24 分(54.1–78.1),暴露公共均分的失真 |
| 首次尝试性能 A1(K0,每任务 3 次) | 任务均分 $q_0$ | Astra 0.368 | GPT-5.6 Sol 0.012 | 约 30 倍;A1 与 Spatial 组秩相关 $\rho=0.94$,是所有轴中关联最强的一对 |
| Astra 历史消融:后期(K4–K6)在线成功率 | 12 条链 × 3 轮的成功数 | 全环 41.7%(15/36) | 无历史 8.3%(3/36);去评分反馈 13.9%;去图像 33.3% | +33.4 个百分点,证明留存经验在重复尝试之外有效 |
| K6 冻结 workspace 在 5 个未见布局上的零修订测试 | 12 源 × 5 布局 = 60 次成功率 | 仅 workspace 文件 41.7%(25/60) | 同源在自己布局上 88%(14/16,描述性) | 证明存储工件跨布局可用,同时量化了场景特化的差距 |
| 用前 5 轮物理反馈预测 GPT-6.1 Sol 的 K6–K17 轨迹 | 预测均方绝对误差 MAE | Weibull 形状迁移 0.019 | 保持最后观测分 0.112 | 误差降低约 83% |
| T50(半增益轮)的两两排序预测 | 系统对排序恢复率 | 15/15 全部恢复 | —(无信息基线为随机 50%) | 公共能力 profile 完全携带了增益时机的排序信息 |
局限与改进
作者承认:主对比只有 6 个『模型+配置』系统且每任务一条改进链,K0 三次重复无法估计链间变异;首次成功即停,不测可靠重复执行;A4/A5 用随系统变化的条件任务集(GPT-5.6 Sol 的 A4 建立在唯一解出的任务上),跨系统不可比;Astra 在无提示实验中从 15 降到 13 任务,结果对运行条件敏感;能力分析依赖评分设定不同的公共基准,6 系统无独立验证,最小校正 q=0.11 未达显著,瓶颈与预测只是待检验假说;消融与冻结测试只覆盖 Astra 和 6 任务,跨任务仅 3 例。我的补充:(1)木桶假说本质是 6 个点上的秩相关,样本极小,基准归组存在研究者自由度;(2)实验以 RoboDojo 仿真为主,真实世界扰动未测;(3)T50/Weibull 预测在 GPT 家族内校准,跨家族外推未知;(4)GPT 与 Claude 修订窗口差 3 倍,配置差异与模型能力混杂在同一比较单元;(5)A2 不含墙钟时间,而现实中早收益的时间成本重要。
独立分析的弱点
弱点一:因果缺位。能力—结果关联建立在 6 个点、无独立验证的秩相关上,无法回答『补空间推理是否提升 A1』;改进方向是落实附录 D 的定向干预,如外挂几何估计工具做受控前后对比。弱点二:预算口径任意:$U_t$ 把推理超时按整步限额折算成物理步数,罚则缺乏物理依据;条件任务集使 GPT-5.6 Sol 的 Budget 分几乎无意义;可改用全任务花费—收益曲线或统一虚拟预算。弱点三:『成功即停』使可靠性缺席,而 RSI 的核心恰是稳定复现——文中 Astra 修复『成功一次、重复失败』的反例就在眼前,但五轴没有保持率;建议增加解后连续重跑协议。弱点四:干预覆盖窄——消融与冻结只做 Astra 与 6 任务,跨任务迁移仅 3 例且无失败案例分析,无法判断迁移瓶颈在检索、适配还是可行性评估;应扩展到全部系统并记录经验选择轨迹。弱点五:五轴等权均值本身是人为压缩,与作者批评的单一排名只有程度差别,且各轴条件任务集不同,均值掩盖条件性;建议报告完整 profile,慎用聚合分。
未来方向
作者方向:(1)用定向能力干预检验木桶假说的候选瓶颈,把关联升级为因果证据;(2)解释哪些保留的技能或记忆使迁移成为可能——Organize Table 中 Opus 把 Pack Objects Into Box 的参数化 move 工具与 Store Tools In Toolbox 的『俯仰 30° 抓取够到 +y 半区』记忆组合,『程序+适用条件』的共同迁移机制值得形式化;(3)扩大系统数量并引入独立验证,把 T50 与轨迹预测发展成可用工具。我的延伸:(1)把五轴 profile 变成模型卡标准字段,推动发布时报告物理 RSI 各轴;(2)统一修订窗口重跑,剥离 1800s 对 600s 的配置混杂;(3)在真实机器人上复制协议,检验冻结 workspace 41.7% 跨布局成功率的迁移;(4)把工具谱系复用率(0.347 对 0.086)作为『改进风格』特征,研究其与长期上限的关系;(5)给出 T50 随能力 profile 的参数化缩放形式,而不止秩恢复;(6)把预算 H 作为显式变量消融,回答『预算翻倍能买回多少改进』。
复现评估
复现难度:中高。有利因素:协议完全参数化——K0 三次、H=17、4200s 推理、1800/600s 修订、$17\times$ 步限预算、layout 0 + seed 0、6 难度层×3 任务;任务来自公开的 RoboDojo 并按官方成功率分层;五轴精确计算在附录 B,中间量在 Table 4 公开;消融条件与逐轮成功率(Table 7/8)、冻结测试(Table 9)逐格可查;17 个基准清单具体到子任务(Table 6);有项目主页 physrsi-eval.github.io。不利因素:核心系统全是闭源前沿模型,结果依赖具体 API 版本与 harness(Codex CLI 0.156.1、Claude Code),会随时间漂移;算力与费用可观——单任务最坏 $17\times(4200+1800)$ 秒约 28 小时仿真挂机,6 系统×18 任务×20 轮的仿真量与 API 开销巨大;公共基准分数有强时间敏感性;拿不到每条链原始轨迹,则置换检验与 bootstrap 置信带无法复算。学术团队用开源模型复刻协议可行,但缩放律结论需要至少 6 个能力有梯度的系统,开源模型能力同质化可能压扁动态范围。
论文图表
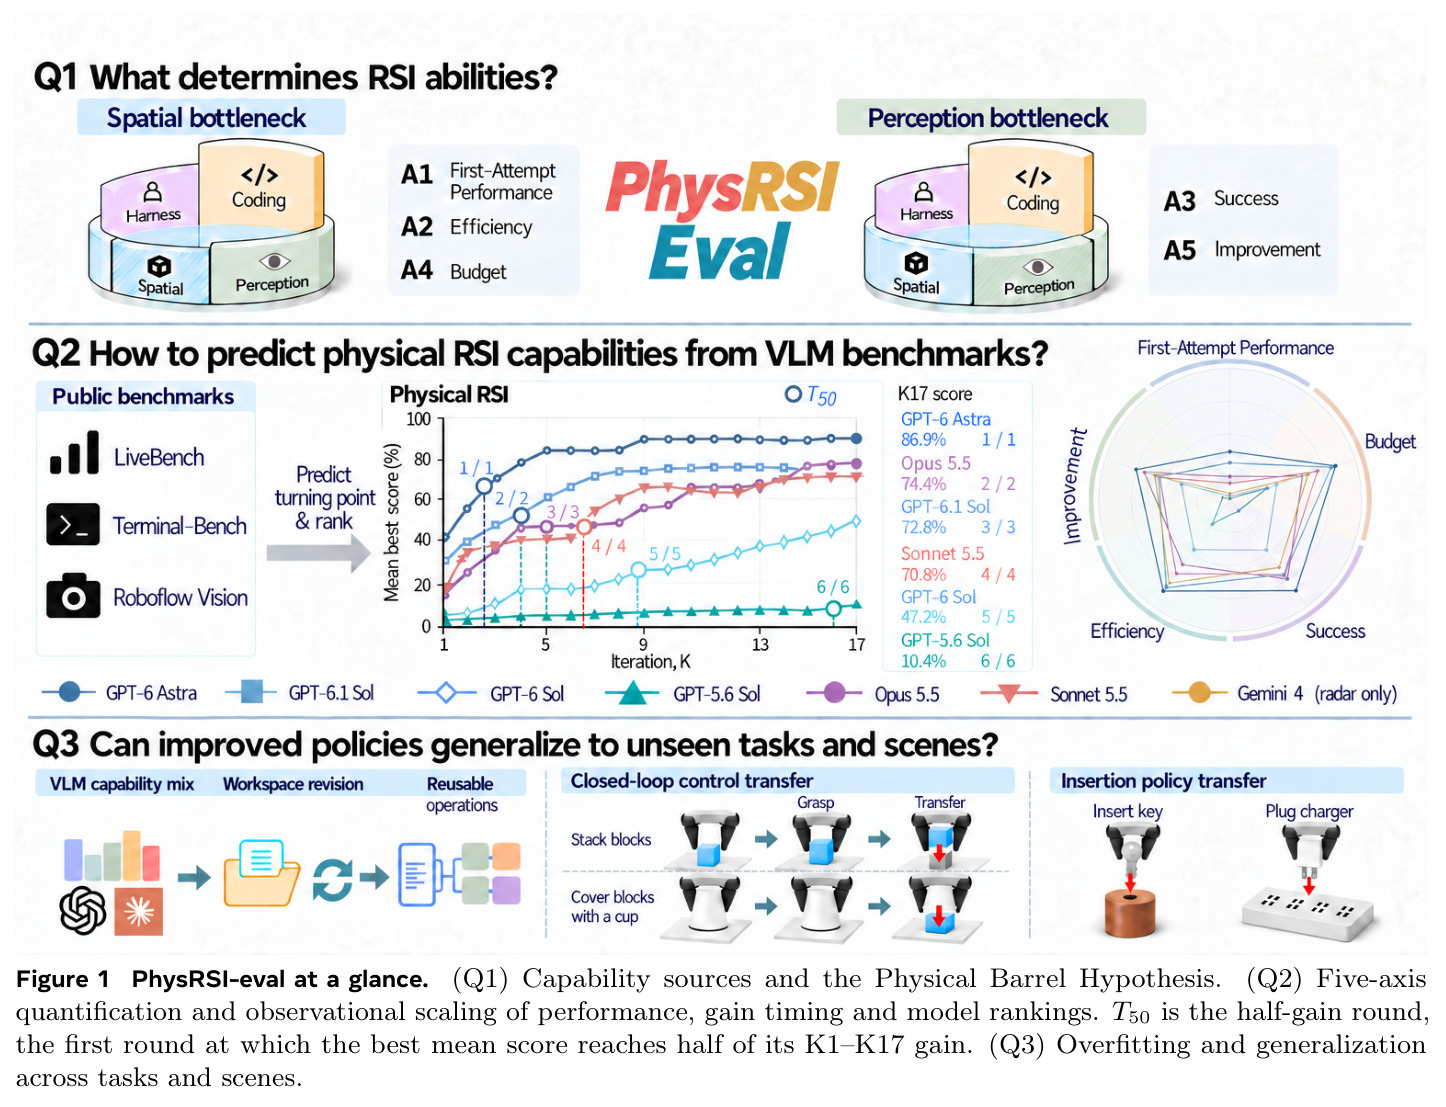
全文概览图,按三个研究问题组织:Q1 展示能力来源分析与木桶假说示意;Q2 展示五轴量化、性能与增益时机的观测性缩放以及模型排名预测,并定义 T50(最佳均分首次达到 K1–K17 增益一半的轮次);Q3 展示跨任务与跨场景的过拟合/泛化检验。
一图看懂论文的问题结构、方法框架与三大结论,是理解全文逻辑的地图。
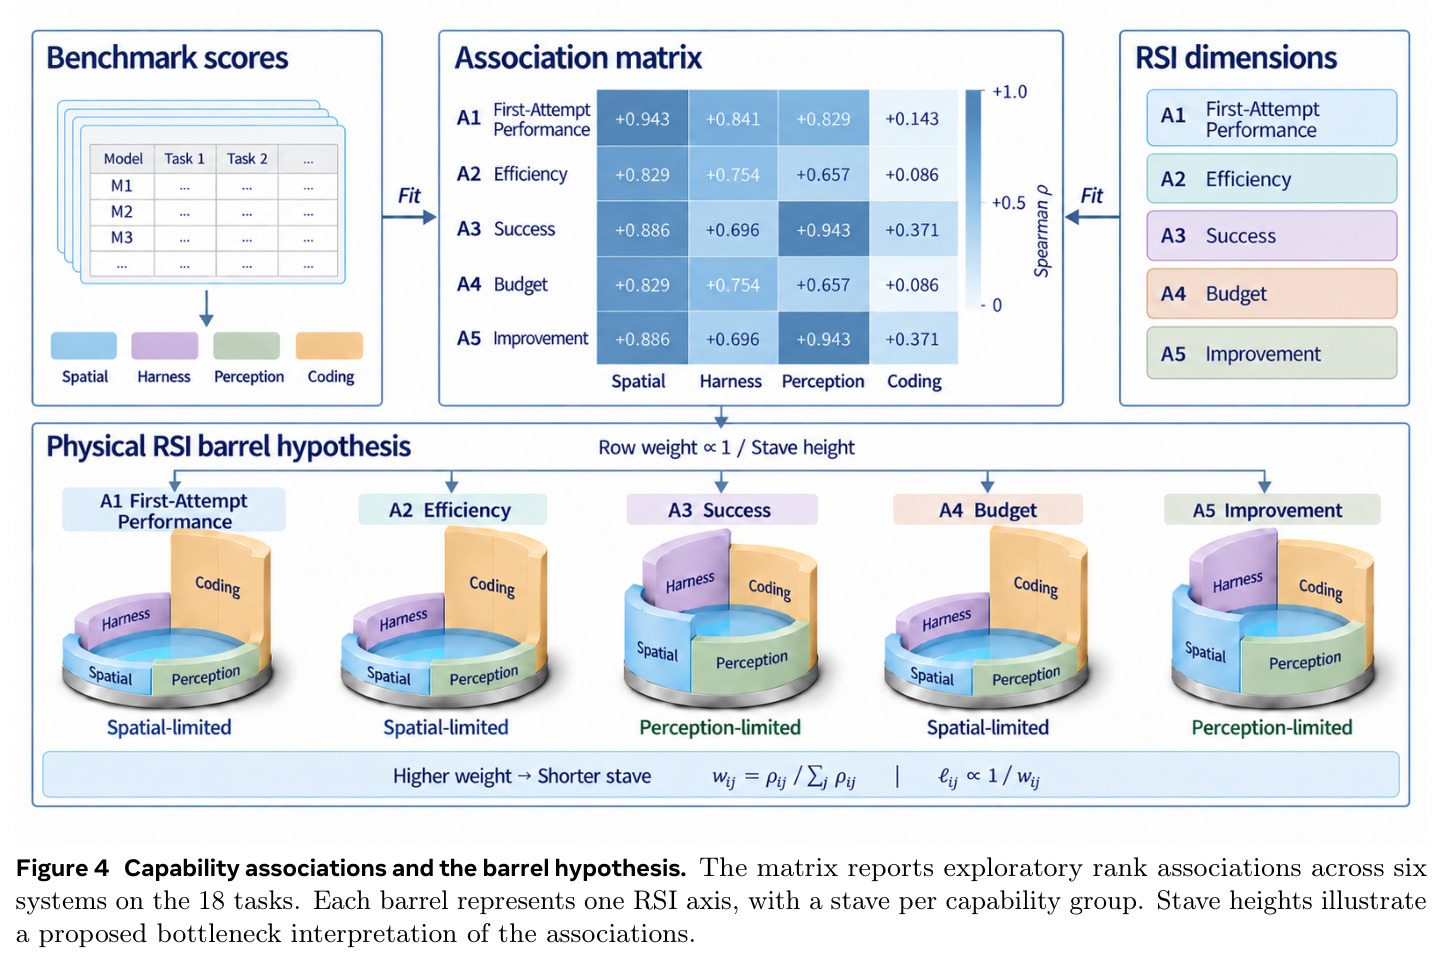
左侧矩阵给出 6 个系统上四组能力 profile(Spatial/Harness/Perception/Coding)与五个 RSI 轴 A1–A5 的 Spearman 秩关联:Spatial 与 A1 达 0.94、与 A2/A4 达 0.83;Perception 与 A3/A5 达 0.94;Coding 全面不超过 0.37。右侧用木桶示意:每根桶板是一个能力组,不同轴的短板不同。
这是 Q1 的核心证据图,也是 Physical Barrel Hypothesis 的直接来源,论文标题问题的答案浓缩于此。
列出 18 个任务的名称、每轮步数限制(300–1300 步@25Hz)与评分方式:分级任务按达到的最高档位给部分分(如 arrange_largest_number 的 [5,15,30,100]),二值任务给 0/1,成功判定独立于档位。
定义了评测的任务空间与原生评分规则,是理解部分分如何进入五轴计算的前提。