Fréchet Forcing:用短片段训练长时序流式世界模型 Frechet Forcing: Training Long-Horizon Streaming World Models from Short Clips
以真实数据Fréchet距离三项约束替代教师,rollout稳定超4000帧
前置知识
流式视频世界模型
逐块(chunk)生成未来视频帧的生成模型,每个新块以两部分为条件:上下文中自己之前生成的历史、以及外部输入的动作流(如机器人末端位姿或相机轨迹)。训练时条件历史是真实视频,部署时却要消费自己生成的历史,形成训练-部署鸿沟。
本文解决的核心问题就是这类模型在自回归部署时的误差累积与漂移,所有设计都围绕 rollout 展开的。
Diffusion Forcing 与块因果 DiT
把视频切成小块,给每个块独立分配噪声水平进行去噪训练的范式;配合块因果注意力(每个块只看过去的块)即可边生成边条件于较干净的历史。基座模型 MiniWorld-1B 是在 Wan2.2 VAE latent 上用非递减噪声时间表训练的块因果 DiT,部署时用阶梯采样器(8 步去噪、8 个 chunk 并行在飞、滚动 KV cache)。
理解 chunk、噪声水平、KV cache 等机制是看懂生成锚定历史构造和自由 rollout 细节的前提。
分布匹配蒸馏(DMD)
在生成器自身样本上加噪,用「冻结教师分数减去在线假样本分数」得到训练梯度,从而把多步采样蒸馏成少步生成,是 Self Forcing、Rolling Forcing 等长视频方案的基础。它要求一个比学生更准的教师网络和一个在线 critic。
论文的动机正是论证 DMD 在动作条件世界模型上不可行(教师两难),理解 DMD 才能明白 Fréchet Forcing 省掉了什么。
Fréchet 距离(FID/FVD)
假设两组特征各服从高斯分布,用均值差与协方差之差衡量两个分布的距离:$\mathrm{FD}=\|\mu_1-\mu_2\|^2+\mathrm{tr}(\Sigma_1+\Sigma_2-2(\Sigma_1\Sigma_2)^{1/2})$。FID 在 Inception/CLIP 特征上比较图像分布,FVD 在 I3D 特征上比较视频分布,是生成模型的标准评估指标。
本文反其道把这一评估指标直接变成训练损失,且参考统计量来自真实数据、在任意视野下恒定有效。
流匹配(Flow Matching, FM)
一种生成建模训练目标:学习速度场 $v_\theta$ 去拟合加噪路径上的速度,例如 $x_t=(1-t)x+t\epsilon$ 时目标为 $\epsilon-x$。相比扩散的分数匹配更简洁,是 MiniWorld 预训练所用目标的连续时间形式。
生成锚定约束保留了预训练的 FM 损失,只是把条件历史换成带模型自身误差的自生成历史。
截断时间反传
自回归 rollout 跨几十个 chunk 时完整反传代价过高,因此只把最后 $K$ 个 chunk 保留在自动微分图中,前面的 chunk 以 stop-gradient 方式进入 KV cache,梯度只经过尾部的最新去噪轨迹流入参数。
它引出了「统计必须在梯度承载的 chunk 上计算」这一关键设计,否则会出现论文剖析的梯度-统计错位失效。
研究动机
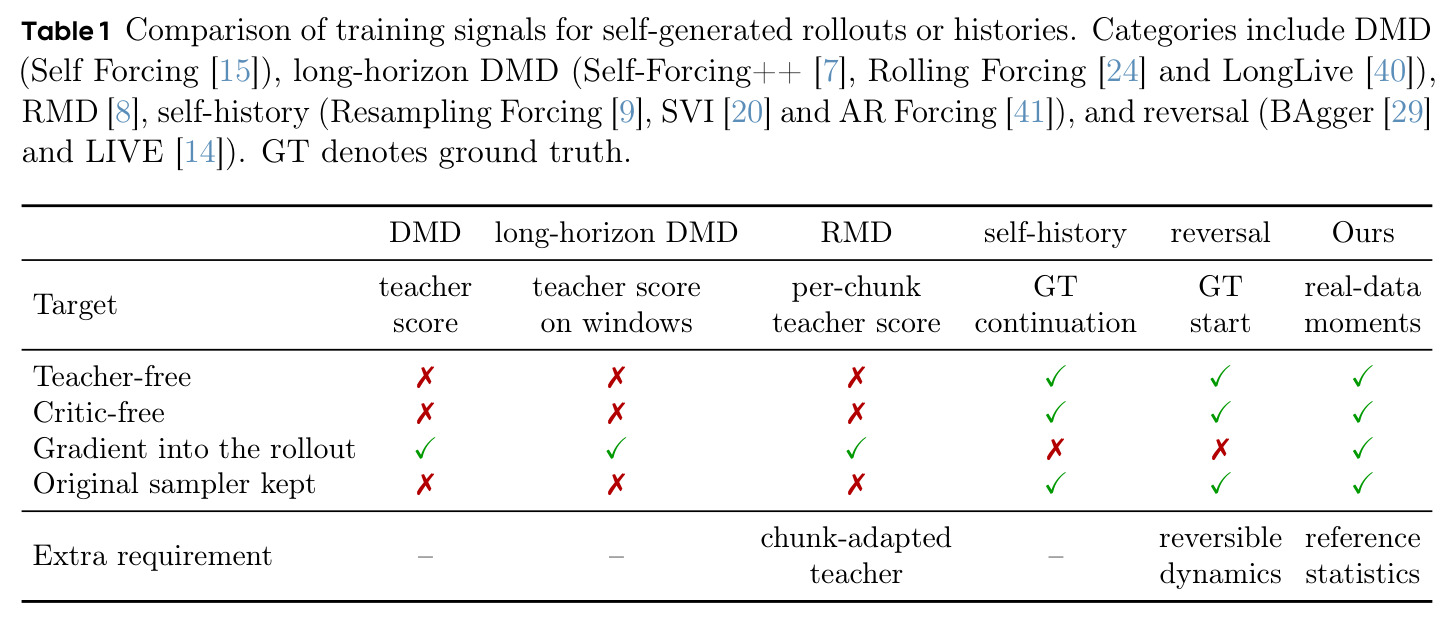
流式视频世界模型逐块生成未来,每个新块以自己生成的历史和动作流为条件;训练时条件是真实历史,部署时却要消费自己的预测,小误差回流上下文并复利放大。实测中 MiniWorld-1B 在 253 帧(预训练片段长度)内表现良好,超过训练视野就迅速退化:DROID 上饱和网格纹理从移动机械臂处扩散,CLIP-FD 从 38 恶化到 431,FVD 从 45 涨到 2058;Sekai 上画面 250 帧内变暗最终淡出至黑,亮度跌到 0.40。主流补救是在模型自身 rollout 上做分布匹配蒸馏(DMD),但动作条件世界模型面临教师两难:外部视频模型不理解动作信号,会把 rollout 拉向错配分布;用自己的预训练网络当教师,它在长视野状态上与学生犯同样漂移,提供不了矫正信号——作者实验中各种 DMD 配置均未超过基线。教师-free 逐样本回归方法(自历史、时间反演)的回归目标永远是录制帧,只能监督能与真实帧配对的状态,rollout 几千帧后到达的状态永远得不到直接监督。
本文的目标是本文目标是让动作条件流式世界模型在训练片段远短于部署视野时,仍能生成长时稳定且服从指令的视频,并满足三个严格约束:不引入教师网络、不引入在线 critic、不使用任何长视频数据,直接微调已部署的多步采样器而不改架构和推理流程。量化目标是以 MiniWorld-1B(253 帧片段预训练)为起点,仅用 381 帧短片段微调最多 36 GPU 小时,使 rollout 在 DROID 机器人操作和 Sekai 相机探索两个领域稳定超过 4000 帧(预训练视野的 10 倍以上),且全程保持动作跟随——DROID 上对正反回放参考的 PSNR 在第 4000 帧仍高于 21 dB(基线仅 8.9 dB),画面真实性、场景一致性、chunk 边界平滑度均不随视野明显衰退。附带的方法论目标是解释清楚朴素分布匹配为何失败,以及每个设计选择分别堵住了哪种失效模式。
与已有工作不同的是,作者的独特切入是对「长 rollout 需要什么监督」的重新定义:一条长 rollout 根本不必匹配教师或任何录制未来,只要它仍是自己场景的真实延续并服从指令动作即可。真实感与场景保真是分布性质,而真实数据的统计量在任何视野下都恒定有效——真实帧的分布是固定的、紧凑可概括的,不像教师分数那样在学生走到的陌生状态上失效;动作跟随则是条件生成性质,模型预训练损失已在监督。于是全部监督信号都能从短真实片段导出,长视频彻底不再是必需品。这与 DMD 系(依赖教师分数+在线 critic、面向少步蒸馏)和教师-free 回归系(监督被真实帧配对限制)都有本质区别。更进一步,作者不满足于给出可行方法,还用三个诊断探针系统解剖了分布匹配在自由 rollout 上的失效动力学——上下文解耦、梯度-统计错位、特征空间被钻空子,以及自生成历史特有的 chunk 边界重绘——并逐一给出精确的设计解,这种「先理解失败再设计目标」的路线在同类工作中独树一帜。
核心方法
直觉上,一条长 rollout 必须同时满足三件事:继续历史并跟随动作(条件生成)、不偏离自己的初始场景(场景保真)、画面保持真实(不变暗、不褪色、不出周期纹理)。没有单一损失能同时保证三者,Fréchet Forcing 因此组合三个权重均为 1 的约束:$\mathcal{L} = \mathcal{L}_{anc} + \mathcal{L}_{ctx} + \mathcal{L}_{real}$。技术路线:每个训练步取一条 96-latent(381 帧)真实片段,用部署采样器从单个真实上下文 latent 自回归 rollout $N=40$ 个 chunk,只把最后 $K=8$ 个 chunk 保留在自动微分图中。生成锚定在「自生成历史、以真实 chunk 结尾」后对后续真实 chunk 施加流匹配损失;上下文保真对梯度承载 chunk 的 latent 统计做以其自身真值为中心的 Fréchet 距离;现实匹配把最后 $D=4$ 个 chunk 解码成像素,与 VAE 重建真实帧在冻结 DINOv2 特征空间算 FD。两个 FD 均用指数滑动平均矩估计($\beta=0.99$)把有效样本量与批量解耦,单卡 batch=1 也可微,再以 $\mathrm{FD}/\mathrm{sg}(\mathrm{FD})$ 自归一化,使三项能以单位权重直接相加。
核心创新是把长时序监督从「匹配教师/匹配录制未来」改为「匹配真实数据统计量 + 保留条件生成损失」。与 DMD 的本质区别:FD 的参考统计量 $(\mu_r,\Sigma_r)$ 预先在真实数据上算好,任何视野都有效,完全不需要教师网络和在线 critic。与教师-free 回归方法的本质区别:后者的回归目标永远是真实帧,只能监督能与录制帧配对的状态,且要求时间可逆动力学或梯度不进 rollout;而 FD 直接作用于部署采样器的自由 rollout,梯度真正流入生成 chunk,分布目标在任意视野都合法。三个约束互补性极强:上下文保真通过逐片段减去自身真值均值 $h=\psi(z_{N-K:N})-\psi(x_{N-K:N})$ 把边缘分布度量变成片段条件度量,全局变暗会移动均值项、片段特异漂移会抬高协方差,但都无法靠塌向数据集平均外观作弊;现实匹配提供语义级感知空间,封死低阶统计被暗场、鱼鳞纹理等退化解满足的漏洞;生成锚定则保证模型不退化为纯分布匹配器、丢失「继续历史」的生成本职。
方法步骤详情
每个训练步(Algorithm 1)四步执行。第一步生成锚定:从真实片段 $x$ 抽历史长度 $c\sim U[1,N]$,把前 $c$ 个 chunk 加噪到 $t_a=0.7$,用部署阶梯采样器无梯度重渲染出带自身误差的历史 $h_c$;关键改动是把历史最后一个 chunk 替换成干净真实 chunk $x_{c-1}$,否则模型学会在每个 chunk 边界重绘场景(flicker 恶化到 1.31);随后对后续 $W=4$ 个真实 chunk 施加 $\mathcal{L}_{anc}=\mathbb{E}\|v_\theta(x_{t_{c:c+W}}|h_c,a)-(\epsilon-x_{c:c+W})\|^2$。第二步自由 rollout:从单个真实上下文 latent 生成 $N=40$ 个 chunk,只有最后 $K=8$ 个在 autograd 图中,前缀 detach 进 KV cache。第三步上下文保真:对梯度 chunk 的每两个相邻 latent 提取各通道空间均值与标准差拼接成 $\psi$,减去本片段对应跨度真值均值后与真实片段统计做自归一化 FD。第四步现实匹配:最后 $D=4$ 个 chunk 多解码一个前置 chunk 再丢弃其帧以保证解码器统计一致,逐帧以 DINOv2 CLS token 嵌入,与 VAE 重建真实帧参考统计做 FD。三项单位权重合并,AdamW lr $10^{-6}$,微调 225 步。
技术新颖性
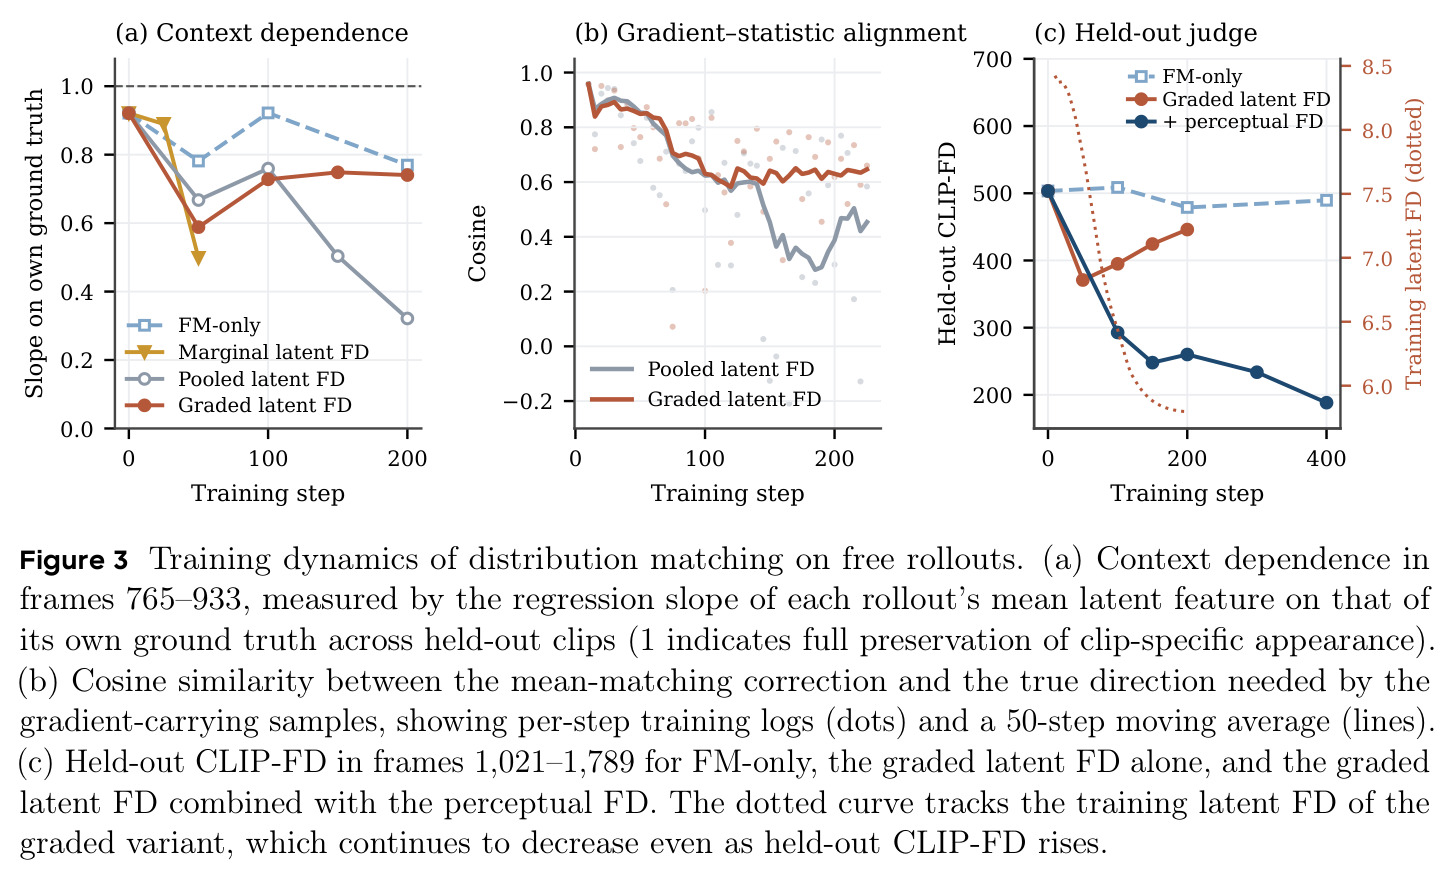
新颖性体现在五层。其一,首次把 Fréchet 距离目标直接用于流式视频世界模型的自生成 rollout 训练:借用 Yang et al. 的滑动矩估计把有效样本量与批量解耦,batch=1/GPU 也能估计数百维协方差,并把 $\nabla\log\mathrm{FD}$ 自归一化梯度与截断反传、多卡 all-gather 特征结合。其二,上下文保真的「逐片段中心化」把边缘分布度量转化为片段条件度量,从机制上堵死序列级分布匹配允许无界漂移的问题。其三,「历史必须以真实 chunk 结尾」发现并解决了自生成历史训练特有的 chunk 边界重绘伪影,还专门设计了闪烁指标量化它。其四,「只对梯度承载 chunk 计统计」消除截断反传下目标与梯度作用样本不一致——pooled 变体的梯度-统计对齐余弦从 0.96 跌到 0.39,graded 变体保持 0.63。其五,三个诊断探针(上下文依赖斜率、对齐余弦、留出 CLIP-FD 裁判)把失效动力学解剖到设计原则层面。整套方法只微调部署采样器本身,不改架构与推理流程,单一超参配方跨 DROID 和 Sekai 通用。
实验结果
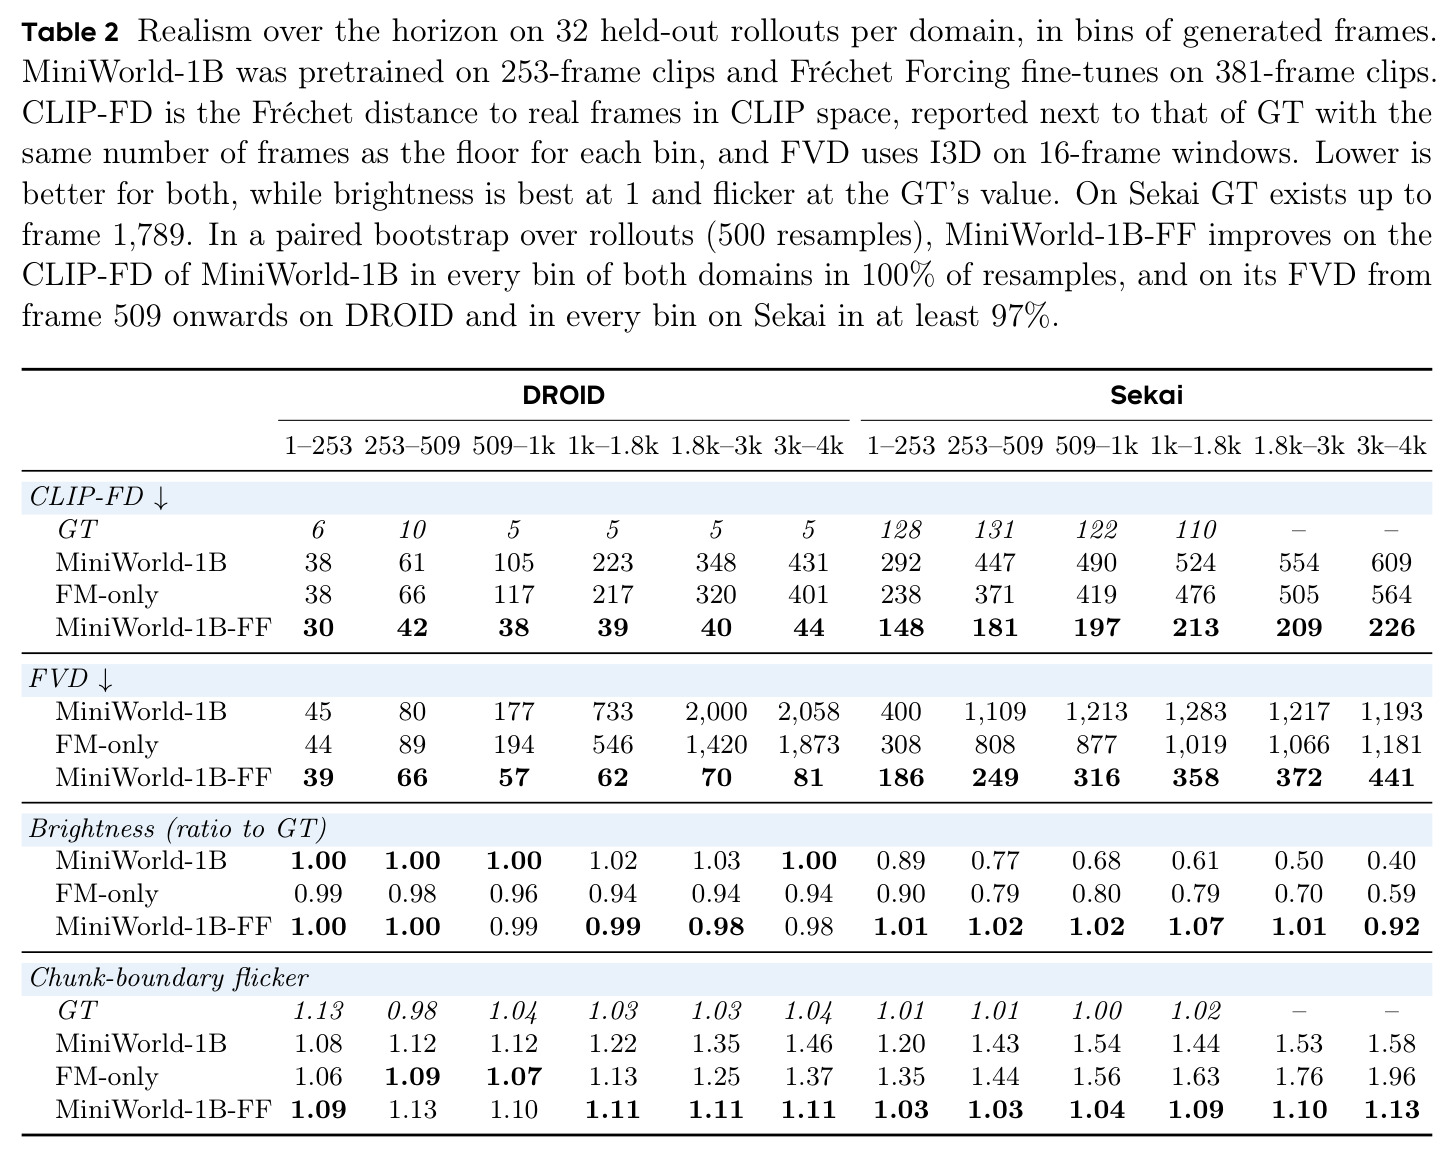
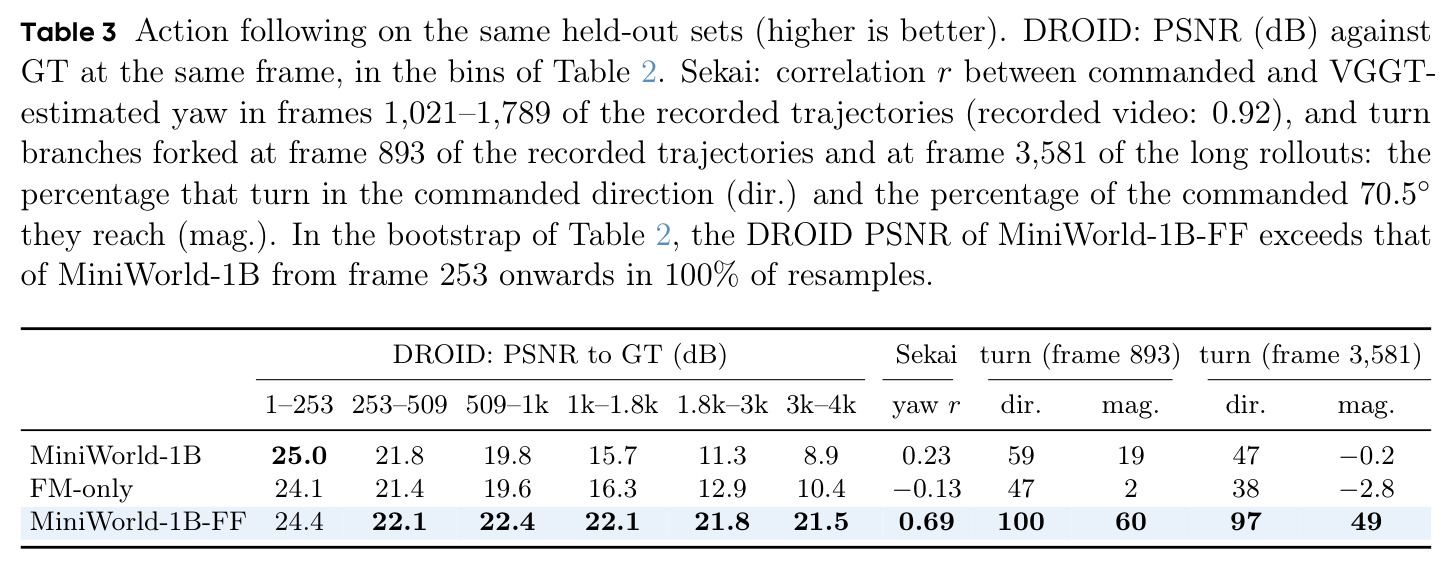
主实验在 DROID 和 Sekai 上以统一协议评估到第 4001 帧,各 32 条留出片段、六个视野 bin。DROID:基线 CLIP-FD 从 38 恶化到最后一 bin 的 431、FVD 从 45 涨到 2058;FF 全程 CLIP-FD 保持 30–44、FVD 39–81,最后一 bin 相对基线分别降 10 倍和 25 倍;亮度保持真值的 98%–100%,flicker 与 GT 持平;对正反回放 GT 的 PSNR 在最后一 bin 达 21.5 dB(基线 8.9)。Sekai:基线亮度从 0.89 跌到 0.40、FVD 达 1193;FF 的 CLIP-FD 从 509 帧起稳定在 197–226,最终 bin CLIP-FD 与 FVD 均比基线低 2.7 倍。动作跟随:Sekai 偏航相关 0.69(基线 0.23),第 893 帧分叉转向 100% 方向正确、60% 幅度(基线 59%、19%),第 3581 帧分叉仍 97%、49%。96 条人工检查的 DROID rollout 中 98% 在 1500 帧无伪影、79% 坚持到 4000 帧。消融证明每个约束都必要:去现实匹配 CLIP-FD 恶化到 395,去上下文保真亮度跌到 0.74,FM-only 479 vs FF 的 226;bootstrap 显示各 bin 改进在 ≥97% 重采样中显著。
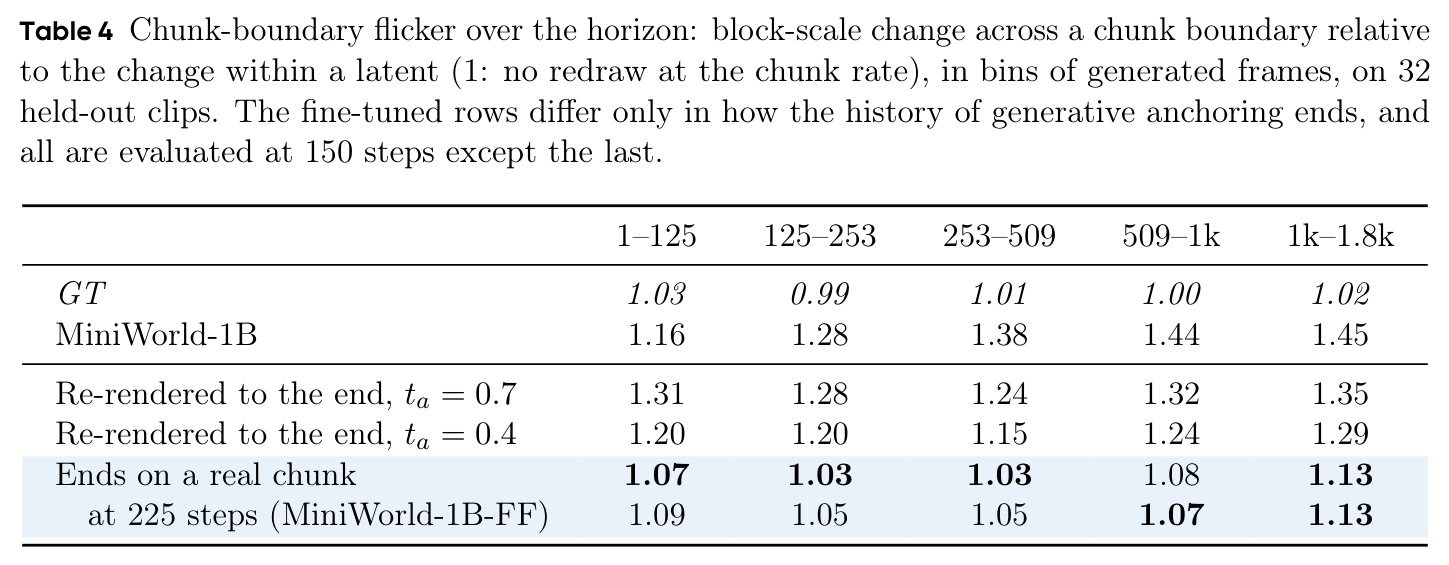
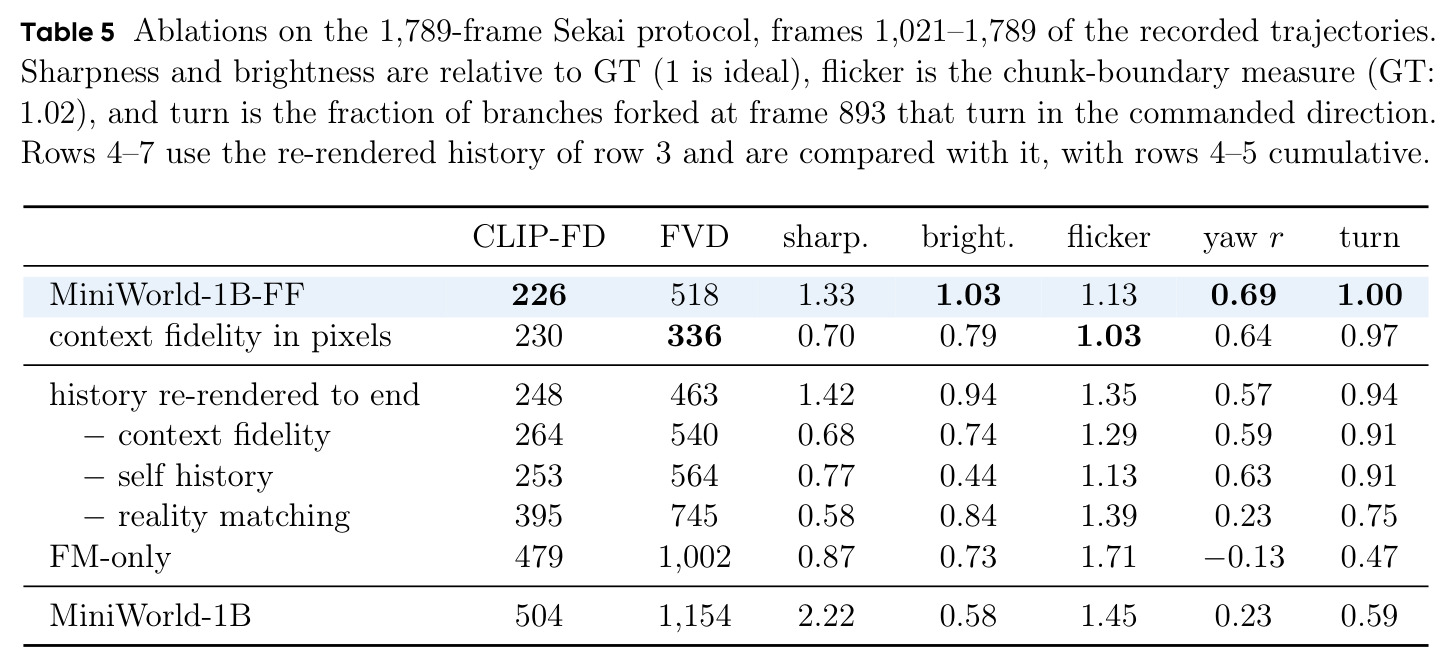
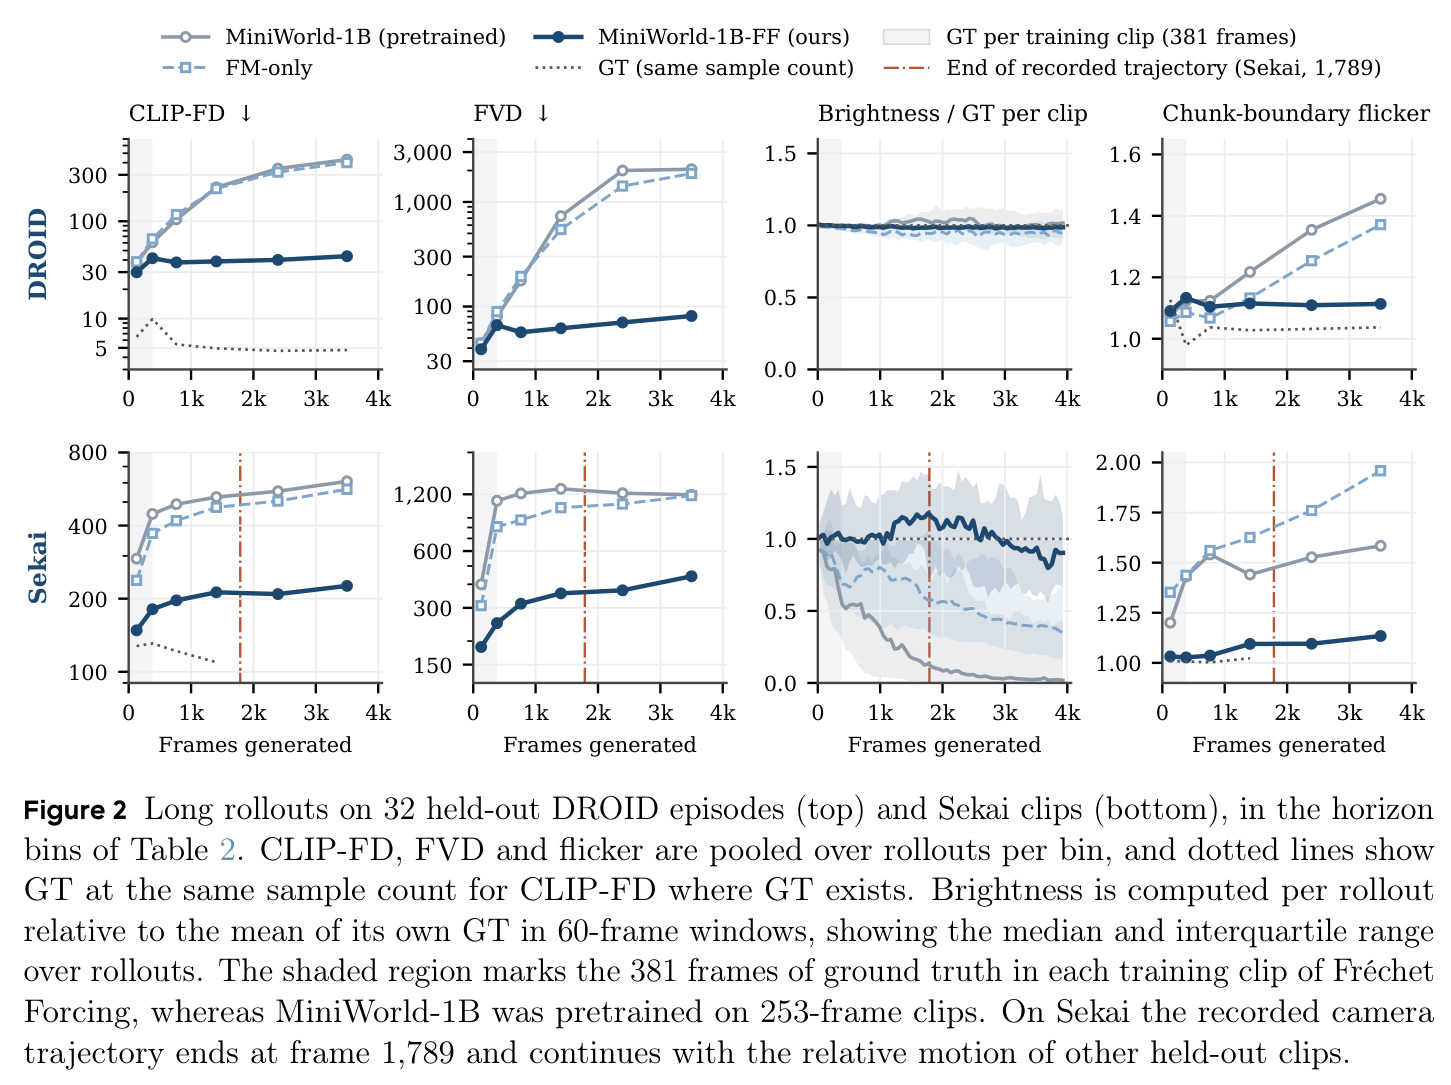
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| DROID 机器人操作长时序生成(4001 帧 rollout) | CLIP-FD(最后一 bin,2997–4001 帧) | 44 | MiniWorld-1B:431 | 降低约 10 倍 |
| DROID 机器人操作长时序生成 | FVD(最后一 bin) | 81 | MiniWorld-1B:2058 | 降低约 25 倍 |
| DROID 动作跟随(PSNR 对正反回放 GT) | PSNR(最后一 bin) | 21.5 dB | MiniWorld-1B:8.9 dB;FM-only:10.4 dB | +12.6 dB |
| Sekai 相机探索长时序生成 | CLIP-FD(最后一 bin) | 226 | MiniWorld-1B:609 | 降低约 2.7 倍 |
| Sekai 相机探索长时序生成 | FVD(最后一 bin) | 441 | MiniWorld-1B:1193 | 降低约 2.7 倍 |
| Sekai 动作跟随(转向分叉于第 893 帧) | 方向正确率 / 指令角度达成率 | 100% / 60% | MiniWorld-1B:59% / 19% | 方向 +41pp,幅度 +41pp |
| Sekai 偏航跟随(1021–1789 帧) | VGGT 估计偏航与指令的相关系数 r | 0.69 | MiniWorld-1B:0.23 | 提升约 3 倍 |
| Sekai 消融(1789 帧协议,1021–1789 帧) | CLIP-FD | 完整方法 226 | 去现实匹配 395;FM-only 479;基线 504 | 证明每个约束均必要 |
局限与改进
作者承认的局限:外观受约束但相机运动幅度不受约束,转向只达指令角度的 49%–60%,需要显式姿态一致性项;感知特征空间尺度粗,部分明亮 rollout 出现指标捕捉不到的细周期纹理;分布项是种群级且只覆盖 317 帧训练 rollout 内的状态,慢漂移只能间接抑制——Sekai 的 FVD 仍从 186 缓升到 441,少数片段持续变暗;现实匹配只评单帧,不保证长程一致性,重访场景可以面目全非,罕见场景(如雪)会在保持真实的前提下漂向主导内容;DROID 上到 4000 帧时 20% 的 rollout 有局部伪影(物体变饱和色块、桌面出现周期纹理)而全局指标稳定,难以察觉;DROID 的参考是正反回放而非连续录制,留出片段参与过预训练,实验只覆盖两个领域、单一模型规模。我的补充:FD 完全押注冻结特征空间的判别力,物理合理性、物体永久性等维度无任何监督;EMA 矩引入的参考-当前滞后在高动态场景的稳定性未验证;方法要求部署采样器可微;动作跟随评估依赖 VGGT 等外部估计器,严重退化的基线帧可能让指标本身失真(FM-only 的 r=−0.13 更可能反映估计失败而非纯不跟随)。
独立分析的弱点
第一,动作幅度欠跟随(49%–60%)说明分布级目标对几何精度不敏感,可加显式位姿一致性项:用可微 VGGT 或 PnP 估计位姿,直接约束其与指令序列的误差。第二,种群级 FD 掩盖局部失败(20% rollout 有局部伪影但全局指标稳定),可做区域级感知匹配:把 DINOv2 patch token 而非仅 CLS token 纳入统计,或对空间分块特征分别做 FD。第三,单帧现实匹配不保证长程一致性,重访场景可合理面目全非,可引入轻量场景记忆或以初始帧为锚的检索式参考。第四,慢漂移只能间接抑制(FVD 从 186 涨到 441),可课程式延长 rollout 长度 $N$,让监督覆盖更远状态。第五,FD 的有效性完全取决于冻结特征空间的判别力,论文已展示低阶空间被退化解钻空子的教训,更精细伪影仍可能漏网,可多特征空间集成或周期轮换裁判特征并配留出裁判监控。第六,三个损失权重全为 1 的配方虽优雅,但在更大模型、不同噪声时间表、更丰富动作空间下的鲁棒范围未做敏感性分析;381 帧固定训练片段与 40 chunk 固定 rollout 也缺乏按场景漂移速度自适应的机制。
未来方向
作者提出的方向:在 rollout 上加显式位姿一致性约束以改善动作幅度跟随;使用空间尺度更细、更难满足的感知特征空间抑制细周期纹理;发展区域级感知匹配以捕捉种群指标掩盖的局部失败。基于本文成果可延伸的方向:其一,把「真实数据统计量做长时序监督」推广到其他模态世界模型(音频、触觉、3D 场景),FD 目标天然跨模态可用;其二,与强化学习结合——稳定超 4000 帧的世界模型可直接充当具身策略训练的仿真器,本文正反回放构造长参考的思路也可反哺评估协议设计;其三,上下文保真的逐片段中心化技巧可移植到长视频生成、长文本生成等其他自回归任务的分布匹配训练中;其四,三个诊断探针(上下文依赖斜率、梯度-统计对齐余弦、留出裁判)可发展为长时序微调的通用监控工具甚至早停准则;其五,把 225 步固定配方升级为随 rollout 长度课程化扩展(先 40 chunk 后 80 chunk),有望冲击分钟级稳定生成并压平残余的 FVD 缓升;其六,探索在特征空间中注入几何与物理先验(深度一致性、物体永久性、光照守恒)的 FD 变体,弥补当前只约束外观不约束物理的缺陷。
复现评估
复现条件相当友好。代码开源于 github.com/zhao-yian/Frechet_Forcing,模型权重在 HuggingFace(zhaoyian01/Frechet_Forcing),项目页含演示视频。基座 MiniWorld-1B 及其领域 checkpoint 开源;数据 DROID(8958 训练 + 2774 评测 episode)和 Sekai(1462 训练 + 156 留出 clip)均公开。算力门槛是最大亮点:8 卡微调仅 225 步,合计 34–36 GPU 小时(每步 68–72 秒),训练全程内存中无需教师网络。一次性开销包括 VAE 重建真实帧并预计算参考统计(DROID 52k latent 窗口 + 108k 帧,Sekai 26k + 54k 帧)和 16 条无梯度 rollout 初始化 EMA 矩。复现需对齐的细节:要求部署采样器可微;多卡损失按世界大小缩放为 $W\cdot\mathrm{FD}/(\mathrm{sg(FD)}+0.01)$;FD 参考必须基于与训练相同窗口和步长的 VAE 重建帧而非原始视频,否则 VAE 重建间隙会诱导高频伪影;现实匹配要多解码一个前置 chunk 并丢弃其帧。超参完整($t_a=0.7$、$W=4$、$K=8$、$N=40$、$D=4$、$\beta=0.99$),复现难度中低、性价比极高。
论文图表
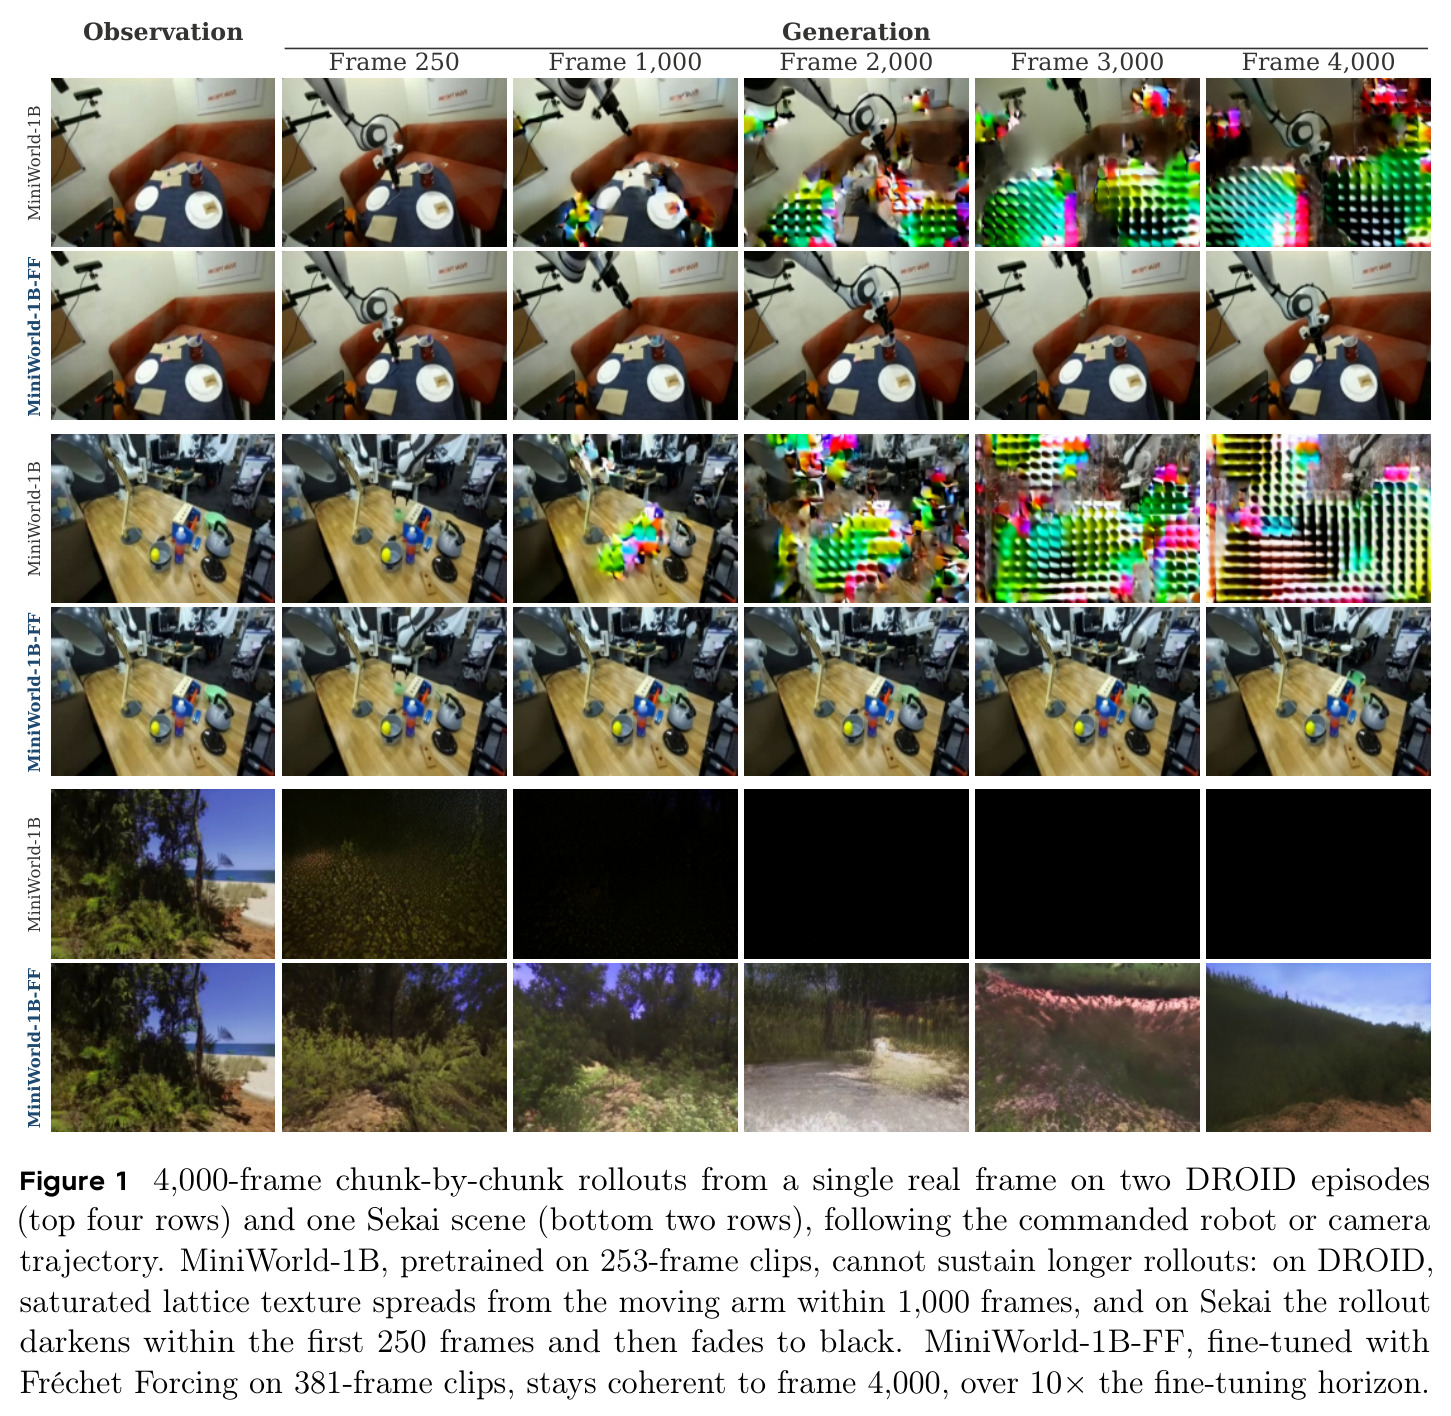
从单张真实帧出发,沿指令的机器人/相机轨迹逐块生成到第 4000 帧。基座 MiniWorld-1B 在 1000 帧内从移动机械臂处扩散出饱和网格纹理,在 Sekai 上 250 帧内变暗直至全黑;经 Fréchet Forcing 微调的 MiniWorld-1B-FF 到 4000 帧仍保持场景连贯,且 4000 帧超过其 381 帧微调视野 10 倍以上。
这是论文的核心效果图,一图直观呈现「训练视野之外的漂移」这一核心问题及方法带来的质的差别,是理解全文动机与结论的起点。