History Forcing:面向长时程视频世界模型的历史引导蒸馏框架 History Forcing: Distilling History-Dependent Continuations for Long-Horizon Video World Models
用教师有/无历史两次预测的残差解耦历史监督,实现长视频一致与视角回访状态保持
前置知识
扩散模型的 score / velocity 参数化
扩散模型对干净数据加噪得到 $x_t=\alpha_t x_0+\sigma_t\epsilon$,网络学习逐步去噪。流匹配常用线性插值,网络预测速度 $v_t=\epsilon-x_0$;由 $\hat{v}_t$ 可反推 $\hat{x}_0=x_t-\sigma_t\hat{v}_t$,再按 $s(x_t,t)\approx(\alpha_t\hat{x}_0-x_t)/\sigma_t^2$ 从去噪预测估计 score。
History Forcing 的历史残差全部定义在 score 或 velocity 空间,不理解这两种参数化就无法看懂它的目标构造公式。
分布匹配蒸馏(DMD)
DMD 让少步生成器匹配预训练扩散模型的输出分布,最小化 $\mathbb{E}_t[D_{KL}(q_{\theta,t}\|p_{ref,t})]$,梯度近似 $\nabla_\theta L_{DMD}\approx\mathbb{E}[w_t\alpha_t J_\theta^\top(s_{fake}-s_{ref})]$。$s_{ref}$ 由冻结的预训练教师估计,$s_{fake}$ 由在学生自己生成的样本上在线训练的去噪器估计。
长视频实验正是在 DMD 框架里把参考 score 替换成历史修正后的 $s_{HF}$,fake-score 训练与权重均保持不变。
自回归视频扩散
3D VAE 把视频压成时空压缩的 latent 帧序列,模型按 chunk(连续若干 latent 帧)逐段去噪生成,分布分解为 $p_\theta(x_{1:N}^0)=\prod_i p_\theta(x_i^0|x_{<i}^0)$,每段以前文 chunk 为条件,用 KV cache 维护上下文窗口。
外观漂移、误差累积、物体离开视野后信息丢失等问题都产生于这种逐 chunk 滚动生成结构,是本文要解决的对象。
Classifier-Free Guidance(CFG)
CFG 用同一个模型在有无条件两种输入下的预测差 $\epsilon_{cond}-\epsilon_{uncond}$ 放大条件的影响,数学上等价于对输出分布按条件似然做指数加权后再归一化,$\lambda$ 控制增强强度。
本文核心公式 $s_{HF}=s_{ref}+\lambda(s^+_{AR}-s^-_{AR})$ 就是把 CFG 思想从"文本条件"迁移到"历史条件",论文明确自称受 CFG 启发。
On-policy 自蒸馏与 EMA 教师(OPSD)
在学生自身 rollout 的采样上训练以消除 exposure bias,用学生的指数滑动平均(EMA)副本作教师提供监督目标,如 $v_{HF}=v^-_{EMA}+\lambda(v^+_{EMA}-v^-_{EMA})$,配合 stop-gradient 的 MSE 损失更新学生,无需额外训练 fake-score 模型。
视线外世界模型实验采用这条路线:少步蒸馏后的生成器在任意噪声水平上不是可靠的 score 教师,所以必须用 OPSD-V 式的速度监督。
VBench / VBench-Long 基准
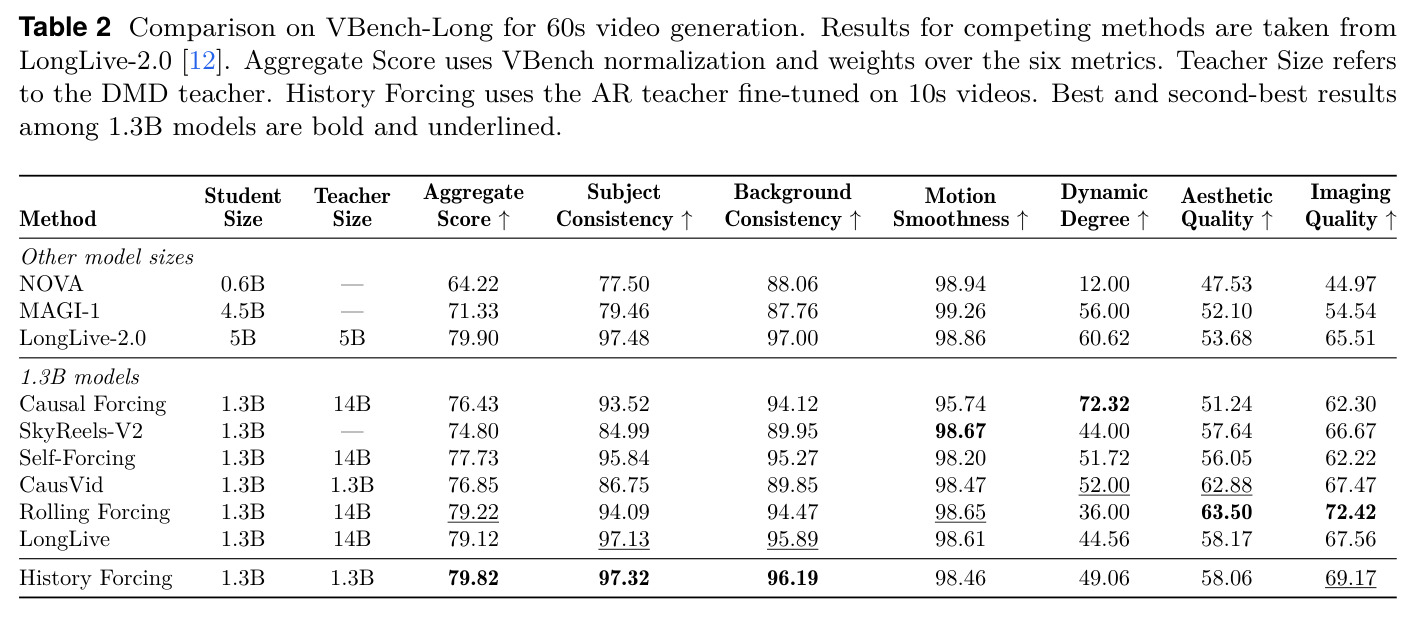
视频生成质量评测基准。Quality Score 聚合主体一致性、背景一致性、时间闪烁、运动平滑、动态程度、美学质量、成像质量等维度;VBench-Long 面向 60 秒长视频,用 MovieGenBench 的 1003 条 prompt 评测,聚合六个指标的加权分。
本文 15 秒(85.07)与 60 秒(79.82)的核心成绩都来自这套基准,读实验表必须知道各维度含义。
研究动机
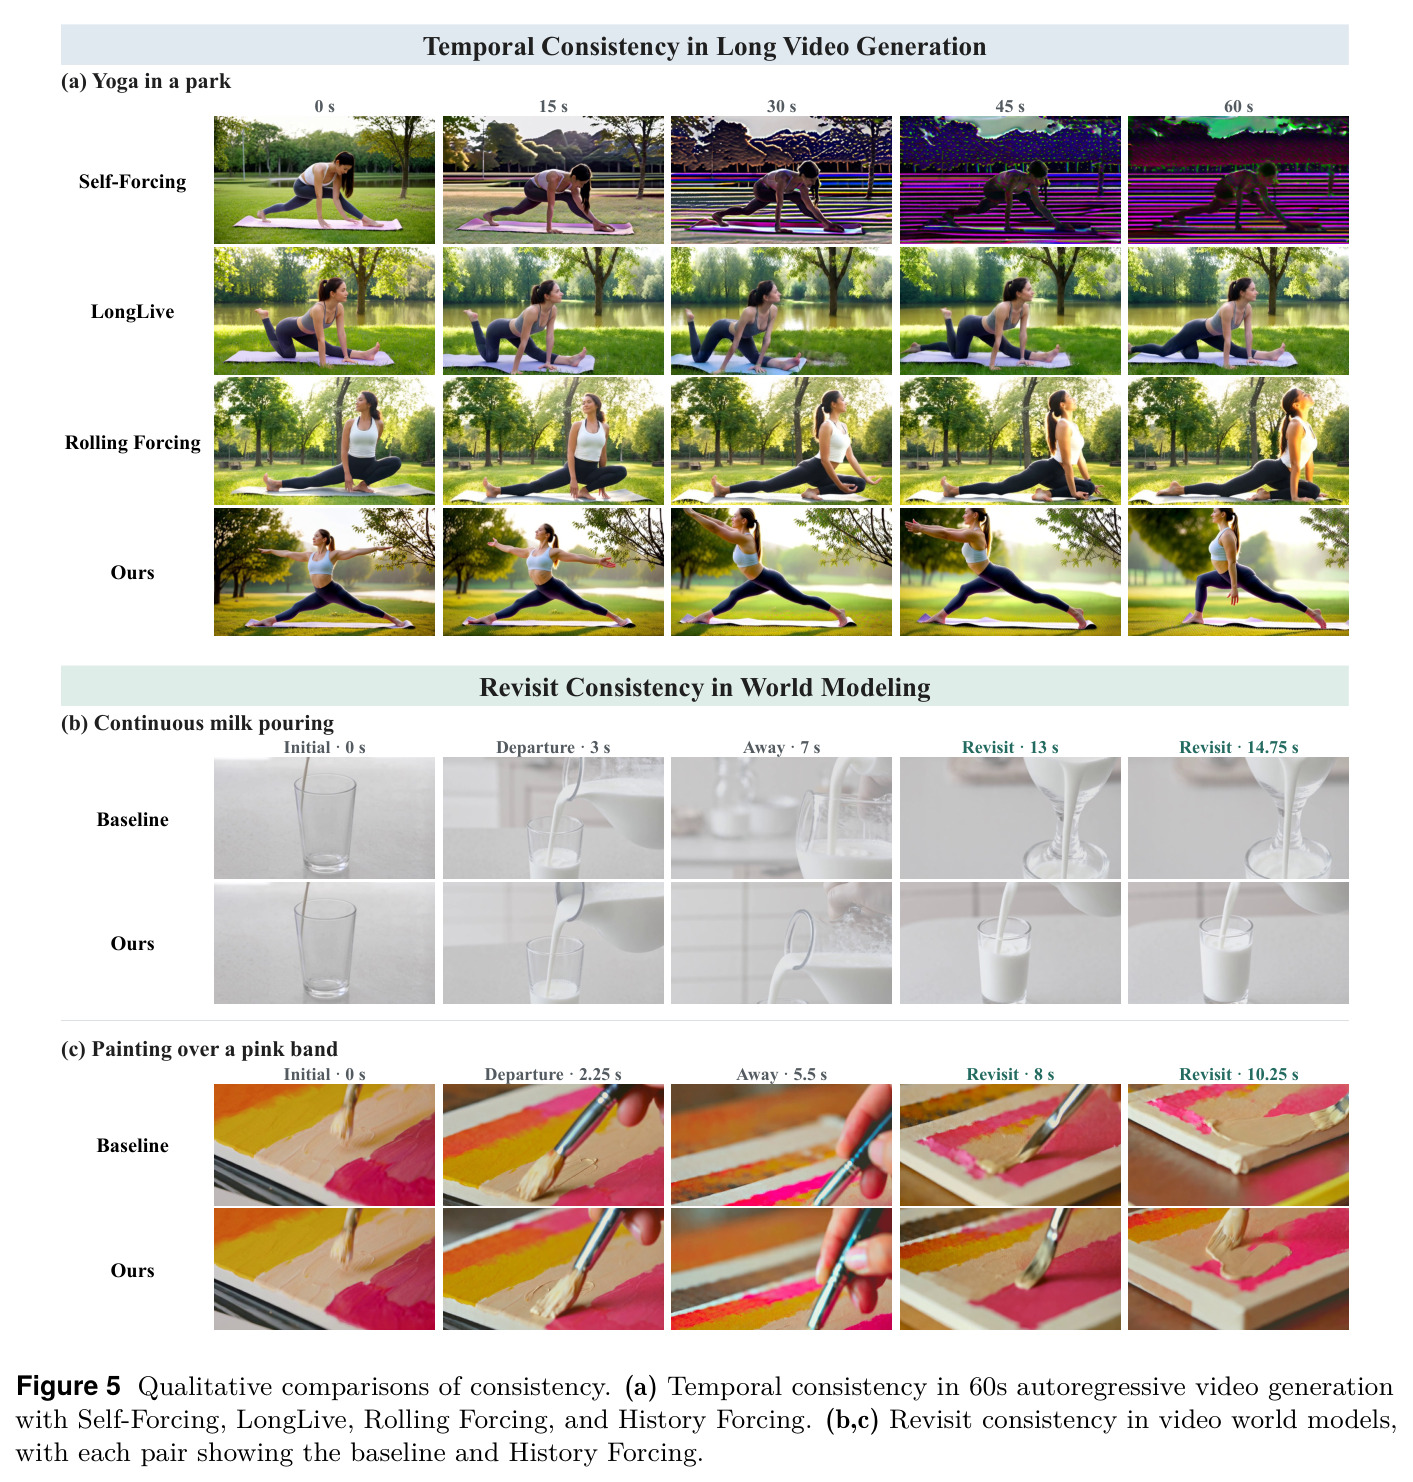
少步自回归视频扩散(CausVid、Self Forcing 一系)让长视频生成变得高效,但滚动生成中误差不断累积:主体外观逐渐漂移、场景布局悄悄改变,60 秒的 rollout 里人物四肢可能重复、山体纹理持续变化。在视频世界模型中问题更尖锐——物体离开视野后可能几十秒才重新出现,此时最近的帧几乎不含它的任何信息,基线模型常出现物体凭空消失或状态回退(比如玻璃杯形状被改、彩色条纹布局变化)。现有蒸馏范式各有一块短板:DMD 用双向扩散教师提供高质量监督,但教师的预测根本"看不见"远处的自回归历史;而 Causal Forcing、Context Forcing、OPSD-V 等直接用带历史条件的 AR 教师做完整蒸馏目标,又把时序一致性与视觉质量绑在同一个目标里(作者称为 history–quality coupling),AR 教师自身的画质缺陷会传染给学生。数据上,Self-Forcing++ 式基线的 15 秒 VBench 质量分只有 84.44,MemoBench 物体一致性仅 58.43,PlayWorld 演化质量只有 2.35(满分 5),说明历史信息远未被充分利用。
本文的目标是本文的目标是把"历史约束"从"生成质量监督"中解耦出来并单独加强:在不牺牲双向教师画质监督的前提下,把长程历史信息显式注入蒸馏目标,让学生学会生成与历史观察一致的内容。具体拆成两个任务验证:一是长视频生成——用学生 rollout 中更早的 chunk 作为历史,抑制时间漂移;二是视线外世界建模——当相机离开某区域再回访时,学生应正确建模未观测期间场景的演化并保持物体恒存性(object permanence)。工程上还要求同一框架统一覆盖 DMD 与 on-policy 自蒸馏两类目标、兼容既有长视频训练策略,且额外开销可忽略(最终做到训练时间 +2.31%、显存 +1.99%),并在 1.3B 规模上取得 SOTA。
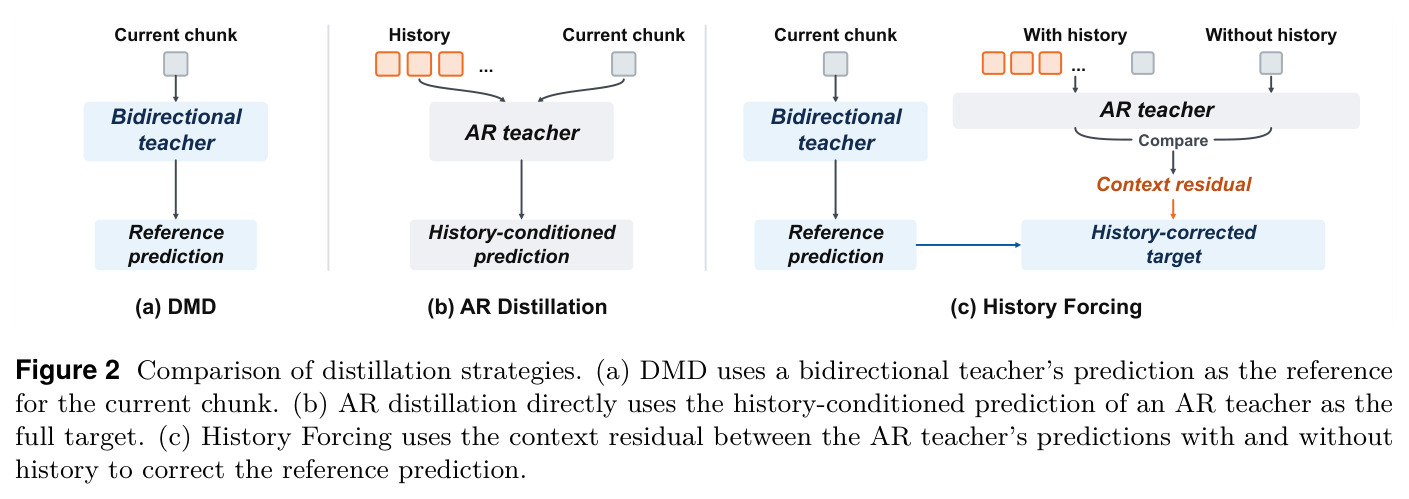
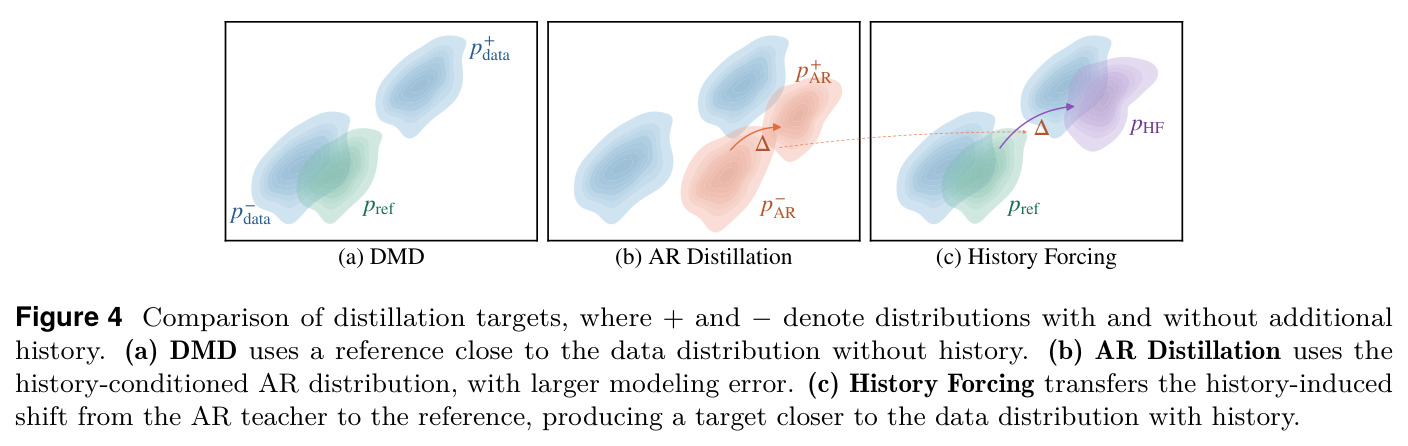
与已有工作不同的是,独特的切入角度是"做差而不是匹配"。既有方法要么完全不用历史(DMD),要么匹配带历史 AR 教师的完整条件分布(历史-质量耦合)。History Forcing 让同一个冻结 AR 教师对同一个噪声 chunk、同一扩散时刻预测两次:一次输入 (额外历史 h, 共享上下文 c),一次只输入 c,取两次 score 预测的残差 $s^+_{AR}-s^-_{AR}$——这个差值恰好把"历史带来的影响"从教师的整体生成能力中隔离出来;再以 CFG 的方式按 $\lambda$ 加权叠加到双向参考 score 上。经贝叶斯展开,这等价于沿 $\nabla\log p_{AR}(h_i|x_t,c)$(提高历史后验密度的方向)对参考分布做重加权。历史监督由此变成一个可加、可调权、可插入任意 on-policy 蒸馏目标的独立模块,这是与 History-Guided Video Diffusion(只在采样期组合不同历史条件)等工作的本质区别。
核心方法
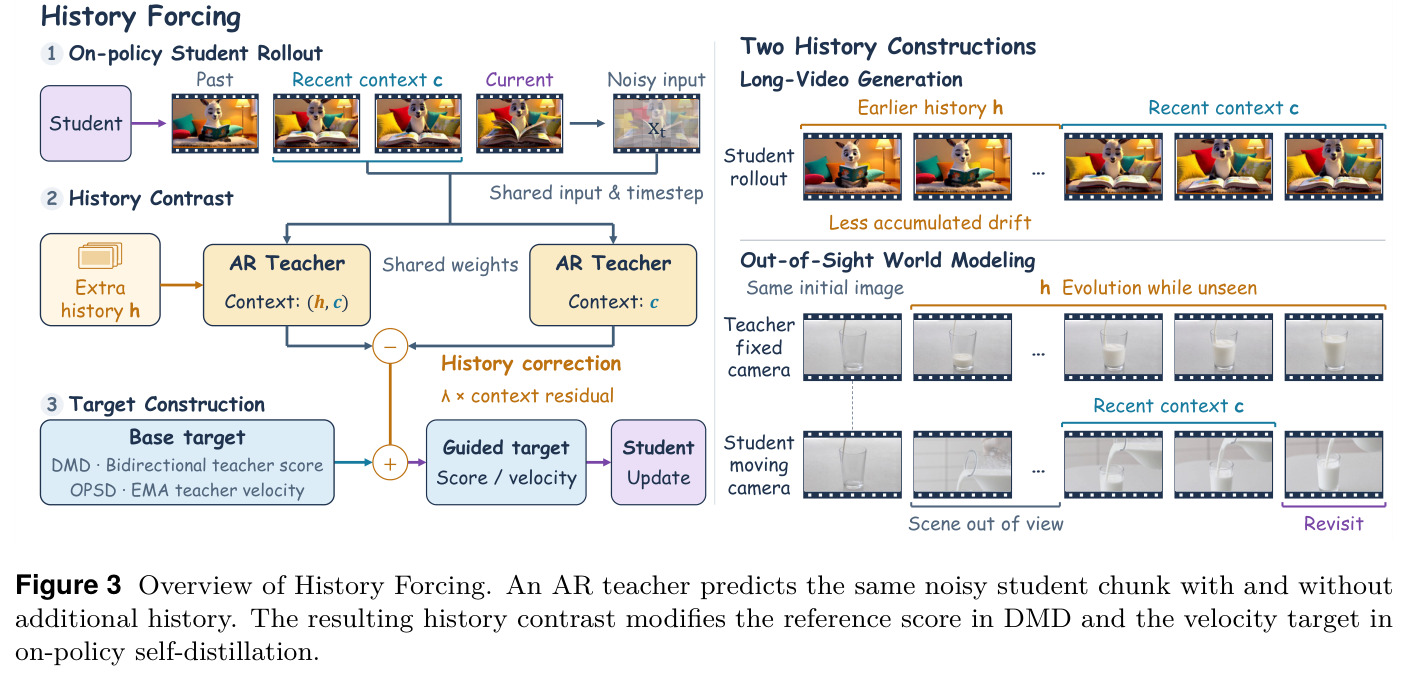
直觉上,作者问了一个 CFG 式的问题:"如果我告诉 AR 教师更早发生了什么,它的预测会改变多少?"这个"改变量"正是被提纯的历史信息。技术路线分三步。第一步 on-policy 学生 rollout:学生用自己的推理采样流程(4 步 SDE)滚动生成 5–15 秒视频,DMD 监督只落在最后 5 秒窗口。第二步历史对照:冻结的 AR 教师对同一个噪声 chunk、同一扩散时刻做两次预测,两次输入共享最近 6 个学生 latent 帧 c,其中一路额外拼接此前 12 个连续 latent 帧作为额外历史 h,取 score 差得到历史残差,再按 $\lambda$ 加权。第三步目标构造与更新:长视频任务在 DMD 中用 $s_{HF}=s_{ref}+\lambda(s^+_{AR}-s^-_{AR})$ 替换参考 score;视线外任务在 OPSD-V 自蒸馏中用 $v_{HF}=v^-_{EMA}+\lambda(v^+_{EMA}-v^-_{EMA})$ 修正 EMA 速度目标,以带 stop-gradient 的 MSE 更新学生。历史来源因任务而异:长视频用共享上下文之前的连续生成 chunk(累积漂移少);世界模型用教师固定机位 rollout 在 chunk 起点之前的帧,专门补上"学生看不见期间"的演化信息。
核心创新是"历史重加权分布"的构造。式 (6):$p_{HF,t}(x_t)=\frac{1}{Z_t}p_{ref,t}(x_t)\left(\frac{p^+_{AR,t}(x_t)}{p^-_{AR,t}(x_t)}\right)^\lambda$,即在参考分布上乘以 AR 教师有/无历史的似然比的 $\lambda$ 次幂。利用贝叶斯公式,比值可改写为 $p_{AR,t}(h_i|x_t,c)/p_{AR}(h_i|c)$,于是 $s_{HF}=s_{ref}+\lambda\nabla_{x_t}\log p_{AR,t}(h_i|x_t,c)$:第二项正是"提高 AR 教师认为该段历史能出现"的后验梯度方向。与 DMD 相比,这显式引入了远处历史;与直接匹配 $p^+$ 的 AR 蒸馏相比,参考分布 $p_{ref}$ 仍然全权负责视觉质量,历史只以梯度修正形式进入,两者彻底解耦;最小化 $\mathcal{L}_{HF}=\mathbb{E}_t[D_{KL}(q_{\theta,t}\|p_{HF,t})]$ 等价于最大化 $J_t(\theta)=-D_{KL}(q_{\theta,t}\|p_{ref,t})+\lambda\,\mathbb{E}[\log p_{AR,t}(h_i|x_t,c)]$,即"匹配高质量参考分布 + 与额外历史保持一致"两项各司其职。
方法步骤详情
长视频生成流程:(1) 初始化——双向 DMD 教师与 fake-score 模型取 Wan2.1-T2V-1.3B 权重,学生取 Causal Forcing 因果 ODE checkpoint,AR 教师取 Causal Forcing 多步 AR 扩散 checkpoint(5s 版注意力窗 21 个 latent 帧;再在 UltraVideo-Long 的 10s 片段上以 teacher forcing 微调 2500 步得到 10s 版,窗 42)。(2) 学生 rollout 5–15 秒均匀采样,在 DMD 监督窗内随机抽 1 个合格 chunk 施加历史监督。(3) 两次 AR 教师预测共享最近 6 个 latent 帧,历史条件输入额外拼 12 个更早的连续 latent 帧;两路 KV cache 分离但当前 chunk 的时间位置对齐;同一噪声、同一 timestep,$\lambda=1$,仅在 shifted timestep $t<750$ 施加。(4) 按式 (9) $\nabla_\theta\mathcal{L}_{HF}\approx\mathbb{E}[w_t\alpha_t J_\theta^\top(s_{fake}-s_{HF})]$ 更新学生,采用 joint 归一化(历史项并入 DMD 梯度归一化因子)。超参:学生 lr $2\times10^{-6}$、fake-score lr $4\times10^{-7}$、有效 batch 64、EMA decay 0.99(第 200 步启用)、共 300 步、8×A100。视线外世界模型:(1) 从 DreamX-World-5B 出发,200 张 Pexels 初始场景 × 4 条"离开再回原点"相机轨迹共 800 样本。(2) 在线生成学生 rollout 与教师固定机位 rollout(共享初始噪声与 SDE 噪声),取教师 rollout 中 chunk 起点之前最多 4 个 latent 帧为 h,共享上下文缩至 4 帧。(3) EMA 教师(decay 0.9999)做两次速度预测得 $v_{HF}$,对回访 chunk 的全部 4 个去噪步以 MSE(式 11)更新;LoRA rank 64、$\alpha=128$、lr $1\times10^{-5}$、100 步、$\lambda=3$。
技术新颖性
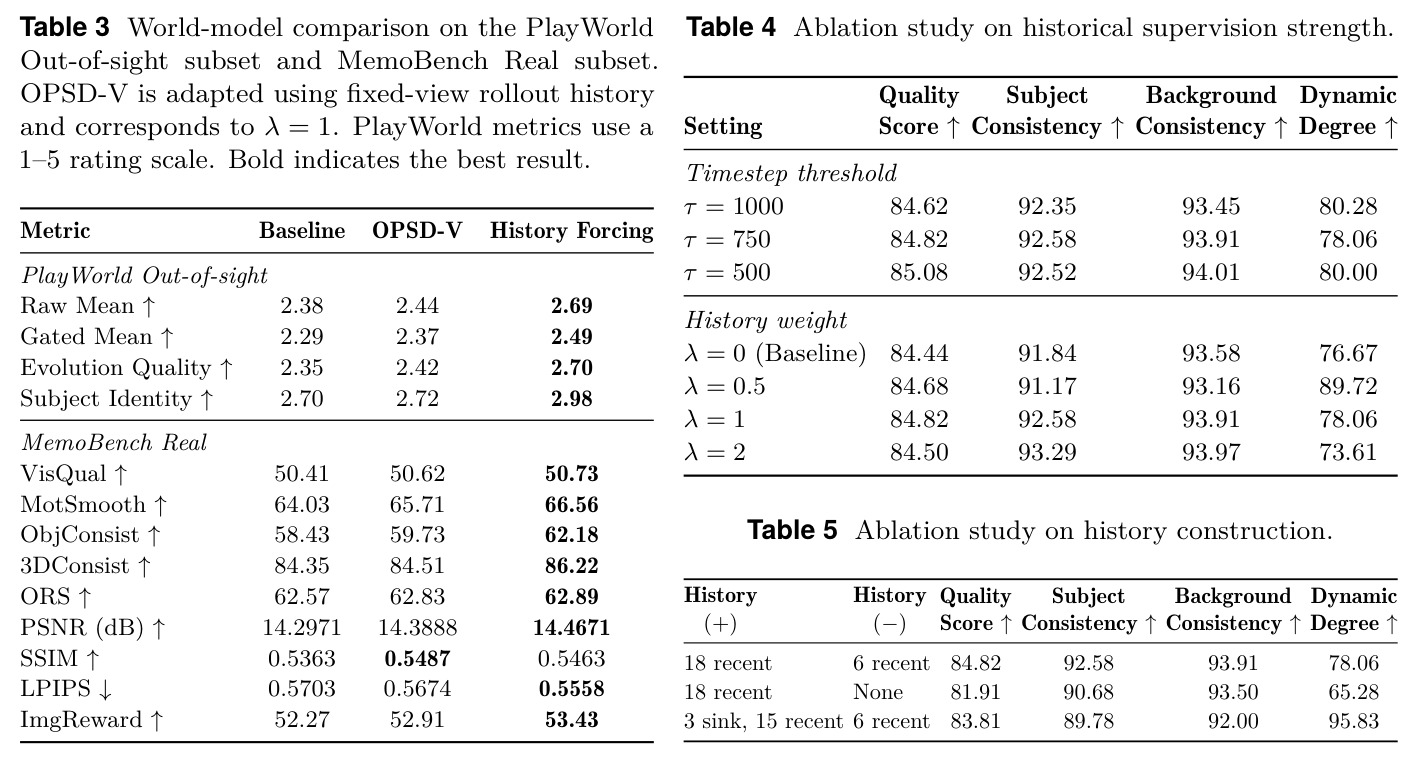
新颖性有三层。公式层面:把 CFG 的"条件预测差 = 对数似然梯度"恒等式迁移到时间维历史条件,给出明确的目标分布 $p_{HF}\propto p_{ref}(p^+/p^-)^\lambda$,历史监督从启发式加权升级为分布重加权,且有"后验梯度"的可解释形式。系统层面:同一残差构造可同时插入 DMD(score 空间)与 OPSD 自蒸馏(velocity 空间),并与 Self-Forcing++ 的长 rollout 训练策略兼容,是真正的统一框架而非单点技巧。工程层面:两路 AR 教师预测使用分离 KV cache 并对齐当前 chunk 的 KV 位置、共享最近 6 帧以维持自回归连续性、每个 iteration 只对 1 个采样 chunk 施加历史监督,把开销压到 +2.31% 时间 / +1.99% 显存。消融数字也反向印证设计必要性:去掉负路径的共享 6 帧,质量分从 84.82 暴跌到 81.91;用 3 个 sink 帧替代最老 3 帧历史,降到 83.81——说明"连续更早 chunk + 共享近期上下文"的构造是性能来源。
实验结果
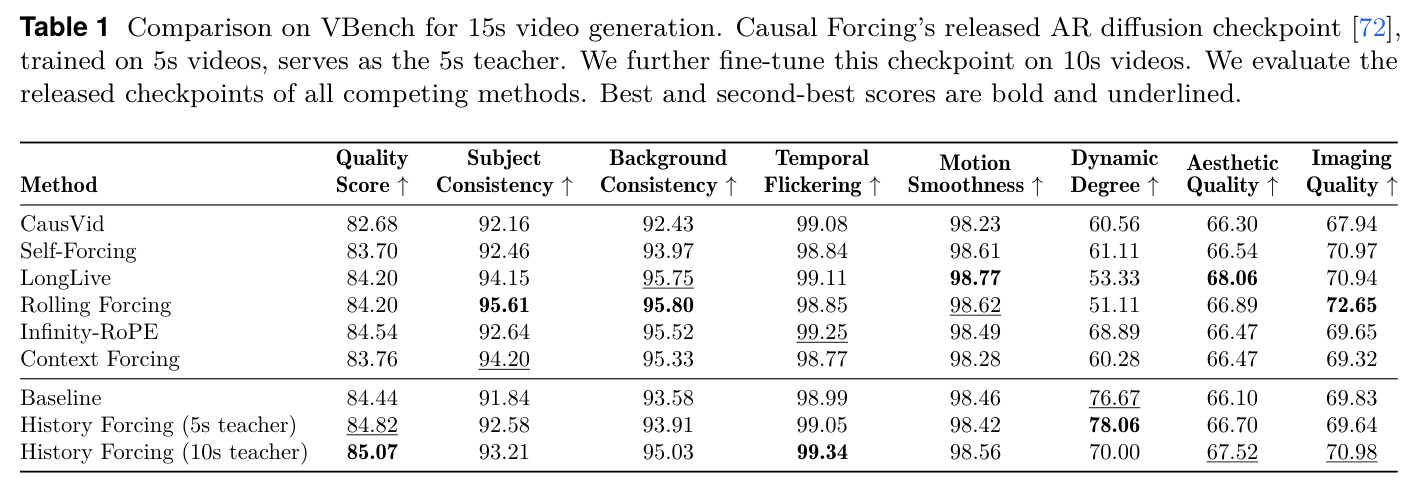
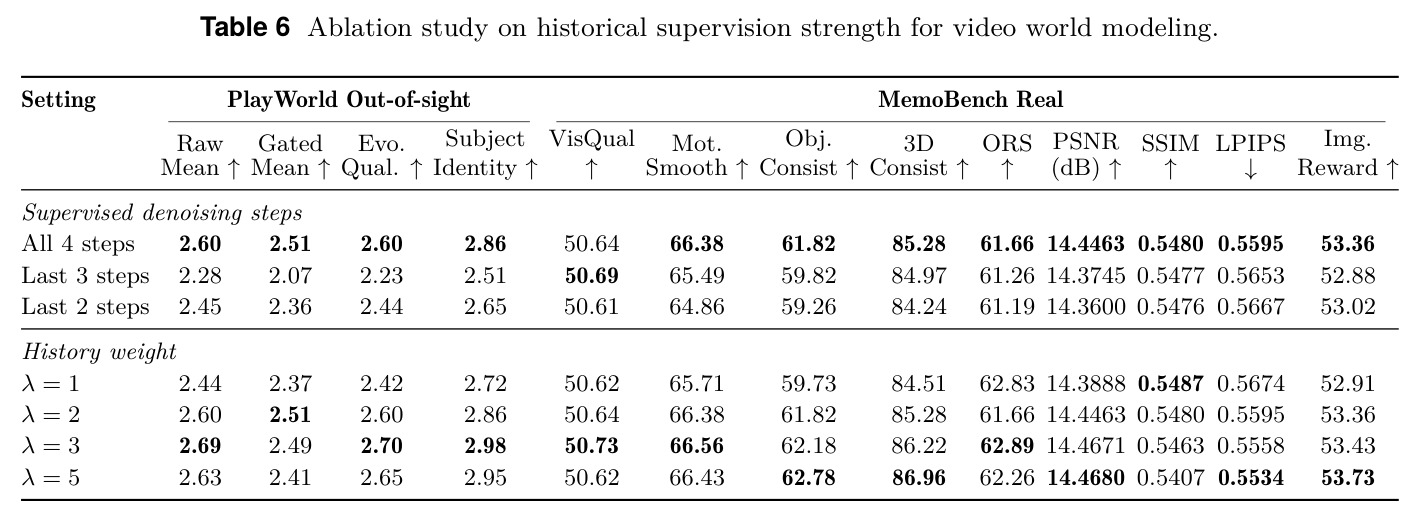
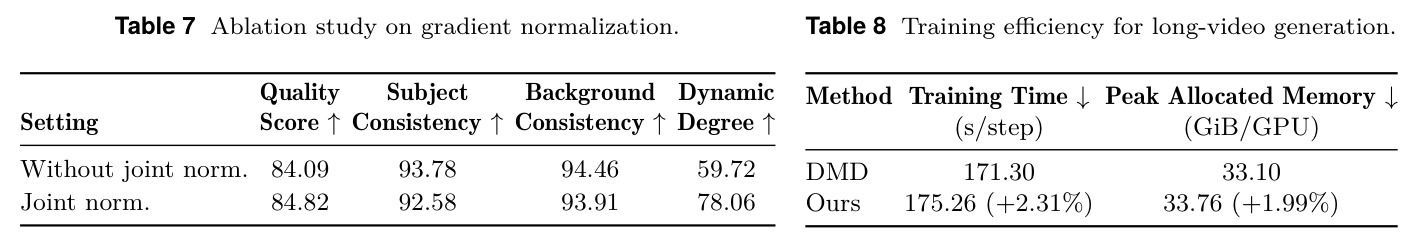
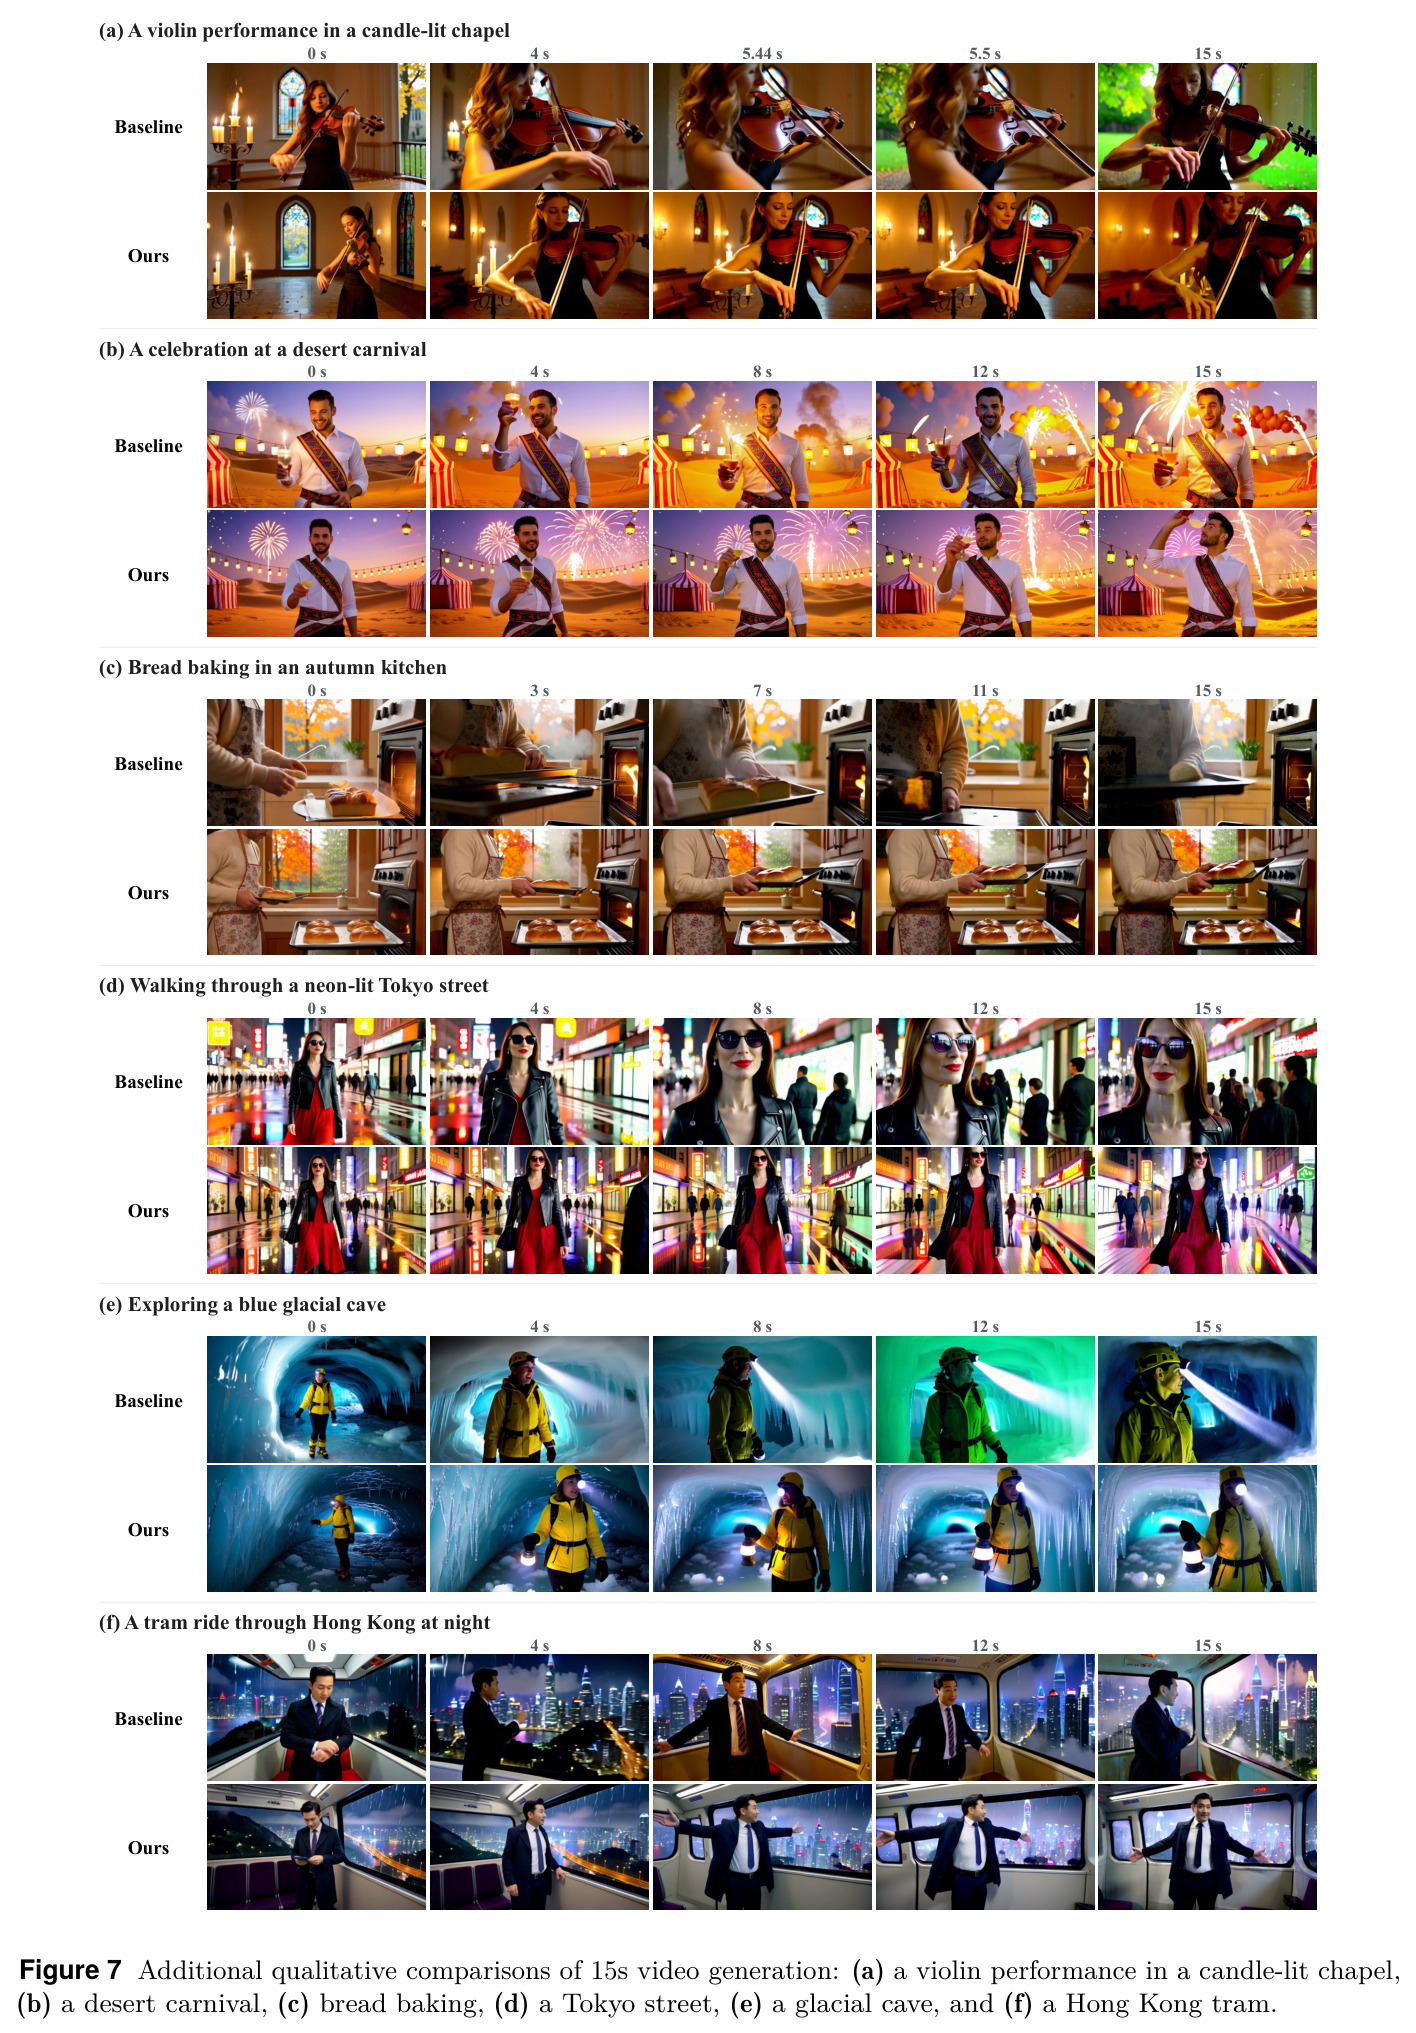
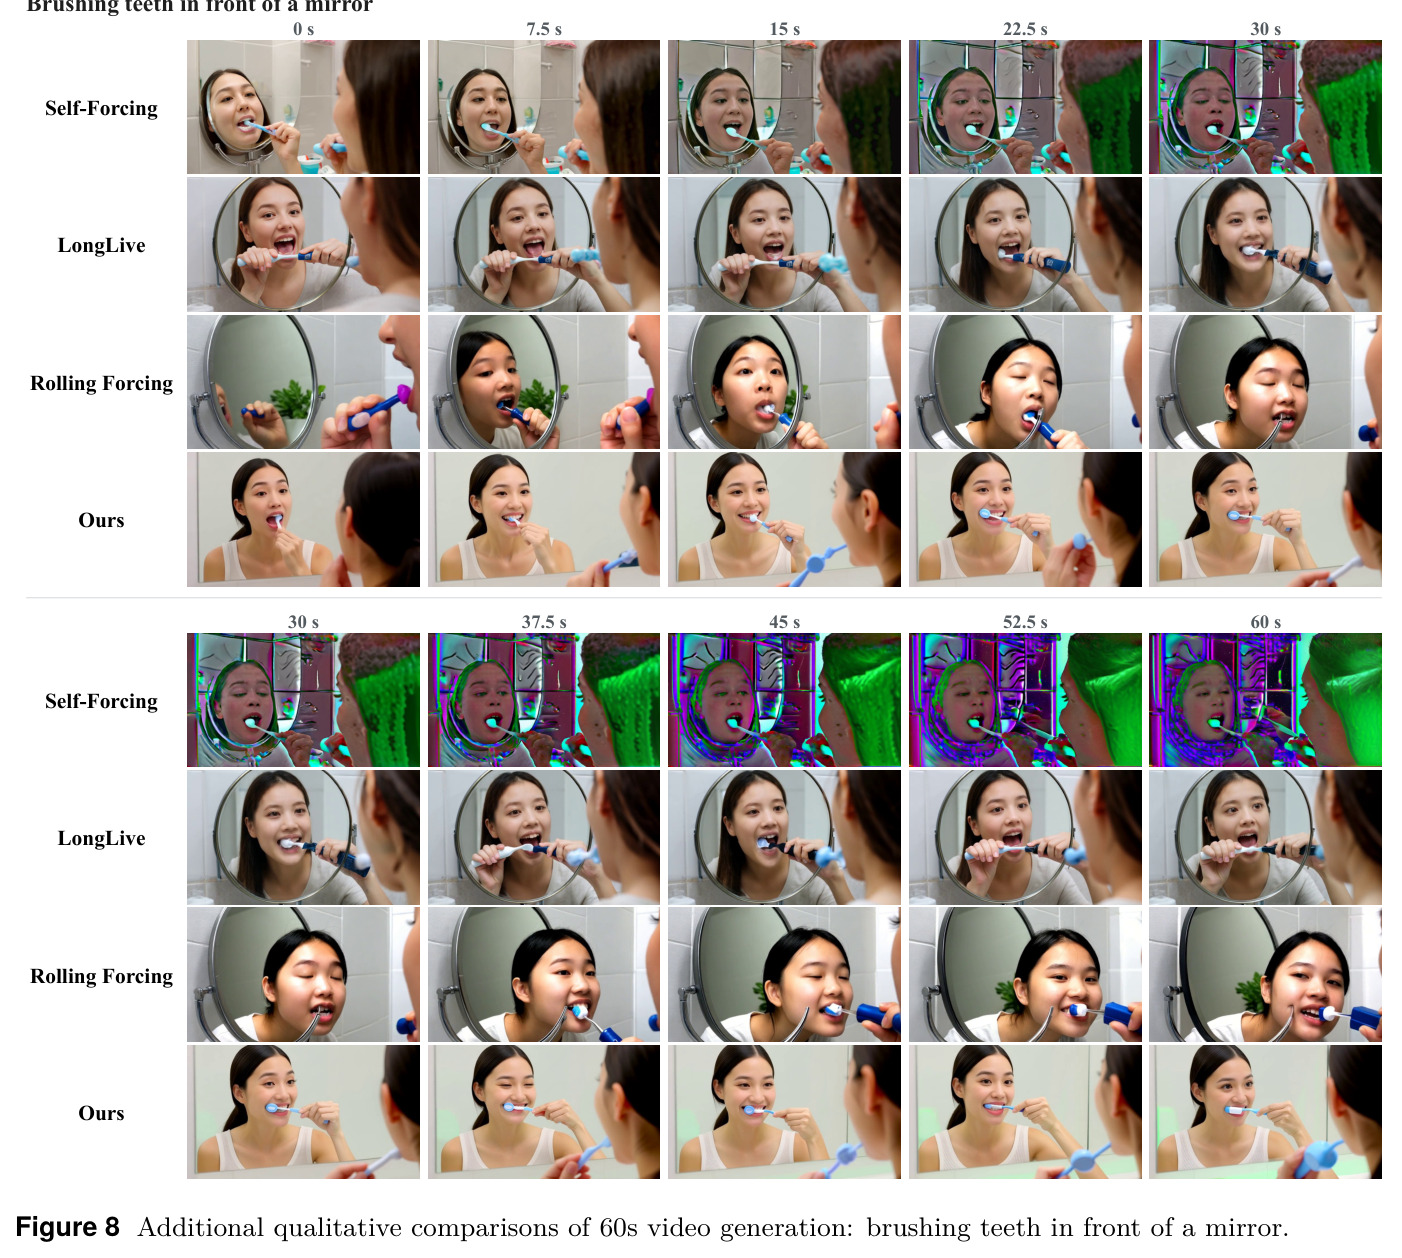
15 秒生成(Table 1,VBench,Wan2.1 增强 prompt、每条 5 个视频):基线质量分 84.44,History Forcing(5s AR 教师)升至 84.82,10s 教师版达 85.07,为全部对比方法(含 LongLive 84.20、Rolling Forcing 84.20、Infinity-RoPE 84.54)最高;主体一致性 91.84→93.21,背景一致性 93.58→95.03,时间闪烁 98.99→99.34,成像质量 69.83→70.98;代价是动态程度 76.67→70.00。60 秒生成(Table 2,VBench-Long,MovieGenBench 全量 1003 条 prompt、每条 rollout 1005 帧):在 1.3B 学生中聚合分最高 79.82,超过用 14B DMD 教师的 Rolling Forcing(79.22)和 LongLive(79.12),逼近 5B 的 LongLive-2.0(79.90);主体一致性 97.32、背景一致性 96.19 均为 1.3B 组最佳,而训练 rollout 仅 ≤15 秒(LongLive 需 60 秒流式长训)。视线外世界模型(Table 3):PlayWorld Out-of-sight 子集(43 例,1–5 分 VLM 评分)Evolution Quality 2.35→2.70、Subject Identity 2.70→2.98、Raw Mean 2.38→2.69,四项全部最优;MemoBench Real 子集(164 条)对基线 9 项指标全部提升、对 OPSD-V 8/9 项占优,物体一致性 58.43→62.18,3D 一致性 84.35→86.22,PSNR 14.2971→14.4671 dB。消融(Tables 4–7):timestep 阈值 $\tau=500$ 质量分最高 85.08、$\tau=750$ 主体一致性最高 92.58,说明历史监督宜集中在低噪声段;$\lambda=1$ 质量最优;joint 归一化使质量分 84.09→84.82、动态程度 59.72→78.06;世界模型侧 $\lambda=3$ 最优、4 个去噪步全监督(Evolution Quality 2.60)明显好于只监督最后 3 步(2.23)或 2 步(2.44)。Table 8 显示训练开销仅 +2.31%(175.26 s/step)与 +1.99% 显存(33.76 GiB)。
局限与改进
作者承认的局限:长视频实验限于 1.3B 教师/学生、世界模型限于 5B backbone;历史监督的质量受底层模型时序建模能力制约——固定机位教师 rollout 本身可能带时序错误、且场景演化有限(离场期间该发生的物理变化未必演化出来),此时"历史"本身不准确,会削弱视线外状态监督甚至引入偏差。我的补充观察:(1) 一致性与动态程度存在此消彼长,Table 1 中动态程度从 76.67 降到 70.00,而 $\lambda$ 是全局标量,无法按 chunk 或时间步自适应;(2) 训练需同时驻留双向教师、AR 教师、fake-score 三个 1.3B 模型(33.76 GiB/卡),对显存预算不宽裕的团队不友好;(3) PlayWorld 用 VLM(Doubao Seed 2.0 Lite)打分,最好成绩 2.70(满分 5)的绝对水平仍低,且未做人工评测验证 VLM 分数与人类感知的相关性;(4) 世界模型训练集仅 800 条(200 图 × 4 条轨迹),轨迹类型限于左/右旋转或平移后回原点,复杂相机路径与多物体交互场景未验证;(5) 视线外演化的监督本质是"教师替你看一眼",对教师自身不理解的物理过程无能为力,这不是框架能单独解决的问题。
独立分析的弱点
(1) 监督信号来自"另一个模型"而非真实世界:固定机位教师 rollout 若演化错误(如沙子倒在了罐子外),学生会把错误固化进权重。改进方向:混入真实回归视频作为历史(OPSD-V 原本就用真实视频)、对教师 rollout 做物理合理性过滤或置信度加权,让 $\lambda$ 随 chunk 质量动态调整。(2) $\lambda$ 全局静态:长视频任务 $\lambda=1$、世界模型 $\lambda=3$ 都是离线调参结果,快运动与静态场景的最优值理应不同,可按残差范数归一化后自适应缩放,或按时间步调度。(3) 历史窗口太短:AR 教师注意力窗仅 21/42 个 latent 帧,60 秒生成时最早的信息必然被挤出窗口;sink 帧实验(3 sink + 15 recent 反而降到 83.81)说明帧选择策略仍粗糙,可引入 VMem 式几何索引检索或压缩记忆 token 来扩展有效历史。(4) 一致性-动态性权衡未真正解决:joint 归一化把动态程度提到 78.06 但一致性略降,可为运动显著区域降低历史权重(空间自适应 mask),或对残差做频域分解只约束低频外观。(5) 评测可信度:VBench-Long 数字转引自 LongLive-2.0 论文,PlayWorld 仅 43 例且依赖单一 VLM 评委,需要人类评测与超过 60 秒的更长 horizon 测试。(6) 监督只在 revisit chunk 施加,离场期间的中间演化完全没有约束,可以把监督扩展到整段离场轨迹的中间状态。每个弱点都指向同一深层问题:历史监督的上限被"历史从哪来"卡死,框架本身只负责"怎么用"。
未来方向
作者明确提出的方向:扩大教师与学生规模(>1.3B / 5B)、更长上下文训练、提升世界模型对物理合理动力学的模拟能力(尤其固定机位 rollout 的演化质量)。基于本文成果可延伸的方向:(1) 把"条件差蒸馏"推广到其他条件维度——音频、文本记忆、机器人 action 条件,形成通用的 residual forcing 家族;(2) 与显式记忆机制(Memory Forcing、WorldMem、VMem 的几何索引检索)结合:残差提供训练信号,记忆模块提供更干净、更长程的历史 h,两者互补;(3) 对 partition function $Z_t$ 有界性假设做理论分析,研究 $\lambda$ 的时间/空间自适应调度与残差归一化,缓解一致性与动态性的权衡;(4) 把固定机位教师换成多机位协同或物理仿真器,获得更可靠的离场演化监督;(5) 交互式世界模型的在线学习闭环:玩家回访时把真实观察到的状态作为 h 继续训练,逐步用真实数据替换教师想象;(6) 在推理期使用残差——类比 History-Guided Video Diffusion,但基于蒸馏后的少步模型做采样时历史引导,无需重训。
复现评估
复现条件较好。代码已开源(github.com/ziplab/History-Forcing),项目页提供大量可视化示例。所有初始化权重均为公开 checkpoint:Wan2.1-T2V-1.3B(双向教师与 fake-score 起点)、Causal Forcing 的因果 ODE checkpoint(学生)与多步 AR 扩散 checkpoint(5s AR 教师)、DreamX-World-5B(世界模型基座)。数据可获得:VidProM prompt 集(过滤扩充后训练)、UltraVideo-Long 10s 片段(AR 教师微调)、Pexels 图片(200 张 × 4 条轨迹共 800 样本),评测用 VBench、VBench-Long(MovieGenBench 官方 1003 条)、MemoBench、PlayWorld 官方实现。算力门槛:长视频训练 8×A100、300 步、每步约 175 秒(总计约 14.6 小时),单节点 8 卡即可承受;世界模型更轻——仅 100 步 LoRA(rank 64),单机数小时。附录 A 披露了全部超参(lr、EMA decay 0.99/0.9999、KV 窗 21/12 帧、timestep shift 5、SDE 4 步 (1000,750,500,250)、seed 42、AdamW betas (0,0.999)),细节充分。主要障碍:需同时驻留三个模型约 34 GiB/卡;60 秒评测需生成 1003 条 × 1005 帧的视频,评测耗时不可忽视。总体属于中等偏易的复现难度。
论文图表
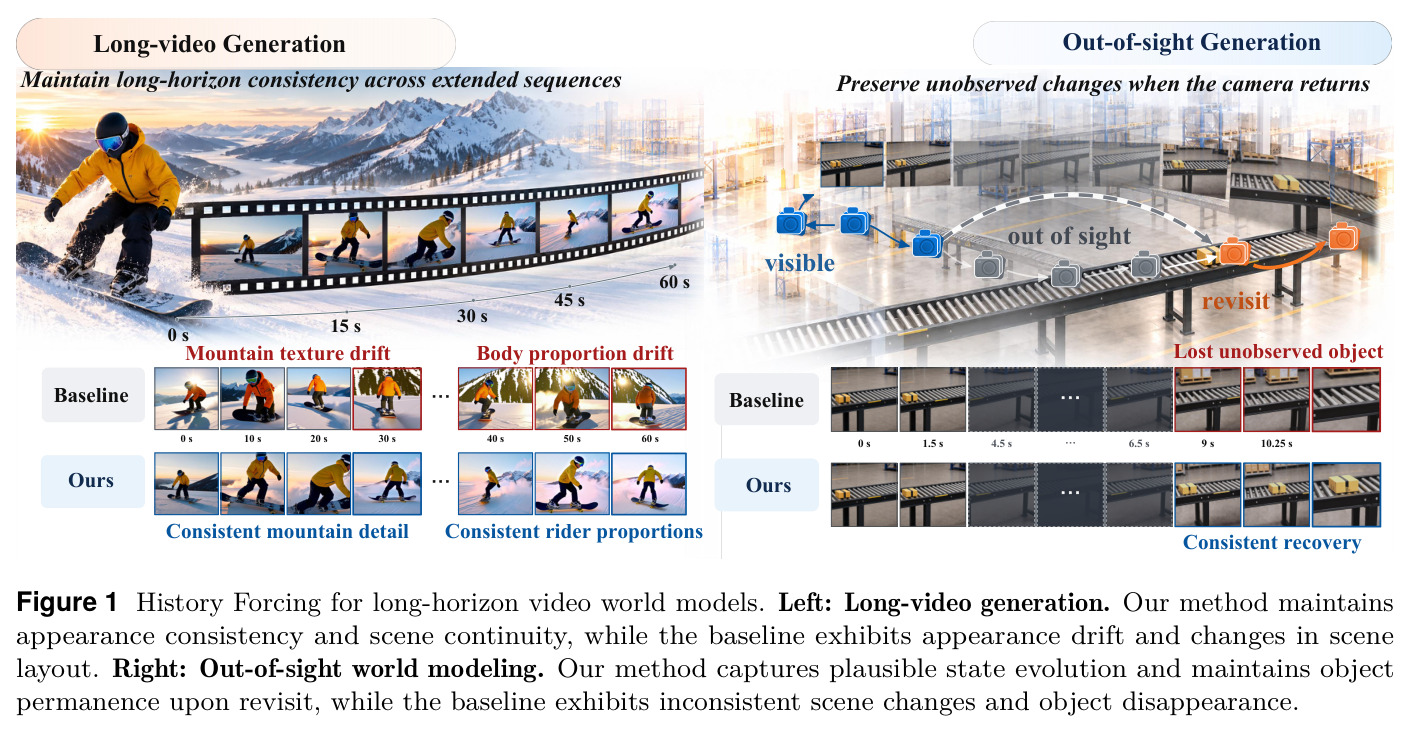
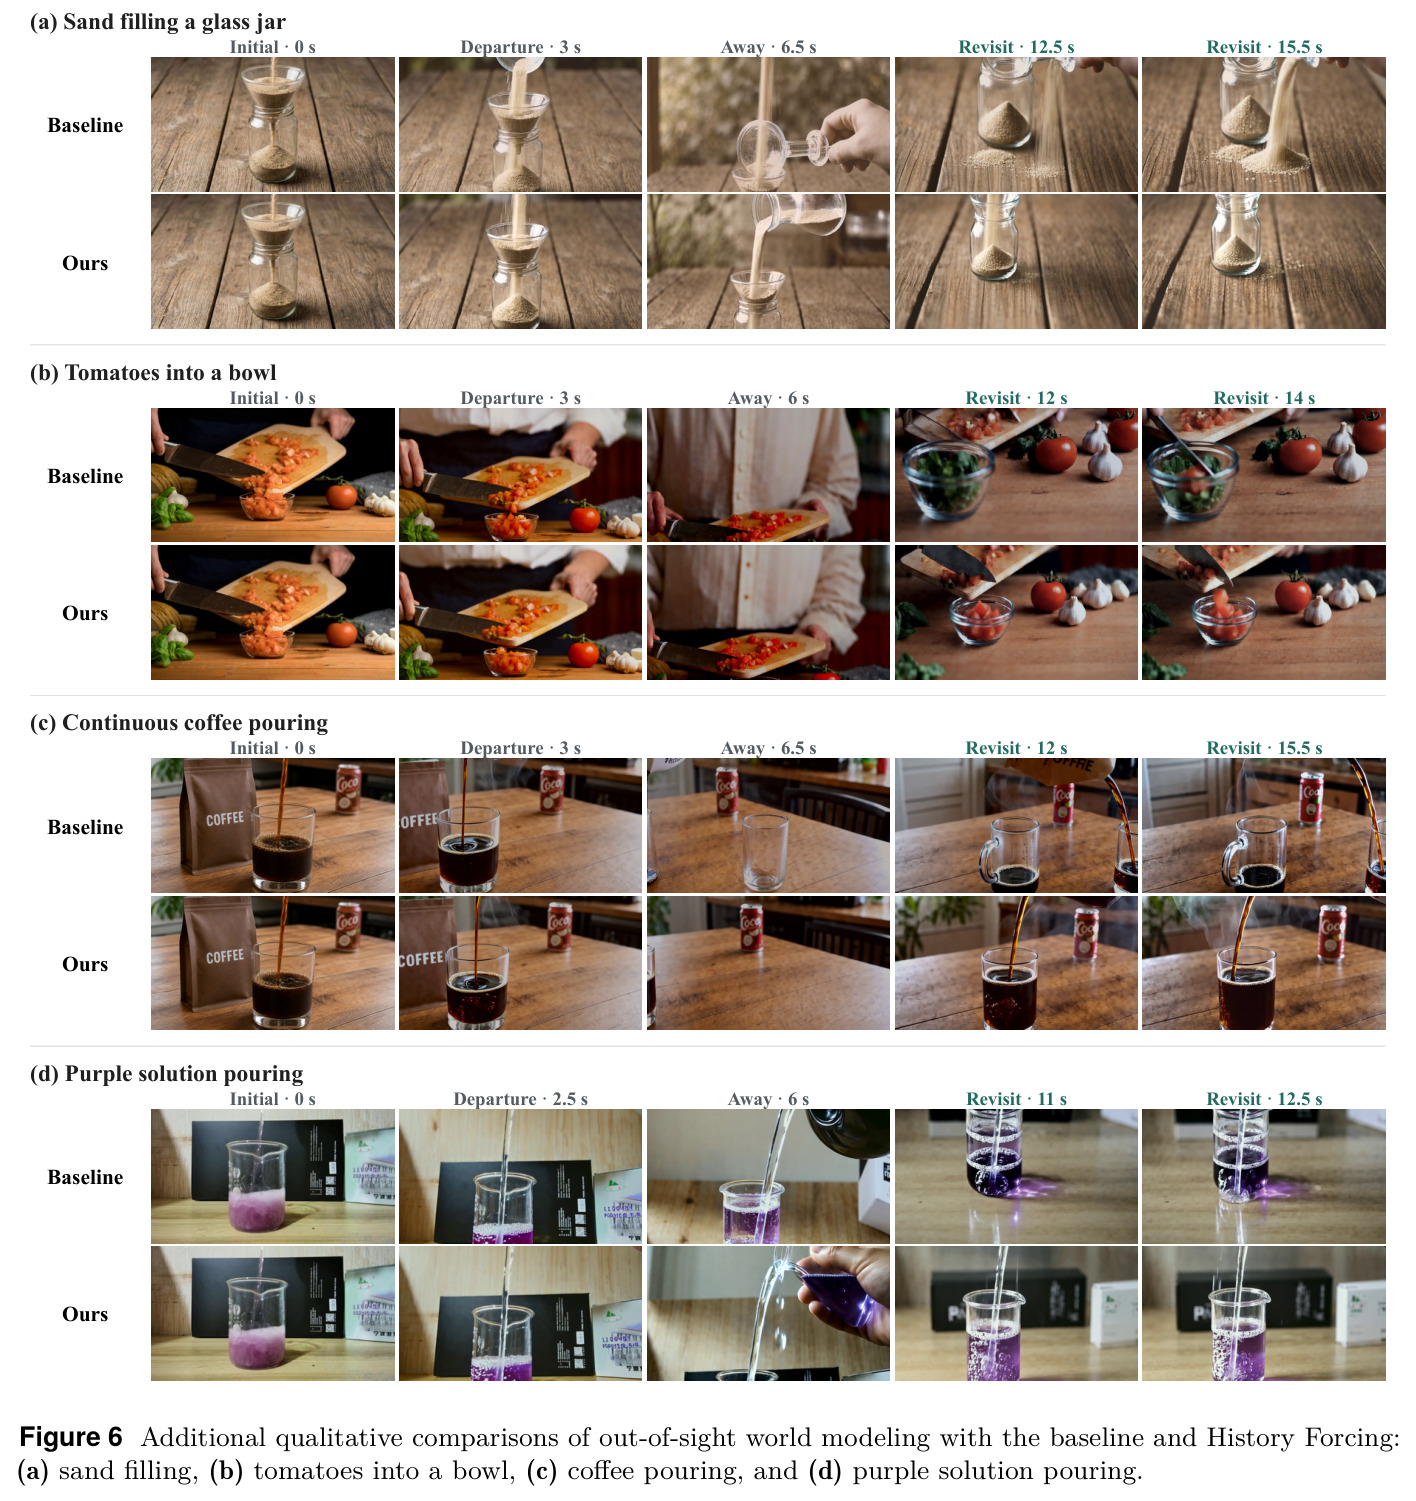
teaser 图,左右两组对比。左侧长视频生成:60 秒序列中基线出现山体纹理漂移(mountain texture drift)与人物身体比例漂移(body proportion drift),本文方法保持山体细节与骑手比例一致;右侧视线外生成:相机 0–10.25 秒间离开再回访,基线丢失了未观测期间的变化导致物体消失(lost unobserved object),本文方法回访时状态恢复一致(consistent recovery)。
一图概括论文要解决的两类失败模式(长程漂移、回访失忆)和方法带来的直观改善,是理解论文动机与价值的最快入口。
世界模型主实验。PlayWorld Out-of-sight(43 例,1–5 分):Raw Mean 2.38→2.69、Gated Mean 2.29→2.49、Evolution Quality 2.35→2.70、Subject Identity 2.70→2.98,History Forcing 四项全最优;MemoBench Real(164 条):对基线 9 项全部提升,如物体一致性 58.43→62.18、3D 一致性 84.35→86.22、PSNR 14.2971→14.4671 dB、LPIPS 0.5703→0.5558,对 OPSD-V 8/9 项占优。
证明框架不止于长视频生成,在"相机离开再回访"的世界模型场景同样有效,且优于同源的 OPSD-V 适配基线。
历史构造消融。默认配置(+侧 18 recent 帧、−侧 6 recent 帧共享)质量分 84.82;去掉 −侧的 6 个共享近期帧(18 recent vs None)暴跌至 81.91;在同等历史预算下把 +侧最老 3 帧换成初始 sink 帧(3 sink, 15 recent)降到 83.81 且主体/背景一致性均下降,动态程度反升至 95.83。
证明"共享近期上下文 + 连续更早 chunk"的历史构造不是随意选择:共享帧让残差真正隔离早期信息的贡献,sink 帧替代反而削弱外观约束。
训练效率对比:DMD 基线每步 171.30 秒、峰值显存 33.10 GiB/GPU;History Forcing 每步 175.26 秒(+2.31%)、33.76 GiB(+1.99%)。开销被控制住的关键是每个 iteration 只对 1 个随机采样的合格 chunk 施加历史监督。
回答"这套方法贵不贵":一致性增益几乎免费,这对判断方法的实用价值和工程可行性至关重要。