Wave Forcing:迈向光速的流式视频生成 Wave Forcing: Towards Speed-of-Light Streaming Video Generation
用波前流水线并行块级去噪与缓存刷新,每轮前向产出一块视频,动稳兼顾。
前置知识
Chunk-wise 自回归视频扩散
把视频在 VAE 潜空间切成若干 latent 块,按时间顺序逐块生成:当前块以历史块(缓存于 Transformer 各层的 K/V)和文本为条件,做 $S$ 步去噪后输出,再继续下一块。Self Forcing、Rolling Forcing、Causal Forcing 都属这一范式,区别在于历史如何构造、训练如何适配。
本文要解决的问题(每块 $S+1$ 次前向、store 开销、长视频漂移)全部建立在这一范式的执行流程上,不懂它就看不懂 1F1C 到底改进了什么。
DMD 分布匹配蒸馏
Distribution Matching Distillation:用分数差(教师分布得分减生成器分布得分)指导少步生成器更新,使 4-5 步即可逼近多步教师的采样质量,是 Self Forcing、Rolling Forcing、Wave Forcing 这类少步流式模型的训练基石。
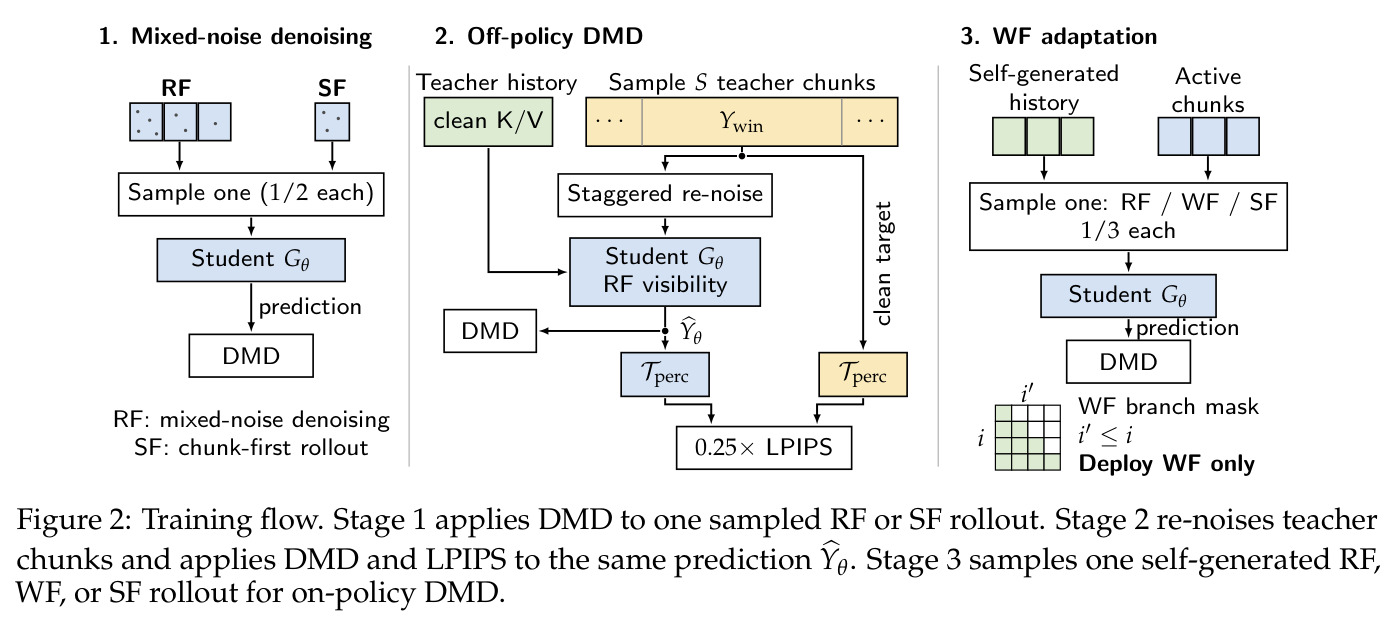
WF 三阶段训练的每个阶段都以 DMD 为主损失(Stage 2 另加 $\lambda_p=0.25$ 的 LPIPS),不理解它就看不懂训练配方为何如此设计。
KV 缓存与 store 前向
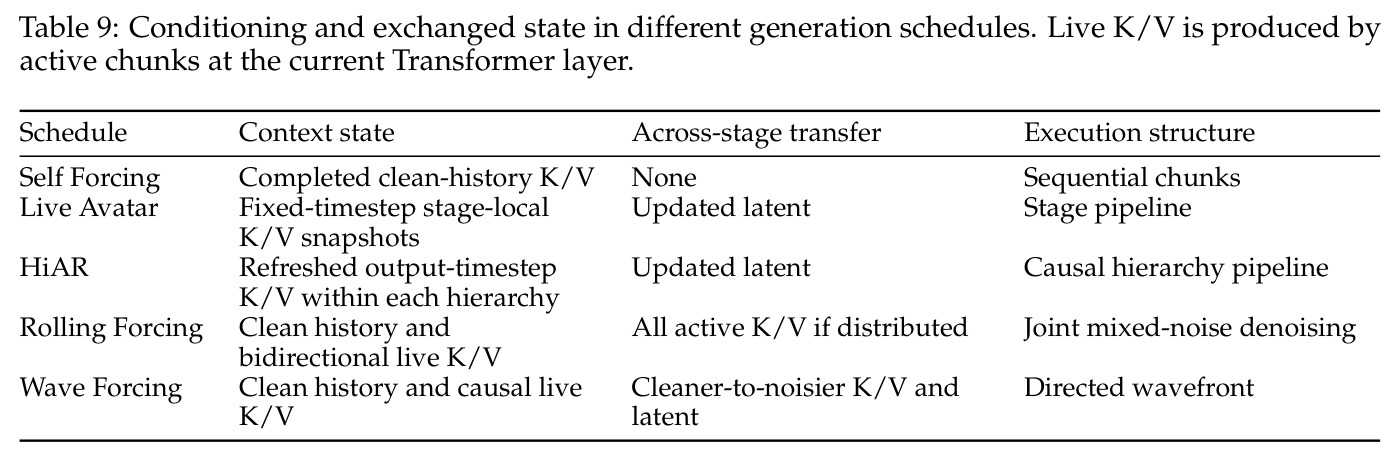
自回归推理会把历史 token 每层的 K/V 缓存起来避免重复计算。本文采用『干净历史』约定:块去噪完成后还要用干净输出再做一次全模型前向(store),把各层 K/V 刷进缓存供后续块读取。这个额外前向正是串行流程中每块 $N=S+1$ 次前向(NF1C)的来源。
store 恰是 WF 拆进流水线的那个阶段,理解它才能明白 $S+1$ 个全模型副本各自在做什么、为什么流水线宽度由去噪步数决定。
Wavefront / 软件流水线调度
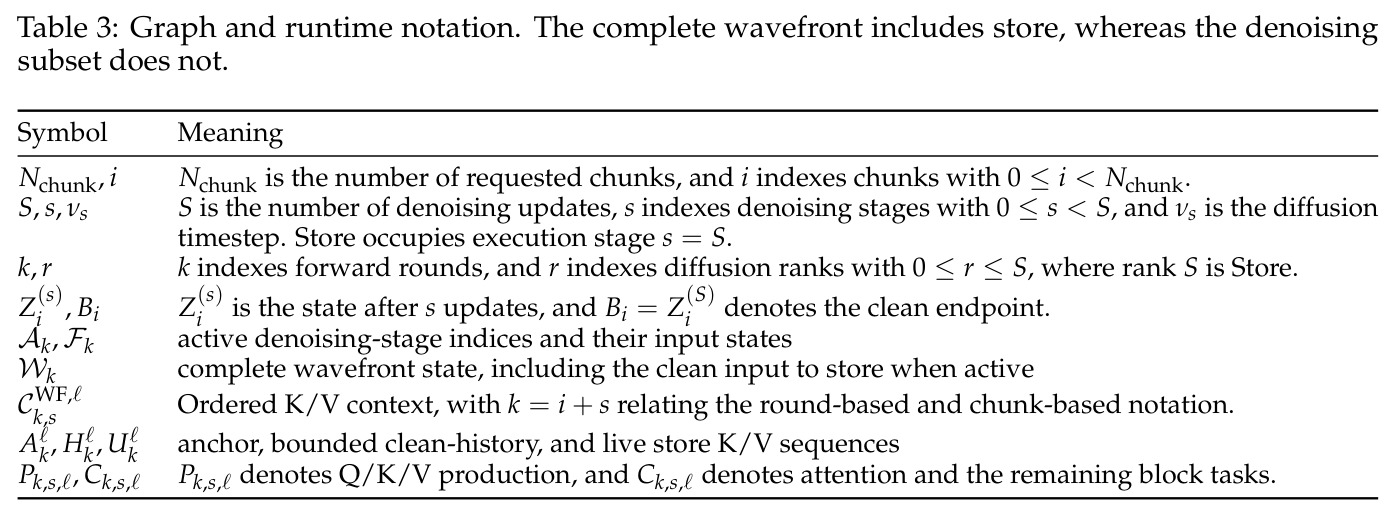
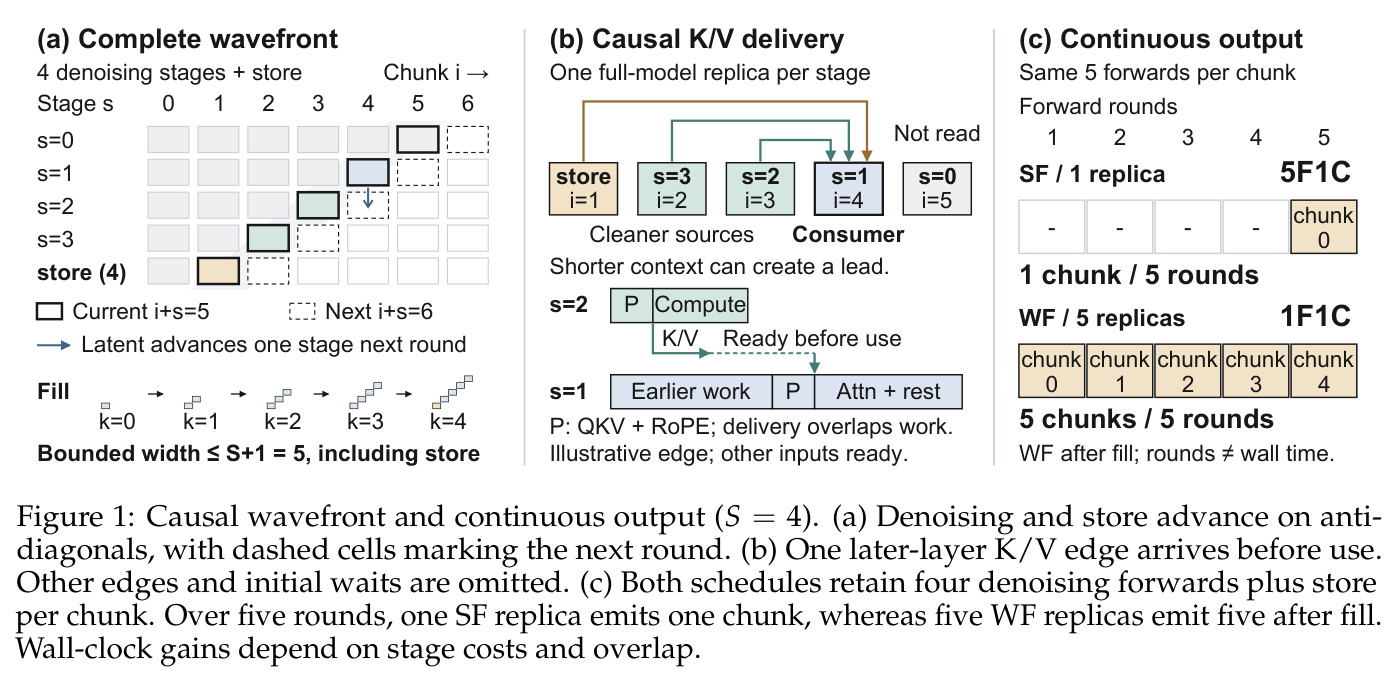
源自科学计算与 GPU 软件流水(software pipelining):把不同迭代的不同阶段错峰重叠执行,活跃任务沿网格反对角线(wavefront)推进,只要满足依赖偏序即可并行。本文让块 $i$ 的第 $s$ 步去噪在第 $k=i+s$ 轮执行,形成沿『块×阶段』网格反对角线移动的波前。
论文的命名、核心调度图(Figure 1a)与 Wave Parallelism 的设计全部直接来自这一思想,是读懂并行方案的钥匙。
上下文并行 Ulysses / Ring
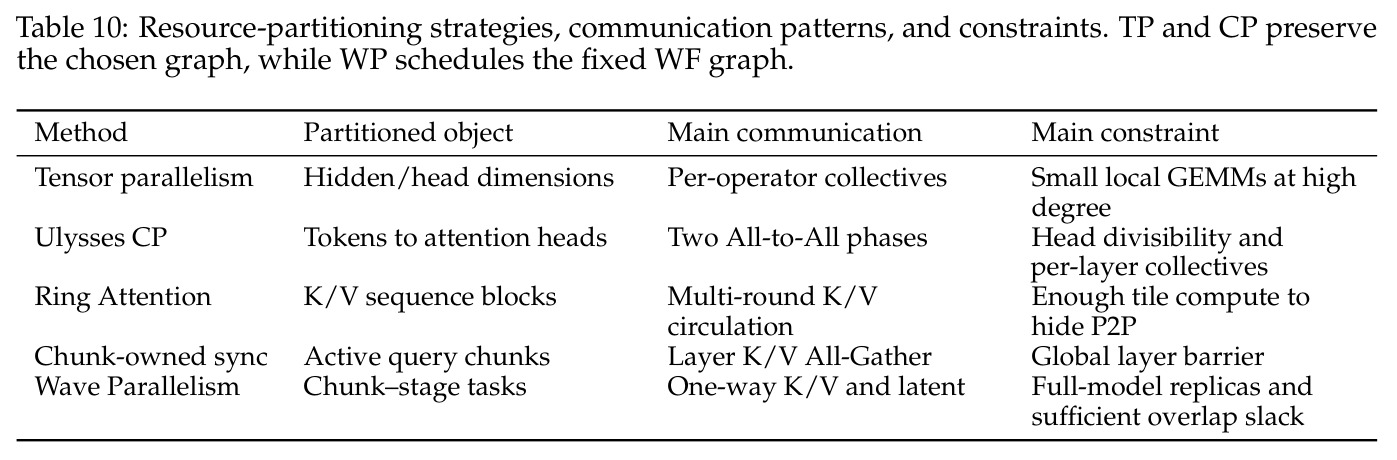
把单次前向的注意力切分到多卡:Ulysses 沿注意力头做 all-to-all 交换 Q/K/V,Ring 让 K/V 在卡间环形传递、各卡计算一段序列。两者都要求一次前向内全卡同步,且受注意力头数整除等约束。
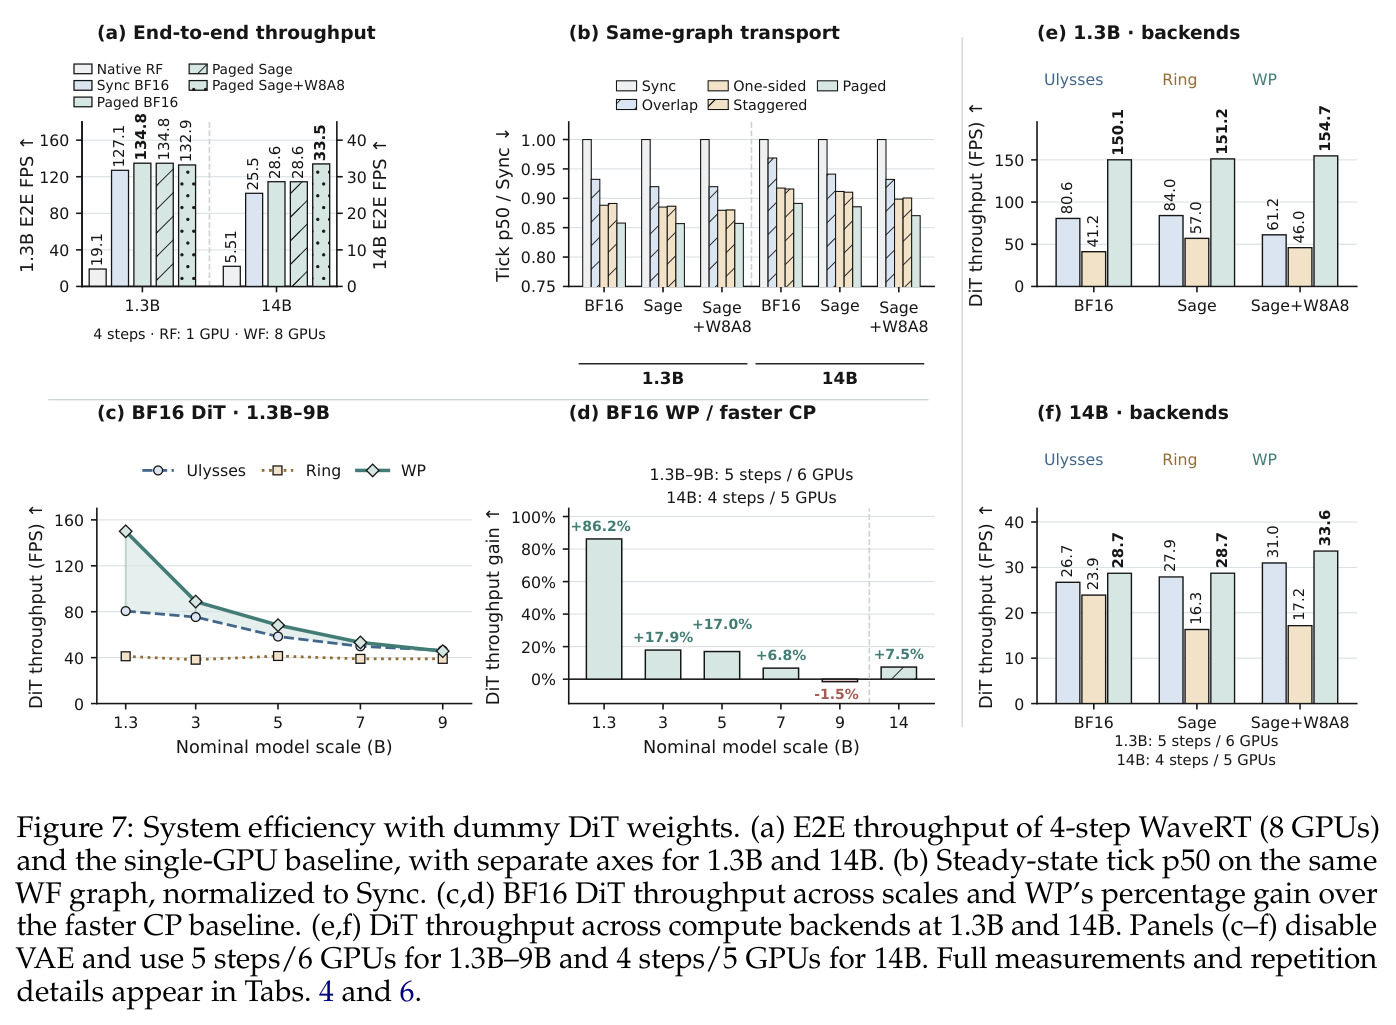
它们是论文的系统吞吐基线(Figure 7c–f);WP 与 CP 的对照——『按块×阶段切任务』vs『按单次前向切数据』——正是系统层面最重要的结论来源。
研究动机
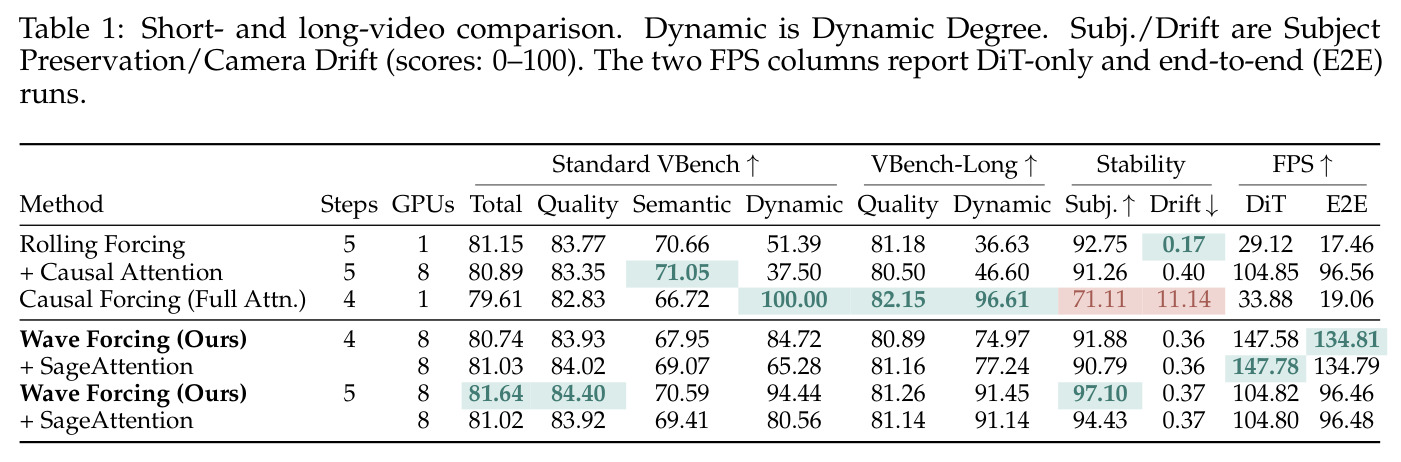
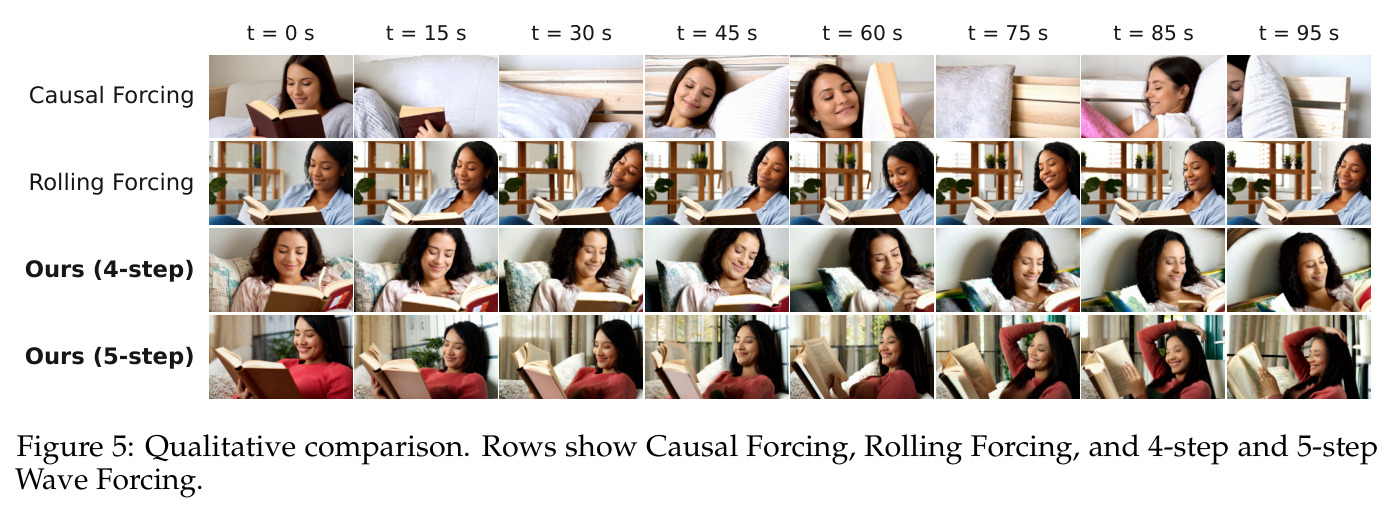
实时流式视频生成(直播、交互渲染、世界模型)要求模型持续吐出外观一致、运动自然的视频。主流 chunk-wise 自回归方法(Self Forcing、Causal Forcing)把视频切成 latent 块逐块做 $S$ 步历史条件去噪,但在『干净历史缓存』约定下,每块去噪完成后还需一次额外全模型前向(store)用干净结果刷新 K/V,于是每输出一块要 $N=S+1$ 次串行前向(NF1C),即使一步去噪也得两次前向,输出节奏被严重拖慢。质量上两难同样尖锐:Causal Forcing 在 100 秒长视频上 Dynamic Degree 高达 96.61,但 Subject Preservation 只有 71.11、Camera Drift 达 11.14,主体在 30 秒和 75 秒处彻底消失;Rolling Forcing 稳定(Subj 92.75、Drift 0.17)却几乎不动,VBench-Long Dynamic Degree 仅 36.63,画面趋于静止。效率与长视频动态-稳定平衡是双重瓶颈。
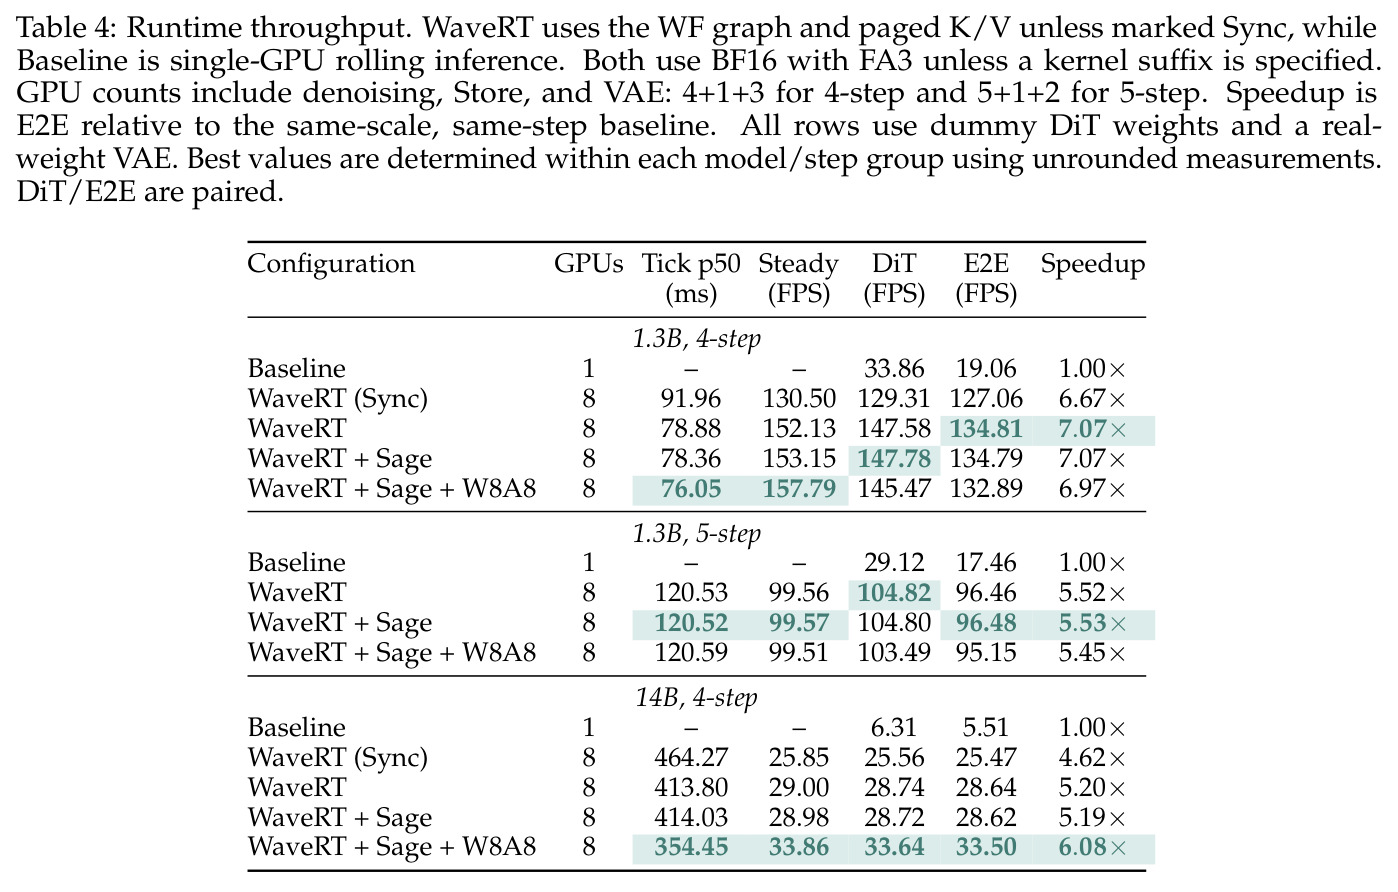
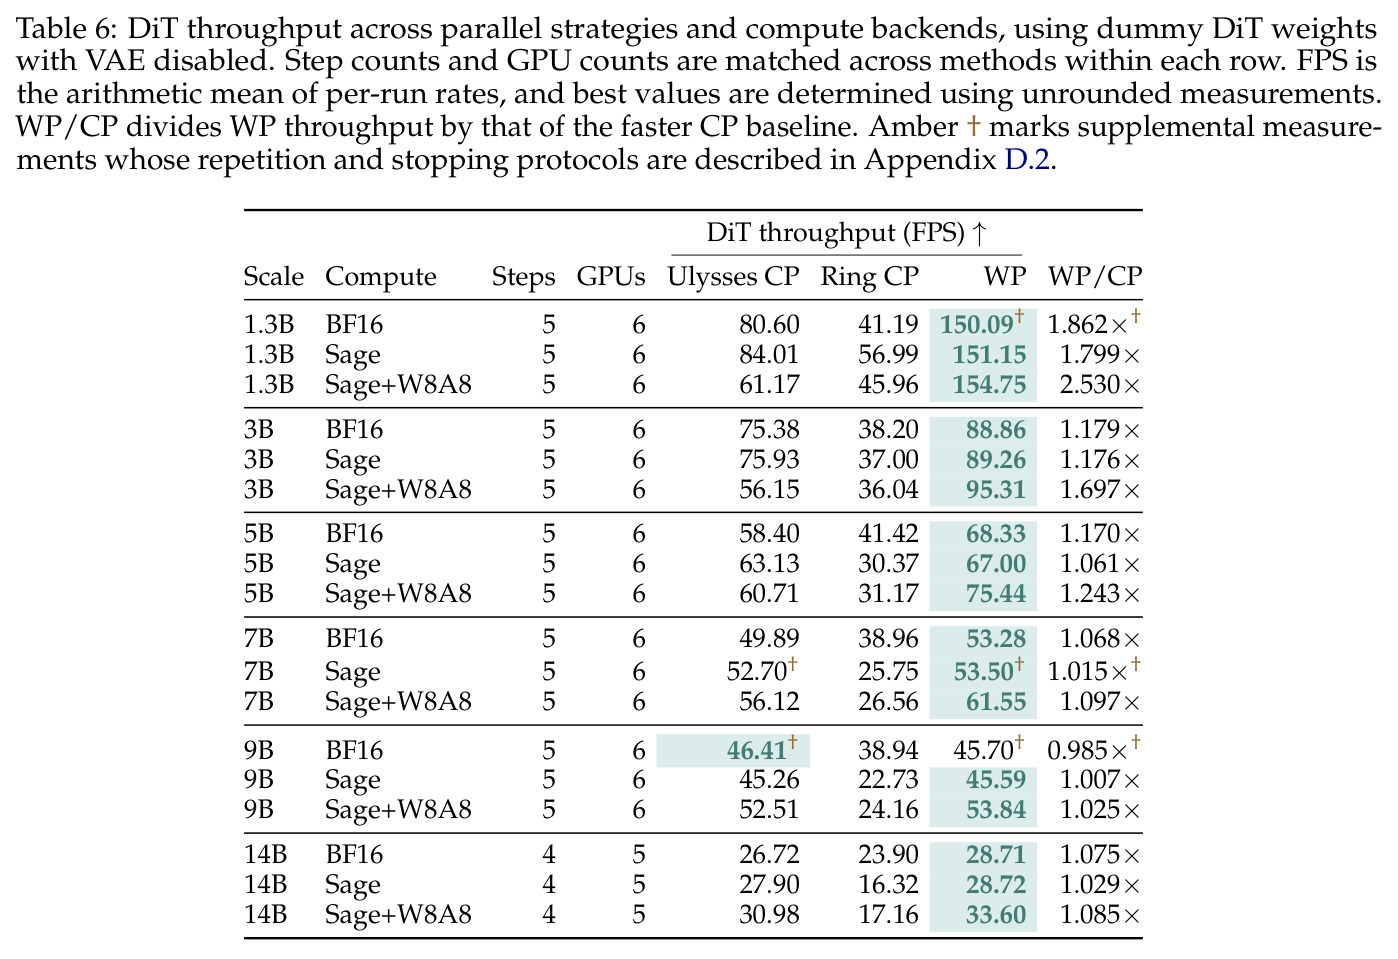
本文的目标是本文的具体目标是在保留每一步去噪更新的前提下,把流式生成的吞吐结构从 NF1C 提升到 1F1C——流水线填满后每轮并发前向稳定产出一个完成块。质量上要求 VBench Total 与 Rolling Forcing 相当(最终 81.64 vs 81.15),VBench-Long Dynamic Degree 大幅提升(36.63→91.45),同时 Subject Preservation 不低于 92、Camera Drift 保持在 1 以下;系统上要求在 8×H200 上让 4 步模型端到端突破 130 FPS(最终 134.81,为单卡基线 19.06 FPS 的 7.07 倍),并在 1.3B–14B 六个规模上验证 Wave Parallelism 相对 Ulysses/Ring 上下文并行的吞吐优势(Sage+W8A8 下达 1.025–2.530 倍)。
与已有工作不同的是,已有工作要么改进训练目标(SF 的自生成历史、RF 的混合噪声联合去噪、SGF 的历史 K/V 梯度回传),要么用 Ulysses/Ring 把单次前向切到多卡,但都默认『去噪与缓存刷新必须串行、由一个副本顺序完成』。本文抓住的盲点是:不同块处在不同噪声阶段,天然存在因果偏序——早先的块更干净、后来的块更噪——这恰好构成可并行调度的波前。若允许新块读取更早块的中间态(而非只看完全干净的历史),去噪与 store 就能摊到 $S+1$ 个全模型副本上流水线化。这是把 wavefront 调度思想从科学计算引入扩散流式生成,并首次把生成语义(因果掩码)、训练配方(混合噪声适配)与运行时系统(K/V 早发布、通信重叠)三方联合设计,而不是只在某一层单点优化。
核心方法
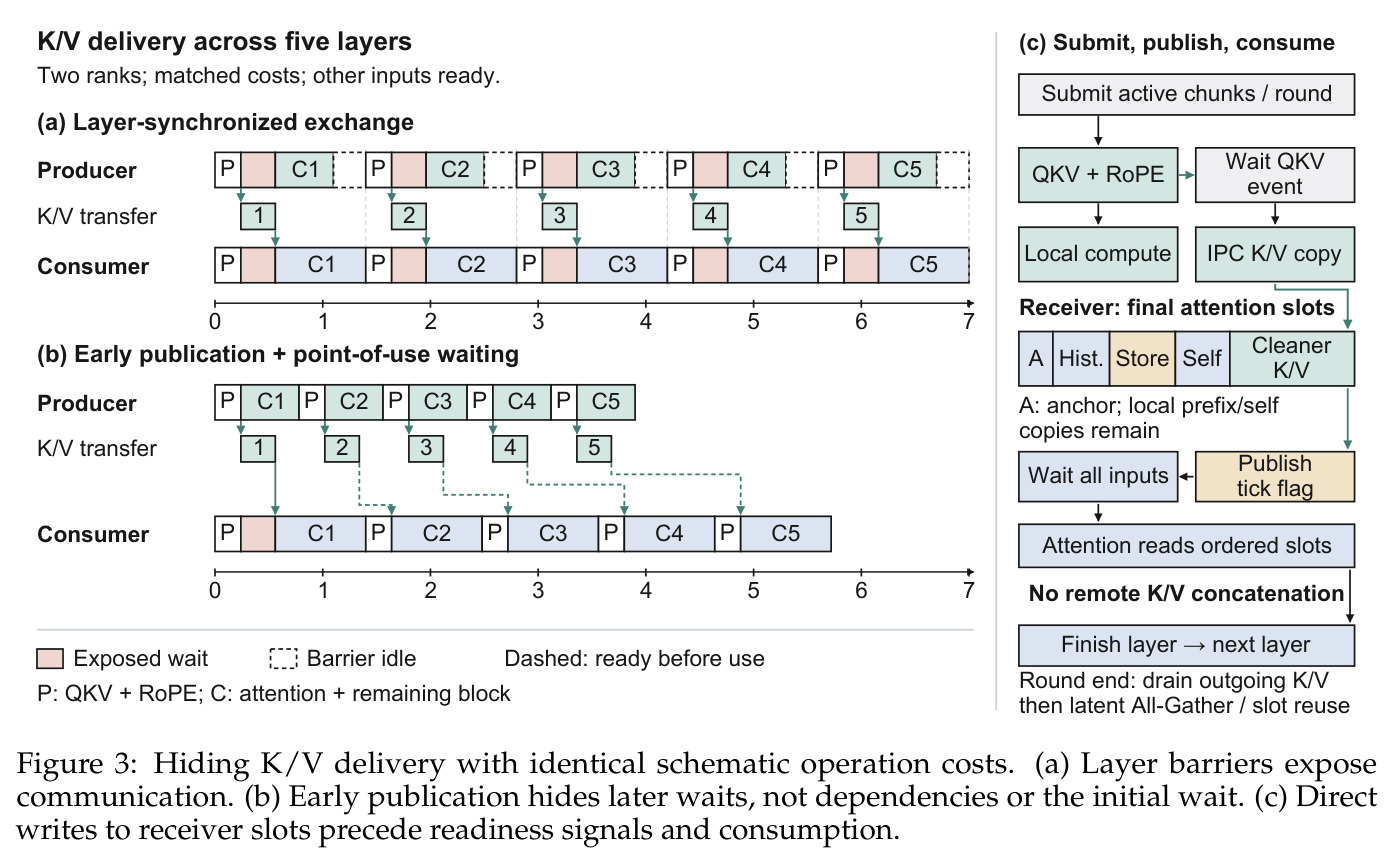
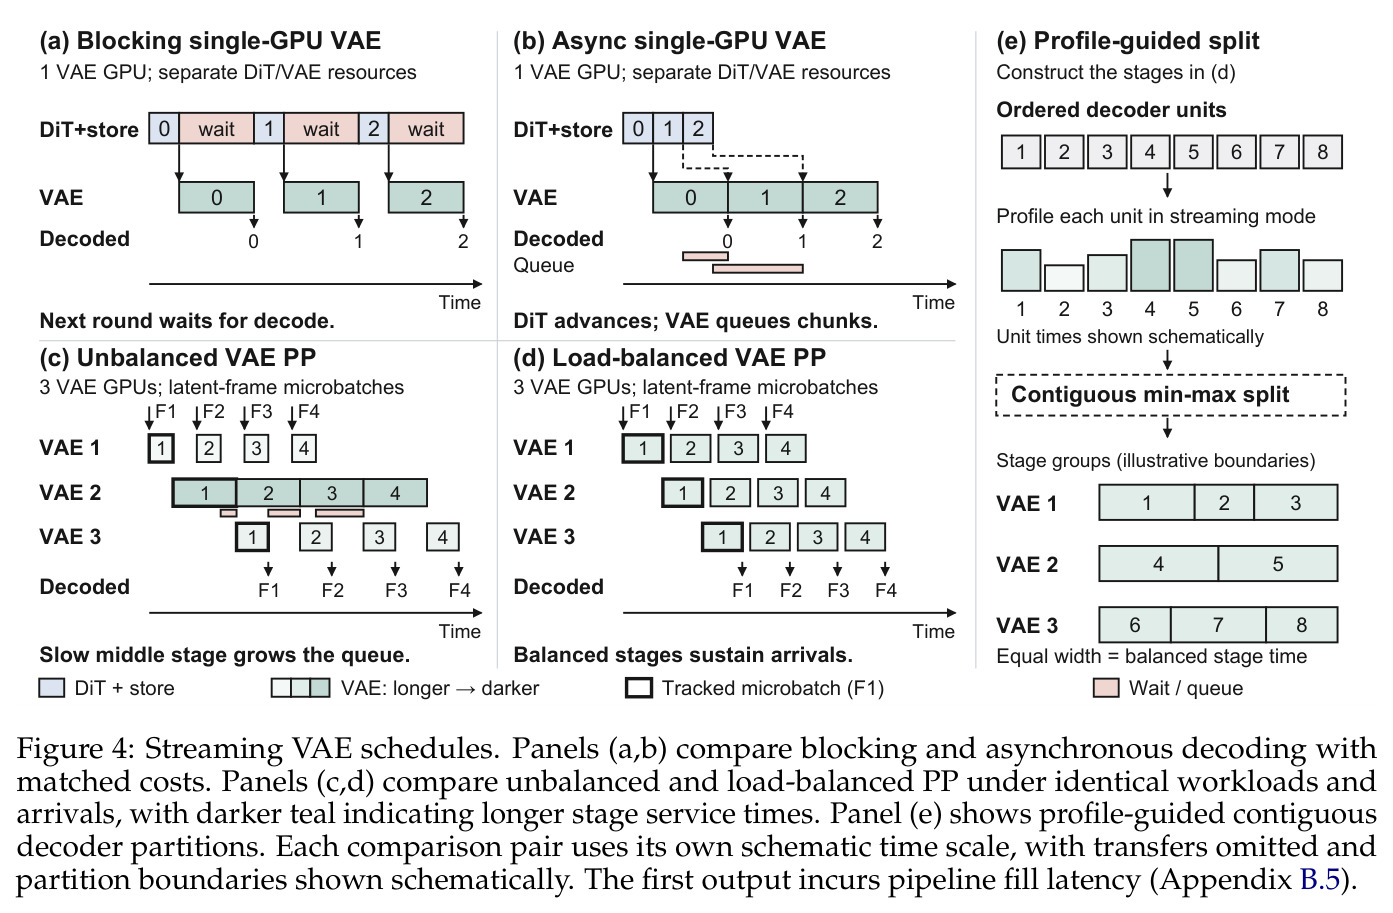
直觉上像多工位装配流水线:传统方法是一个工人把每块视频从头做完($S$ 步去噪再存缓存)才开始下一块;WF 给『第 $s$ 步去噪』和『store』各设一个工位,每个工位一台全模型 GPU 副本,同一时刻各工位处理不同的块——块 $i$ 在第 $k=i+s$ 轮进入第 $s$ 阶段,形成沿反对角线推进的波前。技术上分三层。生成层:块内全注意力+块间因果注意力,查询块 $s$ 能看到所有更早的活跃块 $j\ge s$,上下文按锚定块、干净历史、store 缓存、活跃去噪 K/V 有序拼接。训练层:三阶段配方——混合噪声 DMD 初始化、教师视频错峰加噪的离线 DMD+LPIPS、自生成历史的在线因果适配——让模型学会消费『脏而更干净』的上下文。执行层:Wave Runtime 让每个副本产出 QKV+RoPE 后立即逐层发布 K/V,消费者在注意力前才检查就绪,配合 paged 直写注意力槽位与负载均衡的 VAE 流水分区,把阶段并发转成持续 FPS。
核心创新是『让新块把仍在去噪中的旧块当作条件』,即因果波前。传统自回归(SF/RF)只允许读取完全去噪干净的块,干净历史还要靠额外 store 前向写入缓存,导致每块 $S+1$ 次串行前向。WF 的因果掩码 $M_{WF}(s,j)=\mathbf{1}[j\ge s]$ 允许块 $s$ 读取所有更早活跃块 $j$ 的当前去噪状态 K/V——这些状态虽未完全干净,但噪声水平必然低于自身,方向上总是『更干净』,且块 $j$ 每轮都会推进一个去噪阶段。配合三阶段训练(混合噪声 DMD 初始化、教师块错峰加噪的 DMD+LPIPS、对自生成 RF/WF/SF rollout 的在线 DMD),模型学会消费这种混合噪声上下文。于是去噪与 store 分布到 $S+1$ 个全模型副本上,流水线填满后每轮每条前向产出一个完成块(1F1C),且没有省略或合并任何去噪步——这与为省计算而砍步数的方法有本质区别。
方法步骤详情
第一步,定义波前:块 $i$ 的第 $s$ 次去噪在轮 $k=i+s$ 执行,把 $Z^{(s)}_i$ 更新为 $Z^{(s+1)}_i$;store 在格点 $(k-S,S)$ 刷新第 $k-S$ 块的 K/V;活跃宽度不超过 $S+1$。第二步,构造因果上下文:每层拼接锚定块、干净历史、store 缓存与按 $j$ 递增的活跃去噪 K/V,用 $M_{WF}(s,j)=\mathbf{1}[j\ge s]$ 屏蔽更晚的块。第三步,三阶段训练:Stage 1 以 1/2 概率采样 RF 或 SF rollout 做混合噪声 DMD(4 步学生从 SF 的 ODE 初始化出发,5 步学生复用公开 RF 权重跳过此阶段);Stage 2 对教师块 $Y_{win}$ 错峰加噪、前序教师块作干净 K/V,在同一预测上施加 DMD 与 $0.25\times$LPIPS;Stage 3 均匀采样自生成 RF/WF/SF rollout(各 1/3)做在线 DMD,仅部署 WF 分支。第四步,WaveRT 执行:$S$ 个去噪阶段与 1 个 store 各占一张全模型副本,生产者 $P_{s,\ell}$ 完成 QKV+RoPE 后立即发布 K/V,消费者 $C_{s,\ell}$ 在注意力前等待全部合法输入就绪;paged 直写注意力槽位避免远端拼接;VAE 按 profile 把解码单元切成负载均衡分区放到 3 张专用卡流式解码。
技术新颖性
与 SF/RF 的区别:条件上下文从『只读干净历史』变为『读更干净的中间态』,并移除了 RF 的反向精炼边,这是生成语义层的改变,必须靠专门训练适配(论文消融显示不做 Stage 3 的 WF 适配会掉点)。与 Ulysses/Ring 的区别:CP 切分单次前向内的注意力数据(all-to-all 或 K/V 环传),一次前向仍是一次前向;WP 按『块×去噪阶段』切任务、把整条流水线摊到全模型副本上,天然匹配流式生成的因果结构,还能做通信-计算重叠。与 Live Avatar/HiAR 等流水线化的区别:WF 用三阶段训练显式教模型消费错峰噪声上下文,而非依赖固定时间步或匹配噪声的系统技巧。与 D2F/MBD-LMs 等块级扩散语言模型的区别:WF 面向视频少步蒸馏场景,把 store 阶段、干净历史与因果波前一起纳入调度和训练目标,形成方法-系统闭环。
实验结果
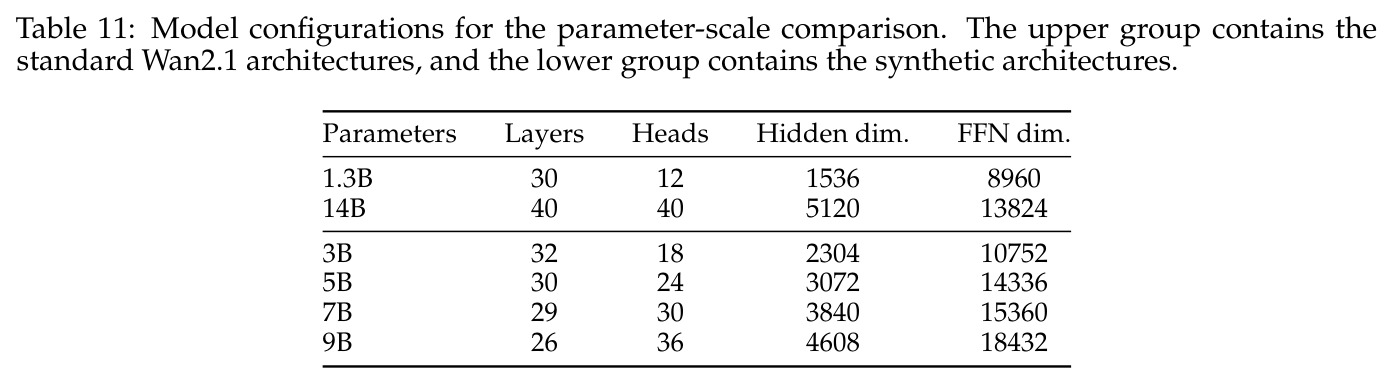
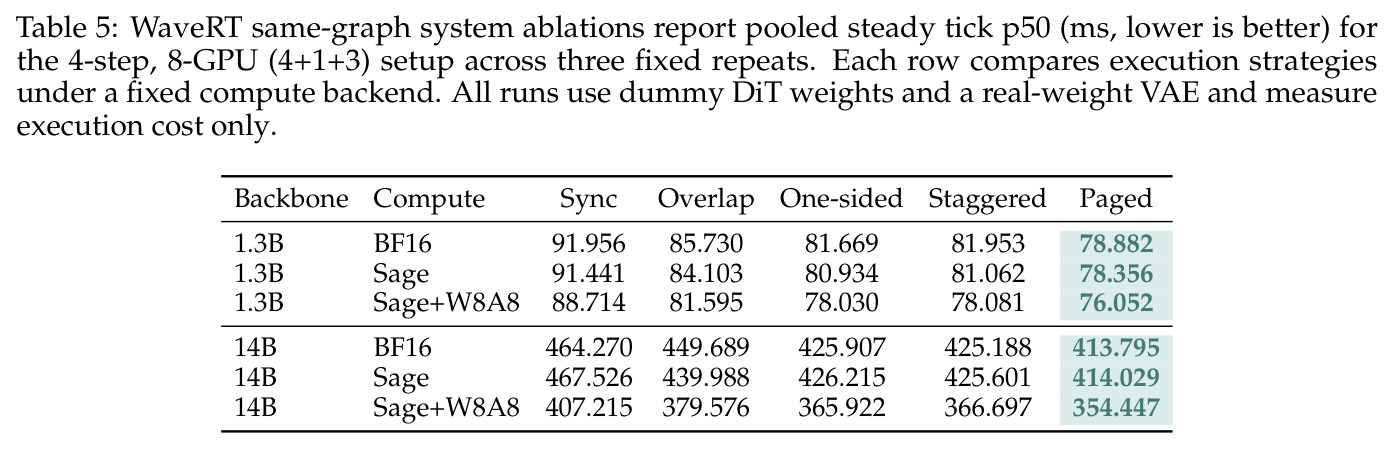
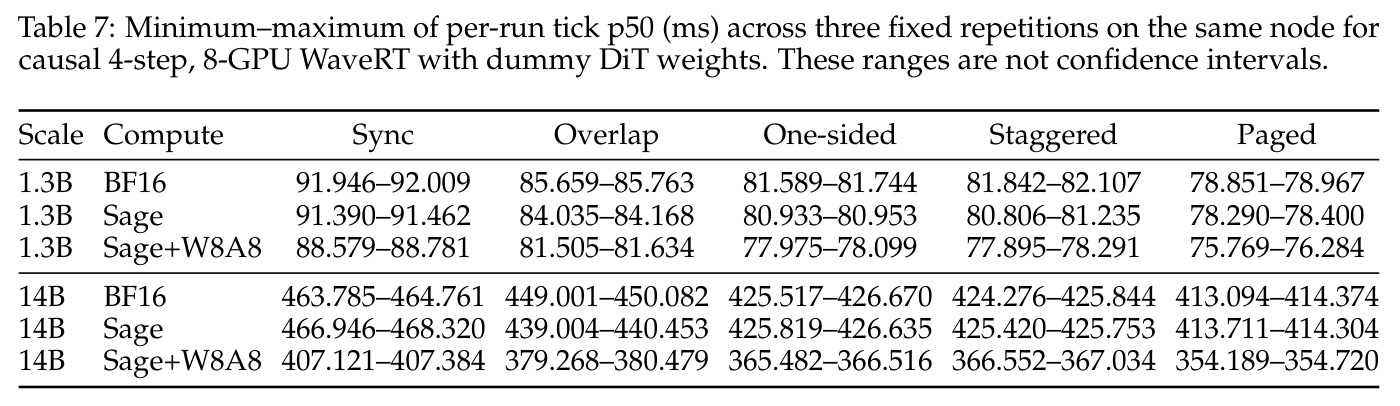
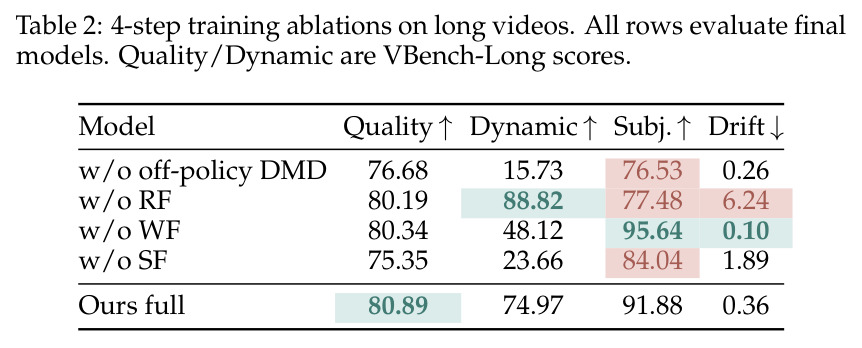
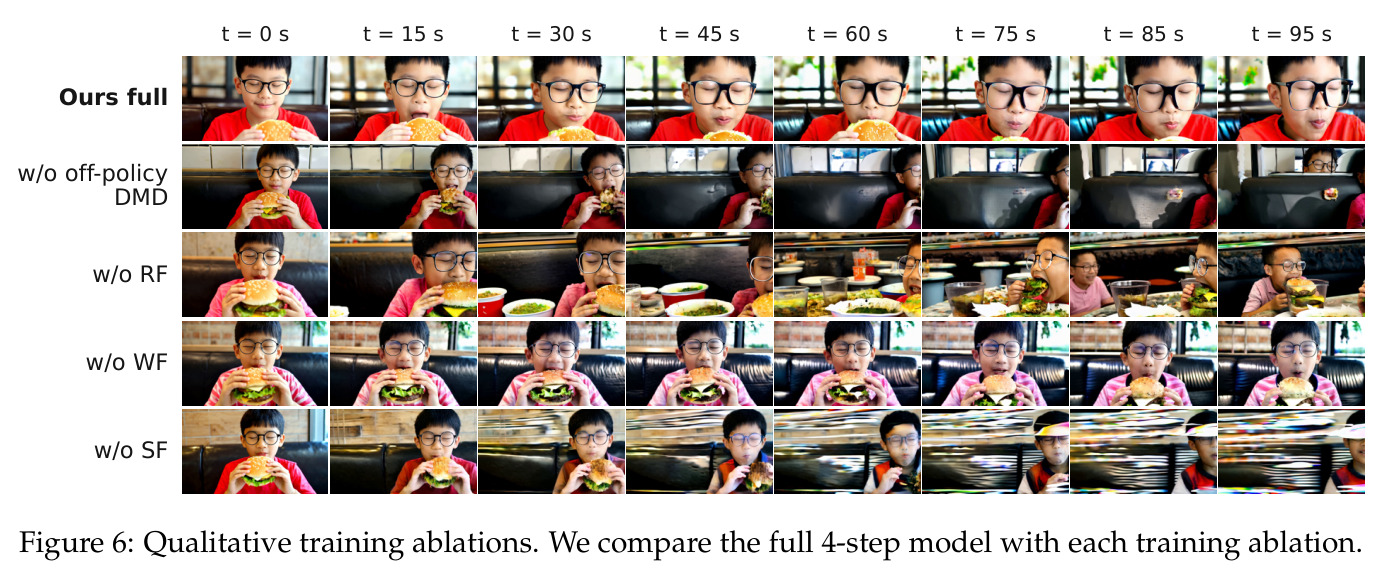
质量上 WF 实现了『不掉点的大提效』(Table 1):5 步 WF 与 RF 总体持平——VBench Total 81.64 vs 81.15、Long Quality 81.26 vs 81.18——但动态度大幅提升:短视频 Dynamic Degree 94.44 vs 51.39、100 秒长视频 91.45 vs 36.63;主体保持 97.10 vs 92.75,相机漂移仅 0.37 vs 0.17。Causal Forcing 的 Long Quality 82.15、Dynamic 96.61 虽最高,但 Subj 71.11/Drift 11.14 被判不可用(主体在 30s、75s 消失)。训练消融(Table 2)逐项验证三阶段必要性:w/o off-policy DMD 时 Quality 80.89→76.68、Dynamic 74.97→15.73;w/o SF Quality 跌至 75.35;w/o RF Dynamic 升至 88.82 但 Subj 跌至 77.48、Drift 升至 6.24;w/o WF Subj 95.64 但 Dynamic 仅 48.12,只有三分支混合无短板。系统上(Figure 7、Table 4),8×H200 的 4 步 WF 达 147.58 DiT / 134.81 E2E FPS,为单卡 19.06 FPS 基线的 7.07 倍;14B 达 28.64/33.50 E2E FPS vs 单卡 5.51。并行对比中,Sage+W8A8 下 WP 在 1.3B–14B 全部六规模领先更快 CP 基线(1.025–2.530×),BF16 下六中取五(1.3B:WP 150.09 vs Ulysses 80.60、Ring 41.19);系统消融显示 Sync→Paged 把 1.3B BF16 tick p50 降 14.2%(91.96→78.88 ms)、14B 降 10.9%(464.27→413.80 ms)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 100 秒长视频生成动态性 | VBench-Long Dynamic Degree | 91.45(5-step WF) | 36.63(Rolling Forcing)/ 96.61(Causal Forcing,但不可用) | 较 RF +54.82,且无 CF 的主体消失问题 |
| 短视频生成动态性 | VBench Dynamic Degree | 94.44(5-step WF) | 51.39(Rolling Forcing) | +43.05(约 1.84 倍) |
| 长视频主体保持/相机稳定 | Subject Preservation / Camera Drift | 97.10 / 0.37 | 92.75 / 0.17(RF);71.11 / 11.14(CF,不可用) | Subj +4.35,Drift 略升 0.20 但远低于可用阈值 |
| 短视频总体质量 | VBench Total | 81.64(5-step WF) | 81.15(RF) | +0.49,总体持平略优 |
| 端到端流式吞吐(8×H200,832×480) | E2E FPS | 134.81(4-step,BF16/FA3;DiT-only 147.58) | 19.06(单卡 Causal Forcing 风格基线) | 7.07 倍 |
| DiT 吞吐对比上下文并行(1.3B–14B 六规模) | FPS(Sage+W8A8,DiT-only) | WP 领先全部六规模,达更快 CP 基线的 1.025–2.530 倍 | Ulysses / Ring 中更快者 | 最高 2.53 倍 |
| 稳态单轮延迟(同一 WF 图) | tick p50 | 78.88 ms(1.3B BF16,Paged)/ 413.80 ms(14B BF16) | 91.96 ms(Sync,1.3B)/ 464.27 ms(14B) | -14.2% / -10.9% |
局限与改进
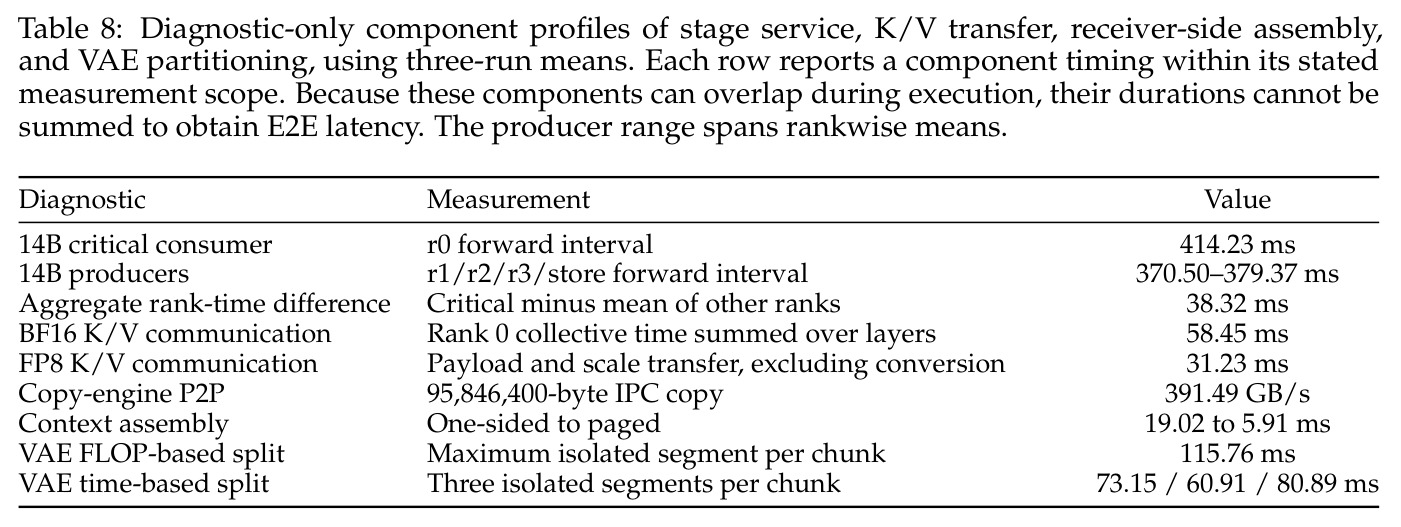
作者承认:VBench 高分不等于长流质量——高 Quality 与 Dynamic Degree 可与主体消失、相机漂移并存;自建的 Subject Preservation/Camera Drift 诊断仅基于 100 条主体导向 prompt,依赖 SAM3 跟踪与几何启发式,阈值敏感性、对有意转场的覆盖及与人类判断的一致性均未验证。输出路径上 VAE 是有限容量瓶颈:即便三段流水,1.3B 五步下 DiT 104.82 vs E2E 96.46 FPS 的差距来自解码尾部,聚合计时无法区分 VAE 计算、传输、排队与反压。训练是复杂的三阶段流程。可扩展性受固定步数限制:$S$ 步去噪加 store 需 $S+1$ 个全模型副本,K/V 逻辑扇出随阶段数二次增长;WP 对 CP 的优势随模型变大收窄(9B BF16 落后 Ulysses 1.53%)。我的补充:14B 系统实验用随机初始化的 dummy weights 测吞吐,真实权重下的行为未验证;所有实验固定文本条件,prompt 切换与相机/动作控制的在线交互延迟未测;评估分辨率仅 832×480,更高分辨率下 VAE 尾部瓶颈可能更严重。
独立分析的弱点
其一,训练配方脆弱且经验性强:RF/WF/SF 三分支各占 1/3 的组合完全靠消融试出,缺任何一个都明显掉点(w/o SF 时 Quality 仅 75.35),迁移到新架构需重新调参,改进方向是研究更原则性的课程设计或用博弈/强化式目标替代分支混合。其二,扩展性受 $S+1$ 全模型副本限制:4 步就要 5 个副本(8 卡中 4+1 归 DiT),14B 时单张 141GB H200 才装得下,且 K/V 扇出随阶段数二次增长;改进方向是阶段内再做 Ulysses 切分的混合 WP+CP,或多流共享副本的服务化设计。其三,稳定性诊断口径窄:100 prompt 加 SAM3/几何启发式可能漏检误检、未覆盖有意转场,应引入带时间戳证据的 VLM judge 并做人标定。其四,系统吞吐用 dummy weights 测量,可能掩盖真实权重下注意力数值分布对 Sage/W8A8 精度的影响,应用真实 14B 权重复测并报告质量回归。其五,E2E 与 DiT FPS 之差(如五步差 8.36 FPS)只归因于 VAE 尾部但缺对照实验,应补 VAE 开/关匹配与分阶段计时。
未来方向
作者规划的路线清晰分三层。执行与扩展:画像解码阶段、传输、队列与反压以指导 DiT/VAE 资源分配;研究细粒度或混合并行(WP+CP 组合)突破固定步数的副本数限制;简化三阶段训练配方。服务化:面向并发 WF 流做准入控制、批处理与资源分配,评估启动延迟、输出抖动、播放停顿与公平性(借鉴 StreamDiffusion、SlackServe、PhysisServe)。交互与在线更新:让 prompt 在生成中途生效——需定义更新落在哪些活跃块、如何刷新受影响缓存并适配训练,度量 prompt-to-visible-output 延迟(参考 LongLive 的 KV recaching);更远期是交互式世界模型:一条路线是学习型世界预测,另一条由引擎维护世界状态、视频模型做结构条件流式渲染。评估侧将引入 StreamEval 式交互基准与理解式 judge。基于本文成果还可延伸:把波前调度推广到交错文本-视频生成;把 store 阶段与低秩/KV 压缩结合以减少副本;为边缘设备设计 1-2 副本的降级 WF(以延迟换吞吐)。
复现评估
论文头部给出 GitHub、Project Page 与 Hugging Face 入口,声明开源代码与模型(Wan2.1-T2V-1.3B 基座)。训练门槛有一个关键减负设计:4 步学生从 SF 的 ODE 初始化出发,5 步学生直接复用公开的 Rolling Forcing 权重并跳过 Stage 1——若只要 5 步版本,训练从 Stage 2 的离线 DMD 开始。评估协议完全可复现:VBench/VBench-Long、200 条 MovieGen prompt(100 秒视频)、100 条稳定性子集,固定 832×480、16 FPS、seed 42,细节在附录 C。系统复现门槛则很高:E2E 实验需要 8×H200 141GB 单节点(4 去噪+1 store+3 VAE),CP 对比横跨 1.3B–14B 且部分用 dummy weights;WaveRT 涉及 CUDA IPC、paged K/V 直写与通信重叠等工程;1F1C 的前提是 $S+1$ 张全模型副本卡,单卡只能退回串行。综合判断:质量结论中等偏易复现(约 8×A100/H100 级训练资源),系统结论属集群级复现,多数读者更适合以使用者身份利用其开源运行时。
论文图表