miniTE:诊断并弥合原生 NVFP4 强化学习中的执行鸿沟 miniTE: Diagnosing and Bridging the Execution Gap in Native NVFP4 Reinforcement Learning
诊断训练与采样引擎间NVFP4数值执行差异,实现稳定高吞吐低比特RL
前置知识
NVFP4 数值格式
NVIDIA 提出的 4-bit 浮点格式:每个元素用 E2M1(2 位指数、1 位尾数)编码,每 16 个值共享一个 E4M3 块缩放因子 $s_b = \mathrm{E4M3}(a_b/(6g))$,最外层还有一个 FP32 缩放 $g$,重建为 $\hat{x}_i = g \cdot s_b \cdot c_i$。两级缩放让 4-bit 元素也能覆盖较大动态范围,但块缩放的舍入方式、外层缩放的粒度(per-tensor/per-row/per-token)都是实现自由度。
本文全部论点建立在「NVFP4 格式名之外还有大量执行自由度」这一事实上,不懂格式就看不懂诊断的对象。
W4A4 原生低比特计算
权重和激活都量化为 4-bit,并由 Tensor Core 直接执行 4-bit×4-bit 的矩阵乘(GEMM),累加在更高精度完成。这与 QLoRA 式的「4-bit 存储 + BF16 计算」不同:前者在计算路径上就节省带宽和算力,但把量化误差与执行细节直接暴露给训练动力学。
miniTE 的加速来源正是原生 W4A4 专家前向(33,540 tokens/s、2.46× 专家前向加速),这是理解效率章节的前提。
MoE 混合专家与分组 GEMM
MoE 层由路由器为每个 token 选出 top-k 专家,被选中的 token 分组送入各专家的 FC1-SwiGLU-FC2 计算。由于每个专家收到的 token 数不同(组大小不均、可能为空),实际执行用分组 GEMM:需要 permutation、padding、专家偏移等准备步骤,这些准备工作往往比矩阵乘本身更耗时。
论文的执行鸿沟出现在专家层,效率优化也围绕 permutation、amax 收集与分组 GEMM 的接口展开。
PPO clip 与截断重要性采样(TIS)
PPO 用重要性比率 $\rho_t = \pi_\theta(a_t|s_t)/\pi_{\bar\theta}(a_t|s_t)$ 修正新旧策略差异,并把 $\rho_t$ clip 在 $[1-\epsilon_{lo}, 1+\epsilon_{hi}]$ 内限制更新步长。TIS 则用更新前 learner 与 sampler 的似然比 $w^{TIS}$ 修正两引擎间的概率差。数值执行不一致会直接改变这些比率与 clip 触发。
理解 logp 差 $\delta_{num}$ 为何重要、以及 TIS 与执行对齐是两种不同修正手段的关键。
训练-推理不一致与执行规范
LLM RL 中 sampler 负责生成 rollout、learner 负责参数更新,二者独立计算 token 概率。已有工作用 TIS、确定性 kernel 等缓解不一致。「执行规范」指完整规定缩放域、舍入、规约顺序、逻辑布局和 cast 位置的说明——相同格式名下不同规范会产生不同的数值结果。
这是本文提出的新诊断单元,全文的动机、方法与结论都围绕它展开。
研究动机
现代 LLM 强化学习把 rollout 采样器(sampler)与策略学习器(learner)部署为两个独立引擎,二者在相同参数版本下各自计算 token 的对数概率,这些概率直接进入重要性比率 $\rho_t$ 和 PPO 的 clip 决策。miniTE 的冻结策略实验显示:仅把专家计算从 BF16 换成 NVFP4,跨引擎绝对 logp 差的 P99 就从 0.1271 nats 涨到 0.2911,配对增加 0.1641(95% CI [0.1311, 0.2005]),可能触发 clip 边界的 token 从 0.627% 升至 1.203%。更关键的是,即便固定目标层的专家路由分配,FC1/FC2 输出的相对 L2 差异仍高达 0.0381–0.6124 与 0.0810–0.7624;只把采样器激活外层缩放从 per-tensor 改成 per-token 也无法消除差异。这种被忽视的执行差异最终表现为训练质量崩坏:朴素 TE NVFP4 在 AIME24 上只拿到 26.67%,远低于 BF16 的 41.11%。
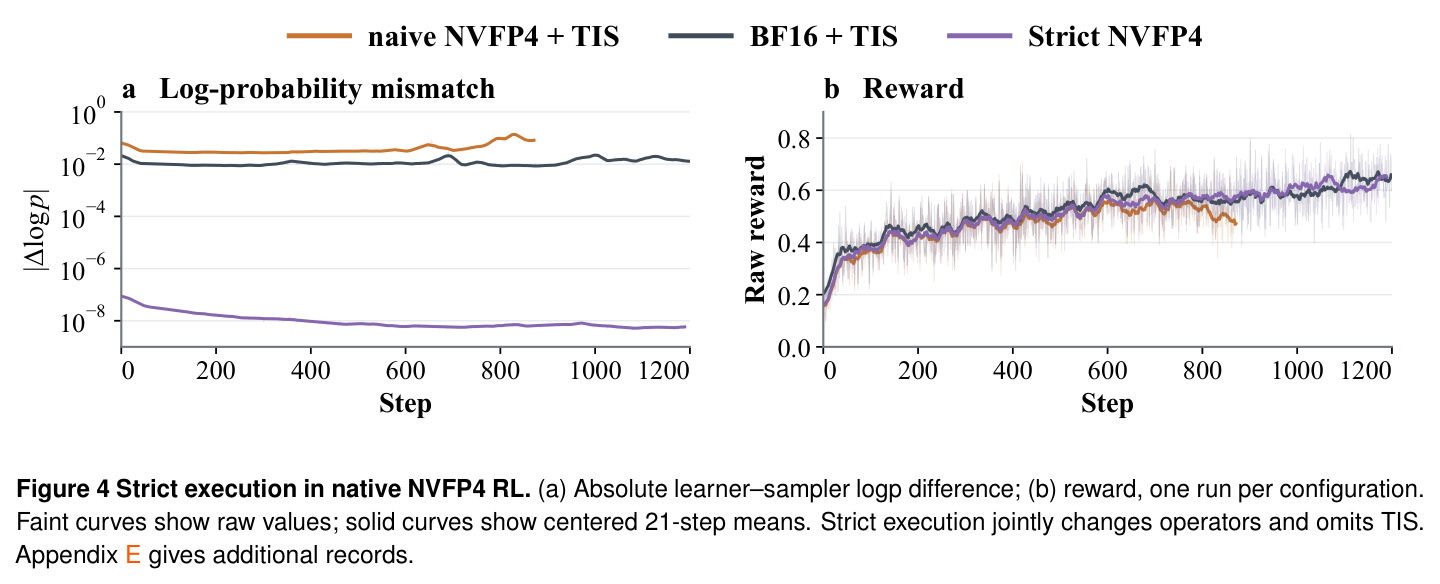
本文的目标是本文目标是让原生 W4A4(权重与激活均为 4-bit)NVFP4 强化学习在不修改 RL 目标函数的前提下做到三点:一是可诊断——建立跨引擎执行检查方法,能在量化操作数、专家输出、token logp 三个边界上量化 learner 与 sampler 的数值差异;二是可对齐——给出明确的执行规范(缩放域、舍入、布局、cast 位置与算子组合),并提供严格匹配采样器 kernel 与规约顺序的对齐参考,把跨引擎 logp 差压到约 $10^{-8}$;三是可加速——把量化与分组 GEMM 当作连通数据流联合优化,在 Qwen3-30B-A3B 上让完整 learner 更新达到 33,540 tokens/s,即 1.39× BF16 与 1.47× TE NVFP4 吞吐,同时五任务平均分从朴素 NVFP4 的 54.57% 提升到 56.35%,接近 BF16 的 58.84%。
与已有工作不同的是,已有工作分别处理了量化误差(NVFP4 对比 BF16)、路由敏感性(匹配专家 ID、路由重放)和策略错位(TIS、off-policy 分析),但都默认「格式名一致 + 专家分配一致」就等于执行一致。本文的独特视角是把诊断单元从「数值格式」提升到「执行规范」(execution specification):NVFP4 这个名字并不规定缩放域(per-tensor 还是 per-token)、舍入指令、规约顺序、padding 策略,以及 router 系数和输出 cast 进入计算的位置,而这些自由度中的每一个都会改变数值结果。论文用三组控制实验证明这一被忽视的缝隙真实存在且影响学习:冻结策略打分暴露跨引擎尾部差异、路由条件对照暴露匹配分配后的算子残差、缩放对照证明单纯 finer scale 无济于事,从而为低比特 RL 给出了一个可操作的新抽象层。
核心方法
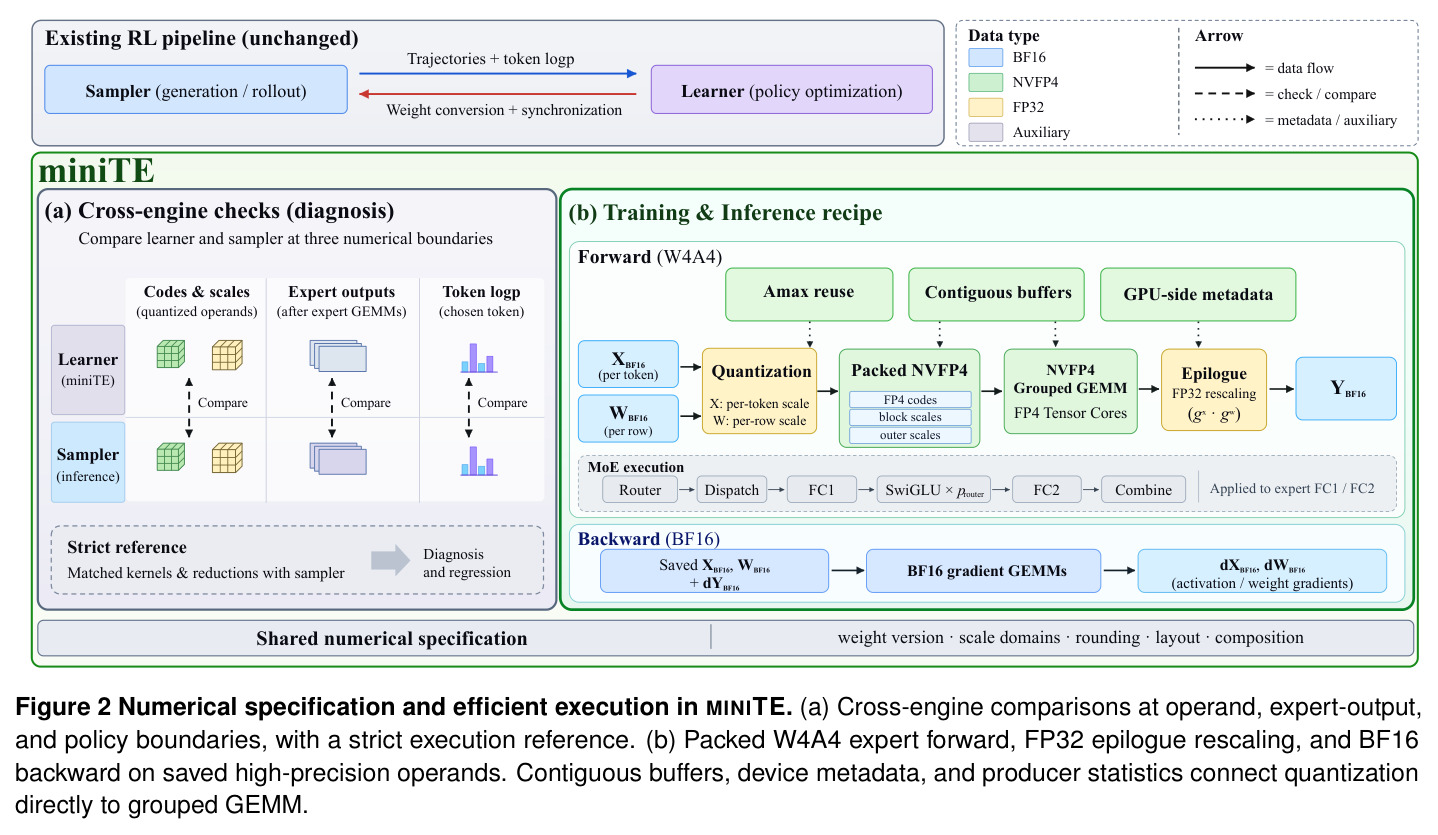
直觉上,RL 的两个引擎像两台「都是 4-bit」的计算器算同一道题:输入相同,但内部舍入和进位规则不同,结果就会分叉,而 PPO 的重要性比率会把这个分叉放大成错误的 clip 决策。miniTE 的技术路线分三块。第一是诊断:在量化操作数、专家输出、token logp 三个边界上比较两引擎,并提供一个把 learner 的 kernel、公式与规约顺序完全对齐到 sampler 的 strict 执行参考作为可行动基准。第二是数值路径:默认配置用 per-token 激活外层缩放加 per-row 权重缩放的原生 W4A4 专家前向,外层因子与规约索引无关、可在 FP32 epilogue 中一次性重缩放;反向用保存的 BF16 操作数做 straight-through 近似。第三是实现:把量化与分组 GEMM 写成连续缓冲上的连通数据流,amax 在 permutation 时顺便收集,FC1/FC2 使用各自适配规约长度的 GEMM 配置。长程 Qwen3-30B-A3B RL 稳定训练,专家前向较 TE U3045 提速 2.46×。
核心创新是「执行规范」这一抽象与三层参考体系的结合,及其配套的高效原生实现。与量化感知 RL、量化采样等工作不同,本文证明:匹配权重版本、数值格式甚至目标层路由都不足以保证一致的策略评估,必须显式规定 scale domain、rounding、layout、composition 与 cast 位置。其次,strict 执行参考把 learner 与 sampler 的 kernel、公式和规约顺序完全对齐,实测 logp 差降至约 $10^{-8}$,并在此配置下保持 reward 增长——证明了原生 FP4 计算与稳定学习可以共存。第三,在实现上,per-token 缩放使外层因子与规约索引 $k$ 无关,于是可以在原生 block-scaled 累加 $U_e = \mathrm{MMA}_{\mathrm{NVFP4}}(\bar{X}_e, \bar{W}_e^{T})$ 之后,于 epilogue 中以 FP32 广播 $g_x g_w$ 再 cast 到 BF16,全程无需物化解码后的 BF16 操作数——这正是 2.46× 专家前向加速的数值基础,把缩放规则与原生 Tensor Core 算术真正连接起来。
方法步骤详情
第一步,冻结策略诊断:以 teacher forcing 打分固定 token 序列,计算 $\delta_{num}^t = \log \pi_\theta^L(a_t|s_t) - \log \pi_{\bar\theta}^R(a_t|s_t)$,32 个 prompt 共 69,088 个匹配 token,2000 次 prompt-cluster bootstrap 给出置信区间,输出 BF16 P99=0.1271 与 NVFP4 P99=0.2911 的对比。第二步,路由条件对照:固定 11 个深度的目标层专家分配、保留自然累积输入,测得 FC1/FC2 相对 L2 残差为 0.0381–0.6124 与 0.0810–0.7624。第三步,定义执行规范:记录缩放域、舍入、布局与 cast 位置。第四步,原生前向:按 $g_{x_{e,t}} = \max_k |X_{e,t,k}|/(6\cdot 448)$、$g_{w_{e,n}}$ 类似取 per-row,生成长度 16 的 E4M3 块缩放与 E2M1 码,关闭 Hadamard 与随机舍入;context-swap 测试保证目标行输出 bitwise 不变。第五步,epilogue 中 FP32 重缩放并 cast 到 BF16,反向以保存的 BF16 操作数做 BF16 GEMM。第六步,联合优化:sort 与 amax 扫描融合、pad 同时携带统计量、连续缓冲与 device 侧 expert offsets、FC1/FC2 各自的 tile 配置。第七步,替换专家分组线性模块接入现有 TIS-corrected RL 流水线。
技术新颖性
与 QeRL(量化 rollout 加 LoRA)、Jet-RL(FP8 统一训练与采样)、QUADS(learner 侧 W4A16 QAT 加 sampler 侧残差补偿)、QaRL(低比特前向加序列级 trust band)不同,miniTE 不修改 RL 目标、不做量化感知训练,而是瞄准跨引擎执行一致性这个此前被当作「工程细节」的维度,并首次系统量化了「格式一致但执行不一致」的现象与后果。相比 Miles(per-token NVFP4 + 高精度 backward + quantizer agreement),miniTE 进一步给出了残差执行差异的诊断方法与严格对齐参考。与确定性 kernel 工作(He & Thinking Machines Lab 等)追求全局 bitwise 确定性不同,它把参考分为 strict(跨引擎)、operator(实现优化)与 training(端到端)三层,各自回答不同问题。系统侧把量化器与分组 GEMM 作为生产者-消费者数据流联合设计(producer 侧 amax、连续缓冲、支持空 expert 组)也是首次在该粒度上报告的。
实验结果
诊断实验:BF16 跨引擎 $|\delta_{num}|$ 的 P99 为 0.1271 nats,NVFP4 升至 0.2911(配对增加 0.1641,95% CI [0.1311, 0.2005]);超 clip 边界的 token 占比从 0.627% 升至 1.203%;匹配路由后 FC1/FC2 相对 L2 差异最高达 0.6124 与 0.7624;仅改 sampler 的 per-token 缩放几乎无效。训练评测(step 999):miniTE 在 AIME24 得 36.67% 对朴素 NVFP4 的 26.67%(+10.00pp),AIME25 24.44% 对 20.56%(+3.88pp),MATH-500 87.45% 对 86.90%,GSM8K 94.79% 对 94.71%,五任务平均 56.35% 对 54.57%(+1.78pp),距 BF16 的 58.84% 还差 2.49pp;但 IFEval 上 miniTE 38.40% 低于 NVFP4 的 43.99%,排名任务相关。效率:完整 learner 更新 33,540 tokens/s,为 BF16(24,134)的 1.39×、TE NVFP4(22,801)的 1.47×;十次试验的 core study 给出配对 trimmed 加速 1.334×;同配方下专家前向较 TE U3045 几何均值加速 2.46×(1.587×–3.065×);BF16 backward 比 MXFP8 backward 快约 1.21×,梯度相对 L2 误差仅 0.001663 对 0.037653。strict 执行参考把 logp 差压到约 $10^{-8}$ 并在未对齐 run 恶化区间维持 reward。数值检查:28 项 bitwise 检查全部通过,fused 布局零偏差。系统观察:colocated RL 中 learner 时间从 47.04s 降至 42.56s,但权重转换/同步从 9.94s 暴涨到 55.26s,成为集成瓶颈;NVFP4 独立 serving 达 80,676 tokens/s,为 BF16(49,119)的 1.64×;GB200 对照显示真实预训练权重+DAPO 文本平均激活 126.2/128 个专家,而随机权重+mock 数据仅 50.8,说明均衡模块计时无法预测真实 learner 排名。
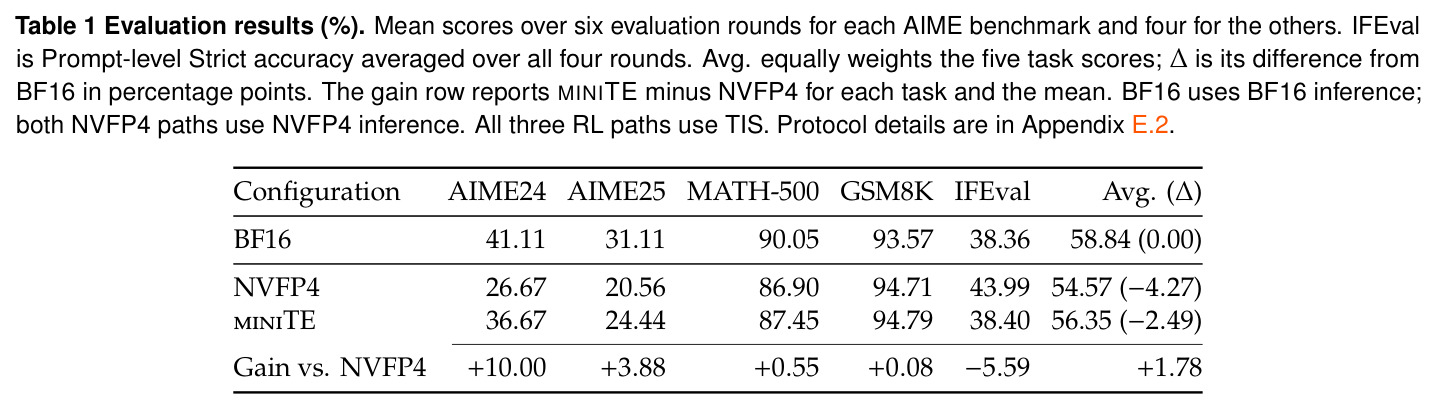
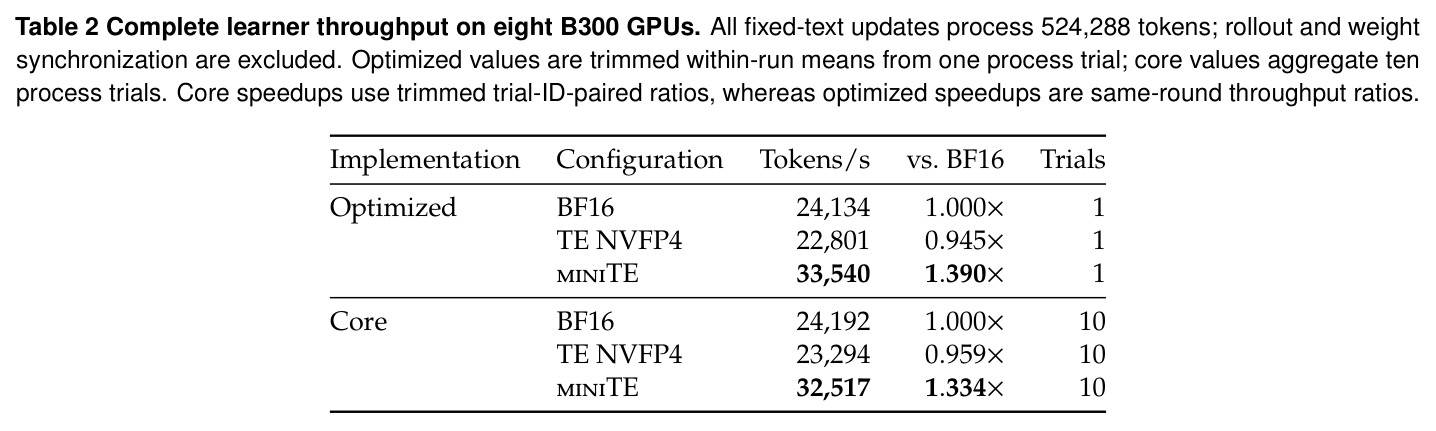
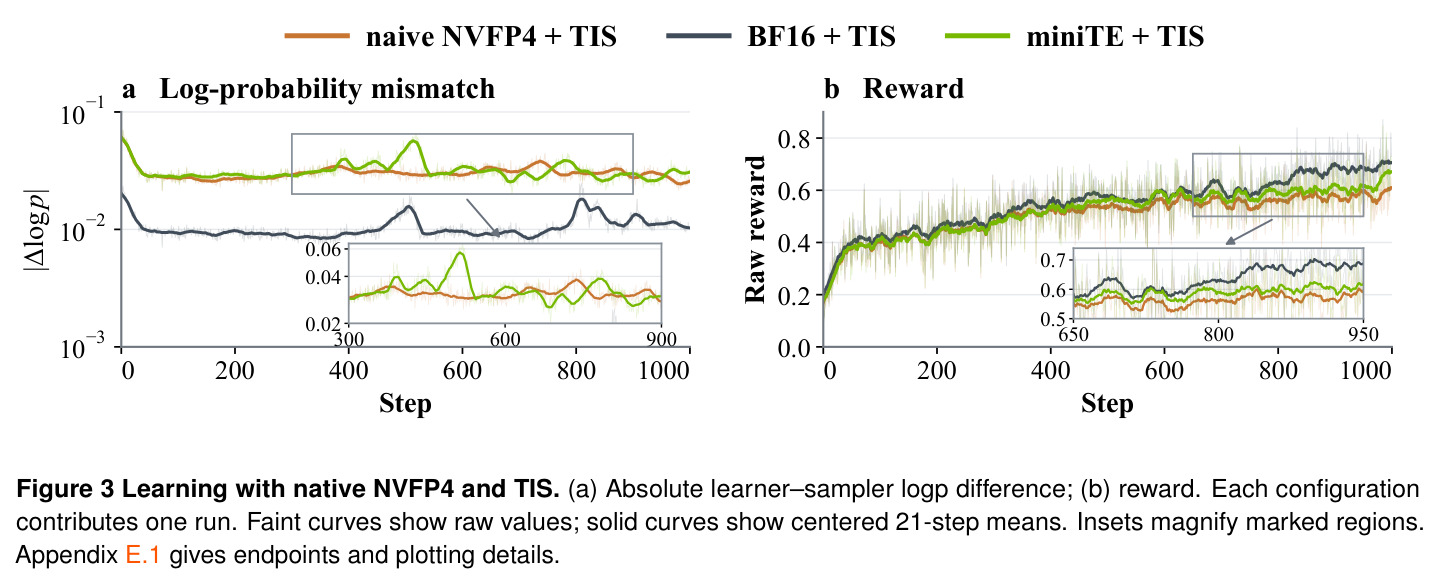
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| AIME 2024(数学竞赛) | 平均准确率 (%) | 36.67 | 朴素 TE NVFP4 26.67 / BF16 41.11 | 较 NVFP4 +10.00pp,仍低于 BF16 4.44pp |
| AIME 2025(数学竞赛) | 平均准确率 (%) | 24.44 | 朴素 TE NVFP4 20.56 / BF16 31.11 | 较 NVFP4 +3.88pp |
| MATH-500 | 准确率 (%) | 87.45 | 朴素 TE NVFP4 86.90 / BF16 90.05 | 较 NVFP4 +0.55pp |
| GSM8K | 准确率 (%) | 94.79 | 朴素 TE NVFP4 94.71 / BF16 93.57 | 较 NVFP4 +0.08pp |
| IFEval(指令跟随) | Prompt-level Strict 准确率 (%) | 38.40 | 朴素 TE NVFP4 43.99 / BF16 38.36 | 较 NVFP4 -5.59pp(任务排名反转) |
| 五任务平均 | 平均分 (%) | 56.35 | 朴素 TE NVFP4 54.57 / BF16 58.84 | 较 NVFP4 +1.78pp,较 BF16 -2.49pp |
| 完整 learner 更新(8×B300,524,288 tokens/更新) | tokens/s | 33,540(core study 32,517,配对 1.334×) | BF16 24,134 / TE NVFP4 22,801 | 1.39× BF16、1.47× TE NVFP4 |
| 专家前向模块(同配方,FC1/FC2×4 种负载) | 几何平均加速比 | 2.46× | TE U3045 per-token 实现 | 范围 1.587×–3.065× |
| 独立 serving 定长生成 | 输出 tokens/s | NVFP4 80,676 | BF16 49,119 | 1.64× |
局限与改进
作者承认:实用路径的五任务平均仍比 BF16 低 2.49pp,跨引擎一致性也不如 strict 执行;执行对齐并不能消除 E2M1/E4M3 固有的量化误差;学习证据只覆盖一个 MoE 模型(Qwen3-30B-A3B)且每个配置仅一次运行;实现增益在 Blackwell 硬件上测得;colocated 测量只覆盖 learner 与权重同步两个阶段,无法断定完整 RL iteration 的快慢;IFEval 低于 NVFP4 说明评测排名任务相关。我补充几点:AIME 每轮约 30 题且每配置单 run,+10.00pp 这类差异缺乏方差估计;strict reference 同时去掉了 TIS,执行对齐的独立贡献无法归因;模块级 2.46× 加速的计时边界排除了 dispatch、FC2 输入在计时器外准备,与 learner 级增益参照系不同,两组数字不能互相外推;权重转换/同步 55.26s 的瓶颈只是被识别而未被解决;per-token 缩放要求推理引擎配合,跨引擎生态兼容性未讨论。
独立分析的弱点
第一,归因不干净:strict reference 同时改变执行对齐与取消 TIS 两个变量,无法判断稳定学习来自哪一项。改进方向是补一组 strict+TIS 的消融。第二,统计强度不足:每个训练配置只有一次运行,而 AIME24/25 每轮约 30 题、仅六轮平均,+10.00pp 的提升可能部分来自种子噪声;改进方向是至少 3 个种子重复并报告方差。第三,端到端收益未证实:learner 快了 4.48s 但权重转换/同步慢了 45.32s,两阶段合计 56.98s 对 97.82s,完整 iteration 可能反而变慢;改进方向是 NVFP4 原生权重交换、增量同步或缓存量化权重以避免每步重转换。第四,泛化范围窄:仅一个 MoE 模型、纯数学数据(DAPO-Math-17k)、Blackwell 硬件,dense 模型、代码与 agent 任务、Hopper 等架构未验证;改进方向是先在小规模 dense 模型上验证诊断方法本身的普适性。第五,工程侵入性:per-token 缩放需要 sampler 端配合修改,若推理引擎不可改,则 miniTE 训练路径难以直接落地,此时可复用的主要是诊断框架而非训练实现。
未来方向
作者提出的方向包括:更紧的执行对齐与格式感知误差补偿结合,在保留原生 W4A4 的同时缩小与 BF16 的质量差距;在线 amax–量化–GEMM 融合,但需在 SM 资源约束下协调 scale 更新、accumulator 重缩放与数据搬移的软硬件协同设计;削减 learner–sampler 边界的重复权重转换与打包;跨模型、任务、独立种子与硬件平台的更广验证。基于本文成果还可延伸:把执行规范抽象推广到 FP8、MXFP4、FP6 等其他低比特路径,形成统一的「执行一致性测试套件」并接入 RL 基础设施的 CI 回归测试;针对权重转换/同步瓶颈设计原生低比特权重传输协议;利用三层参考体系(strict/operator/training)自动搜索数值配方;在端到端 RL iteration 层面做 learner 与 sampler 的联合调度与流水线优化。
复现评估
代码、kernels、诊断工具与训练配置开源于 https://github.com/InfiXAI/miniTE,并提供 Dockerfiles、参考配置与单命令启动脚本,可复现性设计较好。模型 Qwen3-30B-A3B-Base 与数据集 DAPO-Math-17k 均公开。算力门槛很高:完整 learner 基准需要 8×B300 GPU 节点(另有 GB200 对照实验),1000 步长程 RL 训练本身就是昂贵工程,且结果依赖特定版本的 Transformer Engine、推理引擎与 Blackwell 硬件。复现难度评估:完整复现训练结论属于大厂级资源;但论文的诊断部分(冻结策略打分、路由条件对照)算力需求低得多,用单卡或单节点在更小的 MoE 模型上即可验证「执行鸿沟存在」这一核心现象,对多数团队可及;工程团队也可以只借鉴其连续缓冲量化-GEMM 数据流与三层诊断接口的设计思想。
论文图表
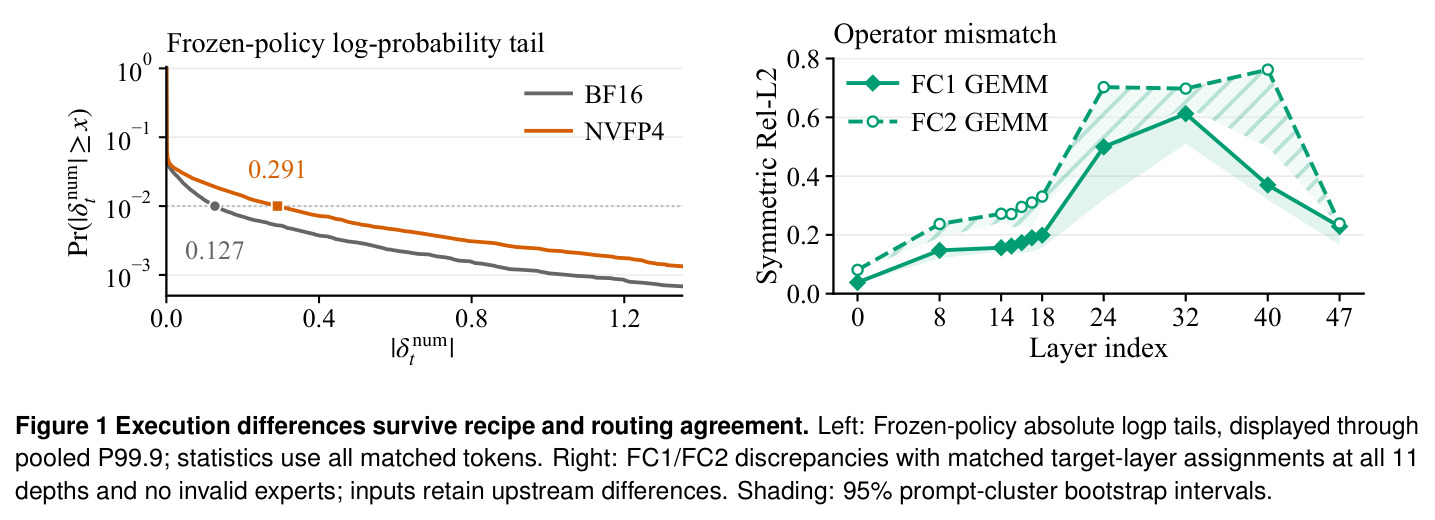
左图为冻结策略下 learner 与 sampler 的绝对 logp 差尾部(以合并 P99.9 展示,统计用全部匹配 token),显示 NVFP4 的尾部(P99=0.2911)明显大于 BF16(0.1271);右图在全部 11 个深度上固定目标层专家分配(无无效专家)后 FC1/FC2 输出的相对 L2 差异,输入保留上游差异,阴影为 95% prompt-cluster bootstrap 区间。
这是全文诊断的核心证据:一张图同时证明「格式一致不够」(左)与「路由一致也不够」(右)两个关键事实,是提出执行规范概念的直接依据。