ABF-Bench:面向智能体区块链取证的可验证基准 ABF-Bench: A Verifiable Benchmark for Agentic Blockchain Forensics
把区块链资金追踪变成可机械验证的智能体任务并实测LLM取证能力
前置知识
区块链资金追踪(Fund Tracing)
追踪被盗或非法资金在公共账本上的流动路径:确定价值从哪里来、到哪里去。公共账本不可篡改,每笔转账永久留痕,因此任何追踪结论都可以被另一位调查者独立复核。难点在于洗钱者会拆分资金、经DeFi兑换、跨链往返,并在混币器或托管服务处让链上线索中断。
本文的任务定义、参考图与边召回评分全部围绕“证据支撑的资金追踪”展开,不理解这一业务对象就看不懂任务形式化与评分设计。
UTXO 与账户模型
比特币采用UTXO模型:账本只记录未花费输出,一笔交易消耗旧输出、生成新输出,追踪沿“输出被谁花费”的链条前进;以太坊采用账户模型:账本维护每个账户的余额和交易历史,追踪沿账户间的转账边前进。两种模型对纯度判定和证据规则的定义完全不同。
ABF-Bench同时覆盖以太坊与比特币(共503条比特币UTXO边),纯度规则在两种账本模型上的不同判定方式是理解参考图构建的关键细节。
可验证奖励强化学习(RLVR)
用机械可检查的信号(如单元测试通过、数学答案正确)作为奖励来后训练模型,是当前推理模型与LLM智能体训练的主流范式。SWE-bench等带机械检验的基准同时充当训练环境,但前沿模型在这些套件上已接近饱和,社区亟需新的可验证领域。
论文的深层动机就是为RLVR开辟代码与数学之外的新训练域:区块链取证中每个操作的判定天然可由账本记录机械核验。
混币器、托管服务与地址投毒
混币器把大量用户的资金混合以切断链上关联;托管服务(如交易所)的内部账本对外不可见,资金充值后控制权移交、链上追踪被迫中止;地址投毒是攻击者向受害者的地址历史中植入外观相似的山寨地址,诱导调查者记错或转错地址。
这三者是任务中“追踪停点”的主要来源;能否识别未披露的托管服务正是智能体(89%)远超固定顺序追踪器(0%)的关键考点。
智能体脚手架(Agent Harness)
包裹在LLM之外的工程结构:工具调用接口、上下文管理、提示规则、记忆机制等,决定模型如何与环境交互。Codex、Claude Code是通用脚手架;同一个模型配不同脚手架,任务表现可相差数十个百分点。
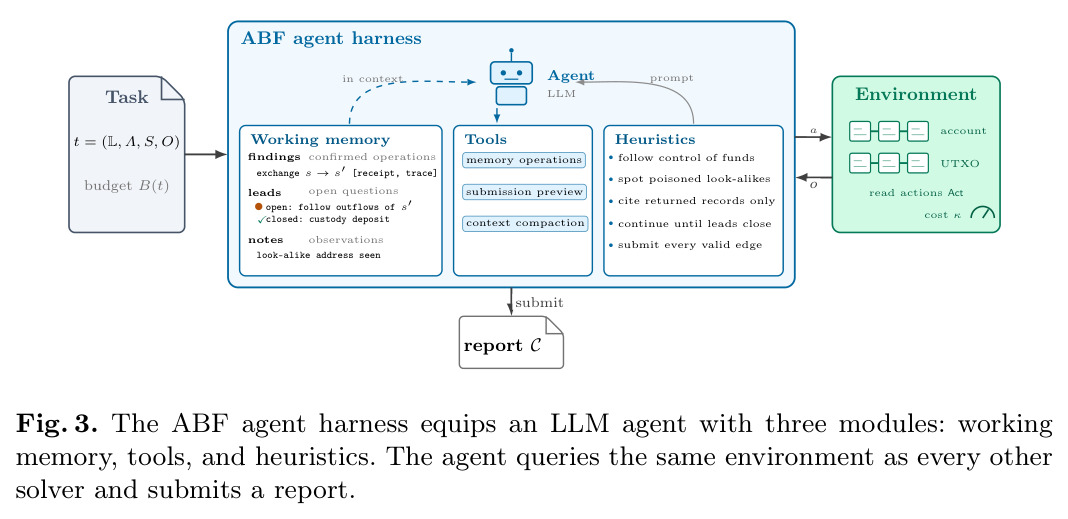
本文的核心对照实验就是固定模型只换脚手架:ABF harness与Codex共用GPT-5.5,边召回0.75对0.47,直接证明脚手架设计本身值28个百分点。
研究动机
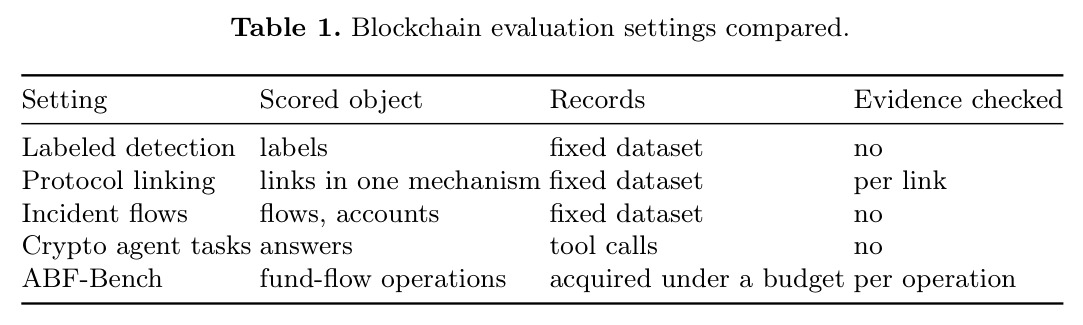
资金追踪是反洗钱合规与安全事件响应的核心:仅2024年一年,攻击者就从加密货币平台窃取22亿美元。洗钱是强对抗性活动——攻击者把资金拆分到多个账户、经交易所/混币器/桥路由、跨链往返,且每次事件手法都不同:已有研究表明学得的检测模型在市场关闭事件后会急剧退化,固定程序式追踪总是落后于新手法。调查者必须自己决定查询哪些记录、并判断这些记录支持什么结论,同时结论必须能被第三方独立核查。然而现有评测资源各有缺口:Elliptic/Elliptic2只评标注交易检测(不查证据);LOCARD、XSplicer只评单一协议机制内的链接;事件流重构类工作同样不检查证据;现有加密智能体任务评答案但不核查证据来源。没有任何现有设置能在受控的记录访问与查询预算下,评估“智能体自己开展调查”这一完整过程。
本文的目标是本文要把“证据支撑的链上资金追踪”形式化为可交互、可机械验证的智能体任务,并据此构建ABF-Bench。具体目标分三层:其一,任务层——每个任务给定种子地址与追踪范围,智能体在统一计量的查询预算内自行决定获取哪些账本记录,提交的每一笔资金移动都必须引用它实际检索到的账本记录作为证据;其二,评测层——确定性验证器逐操作核查证据是否支持该声明,独立评分器对照隐藏的参考图计算边召回,使验证与评分解耦;其三,社区层——真实对手(Bybit被盗案的洗钱者)提供无需人工策划的难度,公共账本让每条声明可机械核验,使基准既能横向比较智能体策略,又能充当可验证奖励强化学习的候选训练环境。
与已有工作不同的是,本文的独特切入角度有三。第一,验证与评分彻底分离:验证器只判断引用的记录是否支持所申报的操作,完全不依赖参考答案,因此任何满足证据规则的替代证据同样有效——这允许智能体找到与参考witness不同但同样合法的证据路径;而参考图从头到尾对求解器隐藏。第二,难度无需人工策划:真实洗钱事件天然产生任务实例,参考图的每条边都保留可检索、可通过验证器的witness。第三,检索条件直接惩罚记忆幻觉:参考边只有在智能体亲自检索过其引用的每条记录时才算恢复,专门针对LLM“引用未读取的记录”这一过度自信失败模式设计——评测中Claude Code的召回从宽口径0.54被压到严格口径0.10,正是该设计暴露出的真实缺陷。
核心方法
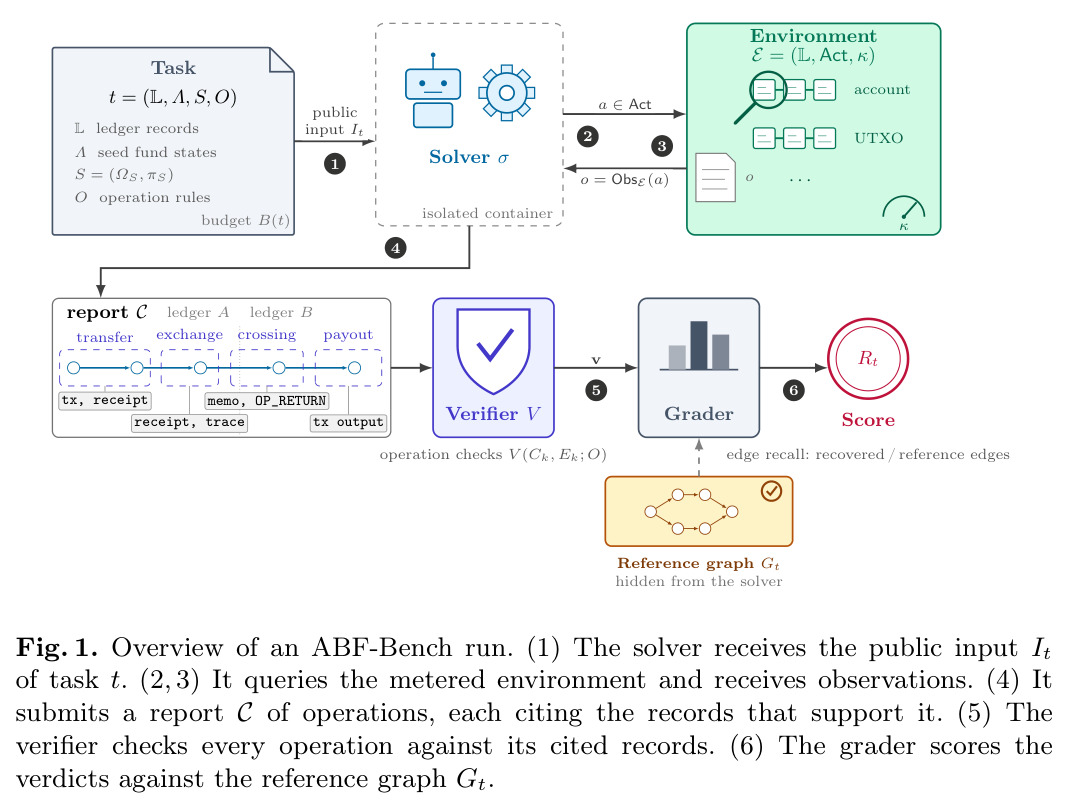
ABF-Bench是四元组 $\langle \mathcal{T}, \mathcal{E}, \mathcal{V}, \sigma_{GT}\rangle$:任务集、证据环境、确定性验证器与参考求解器。任务 $t=(\mathcal{L},\Lambda,S,\mathcal{O})$ 含账本记录集 $\mathcal{L}$、种子资金状态集 $\Lambda$、声明 $S=(\Omega_S,\pi_S)$(范围与混币分摊约定)和操作证据规则 $\mathcal{O}$;资金状态 $s=(\ell,a,x,p)$ 由账本、账户、资产与记录定位符组成。求解器在环境 $\mathcal{E}=(\mathcal{L},\mathrm{Act},\kappa)$ 中每次良构查询成本为1,可获取活动列表、回执、执行trace、UTXO花费等观测,累计成本不得超过预算 $B(t)=2\eta(t)+\delta(t)$(由参考计划校准:$\eta(t)$ 为参考检索动作数,$\delta(t)$ 为按来源持有物计的活动列表数)。结束时提交报告 $\mathcal{C}$,声明分组为操作;验证器输出三值裁决 $v_k=\mathcal{V}(C_k,E_k;\mathcal{O})\in\{1,0,\bot\}$(有效/无效/不确定),评分器对照隐藏参考图 $G_t$ 计算边召回 $R_t=|\mathcal{M}_t|/|G_t|$,检索条件要求solver亲自取回每条被引记录。
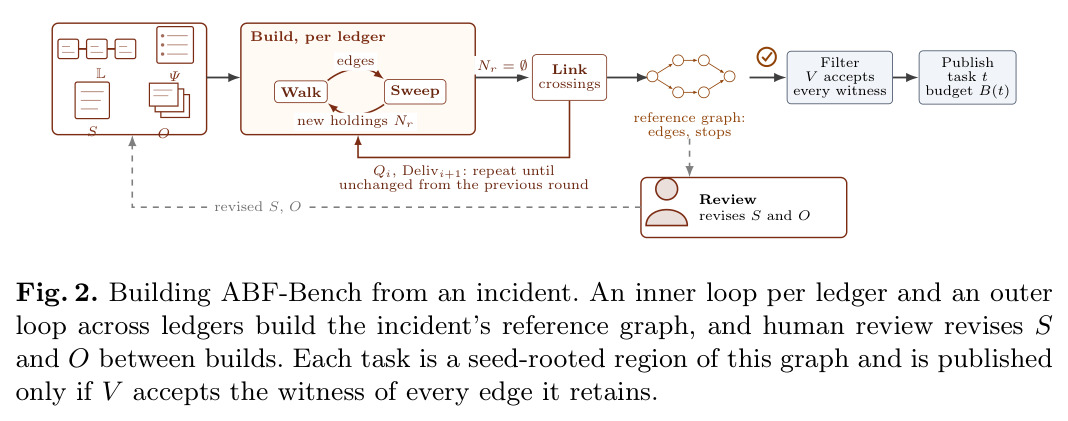
核心创新是“证据引用+检索条件+保守停点”的组合拳,与已有基准的本质区别在于评分对象从“标签/答案”变成“带证据的资金流操作”。(1) 每条声明 $c=(s,s',q)$ 断言数量 $q$ 的资金从状态 $s$ 移到 $s'$,必须附引用 $A(c)$——账本记录定位符集合;操作组 $C_k$ 的证据 $E_k=\mathcal{L}|_{A(C_k)}$ 由验证器按 $\mathcal{O}$ 中该类型的规则判定,例如兑换需要回执加执行trace,跨链需要配对的存款与提款记录。(2) 检索条件:参考边只有在报告含有效操作且运行确实检索过其引用的每条记录时才计入恢复——引用环境未提供过的记录不算数,直接杜绝模型凭预训练记忆“脑补”账本内容。(3) 纯度规则保证参考图保守:仅当持有物只含被盗价值时才留在追踪区域内,外部资金混入即离场(比特币按交易非尘输入判定);记录无法解决的延续一律设停点(未披露托管、混币存款后出口不追),使参考图成为真实洗钱流的下近似,且每条边都有预算内可检索的witness。
方法步骤详情
构建与运行分四步。(1) 种子确定:以2025年2月Bybit被盗案为案例,追踪90天、跨以太坊与比特币,种子来自FBI公告与Bybit公布的事件地址。(2) 账本内迭代:以太坊上Walk沿当前前沿扩展,Sweep重放账本判定哪些持有物在哪些时间区间内只含被盗价值,直到新增集合 $N_r=\emptyset$ 且归属判定全部收敛;比特币用输入归属规则下的交易重放替代该循环。(3) 跨账本迭代:Link把有证据的桥存款与提款配对,为目的地账本提供入口记录;第 $i$ 轮产出比特币入口 $Q_i$ 与回程交付 $\mathrm{Deliv}_{i+1}$,要求 $(Q_i,\mathrm{Deliv}_{i+1})=(Q_{i-1},\mathrm{Deliv}_i)$ 才停止以避免振荡。(4) 人工审核在两轮构建间修订种子/边界/规则;选出的种子根区域两两边重叠不超过较小图边数的25%,发布过滤器要求验证器接受每条保留边的witness——58个任务产出,33个通过发布,31个进入评测。ABF harness给LLM三模块:working memory(findings/leads/notes三节)、工具(记忆操作、提交预检、上下文压缩)和5条启发式(跟随资金控制权、核对投毒仿冒地址、引用值须来自返回记录、穷尽线索或预算才停、提交每条有效边)。
技术新颖性
与已有工作的区别可用Table 1的四个维度刻画:标注检测(Elliptic)评标签、固定数据集、不查证据;协议链接(LOCARD的对应任务、XSplicer的证据化跨链)只评单一机制内的链接;事件流重构(AMLGuard)评流与账户但不查证据;既有加密智能体任务(CryptoBench、AI-ABC)评答案、有工具调用但无证据核查。ABF-Bench的评分对象是资金流操作,记录在预算内按需获取,且逐操作检查证据。技术细节上的新颖点还包括:边以“锚定交易+规范形式的目标资金状态”识别,两条描述落到同一落点算同一条边;验证器的三值裁决 $\{1,0,\bot\}$ 把“证据缺失”与“证据矛盾”分开,检索失败留为不确定而非误判为错误;求解器申报的操作类型只是建议性的,裁决完全取决于声明与引用记录本身;有效但越过停点的边由边精确率惩罚;固定顺序tracer独立于生成器与验证器代码、仅凭公共任务规范实现,事实上充当了规则的独立测试(所有solver至少94%的操作被验证器接受)。
实验结果
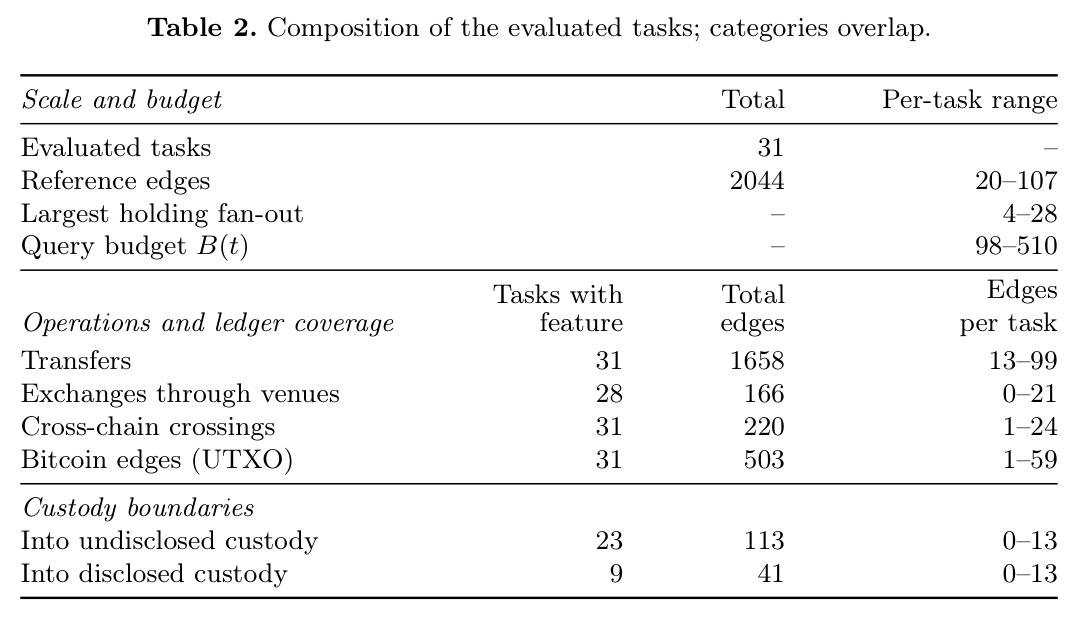
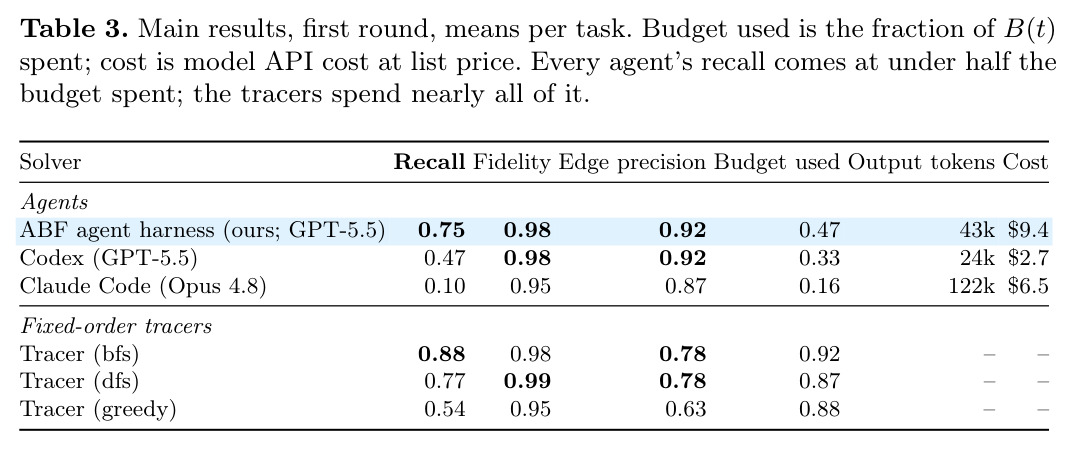
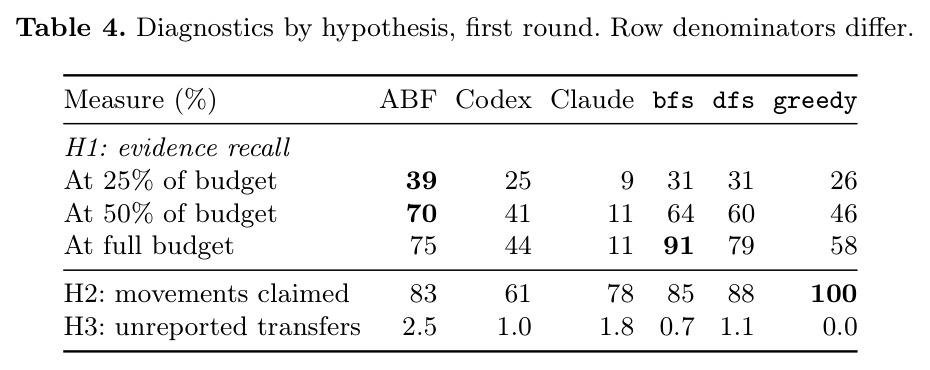
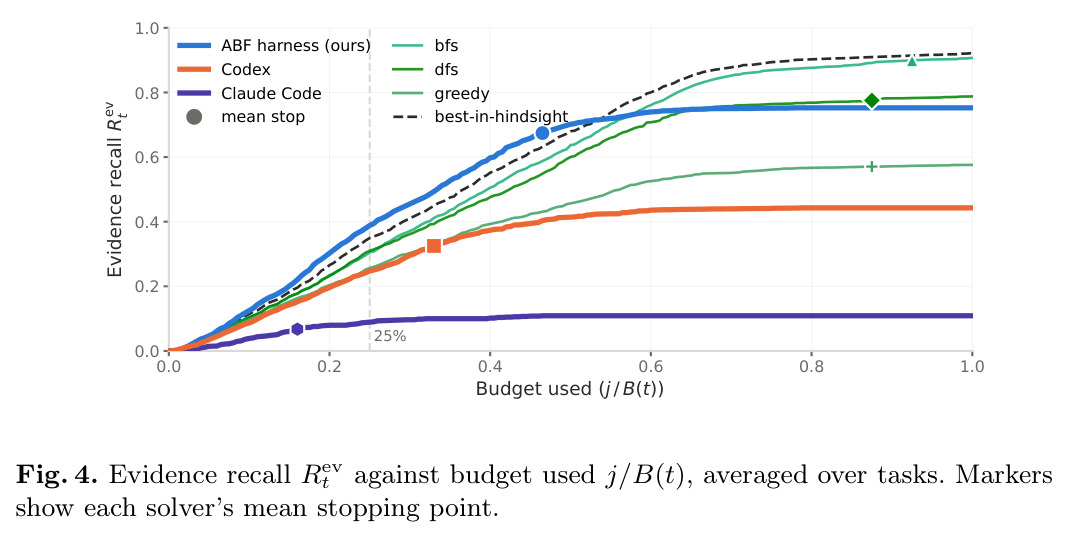
评测在31个任务上进行(2044条参考边,每任务20–107条),首轮均值结果如下。边召回(主指标):ABF harness 0.75,同模型(GPT-5.5)的Codex 0.47,Claude Code(Opus 4.8)仅0.10,tracer中bfs最高0.88(dfs 0.77、greedy 0.54)。保真度:harness与Codex均0.98、与bfs持平,Claude Code 0.95;边精确率harness 0.92高于tracer的0.78——tracer跟随托管sweep越过未披露托管,产生367条参考图外的有效边。Claude Code的0.10由检索条件造成:宽口径召回为0.54,29/31次运行引用了未检索记录。H1效率:预算用25%时harness证据召回39%超过best-in-hindsight tracer的35%;但所有agent提前停止——harness平均只花47%预算(tracer花87–92%),54%预算点后被反超,最终证据召回75%对bfs的91%。H2适应性:harness认领83%已检索操作(bfs 85%);未披露托管识别完胜——agent在可达托管点停走约四分之三以上而tracer为0%;bfs到达87%的托管参考边而harness只63%,说明“到达”与“识别”偏好不同方法。H3可靠性:漏报已检索转账至多2.5%。召回随任务规模下降(最小三分之一任务0.82,最大三分之一0.69),与最大扇出相关性(Spearman $\rho=-0.66$)强于与边数相关性($-0.41$)。重复运行类内标准差0.18/0.17,均值差<0.01。
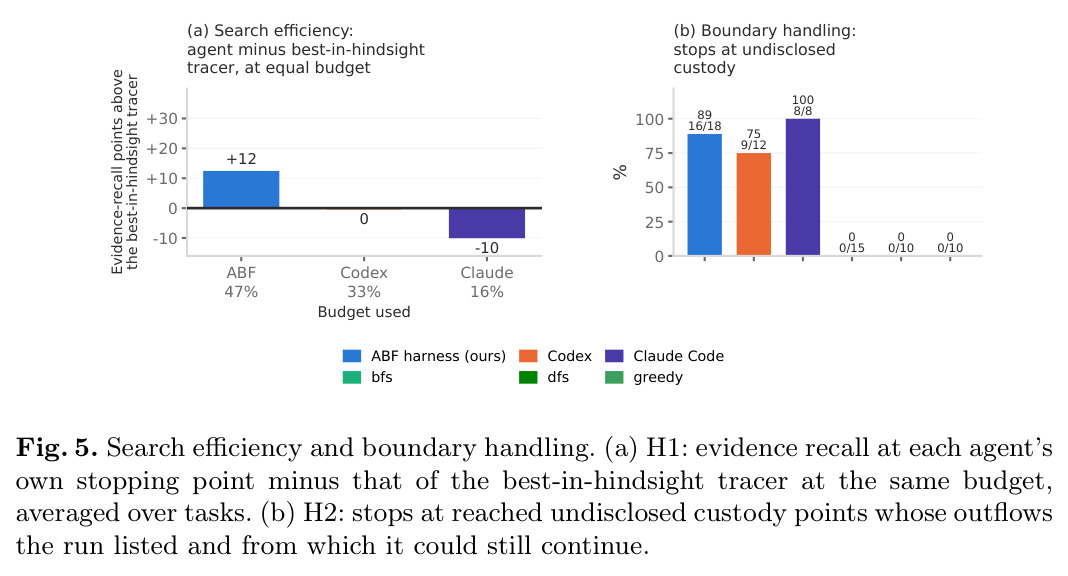
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 边召回(31个跨链资金追踪任务) | Edge recall(宏平均) | ABF harness 0.75 | Codex (GPT-5.5) 0.47;Claude Code (Opus 4.8) 0.10;bfs tracer 0.88 | 相对同模型Codex提升28个百分点(0.47→0.75),但仍低于bfs tracer的0.88,留有提升空间 |
| 保真度(提交操作通过验证器的比例) | Fidelity | 0.98 | bfs tracer 0.98;Claude Code 0.95 | 与最强规则方法持平,验证了H3:智能体的证据组装可以接近规则方法的可靠性 |
| 未披露托管识别(可达且可继续的托管点停止率) | 停止比例 | 智能体约四分之三以上(摘要口径89%) | 固定顺序tracer 0%(所有停点均因预算耗尽) | 规则方法完全无法从行为推断托管边界,智能体具备识别能力 |
| 早期证据获取(预算25%时的证据召回) | Evidence recall | ABF harness 39% | best-in-hindsight tracer 35%;Codex 25%;Claude Code 9% | 超过最优规则追踪器,支持H1:智能体早期检索效率更高 |
| 每任务模型API成本 | 美元(牌价) | harness $9.4(43k输出token) | Codex $2.7(24k);Claude Code $6.5(122k) | 成本更高但召回显著更好,token效率优于Claude Code |
局限与改进
作者承认四点局限。(1) 单一事件:整个套件只覆盖Bybit一案,结论能否推广到其他洗钱手法未知,更多案例在准备中。(2) 训练暴露:事件公开且早于被评估模型,服务文本刻意隐去Bybit与Lazarus名字,但Claude Code仍在21/31份转录中点名事件(Codex 2/33、harness 0/33),记忆可能污染适应性评估。(3) 保守规则:参考图在记录无法解决延续处一律停点,边召回只是真实洗钱流的下近似。(4) 整系统比较:每次对比同时改变脚手架、模型与查询策略,无法归因到单一组件;agent停早后未用预算能回收多少证据未被测量。我的补充观察:(i) 预算公式 $B(t)=2\eta(t)+\delta(t)$ 完全由参考计划校准,对检索策略迥异的agent可能偏紧或偏松,预算敏感性未单独消融;(ii) 证据规则只承认账本记录,协议证明、公开的交易所内部记录等其他证据类被排除,可能低估合法取证手段;(iii) 未披露托管“可从记录推断”的判定依赖人工审核质量,主观性未量化;(iv) 单任务重复运行标准差高达0.18,31个任务下单任务结论噪声大,宏平均比单任务数字更可靠。
独立分析的弱点
独立分析的弱点:(1) 记忆与能力的纠缠——Claude Code点名事件的比率(21/31)暗示其“过度自信”部分来自预训练记忆而非推理,基准无法区分“会查”与“背过”,改进方向是引入模型知识截止日期之后的新事件做纵向对照。(2) 提前停止无惩罚——所有agent只用16–47%预算,未检查分支含有harness未见的25%参考边(Codex超过一半),评分函数对预算浪费零激励,改进方向是把预算使用率或时间加权召回纳入排名。(3) 保守停点可能系统性漏掉混合资金——纯度规则遇到外部资金混入即离场,面对真实混币器后的多路分拆几乎无能为力,改进方向是增加基于比例分摊的辅助软指标。(4) 检索条件只作用于召回——保真度默认不检查引用是否被检索过,Claude Code的保真度要套用同样条件才从0.95降到0.23,两个指标口径不一致,改进方向是统一把检索条件纳入所有指标。(5) 参考图构建依赖人工审核闭环,作者未报告审核者间一致性,改进方向是发布标注协议与一致性统计。
未来方向
作者明确提出的方向:(1) 发布更多事件的案例扩展套件,检验结论的跨事件泛化;(2) 把ABF-Bench作为可验证奖励的训练环境——每个操作可机械裁决、真实对手提供难度,使强化学习超越代码与数学域,反过来把智能体进展转化为链上洗钱调查能力;(3) 用更好的agent设计填补bfs的0.88与harness的0.75之间的差距。基于成果可延伸的研究:(1) 把harness的working memory(findings/leads/notes三节结构)迁移到其他长程调查型任务,如安全事件响应与尽职调查;(2) 研究“何时停止检索”的显式决策模型,因为提前停止是所有agent的共同失败模式;(3) 扩展到更多链(Tron、Solana)与更复杂操作(隐私协议、嵌套混币、闪电贷);(4) 以best-in-hindsight tracer的检索轨迹为教师做模仿学习或强化学习热启动;(5) 评估多智能体分工协作(搜索者/证据审核者/报告者)在预算约束下的收益。
复现评估
论文声明基准“将于发表时发布”,目前尚未开源,可复现性取决于作者后续发布任务、验证器、评分器与harness代码。发布后的复现要点:(1) 每个任务自带公共输入、查询成本与预算,验证器与评分器均确定性,所有solver获得相同输入;重跑评测(tracer、Codex、Claude Code)只需实现证据接口的客户端;(2) 服务端需要能访问以太坊与比特币账本数据的接口(论文未说明具体依赖的节点或API服务,这是复现的最大不确定性);(3) 算力与成本门槛低:tracer在2GB内存限制下本地运行零成本,agent评测每任务约$2.7–9.4(GPT-5.5/Opus 4.8),31个任务单轮约$100–300,普通实验室可承受;(4) 基准重建难度高:Walk/Sweep/Link流水线、纯度判定与人工审核需要区块链取证专业知识与大量工程投入,普通团队建议直接使用发布任务而非重建。总体而言评测复现难度中等偏低,基准重建难度高。
论文图表