Event-STVG:面向长视频事件推理的时空视频定位基准 Event-STVG: Spatio-Temporal Video Grounding for Long-Form Event Reasoning
将时空视频定位从描述式定位重构为长视频事件级推理,最强模型10分钟下仅5.4% m-vIoU
前置知识
时空视频定位(STVG)
Spatio-Temporal Video Grounding 要求模型在未剪辑视频中,根据自然语言查询同时在时间轴上定位目标区间、并在空间上框出目标实体,输出“什么时候+在哪里”的联合结果。传统基准如 VidSTG、HC-STVG 的查询会描述目标的外观、动作和关系,本质是描述引导的实例匹配。
本文提出的 Event-STVG 是对 STVG 任务定义的重构:只有先理解传统 STVG“查询描述外观动作、输出单一目标的时间和框”的设定,才能看清新任务把查询换成“事件类型+序数+角色”后,难点如何从实例匹配转移到事件解析与角色填充推断,也才能理解论文与 VidSTG、HC-STVG 等基准对比时的定位。
m-tIoU 与 m-vIoU 指标
tIoU(时间交并比)衡量预测事件区间与真实区间的重叠程度;vIoU(视频交并比)进一步在时间重叠帧上计算边界框的空间 IoU 并沿轨迹平均,本文将其扩展到多角色:先在事件内对角色等权平均,再对事件平均得到 m-vIoU。vIoU@0.3/@0.5 是事件级 vIoU 超过阈值的事件占比。
论文所有实验表格(Table 2–4)和错误分析结论都用这些指标表述:m-tIoU 对应“时间找对没”,m-vIoU 对应“人框对没”,oracle 设置只看 m-vIoU、端到端设置看两者。不理解其计算方式,就无法明白为什么“时间定位正确但空间 grounding 失败”会导致总分接近零,也读不懂 $\mathrm{Gap}_{SG}$ 这个诊断指标。
多模态大语言模型(MLLM/VLM)
以大语言模型为骨干、能接收图像或视频输入的模型,如 Gemini、GPT、Qwen-VL、GLM-4.6V 等。它们通常把视频采样成帧序列送入视觉编码器再由语言模型推理,能处理分钟级上下文,但在细粒度时空定位、跨帧实体跟踪上能力有限。
Event-STVG 的评测对象就是 MLLM:论文用 10 个模型(9 个通用 VLM 加 1 个 STVG 专用模型 PTD)系统暴露它们在长视频事件推理上的缺陷。了解这类模型“抽帧+视觉编码+语言推理”的工作方式,才能理解输入接口差异(帧数、分辨率、原生视频)对分数的影响以及附录中的对照实验设计。
语义角色(semantic role)
事件的角色模式 $R(E)=\{r_1,\dots,r_K\}$ 定义一个事件由哪些参与者构成,如足球射正事件的 last passer(最后传球者)、shooter(射门者)、goalkeeper(门将)。角色身份由其与事件的关系决定而非实体外观,查询不描述参与者长什么样,模型必须自己推断谁填补哪个角色。
Event-STVG 与传统 STVG 的本质区别就是要求 grounding 事件的语义角色填充者而非被描述的实例:角色由事件结构定义、与外观无关,因此查询不会透露“穿红色球衣的是射门者”这类线索,模型必须看懂进攻过程才能推断谁传球、谁射门、谁守门,这正是任务难度的来源。
序数索引(ordinal index)
同一事件类型在长视频中反复出现,形成有序序列 $E(V,E)=\langle E_1,\dots,E_n\rangle$。查询用序数(如“第三次射正”)指定目标,模型需要枚举所有同类型事件、按时间排序并选中第 $m$ 个,这要求对重复事件进行计数与消歧。
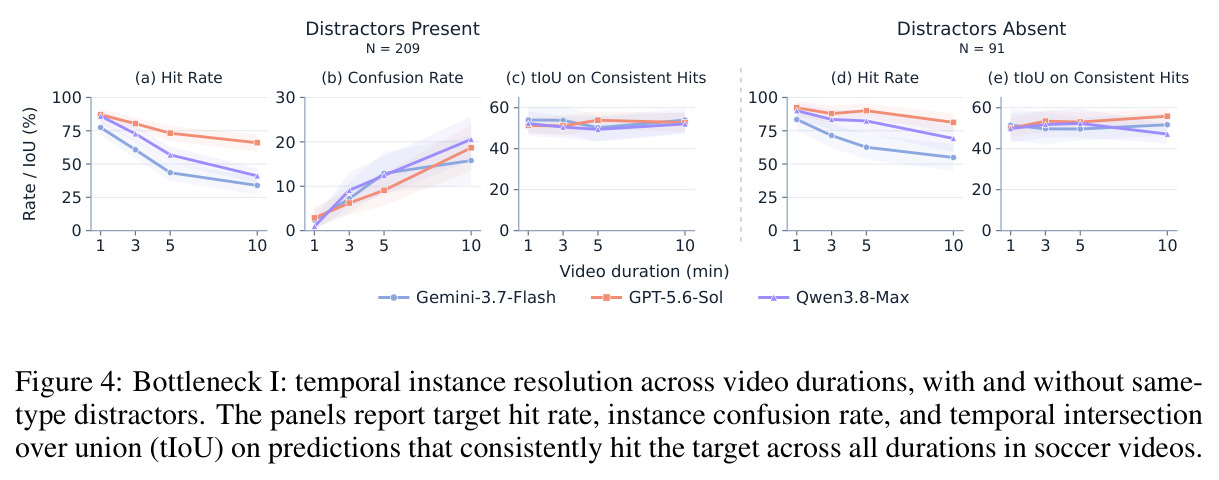
论文发现长上下文的首要瓶颈正是“选错是哪一次事件”:足球上下文含重复同类事件的比例从 1 分钟的 13.68% 升至 10 分钟的 68.69%,命中率随之骤降。理解序数消歧这一机制,才能读懂三级瓶颈分析中的第一瓶颈(Figure 4)以及“持续命中查询 tIoU 不降”这一关键对照。
研究动机
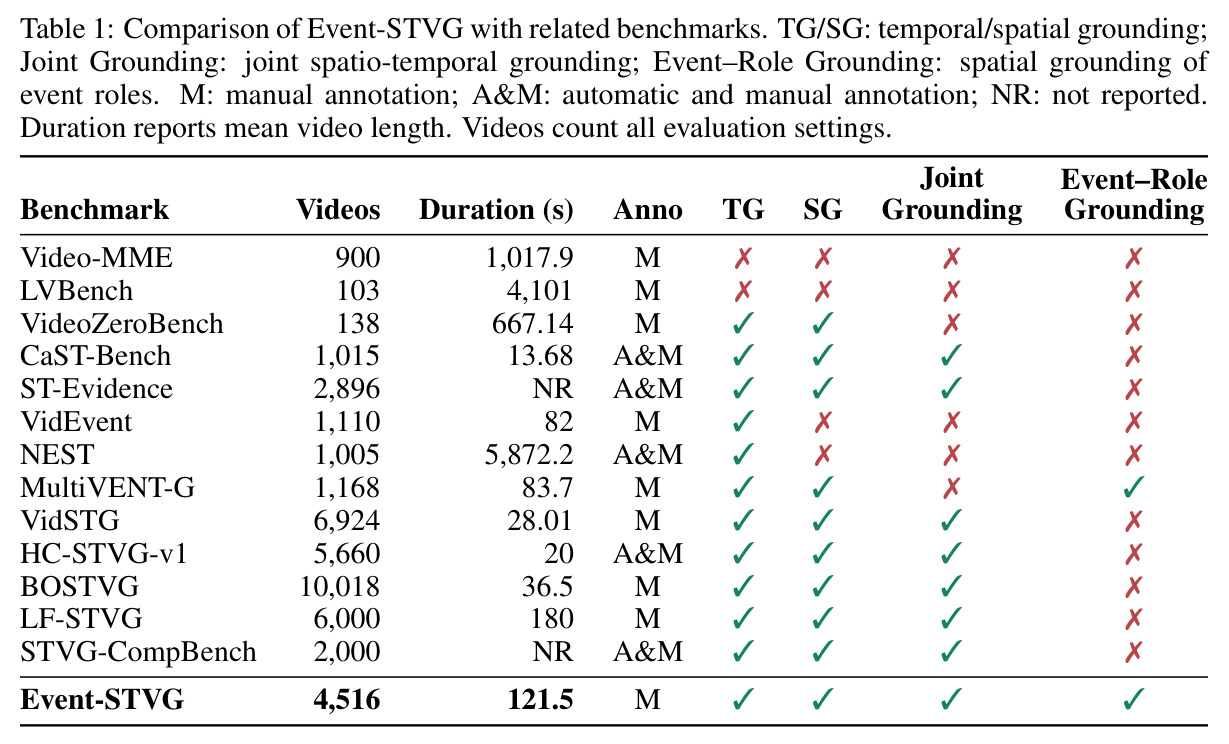
现有 STVG 基准(VidSTG、HC-STVG、BOSTVG、LF-STVG 等)的查询都是描述式的:用外观(如“扎马尾的女子”)、动作和与其他人的关系直接指明目标,模型只需完成“语言描述—视觉实例”的匹配。这些基准的视频也很短:HC-STVG 平均约 20 秒、VidSTG 约 28 秒、BOSTVG 约 36.5 秒,即便面向长上下文的 LF-STVG 平均也只有 180 秒,且从不追问“这是该类事件第几次发生”。随着 MLLM 的发展日益强调长上下文时序推理、重复事件消歧和结构化角色推断,传统 STVG 与之严重脱节:它评测的只是描述条件下的检测与定位,无法回答“模型能否理解一个反复出现的结构化事件,并指出其中某一次的参与者是谁”。
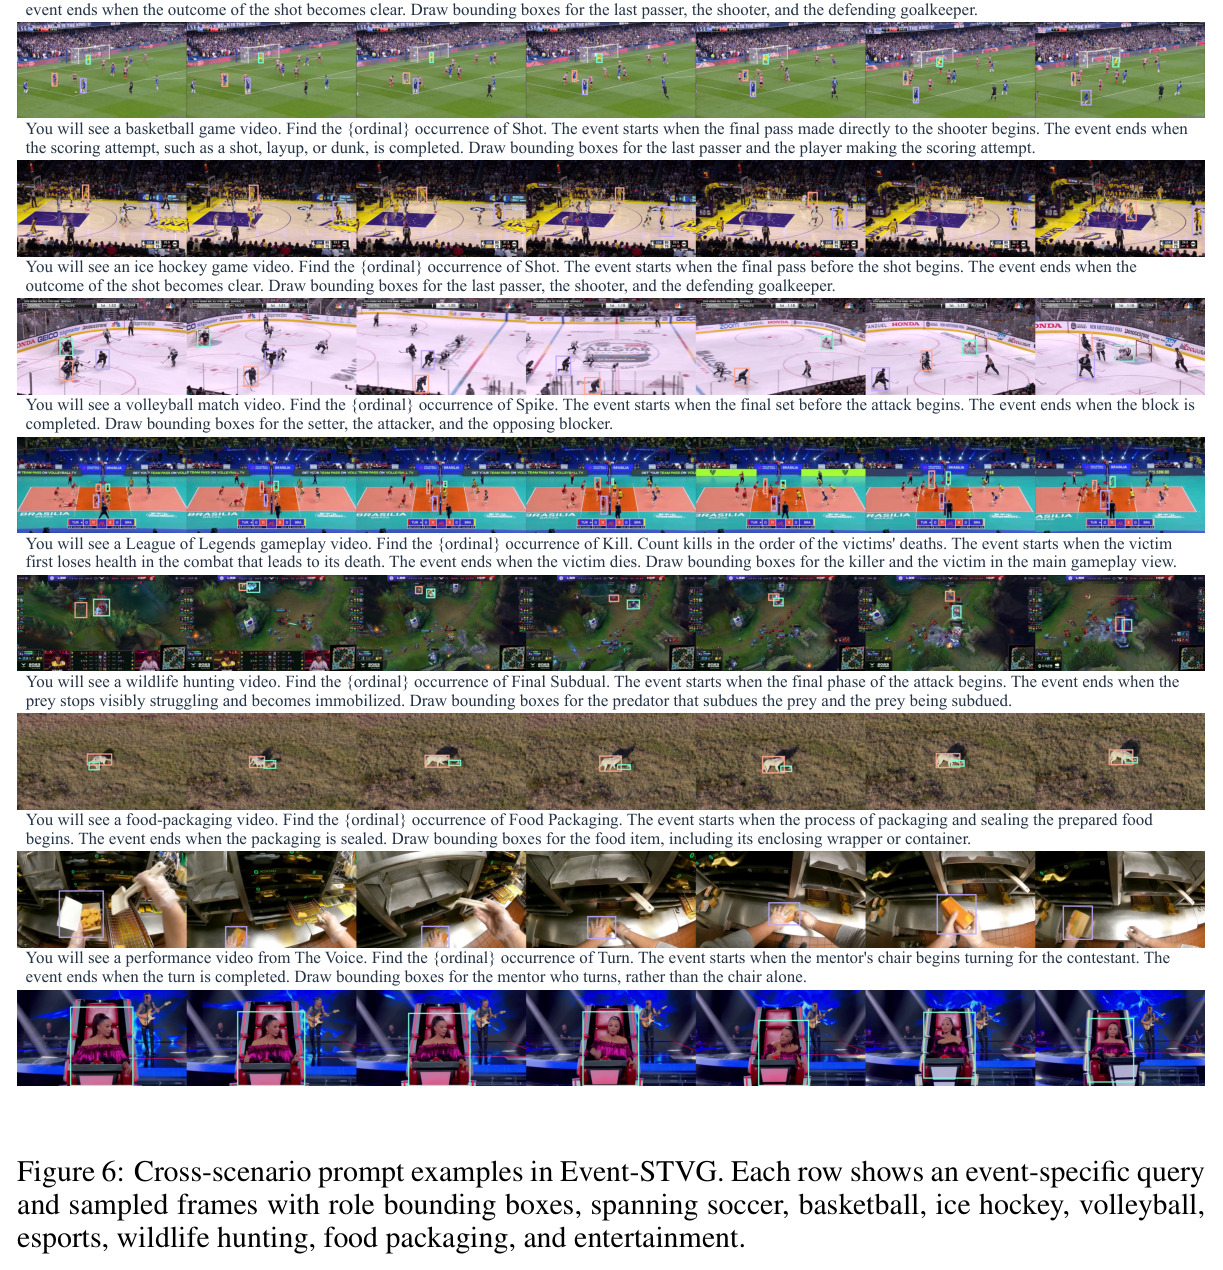
本文的目标是本文要把 STVG 从“定位被描述的目标”重构为“事件级推理”测试:给定事件类型、序数索引 $m$ 和所需角色集合 $R_q \subseteq R(E)$,模型必须(1)在长视频中解析出第 $m$ 次事件发生的时间区间 $\tau_m=[t_s^m, t_e^m]$;(2)推断每个角色由哪个实体填充;(3)在事件区间内联合输出所有角色实体的逐帧边界框轨迹。为此作者构建同名基准:4,016 个人工标注事件实例,覆盖足球加另外 7 个领域,共 26 种事件类型、30 种语义角色、7,323 个事件—角色对、59,381 个边界框;同时用 10 个模型(9 个通用 VLM 与 1 个 STVG 专用模型 PTD)做系统评测,并通过三级错误分析定位失败模式。
与已有工作不同的是,独特切入是“事件—角色联合 grounding”这一此前无人覆盖的组合:VidEvent 和 NEST 做事件时间定位与结构化论元理解,但不做角色的空间定位;MultiVENT-G 有角色级空间证据,却把时间检索和空间检索拆成两个子任务;imSitu 一脉的情境识别在图像或预切分短视频上标注角色,不需要事件时间定位。Event-STVG 首次要求“目标事件的时间定位 + 其语义角色填充者的空间定位”同时完成,并用序数索引把重复事件消歧变成硬性要求,从而把 STVG 与 MLLM 的长上下文推理评测真正接轨;论文还用“oracle→1 分钟→3/5/10 分钟”的分层设置解耦并归因不同能力缺陷。
核心方法
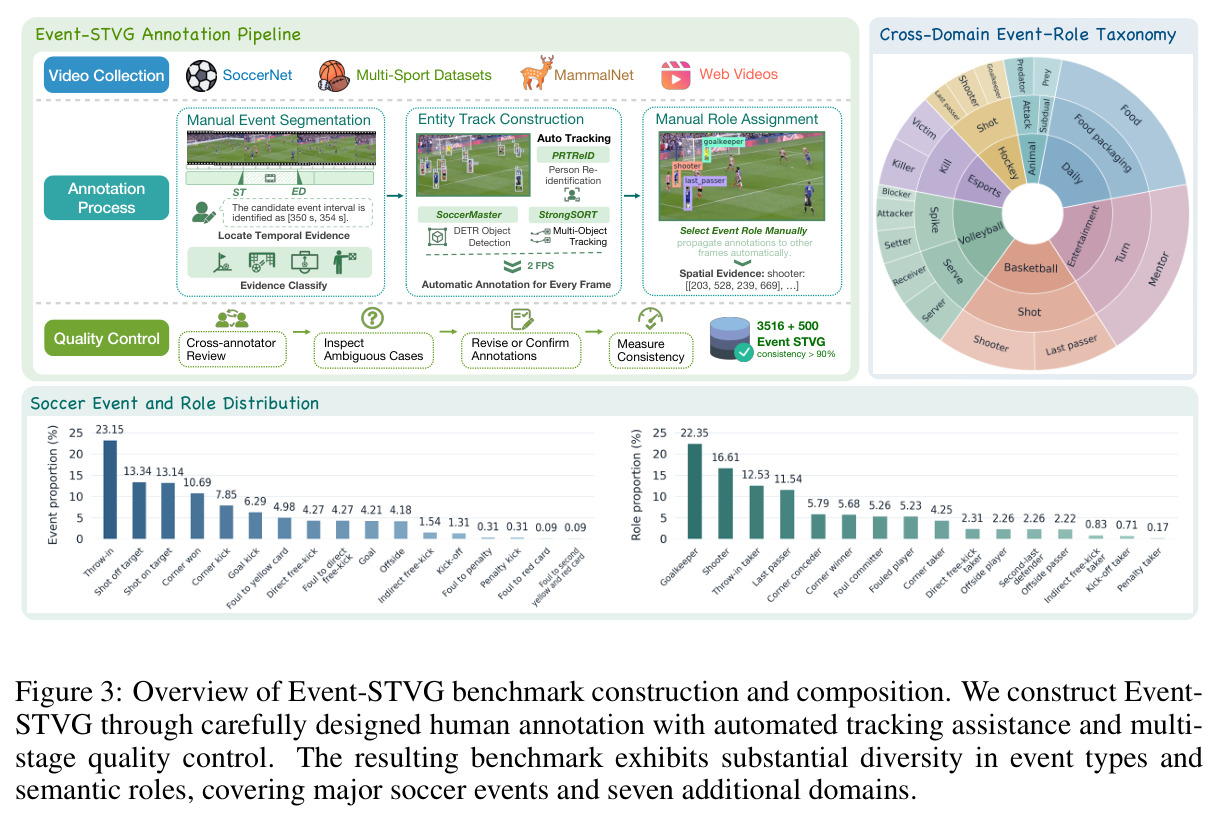
先看直觉:让模型看一段足球比赛并问“第三次射正事件的最后传球者、射门者、门将分别在哪儿”,它必须先数出所有射正、锁定第三次,再看懂这次进攻的传跑结构并逐帧框人——远难于“找到扎马尾的女子”。技术路线上,论文选足球为主领域(球员外观相似、场景一致、多人交互,最能放大推理难度):从 SoccerNet-v2 事件标注自动检索候选事件,标注员按事件特定规则手工确定起止;再用 SoccerMaster 的 DETR 检测、PRTReID 重识别与 StrongSORT 跟踪在 2 FPS 抽帧上生成候选轨迹,由标注员把轨迹绑定到语义角色,可随时改判、删框、补框——自动输出只是辅助,全部真值轨迹经人工校验。评测上下文从 oracle 事件窗口扩展到最长 10 分钟,序数在每种上下文内重新计算;其余 7 个领域(篮球、排球、冰球、动物捕猎、快餐打包、娱乐节目、电竞)用源数据无关的统一流程标注 500 个事件,组成 100 个分钟级评测视频。
核心创新是“事件类型 + 序数 + 角色”三元组查询设计:查询不描述参与者外观、也不描述事件如何展开,只说“第几次的什么事件、要框哪些角色”,迫使模型完成事件解析与角色填充推断。配套设计包括:(1)用规范角色动作定义事件边界,例如射正事件从最后传球者得球开始、到射门结果明朗结束,降低标注歧义;(2)oracle 设置直接给出真实事件区间、只评角色 grounding,从而把空间定位能力与时间检索能力解耦;(3)刻意利用同类型事件的重复出现制造干扰——足球上下文含重复同类事件的比例从 1 分钟的 13.68% 升至 10 分钟的 68.69%,其余领域 99.40% 的查询含重复同类事件,使“哪一次”成为核心考察点;(4)提出相对空间 grounding 差距等诊断指标,把端到端失败分解到三个层级瓶颈。
方法步骤详情
第一步,候选检索与事件切分:用 SoccerNet-v2 事件标注自动召回候选片段,标注员逐个检查并按事件特定边界规则(如“获得角球”从进攻球员得球创造角球开始、到防守者最后触球使球出界结束)手工标定起止,排除回放与特写。第二步,角色轨迹标注:以 2 FPS 抽帧,用检测/跟踪/重识别工具生成候选轨迹,标注员执行“选择—检查—纠正—补全”四步操作,把轨迹绑定到 last passer、shooter、goalkeeper 等角色,无法可靠定位的帧记为 invisible。第三步,上下文与序数构造:把目标事件放入 1/3/5/10 分钟上下文,在每种上下文内枚举所有合格同类事件、按时间排序、确定目标序数。第四步,质量控制:约 10% 数据双人交叉标注(时间 IoU 均值 0.9039、空间 IoU 0.9161),约 5% 抽检序数与查询全部通过,另做结构校验、媒体对齐审计(时间映射最大偏差约 0.017 秒)和 50 例跨领域审计(全部通过)。第五步,评测:以事件类型、序数、角色定义与边界规则构造冻结查询,要求模型输出 JSON 时间窗口和每 0.5 秒的角色框。
技术新颖性
新颖性有三层。任务层面:首次把“事件时间定位 + 语义角色空间 grounding”统一进一个输出可验证的任务,并用序数索引强制重复事件消歧,区别于所有描述式 STVG 和只做时间定位的事件理解基准。评测设计层面:oracle/1/3/5/10 分钟的分层设置能分离“找到那次事件”与“框出参与者”两种能力;并提出相对空间 grounding 差距 $\mathrm{Gap}_{SG}=1-\mathrm{vIoU}_{disc}/\mathrm{tIoU}_{disc}$(在时间重叠帧上衡量空间 grounding 的相对损失),把错误系统归因到三个层级瓶颈,这一诊断框架本身可复用到其他 grounding 基准。数据工程层面:59,381 个人工校验的边界框,配合跨标注者一致性报告(时间 tIoU 0.904、空间框 IoU 0.945)、逐条来源追溯(源帧时间戳、坐标变换、重编码映射全部保留)和回归测试,质量控制在同类基准中相当严格。
实验结果
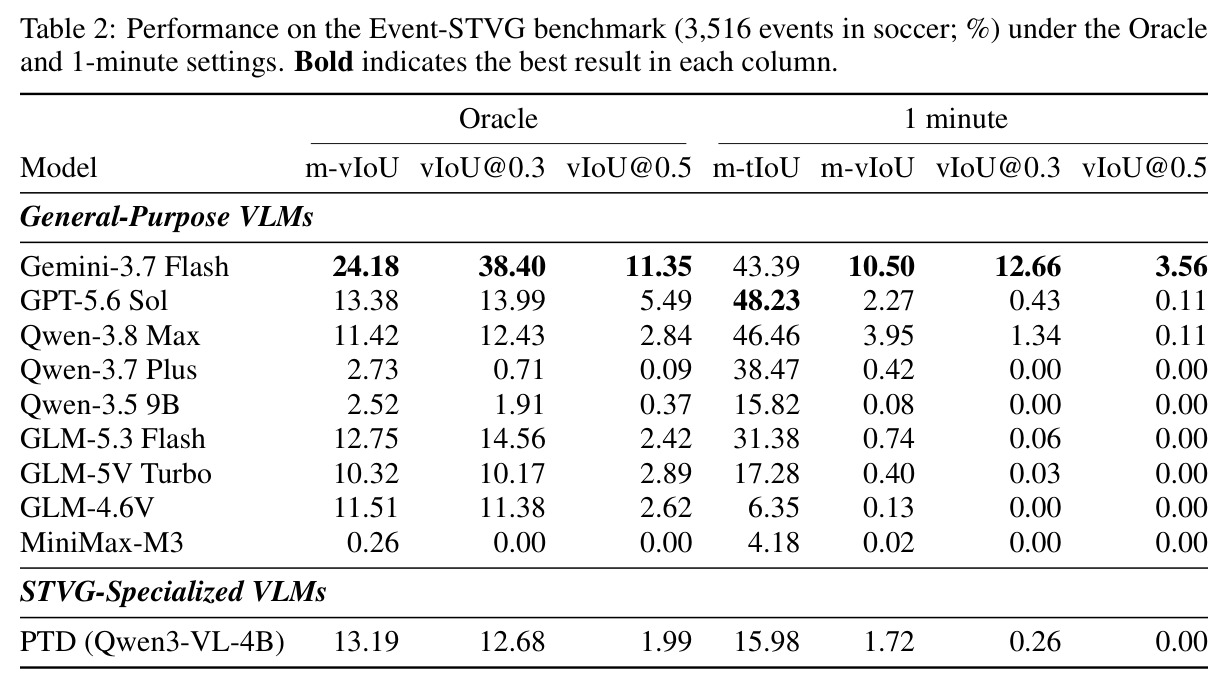
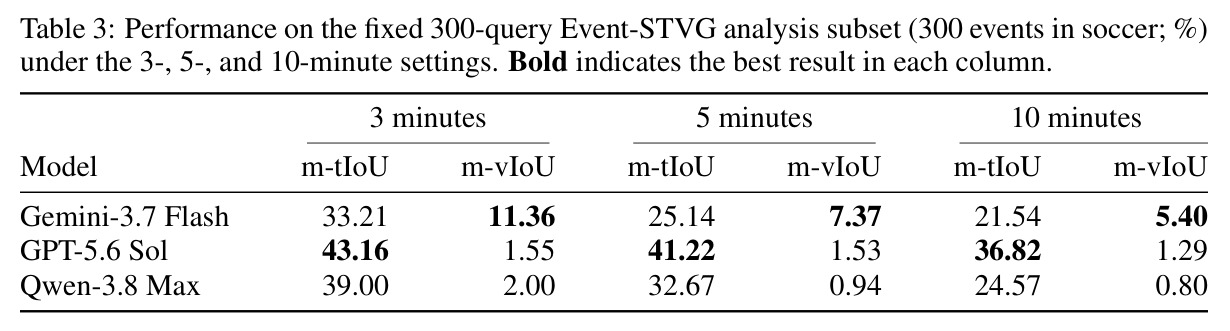
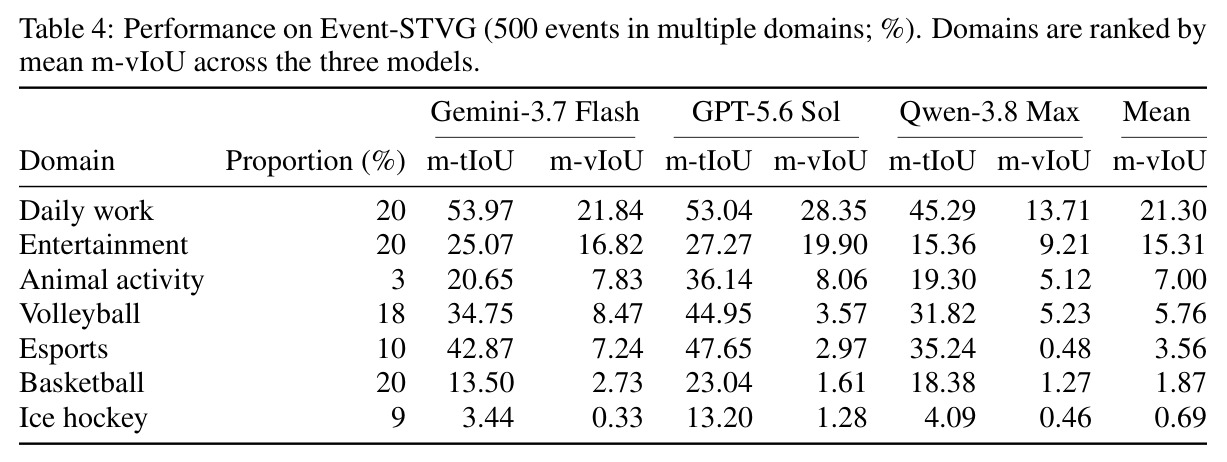
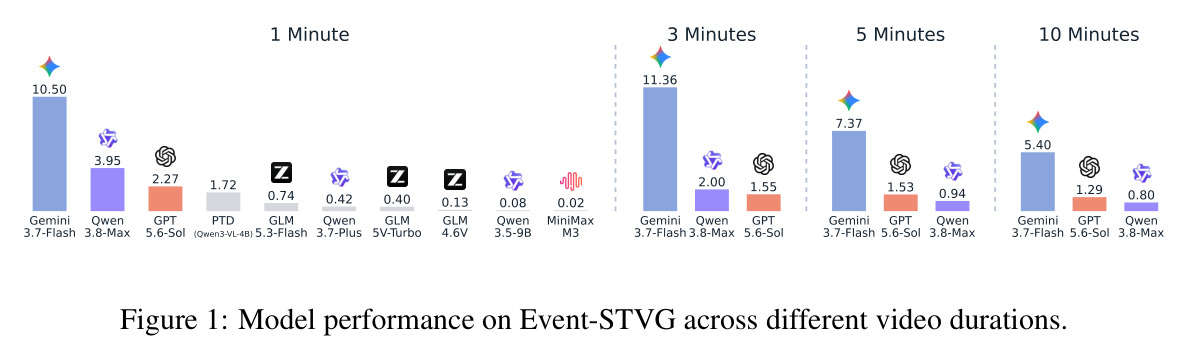
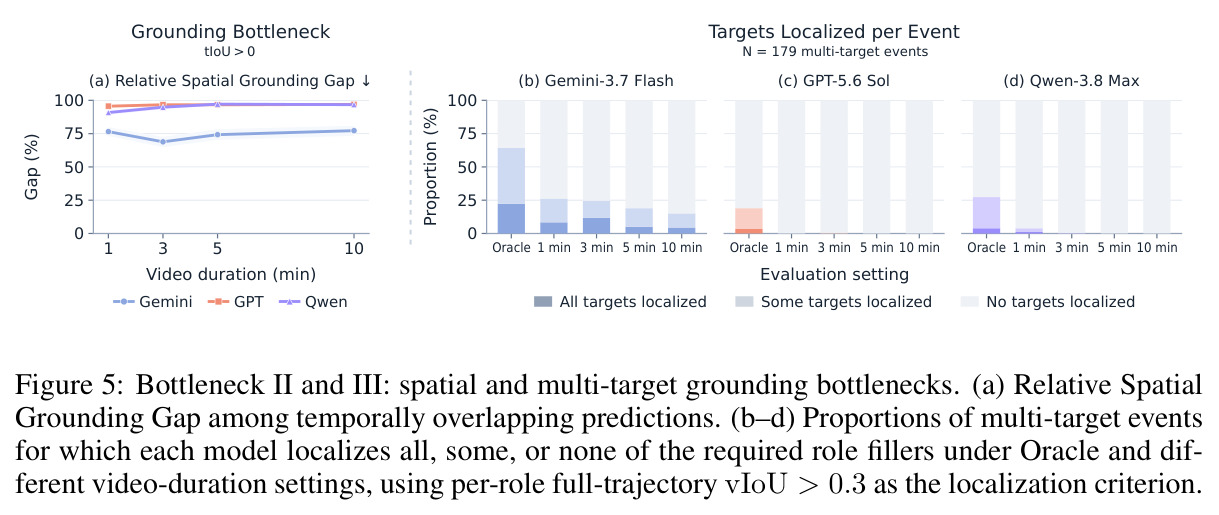
3,516 事件、1 分钟设置下,最佳 Gemini-3.7 Flash 仅 10.50% m-vIoU,oracle 下也仅 24.18%;能力分化:GPT-5.6 Sol 时间定位最强(m-tIoU 48.23%/36.82%)但联合仅 2.27%/1.29%,Gemini 联合最强,无模型兼通。越长越糟:300 查询子集上 Gemini 的 m-vIoU 从 11.36% 跌至 5.40%(3→10 分钟)。三级瓶颈:(I)实例解析:209 个含干扰查询 1→10 分钟命中率降 43.54/21.05/44.98 pp、混淆率升 13.40/15.79/19.62 pp(p<0.0001),持续命中者 tIoU 不降——症结是选错实例;(II)角色 grounding:时间命中查询的 $\mathrm{Gap}_{SG}$ 达 76.53%/95.65%/90.86%,跨域均值 71.12%;(III)多角色组合:179 个查询 oracle 完整成功率仅 22.35%/3.35%/3.91%,跨域 274 个仅 1.46%/0.73%/0%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 足球 3,516 事件 · 1 分钟端到端定位 | m-vIoU (%) | Gemini-3.7 Flash:10.50(基准最佳) | 次优 Qwen-3.8 Max:3.95;STVG 专用 PTD:1.72;6/9 通用模型低于 1 | 较次优通用模型 +6.55 pp,但绝对值仍远未饱和 |
| 足球 · Oracle 角色定位(给定真实事件区间) | m-vIoU (%) | Gemini-3.7 Flash:24.18 | GPT-5.6 Sol:13.38;Qwen-3.8 Max:11.42;PTD:13.19 | 较 GPT +10.80 pp,说明纯空间角色 grounding 也未解决 |
| 足球 · 10 分钟长上下文(300 查询子集) | m-vIoU (%) | Gemini-3.7 Flash:5.40 | GPT-5.6 Sol:1.29;Qwen-3.8 Max:0.80 | 较 GPT +4.11 pp,较 3 分钟的 11.36 下降 5.96 pp(长上下文退化) |
| 足球 · 10 分钟长上下文(300 查询子集) | m-tIoU (%) | GPT-5.6 Sol:36.82 | Qwen-3.8 Max:24.57;Gemini-3.7 Flash:21.54 | 较 Gemini +15.28 pp,印证时间定位与空间 grounding 能力分化 |
| 跨域 7 领域 500 事件 | 三模型平均 m-vIoU (%) | 最佳领域(日常事务)21.30 | 最差领域(冰球)0.69;排球 5.76、电竞 3.56、篮球 1.87 | 无任何领域接近饱和,证明挑战跨领域普遍成立 |
局限与改进
作者明确承认的局限包括:评测以足球为主,其余 7 个领域仅 500 事件/100 个视频,跨域结论的统计功效有限;长上下文用固定的 300 查询分层子集而非全量;不同模型输入接口不一致(GPT 用 2 FPS JPEG 帧 + detail=low,Qwen/GLM 用原生 MP4,PTD 只均匀采样 64 帧),生成参数用平台默认而非固定温度,作者虽用重复实验与对照实验(PTD 风格接口对照、detail=low 对照)量化了影响,接口差异仍可能干扰模型间横向比较;PTD 的指称式接口不显式保留序数信息,其 1 分钟成绩受接口适应影响(对照实验显示 m-tIoU 损失达 −21.68 pp);$\mathrm{Gap}_{SG}$ 聚合了定位质量、角色对应、可见性、缺失预测等多种误差源,不能归因于单一内部机制。我的观察:论文只做诊断、不提出任何改进方法,模型侧的解决路径完全留白;部分跨领域样本很小(如冰球仅占 9%),域级均值方差大;查询模板固定为英文 JSON 输出,模型因格式解析失败得零分时会与真实能力混淆——虽然作者有意把失败保留在分母中,这解释的是端到端可用性而非纯推理能力。
独立分析的弱点
(1)事件实例消歧完全依赖隐式序数计数,模型缺乏显式的“事件枚举—排序—选择”机制,可考虑在定位前先生成结构化事件时间线再选取第 $m$ 个;(2)角色 grounding 与时间定位严重脱节(时间命中的查询空间差距仍高达七至九成),说明 MLLM 缺少跨帧一致的实体跟踪与角色绑定模块,可将 SAM2 类分割跟踪器或轻量跟踪头接入 VLM 管线;(3)多角色组合成功率接近零(跨域最低 0.00%),暴露输出结构复杂时模型顾此失彼,可尝试分解式推理——逐角色生成再校验一致性,或用强化学习把“完整事件”作为奖励单元;(4)评测接口不统一使横向比较带噪声,社区需要标准化的视频输入与输出协议;(5)基准以第三人称转播视角的体育内容为主,第一人称视角、监控等场景未覆盖,角色模式也偏简单(最多 3 个角色、单层结构);(6)静态基准会随模型进步而饱和,10 分钟上限对真正的长视频理解(30 分钟以上的完整比赛)仍然太短,序数查询也只考察“第几个”这一种消歧形式,未涉及“上下文中被提到的那次”等自然指代。
未来方向
作者在结论中提出的方向:Event-STVG 的可验证 grounding 信号可用于强化学习后训练——时间 IoU 和角色 vIoU 都是天然的过程奖励,可为视觉推理提供细粒度反馈。基于本文成果可延伸的方向包括:训练具备事件—角色结构化输出的 grounding MLLM,把 59,381 个人工校验框直接用作 SFT/RL 数据;构建事件时间线记忆机制,专门解决重复事件消歧;把任务扩展到更长视频、更多领域和更深的角色嵌套(如战术层面的多轮传递链);探索让模型调用跟踪/重识别工具的 agentic grounding 范式;以及研究时间定位与空间 grounding 的联合训练目标,缩小本文发现的“时间对了但人框错了”的鸿沟。
复现评估
代码与标注已在 GitHub(THU-KEG/EventSTVG)开源,附录 E 详细公开了标注指南、各事件的边界规则、质量控制流程与一致性数据(355 对时间标注 tIoU 均值 0.904、5,083 个角色框 IoU 0.945),并固定了 bootstrap 种子(21,10,000 次重采样),可复现性意识较强。复现评测的主要成本在 API:9 个通用模型多为闭源(Gemini、GPT 等特定版本),模型迭代后分数不可比;PTD 用开源的 Qwen3-VL-4B 权重可本地复现(FP16、贪心解码,输出完全确定)。数据方面视频来自 SoccerNet-v2、PL-NBA、VNL-STES、VIP-HTD、MammalNet 及 YouTube,SoccerNet 等需签署许可协议,YouTube 视频有下架风险。整体难度中等:用发布标注复现评测表格不难,但要复现整条标注管线需要相当的人工成本。
论文图表
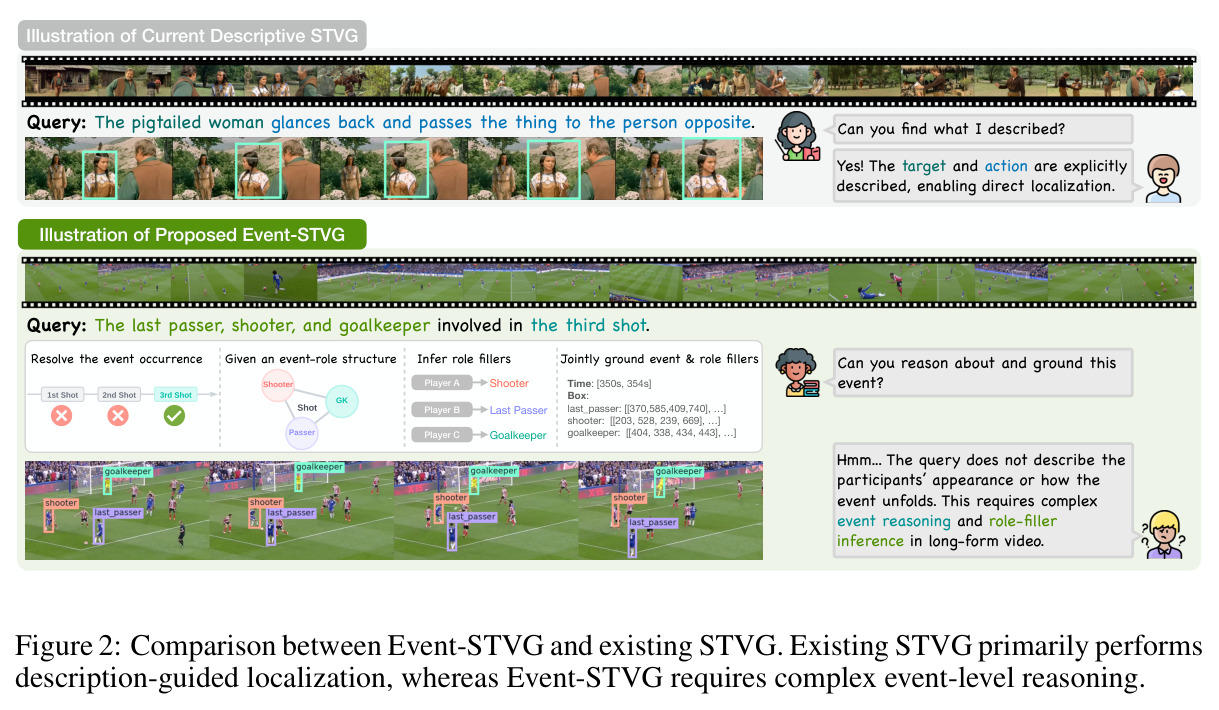
上下对比示意。上方是传统描述式 STVG:查询“扎马尾的女子回头看并把东西递给对面的人”,目标的外观、动作和关系都被显式描述,模型可直接完成语言—视觉匹配定位。下方是 Event-STVG:查询“第三次射正的最后传球者、射门者和门将”,查询不含任何外观线索,模型需要先解析同类事件的发生序列、按事件—角色结构推断每个角色由谁填充,再联合输出时间区间 [350s, 354s] 和三个角色的框轨迹。
定义任务差异的核心图:一眼看清新任务把“找被描述的目标”换成了“数事件、推角色、框所有人”,五种能力(长上下文、重复事件消歧、事件定位、角色推断、多目标 grounding)被同时纳入考察,是理解全文动机的入口。
在相同 100 个查询上比较三种条件:Qwen3.8 完整 Event-STVG prompt(含序数与边界定义、统一 JSON 输出)、Qwen3.8 的 PTD 风格逐角色指称查询(角色独立请求、简化输出再转换)、PTD 本尊(64 帧输入+特殊 token 输出)。Oracle 下 Qwen m-vIoU 从 9.448 降到 8.532(配对差 −0.917 pp,置信区间跨零);1 分钟下 m-tIoU 从 53.022 大幅降到 31.341(−21.68 pp)、m-vIoU 从 4.214 降到 2.184;PTD 的 Oracle m-vIoU 13.040 高于两种 Qwen 条件,1 分钟 m-vIoU 2.104 与 Qwen 相当但 m-tIoU 仅 16.165。
量化接口适应对专用模型基线比较的影响:去掉序数和边界信息主要伤害的是时间检索而非空间 grounding。它提醒读者 PTD 在 1 分钟设置的低分部分源于接口语义差异,不能全部归咎于模型能力。
足球领域配对重标注一致性数据:355 对时间标注的 tIoU 均值 0.904、中位数 1.000、tIoU≥0.5 占 96.06%、tIoU≥0.7 占 85.07%、起止时间平均差仅 0.194/0.349 秒;5,083 个角色—帧框在双方共同可见时平均 IoU 0.945,把单侧缺失(占 2.70%)计为零重叠后降至 0.919,论文同时报告两个口径以避免掩盖可见性标注分歧。
给出标注质量的定量证据,是判断基准真值是否可信、能否直接用作训练数据的关键依据;同时它明示了该实验度量的是工作流内一致性而非独立双盲标注,边界清晰。