3DCodeVerse:以代码探索三维世界 3DCodeVerse: Exploring 3D Worlds as Code
构建203万行可执行3D代码语料与无人在环的多智能体验证闭环,让开源模型3D编程能力大幅跃升
前置知识
3D编程(Procedural 3D Coding)
不直接生成网格或点云,而是让模型写可执行程序来构造三维内容:用 Blender Python(bpy)、CadQuery、OpenSCAD 建静态物体,用 URDF+Blender 定义铰接机构,用 Three.js 搭场景,用 GLSL/moderngl 写程序化图形。程序在指定运行时中执行 $(a,\ell)=E_e(f)$ 后产出网格、场景或动画,天然可编辑、可复用、可组合。
本文的整个生态(数据集、harness、评测)都建立在『3D 内容即代码』这一范式上,所有实验指标(执行率、F@0.05)都围绕可执行程序定义。
Harness(执行-验证闭环脚手架)
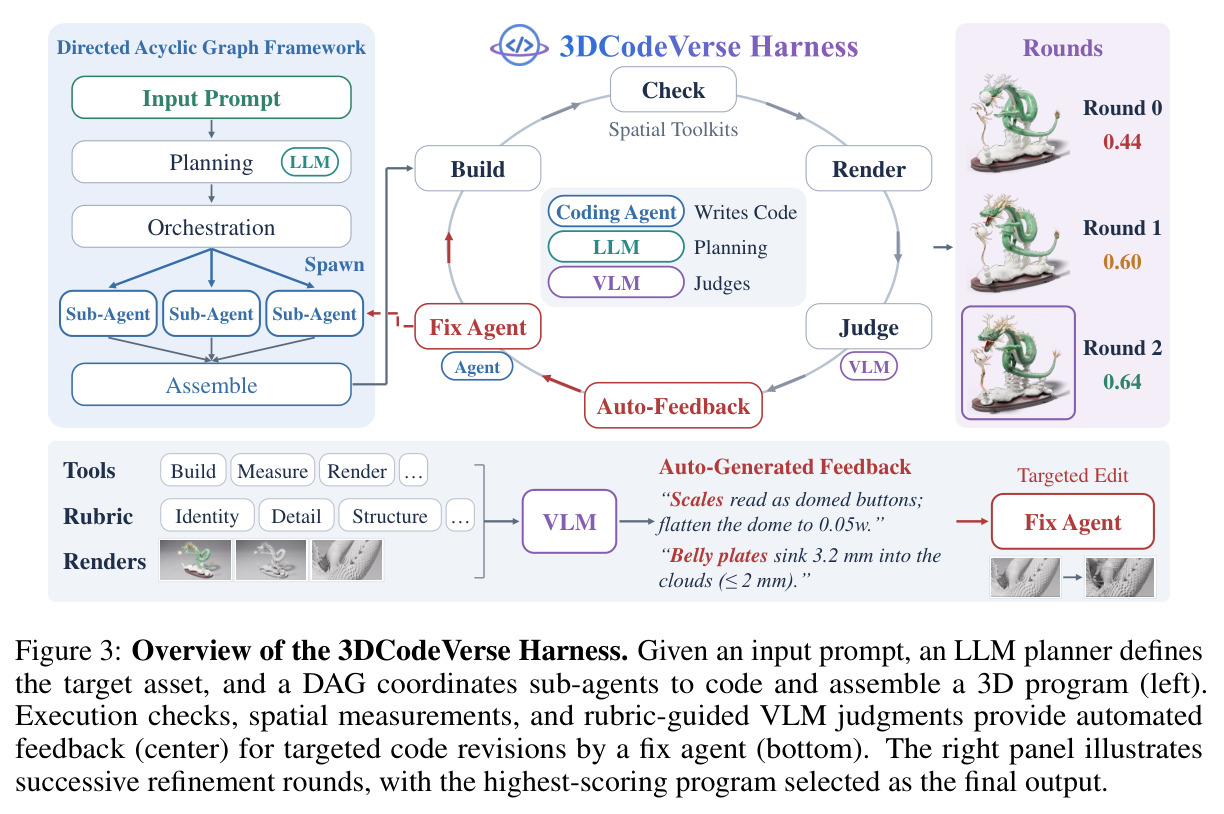
包裹编码智能体的外部框架,实现执行环境 $E_e$ 与渲染 $R$:代码写完后自动构建、测量几何(连通性、穿透、关节运动)、多视角渲染、按评分细则打分,再把反馈转成修订任务让智能体迭代修码,类似开发者的『编译-调试』循环的自动化版本。
3DCodeVerse Harness 是论文两大核心贡献之一,理解它的反馈类型(执行/测量/视觉)与评分机制才能看懂实验结果从何而来。
多智能体 DAG 编排
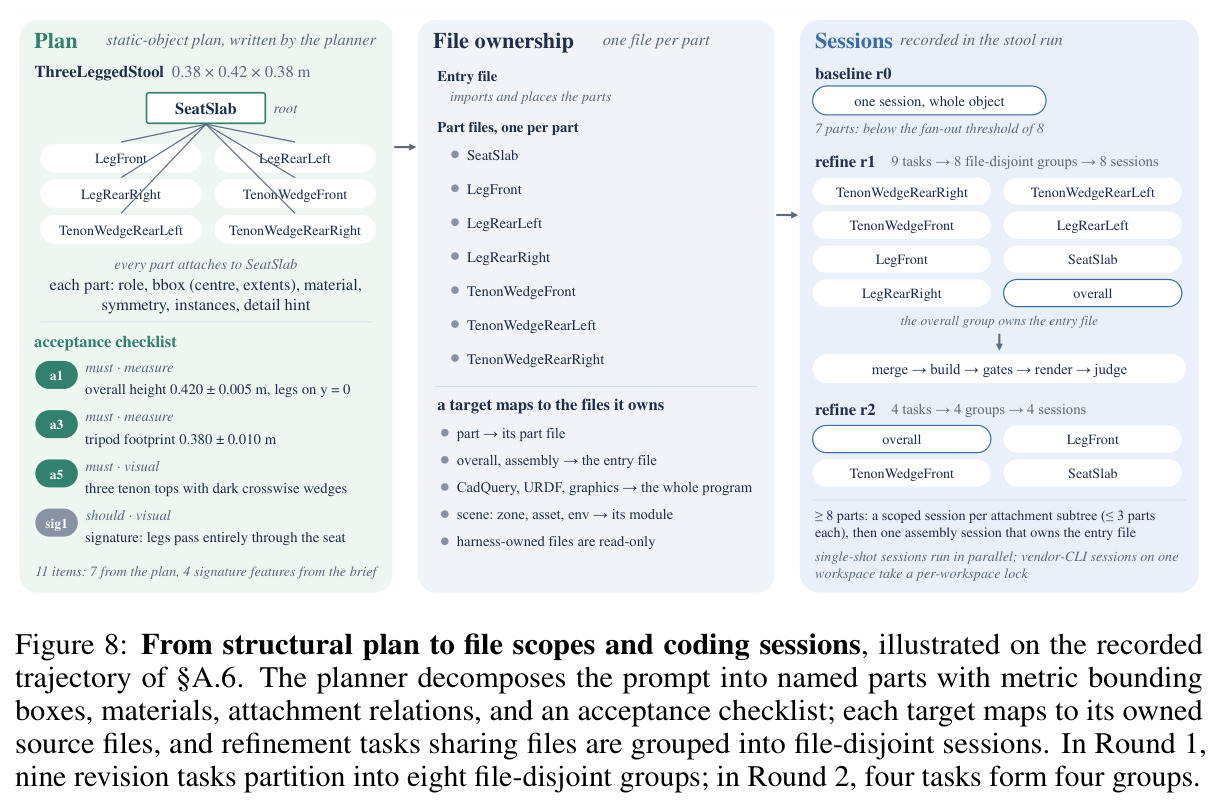
把复杂 3D 项目分解为有依赖关系的编码与装配任务构成的有向无环图 $G=(V,E)$:每个子智能体拥有自己负责的源文件,前置任务完成后装配任务整合代码。文件所有权约束使无依赖任务可并行,且避免跨部件的连锁破坏。
这是 harness 支撑上千行代码大项目并控制上下文长度的关键机制,论文多个消融(scoped session、文件不相交会话)都基于它。
URDF 与铰接物体
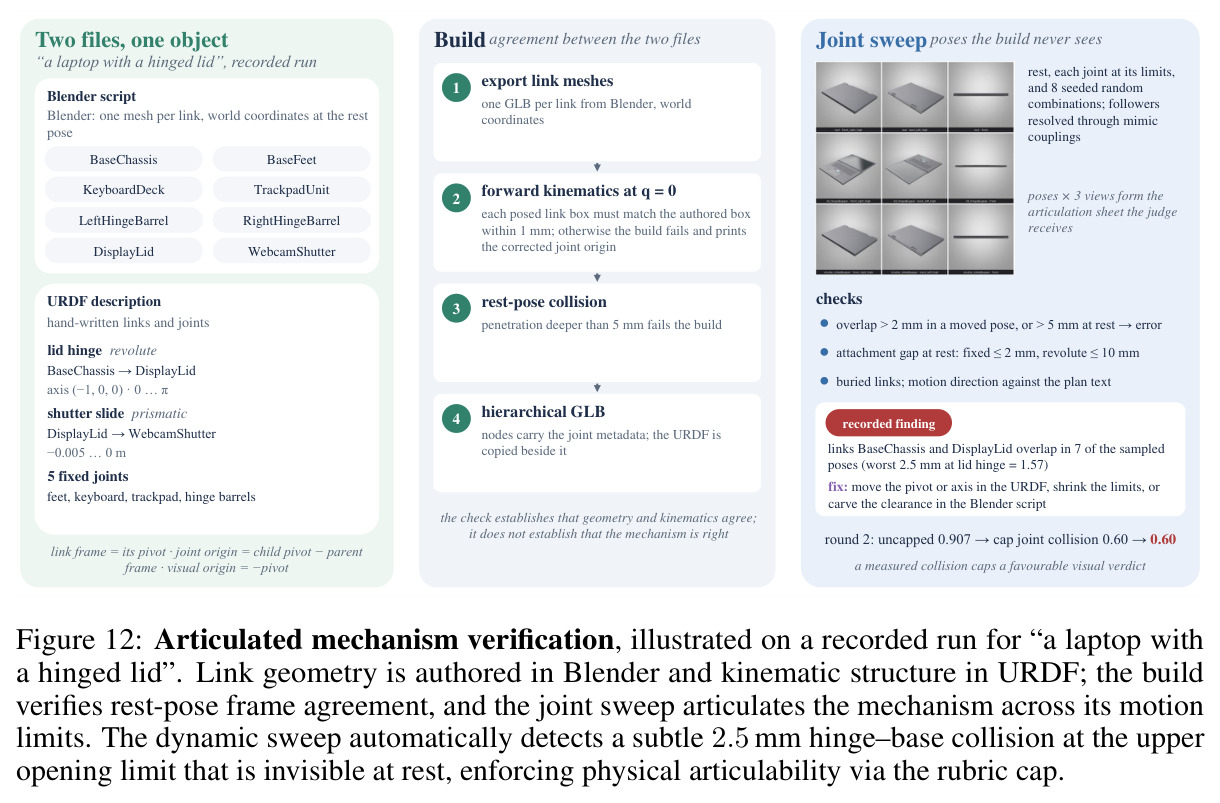
URDF 是机器人学标准描述格式,用连杆(link)和关节(joint:轴向、枢轴、限位)描述可动结构,可被 MuJoCo 等物理引擎直接驱动仿真。数据集中铰接物体由 Blender 脚本写几何 + URDF 写运动学两部分耦合而成。
铰接物体是四类生成轨道之一,论文的关节扫掠(joint sweep)验证和机器人应用都依赖 URDF 的显式运动学。
LoRA 与 DPO 后训练
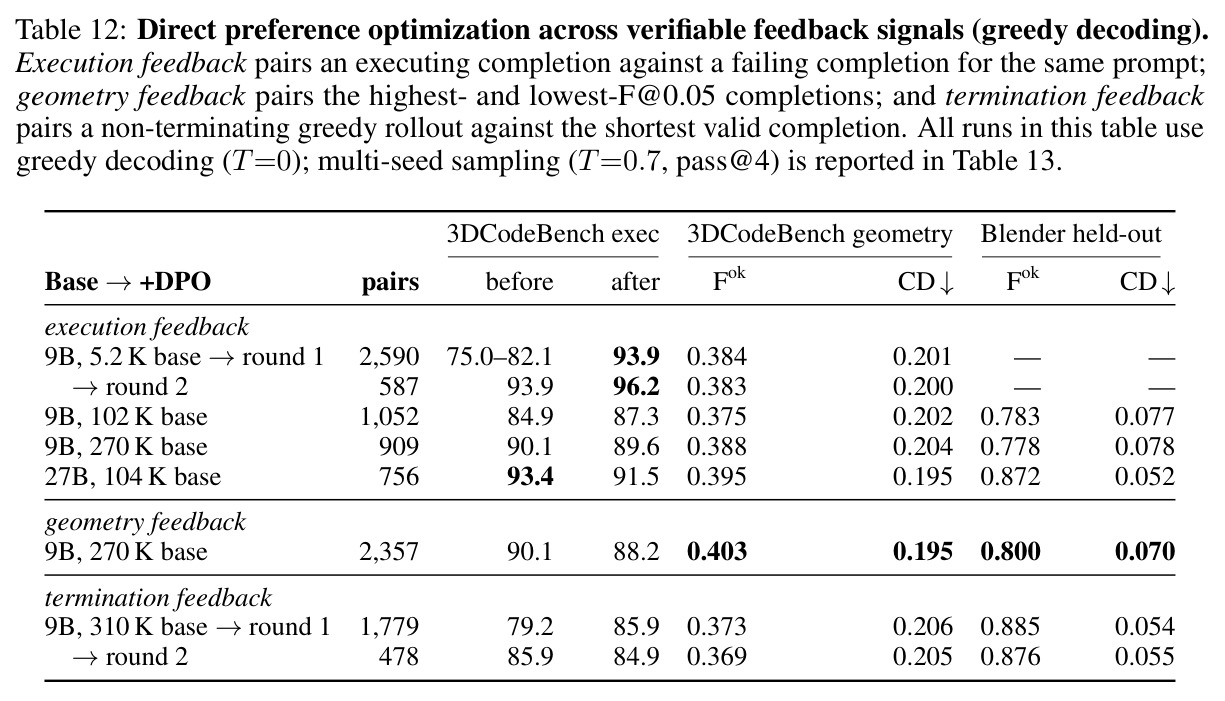
LoRA 是低秩适配的参数高效微调:冻结原模型只训练低秩增量矩阵。DPO(直接偏好优化)用成对偏好数据 $(\text{chosen}, \text{rejected})$ 以 Sigmoid 损失直接优化策略,绕过奖励模型。本文用三种可验证信号构造偏好对:执行成败、几何保真度、是否终止。
第 5.2 节和附录 C 的微调实验全部基于 LoRA SFT + 三轴 DPO,看不懂这两项技术就无法理解开源模型如何从 0% 执行率提升到 84.9%。
VLM 裁判(VLM-as-Judge)
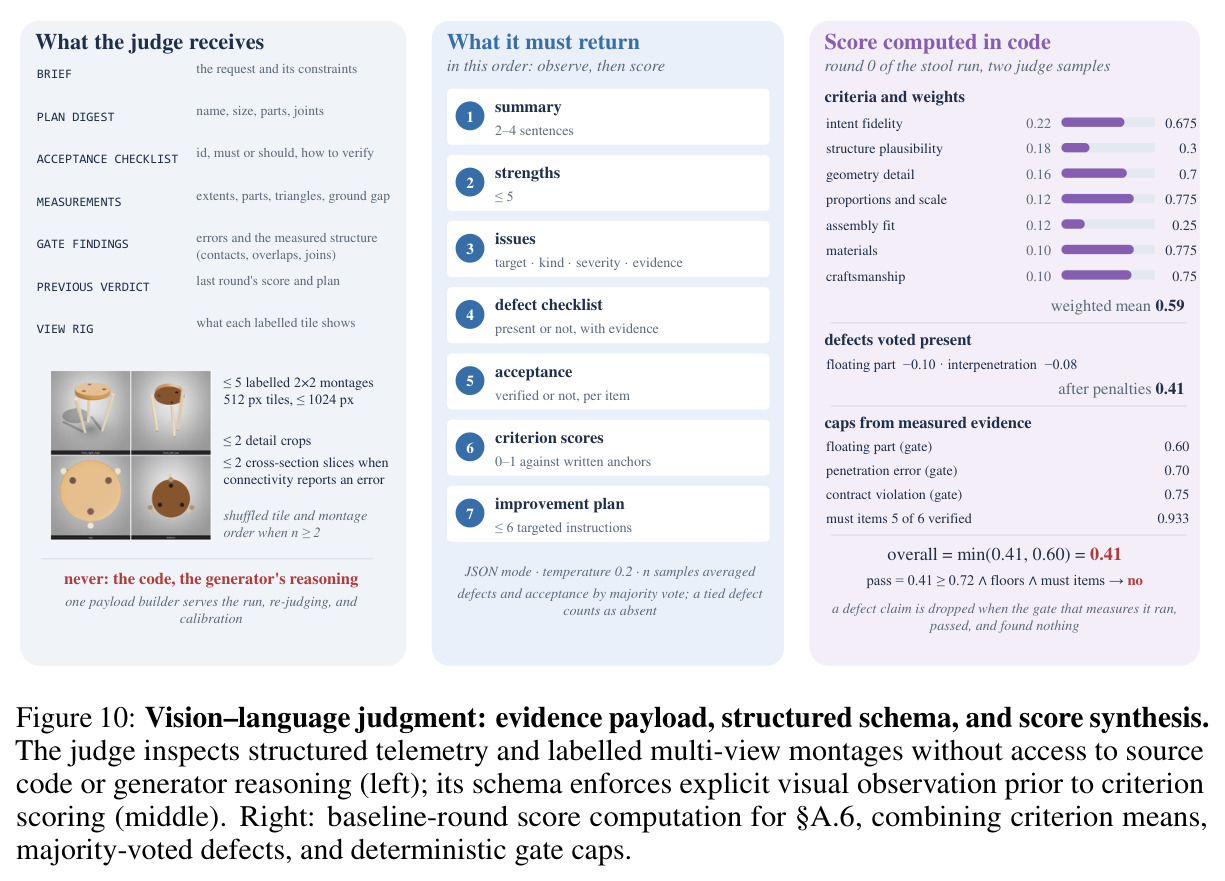
用视觉语言模型检查多视角渲染图,按加权评分细则(意图保真 0.22、结构合理 0.18、几何细节 0.16 等)输出 JSON 格式的证据、缺陷投票和分数,温度设 0.2 并多次采样取均值以降低方差。
harness 的视觉反馈、迭代修复信号和最终评测(Judge Score、VLM Preference)都由 VLM 裁判驱动,其校准方式直接影响结果可信度。
研究动机
代码化 3D 生成能产出结构化、可编辑、可组合的内容,但支撑它的基础设施严重碎片化。数据侧:现有语料各管一角——Shaders21k 只有 21K 个 shader 程序,BlendNet 8K 对、CAD-Recode 和 MeshCoder 各约 1M 但只覆盖单一 CAD/Blender 方言,没有任何数据集同时覆盖静态物体、铰接物体、场景和图形四类内容并跨多个运行时。系统侧:harness 要么面向单一环境(SceneCraft、VIGA 只支持特定 Blender 工作流),要么依赖人工反馈难以规模化(BlenderGym 仅 245 个任务,3DHarnessBench 仅 100 个任务)。后果直接体现在模型能力上:Qwen3.5-9B 在 3DCodeBench 的 212 个 Blender 任务上执行率为 0%,其中 165 个脚本立即死于调用了 Blender 5.0 中已废弃的场景清理算子,即使手动修补这一个调用也只能修好 4/212——开源模型与专用 3D 代码分布之间存在巨大的 API 漂移鸿沟。
本文的目标是本文要构建一个统一的 3D 编程研究生态,包含三个可交付的部分:其一,3DCodeVerse-2M——一个大规模、经过验证的独立可执行 3D 代码语料,覆盖静态物体、铰接资产、场景和程序化图形四类内容、六种图形类型、七个隔离运行时,每个程序打包运行所需的源文件与资产,并附带描述与验证记录;其二,3DCodeVerse Harness——一个多智能体 DAG 框架,用执行检查、空间测量和视觉反馈在生成过程中全自动评估与修订代码,全程无需人工反馈;其三,系统性实证研究——在 3DCodeVerse-2M 上微调开源模型建立可复现基线,并通过 harness 的组件级消融提炼实用的 3D 编程工程指南。
与已有工作不同的是,本文的独特切入在于把 harness 同时定位为『推理系统』和『数据引擎』,而非孤立的 agent 演示。以往工作要么只发布数据集(CAD-Recode、MeshCoder),要么只发布单环境 agent 系统(SceneCraft、LL3M),两者脱节;3DCodeVerse 则让 harness 在推理时记录成功程序、失败尝试、定向修复和偏好对比,其执行轨迹直接转化为 SFT 与偏好学习的监督信号,形成『数据构造 → 程序合成 → 验证 → 修复 → 模型改进』的闭环——harness 生成的 15,704 个执行验证 bootstrap 程序被证明能显著提升微调混合物的目标方言可执行率。另一独特设计是开发期的对抗式循环:先冻结生成工作流、在冻结工件库上迭代优化裁判(降低评分方差、消除与测量证据的矛盾),再用修好的裁判指导生成侧改进,避免了裁判与生成器共同漂移导致的无意义内卷。
核心方法
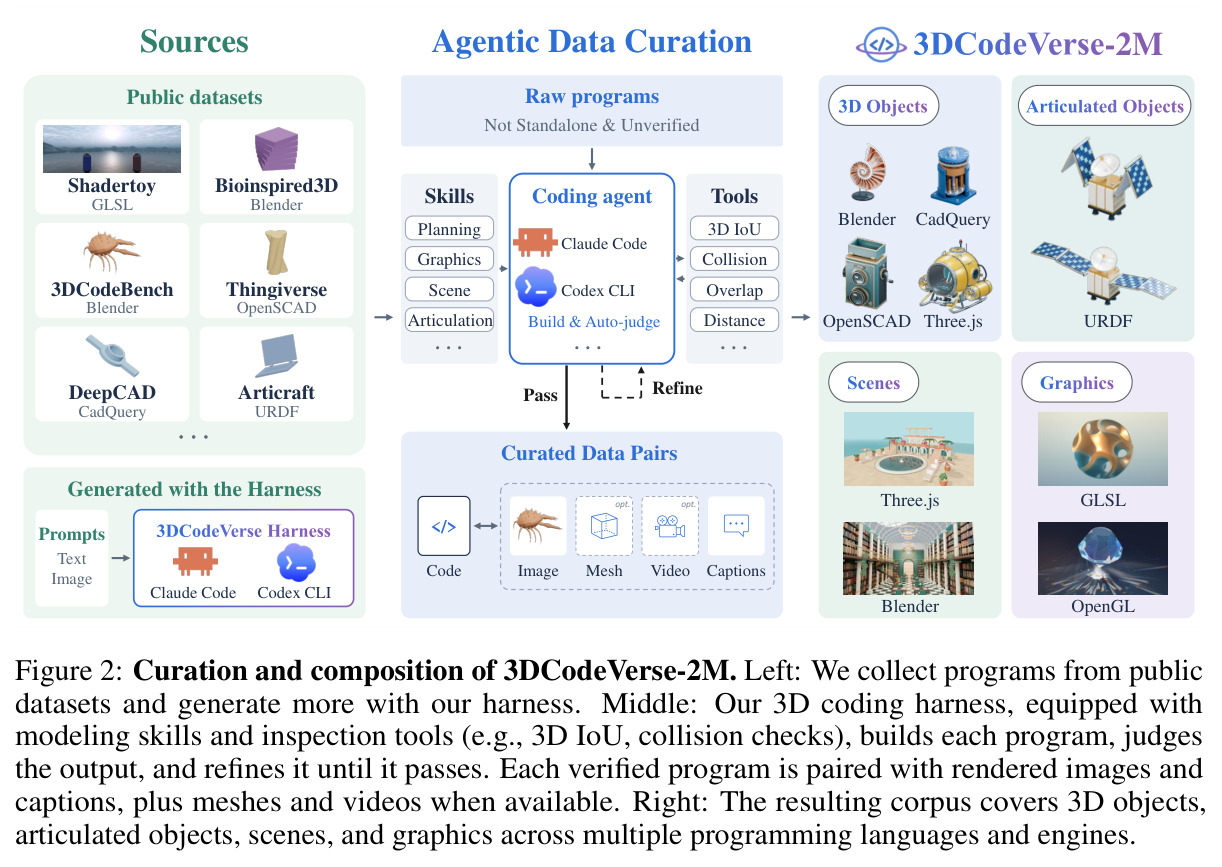
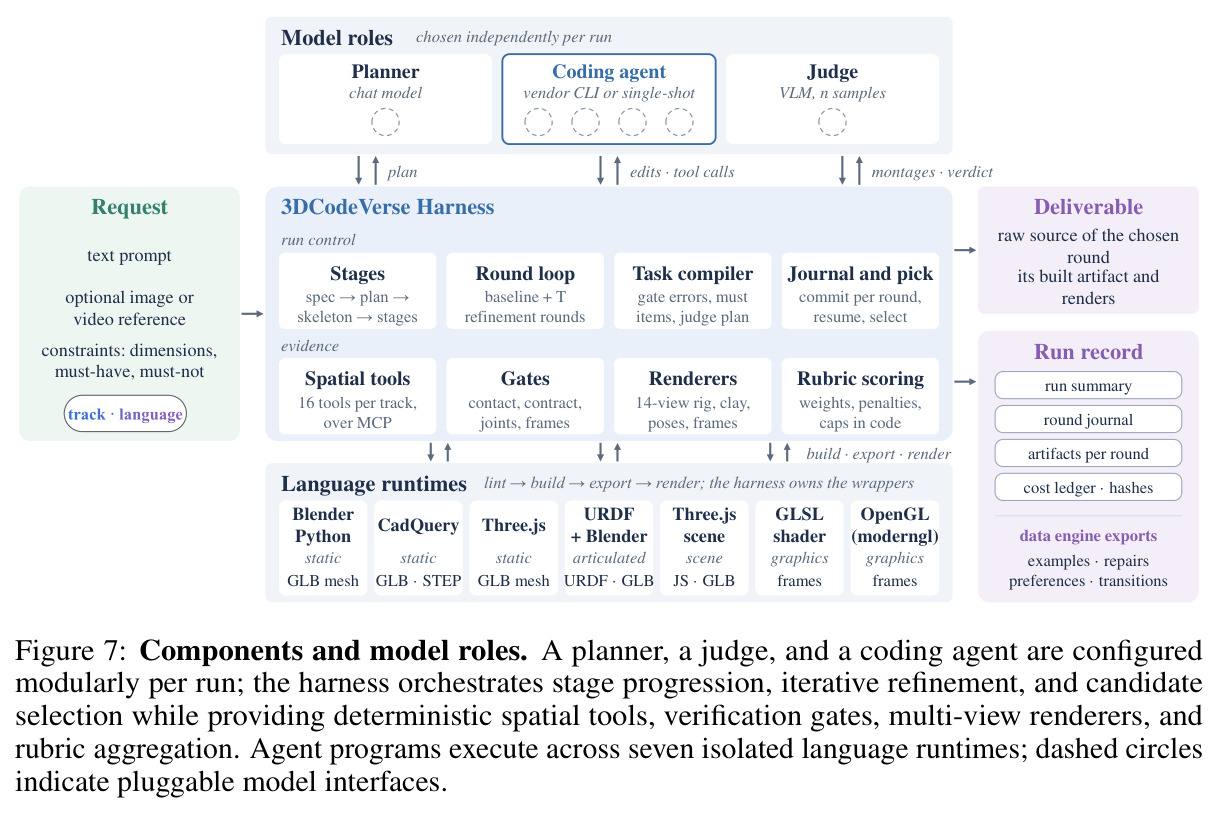
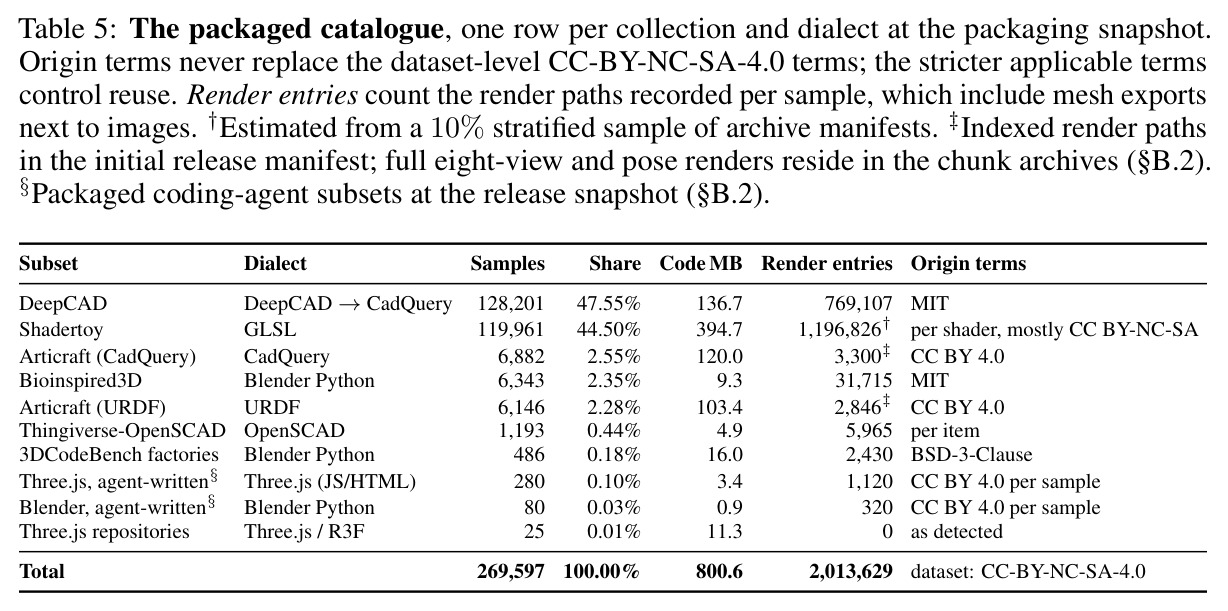
整个生态分三层。数据层:从公开资源(Bioinspired3D、3DCodeBench、Thingiverse、Shadertoy、CodePen 动画、多文件 Three.js 项目)收集程序,用确定性编译器把 DeepCAD 构造序列转成 CadQuery、用 AST 内联器把 Articraft 几何例程转成独立程序并保留 URDF,再用 harness 上的编码智能体合成新程序;每个程序经执行验证、几何/哈希去重,并由 VLM 从代码和渲染生成三种条件的 caption(指令、视觉描述、构造配方)。系统层:给定条件 $c$ 和目标环境 $e$,LLM 规划器先产出结构化计划 $P=A_{plan}(c;e)$(部件、尺寸、材质、空间关系、验收清单),harness 把 $P$ 编译为编码与装配任务的 DAG,子智能体并行写各自的文件得到初始程序 $f^{(0)}$;随后每轮执行 $f^{(t)}$,收集执行日志、空间测量、VLM 评审三类反馈,转成按优先级排序的修订任务 $\Delta^{(t)}$,由 fix agent 产出 $f^{(t+1)}=A_{code}(c,P,f^{(t)},\Delta^{(t)};e)$,至多 $T=4$ 轮。训练层:用 LoRA SFT 加三轴 DPO 微调 Qwen3.5-9B 与 Qwen3.8-27B。
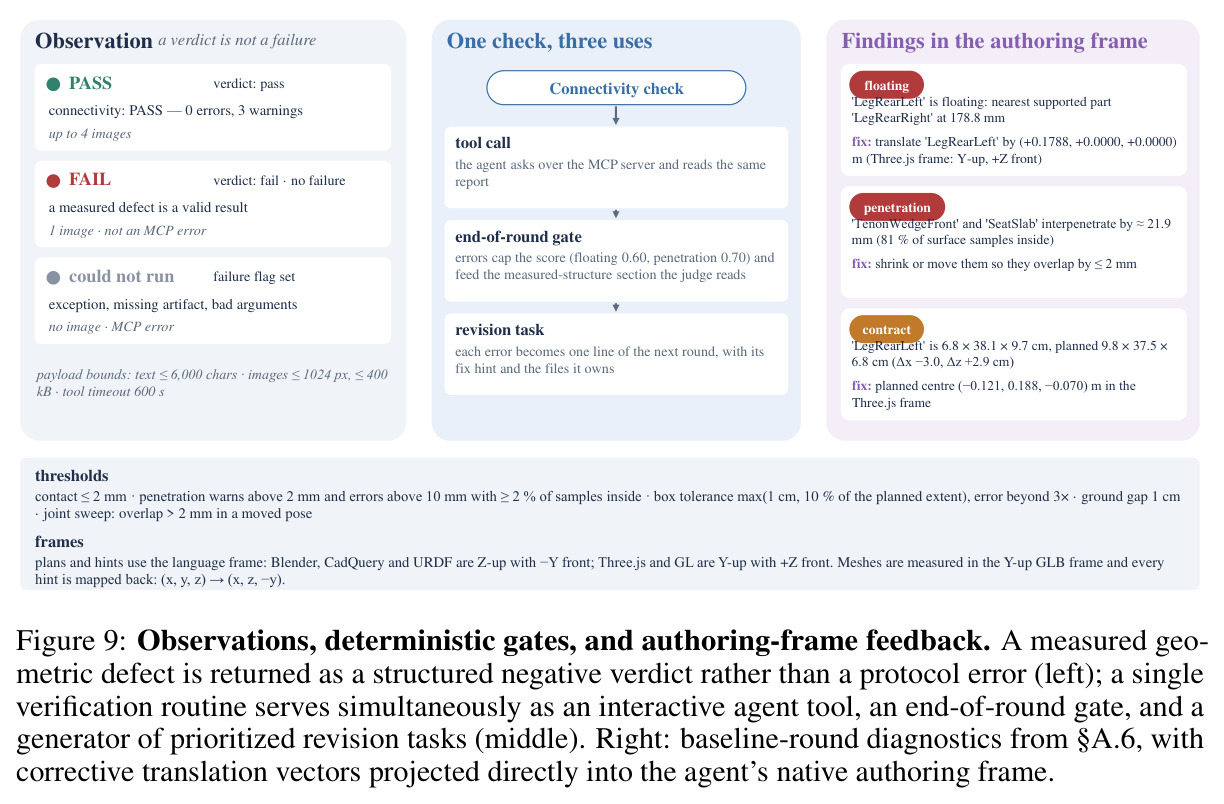
与已有方法的本质区别有三点。第一,统一异构表示为『可独立执行』的代码而非简单聚合:DeepCAD 序列不能直接跑、Articraft 依赖专用 SDK,本文把它们翻译/内联成自包含程序并删除对不可用库的依赖,使每个程序能在声明环境中一键执行。第二,用确定性测量否决视觉幻觉:VLM 评审容易被『看起来合理但几何错误』的输出欺骗,本文让空间工具(连通性、接触/穿透、跨关节位姿的碰撞、放置检查)拥有硬否决权——当确定性门检查通过时,VLM 投票的浮动/穿插缺陷自动作废;轮次分数按 $s^{(t)}=\min\big(u^{(t)},\ \max(0,\sum_k w_k \bar{s}^{(t)}_k-\sum_d \lambda_d \hat{d}^{(t)}_d)\big)$ 合成,其中门错误直接设置分数上限 $u^{(t)}$,强制清单未验证项设置 $0.6+0.4\,v/m$ 的上限。第三,把反馈编译成带数值修正提示的局部修复目标:浮动 178.8mm 的腿会收到精确到 authoring frame 的平移向量 $(+0.1788,0,0)$m,而不是笼统的『修一下』。
方法步骤详情
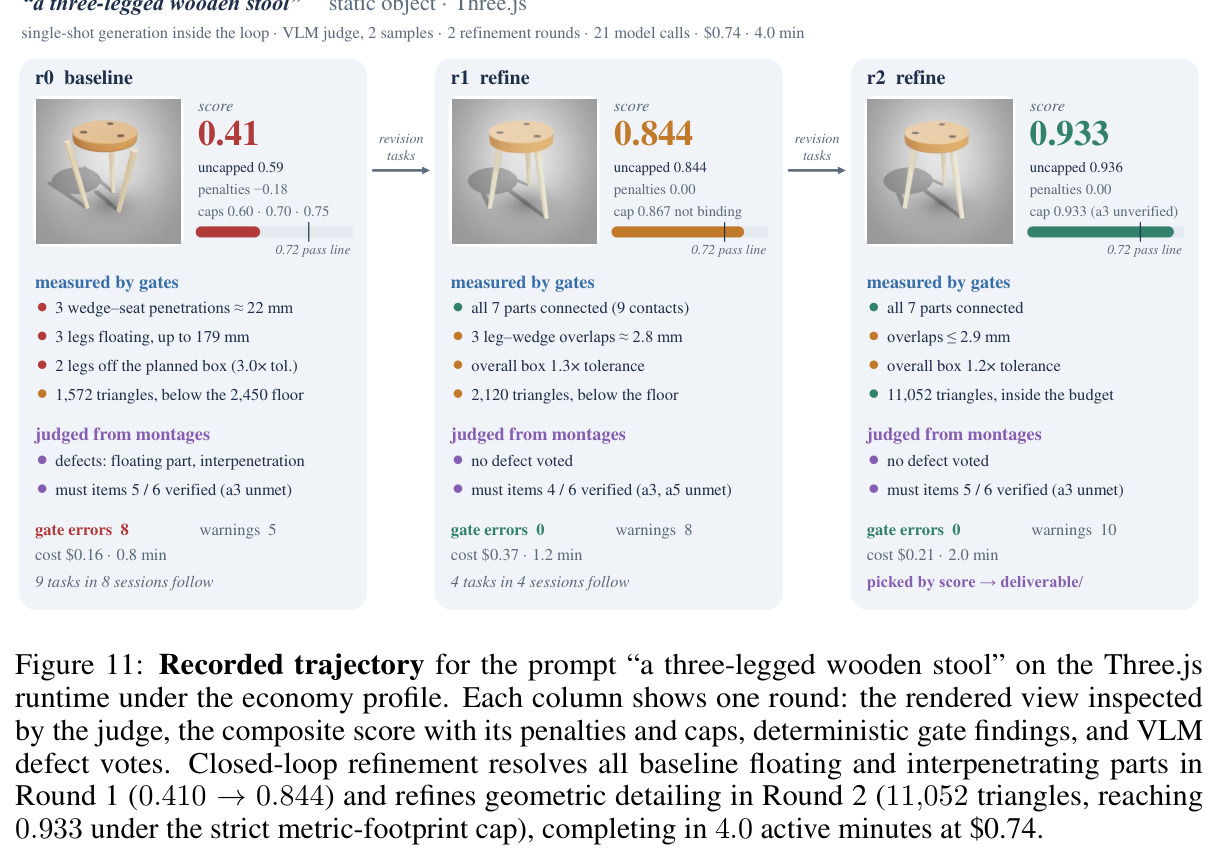
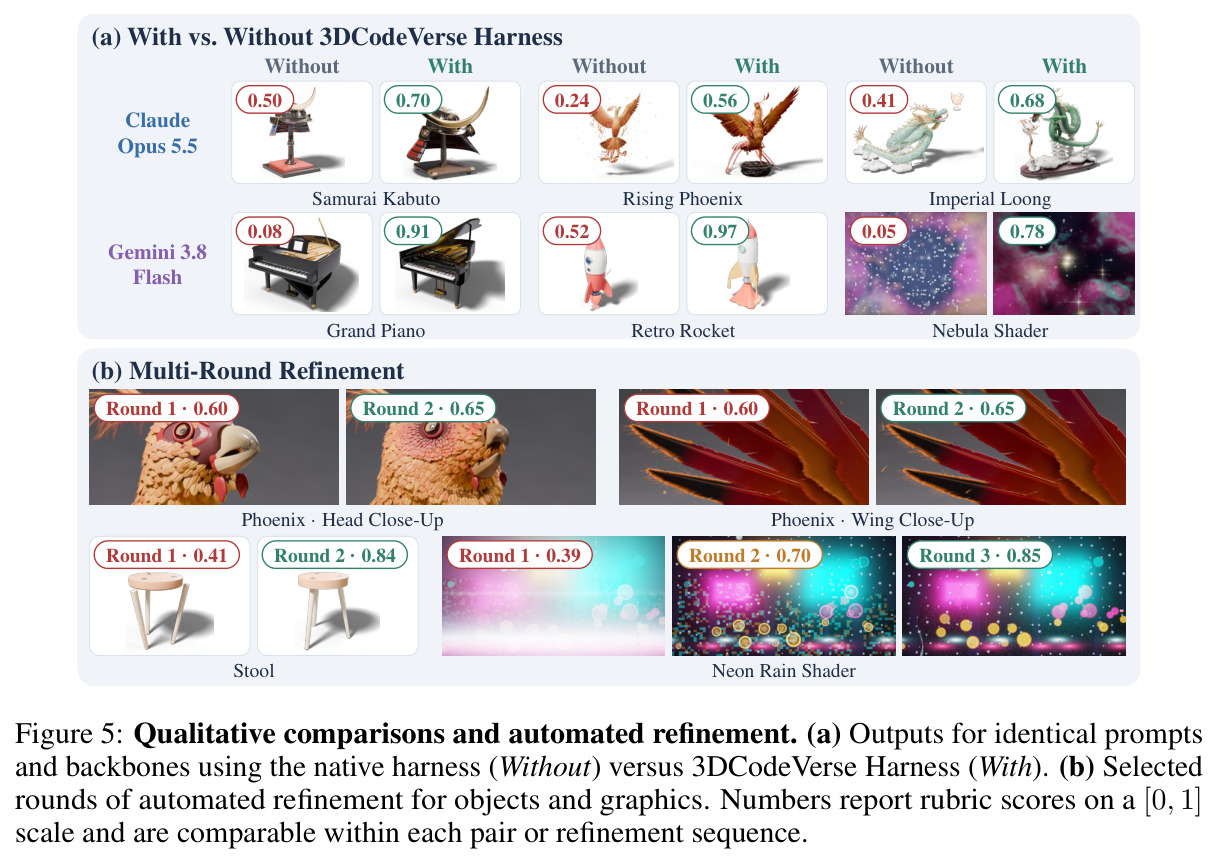
完整流程如下。第 0 步,运行时注册:7 个隔离运行时(Blender Python、CadQuery、Three.js 静态物体,URDF+Blender 铰接,Three.js 场景,GLSL、moderngl 图形)各自定义严格文件布局、静态 lint、沙箱构建包装、规范导出格式和确定性渲染驱动,统一坐标系(Z-up 与 Y-up 两套 frame)与公制单位。第 1 步,规划:规划器以结构化输出产出命名部件及公制包围盒(尺寸公差 ±5%)、材质、对称性、附件拓扑(铰接轨道为带类型关节与仿射 mimic 耦合 $q_j=m_j q_i+b_j$ 的运动树),并绑定验收清单(每项注明验证模态与 must/should 优先级)。第 2 步,DAG 编译与编码:部件映射到文件所有权(每部件一个模块文件+一个装配入口文件),顶层部件 ≥8 的对象按附件子树(≤3 部件)划分作用域会话并行合成,越权写入在 Git 提交间回滚。第 3 步,每轮固定验证链:代码合成 → 构建(失败触发至多 3 次带 traceback 的定向修复)→ 几何测量 → 确定性门 → 14 视角+clay 渲染 → VLM 评审(温度 0.2、多采样均值、缺陷多数投票、蒙太奇顺序随机化)→ Git 归档。第 4 步,任务编译与派发:修订任务按『门错误(带数值修复提示)→ 未验证强制项 → 感知建议』的严格优先级去重后至多派发 6 个,共享文件的任务归并为文件不相交会话。第 5 步,终止与选择:标准配置 $T=4$ 轮、60 分钟墙钟上限,可提前终止;多候选初始化时以构建成功、快速评分、门错误数做词典序排名选出 Round 0 种子;最终按综合分选轮,前两名分差 ≤0.03 时用成对 VLM 决胜。附录 A.6 记录的完整实例:『a three-legged wooden stool』(Three.js,经济档)从 0.410 分(3 处楔木-座面穿透约 22mm、3 条腿悬浮达 179mm、1572 个三角形)经两轮修复到 0.933 分(11052 个三角形),全程 21 次模型调用、4.0 分钟、$0.74。
技术新颖性
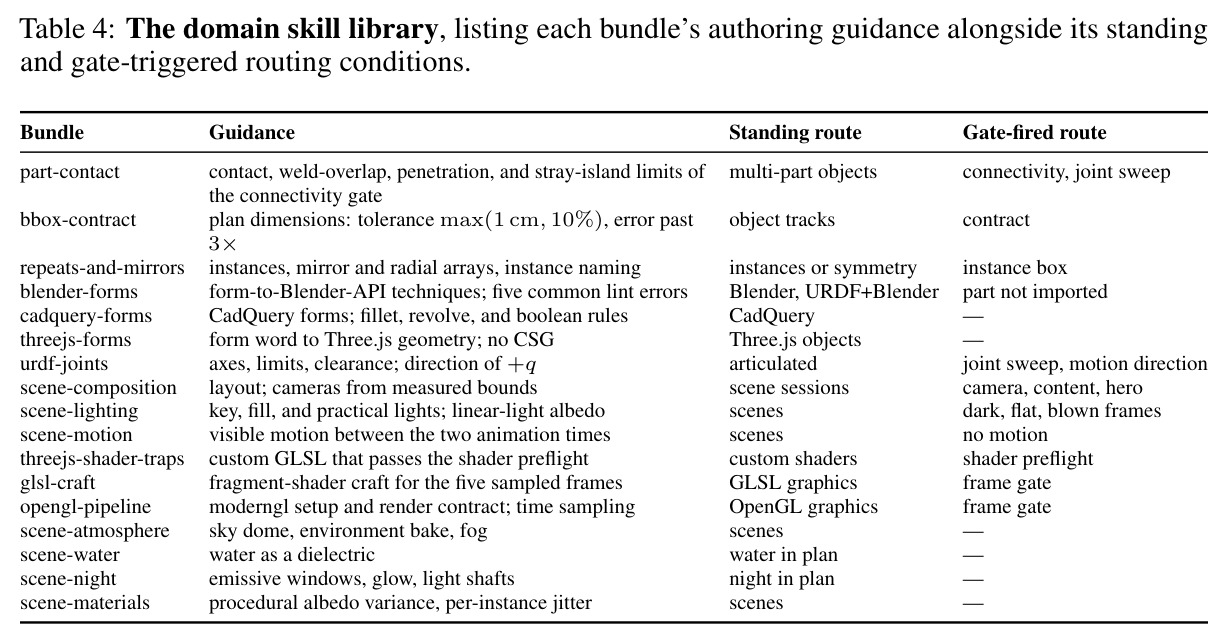
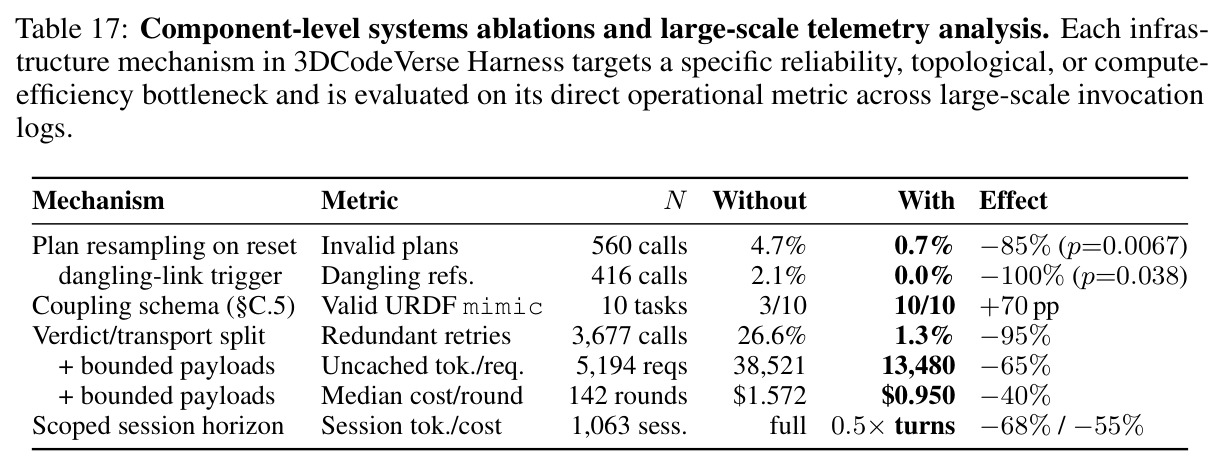
技术新颖性集中在五处。其一,verdict 与 transport 错误解耦:测得的碰撞作为合法的结构化 FAIL 观察返回,只有工具内部崩溃才置 MCP 协议错误标志——仅此一项就把商用 agent 的盲重试率从 26.6% 降到 1.3%(约 20 倍),未缓存 token 每请求降 65%,单轮中位成本降 40%。其二,authoring-frame 诊断投影:网格在规范 Y-up 帧测量,但所有修正提示投影回各语言原生坐标系(Z-up Blender 与 Y-up Three.js 的修正向量不同),智能体可直接照抄执行。其三,动态关节扫掠:静止位姿检查看不见的缺陷(如笔记本铰链在上开极限处 2.5mm 的隐藏碰撞)被 8 个种子多关节构型的扫掠捕获并设置 0.60 的分数上限,强制『几何与运动学一致』。其四,开发期对抗循环以显式目标调裁判:$\mathcal{L}_J(\theta_J)=\mathbb{E}[\mathrm{Var}_r\, s^{(r)}(o;\theta_J)+\lambda\,\rho(j(o;\theta_J),M_e(a))]$ 惩罚评分方差与测量矛盾,使 Gemini 3.1 Pro 裁判的重复评分标准差仅 0.030(Flash 为 0.083)。其五,17 个技能包(每个 ≤350 行约 2500 token)+ 28 条路由规则(常驻路由按轨道/语言/角色匹配,诊断路由由上轮门发现触发)动态注入上下文,配合作用域会话把会话累计 token 的 $n^{1.60}$ 增长律压低——减半轮次深度即省 68% token。
实验结果
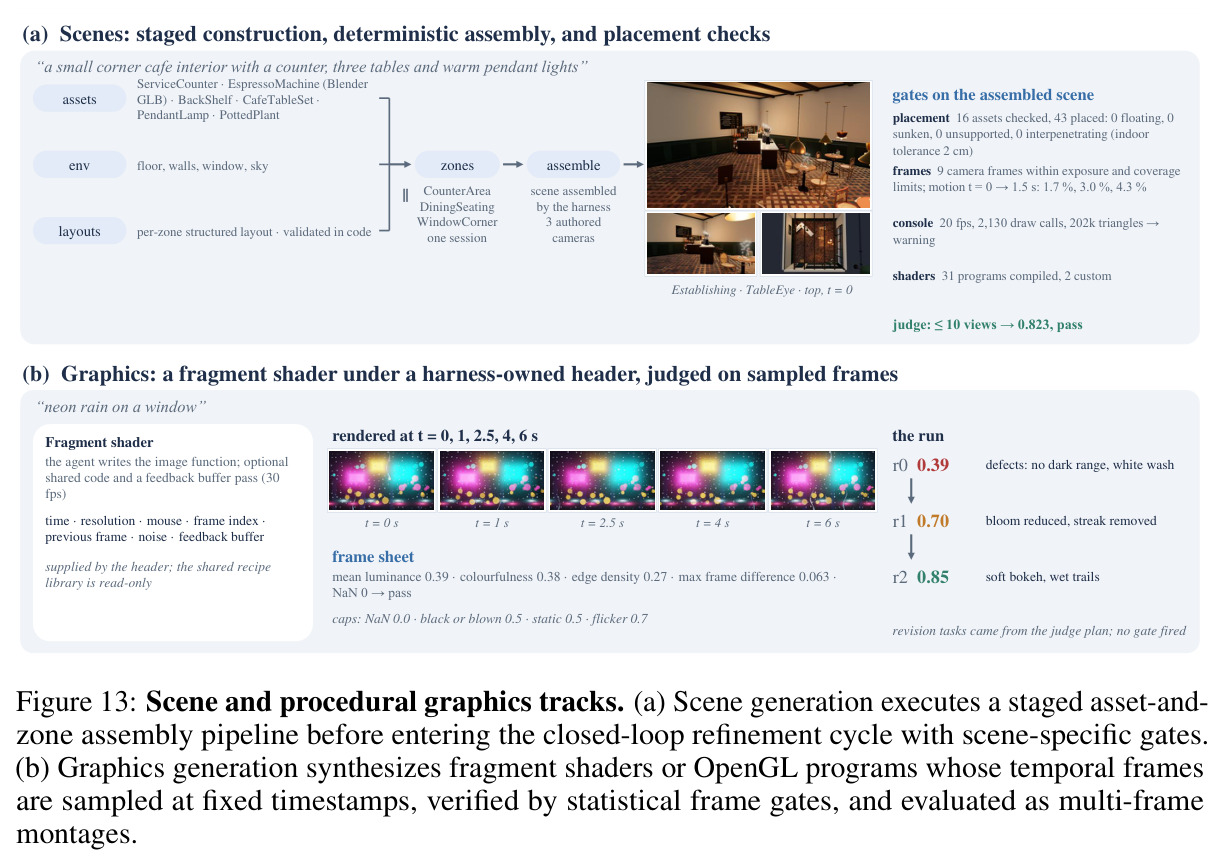
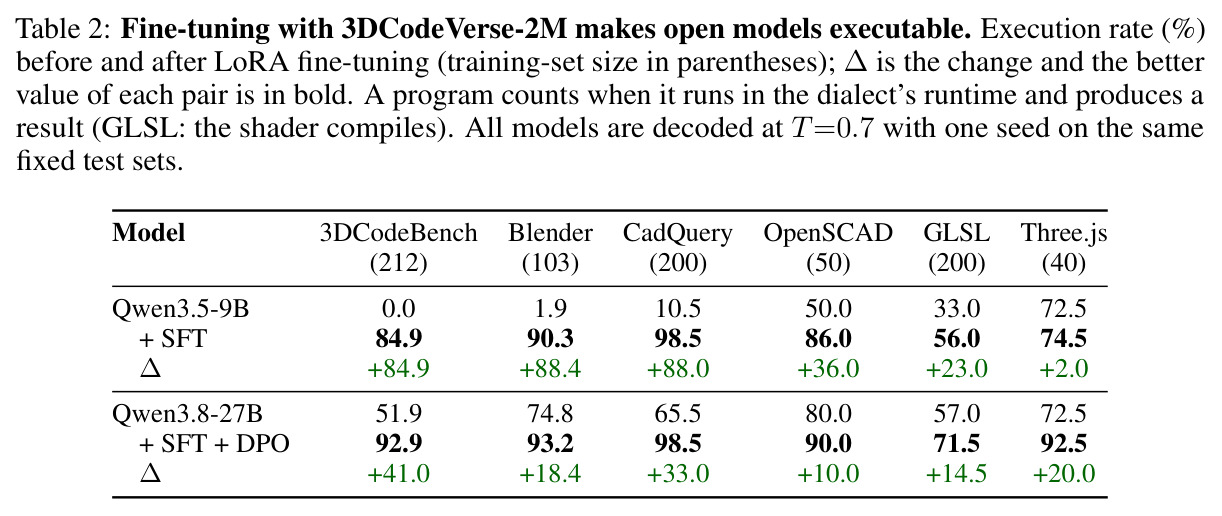
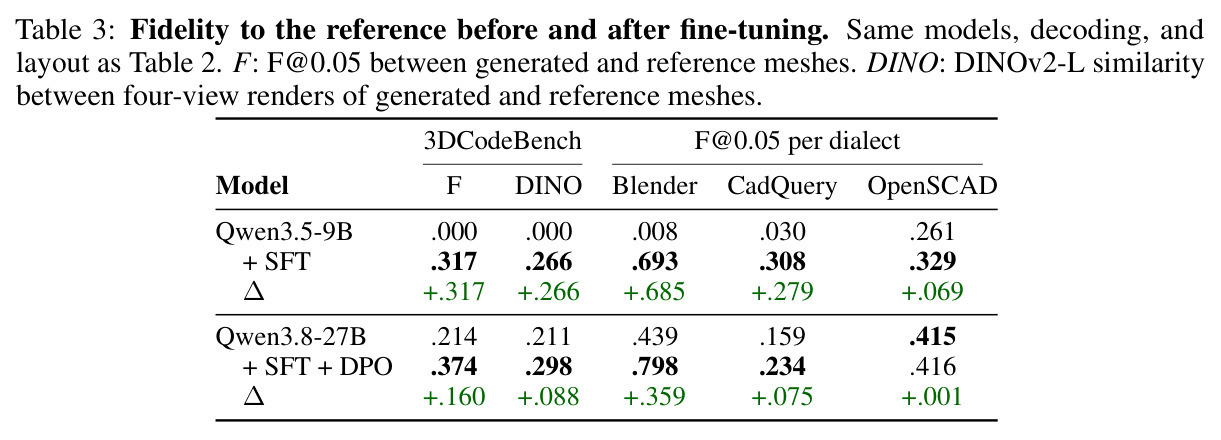
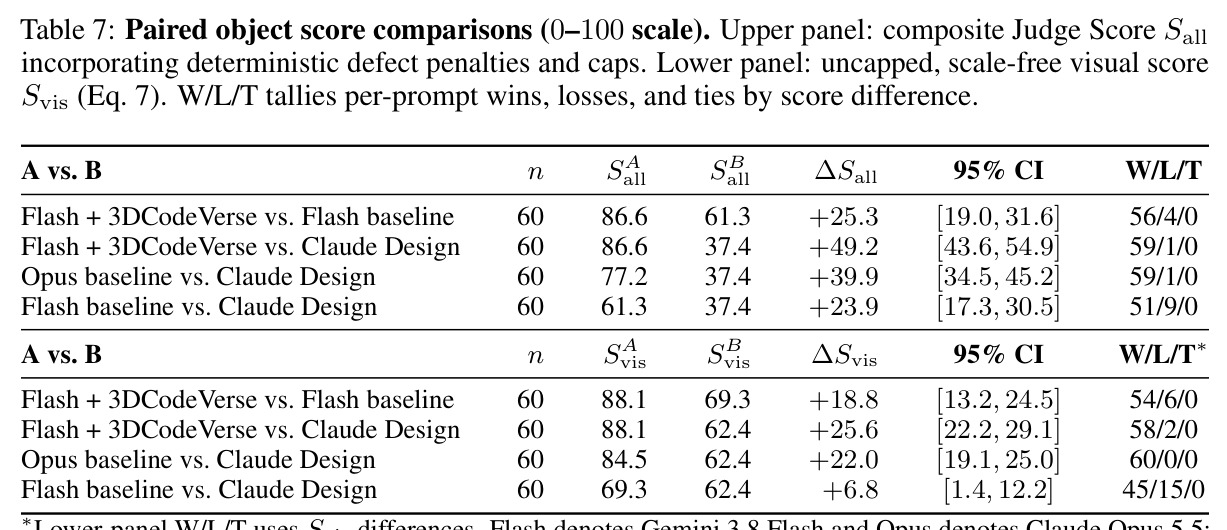
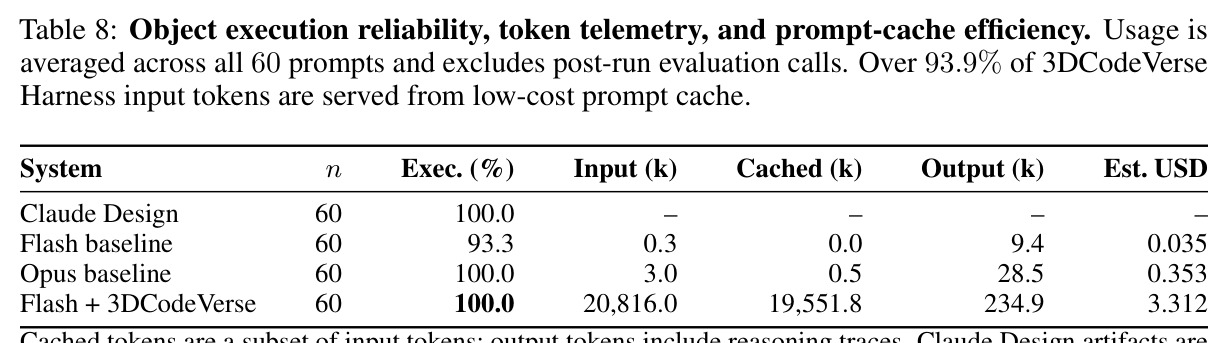
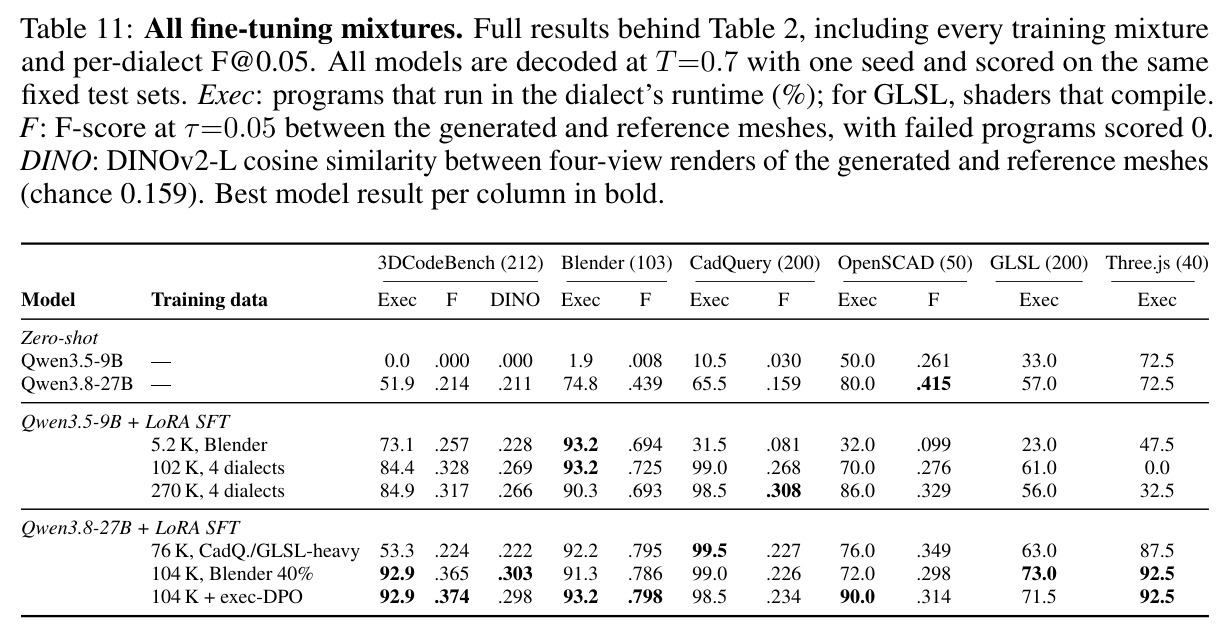
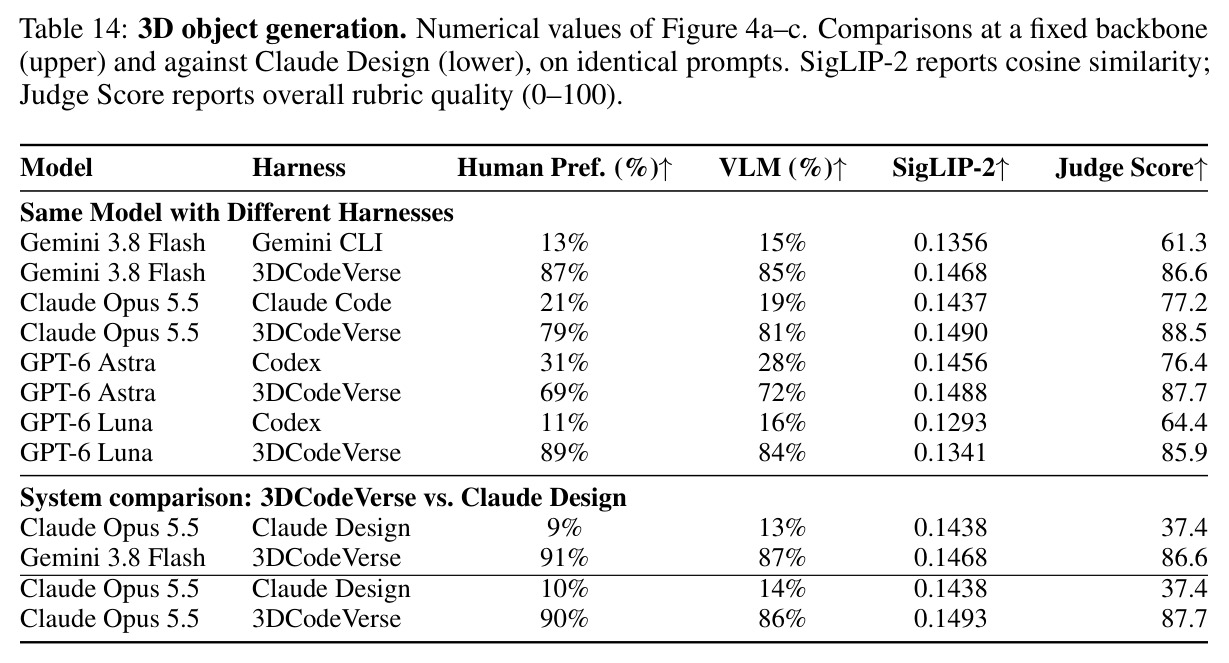
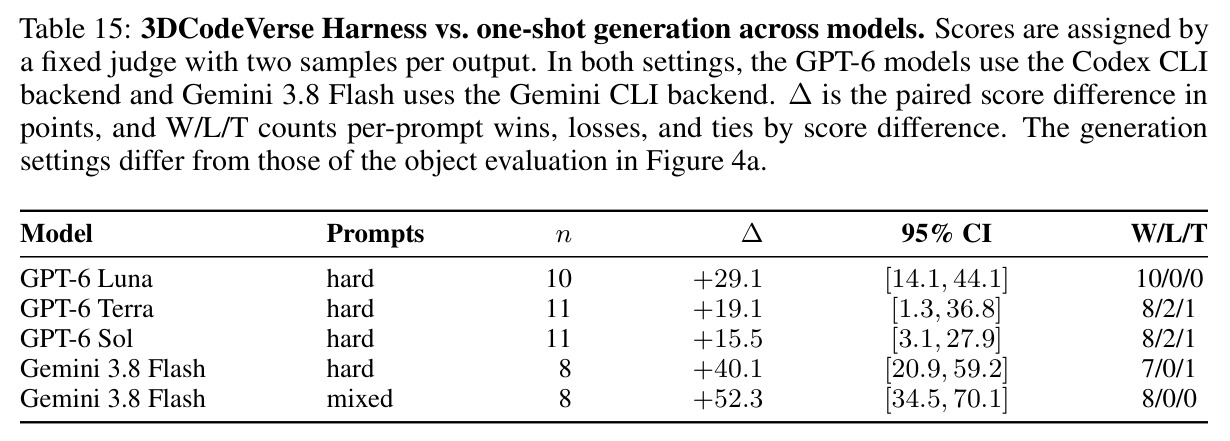
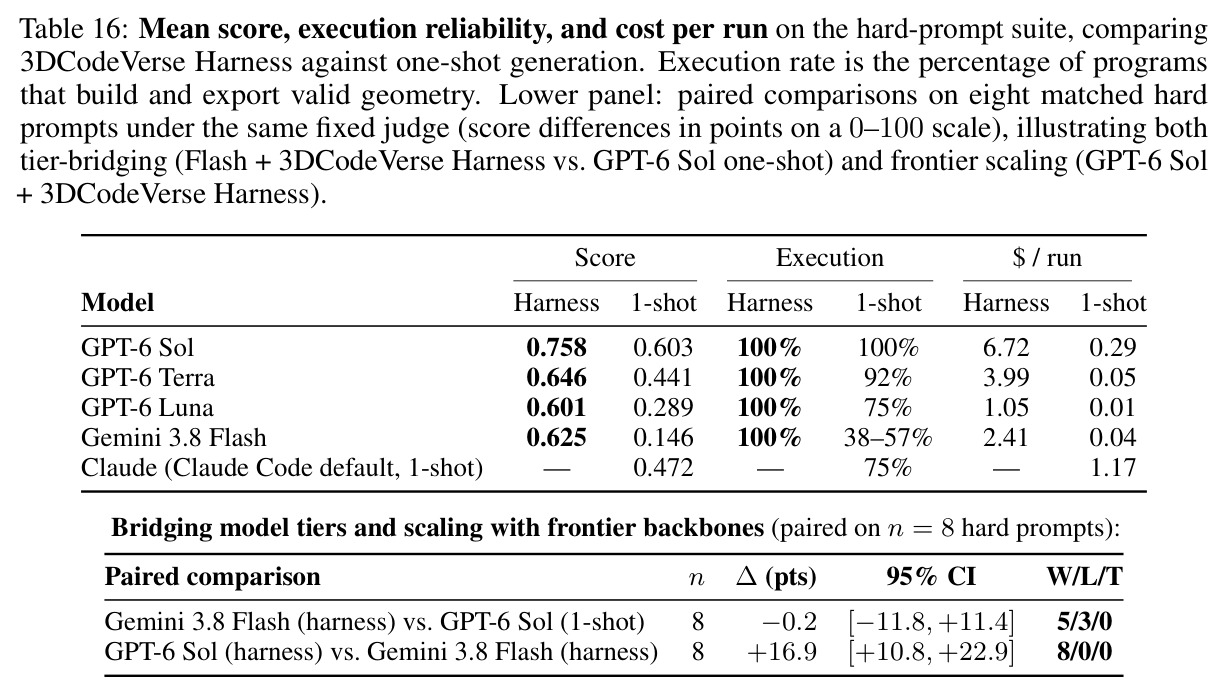
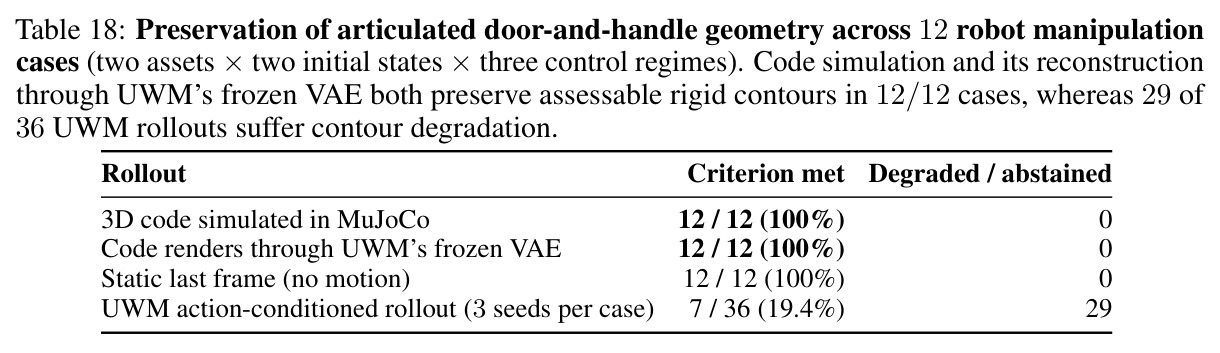
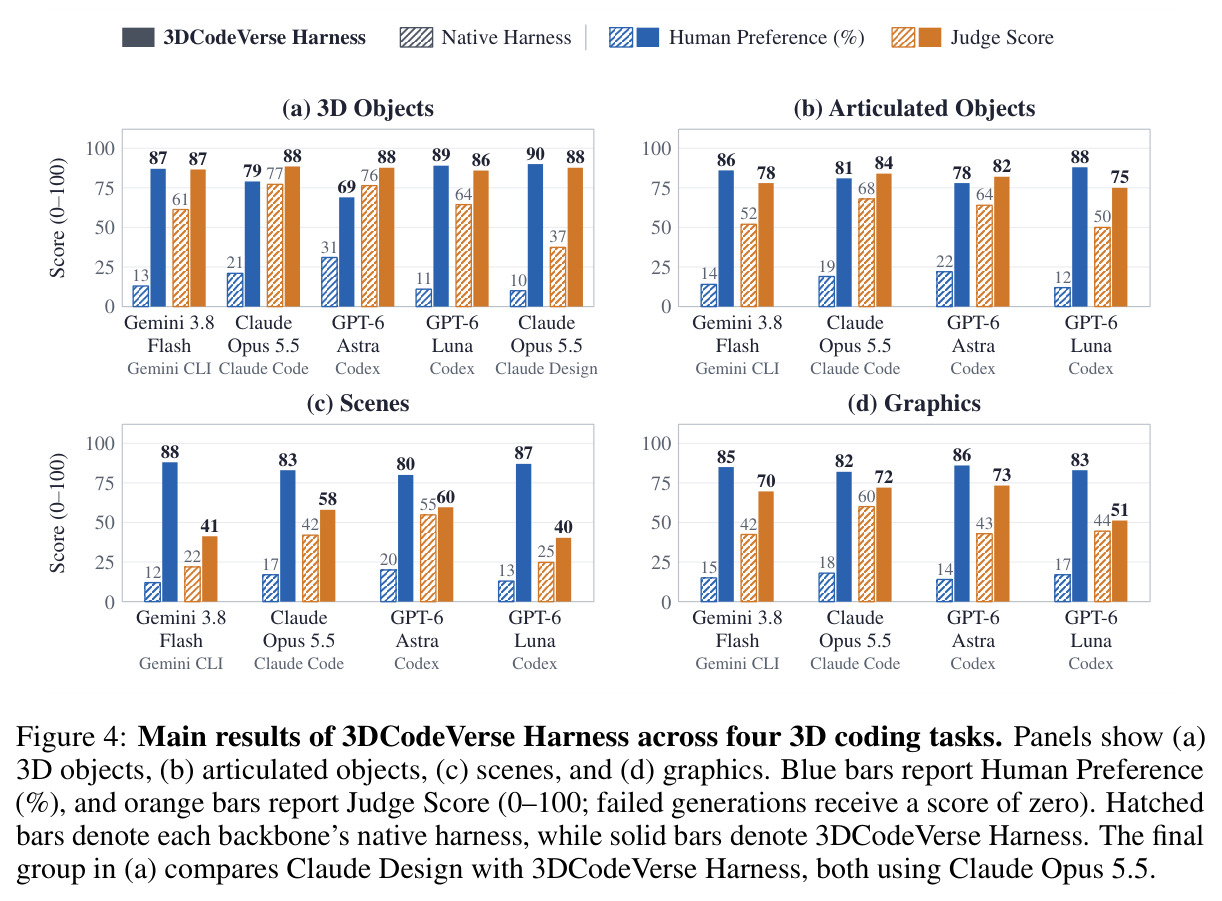
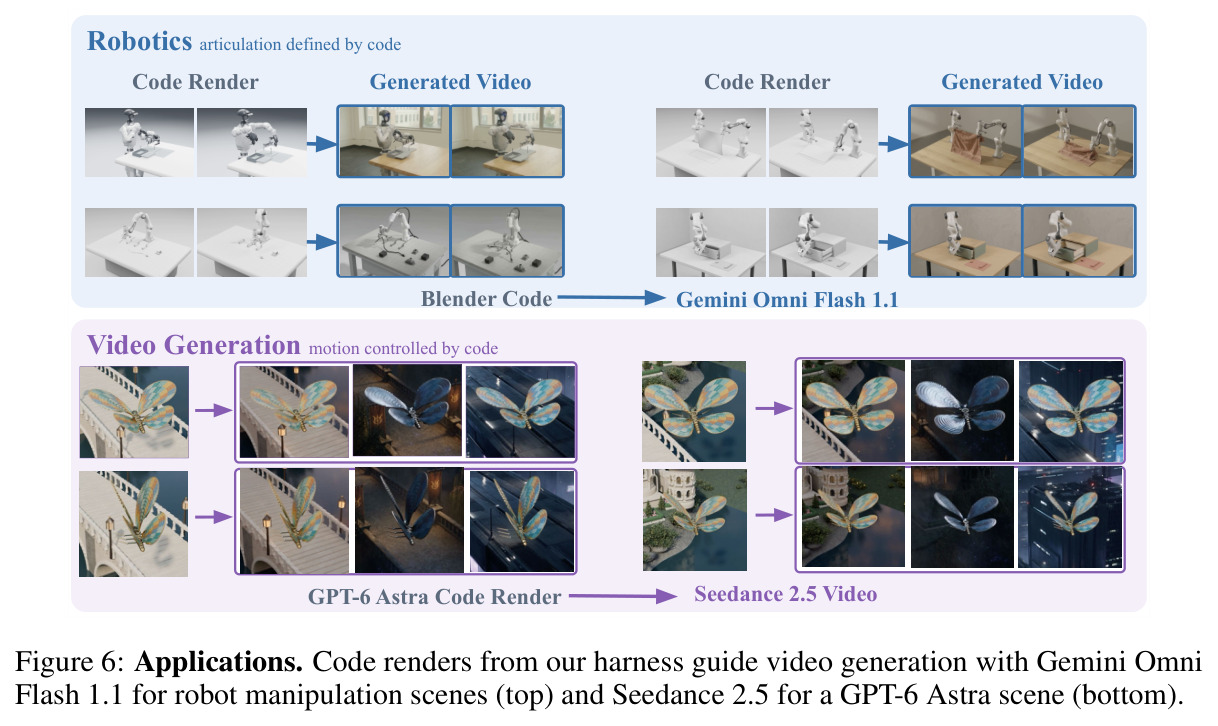
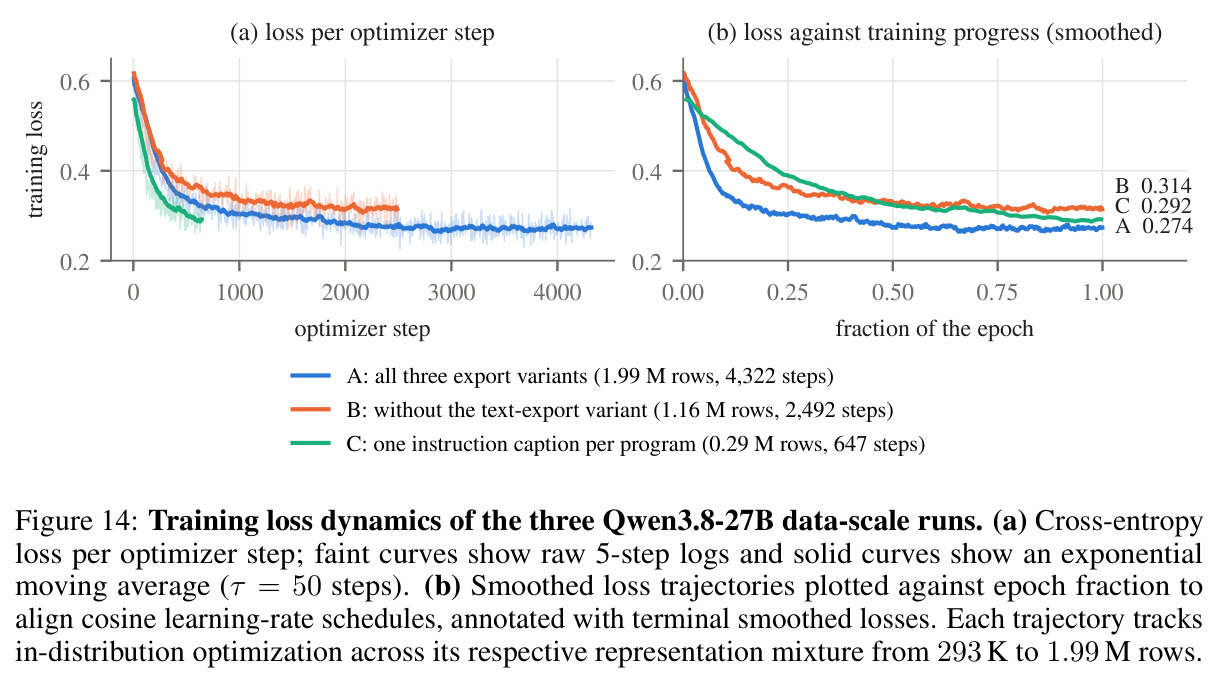
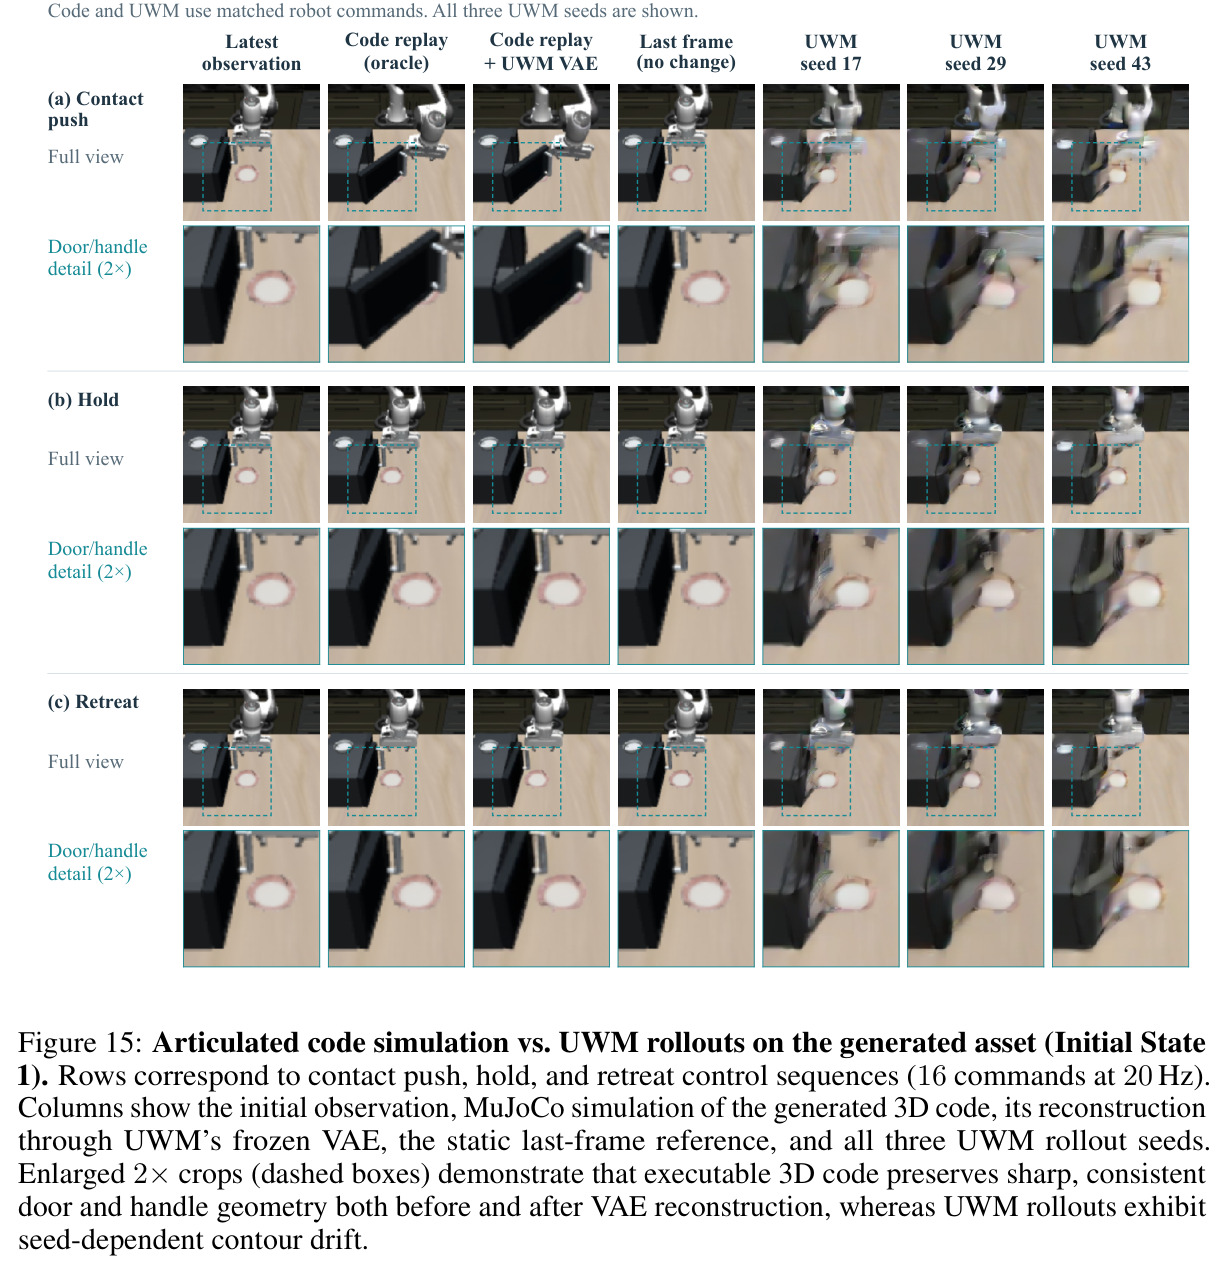
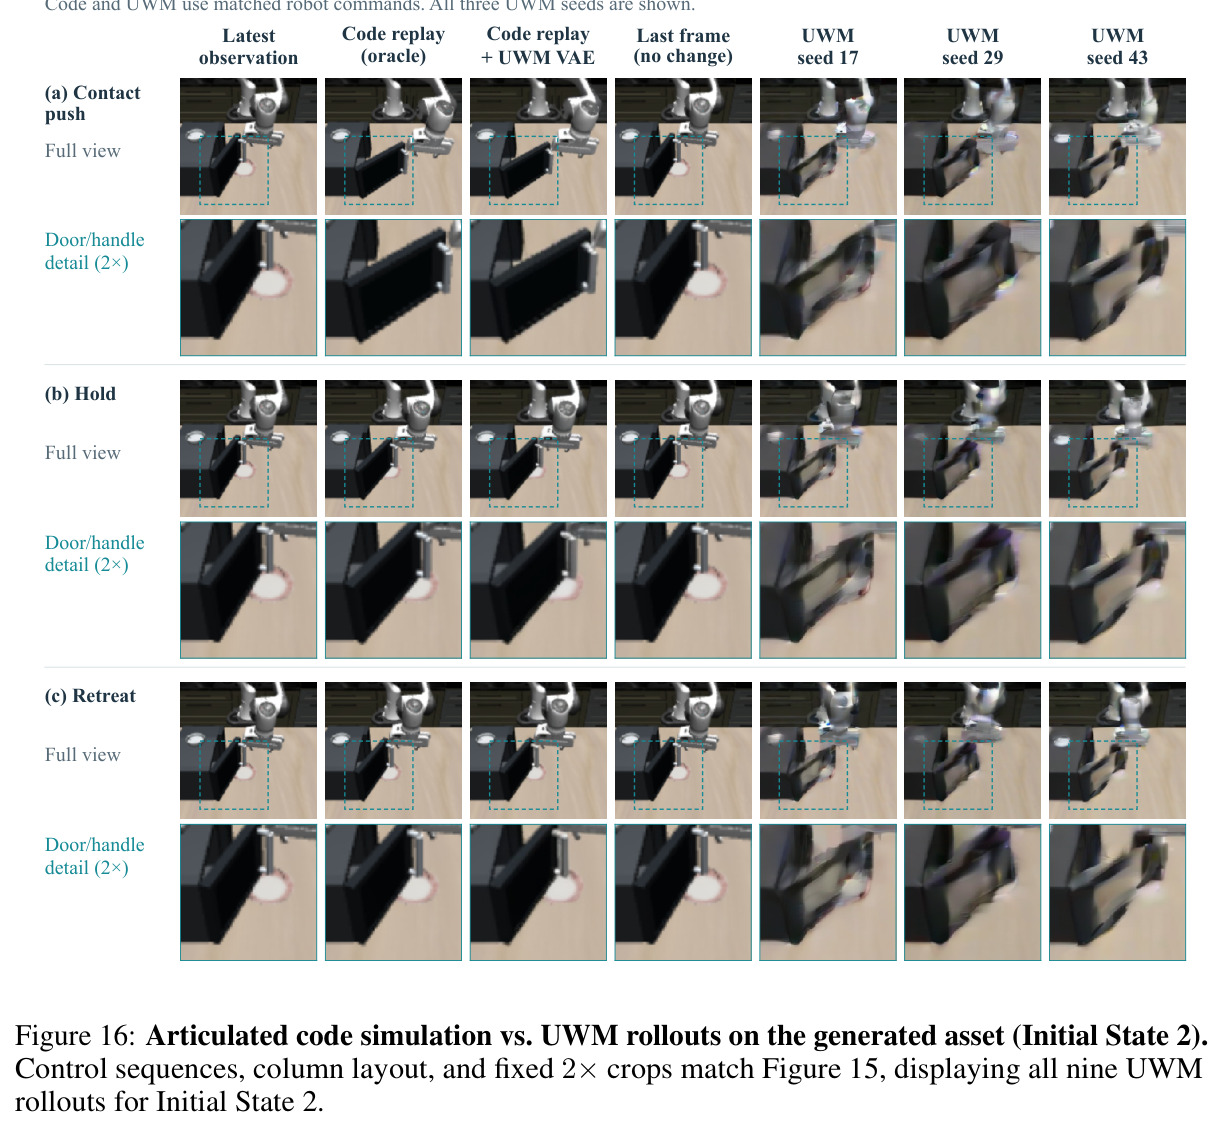
实验分三块,结论都很硬。第一,harness 增益:在 100 个 text-to-3D 物体提示上,同一底座换用 3DCodeVerse Harness 后人类偏好胜率 69%–89%,Judge Score 提升 11–25 分,弱模型获益最大(Gemini 3.8 Flash 61→87,GPT-6 Luna 64→86);对 Claude Design(Opus 5.5 驱动)取得 90% 人评胜率、Judge Score 87.7 vs 37.4,且在去掉所有封顶的免标尺视觉分 $S_{vis}$ 下仍赢 +25.6 分(88.1 vs 62.4,58/2/0),说明优势不来自评分细则;Flash+harness(86.6)甚至超过 Opus 单轮基线(77.2)。铰接/场景/图形三轨道人评偏好 78%–88%。成本上每物体 $3.31,但 93.9% 输入 token 命中提示缓存,执行率从 93.3% 提到 100%。困难提示套件上出现『层级桥接』:Flash+harness 得 0.625,与 GPT-6 Sol 单轮(0.603)统计打平(5/3/0);而 Sol+harness 进一步到 0.758,验证闭环既托举弱模型又抬高旗舰上限。第二,微调:Qwen3.5-9B 在 3DCodeBench 执行率 0→84.9%,27B 51.9→92.9%(+41.0);保真度 9B 的 F@0.05 从 0.000 到 0.317(Blender 保持集 0.008→0.693),27B 从 0.214 到 0.374(Blender 0.439→0.798)。执行反馈 DPO 两轮把 9B greedy 执行从 75.0% 推到 96.2%、pass@4 达 99.1%;终止反馈 DPO 把 OpenSCAD 平均输出从 30,163 压到 2,884 token、greedy 执行 8%→86%;几何反馈 DPO 把条件 F@0.05 从 0.387 提到 0.403。多方言混合训练带来跨语言迁移:CadQuery 98.0%(单方言仅 73.0%),Blender 份额 15%→34% 使 F@0.05 从 0.705 升至 0.816。第三,组件消融与应用:计划上下文重采样把无效计划率降 85%(4.7%→0.7%,$p=0.0067$);显式 mimic 耦合字段把 10 个联动机构提示的有效 URDF 声明从 3/10 提到 10/10;多轮闭环把铰接均分从 0.605 提到 0.789。机器人应用中,harness 验证过的资产在 MuJoCo 仿真与其 VAE 重构里 12/12 保留门-把手刚性轮廓,而 UWM 视频世界模型仅 7/36(19.4%)——29 个 rollout 出现轮廓漂移。代码渲染还作为参考视频驱动 Gemini Omni Flash 1.1 与 Seedance 2.5 的可控视频生成。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 3D 物体生成(vs Claude Design,均为 Opus 5.5 底座) | 人类偏好胜率 | 90%(Judge Score 87.7) | Claude Design 10%(37.4) | +80 pp / +50.3 分 |
| 3D 物体生成(Gemini 3.8 Flash 底座,vs 自带 Gemini CLI) | Judge Score(0–100) | 86.6(人评 87%) | 61.3(人评 13%) | +25.3 分 |
| 免标尺视觉分(排除标尺项与封顶) | $S_{vis}$(0–100) | 88.1(58/2/0) | Claude Design 62.4 | +25.6 分 |
| 3DCodeBench 执行率(Qwen3.5-9B) | 执行率 % | 84.9% | 0.0%(微调前) | +84.9 pp |
| 3DCodeBench 执行率(Qwen3.8-27B) | 执行率 % | 92.9%(SFT+DPO) | 51.9%(微调前) | +41.0 pp |
| Blender 保持集几何保真(9B) | F@0.05 | 0.693 | 0.008 | +0.685 |
| 执行反馈 DPO 两轮后(9B,greedy) | 3DCodeBench 执行率 % | 96.2%(pass@4 99.1%) | 75.0% | +21.2 pp |
| 困难提示套件执行可靠性 | 执行率 | 100%(全部 5 个底座) | 单轮基线 38%–92% | +8 至 +62 pp |
| 铰接资产物理仿真结构保持(vs UWM 视频世界模型) | 门-把手轮廓判据通过率 | 12/12(100%,MuJoCo 及其 VAE 重构) | UWM 7/36(19.4%) | +80.6 pp |
局限与改进
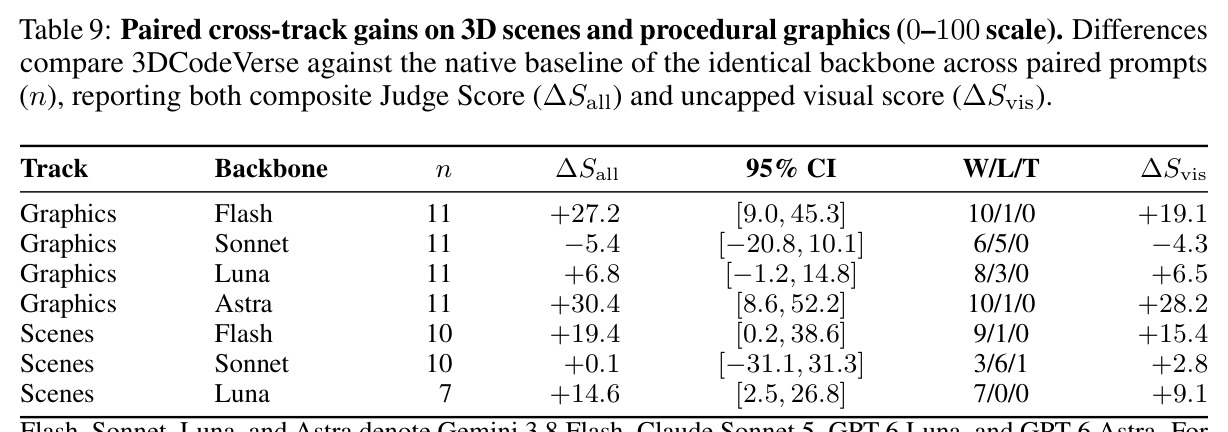
作者承认并可以被读者观察到的局限如下。评测层面:Judge Score 与 VLM Preference 都依赖 Gemini 3.1 Pro 裁判,虽有 σ=0.030 的重复精度、确定性门否决和人类偏好交叉验证三重保险,但裁判仍是同一族 VLM,可能存在系统性审美偏置;评测提示集偏小(物体主基准 60 个、场景/图形各 50 个)。生成层面:A/A 重复研究显示开放提示下结构方差很大($\sigma_\Delta=0.202$,同一提示可被实现为 1 部件 4796 三角形或 10 部件 61340 三角形),单次 rollout 的质量不可预测,需要 best-of-N 对冲。成本层面:Flash+harness 每物体 $3.31、数分钟级延迟,是单轮($0.035)的近百倍,不适合交互式场景;且 Sonnet 5 在图形轨道出现负增益($\Delta S_{all}=-5.4$),说明 harness 的门与细则对某些底座可能形成束缚。数据层面:Shadertoy 占目录 44.5% 而 Three.js 场景仅 280 个,方言分布不均;整库 CC-BY-NC-SA-4.0 许可禁止商用。应用层面:机器人对比只有 12 例、2 个资产、特定门-把手判据,外推性有限;9B 模型处理 280 个长多部件 Three.js 程序时逼近上下文窗口并诱发不终止,说明长程序仍是软肋。
独立分析的弱点
第一,视觉与测量的能力边界不对称:确定性工具只覆盖结构(连通、穿透、限位),材质、光影、美感仍完全依赖 VLM 主观判断, judges 可能在『结构对但难看』的样本上给分漂移——改进方向是把物理仿真(已有 MuJoCo 雏形)、光照渲染统计(图形轨道的亮度/色度门已具雏形)纳入更多轨道。第二,测试时计算开销与方差:$3.31/物体、多分钟延迟、$\sigma_\Delta=0.202$ 的跨运行方差意味着实际交付质量要靠 best-of-N 与多轮兜底——改进方向是把 harness 的修复轨迹蒸馏回单模型(作者已用 bootstrap 程序证明可行),或学习自适应提前终止策略(当前固定 $T=4$/60 分钟)。第三,错误反馈的信噪比:门错误虽有数值修复提示,但 Table 11 显示 stool 第 1 轮仍留下 8 条警告,多数派发预算(≤6 任务/轮)会截断感知类建议,复杂缺陷的收敛可能变慢——可引入缺陷图的依赖排序而非线性优先级。第四,方言覆盖不均:Three.js 场景 280 个、OpenSCAD 1193 个,远少于 CadQuery/GLSL,而这恰是 Web 3D 与社区打印的高需求方向——可用 harness 数据引擎定向扩采。第五,许可:NC 条款阻断商业落地,若要产业化需替换 Shadertoy 等 NC 来源。第六,Sonnet 负增益提示 harness 与底座的适配并非免费:不同 CLI/模型的提示契约可能需要自动调参而非手工工程。
未来方向
作者明确承诺发布数据集、harness、模型与训练配方,并强调 harness 的数据引擎属性支持语料持续扩展。基于其成果可自然延伸的方向:其一,把执行轨迹、修复前后对与偏好对用于 on-policy 强化学习(当前仅离线 SFT+DPO),让模型内化『执行-测量-修复』循环而减少推理时轮数;其二,3D 编辑与增量修改——当前聚焦从零生成,代码的可编辑性尚未系统化为编辑基准;其三,与视频世界模型深度融合——论文已证明代码资产在刚性结构上远胜 UWM 潜空间 rollout(12/12 vs 7/36),可探索代码作为视频生成的可控结构先验、或用视频模型反过来给代码生成提供外观先验;其四,sim-to-real:显式 URDF+物理门验证的资产天然适合真机部署前的仿真训练,可扩展到更丰富的机器人任务族与更多判据;其五,把关节扫掠、穿透检查等推广为形式化验证(如几何约束求解器证明无碰撞),进一步降低对 VLM 的依赖;其六,跨方言统一模型:多方言训练已显示正向迁移(CadQuery 73%→98%),扩大 Three.js/场景语料后可训练单一多运行时 3D 编码模型。
复现评估
复现友好度较高。开源情况:项目页 3dcodeverse.com、GitHub(gaoypeng/3dcodeverse)、HuggingFace 数据集(ilabai/3dcodeverse)均已列出,承诺发布数据、harness、模型和训练配方;附录给出异常详尽的超参(LoRA rank 64/α 128/dropout 0.05、lr $1\times10^{-4}$ 余弦调度、5% warmup;DPO rank 16、β 0.1、lr $5\times10^{-6}$)与评测协议(pinned runtime、300s 超时、T=0.7 单种子、四视角 90° yaw 最优对齐的 Chamfer/F-score)。算力门槛低:全部微调在 4×H100 上完成,9B 的 270K 对/293M token 混合物 4 小时 46 分钟、27B 的 104K 混合物 3 小时 35 分钟,单卡级别的实验室即可复跑。数据侧风险小:论文做了严格的去污染(212 个 3DCodeBench 工厂及 3904 个重种子实例全部排除在训练外),DeepCAD 转换还修复了上游 train/test 的 3230 个重复几何组的跨分割泄漏。难点在 harness 侧:依赖 Claude Code/Codex/Gemini CLI 等商用 agent 后端与 Gemini 3.1 Pro 裁判 API,完整复现其推理时结果需要 API 预算(每物体约 $3.31),7 个隔离运行时(含 Blender 5 的沙箱构建包装)的环境搭建也有工程量;但微调与评测两条线用公开数据即可独立验证。
论文图表
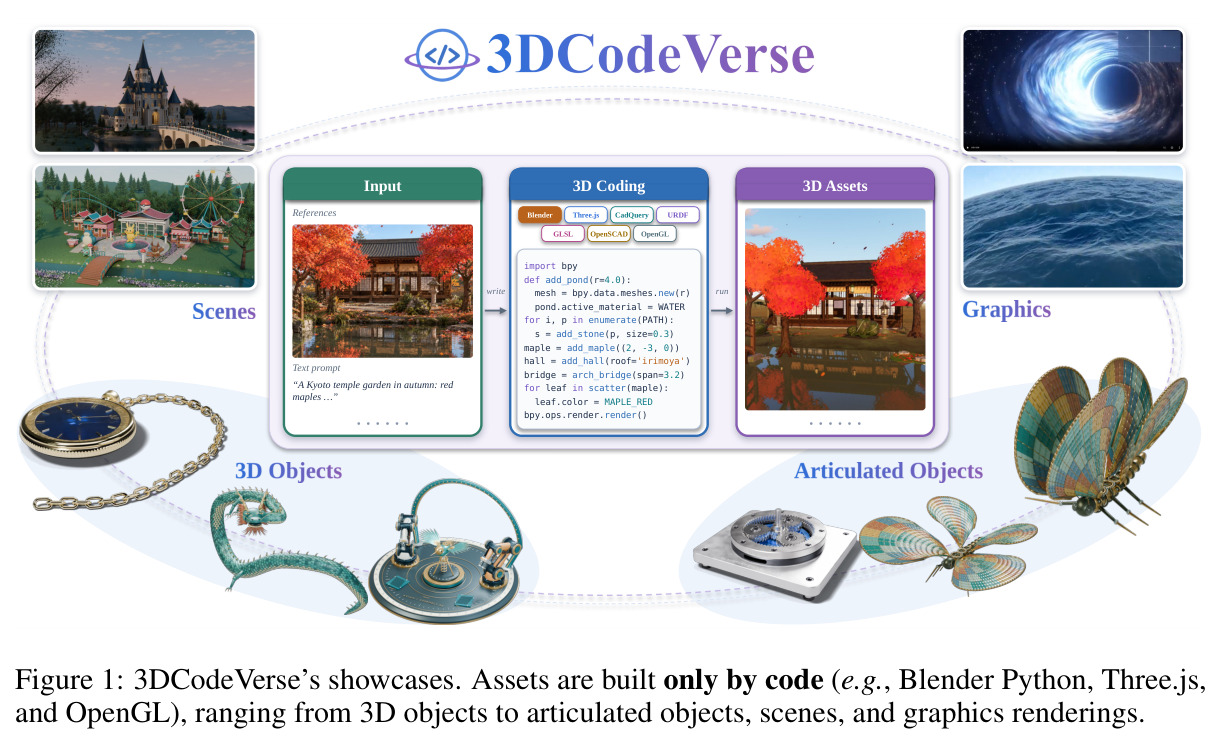
展示图:从文本提示『A Kyoto temple garden in autumn』出发,只用代码(Blender Python、Three.js、OpenGL、CadQuery、URDF、GLSL 等)生成从 3D 物体、铰接物体、场景到图形渲染的各类资产,右侧给出 Blender Python 代码片段示例。
一图定义论文的研究对象:什么叫『3D 世界即代码』,覆盖哪四类内容与哪些语言运行时。