InfiniDream:通过程序化生成构建开放式照片级真实感3D世界 InfiniDream: Open-Ended Photorealistic 3D Worlds Through Procedural Generation
用VLM在符号约束下扩展程序化工厂代码,自动生成开放可编辑的照片级3D世界
前置知识
程序化生成
用可执行程序而非静态 mesh 来编码 3D 内容的技术。资产由参数化算法(L-system、形状文法、噪声地形等)在运行时“长”出来,改参数或换随机种子就能得到不同变体,因而天然具备可编辑性、可扩展性和基于种子的多样性,广泛用于游戏开发和合成数据生成。
本文的全部价值主张建立在程序化表示之上——InfiniDream 生成的不是 mesh 而是“会生成 mesh 的代码”,理解这一点才能明白作者为何执着于保留工厂接口和 seed 逻辑。
Infinigen 与资产工厂
Infinigen 是最先进的照片级程序化场景生成系统,由 40,000 多行手工代码构成,内部包含大量“资产工厂”——每个工厂是针对特定类别(鸟类、鱼类、植物、地形)的参数化生成器,内置精细的几何、材质与光照算法,可产出无限变体,但类别之外无能为力。
InfiniDream 的 SCE 就是在 Infinigen 工厂上做“约束式改造”,论文的动机、基线和评估全部围绕它展开,不懂工厂机制就看不懂编辑策略为何如此设计。
VLM 驱动的 Blender 代码生成
让视觉语言模型直接编写 Python/Blender 脚本来创建 3D 资产与场景的方法(VIGA、BlenderRAG、3DCodeBench 等)。优点是开放——理论上什么都能写;缺点是 VLM 难以在代码里表达照片级的几何细节与复杂材质,产出通常是简化几何体。
这是本文对标的另一条技术路线,理解其“灵活但粗糙”的特性,才能领会 SCE 用约束换取细节质量的动机。
视锥体与射线求交
视锥体是相机可见的空间区域,以相机为顶点、沿视线方向张开的棱台。把图像平面离散成网格后,从相机穿过每个格点的射线与场景几何求交,即可得到物体可能放置的 3D 候选位置;沿射线按深度间隔采样则可得到空中或水下的候选点。
论文的确定性视锥引导网格放置完全建立在这个几何工具上,是理解其“零额外 VLM 调用放置”的关键。
感知评估指标(CLIP/SigLIP2/DINOv3/ImageReward)
一组用视觉-语言基础模型给生成结果打分的指标:CLIP 与 SigLIP2 度量图像与文本嵌入的余弦相似度(语义对齐),DINOv3 用自监督视觉特征比较与参考图的相似度(视觉质量),ImageReward 是拟合人类偏好的打分模型。它们比传统指标更贴近主观感受,但对细粒度几何缺陷不敏感。
论文所有定量结论(物体级、场景级、消融、多样性)都用这四个指标报告,理解各自的度量维度才能正确解读实验结果。
研究动机
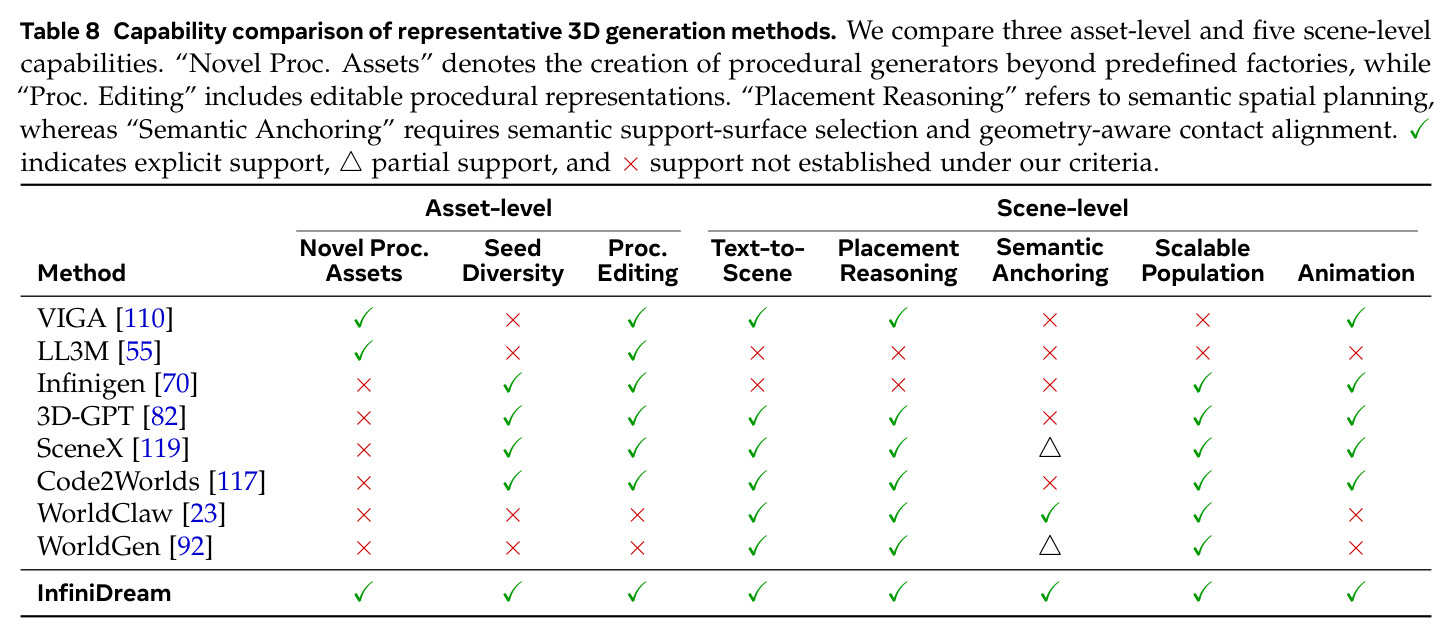
3D 内容生成存在两条路线的矛盾。一方面,程序化系统(如 Infinigen)通过 40,000 多行手工代码和精心打造的资产工厂能产出照片级、可编辑的 3D 场景,但能力被严格限制在预定义类别和规则内——给它“开花的仙人掌”提示,因为没有开花变体工厂就直接生成失败。另一方面,VLM 直接生成 Blender 代码虽然灵活,但产出的几何体过于简化,缺乏照片级细节和复杂材质;把整个 Infinigen 代码库丢给 VLM Agent Harness 后编辑仍然不精确。折中方案如 Code2Worlds 用 VLM 编排预定义函数和参数(比如只能把鱼改成灰色),本质上被困在参数空间里,无法创造新的结构特征(如给鱼加上新鳍)。基于检索或生成式 mesh 的大规模世界方法又丢失了参数化可编辑性与种子多样性,想要物体变化就得直接改 mesh 或重新生成。
本文的目标是本文目标是构建一个 VLM 驱动的开放式程序化 3D 世界生成框架 InfiniDream:用户给一句自然语言描述(如“一个梦幻的水下世界,有彩虹色软珊瑚、热带鱼和远处漂浮的半透明水母”),系统就能自动生成照片级真实、可编辑、具种子多样性的大规模 3D 世界。目标拆成两个层次:资产级,要超越预定义工厂创造新颖的程序化资产(如让仙人掌开花),同时保留可编辑性和 seed 多样性;场景级,要把语义规划与确定性物体放置结合,以精确摆放、程序化填充和动画构建大规模世界,并在物体与场景两个层面、感知指标和人类偏好上都超越 VLM 代码生成、工厂编排与 mesh 组合三类既有方法。
与已有工作不同的是,本文的独特切入点是“不做二选一,而是受约束地扩展”。已有三条路——VLM 从头写代码、在预定义工厂内调参数、把 Infinigen 整个交给 agent——分别输在细节、开放性和精度上。作者的关键观察是:Infinigen 的复杂性既是障碍也是财富,问题在于如何把一个庞大的程序化代码库变换成 VLM 可管理的编辑空间。为此提出符号约束编辑(SCE):用 AST 依赖分析裁剪出小的“可编辑表面”,其余算法作为只读“链接基础设施”,并设计 Tweak/Create/Promote 三级渐进式编辑策略。场景端同样遵循“语义交给 VLM、几何交给确定性算法”的分工:VLM 只做离散语义决策(放什么、放哪类表面、放多少),连续坐标计算交给视锥网格搜索,避免了反复调用 VLM 预测坐标和渲染验证的开销与不可复现性。
核心方法
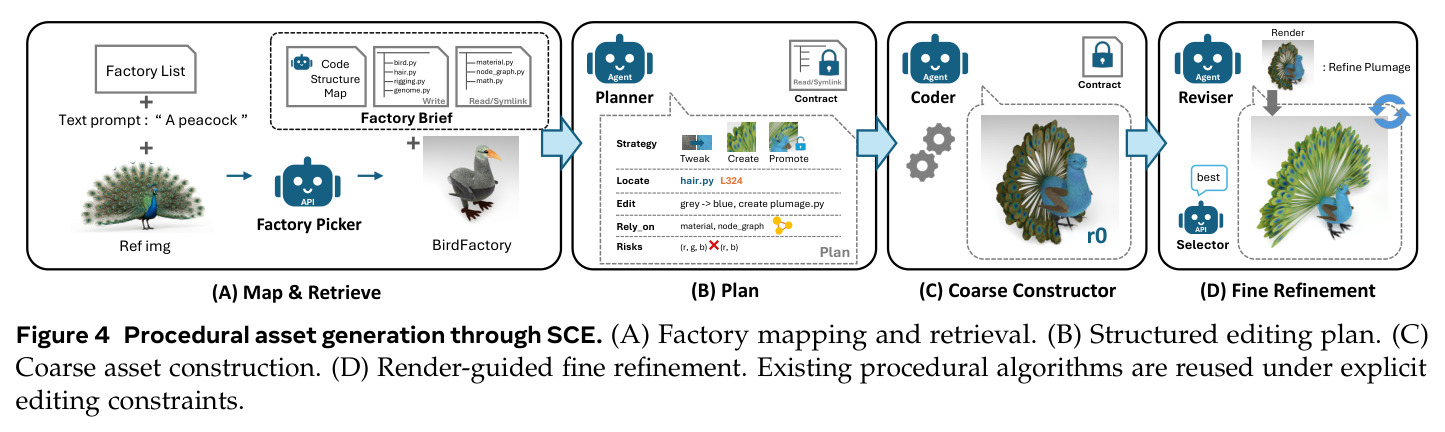
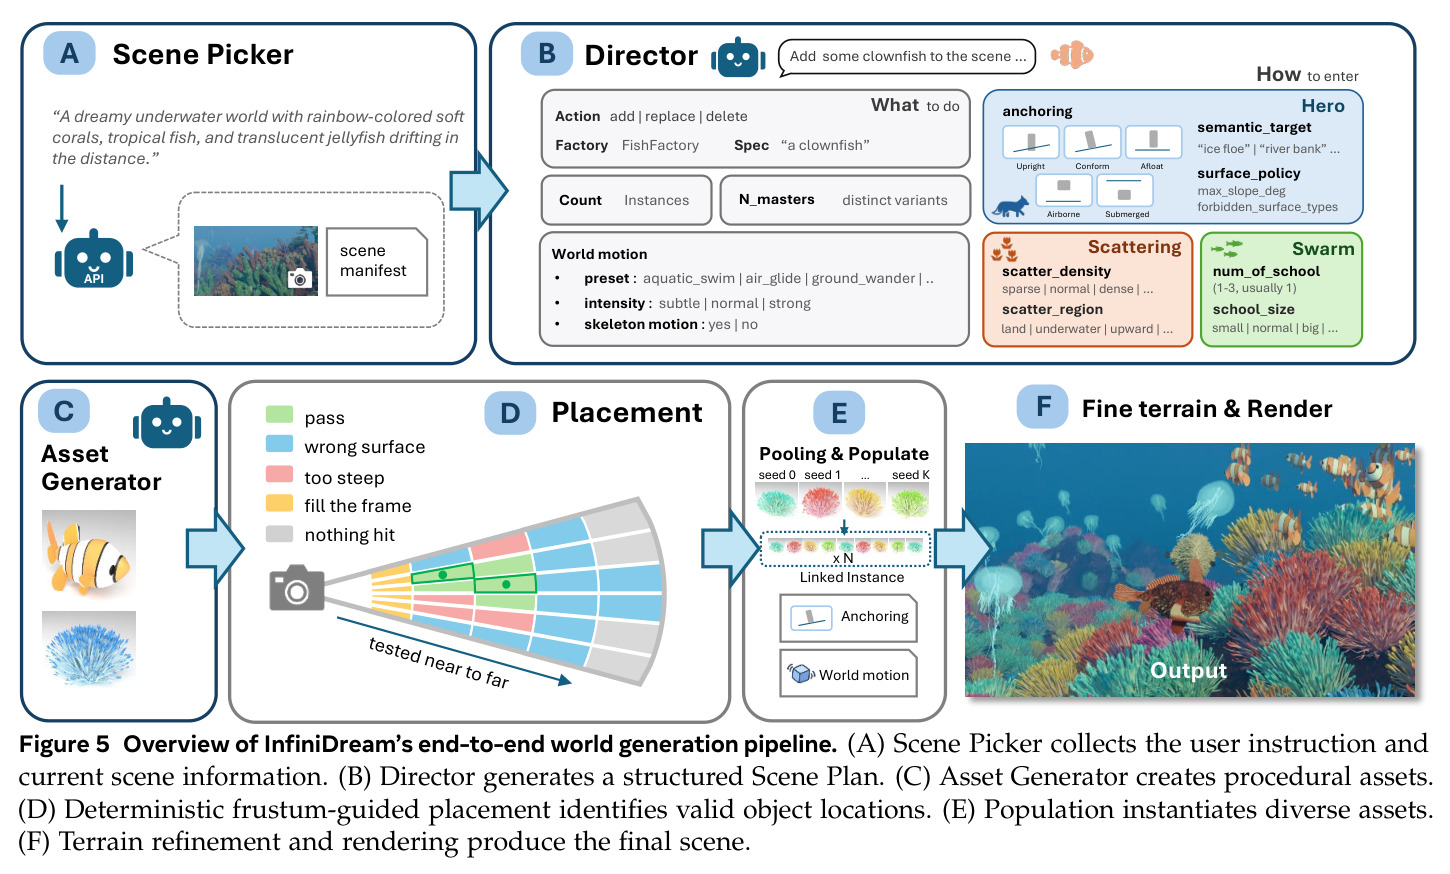
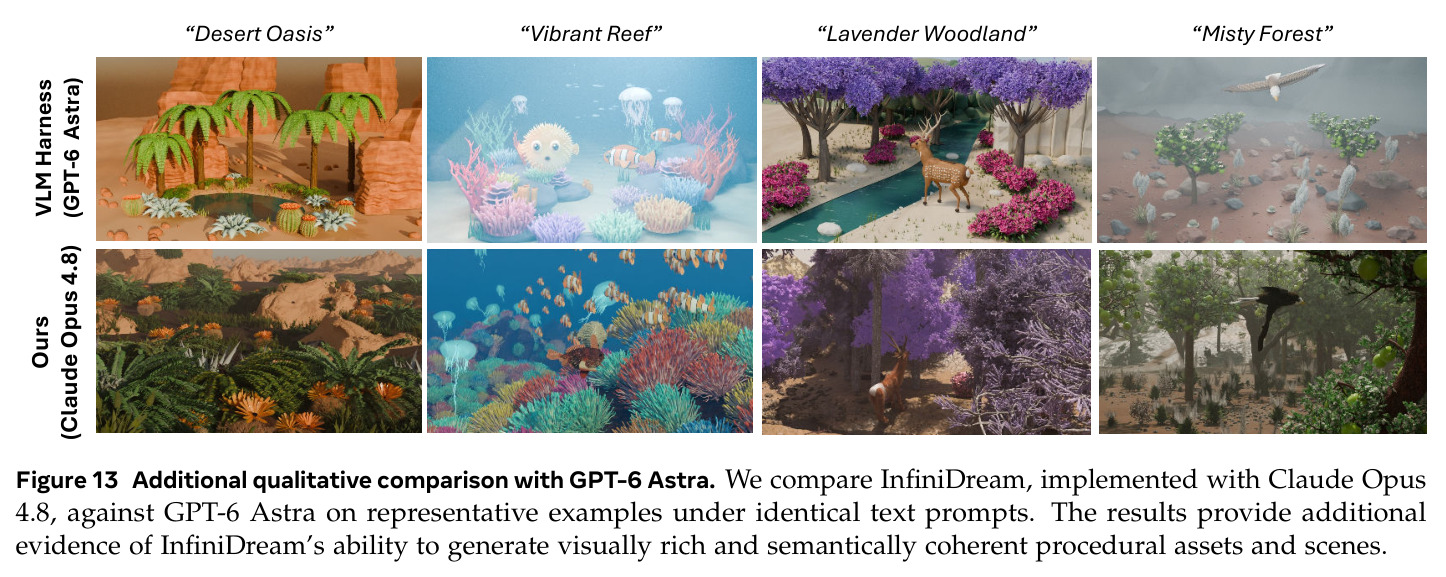
InfiniDream 是端到端的 text-to-world 流水线,直觉是“VLM 出主意、程序化算法干活”。先由 Scene Picker 从 70 个预生成环境库(14 生物群系 × 5 种子)选定初始粗场景,Director 把自然语言转成结构化 Scene Plan,规定增/删/换操作、放置模式(Hero/Scattering/Swarm)、实例数 N 与原型数 K、世界运动。资产级走 SCE:检索最相关工厂,构建含代码结构图、可编辑表面与只读链接基础设施的 Factory Brief;Planner 产出结构化编辑计划,Coarse Constructor 在约束内执行,Reviser 对照参考图渲染迭代修正(最多 6 轮),Selector 选最佳。场景级用确定性视锥网格放置:屏幕区域离散成 9×5 网格(≥6 实例用 17×9),沿相机射线求交生成候选,经可见性、碰撞、间距、表面策略、投影面积 5 项检查后近到远贪心选位 $i^* = \min\{i : \bigwedge_{j=1}^{5} g_j(p_i) = 1\}$。最后资产池化以 $M = \{M_k = G(s_k)\}_{k=1}^{K}$ 生成 K 个种子原型、$I_i = \mathrm{Clone}\, M_{((i-1) \bmod K)+1}$ 复制出 N 个实例,经地形细化、动画与渲染输出世界。全流程用 Claude Opus 4.8 作 VLM、Blender 4.x 渲染。
核心创新是符号约束编辑(SCE):不让 VLM 在 40,000 行代码里盲目探索,而是显式抽出代码结构并施加编辑契约。Factory Brief 把代码库分成三部分——Code Structure Map(VLM 摘要的关键函数与依赖)、Editable Surface(经深度限制为 2 的 AST 依赖图动态识别的资产专属模块,可写)和 Linked Infrastructure(共享底层算法如节点图,以只读符号链接提供)。编辑策略分三级:Tweak 只调参数与高层逻辑;Create 新写程序化函数;Promote 在必要时把受保护模块提升为可编辑,实现编辑空间的可控扩张。一个关键细节是保留 seed 依赖的随机性——通过调整采样范围而非固定参数来匹配参考图,从而不牺牲变体多样性。场景端的本质区别是把语义推理与几何计算彻底解耦:VLM 决策被限制在离散语义操作和约束上,连续坐标由确定性算法求解,整个放置过程零额外 VLM 调用,既省成本又完全可复现。
方法步骤详情
流水线分六步。(1) 场景选择:从 70 个预生成环境(14 生物群系 × 5 种子)选定初始场景并固定种子。(2) 场景规划:Director 输出 Scene Plan,含增/删/换操作;Hero 放置支持 7 种锚定(rooted/upright/tilted/conform/afloat/airborne/submerged)加 Semantic Target 与 Surface Policy(表面类型、坡度上限、支撑条件);Scattering/Swarm 由密度和群组规模控制;并确定 N、K 与 World Motion。(3) 资产生成(SCE):检索工厂 → 构建 Factory Brief(AST 依赖图深度 2)→ Planner 给编辑计划 → Constructor 执行并保持工厂入口与函数签名兼容 → Reviser 按渲染与参考图差异定向改代码,最多 6 轮,失败按 traceback 修复 → Selector 视觉选优。(4) 放置:屏幕区域离散为 9×5 网格(≥6 实例用 17×9),射线求交或深度采样(×1.3,最深 80 m)生成候选,5 项确定性检查后近到远选位;大物体先放、确定性哈希保证可复现,投影面积优选下限 1.2%、松弛下限 0.2%、上限 25%,无解时逐级松弛。(5) 池化与填充:K 个种子原型链接复制成 N 实例,按锚定模式放入场景。(6) 接入 Infinigen 细地形管线,结合世界运动与局部动画渲染成片。
技术新颖性
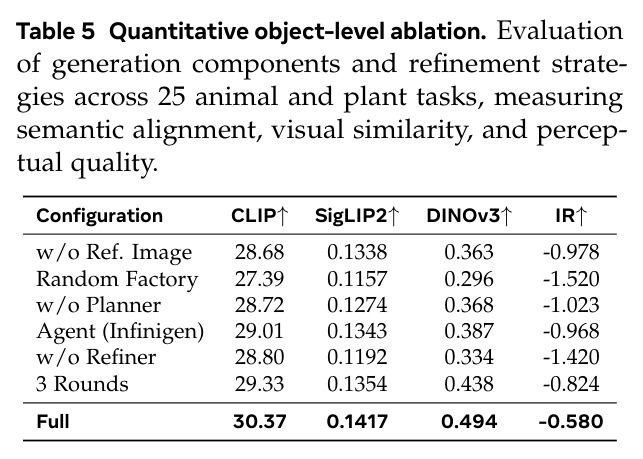
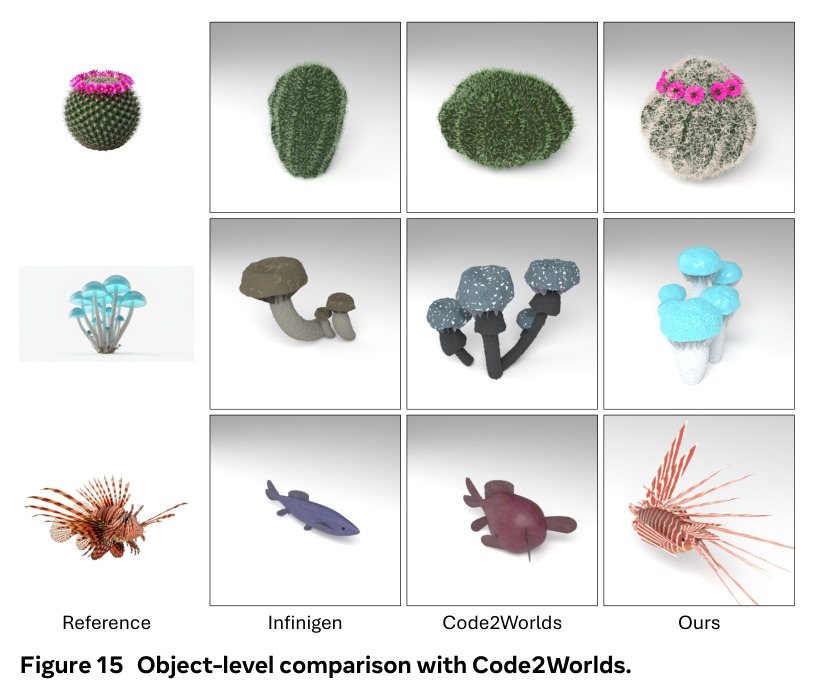
技术新颖性体现在三个层面。资产级:与 VIGA、BlenderRAG 等“视觉反馈+从头生成”方法相比,SCE 首次把 VLM 代码生成“嫁接”到成熟程序化工厂内部,复用已有的材质、光照、地形等数万行算法积累而不是重造轮子;与 Code2Worlds 等“参数编排”方法相比,Create 策略允许引入工厂中根本不存在的新结构(开花仙人掌、彩色孔雀羽毛),首次实现开放式程序化资产生成。场景级:确定性视锥网格放置替代了主流的“VLM 直接预测坐标”或“反复渲染验证”,用投影面积带 $a_{\min} \le a(p) \le a_{\max}$ 与近到远搜索实现隐式的尺寸感知布局——小物体自然落在近处、大物体被推向远处,放置全程无额外 VLM 调用。系统级:语义预算的资产池化把昂贵构建从 N 次降到 K 次,兼顾成本与种子多样性,这是对 Infinigen 池化机制面向独立物体填充的扩展;消融显示给 agent 整个代码库自由发挥(29.01 CLIP)仍显著劣于结构化约束(30.37),直接验证了“约束带来质量”的核心论点。
实验结果
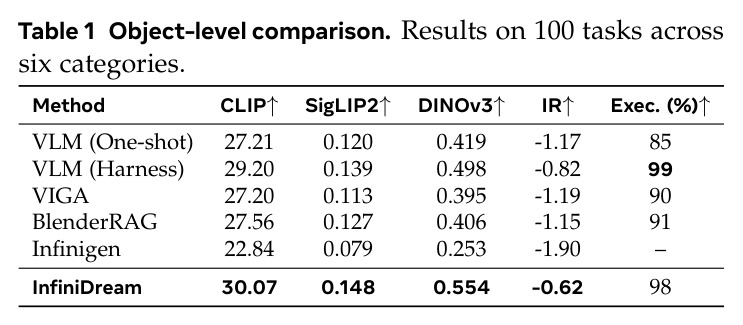
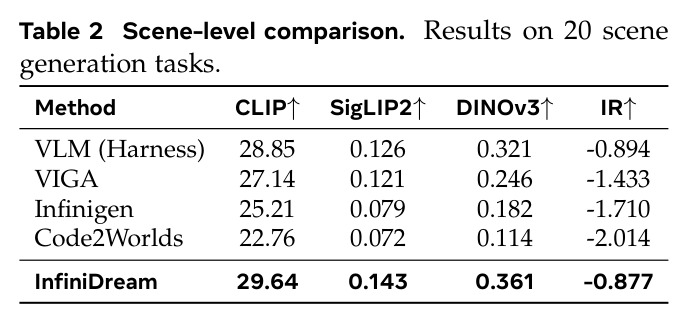
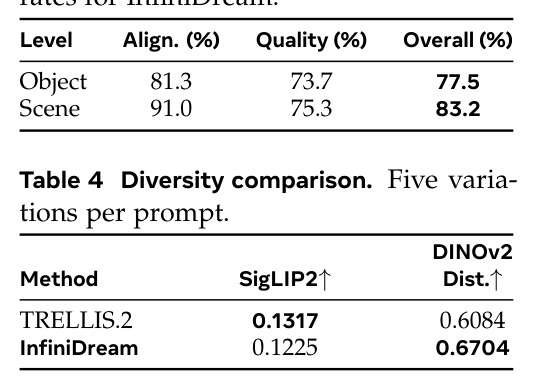
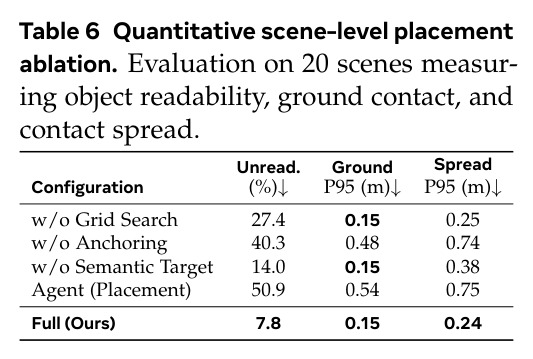
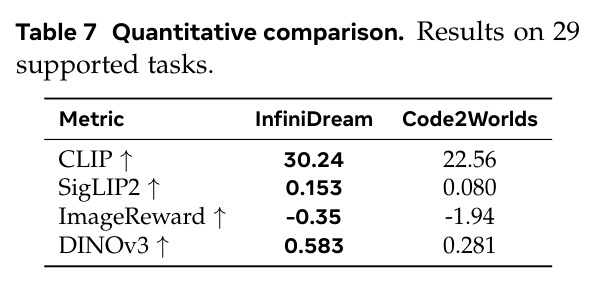
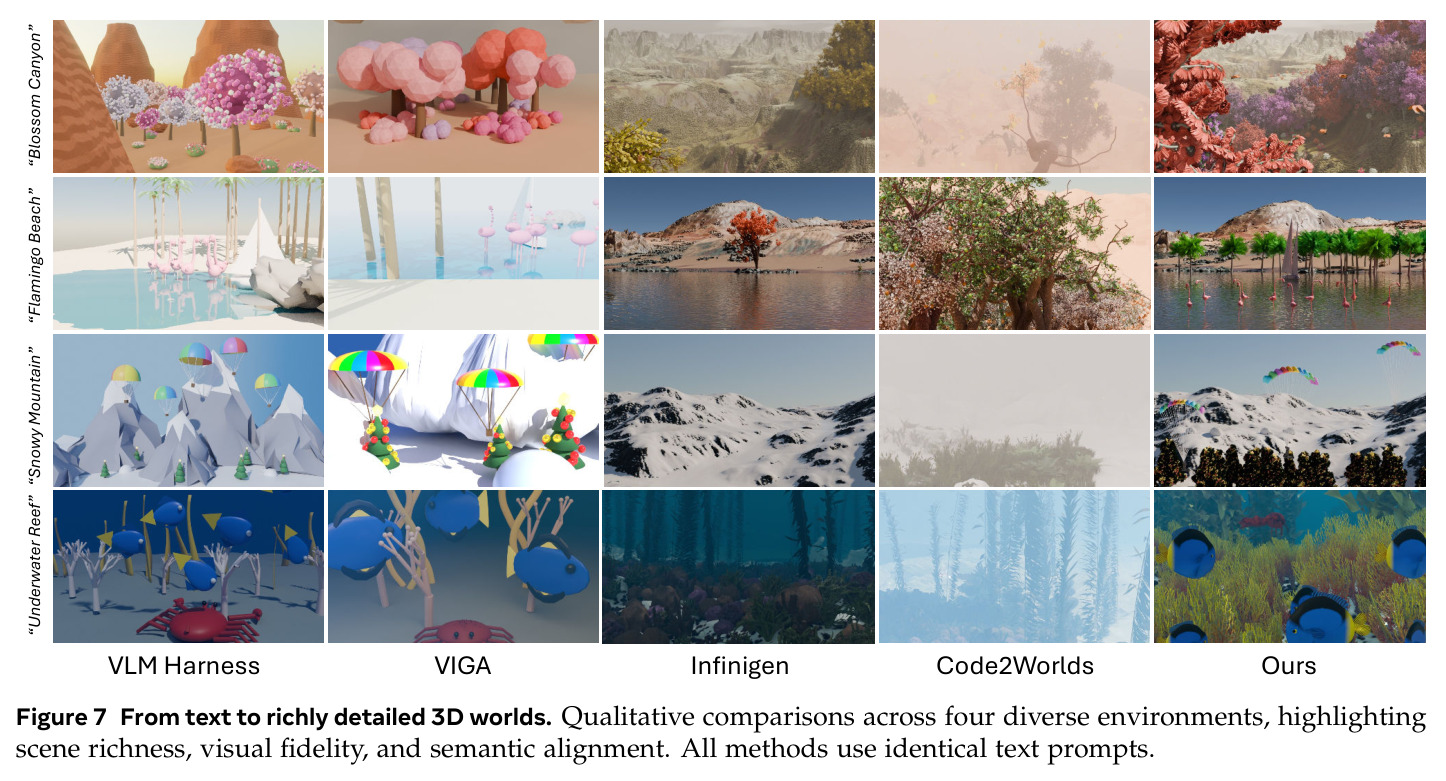
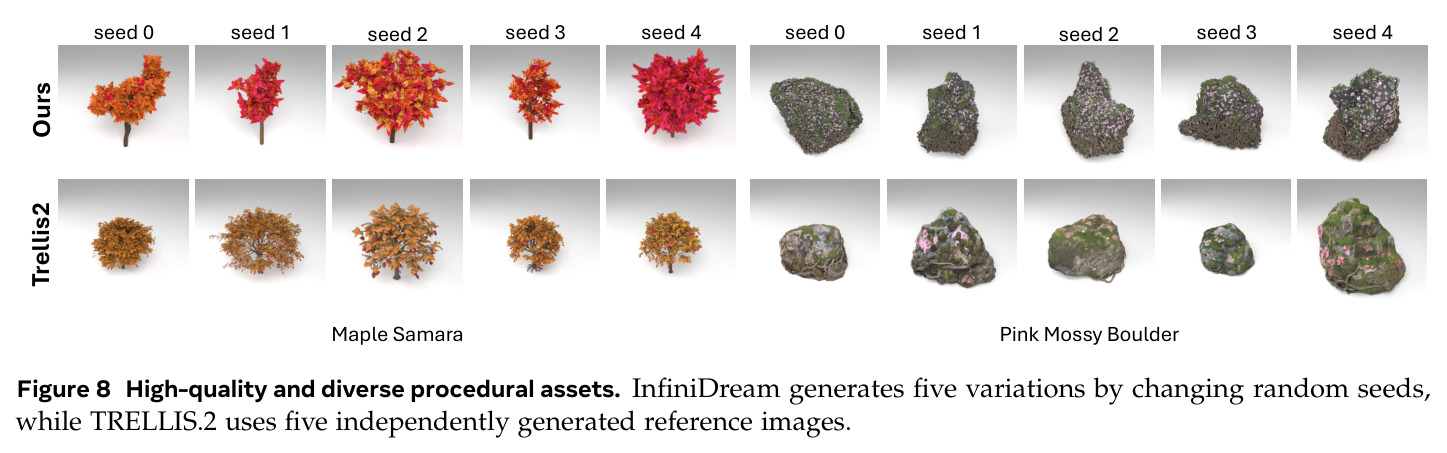
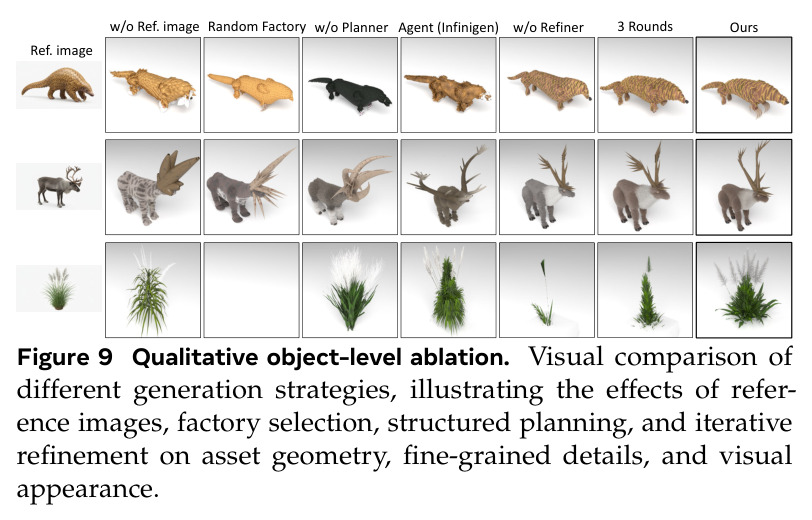
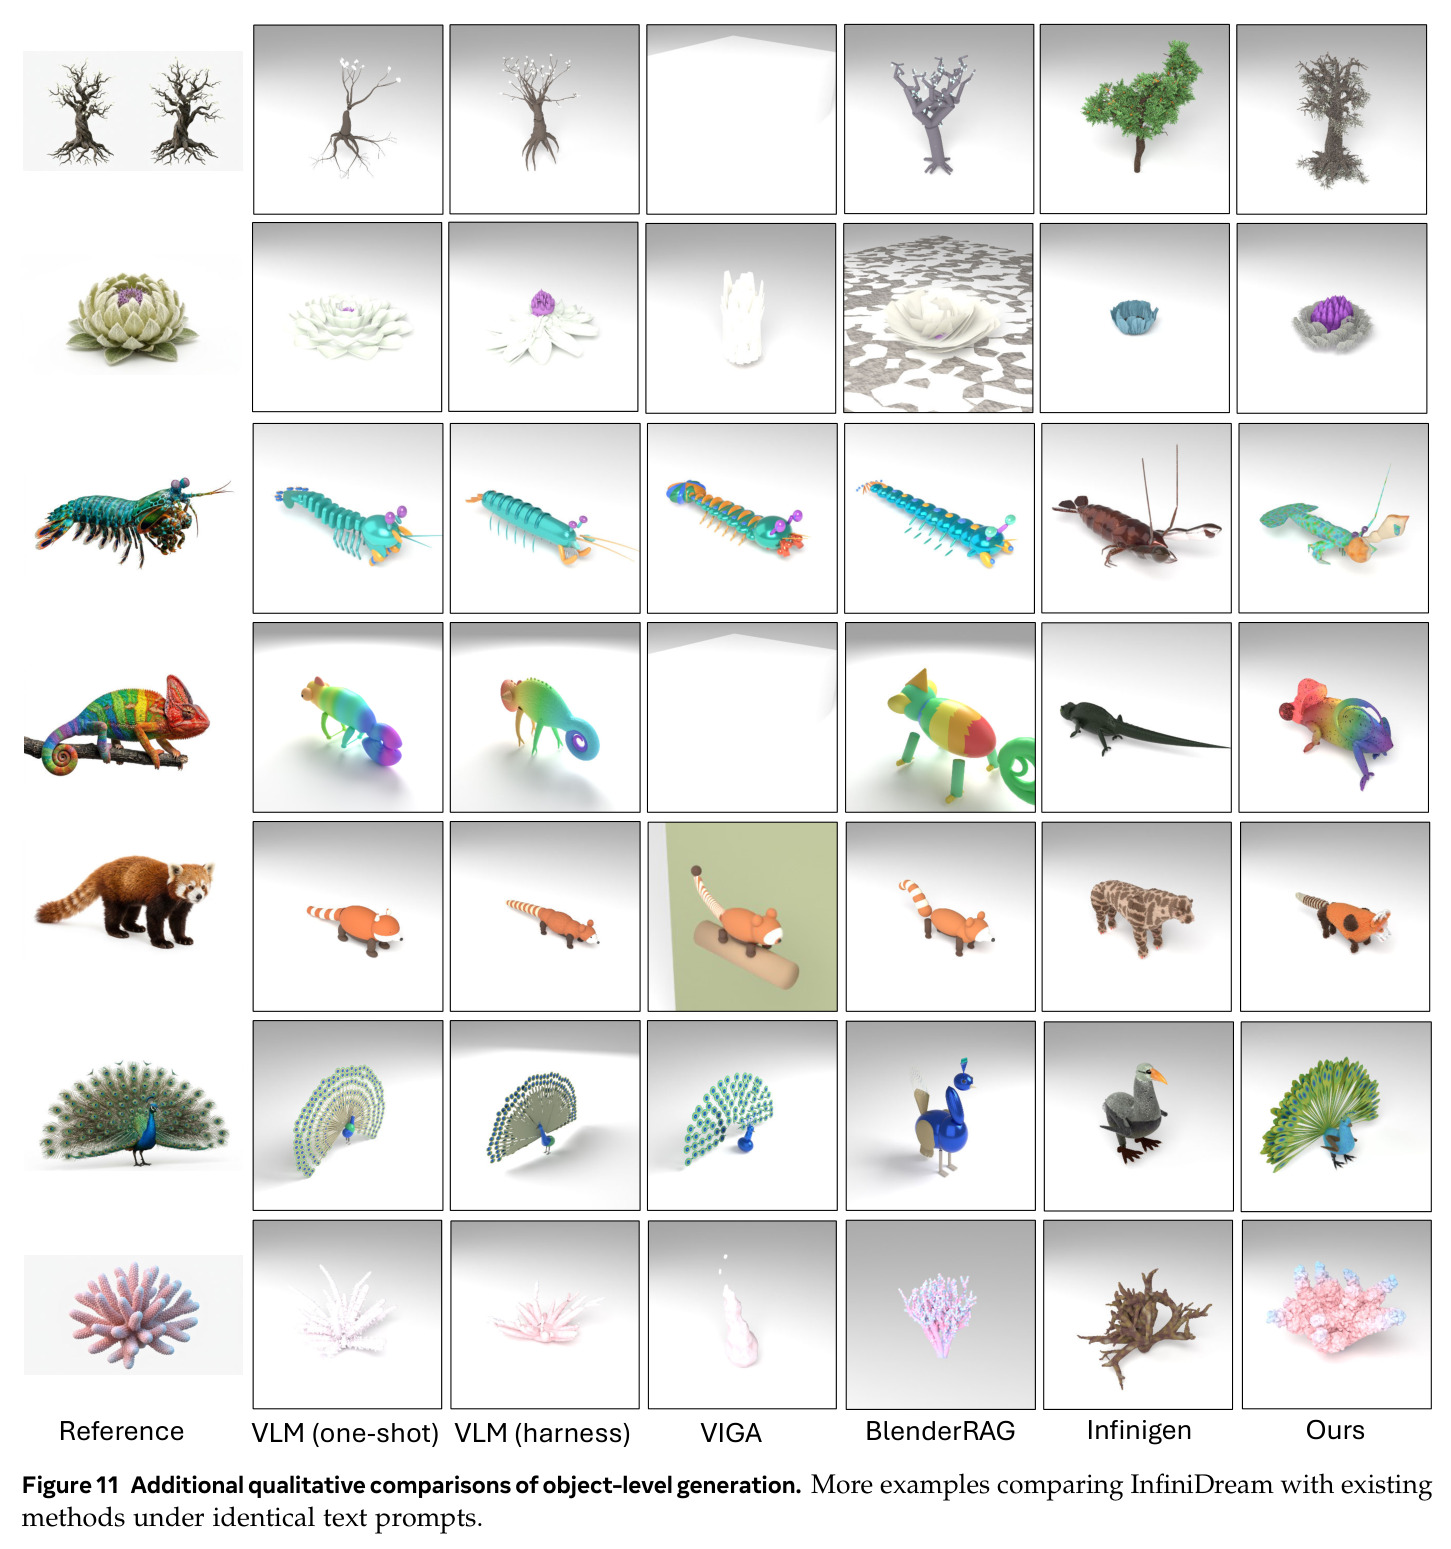
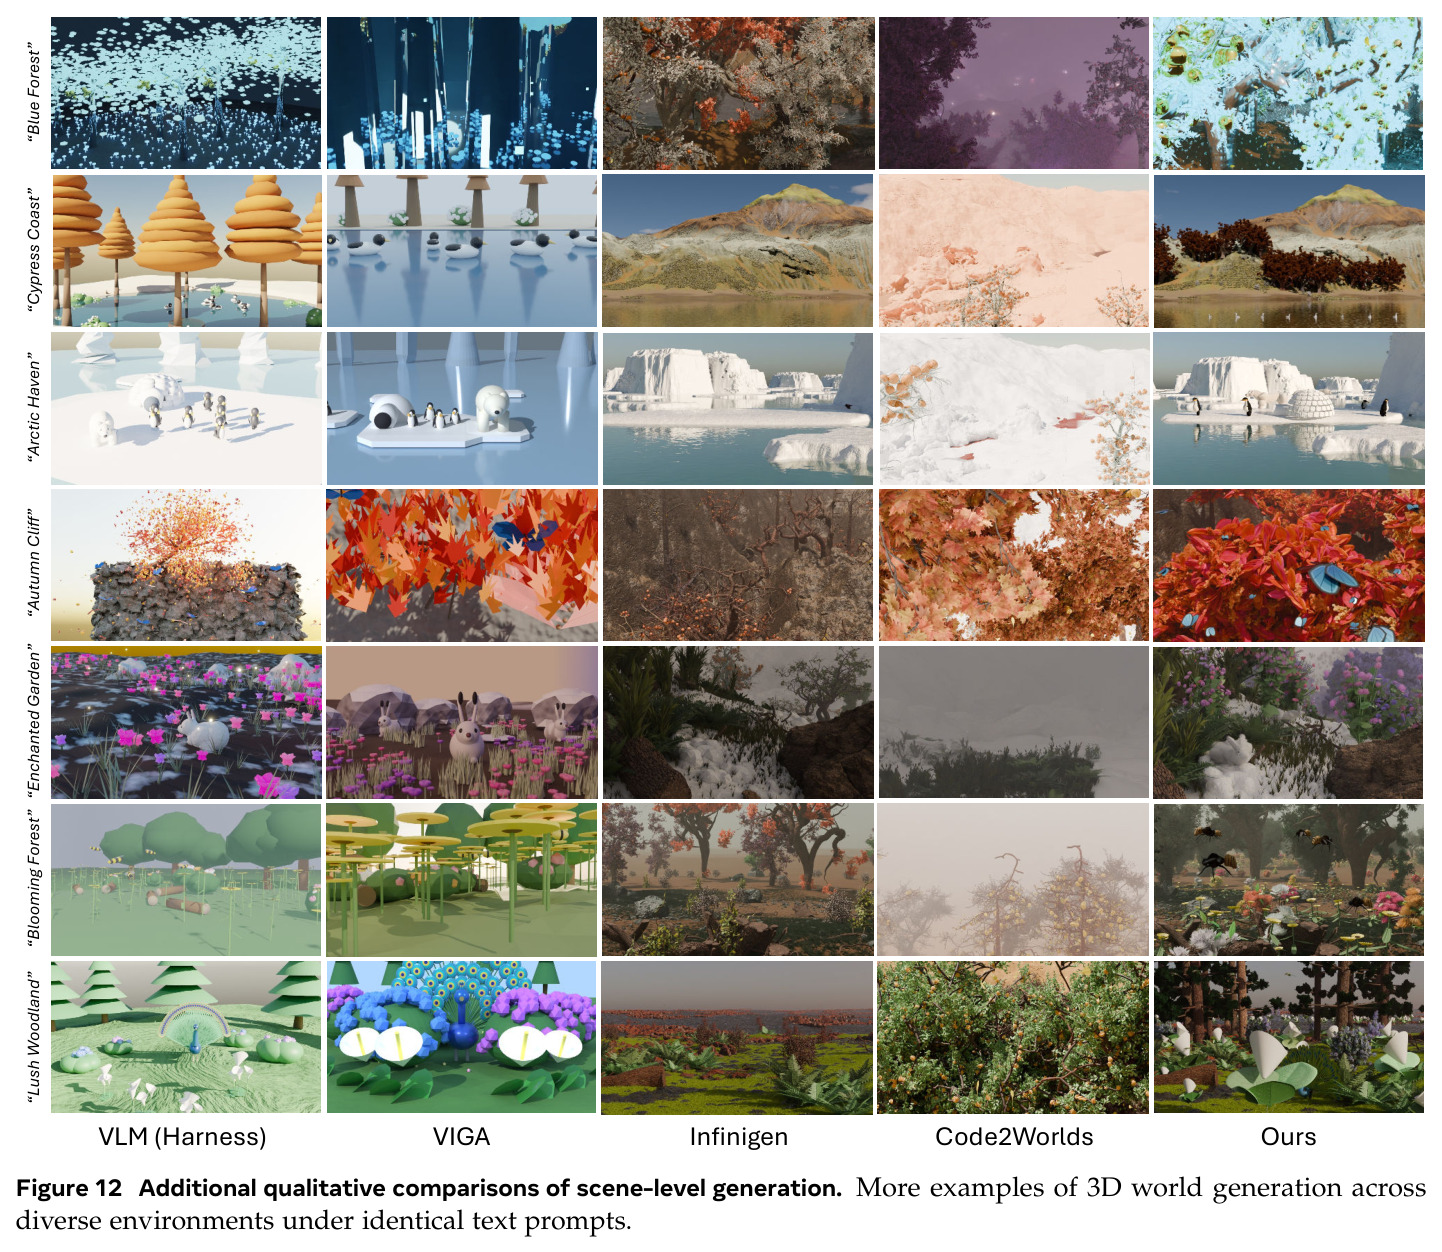
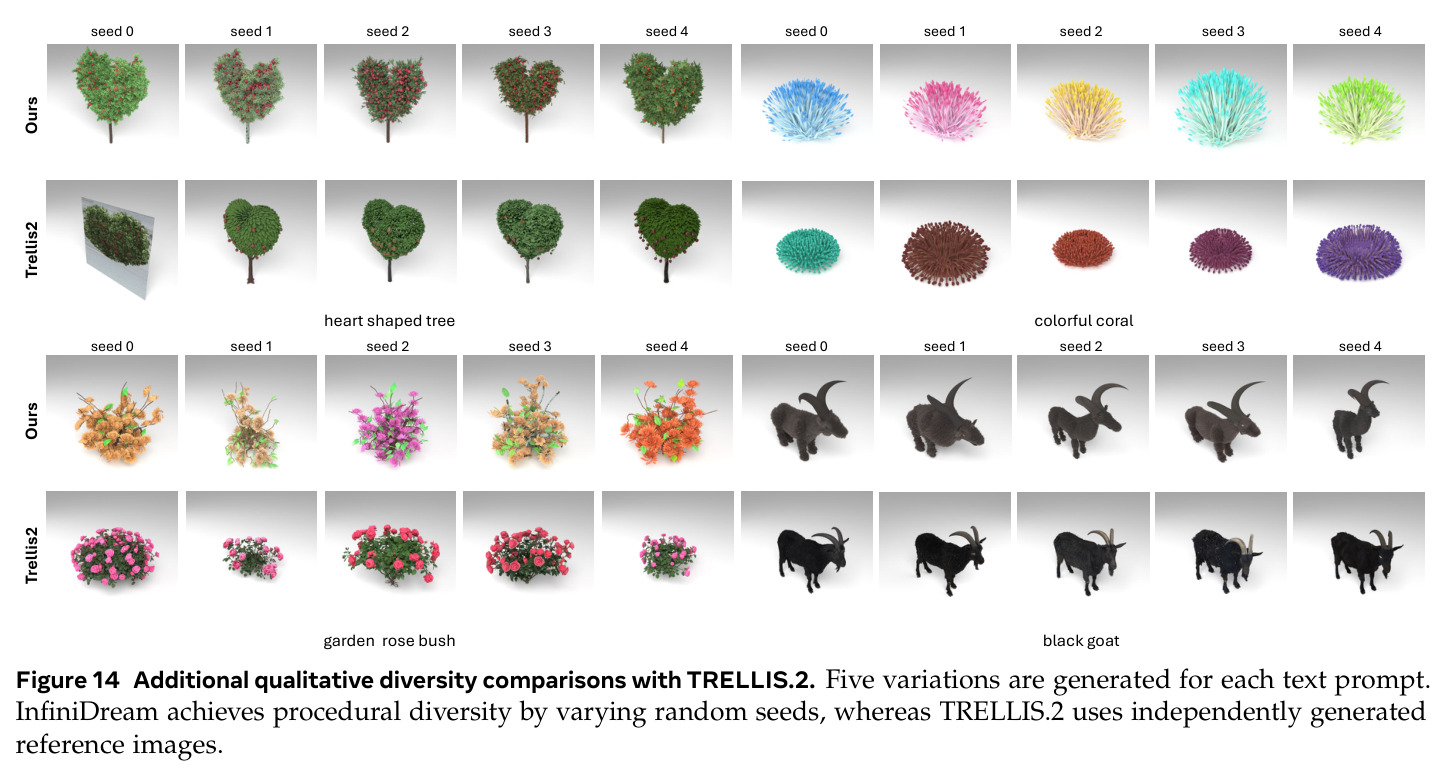
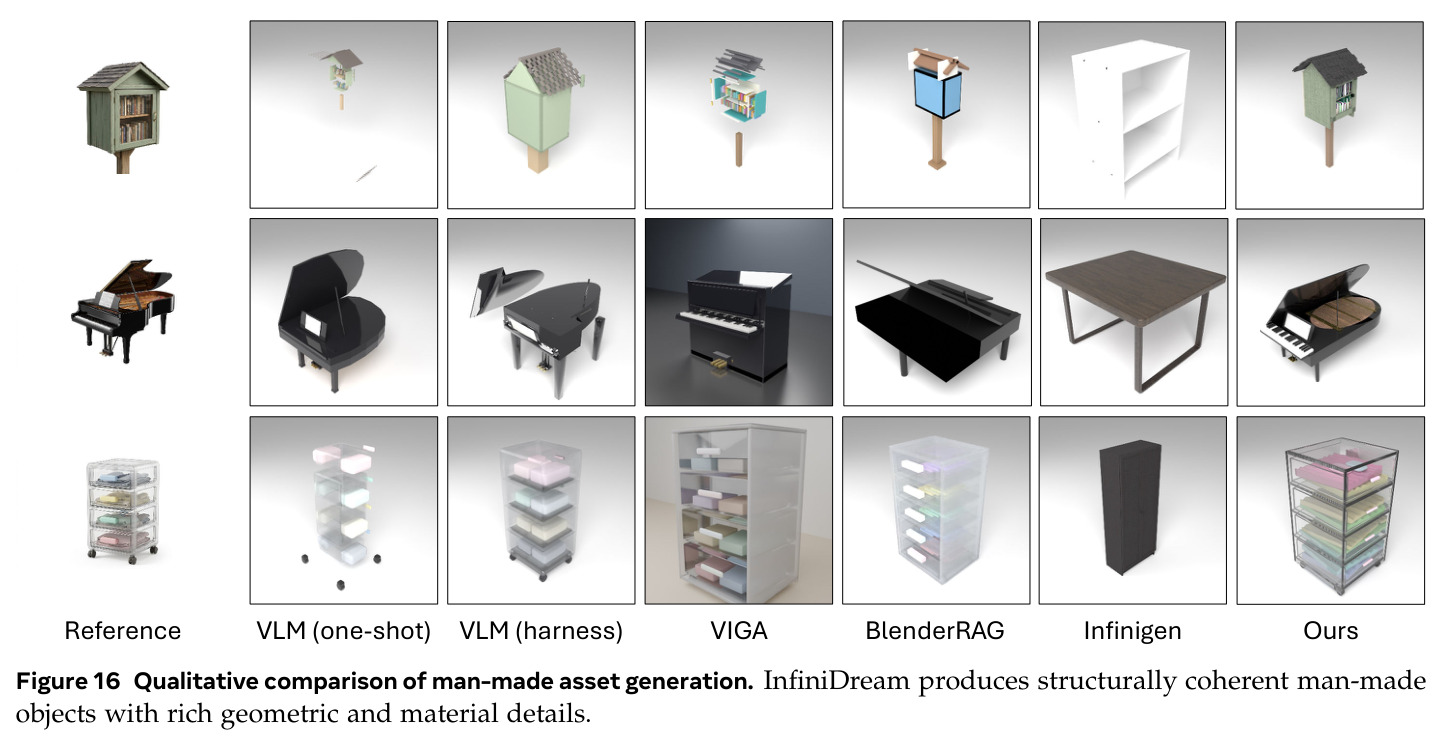
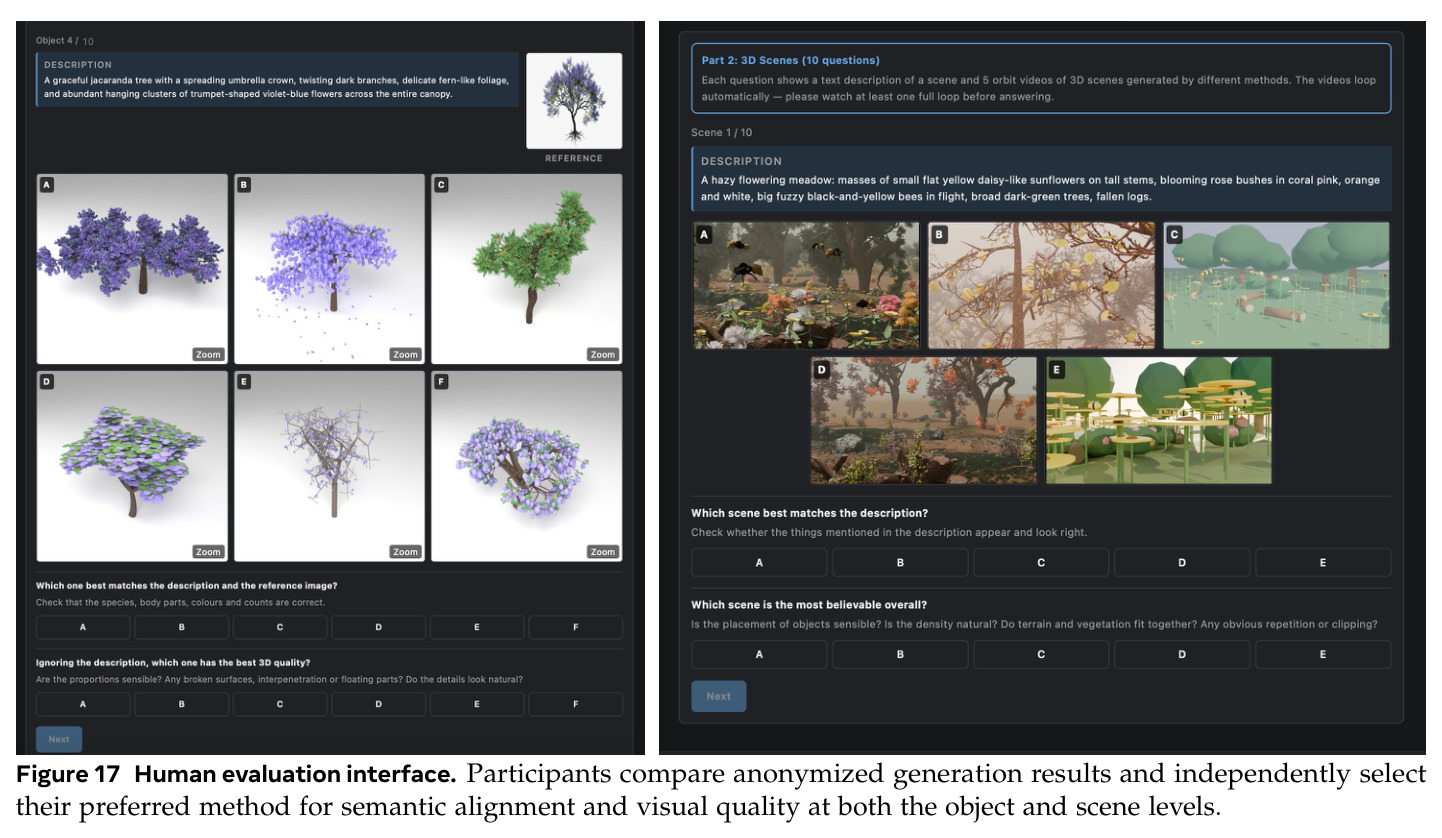
物体级(100 任务、6 类别):InfiniDream 全面第一——CLIP 30.07、SigLIP2 0.148、DINOv3 0.554、ImageReward -0.62,可执行率 98%;最强基线 VLM Harness 为 29.20/0.139/0.498/-0.82,Infinigen 原厂最弱(CLIP 22.84、DINOv3 0.253)。在 Code2Worlds 支持的 29 个任务子集上差距更大:CLIP 30.24 vs 22.56、DINOv3 0.583 vs 0.281。场景级(20 任务):CLIP 29.64、SigLIP2 0.143、DINOv3 0.361、IR -0.877,均超 VLM Harness(28.85/0.126/0.321/-0.894)与 Code2Worlds(22.76/0.072/0.114/-2.014)。人类偏好研究(30 人、强制二选一):物体级总体偏好率 77.5%(对齐 81.3%、质量 73.7%),场景级 83.2%(对齐 91.0%)。多样性(15 提示 × 5 变体):成对 DINOv2 距离 0.6704 高于 TRELLIS.2 的 0.6084,SigLIP2 0.1225 vs 0.1317 语义相当。物体消融(25 动植物任务):完整流程 CLIP 30.37/IR -0.580;随机工厂跌至 27.39/-1.520,去精修 IR -1.420,agent 自由访问全库 29.01——各组件均有贡献。放置消融(20 场景):完整方法不可读率仅 7.8%、接地误差 P95 0.15 m、接触散布 P95 0.24 m;agent 自由放置不可读率飙到 50.9%,去锚定 40.3%。
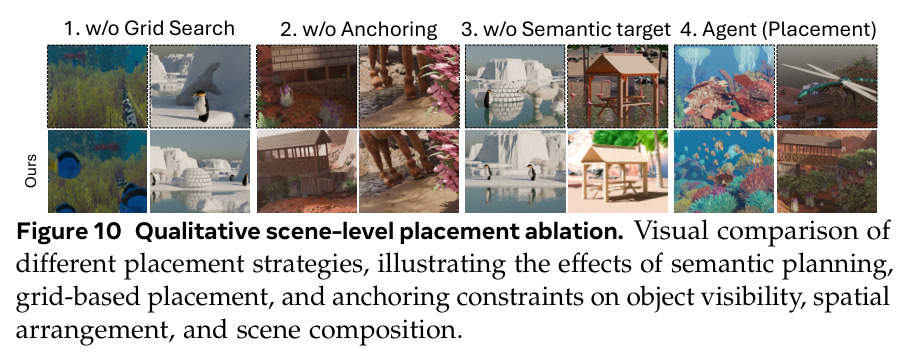
局限与改进
作者明确承认两点局限:动画管线依赖预定义运动类型(aquatic_swim、air_glide、ground_wander 等预设),尚不支持 VLM 生成自定义动画代码;框架目前面向自然环境,未扩展到空间关系和物体交互更复杂的室内场景。我的补充观察:其一,系统深度绑定 Claude Opus 4.8 与 Gemini 3 Pro Image 等顶级闭源模型,资产生成需多达 6 轮渲染-修订迭代,单资产的时间与 API 成本论文未报告;其二,场景生成从 70 个预生成环境库起步,“开放式世界”实际建立在离线准备好的粗场景之上,库外环境可能覆盖不到;其三,CLIP/SigLIP2 对细粒度几何缺陷(拓扑错误、穿模)不敏感,场景级 DINOv3 的参考图由 Gemini 3 Pro Image 生成,评估本身引入了生成模型的偏差;其四,确定性放置围绕固定主相机视角设计,自由漫游镜头下的物体分布是否合理未经验证;其五,物体级可执行率 98% 略低于 VLM Harness 的 99%,说明约束式编辑偶尔也会产生不可执行代码。
独立分析的弱点
独立分析几个弱点。第一,资产生成成本与延迟:每个资产要经工厂检索、粗构建与最多 6 轮 Reviser 渲染迭代,池化只缓解场景内重复构建,遇到新物体类型时冷启动开销大——改进方向是把历史编辑计划蒸馏成“经验库”,相似请求直接命中。第二,可复现性依赖闭源 VLM:Claude Opus 4.8 版本更新会改变行为,瓶颈在 API 配额而非算力;可微调开源 VLM 打造专用代码编辑器来降本。第三,评估盲区:CLIP/SigLIP2 与人类偏好在精细几何上相关性有限,论文自建的接地误差(P95 0.15 m)与接触散布指标才是更硬的证据,但只覆盖表面支撑物体且排除了无支撑面物体;建议引入物理仿真或可微渲染损失做几何级验证。第四,Promote 策略是潜在失控点:受保护模块开放编辑后,契约实际靠 VLM 自觉遵守,缺乏静态验证器保证 seed 逻辑未被破坏,可加入 AST 级随机性保持检查。第五,70 个预生成场景库带来选择偏差,Scene Picker 一次性固定基底,初始选择不当会封顶后续编辑的上限,缺乏回退或换底机制。
未来方向
作者提出的方向:用 VLM 生成动画代码替代预定义运动类型,支持更复杂、可定制的动作;扩展到室内环境,处理更复杂的空间关系与物体交互(开关门、坐卧等支撑关系)。基于成果可延伸的方向:把 SCE 思想迁移到其他大型代码资产(CAD 内核、Shader 节点图、物理材质库),形成通用的“符号约束代码编辑”范式;与解耦世界状态和生成式视频渲染的工作正交结合,用 InfiniDream 提供显式世界规格、视频模型负责渲染;把 Reviser 的视觉对比升级为可微渲染或人类反馈驱动的优化信号;探索多智能体协作放置以支持动态叙事(物体随剧情增删改);用在线程序化地形生成替换 70 个粗场景库,消除初始场景选择偏差,实现真正无界的开放式世界。
复现评估
复现条件较好但门槛不低。代码已在 GitHub 开源,并有项目页展示结果;核心依赖公开的 Infinigen 代码库和 Blender 4.x。基准(100 物体任务 + 20 场景任务)、评估协议和消融设置在附录中写得相当细致:包括 SigLIP2 用 google/siglip2-base-patch16-224、从 logits 恢复余弦相似度的参数 $\cos = (\mathrm{logit} - b)/t$($t = 112.67$,$b = -16.77$)、四视角平均方式、参考图划分(ref_00 供生成、ref_01–04 仅用于评估)等。主要障碍:需要 Claude Opus 4.8 API(所有 VLM 基线也统一用它保证公平),参考图依赖 Gemini 3 Pro Image,均有成本;场景基准依赖自建的 70 个预生成环境库(14 生物群系 × 5 种子),若未随代码发布需自行重建;物体级四视角渲染加最多 6 轮迭代的生成-评估开销不小。总体估计:熟悉 Blender 与 Infinigen 的研究者投入数天和数百美元 API 费用可复现主表结果。
论文图表
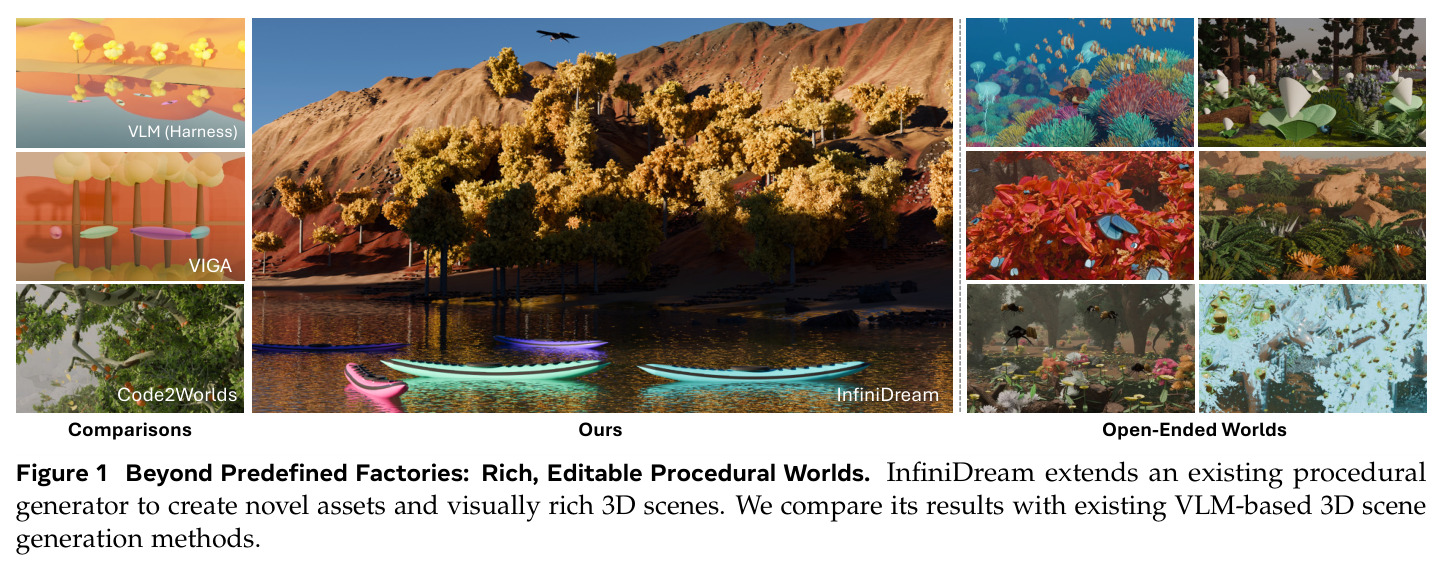
首图对比:InfiniDream 在既有程序化生成器之上扩展出新颖资产和视觉丰富的 3D 场景,与既有 VLM 场景生成方法的结果对照,右侧展示开放世界示例。
一图定调:论文的核心卖点是“超越预定义工厂”的照片级可编辑世界,读者应先建立整体印象。
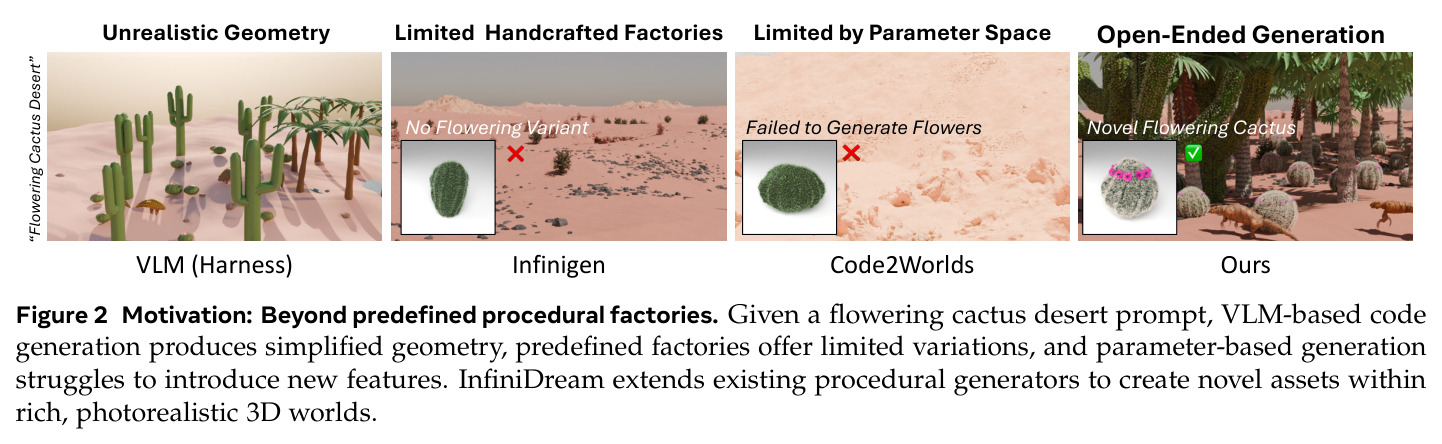
以“开花的仙人掌沙漠”为例并列四列结果:VLM 直接生成几何简化、Infinigen 无开花变体而失败、Code2Worlds 受限于参数空间无法生成、InfiniDream 成功产出带花的新颖仙人掌。
精准呈现三条既有路线各自的失败模式,是理解论文动机的最直观证据。
以蝴蝶和野兔为例从左到右对比:VLM 从零写代码、Infinigen 预定义工厂、给 agent 完整 Infinigen 访问、本文 SCE 约束编辑,展示各自产出质量差异。
直观说明为什么“整个代码库直接丢给 VLM”不行、符号约束编辑更好,是 SCE 的动机图。
相同文本提示下七列对比:参考图、VLM one-shot、VLM harness、VIGA、BlenderRAG、Infinigen 与本文,展示几何细节、材质与照片级外观差距。
物体级定性结果主图,支撑 Table 1 的数字结论。
30 名参与者的强制选择偏好率:物体级对齐 81.3%、质量 73.7%、总体 77.5%;场景级 91.0%/75.3%/83.2%。
感知指标的独立佐证,说明自动指标的提升能转化为人类偏好。