生成知道什么:解锁统一多模态模型中的细粒度理解 What Generation Knows: Unlocking Fine-Grained Understanding in Unified Multimodal Models
GAFU 将生成侧表征压成可检索的 G token 注入理解通路,使细粒度理解全面超越同数据 SFT
前置知识
统一多模态模型(UMM)
在单一模型内同时建模多模态理解与视觉生成的模型,建模范式包括自回归(Emu3)、扩散(Show-o2)或混合式(BAGEL、Janus-Pro)。早期 UMM 多用统一稠密骨干共享视觉表征,后来逐渐在统一框架内为理解和生成分配专用视觉通路,因为理解更依赖高层语义、生成需要丰富的视觉细节,单一表征难以同时满足两种需求。
本文的全部故事发生在 UMM 内部:正是 UMM 天然同时拥有理解侧与生成侧两条视觉表征通路,才存在'用生成侧信息反哺理解'的可能性,理解 UMM 的双通路结构是读懂本文的前提。
双通路视觉表征(语言对齐 vs 生成对齐编码器)
现代 UMM 通常用语言对齐编码器(CLIP/SigLIP)产生理解侧表征 $U$,用 VAE/VQ-VAE 等生成编码器产生生成侧表征 $R_G$。前者为适配语言而压缩掉大量视觉细节,后者保留重建图像所需的空间结构与局部纹理。例如 BAGEL 的理解侧是 SigLIP 的 16×16 tokens,生成侧是 KL-VAE 的 64×64 潜变量。
论文的核心假设是生成侧表征对细粒度变化更敏感且与理解侧互补。理解两种编码器的表征来源与信息取舍差异,是读懂第 3.1 节分析实验与 GAFU 方法设计的必要背景。
DPO(直接偏好优化)
Rafailov 等人提出的偏好学习方法,无需显式奖励模型,直接在损失中要求正样本的奖励(隐式地由策略概率导出)高于负样本。本文将其改造为 'CE 空间 pairwise DPO':比较同一问题下使用匹配 G token 与错配 G token 的答案交叉熵 $\ell^+, \ell^-$,用 $\mathrm{softplus}(-\beta(\ell^- - \ell^+))$($\beta=0.1$)拉开差距,迫使模型偏好样本相关的生成证据。
GAFU 用它保证模型真正'使用'与当前样本匹配的 G token,而不是泛泛地容忍 G token 的存在。这是 Stage 2 训练目标的核心组件,也是消融实验中增益的主要来源之一。
前向 KL 散度正则
KL 散度 $D_{\mathrm{KL}}(p \| q)$ 衡量两个分布的差异,前向 KL 以参考分布为基准加权。本文在 shuffle-G 分支(拿到错配生成记忆)上对每个答案 token 计算当前模型与冻结原始模型(只看理解侧表征 $U$)输出分布之间的 KL,约束错配 G token 不把输出分布带偏。
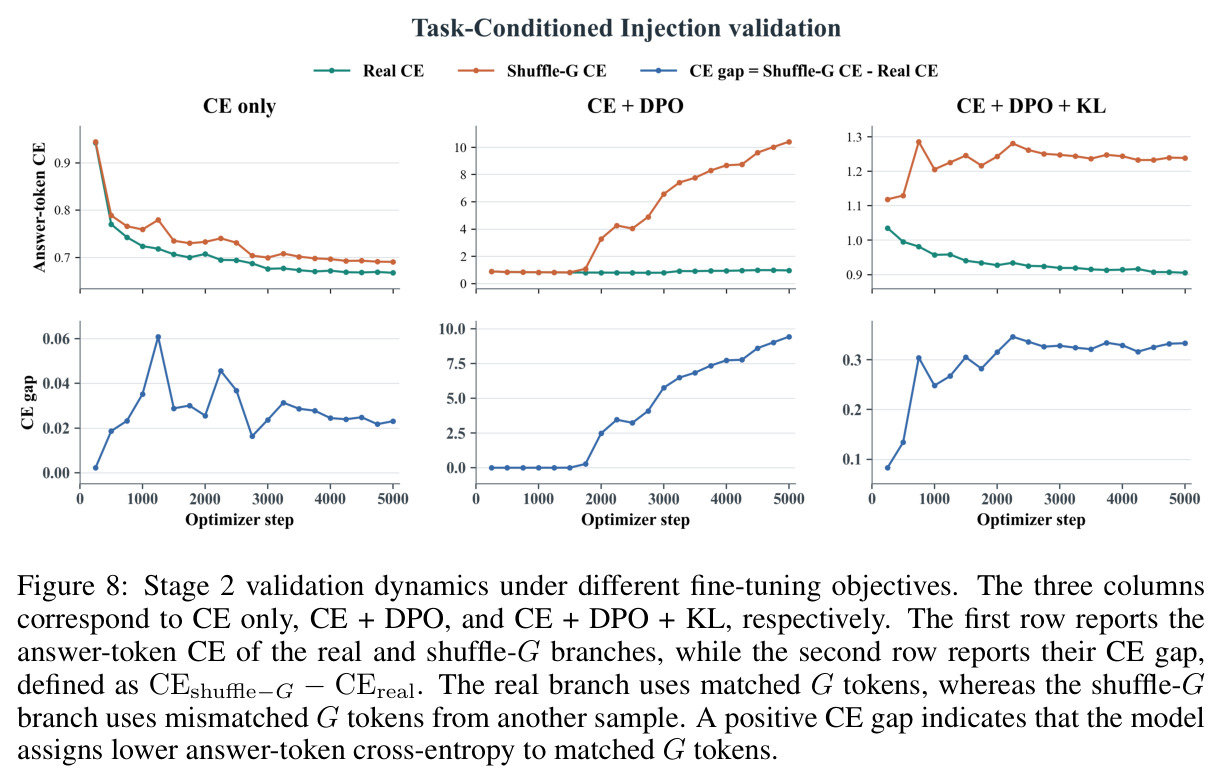
消融显示只用 CE+DPO 时 OmniSpatial 从 33.33 暴跌至 22.24——DPO 会靠'摧残' shuffle 分支来扩大偏好差距,KL 正则是把偏好学习转化为可靠收益的关键保险,理解它才能理解本文训练设计的精髓。
Q-Former 式可学习查询压缩
用一组固定数量的可学习查询向量与输入特征做联合自注意力,把任意长度/分辨率的特征压缩成固定数目的 token,BLIP-2 的 Q-Former 是经典实现。本文 GToken Encoder 用 256 个可学习查询配合 2D RoPE 位置编码,把生成侧表征压成 256 个 G token,并用对称的 Decoder 加重建查询还原原始生成表征。
G token 的构建直接继承这一思路。理解'压缩如何不丢失细粒度与空间信息'(重建 + 空间绑定 + 关系对齐三重损失)是理解 Stage 1 的核心,也是判断 G token 是否塌缩的关键。
LoRA 低秩适配
参数高效微调方法:冻结原模型权重 $W$,只训练注入的低秩分解 $\Delta W = BA$($B \in \mathbb{R}^{d \times r}$, $A \in \mathbb{R}^{r \times d}$,秩 $r$ 很小)。本文在理解通路注入 rank=16、alpha=16 的 LoRA,与交叉注意力注入模块一起在 Stage 2 训练,原生视觉编码器全程冻结。
说明 GAFU 是轻量后训练框架:不动原生通路的大权重,成本可控,这也是它能跨 BAGEL(14B 混合架构)、Janus-Pro(7B 自回归)、Lance(3B)等不同 UMM 即插即用、快速验证的关键。
研究动机
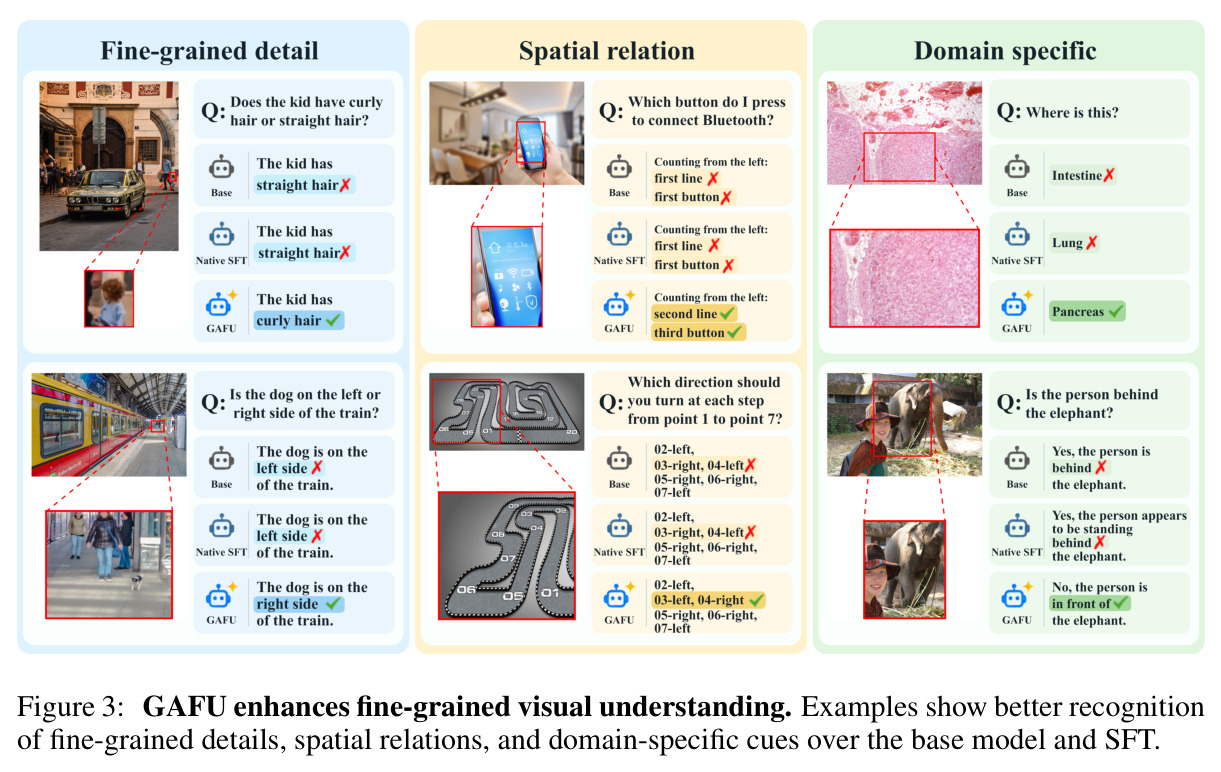
视觉语言模型(VLM)近年来在高层语义理解上进步显著,但在细粒度视觉理解——物体、属性、计数、空间关系的微小差异——上仍明显不可靠,BLINK、MMVP 等基准反复证实'看得见但看不细'的问题。主流改进思路是更高保真的视觉编码器与更保信息的视觉-语言接口(Ferret、Monkey、LLaVA-UHD、Cambrian 等),但它们都依赖语言对齐的视觉编码器先把图像压缩成有限表征再做语言建模,上游丢失的细粒度证据下游无法找回。统一多模态模型(UMM)的出现带来新机会:其生成通路(VAE/VQ)为重建图像保留了更丰富的结构、空间关系与局部细节。但已有'生成辅助理解'两条路线均有缺陷:生成监督路线(如 Reconstructive visual instruction tuning、Diffusion feedback、GenHancer)用启发式生成目标间接塑造表征,不直接检验原生生成侧表征,且理解与生成的表征需求可能冲突;显式生成路线在推理时生成图像中间态再重编码进理解空间,既引入推理开销、又重现理解侧的视觉编码瓶颈,还可能把生成错误传播给下游理解。
本文的目标是本文目标分两层。第一层是实证问题:原生生成侧表征是否真的含有理解通路之外的细粒度视觉线索?这种优势在什么条件下成立——对哪些类型的变化(物体/属性/计数/关系)更强、是否依赖空间组织、是否随输入分辨率变化?作者在 6 个 UMM(BAGEL、Janus-Pro、Lance、Show-o2-7B、BLIP3-o-4B、DreamLLM-7B)、2,084 对 VisMin 最小编辑图像、4 个变化域上做系统分析。第二层是工程问题:若优势存在,如何让理解通路在推理时按任务需要高效取用?答案是 GAFU 后训练框架,要求在 3B 到 14B、自回归/混合/扩散等不同架构上都稳定超越同数据 SFT,并在通用(VStar-Bench、OmniSpatial、MMVP)与领域特定(VSR-Bench、PathVQA)五个基准上取得一致增益。
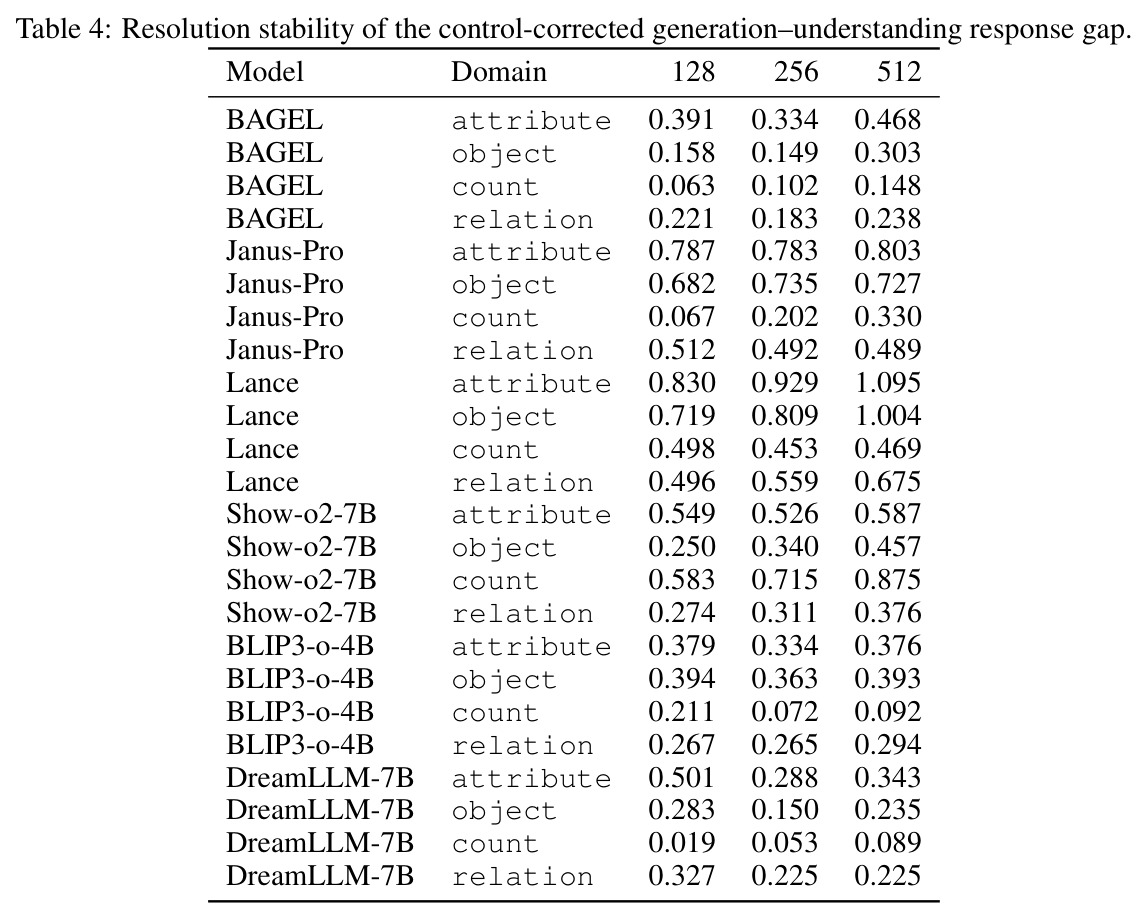
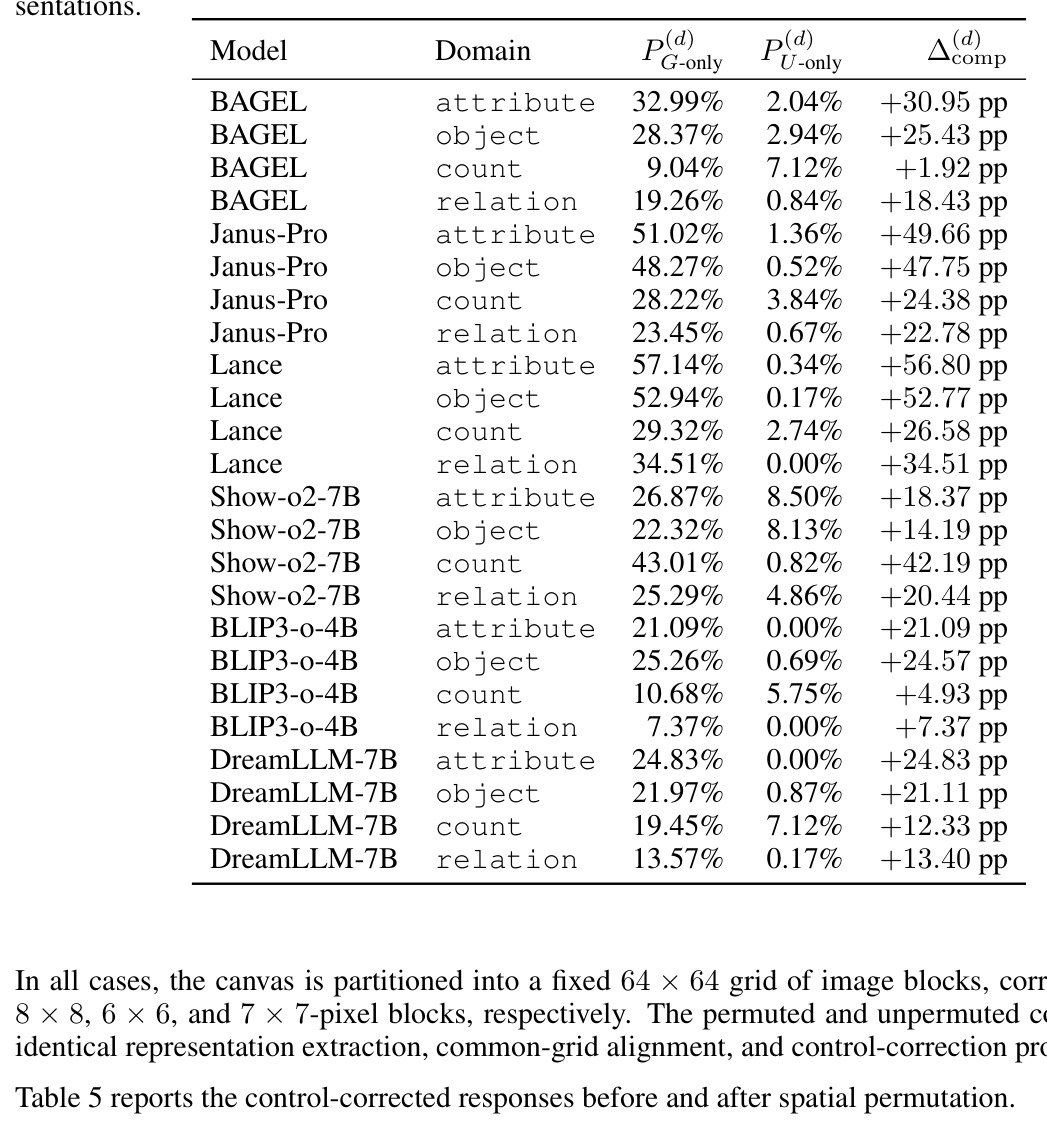
与已有工作不同的是,本文的独特切入是'直接使用原生生成侧表征'这条此前无人系统走过的中间路线:既不用生成任务做间接监督,也不显式生成图像。作者第一次逐点量化了生成侧表征的三个性质:其一,对细微语义变化的响应比理解侧更强——构造与语义编辑同等线性-RGB RMS 变化幅度的对照图以排除低层外观干扰后,24 个模型-域组合中生成侧敏感性全部占优;其二,其强响应中相当部分是理解侧完全捕捉不到的——仅生成侧强响应的样本比例平均 28.18%,仅理解侧仅 2.48%,净差 25.70 个百分点;其三,该优势依赖空间组织——对 64×64 图像块做固定置换后,优势在全部 24 个组合中缩水。这三个发现直接决定了方法设计:G token 必须做空间绑定、必须与理解侧做关系对齐而非特征值匹配、必须按任务检索而非简单拼接。'分析结论与方法设计一一对应'的因果衔接是本文最鲜明的特色。
核心方法
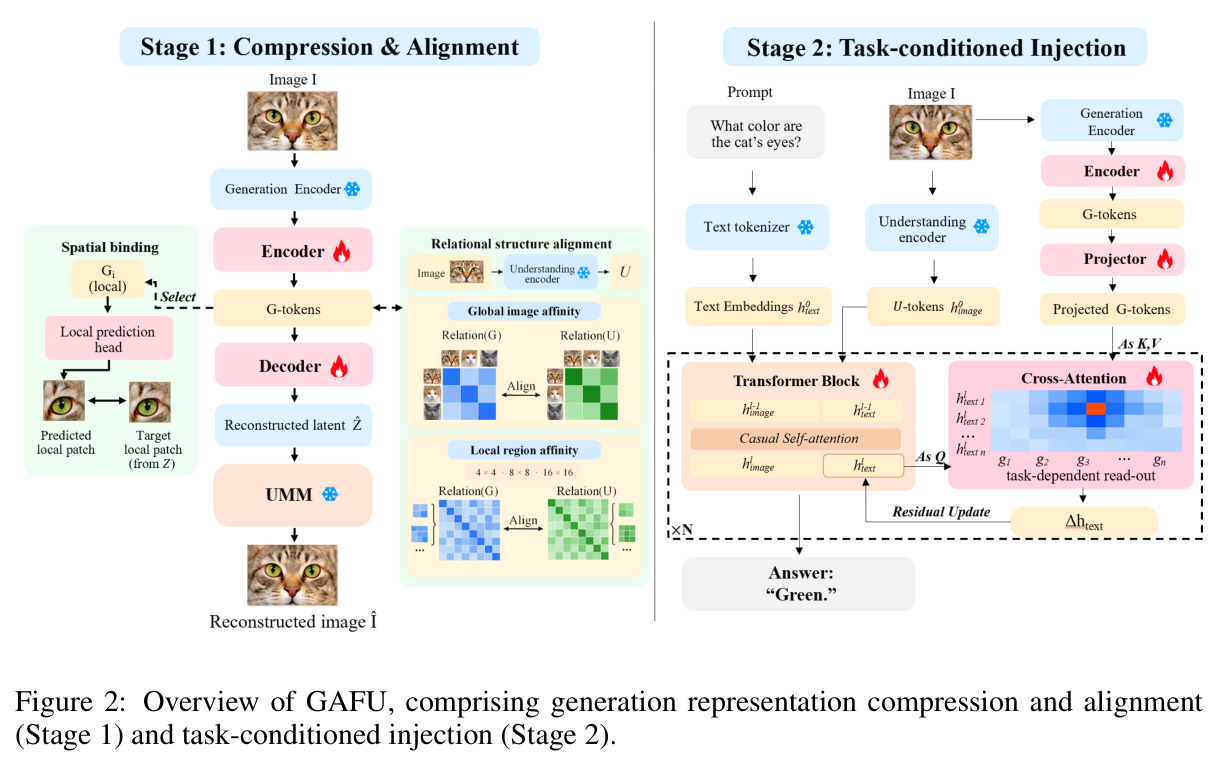
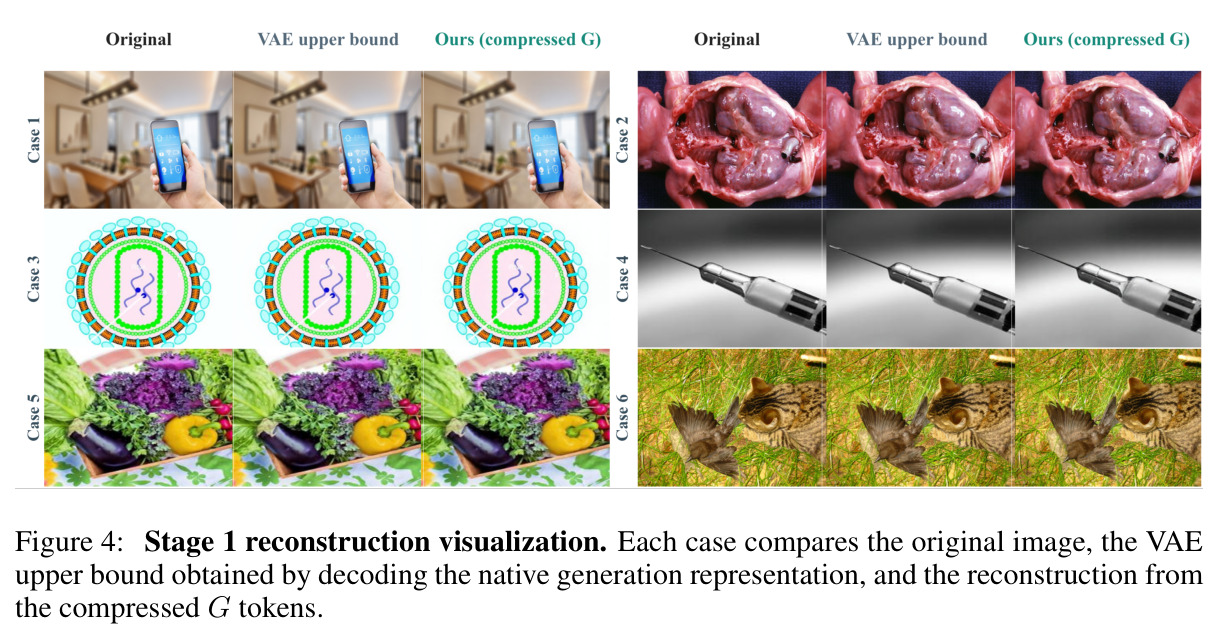
直觉上:理解侧编码器(SigLIP/CLIP)为语言对齐丢掉了细节,而生成侧(VAE 潜变量)天然保留'画出这张图所需的全部信息',所以应把这些信息组织成理解通路能随时查阅的'记忆库',让模型答题时按需取用。技术上分两阶段。Stage 1 压缩与对齐:冻结 UMM 原生双通路,训练对称的 6 层 Transformer Encoder-Decoder(hidden 1024、8 头、FFN 4096、2D RoPE),Encoder 将投影后的生成侧表征与 256 个可学习查询做联合自注意力,输出 256 个 G token(维度对齐理解通路:BAGEL/Janus-Pro/Lance 分别为 3584/4096/2048);总损失 $\mathcal{L}_{ext} = \lambda_{rec}\mathcal{L}_{rec} + \lambda_{spa}\mathcal{L}_{spa} + \lambda_{rel}\mathcal{L}_{rel}$,其中重建损失经冻结生成通路解码回图像后用 $\|\hat{I}-I\|_1 + 0.5\|\hat{I}-I\|_2 + 0.5\mathrm{LPIPS}$ 监督,空间绑定让每个 G token 不经 Decoder 直接线性读出其对应空间位置的生成目标,关系对齐在 4/8/16 尺度与全局将 G 与理解侧表征的成对余弦相似结构对齐。用 1M 张 Cambrian 图像训练 8,000 步。Stage 2 任务条件注入与微调:在理解通路每层 Transformer 后插入交叉注意力模块,用当前文本隐状态 $h_{text}$ 作 query、投影后的 G token 作 key/value,零初始化输出投影后残差写回;训练目标 $\mathcal{L} = \lambda_{CE}\mathcal{L}_{CE} + \lambda_{DPO}\mathcal{L}_{DPO} + \lambda_{KL}(t)\mathcal{L}_{KL}$,配合 shuffle-G 错配分支、前向 KL 正则、理解表征掩码调度等稳定策略,训练 5,000 步。
核心创新是把'生成侧信息'从监督信号或中间产物提升为一等公民——原生生成侧表征本身。与生成监督方法的本质区别:不用重建/生成损失去间接塑造理解侧表征(避免两种表征需求的冲突),而是新建一条紧凑旁路直接携带生成侧证据,原生通路零改动。与显式生成方法的本质区别:不做任何图像生成推理(无扩散/自回归生成的开销与误差传播),而是把生成侧潜变量一次性压成 256 个 G token。与简单拼接方法的区别:任务条件化交叉检索——用随推理演化的文本隐状态做 query,问题问什么就取什么证据;消融证明这比把 G 拼进输入(落后 1.96–6.28 分)、入口融合(落后 4.67–12.14 分)乃至用视觉隐状态查询(落后 1.05–4.67 分)都好,说明'如何读 G'比'是否给 G'更重要。另一个关键设计是 shuffle-G 偏好学习:用同批另一张图的 G token 作错配负样本,配合前向 KL 约束错配分支不得偏离冻结参考分布、梯度加权(正负 4:1、负梯度范数封顶 0.25 倍)防止刷分,逼迫模型学会'用对样本相关证据'而非'无视 G token'。
方法步骤详情
第一步,表征压缩(Stage 1 训练):输入为 UMM 生成通路原始表征(如 BAGEL 的 KL-VAE 后验均值 64×64 经 2×2 patch 化为 32×32),输出 256 个 G token。Encoder 将生成表征投影到 1024 维后与 256 个可学习查询拼接,经 6 层带 2D RoPE 的 Transformer 自注意力聚合,查询输出投影到理解通路隐维度。第二步,三重对齐损失:Decoder 用 G 加重建查询还原生成潜变量,再过冻结生成通路解码成图像 $\hat{I}$,$\mathcal{L}_{rec} = \|\hat{I}-I\|_1 + 0.5\|\hat{I}-I\|_2 + 0.5\mathrm{LPIPS}(\hat{I},I)$;空间绑定 $\mathcal{L}_{spa} = \frac{1}{N}\sum_i \|h_{spa}(G_i) - z^{bind}_i\|_2^2$,每个 G token 直接预测其 16×16 网格位置的生成目标(BAGEL/Lance 用 32×32 原生网格对应 2×2 区域,Janus-Pro 由 24×24 池化而来,用目标能量归一化 MSE);关系对齐将 G 和 U 自适应平均池化到 $s\in\{4,8,16\}$ 尺度得 $s^2$ 个节点,对节点集算成对余弦相似矩阵、去对角、中心化得关系向量 $r(Z)$,$\mathcal{L}_{rel} = \frac{1}{4}(\mathcal{L}_{global} + \mathcal{L}^{(4)}_{local} + \mathcal{L}^{(8)}_{local} + \mathcal{L}^{(16)}_{local})$,全局项在批内图像级节点间计算。第三步,任务条件注入(Stage 2):理解通路每层后,query 为当前文本隐状态,key/value 为投影后的 G token(沿用原生视觉 token 的位置编码),输出投影零初始化并残差写回;LoRA rank=alpha=16。第四步,三分支训练:正分支用匹配 $G_i$ 算答案 CE($\lambda_{CE}=5$);shuffle-G 分支换成捐赠者 $G_{\pi(i)}$($\pi(i)=(i+N/2) \bmod N$ 确定性配对);参考分支用冻结原模型仅看 $U$、不反传。CE 空间 DPO 为 $\mathcal{L}_{DPO} = \frac{1}{B}\sum_i \mathrm{softplus}(-\beta(\ell^-_i - \ell^+_i))$,$\beta=0.1$,$\lambda_{DPO}=1$;正负 DPO 梯度按 4:1 加权、负梯度全局范数封顶为正分支的 0.25 倍;KL 权重从 1 线性降到 0.25 再降到 0。第五步,稳定策略与配置:前 3,750 步分别以 0.8/0.5/0.2 概率掩码理解表征 $U$,逼迫模型依赖 G;Stage 2 全局 batch 32、5,000 步,注入模块峰值 lr $2\times10^{-5}$、LoRA 峰值 $10^{-4}$,训练后半段解冻 GToken Encoder 联合优化。
技术新颖性
新颖性体现在四个层面。(1)实证层面:首次在 6 个 UMM 上用'控制修正'敏感性度量系统证明生成侧表征的细粒度优势及其空间依赖——为每个语义编辑构造同区域、同等线性-RGB RMS 变化幅度的自然退化对照图,从而把'语义响应'从'低层外观响应'中剥离出来,这套分析范式(敏感性/互补性/空间依赖三维诊断)本身即可复用到其他模型。(2)表征层面:G token 是'生成证据的压缩记忆库'而非新的输入模态——256 个 token 承载可重建整图的信息(Figure 4 的重建可视化佐证),并以空间绑定对抗压缩后的空间塌缩、以关系对齐保证与理解侧的兼容而不做特征值匹配,保留了通路特异性信息。(3)目标函数层面:CE 空间 pairwise DPO 是对标准 DPO 的巧妙改造——正负样本仅差在 G token 是否匹配,直接优化'是否使用了样本相关证据'这一行为,比通用语义偏好更贴合本文目标;梯度加权/封顶、KL 三段调度、U 掩码四段调度等配套工程细节保证了这种偏好学习的稳定性。(4)通用性层面:框架不绑定特定 UMM 范式,在混合架构 BAGEL(14B)、自回归 Janus-Pro(7B)、Lance(3B)上均有效,15 个模型-基准组合全部超越同数据 SFT。
实验结果
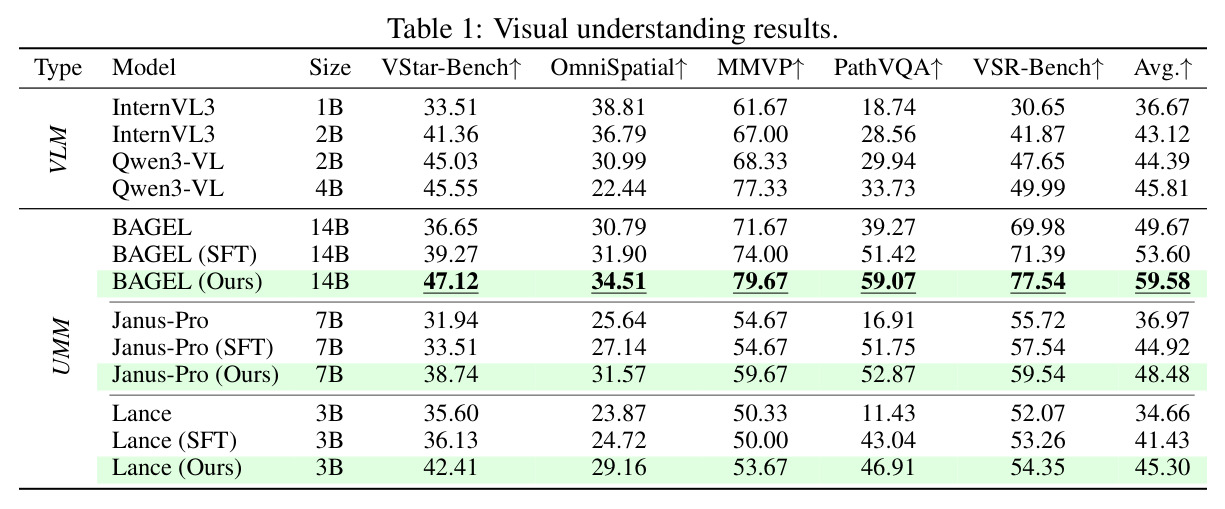
分析实验(6 UMM × 4 域 = 24 组合,2,084 对 VisMin 图像):控制修正后生成侧敏感性在全部 24 个组合高于理解侧,且优势在属性/物体/关系域大、计数域最小;互补性上,仅生成侧强响应比例平均 28.18%、仅理解侧仅 2.48%(净差 +25.70 pp),其中 Lance 属性域高达 +56.80 pp、BLIP3-o-4B 关系域最低 +7.37 pp;64×64 块级空间置换使 G−U 优势在全部 24 个组合缩水(如 Janus-Pro 属性 0.803→0.107、BAGEL 关系 0.238→−0.128),而计数域缩水最小,证实空间组织是生成侧优势的系统性来源。主实验(Table 1,15 个模型-基准组合):GAFU 全部超越同数据 SFT,五基准平均增益 3.56–5.98 个百分点,最大相对提升 VStar-Bench 20.00%、OmniSpatial 17.94%、VSR-Bench 8.62%。具体地,BAGEL-14B 五基准平均 49.67(Base)→53.60(SFT)→59.58(GAFU),其中 VStar 36.65→39.27→47.12、MMVP 71.67→74.00→79.67、PathVQA 39.27→51.42→59.07、VSR 69.98→71.39→77.54、OmniSpatial 30.79→31.90→34.51;Janus-Pro-7B 平均 36.97→44.92→48.48;Lance-3B 平均 34.66→41.43→45.30。九个通用理解组合中 GAFU 相对 SFT 的提升全部大于 SFT 相对 Base 的提升;MMVP 上 SFT 对 Janus-Pro 零提升、对 Lance 反而降 0.33 分,GAFU 却仍有 +3.67–5.67 增益,说明仅靠理解通路的监督适配无法突破其表征瓶颈。消融(Table 2,BAGEL):空间绑定与关系对齐缺一不可(联合使用比单独使用在 MMVP 上高 4.67–5.34 分);注入接口以文本隐状态查询最优;10 层稀疏注入与全 27 层仅差 0–1.67 分;CE+DPO 无 KL 时 OmniSpatial 崩至 22.24(比 CE-only 低 11.09 分),加 KL 后恢复至 34.51,完整目标比 CE+DPO 提升 3.14–12.27 分。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 细粒度视觉感知(小物体/局部属性/相对位置) | VStar-Bench 选择准确率(191 题) | BAGEL-14B 47.12 | BAGEL-14B SFT 39.27(Base 36.65) | +7.85 pp,相对 SFT 提升 20.00%(全文最大相对增益) |
| 空间推理 | OmniSpatial 准确率(1,533 题) | Lance-3B 29.16 | Lance-3B SFT 24.72(Base 23.87) | +4.44 pp,相对提升 17.94% |
| 多模态视觉模式感知 | MMVP 准确率(300 题) | BAGEL-14B 79.67 | BAGEL-14B SFT 74.00(Base 71.67) | +5.67 pp(SFT 在 Lance 上反而降 0.33,GAFU 仍正增益) |
| 医学视觉问答(病理) | PathVQA 归一化精确匹配(6,719 测试题) | BAGEL-14B 59.07 | BAGEL-14B SFT 51.42(Base 39.27) | +7.65 pp(在强 SFT 基线上仍有大增益) |
| 视觉空间关系判断 | VSR-Bench 准确率(2,195 题) | BAGEL-14B 77.54 | BAGEL-14B SFT 71.39(Base 69.98) | +6.15 pp,相对提升 8.62% |
局限与改进
作者在附录 E 承认三点局限:其一,GAFU 目前只针对主流双通路视觉编码器的 UMM,其他视觉通路设计或表征接口不兼容的架构需要额外适配;其二,效果依赖原生生成表征本身的质量,不同模型与任务的收益不一(互补性分析中 BLIP3-o-4B 关系域净差仅 +7.37 pp,BAGEL 计数域仅 +1.92 pp);其三,提取、投影、注入 G token 相比纯理解通路带来额外的推理计算与内存开销,且论文未给出量化的延迟/显存数字。我自己的观察还有:主对照只有同数据 SFT,没有与生成监督类(GenHancer、Reconstructive Alignment)或显式生成类方法正面对比,'超越 SFT'不足以证明它优于其他生成辅助路线;分析用的 VisMin 最小编辑对以单物体、单属性变化为主,对复杂多物体真实场景的代表性有限;计数域收益一贯最小(敏感性差值最低仅 0.019),因为生成侧优势依赖局部空间证据而计数需要跨实例聚合,这类任务可能需要不同机制;多个基准用候选答案平均 CE 打分而非自由生成,可能与真实对话场景的表现存在差距。
独立分析的弱点
弱点一:推理开销未量化。GToken Encoder 前向、理解通路 27 层每层的交叉注意力注入、以及 G token 的 KV 缓存都会增加延迟与显存,论文只承认'有开销'但没给数字,工程落地前必须实测;鉴于消融显示 10 层稀疏注入仅损失 0–1.67 分,可优先采用稀疏注入折中。弱点二:计数类任务收益最小——分析与消融都指向同一结论:生成侧优势来自局部空间绑定证据,而计数是跨实例聚合任务,256 个查询的压缩可能牺牲实例可分性;改进方向是引入实例中心压缩头或在关系对齐中加入计数感知约束。弱点三:G token 质量完全绑定于原生生成通路——若某 UMM 的 VAE 潜变量分辨率低、压缩率高,增益会相应缩水(BLIP3-o-4B 部分域净差很小即为例证);可探索多分辨率 G token 或与统一 tokenizer(UniTok、TokenFlow)结合从源头缓解。弱点四:偏好学习超参链复杂(4:1 梯度权重、0.25 倍负梯度范数封顶、KL 权重 1→0.25→0 三段调度、U 掩码 0.8/0.5/0.2/0 四段调度),跨模型迁移需要重新调参而论文未做超参敏感性分析;可改用更鲁棒的对比目标或自动化调度。弱点五:协同是单向的——G token 只反哺理解,理解通路的高层语义没有回馈生成侧,错失对称收益;且 Stage 2 训练数据以 FineVision 为主,域外泛化(如遥感、图表)未经检验。
未来方向
作者展望是把 UMM 从'联合建模'推向'能力协同',为复杂真实场景提供更可靠的细粒度理解。基于本文成果可延伸的方向:其一,双向协同闭环——把理解通路的高层语义同样注入生成通路(理解引导生成已有成熟范式),与 GAFU 组成完整的协同栈,并在 IMUG-Bench 类交错任务上验证;其二,用稀疏注入(10 层已达全层 96% 以上性能)加 G token 缓存把推理开销压到实用水平,并在端侧小模型上验证 3B 尺度以下的可行性;其三,把 shuffle-G 偏好学习推广到 GRPO/RLHF 框架,用可验证奖励(定位、计数正确性)直接奖励生成证据的正确使用,替代目前的 CE 差 proxy;其四,扩展到视频与 3D 场景的时空细粒度理解——生成侧视频潜变量的时序结构天然携带运动与遮挡信息,适合空间关系与物理推理任务;其五,与统一 tokenizer 路线融合,从表征源头消除双通路分裂,GAFU 的三重对齐目标(重建+绑定+关系)可作为统一表征的训练准则;其六,把三发现分析范式(控制修正敏感性/互补性/空间依赖)做成标准化诊断工具,在新 UMM 设计阶段即评估其生成-理解协同潜力。
复现评估
复现条件较好。代码已在 GitHub 开源(https://github.com/LRuca/GAFU);训练数据全部公开(Cambrian 分层采样 1M 图、FineVision 相关性≥3 的 1,344,016 样本、VSR 官方 7,680 训练样本、PathVQA 19,654 训练样本);评测集全部公开且协议详述(VStar 191 题选项打乱后按候选平均 CE 择优、OmniSpatial 1,533 题、MMVP 300 题成对互补、VSR-Bench 2,195 题 True/False 贪心生成、PathVQA 全部 6,719 测试题归一化精确匹配);三个 backbone(BAGEL-14B、Janus-Pro-7B、Lance-3B)均为开源模型。附录 A–D 给出六个模型的表征提取位置与网格对齐细节、对照图构造的十个退化算子与闭式解、全部损失公式与梯度分解、优化器配置(Stage 1:8 GPU、每卡 micro-batch 4、全局 32、8,000 步、峰值 lr 1e-4 cosine 衰减;Stage 2:全局 32、5,000 步、注入模块 2e-5、LoRA 1e-4)。难点在于 shuffle 分支/KL 参考分布/梯度封顶等实现细节需仔细对照论文公式,且 Stage 1 需要 8 卡级算力(不过原生通路全程冻结,显存压力远小于全量微调)。综合评估:拥有 8×A100 级资源与较强工程能力的小团队可在数周内复现主结果,建议先从 BAGEL 单模型复现起步。
论文图表
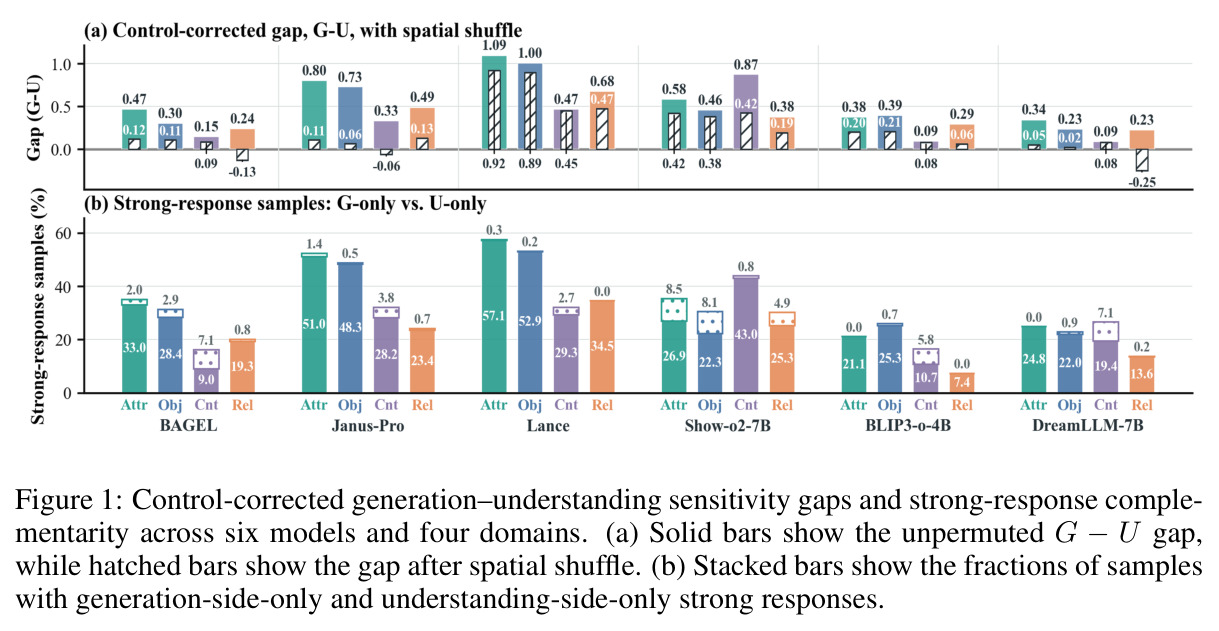
论文分析实验的总览图。(a) 子图实心柱为未置换条件下生成侧与理解侧的控制修正敏感性差(G−U),斜纹柱为对 64×64 图像块做空间置换后的同一差值:24 个模型-域组合中实心柱全部为正,置换后差值全部缩水;(b) 子图堆叠柱展示仅生成侧强响应与仅理解侧强响应的样本比例,前者在所有组合中都更高。
这是论文三大实证发现——生成侧敏感性优势、表征互补性、空间依赖性——的一图总览,是整个 GAFU 方法设计(空间绑定、关系对齐、任务条件检索)的实证地基,读懂此图就读懂了'为什么这样设计'。
在 BAGEL 上从四个维度消融:对齐目标(去空间绑定/去关系对齐/仅重建)、注入接口(token 拼接、入口融合、视觉隐状态查询、可学习查询、本文的文本隐状态查询)、注入密度(10 层稀疏 vs 全 27 层)、微调损失(CE only / CE+DPO / CE+DPO+KL)。完整配置在 VStar/OmniSpatial/MMVP 达 47.12/34.51/79.67,各替代方案均有不同幅度下降,其中 CE+DPO 无 KL 使 OmniSpatial 崩至 22.24。
逐项验证每个设计选择的必要性,揭示两个非平凡结论:'如何读 G'比'是否给 G'更重要,以及无 KL 约束的偏好学习会以摧毁错配分支的方式刷分。
附录中 24 个模型-域组合的逐项数据:仅生成侧强响应比例 P_G-only、仅理解侧强响应比例 P_U-only 及净差 Δ_comp。平均值为 28.18% / 2.48% / +25.70 pp;Lance 属性域最高(+56.80 pp),BLIP3-o-4B 关系域最低(+7.37 pp);属性与物体域的 P_G-only(35.66% 与 33.19%)高于计数与关系域(23.29% 与 20.58%)。
互补性结论的完整量化证据:说明生成侧表征捕捉到大量理解侧完全看不见的任务相关变化,且互补强度随变化类型呈系统性分布。