稀疏自编码器是符号匹配的共享坐标系 Sparse Autoencoders Are a Shared Coordinate System for Symbolic Matching
SAE 特征加 IDF 稀有度加权,免训练匹配异构符号系统,最高领先稠密基线 45 分
前置知识
稀疏自编码器(SAE)
一种挂在语言模型隐藏状态上的自编码器,把 $d$ 维稠密残差流编码为 $F$ 维($F \gg d$,如 131,072)的非负稀疏码,再试图重构原向量。训练后每个激活维度对应一条可解释的「特征」方向,可解释性研究用它把因超叠加(superposition)而纠缠的神经元拆成命名概念。本文用 JumpReLU 变体:$\mathbf{E}(\mathbf{h})=\mathrm{JumpReLU}(\mathbf{W}_{\mathrm{enc}}\mathbf{h}+\mathbf{b}_{\mathrm{enc}})$,每个特征有独立学习阈值 $\theta_f$,激活低于阈值直接置零。Gemma Scope、Llama Scope 等公开 SAE 覆盖各层各宽度,可直接下载使用。
本文方法的全部建立在「把稠密隐藏状态换成名命特征坐标」之上,不懂 SAE 就无法理解其坐标系和可解释性从何而来。
残差流与层间读取
因果 Transformer 的每一层向残差流写入信息,第 $\ell$ 层的 $\mathbf{h}_t\in\mathbb{R}^d$ 汇总了此前所有层对位置 $t$ 的加工结果,也是 Gemma Scope 这类 SAE 挂载和读取的位置。同一个 token 在不同层携带的信息截然不同:浅层偏词法表面、中层偏语义概念、深层偏向输出预测。因此「在哪一层读表示」本身就是一个超参数。
SAE-IDF 需要选定层来读取符号表示,论文用大量扫描实验(第 5 到 40 层)说明层、宽度、稀疏度的影响,必须先理解残差流才能看懂这些消融。
逆文档频率(IDF)
文本检索的经典加权思想(Spärck Jones, 1972):一个词出现的文档越少越有区分力,权重形如 $\log(N/df)$。TF-IDF 检索用它压低「的、是、the」这类无处不在的词,放大稀有词的贡献。本文把同一思想搬进 SAE 特征空间:统计每个特征在多少个符号上激活($df(f)$),给稀疏码的每一维乘上对应的 $\mathrm{idf}_f$,让「铁路」「车站」这类稀有概念主导余弦相似度,压掉「数学记号」「许可证文本」这类所有符号都激活的普遍特征。
IDF 是方法两个组成要素之一,消融显示没有它稀疏码本身几乎不起作用,理解它才能理解方法为何有效。
符号匹配与异构系统对齐
给定源系统中的一个符号(本体术语、表列、定理、知识图谱类),在目标系统中找出其对应物的任务。不同社区各有名字和专用方法:本体匹配(OAEI 竞赛)、模式匹配、知识图谱实体对齐、跨语言代码检索。每个系统的模式(schema)互不相通——同一个概念在 DBpedia 叫 RailwayStation、在 NELL 叫 trainstation;一个数学命题在 Lean 4 里是定理、在 Metamath 里是 $e 假设串。
这是论文要解决的问题本身,也是理解「一个方法通用覆盖 6 类系统」这一核心卖点的背景。
各向异性与超叠加
各向异性(anisotropy)指稠密嵌入集中在一个低维锥里,所有向量共享大的公共分量和第一主成分,余弦相似度因此被「人人都像」的成分污染;超叠加(superposition)指模型把远多于维度的概念挤进同一个向量空间,每个稠密维度混合许多概念。前者催生了 all-but-the-top、白化等事后修正,后者是 SAE 兴起的技术动因。
论文论证稠密基线失败、稀疏特征成功的根源就是这两个性质;附录 K 还系统对比了白化等稠密修正为何追不上 SAE-IDF。
神经符号模型
把可读、可干预、可验证的符号组件(规则、定理证明器、知识图谱)与神经组件结合的架构,符号部分承担认知科学中缓慢、审慎、按规则推理的 System 2 能力。其瓶颈在扩展性:LLM 靠自监督从海量语料获得知识,而符号系统依赖人类专家手工构建(如 Cyc 项目),导致现有神经符号模型局限于单一领域。
论文的最终愿景是通用符号骨干——靠匹配并合并现有符号系统来复用人类劳动,而不是从零手工构建,理解这一点才能明白匹配为何是「第一步」。
研究动机
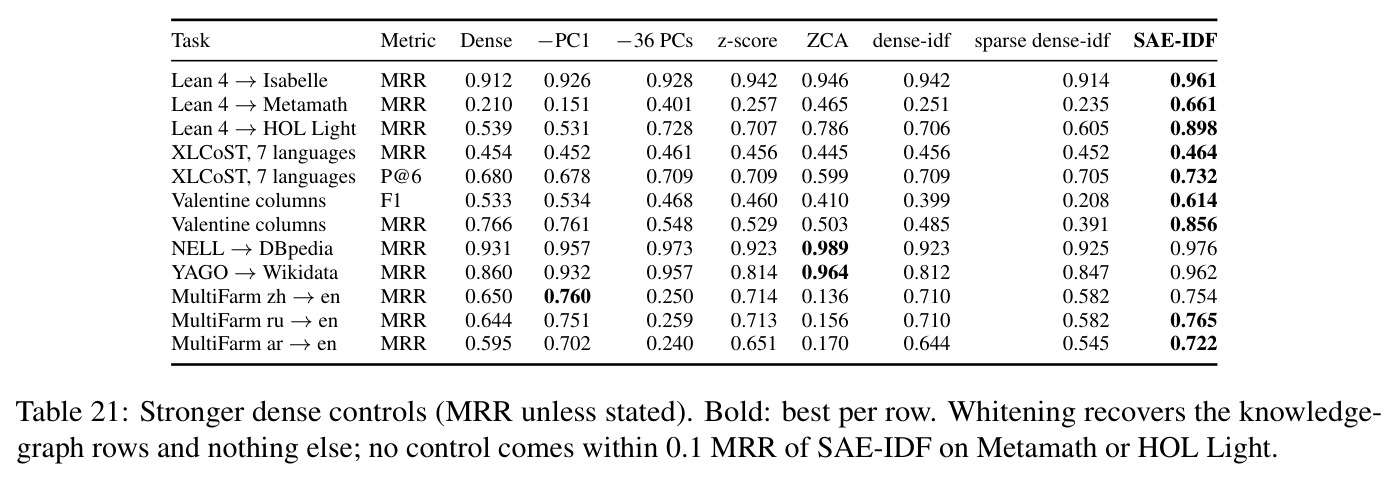
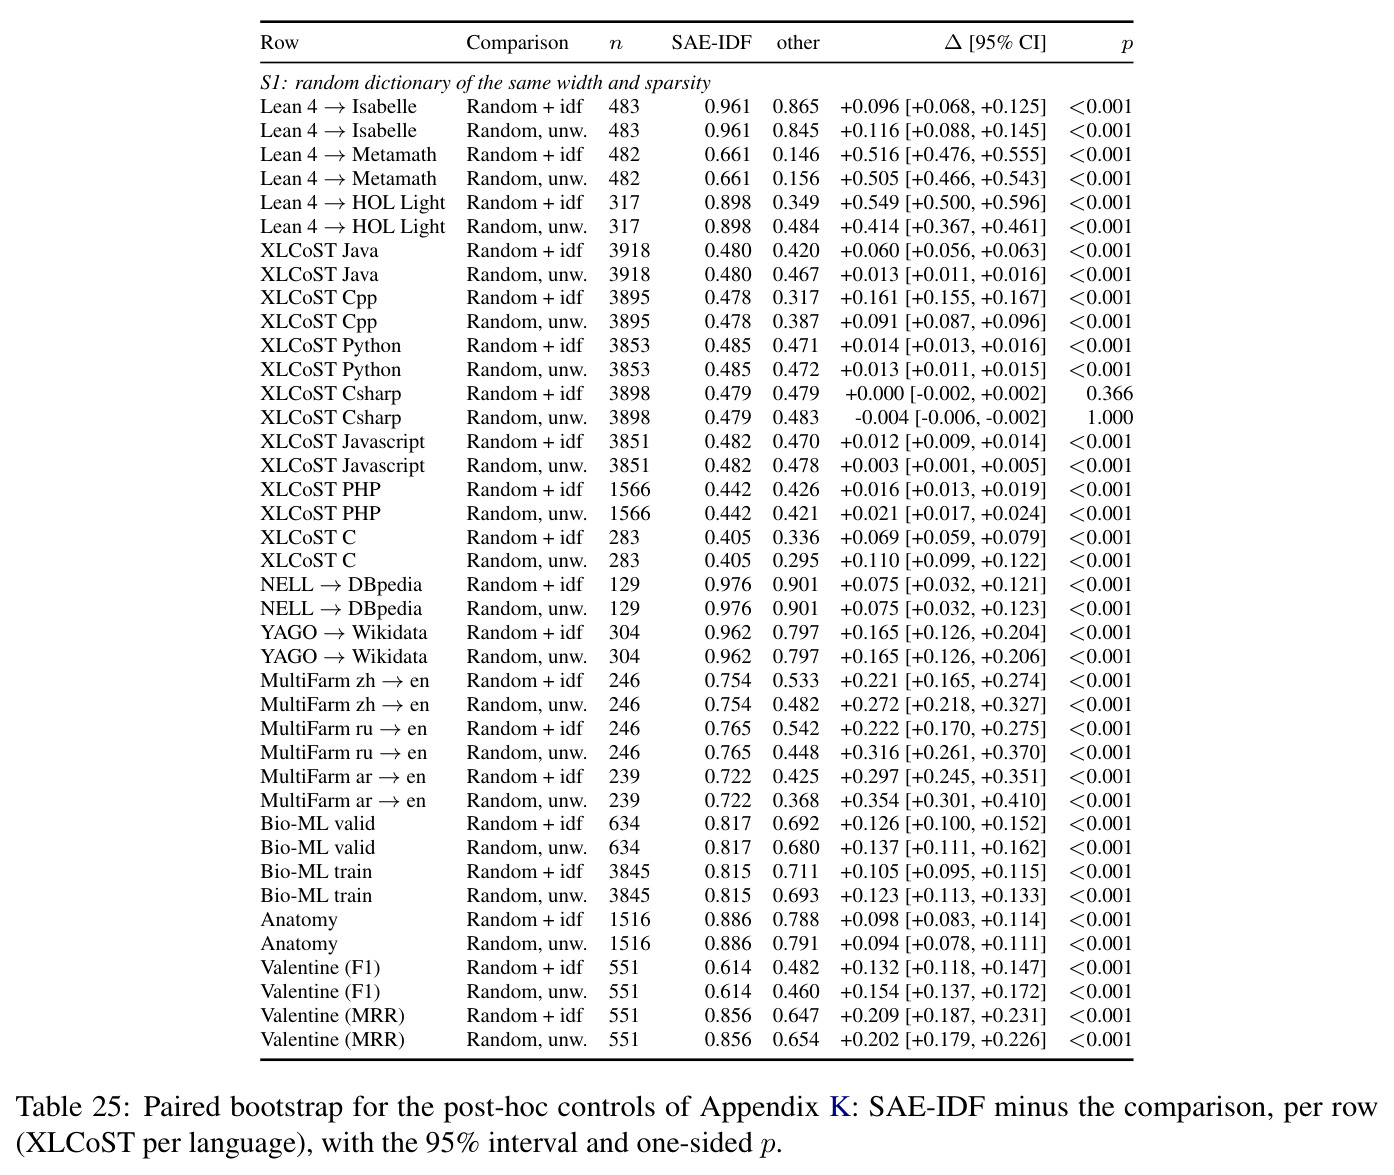
神经符号模型要成为 LLM 之外的一条可信路径,必须把符号部分建到 LLM 的规模,但符号知识依赖人类专家的手工整理:mathlib、Gene Ontology、各大知识图谱各自为政,同一个事实散落在模式互不相通的众多系统里——一个数学命题在 Lean 4 里是定理、在 Metamath 里是 $e 假设串、在 HOL Light 里又是另一种写法;同一个类别在 DBpedia 叫 RailwayStation、在 NELL 叫 trainstation。要复用这些已有的人类劳动而不是像 Cyc 那样从零手写,第一步就是把不同系统里的符号对上号,即本文统称的符号匹配。直接用 LLM 的稠密隐藏状态做这件事有两个已知障碍:其一,残差流各向异性,所有输入共享的公共方向主导相似度,把谁都算得很像;其二,稠密文本嵌入偏向表面词法相似而非结构对应。更麻烦的是,每个稠密维度因超叠加混合了大量概念,既无法按稀有度降权,也无法解释一次匹配为什么成立;论文附录 K 的对照实验显示,减均值、去第一主成分、白化、稠密版 IDF 等事后修正确实追不上本文方法。
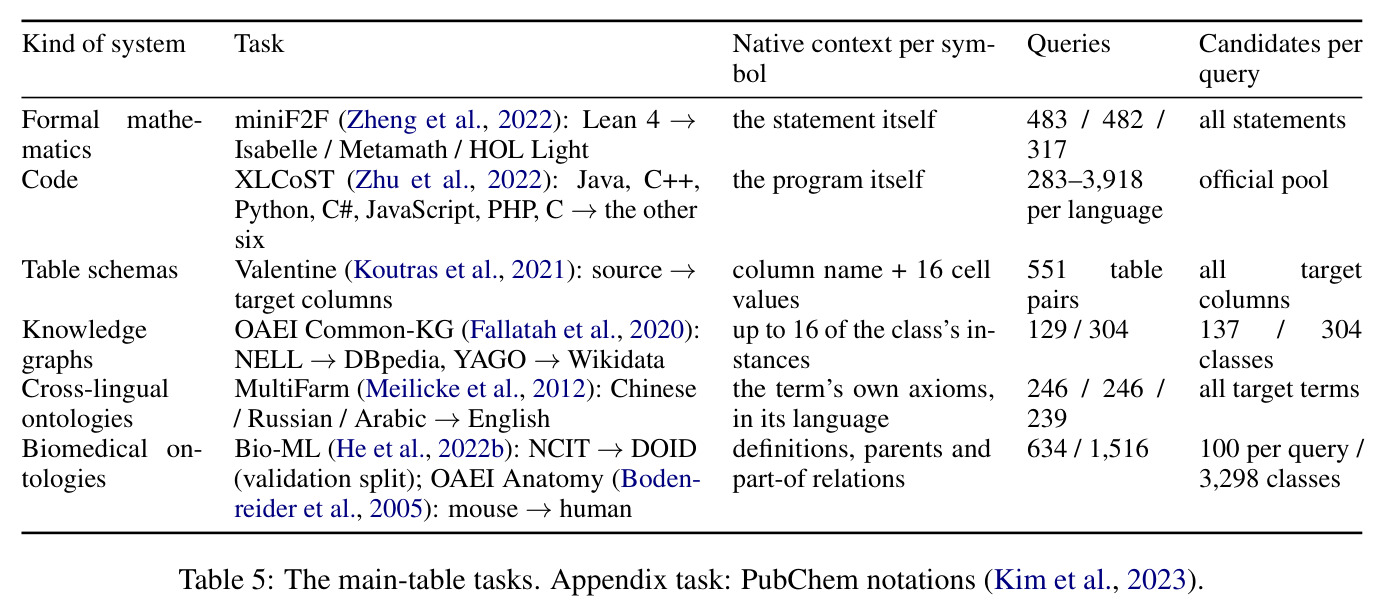
本文的目标是本文的目标是给通用符号骨干打第一块基石:一个免训练、跨系统、可解释的符号匹配方法,能对齐任意两个 LLM 读得懂的符号系统。验收标准有三条。其一是通用性:同一方法、同一套配置不改地跑遍形式数学(miniF2F 的 Lean 4 到 Isabelle/Metamath/HOL Light)、跨语言代码检索(XLCoST 七种语言)、表模式匹配(Valentine)、知识图谱(OAEI Common-KG)、跨语言本体(MultiFarm)和生物医学本体(Bio-ML、Anatomy)共 6 类系统 12 个任务。其二是有效性:在同一 LLM 内部全面超过稠密隐藏状态基线(Gemma-2-9B 上 12 项任务全胜,最高领先 0.45 MRR),并在多数任务上是最好的免训练方法。其三是可解释性:每次匹配都能分解为若干具名概念的贡献,让人读得懂它为什么成立、为什么失败。
与已有工作不同的是,已有工作的切入要么为单一系统类型定制专用匹配器(BERTMap、LogMap 只服务本体对齐,换一类系统就得重造并重新训练),要么把 LLM 当作通用嵌入器、再对稠密向量做事后几何修正(去均值、去主成分、白化)。本文抓住了一个被忽视的事实:SAE 字典是在大语料上训练出来的、对所有 token 共享的坐标系,稠密空间里那些污染相似度的公共方向,在稀疏空间里会显形为少数可以被点名的「普遍特征」——例如激活于 99% Pile token 的「数学或编程记号」特征。于是文本检索领域 1972 年的 IDF 就能原封不动地搬进来,把普遍特征精确降权。这个视角把符号匹配从「几何问题」变成「稀有概念共享问题」,类比 BLAST 在 DNA 序列搜索中靠少量高分辨率的局部匹配打分,而不是统计两条序列共有的平凡片段。同时,因为每个稀疏维度在 Neuronpedia 上有人类可读的自动解释,匹配天然可审计,这是稠密方法给不了的。
核心方法
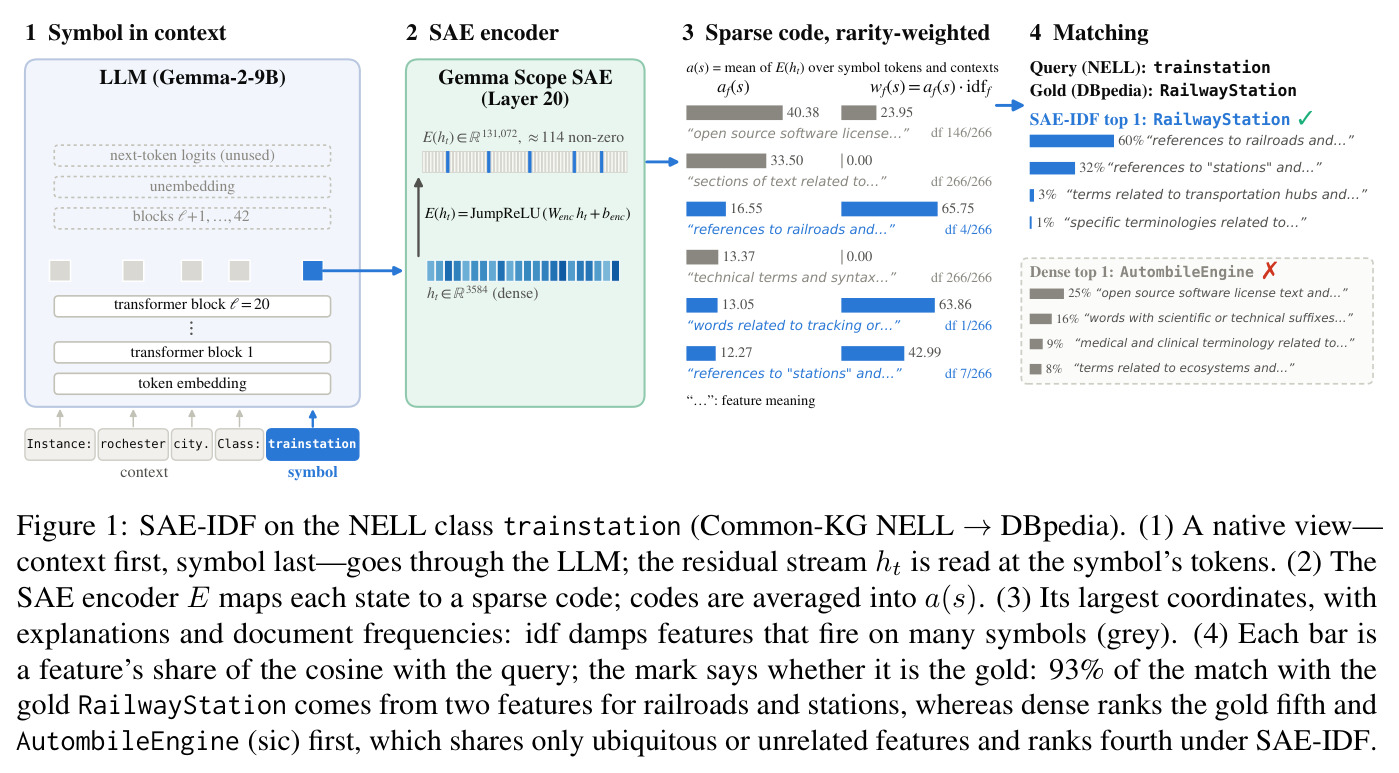
直觉上,两个符号等价,当且仅当它们共享少数旁人没有的概念:trainstation 和 RailwayStation 之所以对得上,是因为两者都谈「铁路」和「车站」,而不是因为都含有「数学记号」「开源许可证文本」这类到处出现的成分。SAE-IDF 把这个直觉变成四步流水线。第一步,把每个符号连同其系统内的原生上下文(知识图谱类的实例、本体术语的公理、表列的采样值)写成一段文本,喂给 LLM(如 Gemma-2-9B),前向传播到目标层 $\ell$(主实验为第 20 层);第二步,取符号自身 token 位置的残差流,用该层的公开 JumpReLU SAE($F=131{,}072$ 个特征,平均 L0 约 114)编码成稀疏码,再对 token 和视图取平均得到 $\mathbf{a}(s)$;第三步,统计每个特征在参考集合 $D$ 中激活了多少符号($df(f)$),给每维乘上 $\mathrm{idf}_f=\lfloor\log(1+N/df(f))\rfloor$,得到加权向量 $\mathbf{w}(s)=\mathbf{a}(s)\odot\mathrm{idf}$;第四步,查询符号与候选池逐个算余弦,取 top-1 作为匹配结果。整个过程没有任何梯度更新,完全复用现成的模型和现成的 SAE。
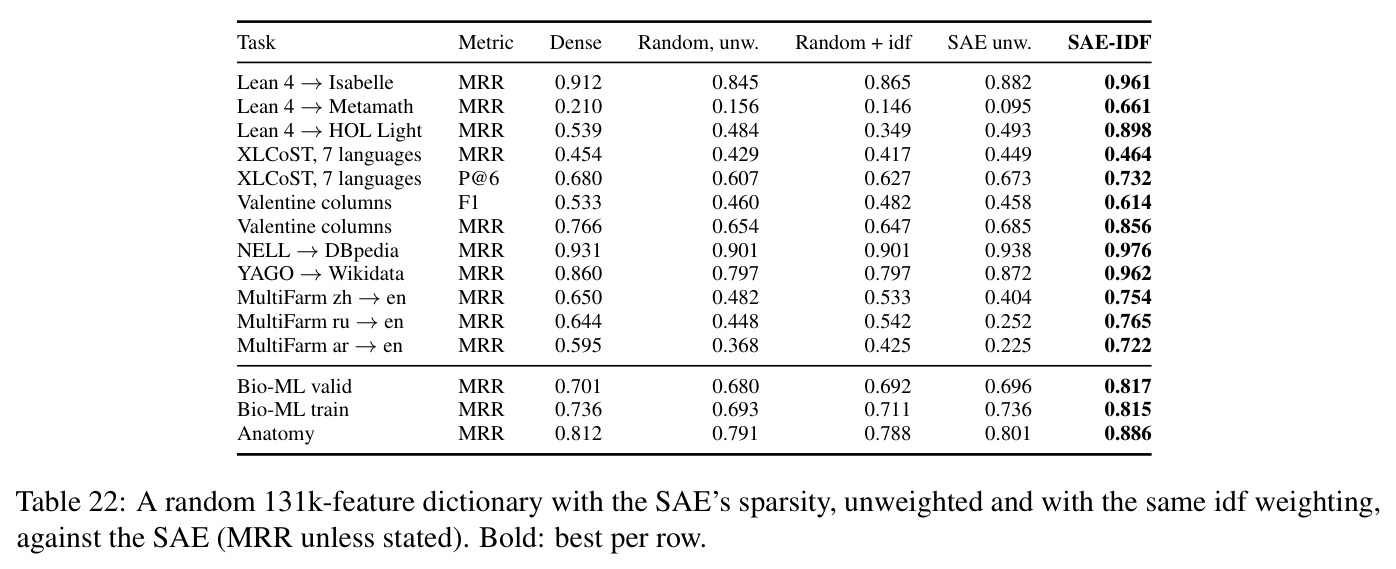
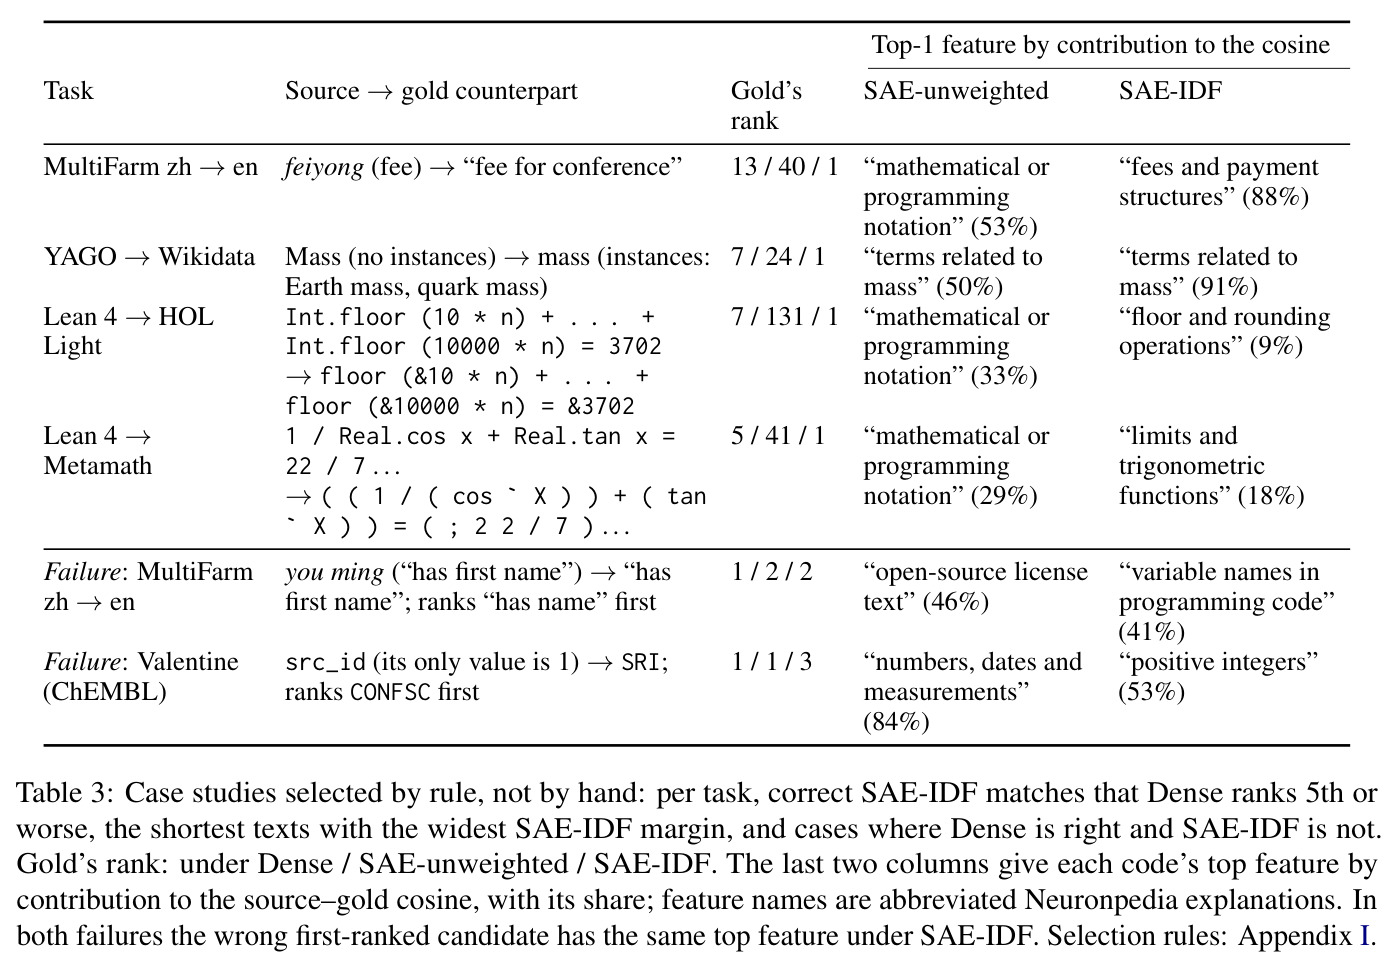
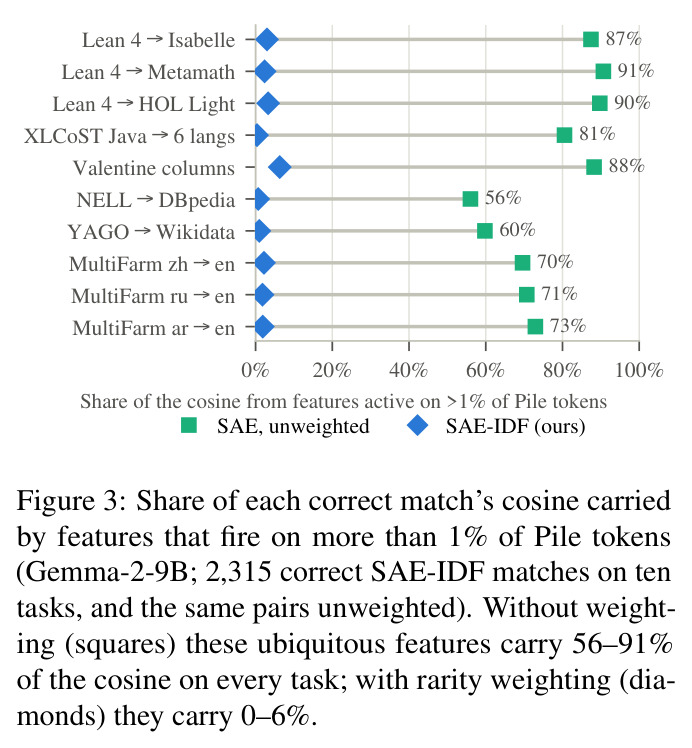
核心创新是把 SAE 字典当作异构符号系统之间的共享坐标系,并用 IDF 治理它。已有方法把 LLM 隐藏状态视为一个整体向量,相似度里混着所有符号共享的公共方向;SAE-IDF 指出,这些公共方向在稀疏空间会「现出原形」——变成少量可识别、可命名的普遍特征,例如在 99% Pile token 上激活的特征 f106376「数学或编程记号」。一旦普遍特征被点名,经典的 IDF 就能精确把它们的权重压到零,让匹配只由稀有概念驱动。这带来两个质的飞跃。其一是匹配质量:消融显示,没有加权的稀疏码在 18 组主表比较中 15 组反而输给稠密基线,而用随机字典加同样的 IDF 也全面低于稠密——「学到的特征」和「稀有度加权」缺一不可,二者结合才成立。其二是可解释性:余弦可以精确分解到特征,$\cos(\mathbf{w}(s),\mathbf{w}(t))=\sum_f c_f$,每一项对应一个有名字的概念,于是每次匹配都是一份可读的证据链(NELL 的 trainstation 匹配 DBpedia 的 RailwayStation,93% 的余弦来自「铁路」和「车站」两个特征),失败时也能读出原因("has first name" 输给 "has name",是因为两者共享「程序代码中的变量名」这一特征)。
方法步骤详情
完整流程分四步。第一步「原生视图」:对每个符号 $s$,从其所属系统抽取原生记录作为视图 $v_1(s),\dots,v_m(s)$——Common-KG 的类采样至多 16 个实例写成 Instance: ,MultiFarm 的术语逐条公理写成 . Term: ,Valentine 的表列写成列名加 16 个采样值,miniF2F 的视图就是定理陈述本身;每个视图转成「上下文在前、符号在后」的文本。第二步「编码」:文本经 LLM 前向传播到目标层 $\ell$,只保留符号自身 token 位置 $T_j(s)$ 的残差流(上下文信息已经过自注意力汇入这些位置),用该层 JumpReLU SAE 逐一编码,按 $a(s)=\frac{1}{m}\sum_{j=1}^{m}\frac{1}{|T_j(s)|}\sum_{t\in T_j(s)}\mathbf{E}(h_t)$ 先对 token 再对视图平均,得到非负、大部分为零的稀疏码。第三步「稀有度加权」:在参考集合 $D$ 上统计 $df(f)=|\{u\in D: a_f(u)>0\}|$,按 $\mathrm{idf}_f=\lfloor\log(1+N/df(f))\rfloor$ 加权得 $\mathbf{w}(s)=\mathbf{a}(s)\odot\mathrm{idf}$,激活于每个符号的特征权重为零;miniF2F、XLCoST、Valentine 用候选池当 $D$,本体和知识图谱任务用两侧全部符号。第四步「匹配与解释」:按 $\hat{t}(s)=\arg\max_{t\in C(s)}\cos(\mathbf{w}(s),\mathbf{w}(t))$ 排序候选,余弦逐特征分解为 $c_f$,配合 Neuronpedia 的自动解释(覆盖所用 131,072 个特征中的 129,642 个)即可读出每次匹配的依据。
技术新颖性
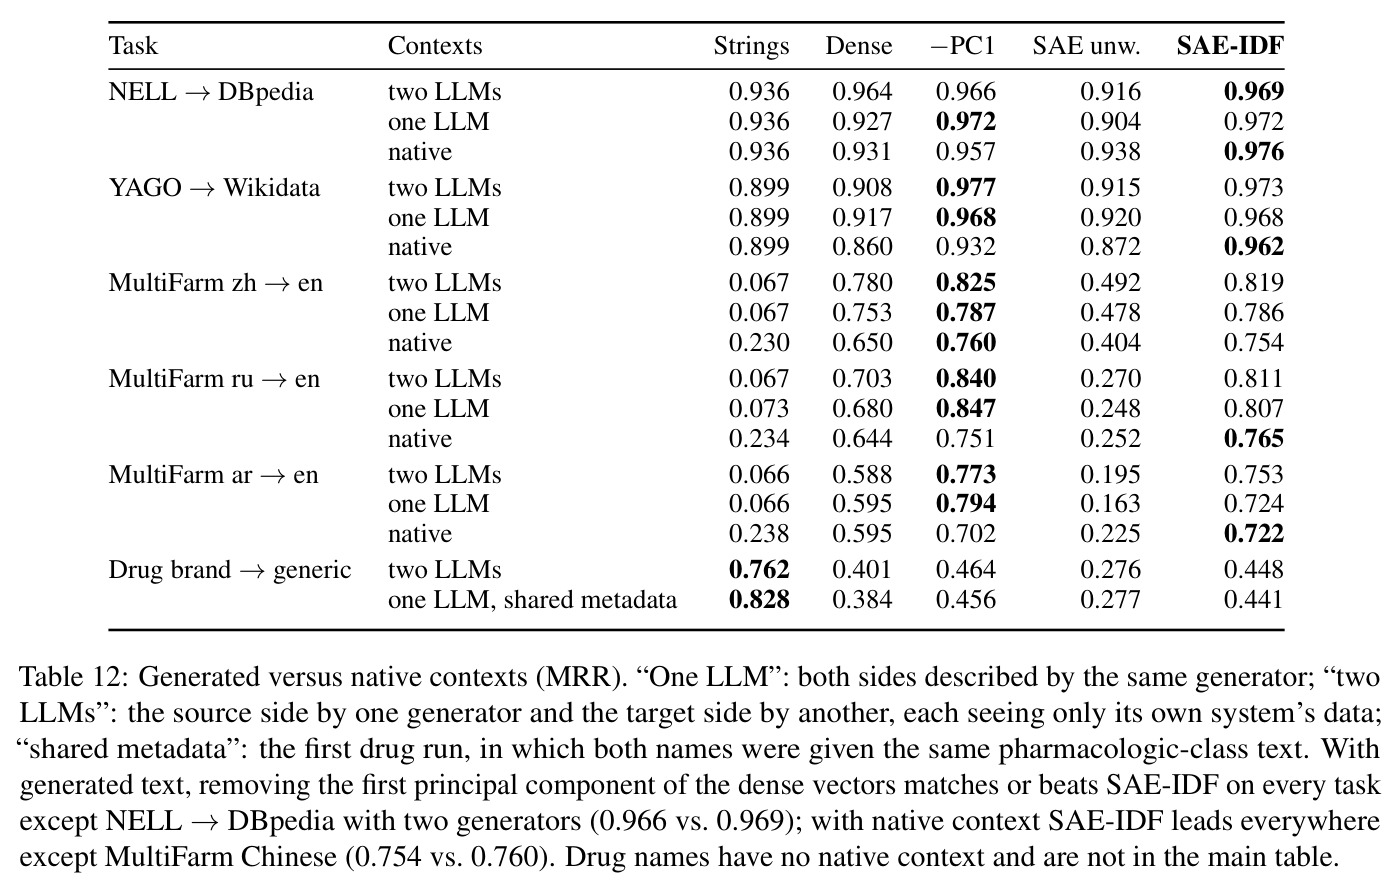
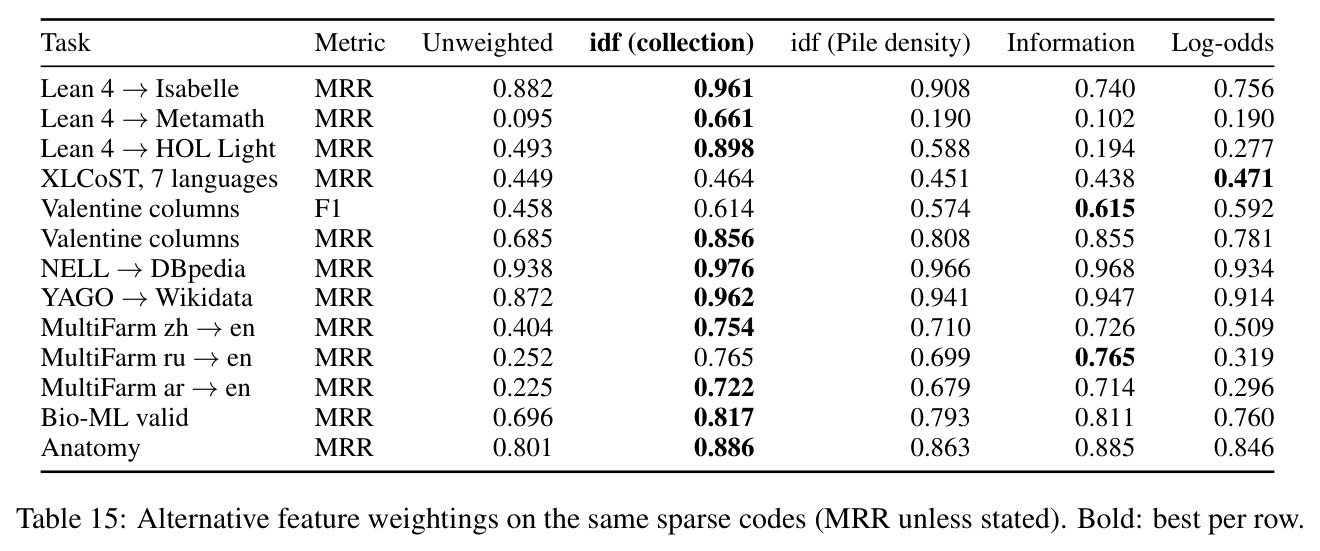
与现有技术的本质区别有三点。第一,对「通用」的承诺:本体匹配领域的 BERTMap 需要为每个本体对微调 BERT,LogMap 依赖词法加逻辑规则,LLM 智能体方案逐对提示推理,它们都绑定单一系统类型;本文一个方法、零训练覆盖形式数学、代码、表模式、知识图谱、跨语言本体、生物医学本体六类,且随公开 SAE 的每次发布(更多层、更大宽度、更强模型)自动免费升级。第二,对稠密嵌入的改造深度:BGE-M3、Qwen3-Embedding 这类检索器需要配对数据训练相似度,而本文证明无需任何对齐数据,仅靠「稀疏化 + 稀有度加权」就能在多数任务逼近甚至超越它们;附录 K 的预注册实验进一步显示,白化、去 36 个主成分、稠密版 IDF 等事后修正都远追不上——差异必须来自特征空间的稀疏分解本身,而非几何修正。第三,可解释性不是附加品而是机制的一部分:加权操作直接作用在名命特征上,分数分解、失败归因、乃至后续「规则 vs 神经」分工的分析(数值列最难)都由这套坐标系直接给出,而非依赖事后归因工具。
实验结果
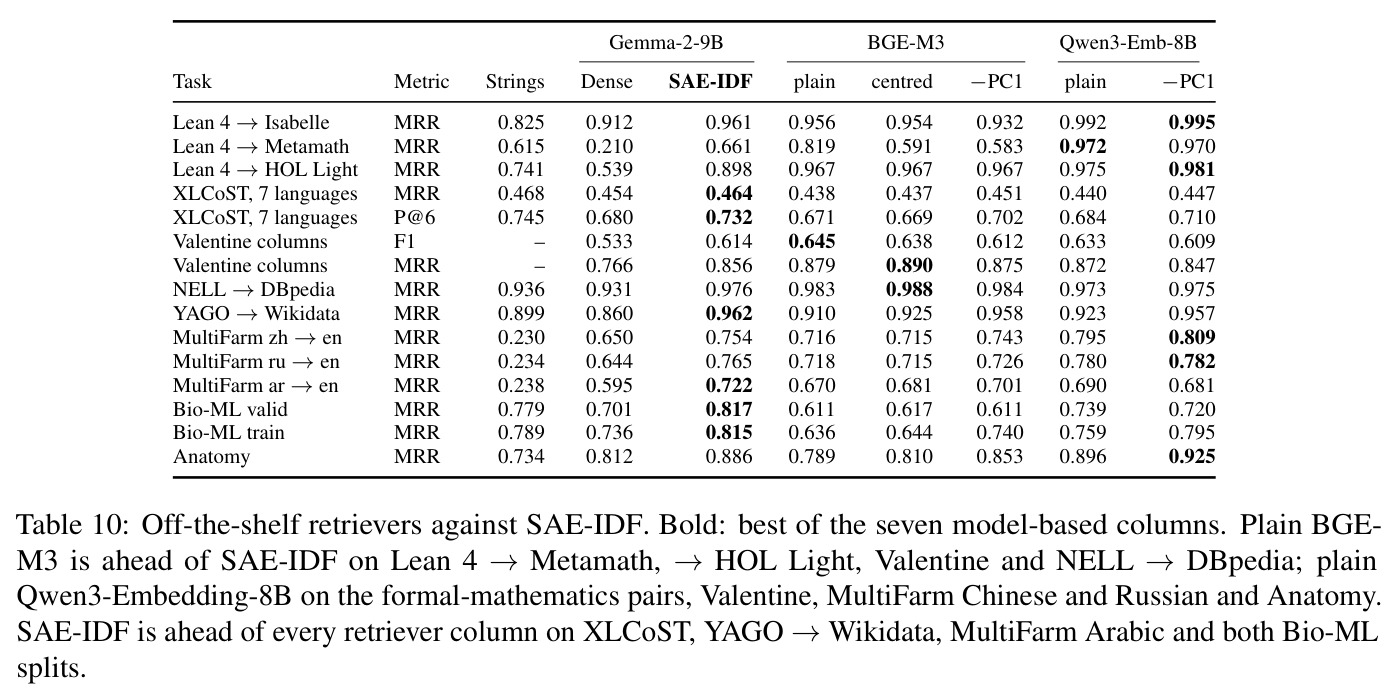
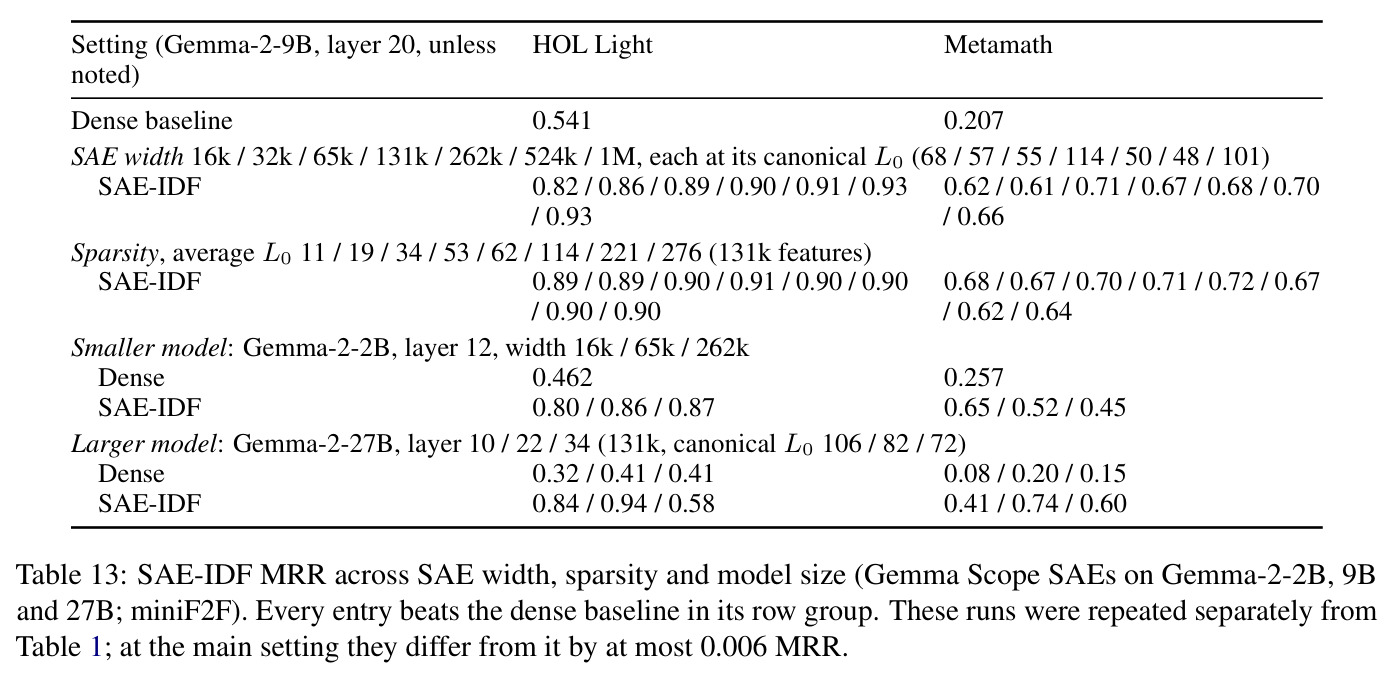
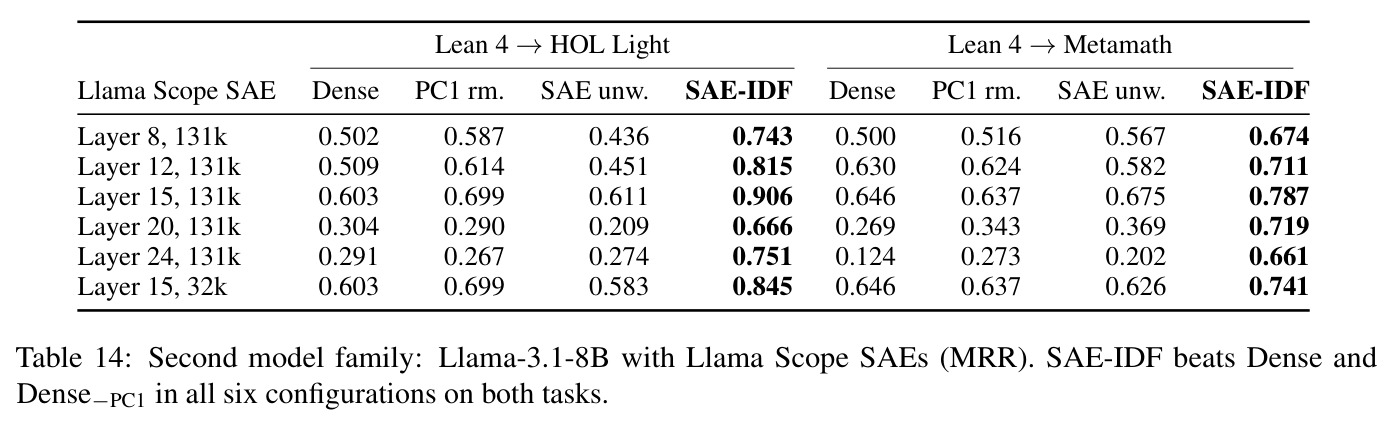
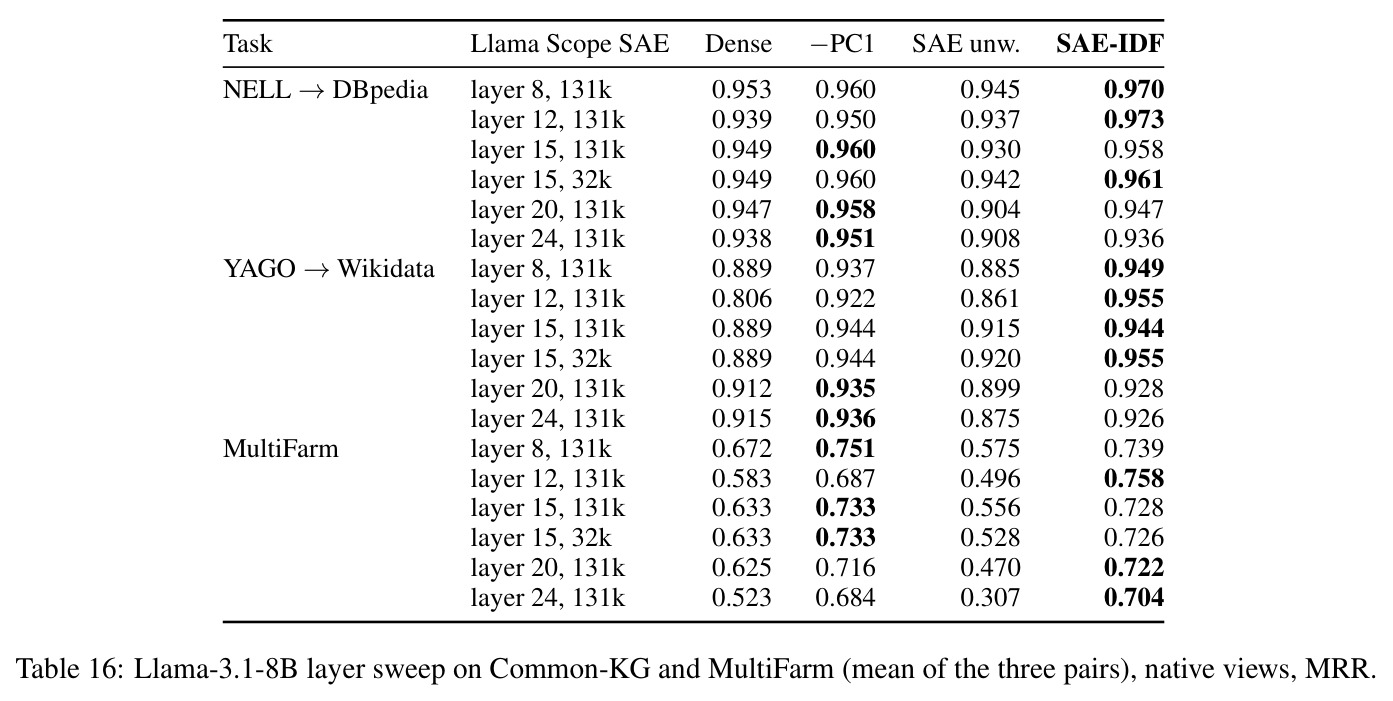
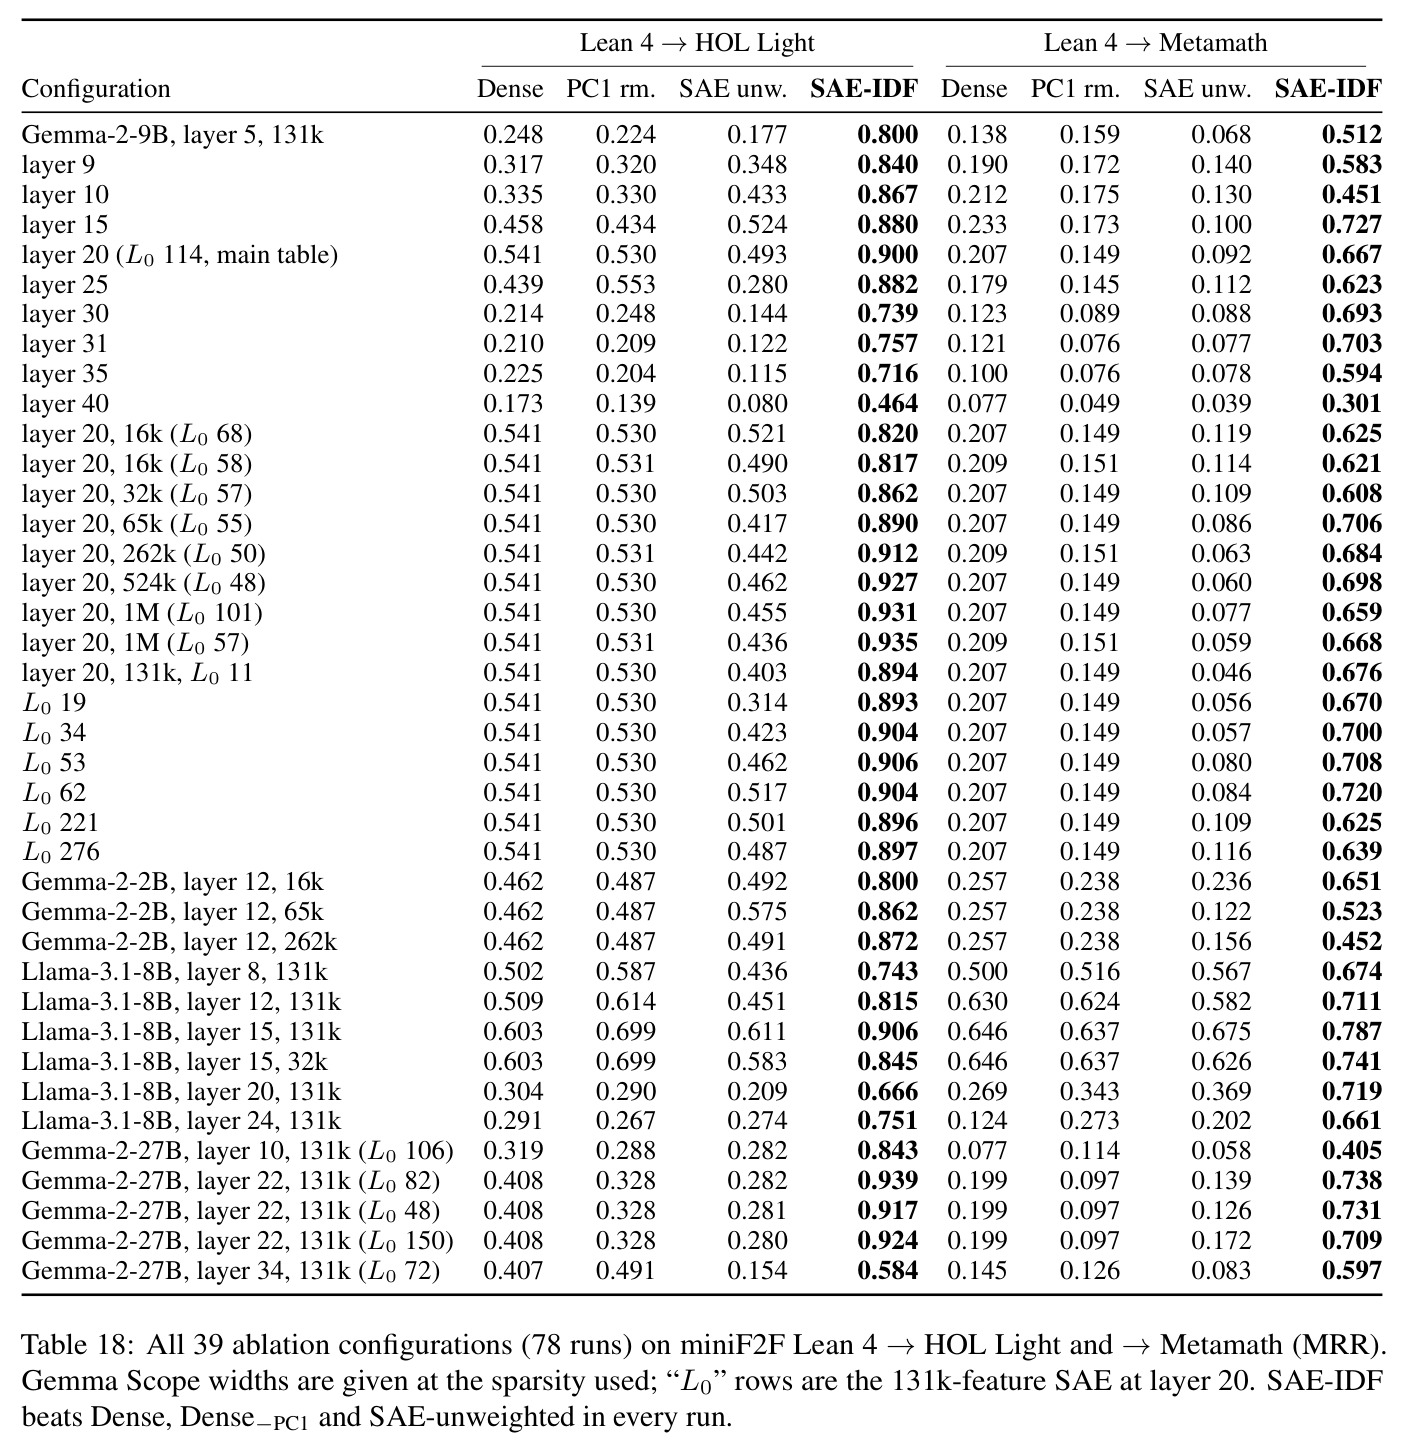
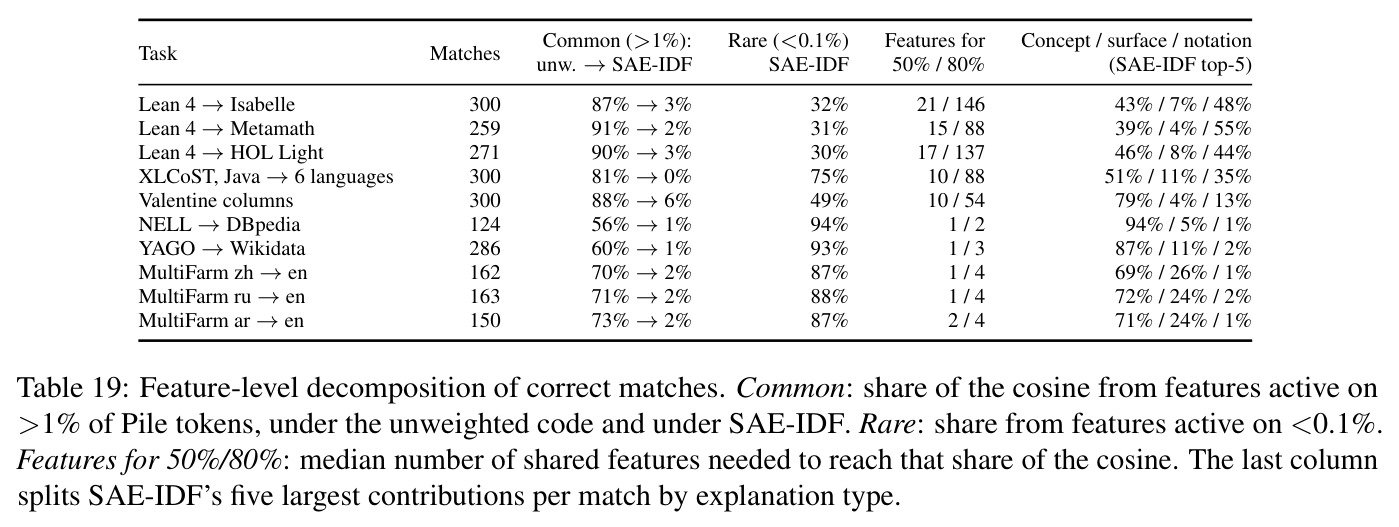
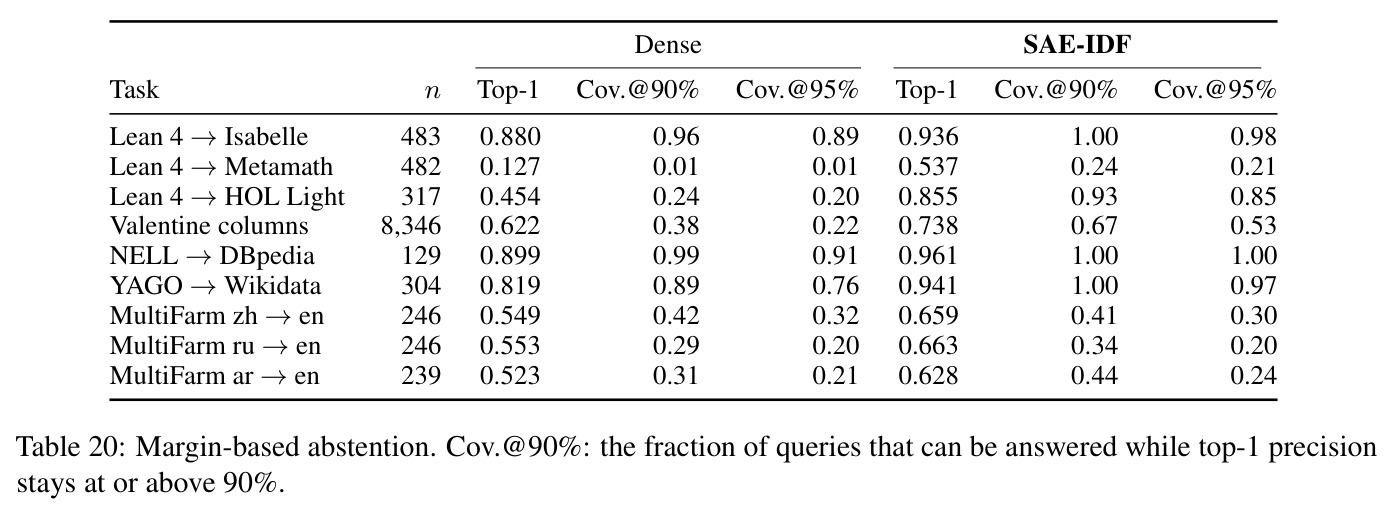
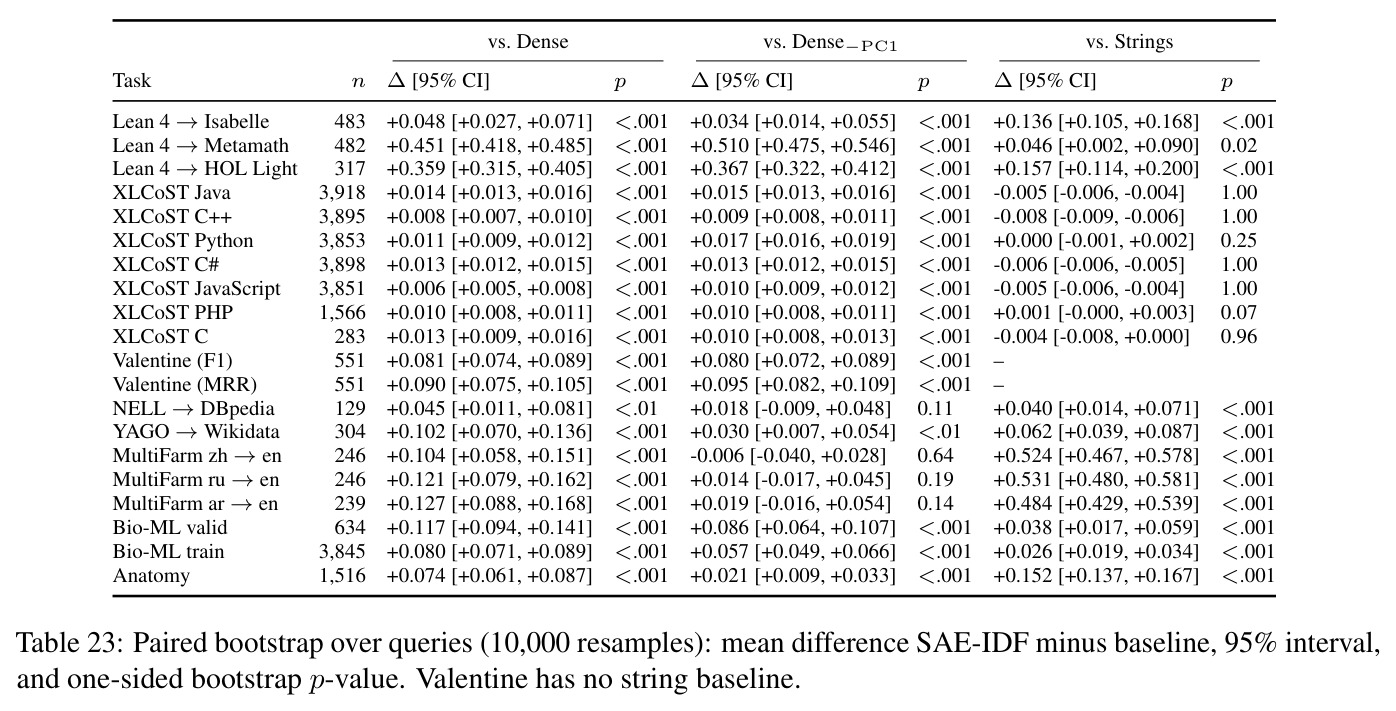
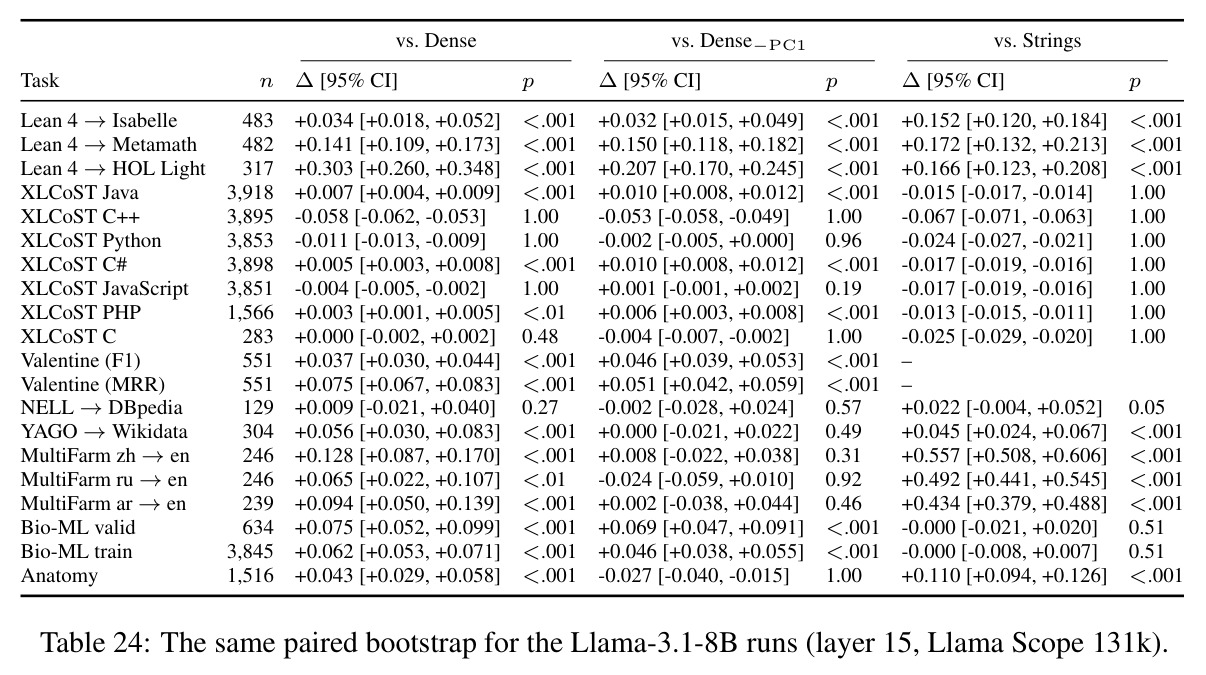
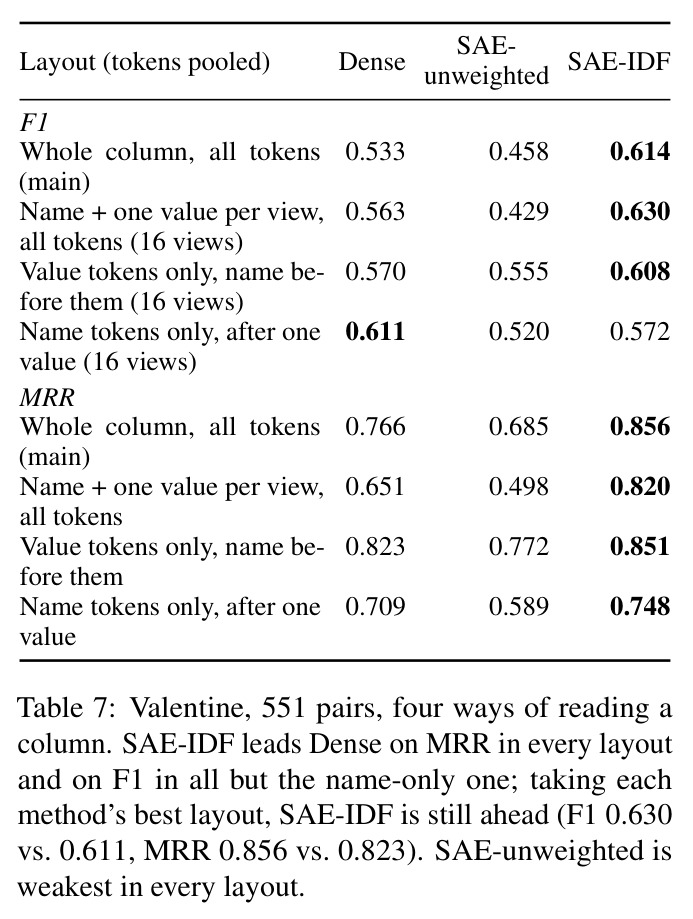
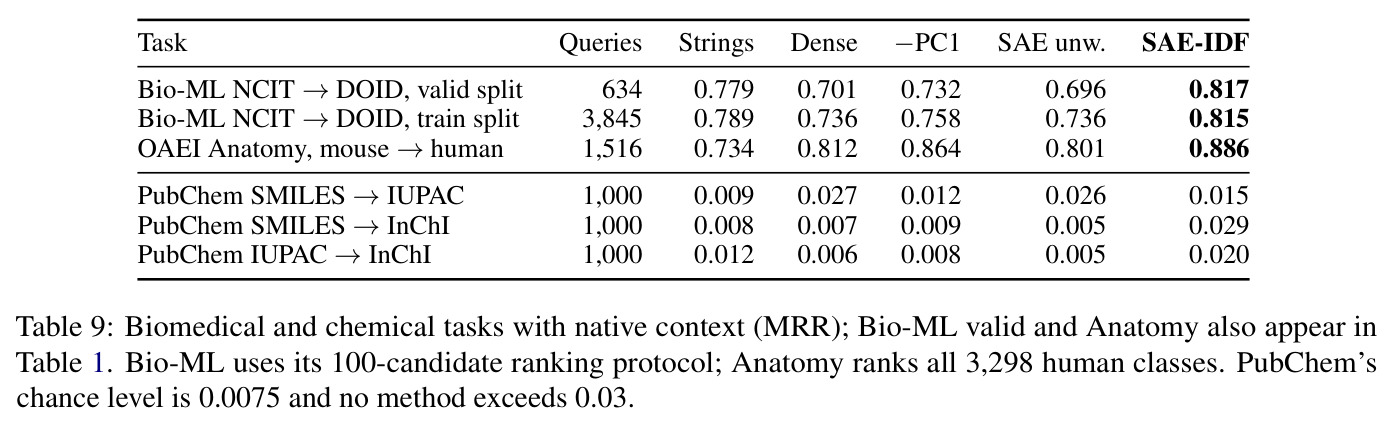
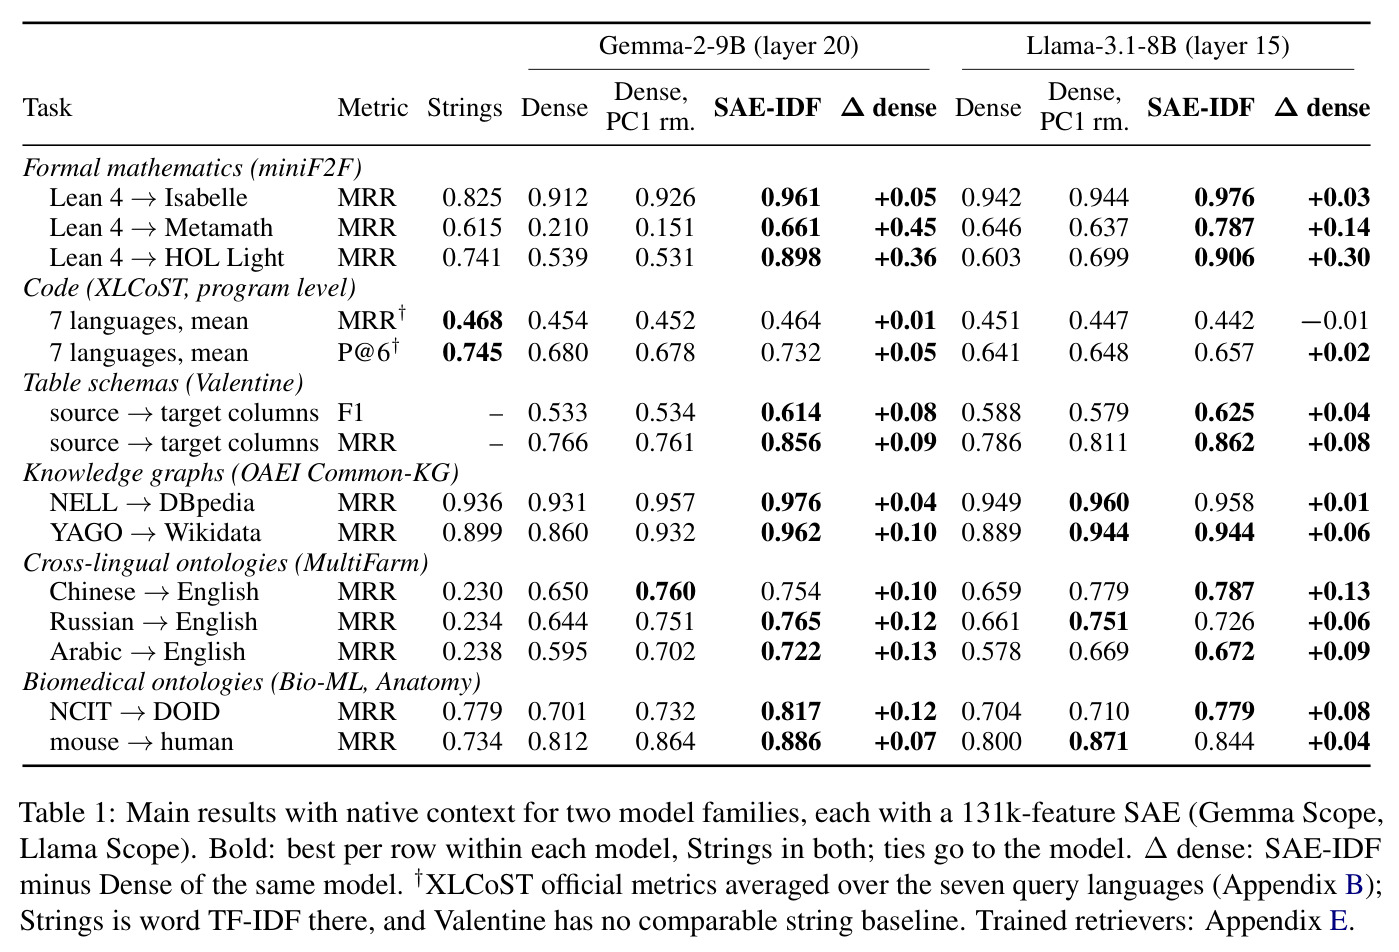
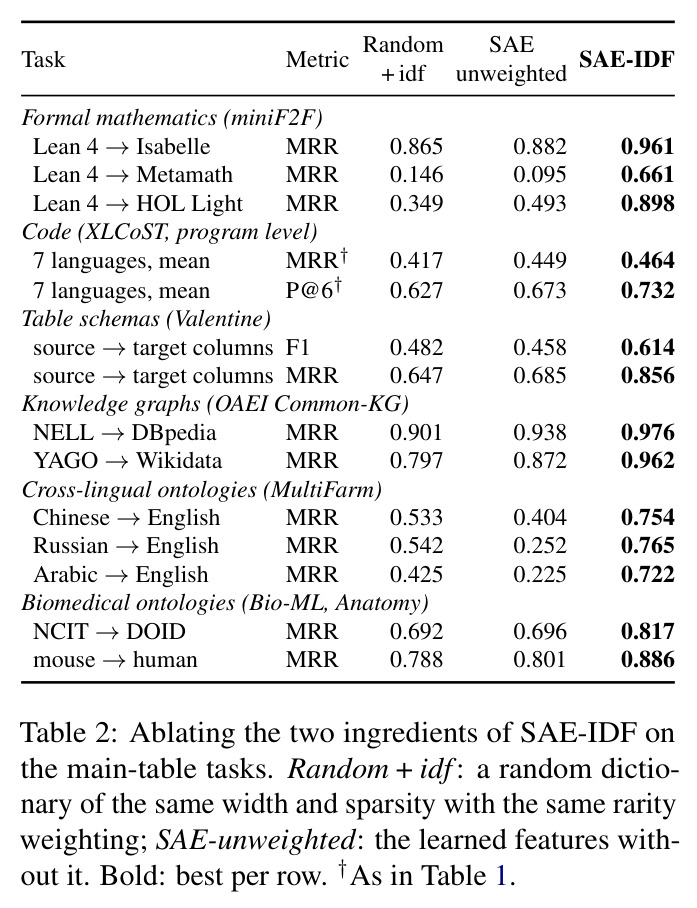
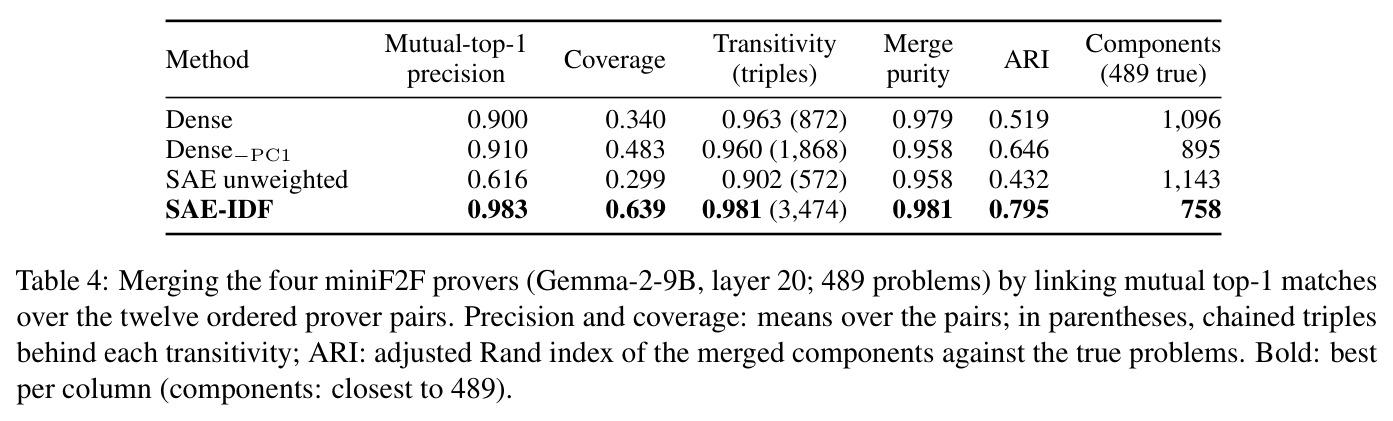
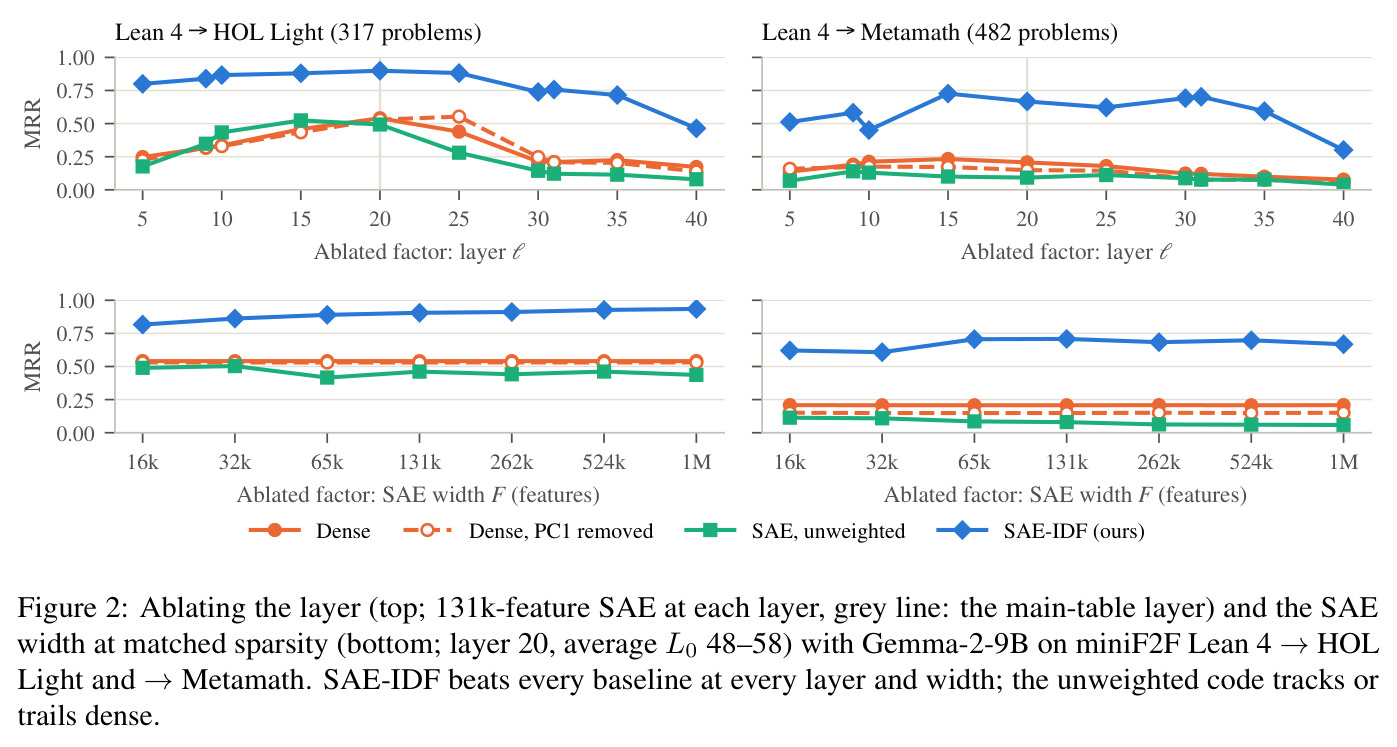
主实验(Table 1)覆盖 6 类系统 12 个任务。Gemma-2-9B(第 20 层 SAE)上 SAE-IDF 全部 12 个任务领先稠密基线,差距最大处正是记号差异最大的形式数学:Lean 4 到 Metamath 的 MRR 从 0.210 提到 0.661(+0.45),到 HOL Light 从 0.539 提到 0.898(+0.36),而记号相近的 Isabelle 仅从 0.912 到 0.961;知识图谱 NELL 到 DBpedia 0.976 对 0.931,YAGO 到 Wikidata 0.962 对 0.860;跨语言本体 MultiFarm 中/俄/阿分别 0.754、0.765、0.722,领先稠密 0.10 到 0.13(字符串基线仅 0.23);Valentine F1 0.614 对 0.533、MRR 0.856 对 0.766;Bio-ML NCIT 到 DOID 0.817 对 0.701;Anatomy 0.886 对 0.812。配对 bootstrap 显示所有对稠密的增益 p<0.004。Llama-3.1-8B 上 14 行中 13 行领先,仅 XLCoST MRR 例外。消融(Table 2)证明两个成分缺一不可:去掉 IDF 的稀疏码在 18 组比较中 15 组输给稠密;换成同宽度同稀疏度的随机字典加同样 IDF,则在所有任务低于稠密。结构扫描(Figure 2)覆盖 39 种配置:SAE-IDF 在全部配置胜过稠密与 Dense-PC1,对 SAE-unweighted 在 78 次运行中全胜(+0.11 到 +0.66);宽度每翻一倍性能上升(HOL Light 从 16k 的 0.817 到 1M 的 0.935),模型从 2B 到 27B 缩放同样有效(Gemma-2-27B 第 22 层上 Metamath 0.738 对稠密 0.199)。特征分析(Figure 3)给出机制证据:未加权时,激活于超过 1% Pile token 的普遍特征携带 56-91% 的余弦,加权后骤降到 0-6%;KG 与本体匹配 87-94% 的余弦来自激活率低于 0.1% 的稀有特征。系统合并实验(Table 4)中,以互为 top-1 为链接合并四个证明助手,SAE-IDF 覆盖 0.64 对稠密 0.34,传递性 0.981 对 0.963,聚类 ARI 0.795 对稠密 0.519;弃权机制下 90% 精度时 HOL Light 可回答 93% 的查询(稠密仅 24%)、Metamath 可回答 24%(稠密 1%)。
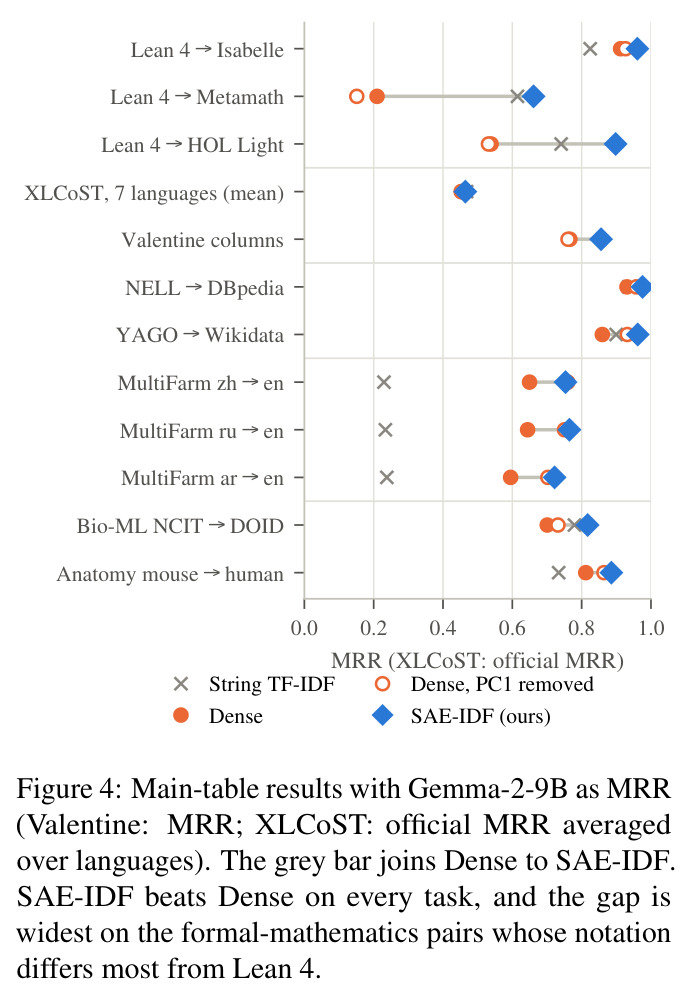
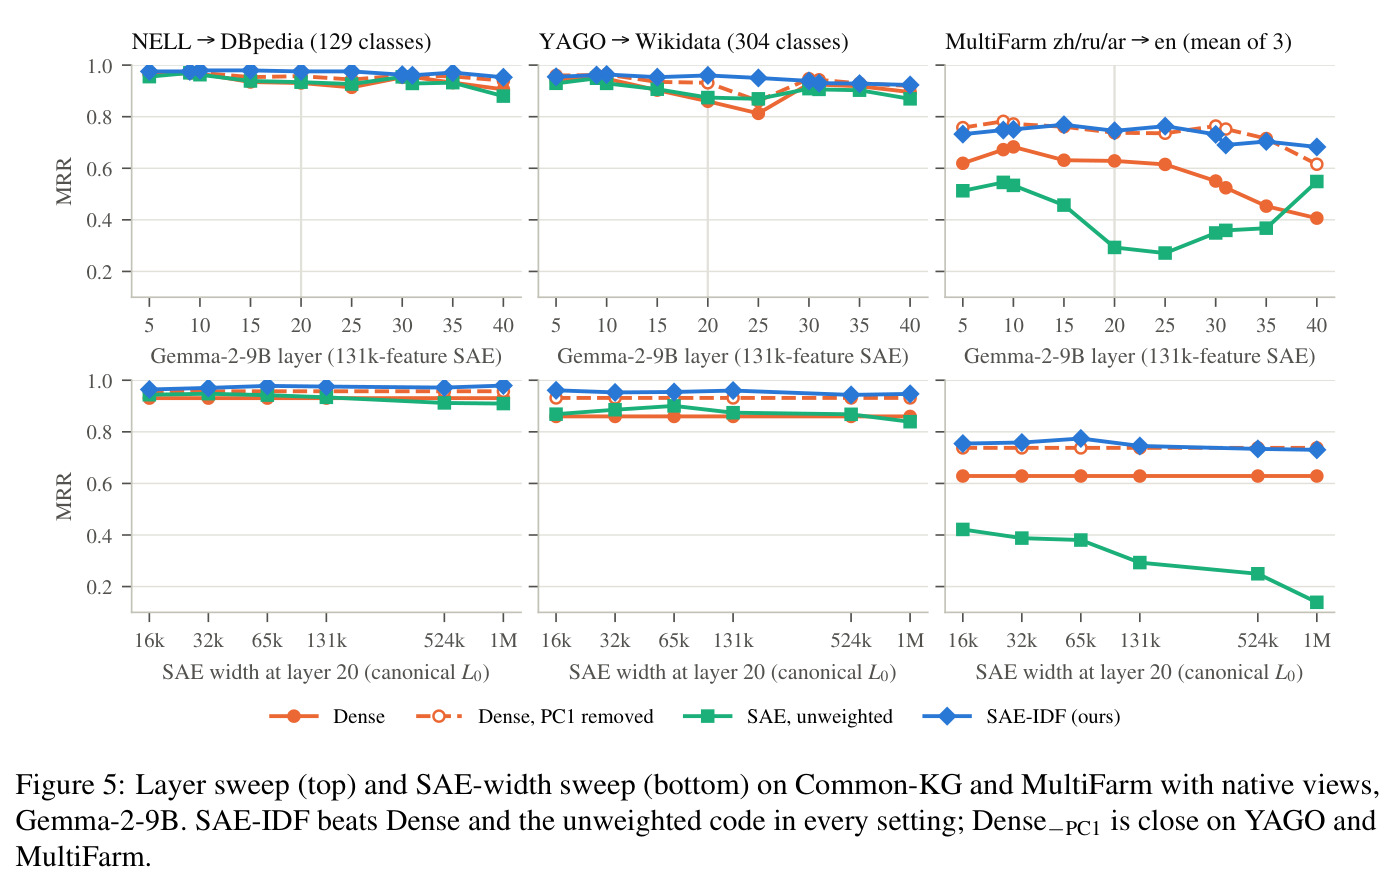
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Lean 4 → Metamath(形式数学定理检索,Gemma-2-9B) | MRR | 0.661 | 稠密隐藏状态 0.210;最佳训练检索器 Qwen3-Emb-8B 0.972 | 对稠密 +0.45(约 3.1 倍),但落后可能有预训练记忆的训练检索器 |
| Lean 4 → HOL Light(Gemma-2-9B) | MRR | 0.898 | 稠密 0.539;字符串基线 0.741 | 对稠密 +0.36,对字符串 +0.16 |
| YAGO → Wikidata(知识图谱对齐,Gemma-2-9B) | MRR | 0.962 | 稠密 0.860;Dense-PC1 0.932 | 对稠密 +0.10,且超过所有检索器列 |
| MultiFarm 中文 → 英文(跨语言本体匹配,Gemma-2-9B) | MRR | 0.754 | 稠密 0.650;词符 TF-IDF 仅 0.230 | 对稠密 +0.10,对字符串 +0.52 |
| Valentine 表模式匹配(Gemma-2-9B) | F1 | 0.614 | 稠密 0.533;Dense-PC1 0.534 | +0.08;MRR 0.856 对 0.766(+0.09) |
| Bio-ML NCIT → DOID(生物医学本体,Gemma-2-9B) | MRR | 0.817 | 稠密 0.701;BGE-M3 0.611 | 对稠密 +0.12,超过所有检索器列 |
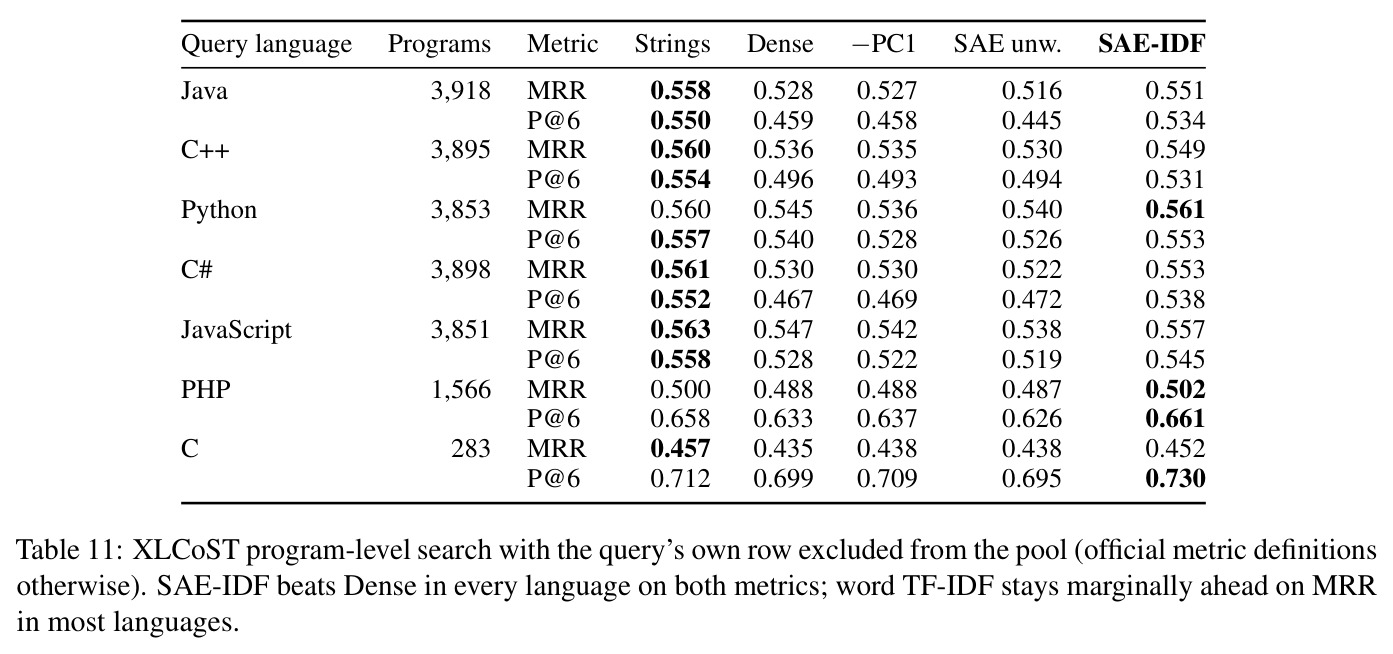
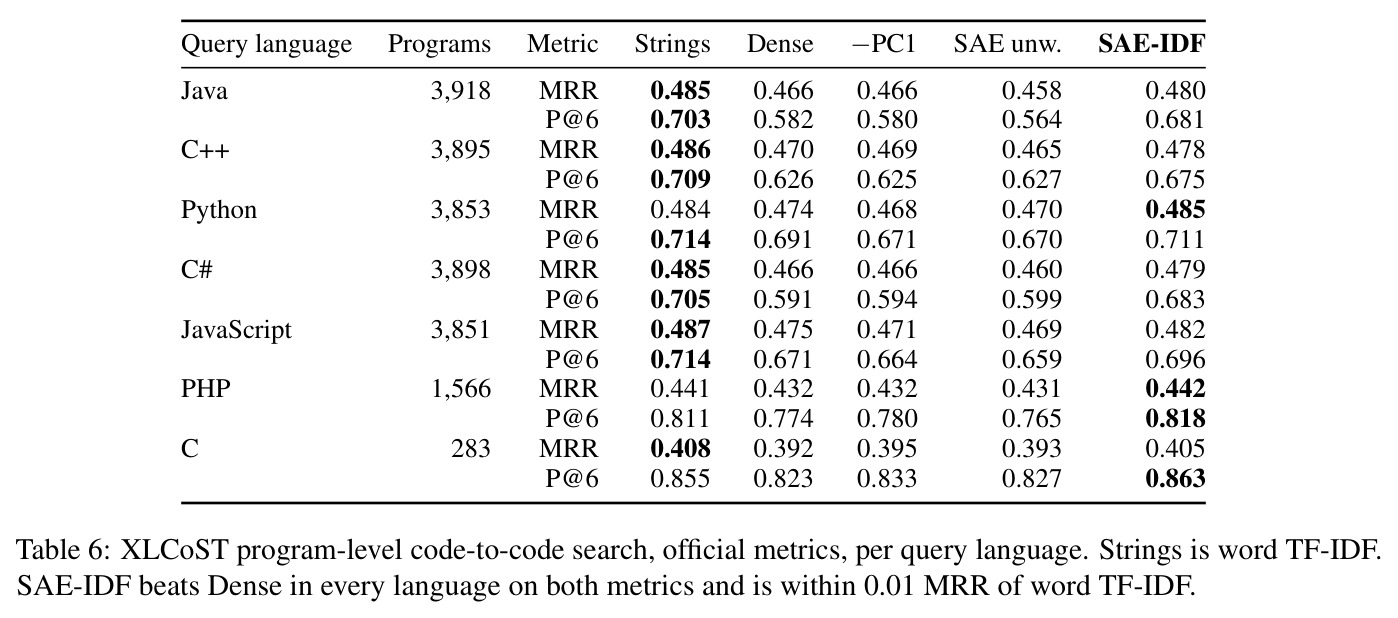
| XLCoST 七语言均值(代码搜索,Gemma-2-9B) | P@6 / MRR | 0.732 / 0.464 | 稠密 0.680 / 0.454;词 TF-IDF 0.745 / 0.468 | P@6 +0.05;MRR 仅 +0.01,共享标识符时字符串基线仍略优 |
局限与改进
作者坦承的局限:其一,方法的通用性受制于基座模型对记号的阅读能力——在 PubChem 的 SMILES、IUPAC、InChI 三种记号上所有方法都接近随机水平(最高 0.029 MRR,随机 0.0075),没有原生上下文的 ICD 编码和药名被直接放弃;其二,主表协议是给定候选池的检索,真实合并管道还需决定一个符号有多少对应物,基于余弦边距的弃权只覆盖「确有对应物」的查询,无对应检测未测试;其三,比较对象是表示而非专用流水线,不声称在任何基准上 SOTA,训练检索器在形式数学上大幅领先(0.97-0.99 MRR),且不排除其记住公开对齐语句的可能;其四,IDF 依赖参考集合的选择,在 Metamath 上候选池 IDF 得 0.661、独立采样的库内定理 IDF 只有 0.588,这一敏感性被列为声明性局限。我自己的观察:XLCoST 上方法几乎不占优(MRR 落后词 TF-IDF 约 0.005),说明当两个系统天然共享标识符这类表层特征时,概念特征无从发力;Llama-3.1-8B 上有 4 行落后于 Dense-PC1(如 Anatomy 0.844 对 0.871),优势对模型家族并非完全稳健;另外每个符号都要跑一次 LLM 前向加 SAE 编码,候选池大时代理成本远高于一次性稠密向量检索,论文没有报告端到端延迟和索引方案。
独立分析的弱点
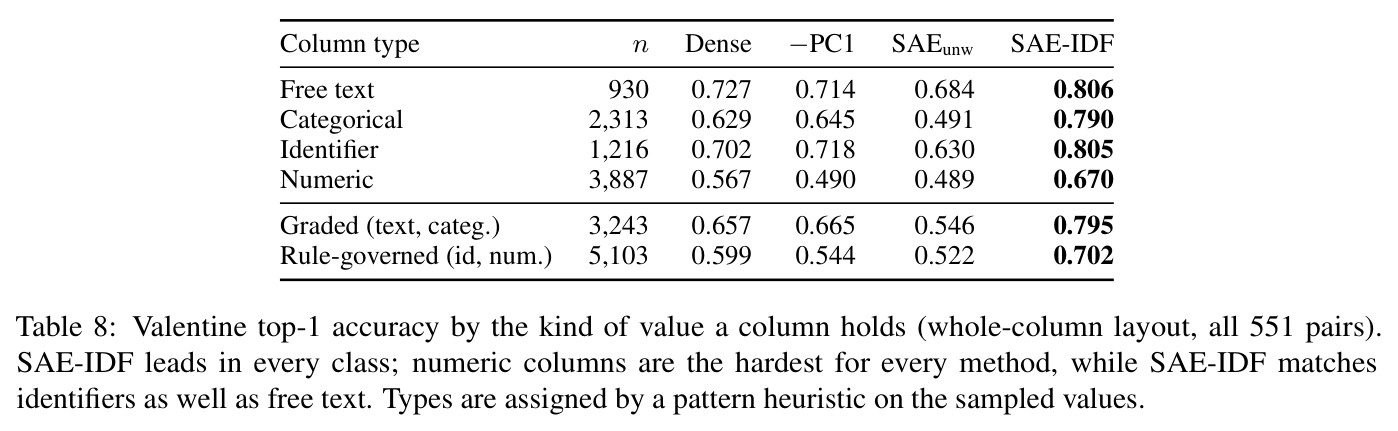
独立分析几个弱点。第一,表层特征对冲:当符号系统的记号天然共享(XLCoST 七种语言共用变量名和标识符)时,IDF 把稀有概念提上来也无济于事,方法只剩 +0.01 的边际甚至输给词 TF-IDF;改进方向是把字符级/词级稀疏特征与 SAE 概念特征做混合加权,让两套证据按任务自适应融合。第二,数值内容是盲区:Valentine 按列类型拆分后,自由文本、分类、标识符列的 top-1 达 0.79-0.81,数值列只有 0.670,因为裸数字几乎不激活概念特征;改进方向是按论文自己的假设引入规则组件(范围、单位、分布检验),这正是一个神经+符号混合匹配器的天然分工界面。第三,IDF 的参考集合敏感性:Metamath 上候选池 IDF 与库内 IDF 相差 0.07,而 Pile 密度 IDF 直接崩到 0.190,实践者若拿不到干净的候选池会踩坑;改进方向是研究更稳健的加权(论文中 information 加权在本体和表格任务已接近最优)或自适应估计参考分布。第四,检索式协议回避了真实对齐的难点:一对多、无对应、全局一致性只在小规模四证明助手合并试验中初步触及,且依赖「互为 top-1」这一强条件;改进方向是把边距弃权与全局结构约束(图匹配、传递性校验)结合,并测试「检测无对应符号」的能力。第五,工程成本:每个符号需一次 LLM 前向加 SAE 编码,虽然可以预计算成稀疏向量后用倒排索引检索,但论文未讨论索引与规模化的路径,落地前需要补上这部分。
未来方向
作者指出的方向:构建真正的合并管道——决定符号对应物的数量(无、一、多),在传递性约束下合并多个系统并以全局一致性为准绳评估,而不仅是成对检索;把规则与神经表示的分工形式化(Table 8 显示数值列最弱、正适合规则接管,这暗示一个分层神经符号匹配器);利用 SAE 随模型缩放的红利——稀疏字典已在 frontier 模型上扩到千万级特征(Templeton et al., 2024; Gao et al., 2025),SAE-IDF 免费继承每次发布,HOL Light 上宽度从 16k 到 1M 的持续上升暗示更大模型加大字典的空间远未到头。基于成果可延伸的方向:其一,把「稀有概念共享」的具名证据用于数据清洗和知识图谱构建的人机协作界面,每次匹配自带理由,天然适合审计式审核与高风险资源(如生物医学本体)的人工复核;其二,既然坐标系共享,符号之间的关系(父类、逆关系、公理结构)也有望在特征空间对齐,可尝试跨系统的结构迁移和类比推理;其三,为模型读不懂的记号(SMILES、InChI)训练领域 SAE 或引入化学感知编码器,把方法推广到分子、蛋白质等非文本符号系统;其四,用这套坐标系反过来诊断稠密嵌入模型,量化不同检索器在「概念 vs 表层」维度上的偏向。
复现评估
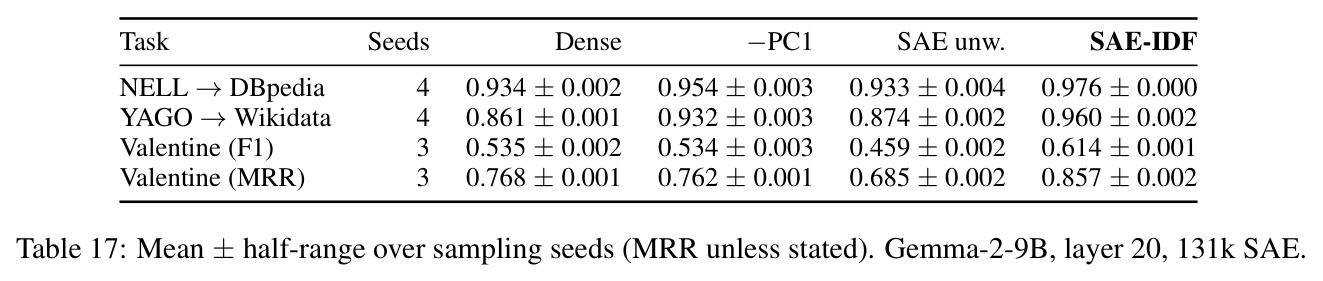
复现条件非常友好,是这篇论文对实践者最大的善意之一。所有组件都是公开现成的:Gemma-2-9B/2B/27B 与 Llama-3.1-8B 权重、Gemma Scope 与 Llama Scope 的 JumpReLU SAE(含逐特征阈值和规范发布文件)、Neuronpedia 的特征自动解释,以及 miniF2F、XLCoST、Valentine、OAEI Common-KG、MultiFarm、Bio-ML、Anatomy 等全部基准及其官方评测代码与协议。算力门槛低:一张 48GB A6000 或两张 24GB A5000 即可跑 Gemma-2-9B 加 131k SAE(SAE 编码器仅约 0.9GB bfloat16),Llama-3.1-8B 用单张 40GB A100,Gemma-2-27B 两张卡;文本截断到 1024 token,编码耗时从几分钟(miniF2F、Common-KG、MultiFarm)到几小时(XLCoST、Valentine),评分与全部统计分析(bootstrap、特征分解)在 CPU 完成。方法零训练、无超参搜索,主表每模型只有一个层、一个 SAE 文件。论文还做了种子稳定性检验(Table 17,均值波动在 ±0.004 内),并把 39 种消融配置、38 个规则选取案例的特征分解清单随代码发布。需要小心的只有两点:IDF 参考集合的构造(候选池与独立库会差约 0.07 MRR)和各任务视图模板的细节(附录 A)。总体判断:一名有 GPU 和基本工程能力的工程师一两天内可复现主表。
论文图表