先接纳、后取消:思考量如何让推理模型按字面义解读 some 与 or Entertain, then Cancel: How Thinking Makes Reasoning Models Read Some and Or Literally
固定权重只调思考量:思考让模型取消 some/or 的量级含义,先接纳实用解读、最终按字面作答。
前置知识
量级含义(scalar implicature)
说话人说「some students passed」时,听者通常推断「并非全部通过」。这句话在逻辑上与「全部通过」相容(some 只是 at least one),但按 Grice 的会话准则,若说话人知道全部通过就会说 all,所以听者从「所说」推出「所言」。some→非全部、or→非 both 是教科书级的量级含义案例。
本文的因变量就是模型选择这种实用解读还是字面解读:主指标 R 定义为 committed answers 中实用解读的比例,全文的每一个数字都建立在能区分这两种都被句子许可的解读之上。
广义与特设含义(GCI vs PCI)
Grice 区分广义会话含义(generalized,词语自带、除非语境阻止,如 some→非全部)与特设会话含义(particularized,只在具体语境中产生,如以「我戴了手套」回答「你留指纹了吗」表示否认)。GCI 近似默认推理,PCI 必须靠语境推断才能得到。
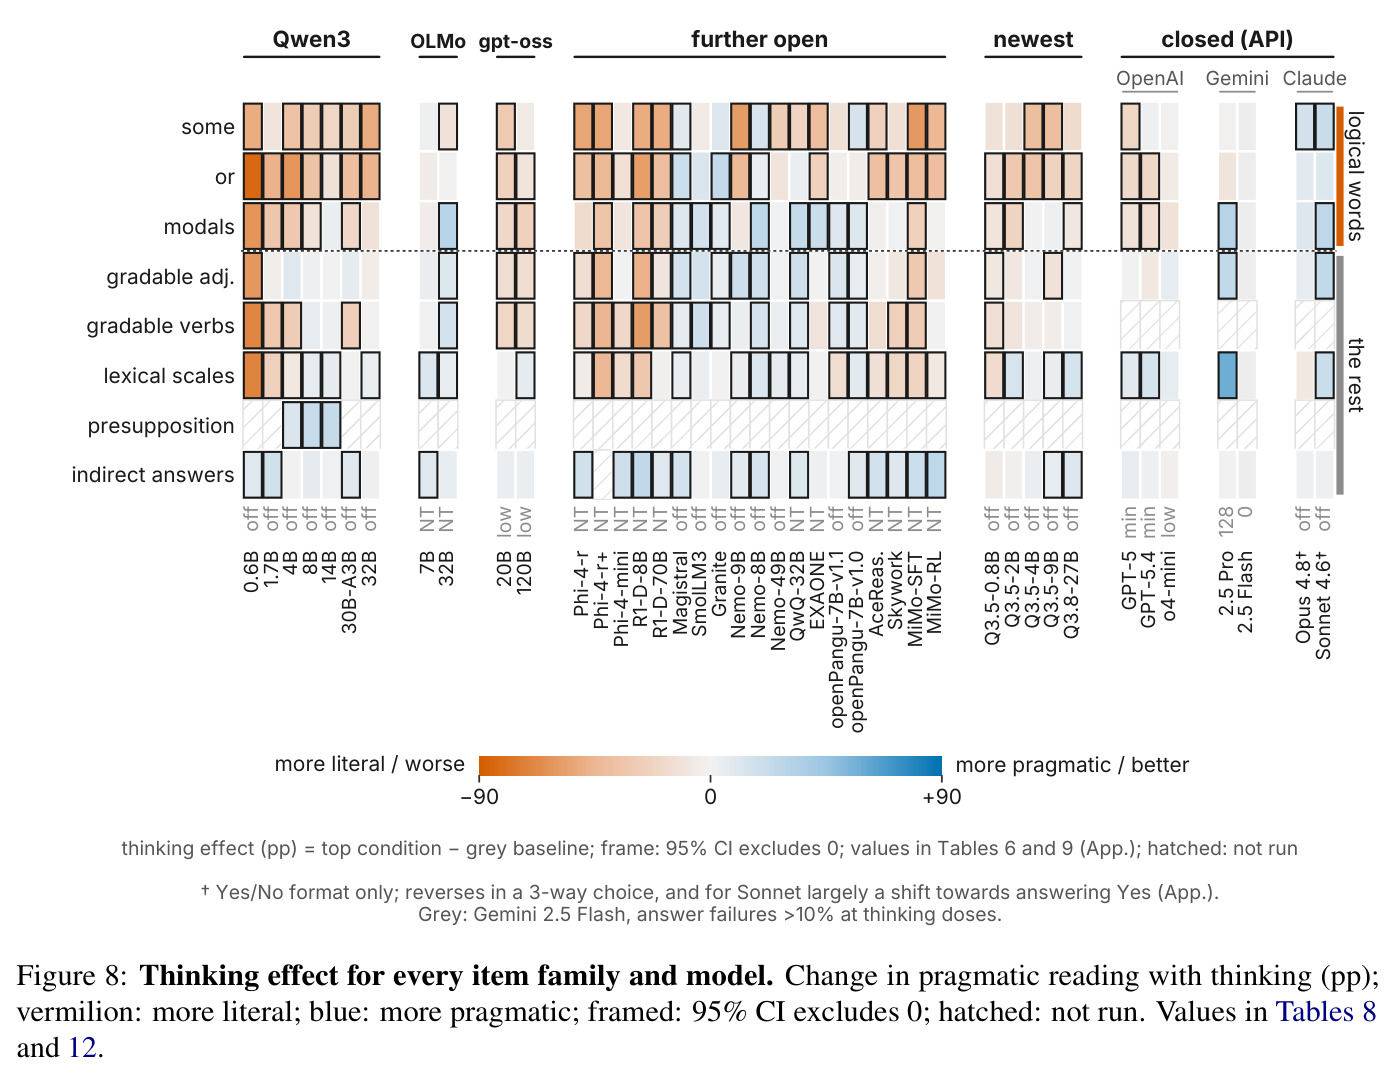
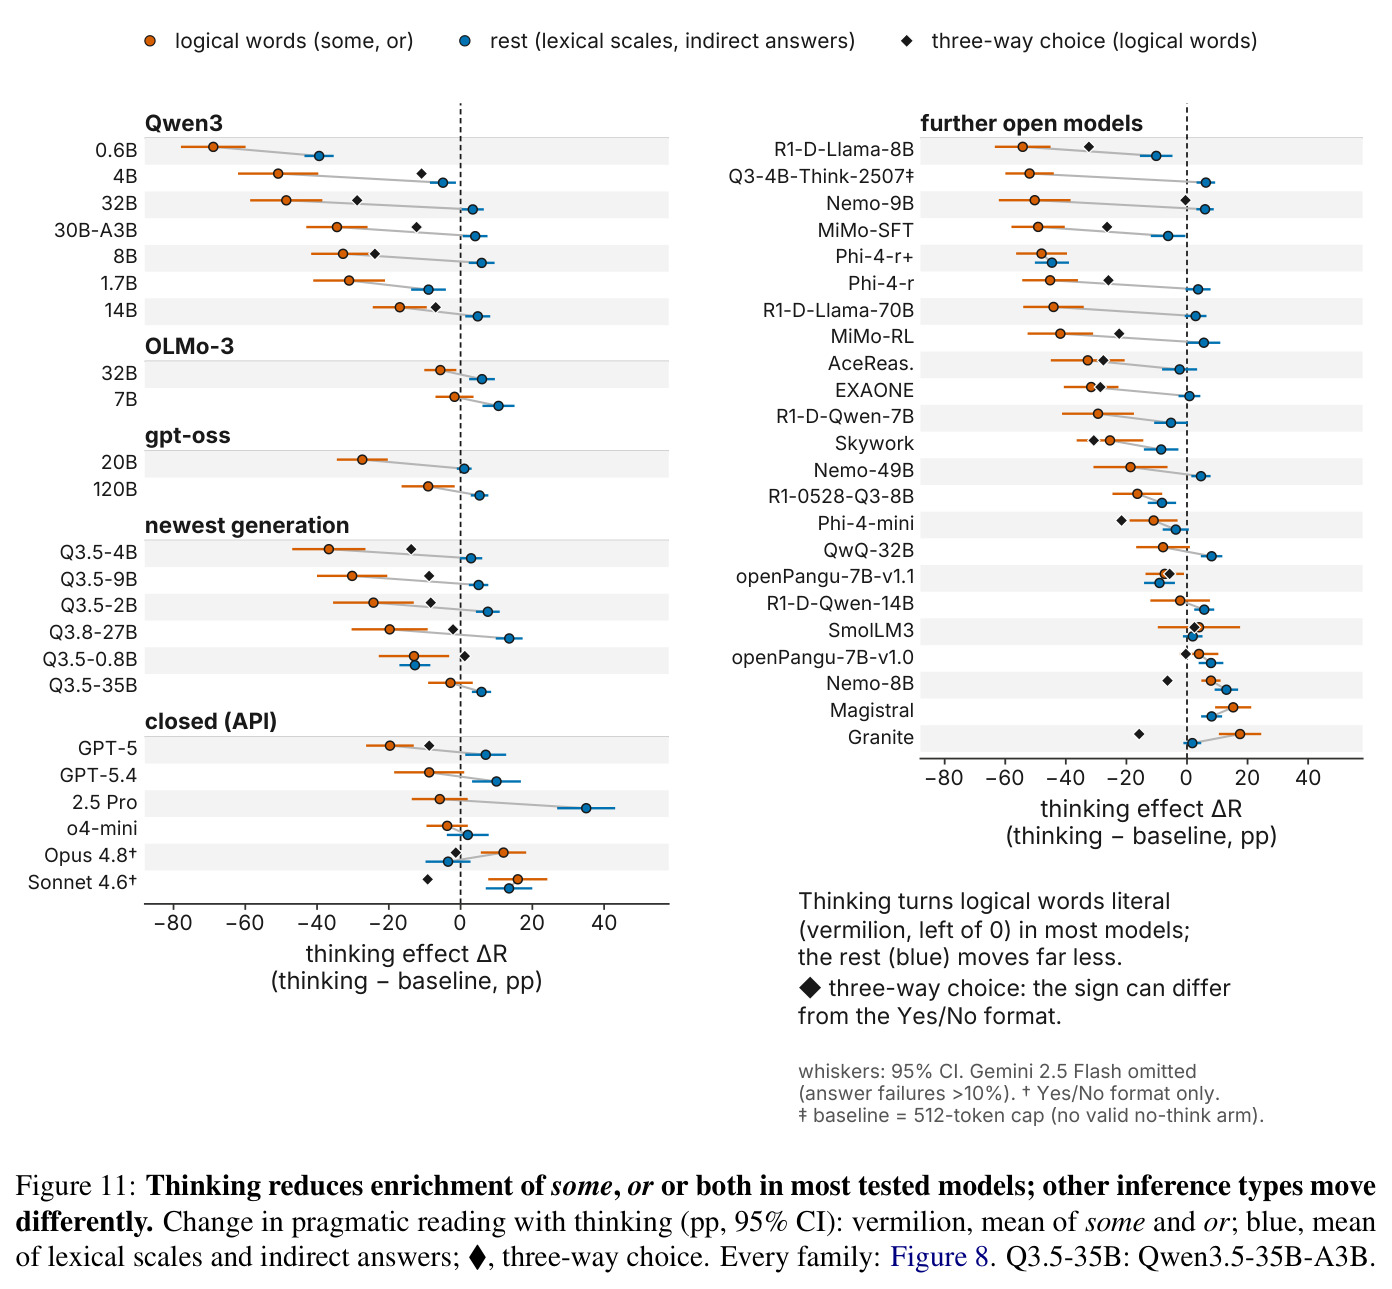
论文的核心发现是思考对两类含义的作用方向相反:GCI(some/or)被取消而 PCI(间接回答、比喻)反而提升。这一分离是支持 default-and-cancel 账户、反对单一努力账户的关键证据。
推理模型的可控思考(mode / budget / effort)
Qwen3 等混合思考模型提供思考开关(模板仅差一个空 think 块)、思考 token 预算上限,gpt-oss 提供 low/high 推理努力档位。用户可以在完全不改权重的情况下控制模型思考多少。
正因为思考是一个可调设置,作者才能像药物剂量-响应实验一样固定权重、只调「剂量」,把思考本身变成独立变量——这是全文实验设计的根基。
默认-取消账户 vs 努力账户
人类语用学两大竞争理论:努力账户(Sperber & Wilson 相关性理论)认为含义推导耗费加工资源,思考越多含义应越多(成人拒绝 underinformative 的 some 句更慢、时间压力下更少拒绝);默认-取消账户(Levinson)认为 GCI 默认产生,只有语境或真值核查反对时才被取消。
两种账户对「更多思考」的预测方向相反,本文全部实验就是为区分它们而设计的(预注册 7 组假设)。结论偏向默认-取消:思考花在严格蕴含核查上,取消了 GCI。
迹前缀干预(trace-prefix diagnostic)
把模型自己生成的思考文本在每 t∈{0,32,...,2048} 个 token 处截断、强行闭合思考模板,再强迫模型给出答案,观察所选解读 R(t) 随前缀长度的变化。这是对推理迹的干预操作,而非读取隐藏状态的探针。
它把「解读何时从实用转向字面」定位到迹内部,直接产生了「先接纳后取消」这一核心发现,也衍生出取前 128 token 答案的推理时补救方法。
研究动机
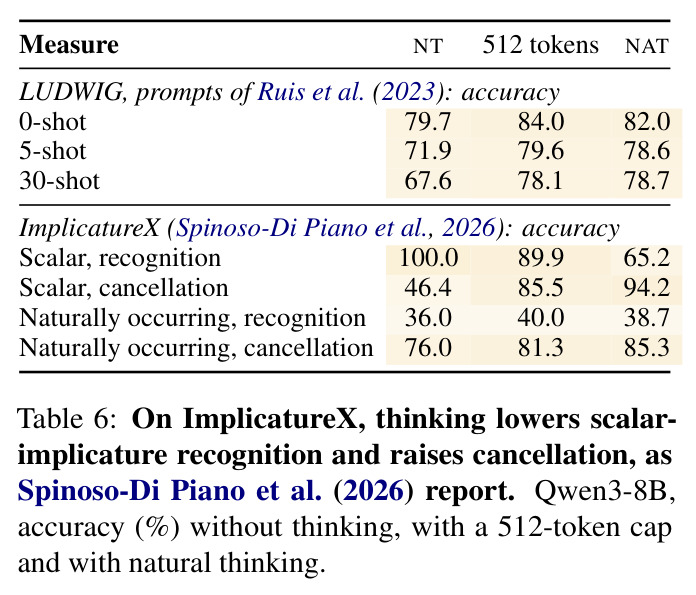
推理模型已把思考做成用户可控设置(开关、token 预算、努力档位),数学和代码上更多思考通常更好,但没人系统测过「多想」对日常语用理解的影响——即模型能否听出言外之意。现有评估都在固定设置下测准确率,而 some/or 的字面与实用解读都被句子许可,准确率无法区分「解读改变」和「能力丧失」。已有证据互相矛盾:CoT 提示提升含义解析(Kim et al. 2023;Ruis et al. 2023 中 CoT 让 GPT-4 在 LUDWIG 上达 86.5%,接近人类 86.2%),但也被观察到「鼓励字面解读」(Park et al. 2024);更多思考降低心智理论准确率(Gong et al. 2026);ImplicatureX 上 Qwen3 思考模式在单一 512-token 预算下识别更少量级含义(Spinoso-Di Piano et al. 2026),但无置信区间、未当作思考效应分析。实际风险很具体:默认开思考的助手会把「some of the tests failed」理解成允许「全部失败」,给用户技术上正确但答非所问的回复。
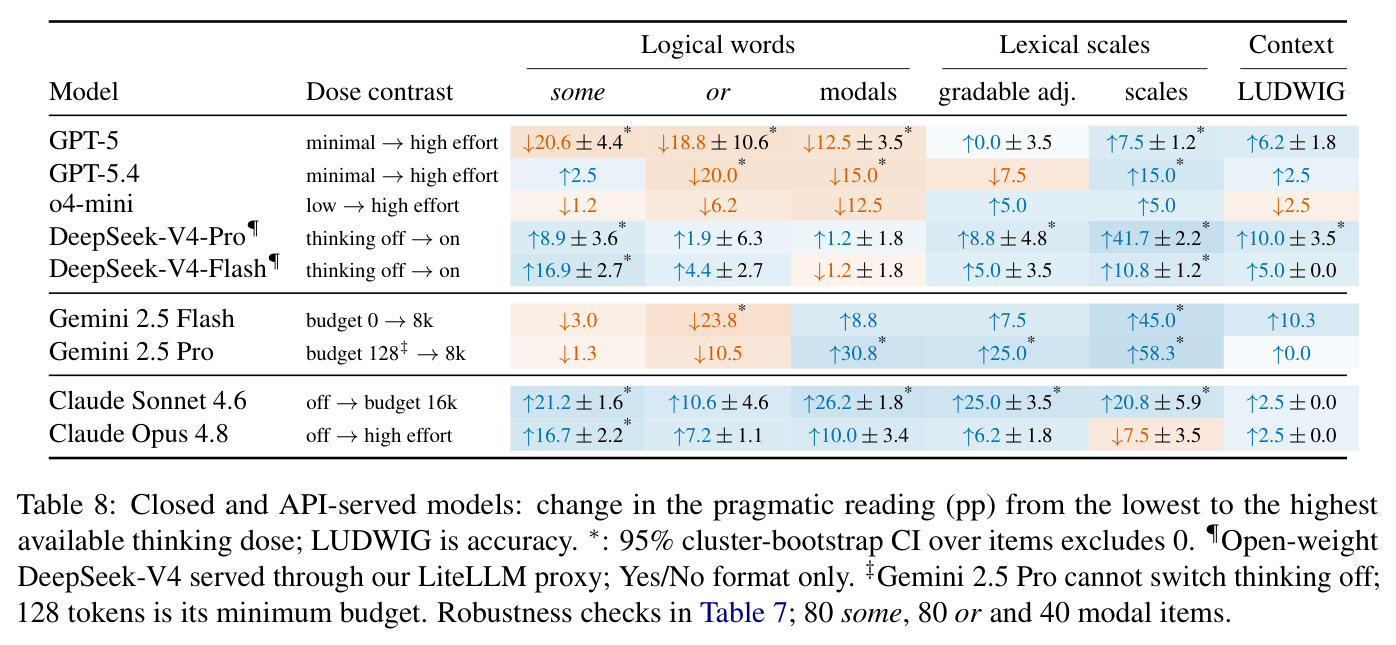
本文的目标是本文要在权重完全固定、只改变思考剂量的条件下回答四个问题:一是量化模型对同一句话所选解读如何随思考量变化(剂量-响应);二是区分 logical words(some/or/情态动词)、词汇等级(good/excellent)、预设与语境驱动含义等不同现象类;三是在模型自己的思考迹内定位解读翻转发生的位置;四是沿 base→SFT→DPO→RL 检查点谱系找出字面默认产生于哪个训练阶段,并探索不重训的推理时补救。作者为此预注册了假设、阈值与判伪条件,在 40 个开源推理模型和 7 个闭源模型(GPT-5、Claude、Gemini、o4-mini、DeepSeek-V4 等)上系统测量。
与已有工作不同的是,本文的独特切入有三点。其一,把思考预算当作受控剂量、权重固定的剂量-响应实验——此前工作要么只比较固定设置,要么用提示工程混淆了权重与提示。其二,迹前缀强迫作答诊断:在模型自己的推理文本上逐段截断后逼其表态,直接观察解读随迹位置的动态,而不是只看最终答案或隐藏状态,从而能说「思考使模型把逻辑词当逻辑读」是思考本身的效应。其三,同时按现象类(GCI/PCI/预设)分离效应、用预注册假设检验三个竞争理论账户(努力、默认-取消、能力放大),并系统性控制 Yes 偏置这一经典混淆(翻转问句、无极性三选一、去掉原句的 Yes 率探针),识别出 Magistral、Claude Sonnet 等模型「更语用」的表象其实是应答偏置。
核心方法
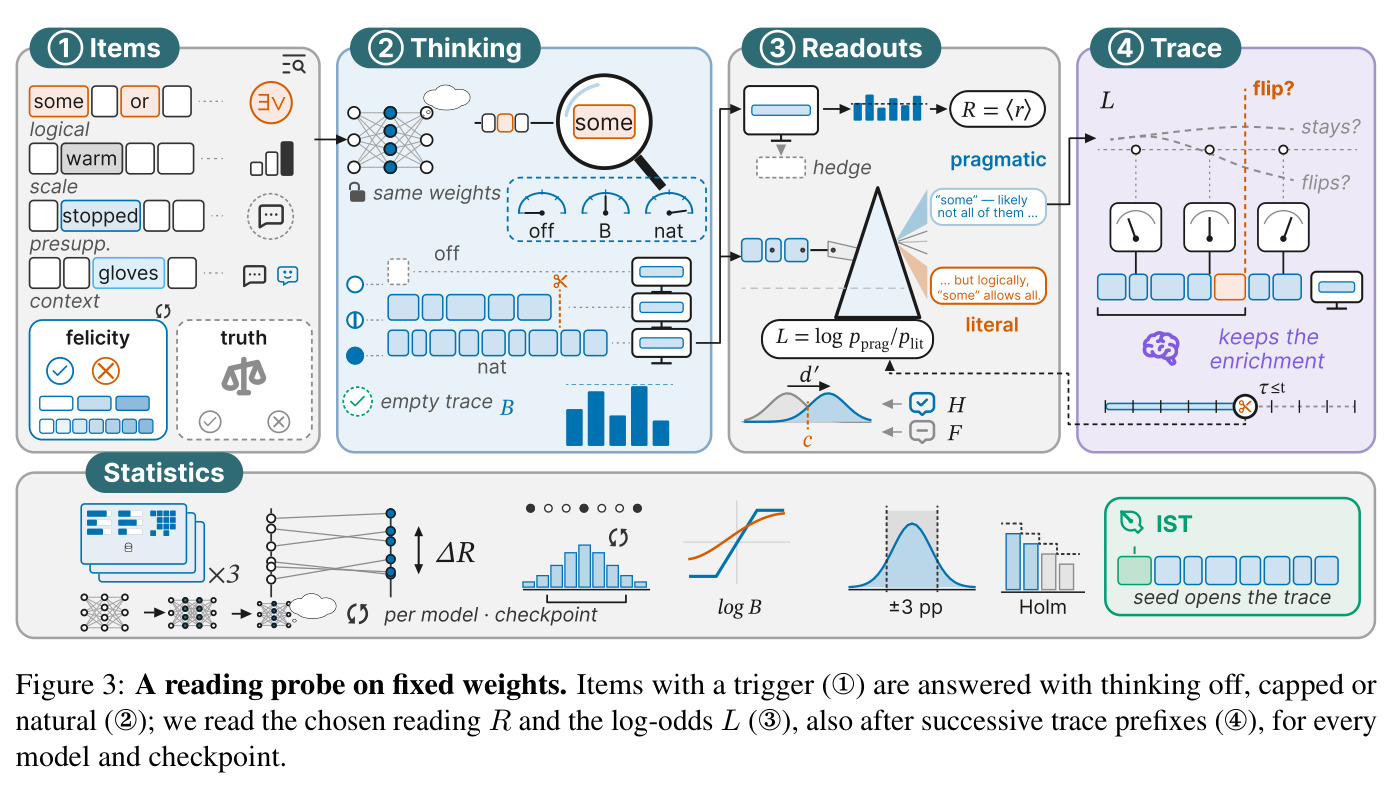
整体是一个「固定权重的解读探针」。直觉上,既然 some/or 的两种解读都被许可,就可以问模型「你是否得出说话人相信『非全部』」,看它选哪边;然后只动思考这个旋钮,比较不同剂量下的选择;最后在思考迹上逐点截断逼答案,看选择在哪一步翻转。技术路线分四步(Figure 3):①构造带触发词的题项与提问框架;②同一权重分别在思考关(NT)、封顶预算 B、自然停止(NAT,上限 8192 token)三种条件下作答,T=0.6、top-p 0.95、top-k 20、3 个解码种子,vLLM 服务于 H800;③读取所选解读 R 与不需解析答案的 log-odds $L = \log \frac{p(\text{pragmatic}\mid x_i, y_{ik})}{p(\text{literal}\mid x_i, y_{ik})}$,另有信号检测指标 $d' = z(H) - z(F)$;④在每个前缀 t∈{0,32,...,2048} 截断迹后重读 R 和 L,把每条迹标注为 entertain-then-cancel(早期前缀实用、最终字面)或 literal-throughout。统计上用按项聚类的 bootstrap 95% CI(1 万次重采样)、族内 Holm 校正、±3 pp 等价检验,标题数字均在 held-out 一半题项上计算。
核心创新是把「思考」从工程设置变成可操纵的实验自变量,并配上两个互补工具:剂量-响应剖面回答「思考量如何改变所选解读」,迹前缀诊断回答「解读在思考内部的哪一步翻转」。与已有工作的本质区别在于测量对象:ImplicatureX 只在单一预算观察到准确率变化、Gong et al. 只看心智理论准确率、提示工程工作混淆权重与提示——本文固定权重、区分现象类、干预迹本身,测的是「被许可的两种解读之间的选择」而非单正确答案任务的准确率,因此效应的方向本身就是理论证据。由此提出的 entertain-then-cancel 机制假说也来自数据:实用解读先在早期思考 token 中被接纳(小模型中甚至比不思考更强),随后被取消,最终答案回到字面——「模型先娱乐了这个含义,再把它取消」。
方法步骤详情
①题项与框架:逻辑词题来自 IMPPRES,词汇等级题来自带人类推理率的 scalar-diversity 集(van Tiel 2016、Gotzner 2018),预设题来自 IMPPRES 与 NOPE,特设含义来自 LUDWIG、PragMega、Fig-QA、PUB、Circa;另为本研究生成 Bott–Noveck 风格范畴句与 50 个说话人知识场景(双 LLM 评分器筛选加专家盲审,24 个场景盲审一致率 100%)。主框架问「你是否得出说话人相信第二句话为真」(实用=Yes、字面=No),另有三选一 NLI 格式(去极性)与真/假框架(逻辑模式对照);选项每 trial 洗牌;数据 50/50 分为开发/测试半。②思考操纵:NT 用模型自带开关;封顶预算 B∈{64,...,2048} 用 Qwen3 自带停句,并以纯闭合标签的 plain cap 排除「时间紧迫」线索;NAT 自然停止≤8192;无开关模型用 forced-empty 空思考块作基线;gpt-oss 用 low/high effort。③读取:$R_{mk}=\frac{1}{|I|}\sum_{i\in I} r_{imk}$,思考效应 $\Delta R = R_{\text{NAT}}-R_{\text{off}}$(百分点)。④迹诊断:对每条自然迹按前缀 t 截断、闭合、逼答案得到曲线 R(t);空前缀复现无思考基线(Qwen3-8B some 35.8% vs 38.8%)作锚定,且两端锚定保证测量有效。⑤统计与检查点:聚类 bootstrap CI、Holm 校正、logistic 回归(log 思考预算×现象类交互,按项聚类稳健误差);沿 OLMo-2/OLMo-3-Think、Tülu-3、Qwen2.5 蒸馏/零 RL 谱系逐阶段用 log-prob 打默认解读分。⑥补救:路由只读 prompt(问题模板与原句),标量题取前 128 token 前缀分布的答案(权重 w=1),其余题保持自然思考答案。
技术新颖性
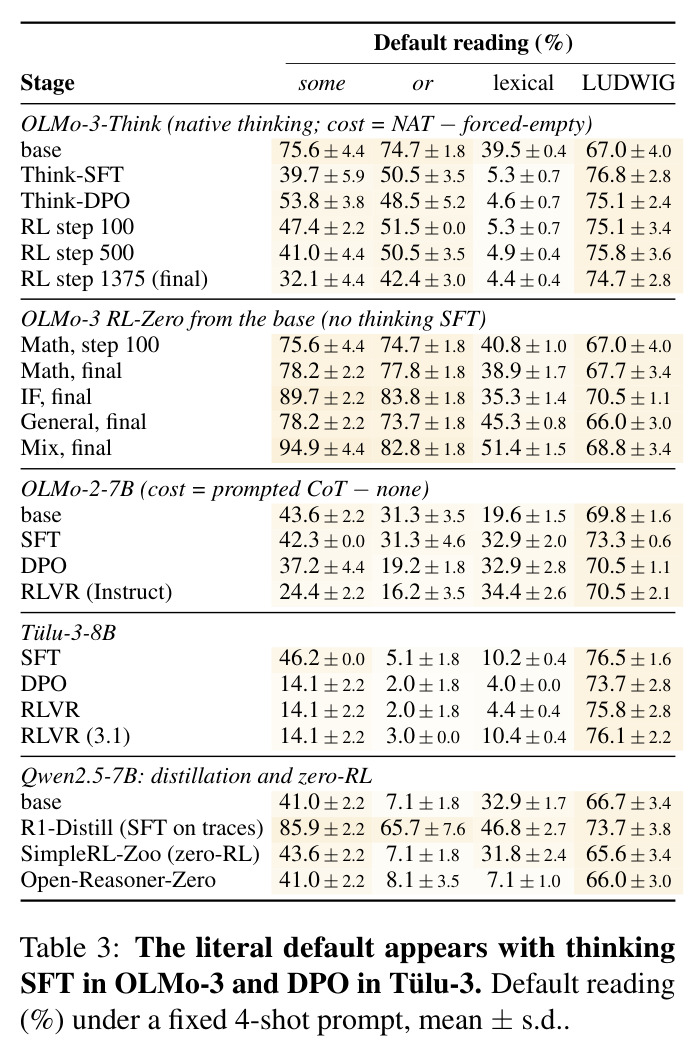
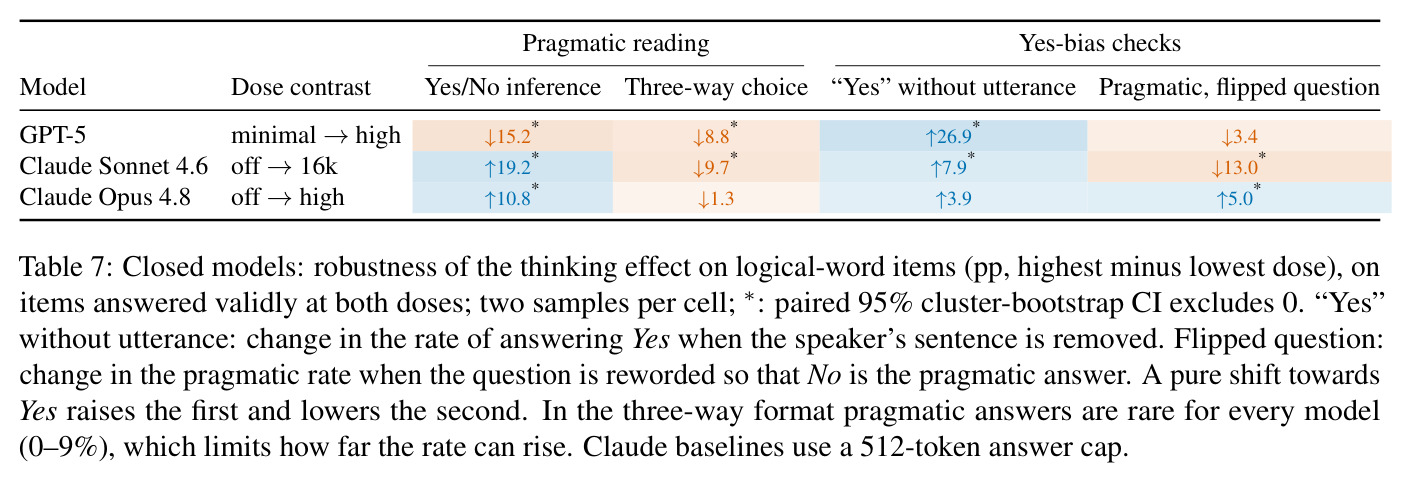
技术新颖性体现在四个层面。测量层面:首次把「所选解读」作为思考剂量的函数来测量,而非固定设置下的准确率,避免了解读变化与能力变化的混淆。干预层面:迹前缀强迫作答是对推理文本的因果式干预,与读取隐藏状态的探针互补,且两端锚定(空前缀复现无思考、迹末即最终答案)使测量可信。定位层面:检查点分析把 SFT/DPO/RLVR 各阶段与默认解读变化对齐,发现字面默认出现在 OLMo-3 的思考 SFT(75.6%→39.7%)与 Tülu-3 的 DPO(46.2%→14.1%),而非预注册假设的 RLVR——H3 结论为 mixed,这种诚实报告预注册失败的做法本身少见。控制层面:用翻转问句、无原句 Yes 率、无极性三选一三种手段系统排除 Yes 偏置,识别出 Magistral-Small(翻转后实用率降 52.9 pp)与 Claude Sonnet 4.6(三选一降 9.7 pp)的「更语用」其实是应答偏置;种子实验(IST)则显示迹的开头一句话就能部分恢复被取消的含义,说明选择对迹内容敏感而非纯粹的长度效应。
实验结果
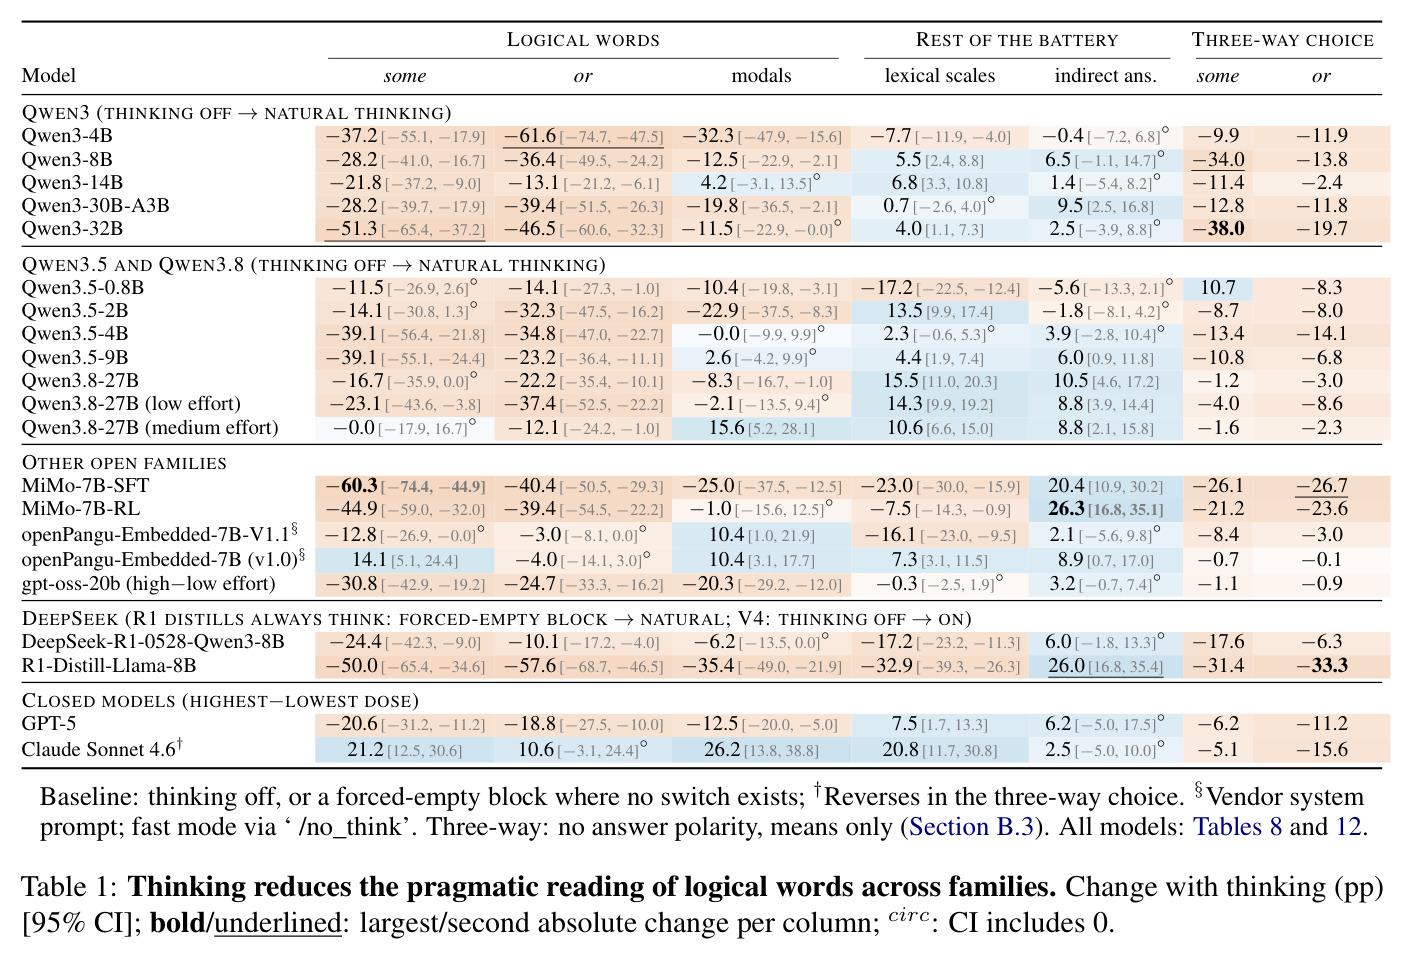
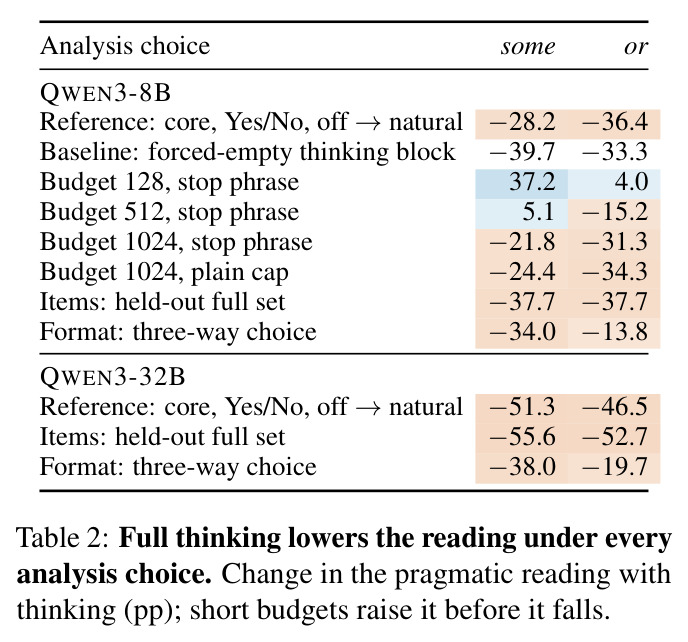
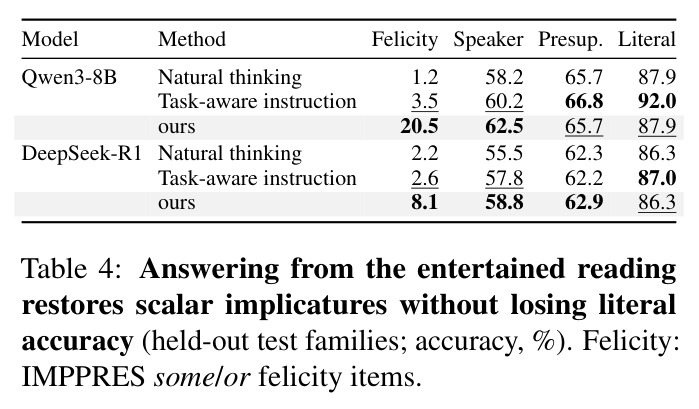
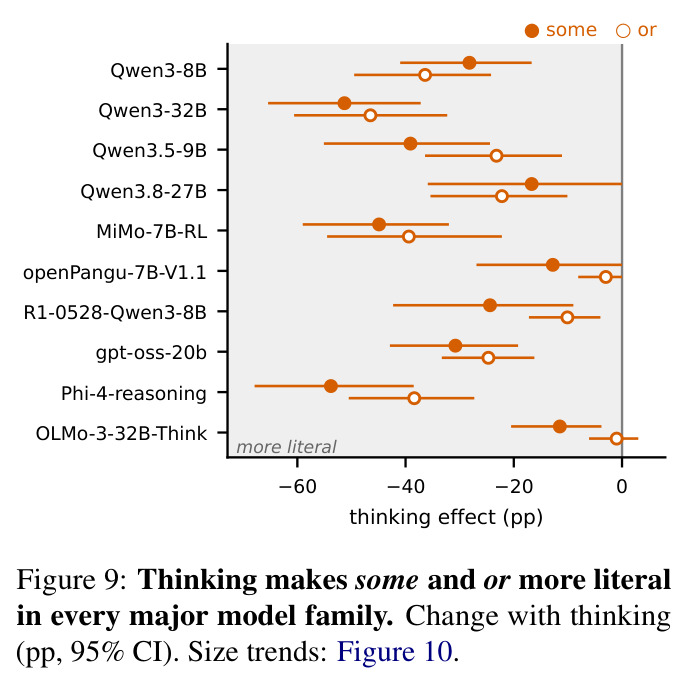
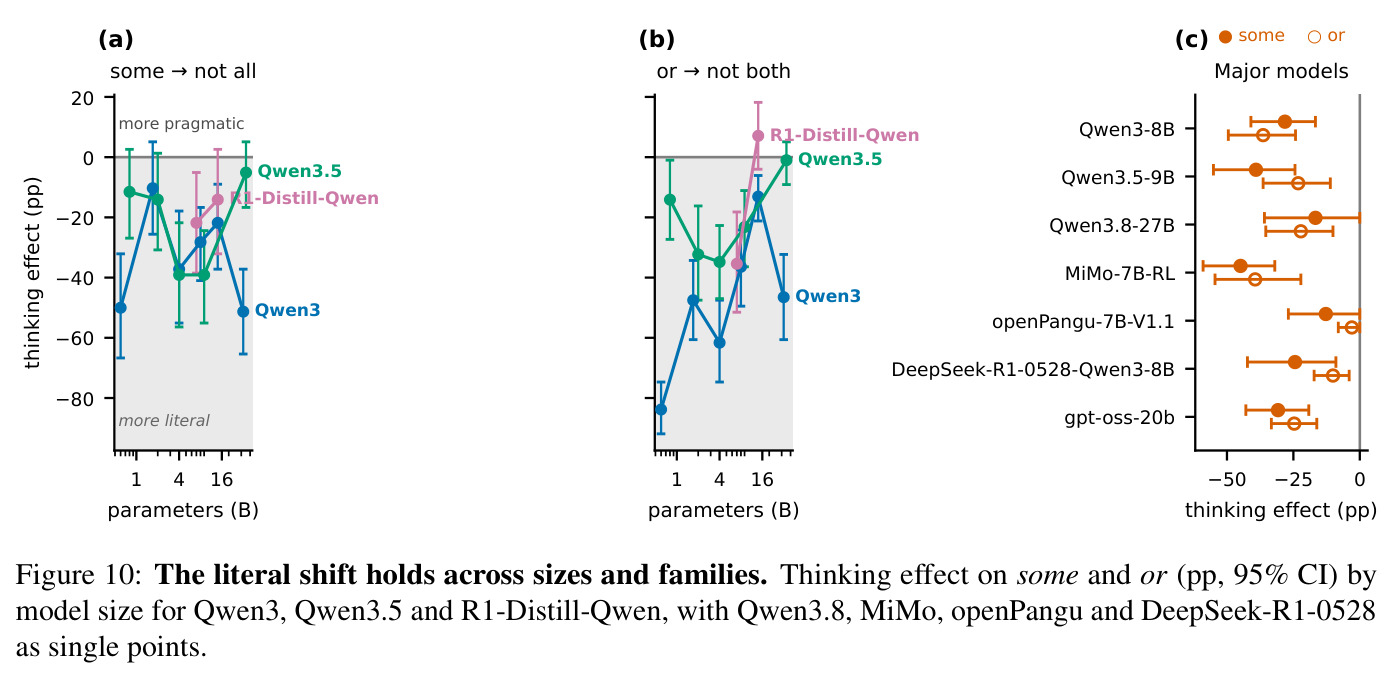
(1)思考取消 some/or 的含义:40 个开源推理模型中 30 个在通过预声明格式与极性检查后显著转向字面(4 个反向、1 个仅在 Yes/No 格式、5 个无显著变化),无极性三选一格式下 21/24 个模型转字面;GPT-5 high vs minimal effort 下 some −20.6 pp、or −18.8 pp、情态动词 −12.5 pp。Qwen3-8B some −28.2 pp [−41.0,−16.7]、or −36.4 pp;Qwen3-32B −51.3/−46.5 pp;gpt-oss-20b −30.8/−24.7 pp;R1-Distill-Llama-8B some −50.0、or −57.6 pp。全 held-out 集 48 个 some/or 位移中 47 个存活 Holm 校正;混合效应模型预算×现象类交互为负(Qwen3-8B:−0.063,CI −0.087 至 −0.039,p<.001)。反例同样有信息量:DeepSeek-V4 开思考反而更语用(V4-Pro some +8.9、词汇等级 +41.7 pp);Claude Sonnet 4.6 在 Yes/No 下 +21.2 pp 被证明主要是 Yes 偏置,三选一下反降 9.7 pp。(2)现象类分离:情态动词位移不一致(Qwen3-32B −13.6、Qwen3-14B +1.2、OLMo-3-32B-Think +29.7 pp);词汇等级在 ≥8B 的 Qwen3 随思考更语用(8B +5.5、32B +4.0 pp)而 4B 变差(−7.7 pp);预设准确率 Qwen3-8B +22.2 pp;语境驱动含义全面改善:Fig-QA +10.7、PUB +10.1(4B–32B 每档显著)、Circa +17.5、NOPE +9.9 pp,14 个受测模型无一显著变差。(3)剂量响应非单调:Qwen3-8B 的 some 在预算 128 token 时实用解读比无思考高 +37.2 pp,512 时 +5.1 pp,1024 时 −21.8 pp——先升后降。(4)迹内动态:Qwen3-8B some 空迹 35.8% → 128 token 52.0%(+16.2 pp)→ 迹末 1.1%;entertain-then-cancel 轨迹占 Qwen3 各模型/词的 41.4–68.1%(8B some 单迹 67.4%,literal-throughout 31.4%);Phi-4-reasoning 从 61.5% 跌到 9.0%,75.3% 轨迹先实用后字面。(5)训练起源:OLMo-3-Think 的 some 默认解读 75.6%(base)→39.7%(Think-SFT);Tülu-3 在 DPO 从 46.2%→14.1%;OLMo-3 RL-Zero 数学最终 78.2%(几乎不变);蒸馏反向:R1-Distill-Qwen-7B 从 41.0%→85.9%;OLMo-3 RL 过程中思考成本从 −32.1 pp 缩到 −2.6 pp。(6)补救有效且无害:只路由标量题、取前 128 token 答案,IMPPRES some/or 得当性准确率 Qwen3-8B 1.2%→20.5%、DeepSeek-R1-0528-Qwen3-8B 2.2%→8.1%,字面 gold 各层不动,合并分 +1.4 pp [1.2,1.6];对照的任务感知指令虽整体 +2.3 pp 却只把这两项提到 3.5%/2.6%。(7)稳健与复现:换停句方式(plain cap −24.4 vs 停句 −21.8 pp)、forced-empty 基线(−39.7 pp)、held-out 全集(−37.7 pp)、三选一(−34.0 pp)全部存活;ImplicatureX 识别 100.0%→65.2%、取消 46.4%→94.2%;机器翻译德语 −37.9 pp、中文 −17.1 pp(Qwen3-8B)。
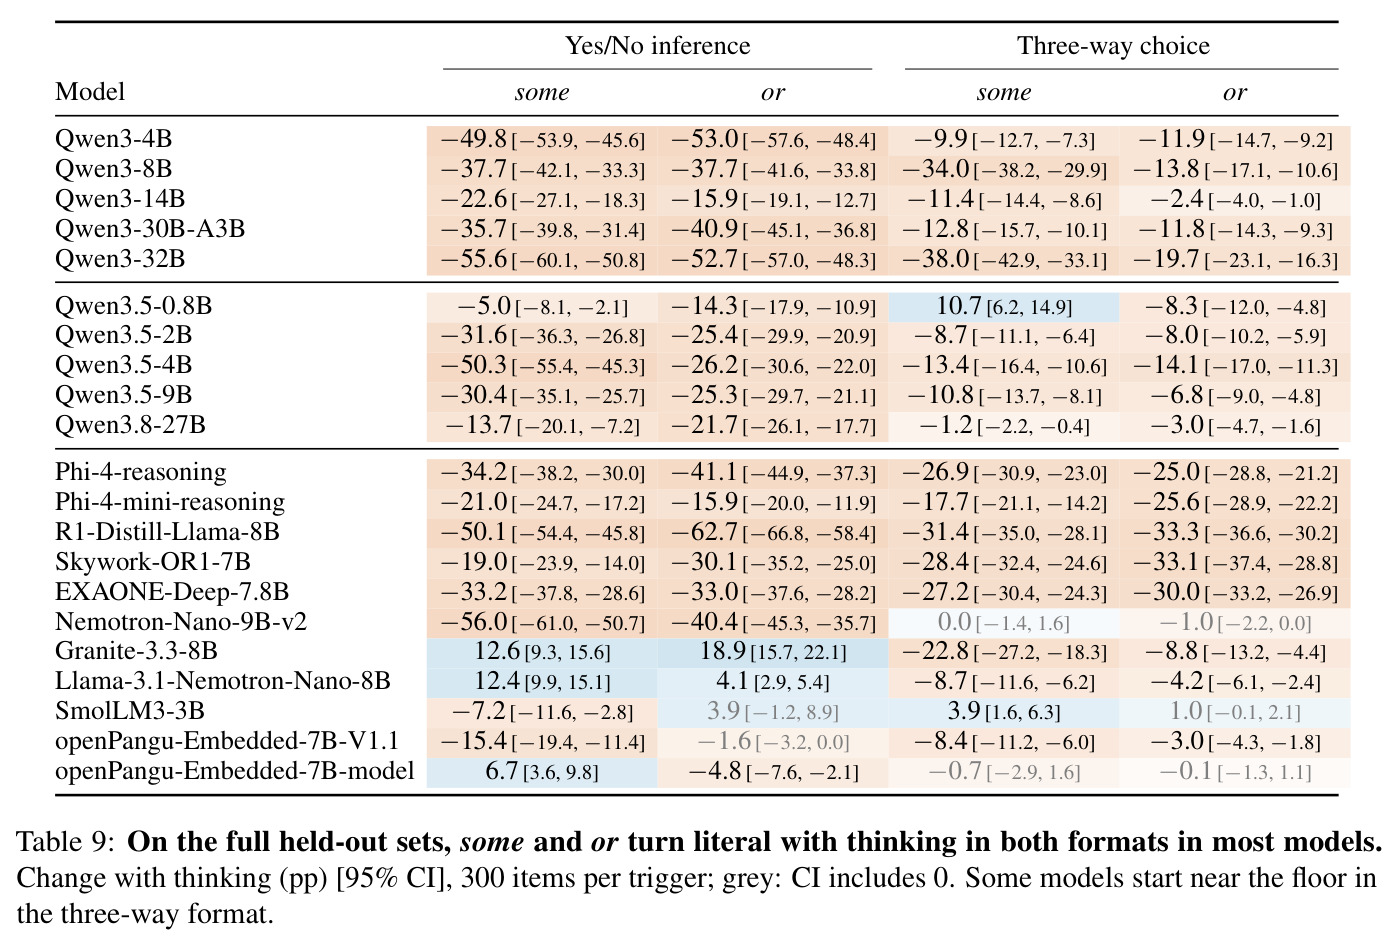
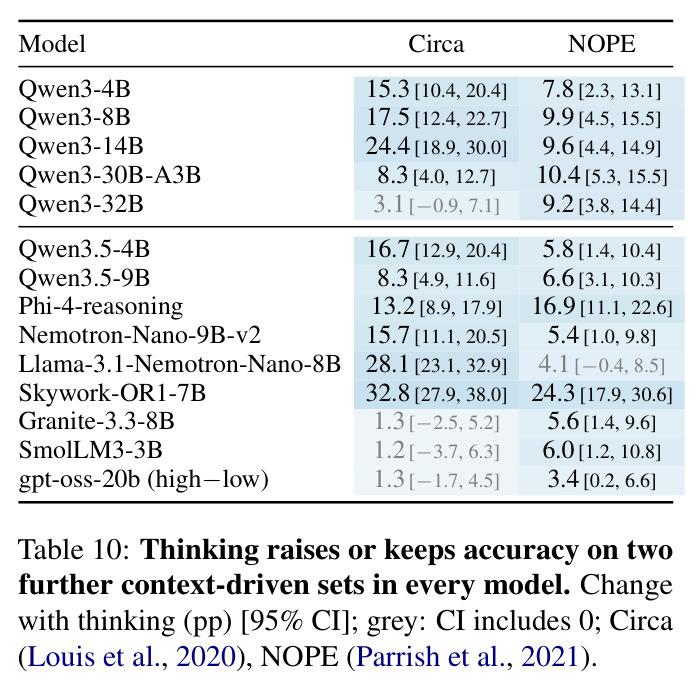
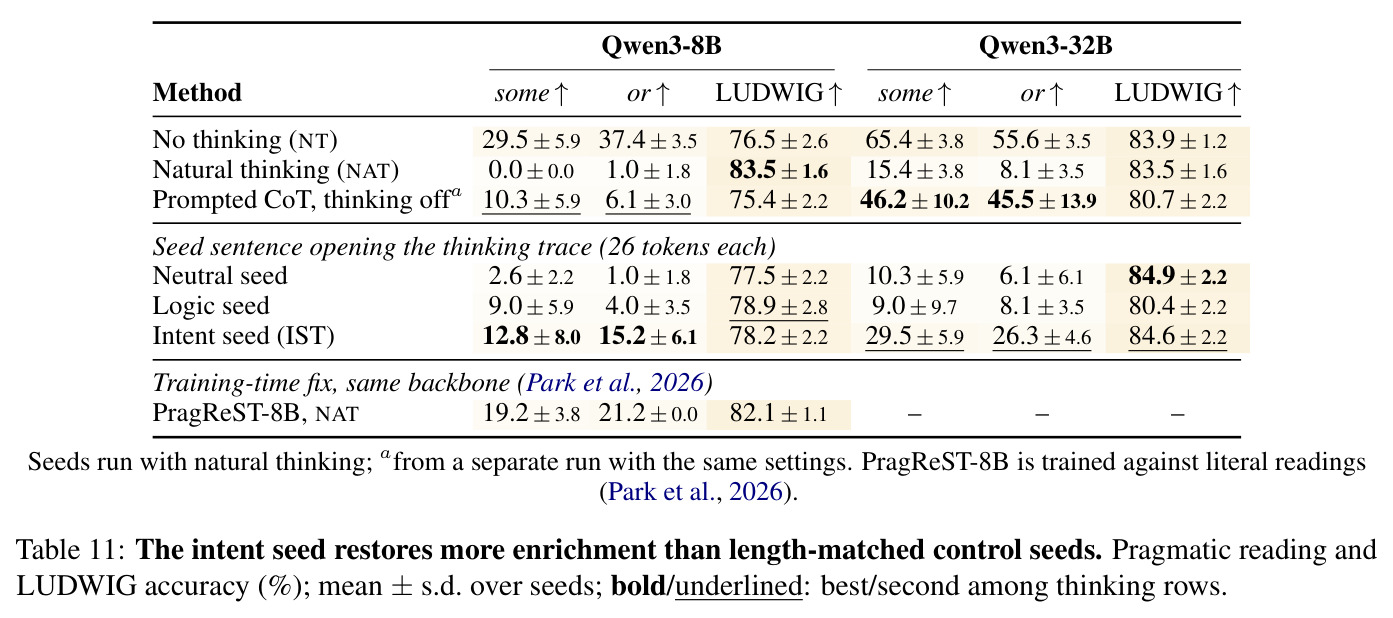
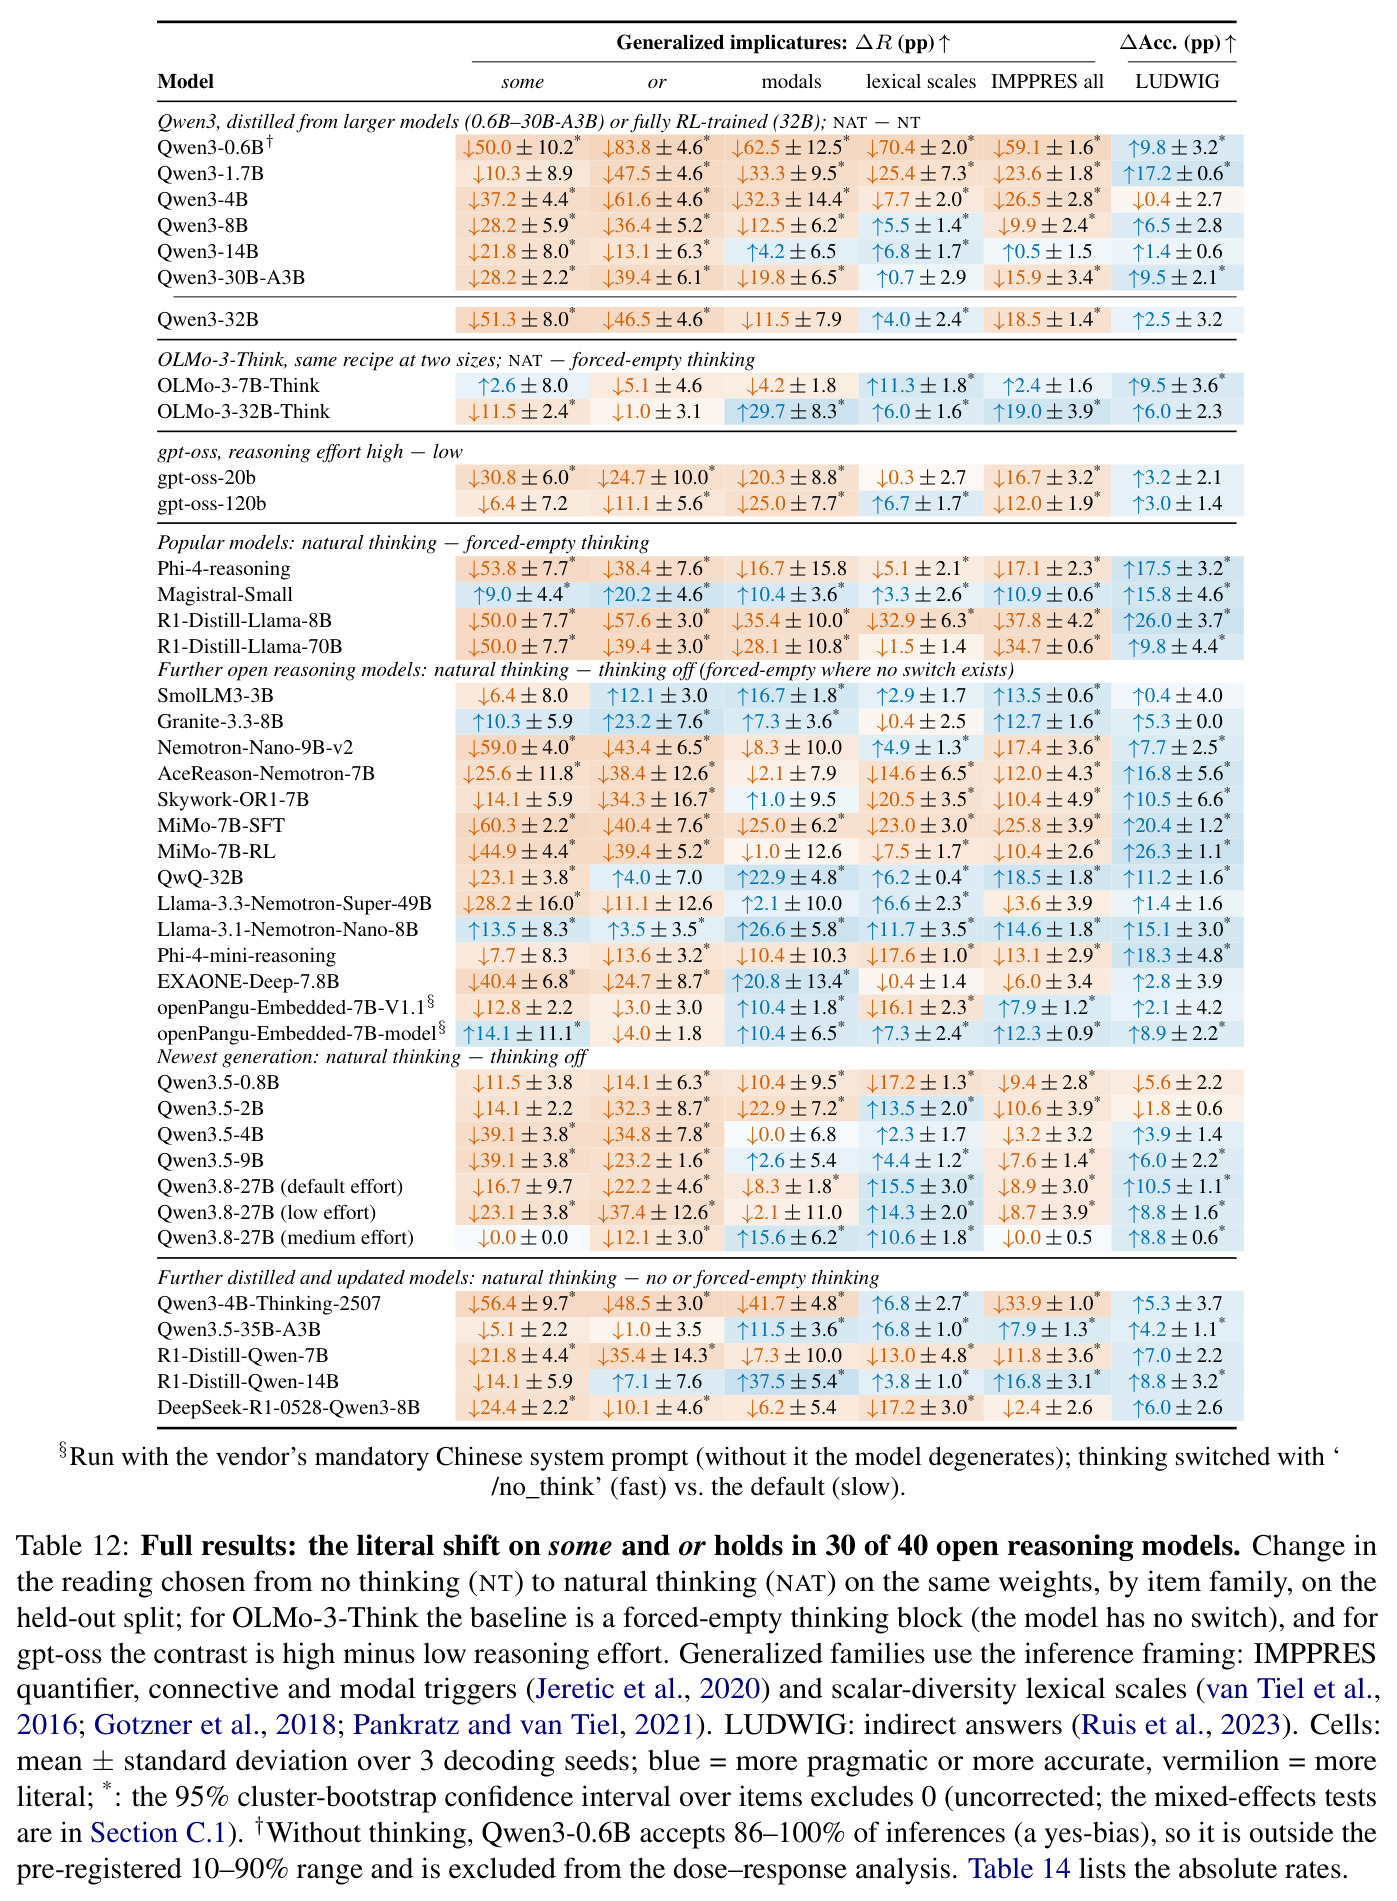
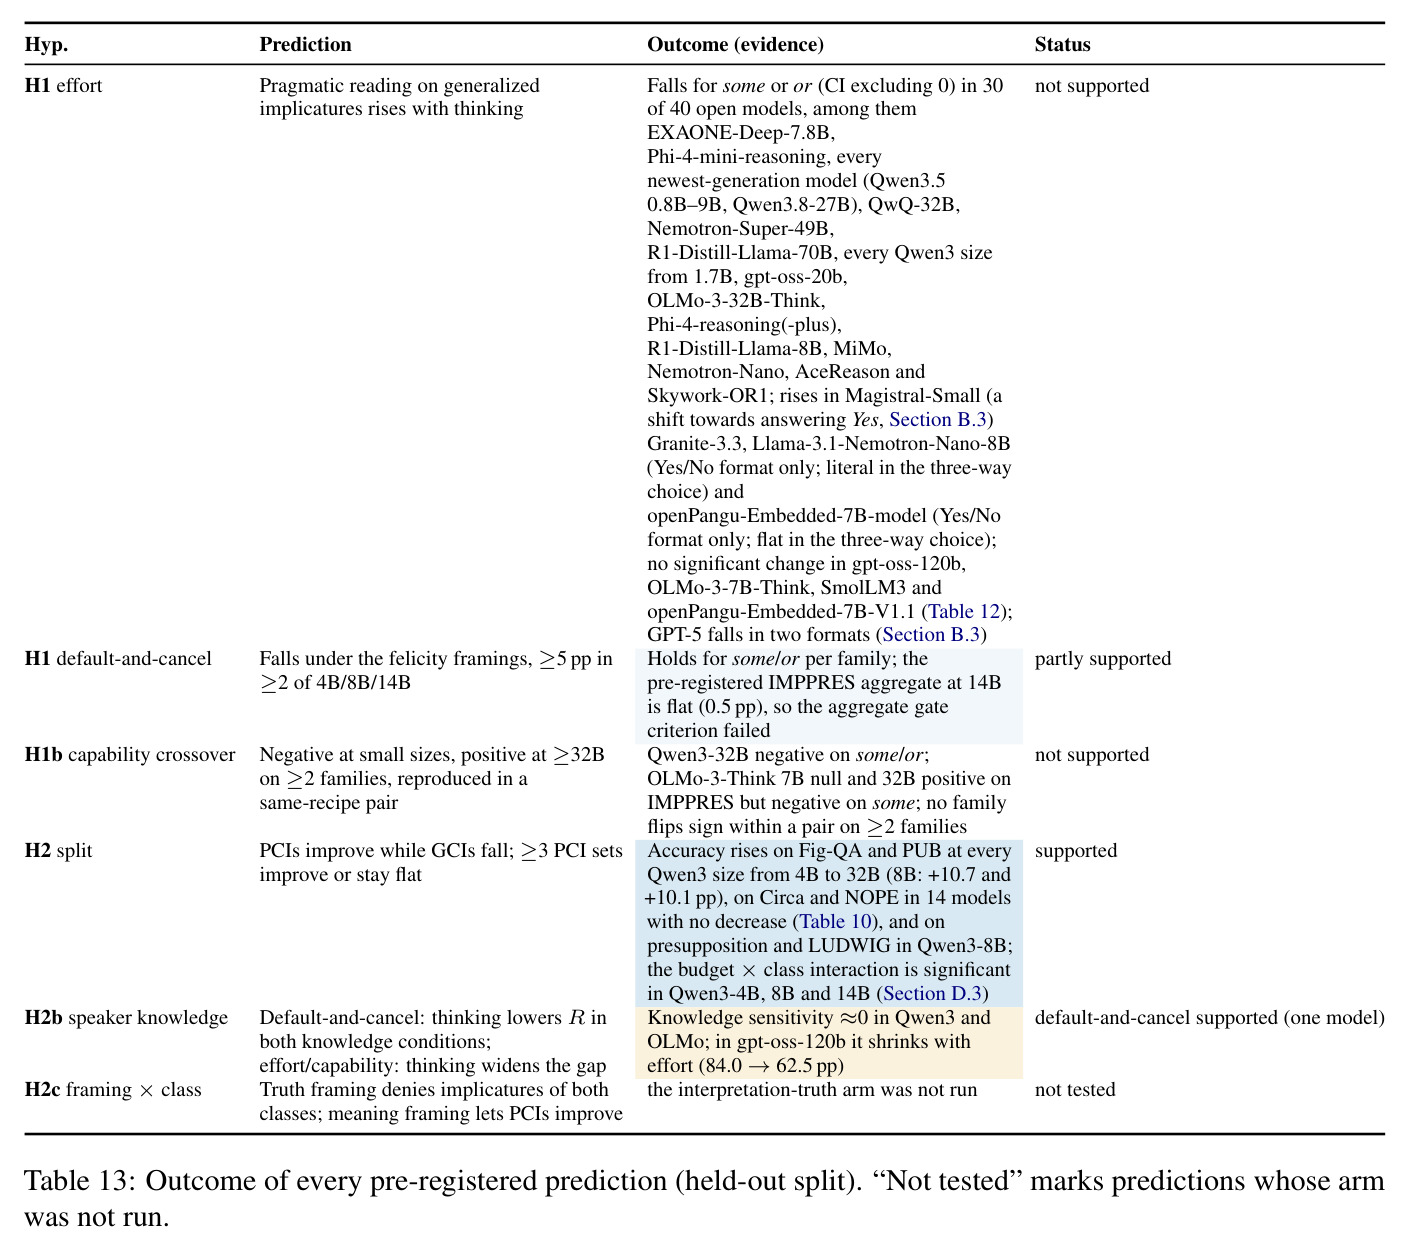
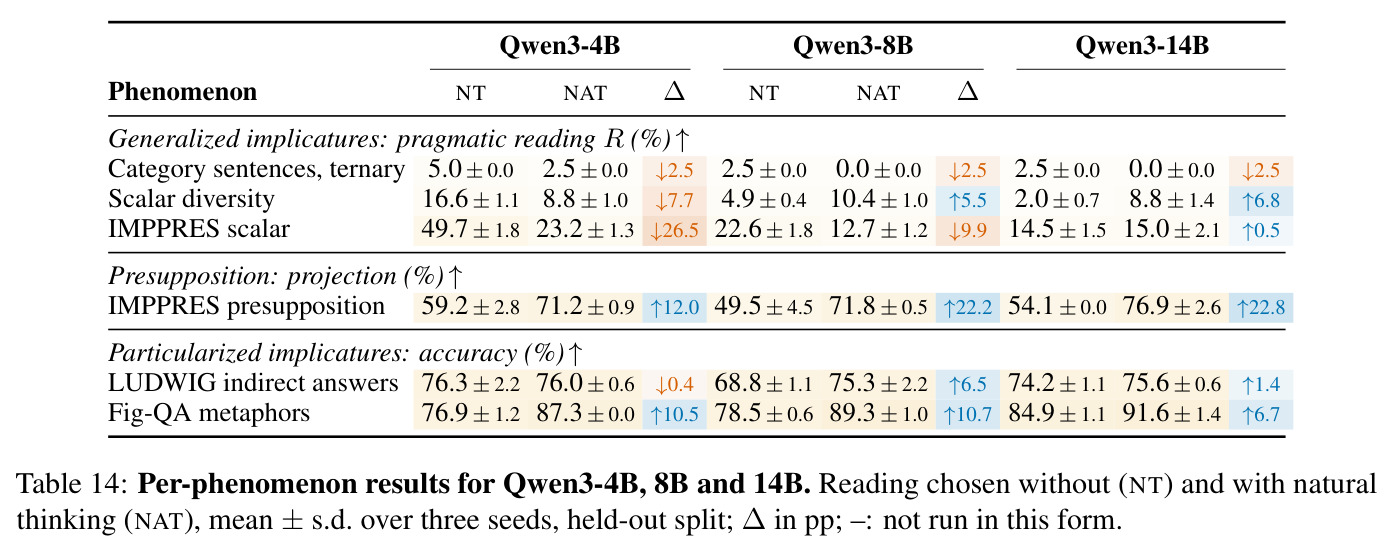
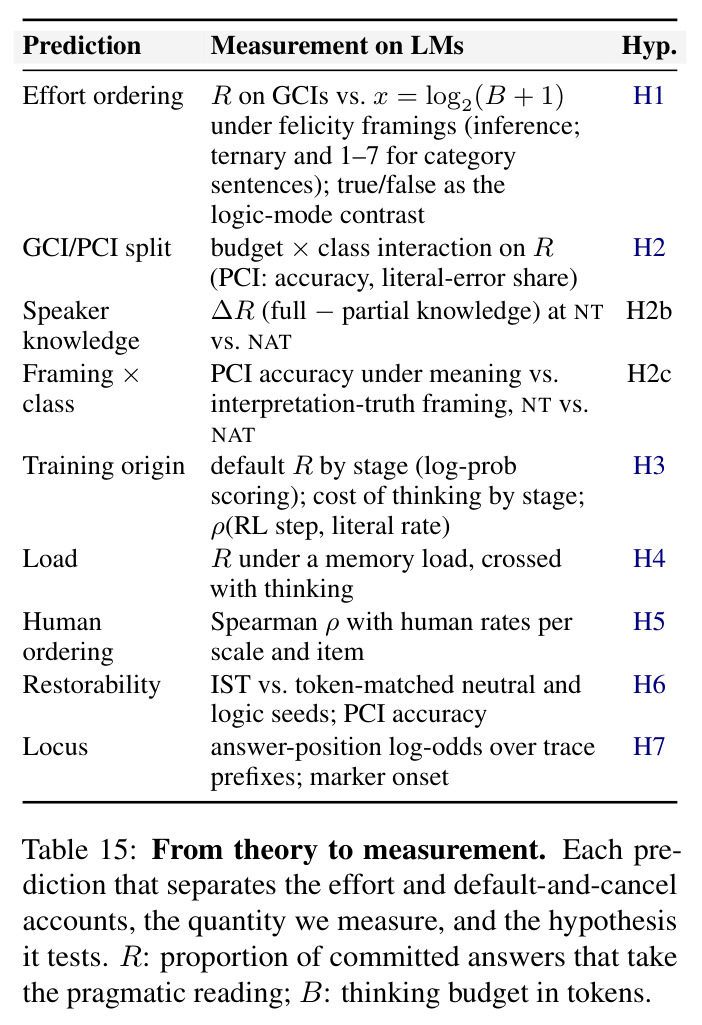
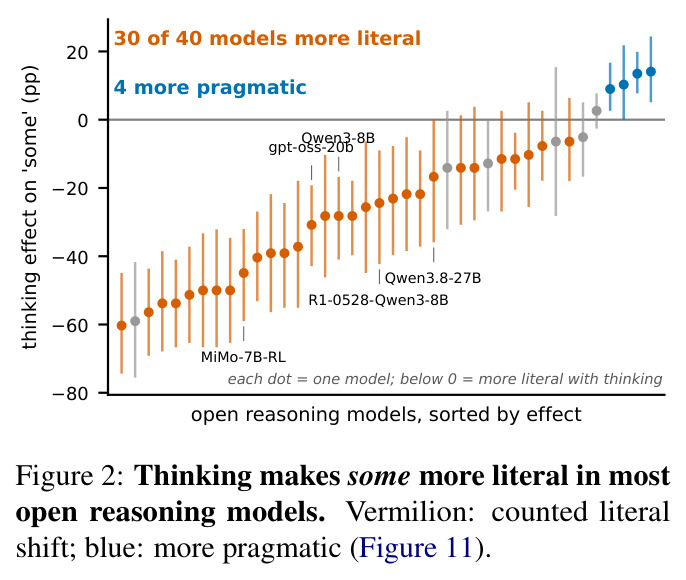
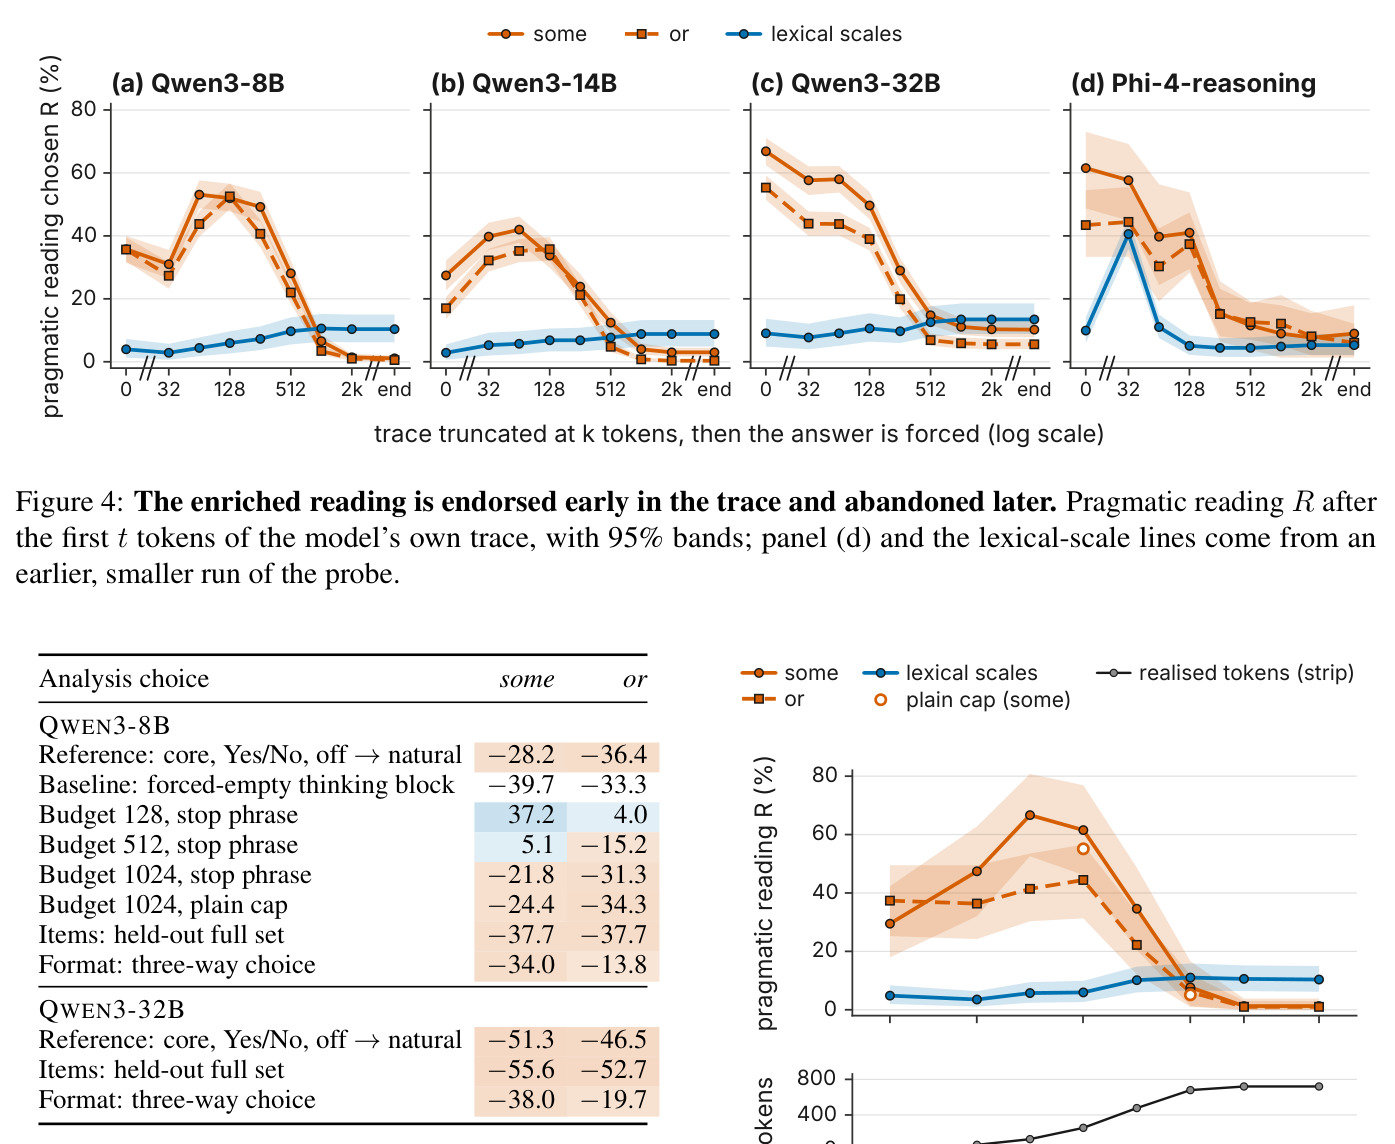
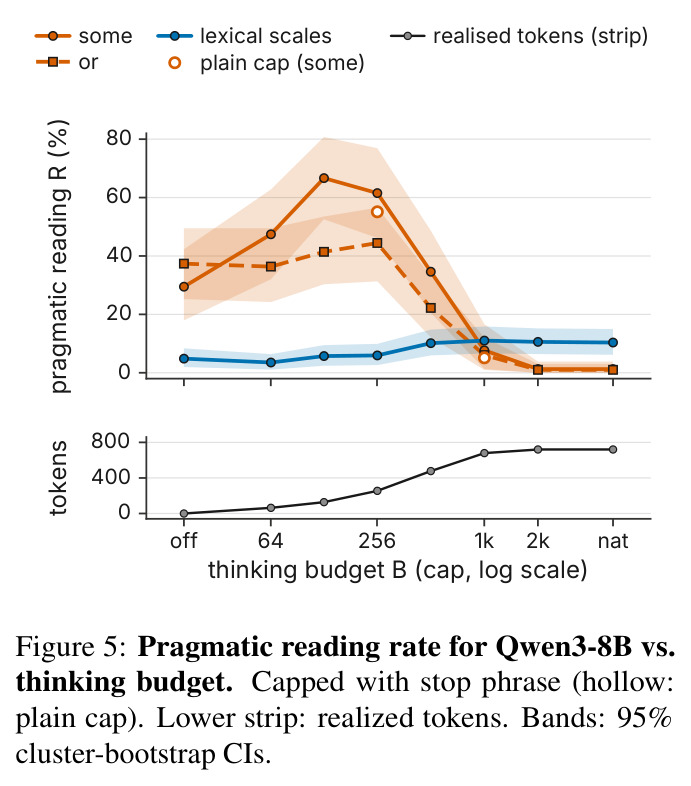
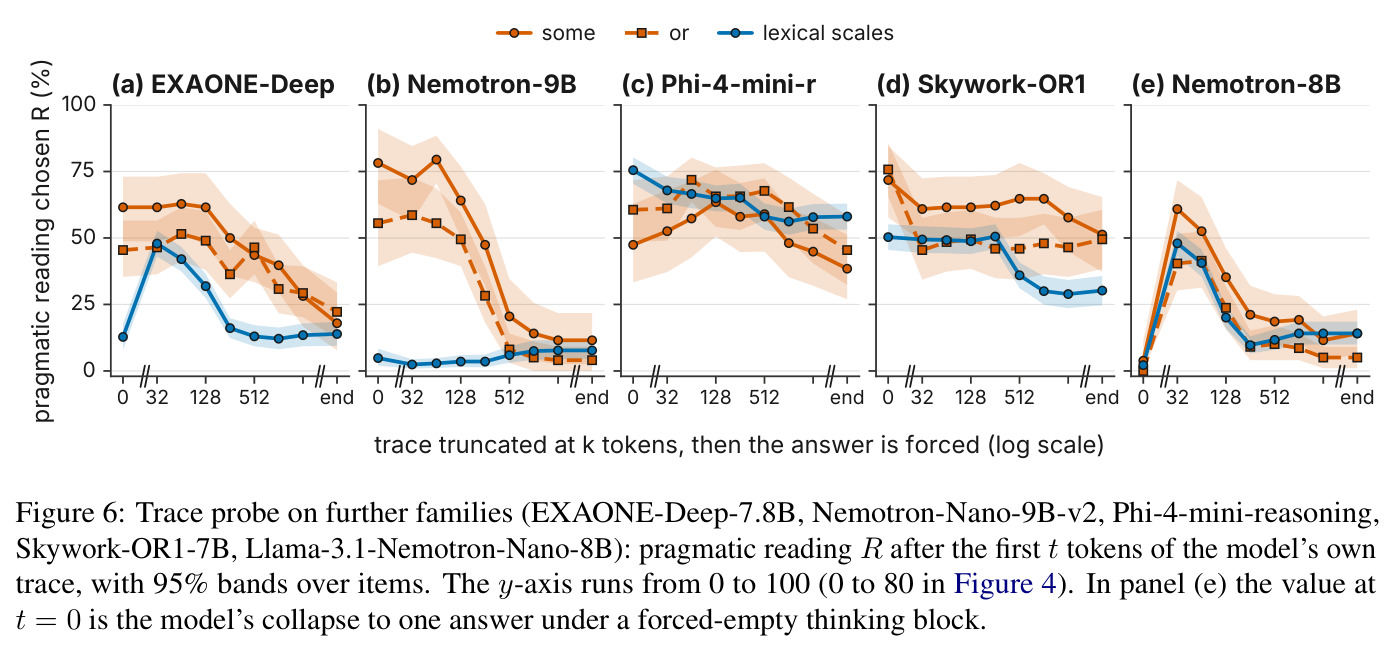
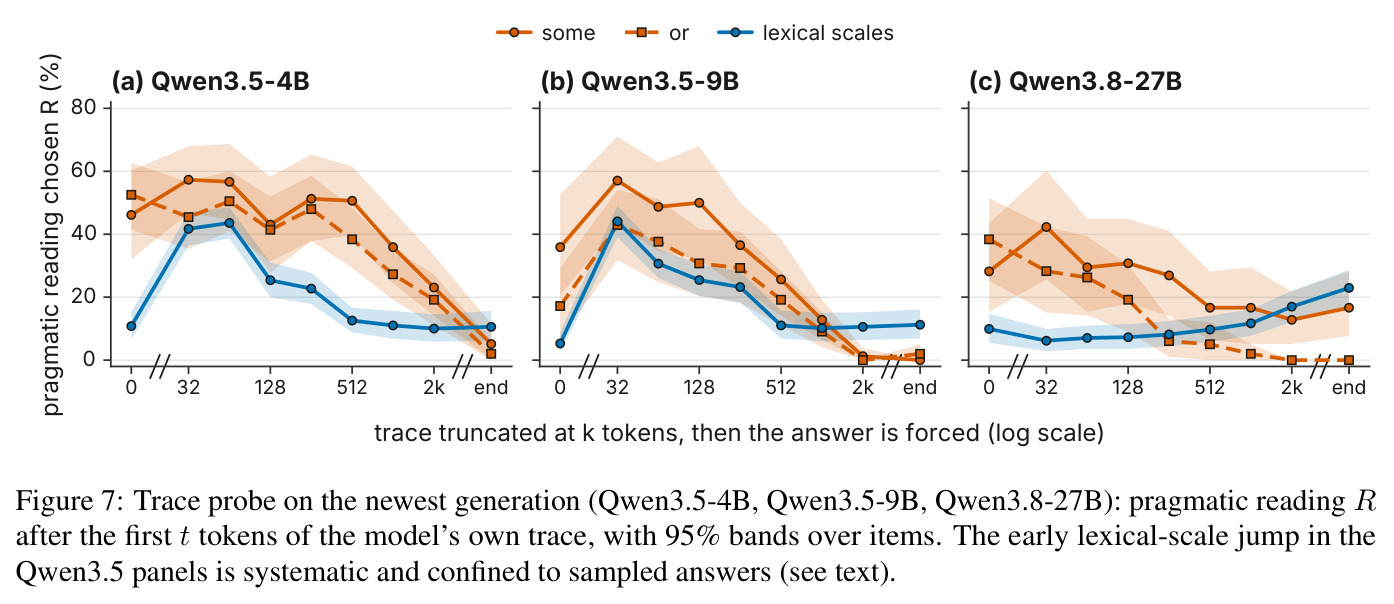
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| some 量级含义解读(Qwen3-8B,Yes/No 得当性框架) | ΔR 实用解读变化(百分点) | −28.2 [−41.0, −16.7] | 思考关闭(NT),同一权重 | 自然思考使其更字面;held-out 全集 −37.7 pp、三选一格式 −34.0 pp 均复现 |
| some/or 字面位移(40 个开源推理模型面板) | 通过预声明检查的显著位移模型数 | 30/40 转字面;三选一格式 21/24;48 个全集位移 47 个存活 Holm 校正 | 各模型思考关/forced-empty 思考块 | 4 个反向(如 DeepSeek-V4、Magistral)、5 个无显著变化 |
| GPT-5 解读位移 | ΔR(pp,high vs minimal effort) | some −20.6、or −18.8、情态动词 −12.5 | minimal effort | 闭源旗舰同样转字面,且非 Yes 偏置(去原句 Yes 率反而 +26.9) |
| R1-Distill-Llama-8B 解读位移 | ΔR(pp,自然思考 vs forced-empty) | some −50.0、or −57.6 | forced-empty 思考块 | 蒸馏思考模型中位移最大档之一;间接回答准确率 +26.0 pp |
| IMPPRES some/or 得当性(128-token 前缀补救,Qwen3-8B) | 准确率(%) | 20.5% | 自然思考 1.2% | +19.3 pp,字面 gold 层不变(87.9%);DeepSeek-R1-0528-Qwen3-8B 2.2%→8.1% |
| 预设投射(Qwen3-8B,IMPPRES 预设) | ΔAcc(pp) | +22.2(49.5%→71.8%) | 思考关闭 | 非量级类随思考改善,支持现象类分离 |
| 语境驱动含义(Qwen3-8B:Fig-QA/PUB/Circa/NOPE) | ΔAcc(pp) | +10.7 / +10.1 / +17.5 / +9.9 | 思考关闭 | Fig-QA 与 PUB 在 Qwen3 4B–32B 每一档都显著;14 个模型在 Circa/NOPE 上无一变差 |
| ImplicatureX 标量含义(Qwen3-8B,复现先前工作) | 识别/取消准确率(%) | 自然思考 65.2% / 94.2%(512-token 帽 89.9% / 85.5%) | 无思考 100.0% / 46.4% | 复现 Spinoso-Di Piano et al. 2026 的单点观察并补上剂量-响应与置信区间 |
局限与改进
作者承认的局限:剂量-响应主证据依赖有思考开关/档位的 Qwen3 与 gpt-oss,其他开源模型只能与未经训练的 forced-empty 空思考块比较;闭源模型仅通过 API 检查;检查点比较是相关性的,迹探针是干预而非读取内部状态,二者都不能确定机制;标题结果仅英文,德/中切片是机器翻译(中文盲检 20 项中 3 项有含义或触发词错误);强制选择格式本身影响结论——Claude 在两种格式间方向反转;自由作答无法被 LLM 评分器可靠编码(最佳评分器与人类共识 κ=0.57,低于预注册的 0.70 门槛),故全部标题结果用强制选择;128-token 补救只在共享同一基座的两个 8B 模型上验证;人类标注是讨论后的共识标签,无独立双人标注与评分者间一致性。我自己的观察:R 只统计 committed answers、丢弃 hedged 回复,可能低估模型的分级解读分布;补救的权重在开发集上经两轮探索选定、只在 held-out 上评一次,存在选择效应;Qwen3.5-9B 有 1,163 条 some 迹在截断时产生无效答案被丢弃,其轨迹结论只建立在幸存迹上;跨语言证据只能算提示性;最关键的机制问题(为什么取消)仍未回答——literalness 标记词只在 20.6% 的翻转迹中先于翻转出现、且在 39.1% 的未翻转迹中同样出现,作者的标记词假设被自己的数据证伪。
独立分析的弱点
(1)补救依赖迹的文本形态:128-token 前缀之所以含实用解读,是因为当前模型的思考风格恰好先「娱乐」含义;若未来模型更早引入 strictly speaking 类字面核查词,固定截断点会失效。改进方向是学习逐题的路由点,或对前缀分布加权而非 w=1 的硬替换。(2)强制选择可能人为制造单一解读:模型内部或许持分级解读分布,Yes/No 二选一会放大极性效应(Claude 的反转就是证据)。改进是把免提取的 log-odds 读出升级为主指标,报告解读分布而非单一选择。(3)机制黑箱:论文定位了「何时」翻转,但没回答「为何」——没有激活层面或电路分析,标记词顺序假设被证伪后也未有替代解释。改进可在翻转时刻做表示 steered 干预或因果追踪,检验取消是否由 RLVR 奖励的真值核查模式驱动。(4)理论不完备:some/or 稳定转字面而 modals 不一致(Qwen3-14B +1.2、OLMo-3-32B-Think +29.7 pp),说明现有两个账户都不能完全解释,需要按量级信息量或替代项可得性建模。(5)训练阶段分析混淆数据与阶段:同一阶段的检查点可能换了数据配比,结论「字面默认出现在思考 SFT/DPO」无法归因到训练目标本身,需要受控续训实验(同数据只改目标)。(6)跨语言证据薄弱:机器翻译未人审、中文 3/20 有错,不能外推到多语部署场景,应原生构造多语言题集。(7)现象覆盖有限:只测了 forced-choice 下的理解,未测产出(模型自己说话时是否遵守量级),而产出侧才是助手机器人最常见的暴露面。
未来方向
作者明确提出:推理模型的评估应同时报告所选解读与准确率(否则无法区分解读漂移与能力变化);默认开思考的部署者应评估解读而非只看准确率;训练应保留语境许可时的说话人意图(如 PragReST 类反字面训练在 Qwen3-8B 上把 some 拉回 19.2%)。四个预注册补救(迹首意图句、思考结束前自检、在自身正确迹上微调、偏好优化)都没过开发门槛,IST 只恢复了 29.5% 无思考水平中的 12.8%(43%),更有效的推理时或训练时干预是开放问题。基于成果可延伸的方向:①把迹前缀诊断用于其他「思考损害」任务(心智理论、预设投影、抗干扰),定位损害在迹内的发生点;②机制研究:在翻转时刻做激活分析与因果干预,检验「取消」是否等于 RLVR 奖励的真值核查习惯;③解读感知解码:按路由选择前缀答案、或让模型同时输出两种解读再按语境选择;④在原生多语言题集上检验 entertain-then-cancel 的普适性;⑤研究思考预算与说话人知识利用的交互——gpt-oss-120b 是唯一利用全知/部分知识差异的模型(低 effort 84.0 pp),但高 effort 下降到 62.5 pp,说明思考可能挤占了社会推理资源;⑥把「剂量」思想推广到其他推理超参(自洽样本数、反思轮数)对语用行为的影响。
复现评估
开源程度非常高:代码、全部 verbatim 提示、40 个开源模型的完整迹日志、新范畴句与 50 个说话人知识场景、IMPPRES some/or 的极性翻转与三选一变体(以标识符加模板形式发布)、机器翻译德/中切片(明确标注未人审)都在 GitHub(kouzhizhuo/entertain-then-cancel)开放;预注册文件 METHOD_DESIGN.md 在匿名仓库公开,假设、阈值、判伪与排除规则在主实验前固定并逐条报告结果(含失败项)。算力需求:开源侧 NVIDIA H800 约 200 GPU 小时(vLLM 服务,T=0.6、top-p 0.95、top-k 20、3 seeds,自然思考帽 8192),闭源 API 合计约 105 美元;每个检查点记录 commit hash,模型全部为开放权重、无门控。复现难度分层评估:复现核心结论只需 1–2 个带思考开关的 8B 模型(如 Qwen3-8B)加单张消费级/工作站 GPU,门槛中等偏易;完整复现 40 模型面板与 OLMo/Tülu/Qwen2.5 检查点谱系需要大量下载、许可合规(IMPPRES 为 CC BY-NC、openPangu 限制欧盟内使用、NOPE 不可再分发)与较多 GPU 时,门槛较高;专家共识标注环节普通团队难以完全复制,但它只承担小样本验证功能,不影响主结果。
论文图表
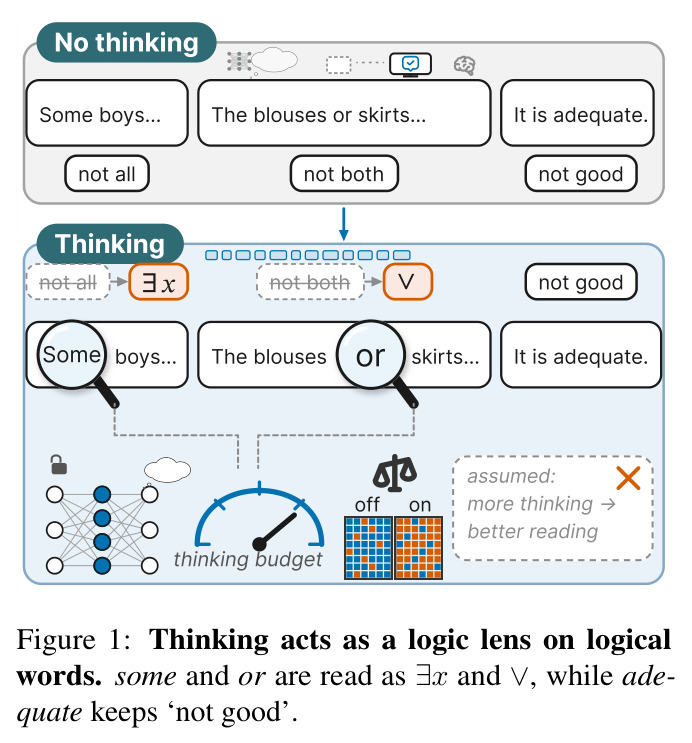
论文开篇的概念图:对比无思考与有思考两种模式下模型对同一句话的读法。无思考时 some 读出「非全部」、or 读出「非两者」的实用含义;有思考时 some 被读成纯存在量词 $\exists x$、or 读成逻辑析取 $\vee$,而 adequate 仍保留「不好」的词汇含义。
一图概括全文主旨:思考像一面「逻辑透镜」,只对逻辑词生效——取消量词与连接词的会话含义,却不改变词汇等级的含义。读者先看这张图就能建立正确的预期。