思维惯性:被要求不要思考时,大语言模型仍在思考 Thinking Inertia: LLMs Keep Thinking When Told Not To
提出响应级三级评测体系,揭示LLM被禁止思考仍持续显式推理的“思维惯性”
前置知识
思维链(Chain-of-Thought, CoT)与测试时计算
思维链指让模型在给出最终答案前先输出中间推理步骤的范式,从早期 CoT 提示发展到测试时扩展(test-time scaling):给模型更多生成中间 token 的预算可显著提升复杂任务表现。但它也带来延迟与 token 成本上升,因此出现了推理长度压缩、token 预算控制、简短草稿蒸馏等效率化方法。
本文研究的正是这个范式的对立面:当用户要求模型“不要思考、直接给答案”时,模型能否真正做到响应层面上的零推理。理解 CoT 机制才能理解“停止思考”为何不是简单关掉开关。
思考模式开关(enable_thinking)
现代推理型 LLM(如 Qwen3、DeepSeek 系列)提供原生思考开关和推理力度(reasoning effort)设置:开启时模型在特殊 块中输出推理轨迹,关闭时预期直接输出答案。这是 API 层面最常用的“无思考”控制手段。
论文的核心批判对象就是这种开关:它只控制了可见格式(有无 块),并不保证普通答案通道里不残留与问题相关的推理文字,这正是“思维惯性”现象的载体。
答案空间(Answer Space)
指一道题可容许的答案集合 $\mathcal{A}$:布尔判断是 $\{\text{yes}, \text{no}\}$,多选题是 $\{A,B,C,D\}$,开放式问答则允许自由生成。答案空间越窄,模型越像是在“核对一个给定命题”;越宽,越需要“从零构造答案”。
本文最重要的结论——思维惯性的强度按 Boolean < 多选 < 开放式阶梯排列——完全由答案空间组织,而非由开关、基准难度或模型规模决定,这是读懂全文主线的钥匙。
LLM-as-Judge(大模型评审)
用一个强 LLM 按预定义 rubric 给其他模型的输出打分的评测方法。关键设计是“盲化”:裁判只看到问题与被评文本,不知道模型身份、干预方式、答案正误,以避免偏置。常用双裁判(不同模型家族)交叉验证结论稳健性。
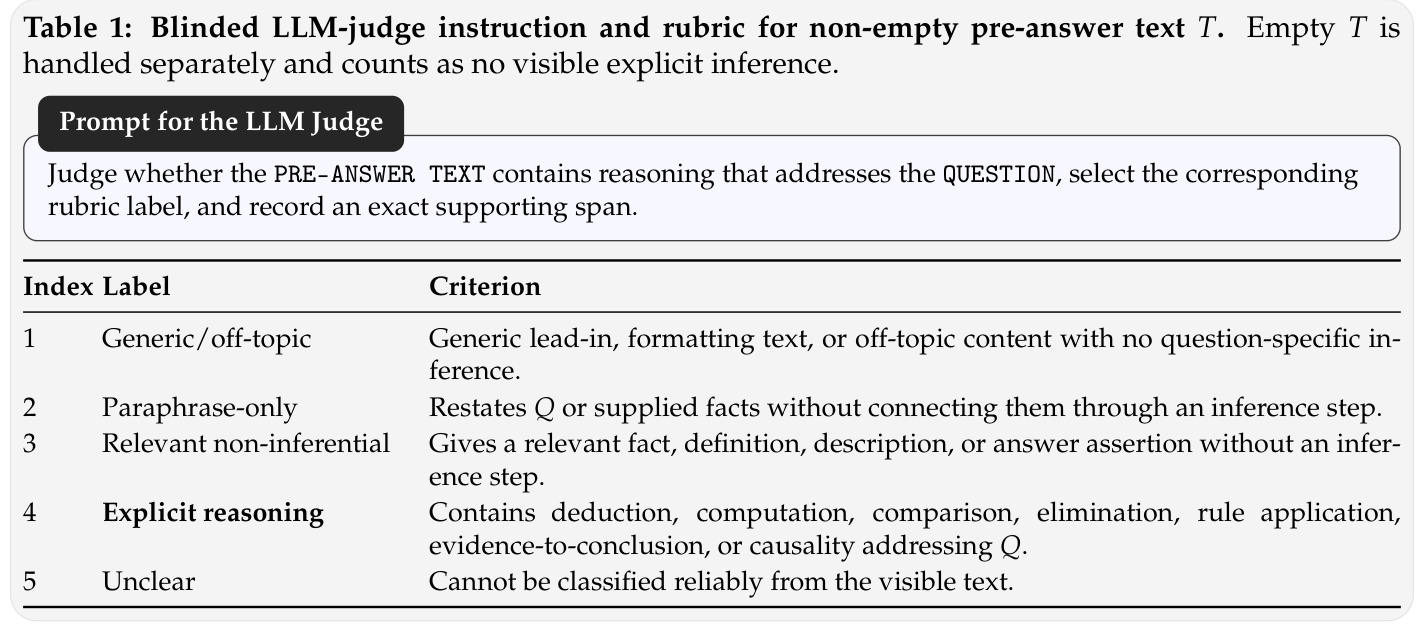
论文第三级指标 EIR 完全依赖一个盲化的 GPT-5.5 裁判把答案前文本分为五类,只有判为“显式推理”才计入指标;理解其盲化协议与人工一致性验证(98.8%)才能评估该指标的可信度。
指令感知嵌入与余弦相似度
嵌入模型把文本映射为向量,余弦相似度 $\cos(\phi(Q),\phi(T))$ 度量两段文本的语义相关性。“指令感知”指查询侧可以附带一句任务说明(如“检索包含与回答该问题相关推理的答案前文本”),让编码器聚焦目标关系而非表面词面重叠。
第二级指标 QRel. 用 Qwen3-Embedding-4B 的指令感知模式计算问题与答案前文本的相关度,它是连接“是否完全无文本”与“是否真在推理”之间的连续信号。
研究动机
LLM 普遍配备了显式的“思考模式”,而它的对立面“无思考(no-thinking)”却长期缺乏清晰定义。社区实践中通常用三个表面代理来判定模型“没有思考”:(i) 提示侧控制——把模型置于 no-think 设置、或不去提示它逐步推理;(ii) 可见格式控制——响应中没有独立推理轨迹或 块;(iii) 长度控制——输出短就当作推理少。论文证明这三类代理都不可靠:一台禁用了思考模式的前沿模型 DeepSeek-V4-Flash(284B),在开放式任务上 99.9% 的响应仍在普通答案通道里暴露与问题相关的显式推理;反过来,“让我想想,答案是 X”这种不含任何任务信息的套话又会被长度/格式代理误判为推理;而一句短小紧凑的中间方程(如 $t = 2v_0\sin\theta/g$)虽短却包含真正的推断步骤。换言之,现有手段把“指令条件”与“可见推理是否被抑制”混为一谈,我们既无法确认模型何时真的停止思考,也没有度量它的工具。
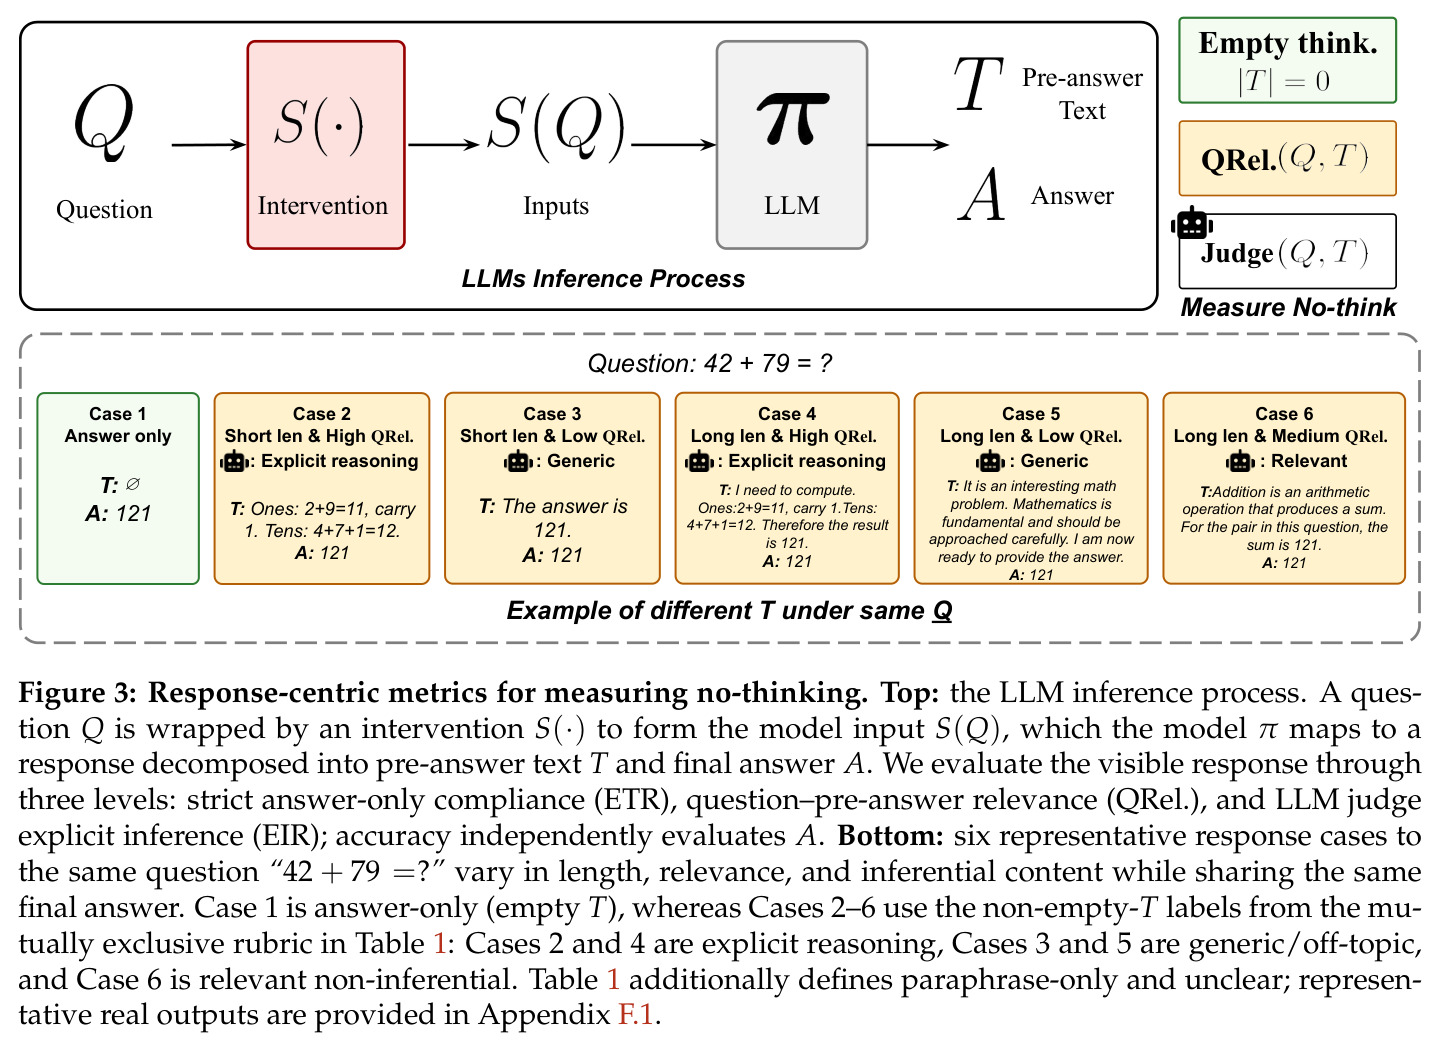
本文的目标是本文要把“无思考”从表面代理升级为可测量的响应级行为,建立一套系统评测框架。具体做法是:把任意 LLM 响应规范地分解为答案前可见文本 $T$ 和最终答案 $A$,在三个渐进层级上度量 $T$ 的内容——(1) 严格答案唯一合规(Empty-Thinking Rate, ETR);(2) 问题-答案前文本相关性(Question–Pre-answer Relevance, QRel.);(3) 由 LLM 裁判判定的显式推理率(Explicit Inference Rate, EIR)——同时用任务准确率独立评估 $A$。在此框架上回答三个问题:Q1 开/关思考模式是否真能抑制可见的答案前内容;Q2 逐步增强的答案唯一干预能否让响应更“答案唯一”而不损伤准确率;Q3 无思考行为如何随答案空间、基准领域以及模型家族与规模变化。
与已有工作不同的是,已有工作关心的是如何压缩、预算或选择性分配测试时计算,评估对象是 token 数与准确率的权衡;本文的独特切入是“可见推理内容本身”——不问推理有多长,而问被要求不思考时模型到底暴露了什么。作者明确把响应级“无思考”与模型内部潜在计算划清界限(避免像 Coconut 那类隐空间推理导致定义发散),主张用可观察、可审计的文本行为来定义能力边界。实验设计上,除了六个按无思考强度排列的干预模式外,还引入了“同一问题改写答案空间”的受控比较(同一道数学题分别改成布尔核对、四选一、开放式生成),从而把“答案接口的结构”从“基准难度”中剥离出来,这是以往推理效率文献没有的视角。
核心方法
直觉是:与其猜测模型“内心”是否还在计算,不如严格审计它“嘴上”说了什么。论文提出响应中心框架:设模型为 $\pi$,任务样本为 $Q=(q,c,\mathcal{A})$(题干、可选上下文、可容许答案空间),外部干预 $S(\cdot)$(如系统提示“请直接回答,不要思考”)包裹问题得到输入 $S(Q)$,模型产生可观察响应 $\pi_{S(Q)} = (T, A)$,其中 $A$ 是最后一个可解析的最终答案,$T$ 是它之前所有可见文本(可来自特殊推理块、普通答案通道或简短引导语)。评测在三个层级上展开:Level 1 的空思考率 $\mathrm{ETR} = \tfrac{100\%}{N}\sum_i \mathbb{1}\{|T_i|=0\}$ 要求完整输出除答案及允许的包装(如 \boxed{})外无任何实质文本;Level 2 的 $\mathrm{QRel.}(Q_i,T_i)=\cos(\phi(Q_i),\phi(T_i))$(空 $T$ 记 0)用指令感知嵌入测语义相关;Level 3 的 $\mathrm{EIR}=\tfrac{100\%}{N}\sum_i \mathrm{Judge}(Q_i,T_i)$ 由盲裁判五分类后导出二值分数。准确率独立评估 $A$,与 $T$ 的指标互不污染。干预按无思考强度组织成六模式谱系 M1–M6,覆盖原生开关、语义抑制与结构前缀强制。
核心创新是“三级渐进评测 + 对表面代理的系统批判”。与以往用 块缺失或 token 长度判定无思考不同:ETR 是结构性规则,检查最干净的答案唯一上限;QRel. 是连续的相关信号,用 Qwen3-Embedding-4B 的指令感知查询编码(查询指令为“给定问题,检索包含与回答该问题相关推理的答案前文本”,$T$ 编码为候选段落),测量的是“与解题相关”而非表面重叠;EIR 才把真正的显式推理从“相关但非推理文本”中剥离——盲化 GPT-5.5 裁判只接收 $(Q_i, T_i)$,隐藏模型身份、干预方式、最终答案与正误,按五分类 rubric(Generic/off-topic、Paraphrase-only、Relevant non-inferential、Explicit reasoning、Unclear)打标,只有 Explicit reasoning 计 1。为防指标被复述驱动,作者做了全语料审计:572,688 条输出中仅 301 条(0.053%)被标记为近逐字重复,把它们的相关度清零后全局 QRel. 均值最多变动 0.00053;另有 355 条(0.06%)被判为 paraphrase-only 并从 EIR 中剔除。
方法步骤详情
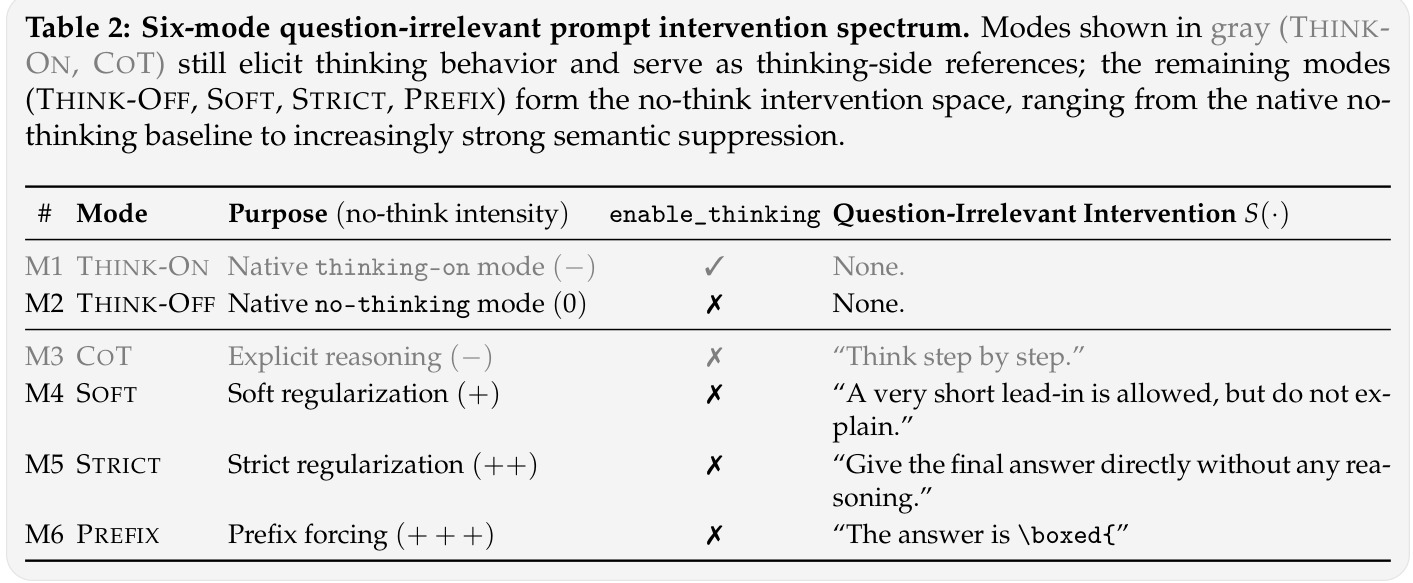
第一步,构建六模式干预谱系(Table 2):M1 THINK-ON 原生思考开;M2 THINK-OFF 原生思考关(无思考基线);M3 COT 思考关但附加“Think step by step”重新诱导推理;M4 SOFT “允许极短引导语,但不要解释”;M5 STRICT “直接给出最终答案,不要任何推理”;M6 PREFIX 预填答案模板“The answer is \boxed{”,绕过指令通道做结构性前缀强制。第二步,在六个 LLM(Qwen3-4B/32B/235B-A22B、DeepSeek-V4-Flash、GPT-5.4、Gemini-3-Flash)× 三个答案空间族(Boolean:BoolQ/StrategyQA;MCQ:MMLU/MMLU-Pro;开放式:GSM8K/MATH)上评测全部模式。第三步,按第二节公式计算 ETR/QRel./EIR 与准确率:QRel. 用 Qwen3-Embedding-4B(last-token pooling,最大序列长 32,768),EIR 用温度 0 的 GPT-5.5 做主裁判、Claude Opus 4.8 做独立家族复核。第四步,附加两类控制实验:MMLU 学科域分析(固定四选一接口比较 Humanities/Social Sciences/STEM),以及同题答案空间改写(把 MMLU/MMLU-Pro 中数值答案的题目在 Qwen3-32B、M2 下从 MCQ 改写成 Boolean 或开放式)。第五步,人类验证:盲化抽样 600 条输出(每基准 100 条,保持空/非空比例),5 名标注者独立给出五级相关度评分与 Level 3 推理标签,并做空 $T$ 边界人工审计。
技术新颖性
新颖性体现在三个层面。定义层面:首次把“无思考”操作化为响应级可观察行为,并明确声明不涉及隐藏状态中的潜在计算,从而绕开了“模型内部是否在思考”这类不可证伪的问题,同时把 provider 的思考开关仅当作干预手段而非行为描述。度量层面:三个指标互补且各有分工——ETR 给出结构上限、QRel. 提供连续相关信号但刻意不宣称是推理检测器、EIR 负责把推理从复述与相关断言中分离;配合全语料审计(近逐字重复仅 0.053%、paraphrase-only 仅 0.06%)和 98.8% 的人机一致率,指标效度有实证支撑,这在“无思考”评测中是首个完整闭环。实验层面:六模式强度谱系把“开关”与“指令抑制”分离,M6 前缀强制作为独立分支揭示了结构约束并不必然优于语义约束;同题改写实验则证明答案接口本身(候选可见性)是决定性变量,同类发现在跨基准与同题内两个尺度上同时成立,形成双重证据。
实验结果
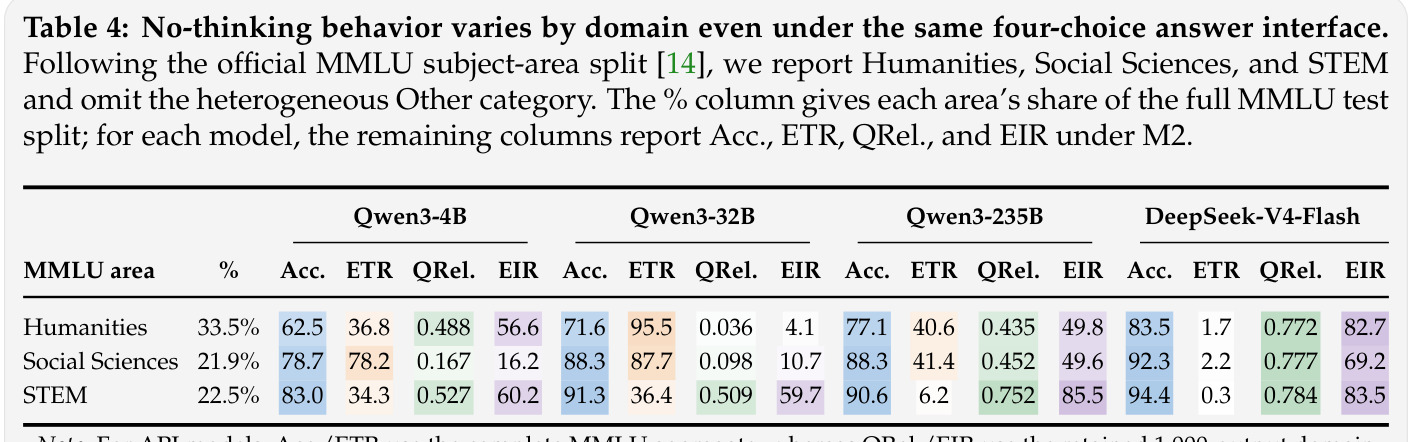
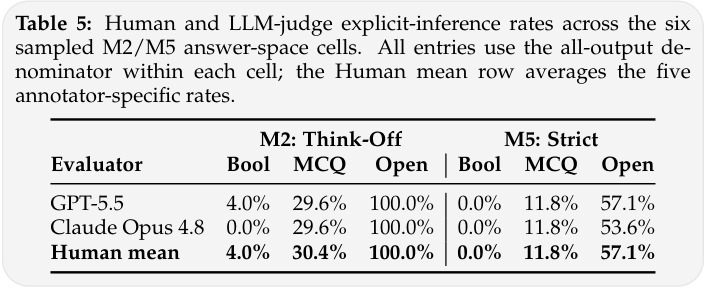
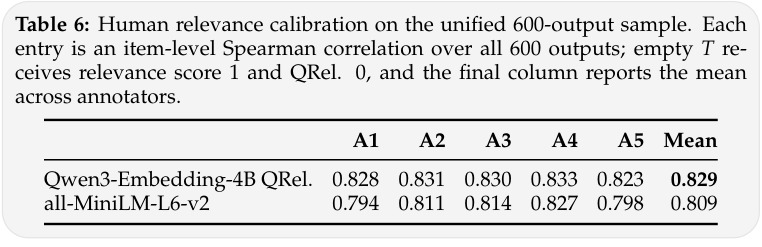
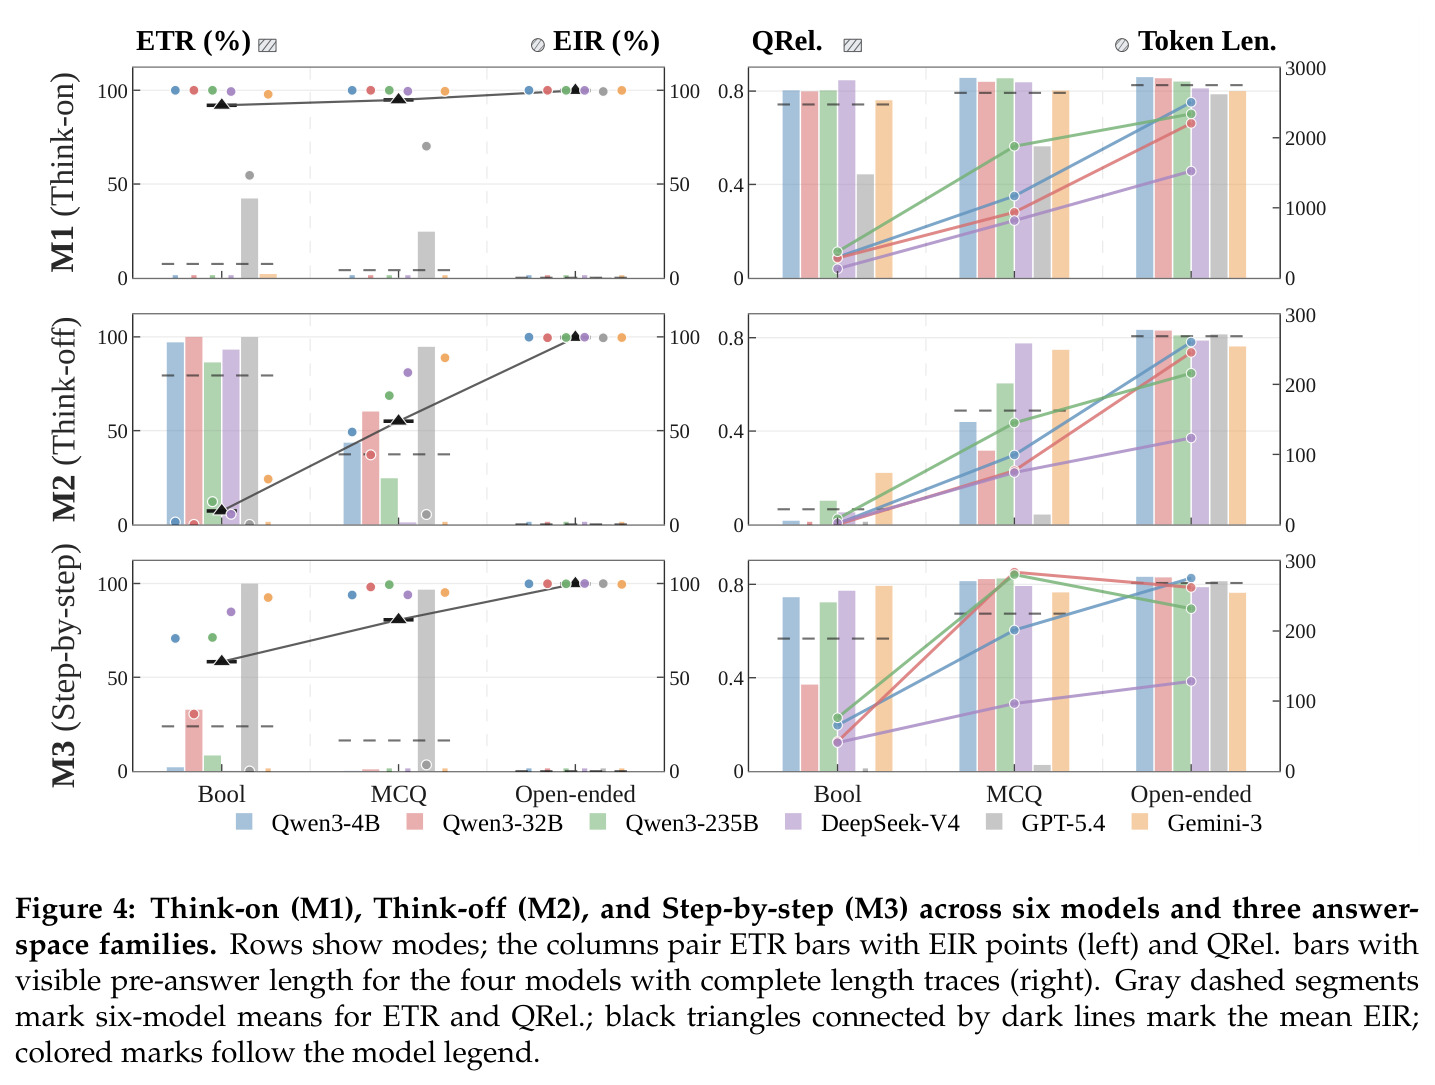
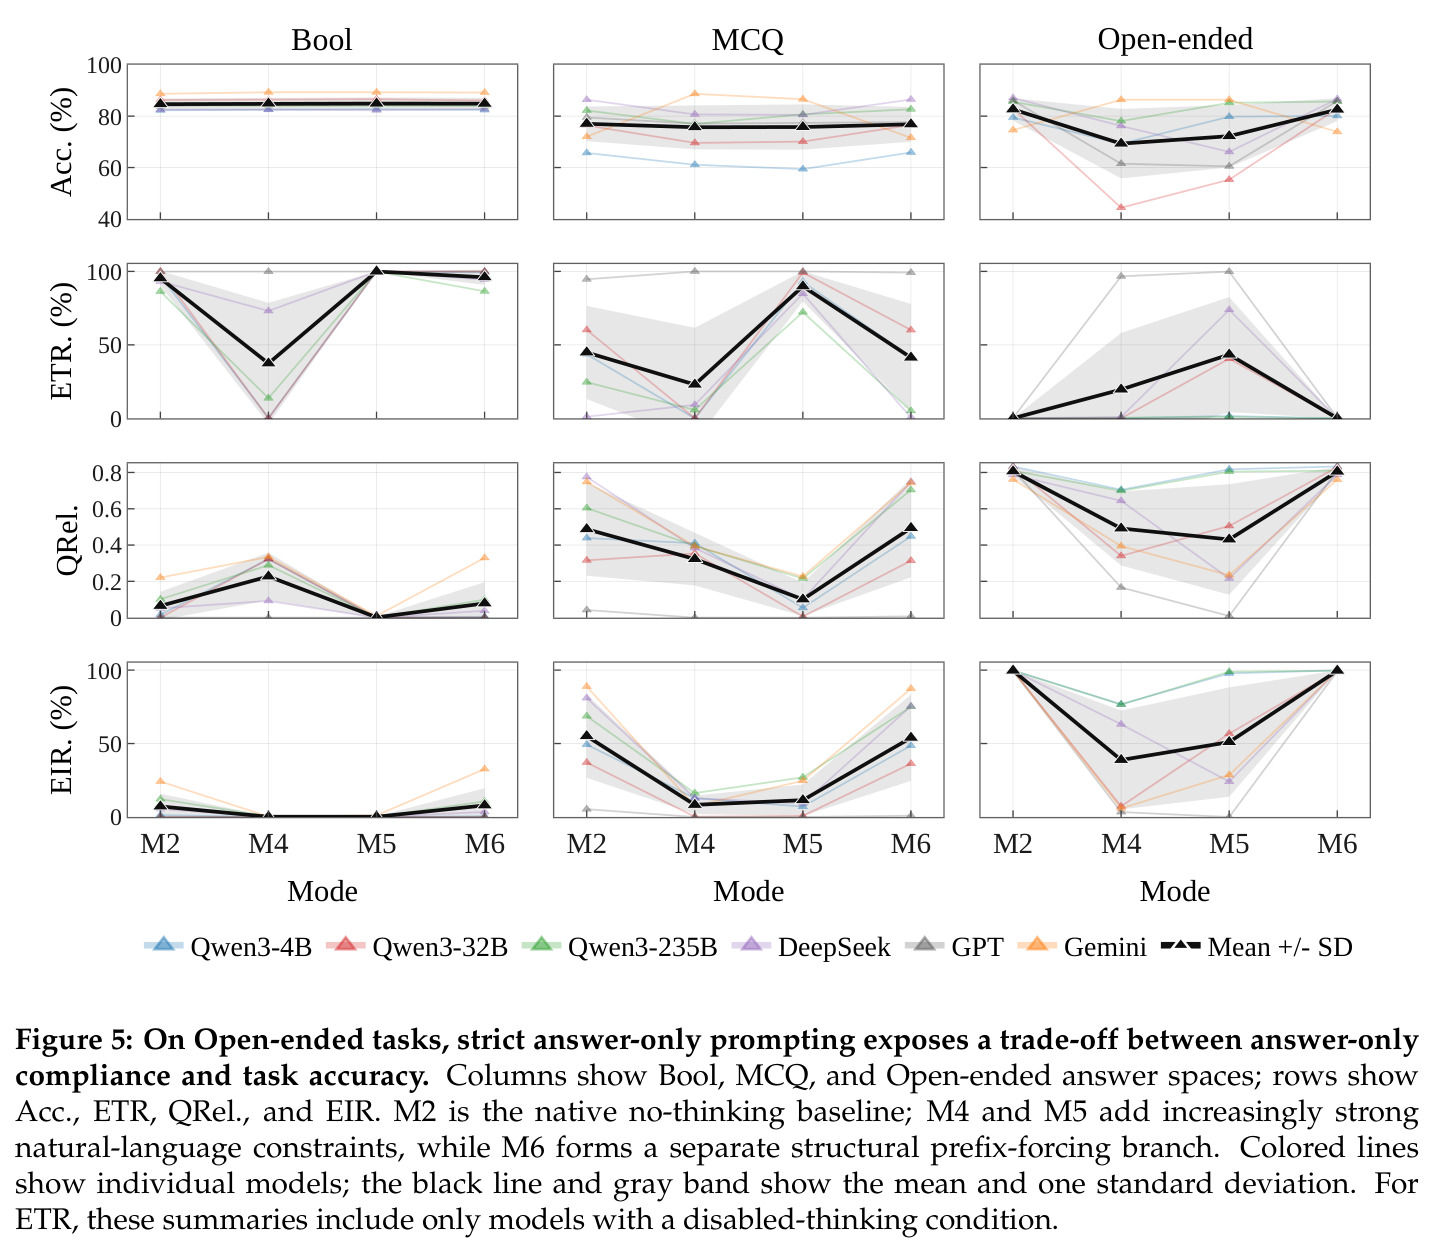
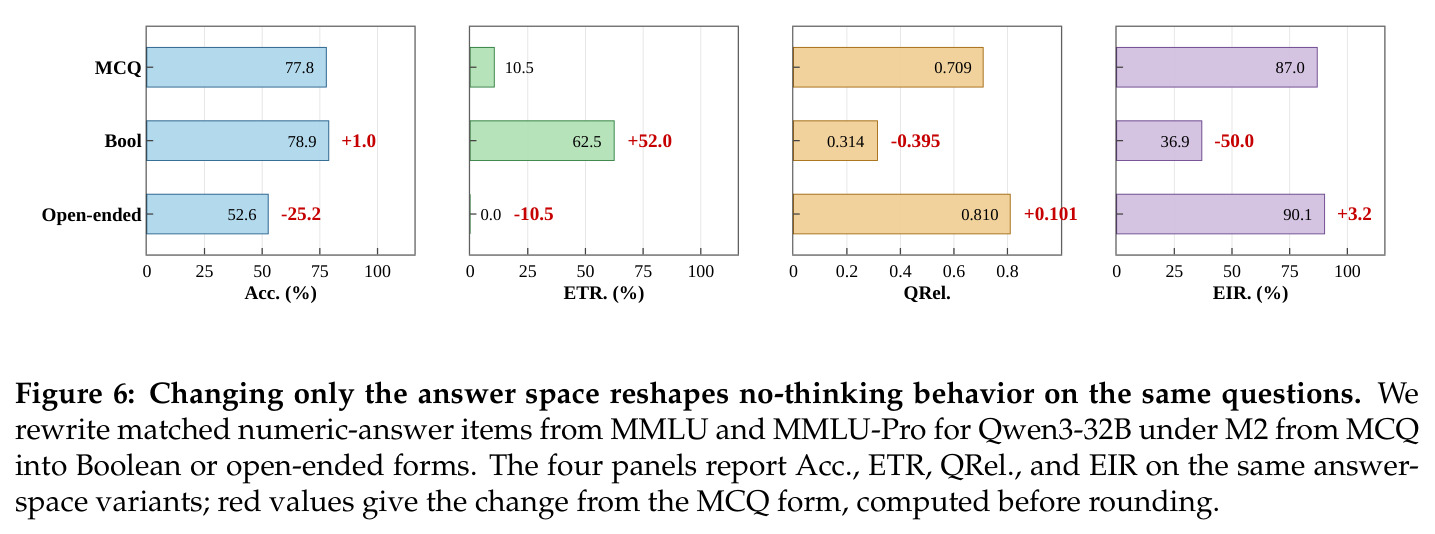
论文报告四个主要发现。(i) 显式 no-think 控制不可靠:DeepSeek-V4-Flash 在禁用思考的设置下,开放式响应中 99.9% 仍含可见显式推理。(ii) 思维惯性按答案空间阶梯排列:M2 下 Bool 的六模型平均 ETR 约 80–100%,MCQ 从近 0 到 95% 不等且模型间异质,开放式 ETR 几乎处处归零但 QRel. 保持 M1 水平、EIR 居高;EIR 均值呈 Bool < MCQ < Open-ended 阶梯。M3 逐步提示能把 QRel./EIR 拉回 M1 水平(GPT-5.4 例外,它在 Bool/MCQ 上保持高合规与低 EIR),但阶梯顺序不变。(iii) 无思考-性能权衡:五个完全禁思考的模型从 M2 到 M5,开放式平均 ETR 从近 0 升至约 40%,平均准确率下降约 15 个百分点;全语料 EIR 从 99.69% 降至 62.00%。对比之下 Bool 上 EIR 从 5.15% 降到 0.12%、MCQ 从 45.57% 降到 25.39% 而准确率基本持平。M6 前缀强制不是 STRICT 的加强版:MCQ 与开放式上平均 ETR 从 M5 反而回落,QRel./EIR 在所有答案空间反弹。(iv) 答案空间决定可压缩性:同题改写(Qwen3-32B、M2)把 MCQ 改成 Boolean 后准确率 77.8%→78.9%(+1.0),ETR 10.5%→62.5%(+52.0),QRel. 0.709→0.314(−0.395),EIR 86.95%→36.90%(−50.0);改成开放式则准确率 52.6%(−25.2)、ETR 0%(−10.5)、QRel. 0.810(+0.101)、EIR 90.14%(+3.2)。学科分析(Table 4)显示固定四选一接口下 MMLU STEM 准确率最高(DeepSeek 94.4%)但 ETR 最低(0.3%)、QRel.(0.784)与 EIR(83.5%)最高,说明高准确率不等于容易无思考。人类验证全面支持指标:ETR 边界审计与人工一致 565/600(94.2%),QRel. 与五标注者平均 Spearman $\rho=0.829$(all-MiniLM-L6-v2 仅 0.809),EIR 与主裁判二元一致 98.8%、与 Claude Opus 4.8 一致 96.7%;人工标注复现了答案空间阶梯(Table 5:M2 下 Bool 4.0%/MCQ 29.6%/Open 100.0%;M5 下 0.0%/11.8%/57.1%)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 开放式任务(GSM8K/MATH)显式推理率 | EIR (%) | M5 严格答案唯一下 62.00% | M2 原生无思考下 99.69% | 下降 37.7 个百分点,但显式推理仍占多数,显示抑制不彻底 |
| 开放式任务答案唯一合规率 | ETR (%) | M5 下约 40%(五模型均值) | M2 下接近 0% | 合规率大幅提升,但代价是平均准确率下降约 15 个百分点 |
| 同题改写:MMLU 数值题 MCQ→Boolean(Qwen3-32B, M2) | ETR (%) | 62.5% | 原始 MCQ 形式 10.5% | +52.0 个百分点,且准确率几乎不变(77.8%→78.9%) |
| 同题改写:MMLU 数值题 MCQ→开放式(Qwen3-32B, M2) | EIR (%) | 90.14% | 原始 MCQ 形式 86.95% | 进一步上升且准确率跌至 52.6%(−25.2),证实开放式最难抑制 |
| Boolean 任务显式推理率(M2→M5) | EIR (%) | 0.12% | 5.15%(M2) | 窄答案空间下几乎可完全消除显式推理且准确率持平 |
| MCQ 任务显式推理率(M2→M5) | EIR (%) | 25.39% | 45.57%(M2) | 下降 20.2 个百分点,但仍是 Bool 的约 200 倍,呈中间地带 |
局限与改进
作者承认的限制:分析刻意以可观察响应为研究单元,不声称隐藏状态中没有任务相关计算——潜在推理可能仍在消耗算力,因此“可见合规”不等于“推理成本降低”;六模型六基准、尽量确定性解码的设置,对多语言、代码、工具使用、多轮对话、随机解码以及闭源 API 端点演化的泛化性仍是开放问题;QRel. 只是相关性的操作化补充而非独立的推理检测器;EIR 依赖可见文本 rubric 与裁判校准(作者用独立裁判家族和多项审计缓解)。我自己的观察:其一,主裁判 GPT-5.5 与被评模型 GPT-5.4 同属一个家族,尽管盲化并有 Claude Opus 4.8 复核且人机一致率 98.8%,家族自评偏置仍值得更长裁判池验证;其二,ETR 要求最终答案“可解析”,人工边界审计中 35/600 的分歧即源于此,说明严格合规率的绝对值对解析器实现敏感;其三,干预只覆盖提示与前缀级别,未测试训练时干预(如选择性推理 RL),“开关不可靠”对经训练获得自适应停止能力的模型是否成立待检验;其四,未报告延迟与真实计费 token(如加密 reasoning 块)的变化,任务感知路由的实用价值缺少成本侧证据。
独立分析的弱点
第一,EIR 的效度完全锚定在 LLM 裁判上:rubric 中“短而紧凑的推断步骤”与“相关但非推理的断言”边界(如一条代入公式的算式 vs 一句直接报答案)本质上难以判分,虽然盲化协议与双裁判交叉验证缓解了偏置,但边界案例的系统性偏差无法排除。改进方向:引入多裁判池加众包仲裁,公开全部 600 条人工标注与裁判 prompt 做元评测,报告按 rubric 类别的混淆矩阵。第二,基准偏数学:开放式族只有 GSM8K/MATH,答案可验证性强、且数学题天然“必须算”,开放式知识问答或写作类任务上 EIR 阶梯是否同样陡峭未知。改进方向:扩展到开放域 QA、摘要与多跳问答,检验答案空间效应的稳健性。第三,干预是静态提示级别的:现实中厂商还会用 RL 训练长度偏好、难度路由等手段,本文结论对“训练出来的停止能力”没有发言权。改进方向:把 ETR/EIR 作为奖励信号做校准停止训练并与提示干预对比。第四,缺少成本维度:无思考的核心动机之一是省钱省延迟,但论文未测量 API 隐藏推理 token 的计费与端到端延迟。改进方向:结合 provider 计费数据,把“可见合规”与“真实成本节省”解耦呈现。
未来方向
作者在 5.2 节提出的方向:任务感知路由——当答案接口提供足够结构支持(如候选可见、布尔核对)时直接回答,否则保留显式计算以保准确率;训练模型做“校准停止”(calibrated stopping)而非统一抑制,联合优化准确率、答案唯一合规、可见相关/推理、延迟与实际推理 token 成本;把评测扩展到多语言与交互式任务以检验泛化;用内部分析检验被抑制的计算究竟是消失、转入隐藏通道还是仅从视图中省略;在高风险场景中权衡简洁输出与可验证性(解释有助于发现错误)。基于本文成果可延伸的方向:把三指标纳入推理模型的后训练对齐目标,做成可优化的约束而非仅是评测;利用 Qwen3 三个尺寸(4B/32B/235B)的数据研究思维惯性的 scaling 规律,预测更大模型的抑制难度;开发无需裁判的因果探测方法,例如通过激活引导或探针判断“停止指令”是否改变了内部计算轨迹;以及把答案空间改写做成通用推理控制手段——给模型一个“候选答案核对视图”来廉价地提升答案唯一合规。
复现评估
复现条件总体良好。论文页面标注了 WEBSITE、GITHUB 与 DATA 链接,评测协议在正文中描述得相当完整:六模式的干预 prompt 原文、Table 1 的裁判指令与五分类 rubric、盲化协议(裁判只见 $(Q_i,T_i)$)、嵌入模型(Qwen3-Embedding-4B,last-token pooling,32,768 最大长度)、抽样与人工标注协议(600 条、5 名标注者、空/非空比例保持)均公开可查;审计统计(572,688 条全语料、301 条近逐字、355 条 paraphrase-only)也提供了数据。主要门槛在算力与 API 成本:Qwen3-4B/32B 可本地复现,Qwen3-235B-A22B 需多卡环境;DeepSeek-V4-Flash、GPT-5.4、Gemini-3-Flash 及 GPT-5.5 裁判需要 API 调用,EIR 对每条非空 $T$ 一次裁判调用、QRel. 每条一次嵌入,全语料规模下费用可观,但只复现 Qwen3 家族并换用开源裁判即可大幅降本。需要注意的是闭源端点会随时间漂移,论文数字难以逐位复现,作者也在限制一节承认了这一点;好在结论以相对趋势(答案空间阶梯、M2→M5 权衡)为主,对端点小幅漂移稳健。
论文图表
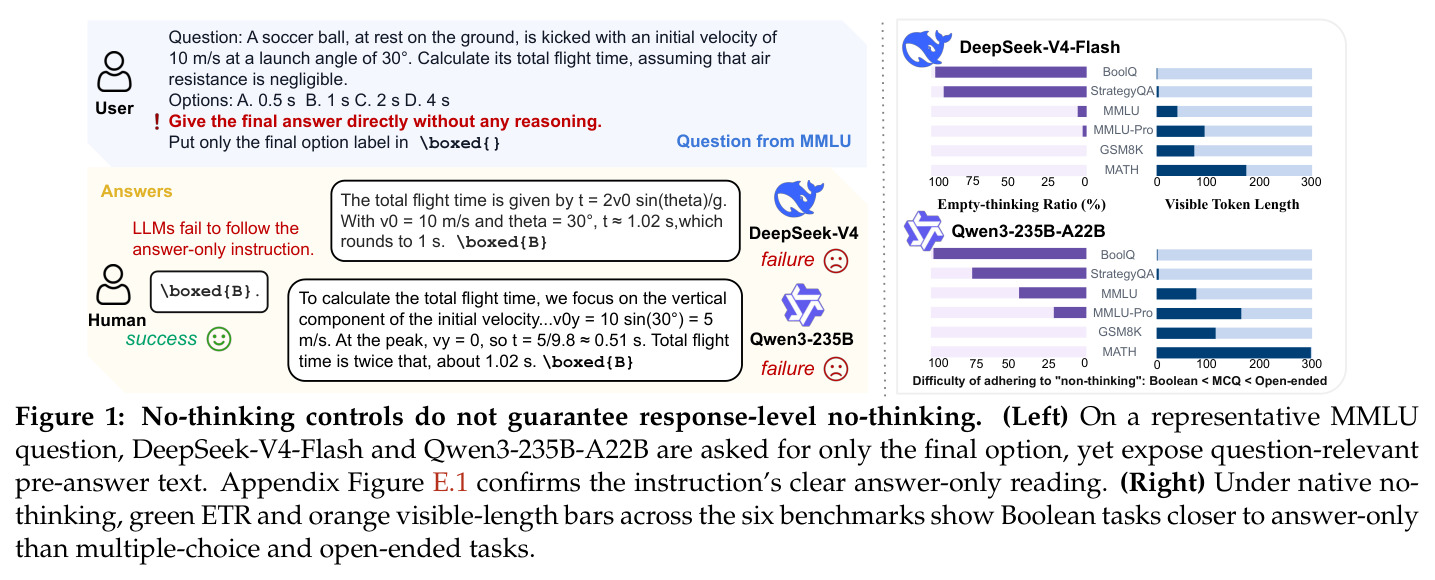
左图展示一个代表性 MMLU 物理题(抛体飞行时间),DeepSeek-V4-Flash 与 Qwen3-235B-A22B 被明确要求“不要任何推理、只输出选项标签”,却在最终 \boxed{B} 之前暴露了与问题相关的答案前文本(如写出 $t = 2v_0\sin\theta/g$ 的计算);右图在六个基准上对比原生无思考下的空思考率(绿色 ETR 柱)与可见 token 长度(橙色柱),显示 Boolean 任务比多选和开放式更接近答案唯一。
这是全文的开题图:一眼看到“明确禁令也拦不住推理外泄”的具体样例和跨基准的统计规律,建立对思维惯性现象的直观认识。
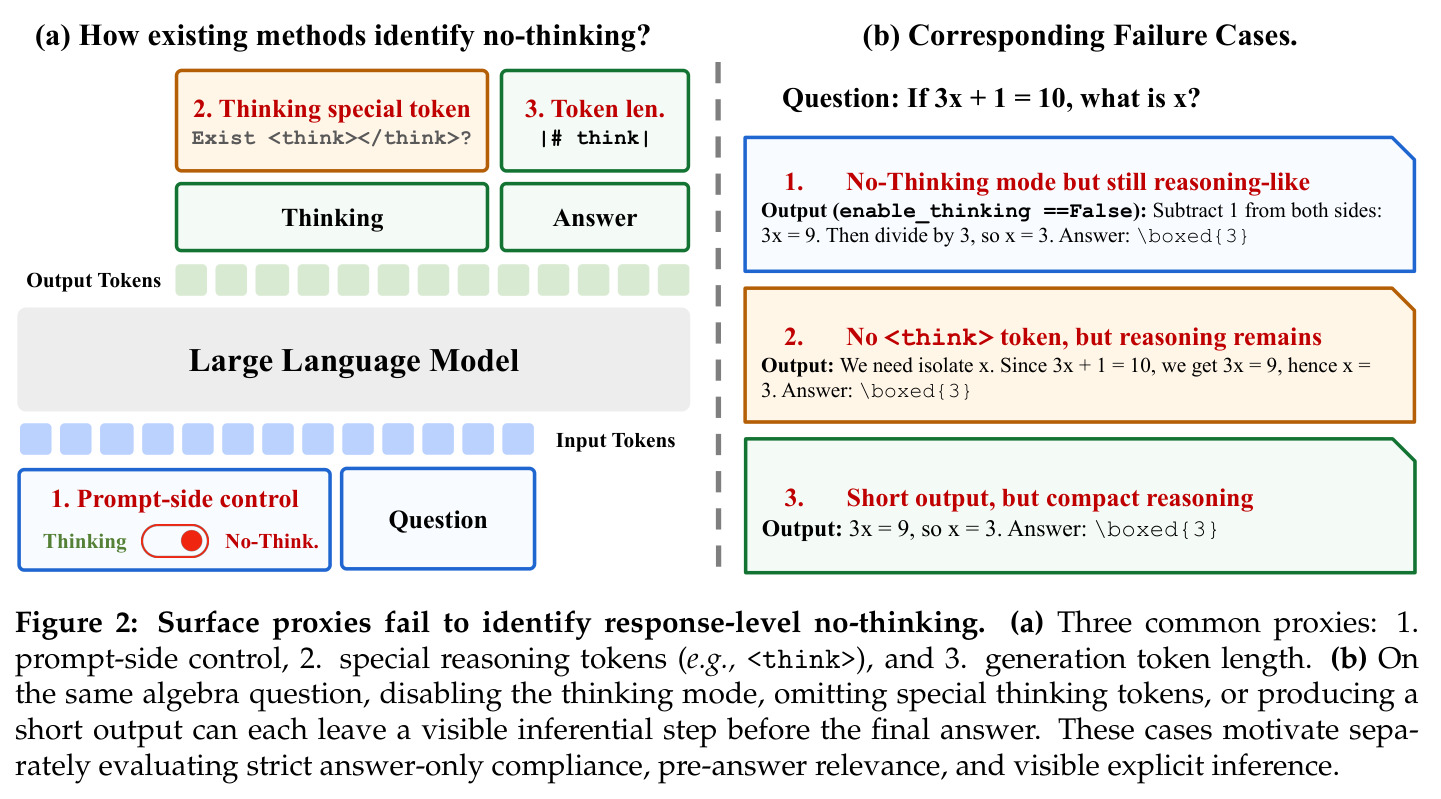
左半部分列出三种常见无思考判定代理:1. 提示侧控制(no-think 设置)、2. 特殊推理 token(是否存在 <think> 块)、3. 生成 token 长度;右半部分在同一道代数题 $3x+1=10$ 上给出对应失败案例:禁用思考模式、去掉 <think> 标签、或输出很短,三种情况下模型都在最终答案前留下了可见的推断步骤(如 $3x=9$,故 $x=3$)。
它系统性地论证了论文的动机——三种社区惯用代理各自都有反例,从而引出需要响应级内容审计的必要性。
六个被评模型及其思考模式支持:Qwen3-4B(4B)、Qwen3-32B(32B)、Qwen3-235B-A22B(235B,High|Off)、DeepSeek-V4-Flash(284B,On|Off)、GPT-5.4(High|Off)、Gemini-3-Flash(High|Minimal)。三个 Qwen3 尺寸支持家族内 scaling 分析,本地 4B/32B 提供透明的原生开关对照。
明确实验覆盖的模型家族与规模,是判断结论普适性(尤其 API 模型 vs 开源模型)和复现所需资源的基础。