思维链表层之下:大语言模型推理操作的机制可解释性 Beneath the Surface of Chains-of-Thought: A Mechanistic Interpretation of Reasoning Operations in LLMs
八类推理操作在LLM隐层形成可分的几何结构,中层最强,且因果依赖前文上下文。
前置知识
思维链(Chain-of-Thought, CoT)
指大语言模型在给出最终答案前先生成一系列中间推理文本的范式。形式上,模型自回归地生成推理轨迹 $r=(t_1,\dots,t_N)$ 再产出答案 $y$,即 $p(r,y|x)=\prod_{i=1}^{N} p(t_i|x,t_{<i})\cdot p(y|x,r)$。现代推理模型(如 DeepSeek-R1)通过强化学习直接把这条轨迹本身作为优化对象,而不仅优化答案对错。
本文的研究对象正是 CoT 轨迹中被文本显式表达的推理操作;理解轨迹如何生成、以及它已成为训练优化的直接对象,是理解论文动机的前提。
线性探针(Linear Probe)
一种可解释性技术:冻结模型,只在隐层表征之上训练线性分类器,检验某属性(情感、事实、类别)是否可线性解码。若在 held-out 数据上可分,说明该信息以线性形式编码于表征。本文用 L2 归一化 + PCA 降维 + LDA 构造探针,并用类均值差单位向量作为每个推理操作的表征方向。
论文所有核心结论(可分性、层间动态、错误迁移)都建立在探针分析之上;还需理解探针只能证明信息存在,不能证明模型确实使用了该信息。
线性判别分析(LDA)
有监督降维方法,寻找使类间散度最大、类内散度最小的投影方向。对 $C=8$ 类问题,LDA 子空间最多 $C-1=7$ 维。本文先做 PCA 到 128 维再接 LDA,把 span 表征投影到判别空间,再取类均值差的归一化方向作为 one-vs-rest 操作向量 $d_c=(\mu_c-\mu_{\neg c})/\lVert\mu_c-\mu_{\neg c}\rVert_2$。
操作向量与对齐分数 $a(i,c)=z_i^{\top} d_c$ 的定义依赖 LDA;论文还专门做了 PCA-only 实验证明结论不依赖这一有监督投影。
AUROC 与 AUPRC
两种二分类评估指标。AUROC 是随机正样本得分高于随机负样本的概率,0.5 为随机水平;AUPRC 是精确率-召回率曲线下面积,随机基线等于正类占比。本文把每类操作当作 one-vs-rest 二分类,类不平衡明显,因此 AUPRC 比 AUROC 更严格、更能反映真实可分性。
论文所有表格都报告 AUROC/AUPRC 成对数值(如隐藏探针 0.937/0.742),正确理解这两个指标才能判断结果强弱与置信区间意义。
注意力掩码干预(Attention Masking Intervention)
一种因果干预手段:在相同 token 序列上重跑模型,但禁止某些位置间的注意力(屏蔽 attention 对应通道),从而检验被掩信息对下游表征的贡献。本文禁止目标操作块首 token 关注前 30 个 token,度量对齐分数变化 $\Delta_c=a_{\text{after}}-a_{\text{before}}$,负值表示被掩前文原本有贡献。
论文 3.4 节的因果结论——后续操作表征依赖前文推理上下文——完全依靠这一干预设计,是从相关走向因果的关键。
残差流与层间表征
Transformer 每层的输出通过残差连接叠加进贯穿网络的残差流,$h_i^{(l)}\in\mathbb{R}^d$ 表示第 $l$ 层 token $i$ 的表征(本文还区分 attention 输出、MLP 输出与残差流三种表征类型)。不同层编码不同抽象度的信息:早层偏词汇与局部特征,中层偏语义与任务结构,晚层服务输出预测。
论文的核心发现之一是操作信息在中间层最强、早期为 token 局部线索、后期更分布式,没有层间表征的概念就无法理解这些结论。
研究动机
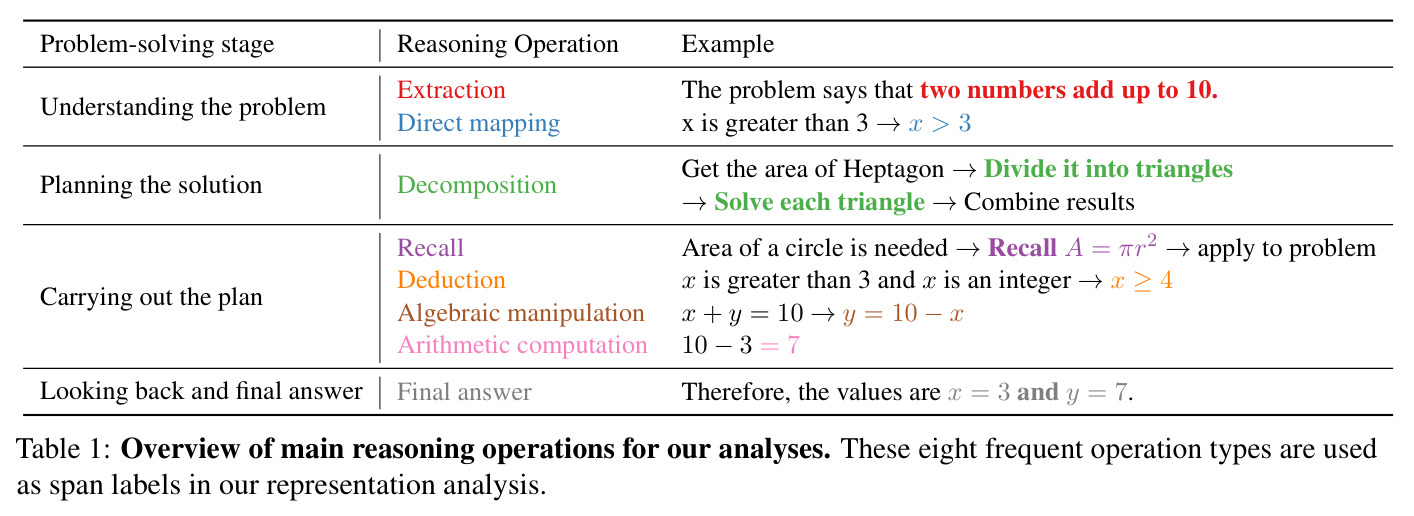
以 DeepSeek-R1 为代表、经强化学习与搜索算法训练的推理模型,其优化目标早已不止最终答案正确性,还包括产生答案的推理轨迹本身。在生成的思维链里,「提取条件」「回忆公式 $A=\pi r^2$」「把七边形分解成三角形」等操作在文本上显式可辨,但它们在模型内部如何组织几乎无人知晓。已有工作分两支:一支在轨迹层面刻画推理行为(如 Thought Anchors 找出影响后续推理的关键步骤,Gandhi et al. 分析验证、回溯、子目标设定等行为);另一支用隐状态预测答案正确性(Zhang et al., 2025)。两者都没有回答:文本上显式区分的不同推理操作,在表征空间里是否对应可分的几何结构?这种结构是超越词汇表面的真实功能组织,还是只是「回忆公式的地方总出现等号」这类表面统计规律?不弄清这一点,以轨迹为对象的训练优化就缺乏机制层面的解释基础。
本文的目标是本文的目标是在表征层面建立「文本显式推理操作」与「内部几何组织」的对应关系,并拆成四个可检验问题:(1) 同一推理操作的不同实例,是否在跨越具体题目与词汇内容的情况下共享几何结构,即在 held-out 表征中可分?(2) 这种操作级结构在模型哪些层、推理轨迹哪些时刻出现——是集中于个别提示 token,还是分布在整段操作 span 上?(3) 上下文因素如何影响该结构:token 身份、操作在轨迹中的位置、操作执行是否事实正确?(4) 前文推理上下文是否因果地参与后续操作表征的形成?作者希望把推理轨迹从输出文本层面「下沉」到内部表征层面,为以推理过程为优化对象的训练范式提供机制性理解,并为未来潜空间直接干预奠基。
与已有工作不同的是,独特切入角度在于「操作级」粒度与认知框架的结合。作者借用 Pólya《How to Solve It》(1945) 的四阶段问题解决理论(理解问题、拟定计划、执行计划、回顾作答),把 CoT 不看作同质 token 序列,而是功能块序列 $r=(c_1,\dots,c_K)$,每块承担明确功能。与语义概念线性表征研究(Park et al. 等关注名词性静态概念)不同,这里关注的是可在轨迹任意位置复现的局部过程性操作;与轨迹级行为分析(回溯、验证等跨多步行为)也不同,操作 span 局部、可标注、可跨模型比较。方法上则把相关性探针、严格的词汇/位置对照、注意力掩码因果干预与错误迁移实验串成完整证据链,首次在操作级连接可观察推理文本与内部几何结构。
核心方法
直觉上:如果模型在思维链里「真的在做」分解、回忆、演绎这些事,而不只是复述套话,那么同一操作的大量不同实例就应在隐空间彼此靠近、与其他操作分开。技术路线分四步:第一步,让推理模型对数学题生成思维链,只保留答案正确的轨迹;第二步,用 GPT-5 把轨迹切成非重叠的操作 span 并赋予八类标签;第三步,抽取每个 span 在各层的隐状态,经 L2 归一化、PCA 降到 128 维、LDA 投影到 7 维判别空间,用训练集构造每个操作的 one-vs-rest 方向 $d_c=(\mu_c-\mu_{\neg c})/\lVert\mu_c-\mu_{\neg c}\rVert_2$;第四步,在完全未见过的测试 span 上计算对齐分数 $a(i,c)=z_i^{(l,m)\top} d_c^{(l,m)}$,以 AUROC/AUPRC 逐层评估,再用层间扫描、span 内方差、共享 token、注意力掩码与错误迁移五组分析刻画该结构的性质。
核心创新是把「推理操作」当作表征分析的基本单位,并证明这些文本上显式的功能标签具有超越词汇的内部几何对应。与已有工作的本质区别有三。第一,线性表征研究过去处理名词性语义概念,而推理操作是动词性、过程性的功能,且会在轨迹中反复出现于不同位置;本文证明这类「操作」同样存在近线性组织。第二,先前推理轨迹分析(Thought Anchors、ReasoningFlow、认知行为分类)停留在可观察文本或轨迹层面,本文第一次把文本层面的功能结构与隐层几何连接起来。第三,本文不满足于「探针能分」这一弱结论,而是用文本分类器、词汇匹配对、竞争操作词表、数字/公式密度、仅位置分类五重对照排除表面解释,再用注意力掩码做因果检验、用错误推理做迁移检验,把「操作几何」从相关性升级为有因果支撑的结构性发现。
方法步骤详情
(1) 数据与模型:在 DAPO-Math-17K 与 TheoremQA 上,用 Qwen2.5-7B、Qwen3-8B、Gemma4-31B 以温度 0.7、top_p 0.9、最长 4096 新 token 采样生成思维链,Qwen3.6-27B 作 LLM 裁判筛选,每模型/数据集保留 500-700 条正确轨迹。(2) 操作标注:GPT-5 按 Pólya 四阶段体系把轨迹切成非重叠 span 并赋 8 类高频标签(Extraction、Direct mapping、Decomposition、Recall、Deduction、Algebraic manipulation、Arithmetic computation、Final answer);超过 50 token 的 span 取生成熵最高处为中心的 50-token 窗口,超过 300 token 剔除;人工验证显示 96.4% span 有人类多数票(Fleiss' κ=0.666),GPT-5 与人类一致率 76.2%(Cohen's κ=0.715)。(3) 探针构建:每操作最多 300 训练/60 测试 span,问题级划分,依次做 L2 归一化、PCA 降到 128 维、LDA 投影到 7 维,所有参数仅由训练 split 拟合后冻结用于测试。(4) 评估与分析:held-out 上计算 one-vs-rest 对齐分数 $a(i,c)=z_i^{\top} d_c$ 并逐层报告 AUROC/AUPRC,再做 span 内方差、共享 token 分化、注意力掩码干预 $\Delta_c=a_{\text{after}}-a_{\text{before}}$、错误 span 零再训练迁移四组延伸分析。
技术新颖性
技术新颖性体现在四个层面。其一,分类学设计:把 1945 年的 Pólya 问题解决理论与现代 LLM 机制分析结合,构建了含 4 阶段、28 种操作的层级分类体系(附录 E),主实验选取跨阶段高频的 8 类,兼顾认知合理性与统计可行性。其二,探针协议严谨:问题级 train/test 划分、类均衡采样、全部参数只在训练集拟合、随机标签与随机位置双重基线、5000 次分层 bootstrap 置信区间与 1000 次置换检验——48 个 AUROC 置信区间全部高于 0.5,96 个置换检验均 p<0.001。其三,「分布性」分析:用 span 内方差证明中层操作信号分布于整段而非个别提示词,配合共享 token 实验(the、is、of 等功能词在不同操作上下文中表征分化)排除 cue-token 解释。其四,干预与迁移:掩码实验显示推理操作的前文依赖显著强于文学话语控制组($\Delta=-0.4356$ vs $+0.0409$),错误 span 迁移则揭示功能身份与执行正确性部分分离,这些都是该领域此前未给出过的证据。
实验结果
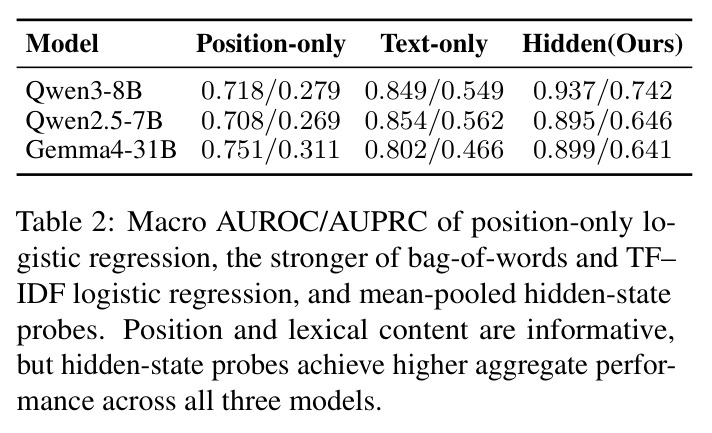
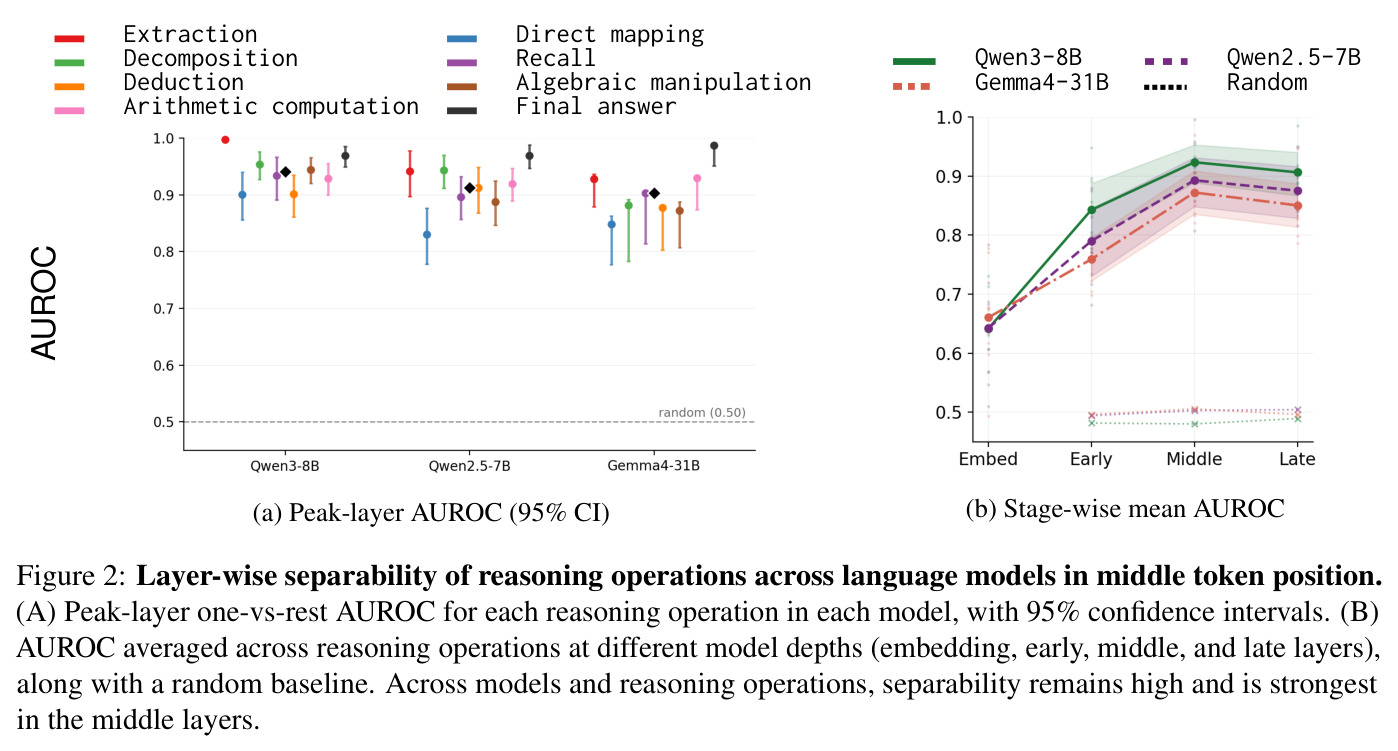
五大核心发现,均有数字支撑。(1) 操作可分且中层最强:Qwen3-8B 隐藏探针 macro AUROC/AUPRC 达 0.937/0.742,高于文本基线 0.849/0.549(三模型 AUROC 提升 0.041-0.097、AUPRC 提升 0.084-0.193)和仅位置分类器 0.718/0.279,且可分性在中间层达峰。(2) 非表面现象:含竞争操作高频词的对抗子集上仍达 0.919/0.848;限定 50-75% 数字/公式密度时 0.917/0.789;去掉 LDA 仅用 PCA 保持 0.938/0.716;按轨迹位置分档评估仍有 0.916-0.973。(3) 泛化强:Llama-3-8B 复制实验 0.958/0.840;Qwen3-8B 探针零再训练迁移到 GPQA-Diamond 0.938/0.764、MATH-500 0.948/0.799。(4) 信号动态:早期层信号 token 局部、中层变分布式(span 内方差先降后微升),相同表面 token(the、of 等功能词)在中后层沿操作方向分化;掩蔽块首 token 对前 30 token 的注意力使对齐分数显著下降($\Delta=-0.4356$, p<0.0001),而文学话语控制无效应($\Delta=+0.0409$, p=0.809)。(5) 错误下几何仍在:事实错误 span 上 0.920/0.759 与 0.955/0.877,略低于操作匹配非错误 span 的 0.937/0.808、0.971/0.901;Deduction 与 Arithmetic Computation 衰减最明显,Recall 几乎不变。
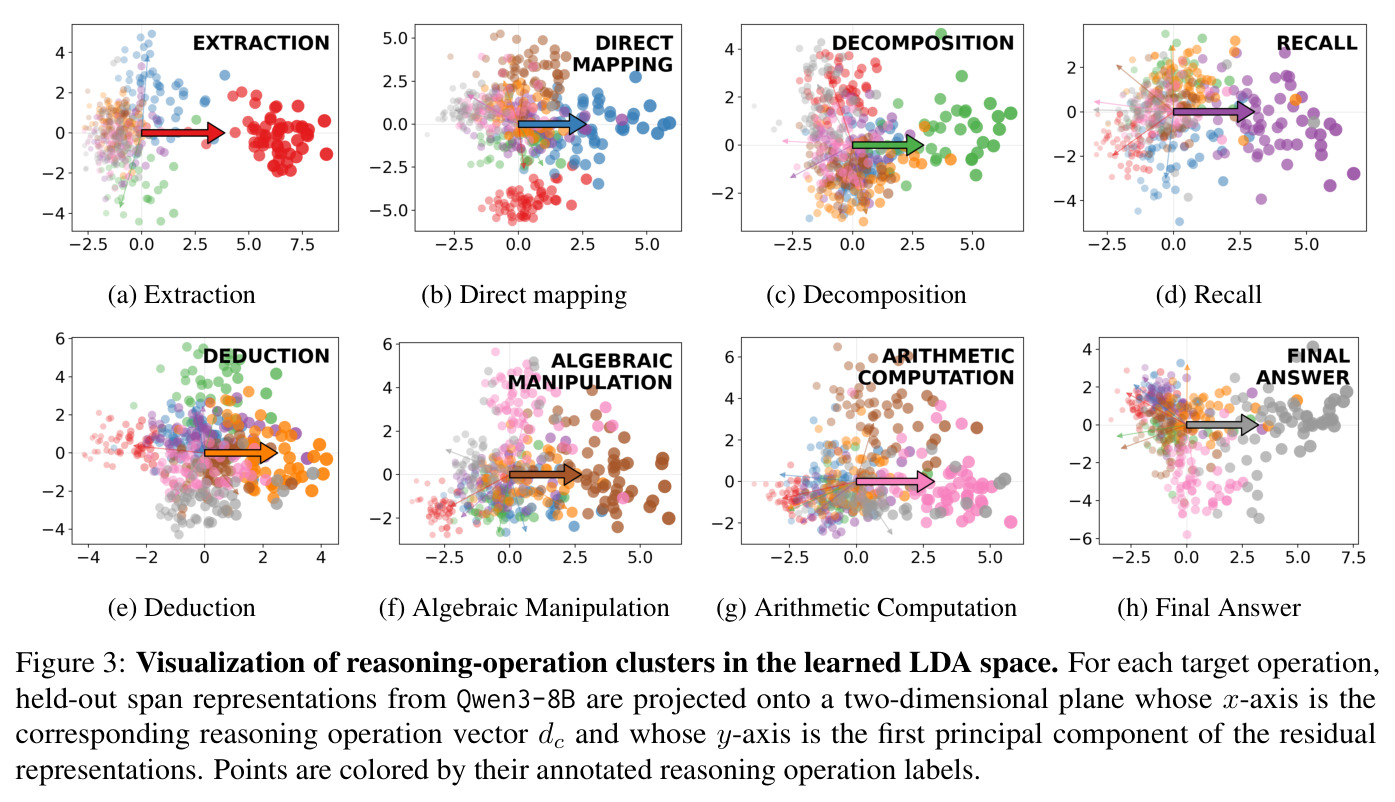
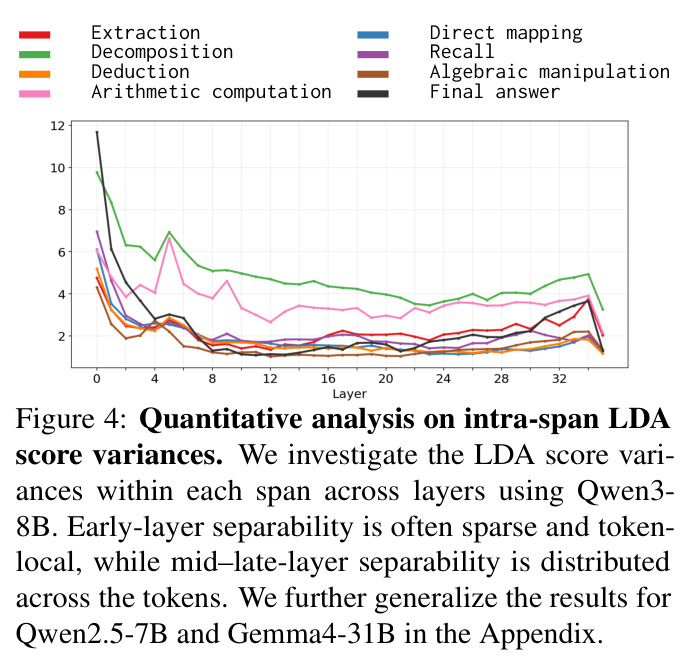
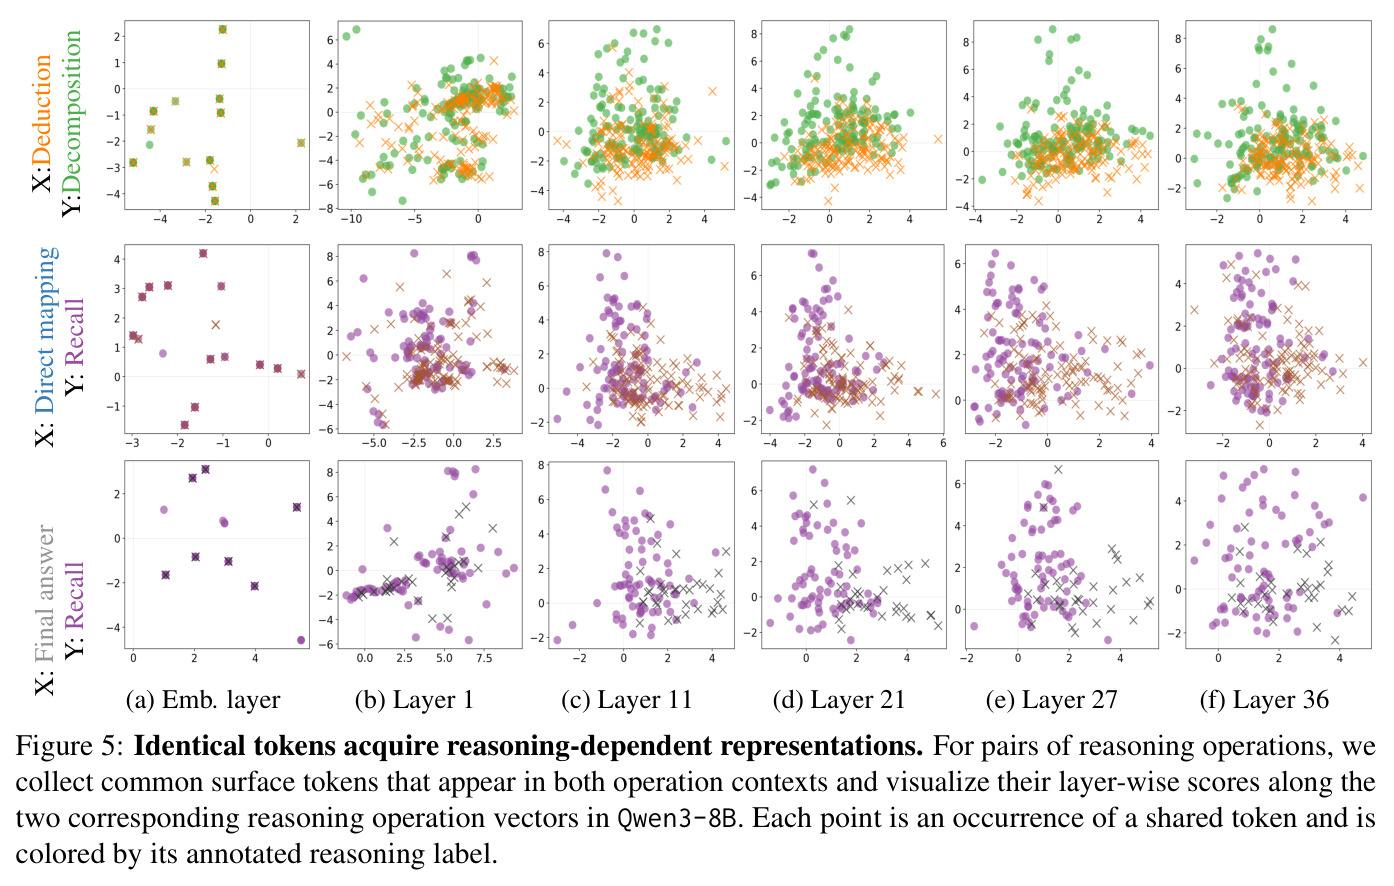
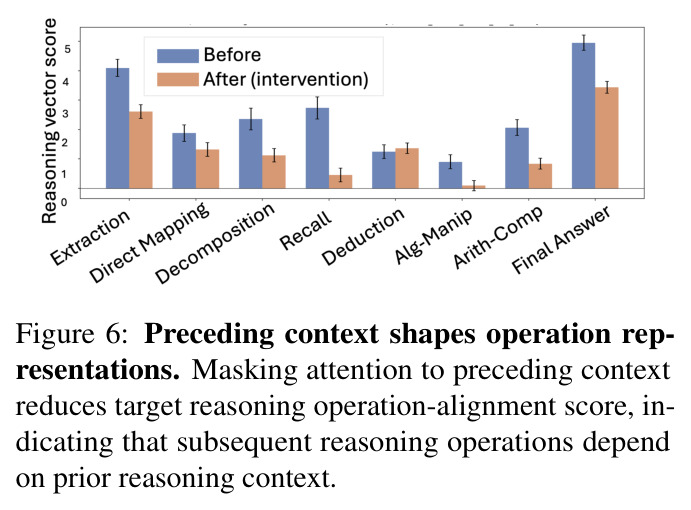
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 推理操作 one-vs-rest 可分性(Qwen3-8B,middle-token) | macro AUROC/AUPRC | 隐藏状态探针 0.937/0.742 | 仅位置逻辑回归 0.718/0.279 | +0.219/+0.463 |
| 推理操作可分性 vs 文本基线(Qwen3-8B,均值池化) | macro AUROC/AUPRC | 隐藏状态探针 0.937/0.742 | BoW/TF-IDF 中较强者 0.849/0.549 | +0.088/+0.193(三模型 AUROC 提升 0.041-0.097,AUPRC 提升 0.084-0.193) |
| 跨数据集零样本迁移(GPQA-Diamond,Qwen3-8B 探针) | macro AUROC/AUPRC(层 10-30 平均) | 0.938/0.764 | 随机基线 AUROC 0.500(原任务训练、零再训练) | 跨任务迁移几乎无衰减 |
| 跨数据集零样本迁移(MATH-500,Qwen3-8B 探针) | macro AUROC/AUPRC(层 10-30 平均) | 0.948/0.799 | 随机基线 AUROC 0.500 | 跨任务迁移几乎无衰减 |
| 跨模型复制(Llama-3-8B) | macro AUROC/AUPRC(均值池化,层 10-28) | 0.958/0.840 | 随机标签基线(AUROC 0.500) | 证明现象不限于 Qwen/Gemma 家族 |
| 事实错误 span 上的操作识别(Qwen3-8B,均值池化) | macro AUROC/AUPRC | 错误 span 0.955/0.877 | 操作匹配的非错误 span 0.971/0.901 | 可分性下降但保持高位,表明几何持久、部分衰减 |
| 竞争操作词表对抗子集(Qwen3-8B) | macro AUROC/AUPRC | 冻结探针 0.919/0.848 | 随机基线(AUROC 0.500) | 含对立操作 cue 词仍强可分,排除词汇线索解释 |
局限与改进
作者明确承认三点局限:其一,操作标注由 GPT-5 生成,仅在 84 个 span 上做了人工验证(多数票一致率 96.4%、Fleiss' κ=0.666),且只验证标签、未验证 span 边界,因此标签只是文本表达功能的近似而非潜在认知状态真值;其二,实验局限于数学与定理驱动推理和 Qwen/Gemma/Llama 几个模型家族,常识推理、规划、代码生成等场景的几何组织可能不同;其三,工作是诊断性而非干预性/应用性的,未评估操作向量能否实际改善模型行为。我的补充观察:GPT-5 既做操作标注又参与体系设计,标注偏差可能系统性传导到探针评估;训练与测试划分虽按问题 shuffle,但 Qwen3-8B 有 14/608 个问题同时出现在两个 split;每操作最多 300/60 的 span 预算较小(Decomposition 仅 233 训练/52 测试),部分操作 AUPRC 置信区间较宽(如 Deduction middle 0.531 [0.437, 0.640]);线性探针只证明信息存在、不证明模型在「使用」它,掩码干预也只覆盖 chunk 起点一种情形。
独立分析的弱点
独立分析后我认为有四个弱点值得注意。第一,标注循环性:用 LLM(GPT-5)给 LLM 的输出打操作标签,若 GPT-5 的分类标准本身偏向某种表面模式,探针学到的可能部分是标注器偏差与表面规律的混合物,尽管五重对照大大缓解了这一点,但无法完全排除;改进方向是引入更大规模、多标注者、含边界验证的人工金标准,或用不同厂商的 LLM 交叉标注并比较一致性。第二,操作粒度是精选的 8 类,完整 28 类体系中低频操作(如 Induction、Analogy 全程只有 1-2 个样本)无法分析,而它们可能恰是推理能力的关键;改进方向是构造针对稀有操作的定向数据增强或合成轨迹。第三,正确性判断依赖 LLM 裁判(Qwen3.6-27B)而非精确匹配,正确轨迹集合可能混入裁判误判样本;改进方向是在可精确匹配的数据子集上复验全部结论。第四,掩码干预只测了 chunk 首 token 对紧邻前文的依赖,且掩码长度、随机对照块的样本选择与主实验不完全可比(作者自己也承认效应量不可直接跨设置比较);改进方向是做逐 token 滑窗掩码曲线,刻画操作表征形成的完整时间线,并对效应量做严格的配对等价检验。
未来方向
作者在结论与局限中提出的方向包括:用操作探针支持推理失败检测、验证与解码时控制,以及基于激活的操作向量引导(steering);对更大规模、含边界验证的标注数据进行验证;把分析扩展到常识推理、规划、代码生成与不同架构/训练流程的模型。基于本文成果还可自然延伸:(1) 与过程奖励模型(PRM)结合——Deduction 与 Arithmetic Computation 在错误执行下可分性下降最明显,操作向量或许能定位「哪一步的执行质量劣化」,为步级奖励提供内部信号;(2) 检验连续潜空间推理方法(Coconut、CODI 等把推理压入连续空间)是否保留操作几何,用以判断压缩推理是否丢失功能结构;(3) 用操作向量做训练时正则或 RL 奖励塑形,鼓励轨迹覆盖多样化操作阶段(如防止 Decomposition 缺失);(4) 把操作方向做成可解释监控面板,实时可视化模型当前正在执行哪种推理操作,辅助对齐与调试;(5) 深化因果方向:不只掩码删除,而是向表征注入操作方向,检验能否诱导出对应的推理操作行为。
复现评估
复现条件较好。代码与项目材料已开源(github.com/naver-ai/beneath-cot);三个主模型均为 HuggingFace 公开 checkpoint(Qwen/Qwen2.5-7B、Qwen/Qwen3-8B、google/gemma-4-31B-it),另有 Llama-3-8B 复制实验;所用四个数据集均公开。算力方面:每个模型/数据集生成轨迹用 8 张 NVIDIA V100(温度 0.7、top_p 0.9、最多 4096 新 token),后续表征分析单 V100 节点即可,中等规模实验室可负担。需注意的复现细节:轨迹生成未固定随机种子(论文明确说明语料不可逐位复现),但问题级划分、采样与随机基线构造固定 seed=42;操作标注与错误标注需要 GPT-5 API(有费用);正确性判断用 Qwen3.6-27B 作裁判而非规则解析;GPT-5 标注系统提示词全文与人类标注协议(韩语界面、三标注者投票)都在附录 E 公开。总体而言,拥有单节点多卡 GPU 与少量 API 预算的团队可在数天内复现主结果,难度中等。
论文图表
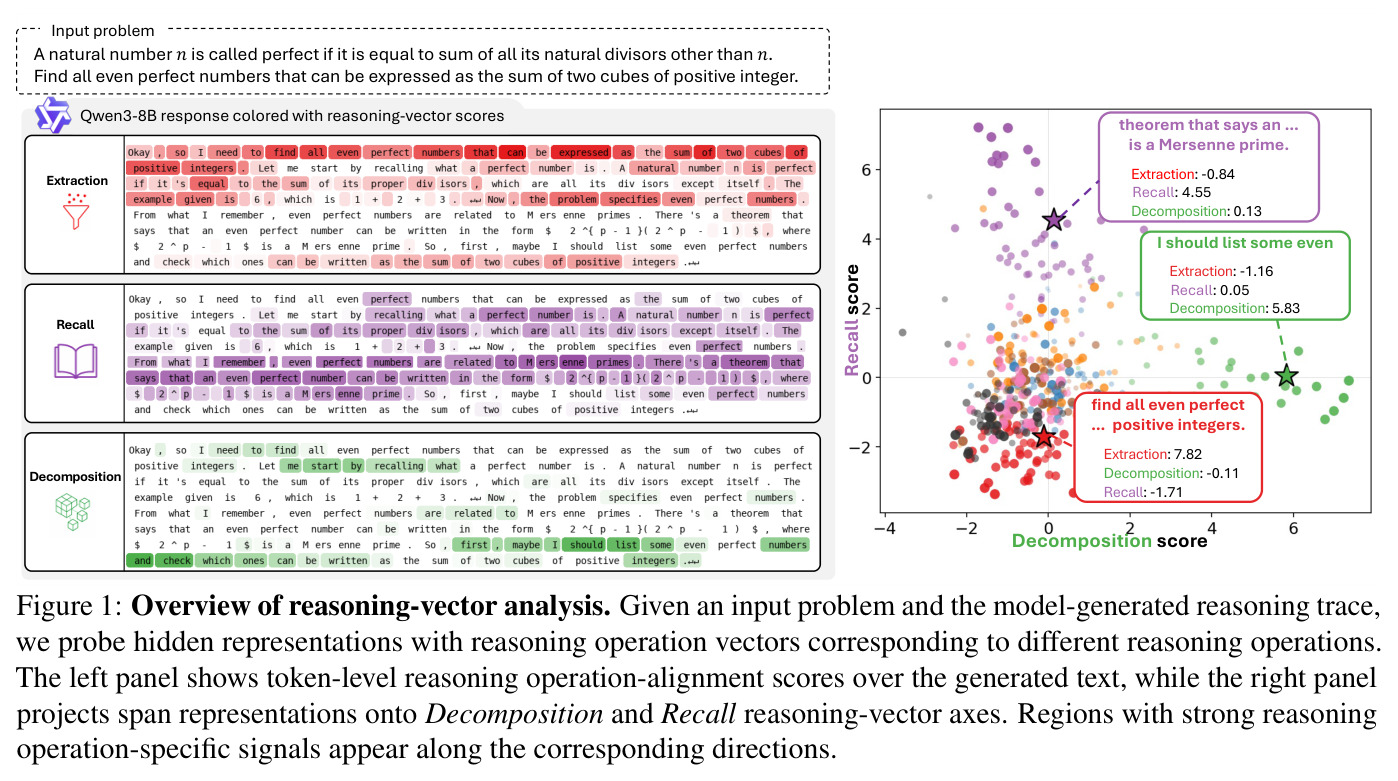
对代表性轨迹逐层逐 token 计算与目标操作向量的对齐分数并绘制热图(含 Extraction 两例与 Arithmetic Computation 一例):早期层信号弱或局限于个别 token,中层在连续 token 上变得连贯,晚层可能又减弱;同一 token(如逗号)在不同出现位置分数强度不同。
以 token 级分辨率展示操作信号的层间涌现过程,是 Figure 4 分布性结论的定性对应,直观呈现「表征经上下文处理而涌现」。
为 Recall、Decomposition、Deduction 三类操作补充的层×token 热图,模式与 Figure A 一致:早期稀疏且局部,中层在连续 token 上结构化,晚层定位减弱;同一标点在不同操作上下文中的分数强度不同。
跨更多操作类型复证 token 级动态模式,说明结论不是个别操作的特例,增强了分布性发现的普适性。
对 Qwen2.5-7B 与 Gemma4-31B 绘制 span 内 LDA 分数方差随层的变化曲线,8 个操作逐一展示:与 Qwen3-8B 相同,早期方差高、中层下降、后层略回升。
把「从 token 局部线索到 span 分布信号」的转变推广到其他模型家族,排除 Qwen3-8B 特异性,支撑跨模型稳健性主张。
主文 Figure 6 之外的两种干预:(a) 掩蔽整个前一个标注操作块(preceding-chunk masking),(b) 掩蔽长度相当的随机前文块(random-control)。效应量排序为 随机块 < 前块 < 紧邻 30 token,说明相关前文的作用强于任意前文;Recall 是随机对照也产生较大下降的例外。
补全因果论证的对照链:只有证明结构化前文比随机前文更重要,才能排除「去掉任意上下文都会掉分」的平凡解释。
附录中 middle-token 表征的逐层 AUROC/AUPRC 曲线(Qwen3-8B、Qwen2.5-7B、Gemma4-31B 各两幅,8 操作分色,实线为真实标签,虚线为随机标签/随机位置基线):全部明显高于基线且峰值在中间层。
给出 Figure 2 汇总图背后的完整逐层数据,供读者核查每个操作、每一层的表现与置信度。
与 Figure E 同构,但使用均值池化的 span 表征:均值池化因聚合了 span 内多 token 信息,往往从更早的层就获得较强可分性,与 span 内方差分析一致。
证明结论不依赖于「取中间 token」这一特定表征选择,池化方式的差异也可用分布性发现解释。
使用 span 首 token 表征的逐层 AUROC/AUPRC 曲线,定性趋势与 middle/mean 一致:高于随机基线、中间层最强,但单 token 表征对局部词汇内容与边界效应更敏感。
与 Figure H 一起完成 first/middle/mean/last 四种表征选择的稳健性矩阵,说明操作信息存在于 chunk 内多个位置。
使用 span 末 token 表征的逐层 AUROC/AUPRC 曲线:与 first-token 情形类似,保持相同的层间趋势与跨模型一致性,定量上有小幅差异。
补全表征选择稳健性的最后一块,使「可分性不是特定 span 位置的伪影」这一主张有完整证据。
对早层(0-4 层均值)与高 AUROC 晚层的信号用相同的三 token 因果滑动均值和阈值检测起始位置,计算 $\delta^{\text{onset}}_c=t_{\text{late}}-t_{\text{early}}$:八个操作均值均为负,其中 Arithmetic Computation(77.0% 样本为负,均值 −9.399)与 Final Answer(87.5%,均值 −2.719)最明显,Extraction、Algebraic Manipulation 等接近对半;p 值为未校正的单侧 Wilcoxon 符号秩检验。
探索不同操作的信号在早/晚层的出现时序差异,提示晚层信号对某些操作可能更早形成,为后续因果方向研究提供线索;作者也强调其检测器依赖性。
把同样的探针流程应用到 Llama-3-8B(每操作最多 100 训练/20 测试,层 10-28 平均):均值池化 macro AUROC/AUPRC 0.958/0.840,middle-token 0.910/0.731;其中 Decomposition 0.987/0.852(mean)最高,Deduction 最难(0.869/0.652)。
在完全不同的模型家族上复制主结果,是「操作几何跨架构存在」这一泛化主张的直接证据。
把在 DAPO-Math-17K/TheoremQA 上训练的 Qwen3-8B 探针不加任何再训练直接用于新任务标注 span(层 10-30 平均):GPQA-Diamond macro 0.938/0.764(mean),MATH-500 0.948/0.799;Final Answer 与 Extraction 最高,Direct Mapping 的 AUPRC 下降较多(如 0.506/0.455)。
证明操作几何不是特定数据集的伪影,探针可作为跨任务通用的推理监控工具,有很强的应用暗示。
只训练于正确轨迹的探针迁移到错误轨迹中的事实错误 span 与操作匹配非错误 span(层 10-30 平均):macro 上错误组 0.920/0.759(middle)与 0.955/0.877(mean)对比非错误组 0.937/0.808 与 0.971/0.901,多数配对 Wilcoxon 检验显著;分操作看 Deduction 与 Arithmetic Computation 下降最一致,Recall 无显著差异。
支撑「功能身份与执行正确性部分分离」这一精细结论:算错的操作仍被认出是算术操作,只是几何可分性略降。
去掉有监督 LDA、只用 PCA(8/32/128 主成分)加训练集类均值方向评估:均值池化下 macro AUROC 从 0.846 到 0.938(128 主成分时 Qwen3-8B 0.938/0.716、Qwen2.5-7B 0.914/0.700、Gemma4-31B 0.872/0.552),主要增益出现在 8 到 32 主成分之间。
排除「可分性是有监督投影制造出来的」这一方法论质疑,说明操作信息在无监督压缩空间中就已存在。
列出完整层级分类体系中各操作在三模型上的样本量:高频操作如 Arithmetic computation(Qwen3-8B 3331)、Algebraic-manipulation(2172)、Recall(1903),而 Induction、Analogy 全程仅 1-6 个样本;Decomposition 在 Qwen3-8B 只有 285。
解释了为何主分析只选 8 类操作以及 Decomposition 采样不足的问题,是评估统计功效与样本偏差时必须参考的表。
对每个锚 span 构造词汇相似但标签不同的对照 B 与词汇不同但标签相同的对照 C,比较冻结探针到锚操作方向的距离差 $\Delta_A=d_c(A,B)-d_c(A,C)$:八个操作中位数效应均为正(Extraction 4.68、Decomposition 3.91、Final Answer 1.75 等),Extraction、Direct Mapping、Decomposition、Deduction、Final Answer 的 95% 置信区间完全在零以上。
在词汇层面精细匹配后操作身份仍胜过词汇相似性,是排除「宽泛词汇相似性解释」的关键定量证据。
限定数字/数学 token 密度 50-75% 的 49 个测试 span(覆盖五个操作):均值池化 macro 0.917/0.789,各操作均高于随机(AUROC 0.500),其中 Direct Mapping 0.994/0.979、Final Answer 0.999/0.998,而 Arithmetic Computation 的 AUPRC 降至 0.510(随机 0.204),是边缘最小者。
专门回应「Arithmetic Computation 可分只是因为公式和数字多」的质疑,证明符号密度本身不足以解释可分性。
5000 次分层 bootstrap 得到的层平均 AUROC/AUPRC 95% 置信区间(Qwen3-8B 层 10-30、Qwen2.5-7B 层 8-23、Gemma4-31B 层 13-40):如 Qwen3-8B Extraction 均值池化 AUROC 0.998 [0.995, 1.000],全部 48 个 AUROC 区间完全高于 0.5;Deduction 等 AUPRC 区间较宽(如 0.648 [0.545, 0.753])。
提供结果的完整不确定性刻画,让读者能区分「非常稳的操作」(Extraction、Final Answer)与「样本少、区间宽的操作」(Deduction、Direct Mapping)。
7 名标注者中每人独立标注 84 个抽样 span 中的三分之一:人类一致率方面 50/84(59.5%)全票、81/84(96.4%)达多数票、Fleiss' κ=0.666;GPT-5 与人类多数票精确一致 64/84(76.2%)、Cohen's κ=0.715、软一致 80.4%(少数票匹配记半分)。
这是评估全文标签可靠性的基石:没有这张表,就无法判断后续所有 AUROC 是在测量模型表征还是在测量标注噪声,也直接对应作者自己承认的首要局限。