交互式视频生成中的投机采样 Speculative Sampling in Interactive Video Generation
把大块双向预测缓存为可撤销的未来,兼顾大窗口质量与细粒度低延迟交互。
前置知识
潜在扩散视频生成与 DiT
潜在扩散模型先把视频经 3D VAE 压缩成潜在张量,再在潜在空间用 Diffusion Transformer(DiT)迭代去噪。DiT 用 Transformer 骨干对整段潜在序列做联合注意力,一次采样调用即可同时产出多个时间步的 latent,是本文'块(chunk)'的基本计算单元。
论文的块大小 K、采样调用、双向建模窗口全部定义在 DiT 潜在采样层面,是理解延迟模型和方法的前提。
分块自回归视频生成与双向窗口
把长视频切成时长为 $T=K\delta$ 的块:块内用双向时间注意力联合采样 $K$ 个 latent,块间以自回归方式基于历史续写。块越小,吸收新条件的机会越频繁但联合建模弱;块越大质量越好,但新条件要等到块边界才能影响输出。
本文的核心问题正是块大小 $K$ 的两难,方法目标是把'建模窗口'与'输出承诺'解耦。
投机采样
源自 LLM 推理:小模型快速起草多个 token、大模型并行验证,用一次前向换多个输出步。本文借用'多算未来、按需取用'的思想但机制不同:同一个大模型一次多采样 $K-1$ 个未来 latent,缓存为可撤销预测;条件不变则免费复用,条件变化则只重算可行后缀。
方法名与核心机制来源;必须区分本文投机采样与经典投机解码(草稿-验证双模型)的本质差异。
3D VAE 时间压缩与首帧路径
视频潜空间 VAE 在时间维度以比率 $r$ 压缩,一个 latent 对应 $r$ 个像素帧、时长 $\delta=r/f$。其预训练续写接口通常要求'未压缩的首帧 latent',而流式缓存中的中间帧属于时间压缩后的 latent 组,二者格式不兼容,不能直接输入。
这是把双向模型改为流式服务的关键工程障碍,论文的'解码为像素再经首帧路径重编码'适配方案由此而来。
USP 序列并行
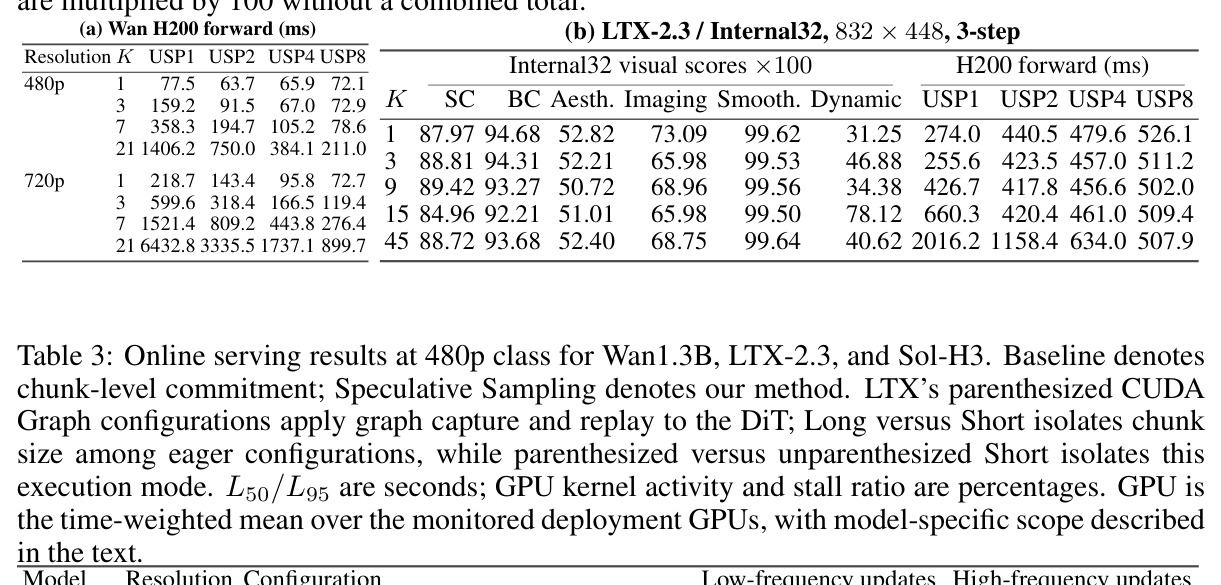
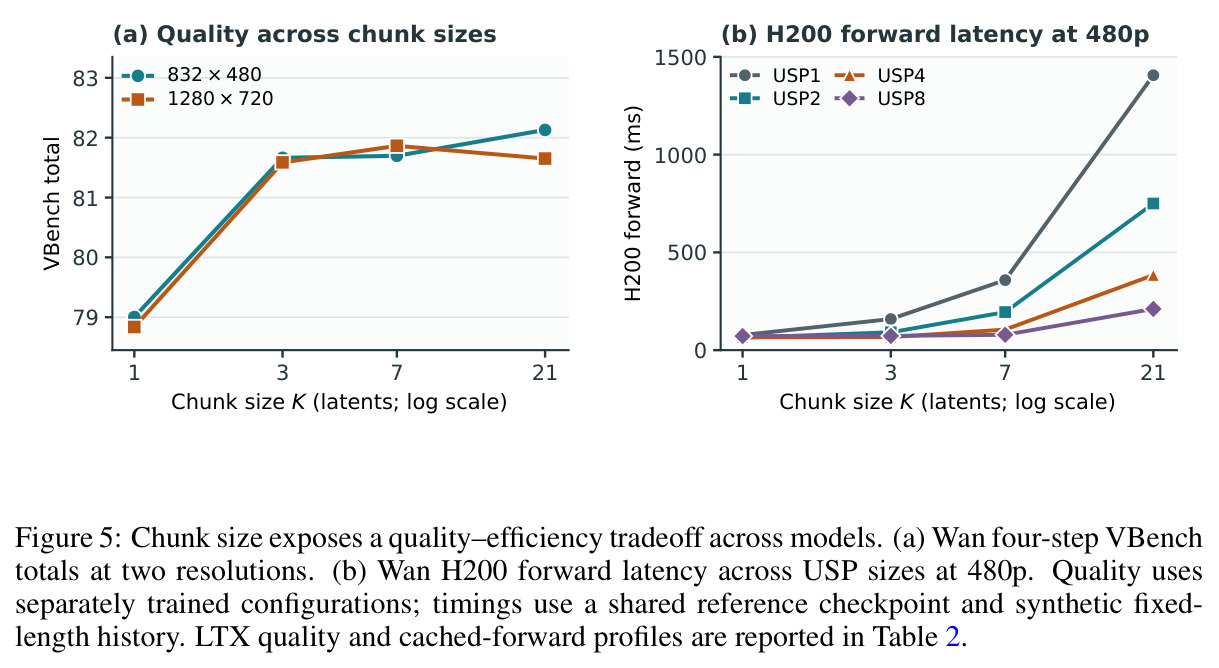
Unified Sequence Parallelism 把长序列切分到多张 GPU 并行执行注意力与前向,用于压缩单次前向延迟。论文用它证明'更多并行度可以让大块几乎和小块一样快':Wan 480p 下 $K=7$ 在 USP8 上仅 78.6ms,接近 $K=1$ 在 USP1 上的 77.5ms。
它是'优化焦点应转向加速每块生成时间 $C$ 而非缩小块'这一核心主张的主要实验支撑。
研究动机
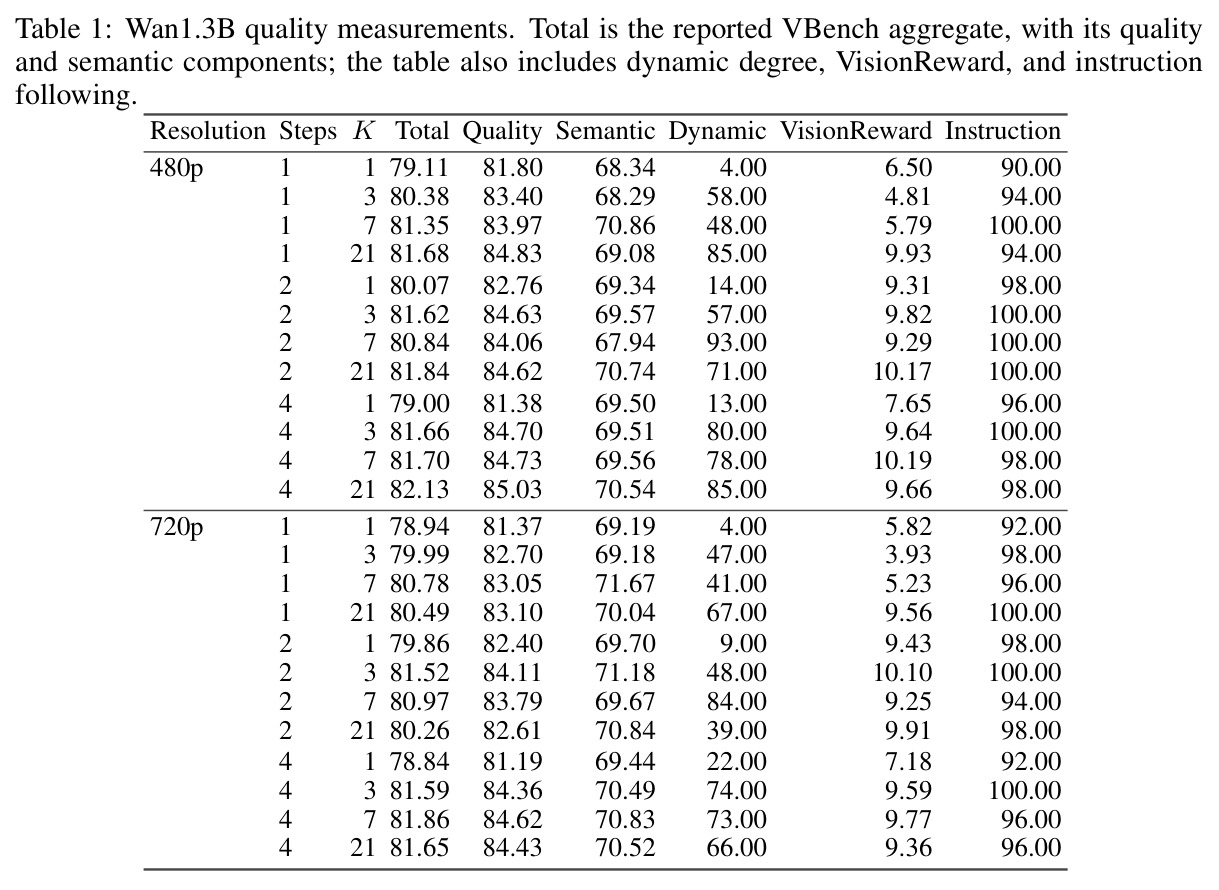
交互式视频生成要求新到达的条件(视角指令、动作指令等)能及时影响正在播放的视频,而生成吞吐量并不能刻画这一需求——再快的模型也可能让用户等到下一个生成/播放边界。主流路线是细粒度分块自回归生成:块越小交互越及时,但论文的初步实验揭示小快块有双重代价。质量上,Wan1.3B 四步采样 480p 下 $K=1$ 的 VBench 总分仅 79.00,$K=3$ 升至 81.66,$K=21$ 达 82.13;动态程度更从 4.00 涨到 85.00,说明逐帧小块严重限制联合时间建模。效率上,小块无法利用 GPU 并行。更关键的是延迟结构问题:只要新内容只能在固定块播放边界进入播放,在均匀到达条件下期望等待满足 $E[R+Q]\geq T/2$($T=K\delta$ 为块时长),这是调度与播放对齐强加的等待下界,与模型快慢无关。因此低延迟被迫以缩小建模窗口为代价。
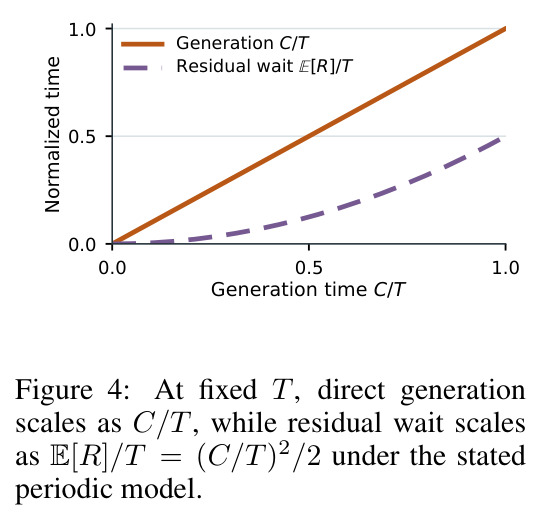
本文的目标是本文目标是把'双向建模窗口大小'(决定视觉质量与 GPU 并行利用)与'输出承诺粒度'(决定交互延迟)彻底解耦:保留大块联合采样(如 $K=21$)的质量优势,同时实现 $q=1$(逐 latent、每 $\delta$ 秒)的细粒度交付与低延迟响应,消除块边界造成的 $T/2$ 等待下界。更远的目标是开辟一条替代路线:无需 Self-Forcing 式流式后训练,直接把大型双向教师模型服务进低延迟交互式流媒体系统,并把社区的优化焦点从'把块做小'转向'把每块生成时间 $C$ 做短'——因为理论显示生成时间缩短时残余等待按 $(C/T)^2/2$ 二次方收敛。
与已有工作不同的是,独特切入有三点。其一,视角上的形式化:作者先建立服务系统模型,把响应延迟分解为 $L=R+C+Q$(生成前等待、生成本身、播放对齐等待),证明瓶颈来自块边界的调度与对齐而非生成速度——这一等待下界此前从未被显式刻画。其二,方法上的反向投机:借鉴 LLM 投机解码'多算未来'的思想但反其道行之,不是用草稿模型省算力,而是把大窗口必然多算出来的未来缓存起来,条件不变时免费复用、条件变化时只重算可替换后缀,使块大小从延迟约束变成质量-时间的联合决策变量。其三,定位上的差异化:NFD 虽也在帧因果骨干上做多帧投机采样,但保留因果掩码、不利用窗口内双向注意力;本文首次在放大的双向窗口上做细粒度承诺,且不经任何因果化后训练。
核心方法
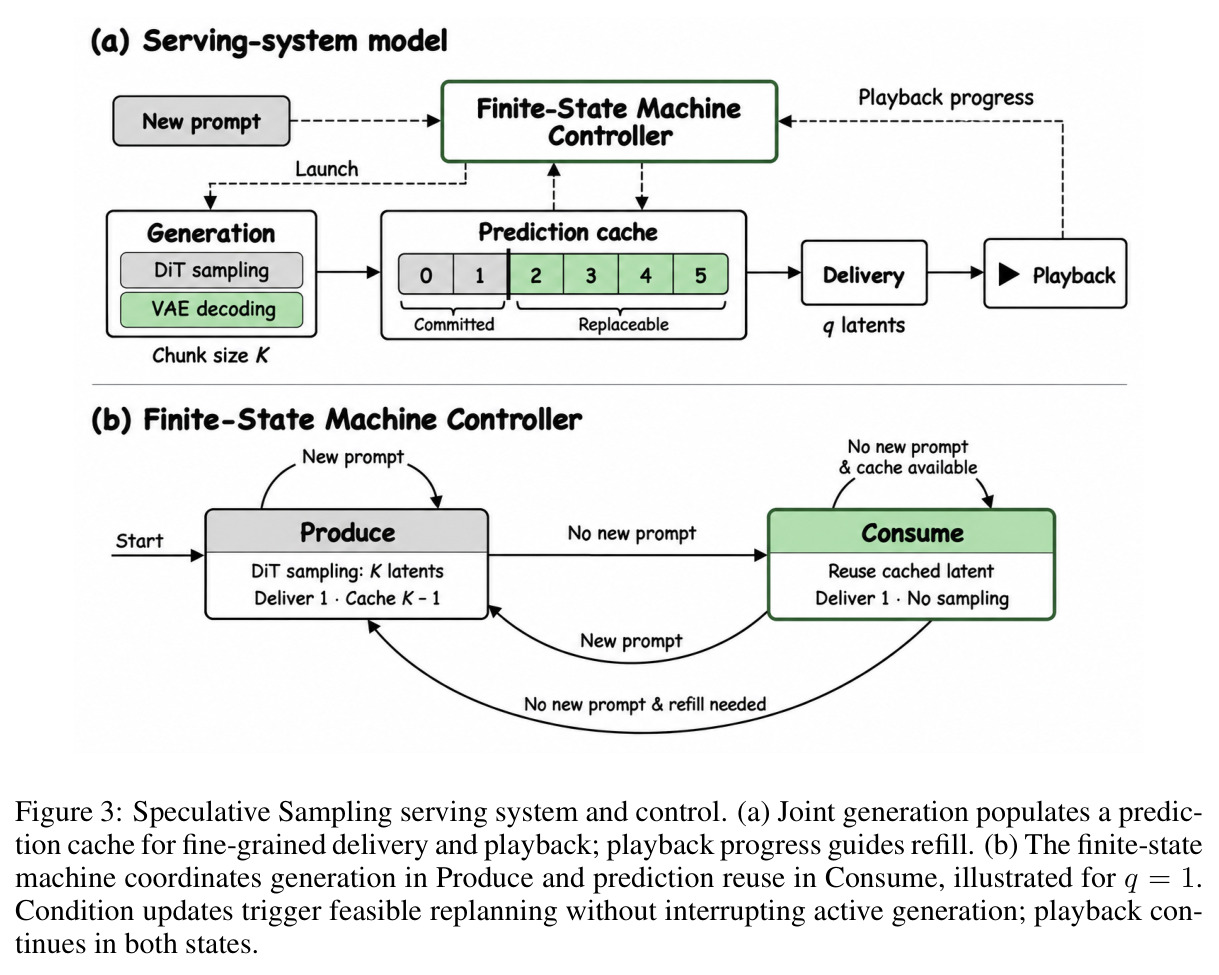
直觉版本:一次 DiT 采样调用能以远小于线性增长的代价联合采样 $K$ 个 latent,那就每次多采 $K-1$ 个'多余'的未来 latent,只交付 1 个,其余存为投机预测缓存;条件不变则后续交付直接从缓存白拿(不重采样),条件变了就锁定已承诺前缀、只对可行后缀重新采样。技术路线分四步:(1) 服务系统建模,把延迟分解为 $L=R+C+Q$ 并证明固定块边界下 $E[L]\geq C+T/2$,而细粒度承诺下对齐只由 $\delta$ 决定;(2) 块大小消融确认 $K>1$ 在质量与并行效率上更优(480p 四步 VBench 79.00→82.13,前向延迟仅 2.05 倍);(3) 构造两状态有限状态机控制器(Produce/Consume)协调联合生成与缓存消费,播放独立推进;(4) 适配双向模型的流式续写接口,解决 3D VAE 时间压缩带来的 latent 格式问题。这样块边界不再施加等待下界,响应下限变成'生成时间加最多一个 $\delta$ 的对齐'。
核心创新是'联合预测多少'与'承诺多少'的解耦。传统分块生成中两者绑死:$K$ 既是建模窗口又是交付单元,想低延迟就必须缩小 $K$、牺牲质量。本文在每次采样调用中,把下一个待交付 latent 加上 $K-1$ 个噪声 latent 作 padding 组成双向窗口,采样得 $\hat{Y}_j\sim p_\theta(\cdot\mid H_j,c)$($H_j$ 为保留前缀的条件状态,$c$ 为当前条件),预测连同源/播放映射与条件版本一起入缓存;已承诺内容不可替换,未承诺未来保持可撤销,交付粒度 $q=1$。与 LLM 投机解码的本质区别:不需要草稿-验证双模型,只缓存自己多余的未来,无条件变化时零额外采样调用。与 NFD 的区别:NFD 在放大的因果窗口内提吞吐,本文在放大的双向窗口内提质量并做细粒度交付。于是块边界的 $T/2$ 等待下界被移除,对齐粒度由 $q$ 而非 $K$ 决定。
方法步骤详情
第一步,服务系统建模:将响应延迟分解为 $L=R+C+Q$,其中 $R=t_{start}-t_{arrival}$ 为条件到达到生成启动的等待,$C=t_{ready}-t_{start}$ 为到首个可交付输出的生成时间(含 DiT 采样与必要的 VAE 解码),$Q=t_{playback}-t_{ready}$ 为播放对齐等待;推导固定块边界下 $E[L]\geq C+T/2$,细承诺下 $E[R]=C^2/(2T)$、$Q<\delta$。第二步,投机采样与缓存:在分支位置 $j$ 用 $K$-latent 双向窗口采样并缓存预测,附加条件版本号;正常补给出(剩余可播覆盖接近计算提前量时)而非每次交付都触发采样。第三步,FSM 控制:Produce 表示生成任务活跃、Consume 表示空闲可复用缓存;事件包括条件到达、就绪、任务完成、播放 tick、唤醒;Produce 期间到达的更新只写 pending 版本不打断任务,多个更新合并到最新;完成事件经守卫 $g(\bar{x},t)$ 决定立即再启动或回落 Consume。第四步,守卫式替换:更新时选最早可行边界(越过保护前缀 $\ell$、条件输入齐备、VAE 连续有效、旧前缀能覆盖新内容就绪前的所有播放截止期),锁定前缀、只重算可行后缀,不把新样本裁短到旧块剩余长度。第五步,双向模型流式适配:将保留边界解码为像素,经 VAE 首帧路径重编码成续写接口要求的未压缩首帧 latent,再启动下一次采样。
技术新颖性
新颖性有四层。概念层:首次把交互式视频生成形式化为'预测+输出承诺'的联合问题,证明响应延迟的 $T/2$ 下界源于块边界对齐而非生成速度,从而把优化目标从缩小块转向降低生成时间 $C$(残余等待按 $(C/T)^2/2$ 缩放,加速收益被二次放大)。方法层:重计算高效的投机采样——无条件变化时预测复用不增加任何采样调用,更新只重算可行后缀,相对开销 $A\simeq 1/(1-w)$($w$ 为被丢弃预测比例),并在独立更新模型下给出 $A=Kp/(1-(1-p)^K)$、小更新率下 $A-1\simeq\lambda(T-\delta)/2$;控制器被形式化为带完整寄存器、守卫 $F_j$ 与不变量的扩展 FSM(附录 C),可直接照此实现。系统层:证明双向教师模型可不经因果化后训练直接流式服务,用'解码-重编码'适配 3D VAE 续写接口,并提出边界图像续写等三种条件适配器的分类(附录 E)。实证层:在 Wan1.3B、LTX-2.3、Sol-H3 三个模型上验证实测延迟降幅与理论预测吻合(Sol-H3 实测 0.493/2.814s 对理论 0.438/2.562s)。
实验结果
块大小分析(4.2 节,Figure 5/Table 1/2):Wan1.3B 上 $K>1$ 普遍提升 VBench——四步 480p 总分从 $K=1$ 的 79.00 升至 $K=3$ 的 81.66、$K=21$ 的 82.13,动态程度从 4.00 升至 85.00,指令跟随普遍达 94-100;增益非单调,最优 $K$ 依设置而定。代价可控:480p 前向延迟 $K=1\to3$ 仅 2.05 倍、720p 仅 2.74 倍;USP8 下 480p $K=7$ 仅 78.6ms(对照 $K=1$/USP1 的 77.5ms),720p $K=21$ 从 6432.8ms 降至 899.7ms。LTX-2.3 上 $K=9$ 主观一致性最高 89.42,$K=15$ 动态 78.12。端到端服务(Table 3,30 条 60 秒轨迹,低频 1-2 次/高频 3-11 次更新):Sol-H3 短/长设置实测平均延迟降低 0.493/2.814s,接近理论 0.438/2.562s;Wan 增益 0.155→1.744s,LTX eager 0.014→2.116s,随块增大而增大,符合理论趋势。本方法下长设置 L50 仅比对应短设置高 0.26-0.39s;Sol-H3 长设置 L50=1.42/1.41s 低于短块基线的 1.87/1.87s 且零播放停顿,即大块可反超小块基线。资源面:长设置 GPU 核活动率 Wan 17-20%(短 50-52%)、Sol-H3 18-23%(短 49-50%),显示还有服务更多并发流的余量;代价是 LTX CUDA Graph 高频更新下停顿率 4.407%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 交互式流式视频生成(Sol-H3,124 帧长块,480p/24fps) | L50 响应延迟(秒,低频/高频更新) | 1.42 / 1.41 | 短块(22 帧)基线 1.87 / 1.87 | 降低约 0.45s(约 24%),且播放停顿率为 0;延迟降幅 2.814s 接近理论值 2.562s |
| 视频生成质量(Wan1.3B,4 步采样,832×480) | VBench 总分(946 prompts,5 seeds) | 82.13(K=21) | 79.00(K=1 逐帧) | +3.13,动态程度从 4.00 升至 85.00 |
| DiT 前向延迟(Wan,480p,H200) | 单次前向耗时(ms) | 78.6(K=7,USP8) | 77.5(K=1,USP1) | 联合建模 7 个 latent 而延迟几乎持平 |
| 720p 大块前向延迟(Wan,K=21) | 单次前向耗时(ms) | 899.7(USP8) | 6432.8(USP1) | 约 7.15 倍加速,使超大块可服务化 |
| 在线服务响应(Wan1.3B,长块 K=21/USP8,480p) | L50(秒,低频/高频) | 1.32 / 1.35(投机采样) | 3.23 / 3.11(长块基线) | 降低约 1.8-1.9s(约 58%),逼近短块基线的 1.13-1.24s |
局限与改进
作者承认两点局限:其一,投机预测只有在被新条件作废前被复用才有收益,频繁或连续更新会丢弃每块大部分预测、浪费大量 DiT 计算(相对开销 $A\simeq 1/(1-w)$ 随丢弃比例 $w$ 膨胀,极端时接近 $K$ 倍);其二,窗口内双向注意力使保留的 KV 可能编码了随后被丢弃后缀的信息,仅删除其 KV 条目未必能完全消除其对再生续写的影响,需要匹配的受控消融才能分离。我的补充观察:(1) 服务实验集中在 1.3B 级 Wan 与较小配置的 LTX/Sol-H3,更大模型上 $C$ 与 $T$ 的比值可能恶化,$C\leq T$ 的调度假设更紧;(2) LTX 质量评估用内部 Internal8K/Internal32 数据集,公开可比性弱;(3) LTX eager 短块推理跑不满播放、需 CUDA Graph 兜底,且高频更新下本方法停顿率 1.781-4.407%,说明生成时间逼近块时长时收益受限(附录 A 的 $C=T$ 极限情形恰好退化为基线);(4) 长设置 L95 仍达 2.47-4.24s,尾部延迟对严格交互场景仍偏重。
独立分析的弱点
弱点一:高频更新下的计算浪费。$w$ 大时相对开销 $A$ 趋向 $K$:$K=21$ 且接近每个交付步都更新时,可能浪费九成以上采样计算,Table 3 中 LTX 高频停顿率上升即其表现。改进方向:用论文自己推导的 $A-1\simeq\lambda(T-\delta)/2$ 作为在线准则,按更新率 $\lambda$ 动态收缩窗口或切换回小块;对仍有效的部分预测做部分去噪续算而非整块重采样。弱点二:KV 污染。被丢弃后缀经双向注意力渗入保留前缀表征,删除 KV 条目不能彻底清除影响,长交互下可能累积语义漂移。改进方向:定期用 clean prefill 重建干净 KV(用成本换正确性)、对越界位置施加注意力掩码隔离、或在训练中加入'后缀可丢弃'的鲁棒性目标。弱点三:单 worker 与 $C\leq T$ 的容量假设。当 $C$ 逼近 $T$(如 LTX eager 短块 under-run)时需要 CUDA Graph 补救,高频下仍有 1.8-4.4% 停顿。改进方向:按附录 F 把 DiT 采样与 VAE 解码做成重叠流水线以缩短有效 $C$,并与多流并发调度联合设计。弱点四:评估透明度。Internal8K/Internal32 不公开、Sol-H3 依赖 NVIDIA 内部引擎,跨工作质量对比难以独立复核,建议补公开基准与人评。
未来方向
作者明确提出(附录 F):把 DiT 采样与 VAE 解码作为一条生成流水线协同优化——何时把完成的 latent 组交给 VAE、解码如何按播放截止时间调度、两阶段间算力与显存如何分配,并要求候选调度以'到首个可交付组的时间、后续组截止期、总 GPU 成本、播放停顿'为指标在完整流水线内评估,而非孤立优化各阶段运行时。基于本文成果还可延伸:(1) 与少步蒸馏、对抗后训练正交叠加,直接压低 $C$——本文已论证 $C$ 是延迟的中心变量;(2) 把块大小 $K$ 变成控制器的在线决策变量,按条件更新率在质量-延迟前沿上动态选点(论文已证明 $K$ 是设计变量而非约束);(3) 在世界模型与交互智能体场景验证,把投机缓存与观测反馈闭环结合(引文中的 BiWM、MaineCoon、Equilibrium Forcing 等方向);(4) 多流服务下研究并发调度与公平性,利用长设置仅 17-25% 的 GPU 活动率余量提升单机并发吞吐。
复现评估
复现难度:中高。有利条件:Wan1.3B 权重公开,训练配方明确(按 CF++ 在 Toy6K 上训练 $K\in\{1,3,7,21\}$、1/2/4 步采样),VBench 公开(946 prompts、5 seeds、81 帧 16fps、832×480 与 1280×720);附录 C 给出 FSM 的完整形式化规约(寄存器元组、事件字母表 $\mathcal{E}=\{update, ready, finish, tick, wake\}$、可行边界谓词 $F_j$、守卫 $g$、不变量与失败处理),附录 D 给出事件与测量 schema,附录 E 描述三种条件适配器,理论上足以照此实现控制器与评估协议。不利条件:项目页未提及代码开源;LTX-2.3 与 Sol-H3 依赖内部数据(Internal8K/Internal32)与 NVIDIA 内部引擎;服务实验需要 4-8 张 B300/H200 级 GPU 并用 NVML 统计活动率,硬件门槛很高;60 秒交互轨迹(低频 1-2 次、高频 3-11 次更新)的生成协议需自行复刻。若只复现核心论点(块大小消融加小规模服务演示),单机 4-8 卡 H100 跑 Wan1.3B 即可,工作量约数周。
论文图表
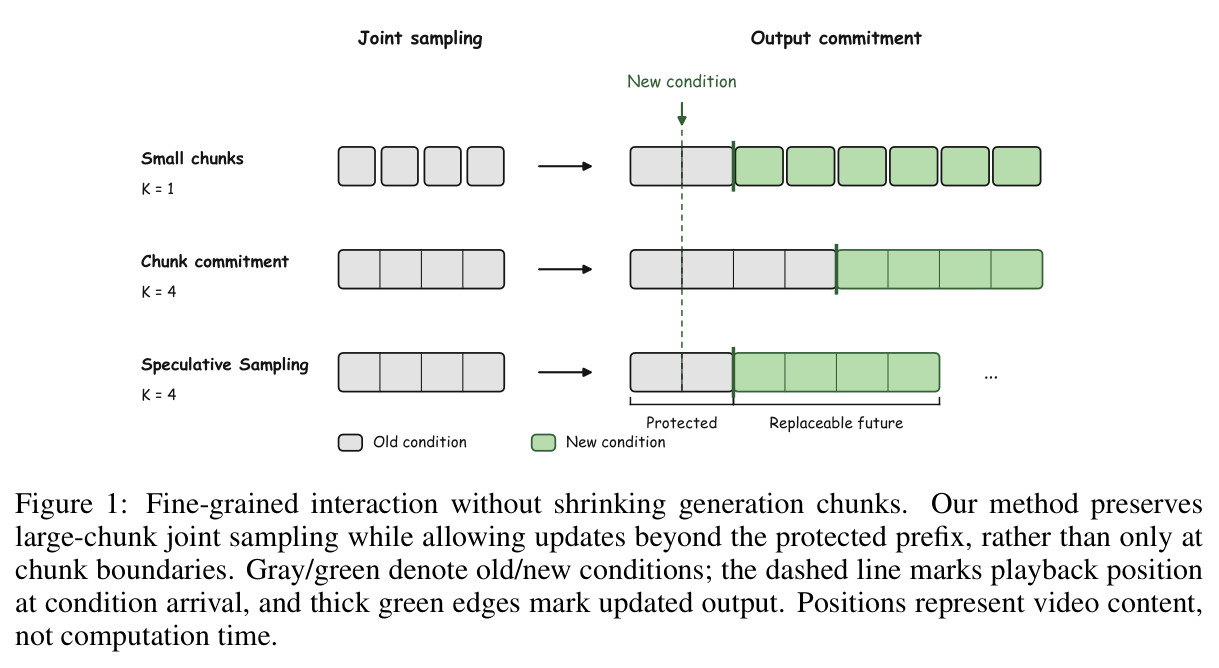
三行对比示意:小块 $K=1$(逐帧采样、交互频繁但联合建模受限);块级承诺 $K=4$(整块生成后整体交付,条件更新只能在块边界生效);投机采样 $K=4$(保持 4-latent 联合采样,绿色粗边表示被新条件更新的输出可越过受保护前缀、在可替换未来中逐个交付)。灰/绿代表旧/新条件,虚线为条件到达时的播放位置,横轴是视频内容位置而非计算时间。
一图看懂论文主张:不缩小块也能实现细粒度交互,是全文动机与效果的最直观概括,图 1 的三行对比就是摘要的视觉版。
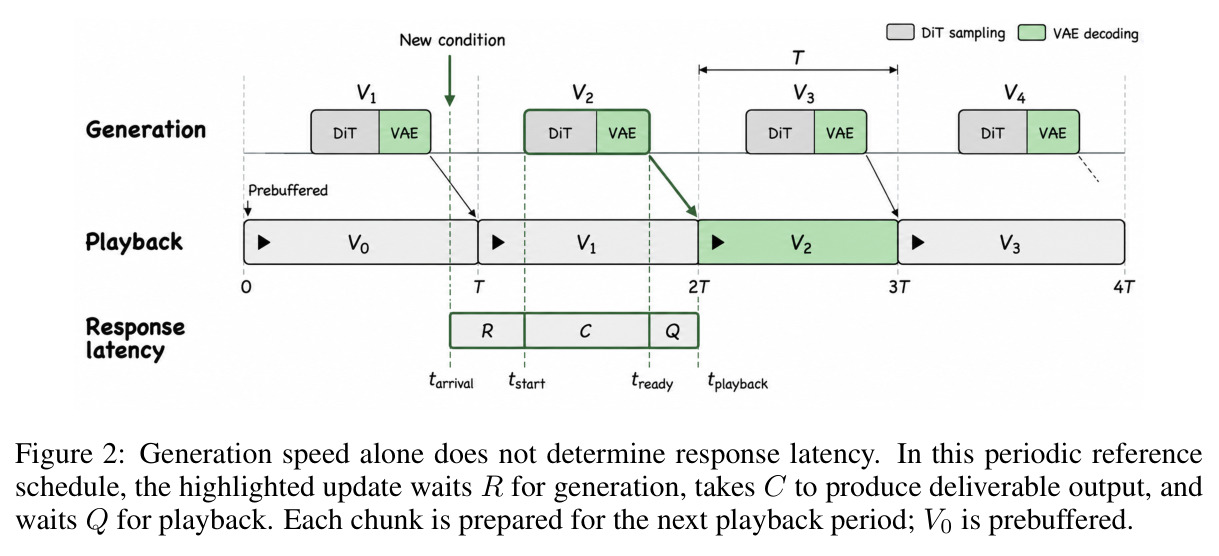
周期参考调度时间线:一个条件更新到达后先等待 $R$ 才开始生成,生成耗时 $C$ 产出首个可交付输出,再等待 $Q$ 到播放边界才显示;每块都为下一个播放周期预备,首块 $V_0$ 已预缓冲。图中直观展示 $L=R+C+Q$ 的三段构成与块边界的对齐约束。
这是服务系统模型的可视化基础;理解 $E[R+Q]\geq T/2$ 等待下界的来源、以及为什么'生成快不等于响应快'必看此图。
(a) Wan 在 480p/720p 下各 $K$、USP1-8 的 H200 单次前向毫秒数:如 720p $K=21$ 从 USP1 的 6432.8ms 降到 USP8 的 899.7ms,$K=1$→$3$ 仅 2.05 倍(480p);(b) LTX-2.3 在内部 32 例测试集上 $K\in\{1,3,9,15,45\}$ 的六项视觉分数与缓存前向耗时:$K=9$ 主观一致性 89.42 最高,$K=15$ 动态 78.12,USP8 下 $K=45$ 仅 507.9ms。
给出服务实验所依据的延迟画像与 LTX 质量数据:'并行度可让大块几乎和小块一样快'与'LTX 大块质量不降'两点都出自此表,是连接质量分析与端到端 Table 3 的桥梁。