面向高效自回归视频生成的投机强制 Speculative Forcing for Efficient Autoregressive Video Generation
把中间去噪估计当草稿逐token提前验收,质量不降前提下将自回归视频生成提速至1.6倍
前置知识
自回归视频扩散生成
将视频切成若干潜在块(chunk),按 $p(c_1,c_2,\ldots)=\prod_t p(c_t\mid c_{<t})$ 逐块生成;每块从高斯噪声出发经 $K$ 步去噪得到干净潜在表示,并以历史块为条件。历史 token 的各层键值(KV)被缓存,避免每个新块重复计算历史特征。
本文加速的正是这类模型的去噪循环,理解 chunk、token、KV 缓存的运作方式,才能明白提前验收 token 到底省掉了什么计算、又靠什么保持上下文连贯。
少步蒸馏(DMD 与 Self Forcing)
分布匹配蒸馏(DMD)把多步教师模型的输出分布蒸馏进学生网络,使其仅需 $K=4$ 步即可生成;Self Forcing 进一步在自回归 rollout 上训练,并随机抽取去噪出口步施加分布匹配目标,因此每一步的中间干净估计 $\hat{x}^{(k)}_0$ 都得到监督,本身就是合理的视频输出。
本文方法成立的前提正是中间估计可当草稿用:若中间估计未经监督,提前接受会导致质量崩塌。理解这一点才能明白为什么该加速只对 Self Forcing 系生成器有效。
投机解码(Speculative Decoding)
大语言模型推理加速范式:小模型快速产出草稿 token,大模型一次性并行验证,只接受与目标分布一致的部分,从而保证输出分布严格不变。名字里的投机即指先赌一把再验证。
本文标题与方法直接借用草稿—验证框架,但验证目标从分布不变换成了收敛预测,接受是有损的。理解原范式有助于把握这篇论文借了什么、改了什么。
KV 缓存与注意力汇(attention sink)
流式生成时缓存已生成 token 各层的 key/value,新 token 只需计算自身查询;attention sink 指把最早若干潜在帧固定保留为锚点,配合局部注意力窗口,在有限显存下维持长视频生成的稳定性。
本文被接受的 token 不再参与去噪,但其 KV 保留在缓存中供后续 token 注意,且缓存中混有不同去噪步的状态;这是方法正确性与工程实现的核心细节。
VBench 与 Drift 指标
VBench 是视频生成质量评测体系,含主体/背景一致性、运动平滑度、动态程度、成像质量等 16 个维度,并给出 Total/Quality/Semantic 聚合分;Drift 沿用 Reward Forcing 的定义,把成像质量(MUSIQ)分数按 2 秒非重叠分段求标准差再对视频取平均,衡量画质随时间的漂移。
论文所有不降质的结论都建立在这两套指标上;此外还用 RPE(相机位姿相对误差)评估世界模型的相机跟随精度,读懂指标定义才能判断结论的说服力。
研究动机
现有少步自回归视频生成器(如 LongLive 与 Lingbot-World 2.0,均为 1.3B 参数、4 步蒸馏模型)对所有 token 一视同仁地跑满全部去噪步:即使某个区域的估计在第 1 步就与最终输出几乎一致,它仍要完整走完 4 步。这带来直接的算力浪费:在单张 H100 上,5 秒视频吞吐只有约 26.4 fps,30 秒视频约 24.5 fps,镜头不断变化的世界模型 rollout 更低至 18.1 fps。作者的关键观察(Figure 2)是 token 间收敛速度差异巨大:与历史相似的背景和物体区域常在最初几步就逼近 4 步最终输出,而新出现的结构、精细细节、世界模型中新揭示的区域要持续变化到最后一步。已有加速方法各有不足:KV/特征缓存只复用计算、不减少步数;RAS、HSA 等空间自适应采样虽按区域分配计算,但每个 token 仍被带到噪声调度终点,从不宣告完成,误差须靠周期性全量更新兜底;DSA、Surprise Forcing 以整帧或整块为粒度分配去噪深度,无法区分同一块内已定型与仍在变化的 token。
本文的目标是本文要系统回答一个问题:是否每个 token 都需要去噪到最后一步?目标是构建一个不改动生成器权重、可即插即用的推理框架:在 4 步去噪过程中逐 token 预测当前中间估计与其满步输出的差距,一旦判定已收敛便将其冻结为最终输出、退出后续所有去噪前向,仅对仍在变化的 token 继续精修。量化目标是在短视频、长视频、可控世界模型三类场景下,把平均去噪步数从固定的 4.00 降到约 1.5 至 2.5,同时使 VBench 各质量维度、画质漂移指标 Drift、相机跟随精度 RPE 均不劣于 4 步基线,并在单张 H100 上兑现 1.35 至 1.65 倍的实测吞吐提升。
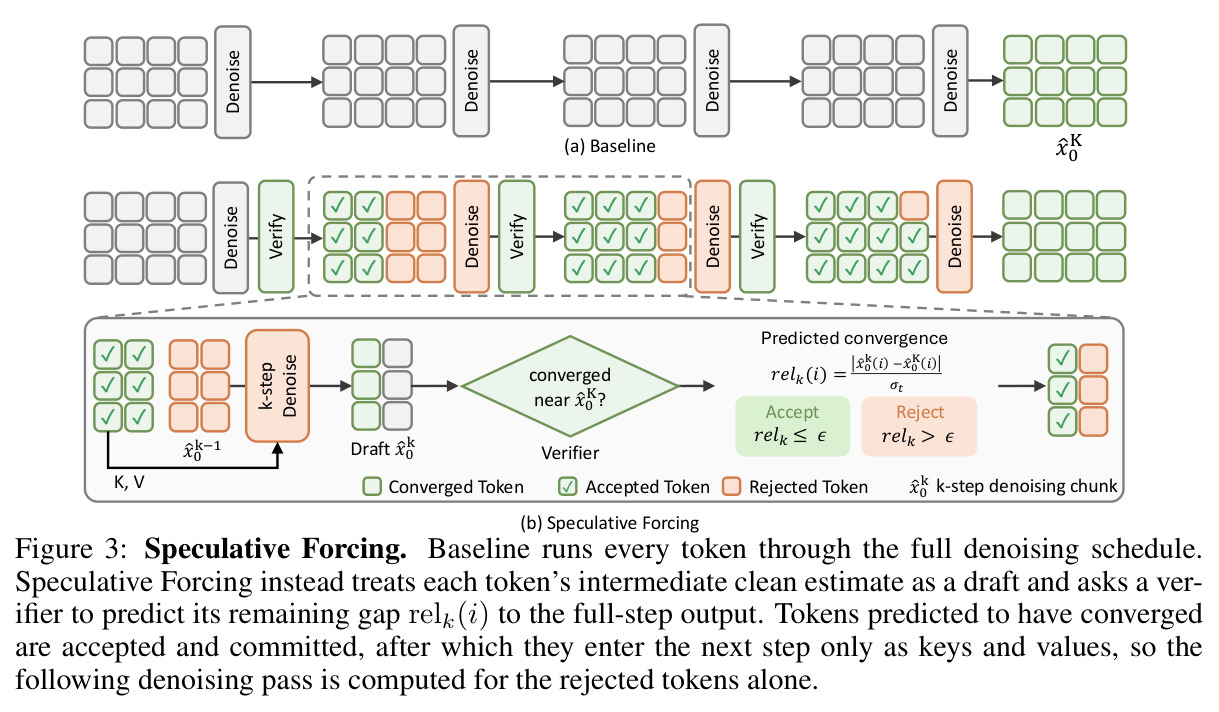
与已有工作不同的是,本文的独特切入点有三。其一,把 Self Forcing 式蒸馏的结构性质转化为加速机会:这类训练随机抽取去噪出口步施加分布匹配目标,使每一步的中间干净估计都受到监督、本身就是可用的生成结果,因此天然可以充当草稿(draft),这是普通蒸馏范式不具备的性质。其二,借来 LLM 投机解码的草稿—验证框架但替换其目标函数:投机解码要求接受后输出分布严格不变,而本文验证器预测的是剩余收敛间隙,接受意味着容忍与满步输出的微小偏差,用可控的有损换取大幅计算节省,实验证明这种有损在感知上中性。其三,验收粒度做到 token 级:同一块内已定型区域第 1 步就退出、畸形区域精修到第 4 步;被接受的 token 输出冻结但 KV 保留供后续注意,缓存中不同去噪步的状态允许共存,块末一次干净前向统一刷新。
核心方法
直觉是去噪算力应按需分配:已收敛的 token 继续算纯属浪费。技术路线是在标准 4 步去噪循环中嵌入逐验证机制,形成草稿—验证—提交的循环。具体地,每步 $k<K$ 时验证器对仍活跃(未被接受)的 token 打分,判断其草稿 $\hat{x}^{(k)}_0$ 与满步输出的距离是否已足够小;通过者被提交为最终输出并从后续去噪前向中剔除,未通过者重新加噪到下一噪声级继续精修;到第 $K$ 步仍活跃的 token 全部提交。被接受的 token 不再参与去噪,但其各层键值保留在缓存中供活跃 token 注意,保持上下文完整;每块生成完毕后,生成器对拼装结果在 $t=0$ 做一次干净前向,统一刷新 KV 缓存。由此每块的去噪 token 评估数从 $KN$ 降到 $\sum_i k^*(i)$($k^*(i)$ 为 token $i$ 的提交步),另加 $N$ 次干净前向开销,平均去噪深度 $\bar{k}=\frac{1}{N}\sum_i k^*(i)$ 成为效率的核心度量。
核心创新是把何时可以停止去噪形式化为可预测的判别问题。作者定义收敛间隙 oracle:$\text{rel}_k(i)=\frac{\|\hat{x}^{(k)}_0(i)-\hat{x}^{(K)}_0(i)\|_2}{\sigma_t}$,其中 $\hat{x}^{(K)}_0$ 是同噪声同条件下满步输出的参考,$\sigma_t$ 为该块满步输出的 token 范数中位数;$\text{rel}_k(i)\le\epsilon$ 即视为收敛。推理时满步参考不可得,需验证器提前预测该间隙,论文给出两条互补路线。免训练验证器用两个代理信号:第 1 步用冗余度 $s_{\text{red}}(i)=\min_{h\in H}\|\hat{x}^{(1)}_0(i)-h\|_2$,即与注意力窗口内干净历史及参考帧(含 attention sink)中最相似 token 的距离;第 2 步起用稳定性 $s^{(k)}_{\text{stab}}(i)=\|\hat{x}^{(k)}_0(i)-\hat{x}^{(k-1)}_0(i)\|_2$。学习式验证器则从冻结生成器最后一块 Transformer 的隐状态直接回归间隙 $\hat{r}_k(i)$,证明中间特征本身就编码了这个预测还会变多少的信息。所有分数先经时空平滑算子 $\mathcal{S}$ 再阈值化,保证验收决策在空间与时间上连贯。
方法步骤详情
(1)初始化:块内 $N$ 个 token 全部活跃,第 1 步去噪产出每个 token 的草稿 $\hat{x}^{(1)}_0$。(2)验证:免训练路线在 $k=1$ 算 $s_{\text{red}}$、$k\ge2$ 算 $s_{\text{stab}}$,阈值 $(\tau_{\text{red}},\tau_{\text{stab}})$ 在留出数据上按 oracle 准则校准;学习路线用 4.11M 参数卷积头(LayerNorm 加三个 3D 卷积,通道 $1536\to96\to48\to1$,前两层 $3\times3\times3$ 带 GELU、末层 $1\times1\times1$,跨步共享,输出经 $2\times2\times2$ 平均池化再最近邻上采样回原网格)从最后 Transformer 块隐状态预测 $\hat{r}_k(i)$。(3)提交:分数经平滑后与 $\epsilon$ 比较,达标 token 的输出固定为 $\hat{x}^{(k)}_0(i)$、当步各层 KV 写入缓存,后续去噪不再计算它;未达标 token 重加噪到下一噪声级续跑。(4)收尾:$k=K$ 时剩余 token 全部提交,块输出 $c_t(i)=\hat{x}^{(k^*(i))}_0(i)$ 混有多步估计,随后在 $t=0$ 做干净前向统一刷新 KV。(5)训练验证头:冻结生成器跑满 $K$ 步 rollout,收集各步隐状态与 oracle 间隙,用 Huber 损失 $\mathcal{L}=\frac{1}{N(K-1)}\sum_{i,k}\text{smooth}_{\ell_1}(\hat{r}_k(i),\text{rel}_k(i))$ 训练,Adam、学习率 $10^{-3}$、批量 4;LongLive 用 1K 条 VidProM 提示词,Lingbot 用 1K 张不相交场景图像。
技术新颖性
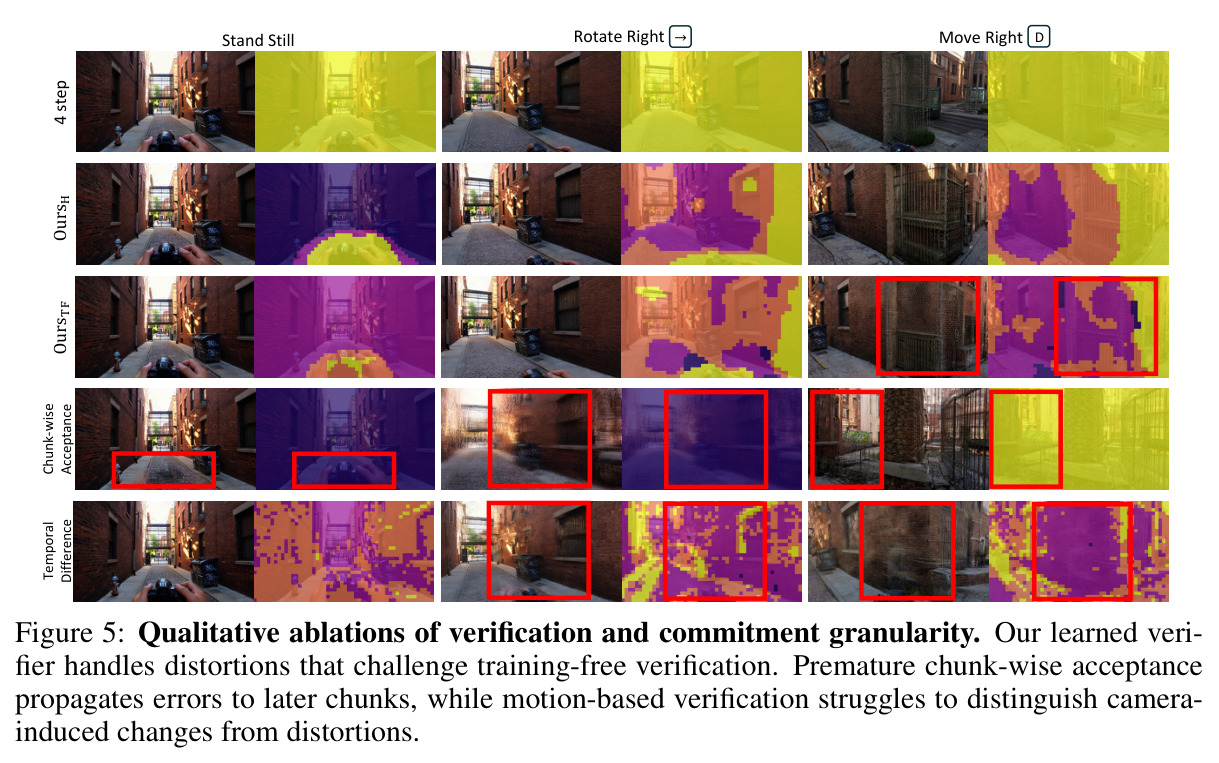
与已有方法的本质区别:相比 DeepCache、ToCa 等 KV/特征缓存方法,本文不是复用计算而是提前终止计算,且被终止的 token 状态被转正为最终输出与后续上下文;相比 RAS、HSA 的空间自适应采样,那些方法仍把每个 token 推到调度终点、靠周期性全量更新约束误差,而本文显式宣告 token 完成,因而在这类 4 步蒸馏的极短调度下依然有效——论文指出替换式缓存正因短调度下无步可替而失效;相比 DSA、Surprise Forcing 的帧/块级步数分配,token 级验收能在同一块内同时保留已定型区域并继续精修畸形区域,消融显示相同平均步数下块级验收 Quality 82.54 对 82.65、Drift 3.214 对 2.839;相比 LLM 投机解码,本文不追求分布无损,草稿来自生成器自身的中间估计而非外部小模型,验证信号是从隐状态回归的收敛间隙(AUROC 0.87 至 0.94)而非输出分布比对。工程上还有一个新颖点:缓存允许不同去噪步的 KV 共存,用块末干净前向统一刷新,兼顾早提交与上下文质量。
实验结果
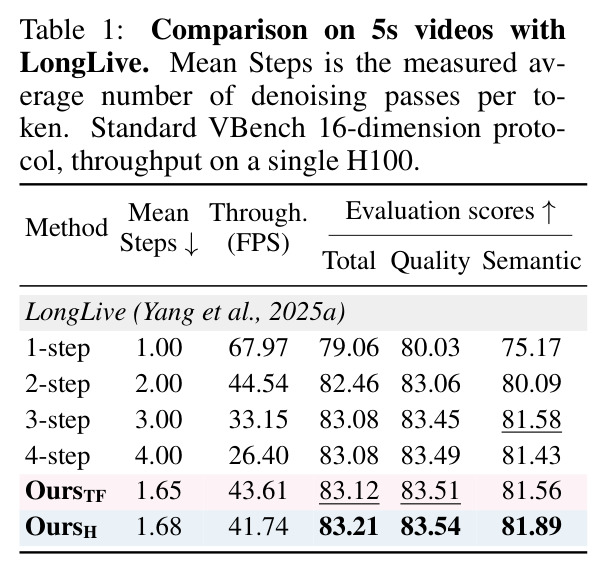
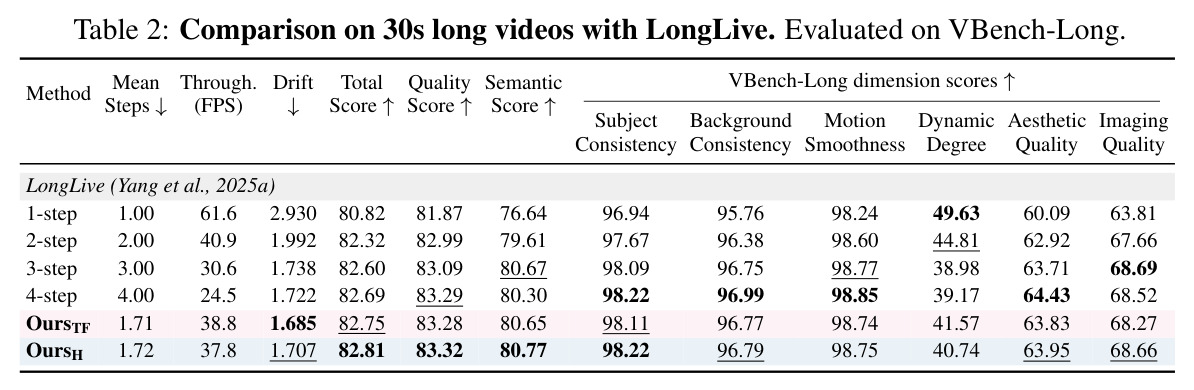
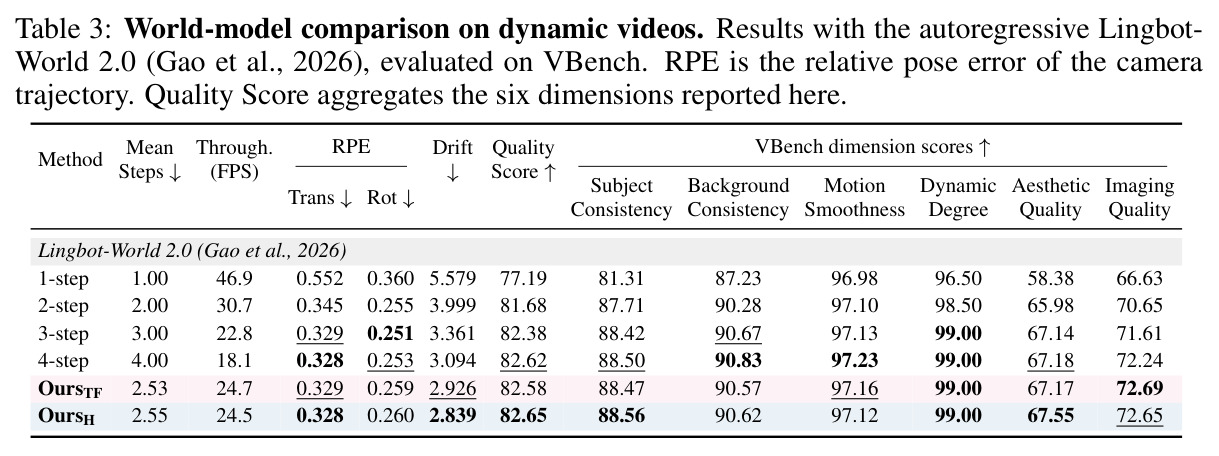
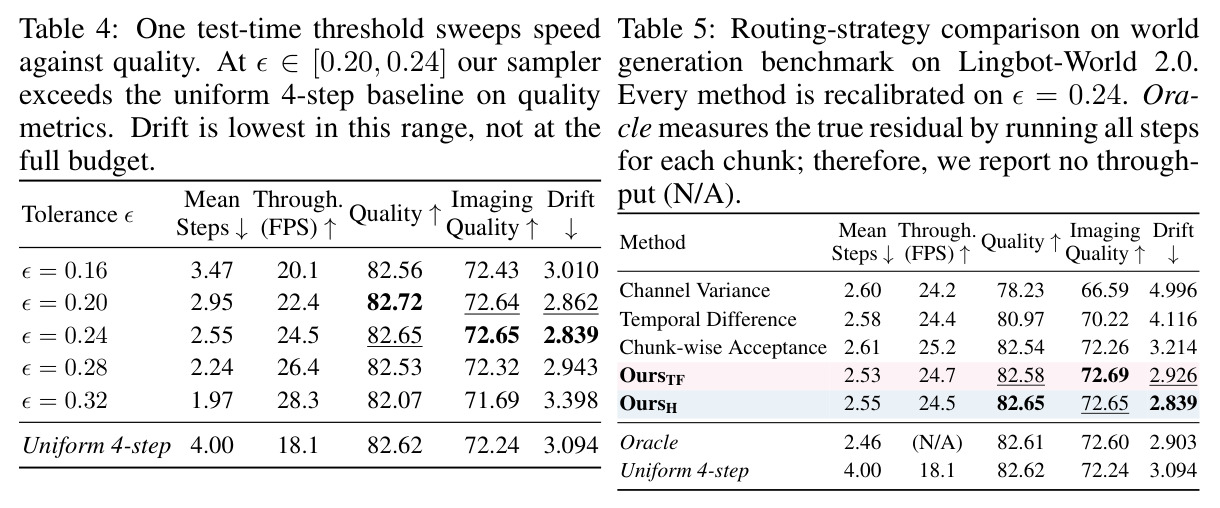
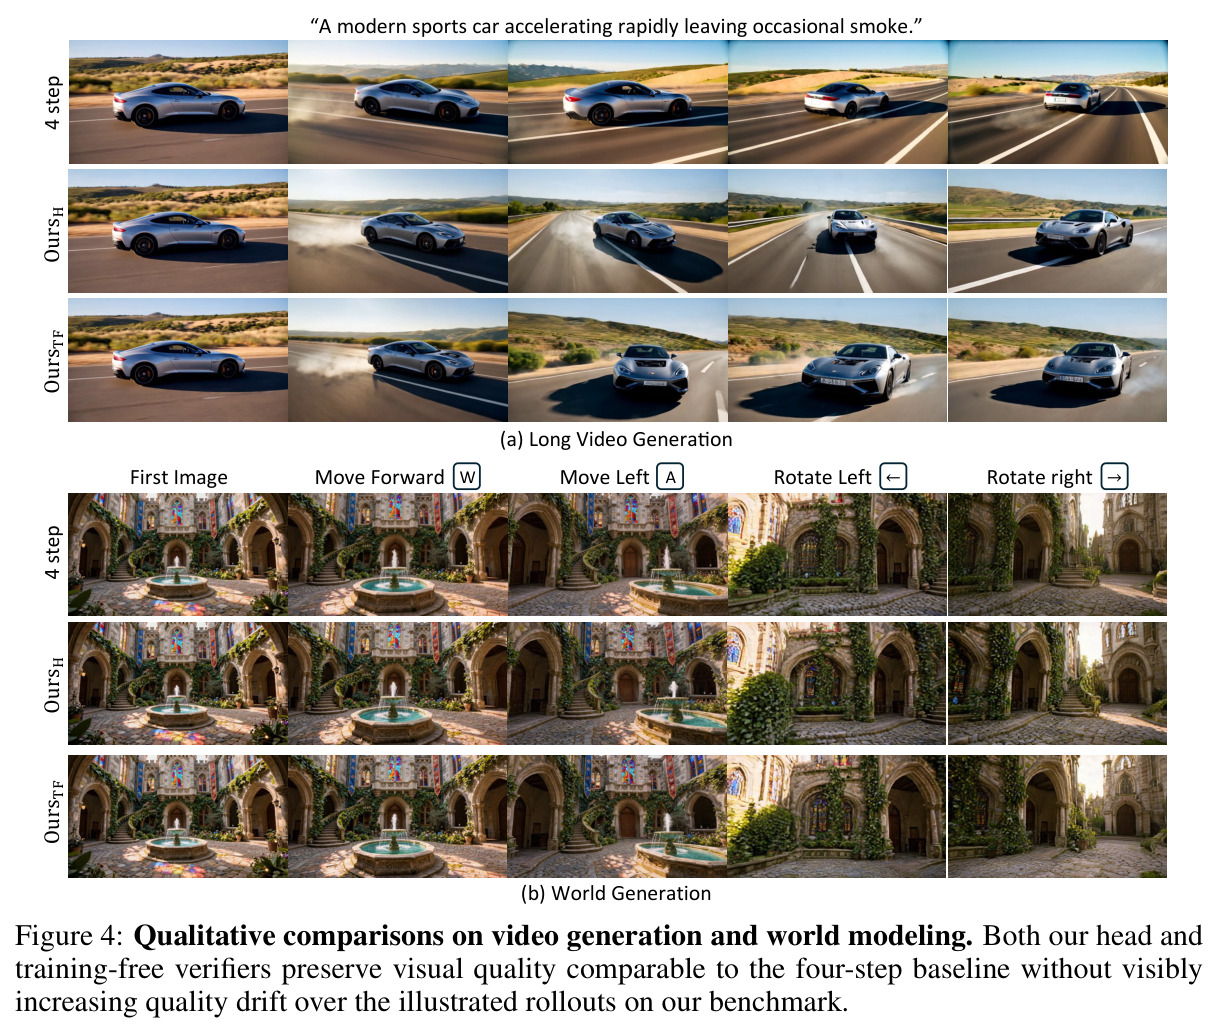
实验覆盖三类场景,生成器冻结,单张 H100 测吞吐。短视频(LongLive 5 秒、VBench 16 维):4 步基线 Total 83.08、26.40 fps;OursH 平均 1.68 步达 Total 83.21、41.74 fps(1.58×),OursTF 1.65 步、43.61 fps(1.65×),均超 2/3 步基线。长视频(30 秒、VBench-Long):OursTF/OursH 用 1.71/1.72 步跑到 38.8/37.8 fps(约 1.5×),Total 82.75/82.81 不低于基线 82.69,Drift 1.685/1.707 低于 1.722,动态程度保持约 41,说明画质变稳并非靠压制运动。世界模型(Lingbot-World 2.0,200 场景、每段 253 帧):镜头运动使任务更难,只降到 2.53/2.55 步,OursH 以 24.5 fps(1.35×)保住 Quality 82.65(基线 82.62),Drift 2.839 显著低于 3.094,RPE 平移/旋转 0.328/0.260 与基线 0.328/0.253 相当。消融:容差扫描显示 $\epsilon\in[0.20,0.24]$ 是甜点区(Quality 82.72/82.65 且 Drift 最低),$\epsilon=0.32$ 跌至 82.07;路由策略对比中通道方差信号崩至 78.23、时间差分 80.97、块级验收 82.54,均逊于 OursH 的 82.65,后者几乎追平 oracle 验收的 82.61;学习头验证精度 AUROC 0.87 至 0.94,全面领先冗余度、稳定性与运动信号;对比 Surprise Forcing(5 秒需 3.59 步、27.38 fps、Total 83.11),OursH 用 1.68 步、41.74 fps 拿到 83.21。整体来看,免训练与学习式两条验证路线表现接近,说明收敛信号本身易于获取,学习头的主要价值在世界生成这类高畸变场景下更稳。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 5 秒短视频生成(LongLive,VBench 16 维) | VBench Total 分数 / 平均去噪步数 / H100 吞吐 | OursH:1.68 步,41.74 fps,Total 83.21;OursTF:1.65 步,43.61 fps,Total 83.12 | 4 步均匀采样:4.00 步,26.40 fps,Total 83.08 | 平均步数 -58%,吞吐 1.58×(OursTF 达 1.65×),Total 反而 +0.13 |
| 30 秒长视频生成(LongLive,VBench-Long) | Total 分数 / Drift 画质漂移 / 吞吐 | OursTF:1.71 步,38.8 fps,Total 82.75,Drift 1.685;OursH:1.72 步,37.8 fps,82.81,Drift 1.707 | 4 步:4.00 步,24.5 fps,Total 82.69,Drift 1.722 | 吞吐约 1.54×,Total +0.06 至 +0.12,Drift 更低(长时程不累积误差) |
| 可控世界模型 rollout(Lingbot-World 2.0,200 场景 × 253 帧) | VBench Quality(6 维聚合)/ RPE 相机位姿误差 / Drift / 吞吐 | OursH:2.55 步,24.5 fps,Quality 82.65,RPE 平移/旋转 0.328/0.260,Drift 2.839 | 4 步:4.00 步,18.1 fps,Quality 82.62,RPE 0.328/0.253,Drift 3.094 | 吞吐 1.35×,Quality 持平,Drift -0.255,相机跟随精度不受损 |
| 与 Surprise Forcing(帧/块级步数分配)对比(5 秒 LongLive) | 平均步数 / 吞吐 / Total 分数 | OursH(ε=0.28):1.68 步,41.74 fps,Total 83.21 | Surprise Forcing:3.59 步,27.38 fps,Total 83.11 | 步数少 53%、吞吐高 52%,质量还略高 |
| 验证信号准确率(LongLive,识别需继续精修的 token) | AUROC(按去噪步 k 与容差 ε 分解) | OursH 在 ε=0.24 下 k=1/2/3 分别 0.934/0.890/0.906 | 冗余度 0.828/0.692/0.611,稳定性(k≥2)0.774/0.854,运动信号 0.701/0.592/0.561 | 第 1 步领先冗余度 +0.106,各步全面领先,说明隐状态确实编码收敛信息 |
| 学习验证器 vs oracle 验收(Lingbot 世界生成) | Quality 分数 / Drift | OursH:Quality 82.65,Drift 2.839(2.55 步) | Oracle(推理时真跑满 4 步算真实残差):Quality 82.61,Drift 2.903(2.46 步) | 不用任何满步参考即几乎追平 oracle 上界,Quality 还高 0.04 |
局限与改进
作者承认两点局限。其一,加速幅度依赖底层生成器对减步的敏感度和领域难度:世界生成中镜头运动不断引入新内容与较强畸变,平均步数只能降到约 2.5 而非 1.7;若换一个对步数更敏感的骨干网,可提前接受的 token 更少,无法保证同等加速。其二,块末干净前向是固定开销,理想加速比为 $5/(\bar{k}+1)$(如 $\bar{k}=1.65$ 时约 1.89×),且每块要执行到最后一个 token 被接受为止,实际吞吐受块内 $\max_i k^*(i)$ 而非均值 $\bar{k}$ 制约,因此实测 1.35 至 1.65 倍低于理想值。我自己的观察:质量保持是以生成器自身 4 步输出为参照定义的,4 步基线自身的缺陷会被完整继承,方法并不逼近多步教师;评测全部依赖 VBench 类自动指标,没有人类感知评测,30 秒/253 帧之外更长 rollout 中早期接受误差是否累积缺乏验证;免训练验证器的两个阈值需按场景校准,冗余度假设在全新内容占主导时会失效;实验仅限 1.3B 模型,向更大规模模型的迁移未验证。
独立分析的弱点
具体弱点与改进方向:(1)掉队者问题——每块必须执行到 $\max_i k^*(i)$,个别顽固不收敛的 token 会拖累整块吞吐;可引入跨块异步调度,或对迟迟不收敛的 token 动态降级(用外推估计提前提交并接受其误差)。(2)干净前向的固定开销本可消除:作者自己指出若像 CausalRCM 那样复用带噪 KV,理想加速比可逼近 $4/\bar{k}$,该技术与本文正交、可以叠加。(3)学习验证器按生成器/领域分别训练(LongLive 用提示词、Lingbot 用图像,各 1K),跨模型泛化能力未知;可探索多模型联合训练通用验证头,或把免训练信号蒸馏进单一头。(4)验收决策完全在潜空间做出,无像素域监督,理论上可能出现局部纹理伪影(作者用时空平滑缓解,但无硬保证);可加入轻量解码域或频域判别信号。(5)容差 $\epsilon$ 全局统一,但同一块内不同区域理应有不同容忍度(天空与人脸不该同权);区域条件化或按内容自适应的容差是自然延伸。
未来方向
作者提出的方向:把 token 级验收用于条件强约束的场景——说话人头像生成(背景基本静止、运动集中于面部与上身)、以真实场景为底座的环境接地世界模型(如 Seoul World Model、World Observer,其中扭曲的观测与参考图已为大部分视口提供视觉证据、仅新覆盖区域需真正生成)、提供静态场景渲染的灵巧世界模型,以及结合已知环境与生成内容的 AR/VR 应用。基于本文成果可延伸的:与带噪 KV 复用结合消掉干净前向、把理想加速推向 $4/\bar{k}$;把预测剩余间隙推广为联合预测最优退出步与噪声级,统一步数分配与 token 验收两套机制;在更大规模(远超 1.3B)模型和分钟级 rollout 上检验误差累积;为交互式世界模型设计动作条件化的验证信号——动作改变的区域天然应获得更多步数,这与本文已见区域早收的发现正好互补。
复现评估
复现条件较好。基座 LongLive 与 Lingbot-World 2.0(Causal-Fast,均 1.3B)是公开权重;本方法只训练 4.11M 参数的验证头,生成器全程冻结,1K 条 VidProM 提示词(视频)或 1K 张不相交场景图像(世界模型)即可生成训练 rollout,Adam(学习率 $10^{-3}$、批量 4)训练,成本很低。附录 A 完整给出超参:时间步 $[1000.0, 937.5, 833.3, 625.0]$、$\epsilon$(短视频 0.28、长视频/世界 0.24)、免训练阈值 $(\tau_{\text{red}},\tau_{\text{stab}})$ 三组取值(5 秒视频为 0.497/0.327)、平滑核(9×9、$\sigma=1.0$)等;附录 B 给出评测细节:VBench/VBench-Long 协议、Drift 用 MUSIQ 按 2 秒分段、RPE 用 Depth Anything 3 恢复位姿并做 Sim3 Umeyama 对齐、世界基准由 Qwen2.5-7B-Instruct 写描述、Z-Image-Turbo 生成 1376×768 初始图。推理在单张 H100 上完成,训练一张 H100 应可胜任;项目页 speculative-forcing.github.io 提供补充材料,正文未明确承诺开源代码。综合看复现难度中等偏低,主要工作量在共享索引、原地 KV 更新与干净前向合并等工程优化。
论文图表
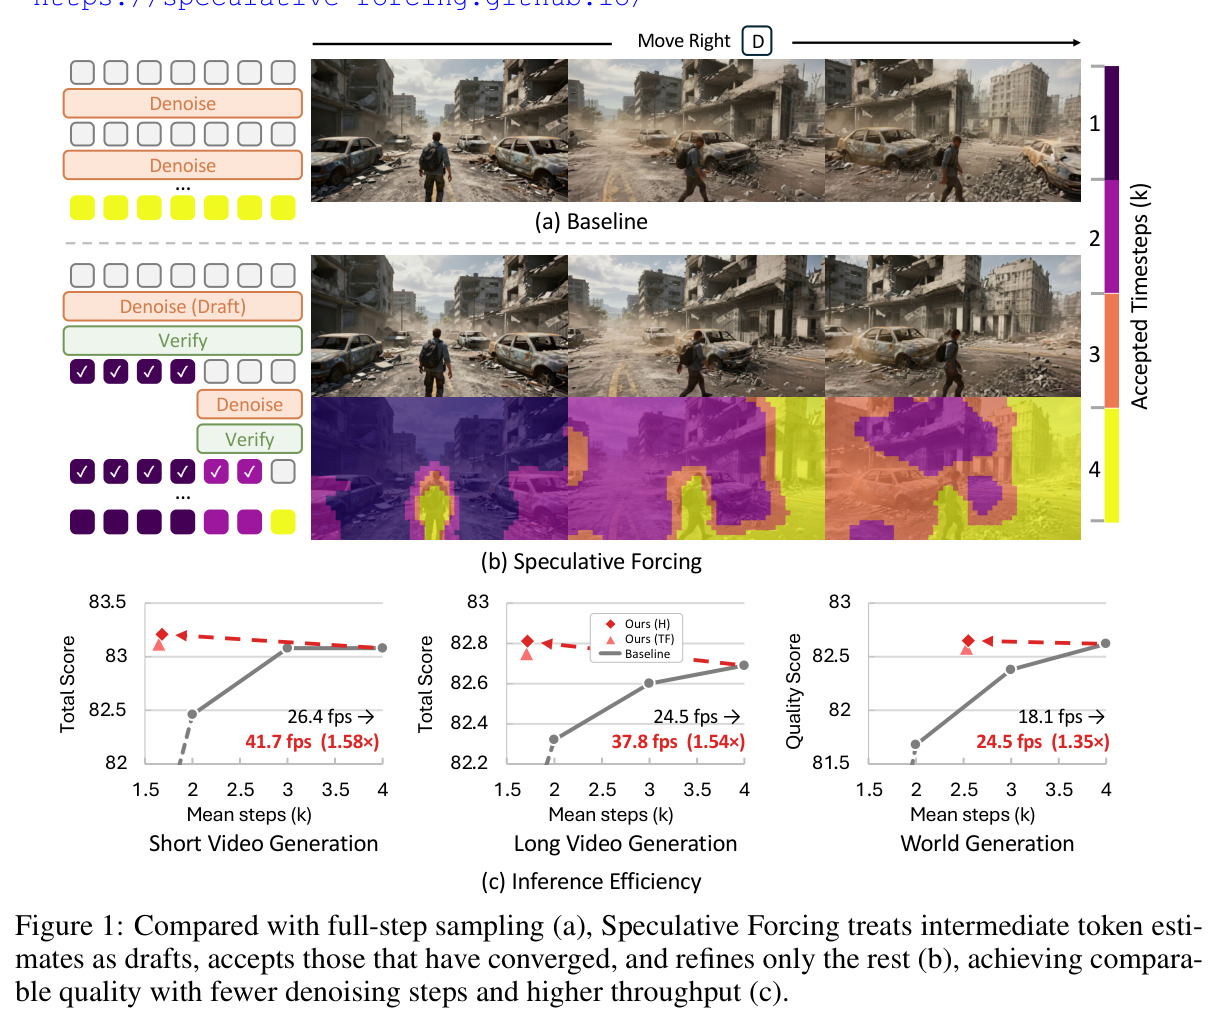
三联总览图。(a) 基线对每个 token 跑满 4 步 Denoise;(b) Speculative Forcing 交替执行 Denoise 与 Verify,已收敛的 token 打勾提前退出,只精修其余 token;(c) 三张质量-效率散点图分别对应短视频生成、长视频生成、世界生成,横轴为平均去火步数(约 1.5 至 4),纵轴为 VBench Total 分数,标出 Ours(H) 与 Ours(TF) 的位置:吞吐从 26.4 提到 41.7 fps(1.58×)、24.5 到 37.8 fps(1.54×)、18.1 到 24.5 fps(1.35×),质量与 4 步基线持平甚至略高。
一张图讲清全文主张:在质量-步数权衡曲线上,本方法位于 4 步基线的左上方(更快且不掉分),三个场景各给一个数据点,是论文价值主张的浓缩。
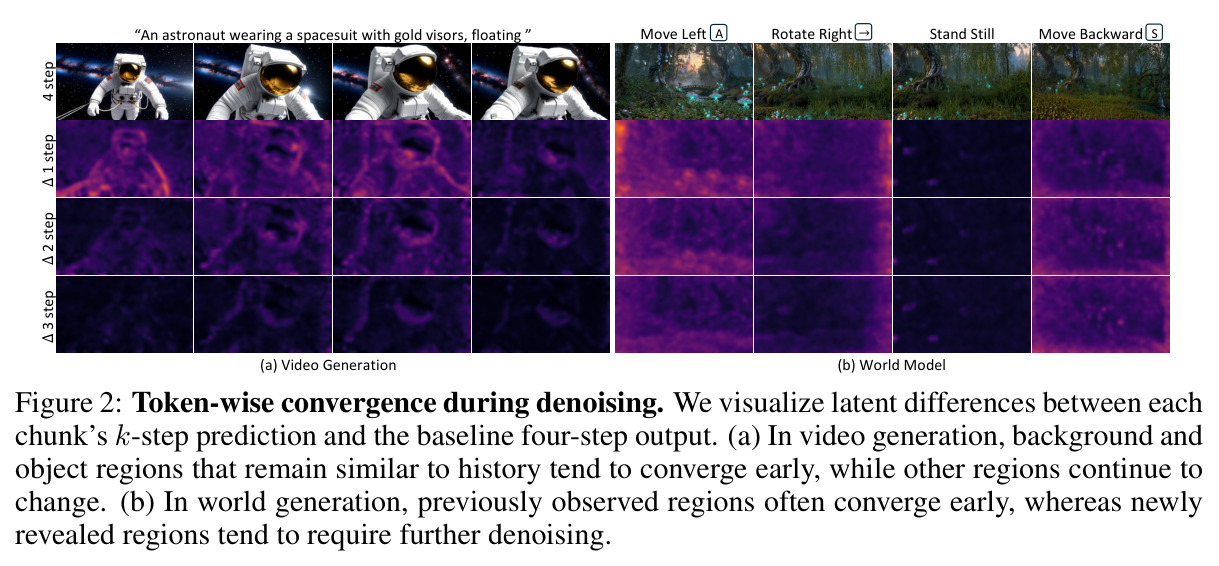
动机实验图。(a) 视频生成:给定戴金色面罩的宇航员提示词,上行展示 step 1 至 step 4 的解码预览,下行展示相邻步潜空间差异 Δ 的热图;(b) 世界生成:左移、右旋、静止、后退等动作持续改变视野。热图可视化每个块 k 步预测与 4 步基线输出的差异:与历史相似的区域(背景、已见物体、先前观察过的区域)差异早早趋近于零,而新出现的结构与镜头新揭示的区域差异持续到最后一步,且这种模式在视频生成与世界模型中一致成立。
这是整个方法成立的实证前提:如果所有 token 以相同速度收敛,逐 token 验收就毫无意义。这张图把统一计算是浪费这一直觉变成了可见证据。
路由策略对比表(所有方法校准到相近平均步数,ε=0.24):改编自 RAS 的通道方差信号 Quality 仅 78.23、Drift 4.996;改编自 MotionCache 的时间差分 80.97、4.116;块级验收 82.54、3.214;OursTF 82.58、2.926;OursH 82.65、2.839;Oracle(推理时真跑满 4 步算真实残差)82.61、2.903 但无吞吐;4 步基线 82.62、3.094。
一张表同时回答两个设计问题——什么信号能预测收敛、验收粒度为何必须是 token 级,并给出学习验证器接近 oracle 上界的证据,是消融部分信息密度最高的表。
验证准确率分析表(LongLive,按 ε=0.16/0.24/0.32 与去噪步 k=1/2/3 报告 AUROC):OursH 在 ε=0.24 下为 0.934/0.890/0.906;per-token MLP 与在线训练变体与之相当(说明骨干特征已含充分信息);冗余度第 1 步 0.828 但衰减到 0.611;稳定性 k≥2 为 0.774/0.854 但第 1 步无定义;运动信号最差 0.535 至 0.719。
量化解释各验证信号在哪些步可靠,直接支撑免训练验证器第一步用冗余、之后用稳定的拼接设计,也说明学习头为何全面领先。
验证头消融表(Lingbot,均校准到相近步数):在线训练变体 2.57 步、Drift 2.940;per-token MLP 2.52 步、24.8 fps、Drift 2.899、Quality 82.67;去掉时空平滑 2.55 步、Drift 2.882、Imaging Quality 72.54;完整 OursH 2.55 步、24.5 fps、Drift 2.839、Quality 82.65、Imaging Quality 72.65 为各变体中最佳。
说明头的具体设计并非玄学:MLP 已够用,真正的增益来自时空平滑带来的验收决策连贯性(更低 Drift、更高成像质量)。