ReaDy:以循环状态为动态上下文的混合线性注意力模型推测起草加速方法 ReaDy: Recurrent States as Dynamic Context for Speculative Drafting in Hybrid Linear Attention Large Language Models
首个用HLA循环状态为推测起草提供动态上下文,平均加速3.16×
前置知识
推测解码(Speculative Decoding)
用轻量草稿模型一次自回归地提出若干候选token,大目标模型一次前向并行验证:贪心或拒绝采样决定接受的最长前缀,一次验证可提交多个token,从而减少目标模型的串行前向次数。接受长度τ(每次验证平均提交的token数,含目标补充token)是核心质量指标。
本文即推测解码方法,所有指标(TPS、τ、前缀存活率)都建立在这个验证-接受框架上;不理解它就无法解读「接受长度+8.50%只换来吞吐+7.97%」这类结论。
混合线性注意力(HLA)
把少数全注意力层(保留逐token增长的KV缓存、提供精确检索)与多数线性注意力层(把历史键值关联压缩进固定尺寸循环状态 $S_t \in \mathbb{R}^{d_v \times d_k}$,状态大小与前缀长度无关)交错堆叠。Qwen3.8-27B 采用3个Gated DeltaNet循环层接1个全注意力层的模式,共48个循环层、16个全注意力层。
循环状态正是ReaDy读取的上下文来源;没有HLA提供的固定尺寸可查询目标记忆,这个方法就不成立。
Gated DeltaNet 循环状态
一种线性注意力层,状态更新为 $S_i = S_{i-1}A_i + B_i$,其中 $A_i = \alpha_i(I - \beta_i k_i k_i^\top)$ 变换既有关联(衰减门α控制遗忘,δ项修正当前键的关联),$B_i = \beta_i v_i k_i^\top$ 写入新关联;原始注意力读出为 $o_i = S_i q_i$。
论文的核心理论分析基于此更新式展开:$S_{t+j} = S_t P_j + W_j$ 说明未来读出依赖起草时不可得的有效查询 $q_{\text{eff}}^j = P_j q_{t+j}$,这是「为什么要另开一条状态读取通道」的动机。
DSpark 半自回归起草
DSpark用并行骨干一次前向生成整块(如7个)位置的表示与base logits,再用轻量序列预测头(Markov或RNN变体,以前一token为条件)在块内引入依赖,兼顾并行度与块内一致性,并配合置信度调度的验证机制。ReaDy的起草器骨干与预测头直接沿用公开的 RadixArk DSpark checkpoint。
ReaDy完全构建在DSpark之上,只是新增一条状态读取路径;理解「并行骨干一次产出整块表示」才能明白为何每个草稿位置需要各自的位置特定上下文。
前缀存活率(Draft-Prefix Survival)
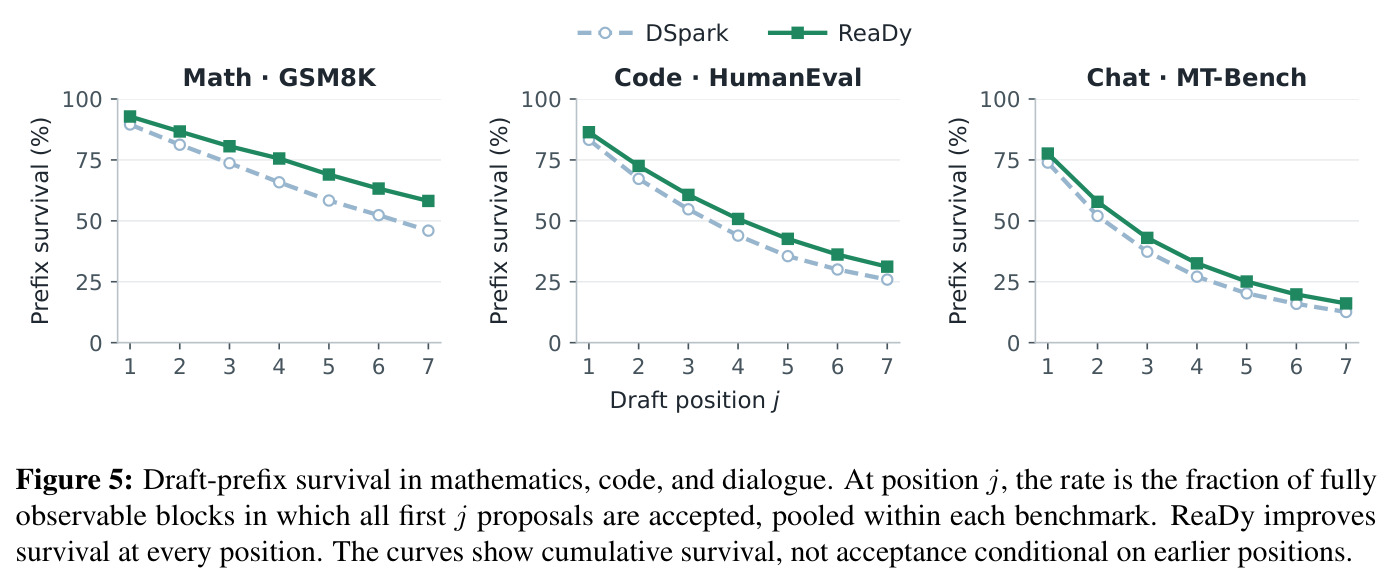
在第 $j$ 个草稿位置,存活率是全部可完整观测的起草轮次中前 $j$ 个候选token都被接受的比例:$\hat{P}_j = \frac{1}{N}\sum_i \mathbb{1}\{A_i \ge j\}$。注意它是累积存活而非条件接受率,轮次不足的末端样本按删失(censored)处理而非计为拒绝。
Figure 5 与附录E的协议都用它来定位「草稿块从第几位开始崩」,且论文特别强调累积/条件的区别,误读会导致对改进幅度的错误判断。
查询空间投影(理论工具)
对已知查询矩阵 $Q$,$\Pi_Q = QQ^\dagger$(Moore-Penrose伪逆)是向其列空间投影的算子。对新查询 $q^*$ 有分解 $Sq^* = (SQ)Q^\dagger q^* + S(I-\Pi_Q)q^*$:第一项完全由已暴露读出 $(O, Q)$ 决定;第二项只有直接访问状态 $S$ 才能得到,且当 $Q$ 行满秩时该项消失。
Proposition 1 是论文论证「新增状态读取通道能带来已有隐特征读出无法决定的新信息」的理论根据:关键在于接口暴露了哪些查询方向,而非读出数量。
研究动机
推测解码通过让轻量起草器一次提出多个token、目标模型并行验证来加速自回归生成,但起草质量随之成为新瓶颈。主流特征复现式起草器(GliDe、LongSpec的跨注意力读KV、KVShot的KV检索、DFlash/DSpark的隐特征复用)依赖目标模型输出的隐状态特征作为条件上下文;这些特征是目标在自身查询位置学到的读出,其上下文侧重未必匹配草稿块中后续位置的需求——起草第3个token所需的前缀关系,可能在前向特征中根本没有被强调。另一类方法直接查询目标的KV缓存做新鲜检索(如KVShot),但KV缓存是逐token增长的记忆,尺寸随前缀线性增长,供给额外上下文的I/O开销随上下文变长而水涨船高,长上下文场景代价高。因此,如何在半自回归起草中为每个草稿位置提供位置相关的前缀上下文,同时不引入随前缀增长的访存开销,是现有方法未解决的核心矛盾。
本文的目标是本文提出首个利用混合线性注意力(HLA)模型循环状态作为推测起草上下文来源的方法ReaDy:让每个草稿位置用可学习的查询直接检索目标模型已提交(committed)的固定尺寸循环状态,获得位置特定的补充上下文,再通过轻量残差更新注入草稿表示,从而提升草稿-目标一致性与接受长度。方法还须满足三个约束:一是额外计算与I/O开销足够低,不能吃掉接受长度带来的加速;二是与预训练DSpark起草器兼容,只需轻量两阶段适配而非从头训练;三是用理论说清楚「新查询何时能从已暴露读出之外的状态中获得新信息」。最终目标是在Qwen3.8-27B上实现相对自回归解码平均3.16×、相对DSpark 7.97%的吞吐提升,同时接受长度提升8.50%。
与已有工作不同的是,独特切入角度是把「上下文来源」从逐token的KV缓存换成固定尺寸的循环状态矩阵。理论上,作者用理想化接口 $O = SQ$ 刻画已暴露读出与新查询的关系:$Sq^* = (SQ)Q^\dagger q^* + S(I - \Pi_Q)q^*$,第一项由已有读出唯一决定,第二项只有直接访问状态 $S$ 才能获得——说明决定信息新颖性的是接口暴露的查询方向,而非读出数量。工程上,对Gated DeltaNet沿固定续写展开得 $S_{t+j} = S_t P_j + W_j$、$o_{t+j} = S_t q_{\text{eff}}^j + W_j q_{t+j}$,其中有效查询 $q_{\text{eff}}^j = P_j q_{t+j}$ 依赖未来系数,起草时不可得;既然无法重建未来读出,不如让起草器学习自己的位置条件查询去读已提交状态 $S_t$。作者明确指出这是首个把HLA循环状态用作推测起草补充上下文的工作,与读KV缓存的GliDe/LongSpec/KVShot形成清晰对照。
核心方法
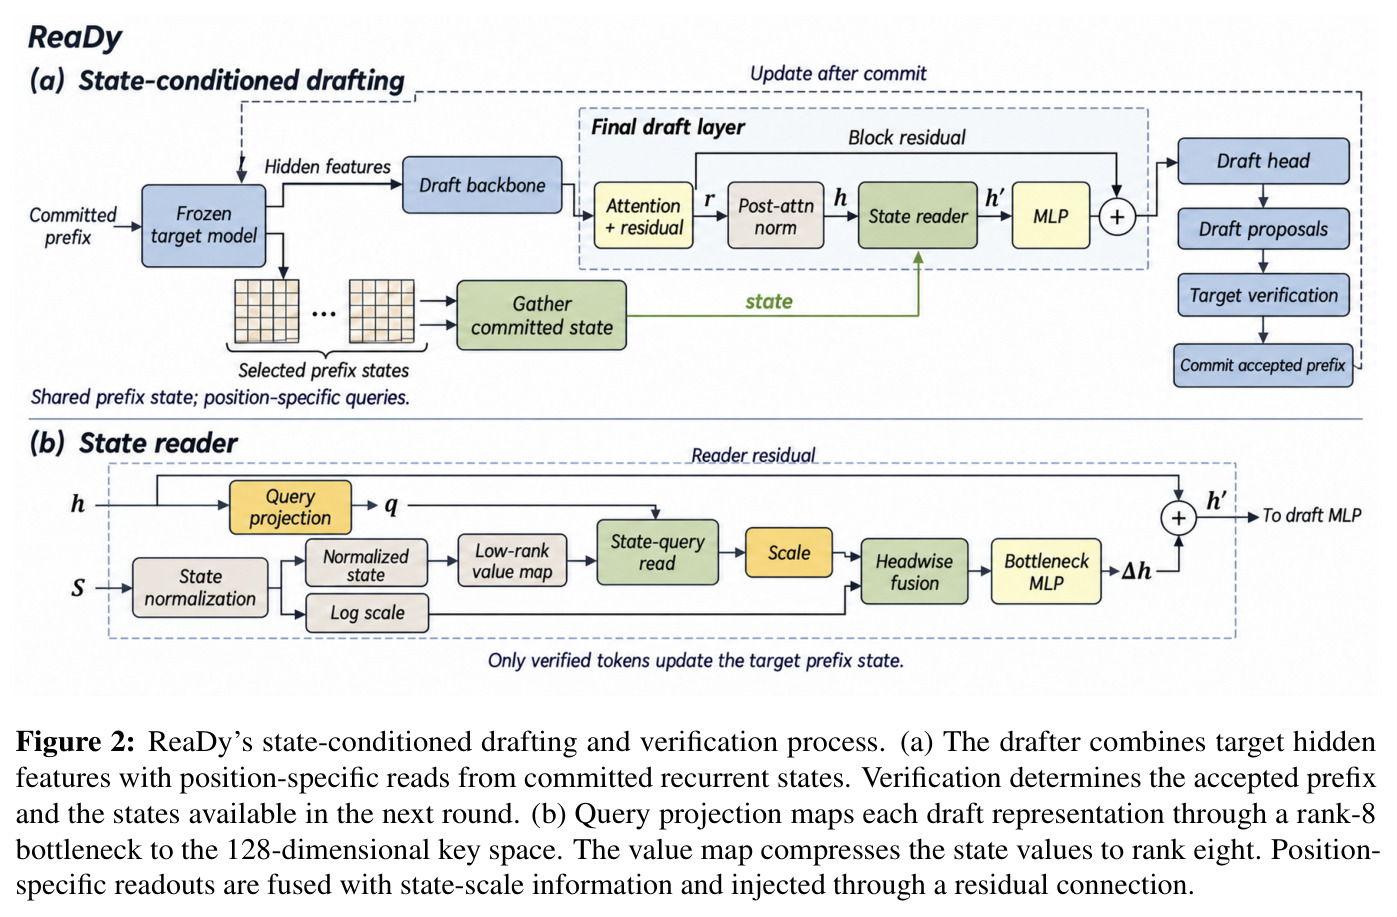
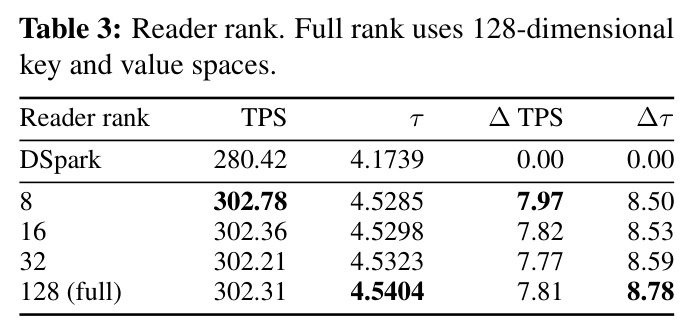
ReaDy在DSpark半自回归起草器之上增加一条「状态读取路径」。直觉:HLA目标模型(Qwen3.8-27B,64层中48层为Gated DeltaNet)的循环状态以固定尺寸矩阵 $S^{\ell,a}_t \in \mathbb{R}^{128 \times 128}$ 紧凑积累历史关联,用可学习查询直接读取,即可让每个草稿位置获得与自身需求匹配的前缀上下文,无需扫描逐token增长的KV缓存。技术上,读取器放在草稿器最后一层、注意力后归一化之后、MLP之前:对草稿表示 $h_j \in \mathbb{R}^{5120}$ 做RMSNorm并经秩 $r=8$ 瓶颈映射到128维键空间得查询 $q_j$;同时用 $V \in \mathbb{R}^{128 \times 8}$ 把状态值维压缩到秩8得投影状态 $T = V^\top \bar{S}$(整块共享);内积得8维读出 $u_j$。所选层(30、62)头的读出与log-RMS状态尺度拼接,经瓶颈MLP形成残差 $\Delta h_j$ 一次性注入。所有草稿位置读同一份已提交状态,检索因查询不同而位置特定;目标架构与其原有缓存完全不变。
核心创新是「状态条件化起草」。已有方法要么复用目标隐特征(其上下文侧重由目标自身查询决定,未必服务后续草稿位置),要么查询逐token增长的KV缓存(I/O随前缀线性增长)。区别有三:(1) 上下文源是固定尺寸循环状态,$M$ 个层-头对只含 $M d_v d_k$ 个元素、与前缀长度 $t$ 无关,同规模KV记忆则含 $Mt(d_k+d_v)$ 个元素;(2) 每个草稿位置用自己的学习查询 $q_j$ 读同一份已提交状态,检索天然位置特定且不推进目标状态;(3) 双侧低秩约束:查询侧经 $U \in \mathbb{R}^{r \times d_k}$ 限制到学习子空间,值侧经 $V \in \mathbb{R}^{d_v \times r}$ 压到秩8,投影 $T$ 整块共享,单次读出成本从 $d_v$ 降到8。理论上 Proposition 1 证明:仅当 $q^*$ 落在已暴露查询span内,读出才由 $(O,Q)$ 唯一决定;落在span外则不同状态可有相同读出却对新查询给出不同答案——为「直接读状态能获得隐特征读不出的信息」提供动机(作者也说明这不证明完整多层特征必然不足)。
方法步骤详情
流程分四步。(1) 状态接口:目标在前缀 $t$ 处提供隐特征与选定循环层(第30、62层)的128×128循环状态,RMS归一化得 $\bar{S}$。(2) 位置条件读取:在草稿器最后一层注意力后,对位置 $j$ 依次计算 $z_j = W_q\text{RMSNorm}(h_j)$、$q_j = U^\top z_j$、$T = V^\top \bar{S}$、$u_j = Tq_j/\sqrt{d_k}$;$W_q$、$U$ 构成秩8查询瓶颈($8\times5120$、$8\times128$),$V \in \mathbb{R}^{128\times8}$ 压缩状态值维。(3) 融合注入:读出与log-RMS状态尺度拼成 $f_j$,经瓶颈MLP得残差 $\Delta h_j$,以 $h'_j = h_j + \Delta h_j$ 注入后由草稿MLP产出base logits,DSpark序列预测头生成7-token候选块。(4) 验证提交:贪心下接受与目标argmax一致的最长前缀,失配处截断并提交目标纠正token,全中则给bonus token;只保留已提交token对应的状态,被拒续写状态不保留。训练两阶段:先冻结草稿器、在20k样本上只训读取器(lr $10^{-4}$),再联合训练读取器与LoRA(50k样本,$5\times10^{-5}$);损失 $\mathcal{L} = \mathcal{L}_{\text{CE}} + 0.1\mathcal{L}_{\text{L1}}$,位置权重 $w_j = e^{-j/4}$,目标全程冻结。
技术新颖性
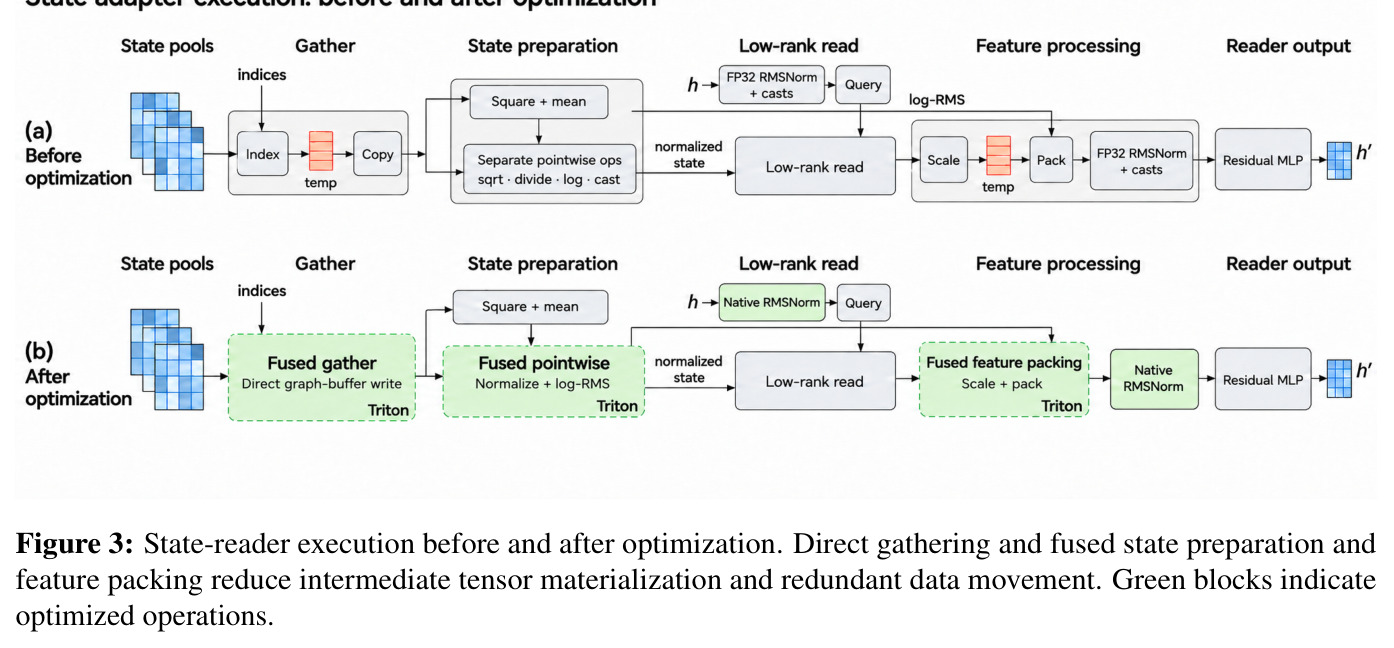
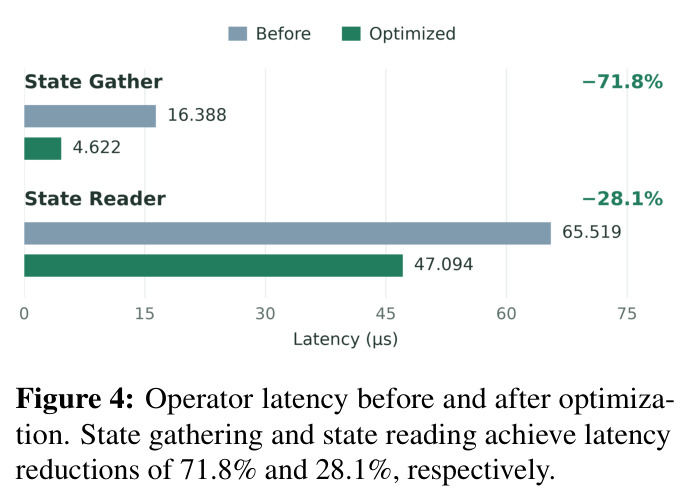
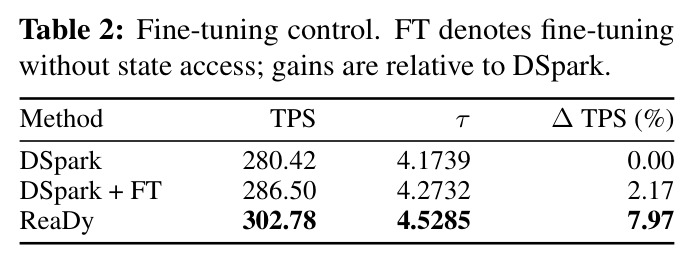
新颖性有四。(1) 概念上首个把HLA循环状态作为推测起草的上下文通道:GliDe/LongSpec跨注意力读KV、KVShot检索KV缓存,共同问题是访存随前缀增长;ReaDy上下文源固定尺寸,投影 $T$ 与整块查询共享,I/O天然有界。(2) 接口理论:Proposition 1的秩-投影分析严格刻画「新查询何时带来已有读出无法决定的信息」($q^*$ 须在 $\text{span}(Q)$ 外),把问题从「读出够不够多」转为「接口暴露了哪些查询方向」;Proposition 2给出 $S_{t+j} = S_tP_j + W_j$ 的展开,说明有效查询依赖不可得的未来系数。(3) 系统工程:熔合gather直接写入预分配缓冲、熔合状态准备与读出打包、原生RMSNorm,把gather延迟从16.388μs降到4.622μs(-71.8%)、读取器从65.519μs降到47.094μs(-28.1%)。(4) 适配策略:两阶段「先读取器后LoRA联合」接入预训练DSpark;Table 2对照证明增益主要来自状态访问而非额外训练(相对无状态微调版再+5.68% TPS、+5.97% τ)。
实验结果
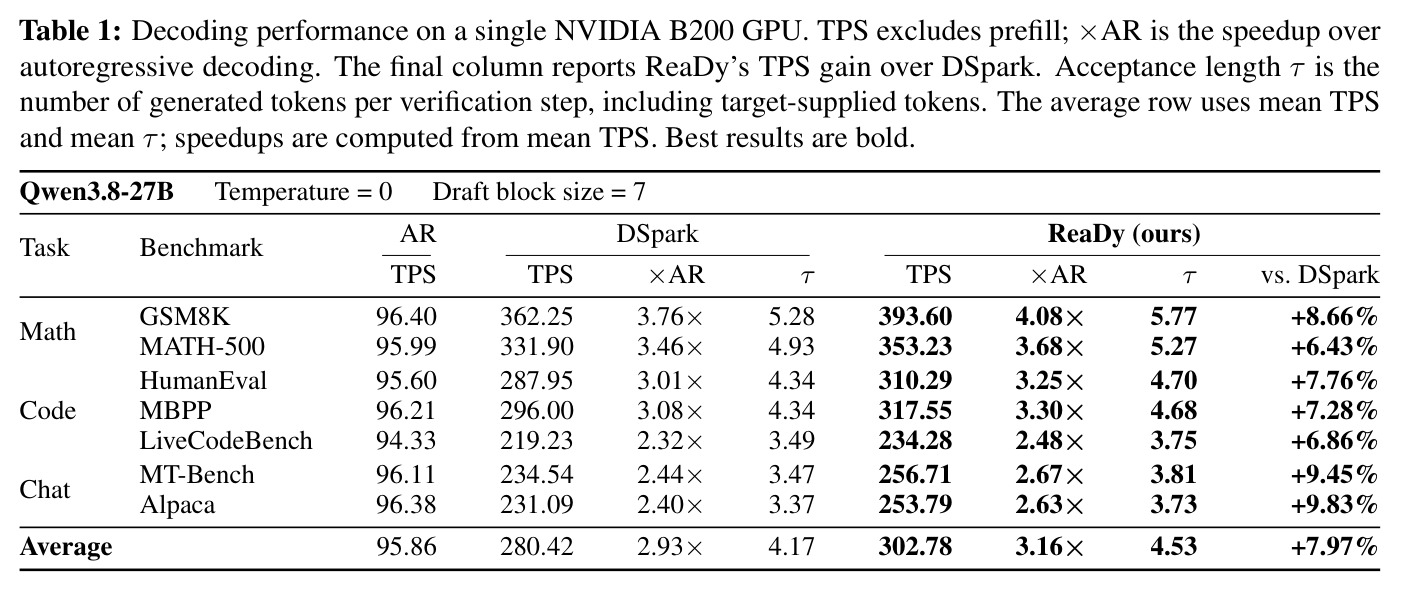
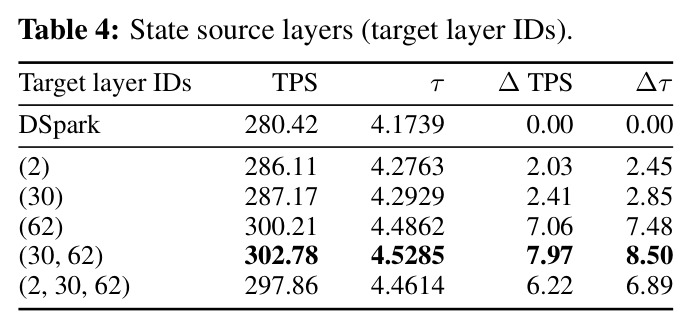
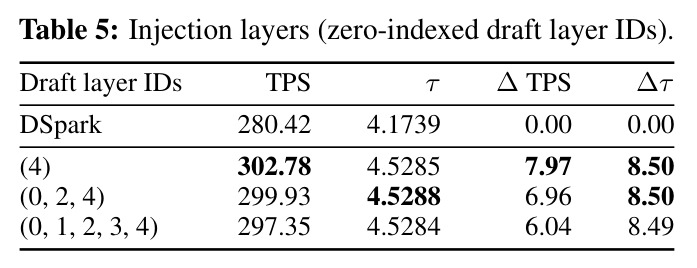
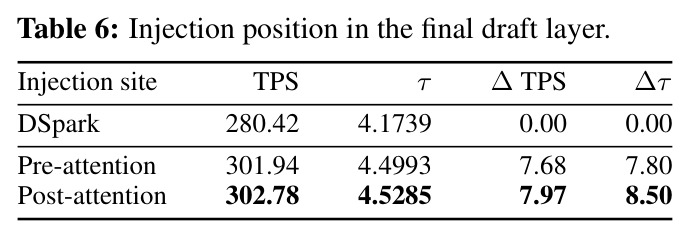
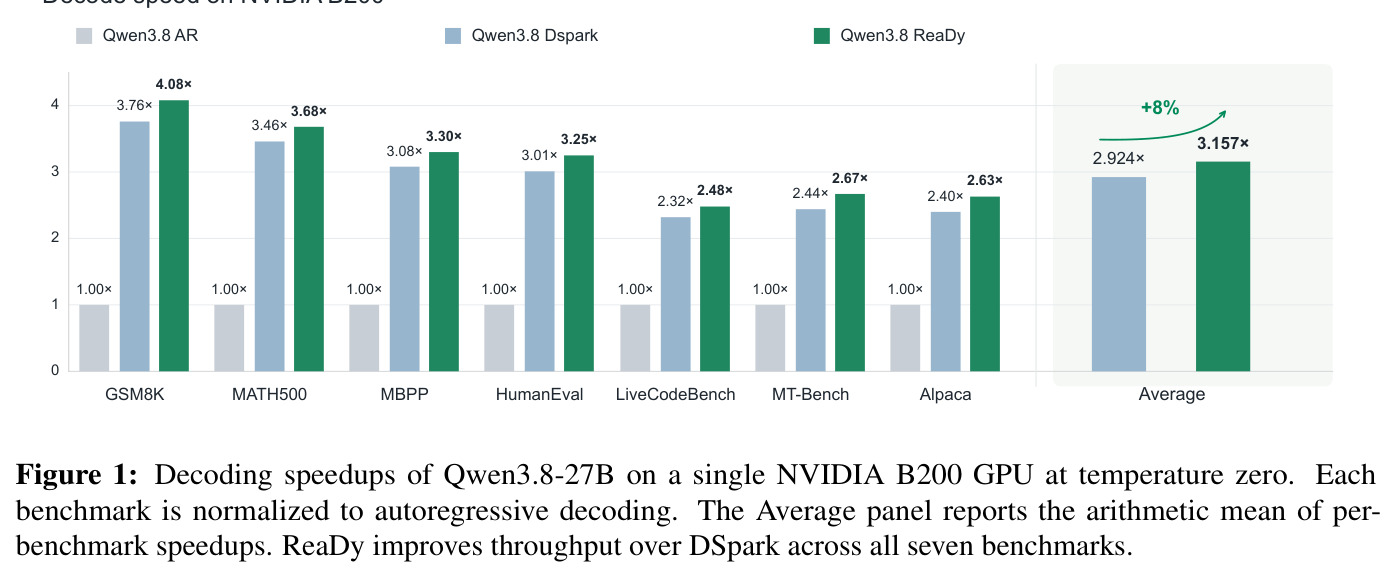
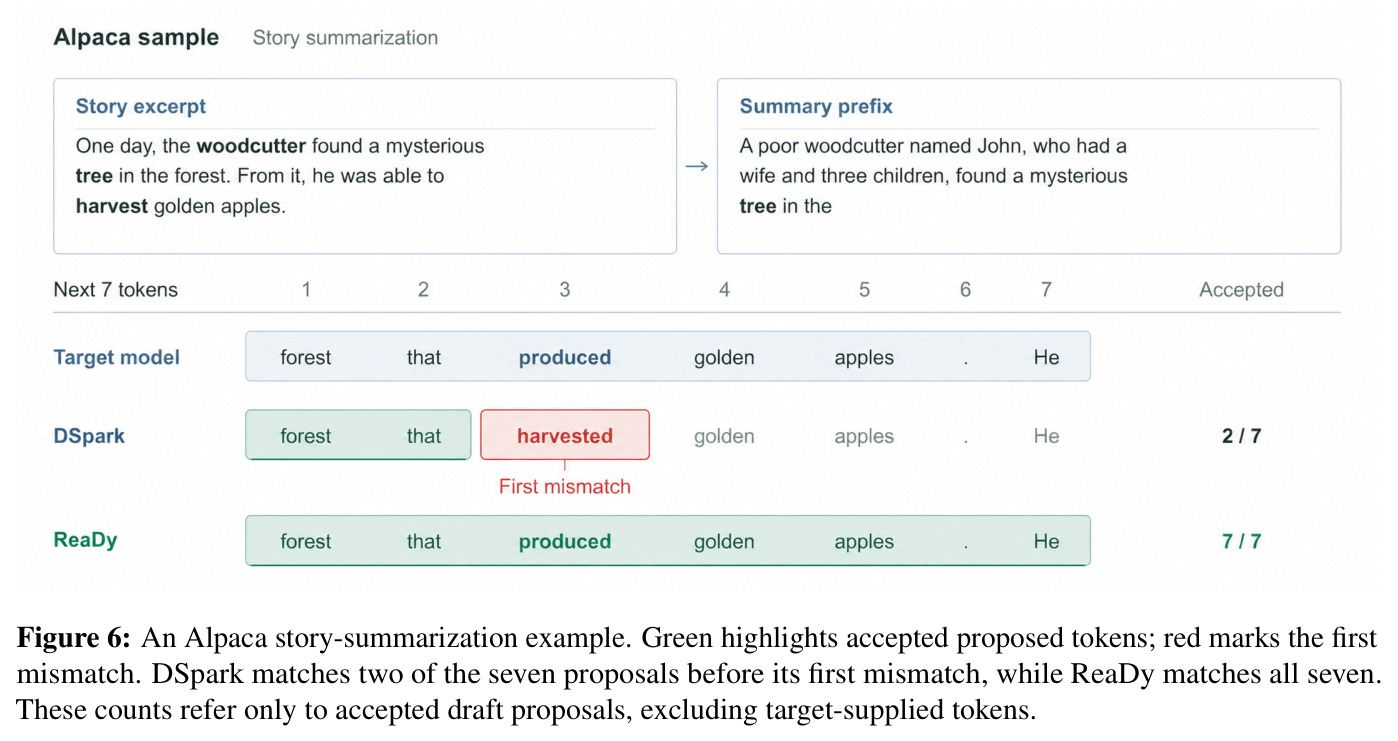
Table 1(单张B200,7基准,贪心,块大小7):ReaDy平均吞吐302.78 tokens/s,为AR(95.86)的3.16×,比DSpark(280.42,2.93×)快7.97%;接受长度 $\tau$ 从4.1739升至4.5285(+8.50%)。分基准(×AR,对DSpark增益):GSM8K 4.08×/+8.66%,MATH500 3.68×/+6.43%,HumanEval 3.25×/+7.76%,MBPP 3.30×/+7.28%,LiveCodeBench 2.48×/+6.86%,MT-Bench 2.67×/+9.45%,Alpaca 2.63×/+9.83%——对话增益最大、代码最小。Figure 5:第7位存活率45.98%→58.17%(GSM8K)、25.89%→31.19%(HumanEval)、12.59%→16.11%(MT-Bench),各位置均更高。消融:无状态微调仅+2.17%(Table 2),ReaDy相对其再+5.68%/+5.97%;秩8近饱和,全秩128只多换0.0119的 $\tau$ 却降吞吐(Table 3);层62单独+7.48% τ,(30,62)最优,加层2反降(Table 4);仅最后一层注入一次最佳(Table 5);注意力后注入优于前(Table 6);Figure 6中DSpark第3位失配只中2个token,ReaDy全中7个。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 数学推理 · GSM8K | 吞吐 TPS (tokens/s) | 393.60(4.08×,τ=5.77) | AR 96.40;DSpark 362.25(3.76×,τ=5.28) | 对DSpark +8.66% TPS |
| 数学推理 · MATH-500 | 吞吐 TPS (tokens/s) | 353.23(3.68×,τ=5.27) | AR 95.99;DSpark 331.90(3.46×,τ=4.93) | 对DSpark +6.43% TPS |
| 代码生成 · HumanEval | 吞吐 TPS (tokens/s) | 310.29(3.25×,τ=4.70) | AR 95.60;DSpark 287.95(3.01×,τ=4.34) | 对DSpark +7.76% TPS |
| 代码生成 · MBPP | 吞吐 TPS (tokens/s) | 317.55(3.30×,τ=4.68) | AR 96.21;DSpark 296.00(3.08×,τ=4.34) | 对DSpark +7.28% TPS |
| 代码生成 · LiveCodeBench | 吞吐 TPS (tokens/s) | 234.28(2.48×,τ=3.75) | AR 94.33;DSpark 219.23(2.32×,τ=3.49) | 对DSpark +6.86% TPS |
| 对话 · MT-Bench | 吞吐 TPS (tokens/s) | 256.71(2.67×,τ=3.81) | AR 96.11;DSpark 234.54(2.44×,τ=3.47) | 对DSpark +9.45% TPS |
| 指令跟随 · Alpaca | 吞吐 TPS (tokens/s) | 253.79(2.63×,τ=3.73) | AR 96.38;DSpark 231.09(2.40×,τ=3.37) | 对DSpark +9.83% TPS |
| 七基准平均 | 吞吐 TPS / 接受长度 τ | 302.78 tokens/s(3.16×,τ=4.5285) | AR 95.86;DSpark 280.42(2.93×,τ=4.1739) | 对DSpark +7.97% TPS、+8.50% τ;对AR 3.16× |
| 前缀存活率(第7位)· GSM8K / HumanEval / MT-Bench | 累积前缀存活率 (%) | 58.17 / 31.19 / 16.11 | DSpark:45.98 / 25.89 / 12.59 | 每位置均更高,第7位分别+12.2 / +5.3 / +3.5 个百分点 |
| 无状态微调对照(Table 2) | TPS / τ 相对DSpark增益 | ReaDy +7.97% / +8.50% | DSpark+FT 仅 +2.17% / +2.38% | 状态访问相对微调版再贡献 +5.68% TPS、+5.97% τ |
局限与改进
作者承认的局限:(1) 前缀存活测量所用checkpoint存在训练/评测重叠,只刻画解码行为、不建立held-out泛化,也未分离语义检索机制;(2) Proposition 1/2只针对理想化状态-查询读出接口,不证明完整多层特征信息不足;(3) 延迟是operator级测量,端到端收益需看主实验,且「略小的吞吐增益凸显控制读取器开销的必要」。我观察到的局限:(1) 仅Qwen3.8-27B一个目标、单GPU、并发1、贪心解码,未覆盖采样式验证与高并发服务,吞吐结论外推存疑;(2) 方法依赖目标暴露循环状态,纯Transformer目标没有固定尺寸状态,不适用;(3) 约8%增益需70k样本两阶段训练与新增读取器参数,性价比需权衡;(4) 对话任务第7位存活率绝对值仍低(16.11%),长块起草的根本难度未解决;(5) 消融只覆盖秩、源层、注入层/位置,读取器深度、$\mathcal{L}_{\text{L1}}$ 系数、位置权重 $w_j=e^{-j/4}$ 等训练组件未单独消融。
独立分析的弱点
(1) 读取配置全局静态:源层(30,62)与秩8由离线消融选定,但Table 4显示各层信息量差异悬殊(层62单独+7.48% vs 层30仅+2.85%),状态有用性高度依赖层与任务;按位置/难度动态分配读取层与秩(作者结论中也提及)应能降低无效开销。(2) τ +8.50%但吞吐只+7.97%,47μs读取延迟在并发>1时会被放大,而论文只测并发1;改进方向是进一步融合算子或把读取器蒸馏进骨干。(3) 训练配方与DSpark原版不同(去掉置信损失、改用 $w_j=e^{-j/4}$),与预训练DSpark的对比混入适配红利,且L1权重、位置权重等组件未单独消融,应补齐成分消融。(4) 仅贪心+thinking模式,与主流采样式验证工作不可直接比表,应补rejection sampling评测。(5) 状态只在最后一层注入一次,中间层读取理论上可帮助块内早期位置建模,但Table 5显示多注入只掉吞吐,说明读取路径仍太贵,需要更便宜的注入机制。
未来方向
作者明确提出的方向:(1) 从头训练完整草稿器,而非依赖预训练DSpark的两阶段适配;(2) 学习跨草稿位置的状态访问与读取容量分配(哪个位置读哪层、读多少秩)。基于本文成果可延伸:(1) 把状态条件读取移植到EAGLE-3类自回归草稿器,检验对块内依赖建模的普适收益;(2) 与DSpark的置信度调度结合,做采样式验证下的状态条件训练与自适应块长;(3) 混合路由:循环状态提供固定尺寸的全局摘要、KV缓存提供精确实体级检索,按位置不确定性在ReaDy式读状态与KVShot式读KV之间动态选择,兼取两者;(4) 联合微调目标状态写入过程,让状态本身对草稿查询更「可读」;(5) 在更大目标模型与真实多并发服务负载下评测,考察读取延迟的摊销;(6) 理论上把Proposition 1的秩投影分析从单层线性读出扩展到多层非线性特征接口,建立读取器秩与可接受增益上界的关系。
复现评估
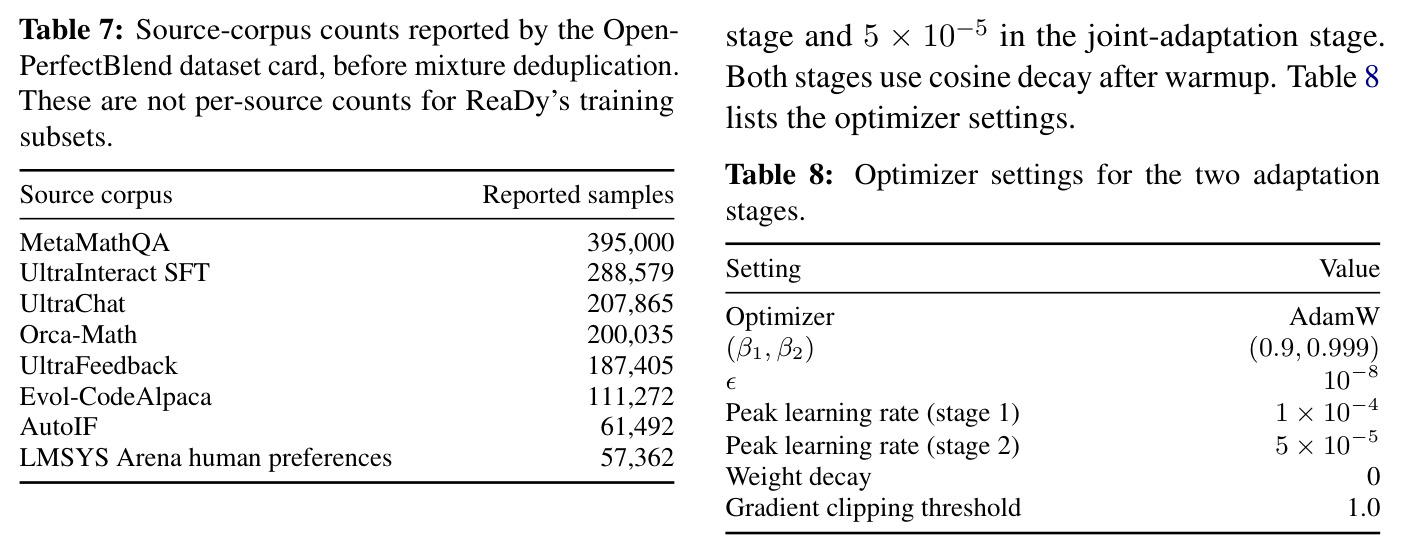
复现条件较好但门槛不低。开源:代码在 GitHub(StartLuxLabs/ReaDy),起草器初始化自公开的 RadixArk Qwen3.8-27B-DSpark checkpoint,数据 OpenPerfectBlend 公开(Table 7:MetaMathQA 395k、UltraInteract SFT 288,579条等8个源),目标Qwen3.8-27B公开。配方完整:读取器公式、$d_k=d_v=128$、秩8、源层(30,62)、注入位置、优化器设置(AdamW,FP32主参数,峰值lr $1\times10^{-4}$/$5\times10^{-5}$,余弦衰减,Table 8)、损失与位置权重均给出。算力:两阶段训练(20k+50k样本,按4 GPU平均损失实现),推理需单张B200级GPU跑BF16的27B模型,SGLang需支持HLA与自定义熔合算子。主要风险:熔合gather与打包算子的实现质量直接影响吞吐结论(优化前后gather延迟差3.5倍),thinking模式设置、存活协议的删失处理等细节需对齐。总体属「可复现但需系统工程投入」的工作。
论文图表
两阶段适配的优化器设置:AdamW(β=(0.9,0.999),ε=1e-8),阶段1峰值学习率1×10⁻⁴(仅读取器),阶段2为5×10⁻⁵(读取器+LoRA联合),权重衰减0,梯度裁剪阈值1.0,均带warmup后余弦衰减。
训练复现的必要超参数,配合损失公式与位置权重构成完整的训练配方。