投机解码中并行草稿的上下文校正(DCOCO) Contextual Correction of Parallel Draftsfor Speculative Decoding
用并行批量打分恢复扩散草稿块内依赖,前缀优先选路,投机解码吞吐最高提升6.6倍
前置知识
投机解码(Speculative Decoding)
LLM 推理加速技术:轻量草稿模型一次提出多个未来 token,目标大模型在一次前向中并行验证。验证从左到右接受最长一致前缀,在首个拒绝处停止并由目标模型补采一个 token。接受/拒绝规则经过精心设计,保证最终输出分布与目标模型完全一致(无损)。加速效果取决于被接受的平均长度与草稿生成延迟之间的权衡。
本文的全部设计(前缀优先、接受长度 τ、吞吐指标)都建立在投机解码的草稿—验证框架和'首错即停'这一结构性质之上,不理解它就无法理解为什么校正应该优先前缀。
并行扩散草稿器(DFlash)
一类基于离散扩散式并行预测的草稿模型:不同于自回归草稿器逐个生成 token,DFlash 在目标模型特征的条件下,用一次前向同时去噪/预测整个 16 token 的草稿块,把草稿延迟压缩到单次前向。代价是块内每个位置看不到前面槽位最终选定的 token,会出现单个合理但组合不连贯的输出(如同时有 'New York' 与 'San Diego' 概率时输出 'New Diego')。
DFlash 是 DCOCO 的直接宿主:校正器的全部输入(隐状态、候选 id、logit)都来自同一次 DFlash 前向,理解它的并行性与缺陷是理解本文动机的前提。
接受长度 τ 与 top-k 覆盖率
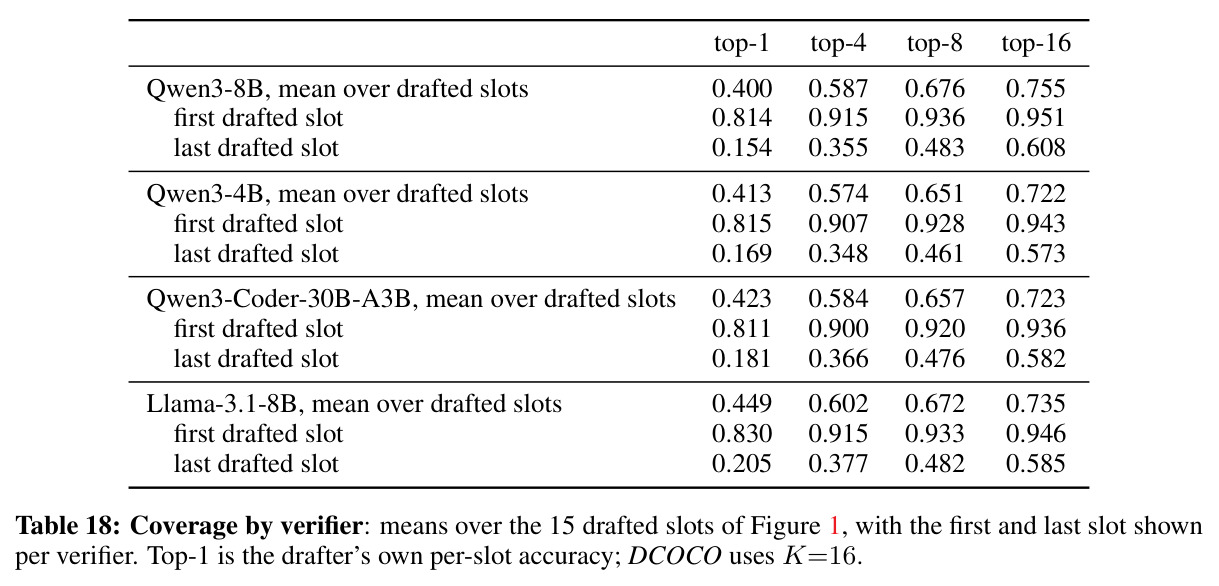
τ = E[A(ŷ)] + 1,其中 A(ŷ) 是每轮被验证器接受的最长前缀长度,τ 决定每轮提交的 token 数,是解释吞吐变化的机制指标。top-k 覆盖率指草稿器 top-k 候选中包含验证器最终提交 token 的槽位比例。本文实测 Qwen3-8B 上 top-1 平均覆盖 0.400 而 top-16 达 0.755;最后一个槽位 top-1 仅 0.154 而 top-16 仍有 0.608。
覆盖率实验证明'正确 token 已在候选池中、只是没被选中',是'重选择而非重新生成'这一核心思路的实证依据;τ 则是读懂所有实验表格的钥匙。
点质量提议与随机验证
若草稿器确定性地输出某个 token,其提议分布是点质量 $p_j(v|x,\hat{y}_{<j}) = \mathbf{1}[v = \hat{y}_j]$。标准投机采样以 $\min\{1, q_j(\hat{y}_j)/p_j(\hat{y}_j)\} = q_j(\hat{y}_j)$ 的概率接受,拒绝时从残差分布 $r_j(v) = q_j(v)\mathbf{1}[v \neq \hat{y}_j]/(1 - q_j(\hat{y}_j))$ 重采样,可证明仍精确保持目标分布。
论文附录 G 专门证明 DCOCO 的确定性提议在温度 T=1 的随机解码下依然无损,因此转移分数无需 softmax 归一化、无需采样——这是方法正确性的关键一环。
研究动机
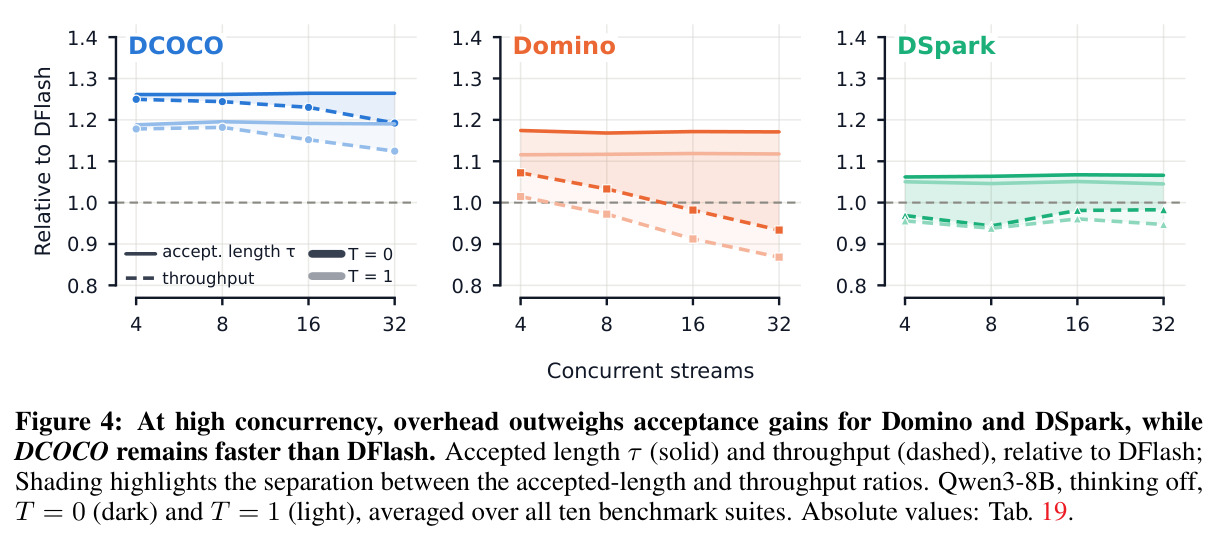
基于 DFlash 等并行扩散草稿器的投机解码虽然把草稿延迟压缩到一次前向,但块内每个位置都是在不知道前面槽位最终选了什么 token 的情况下预测的,丢掉了自回归草稿天然具备的块内依赖。结果是各自看似合理的预测拼在一起却不连贯——例如草稿器同时给 'New York' 和 'San Diego' 概率时可能输出 'New Diego'——直接压低草稿接受率。已有两条修正路线:DSpark 在并行骨干上加轻量串行模块做半自回归草稿,Domino 用因果校正模块借助前缀信息精炼草稿,两者都能恢复接受率,但它们的校正模块都是逐位置串行递推的,其延迟坐在每个草稿周期的关键路径上。在 vLLM 批量服务下,并发越高、验证器周期被摊薄得越厉害,这块串行开销的相对占比就越大:论文实测在 32 路并发时 Domino 和 DSpark 的吞吐甚至跌破不加校正的 DFlash 本身,校正收益在真实服务负载下完全消失。
本文的目标是本文要回答的核心问题是:能否在不重新引入任何串行神经模块的前提下,恢复并行草稿丢失的块内依赖?具体目标分三层。其一,校正所需信息必须全部来自已有的一次 DFlash 前向(隐状态、候选 id、logit),不增加任何草稿前向次数,使神经打分完全并行。其二,把'修正'重新表述为在草稿器已有的 top-K 候选池内做重选择,而不是重新生成 token——实证依据是 Qwen3-8B 上在 top-1 选错的槽位中,59% 的情况下正确 token 就躺在 top-16 候选里。其三,选择规则必须尊重投机验证'接受连续前缀、首错即停'的结构,优先保证块首位置的质量,而非整块聚合分数最优。最终目标是在贪心与随机解码、开/关扩展思考的全部组合以及 1–32 路并发下都取得最高平均吞吐。
与已有工作不同的是,本文切入点的独特性在于两个被前人忽视的观察的组合。第一,并行草稿器'往往已经猜到了正确答案、只是没选它':top-16 覆盖率比 top-1 高出巨大(15 槽平均 0.755 对 0.400),且越深入块内差距越大(末槽 0.608 对 0.154,差距从首槽的 0.12–0.14 增至 0.38–0.45),因此校正可以从'逐位重新生成'降维成'在 K 个候选间重选',而相邻槽位间的 $K^2$ 个候选转移可以一次批量打分。第二,验证的不对称性:第 5 个槽位改得再好,只要第 1 槽被拒就完全无效,所以优化目标应是前缀生存质量而非整条路径的分数和。DSpark 和 Domino 只看到了第一点(恢复依赖),却用逐位置串行模块支付延迟代价;DCOCO 把所有神经计算并行化,唯一串行的只是 $O(BK)$ 的网格游走——纯 argmax、无任何网络前向——从而在高并发下仍保有优势,而串行竞争者反被开销吞没。
核心方法
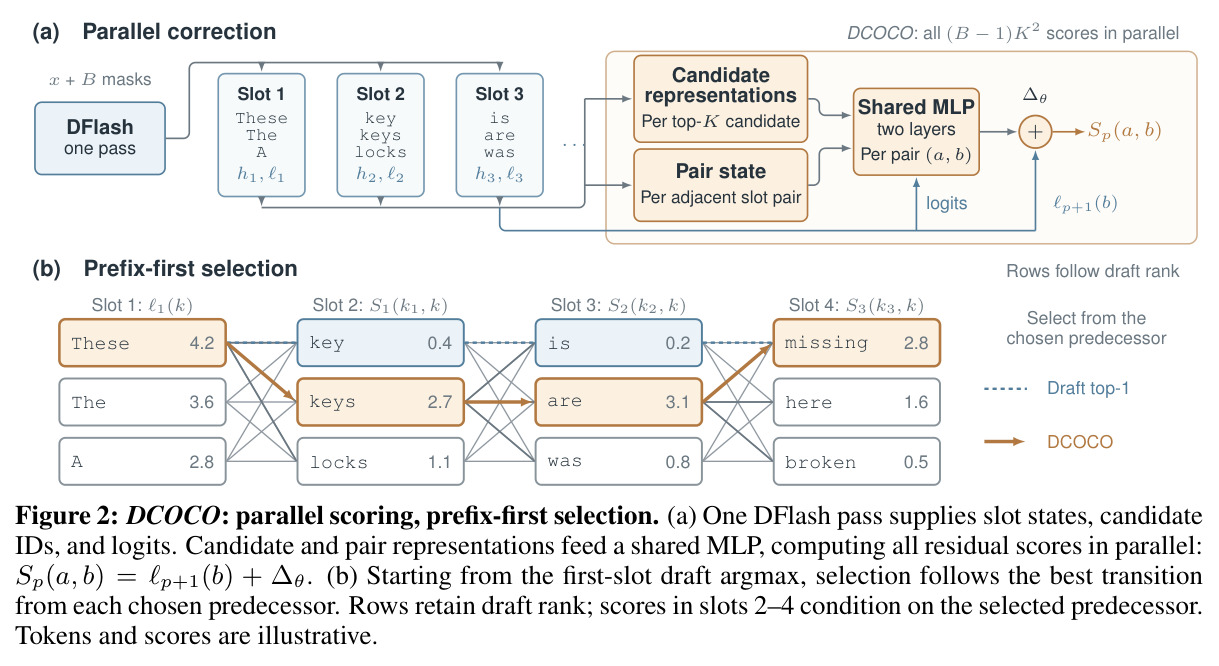
DCOCO(DFlash Contextual Corrector)分两步工作。第一步是并行重打分:对一次 DFlash 前向产出的 $B=15$ 个草稿槽位(另有一个作为上下文锚点的槽位),每槽保留 top-$K=16$ 个候选,构成 $B \times K = 240$ 个节点的稠密一阶网格;对每对相邻槽位间的所有 $K^2 = 256$ 个候选转移计算分数 $S_p(a,b) = \ell_{p+1}(b) + \Delta_θ(\cdot)$,其中后继候选的草稿 logit 提供基础分,一个在槽位间共享参数的两层 MLP 给出上下文修正项;全部 $(B-1)K^2 = 14 \times 256 = 3584$ 个转移分数在一个批量操作内并行算完。第二步是前缀优先选路:第一个槽位取草稿的 argmax,之后每个槽位从已选前驱出发选分数最高的后继 $k_{p+1} = \arg\max_b S_p(k_p, b)$,逐步向右走出最终提议块。直觉上,这是让草稿器'回头看一眼'每个候选与前文的搭配是否协调,再按验证器消费草稿的顺序(从左到右、遇错即停)挑选最佳组合。
核心创新有二。第一是'重选择而非重生成':不从头重新生成草稿,而是利用覆盖率实验揭示的事实——正确 token 大概率已在 top-$K$ 池中——把块内依赖恢复问题转化为对 $K^2$ 个候选转移的打分问题。所有转移分数由同一组共享参数(候选表示 + 槽对状态 + 两层 MLP,Qwen3-8B 上仅 2,229,505 个参数)一次并行算出,没有任何逐位置运行的神经递推,这与 DSpark/Domino 必须沿块串行运行的校正模块有本质区别。第二是'前缀优先贪心选路':与其最大化整条路径的转移分数之和(后面的高分无法弥补前面被拒的损失),不如从左到右逐步贪心,每一步都在已选前驱的条件下选最优后继——这与验证'首错即停'的消费结构严格对齐。此外 MLP 输出层零初始化,训练开始时 $\Delta_θ \equiv 0$,每个转移分数退化为后继草稿 logit,选路严格还原草稿器自身的 argmax 提议,保证训练起点即基线、增加的任何收益都来自学到的修正项。
方法步骤详情
(1)单次 DFlash 前向产出每槽隐状态 $h_i$、top-16 候选 id 与草稿 logit $\ell_i(k)$。(2)构造候选表示:$b_i^k = \mathrm{LN}(W_{cand} E[c_i^k])$、$g_i = \mathrm{LN}(W_{ctx} h_i)$ 采用非仿射 LN(token 嵌入与隐状态尺度差两个数量级以上),融合为 $z_i^k = \mathrm{LN}_{\gamma,\beta}(W_{fuse}[b_i^k; g_i])$,宽度 $r=128$。(3)槽对状态 $s_p = W_{pair}[h_p; h_{p+1}]$ 每对槽只算一次、被其间 $K^2$ 个转移复用。(4)转移打分 $S_p(a,b) = \ell_{p+1}(b) + \Delta_θ([s_p; z_p^a; z_{p+1,b}; \ell_p(a); \ell_{p+1}(b)])$,$\Delta_θ$ 为 386→256→1 的 GELU 两层 MLP,全部 3584 个分数一次批量算出。(5)前缀优先游走 $O(BK)$:首槽取草稿 argmax,其后逐槽选 $\arg\max_b S_p(k_p,b)$。(6)训练:从 6 epoch 的 DFlash 检查点出发,草稿器与校正器联合再训 6 epoch;标签是教师强制下验证器在相邻两槽的 argmax token 对(都需在各自 top-K 内,否则掩码剔除),损失为对 $K^2$ 个转移联合 softmax 的交叉熵,并按 $e^{-(p-1)/\rho}$($\rho=4$)对靠前位置指数降权以近似前缀生存;token 嵌入表冻结,AdamW 学习率 $6\times10^{-4}$、cosine 加 4% warmup、8 卡、约 75 万 token/优化器步。
技术新颖性
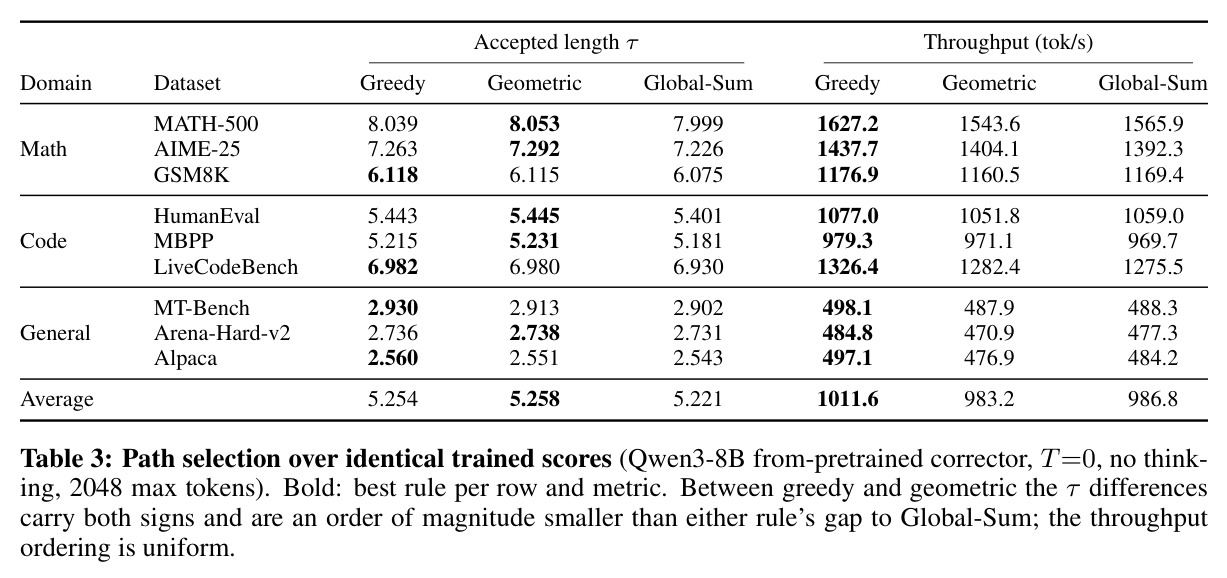
技术新颖性体现在四个层面。架构上,此前恢复块内依赖的方法(Hydra 的串行依赖头、DSpark 的半自回归模块、Domino 的因果校正编码器)都需要一个沿块逐位递推的学习模块坐在关键路径上;DCOCO 的神经打分完全并行且参数全局共享(2.2M 参数对比五层草稿骨干),唯一串行的是不含任何参数的 argmax 游走。目标上,论文首次把投机验证的前缀结构明确引入草稿校正:训练损失用指数降权($\rho=4$)作为前缀生存的固定代理,推理用前缀优先贪心,且作者论证联合交叉熵的监督严格强于解码时需支持的条件决策——它不仅把真后继排到真前驱所在行的首位,还同时压制所有竞争行。理论上,附录 G 证明确定性点质量提议在标准投机采样下依然无损:接受概率化为 $q_j(\hat{y}_j)$,残差分布有闭式解 $r_j(v) \propto q_j(v)\mathbf{1}[v \neq \hat{y}_j]$,因此分数无需归一化、无需从候选分布采样。实验方法论上,通过'同一组分数、三种选路规则'(Table 3)和'同预算训练对照'(Table 4)两个控制实验,把收益干净地归因于校正器本身而非训练预算或选择技巧。
实验结果
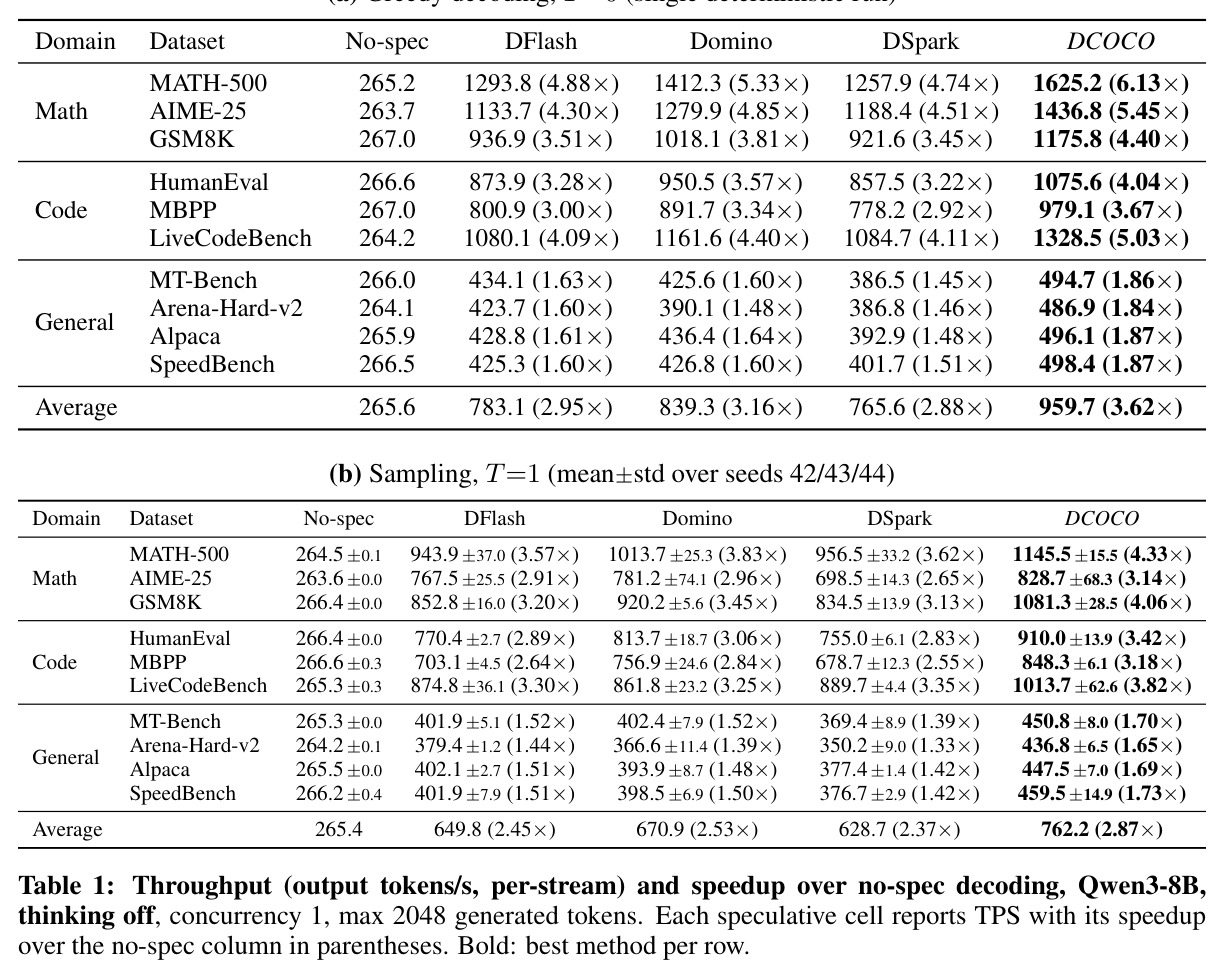
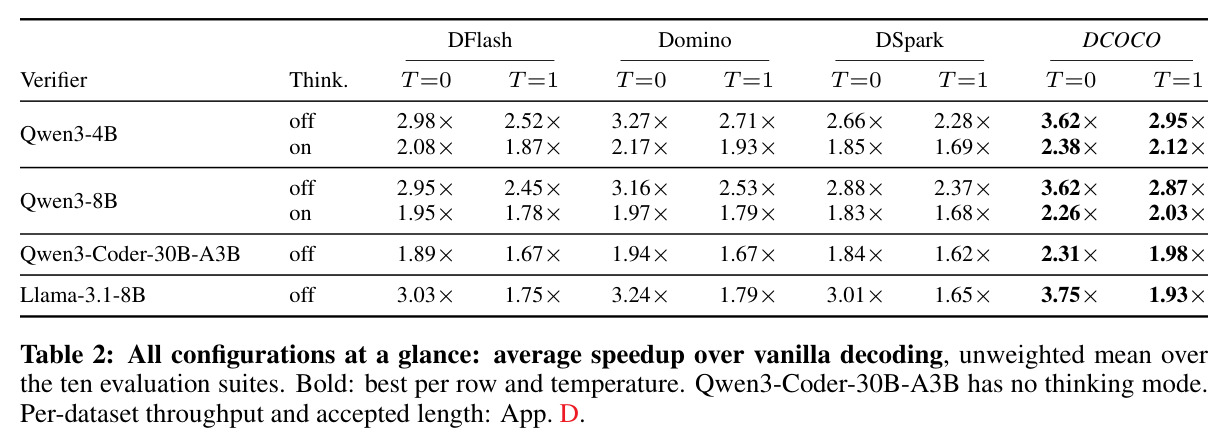
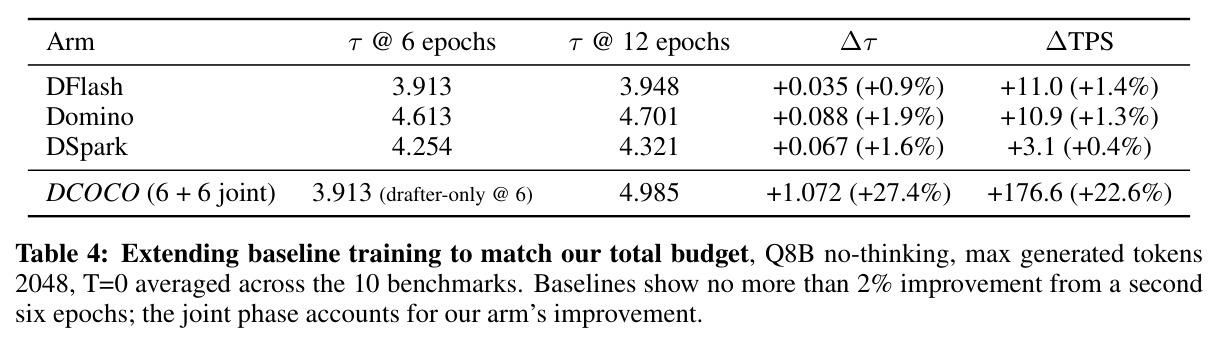
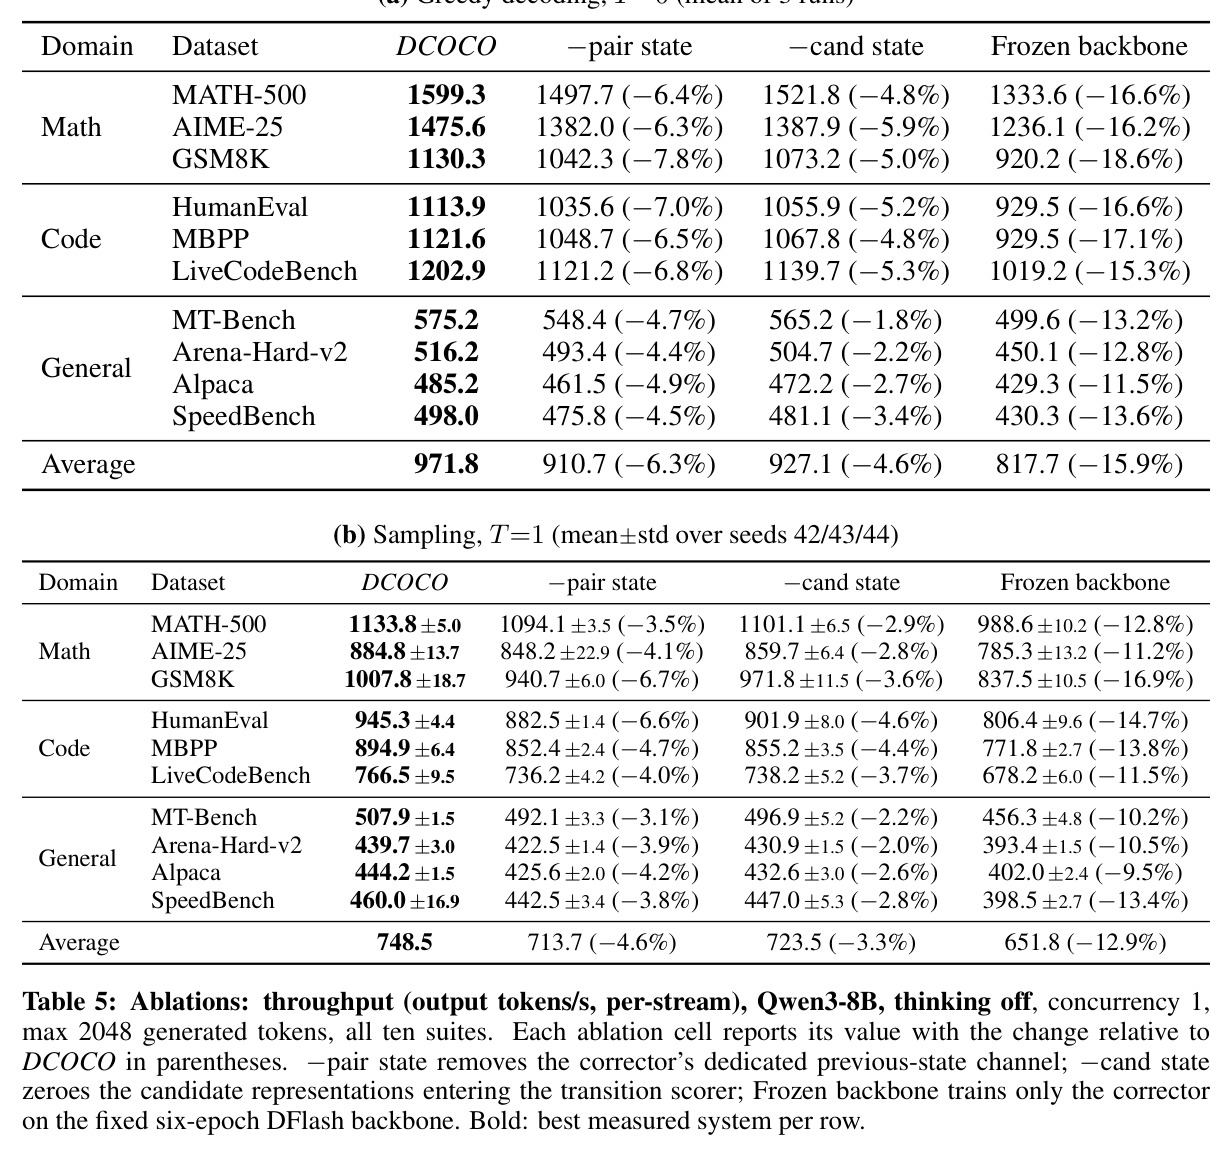
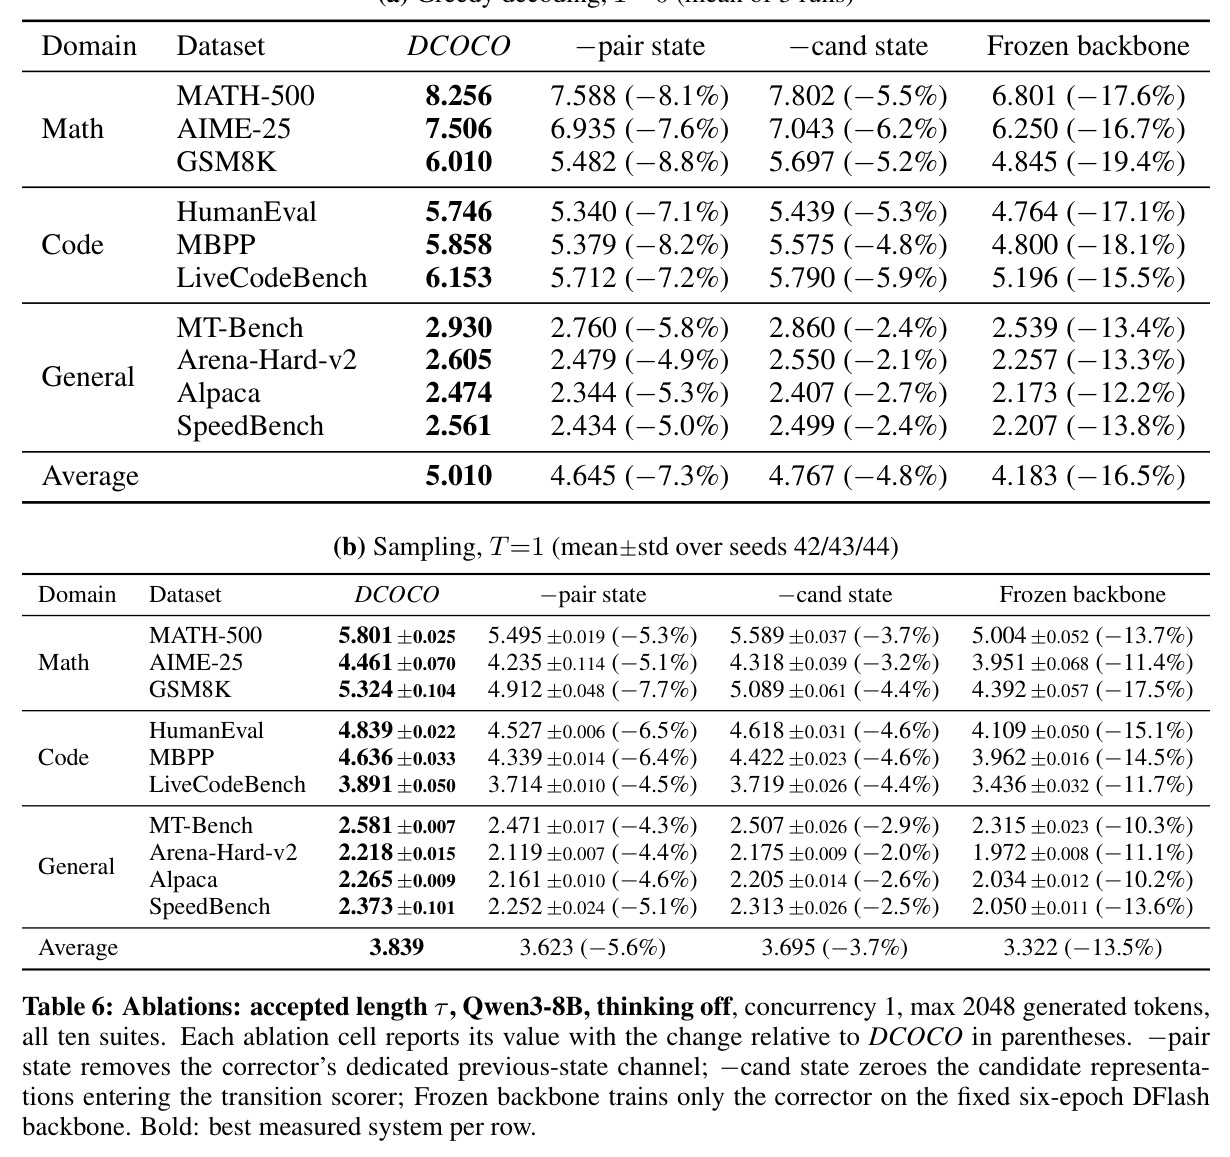
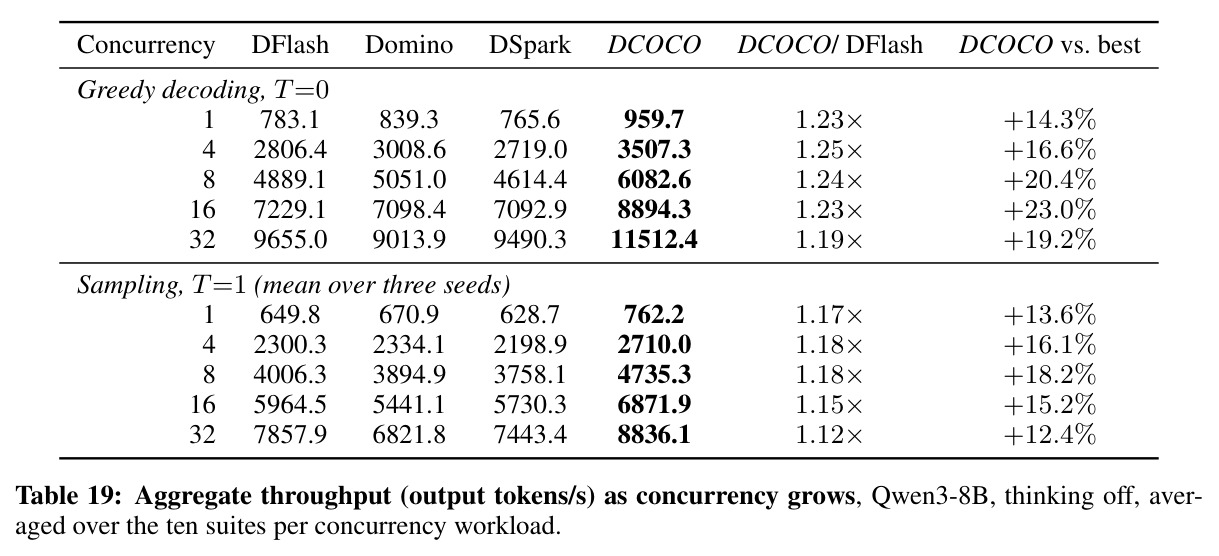
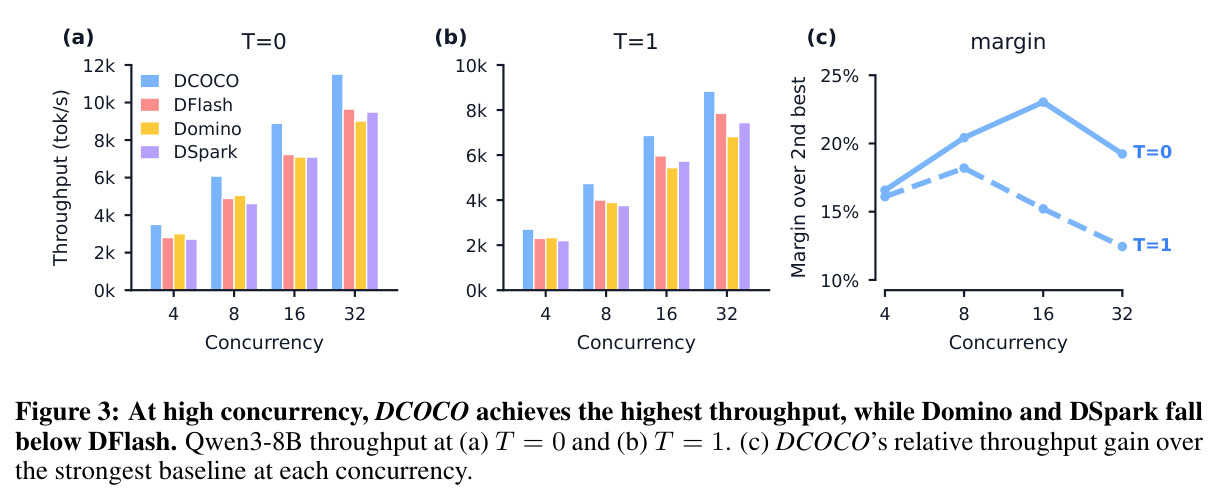
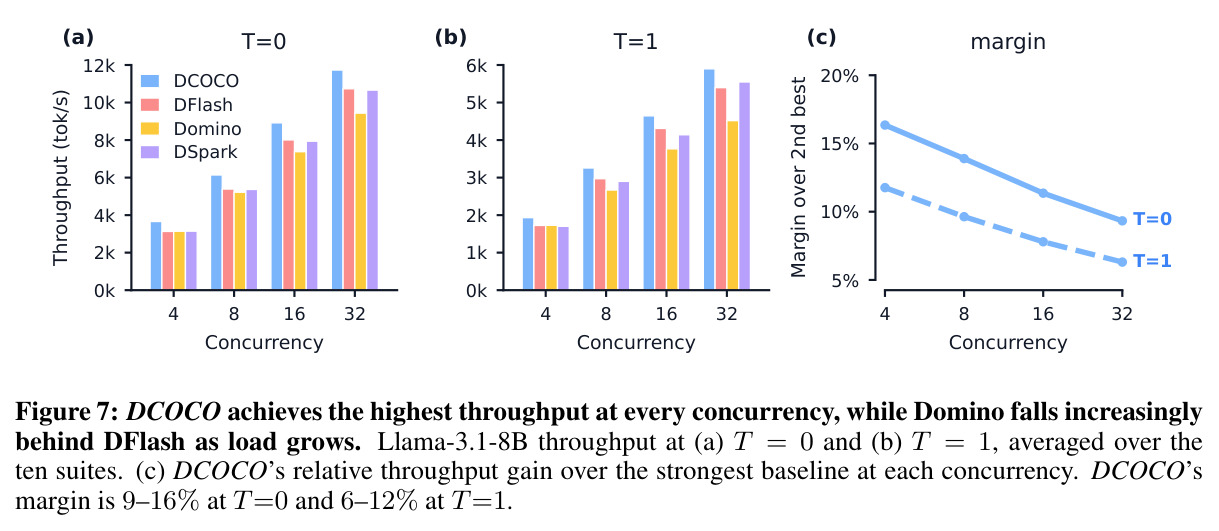
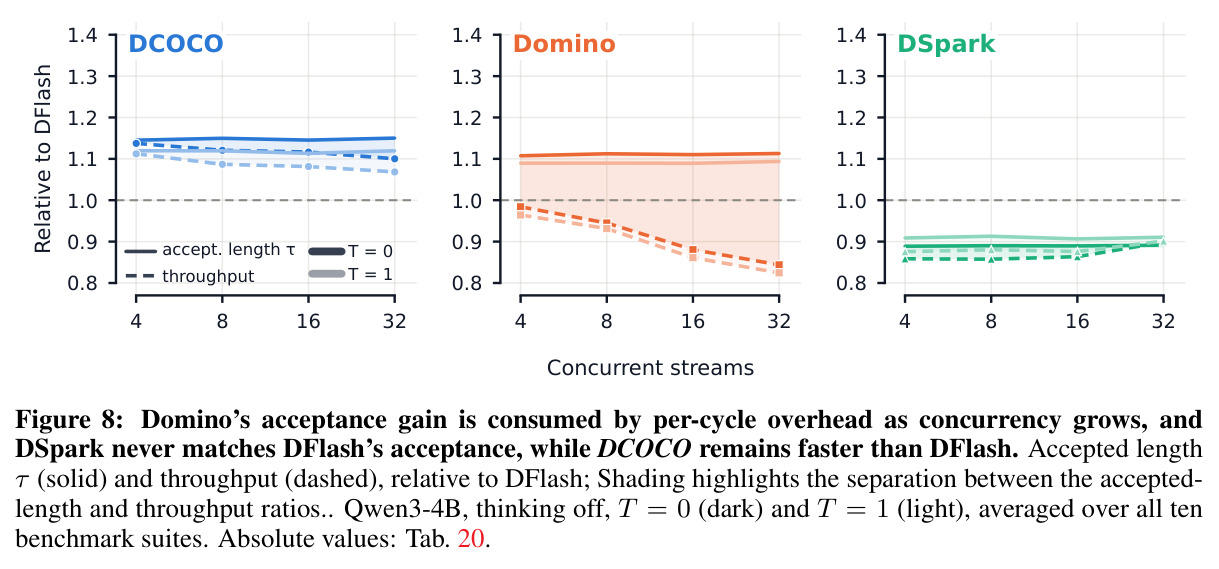
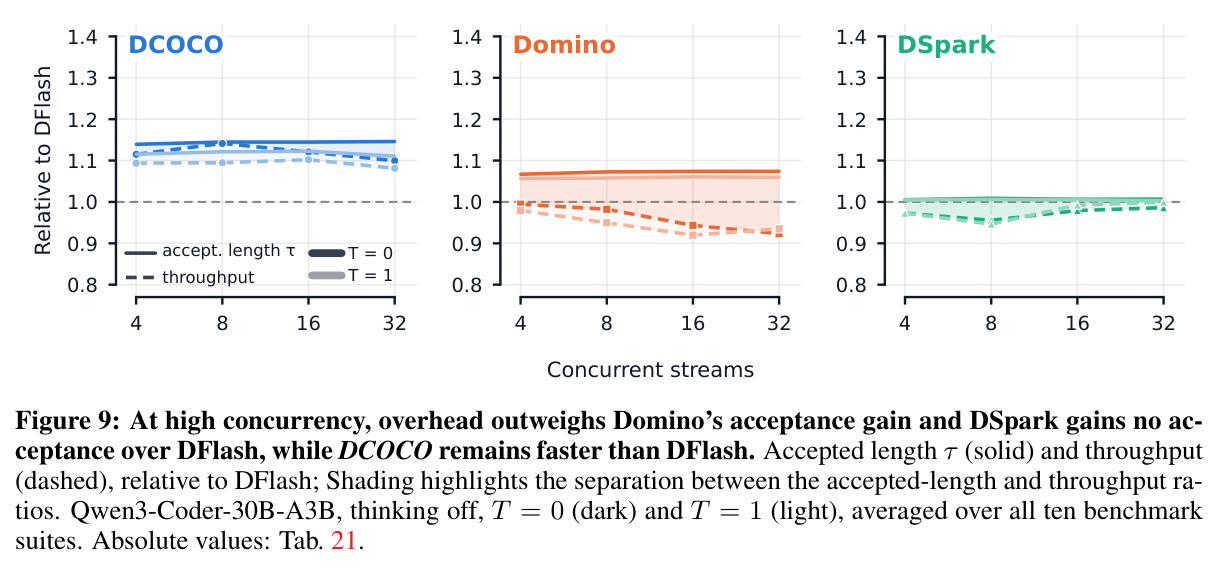
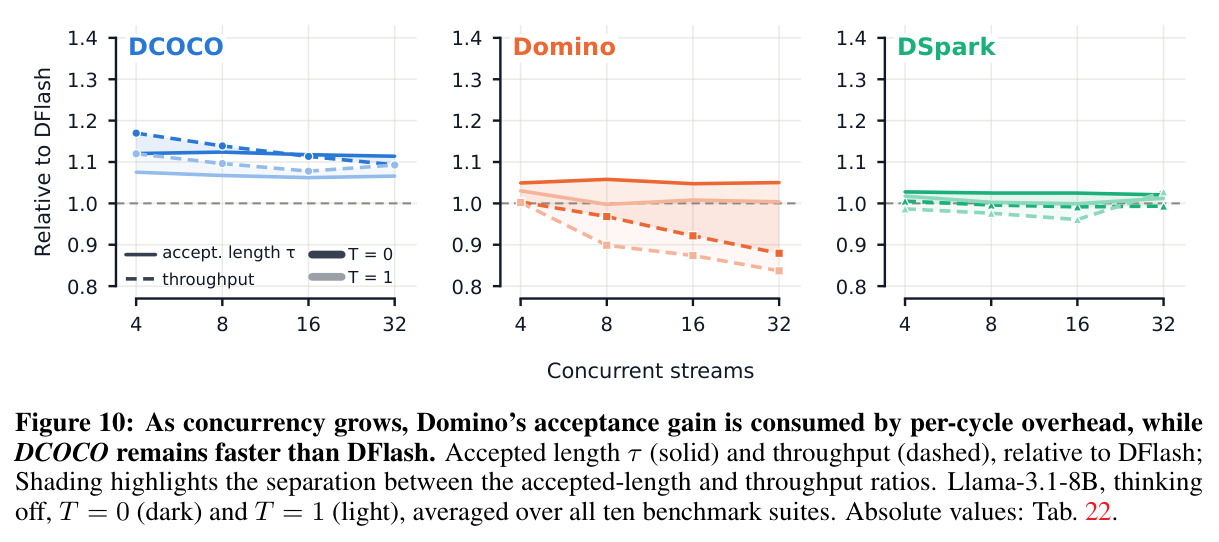
实验覆盖 4 个验证器(Qwen3-4B/8B/Coder-30B-A3B、Llama-3.1-8B)×10 个基准,贪心/随机、开/关扩展思考,vLLM 0.27.0 单卡 B200。Qwen3-8B 无思考 T=0:DCOCO 平均 959.7 tok/s(3.62×),领先最强基线 Domino(839.3,3.16×)14.3%,T=1 领先 13.6%;单套件最高 MATH-500 6.13×,全文最高 6.6×(Qwen3-4B AIME-25)。Table 2 的 12 个配置格中 DCOCO 平均加速全部第一,领先各自最强基线 8–19%,11/12 格平均接受长度第一(Qwen3-8B T=0 τ=4.985,对 Domino 4.613、DSpark 4.254、DFlash 3.913);机制上对最强基线是 7–8% 更长前缀 ×6% 更短周期,对 DFlash 是每周期 3–4% 开销换 18–27% 更长接受。并发 4–32 路下 DCOCO 每格吞吐最高:T=0 峰值领先 23%(16 路)、32 路仍 +19.2%(11512 对 DFlash 9655),而 Domino(9014)与 DSpark(9490)跌破不加校正的 DFlash;T=1 领先从 +18% 收窄到 +12.4%。控制实验:基线多训 6 epoch 接受长度仅 +≤1.9%,DCOCO 联合阶段 +27.4% τ、+22.6% 吞吐,排除预算解释。消融:去槽对状态 τ −7.3%,去候选表示 −4.8%,冻结骨干仍比 DFlash 高 4.4% 但比联合训练低 15.9%。选路对照(Table 3):Global-Sum 全部套件更差;Geometric(λ=0.75) 接受率持平(5.258 对 5.254)但 Greedy 每套件吞吐都更高(平均 +2.8%)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 文本生成吞吐(Qwen3-8B,10 套件平均,无思考) | tokens/s(括号内为对无投机解码的加速比) | DCOCO 959.7(3.62×) | Domino 839.3(3.16×)、DFlash 783.1(2.95×)、DSpark 765.6(2.88×) | +14.3%(T=0)/ +13.6%(T=1),对最强基线 |
| 数学推理(Qwen3-8B,MATH-500,T=0) | 输出 tokens/s 及加速比 | 1625.2(6.13×) | Domino 1412.3(5.33×)、DFlash 1293.8(4.88×) | +15.1%;全文最高 6.6× 加速出现在 Qwen3-4B 的 AIME-25(1811.7,6.59×) |
| 平均接受长度 τ(Qwen3-8B,T=0,无思考) | 每轮平均提交 token 数 | 4.985 | Domino 4.613、DSpark 4.254、DFlash 3.913 | 对 Domino +8.1%,对 DFlash +27.4% |
| 高并发服务(Qwen3-8B,32 路并发,T=0,无思考) | 聚合吞吐 tokens/s | 11512.4 | DFlash 9655.0、DSpark 9490.3、Domino 9013.9(两者均低于不加校正的 DFlash) | +19.2%;峰值在 16 路并发时领先最强基线 +23.0% |
| Llama-3.1-8B 平均吞吐(10 套件,T=0,无思考) | tokens/s 加速比 | 1042.4(3.75×) | Domino 900.8(3.24×)、DFlash 844.2(3.03×) | +15.7%;但 T=1 优势减半为 +8% |
局限与改进
作者承认的局限:收益幅度跟随草稿器的基础接受率——数学/代码任务可达 3.7–6.1×(T=0 无思考),而开放聊天只有 1.8–1.9×,因为聊天文本本身可预测性低、草稿 top-1 命中率差;Llama-3.1-8B 上采样解码的领先幅度减半(T=0 +16% → T=1 +8%)。我自己观察到的局限:逐套件看并非全胜——Llama-3.1-8B 上 MBPP T=0 时 DCOCO 989.7(3.51×)低于 DFlash 1036.3(3.67×)和 Domino 1128.5(4.00×),LiveCodeBench T=1 时 DCOCO 545.3(1.97×)低于 DFlash 643.3(2.32×)和 DSpark,且 Llama T=1 的平均 τ(2.671)甚至略低于 Domino(2.702),说明校正器在特定模型/任务组合上可能零收益甚至负收益;方法深度绑定 DFlash 这一类并行草稿器,且每换一个验证器都要重训草稿器加校正器;批量打分成本随块长 $B$ 线性、随候选数 $K$ 二次增长,扩大块长或候选数时开销会快速上升;一阶网格只建模相邻槽位依赖,块内长程一致性(如相隔数槽的词汇搭配)无从表达;训练每方法只用 seed 42 跑一次,未报告跨训练运行的方差;评测子集较小(多数 128 行、AIME-25 仅 30 行),百分之几量级的 τ 差异在此规模下的统计稳健性存疑。
独立分析的弱点
独立分析三个弱点。(1)一阶马尔可夫假设:$S_p$ 只看相邻槽对,跨槽的搭配冲突(例如槽 1 选 'New' 而槽 3 选 'Diego' 这类相隔两槽才暴露的不一致)无法通过相邻转移打分捕捉,贪心游走也只是局部最优;改进方向是加入轻量跨槽注意力项,或在游走过程中对已选前缀做二次重打分。(2)贪心无前瞻且不可回退:前缀优先虽对齐验证结构,但早期一旦选中次优候选,后续只能将错就错;由于打分已全部并行完成,可几乎零成本地把单路径游走升级为 beam=2–4 的窄束搜索,复杂度仍只有 $O(BK \cdot \mathrm{beam})$。(3)逐验证器重训与全局固定超参:$B=16$、$K=16$、$\rho=4$ 对所有域共用,而覆盖率数据显示聊天任务 τ 仅 2.5–2.9,块的后半段几乎注定被丢弃,验证算力被浪费;改进方向是按草稿置信度在线截断块长或动态调整 K,并把 $K^2$ 的二次成本稀疏化(每个前驱只保留 top-$m$ 后继,降为 $O(BKm)$)。此外,训练标签完全来自教师强制下验证器正确的前缀,虽然作者论证了这正是校正器输出被消费的唯一状态,但真实解码中的分布漂移(校正后的提议导致验证器状态偏离训练分布)未被显式建模。
未来方向
作者提出或暗示的方向:把候选网格打分推广到更丰富的草稿树结构(结合 EAGLE-2 式按置信度分配的动态树);正文顺理成章的延伸包括——将上下文校正思想移植到其他并行草稿器(Medusa/Hydra 的多头、PARD、CTC 草稿),因为重选择范式只依赖'一次前向给出 top-K 候选'这一最小接口;用在线解码的真实接受/拒绝信号做 RL 或 bandit 微调转移分数,替代教师强制的验证器 argmax 标签;在更大规模 MoE(百亿级以上)和多卡张量并行下复验高并发结论;研究跨训练种子的方差与 τ 增益的统计显著性。基于本文成果还可延伸:利用覆盖率随槽位深度的衰减规律(top-1 从首槽 0.81 跌至末槽 0.15)做自适应块长——在线估计剩余槽位的期望边际收益、提前终止草稿块以省下验证算力;以及探索校正器作为可迁移通用模块(输入均为相对表示,可配适配层跨验证器共享),把'每换验证器重训'的成本摊薄。
复现评估
复现条件较好。代码在 GitHub、各验证器配套的草稿器与校正器权重在 Hugging Face 公开(论文首页附链接)。训练数据全部公开:Nemotron Post-Training Dataset v2 的 stem/math/code 子集约 80 万提示加 CodeAlpaca-20k,各验证器以贪心解码(T=0、关思考、上限 4096 token)重生成续写。训练协议完整给出:AdamW 学习率 $6\times10^{-4}$、无权重衰减、cosine 调度加 4% warmup、8 GPU、每微步每卡 4096 token 预算、23 步梯度累积(约 75.4 万 token/优化器步)、12 epoch(6 epoch DFlash + 6 epoch 联合训练),token 嵌入冻结,BF16 推理。校正器极小(Qwen3-8B 上 2,229,505 参数),推理开销只是每周期一次 3584 个转移的批量 MLP 加一次 $O(BK)$ 游走。评测环境逐项列出:vLLM 0.27.0、PyTorch 2.13.0+cu130、单卡 B200、关前缀缓存、开 CUDA Graph,T=1 用种子 42/43/44 三次运行报均值±标准差,并公布固定评测子集与抽样种子 1234(多数基准 128 行)。难点在硬件:完整复现训练需要 8 卡级别的 GPU 和 B200 级评测卡;只复现推理对比则只需下载权重加单卡,难度中等。注意每方法只用 seed 42 训练一次,严格复现表中数字应无障碍,但跨训练运行的方差论文未测量。
论文图表
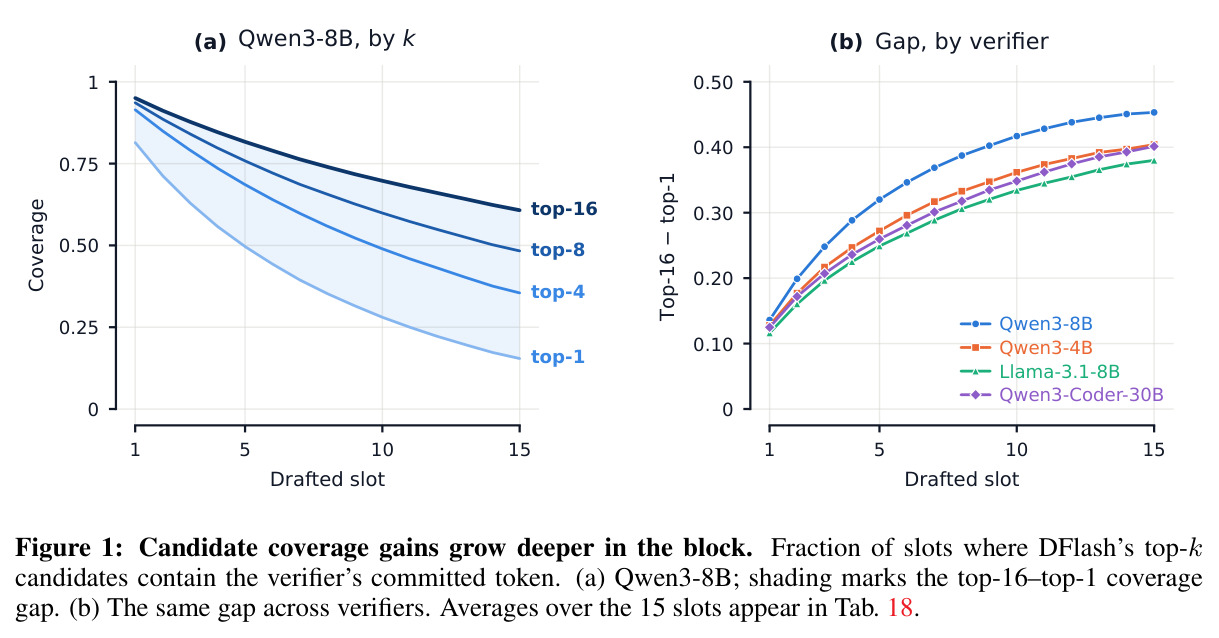
展示 DFlash 的 top-k 候选包含验证器最终提交 token 的槽位比例随草稿槽位深度的变化:(a) Qwen3-8B 上 top-1/top-4/top-8/top-16 四条曲线,阴影标出 top-16 与 top-1 的覆盖差距;(b) 同样的差距在四个验证器上的对比。首槽 top-1≈0.81、top-16≈0.95,末槽 top-1<0.16 而 top-16 仍>0.60,差距从首槽 0.12–0.14 增至末槽 0.38–0.45。
这是全文立论的实证基础:正确 token 几乎总在候选池中、且越深入块内越'藏在池里',直接推出'重选择而非重生成'的技术路线和 K=16 的候选数选取。
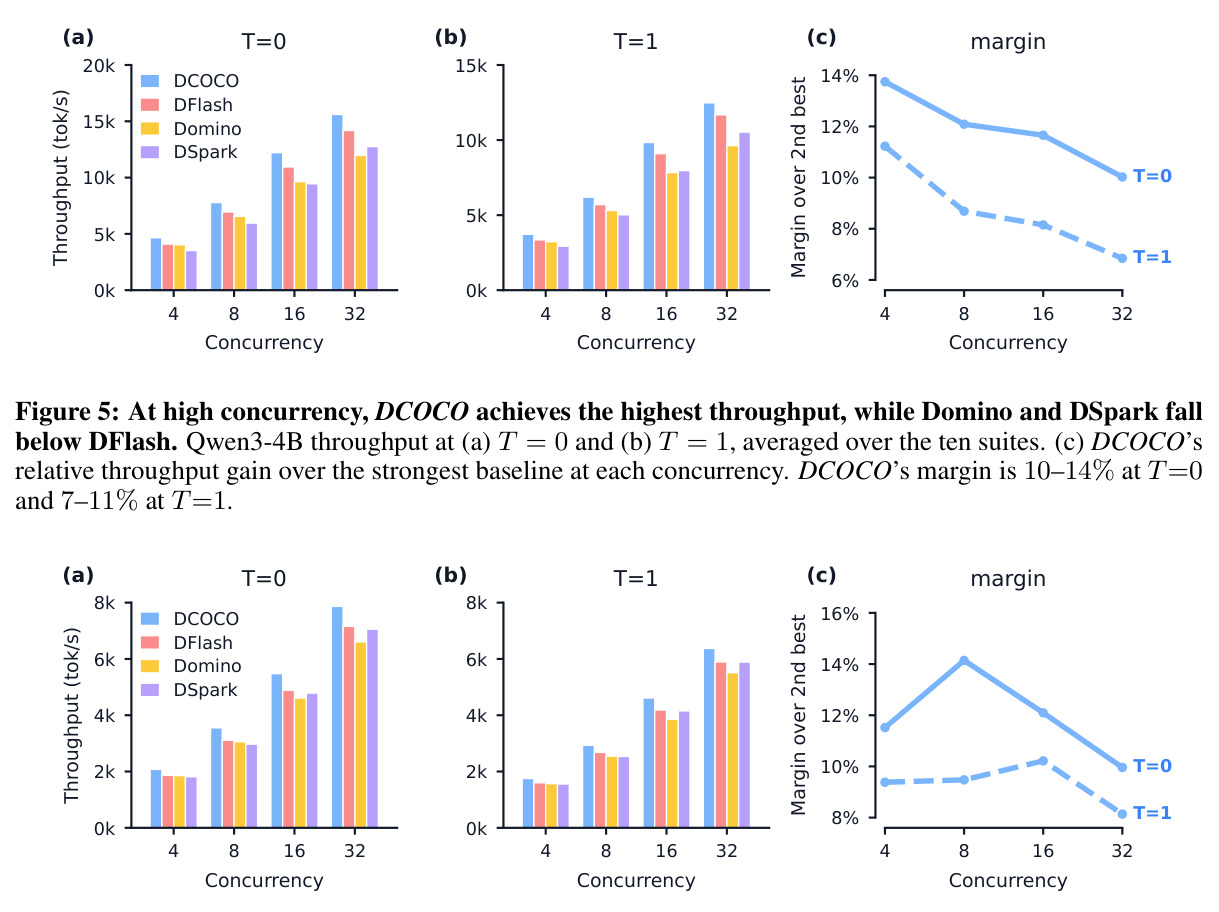
附录 F 中 Qwen3-Coder-30B-A3B 的并发吞吐图:DCOCO 每个并发度都最高,领先幅度 T=0 为 10–14%、T=1 为 8–10%;Domino 和 DSpark 始终处于或低于 DFlash 水平。
在 MoE 骨干上复验结论,覆盖了代码专精模型这一重要部署场景。