DLoop:循环式投机解码 DLoop: Looped Speculative Decoding
草稿模型自信时连续多轮草稿、合并一次验证,无损加速5–41%
前置知识
投机解码(Speculative Decoding)
加速自回归生成的方法:轻量草稿模型一次提出 $k$ 个草稿 token,目标模型用单次前向并行验证;按 speculative sampling 的接受规则逐 token 决定接受与否,首个被拒 token 之后全部丢弃,并由目标模型补一个 bonus token。输出分布与目标模型严格一致,因此是无损加速。
DLoop 的全部改进都建立在草稿-验证交替结构上:理解验证对应一次昂贵的目标模型前向、草稿对应廉价的草稿模型前向,才能明白它省掉的到底是什么、为什么仍然无损。
接受长度 $\tau$(acceptance length)
每次验证平均被接受的 token 数,是投机解码的核心质量指标:$\tau$ 越高,单次目标模型前向产出的 token 越多,加速比越接近 $\tau$。它与草稿模型质量、任务类型强相关,例如本文 Qwen3-4B 上 EAGLE-3 的 $\tau$ 约为 6.92。
论文所有结论都用 $\tau$ 和 wall-clock 加速比两个指标度量;DLoop 的门控本质上就是在预测“当前块会不会被全盘接受”,即对 $\tau$ 的逐块局部预测。
自回归草稿模型 vs 并行草稿模型
EAGLE-3、MTP 等自回归草稿模型逐 token 生成草稿,每次前向产出 1 个 token,可随时停止或继续;DFlash、Domino、DSpark 等并行草稿模型一次前向并行产出整块 $k$ 个 token,提前停止并不降低该阶段成本。两类模型的这一结构差异决定了自适应策略是否有效。
已有自适应草稿长度方法只对自回归草稿模型有效,对并行草稿模型几乎无用——这正是 DLoop 以“完整草稿阶段”为最小循环单元所要解决的核心矛盾。
训练时测试(training-time test)
EAGLE-3 提出的训练技巧:训练时把草稿模型在单个草稿阶段内展开(unroll),让它以自己预测出的特征作为后续步的输入,从而缩小训练与测试时的输入分布差距。
DLoop 的循环感知训练直接源于此:额外草稿阶段必须以草稿模型自己的隐状态 $\tilde{h}$ 为输入,这需要把“自展开”从阶段内推广到跨阶段,否则草稿模型遇到没见过的输入会崩。
树验证(tree verification)
把一次草稿从单条 token 链扩展成一棵候选树:同一位置保留多个候选 token,目标模型一次前向验证整棵树并沿最优路径接受,进一步降低验证次数。代表工作有 EAGLE 树、DDTree、DARTree。
论文实验证明 DLoop 与树验证正交可叠加:树负责把草稿“分叉”,DLoop 负责把草稿“拉长”,理解这一点才能读懂 Table 5 的组合收益。
研究动机
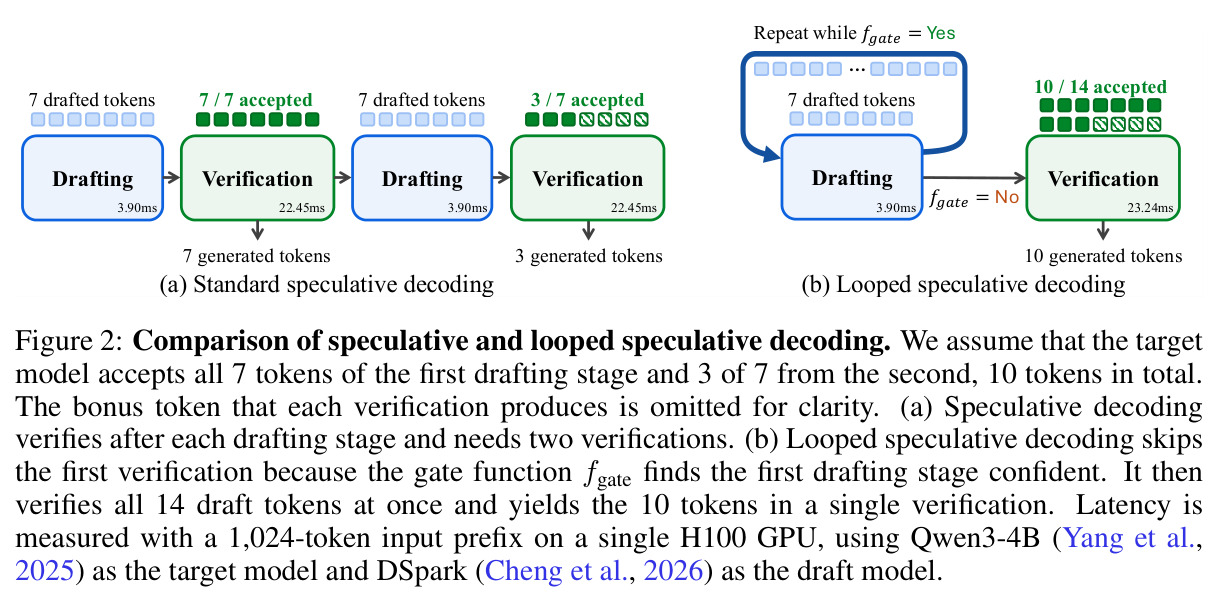
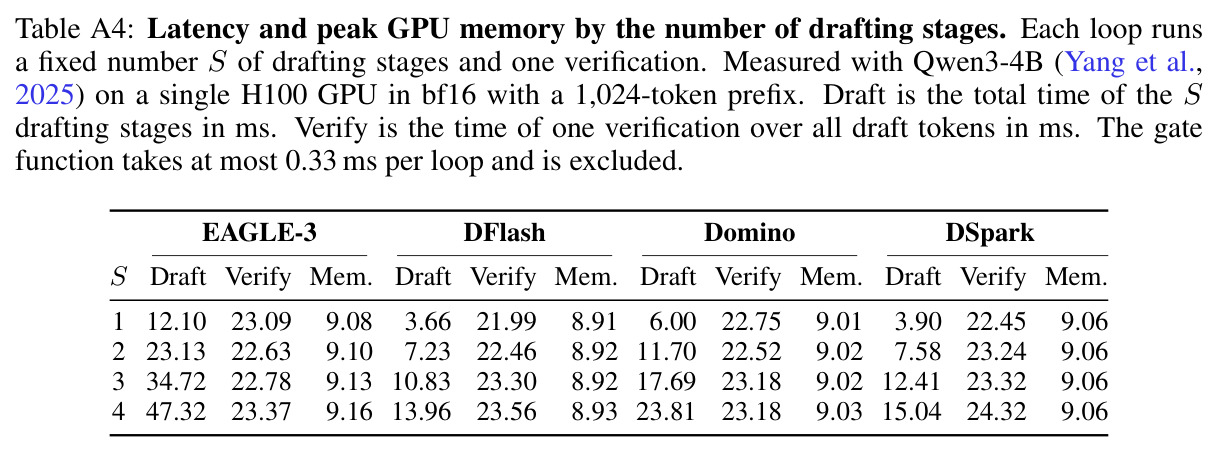
标准投机解码把“一次草稿阶段 + 一次验证”固定交替:即使草稿模型很有把握、整块 $k$ 个草稿 token 全部通过验证,下一轮草稿也必须先等一次完整验证,因此单次验证最多产出 $k+1$ 个 token,草稿再准也无法突破这一上限。而验证需要目标模型的完整前向传播,是解码时延的主导项:论文在单张 H100 上测得 Qwen3-4B+DSpark 一次验证约 22.45ms,一次草稿仅 3.90ms,相差近 6 倍。Fig. 1 统计显示,EAGLE-3、DFlash、Domino、DSpark 四个草稿模型在数学(GSM8K/MATH-500/AIME25)、代码(HumanEval/MBPP/LCB)、聊天(MT-Bench/Alpaca)三类任务上都存在大量被完全接受的草稿块(DSpark 全接受率最高)。已有的自适应草稿长度方法(BiLD、SVIP、SpecDec++ 等)虽然也在解码中决定草稿长度,却只对自回归草稿模型有效:并行草稿模型一次前向就产出整块 $k$ 个 token,提前停止并不降低该阶段成本;想继续多写,又缺少未验证位置的目标模型隐状态,草稿模型没见过这种输入。
本文的目标是本文目标很明确:允许一次验证覆盖 $S\ge 1$ 个草稿阶段——在草稿模型仍然自信时连续执行多个草稿阶段,把累积的全部 $Sk$ 个草稿 token 合并进同一次目标模型前向验证,用廉价的草稿模型前向替换昂贵的目标模型前向。约束条件是:解码保持无损(接受规则不变,输出分布与目标模型完全一致);不改变草稿模型的架构与参数量,直接作用于公开发布的权重;对自回归草稿模型(EAGLE-3、MTP)与并行草稿模型(DFlash、Domino、DSpark)统一适用;循环深度 $S$ 不预先固定,而在解码时由门控逐块决定。量化目标是在与九个自适应草稿长度方法的正面对比中,同时取得最高的平均接受长度 $\tau$ 与最高的实际 wall-clock 加速比。
与已有工作不同的是,独特切入是把“自适应”的粒度从 token 级提升到草稿阶段(块)级。以往工作决定的是“一次验证对应的草稿在哪里结束”:BiLD/SVIP/AdaEDL/LLMCad 依据 top-1 概率或熵逐 token 停止,SpecDec++/DISCO 训练逐 token 停止头,AdaEAGLE 事前预测长度,DSpark 的置信度调度器决定块内验证多少 token。DLoop 则保持完整草稿阶段为最小单元,只回答“要不要再来一个阶段”,因此天然兼容一次前向出一整块的并行草稿模型。第二个差异是门控本身:直接复用草稿阶段已经算出的 log 概率求和,不引入任何额外模块或前向。第三是训练侧:把 EAGLE-3 的 training-time test 从单个草稿阶段内的展开,扩展为跨草稿阶段的展开,让草稿模型习惯以自己的隐状态 $\tilde{h}$ 续写未验证位置——这是并行草稿模型也能被拉长的关键。相比 SpecBlock 需要训练新草稿模型加排名头,DLoop 完全即插即用,还能与树验证叠加。
核心方法
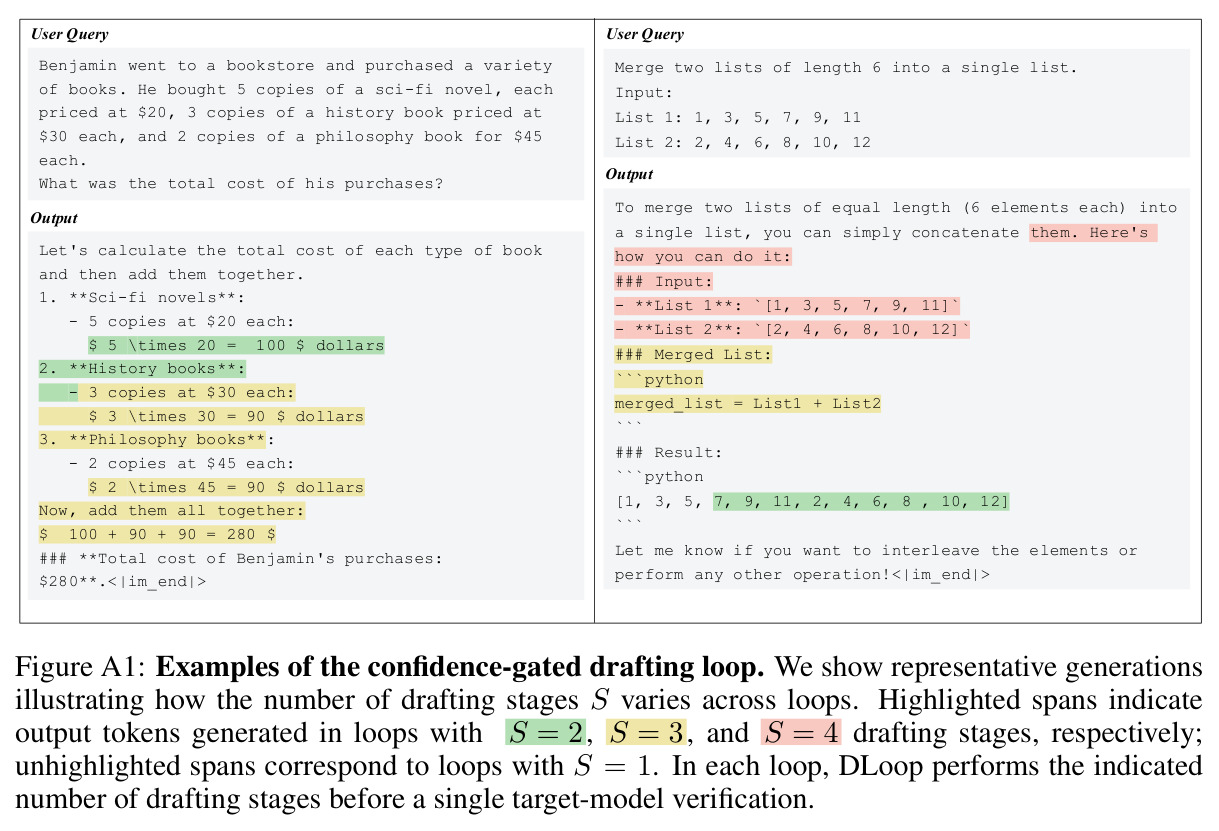
直觉是:既然相当比例的草稿块本来就会被全盘接受,紧随其后的验证就是白白浪费的目标模型前向;草稿模型自信时应继续草稿,直到不确定再统一验证。技术路线由两半组成。推理端是置信度门控草稿循环:第 $s$ 个草稿阶段产出块 $\hat{x}_{t+(s-1)k+1:t+sk}$ 后,计算该块各 token 的 log 概率之和 $c_s$,若 $c_s\ge g$ 则追加一个草稿阶段,否则目标模型对累积的 $Sk$ 个草稿 token 做一次验证;额外阶段的上下文缺口用草稿模型自己的最终层隐状态 $\tilde{h}$ 拼接填补(式 3)。训练端是循环感知训练:对每个训练位置采样 $S-1\sim U\{1,\dots,N\}$ 并跑 $S$ 个草稿阶段,损失只放在第一阶段(保留原目标)与最后阶段(链最长、最难的部分)上,$\mathcal{L}=\tfrac{1}{2}(\mathcal{L}^{(1)}+\mathcal{L}^{(S)})$,取 $N=3$。整个方法不改架构、不加模块,只改变“验证之前有几个草稿阶段”。
核心创新有三点。其一,以完整草稿阶段为单位的门控:分数 $c_s=\sum_{i=t+(s-1)k+1}^{t+sk}\ell_i$ 是整块联合概率的对数,由于每项 $\ell_i\le 0$,任何一个不确定位置都会拉低总分,这与“首个被拒 token 之后全部丢弃”的接受规则严格对齐;而 $\ell_i$ 在草稿时已经算好,门控只多一次求和加一次比较,附录实测每循环至多 0.33ms。其二,额外草稿阶段的输入方案:未验证 token 没有目标模型隐状态,DLoop 用草稿模型产块时顺带得到的最终层隐状态 $\tilde{h}$ 接在目标侧上下文 $h_{1:t-1}$ 之后(式 3),上一块末尾的草稿 token 充当新锚点,每个阶段只处理 $k$ 个新位置。其三,与已有方法的本质区别:BiLD/SVIP/SpecDec++ 等改变“草稿在块内何处结束”,PACER 依赖额外训练的 pre-verification 层,SpecBlock 要训练新草稿模型,而 DLoop 不改变草稿模型如何生成 token,只改变验证前块的数量,并用循环感知训练让新输入模式变得可靠。代价与收益清晰:放弃最多 $S-1$ 个 bonus token,换回 $S-1$ 次目标模型前向。
方法步骤详情
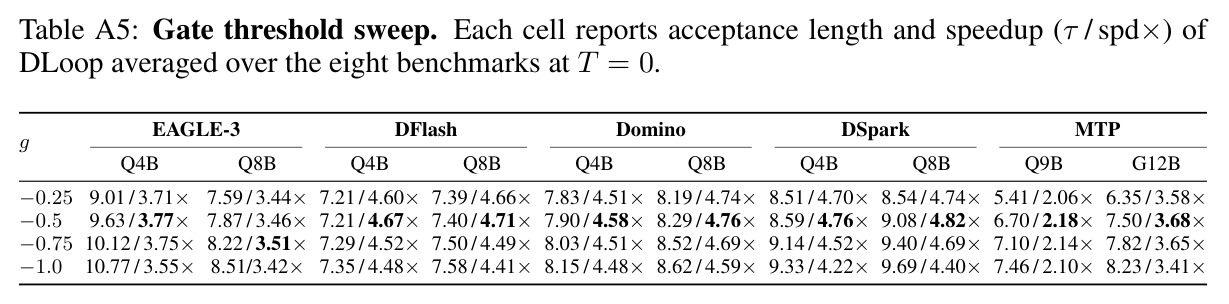
记号:目标模型 $M_t$、草稿模型 $M_d$、块大小 $k$、阈值 $g$、深度暴露 $N$。(1) 第一草稿阶段:输入目标侧上下文 $h_{1:t-1}$ 与锚 token $x_t$(即上次验证的 bonus token),产出 $\hat{x}_{t+1:t+k}=M_d(h_{1:t-1},x_t)$,同时记录每个草稿 token 的 log 概率 $\ell_i$ 与 $M_d$ 的最终层隐状态 $\tilde{h}$。(2) 门控判定:$c_s=\sum\ell_i$,若 $c_s\ge g$($f_{gate}=1$)则继续,否则转 (4);实验中 $g$ 在 $\{-0.25,-0.5,-0.75,-1.0\}$ 中扫描,多数设置取 $-0.5$。(3) 额外草稿阶段($s\ge2$):$\hat{x}_{t+(s-1)k+1:t+sk}=M_d(h_{1:t-1}\Vert\tilde{h}_{t:t+(s-1)k-1},\ \hat{x}_{t+(s-1)k})$,只处理 $k$ 个新位置,回到 (2)。(4) 验证:目标模型单次前向处理 $Sk$ 个累积草稿 token,按 speculative sampling 接受前 $a$ 个并补一个 bonus token,首个被拒 token 之后的全部块丢弃;输出分布不变,无损。(5) 循环感知训练:从发布权重起训 1 个 epoch,数据为 PerfectBlend 130 万 prompt 配目标模型自生成回复;每个位置采样 $S$,用 ground-truth token 构造 $\tilde{h}$ 链,中间阶段不算 logits 只传递隐状态,损失 $\mathcal{L}=\tfrac{1}{2}(\mathcal{L}^{(1)}+\mathcal{L}^{(S)})$,$N=3$。
技术新颖性
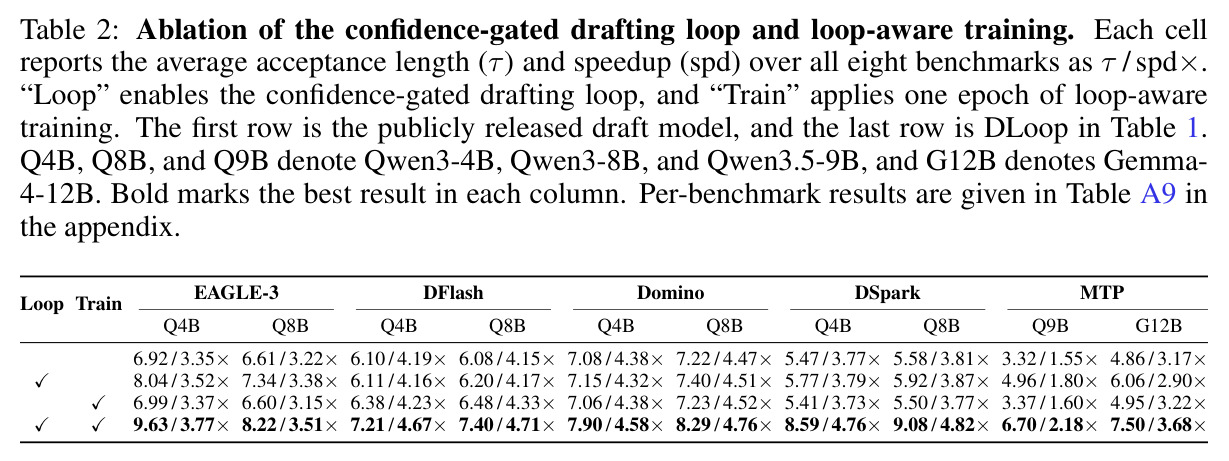
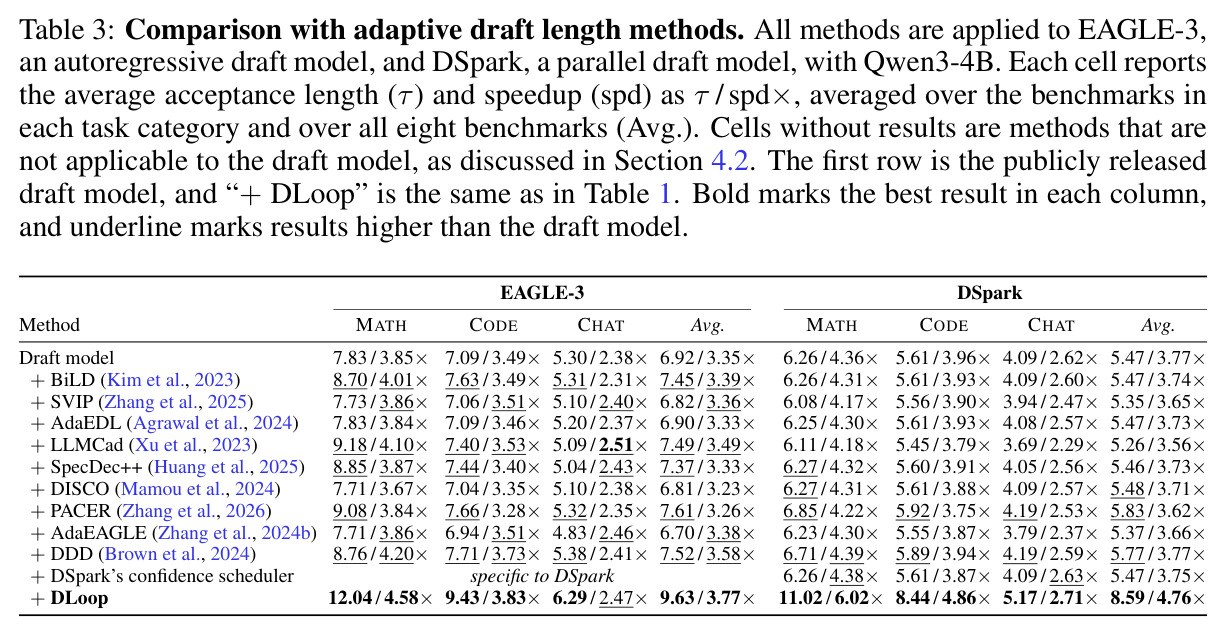
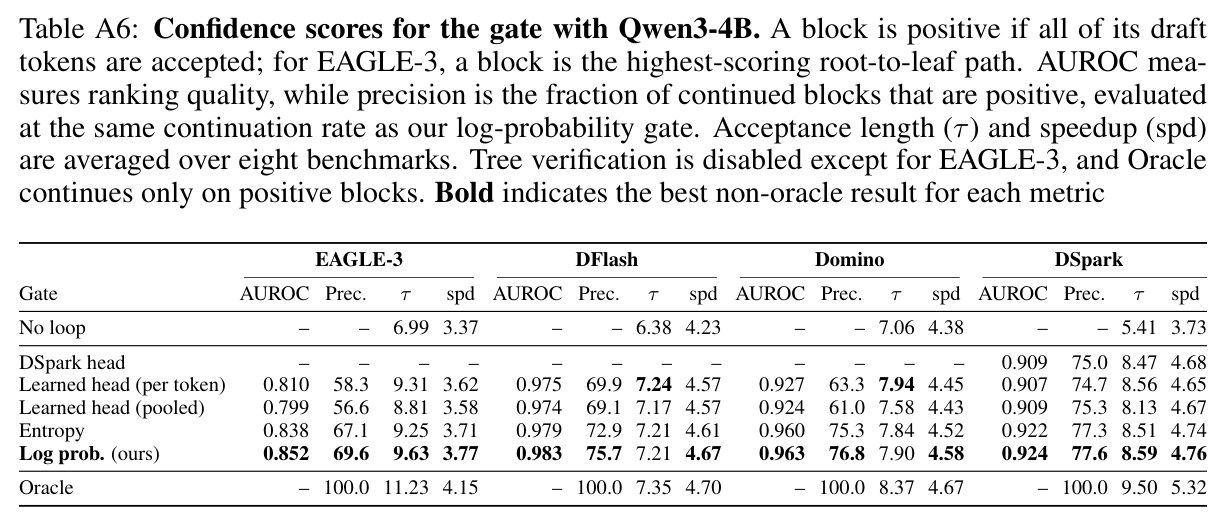
新颖性可从四个坐标看清。对自适应草稿长度方法:它们在块内逐 token 决定停止,前提是草稿器可自由伸缩(独立小模型),移植到按固定长度训练的 EAGLE-3 最多带来 +0.14× 加速、移植到并行草稿 DSpark 无一超过原基线(Table 3);DLoop 以整块为最小单元绕开了这一结构性限制。对 PACER:同样是按块续写,但 PACER 需要单独训练的 pre-verification 层预测接受率,DLoop 的门控免参数,且 Table A6 显示 log 概率分数的 AUROC(0.852–0.983)与精确率(69.6–77.6%)反而优于学习到的头(如 DFlash 0.975/69.9%)。对 EAGLE-3 的 training-time test:那是单阶段内的自展开,DLoop 推广为跨阶段的链式展开,并首次让并行草稿模型在未验证位置上可靠续写。对树验证:DLoop 把草稿拉长、树验证把草稿分叉,二者正交可叠加(DDTree/DARTree)。消融(Table 2)还揭示一个反直觉结论:循环感知训练单独使用几乎无效(变化 <7%),它的价值在于为循环准备草稿模型,两者组合的增益超过各自单独增益之和。
实验结果
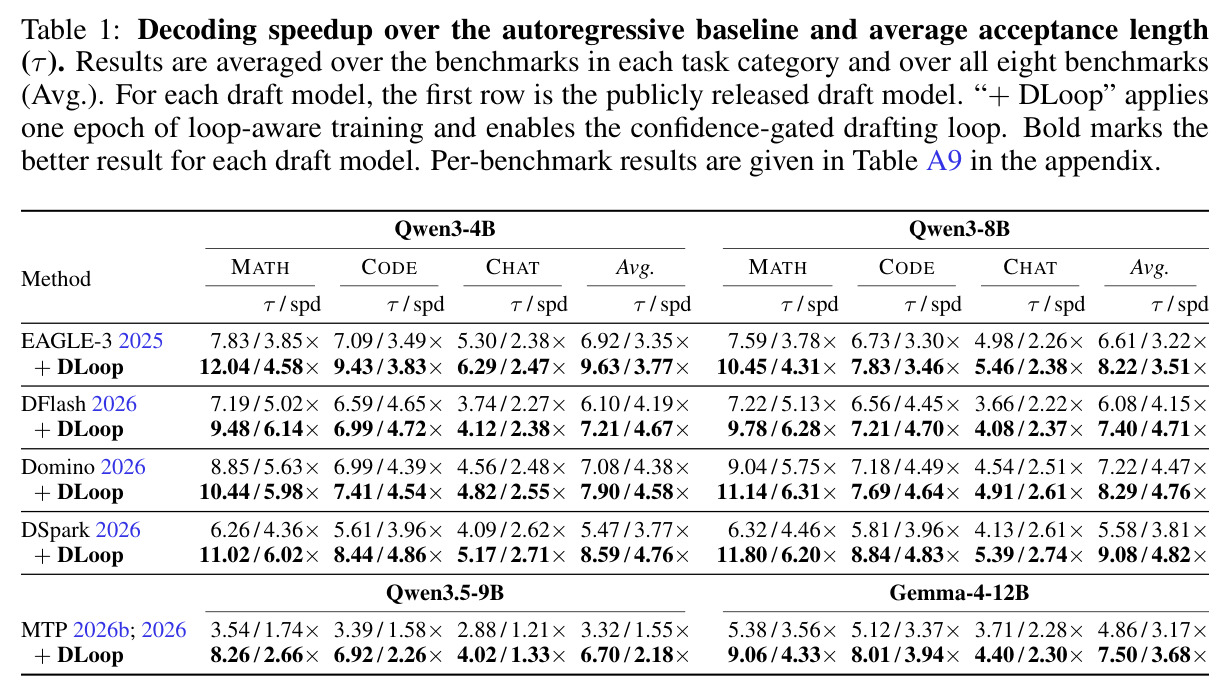
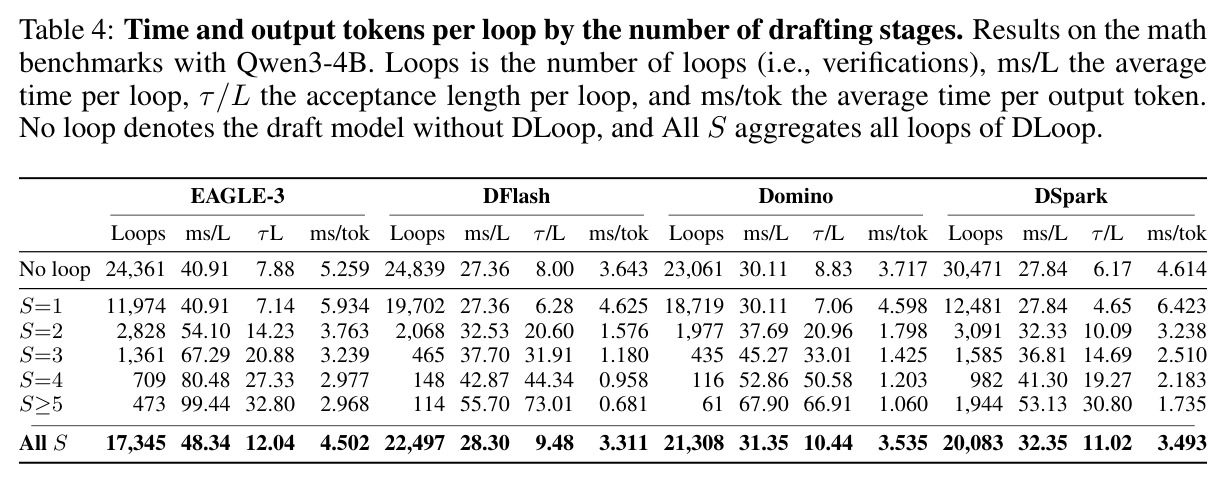
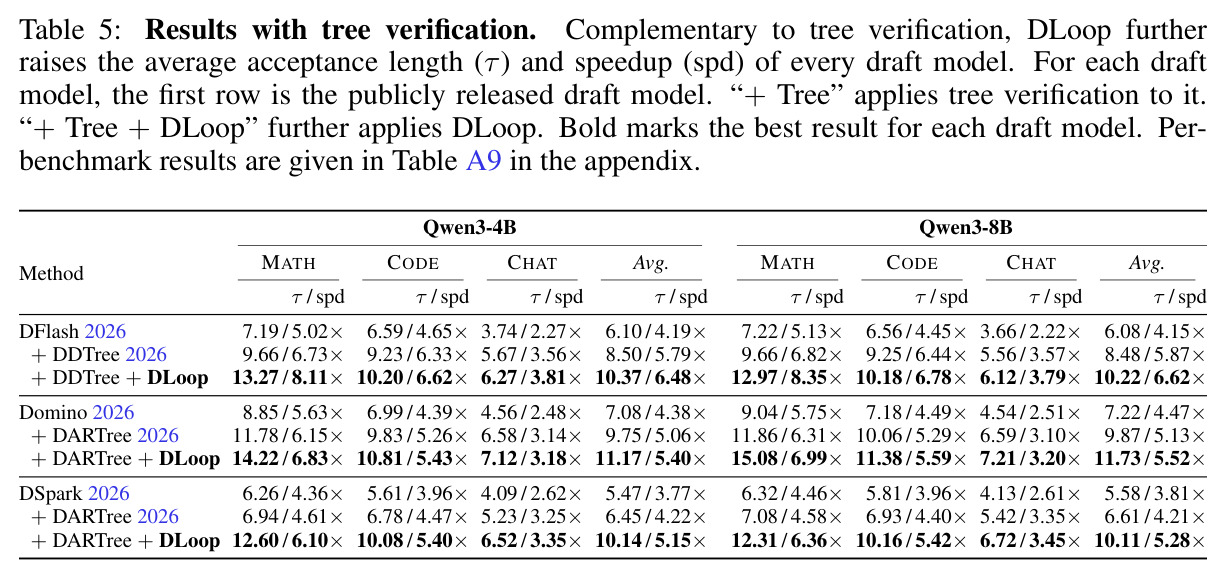
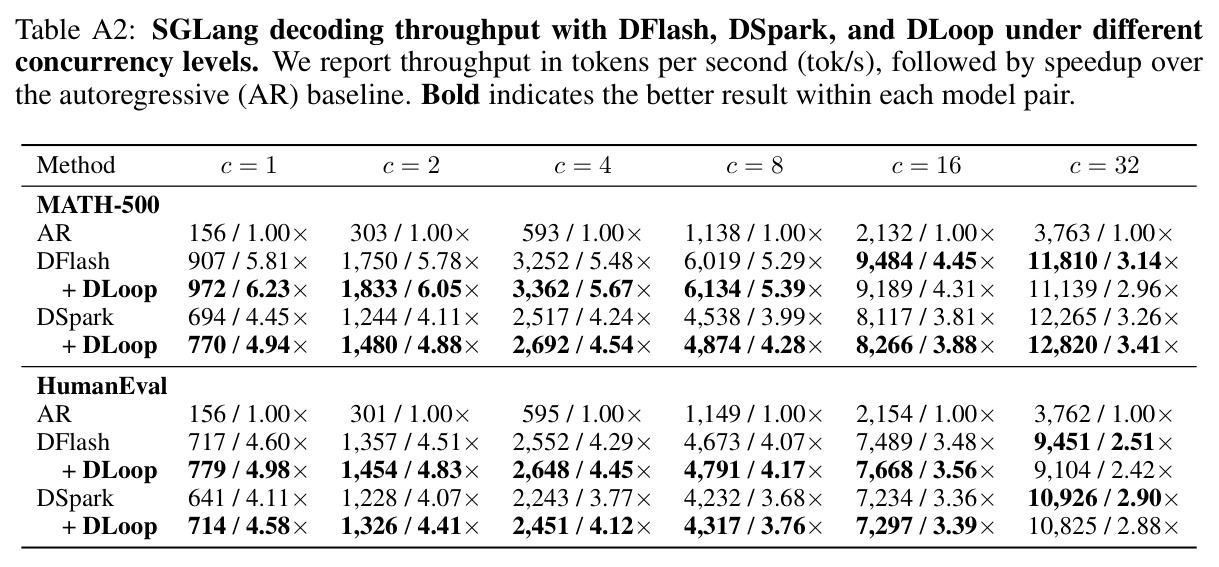
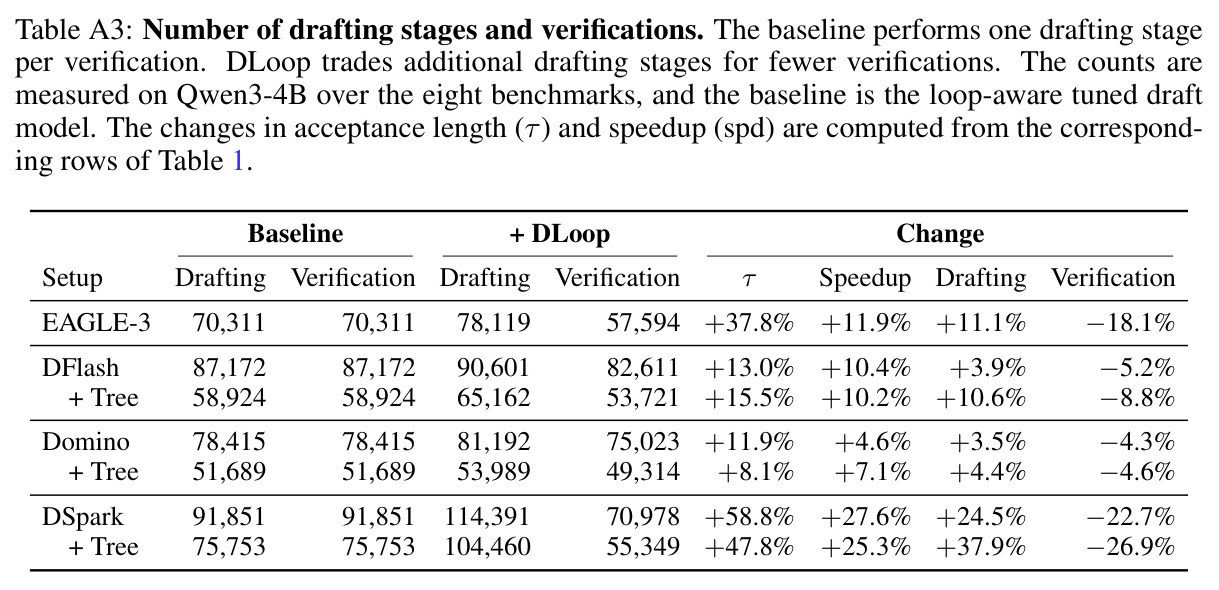
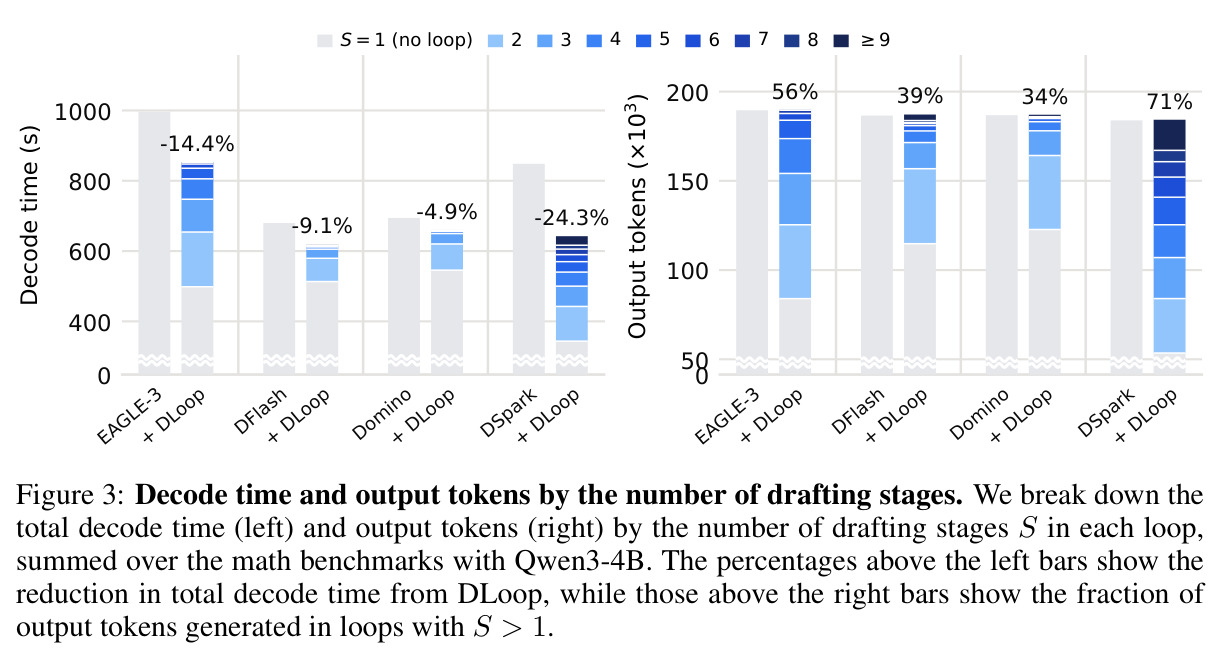
(1)主结果(Table 1):五个草稿家族 × 四个目标模型上,接受长度 $\tau$ 提升 12–102%,wall-clock 加速提升 5–41%。EAGLE-3+Qwen3-4B 平均 $\tau$ 6.92→9.63、加速 3.35×→3.77×;DSpark+Qwen3-4B 5.47/3.77×→8.59/4.76×;MTP+Qwen3.5-9B 1.55×→2.18×(+41%,相对增益最大);Gemma-4-12B MTP 3.17×→3.68×。DSpark 增益最大,与其全接受率最高一致。(2)组件消融(Table 2):只开循环,$\tau$ 全线上升但对并行草稿模型加速几乎持平或略降;只做训练,两指标变化 <7%;组合后所有设置同时提升且超过分项之和。(3)对比九个自适应长度方法(Table 3):DSpark 上无一超过原基线,EAGLE-3 上最多 +0.14×;DLoop 在两个草稿模型上 $\tau$ 与加速均最高(EAGLE-3 Q4B 9.63/3.77×,最好的对比方法 DDD 仅 7.52/3.58×)。(4)加速来源(Fig.3、Table 4、A3):总解码时间下降 4.9–24.3%,34–71% 的输出 token 产自 $S>1$ 的循环,验证次数减少 4.3–22.7%(叠加树时最多 −26.9%);单 token 时间随 $S$ 单调下降,从 $S=1$ 的 4.60–6.42ms 到 $S\ge5$ 的 0.68–2.97ms。(5)树验证叠加(Table 5):DDTree+DLoop 把 DFlash Q4B 从 5.79× 提到 6.48×(Q8B 到 6.62×);DARTree+DLoop 给 Domino +7–8%、DSpark +22–25%。(6)$T=1$ 采样下增益保持(DSpark Q4B 3.55×→4.13×);SGLang 并发下 $c=1$ 时 DFlash 5.81×→6.23×,但 $c=32$ 时优势基本消失。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 通用加速(EAGLE-3,Qwen3-4B,8 基准平均) | 接受长度 τ / 加速比 | DLoop:9.63 / 3.77× | EAGLE-3 原版:6.92 / 3.35× | τ +39%,加速 +12.5% |
| 通用加速(DSpark,Qwen3-4B,8 基准平均) | 接受长度 τ / 加速比 | DLoop:8.59 / 4.76× | DSpark 原版:5.47 / 3.77× | τ +57%,加速 +26% |
| 通用加速(MTP,Qwen3.5-9B,8 基准平均) | 接受长度 τ / 加速比 | DLoop:6.70 / 2.18× | MTP 原版:3.32 / 1.55× | τ +102%,加速 +41%(全文最大相对增益) |
| 对比自适应草稿长度方法(EAGLE-3,Qwen3-4B) | 8 基准平均加速比 | DLoop 3.77× | 对比方法中最好的 DDD 3.58× | +0.19×(其余方法最多 +0.14×) |
| 树验证叠加(DDTree,DFlash,Qwen3-4B) | 8 基准平均加速比 | DDTree+DLoop 6.48× | DDTree 5.79× | +12% |
| 树验证叠加(DARTree,DSpark,Qwen3-8B) | 8 基准平均加速比 | DARTree+DLoop 5.28× | DARTree 4.21× | +25% |
| SGLang 并发服务(MATH-500,Qwen3-8B,c=1) | 吞吐加速比(vs 自回归) | DFlash+DLoop 6.23×(972 tok/s) | DFlash 5.81×(907 tok/s) | +7%(c=32 时优势消失) |
局限与改进
作者承认的局限:聊天任务增益最小(全接受率低,$\tau$ 基数小);并发服务下优势衰减——SGLang 中 $c=32$ 时 DFlash+DLoop 吞吐(11,139 tok/s)略低于原版 DFlash(11,810),只有 DSpark 在 MATH-500 上仍保持优势;逐样本不同的循环深度造成参差不齐的草稿侧执行,batch 服务需要 padding(浪费算力)或动态重组(调度开销)。我的补充观察:门控阈值 $g$ 是全局静态超参,需按“草稿模型 × 目标模型”组合扫描选取;循环最多放弃 $S-1$ 个 bonus token,当草稿质量差、全接受率低时收益缩水甚至可能为负(聊天任务已现端倪);实验集中在大约 1024-token 前缀的短上下文,长上下文下草稿/验证耗时比与最优阈值可能漂移;每个草稿模型需重训 1 个 epoch 并扫阈值,并非零成本;门控与 oracle 仍有差距(EAGLE-3 Q4B oracle 可达 $\tau$ 11.23/4.15×,DLoop 为 9.63/3.77×),说明“预测哪块会被全接受”本身还有提升空间。
独立分析的弱点
独立分析的弱点:(1)静态全局阈值 $g$ 不随生成阶段、任务难度或负载变化,分布漂移时(长上下文、新领域)可能失准——改进方向是借鉴 AdaEDL 式的在线校准,用每次验证的实际接受数反馈微调阈值;(2)门控只汇总最新块的 log 概率,忽略跨块相关性与位置信息,且 log 概率高的块仍可能整体被拒——可引入块间一致性特征,Table A6 显示 pooled 学习头与免参数分数差距很小,代价可控;(3)额外草稿阶段以自身 $\tilde{h}$ 续写,误差理论上沿链累积,论文未分析超长链($S>10$)的稳定性,也未给出置信分数的校准曲线;(4)ragged 执行对批服务不友好,高并发下增益消失——需要按预测深度分桶、padding-free kernel 或与调度器协同设计;(5)训练与调参按“草稿模型 × 目标模型”逐一进行,新模型上线需重复整套流程,可探索跨模型通用的门控元策略或自动阈值选择。
未来方向
作者提出的方向:与树验证更深度融合,在树上自适应决定扩展深度与分支,而不只是延长最高分路径;服务与 kernel 层面对自适应循环深度的原生支持(动态重组、padding-free 批处理);SGLang 等框架中并发场景的循环深度调度。基于本文成果可延伸:把二值门控升级为对最优 $S$ 的分布预测,用验证反馈做在线 bandit 式调整;将循环感知训练与 VAT 的验证感知监督结合,进一步压低被拒率;把跨阶段自展开用于从头蒸馏更强的并行草稿模型;研究 bonus token 损失与验证节省之间的理论权衡,导出最优停止阈值;在长上下文、量化模型与大批量服务 jointly 优化的设定下重测阈值迁移性;扩展到半自回归/扩散式草稿器上的循环。
复现评估
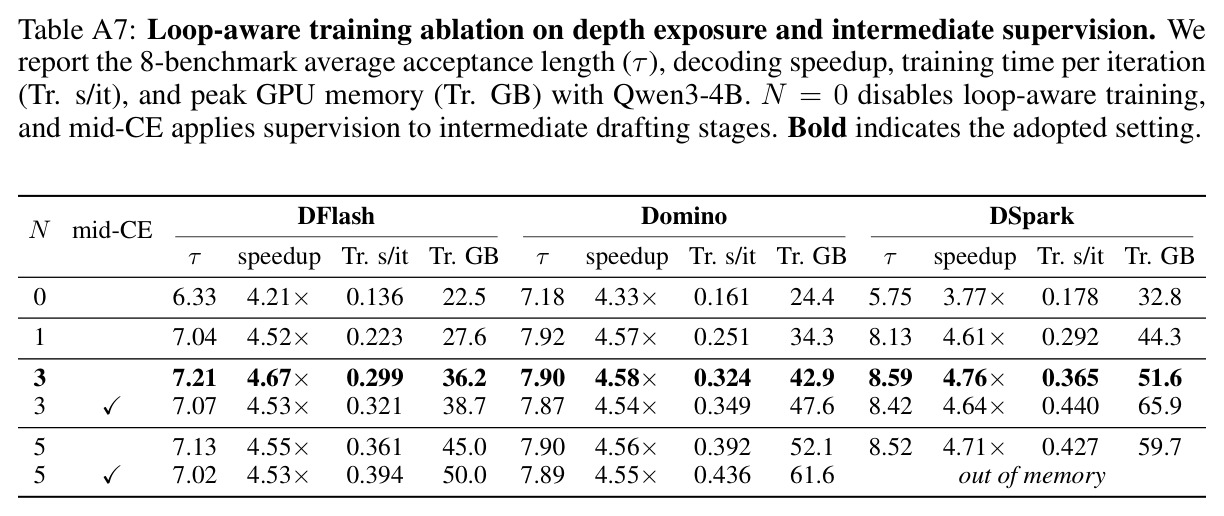
复现条件较好。代码承诺开源(github.com/naver-ai/DLoop);五个草稿模型(EAGLE-3、DFlash、Domino、DSpark、Qwen3.5/Gemma 的 MTP)权重均公开,训练数据为公开的 PerfectBlend 130 万 prompt 配目标模型自生成回复。循环感知训练从发布权重出发只需 1 个 epoch,单张 H100 80GB(bf16)即可容纳:附录 A7 显示 $N=3$ 时每迭代 0.30–0.37s、峰值显存 36.2–51.6GB;MTP 沿用 EAGLE-3 训练配方;仅 EAGLE-3 在 Qwen3.5-9B/Gemma-4-12B 上无官方权重,作者自训 3 个 epoch 作基线。超参极少:$g$ 在 4 个值中扫描(多数取 $-0.5$)、$N=3$。评测协议完全沿用 DFlash 官方代码(8 基准、样本数与 prompt 模板固定),并补充了 $T=1$ 采样与 SGLang 并发数据。总体难度中低:训练单卡可行,评测需 H100 级 GPU 与若干 4B–12B 模型;若只想快速验证核心结论,建议从 DSpark+Qwen3-4B 入手复现 Table 1(全接受率最高、增益最直观)。
论文图表
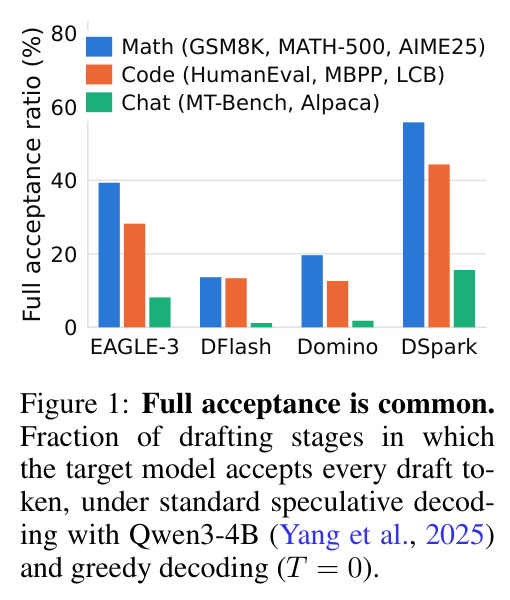
在 Qwen3-4B 目标模型、贪心解码(T=0)的标准投机解码下,统计 EAGLE-3、DFlash、Domino、DSpark 四个草稿模型在数学(GSM8K/MATH-500/AIME25)、代码(HumanEval/MBPP/LCB)、聊天(MT-Bench/Alpaca)三类任务上“草稿块被目标模型全部接受”的比例(纵轴为全接受率,刻度 0–80%)。所有模型、所有任务都存在可观的全接受比例,其中 DSpark 最高。
这是全文立论的实证基础:大量草稿块本来就全对,紧随其后的验证是纯浪费的目标模型前向,直接 motivates“多轮草稿合并一次验证”的循环设计,也解释了为何 DSpark 从 DLoop 获益最大。