后训练之前的智能体能力评估:一种端到端方法 Evaluating Agentic Capabilities Before Post-Training: An End-to-End Approach
ASAP让预训练基座模型不改权重直接跑端到端智能体任务,并给出行为级诊断
前置知识
基座模型 vs 指令模型
基座模型指仅完成预训练(下一词预测)的模型,如 Qwen3.5-35B-A3B-Base;指令模型在其上经 SFT/RLHF 等后训练,学会遵循系统提示、对话模板和工具调用格式。基座模型擅长文本续写,但未经训练去执行“回合制”的智能体交互协议。
本文全部设计都围绕这一差异展开:不把基座改造成 chat 模型,而是把它当作续写模型直接跑智能体任务。
Agent Scaffold(智能体脚手架)
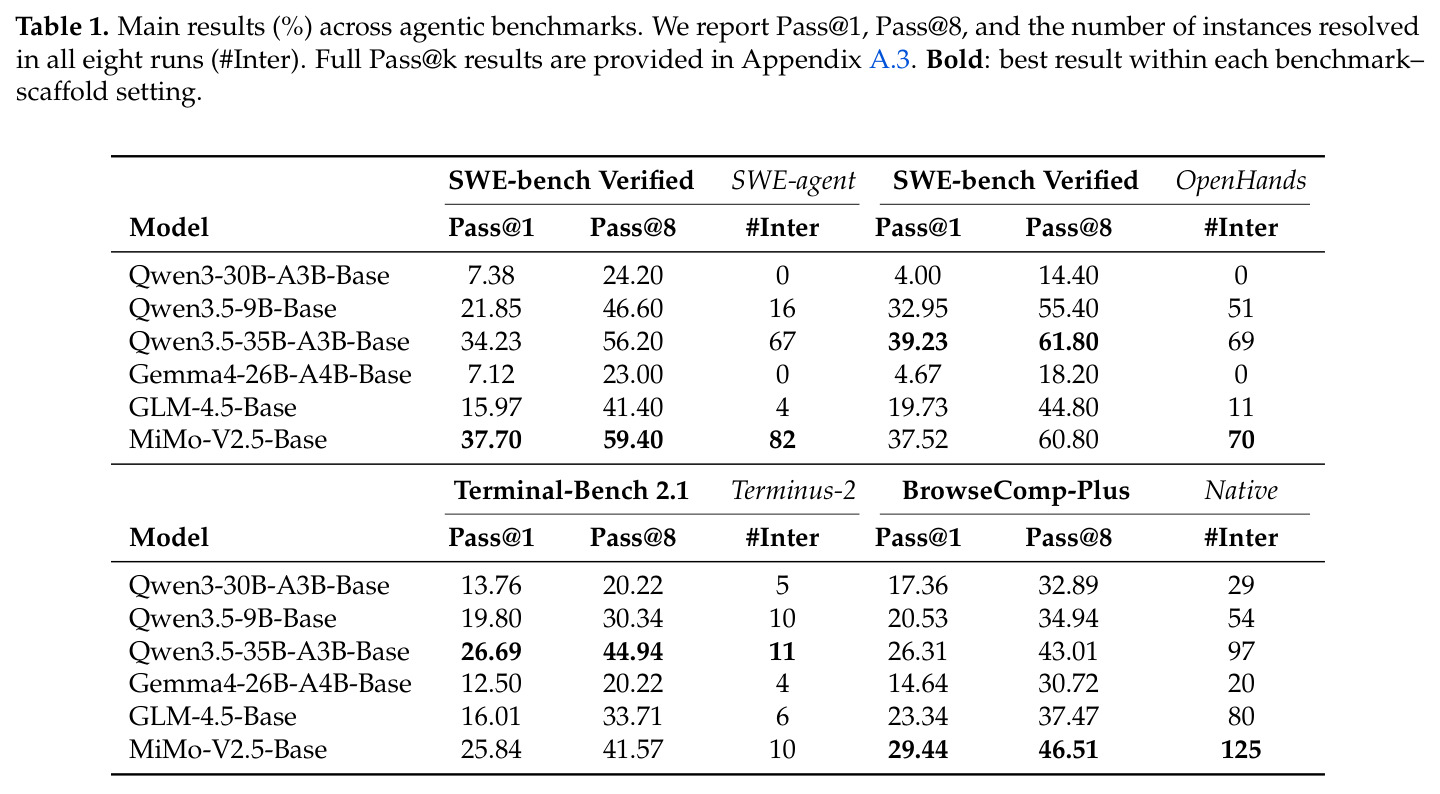
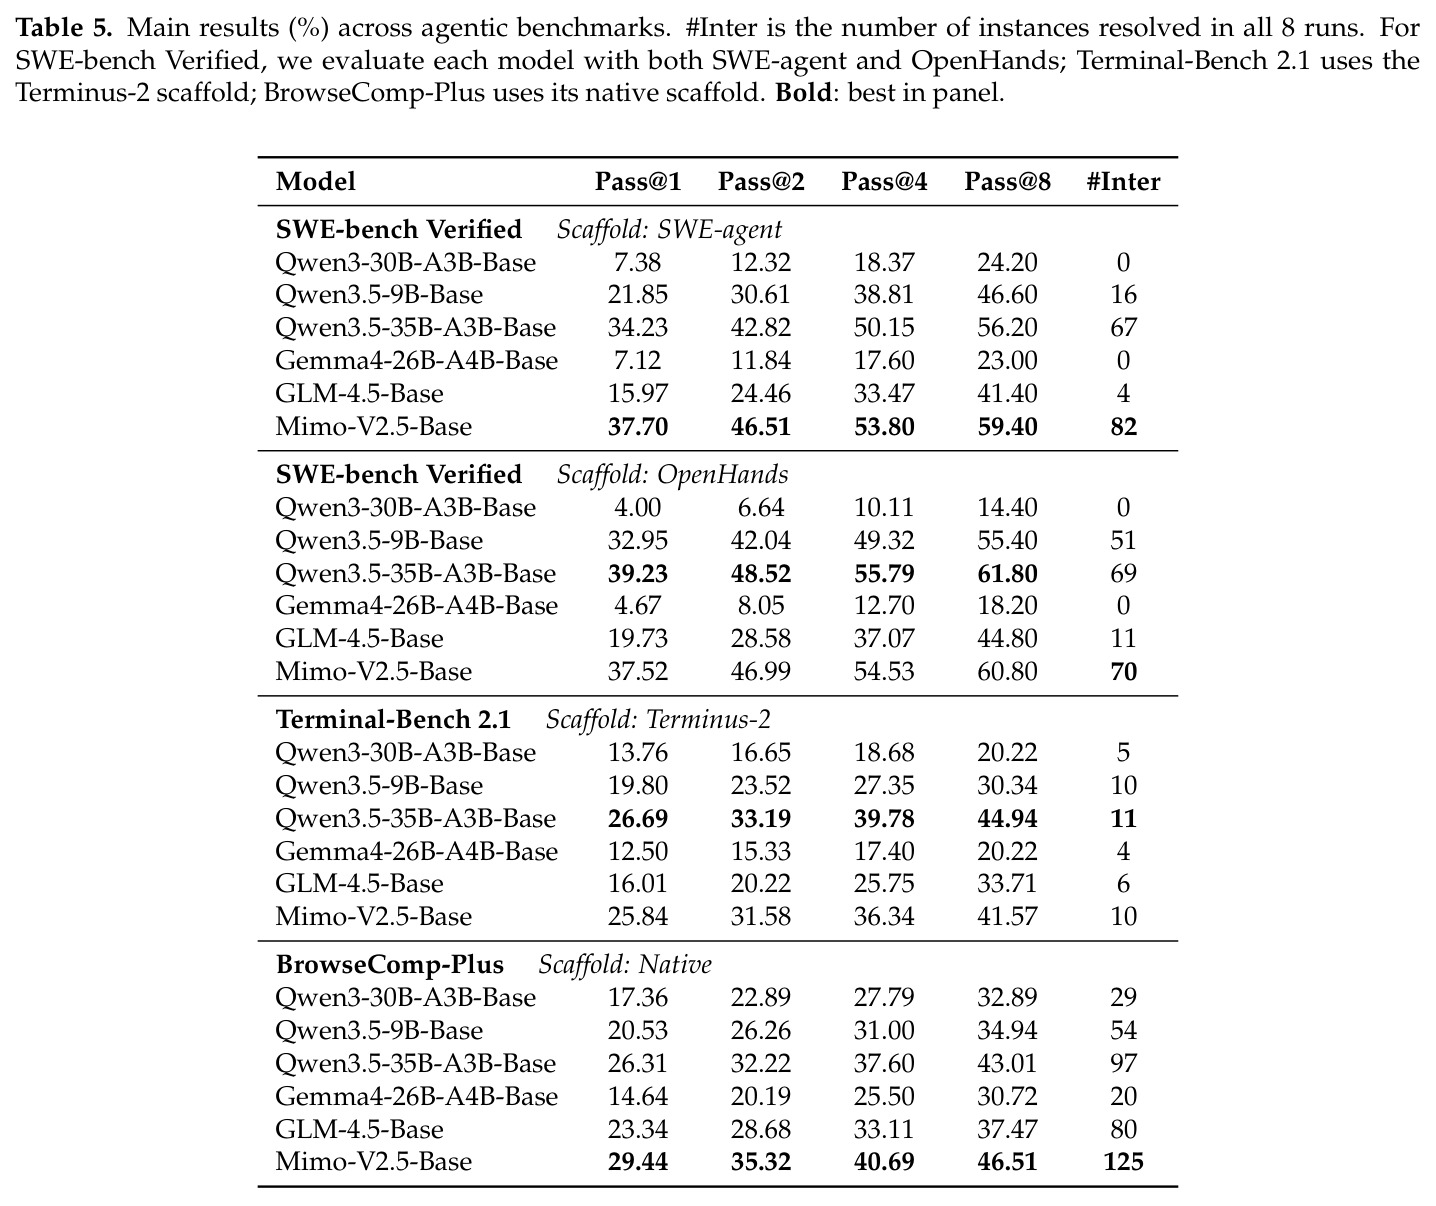
脚手架是包裹模型的执行循环代码,负责任务描述注入、动作解析、环境执行、观察回填与终止判定,如 SWE-agent、OpenHands、Terminus。同一模型在不同脚手架下表现差异很大:论文中 Qwen3.5-9B 在 SWE-agent 下 21.85%、OpenHands 下 32.95%。
ASAP 的做法是对现有脚手架打轻量补丁而非自建评测器,理解脚手架才能明白它到底改了什么、保留了什么。
补全式接口与对话模板
chat 模型用 messages 列表加 chat template 交互,被训练成响应角色消息;补全式接口只给一段前缀文本,模型负责续写。基座模型只有补全接口,直接套 chat 模板会导致格式混乱、输出不可解析。
ASAP 的关键决定是保留补全接口,让基座模型在原生接口上“续写”智能体轨迹,这是与传统 agent 评测的根本区别。
Pass@k 与 Intersection@n
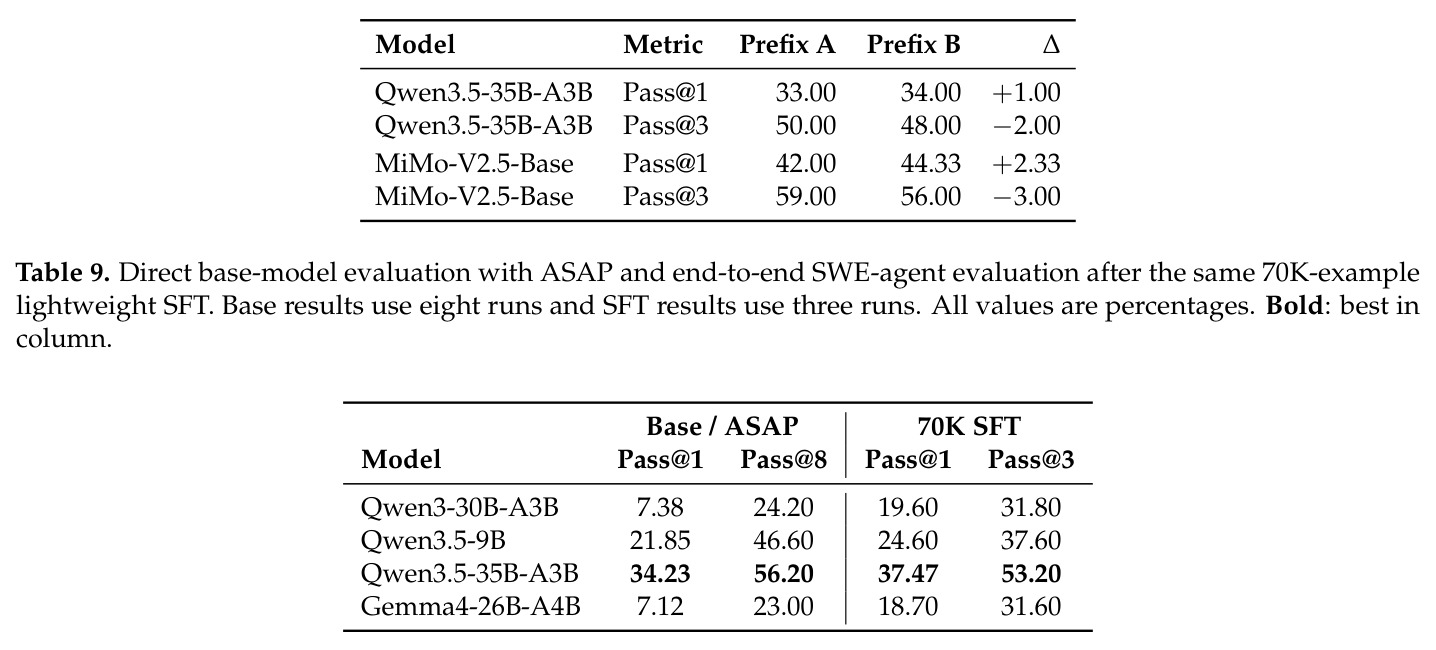
Pass@k 用无偏估计衡量 k 次采样中至少一次成功的概率 $\hat{P}_k = 1 - \binom{n-c}{k}/\binom{n}{k}$,n 为总采样数、c 为成功数;Intersection@n 统计 n 次运行全部解决的实例数,衡量稳定核心能力。论文中 Qwen3-30B-A3B-Base Pass@8 达 24.20% 但 Intersection@8 为 0。
两者结合才能区分“偶尔能解出”与“稳定可复现”两种能力,是读懂主结果表的前提。
静态代理评估(proxy evaluation)
指不实际运行智能体、用静态题目或似然近似智能体能力的方法:APTBench 把成功轨迹转成选择题与文本补全,PACE 用静态条目跨模型校准预测性能,Composer 2 用代码库负对数似然选基座,DeepSeek 用轨迹 BPB/NLL 做代理。它们轻量但看不到模型自身与环境的交互。
理解这些代理方法的盲区,才能明白本文“端到端执行 + 轨迹级行为分解”的动机与差异化定位。
研究动机
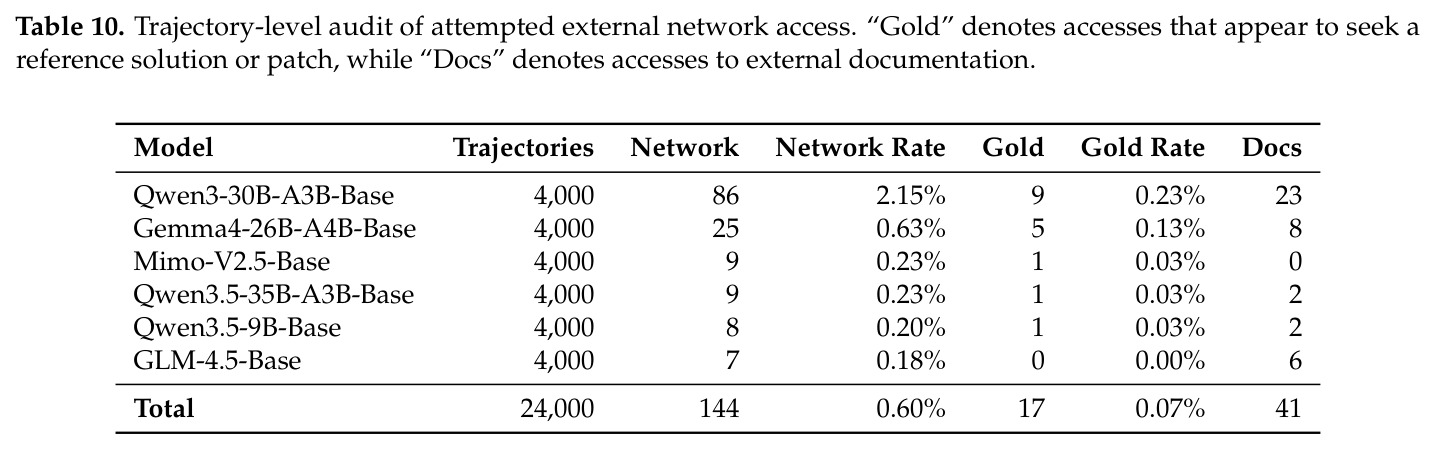
智能体能力已成为现代 LLM 的核心竞争力,但 SWE-bench、Terminal-Bench、DeepSWE 等端到端智能体基准几乎只在后训练之后使用,预训练阶段缺乏对基座模型的端到端评估手段。直接把基座模型插入标准脚手架,会因其未学习系统提示、chat 模板和工具调用协议而产生畸形、不稳定的轨迹;给每个 checkpoint 做 SFT 又成本高昂且改变了被评估对象本身。因此现有预训练侧评估只能退而求其次:APTBench 将成功轨迹转成静态选择题和文本补全,PACE 通过静态条目跨模型校准预测智能体性能,Composer 2 用代码库负对数似然选基座,DeepSeek 用轨迹 BPB/NLL 做代理。这些标量分数无法回答关键问题:模型是否会探索环境、做有效编辑、测试假设、失败后修正,还是根本无法推进任务。
本文的目标是本文目标是构建一个轻量框架,在不做任何权重更新、不把基座模型转换为 chat 式智能体的前提下,让预训练基座模型通过原生补全接口直接执行端到端智能体任务。具体要满足三点:一是能在 SWE-bench Verified、Terminal-Bench 2.1、BrowseComp-Plus 等异构基准上对不同基座模型给出有区分度的分数;二是对同一预训练 run 内不同 checkpoint 的差异保持敏感,甚至当常规预训练基准分数几乎不变时仍能区分;三是暴露模型自身生成的执行轨迹,把总分变化分解为探索、编辑、测试、恢复、完成等具体行为的变化,为预训练数据设计提供可操作的诊断依据。
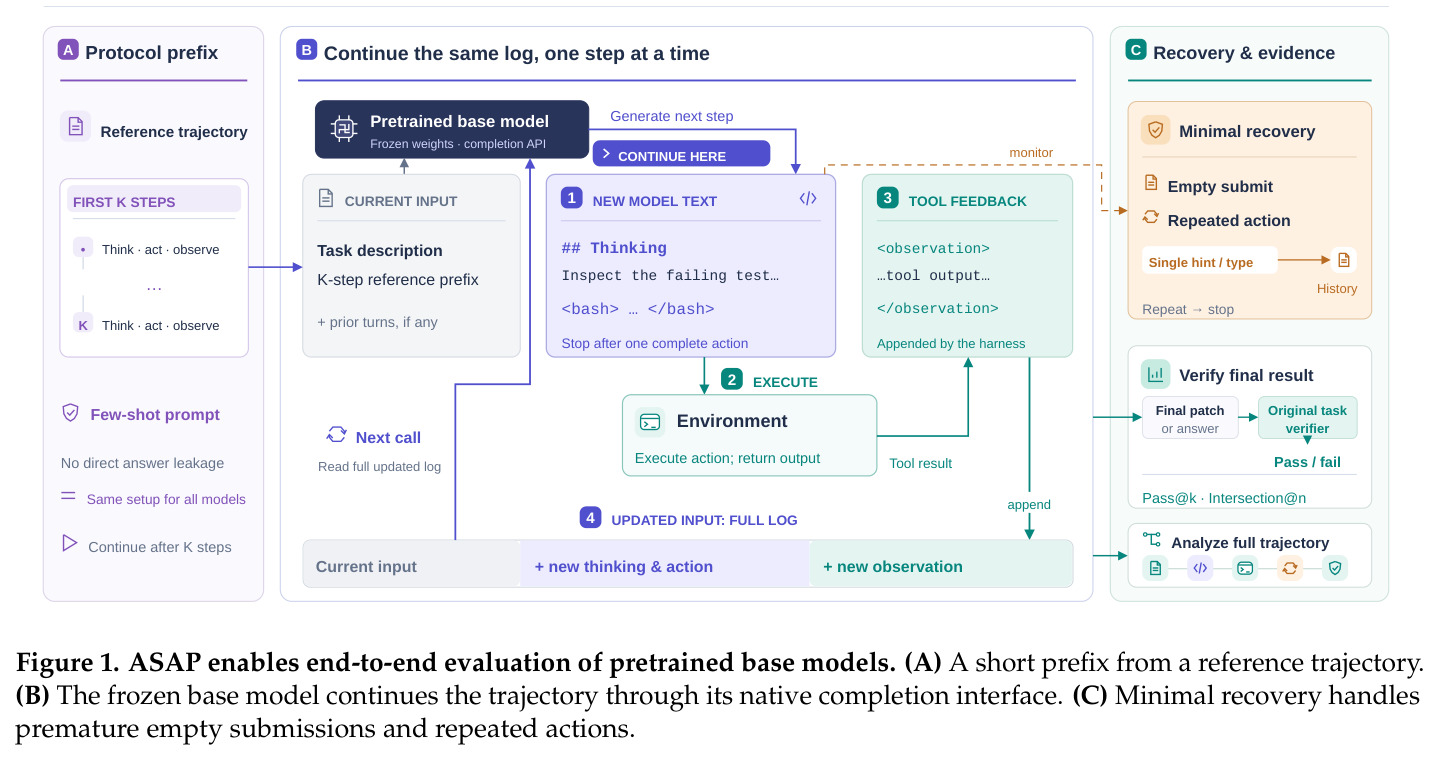
与已有工作不同的是,本文的独特切入点是一个观念转换:基座模型应当被当作“续写模型”而不是“不完整的 chat 模型”来评估。已有工作要么改造任务以适配基座(APTBench 把轨迹变静态题),要么用似然绕开真实交互,本文则反过来改造脚手架的交互协议以适配基座的续写天性:保留补全接口、去掉 chat 模板和系统提示,仅用 Markdown+XML 轨迹格式、3 步参考轨迹前缀和最小恢复机制三个组件,就能复用 SWE-agent、OpenHands、Terminus、BrowseComp 等现有脚手架。这样评估的是模型自己生成的行为而非参考轨迹的似然,且零训练成本、一次评估可跨 checkpoint 复用。
核心方法
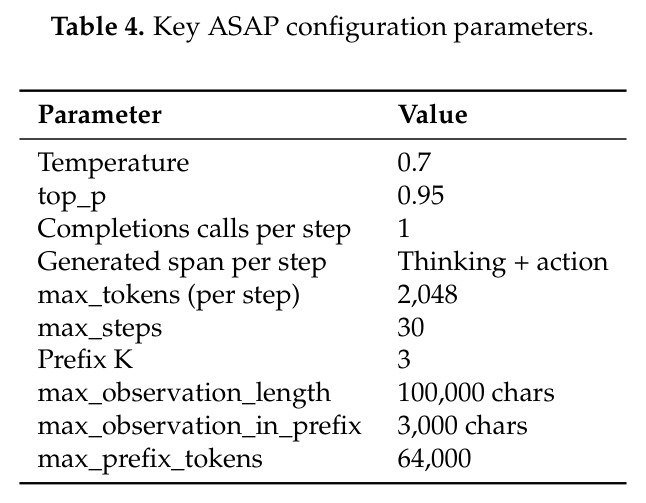
ASAP 的直觉是:预训练语料中天然存在大量 shell 日志和结构化文本,基座模型本就擅长“续写”这类格式,缺的只是一个进入交互状态的起点和防退化的护栏。技术上由三个组件构成:其一,把每步交互表示为结构化 Markdown+XML 轨迹——自由思考用 Markdown(从 ## Thinking 开始),动作与环境反馈用 XML 标签(如 、)定界;其二,从指令模型(Kimi K2.5、GLM-5.2、MiniMax M2.7)的参考轨迹中取前 K=3 步作为前缀,充当协议层面的 few-shot 引导;其三,对“未编辑就提交”和“重复同一动作”两类结构性失败各给一次文本提示并允许自主恢复。默认配置:temperature 0.7、top_p 0.95、每步最多 2048 tokens、最多 30 步。指标采用无偏 Pass@k 估计 $\hat{P}_k = 1 - \binom{n-c}{k}/\binom{n}{k}$ 与 Intersection@n。
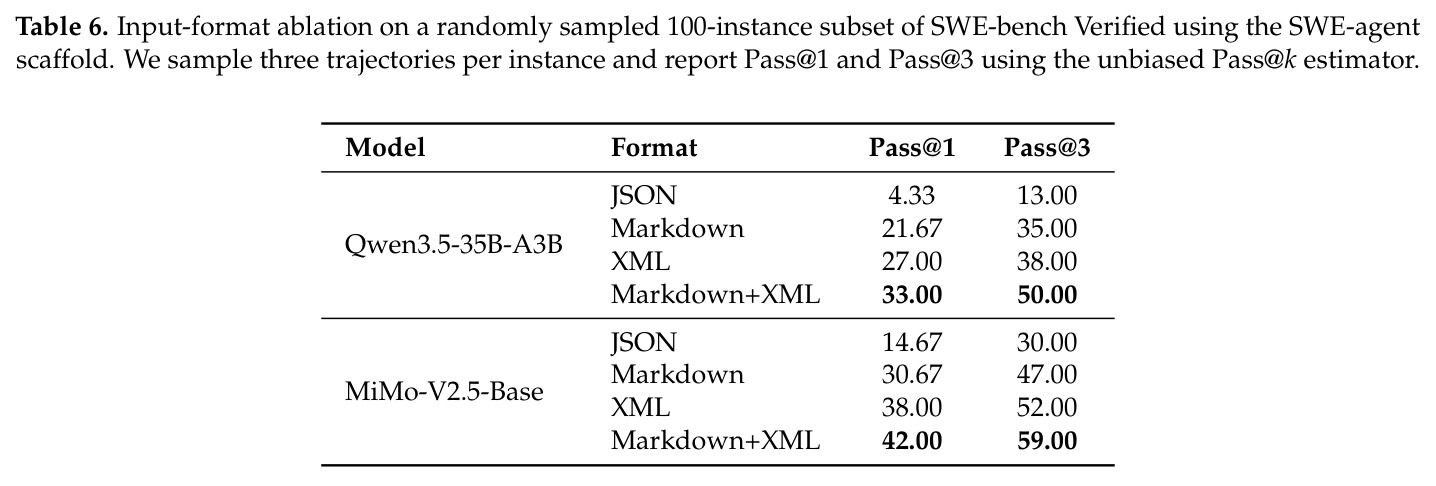
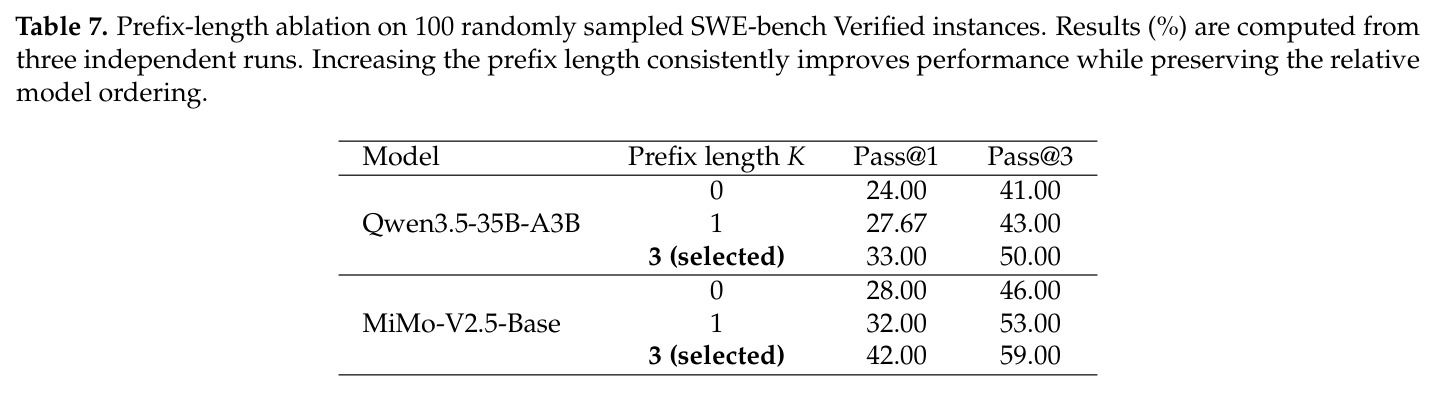
核心创新是把基座模型的智能体评测定义为“续写问题”:评估对象是被测模型自己生成的完整轨迹,而不是参考轨迹的似然(BPB/NLL)或转换后的静态题(APTBench)。与逐 checkpoint SFT 方案相比,ASAP 不更新权重、不改变被评估对象,同一实例对所有模型用同一前缀,保证受控比较。恢复机制刻意最小化:每类失败至多一次提示,harness 从不代替模型插入任务相关动作或编辑,模型无法靠提示通过任务,干预只防止“提前提交”与“死循环”这类结构性退化主导评分。设计均有消融支撑:Markdown+XML 比纯 JSON 的 Pass@1 高出 28.67pp(Qwen3.5-35B-A3B:33.00% vs 4.33%);前缀从 0 步加到 3 步提升 9pp(24.00%→33.00%)且不改变模型排序,K=3 也避免了更长前缀泄漏 gold patch 的风险。
方法步骤详情
执行流程分五步。第一步,前缀构造:从参考轨迹池随机选一条指令模型轨迹,截取前 3 步(思考·动作·观察),验证不含 gold patch 与解法信息,同一实例对所有被测模型用同一前缀。第二步,续写生成:把任务描述加前 K 步拼成前缀文本,基座模型一次补全调用生成 ## Thinking 思考与动作(如 ...),生成到完整动作结束即停止。第三步,执行与回填:harness 解析动作、在环境中执行,把输出包进 追加到日志末尾,再让模型续写下一步,如此循环;观察最长截断 100,000 字符。第四步,恢复干预:若模型未做任何源码编辑就发出 ,首次拒绝并提示至少编辑一个源文件,再次则接受为空 patch 终止;若重复同一动作,首次抑制并提示换方法,再次出现则终止。第五步,终止与评分:遇 、30 步上限或再次退化即终止,用原始任务验证器判分,报告无偏 Pass@k 与 Intersection@n(8 runs),并统计可解析 turn、有效工具调用、自主编辑、主动测试、解决率等行为指标。
技术新颖性
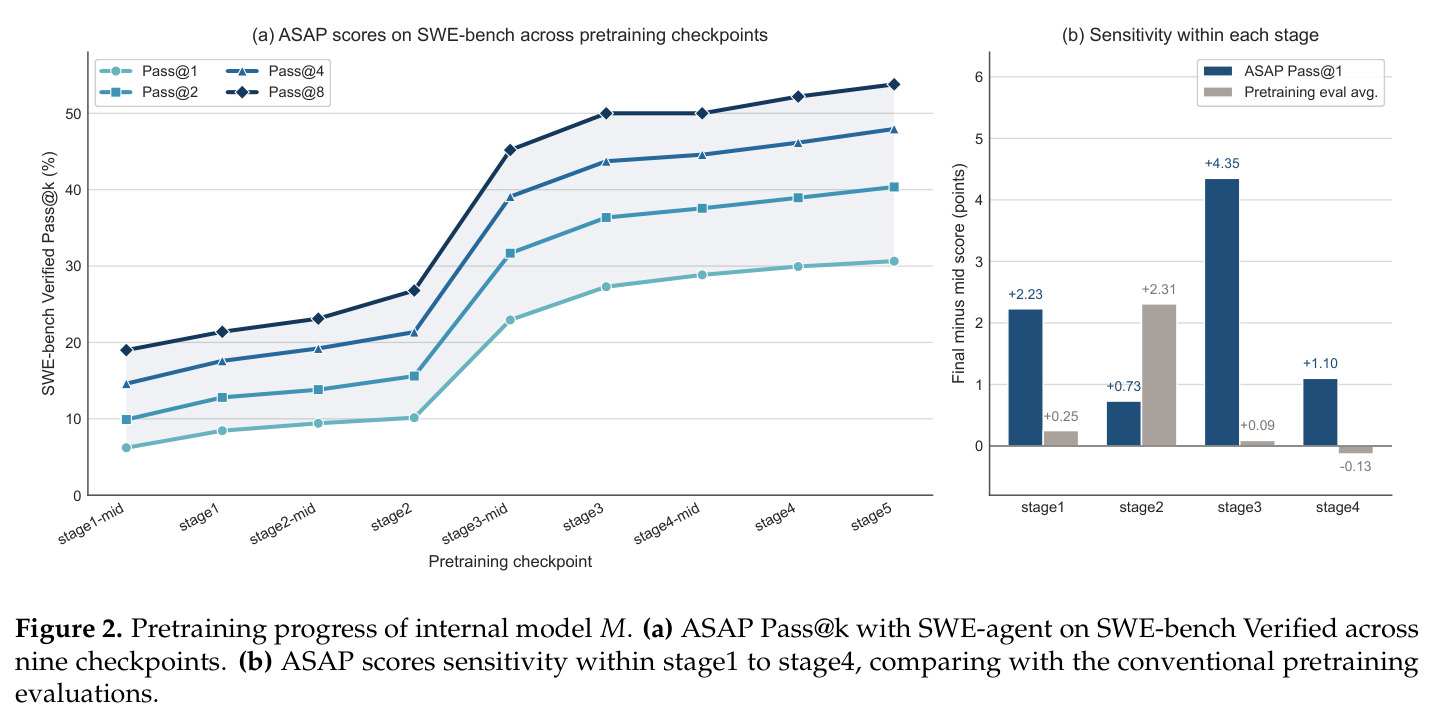
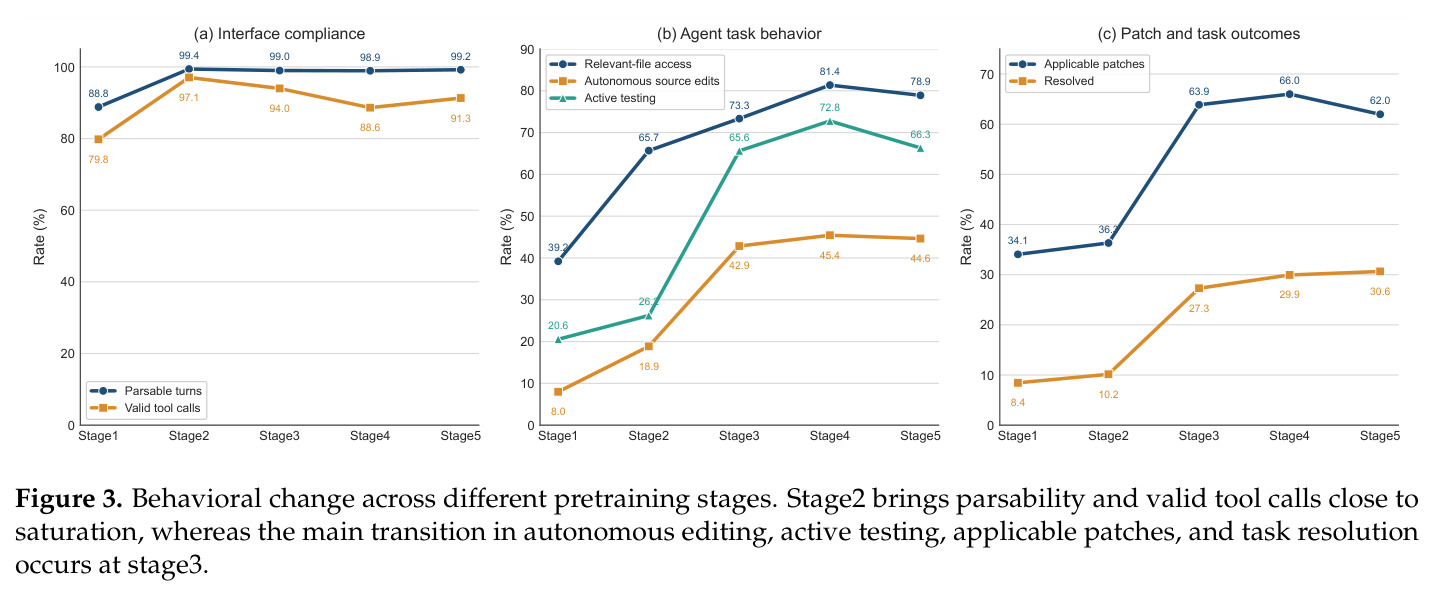
技术新颖性体现在三处。第一,协议适配而非模型适配:APTBench/PACE 改造任务形态,本文只改模型侧交互协议(格式、前缀、恢复),脚手架的环境与逻辑几乎不动,方法可移植到 SWE-agent、OpenHands、Terminus、BrowseComp 四种设置。第二,格式工程的系统消融:在 100 实例子集上比较 JSON/Markdown/XML/Markdown+XML,Markdown+XML 在两个模型上均为最优(Qwen3.5-35B-A3B Pass@1 33.00% vs 纯 XML 27.00% vs 纯 JSON 4.33%),说明 Markdown 提供自由推理空间、XML 提供结构边界的互补价值。第三,轨迹级行为归因:把总分分解为接口行为、执行行为、结果三层指标,这种归因对准确率式基准根本不可得——它揭示了 stage2 主要提升接口可靠性(可解析 turn 88.81%→99.41%)而 stage3 才带来真正的执行能力(自主编辑 42.86%、主动测试 65.64%),从而能反推预训练数据配方的问题所在。
实验结果
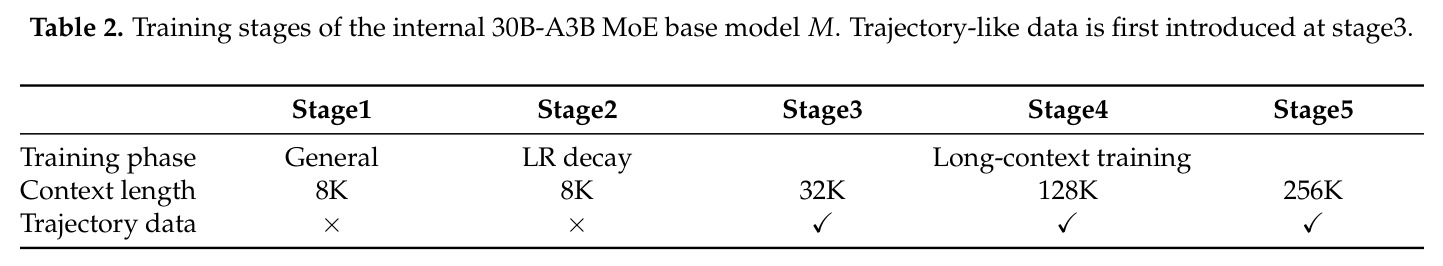
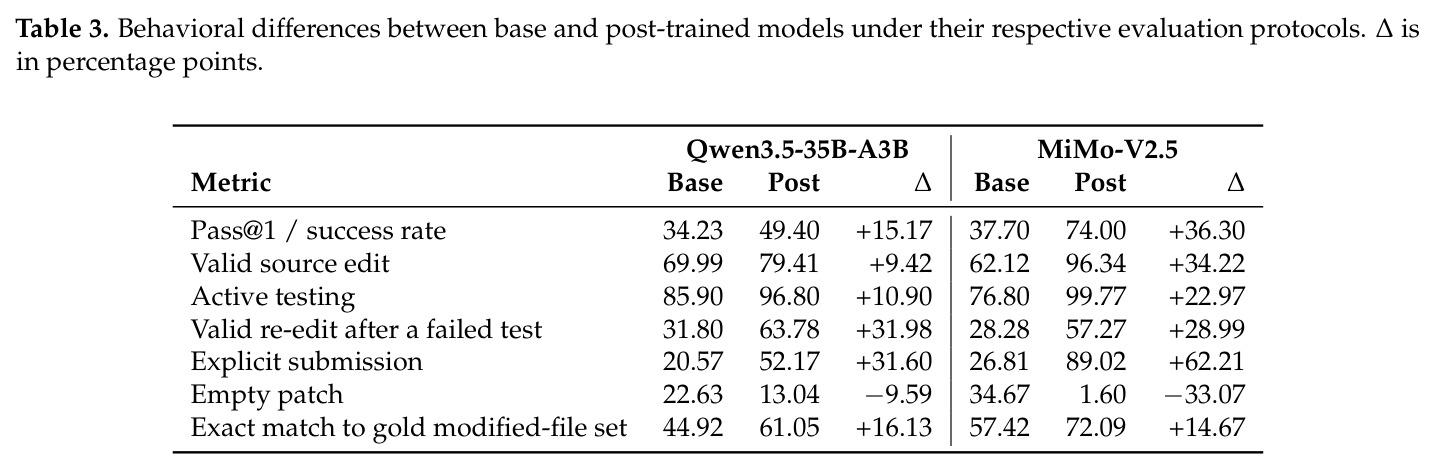
主评测(Table 1,6 基座×4 设置×8 runs):SWE-bench Verified+SWE-agent 下 MiMo-V2.5-Base Pass@1 37.70%、Pass@8 59.40%、82 实例全解;Qwen3.5-35B-A3B-Base 34.23%/56.20%/67;Qwen3-30B-A3B-Base Pass@8 达 24.20% 却无实例全解;两脚手架排序 Spearman ρ≈0.89。预训练监控(Figure 2):内部 30B-A3B 模型 M 的 stage2→stage3(引入轨迹数据+32K 上下文)Pass@1 从 10.15% 跳到 27.30%;stage1/3/4 内 ASAP 提升 +2.23/+4.35/+1.10pp,常规基准仅 +0.25/+0.09/-0.13pp。行为分解(Figure 3):stage2 可解析 turn 88.81%→99.41% 但解决率仅 10.15%,stage3 自主编辑 42.86%、主动测试 65.64%、解决率 27.30%——stage2 学会接口、stage3 学会执行。前后训练(Table 3):Qwen 34.23%→49.40%(+15.17pp)、MiMo 37.70%→74.00%(+36.30pp),MiMo 空 patch 34.67%→1.60%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SWE-bench Verified(SWE-agent 脚手架) | Pass@1 / Pass@8 / #Inter(8次全解) | MiMo-V2.5-Base:37.70% / 59.40% / 82 | Qwen3-30B-A3B-Base:7.38% / 24.20% / 0 | 最强与最弱基座相差 30.32pp,证明 ASAP 对基座模型的区分度 |
| SWE-bench Verified(OpenHands 脚手架) | Pass@1 | Qwen3.5-35B-A3B-Base:39.23% | Qwen3-30B-A3B-Base:4.00% | 差距 35.23pp;与 SWE-agent 排序高度相关(Spearman ρ≈0.89) |
| Terminal-Bench 2.1(Terminus-2 脚手架) | Pass@1 | Qwen3.5-35B-A3B-Base:26.69% | Gemma4-26B-A4B-Base:12.50% | 在终端任务域保持 14.19pp 区分,验证跨域有效性 |
| BrowseComp-Plus(原生脚手架,深度研究) | Pass@1 | MiMo-V2.5-Base:29.44% | Gemma4-26B-A4B-Base:14.64% | 区分 14.80pp,说明方法不限于软件工程任务 |
| 预训练 checkpoint 区分(内部模型 M,stage3 中点→终点) | Pass@1 提升 | ASAP:+4.35pp | 常规预训练基准平均:+0.09pp | 敏感度约为常规基准的 48 倍,常规分数不动时仍能区分 checkpoint |
| 基座 vs 后训练(MiMo-V2.5,SWE-bench Verified) | Pass@1 / 成功率 | ASAP 评基座:37.70% | 原生脚手架评后训练模型:74.00% | +36.30pp,空 patch 从 34.67% 降至 1.60%,显式提交从 26.81% 升至 89.02% |
局限与改进
作者承认的局限:其一,base 与 post-trained 的对比因协议不同(ASAP vs 原生 SWE-agent)只是描述性的,不是后训练效果的受控估计;其二,stage2→stage3 同时引入轨迹数据与 32K 长上下文训练,无法把能力跃迁归因到单一变量(stage2 评测时靠 YaRN 外推超出原生 8K 上下文);其三,SFT 一致性实验只有 4 个模型,作者自己声明只能作为聚合层面的一致性检查而非性能预测。我补充的观察:参考前缀依赖 Kimi K2.5、GLM-5.2、MiniMax M2.7 等指令模型,弱基座可能被强前缀“抬”出不属于自身的能力,前缀公平性只在两个模型上验证;8 runs × 500 实例的长轨迹推理成本高,Intersection@n 对采样预算敏感;行为指标(主动测试、相关文件访问等)靠规则从轨迹抽取,判定规则未公开;内部模型 M 的 checkpoint 不公开,5.1 节核心实验无法独立复现;任务覆盖限于软件工程、终端、浏览三类,长视野多智能体场景未验证。
独立分析的弱点
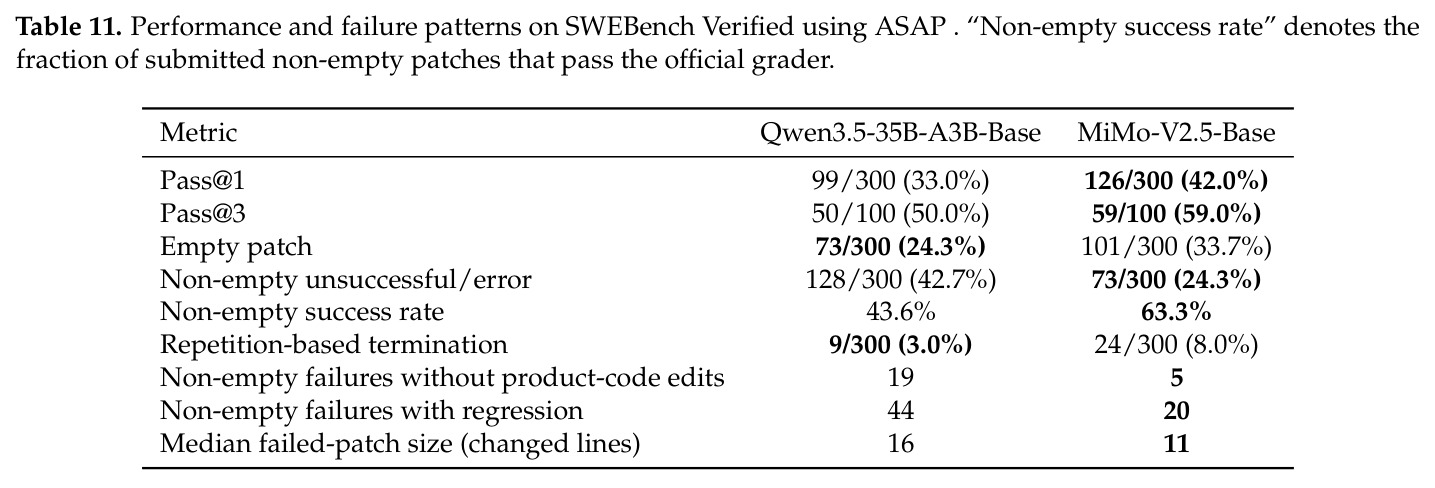
第一,前缀的隐性偏置:K=3 前缀虽验证不含 gold patch,但它示范了“正确开局”(查仓库结构、检查相关文件),探索习惯差的模型可能被带强,前缀来源鲁棒性只在两个模型上检验,样本太小。改进方向:报告多前缀集合下的分数方差,并加入“无前缀纯任务描述”对照,量化协议引导与能力 elicitation 的边界。第二,恢复机制阈值武断:每类失败恰好一次提示、第二次即判死,这个“1”没有理论依据——MiMo 类滞留探索的模型有 8% 轨迹因重复终止,可能过严。改进方向:把提示次数作为消融维度,或引入基于信息增益的自适应干预。第三,步数预算一刀切:max_steps=30 对探索型模型不利,MiMo 的空 patch 率(33.7% vs Qwen 24.3%)可能部分是预算不足而非能力不足。改进方向:按 token 预算而非步数标准化。第四,行为指标为规则抽取:“主动测试”“相关文件访问”的判定规则未公开,跨脚手架一致性未知,可能误判。改进方向:开源抽取规则并报告与人工标注的一致率。
未来方向
作者明确提出的方向:一是模型特定训练数据合成——针对 Qwen 类模型(敢改但精度低,非空失败中含回归 44 例、中位改动 16 行)生成强调最小正确 patch 的数据,针对 MiMo 类模型(谨慎但滞留探索)生成鼓励“有界探索→具体假设→聚焦编辑→验证→及时提交”的轨迹数据;二是利用同一中间仓库状态的多个候选续写,用任务验证器构造偏好对,区分精确进展与空/退化/过宽改动,产生比通用轨迹混合更细的偏好信号。基于本文成果还可延伸:把 ASAP 作为预训练数据配方的在线验证器,每引入一类新数据即观测行为指标变化;研究 ASAP 分数与轨迹似然(BPB/NLL)代理的相关性,构建低成本筛选+高保真确认的两级评估流程;扩展到多智能体协作、长视野规划等更复杂场景;探索 scaffold-invariant 智能体行为的训练目标,缓解论文观察到的脚手架依赖(Qwen3.5-9B 两脚手架相差 11.1pp)。
复现评估
复现条件较好但有缺口。开源部分:六个被测基座(Qwen3-30B-A3B、Qwen3.5-9B/35B-A3B、Gemma4-26B-A4B、GLM-4.5、MiMo-V2.5)均为公开权重;三个基准(SWE-bench Verified 500 实例、Terminal-Bench 2.1、BrowseComp-Plus)公开;方法只有三个组件,附录 A.1 给出完整配置(temperature 0.7、top_p 0.95、30 步、K=3、观察截断 10 万字符),自行实现难度可控。缺口:论文未提供官方代码仓库,脚手架补丁与行为指标抽取规则需自行重写;参考前缀需调用 Kimi K2.5、GLM-5.2、MiniMax M2.7 等指令模型生成;内部模型 M 的 checkpoint 与常规预训练评测细节不公开,5.1 节实验无法复现。算力上,完整主评测是每模型 8 runs × 500 实例 × 最多 30 步的长轨迹推理,六个模型约 24,000 条轨迹,需数千 GPU 小时量级;小规模验证单机多卡即可。总体复现难度:中等偏高。
论文图表
Qwen3.5-35B-A3B-Base 与 MiMo-V2.5-Base 在同 100 实例 × 3 runs 的失败画像:非空成功率 43.6% vs 63.3%,空 patch 24.3% vs 33.7%,重复终止 3.0% vs 8.0%,失败 patch 中位改动 16 行 vs 11 行,无产品码编辑的失败 19 例 vs 5 例,含回归的失败 44 例 vs 20 例。
揭示两种截然不同的执行风格:Qwen 敢改但精度低且改动过宽,MiMo 挑剔但常不落地;这直接支撑“按模型弱点定制训练数据”的核心应用结论。