EarlyEval:用早期结果预测降低智能体评测成本 EarlyEval: Cheaper Agent Evaluation via Early Outcome Prediction
在智能体跑完前预测其最终成败并提前停机,节省13%–26%步骤且榜单排名基本不变
前置知识
智能体基准与 Pass@1
SWE-bench Verified、TerminalBench 这类基准让智能体在多步环境中读文件、执行命令、调用工具并修订方案,每步至少触发一次模型调用,单个任务常跑几十步。任务结束时基准给出二元分 $y \in \{0,1\}$,聚合后的任务解决率(resolve rate / Pass@1)是核心指标,也是排行榜的排序依据。
论文的成本模型、停机判定与 $\Delta$|Pass@1| 保真度指标全部建立在这套评测流程之上。
Leave-one-agent-out 协议
论文把"智能体"定义为 scaffold 框架与底座 LLM 的组合。评估时轮流留出一个完整智能体作为测试对象,只用其余智能体的历史轨迹训练预测器;在 TerminalBench 上还进一步剔除与被测智能体共享同一底座模型或同一 scaffold 的训练轨迹,杜绝残余信息泄漏。
论文所有结果都按此协议报告,它决定了"能否评估从未见过的智能体"这一核心结论的可信度。
LightGBM 梯度提升树
梯度提升决策树的高效实现:串行训练多棵浅层树,每棵拟合当前集成的残差梯度;推理时只需遍历有限棵树,几百维特征在单核 CPU 上亚毫秒内即可给出分数,几乎不占计算资源。
EarlyEval 每一步都要重新打分,预测器必须近乎零开销,这正是作者选用 LightGBM 并据此击败 LLM judge 基线的关键理由。
Platt 校准
树集成等正则化模型输出的原始分数尺度常被扭曲。Platt scaling 用一维逻辑回归 $p = \sigma(a \cdot \mathrm{logit}(\hat{s}) + b)$ 把原始分数映射为校准概率,标量 $a$、$b$ 在留出集上拟合;由于变换单调,模型排序与 AUC 不变,只是统一了概率尺度。
停机规则直接拿概率与阈值 $s$、$f$ 比较,没有校准,不同预测器与不同折之间的阈值就没有一致含义。
TF-IDF 与截断 SVD
TF-IDF 按词频-逆文档频率把文本编码为词 n-gram 加权稀疏向量;截断奇异值分解(Truncated SVD)再将其压缩为低维稠密向量,保留主要语义方向并控制总维度,是经典轻量文本表示管线。
论文的文本特征族(任务描述、动作历史、环境反馈)全部经此管线向量化,是读懂 Table II 特征设计的必要前提。
研究动机
评测 LLM 智能体的账单已高到阻碍研发迭代。OpenHands Index 实测:Claude 5、GPT-5.5、Gemini 3.1 Pro 跑一遍 SWE-bench Verified(500 题)分别需要 $715、$760、$935;rollout 更长的 SWE-bench Multimodal 单次高达 $2,270,GAIA 也要 $1,305。而这只是单次评测——团队每改一版 prompt、scaffold 或底座模型都要重跑基准,对照实验还要成倍叠加,一个开发周期动辄几十次评测,成本乘法式累积,把频繁评测挡在多数从业者的预算之外。已有的 benchmark distillation 路线(Anchor Points、tinyBenchmarks、自适应测试等)只把基准裁剪成更小的任务子集,但保留下来的任务单题执行成本分文未降,昂贵的多步 rollout 原样保留。
本文的目标是本文提出并验证"早期结果预测"这一新的效率维度:任务一个不少,但在每个任务内部削减成本。具体目标是训练轻量级预测器,在智能体逐步执行时持续监控其部分轨迹,一旦成功或失败在统计上变得显然(校准置信概率越过预设阈值),立即终止运行并把预测结果记为该任务的得分。量化目标包括:在从未见过的智能体(leave-one-agent-out 协议)上预测准确率达到 89%–97%;每个智能体 resolve rate 的偏移控制在约 1–2 个百分点;全量排行榜 Spearman 排名相关 $\rho \geq 0.95$;同时削减两位数百分比的执行步骤与输入/输出 token。该轴与任务蒸馏正交,可叠加使用。
与已有工作不同的是,切入点是被忽视的"结果早熟"现象。作者设计了一个能看答案的 oracle 观察者来分析真实轨迹:OpenHands 公开的 tianocore/edk2-pytool-library-372 案例(45 步)中,智能体在第 20 步写出复现脚本、第 23 步完成唯一一行路径分隔符修复,此后源代码再无改动、只在各方向上测试——第 23 步时任务实质已解决,剩余约一半开销是冗余的。反过来,反复用同一编辑对抗不变报错的智能体早已"宣告"失败。关键洞察有二:这类信号一半来自与参照解的比对,一半内生于轨迹本身(无需 gold patch);更重要的是,它们可以从同一基准上其他智能体的历史评测轨迹中学到——排行榜和公开运行天然积累了大量带结果标签的数据,本文正是第一个把这笔"免费监督"用于任务内早停的工作。
核心方法
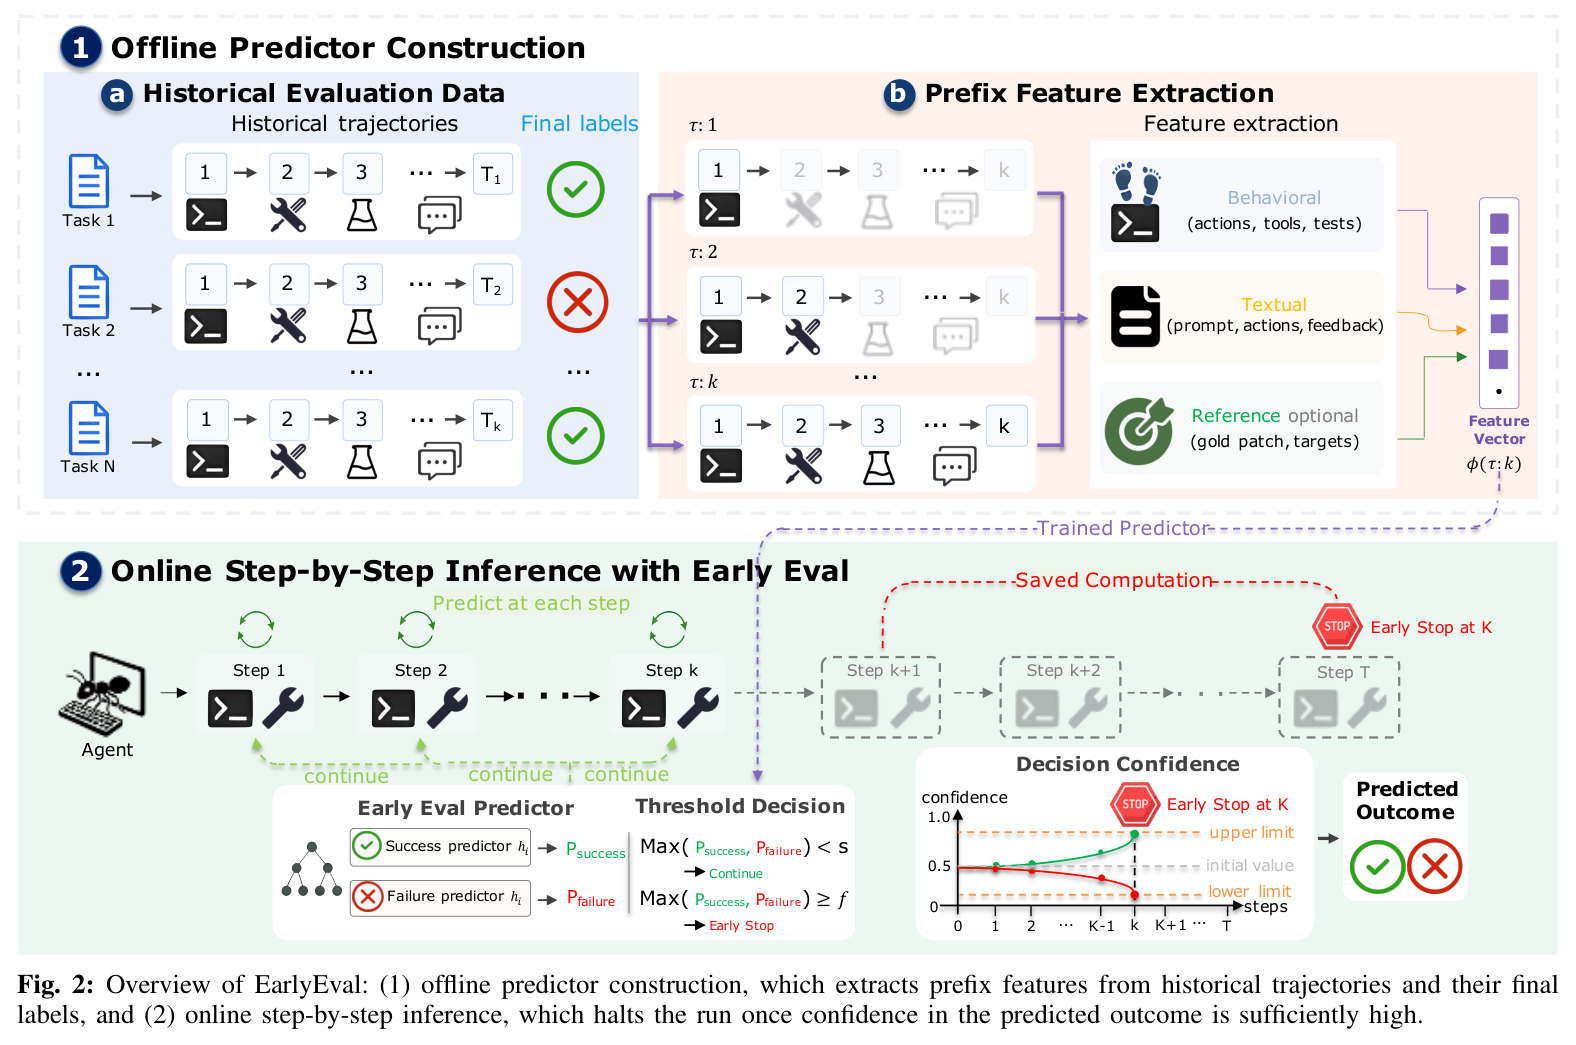
直觉上,EarlyEval 像一位看过无数棋局的裁判:中盘形势已定时,无需等收官即可判胜负。它分两个阶段(Fig. 2)。离线阶段:收集目标基准上大量历史评测轨迹,每条轨迹 $\tau = (e_1, \dots, e_T)$ 带基准给出的最终二元标签 $y \in \{0,1\}$;把轨迹展开成前缀 $\tau_{:k}$($k=0,\dots,T$),每个前缀继承最终标签;对每个前缀抽取三族特征 $\phi(\tau_{:k})$——行为统计、TF-IDF+SVD 文本向量、以及有参照解时的金标重叠特征;据此训练两个 LightGBM 梯度提升树集成:成功预测器 $h^+$(目标 $y=1$)与失败预测器 $h^-$(目标 $1-y=1$,即失败轨迹)。在线阶段:新智能体每执行一步,就提取当前前缀特征输入双模型,原始分数经 Platt 校准为概率 $p^+$、$p^-$;当 $p^+ \geq s$ 或 $p^- \geq f$($s$、$f$ 为预设阈值)时停机并记录预测结果,否则放行至自然结束。整个过程对原评测管线是即插即用的旁路。
本质创新在于把评测效率的战场从"任务之间"搬进"任务内部"。任务蒸馏减少题目数,EarlyEval 不动任务池,而是利用每条轨迹中"结局早已注定"的冗余尾段。技术上有三个关键设计:其一,双预测器而非单一分类器——$h^+$ 与 $h^-$ 以互逆目标分别训练,让正负证据独立累积,因为成败的行为信号本质不对称(成功的标志是"测试首次全绿"式的里程碑,失败则是"无编辑长连读、重复同款编辑"式的停滞模式);其二,双阈值天然构成"不自信区域":两个概率都低时放行继续执行,避免在结局仍模糊时武断误判;其三,训练信号是 agent-agnostic 的——只用其他智能体的历史轨迹,因此能直接评估从未见过的新智能体。此外作者刻意选用每步推理亚毫秒级的 GBDT 而非 LLM judge,避免裁判自身的推理开销吃掉早停省下的算力。
方法步骤详情
完整流程五步。第一步,数据收集:对基准 $B$ 汇集 $M$ 个智能体的完整轨迹并附最终标签 $y$,丢弃少于 10 步的短轨迹;每个前缀样本按 $1/(T+1)$ 加权,保证长轨迹不主导损失、每条轨迹对目标函数贡献相同总质量。第二步,前缀展开:轨迹切成 $\tau_{:k}$($k=0..T$),全部继承最终标签 $y$。第三步,特征抽取(Table II):行为族 115 维,含活动计数(37 维:步数、动作量、各类编辑/测试/git 操作计数)、末步属性(11 维)、关键事件时序(18 维:编辑/测试/提交/报错首次出现步与距今步数)、工作模式(32 维:每编辑读文件比、无编辑连读、未测试即提交等停滞与冒险信号)、错误与测试状态(17 维);文本族把任务描述、全部动作历史+最近动作、全部环境反馈+最近反馈分块 TF-IDF(unigram+bigram,min_df=5,词表 3 万)后经截断 SVD 降为 64/128/128 维;参照解族(仅当基准发布 gold patch)含金标补丁描述 28 维与前缀-金标重叠 54 维(文件、API 符号、测试名的 Jaccard 与命中计数)。第四步,训练:按任务划分训练/验证折(同一轨迹的前缀不跨折),两个 LightGBM 共享超参(学习率 0.03、31 叶、最大深度 6、min_child_samples 200、行列采样 0.75/0.70、L1/L2 正则 0.5/10.0、至多 2000 轮、验证 50 轮无提升早停),并在验证折上拟合 Platt 校准 $p = \sigma(a \cdot \mathrm{logit}(\hat{s}) + b)$。第五步,在线推断:每步重算 $\phi$,$p^+ \geq s$ 或 $p^- \geq f$ 即停;同一步双双越阈按先越者定结果;否则继续至自然完成。
技术新颖性
与三类相邻工作的本质区别:(1)任务蒸馏(Anchor Points、tinyBenchmarks、自适应测试、Fluid Benchmarking)决定"评哪些题",本文决定"每题评多久",两轴正交可叠加——这是论文自称的全新效率维度;(2)部署期智能体早停(内在退出指令、自验证、logprob 不确定性、预算控制)依赖运行时自我观察、目标是保住单个智能体的成功率,而 EarlyEval 站在评测者视角,可利用部署时不可得的信号——参照答案与其他智能体的历史轨迹,目标是保真复现评测结论而非改善智能体表现;(3)与 LLM judge 判定相比,GBDT 在几百维特征上亚毫秒完成推理,不会像每步一次 LLM 前向那样抵消节省。RQ4 消融证实 LightGBM 处于精度-效率 Pareto 前沿,且双头设计让两个预测器几乎从不在同一条轨迹上触发,节省量近似可加(−10.6% + −15.4% = −26.0%)。
实验结果
RQ1(精度与节省,Table III):leave-one-agent-out 下,SWE-bench Verified 阈值 0.95 时双机制削减 26.0% 执行步骤、32.7% 输入 token、28.7% 输出 token,$\Delta$|Pass@1| 仅 1.1 个百分点;Toolathlon 阈值 0.90 时步骤 −23.0%、输入 token −44.1%、输出 −29.4%、失真 0.9pp;TerminalBench 无同模型设定 0.90 时步骤 −25.4%、失真 2.1pp。把阈值从 0.95 放宽到 0.75,SWE-bench 步骤节省升至 63.4%,但失真增至 4.1pp,呈单调可调权衡。成功预测器仅在 SWE-bench 可靠(精度 88.3%–93.9%),在 Toolathlon 覆盖率归零;失败预测器全场景稳健(SWE 96.7%、TerminalBench 89.4%–96.6%、Toolathlon 96.6%–99.4%),说明默认配置实际主要靠"提前宣判失败"省钱。双机制节省≈两单机制之和,证明二者几乎从不同时触发。RQ2(排名保真,Table IV):SWE-bench $\rho=0.991$(81% 智能体位次不变)、Toolathlon $\rho=0.994$(70%)、TerminalBench 无同 scaffold $\rho=0.994$(70%)、最严苛的无同模型 $\rho=0.959$(59%);Top-3 智能体大多 $\Delta$Rank=0。RQ3(Table V):整族去掉参照解特征只把覆盖率从 34.8% 降到 32.1%、步骤节省从 26.0% 降到 24.7%,解释了无 gold patch 基准上的可用性;去掉行为族伤害最大(覆盖 23.4%、节省 16.4%);任何单一子组消融影响不超过 1.3pp,信号在族内冗余分布。RQ4(Table VI):LightGBM 全维占优(34.8% 覆盖/95.0% 精度/−26.0% 步骤/1.1pp);Direct MLP 精度 87.9%、仅 −20.0%;稠密逻辑回归崩至 43.8%;TF-IDF LR 只停 2.4% 轨迹;Qwen-0.5B LoRA judge 保真 0.8pp 但步骤节省仅 17.9%,且每步需一次 LLM 前向。此外,scaffold 比底座模型更难建模:无同 scaffold 时成功预测器峰值精度从 82.7% 跌到 69.0%,步骤节省从 25.4% 缩水到 17.7%。
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SWE-bench Verified(500 题软件修复)智能体评测 | 执行步骤缩减 / $\Delta$|Pass@1|(阈值 0.95,leave-one-agent-out) | 步骤 −26.0%,输入 token −32.7%,输出 token −28.7%,失真 1.1pp,预测准确率 95.0% | 完整评测(不提前停止) | 削减约四分之一步骤,排行榜 $\rho=0.991$,81% 智能体位次不变 |
| Toolathlon(108 题工具/API 使用)智能体评测 | 执行步骤缩减 / 输入 token(阈值 0.90) | 步骤 −23.0%,输入 token −44.1%,输出 token −29.4%,失真 0.9pp | 完整评测(不提前停止) | 输入 token 节省近一半,$\rho=0.994$,70% 位次不变 |
| TerminalBench(89 题命令行)无同模型泄漏控制 | 执行步骤缩减 / $\Delta$|Pass@1|(阈值 0.90) | 步骤 −25.4%,输入 token −42.7%,失真 2.1pp | 完整评测(不提前停止) | $\rho=0.959$,59% 位次不变(最严苛设定) |
| 预测器架构对比(SWE-bench Verified) | 覆盖率 / 准确率 / 步骤节省 | LightGBM:34.8% / 95.0% / −26.0% | Qwen-0.5B LoRA judge:18.7% / 90.7% / −17.9%;Direct MLP:26.9% / 87.9% / −20.0% | 步骤节省多约 8pp 且精度更高,且无每步 LLM 前向开销 |
局限与改进
作者承认的局限:EarlyEval 依赖目标基准上现成的带标签历史轨迹池,对毫无历史运行的全新基准不适用;早停引入约 1–2pp 的系统性偏差,故只适合迭代开发中的相对比较,不能替代完整运行去产出"正典"可引用分数;成功预测器在无参照解的基准上基本失效(Toolathlon 覆盖率≈0),实践上重度依赖失败预测器。我的补充观察:其一,三个基准均属代码/终端/工具域,行为特征能否迁移到网页操作、具身智能体等节奏迥异的场景未知;其二,SWE-bench 数据全部来自 mini-SWE-agent 单一 scaffold,跨 scaffold 泛化只在 TerminalBench 间接检验且明显退化,暗示特征与 scaffold 强耦合;其三,早停隐含"尾步不改变结果"假设,对具备自我纠错或多轮采样能力的智能体,提前宣判失败可能系统性低估其真实成功率——Table IV 中 $\Delta$Pass@1 几乎全为负值正与此吻合;其四,阈值全局固定,未按任务难度自适应。
独立分析的弱点
独立分析四点弱点。第一,偏差方向不对称:失败预测器主导停机,等于更频繁地"提前判死",对依赖长尾试错才成功的智能体(如多轮 test-time scaling 场景)会系统性低估,且逐题误差无上界(平均 1–2pp 掩盖了尾部)。改进方向:对早停轨迹按校准置信度加权事后校正通过率,或对成功边缘案例强制补跑测试套件(只执行测试,不做完整 rollout)。第二,冷启动依赖:新基准或新智能体族群必须先攒够完整评测数据才能训练。改进:跨基准预训练加目标域微调,或用主动学习挑选信息量最大的轨迹标注。第三,手工特征对 scaffold 敏感:TF-IDF+SVD 捕捉的节奏漂移导致无同 scaffold 设定下精度降至 69.0%。改进:在动作事件流上训练小型序列编码器学习表征,或对特征按 scaffold 归一化。第四,阈值全局静态:不同任务可预测性差异巨大(有的第 10 步已显然,有的到结尾仍模糊),统一阈值必然顾此失彼。改进:按任务簇或在线估计的难度自适应调整阈值,或引入 conformal prediction 提供带覆盖保证的停机规则。
未来方向
作者提出的方向:随基准排行榜积累新运行,以极低边际成本周期性刷新预测器;与任务蒸馏叠加形成"任务间+任务内"双重压缩;推广到更多评测域。基于成果可延伸的方向:把评测者视角的早停信号反哺智能体本身,作为过程奖励或预算感知训练信号;利用已训练的特征做失败模式的在线归因与诊断面板;为多轮自我修正型智能体设计公平的早停协议(例如只在自我纠错概率可忽略后才允许停机);将停机决策与统计保证结合,用 conformal 或贝叶斯方法输出带置信区间的评测分数;在持续集成场景把 EarlyEval 当作廉价冒烟层,仅对预测结果相对上一版翻转的提交触发完整评测,进一步压低迭代成本。
复现评估
复现条件相当友好。代码与实验数据已开源。实现仅依赖 scikit-learn 和 LightGBM,训练在普通 CPU 上即可完成(梯度提升树分钟级训练),在线推理每步亚毫秒、单核即可,全程无需 GPU。训练数据全部来自公开渠道:SWE-bench Verified 7,805 条、TerminalBench 6,757 条、Toolathlon 7,116 条,合计 21,000+ 条带标签轨迹(16/37/22 个智能体配置),随机种子固定为 42,LightGBM 超参与特征定义在论文中给出得相当完整。主要工作量在数据工程:需自行抓取并对齐各基准的运行日志与排行榜结果,并严格复现按任务划分的 leave-one-agent-out 泄漏控制。整体属于低成本、高可行性复现,最大不确定性在于历史轨迹的获取与清洗质量。
论文图表
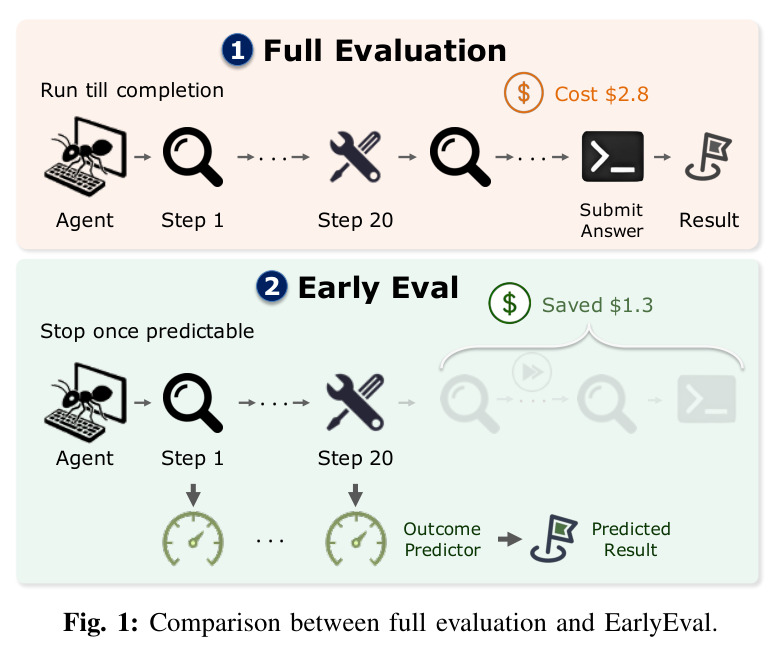
上下对比:完整评测让智能体从第 1 步一直跑到提交,成本 $2.8;EarlyEval 在第 k 步由 OutcomePredictor 判定结果已可预测后提前停机,节省 $1.3 并输出预测结果。
一图讲清论文的核心价值主张——"结果一旦可预测就停",钱省在任务内部而非减少任务数。
列出 Claude 5、GPT-5.5、Gemini 3.1 Pro 在五个软件工程基准上单次完整评测的美元成本:SWE-bench Verified $715–$935,SWE-bench Multimodal 最高 $2,270,GAIA 达 $1,305。
论文动机的量化基础,直观说明评测为何贵到必须省、省哪里。
三族特征明细:行为族(活动计数、末步属性、事件时序、工作模式、错误与测试状态,共 115 维)、文本族(任务/动作/反馈的 TF-IDF+SVD 向量,320 维)、参照解族(gold 描述 28 维 + 前缀-金标重叠 54 维)。
方法可复现性的核心清单,RQ3 的特征消融实验也逐条对照此表展开。
主结果表:各基准、各阈值(0.75–0.97)下成功/失败/双机制的精度、覆盖率、步骤节省与 $\Delta$|Pass@1|,如 SWE-bench 0.95 双机制 −26.0% 步骤、失真 1.1pp。
支撑"省多少、失真多少"的所有核心数字,阈值-精度权衡关系一目了然。
早停榜单与全量榜单对比:各基准 Spearman $\rho$ 为 0.959–0.994,59%–81% 智能体位次不变,并对各设定 Top-3 智能体逐一给出 $\Delta$Pass@1、$\Delta$Rank 与 $\Delta$Steps。
证明省下的成本没有破坏评测结论——排行榜的相对排序这一核心功能被完整保留。
特征消融:去掉参照解族仅让步骤节省从 26.0% 降至 24.7%,去掉行为族伤害最大(降至 16.4%),任意单一子组消融影响不超过 1.3 个百分点。
解释了框架为何能在无 gold patch 的基准上工作,以及信号在族内冗余分布的关键机制。
架构对比:LightGBM 覆盖 34.8%、精度 95.0%、步骤 −26.0% 全面占优;MLP 与线性模型被全面支配;Qwen-0.5B LoRA judge 保真不错(0.8pp)但步骤节省减半且有每步前向开销。
论证"轻量 GBDT 优于 LLM judge"这一关键工程判断,是 RQ4 结论的直接证据。