DeLoop:将重复动作作为长程智能体的自监督训练信号 DeLoop: Repeated Actions as Self-Supervision for Long-Horizon Agents
把智能体自身的循环动作当负例、脱困动作当正例做DPO,无需标签将循环率从57.3%降至6.1%
前置知识
长程智能体与 act–observe 循环
指让大模型在多轮“调用工具→获得观察→决定下一步”的循环中完成任务的系统,交互历史随轮数线性增长。本文主战场 CodeGym 把静态编程题改造成交互式工具调用环境:任务暴露一组函数 API 与 Done() 动作,环境服务器对智能体答案评分,智能体贪心解码、上限 30 轮,一步(step)指一次被执行的动作。
论文的“循环”就定义在这种轨迹结构上(同一调用以相同参数重复出现且观察逐字节相同),所有检测、配对挖掘与评测都建立在对 act–observe 轨迹的理解之上。
上下文压缩(滚动摘要)
当交互历史超过 token 预算时,框架保留系统提示、任务描述与最近 6 条消息,把中间内容替换为同一模型以温度 0 生成的摘要。摘要会抹掉已执行动作及其返回值的精确记录,使策略难以据此避免重复调用;压缩触发的阈值越高(保留越多),循环越少。
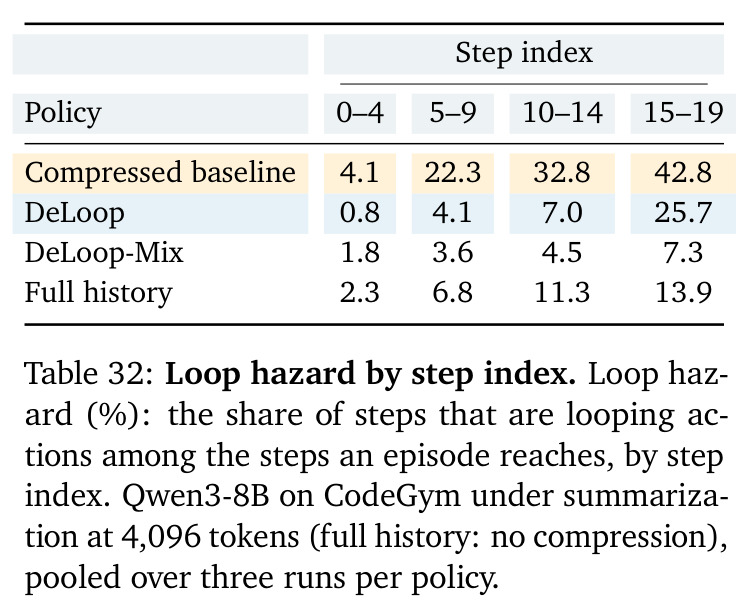
压缩是本文论证的循环放大器(Qwen3-8B 循环率 29.0%→57.3%),也是 DeLoop 的标准训练与评测设置;理解“保留什么历史”与“策略是否使用历史”的分工是把握论文定位的关键。
直接偏好优化(DPO)
无需训练独立奖励模型的偏好对齐方法:对同一上下文 $x$ 下的选择动作 $y^+$ 与拒绝动作 $y^-$,以冻结参考策略 $\pi_{ref}$ 归一化,最小化 $\mathcal{L}=-\log\sigma\big(\beta\log\frac{\pi_\theta(y^+|x)}{\pi_{ref}(y^+|x)}-\beta\log\frac{\pi_\theta(y^-|x)}{\pi_{ref}(y^-|x)}\big)$,其中 $\beta$ 控制偏离参考策略的强度。
DeLoop 的全部训练就是这个损失,创新只在配对来源;论文的目标函数消融(KTO/IPO/GRPO/SFT 对比)与似然锚危害分析都围绕 DPO 的梯度结构展开,不懂 DPO 无法理解这些结论。
LoRA 低秩适配
参数高效微调技术:冻结基座全部权重,只在注意力与 MLP 的各投影层注入可训练的低秩分解矩阵(秩 $r$、缩放 $\alpha$)。本文用 $r=32$、$\alpha=64$、学习率 $8\times10^{-6}$、1 个 epoch 在 8,000 对上训练 Qwen3-8B,有效 batch 16。
复现时必须按论文超参配置 LoRA 训练;它也表明该方法在 8B 级开源模型上即可低成本落地,而非只适用于闭源大模型。
研究动机
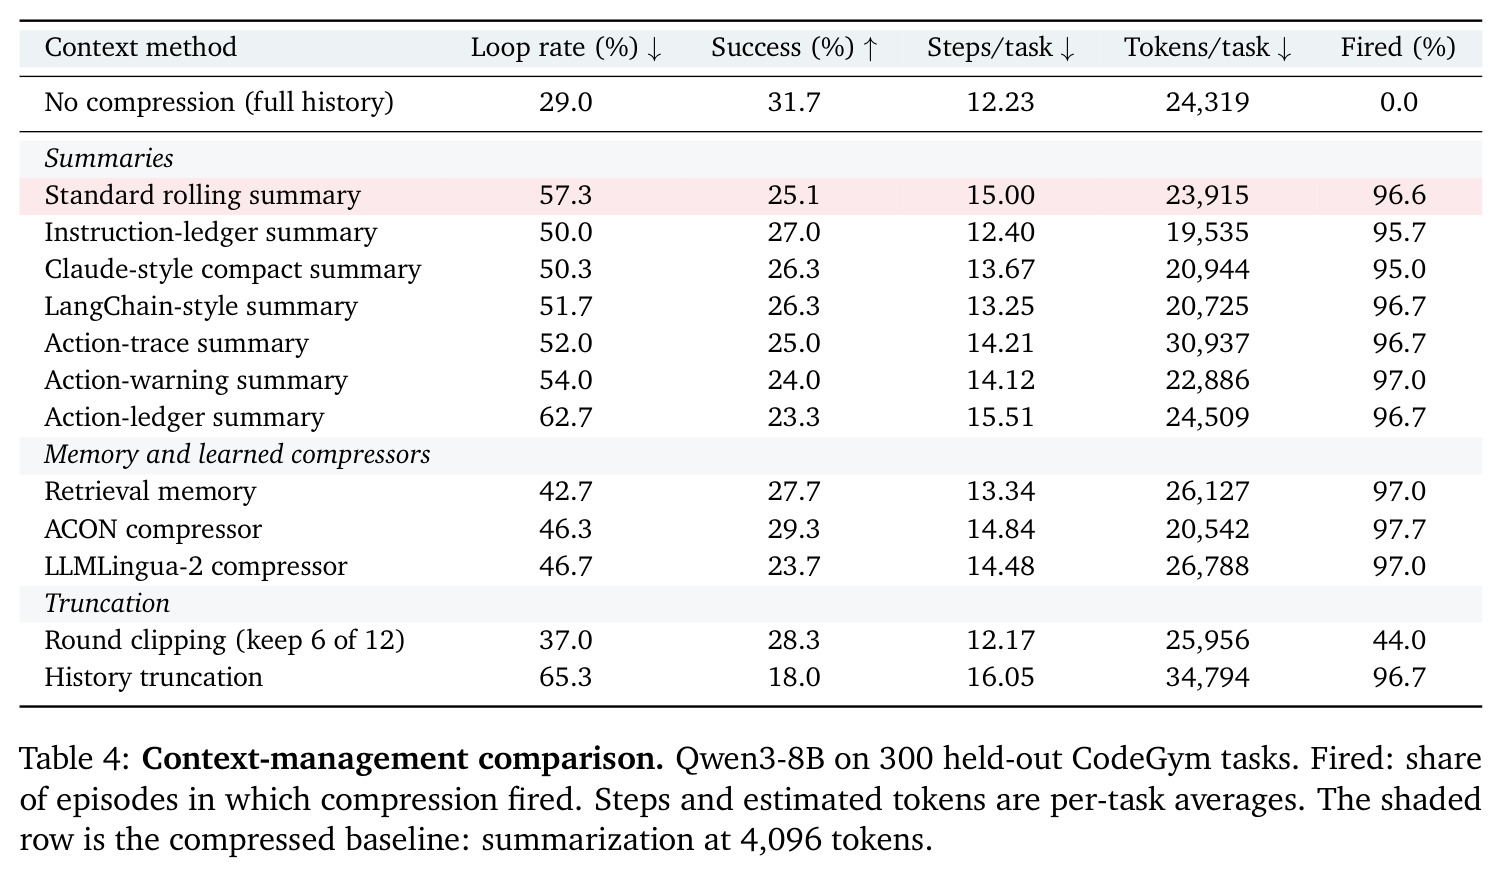
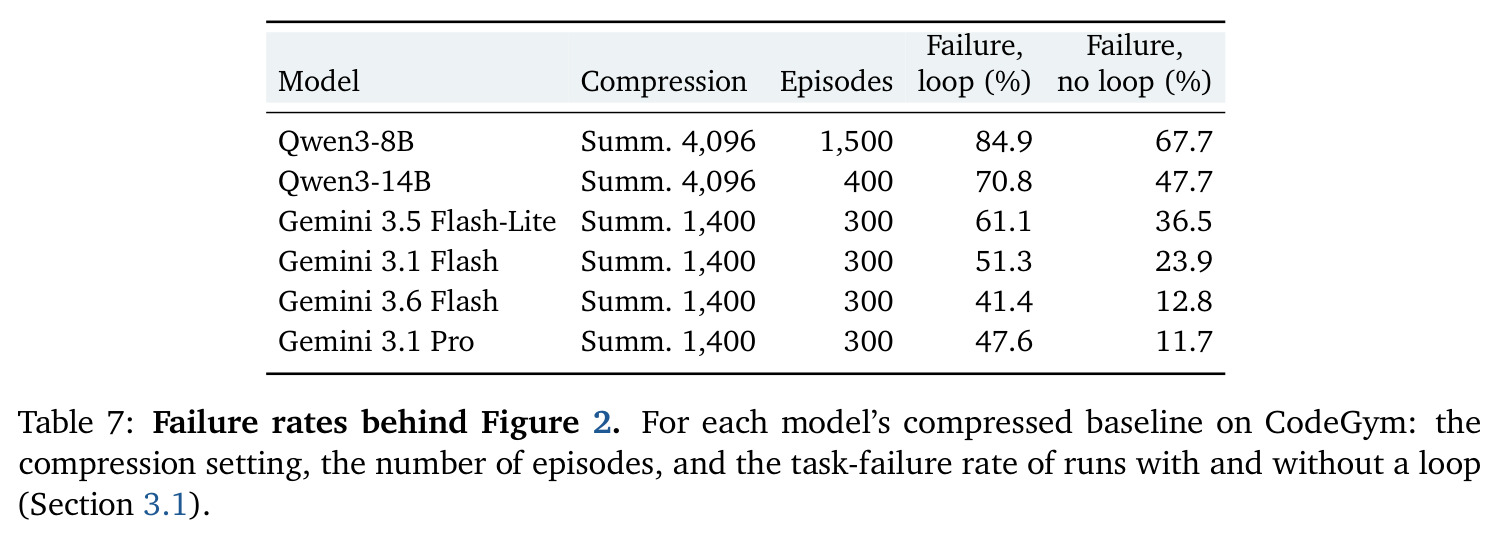
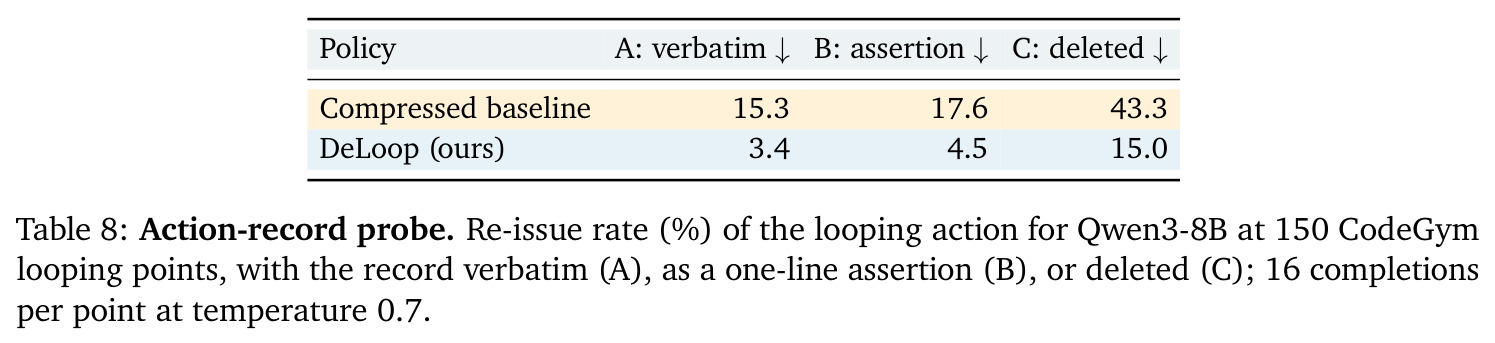
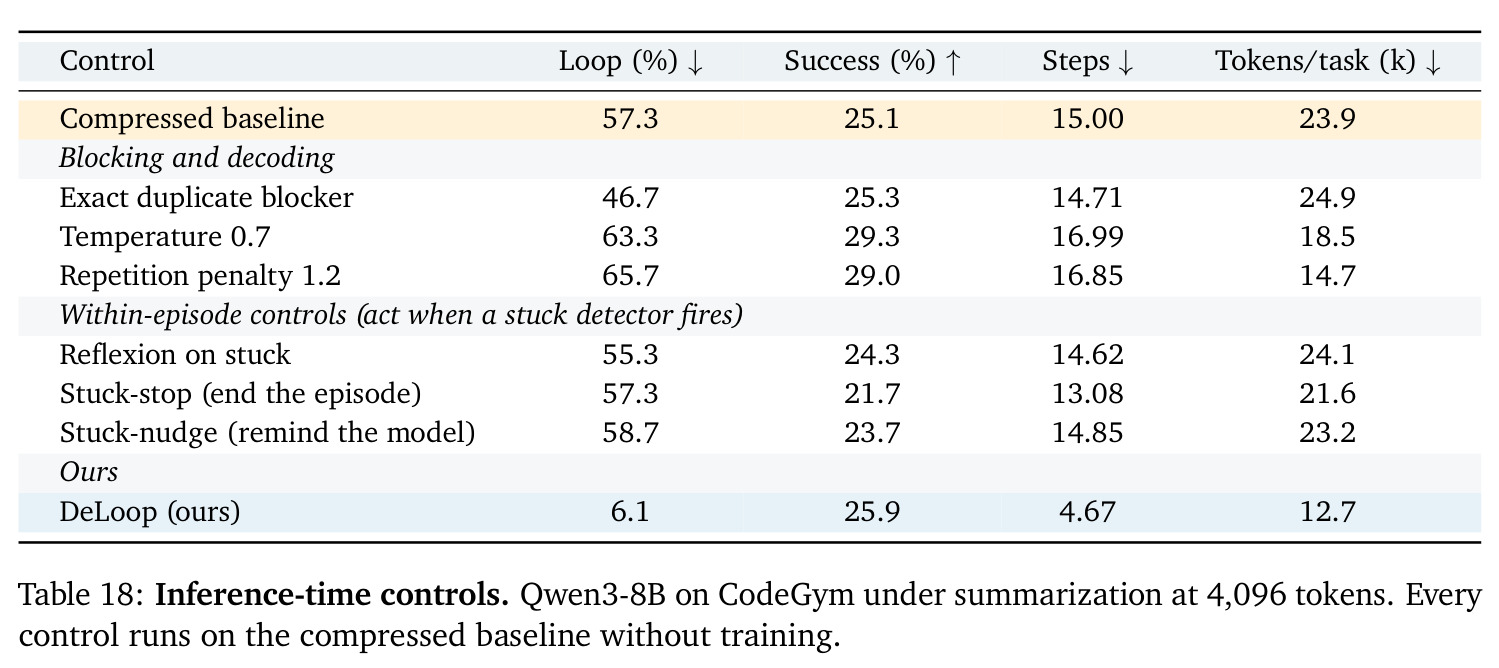
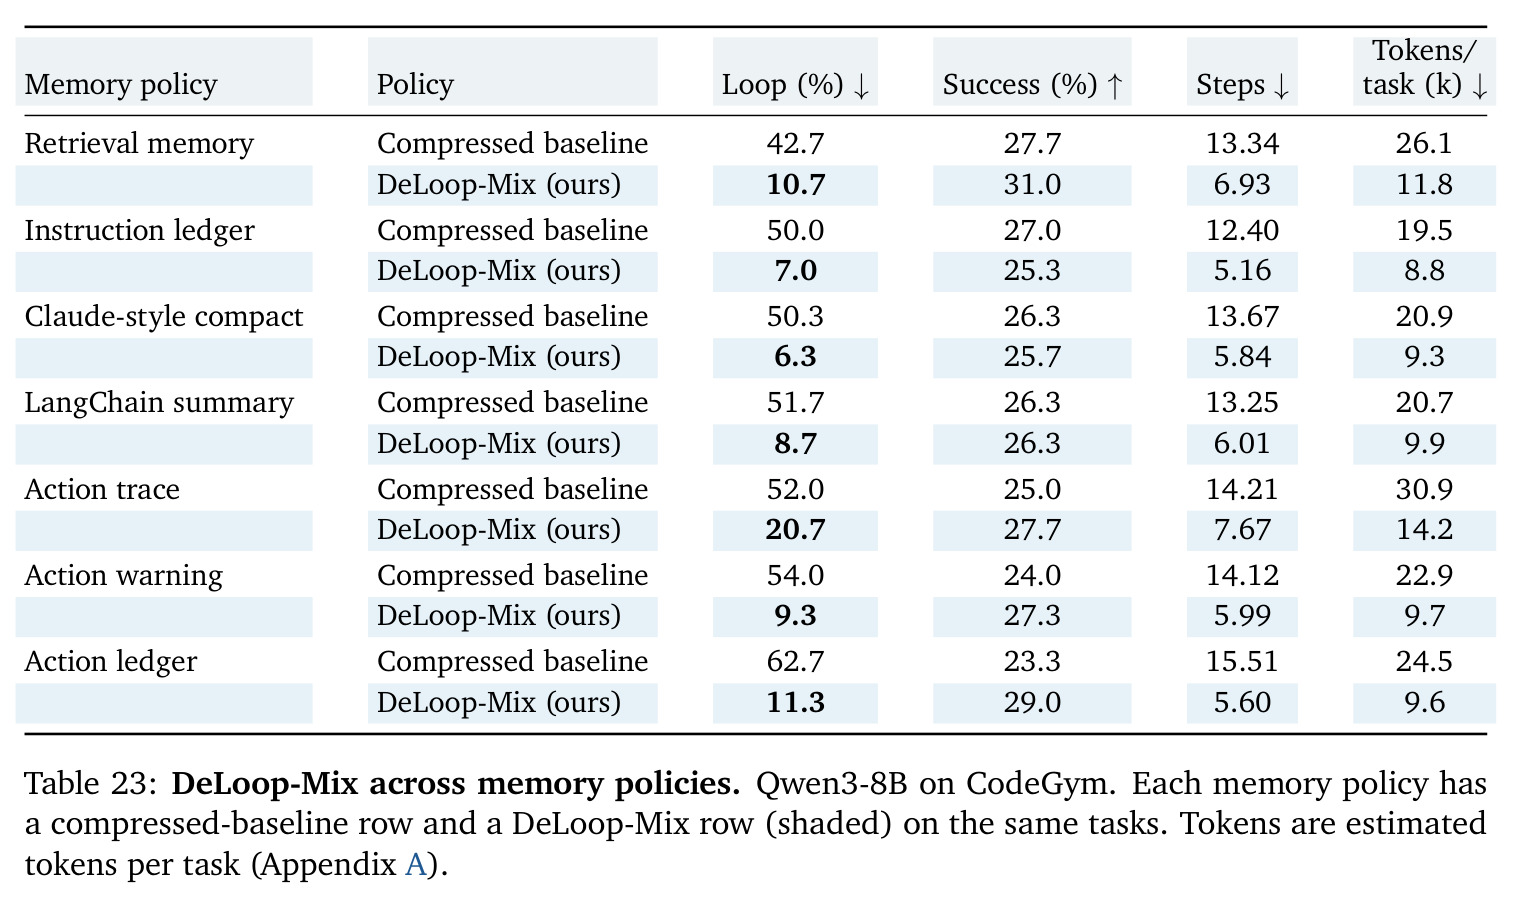
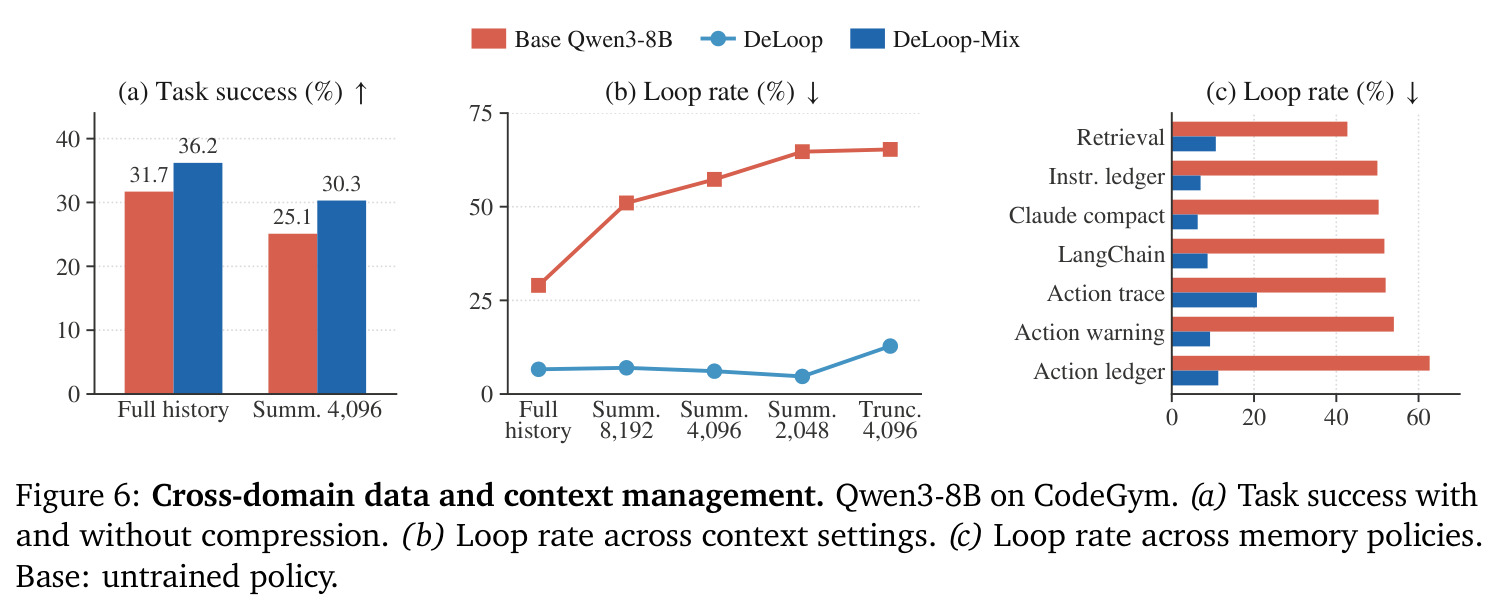
长程智能体经常重做已完成的工作:以相同参数重复调用同一工具、收回一字不差的观察,这一步不产生任何新信息,作者将其正式命名为“循环(loop)”。它在 Qwen、Llama、Gemini 各家模型中原生存在,且上下文压缩使其急剧恶化:CodeGym 上 Qwen3-8B 的循环率(含至少一次循环的任务占比)在全历史下为 29.0%,4,096 token 摘要下升至 57.3%,2,048 token 下 64.7%,截断下达 65.3%,每任务循环动作数增加逾 3.5 倍。循环还与失败强相关:六个模型平均 59.5% 的循环运行失败,无循环运行仅 33.4%(Qwen3-8B 为 85% 对 68%,Gemini 3.1 Pro 为 48% 对 12%);循环运行平均多执行 10.5 个动作、多耗约 11k token。现有对策全部失效:七种记忆/压缩策略(含显式动作台账)循环率仍达 50.0%–62.7%;精确重复拦截器只挡执行不挡生成,71.3% 的任务仍提出已执行过的调用;Reflexion 等推理时控制留在 55.3%–58.7%;带标签训练基线要么依赖任务成败或金标动作,要么信号稀疏(gold-action GRPO 仅 2.7% 的组有梯度)。
本文的目标是作者要训练策略本身去利用历史中“已执行动作”的记录来避免重复,并施加严格的监督约束:不允许使用任务奖励、标准答案、专家演示、步级标签或 LLM 裁判,唯一允许的信息是智能体自己的动作-观察流。量化目标是在大幅降低循环率与交互成本(每任务步数和 token)的同时保持任务成功率不下降,并要求该修复能跨模型规模(Qwen3-8B/9B/14B/32B 与 Llama-3.1-8B)、跨上下文设置(全历史到 2,048 token 摘要与截断)、跨七种记忆策略、跨 ALFWorld、Open-AgentRL、AppWorld、ScienceWorld、Terminal-Bench、BrowseComp-Plus 等环境稳定迁移,且不损伤 LiveCodeBench、MT-Bench、IFEval 上的通用能力。
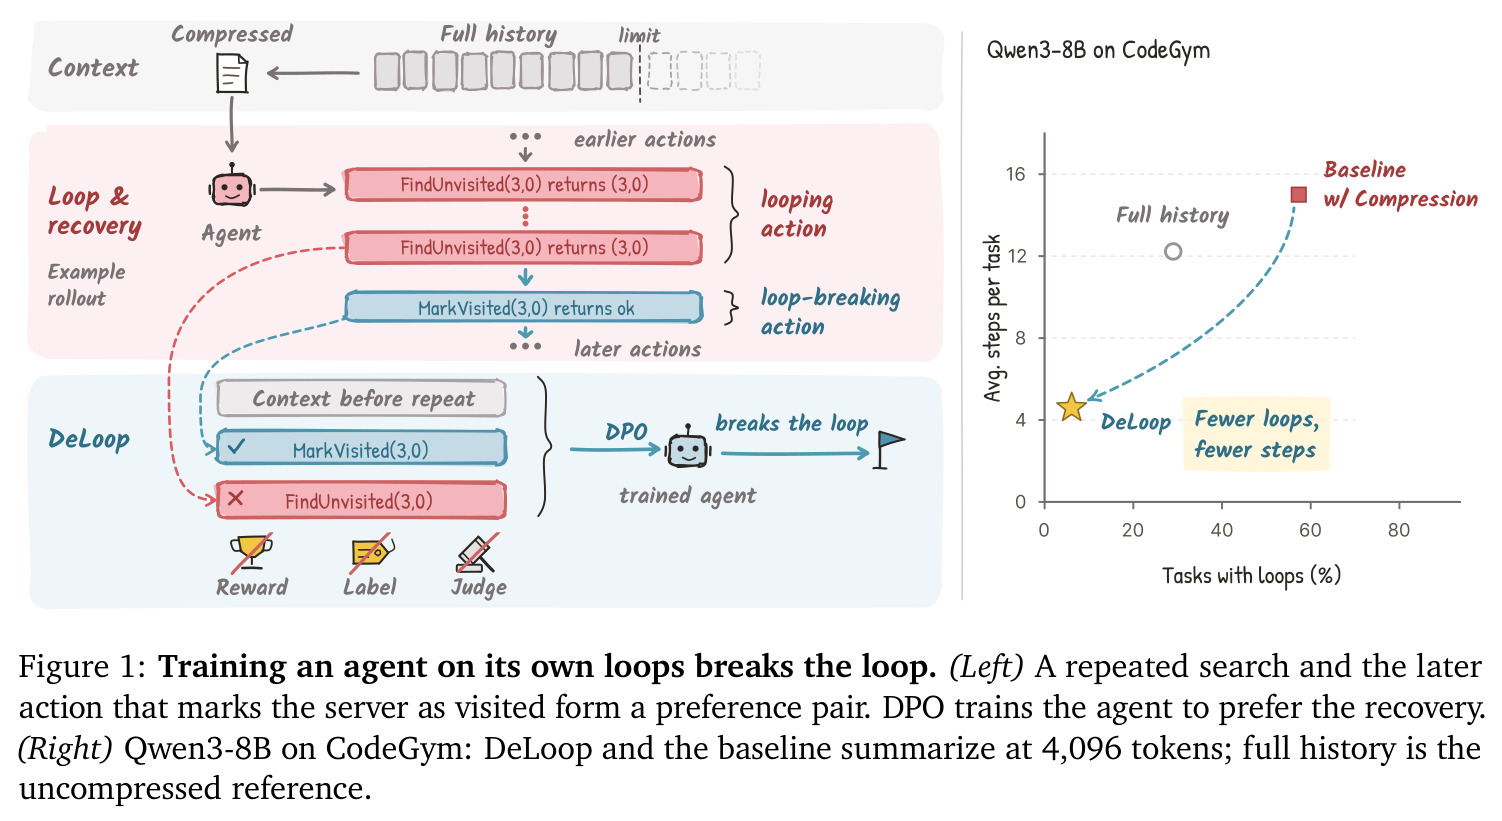
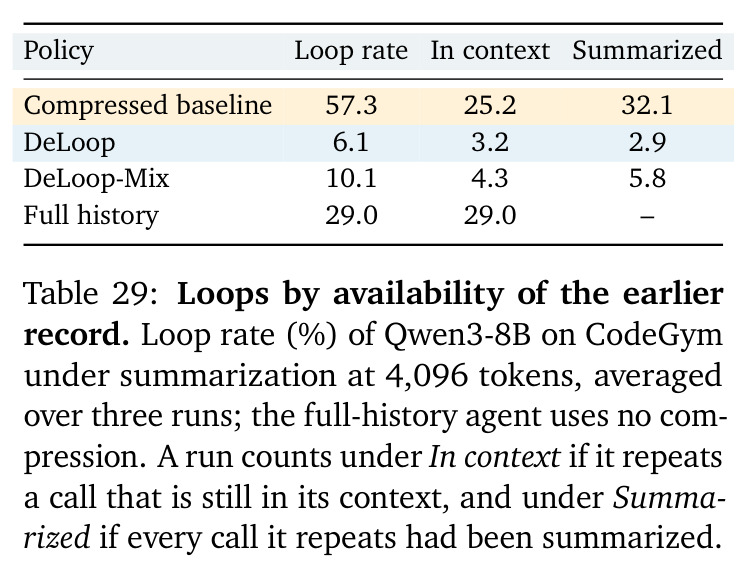
与已有工作不同的是,独特之处在于把“失败本身”当作监督信号。作者观察到循环是轨迹层面可由结构化规则直接识别的事件(同调用、同观察),无需事后失败归因;而同一个 rollout 内智能体稍后的脱困动作天然构成正例,于是“循环动作=拒绝样本、首个脱困动作=选择样本”即可构成免标注偏好对,用 DPO 训练。这同时避开两条主流路线的盲区:上下文管理研究“保留什么历史”,本文问“策略是否真的使用被保留的历史”——实验证明摘要即使显式记录已执行动作,循环率仍达 52.0%–62.7%,说明瓶颈在策略而非记忆;推理时拦截/反思不改变策略,本文直接改参数。思想上与事后经验回放(HER)呼应——能从失败轨迹中学习,但输出是偏好对而非回放目标;8,000 个训练对中 82.6% 来自最终失败的任务,错误轨迹本身就是富矿。
核心方法
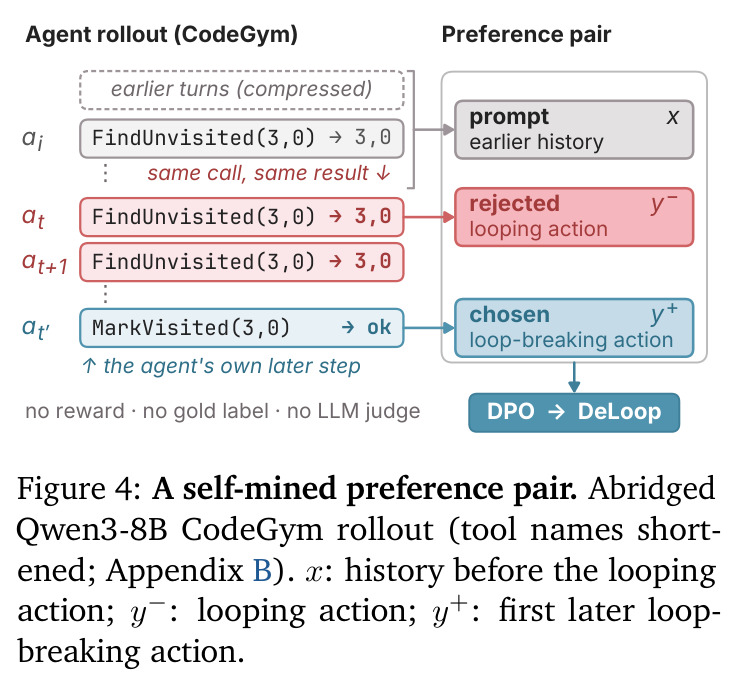
直觉:一个已经掉进循环的 rollout 里同时藏着“错误示范”(反复重发的调用)和“正确示范”(之后终于打破循环的那一步),把两者配成偏好对喂给 DPO,智能体就能从自己的错误里学会脱困,全程不需要任何外部标签。技术路线四步走:第一步给出循环的结构化定义——第 $t$ 步签名为 $x_t=(\kappa(a_t),o_t)$,$\kappa$ 对工具调用做空白与参数顺序规范化,$x_t$ 与更早某步相同则 $s_t=1$,轨迹含任一 $s_t=1$ 即为循环轨迹(同调用但观察不同不算循环,那可能是有价值的状态复查);第二步在压缩设置(4,096 token 摘要)下跑训练任务采集 rollout 并按此规则挖偏好对;第三步用 LoRA DPO 训练策略;第四步推理时仍用同一套压缩 harness,由训练后的模型既生成动作又写摘要,压缩机制本身不变。
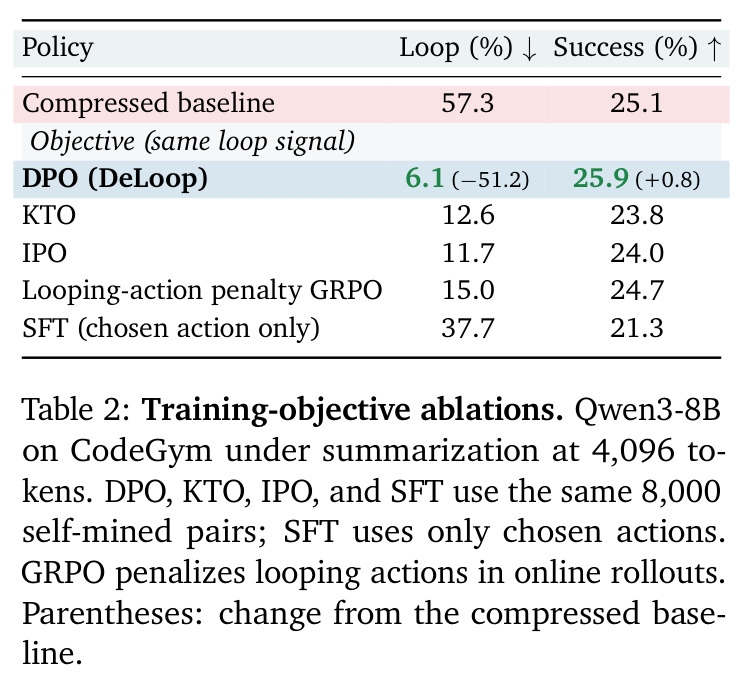
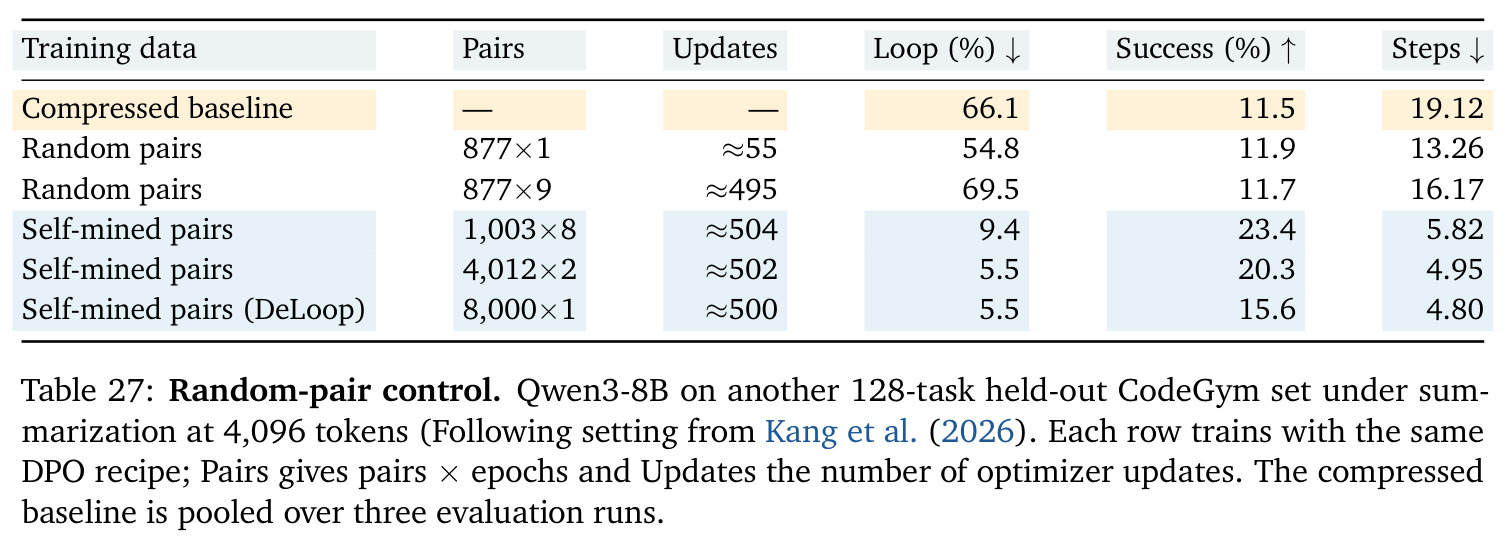
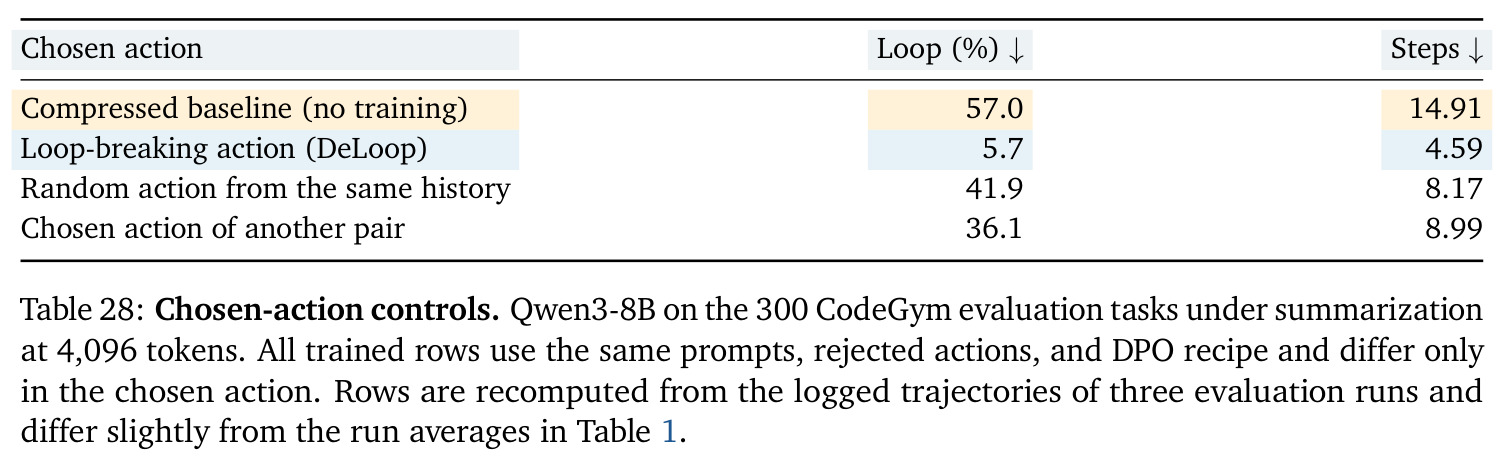
核心创新是“循环自我标注”:$x=h_{t: s_u=0,\ \kappa(a_u)\neq\kappa(a_t)\}$,即同一 rollout 内首个既非循环、又不是同一调用的后续动作。与已有方法的本质区别在监督来源:ETO/Agentic-DPO 需要专家动作,Step-DPO/IPR 需要步级标签或奖励,GRPO 需要任务奖励(gold-action 下仅 2.7% 的组有梯度),DeLoop 唯一的“标签”就是精确重复规则。消融证明配对两侧缺一不可:只模仿脱困动作的 SFT 残留 37.7% 循环率;换成随机选择动作 41.9%、用别的对的 36.1%,真正的脱困动作才降到 5.7%;随机配对训练越久越糟(54.8%→69.5%)。附录 H.3 从梯度解释:$\nabla_\theta\mathcal{L}=-\beta g\,\nabla_\theta\log\pi_\theta(y^+|x)+\beta g\,\nabla_\theta\log\pi_\theta(y^-|x)$($g=\sigma(-\beta z_\theta)$),第一项单独即 chosen-only SFT,压不住循环;加似然锚稀释对比项,循环率从 6.1% 回升至 27.0%。
方法步骤详情
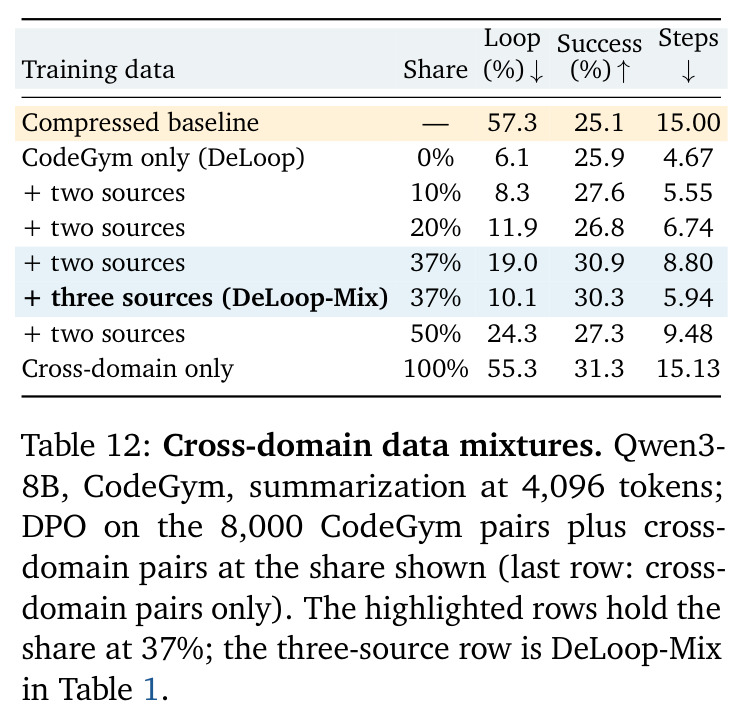
完整流程:第一步采集——在 CodeGym 训练任务上运行压缩智能体(历史估超 4,096 token 触发摘要,同一模型以温度 0 写摘要并保留系统提示、任务与最近 6 条消息;贪心解码、30 轮预算);第二步检测——逐步计算签名 $x_t=(\kappa(a_t),o_t)$ 与历史比对,$\kappa$ 归一化空白与参数顺序、观察须逐字节相同;第三步配对——对每个循环动作 $a_t$ 取 $t'=\min\{u>t: s_u=0,\kappa(a_u)\neq\kappa(a_t)\}$ 为脱困动作,未脱困则弃用该对,一个 rollout 可贡献多对,共挖 9,403 对、取 8,000 训练;第四步训练——LoRA($r=32,\alpha=64$)+ DPO,$\beta=0.05$(经 128 任务筛选集选定),学习率 $8\times10^{-6}$,有效 batch 16,序列长 4,500,1 个 epoch;14B/32B 同规则各挖 2,331/2,244 对、训 2 epoch;第五步推理——整个 rollout 用训练后策略生成动作,压缩机制不变。变体 DeLoop-Mix 另加 4,635 个跨域对(ALFWorld、Open-AgentRL、Terminal-Bench,合计 12,635 对),跨域占 37% 时最佳。
技术新颖性
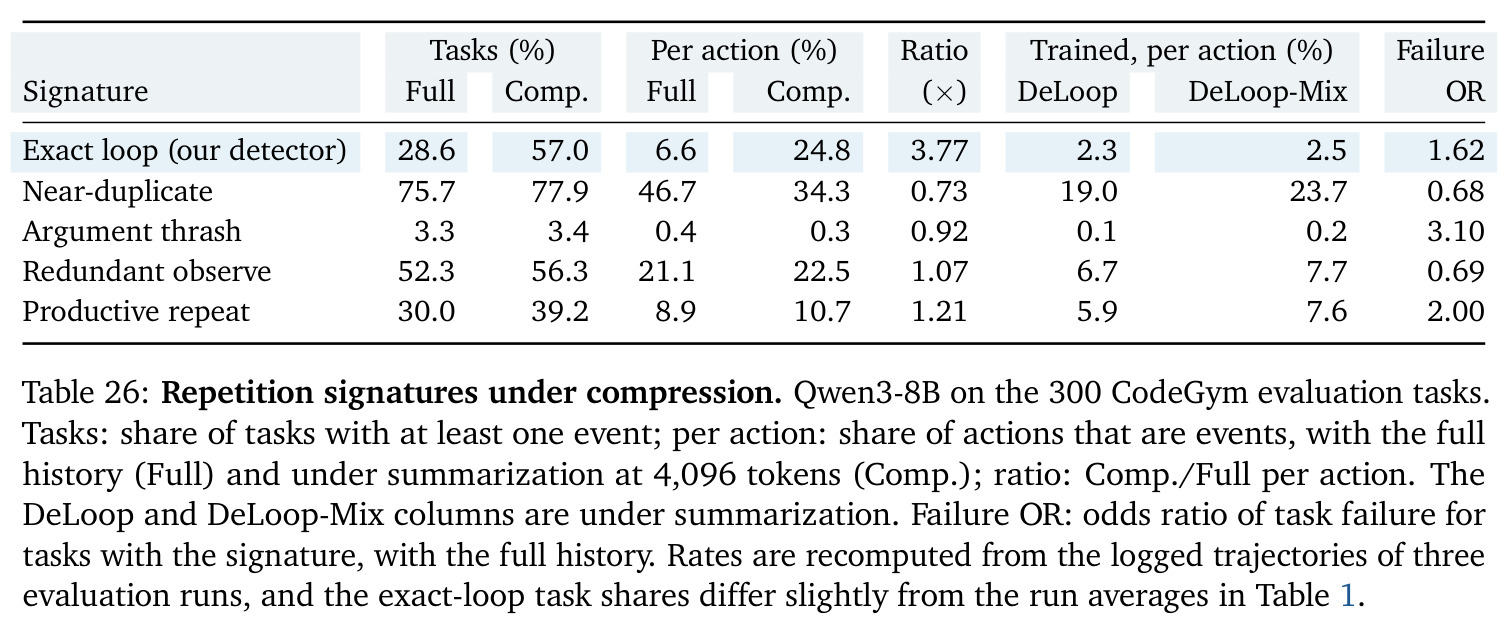
新颖性有四层。其一,问题形式化:首次把“循环”定义为可从动作-观察流结构化判定的事件,并用数据证明它是压缩放大最猛的重复签名(动作占比 6.6%→24.8%,3.77 倍;近重复仅 0.73 倍、冗余观察 1.07 倍);还给出“活动上限”命题——若策略无法区分重复与新动作(歧义度 $\delta>0$),把期望循环数压到 $\varepsilon$ 内必然要求压缩后有效工作量 $E[W_c]\le\varepsilon/\delta$,即“不区分就只能少干活”。其二,免标注监督:与一切需要奖励、金标、裁判或专家动作的训练方法不同,挖掘器只读动作与观察流。其三,配对构造利用同一 rollout 内的自身恢复,与 HER 同样能从失败中学习(82.6% 的对来自失败 rollout),但输出是 DPO 偏好对而非离线回放目标;与 RLTR 等只“惩罚冗余”的方法不同,DeLoop 同时给出替代动作。其四,与压缩正交:固定压缩器、只改策略,在全部 7 种记忆策略与 5 种上下文设置下一致有效,与 Min et al. 改压缩提示词的路线互补。
实验结果
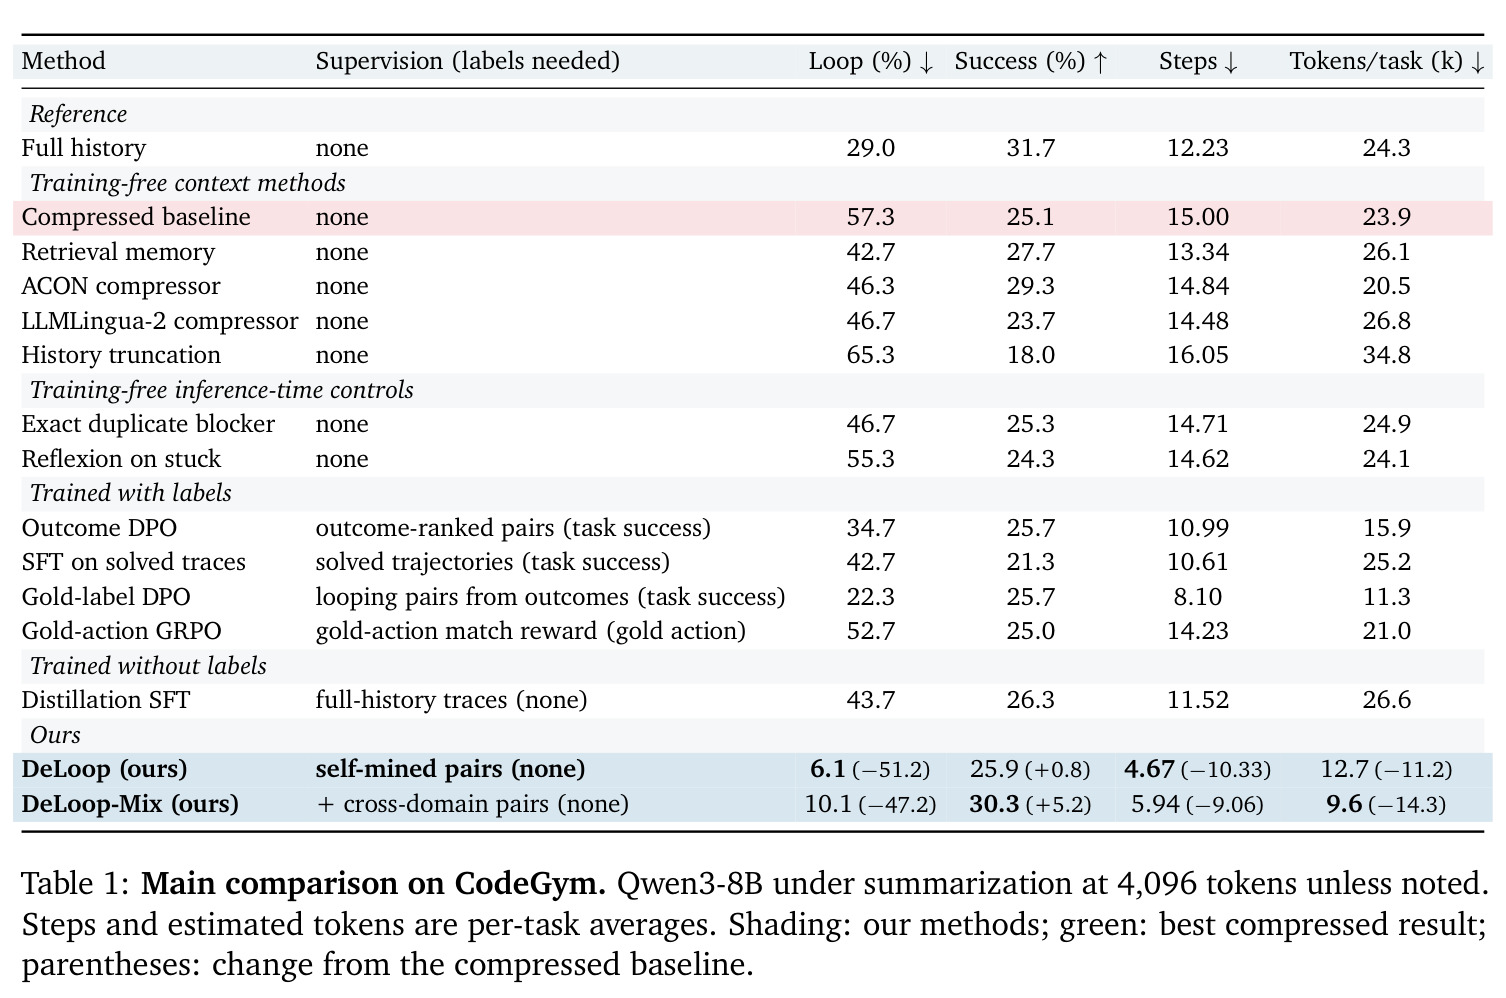
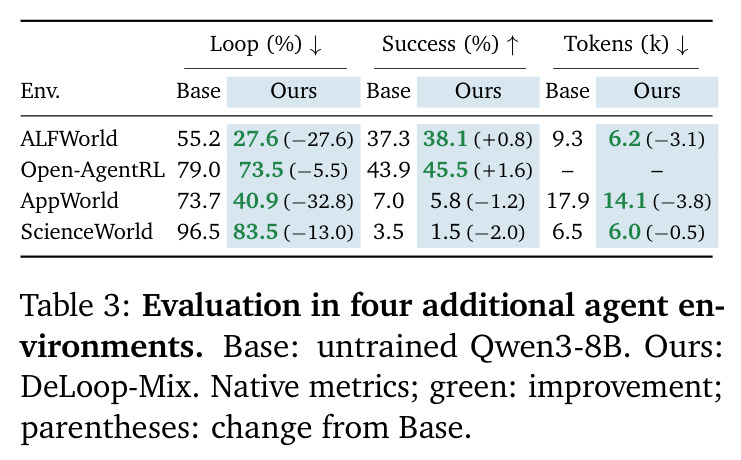
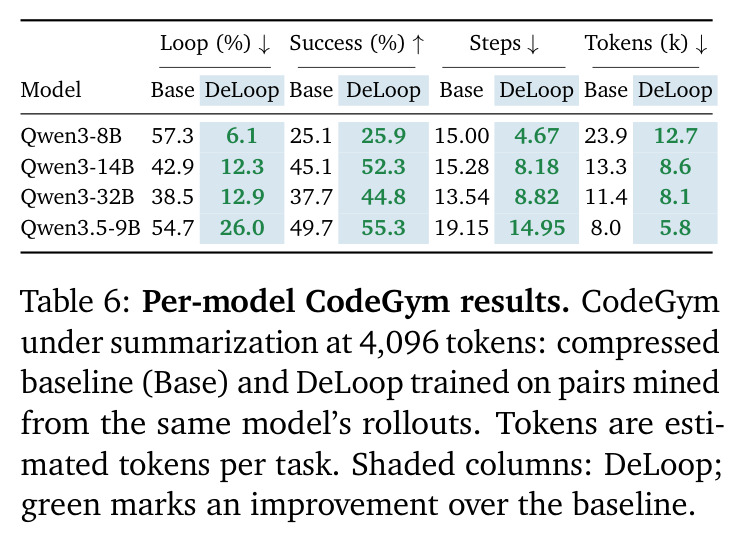
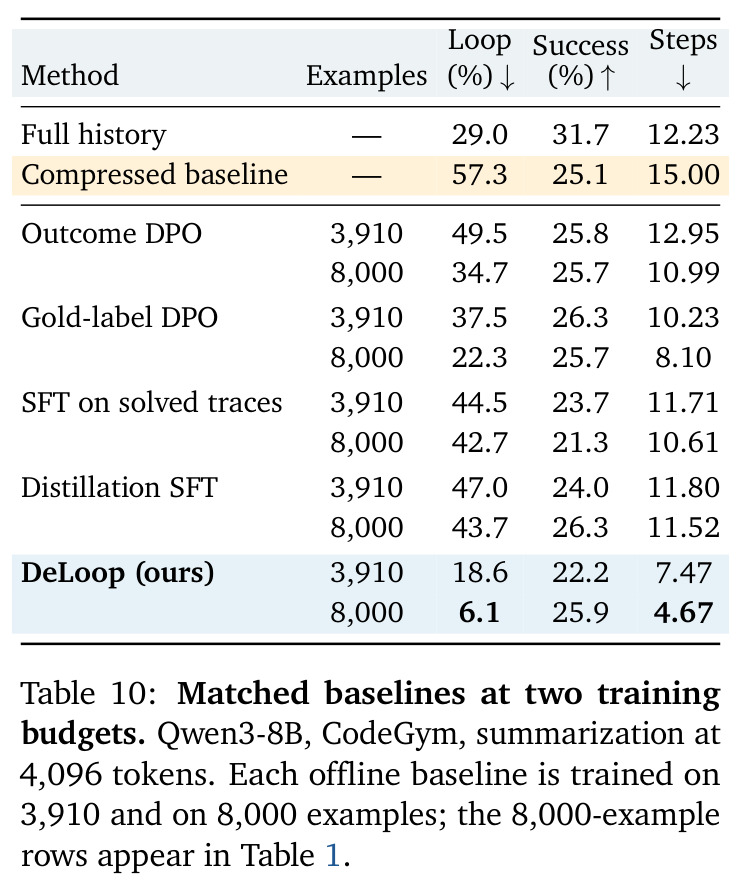
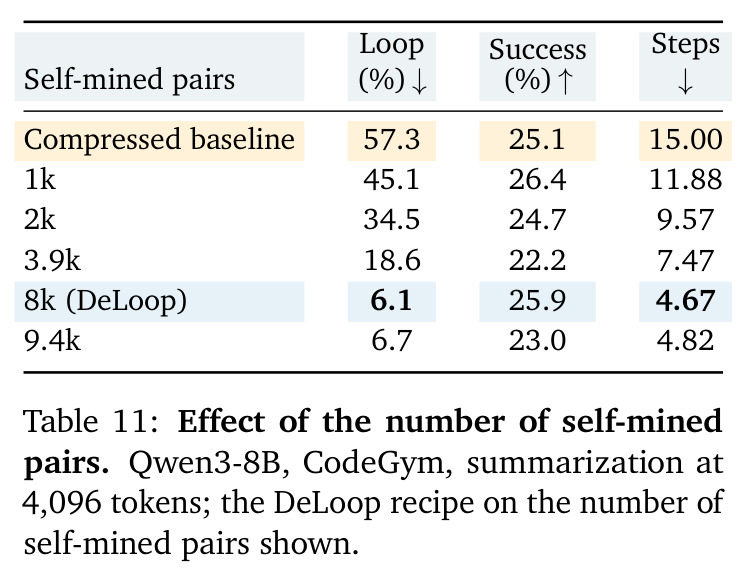
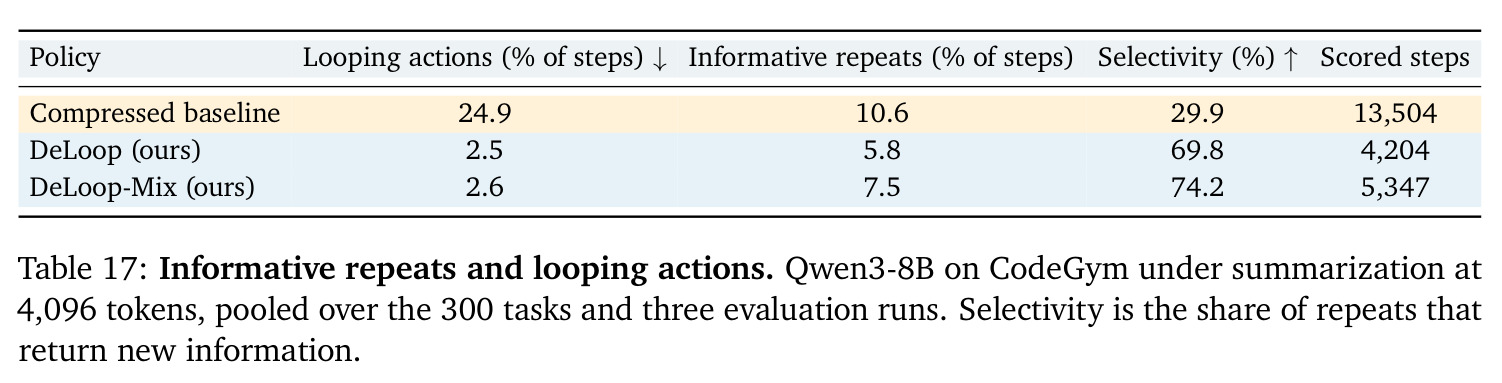
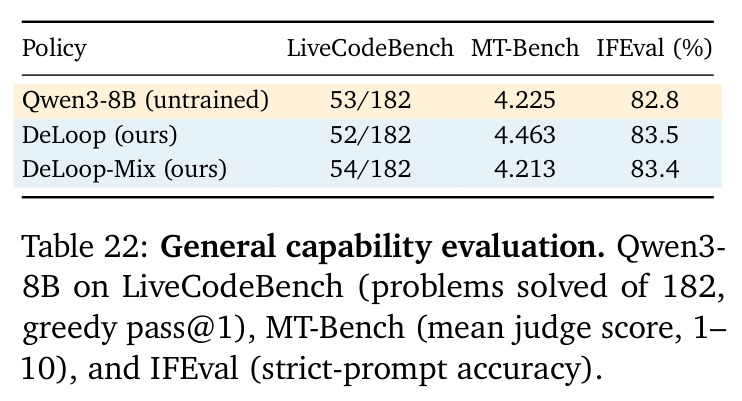
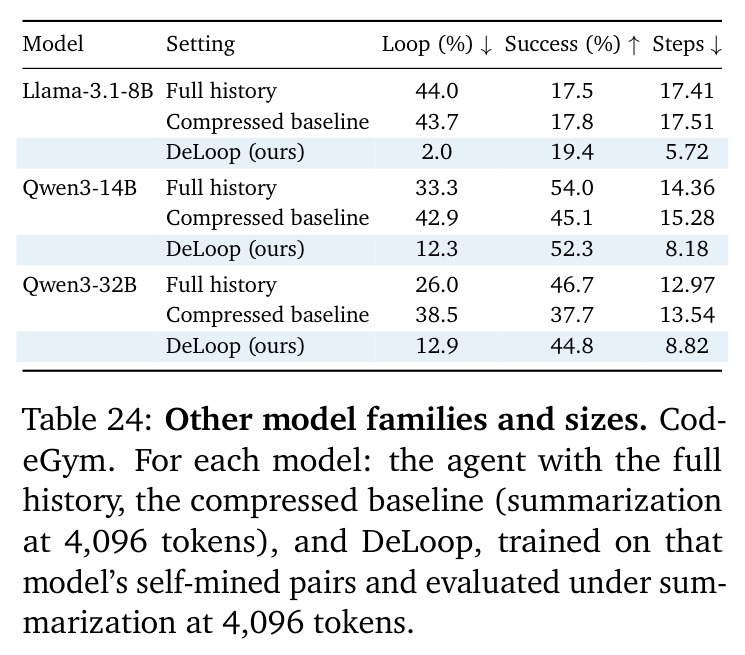
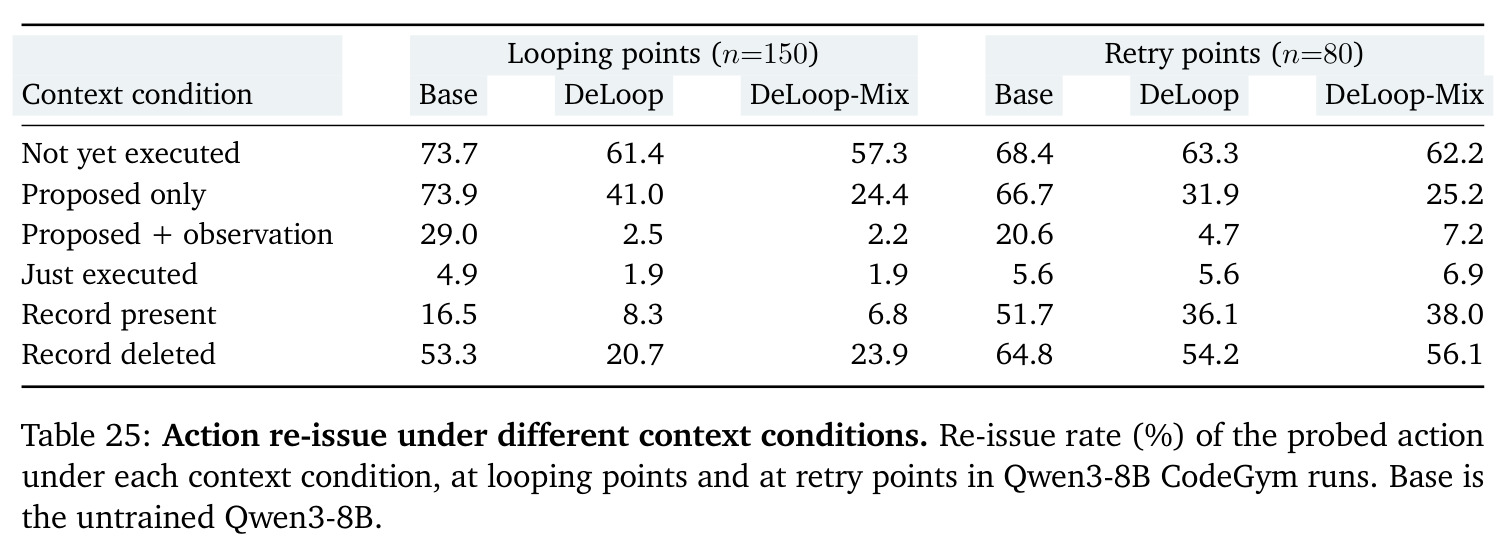
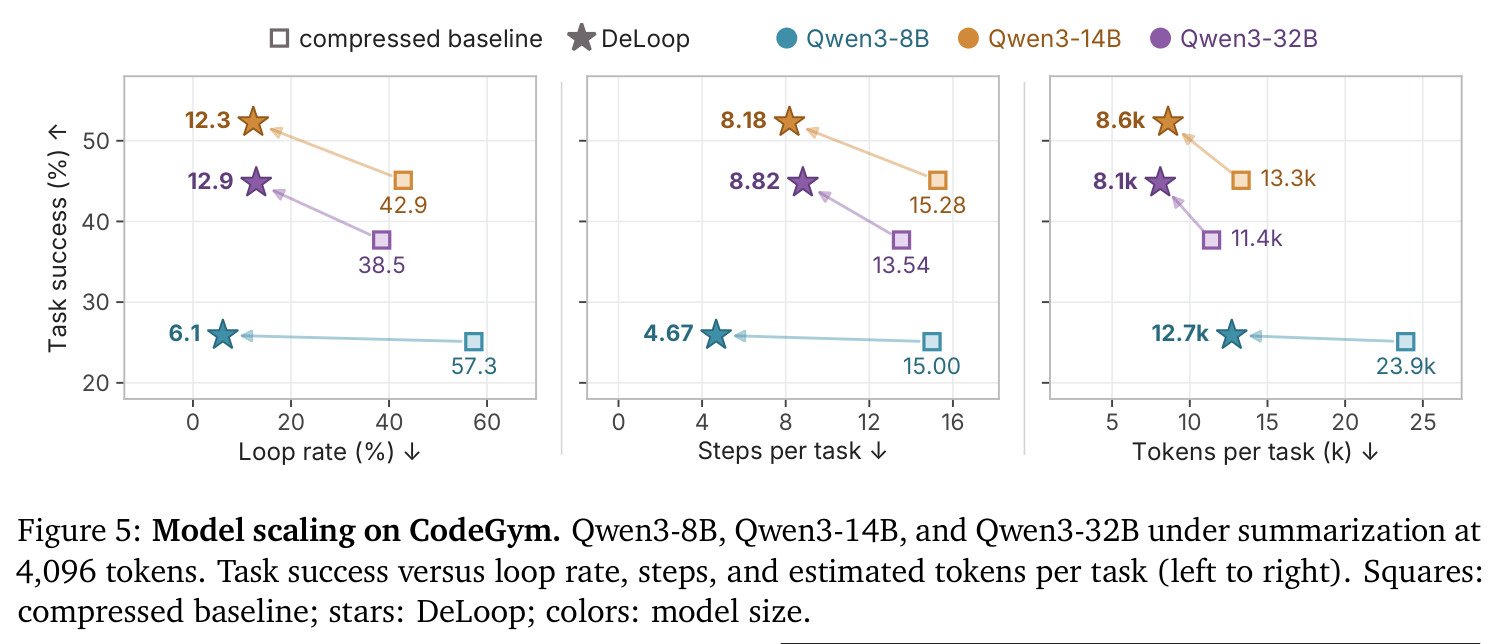
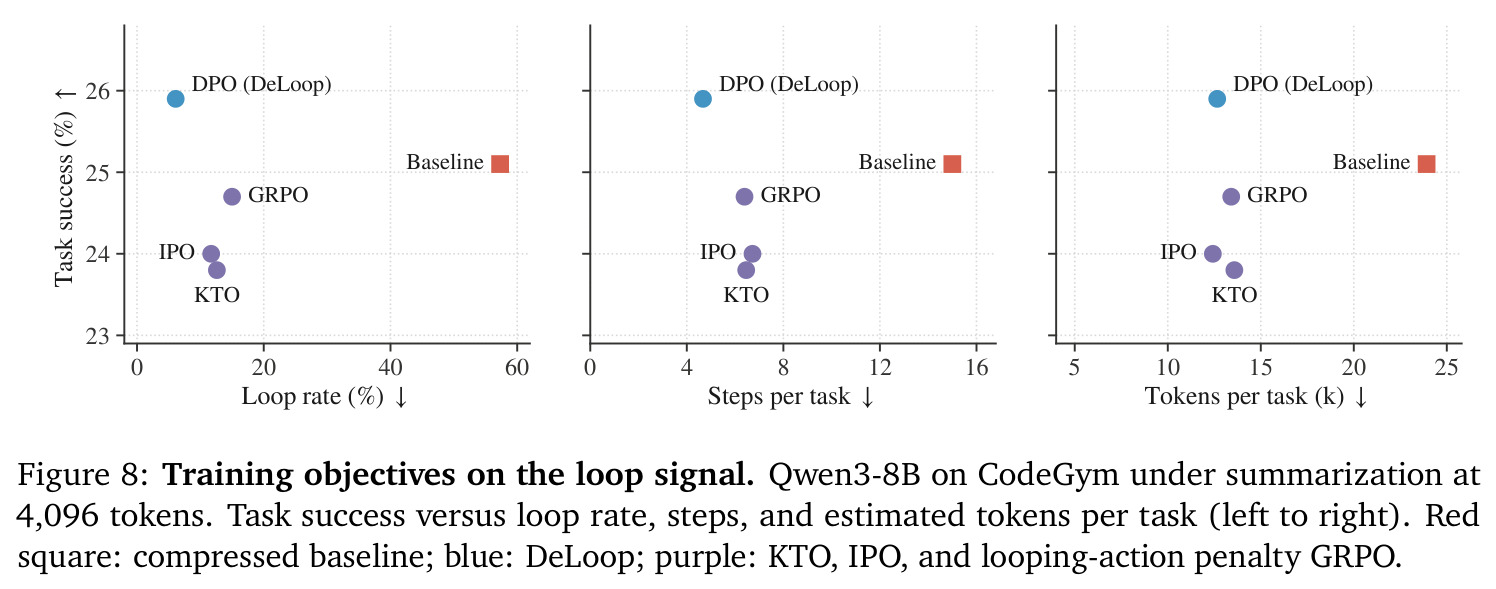
主实验(Table 1,Qwen3-8B,CodeGym 300 保留任务,4,096 摘要):循环率 57.3%→6.1%(9.4 倍),步数/任务 15.00→4.67,token/任务 −47%,成功率持平(25.1%→25.9%);免训练上下文方法循环率 42.7%–65.3%,最强带标签基线 gold-label DPO 也只到 22.3%。模型扩展:14B 循环率 42.9%→12.3%、成功率 +7.2(→52.3%),32B 38.5%→12.9%、成功率 +7.1(→44.8%),Llama-3.1-8B 43.7%→2.0%,Qwen3.5-9B 成功率 +5.6。目标函数消融(同 8,000 对):KTO 12.6%、IPO 11.7%、循环惩罚 GRPO 15.0%,DPO 6.1% 最优,chosen-only SFT 残留 37.7%。数据规模:1k/2k/4k/8k 对对应循环率 45.1%/34.5%/18.6%/6.1%,8k 后饱和。跨域对占 37% 时成功率升至 30.3%(DeLoop-Mix),换公开轨迹(SWE-agent/OpenHands/WebArena)循环率也降至 17.3%–22.7%。泛化:四个环境循环率全降(AppWorld −32.8 点),Terminal-Bench 无效重复 16.6→6.9 次/任务,BrowseComp-Plus 上 22.4%→1.2% 且精度持平,32B 零样本迁移 ALFWorld 成功率 33.6%→42.5%。机制上选择性(重复返回新信息的比例)29.9%→69.8%,同长度任务(6–10 步)循环率 33.2%→13.1%,排除“只是回合变短”的解释;通用能力不退化(LiveCodeBench 53→52/54,MT-Bench 4.225→4.463,IFEval 82.8%→83.5%)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| CodeGym(Qwen3-8B,4,096 摘要压缩) | 循环率(含循环任务占比)↓ | 6.1% | 57.3%(压缩基线) | −51.2 个百分点(9.4 倍) |
| CodeGym(Qwen3-32B) | 任务成功率 ↑ | 44.8% | 37.7% | +7.1 个百分点,循环率同时 38.5%→12.9% |
| CodeGym(Qwen3-14B) | 任务成功率 ↑ | 52.3% | 45.1% | +7.2 个百分点,循环率同时 42.9%→12.3% |
| CodeGym(Qwen3-8B) | 步数/任务 ↓ | 4.67 | 15.00 | −68.9%,token/任务 23.9k→12.7k(−47%) |
| BrowseComp-Plus(830 个查询,DeLoop-Mix) | 循环率 ↓ | 1.2% | 22.4% | −21.2 个百分点,检索精度与未训练模型持平 |
| Terminal-Bench(原生 harness) | 无效重复调用次数/任务 ↓ | 6.9 | 16.6 | 约 −58% |
| ALFWorld(Qwen3-32B 零样本迁移) | 任务成功率 ↑ | 42.5% | 33.6% | +8.9 个百分点,循环率 64.9%→54.5% |
局限与改进
作者承认的局限:8B 上成功率基本不动(+0.8),循环修复省的是成本、不直接买来能力,实质成功率增益要到 14B/32B 才显现;AppWorld(−1.2)与 ScienceWorld(−2.0)成功率反而略降,后者基线循环率高达 96.5%,说明环境本身重复性极强;循环率未降到零(6.1%),且定义只覆盖精确重复,近重复调用(77.9% 的压缩任务中存在)等更宽泛的重复签名仍在;配对要求 rollout 内自行恢复,循环到底不回头的轨迹产生不了样本。我自己的观察:检测依赖观察逐字节相同,$\kappa$ 只归一化空白与参数顺序,遇到带时间戳/随机 id 的非确定性返回会漏检,而放宽到语义相似又有误杀风险——productive repeat 与任务失败的 odds ratio 达 2.00,合理复查不可一刀切;超参较敏感($\beta=0.01$ 时成功率跌到 16.3%,更大学习率把循环率压到 0.7% 但成功率降到 19.3%),存在过度压制探索的权衡;评测多为 300 任务且部分行仅单次运行,方差报告不足;训练对挖自基线 rollout,分布受基线自身缺陷偏置;跨域收益依赖混合比例调参(37% 最优,100% 跨域时循环率反弹到 55.3%)。
独立分析的弱点
独立分析四个弱点。第一,“省钱不涨分”:8B 成功率仅 +0.8,循环修复只回收被浪费的预算,若瓶颈在规划与推理能力则无能为力——可把省出的步数预算转投结果奖励 RL 或更难的课程学习。第二,精确匹配定义覆盖不足:argument thrash(A–B–A 参数振荡)与失败的相关性最强(odds ratio 3.10)却几乎不被检测(仅占 0.3% 动作),非确定性观察也会漏检——改进方向是对观察做结构化字段抽取与噪音字段掩蔽的分层规范化,并为“有信息重复”保留豁免通道。第三,依赖 rollout 内恢复:那些从头循环到尾的轨迹没有监督价值——可跨 rollout 借用相似状态下的脱困动作,或用反事实重放生成假想脱困动作来扩充配对。第四,离线一次性训练:策略更新后循环模式随之漂移,静态 8,000 对可能过时——论文的在线尝试(循环惩罚 GRPO)只到 15.0%,可探索迭代式“采集→挖掘→训练”自举、在线 DPO 或循环感知的过程奖励模型;另外 8B 的成功率平台期也提示循环修复与能力训练应当解耦编排,消融显示 SFT 放在 DPO 之后会把循环率从 6.5% 重新拉回 29.7%,训练顺序本身就是一个待优化问题。
未来方向
作者明确提出希望帮助社区更好地理解和减少长程智能体循环,代码与数据将公开。基于成果可延伸的方向:其一,压缩器与策略联合优化——本文固定压缩器只改策略,而活动上限命题($E[W_c]\le\varepsilon/\delta$)暗示降低歧义度 $\delta$ 的上下文表示(如结构化动作台账)与策略训练结合可进一步逼近零循环,数据也支持:DeLoop-Mix 在全部 7 种记忆策略下有效,与 action ledger 组合把循环率压到 11.3% 且成功率 +5.7 点。其二,与推断时防护叠加:精确重复拦截器 + DeLoop 已示范循环率 1.3%、成功率 27.7%,值得系统搜索防护组合。其三,循环信号在线化:episode 级稀疏奖励使 47.3% 的 GRPO 组无梯度,可设计循环感知的过程奖励或在线迭代挖掘。其四,把定义扩展到语义级重复与多智能体重复通信(MAST 已把步重复列为多智能体失败模式),以及非确定性环境下的鲁棒检测。其五,跨域配对的 scaling law:Table 12 显示 37% 跨域占比最优,数据混合比例与域距离的关系值得系统研究。其六,把“失败自标注”思想迁移到其他可结构化检测的失败模式,如无界代码路径、过早停止。
复现评估
复现条件总体友好。论文声明代码与数据将公开(Code and data will be publicly available);依赖均为公开资产:CodeGym、ALFWorld、AppWorld、ScienceWorld、Terminal-Bench、BrowseComp-Plus,以及 Qwen3-8B/14B/32B、Llama-3.1-8B 开源权重(Gemini 仅用于诊断、需 API)。训练配方完整:LoRA $r=32,\alpha=64$、$\beta=0.05$、学习率 $8\times10^{-6}$、有效 batch 16、序列长 4,500、1 epoch、8,000 对。主要门槛有二:一是 harness 工程——压缩触发逻辑(超 4,096 token 摘要、保留系统提示+任务+最近 6 条消息)与循环检测器的规范化规则(空白/参数顺序归一、观察逐字节比较)必须精确复刻,否则数字不可比;二是挖掘算力——需先跑基线 rollout 采集训练任务(论文未给训练任务规模与 GPU 时数),8B LoRA 单卡级可训,14B/32B 各挖 2,331/2,244 对并训 2 epoch。总体难度中等:算法一页纸即可实现,工作量集中在复刻一致的智能体 harness 与含逐步压缩事件的轨迹日志上。
论文图表
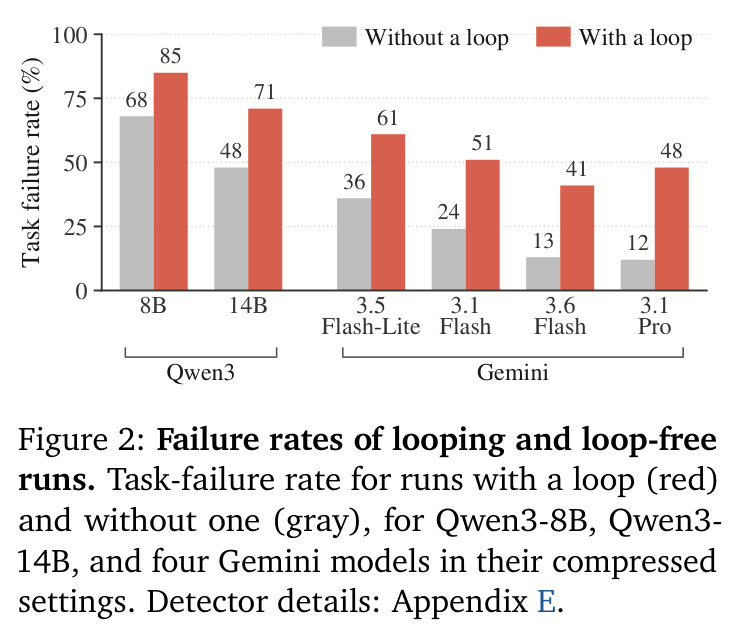
六个模型在其压缩设置下按是否含循环拆分的任务失败率:Qwen3-8B 85% 对 68%、Qwen3-14B 70.8% 对 47.7%、Gemini 3.5 Flash-Lite 61.1% 对 36.5%、3.1 Flash 51.3% 对 23.9%、3.6 Flash 41.4% 对 12.8%、3.1 Pro 48% 对 12%;六模型平均循环运行失败率 59.5%,无循环运行仅 33.4%。
建立“循环与任务失败强相关”这一核心动机证据,说明循环不只是浪费、更是失败信号。
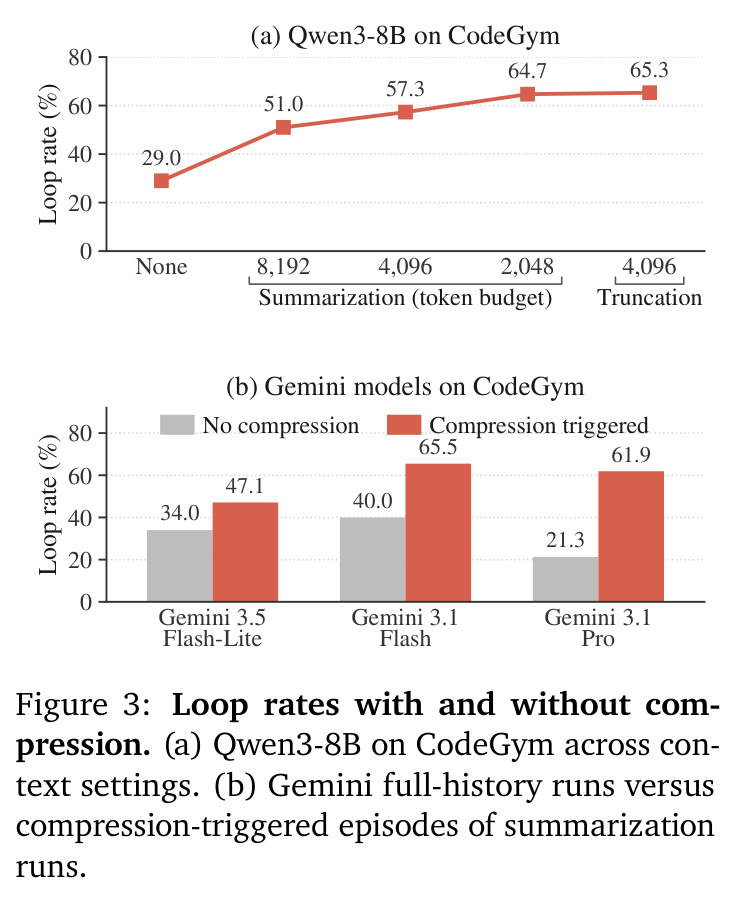
(a) Qwen3-8B 在 CodeGym 上:全历史 29.0%,摘要 8,192/4,096/2,048 token 下分别为 51.0%/57.3%/64.7%,截断 65.3%;(b) 三个 Gemini 模型的全历史对比压缩触发片段:Flash-Lite 34.0%→47.1%、Flash 40.0%→65.5%、Pro 21.3%→61.9%,Pro 全历史循环最少但增幅最大(2.9 倍)。
证明上下文压缩是循环的放大器,这一实证发现直接引出“训练策略而非改良压缩”的技术路线。
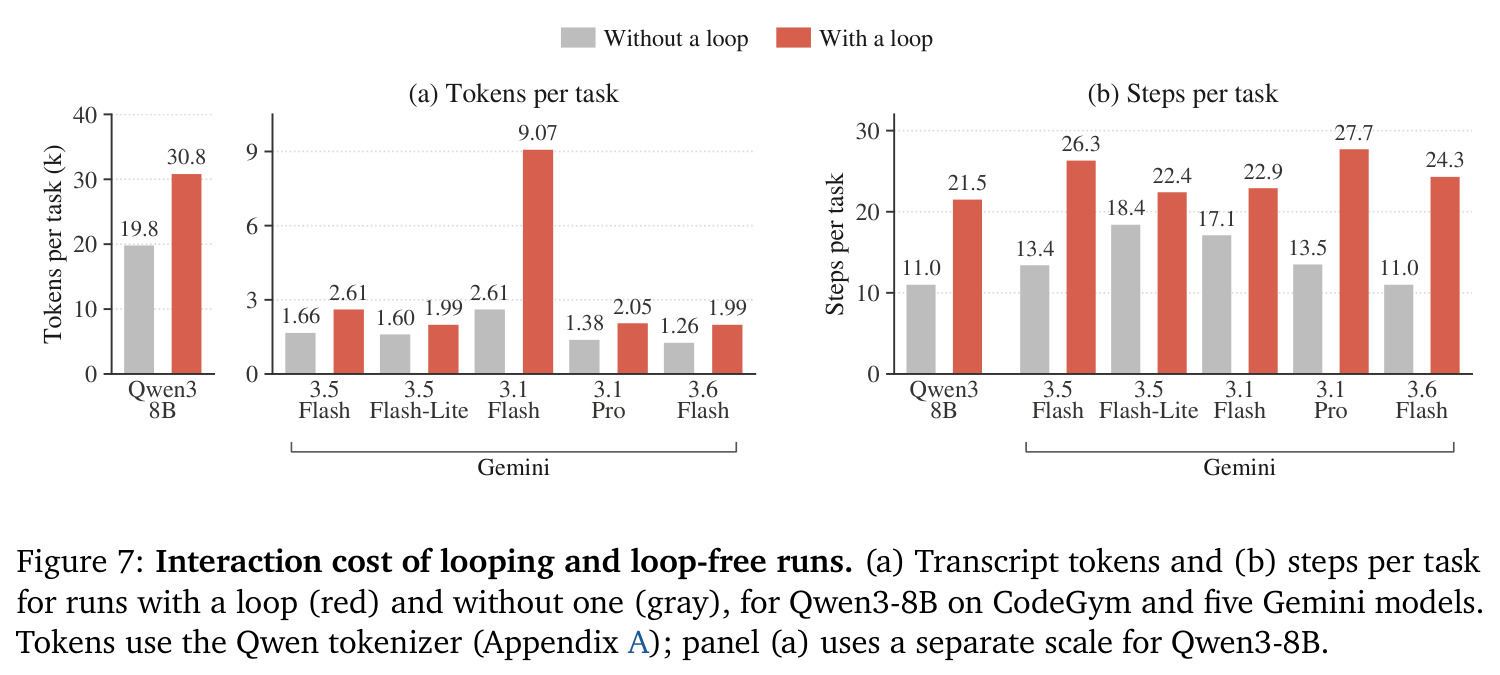
Qwen3-8B 与五个 Gemini 模型上,含循环运行的 transcript token(a)与步数/任务(b)均显著高于无循环运行:Qwen3-8B 循环运行多约 11k token、平均多执行 10.5 个动作,该模式在全部六个模型上一致(如 Gemini 3.6 Flash 为 1.38 对 2.05 步量级差异)。
量化循环的交互成本,把“降循环”与真实的 token/步数开销节约直接挂钩。