ClawLoop:基于Harness原生训练闭环的自改进智能体 ClawLoop: Self-Improving Agents via Harness-Native Training Loop
无需外部教师模型,智能体在沙箱内自造任务、自我训练、自我诊断,形成闭环持续进化。
前置知识
Harness(智能体执行框架)
指为 LLM 智能体提供沙箱化执行环境的软件框架(如 OpenClaw、Claude Code),通常是一个带 POSIX shell、文件系统、包管理器和网络隔离的 Docker 容器,外加工作区供给与轨迹记录 API。与传统 tool-use 智能体只能调用预定义工具不同,harness 智能体可直接执行任意命令、编辑文件、多步推理,任务空间是文件操作、命令执行与技能调用的开放式组合。
本文闭环的三个阶段全部运行在同一 harness 内,训练与推理分布一致。不理解 harness 就无法理解“原生训练回路”的含义,也无法理解任务形式化 $ au = \langle p, s_0, \mathcal{A}, \mathcal{F}, \mathcal{V}_\tau \rangle$ 中工作区状态与动作空间的额外复杂度。
GRPO(组相对策略优化)
DeepSeekMath 提出的在线强化学习算法:对每个任务采样 $N$ 条轨迹构成一组,用组内奖励的均值和标准差做基线归一化得到优势 $\hat{A}_j^{(i)} = (r_j^{(i)} - \bar{r}^{(i)}) / (\sigma_r^{(i)} + \epsilon)$,无需训练价值网络。当组内轨迹全对或全错时标准差 $\sigma_r$ 坍缩、优势为零,该任务不产生任何梯度。
ClawLoop 的准入带设计(只保留 8 次 rollout 中通过 1–5 次的任务)正是为了筛选组内有分歧、GRPO 有信号的任务;这也是理解小模型为何主要靠 RL 阶段提升的关键。
自蒸馏 SFT 与多轮损失掩码
用模型自己生成的成功轨迹(奖励 $r=1$)做监督微调,而不是模仿外部教师的示范。多轮智能体训练中,用逐 token 掩码 $m_t$ 把环境观察 token(工具输出、文件内容)置零,损失 $\mathcal{L}_{\text{SFT}} = -\sum_{i: r_i=1} \sum_{t=1}^{T_i} m_t^{(i)} \log \pi_\theta(a_t^{(i)} \mid p_i, s_0^{(i)}, a_{1:t-1}^{(i)}, s_{1:t-1}^{(i)})$ 只作用于智能体自己的动作 token。
harness 轨迹里单次文件读取或构建日志可达数千 token,不做掩码会淹没梯度;同时 SFT 与 GRPO 的分工(小模型几乎全靠 RL)是论文核心实验结论之一。
可验证任务与执行验证器(Verifier)
每个任务附带验证器 $V_\tau: \mathcal{S} \to \{0,1\}$,检查智能体结束时的工作区状态是否满足目标谓词;测试用业务语义键而非硬编码 ID 定位记录,保证任何正确解都能通过。配套 Oracle 校验(参考解必须跑通自己的验证器)与泄漏审计(指令不得泄漏答案键、初始状态不得直接满足测试),过滤不适定或可作弊的任务。
整个闭环的可信度建立在“答案由代码执行产生、任务通过执行验证”之上,这是合成数据无需人工逐条校对的机制保证,也是可验证奖励 RL 的前提。
准入带与动态课程(Admission Band)
每个候选任务用当前策略跑 $N=8$ 次 rollout,只保留通过次数落在 $[N_l, N_h]=[1,5]$ 的任务:全对说明太简单(优势为零、学不到东西),全错说明太难或任务本身不一致。由于阈值相对当前策略定义,任务会随智能体变强自动退出训练池,无需外部课程表,形成随策略移动的自适应难度筛选。
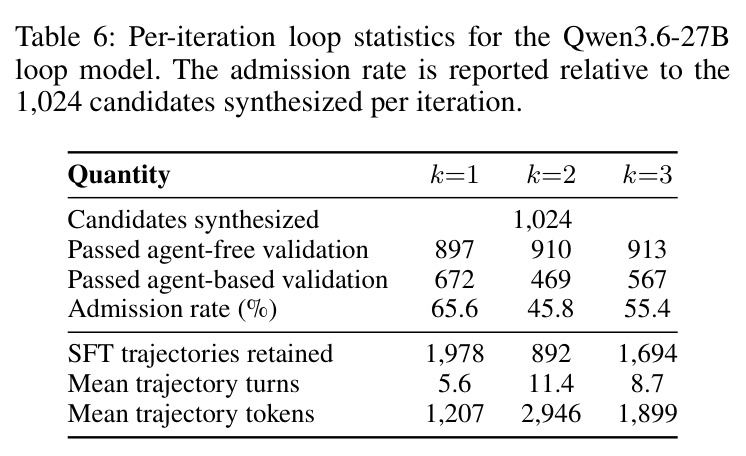
这是把任务验证、SFT 数据筛选与 GRPO 分组三重目的复用同一批 rollout 的枢纽设计,也是论文逐轮准入率波动(65.6%→45.8%→55.4%)等循环动态分析的观测基础。
研究动机
LLM 智能体正从预定义工具调用的 tool-use 形态,演进为直接操作真实文件系统与 shell 的 harness 形态(如 OpenClaw、Claude Code、Codex),任务涉及文件操作、命令执行、技能执行与多步推理的开放式组合,复杂度远超固定工具集。现有后训练流水线几乎都面向 tool-use 智能体,且普遍是一次性、依赖外部教师的:由更强的外部模型(如 MiniMax-M2.5、GLM-5.1)合成任务并收集轨迹,目标模型只训练一次,评测结果仅供人类研究员参考而不回流到训练循环。这带来两个硬伤:训练信号天然被外部模型自身能力封顶;任务域由人类先验一次性划定,无法针对模型暴露出的具体弱点定向出题。唯一在 harness 内做任务合成的先行工作 ClawGym 同样依赖外部强模型、单次运行、没有诊断反馈环节。
本文的目标是构建一个完全去教师化、自我维持的闭环训练框架:让智能体在它未来要工作的同一个 harness 沙箱里,自主合成多样化且代码级可验证的训练任务,收集自己的轨迹,通过 SFT 和/或 RL 更新参数,再在留出评测集上诊断自己的失败模式,并把能力分析报告作为下一轮任务合成的条件输入,如此迭代。具体验证目标是用 Qwen3.6-27B 作为循环模型运行 3 轮闭环后,在 SkillsBench、Claw-Eval-Live、ClawGym-Bench 三个基准上取得一致提升;同时把产出的任务用于训练 Qwen3.5-4B 和 9B 小模型并观察跨尺度增益,以此证明合成数据的质量独立于循环模型本身。
与已有工作不同的是,作者的独特切入是观察到 harness 环境本身已具备闭环自改进的全部基础设施:LLM 可以实例化任意工作区、执行完整轨迹、用代码校验和 rubric 校验结果——缺的不是基础设施,而是“识别自身弱点、生成定向练习、迭代改进”的机制,这正是人类学习的核心能力。与 Agent0 等自进化工作不同,ClawLoop 面向开放的 harness 环境而非固定工具集;与 ACE、Self-Harness 等非参数化方案不同,它更新模型权重而非只改上下文;与 ClawGym 不同,它的任务合成以自身诊断结果为条件,且答案键由代码执行计算产生而非由模型断言,从机制上杜绝了标签幻觉。
核心方法
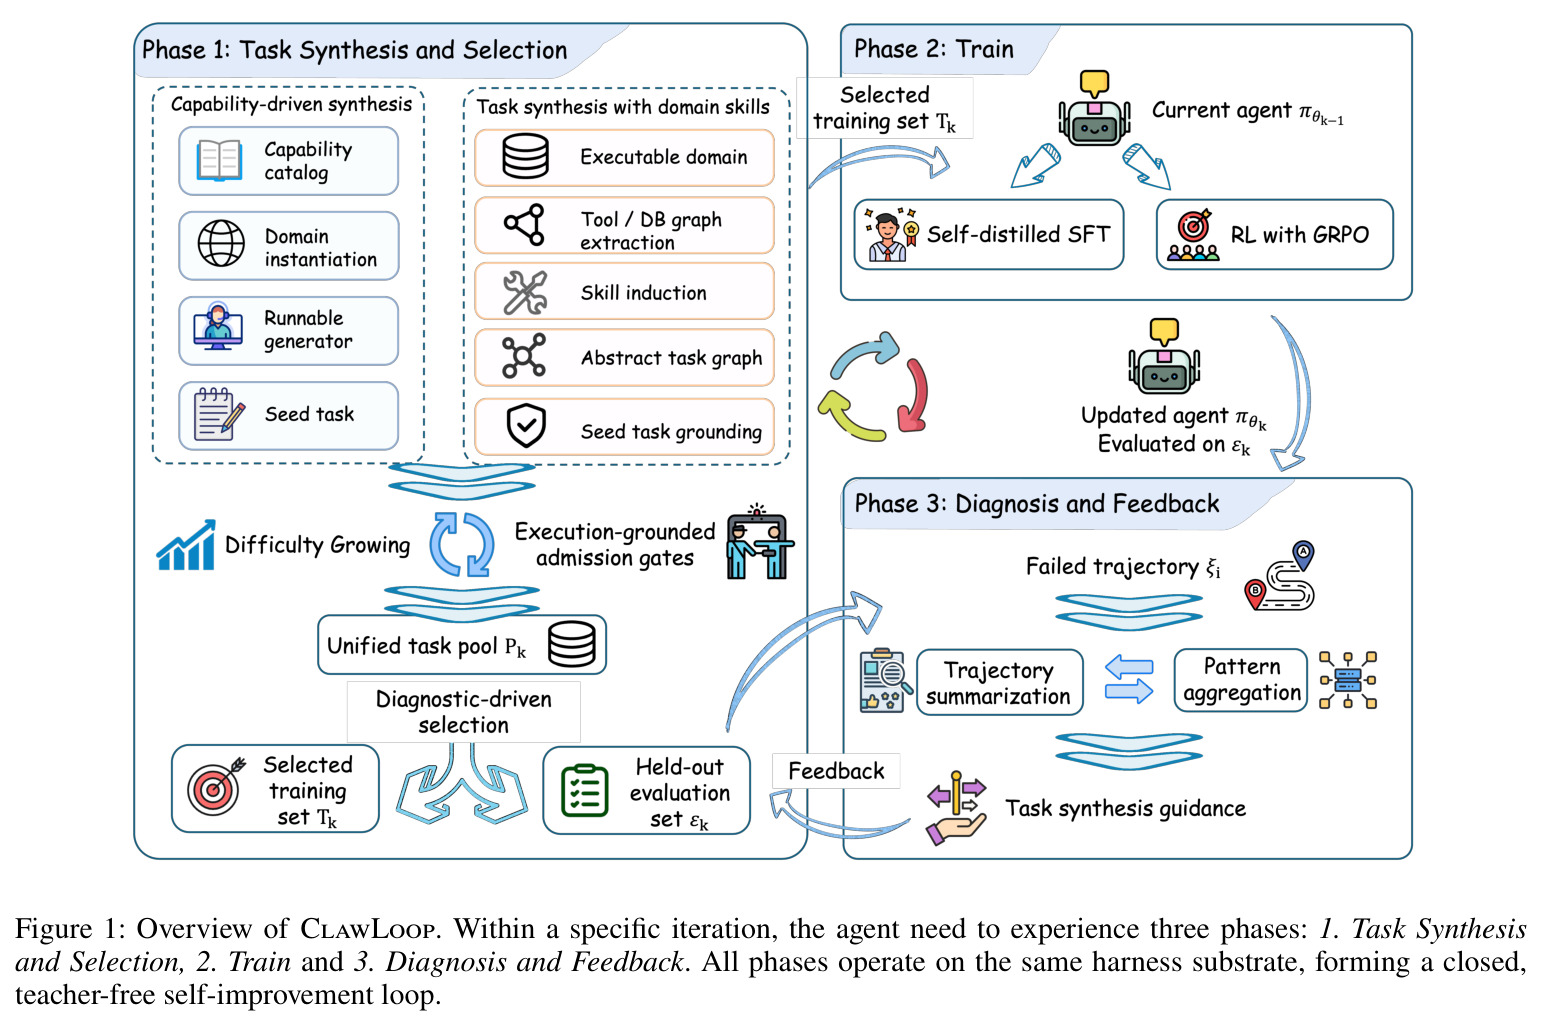
直觉是把“出题人、考生、阅卷人”三个角色都交给同一个模型,但用结构性约束(生成器执行、Oracle 校验、准入带)防止自我欺骗。技术上,任务被形式化为四元组 $\tau = \langle p, s_0, \mathcal{A}, \mathcal{F}, \mathcal{V}_\tau \rangle$(指令、初始工作区、动作空间、确定性转移函数、验证器),循环模型 $\pi_{\theta_0}$ 在同一 harness 内运行 $K=3$ 轮迭代:第一轮 Task Synthesis 用能力驱动与领域接地两条互补路线生成多样化任务池,经难度增长与两阶段验证后切成训练集 $T_k$ 与留出集 $E_k$;第二轮 Training 对成功轨迹做自蒸馏 SFT(多轮损失掩码),再用 GRPO 做结果奖励 RL 突破模仿上限;第三轮 Diagnosis 在 $E_k$ 上收集失败轨迹,总结失败点/根因/缺失能力并聚合为诊断报告,注入下一轮合成。
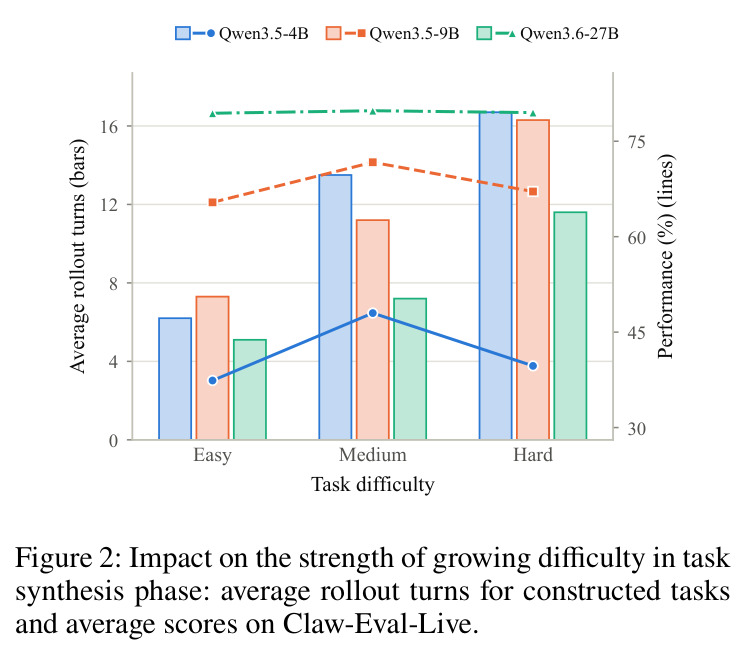
核心创新有三点。其一,“生成生成器而非生成数据”:合成 LLM 从不直接写任务数据,而是写可运行的生成器 $\text{build}(\text{seed}) \to (s_0, y, C)$,在沙箱中执行得到工作区 $s_0$、答案键 $y$ 与答案契约 $C$;$y$ 由代码对合成源数据计算得出而非模型断言,契约 $C$ 显式声明从环境无法恢复的隐藏决策(过滤标准、舍入约定、平局规则、连接键)并固定交付物 schema 与数值容差,且不含答案值。其二,难度由构造强制:multi-hop 绘制强制生成“索引文件 + 实体明细 + 横向参照表”三类数据源结构,dirtiness 绘制注入受控噪声(干扰项、缺字段、schema 不一致、单位错配),而非在提示词里请求“出难一点”。其三,准入带 $[1,5]/8$ 只保留当前策略部分成功的任务,天然聚焦 GRPO 梯度信号,并随策略变强自动淘汰已掌握任务。
方法步骤详情
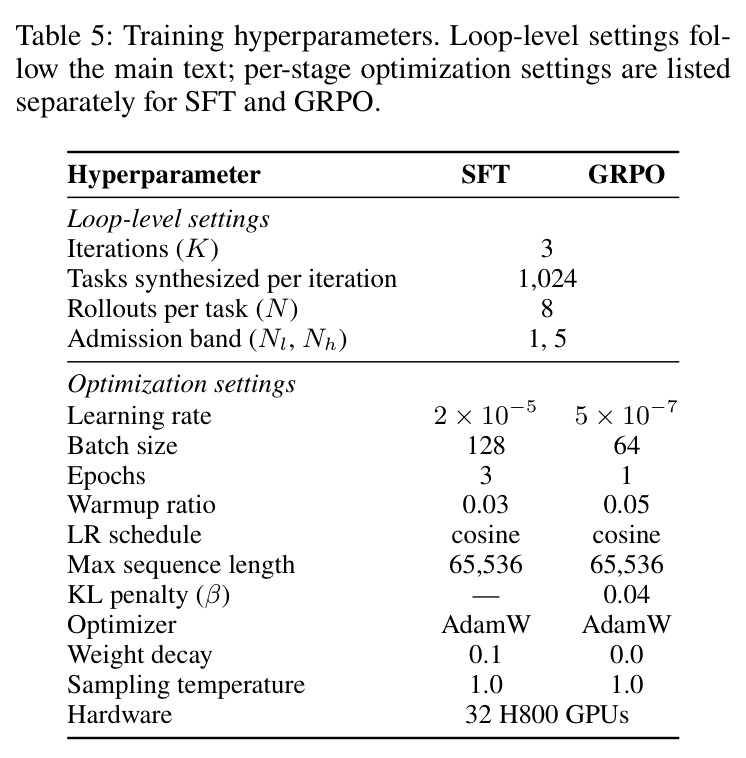
Phase 1 合成:能力驱动路线把工作流模式(对账、跨源审计、多文档合并、领域计算)绑定到能力目录,跨大量领域实例化(含养蜂库存等长尾领域),分结构化交付的分析 track 与终态交付的 terminal track;领域接地路线用 AST 检查加 LLM 分析构建“工具—参数/字段—数据表”三元图,按加权亲和度聚类成技能,再按长程依赖、分支、汇聚、错误恢复等结构特征采样抽象任务图并接地到具体领域,指令在信息屏障下生成以防金标解泄漏。随后做难度增长(multi-hop + dirtiness)与交付格式轮转。验证分无智能体阶段(Oracle 参考解自过验证器、泄漏审计)与有智能体阶段(每题 $N=8$ 次并行 rollout,保留通过 $[1,5]$ 次者)。Phase 2 训练:SFT 学习率 $2\times10^{-5}$、3 epoch、序列长 65536、掩码观察 token;GRPO 学习率 $5\times10^{-7}$、KL 系数 $\beta=0.04$。Phase 3 诊断:失败轨迹总结为失败点/根因/缺失能力三元组,按技能类别聚合(如“改了目标文件但没更新依赖模块的 import”),注入下一轮合成。
技术新颖性
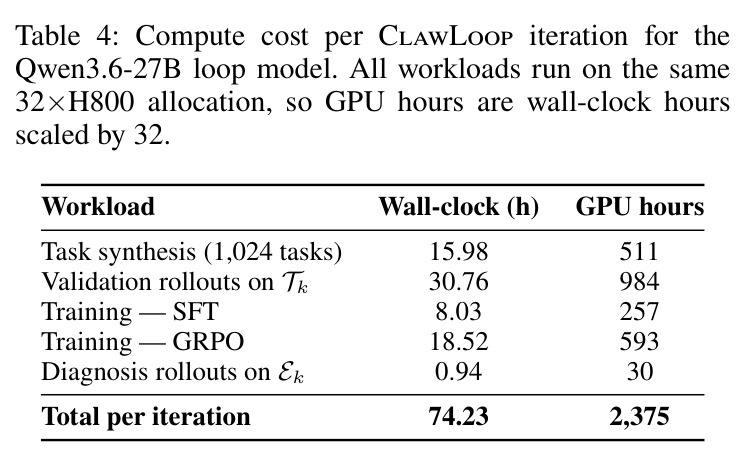
其一,这是首个 harness 原生的无教师迭代自改进闭环:此前工作要么依赖外部强模型单次运行,要么只进化上下文/harness 而冻结权重,ClawLoop 把任务合成、权重更新、自我诊断统一在一个循环里。其二,执行接地标注:把“答案从哪来”变成代码执行问题,把“任务是否适定”变成 Oracle 测试加泄漏审计问题,使合成数据无需人工校对即可信。其三,一份数据三重复用:同一批 $N=8$ rollout 同时充当验证信号、SFT 成功样本与 GRPO 分组,附录测算 rollout 收集占单轮成本约 41%(984/2375 GPU 时),若不复用闭环成本将不可行。其四,诊断反馈把失败轨迹转化为结构化证据而非奖励信号——总结一条失败轨迹远比解出原题容易,且避免了自我奖励带来的 Reward Hacking 风险。
实验结果
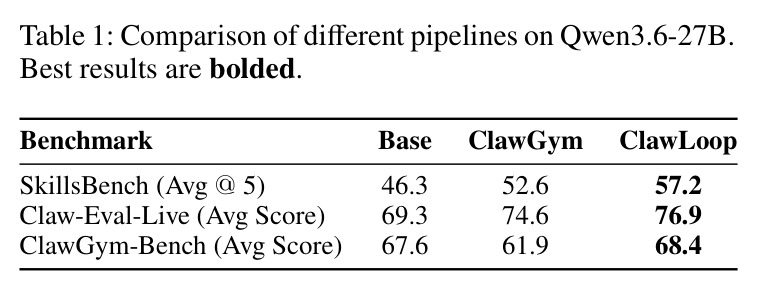
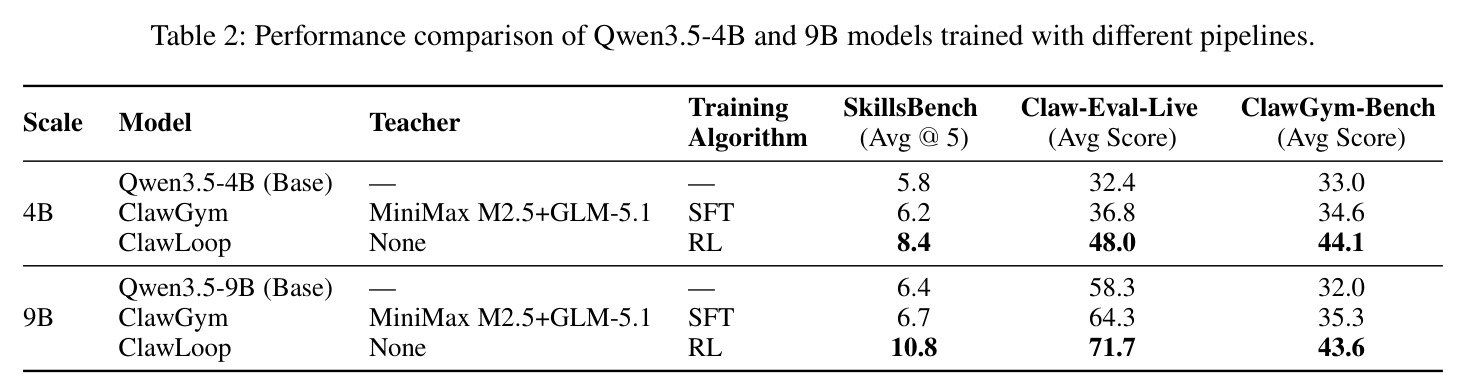
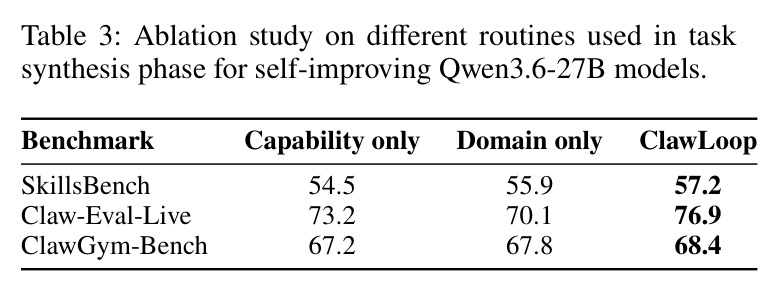
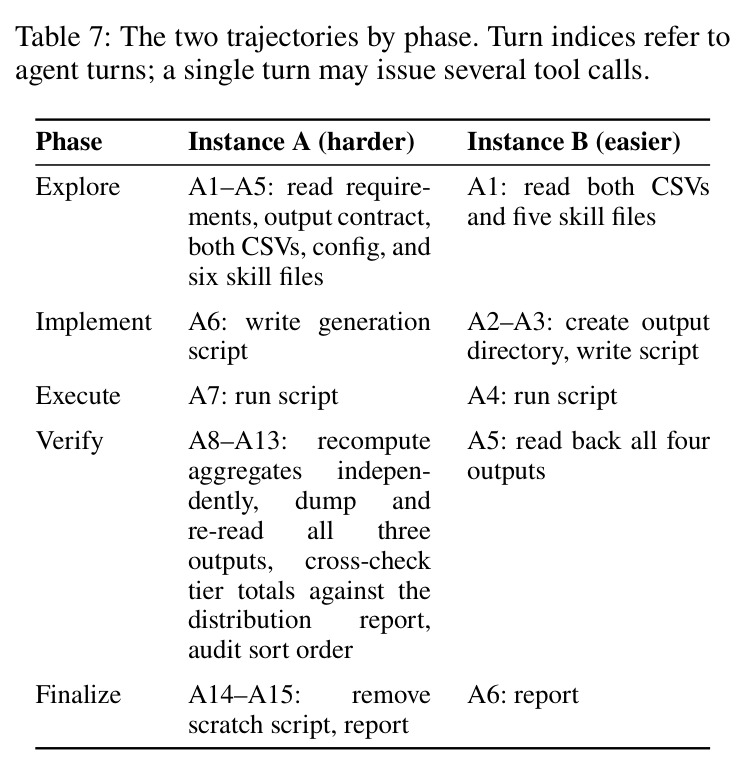
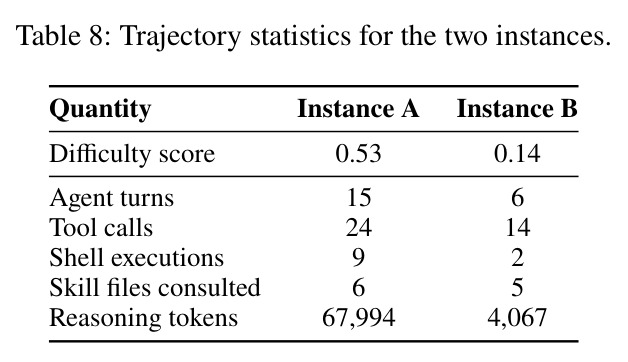
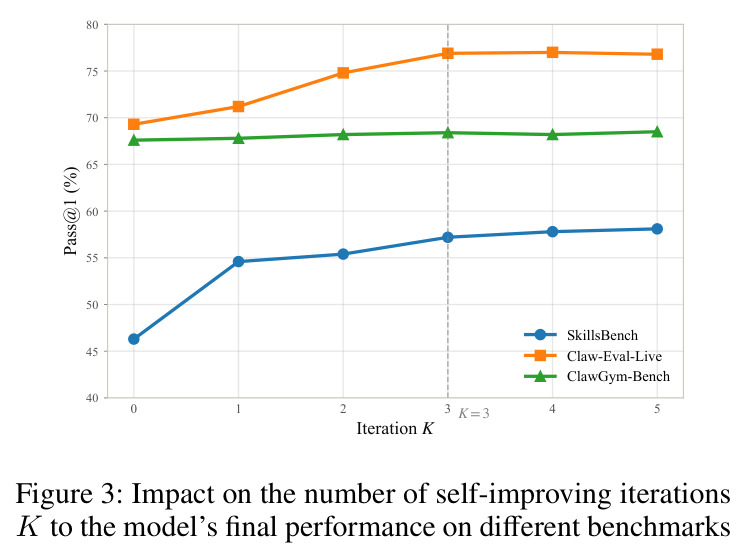
主实验(Table 1):Qwen3.6-27B 经 $K=3$ 轮 ClawLoop(每轮 1024 任务)后,SkillsBench 达 57.2(基座 46.3,ClawGym 52.6),Claw-Eval-Live 达 76.9(69.3/74.6),ClawGym-Bench 达 68.4(基座 67.6,ClawGym 反退化至 61.9);增益三基准均衡,说明是真实能力提升而非分布过拟合。迁移实验(Table 2):ClawLoop 任务做 RL 的 4B 达 8.4/48.0/44.1(基座 5.8/32.4/33.0,教师蒸馏仅 6.2/36.8/34.6),9B 达 10.8/71.7/43.6(基座 6.4/58.3/32.0,ClawGym 6.7/64.3/35.3)——无教师数据全面超过 MiniMax-M2.5+GLM-5.1 蒸馏。消融(Table 3):去能力路线使 Claw-Eval-Live 跌至 73.2,去领域路线使 SkillsBench 跌至 55.9。图 3 显示两基准在 $K=3$ 饱和;附录 D 揭示准入率非单调(65.6%→45.8%→55.4%);难任务比易任务推理 token 多 17 倍(67,994 vs 4,067)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SkillsBench(Qwen3.6-27B,86 任务 / 11 领域) | Avg@5 | 57.2 | 46.3(基座)/ 52.6(ClawGym) | +10.9 vs 基座,+4.6 vs ClawGym |
| Claw-Eval-Live(Qwen3.6-27B,105 真实工作流任务) | 平均分 | 76.9 | 69.3(基座)/ 74.6(ClawGym) | +7.6 vs 基座,+2.3 vs ClawGym |
| ClawGym-Bench(Qwen3.6-27B,200 任务) | 平均分 | 68.4 | 67.6(基座)/ 61.9(ClawGym) | +0.8 vs 基座,+6.5 vs ClawGym(后者同分布反而退化) |
| Qwen3.5-4B 迁移(无教师,仅 RL) | SkillsBench / Claw-Eval-Live / ClawGym-Bench | 8.4 / 48.0 / 44.1 | 5.8 / 32.4 / 33.0(基座);6.2 / 36.8 / 34.6(ClawGym 教师蒸馏 SFT) | 最高 +15.6(Claw-Eval-Live),全面超过教师蒸馏 |
| Qwen3.5-9B 迁移(无教师,仅 RL) | SkillsBench / Claw-Eval-Live / ClawGym-Bench | 10.8 / 71.7 / 43.6 | 6.4 / 58.3 / 32.0(基座);6.7 / 64.3 / 35.3(ClawGym 教师蒸馏 SFT) | 最高 +13.4(Claw-Eval-Live),全面超过教师蒸馏 |
局限与改进
作者承认的:$K=3$ 后 Claw-Eval-Live 与 ClawGym-Bench 饱和,更长的训练视野与自适应停止准则留待未来;4B/9B 只是继承 27B 生成的课程、从未运行自己的诊断回路,严格说不是完整的自改进实例。附录还坦承两个扩展性 caveat:三个尺度共用同一循环模型,无法分离“课程消费者规模”与“课程生产者规模”的效应;小模型成功率过低导致自蒸馏 SFT 正样本稀缺(27B 每轮也只有 892–1978 条成功轨迹),4B/9B 的收益几乎全部归功 RL 阶段。我的观察:单轮成本 74.23 墙钟时 / 2375 GPU 时(32×H800),三轮超 7000 GPU 时,代价不低;诊断只在规模很小的留出集 $E_k$ 上进行,失败模式的覆盖度存疑;基座模型在 SkillsBench 上仅 5.8–6.4 分,说明该基准对 Qwen3.5 系列可能过难,绝对增益需谨慎解读;全部实验限于 Qwen 模型族与 OpenClaw harness,跨模型族泛化未验证。
独立分析的弱点
(1)任务多样性仍受循环模型自身先验限制——虽有长尾领域与难度增长,模型无法出真正超出自己知识边界的题,能力天花板是被推高而非消除;改进方向是引入少量外部接地源(真实文档、代码库、MCP 域)扩展出题素材。(2)诊断反馈通路较弱:$E_k$ 规模小、轨迹总结质量本身无验证、模式聚合靠聚类启发式,错误归因可能被放大进下一轮,且论文没有单独消融诊断模块的贡献;应加入对诊断报告的验证或对照实验。(3)验证器只检查最终状态,过程正确性不可见,可能奖励“结果对但过程粗暴”的轨迹(如直接重写整个文件);可引入过程约束或副作用检查。(4)难度调度实际是开环的:$k{=}2$ 准入率骤降至 45.8%,意味着近半合成预算被浪费,可用准入率信号做闭环控制或 bandit 式自适应调度。(5)可复用性风险:准入带与 SFT/RL 分工强依赖每题 8 次 rollout 的算力预算,小规模团队难以照搬。
未来方向
作者提出的:更长训练视野与自适应停止准则;更换循环模型本身以研究规模对课程生产者的影响;让小模型运行自己的完整诊断回路成为真正的自改进实例。基于成果可延伸的:(1)把诊断报告从“合成条件”升级为“难度调度器”,用逐轮准入率做闭环反馈,解决 $k{=}2$ 超调问题;(2)跨模型课程生态——多个不同规模的循环模型互相出题,形成学生最终超越老师的链式自改进;(3)把答案契约 $C$ 的思想推广到更开放的交付形式(rubric 评分的自由文本、多日长程任务);(4)与非参数化自改进(ACE、Self-Harness)结合,让模型权重与上下文 playbook 同时进化;(5)量化“验证器覆盖度/质量”与能力增益的关系,这个隐含变量目前只有 Oracle 式定性保证;(6)引入过程级奖励与安全性过滤,把闭环推向生产部署;(7)在 SkillsBench 这类未饱和基准上继续加轮数,观察自改进的真实极限。
复现评估
论文细节披露相当充分:附录给出完整伪代码(Algorithm 1)、全部超参(Table 5:SFT 学习率 $2\times10^{-5}$/batch 128/3 epochs,GRPO 学习率 $5\times10^{-7}$/KL 0.04,序列长 65536)、基础设施配置(32×H800、含 Python 3.11 的 Docker 基础镜像、网络隔离、每容器 24 小时与 300 轮上限、32 并发实例)、每轮成本分解(Table 4:合计 74.23 墙钟时/2375 GPU 时)与逐轮统计(Table 6)。但文中未见明确的开源代码或数据发布承诺,所引用的 OpenClaw、各基准均为外部项目。复现门槛偏高:需要 32 卡 H800 级算力(三轮约 7125 GPU 时);依赖 Qwen3.6-27B、MiniMax-M2.5、GLM-5.1 等模型的可获得性;SkillsBench、Claw-Eval-Live、ClawGym-Bench 均为 2026 年新基准,公开程度需逐一确认。总体属于工程复杂度(沙箱集群、并行 rollout、生成器沙箱执行)远大于算法复杂度的复现类型。
论文图表
完整伪代码:每轮迭代依次执行双路线合成(受上一轮诊断反馈 F 调制)、无智能体验证、N 次 rollout 的有智能体验证与准入带过滤、切分 T_k/E_k、自蒸馏 SFT、GRPO、在 E_k 上诊断并聚合失败模式。
把论文所有机制浓缩为可执行步骤,是复现者最该精读的部分,也清晰标注了每个中间量的来源与去向。