ProAS:面向多轮智能体强化学习的进度感知优势塑形框架 ProAS: A Progress-Aware Advantage Shaping Framework for Multi-Turn Agentic Reinforcement Learning
用动态演化的子目标参考图把轨迹级优势塑形成步级信号,修复GRPO均匀信用分配
前置知识
GRPO(组相对策略优化)
DeepSeek 提出的无 critic 强化学习算法:对同一任务采样 G 条轨迹,用可验证奖励 $R(\tau_i)$ 在组内归一化得到轨迹级优势 $A_i=(R(\tau_i)-\mu)/(\sigma+\epsilon)$,再用 PPO 式裁剪目标更新。它省去价值网络、计算高效,但会把同一个 $A_i$ 均匀广播给轨迹内每个 token。
ProAS 正是对 GRPO、DAPO、GiGPO 这类 group-based 算法的优势做后处理塑形,不理解 GRPO 的优势估计与梯度形式,就无法理解'均匀信用分配'问题出在哪、Eq.7 改造的是什么。
优势函数与信用分配
优势衡量某个动作相对平均水平的好坏;多轮智能体任务奖励极稀疏(本文成功记 10、失败记 0),必须把轨迹级结果归因到单步动作,这就是信用分配。归因方式决定每一步的梯度被放大还是抑制,是 RL 训练的核心难题;均匀广播会让好轨迹里的坏动作也被一起强化。
本文的全部动机与两个核心机制(MUI 掩码、APR 再分配)都围绕'不训练 critic 的前提下,把标量 $A_i$ 拆成步级信号 $\tilde{A}_{i,t}$'展开。
PPO 裁剪与策略梯度推导
PPO 用重要性比率 $\rho_{i,t}=\pi_\theta/\pi_{\theta_{old}}$ 乘优势并裁剪到 $[1-\epsilon,1+\epsilon]$ 以限制更新幅度。on-policy 时 $\rho\equiv1$,附录 A 推导表明每步梯度系数退化为 $\mathbb{1}^{clip}_{i,t}\cdot A_i$:整条轨迹共享同一标量乘子。
论文正是通过这条梯度推导(Eq.4)把'均匀信用分配'从直觉变成数学事实:每步梯度 = 轨迹优势 × 得分函数梯度,动作之间毫无区分。
DAG 与子目标分解
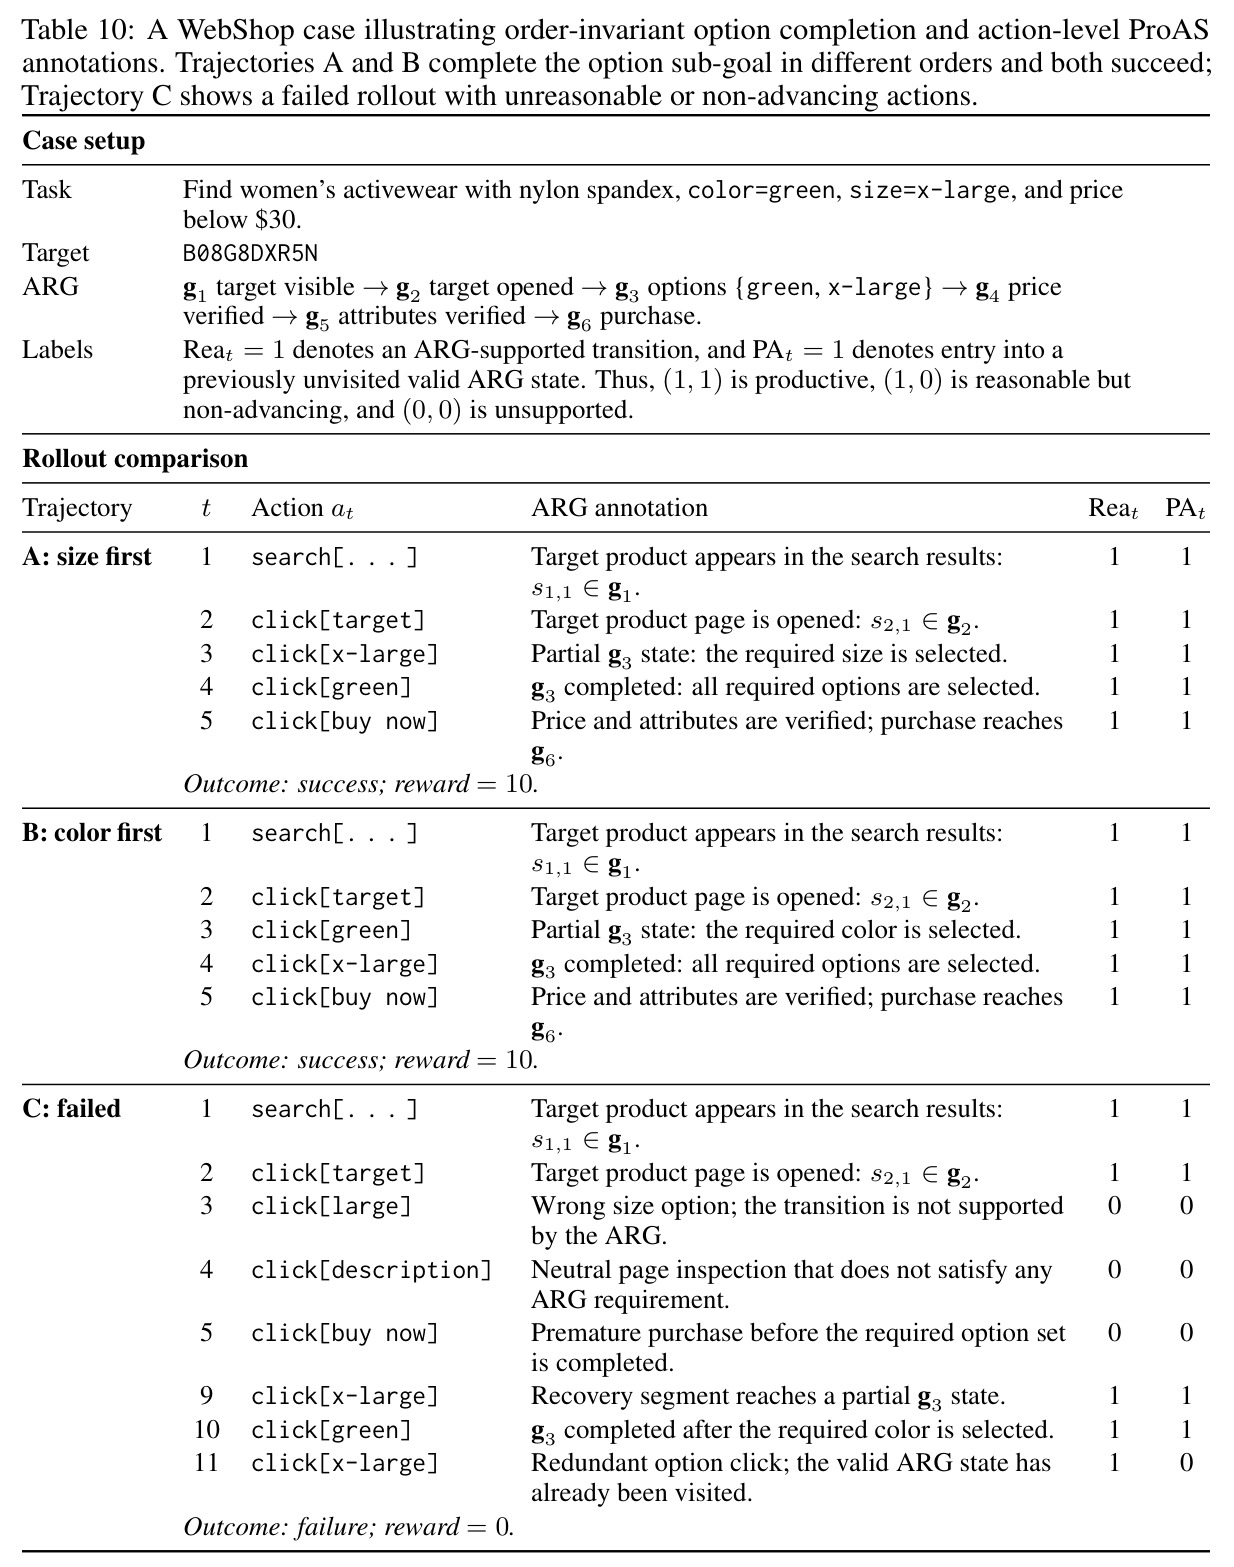
有向无环图 $\mathcal{G}=(V,E)$ 用顶点表示里程碑、有向边表示合法转移。本文把任务进度抽象为 M 个有序子目标 $g_m$,每个子目标是排列不变的合法状态集合(状态等价类),动作是相邻子目标间的确定性转移,从而把许多条不同的成功路径统一成一张可查询的参考图。
智能体参考图 ARG 是 ProAS 的核心数据结构,每步的合理性/推进性标注都来自对这张图的匹配查询,后续 MUI 与 APR 全部建立在其上。
干预(反事实)分析
不只观察相关性,而是固定其他条件、只改动一个因素,统计结果如何变化,以建立因果证据。本文的两个探针实验是:向可见历史注入 4 步不合理动作、或在失败轨迹某一步强行禁止原动作后重采样,各自采 50 条续写并统计期望成功率 ESR。
动机部分的 Insight 1(噪声上下文妨碍成功)与 Insight 2(高未来漂移动作应优先抑制)都依赖这类介入实验,理解它才能评估论文证据的强弱。
研究动机
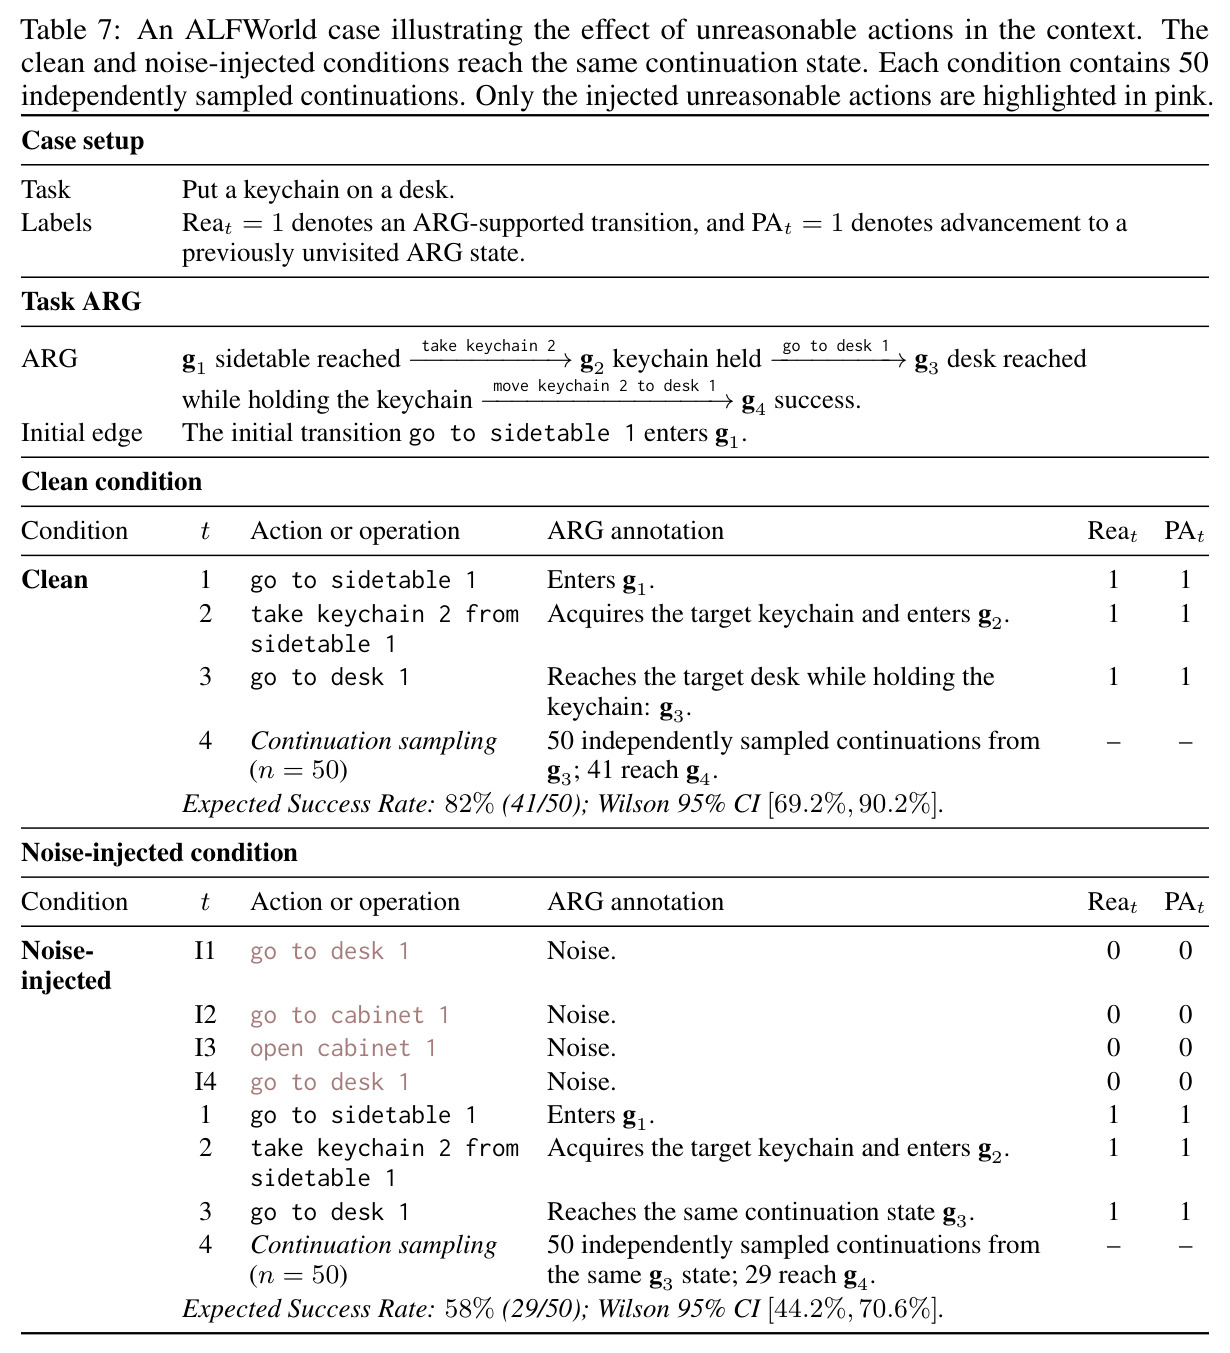
现有 critic-free RL(GRPO、DAPO 等)把轨迹级优势 $A_i$ 均匀广播给轨迹中的每个动作,作者称之为'均匀信用分配困境',并揭示了它的双重次优。在优势为正的首选轨迹(通常是成功轨迹)中,统一奖励会顺带强化结构性不合理的动作:统计显示 Qwen2.5-1.5B-Instruct 在 ALFWorld 成功 GRPO 轨迹中不合理动作占 41.6%,WebShop 占 39.6%;介入实验证明这类动作会污染上下文——在底层环境状态完全相同的情况下,仅在可见历史中前置 4 步不合理动作,就把 50 条续采样的期望成功率 ESR 从 82% 拉低到 58%。在优势为负的非首选轨迹(通常是失败轨迹)中,非推进动作高度集中(ALFWorld 93.1%、WebShop 76.1%),但由于 LLM 的自回归特性,后期偏离往往是早期上下文被污染后的必然结果,对全部动作等量惩罚既不公平、也无视各步的真实下游影响。而 PPO 等 actor-critic 方法虽能做步级归因,却要额外训练一个 critic,在长视野智能体任务中带来大量计算开销与优化不稳定。
本文的目标是本文的目标是在不引入 critic 开销的前提下,为无 critic 的 group-based RL 提供细粒度、步级的信用分配:让算法能区分'结构合法但无推进'与'直接错误'的动作;在正优势轨迹中避免误强化不合理动作(防噪声),在负优势轨迹中按各动作对下游停滞的'责任'分配不同强度的惩罚(防误伤)。作者希望得到一个即插即用的优势塑形框架:以外部结构先验(子目标参考图)在线标注每步动作的合理性与推进性,把标量 $A_i$ 改造成步级信号 $\tilde{A}_{i,t}$,可无缝叠加到 GRPO、DAPO、GiGPO 等主流算法上,同时提升最终成功率与训练收敛速度,并对不完美、静态甚至由教师模型蒸馏得到的参考图保持鲁棒。
与已有工作不同的是,已有的细粒度改进分两类:DAPO 与稠密奖励方法缓解稀疏奖励下的优势消失,但信用分配仍绑定整条轨迹;GiGPO/MiGPO 通过跨轨迹匹配锚定状态或里程碑来计算相对优势,能区分步级差异,但需要重算一整套组内相对优势、并与具体匹配机制耦合。ProAS 的独特切入点是'优势塑形':不改变算法原有的优势估计与更新结构,只在拿到 $A_i$ 之后,依据外部参考图给出的结构标注做非对称修改——正优势轨迹做掩码(MUI),负优势轨迹按未来漂移 $D_{i,t}$ 再分配惩罚(APR)。它把'任务进度结构'当作可在线生长的先验注入 RL,而不是从头学价值函数或设计新奖励;消融显示这比把进度直接写进奖励(PR 变体,ALFWorld 低 14.1 点)更有效。
核心方法
直觉上,一条成功轨迹里可能混有绕路、无效动作,这些'噪声'不应因最终成功而被一并强化;一条失败轨迹里,早期的关键错误才是罪魁,后期的挣扎只是上下文被污染后的必然,不该与早期错误等价同罚。ProAS 据此对轨迹级优势做非对称整形。技术路线分三步:第一步,用预收集的成功轨迹(如官方众包标注)构建智能体参考图 ARG——把任务进度抽象为 M 个有序子目标的状态等价类 DAG,并在训练中随每条验证成功的轨迹做严格并集演化;第二步,对每条 rollout 轨迹逐步与当前图 $\mathcal{G}^{(k)}$ 匹配,标注合理性 $Re_{at}$ 与推进性 $PA_t$,并定义未来漂移 $D_{i,t}=\sum_{t'=t}^{|\tau_i|}(1-PA_{i,t'})$,度量该步之后还有多少非推进动作;第三步按 Eq.7 塑形:$A_i>0$ 时把不合理动作的局部优势置零(MUI),$A_i<0$ 时按归一化漂移 $D_{i,t}/(\bar{D}_i+\epsilon)$ 加重早期关键动作的惩罚(APR),其余情况保持 $A_i$ 不变。
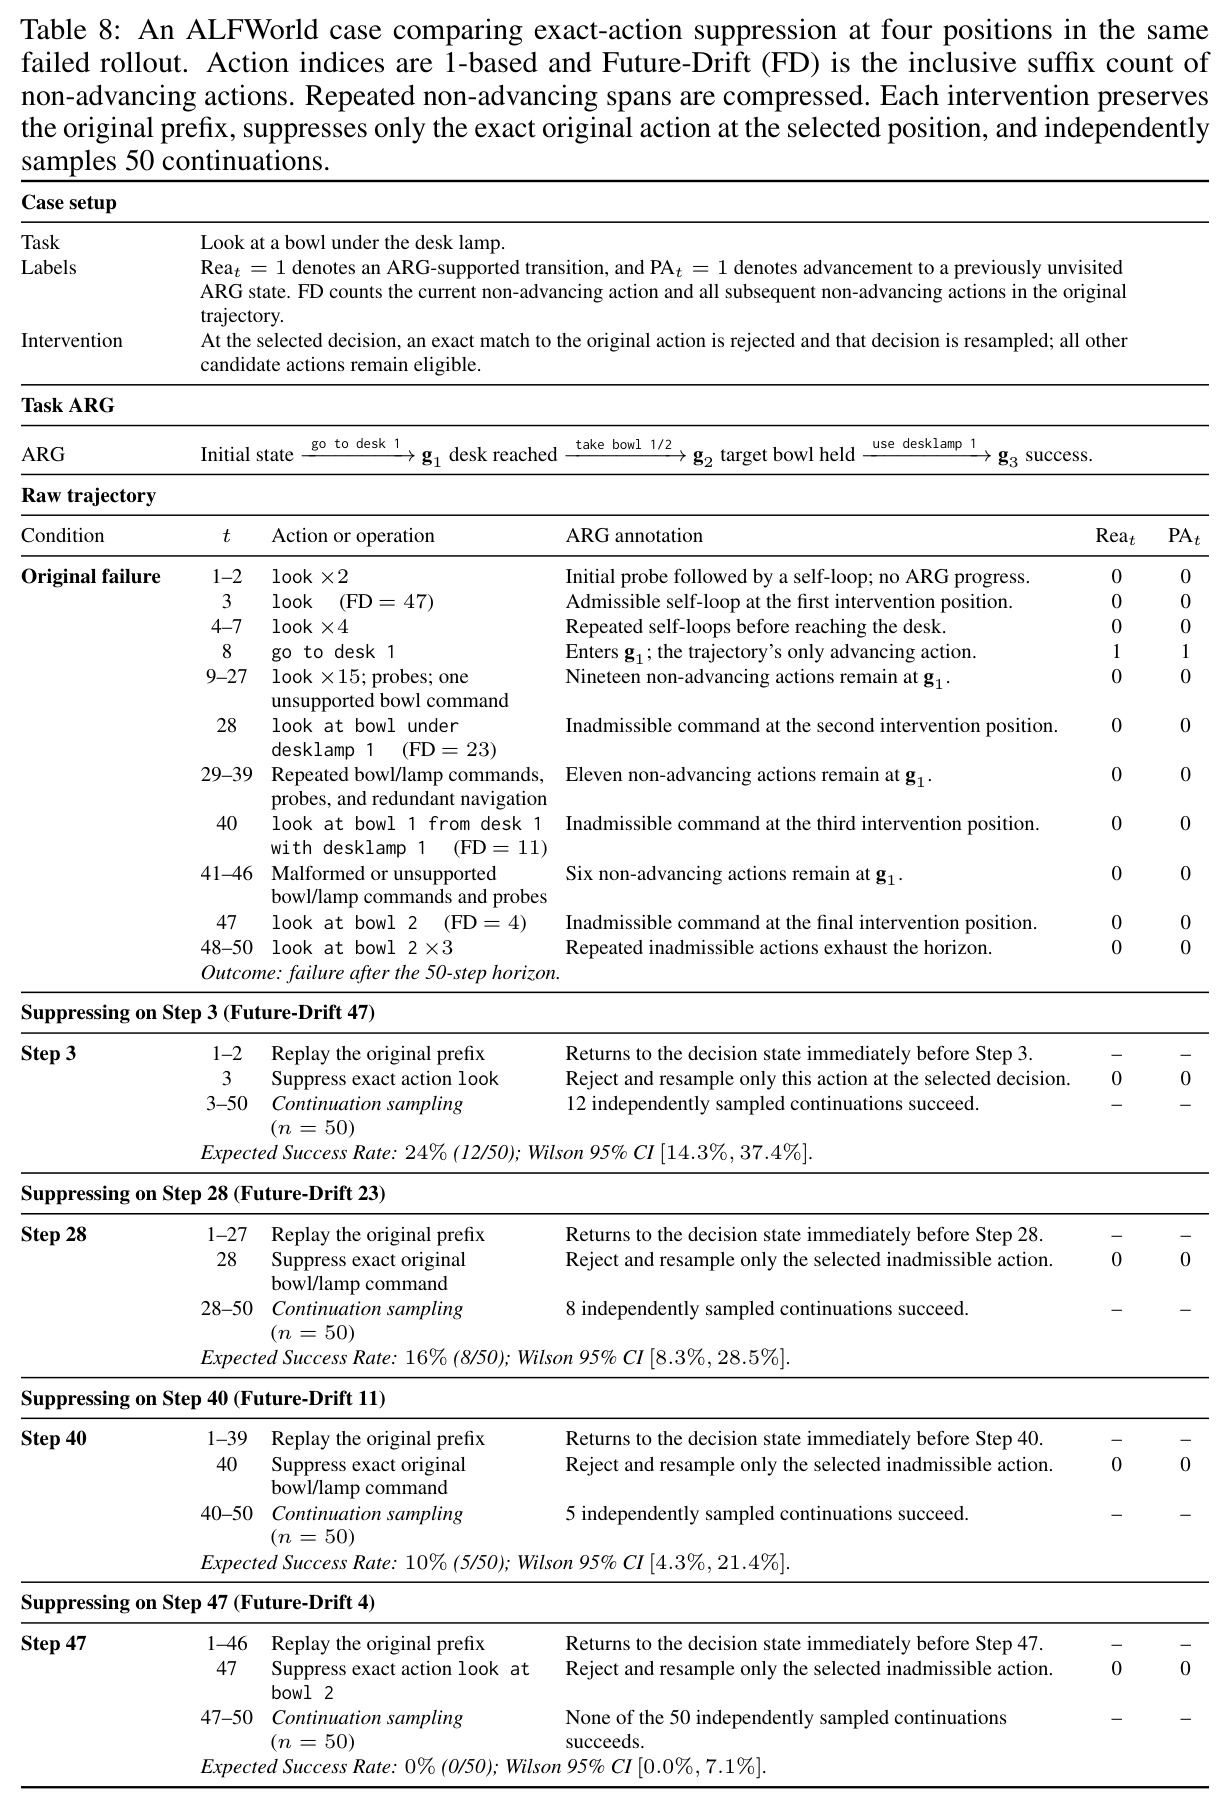
核心创新是'进度感知的非对称优势塑形'。与已有方法的本质区别有三:(1) 与 GRPO/DAPO 的均匀广播不同,ProAS 利用动作的结构属性(是否为图的合法转移、是否进入未访问的新状态)区分轨迹内动作,且对正、负优势采取截然不同的处理——正轨迹防误奖、负轨迹防误罚;(2) 与 GiGPO/MiGPO 通过跨轨迹状态/里程碑匹配重算相对优势不同,ProAS 不改动原有优势估计,只做后处理式塑形,因此天然即插即用,甚至能叠加在 GiGPO 已有的步级优势之上;(3) 与把进度做成稠密奖励的做法不同,塑形直接调制梯度系数,消融证明后者更优(PR 变体在 ALFWorld 低 14.1 点)。此外,未来漂移 $D_{i,t}$ 把'该步对下游停滞的相对责任'量化为惩罚权重,介入实验(抑制 FD=47/23/11/4 的动作后恢复 ESR 为 24%/16%/10%/0%)为其提供了干预层面的证据支持。
方法步骤详情
方法分四步。第一步构建 ARG:顶点为 M 个有序子目标 $g_m$(排列不变的合法状态等价类,剔除错误与自环),边为相邻子目标间的确定性转移 $(s,a,s')$;ALFWorld/WebShop 均用官方标注初始化。第二步在线演化:第 k 轮中凡验证成功的 rollout,先剪除无效与自环步骤(纯化),再提取新状态 $\Delta g_m$ 与新动作 $\Delta E$ 按严格并集更新 $\mathcal{G}^{(k+1)}$(如 take pencil 1 合并为新子目标 g′3)。第三步动作归因:对轨迹 $\tau_i$ 每步计算 $Re_{at}=\mathbb{I}[(s_t,a_t,s_{t+1})\in E^{(k)}]$ 与 $PA_t=Re_{at}\cdot\mathbb{I}[s_{t+1}\in V^{(k)}\setminus S_{\le t}]$,再累加未来漂移 $D_{i,t}=\sum_{t'=t}^{|\tau_i|}(1-PA_{i,t'})$。第四步塑形训练:按 Eq.7 得 $\tilde{A}_{i,t}$——$A_i>0$ 时 $\tilde{A}_{i,t}=Re_{at}\cdot A_i$(MUI 掩掉不合理动作),$A_i<0$ 且 $t\in\mathcal{T}$ 时 $\tilde{A}_{i,t}=\frac{D_{i,t}}{\bar{D}_i+\epsilon}A_i$(APR,$\bar{D}_i$ 为相关步平均漂移),其余保持 $A_i$;随后代入 GRPO/DAPO/GiGPO 的裁剪目标。训练用 Verl-Agent,每迭代 16 任务×G=8 轨迹,学习率 $10^{-6}$,成功奖 10、无效动作罚 0.1。
技术新颖性
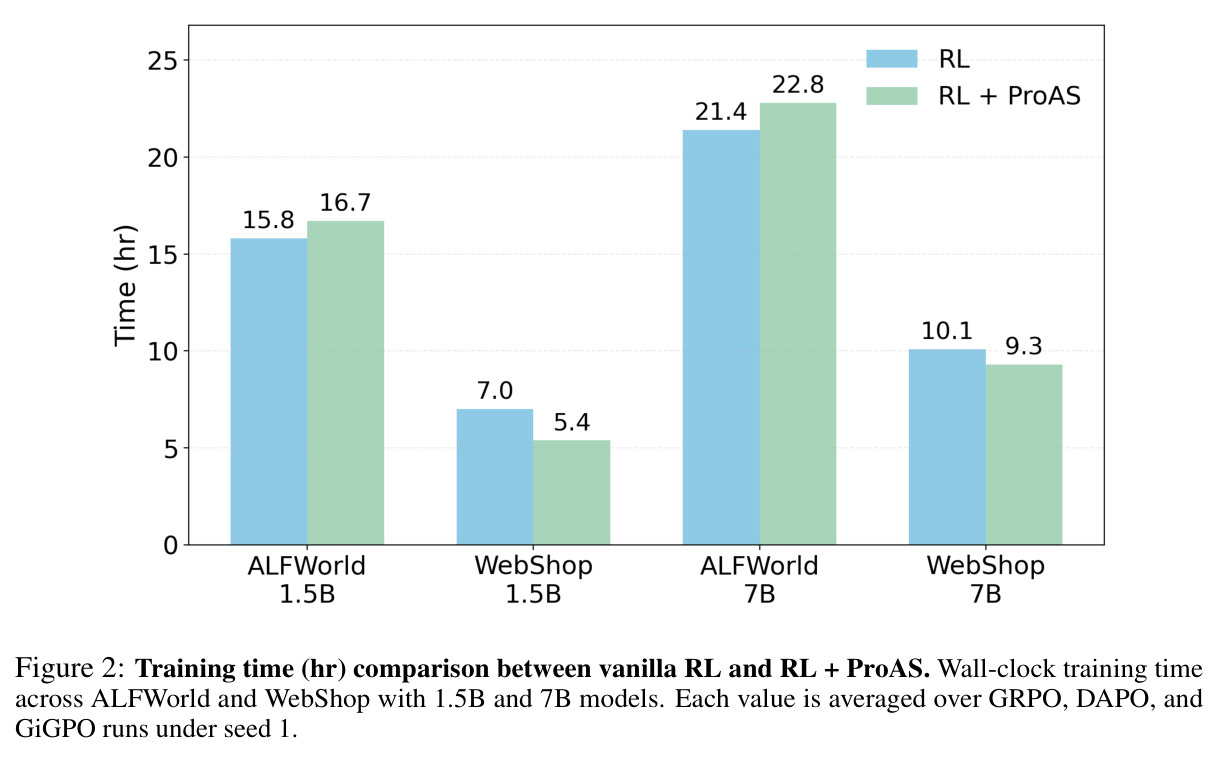
技术新颖性体现在四点。其一,问题刻画新:作者首次系统区分了'正优势轨迹中的噪声强化'与'负优势轨迹中的无差别惩罚'这一对方向相反的失效模式,并用控制变量的介入实验(注入噪声使 ESR 从 82% 降到 58%)给出准因果证据,而非停留直觉。其二,知识表示新:ARG 用'有序子目标 + 无序状态等价类'统一了多解任务的不同成功路径(WebShop 里先选颜色或先选尺码都算推进),并以严格并集在线生长,缓解静态图覆盖不足;Table 9 展示了新路径的净化与合并。其三,塑形机制新:MUI 用二值掩码防止噪声动作分走正优势;APR 用归一化未来漂移做乘性再分配,优于朴素掩码(msk± 变体低 14.1 点)与后缀长度启发式(suffix 变体低 5.5 点),说明 FD 捕捉的是'责任'而非位置。其四,工程友好:不引入 critic、不调用奖励模型,只增加图查询与掩码/加权,Fig.2 显示墙钟训练时间几乎不变(ALFWorld 略增、WebShop 反而更省)。
实验结果
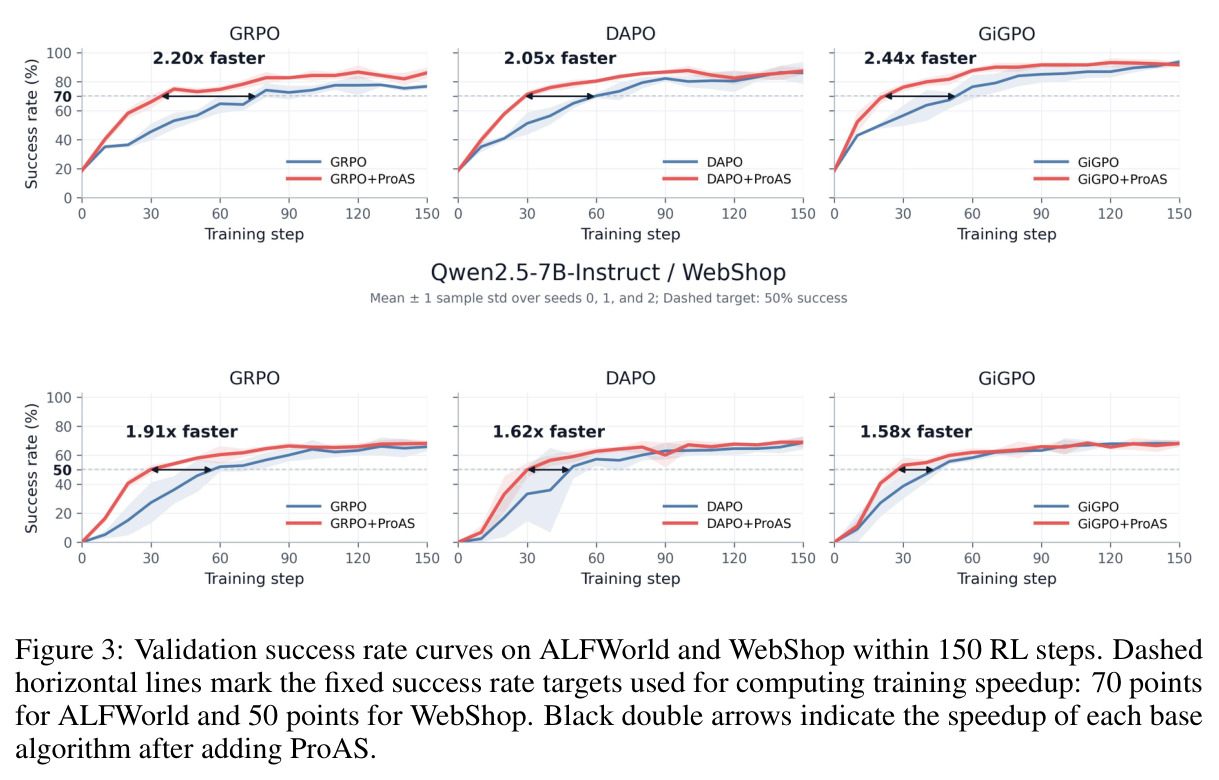
主实验(Table 1,3 种子、150 步 RL)显示 ProAS 是通用增强器。ALFWorld 上 GiGPO+ProAS 达 91.9%(1.5B)与 94.3%(7B)最高成功率,后者超 MiGPO 2.4 点、超 GPT-5.6-Sol(78.9%)15.4 点;GRPO+ProAS 提升最猛:1.5B 70.3%→87.0%(+16.7),7B 80.7%→89.1%(+8.4)。WebShop 更难(GPT-5.6-Sol 仅 21.9% SR):1.5B 上 DAPO+ProAS 与 GiGPO+ProAS 均达 66.7% SR,超 MiGPO 13.1 点;7B 上 GRPO+ProAS 达 70.8% SR、TS 最高 89.0。相对 PPO,ProAS 变体 ALFWorld SR 高 5.5–18.7 点;相对 SFT 高 12.2/14.4 点,说明结构化 RL 监督优于行为克隆。收敛加速 1.12×–2.44×(7B ALFWorld GiGPO+ProAS 达 2.44×)。塑形消融(Table 2a):去 MUI 掉 15.4 点、去 APR 掉 3.7 点,PR 奖励塑形低 14.1 点,掩码/后缀启发式分别低 14.1/5.5 点。ARG 消融(Table 2b):随机标注崩至 47.7%(−39.3);剪 40% 边仍比 GRPO 高 7.0 点;静态图降 4.2 点;7B 蒸馏图(2566 任务)达 83.6%/64.8%,比 GRPO 高 13.3/7.8 点。
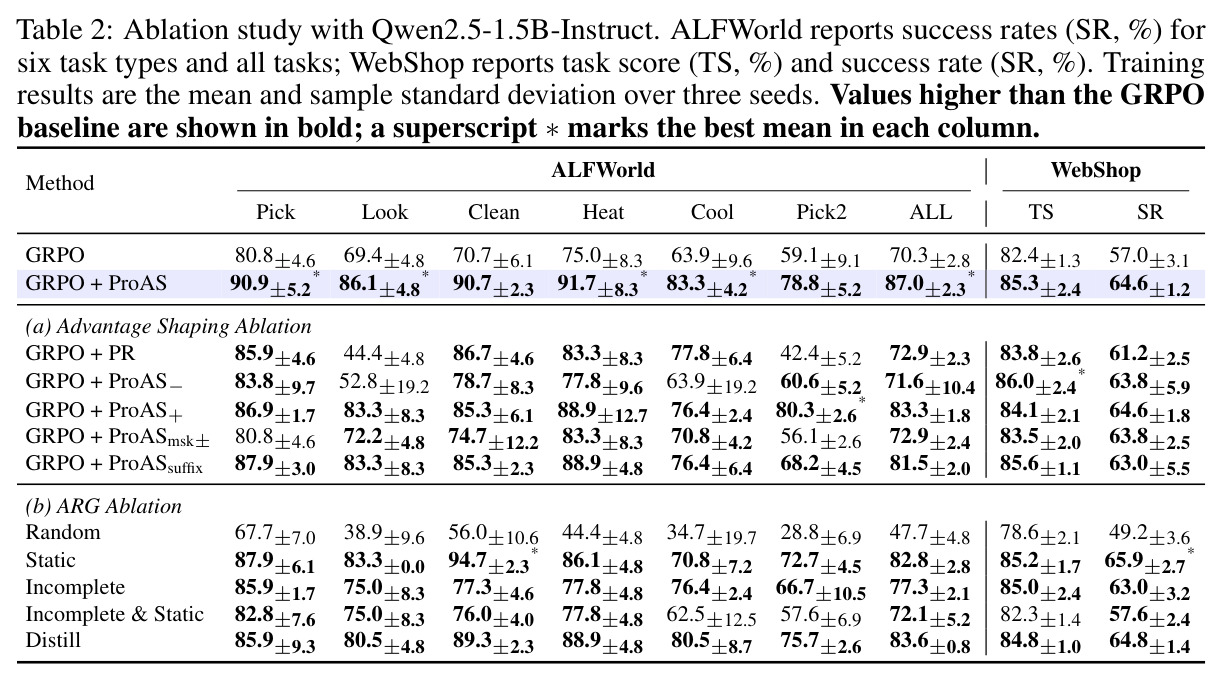
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ALFWorld 全任务成功率(Qwen2.5-1.5B) | SR (%) | 91.9(GiGPO+ProAS);GRPO+ProAS 87.0 | GiGPO 90.1;GRPO 70.3;MiGPO 91.1;SFT 79.7 | 比 GRPO +21.6;GRPO+ProAS 比 GRPO +16.7(全文最大单点提升) |
| ALFWorld 全任务成功率(Qwen2.5-7B) | SR (%) | 94.3(GiGPO+ProAS) | GiGPO 93.8;MiGPO 91.9;GPT-5.6-Sol 78.9 | 比 MiGPO +2.4;比 GPT-5.6-Sol +15.4,创最高纪录 |
| WebShop 成功率(Qwen2.5-1.5B) | SR (%) | 66.7(DAPO+ProAS 与 GiGPO+ProAS 并列) | MiGPO 53.6;DAPO 57.3;GiGPO 64.3 | 比 MiGPO +13.1;DAPO+ProAS 比 DAPO +9.4 |
| WebShop 成功率与任务分(Qwen2.5-7B) | SR (%) / TS | 70.8 / 89.0(GRPO+ProAS) | GRPO 67.7 / 85.6;MiGPO 67.2 / 88.0 | SR +3.1,TS +3.4,均为 7B 块最佳 |
| ALFWorld 训练效率(7B) | Spd@70 加速比(达到 70% SR 所需步数之比) | GiGPO+ProAS 2.44×;GRPO+ProAS 2.20× | 对应无塑形的 GiGPO / GRPO | 收敛最高提速 2.44×,7B 上平均约 2.2× |
| WebShop 训练效率(1.5B) | Spd@50 加速比 | GRPO+ProAS 1.79× | GRPO | 1.5B 两环境平均约 1.5×,效率收益随模型规模放大 |
局限与改进
作者承认的局限:Fig.1(b)(c) 与 Table 7/8 的介入实验基于单条案例轨迹,且各干预位置的前缀与剩余视野不同,只能作为诊断性趋势证据而非普适因果估计;ALFWorld/WebShop 的 ARG 初始化依赖官方标注或环境元数据生成的 oracle,而现实中金标成功轨迹常不可得(他们用 7B 蒸馏实验部分缓解)。我自己的观察:环境覆盖窄——只有 ALFWorld 与 WebShop 两个子目标天然有序、成败可自动判定的经典基准,未验证 AppWorld、SWE-bench 等开放域,'严格序列子目标'假设在那里可能不成立;最大只测到 7B,scaling 行为未知;WebShop 绝对成功率仍只有 66–70%,远未饱和;Static(不演化)图在 WebShop SR 反而全场最佳(65.9%),说明在线演化的收益并非普适,其触发条件值得追问;二值标注无法表达'部分推进'的连续进度;整套方法依赖可验证的结果奖励,对难以自动判分任务不适用。
独立分析的弱点
独立分析四个弱点。其一,参考图依赖外部知识:开放任务(软件工程、GUI 操作)没有官方子目标标注,教师模型也可能采不到足够多的成功轨迹,ARG 的构建成本会成为推广瓶颈;改进方向是从无标注成功 rollout 中自动归纳子目标(状态聚类成等价类),或用 LLM 先验自动合成再人工抽检。其二,二值标注与硬掩码过于激进:$Re_{at}=0$ 直接把优势置零,可能误杀'不在图内但实际有效'的探索动作,长期或抑制多样性、加剧局部最优;改进方向是软掩码(按图匹配置信度缩放优势)或保留下限的 $\epsilon$-掩码,并在实验中监控熵的变化。其三,未来漂移的因果性有限:$D_{i,t}$ 高只说明该步之后有很多非推进动作,未必由该步'导致'(作者自己也只称其为诊断代理);改进方向是在大量轨迹上做系统化的介入实验,或用倾向得分/后门调整校正混杂因素。其四,与步级优势算法的整合偏 ad-hoc:GiGPO+ProAS 需要按优势幅度聚类再做 future-miss 归一化,规则复杂且未给出理论依据;改进方向是建立统一的步级优势-塑形分析框架,量化塑形引入的梯度偏差与方差。
未来方向
作者明确展示的方向是蒸馏 ARG:用 7B 教师模型生成成功轨迹建图(覆盖 2566 个任务)已验证可行,后续可研究教师-学生协同的自动建图、质量过滤与图去噪。基于本文成果可延伸的方向:(1) 自动子目标归纳——用状态聚类或 LLM 抽象把 ARG 构建从人工标注中解放出来,推广到 AppWorld、τ²-Bench、SWE-Agent 等真实长视野任务;(2) 与 critic 类方法结合——检验塑形思想在 PPO/VAPO 或过程奖励模型存在时是否仍有增益,或用塑形信号辅助 critic 训练;(3) 理论化——分析 MUI 掩码与 APR 再分配对策略梯度偏差、方差与收敛性的影响;(4) 连续进度信号——用图距离(当前状态到目标的期望转移数)替代二值 $PA_t$,构造更平滑的优势权重,缓解硬掩码的探索抑制;(5) 跨任务共享图——让 ARG 片段在相似任务间复用,形成可组合的技能先验,并与课程学习结合。
复现评估
复现条件较好。代码开源(github.com/LINs-lab/ProAS),训练基于公开的 Verl-Agent 框架,模型为公开的 Qwen2.5-1.5B/7B-Instruct,环境 ALFWorld/WebShop 均公开且 ARG 可由官方标注直接初始化。附录 B 给出完整超参:AdamW 学习率 $10^{-6}$、权重衰减 0.01、梯度裁剪 1.0、PPO 裁剪 0.2、熵系数 0.001、KL 系数 0.01,每次迭代 16 任务×G=8 轨迹、温度 1.0;奖励为成功 10/失败 0、无效动作罚 0.1;训练 150 步、每 10 步在 128 个固定验证任务上评估、3 个种子报告均值±样本标准差。算力门槛低:1.5B 每次运行 2 张 GPU、7B 4 张。主要难点有二:一是 ARG 构建的工程细节(ALFWorld 有众包标注可用,WebShop 需按任务元数据生成子目标与 oracle,纯化与状态等价类定义需要细心实现);二是蒸馏实验需先用 7B 模型采集成功轨迹。总体属于中等难度,熟悉 RL 训练框架的团队可在数天内复现主结果表。
论文图表
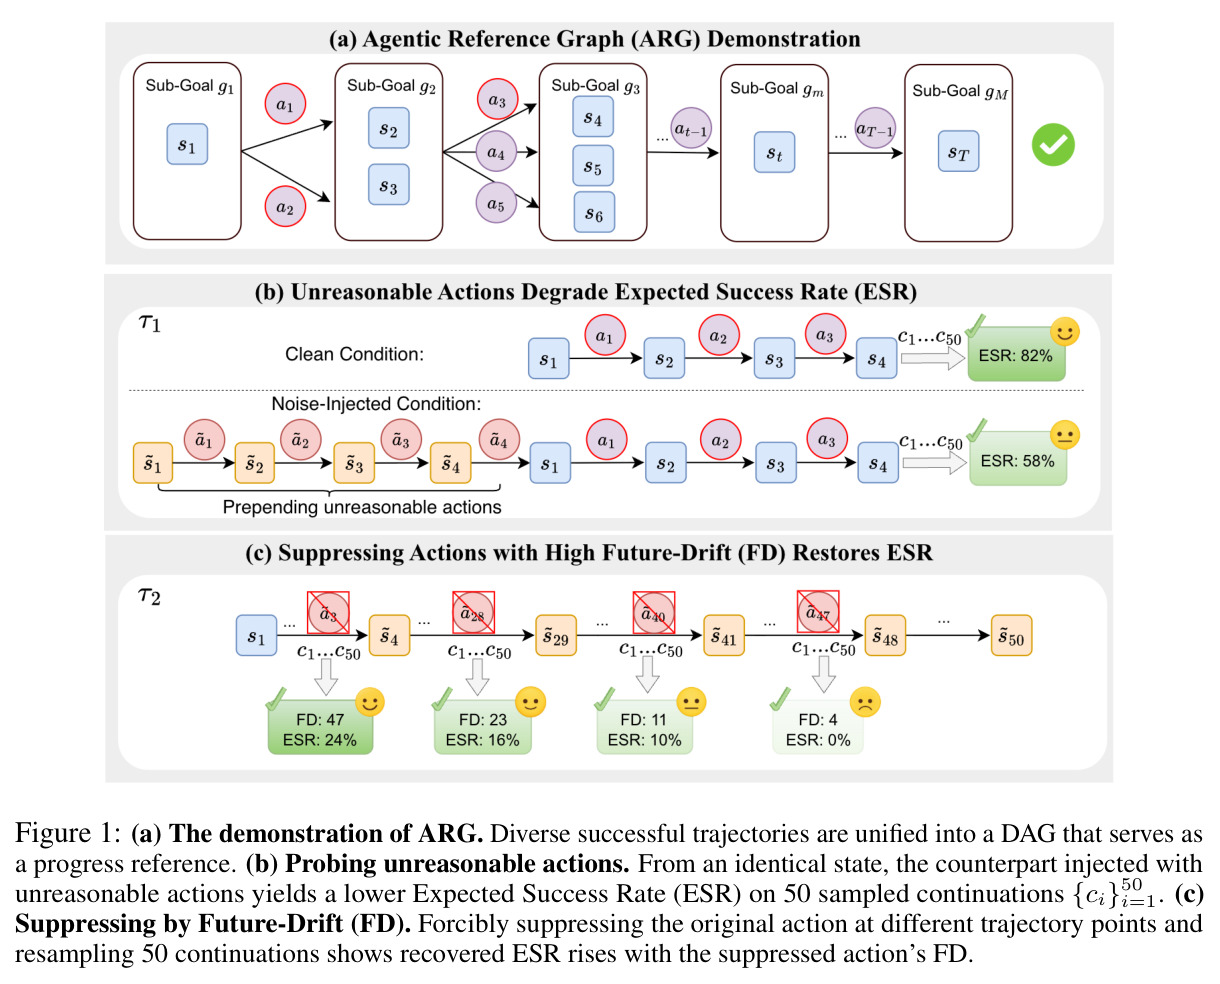
图 1 是全文的纲领图。(a) 展示多条不同的成功轨迹如何被统一成一棵作为进度参考的 DAG(子目标为顶点、合法转移为边);(b) 展示不合理动作探针实验:从同一环境状态出发,注入 4 步不合理动作的可见历史使 50 条续采样的期望成功率 ESR 从 82% 降到 58%;(c) 展示未来漂移抑制实验:在失败轨迹的不同位置强行禁止原动作并重采样 50 条,恢复的 ESR 随被抑制动作的 FD(47/23/11/4)单调升至 24%/16%/10%/0%。
这张图同时承载方法的三大支柱:ARG 的形式化定义、Insight 1(噪声上下文妨碍成功)与 Insight 2(高 FD 动作应优先抑制)的实验证据。看懂它就理解了 ProAS 为什么'正优势要掩码、负优势要按漂移再分配'。
主结果表,覆盖 GPT-5.6-Sol、Direct Prompt、SFT、PPO、MiGPO 及 GRPO/DAPO/GiGPO±ProAS 共十余种配置,按 1.5B 与 7B 两个模型块报告 ALFWorld 六类任务成功率与全任务 SR、WebShop 的 TS 与 SR,并附 Spd@70/Spd@50 加速比;所有数值为 3 个种子的均值±样本标准差。核心结论:GiGPO+ProAS 达 91.9%/94.3%(ALFWorld),GRPO+ProAS 在 7B WebShop 达 70.8% SR,全部 ProAS 变体均超过其基线算法。
这是论文最核心的证据表,RQ1(性能与效率)与 RQ2(算法兼容性)的结论全部由它支撑,也是与他人工作对比的基准。
列出 ALFWorld 六类任务(Pick、Look、Clean、Heat、Cool、Pick2)在三个冻结训练种子与共享验证集中的去重数量:每个种子约 1767–1784 个训练任务,验证集固定 128 个(如 Pick 33、Clean 25、Cool 24)。
交代训练/评测数据的规模与类别分布,帮助读者判断各任务的样本支撑度,理解为什么 Table 1 中按任务类别分解报告成功率。
列出 WebShop 五个品类的任务分布:Fashion 占绝对多数(每种子约 1568–1577 个),Garden 约 283–294,Electronics/Grocery/Beauty 各几十个;每种子约 2011–2036 个训练任务,验证集 128 个。
说明 WebShop 的数据高度不均衡且整体更难(GPT-5.6-Sol 仅 21.9% SR),是解读该环境上提升幅度小于 ALFWorld 的背景信息。
'Look at a pencil under the desk lamp' 案例:第 17 轮的一条成功 rollout 中,examine desk 1 重复、inventory 等无效/自环步骤被剪除(Prune),有效步骤被保留;其中 take pencil 1 from desk 1 是旧图 G(17) 不含的新路径,经验证成功后作为新参考路径合并,产生新子目标 g′3(pencil 1 acquired),得到演化后的 G(18)。
具体展示 Eq.5 在线演化机制的'纯化 + 严格并集'流程,说明 ARG 如何在不破坏图纯度的前提下逐步覆盖环境的多种有效解法。
展示 turn 级输入格式:系统提示 + 任务指令(put two book in bed)+ 最近 2 轮观测-动作历史 + 当前观测与可执行动作列表,监督目标为 <think>推理</think><action>open drawer 1</action> 的结构化回复;SFT 与 RL 共用该格式,仅回复来源不同(离线专家 vs 在线采样)。
交代 SFT 基线与所有 RL 方法共享的观测/动作接口,保证各方法对比公平,也是复现时搭建 prompt 的直接模板。
WebShop 版 turn 级样例:任务指令(价格低于 150 美元的翻页唱机)、上一轮 search[turntables] 与观测(含商品 B09Q6CZ59K 与价格 $110.54)、可执行动作列表,目标回复为点击目标商品;格式与 ALFWorld 一致。
与 Table 11 一起完整给出两个环境的输入模板与动作空间书写规范,对复现 RL/SFT 管线必不可少。