面向代码智能体强化学习的组级智能体评分与优势重分配 Groupwise Agentic Grading and Advantage Redistribution for Code Agent RL
组内智能体评分器给通过测试的解排质量序,和保持地重分配优势,稳定代码智能体RL。
前置知识
GRPO 与组相对优势估计
Group Relative Policy Optimization 是 LLM 强化学习的主流算法:对每个任务采样一组(group)轨迹,用组内奖励的相对比较代替价值网络来估计优势。在最常见的代码智能体设置里,奖励是可执行测试给出的二值结果,同一组内所有通过测试的轨迹获得完全相同的正优势,失败轨迹获得相同的负优势。
本文的问题起点正是 GRPO 的这一性质:通过测试的解被一视同仁,实现质量的差异完全不进入学习信号。理解组相对优势的结构,才能看懂 Gagar 在哪一环介入。
均值中心化优势(Dr. GRPO 风格)
本文采用的优势估计形式:$A_i = R_i - \bar{R}$,其中 $\bar{R} = \frac{1}{n-1}\sum_{j=1}^{n} R_j$ 是组内平均奖励。它不像原始 GRPO 那样再除以组内奖励标准差,因此优势的绝对尺度直接反映组内通过率,组内所有优势之和恒为零。
和保持重分配的所有推导都建立在这个形式上:正优势之和 $S^+$ 与失败侧优势在重分配前后必须精确不变,这是公式 (2)-(4) 的推导基础。
动态采样(Dynamic Sampling)
来自 DAPO 的训练技巧:训练时只保留那些既有通过轨迹又有失败轨迹的混合结果组(即 $0 < \bar{R} < 1$),把全通过或全失败的优势为零的组过滤掉,避免它们对梯度没有贡献却浪费算力。
Gagar 建立在动态采样之上:只有混合结果组才存在'成功之间比质量'的问题,评分器只对这类组运行,这是方法效率和有效性的前提。
智能体评分器(Agentic Grader)
不是一个静态打分模型,而是一个能多轮交互、主动取证的 LLM 评审智能体:它先读轨迹逐轮摘要定位疑点,再细读轨迹片段、把补丁与仓库代码和测试日志交叉核对,必要时运行针对性检查,负评必须引用补丁位置、轨迹事件或执行结果作为证据。源于 Agent-as-a-Judge 思想。
Gagar 与纯文本打分类过程奖励(如 ReCode、TRIAGE)的本质区别就在这里:判断'改动是否最小、是否有副作用'需要仓库上下文和执行证据,静态输入塞不进单个模型上下文。
信用分配与优势塑形
强化学习中决定'哪条轨迹、哪个动作、哪个 token 该为最终结果负责并获得多少强化'的一类技术。优势塑形(advantage shaping)在优化层面调整各轨迹优势的相对大小,而不改变环境奖励本身;关键约束是塑形后正负优势的平衡不能被破坏,否则会导致策略熵失控。
Gagar 本质上是一次优势塑形:把质量偏好编码进通过轨迹的优势权重。论文的消融(只打折 vs 和保持)说明信用分配中'总量守恒'这一约束对训练稳定性起决定作用。
研究动机
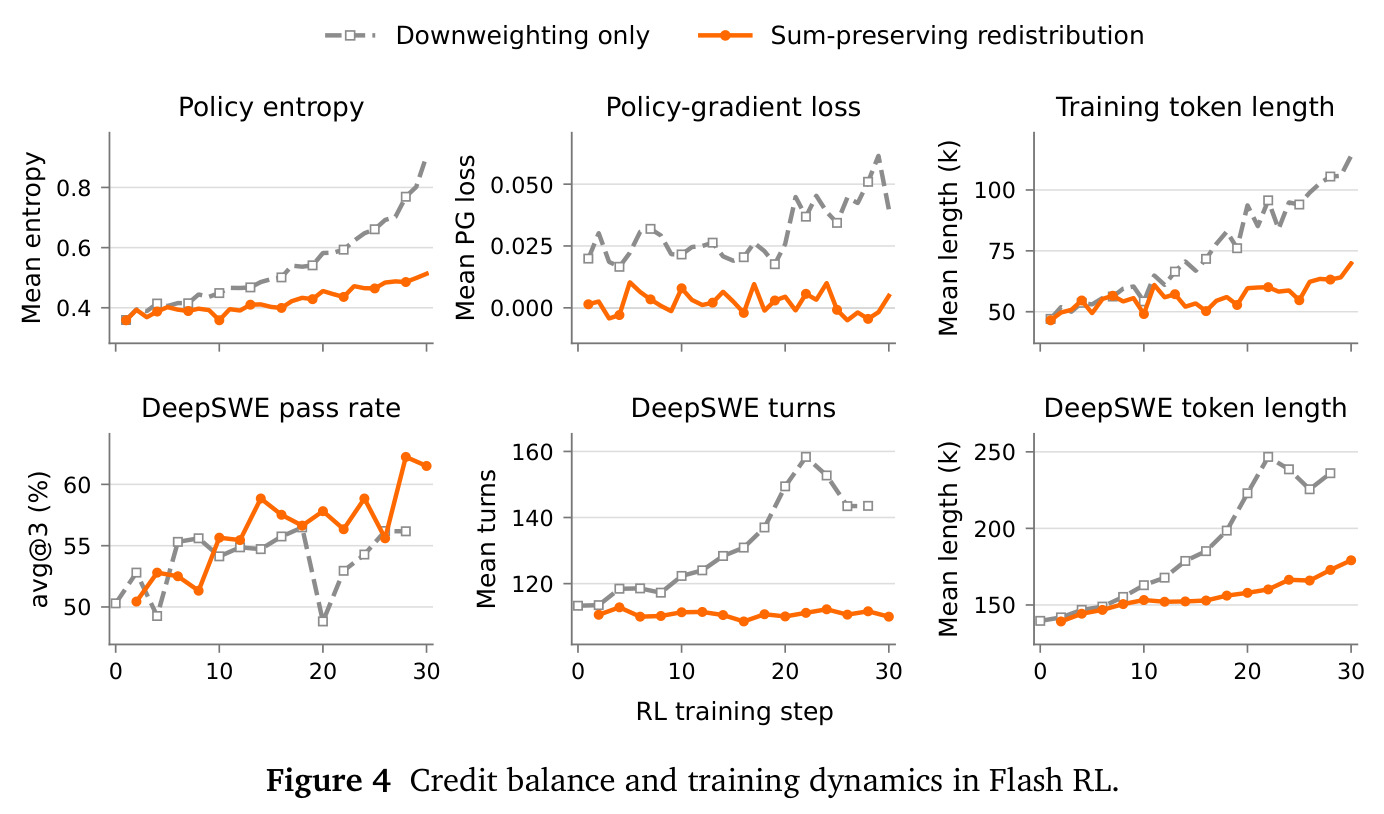
现有代码智能体 RL 普遍以可执行测试为奖励来源:轨迹提交的补丁通过测试得 1、否则得 0。在 GRPO 式组相对优势下,同一 rollout 组内所有通过测试的轨迹拿到完全相同的正优势,实现质量差异完全不进入学习信号。论文指出,同样通过测试的两个补丁,可能一个直击根因、遵循仓库规范、改动最小、可直接合并;另一个引入不必要的复杂度、削弱验证逻辑、或修改了任务范围之外的代码。这些差异直接决定开发者的 review 和返工成本,二值反馈却完全忽略它们。更麻烦的是,若只是简单给低质量通过解打折,组内总正优势会缩水而失败侧负优势不变,正负信用失衡会引发训练崩溃——论文实验中表现为策略熵 30 步内从 0.359 涨到 0.905、平均轨迹长度从 47.1k 涨到 114.1k token、DeepSWE 通过率从 56.5% 跌到 48.8%。核心问题因此有两层:如何把实现质量变成训练信号,以及如何在注入质量偏好的同时不破坏信用平衡。
本文的目标是本文的目标是让代码智能体 RL 在二值测试结果之外,进一步奖励干净、精准、可直接合并的实现。具体拆成三点:其一,对同一任务的所有成功轨迹做组内质量比较,识别不必要的复杂改动、越界修改和低效解题策略,把强化信号更多分配给高质量实现;其二,严格保持组内总正优势不变、失败轨迹优势不变,使质量偏好以零和方式在成功解之间转移,避免正负信用失衡;其三,让这套机制在工业级训练中真正可落地——在 MiMo-V2.6-Flash(310B 总参、15B 激活)与 MiMo-V2.6-Pro(1.02T 总参、42B 激活)的大规模混合任务 RL(每次更新 1568 prompts × 16 rollouts)中验证,目标是提升 DeepSWE v1.1 与 SWE-bench Pro 通过率、降低交互轮数与 token 消耗,并保证训练后期不出现基线那样的性能骤降。
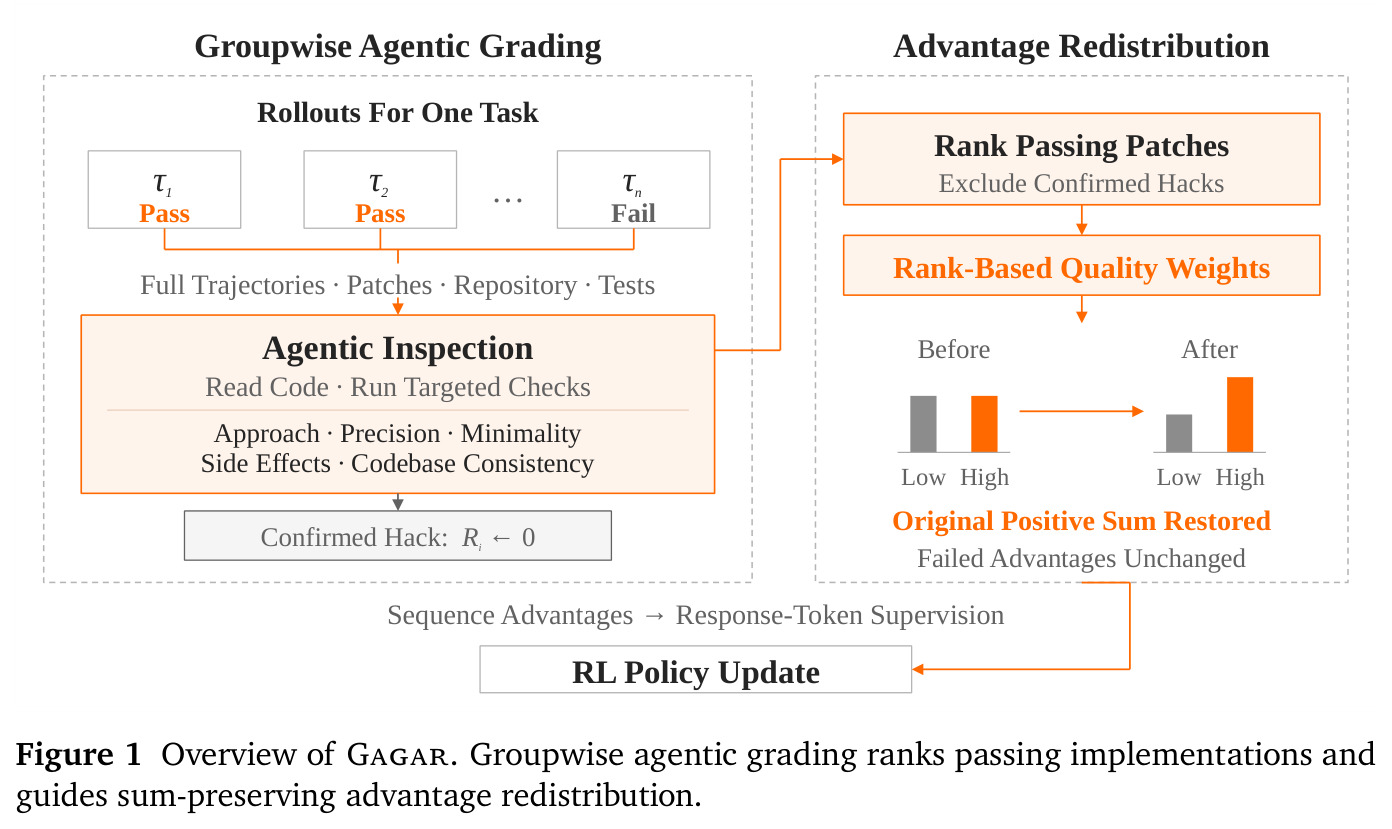
与已有工作不同的是,已有工作各有切入但都留有缺口:ReCode 为通过解加候选级过程奖励、TRIAGE 提供段级监督,但都是孤立地给单条轨迹打分,缺乏组间比较;CPO/GRRM 用比较评估却限于对话和翻译;Agent-as-a-Judge 用智能体检查任务产物但没有做组内联合审查;Groupwise Ranking Reward 虽然做了组内排名,却用单轮文本评分器处理多模态推理,无法检查仓库和执行结果;PAPO 基于固定 rubric 在通过子集内做零和修正,评分器不能主动取证。本文的独特组合有三点:组内比较——把同一任务的所有通过与失败轨迹放进共享工作区联合审查,失败轨迹作为背景暴露无效策略,孤立评估难以发现的'不必要改动'由此显形;智能体探查——评分器可读仓库代码、交叉核对补丁与测试日志、运行针对性检查;和保持重分配——被扣掉的信用不是丢弃,而是按质量权重比例再分配给其他通过解,总正优势与正负信用比严格守恒。
核心方法
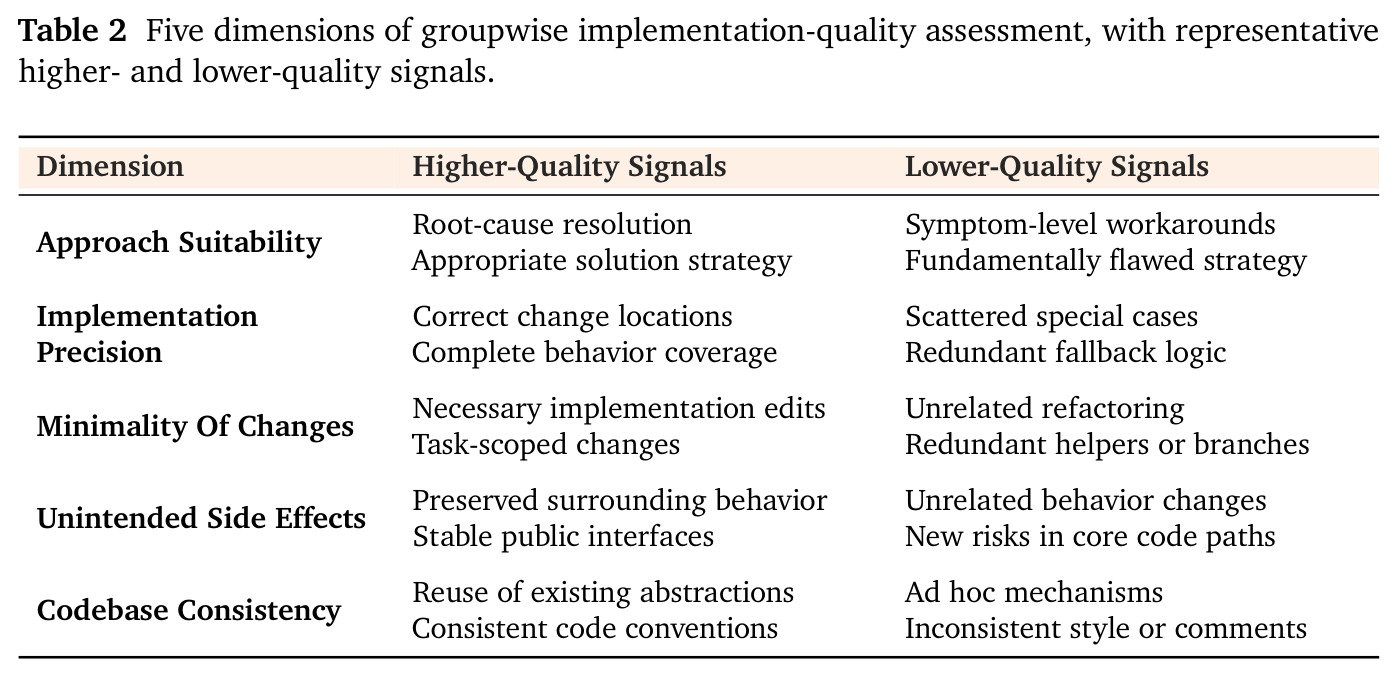
直觉上,Gagar 把'哪些成功更值得奖励'交给一个能动手查证据的评分器回答,再用一套保守权重比例的缩放把偏好写进优势。流程四步:先用动态采样只保留既有通过又有失败的混合结果组($0 < \bar{R} < 1$),优势采用均值中心化形式 $A_i = R_i - \bar{R}$;然后为每组构建共享工作区(任务、仓库、轨迹、补丁、测试输出),SFT 训练的智能体评分器迭代取证:先读逐轮摘要定位疑点,再细读轨迹、把补丁与仓库代码和测试日志交叉核对,必要时运行针对性检查;评分器沿五个维度(方案适配性、实现精度、改动最小性、副作用规避、代码库一致性)给通过候选排序并划分 T1/T2/T3 三个质量层级,确认依赖泄露答案的作弊解直接置零奖励;最后按排名把通过轨迹映射到折扣因子 $f_i \in (0,1]$,用公共缩放 $\lambda = S^+ / \sum_{j\in\mathcal{P}} f_j A_j$ 重分配,使 $\sum_{i\in\mathcal{P}} A_i^* = S^+$ 严格不变,序列优势广播到响应 token 后更新策略,评分与 rollout 生成异步重叠。
核心创新是'和保持优势重分配'。若只按质量因子打折($\tilde{A}_i = f_i A_i$),每个通过解被扣 $(1-f_i)A_i$,失败侧负优势不变,组内正负信用失衡——消融显示只打折的策略梯度损失均值 0.0304 对 0.0021,策略熵 30 步内从 0.359 飙到 0.905。Gagar 改为乘公共缩放因子恢复原总正优势:$A_i^* = \lambda f_i A_i$(通过集),失败侧 $A_i^* = A_i$ 不动。由于所有通过解初始优势相同,更新等价于 $A_i^* = (1-\bar{R})\, f_i / \bar{f}$:因子高于通过集均值 $\bar{f}$ 的解获得信用、低于均值的让出信用,偏好比例 $A_i^*/A_j^* = f_i/f_j$ 严格保持。与 GRPO'成功即同权'、ReCode/TRIAGE'孤立打分'、PAPO'固定 rubric'不同,信用是从低质量成功解'转移'而非丢弃,总正优势、失败侧优势和偏好顺序三者同时守恒,这是训练稳定的数学根源。
方法步骤详情
第一步,rollout 与奖励:每任务生成 16 条轨迹(训练 batch 128),可执行测试给出二值结果,作弊解奖励置零并视作失败,得到优势 $A_i = R_i - \bar{R}$。第二步,动态采样:只保留通过集 $\mathcal{P}$ 与失败集 $\mathcal{F}$ 都非空的组。第三步,组级智能体评分:在线评分器是 MiMo-V2.6-Pro 的 SFT 检查点(每组评分 2000 秒→600 秒);评分器先查是否依赖泄露答案,再对通过候选按五维标准打分,划分 T1/T2/T3 三层,层内按加权分初排,无据则并列;层级与排名映射为折扣因子 $f_i \in (0,1]$,T1 保满权重、T3 拿最强固定折扣。第四步,重分配:算 $\lambda = S^+ / \sum_{j\in\mathcal{P}} f_j A_j$,通过轨迹取 $A_i^* = \lambda f_i A_i$,失败轨迹保持 $A_i$;仅一个通过解或因子全相同时退化为原始优势。第五步,训练集成:校验评分完整性,不可用则回退;序列优势广播到响应 token 做 token-mean 更新。
技术新颖性
技术新颖性体现在四个层面。其一,评估范式:把组内比较从多模态推理的单轮文本评分器推进到代码智能体场景,评分器是可交互的智能体,能读仓库、追轨迹、跑针对性检查,负评必须引用补丁位置、轨迹事件或执行结果作证据——这是纯文本静态评估做不到的。其二,优势构造:不同于在奖励空间做 shaping(mean centering 只保证零均值,不能同时保证总正优势、失败侧优势和质量权重比三个约束),本文直接在优势空间推导,并证明可从目标优势分配反推出等价的奖励变换(附录 A.3)。其三,守恒性质:重分配在通过子集上零和($\sum_i (A_i^* - A_i) = 0$),失败侧完全不动,且 $A_i^*/A_j^* = f_i/f_j$ 保序——把质量偏好与信用总量解耦成两个独立可控的性质,这一守恒框架还可下沉到 token 级复用。其四,工程可行性:用 SFT 蒸馏评分器(2000 秒→600 秒)并结合部分 rollout 调度让评分与生成重叠,使方法在 1568 prompts × 16 rollouts、最高 1.02T 参数的工业规模混合任务训练中真正可运行,而非只在玩具设置里生效。
实验结果
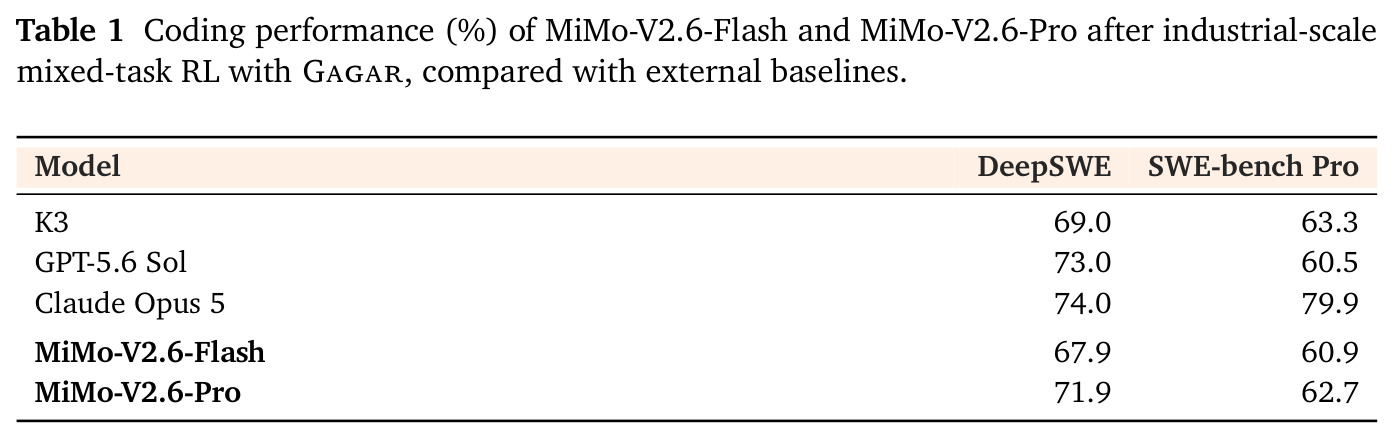
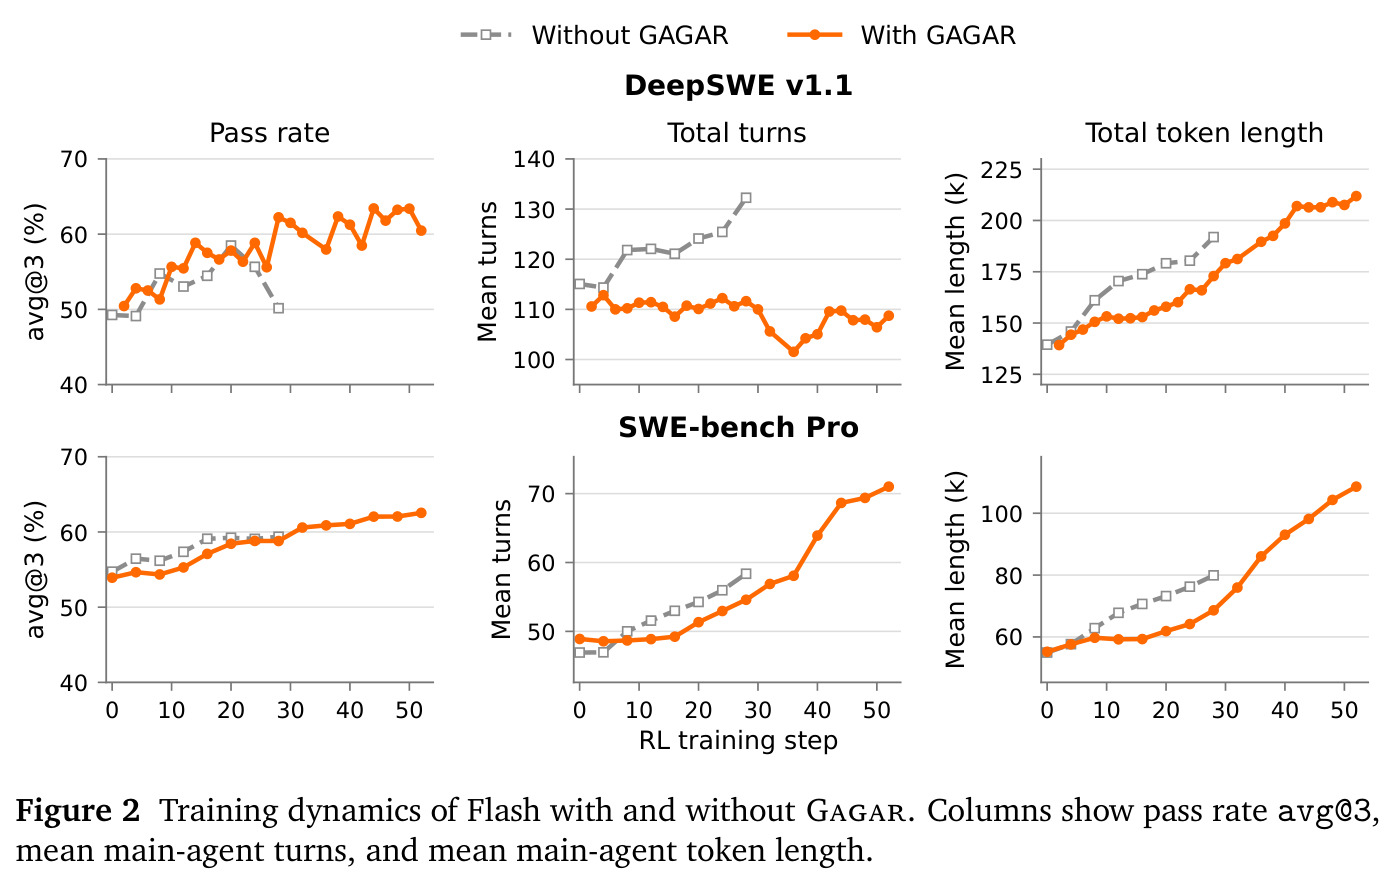
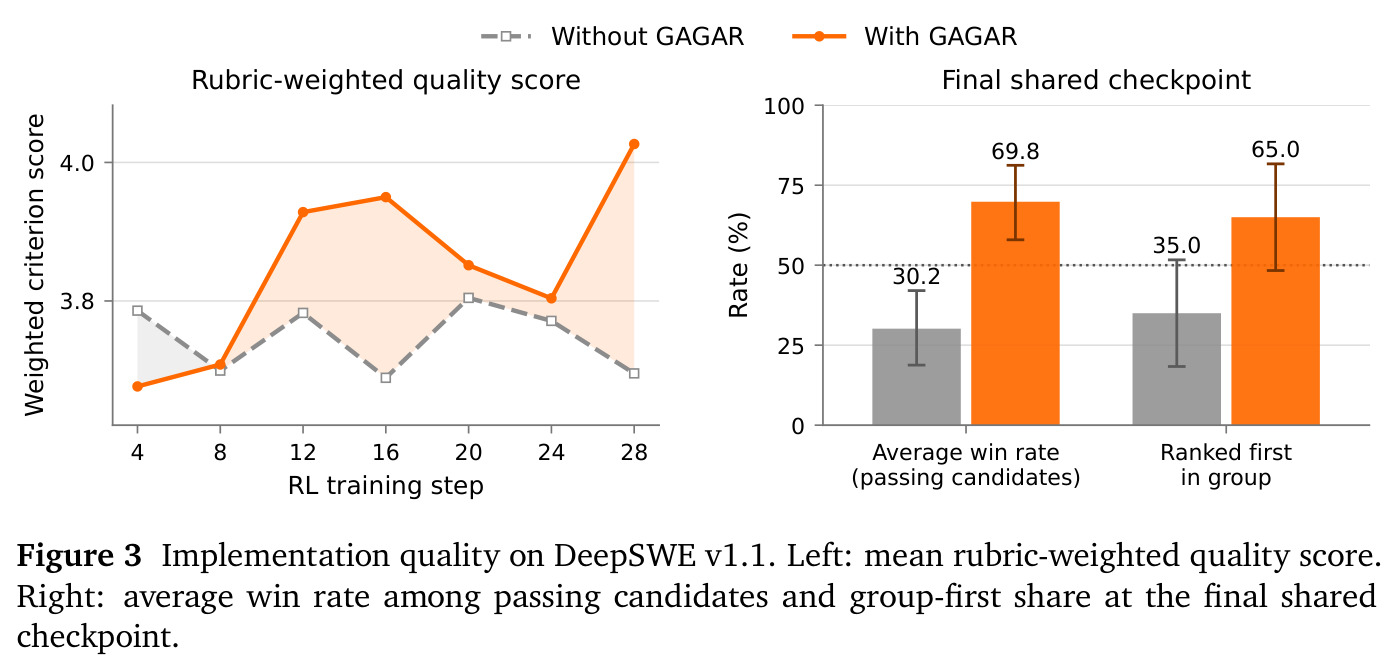
主实验用 Flash 做 code-only RL 对照。DeepSWE v1.1 上,基线在 step 28 因性能骤降被停(58.5%→50.2%),Gagar 同 step 达 62.2%(+12.1pp),step 44 峰值 63.4%;SWE-bench Pro 上基线停在约 59%,Gagar 涨至 step 52 的 62.5%。效率上,step 28 时 DeepSWE 轮数与 token 分降 15.6%(132.3→111.6)和 9.9%。盲评:Gagar 4.03 对 3.70,通过解间胜率 69.8%,65.0% 的组居首,T1 占比 25.4%→34.3%。消融证实'和保持'是稳定关键:只打折时策略梯度损失 0.0304 对 0.0021,熵 0.359→0.905,DeepSWE 通过率跌至 48.8%。工业级混合 RL 后,Flash 与 Pro 的 DeepSWE avg@3 为 67.9 与 71.9;Pro(1.02T)超 2.8T 的 Kimi K3(69.0),SWE-bench Pro 62.7% 超 GPT-5.6 Sol(60.5%)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| DeepSWE v1.1(长程软件开发,code-only RL,step 28 对照) | pass rate avg@3 (%) | 62.2(继续训练峰值 63.4 @ step 44) | 50.2(二值奖励,step 20 时为 58.5 后骤降) | +12.1 个百分点 |
| SWE-bench Pro(仓库级 issue 修复,code-only RL) | pass rate avg@3 (%) | 62.5 @ step 52 | 约 59(step 16 起平台期) | 约 +3.5 个百分点且保持上升趋势 |
| DeepSWE v1.1 交互效率(step 28) | 平均交互轮数 / 平均 token 长度 | 111.6 轮 / 172.9k | 132.3 轮 / 191.9k | -15.6% / -9.9% |
| SWE-bench Pro 交互效率(共享 checkpoint) | 平均交互轮数 / 平均 token 长度 | 54.6 轮 / 68.6k | 58.4 轮 / 79.9k | -6.5% / -14.1% |
| DeepSWE v1.1 实现质量盲评(最终共享 checkpoint) | rubric 质量分 / 通过解间平均胜率 / 组内第一占比 | 4.03 / 69.8% / 65.0% | 3.70 / 30.2% / 35.0% | 质量分 +0.33,T1 层占比 25.4%→34.3% |
| 工业级混合任务 RL(MiMo-V2.6-Pro,1.02T) | DeepSWE v1.1 avg@3 (%) | 71.9 | Kimi K3 69.0(2.8T);GPT-5.6 Sol 73.0;Claude Opus 5 74.0 | 参数量不到 K3 的一半仍领先 K3 2.9 个百分点 |
| 工业级混合任务 RL(MiMo-V2.6-Pro) | SWE-bench Pro (%) | 62.7 | GPT-5.6 Sol 60.5;Kimi K3 63.3;Claude Opus 5 79.9 | 超过 GPT-5.6 Sol 2.2 个百分点 |
局限与改进
作者承认的局限主要在证据范围:受控实验只在 Flash 一个模型家族、两个公开基准(DeepSWE v1.1、SWE-bench Pro)上进行,Pro 仅有混合任务结果而缺少受控对照;质量盲评样本较小(30 个 DeepSWE 任务、每组最多 3 条 rollout),且依赖 Claude Opus 5 作外部裁判,裁判自身偏差未被讨论;评分器准确率只以'保持良好'带过,没有给出与人类判断的一致性数字;作弊判定的漏判/误判率及其对训练的影响均未量化。我自己的观察:方法隐含依赖测试能可靠反映任务完成度,当测试覆盖不足时'通过测试'与'实现正确'可能脱节,评分器也缺乏执行证据来纠偏;五维质量标准与 T1/T2/T3 映射规则在附录,对超参的敏感性未知;每组约 600 秒的评分开销即使与 rollout 重叠,在组积压时仍可能成为吞吐瓶颈;此外序列级优势均匀广播到全部响应 token,不做 token 级信用分配,无法区分轨迹内的关键编辑与冗余探索;DeepSWE 上 62.5% 与 Pro 的对比均未报告方差或多 seed 置信区间。
独立分析的弱点
第一个弱点是评分器上限:T1/T2/T3 分层与层内排名由单一 SFT 评分器决定,一旦它在某类任务(如跨文件重构、大型依赖链)上系统性偏差,错误信用会持续注入训练。改进方向是多个异构评分器交叉验证,或定期抽样人工审计校准。第二个弱点是作弊检测的时序边界:确认作弊后虽然奖励置零并重算组统计,但漏判的作弊解在该 step 已参与排名甚至可能进入 T1,错误信号已进入梯度;可引入静态答案相似度扫描、执行指纹匹配等确定性预筛作第一道防线。第三个弱点是信用分配粒度:序列级优势均匀广播到所有响应 token,轨迹内的冗余探索与关键编辑获得同等强化,可结合步骤分段做轨迹内重分配,衔接 FACTOR 式细粒度方案。第四个弱点是守恒假设的边界:和保持只约束组内零均值与正负平衡,未约束多组聚合后整体优势方差如何演化,及其与 clip 阈值、学习率调度的交互,值得专门分析。第五个弱点是基准偏窄:受控实验只有 DeepSWE 与 SWE-bench Pro,缺少测试覆盖薄弱、需求模糊任务的压力测试,也缺少多 seed 方差报告,62.5% 这类结论的统计置信度难以评估。
未来方向
论文明确给出的延伸点是 token 级应用:'同一守恒原则可在 token 层执行,在不改变总量的前提下于 token 间重分配正信用',这自然衔接 FACTOR 的轨迹到动作、动作到 token 分配。基于成果可继续推进的方向:其一,评分器与策略协同进化——用训练后期的策略模型或积累的组内比较数据持续更新评分器,缓解分布漂移;其二,把五维质量标准从固定加权改为可学习加权,按任务类型自适应;其三,把守恒重分配扩展到失败侧,与 EDAS 的错误多样性塑形结合成双边方案;其四,质量信号与运行效率奖励(性能导向 reward)联合塑形,覆盖'正确且快'的维度;其五,验证框架在浏览器操作、数据分析等其他长程智能体域的可迁移性——那里同样只有二值结果信号;其六,公开组级评分数据构建代码实现质量的偏好评测基准,让'评分器质量'本身成为可比较的对象;其七,探索评分开销与训练收益的缩放规律,给出何时值得开评分的资源决策曲线。
复现评估
复现难度高。论文来自小米 LLM Core,未提及开源代码、评分器权重、评分 prompt 或 T1/T2/T3 映射细则(位于附录正文未给),MiMo-V2.6-Flash/Pro 的 pre-RL SFT 检查点也未声明公开。数据方面 DeepSWE v1.1 与 SWE-bench Pro 公开可取,但训练任务池(尤其混合任务 RL 的非代码部分)未披露。算力门槛极高:受控实验即需 310B 总参/15B 激活的 MoE 做 RL(batch 128 × 16 rollouts),工业配置为每次更新 1568 prompts × 16 rollouts,Pro 实验达 1.02T 总参/42B 激活;在线评分器本身就是同规模 Pro 检查点,每组约 600 秒,需要大规模异步推理基础设施。学术实验室的现实路径是:用 7B–32B 开源模型复现核心算法——'打折 + 缩放'的数学自包含,公式 (2)-(4) 约 20 行代码可实现,评分器用较小开源模型或前沿 API 替代,重点验证和保持 vs 只打折的消融结论(策略熵与轨迹长度增长是清晰的中间观测量),再逐步逼近完整五维评分协议。
论文图表