精炼即编辑:基于生成式精炼网络的免训练提示到提示图像编辑 Refinement Is Inherently Editable: Training-Free Prompt-to-Prompt Image Editing with Generative Refinement Network
首次在生成式精炼网络上实现免训练图像编辑,用比特概率差定位编辑区域,背景保持大幅领先。
前置知识
生成式精炼网络(GRN)
GRN 是 2026 年提出的图像生成架构:图像被表示为二值码,生成从随机二值噪声出发(每比特等概率取 0/1),由 Transformer 每步并行预测全部二值坐标的概率,再按逐步增大的保留率把预测与同一份固定随机码混合,沿“噪声→粗结构→细节”的路径反复全局精炼。与扩散不同它操作离散比特,与自回归不同它没有固定因果顺序,任何坐标都可以被反复重新考虑。
RefineEdit 的全部分支机制、概率差证据与比特路由都建立在 GRN“全局可复精炼+二值表示”之上,不理解 GRN 的生成过程就无法理解方法本体。
层次二值量化(HBQ)
将图像编码为 $Y\in\{0,1\}^{N\times D}$ 的离散表示:$N$ 为空间位置数(本文 64×64),$D$ 为每个位置的比特数(本文 256,来自 64 个潜通道×4 轮量化),解码器可近乎无损地还原图像。每个坐标 $(n,d)$ 唯一确定空间位置 $n$ 上的第 $d$ 个比特。
本文编辑操作的最小单位就是比特:概率差、空间掩码、比特级掩码、路由全部定义在这些坐标上,粒度比常见的 token 或区域更细。
免训练图像编辑与空间控制
指不更新生成器权重、仅在推理期干预实现编辑的范式。扩散系方法依赖掩码混合、注意力操控(P2P、MasaCtrl)或中间特征注入(PnP)来决定“哪里可以变”;流匹配系方法在源/目标分布间构造传输路径(FlowEdit)。空间控制一旦不准,编辑区域过窄会改动残缺,过宽会误伤无关背景。
本文的动机正是替代这类外挂式空间控制——用两分支概率差自动定位编辑区域,理解该背景才能体会其动机与实验对比设计。
自回归(AR)生成的固定顺序限制
AR 视觉模型按 next-token、next-scale 或 bitwise 的固定因果顺序生成,早期生成的 token 无法回头修改;把分布差用于编辑定位时(如选择源/编辑预测),早期做出的决策难以撤销,改动容易不完整。
论文把“可回改的全局精炼”作为切入 GRN 的核心理由,需要理解 AR 的这一局限,才能领会两条技术路线的本质差别。
Prompt-to-Prompt(P2P)编辑设定
只提供源提示词与编辑提示词、不提供任何掩码的纯文本驱动编辑任务,最初由 P2P 通过注意力图操控实现,现泛指这一任务形式。方法需自行推断该改哪里、改成什么。
RefineEdit 属于该设定:输入只有两条提示词,空间定位完全由模型内部概率差推断,这决定了它与需要外部掩码方法的本质不同。
PIE-Bench 与常用编辑指标
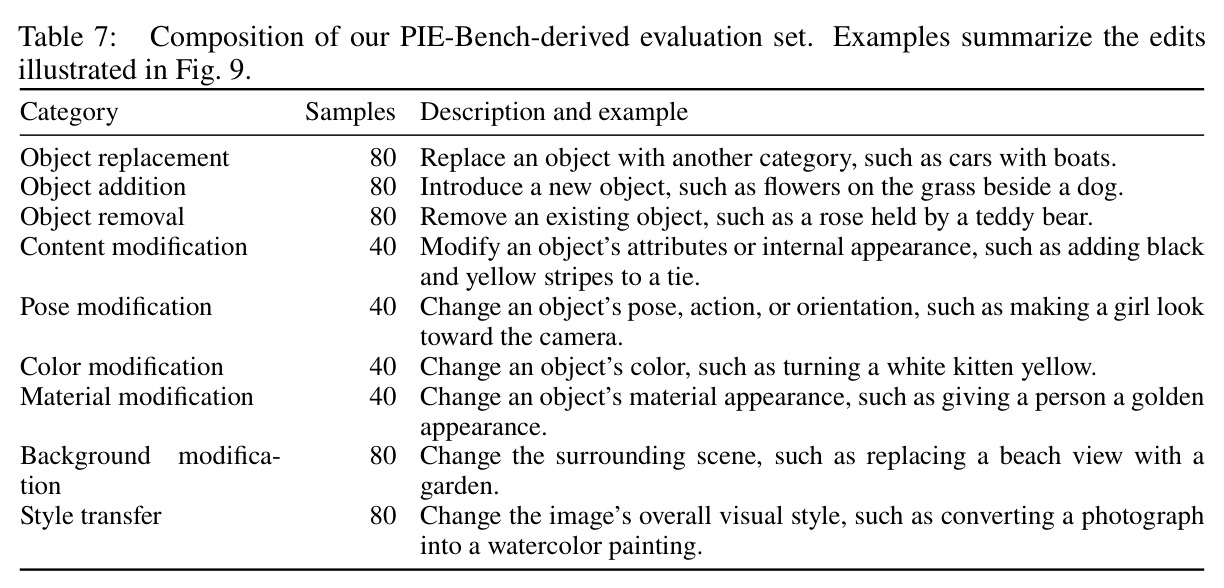
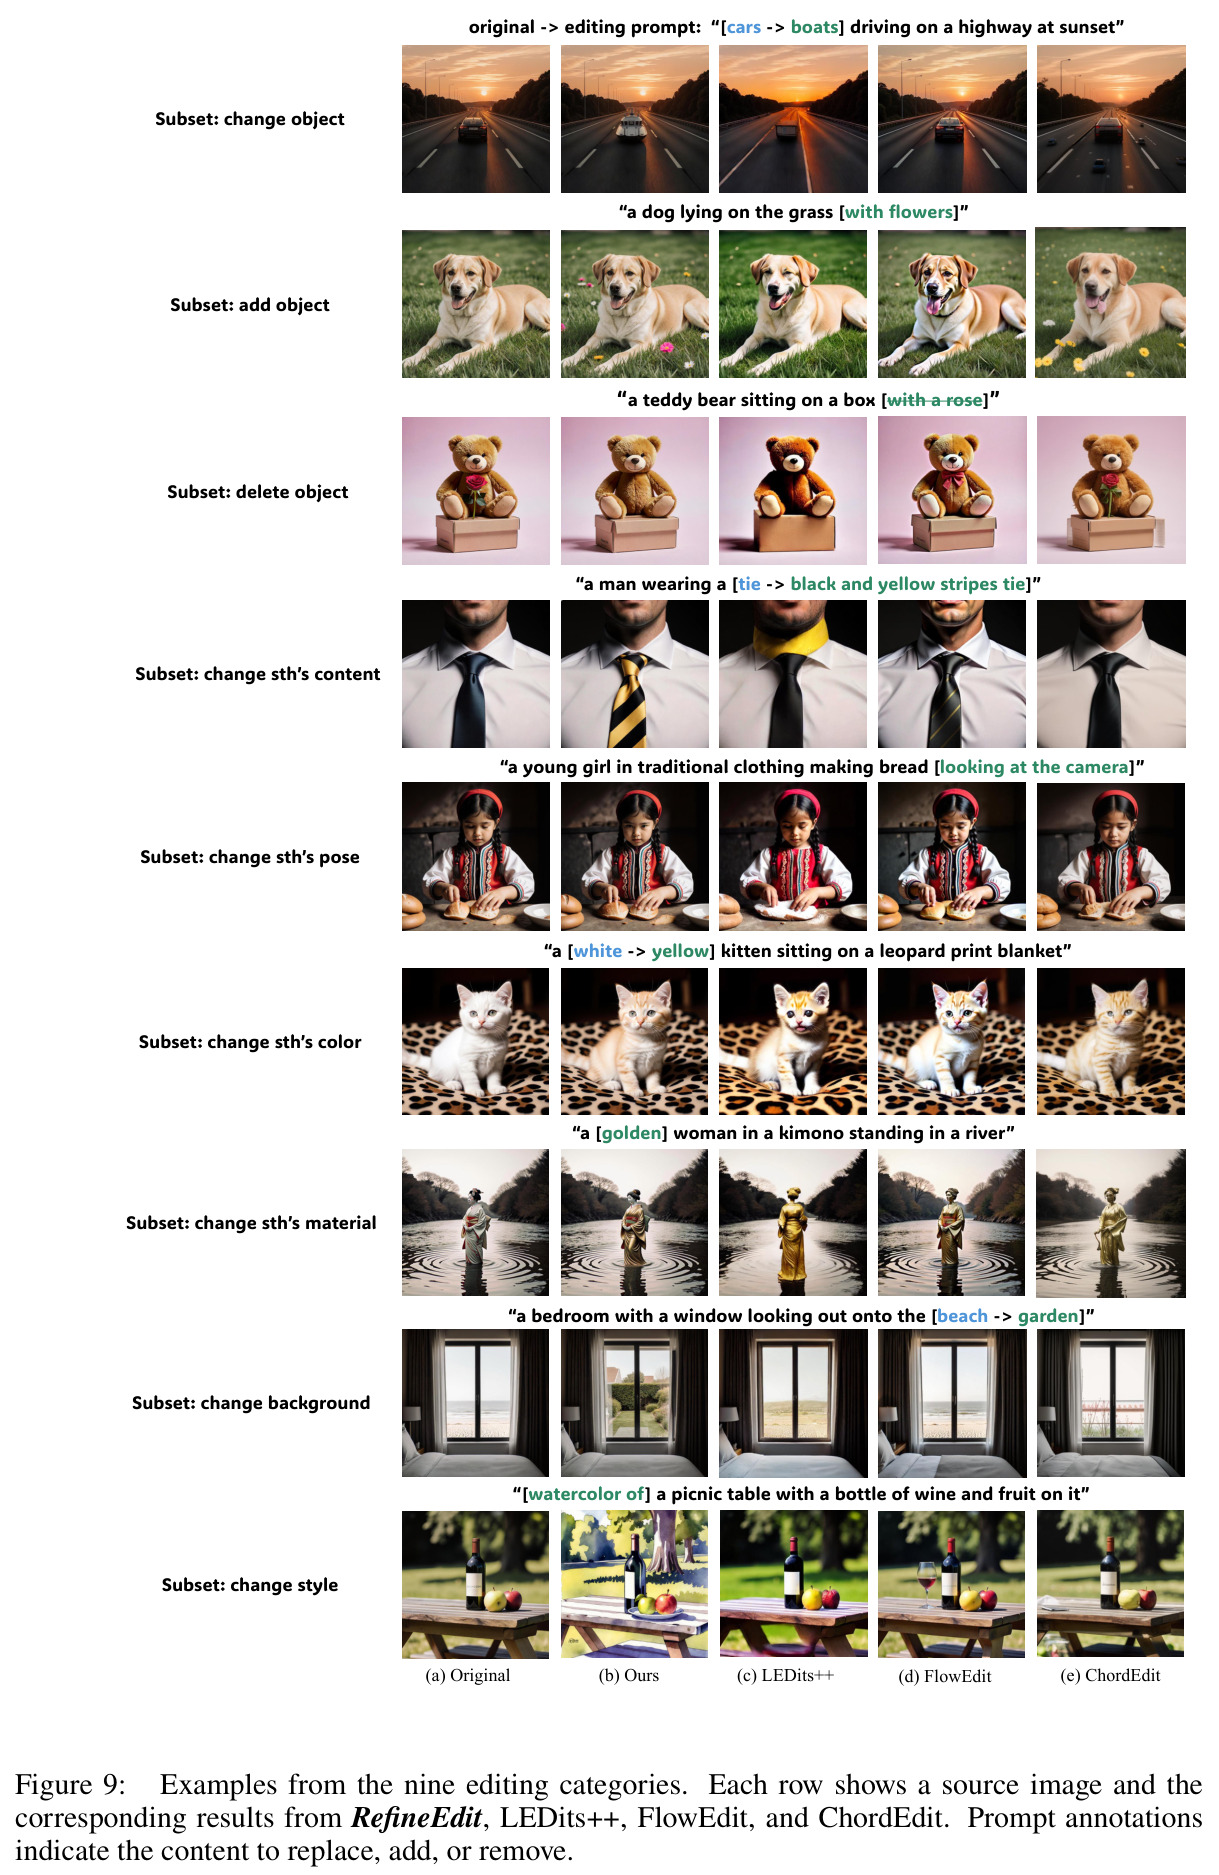
PIE-Bench 是主流图像编辑基准,覆盖九类编辑:物体替换/添加/删除、内容/姿态/颜色/材质修改、背景替换、风格迁移。常用指标:PSNR/SSIM/MSE/LPIPS 在参考编辑掩码之外衡量内容保持,CLIP 分数衡量编辑图与提示词的语义对齐(全图与编辑区两种),Structure Distance 用 DINO ViT 自相似矩阵差异衡量结构变化。
论文所有定量结论(Table 1、5、6)都基于这些指标,理解指标含义才能正确解读“背景保持全面领先、结构距离略逊”的结论。
研究动机
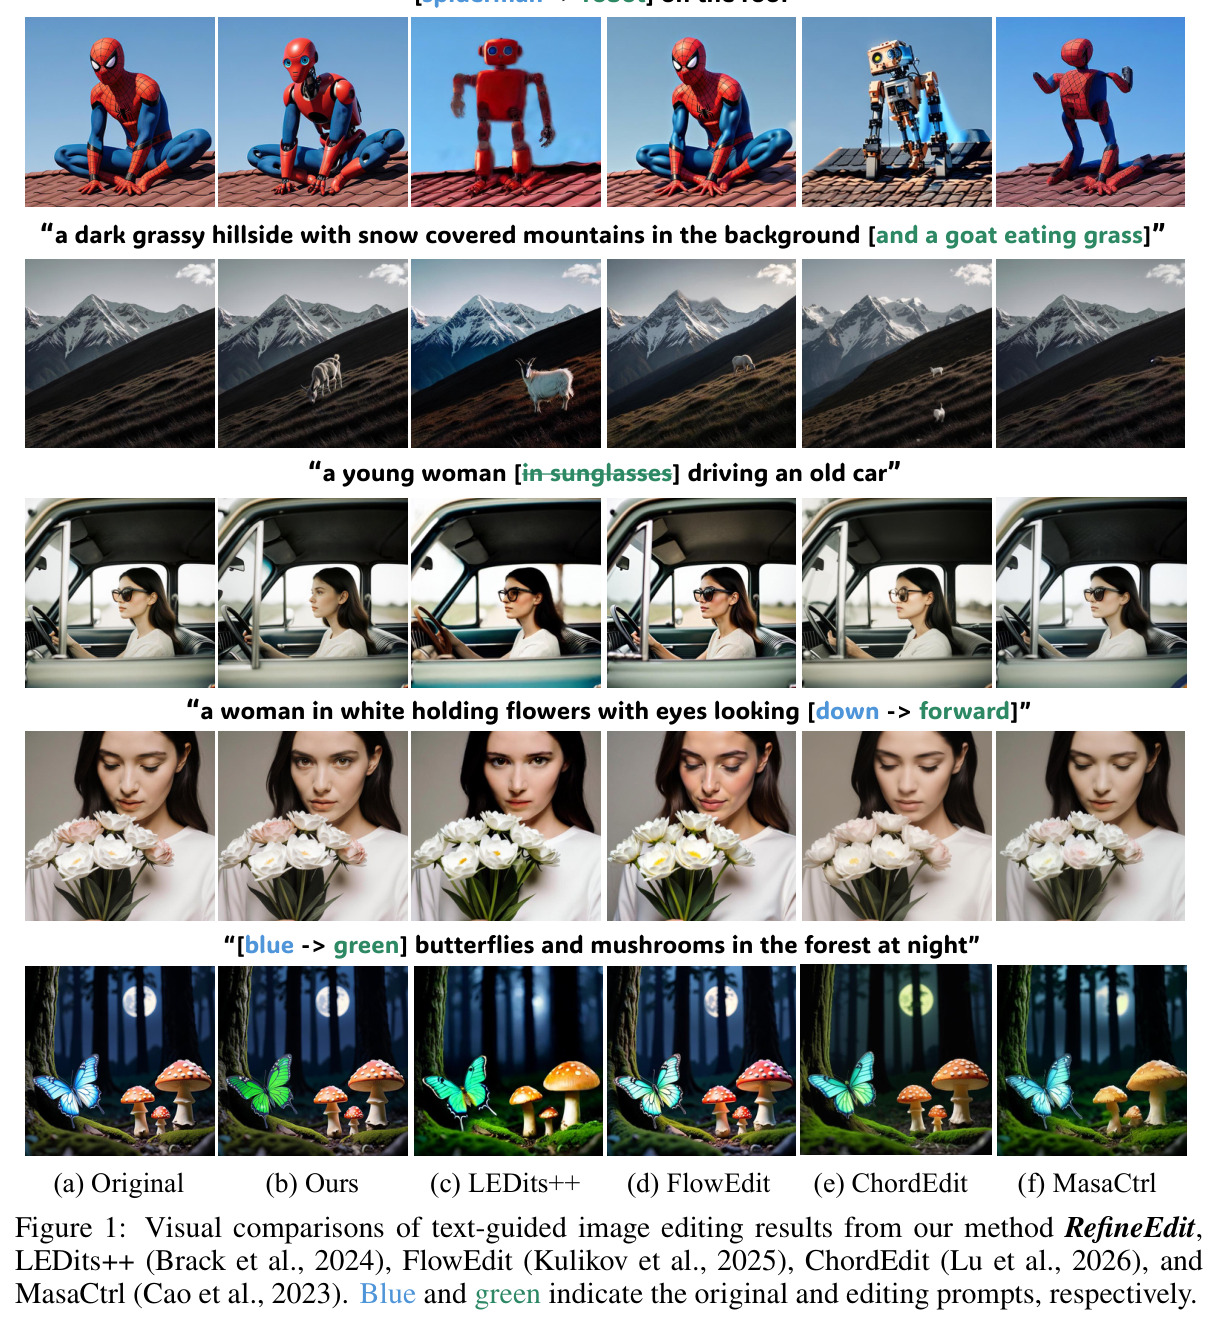
文本引导图像编辑要求在执行指定修改的同时保留无关源内容,而这两个目标天然冲突:编辑越强越容易波及无关区域,保留越强又会让改动不完整。现有免训练编辑器大多在预训练生成器上外挂空间控制:扩散系方法依赖掩码、注意力操控或特征注入(P2P、MasaCtrl、Pix2Pix-Zero、PnP、LEDits++、ChordEdit),流匹配系方法(FlowEdit、RF-Inversion)在源/目标分布间构造传输路径,AR 系方法在解码时于源/编辑预测间选择。这些空间控制的准确性直接决定编辑质量:区域过窄改动残缺,区域过宽破坏背景;且 AR 的固定因果顺序使早期决策无法回改。在 PIE-Bench 的九类任务上,这些方法普遍出现姿态或屋顶被扰动(蜘蛛侠换机器人)、改动不到位(FlowEdit 几乎保留源外观)等问题,说明“在哪里改”的定位仍缺少可靠且可随生成过程演化的证据来源。
本文的目标是本文想回答一个明确的问题:能否让不断演化的生成过程本身提供修改编辑定位所需的证据,把“在哪里编辑”与“编辑成什么”耦合进同一个免训练流程?具体目标是基于 GRN 构建一个不需要任何训练、不需要外部掩码、不需要注意力操控的 prompt-to-prompt 编辑框架:只输入源提示词与编辑提示词,就能在九类编辑任务(物体替换/添加/删除、内容/姿态/颜色/材质修改、背景替换、风格迁移)上同时做到强背景保持与高语义对齐,即在 PIE-Bench 的 PSNR/LPIPS/MSE/SSIM 与 CLIP 指标上取得领先,同时保持与主流流匹配方法相当的推理开销。
与已有工作不同的是,独特的切入点是作者首次把 GRN 引入免训练图像编辑——GRN 此前只用于图像生成与需要训练的视频编辑。作者观察到两条被忽视的性质:其一,GRN 的中间源状态已包含可复用的空间布局,如同画家把同一张猫的粗略草稿分别深化成猫或老虎,编辑分支可以继承布局而只修改外观;其二,GRN 的 HBQ 码让两分支在相同的空间与通道坐标上对齐,在同一步对共享状态分别用源/编辑提示词做条件预测时,同一比特坐标上的有符号概率差可以直接充当编辑证据。由此提出核心洞察“精炼即编辑”:编辑定位不必一次定死,而可以随图像演化每步重算——这既不同于扩散方法相对静态的空间控制,也不同于 AR 编辑器受固定顺序约束的 token 选择。
核心方法
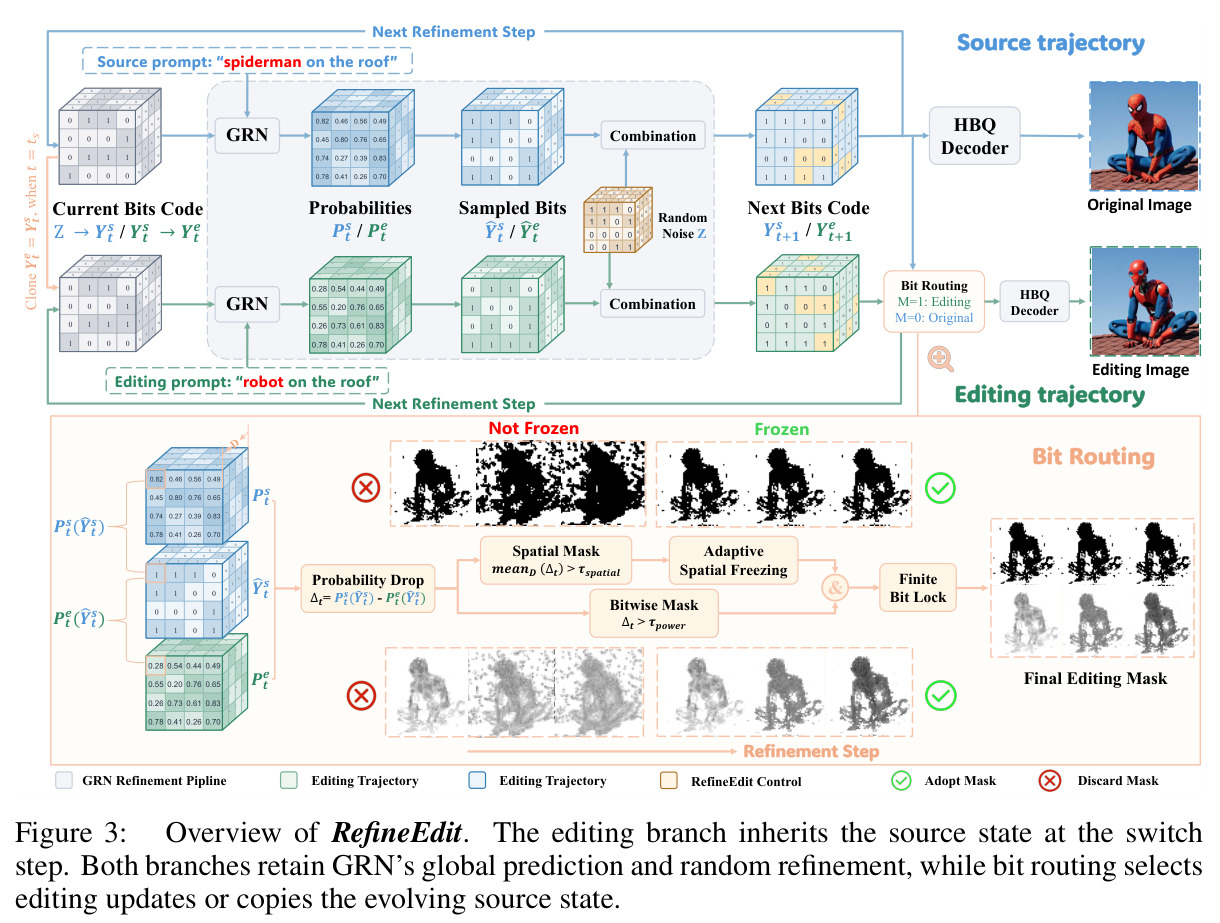
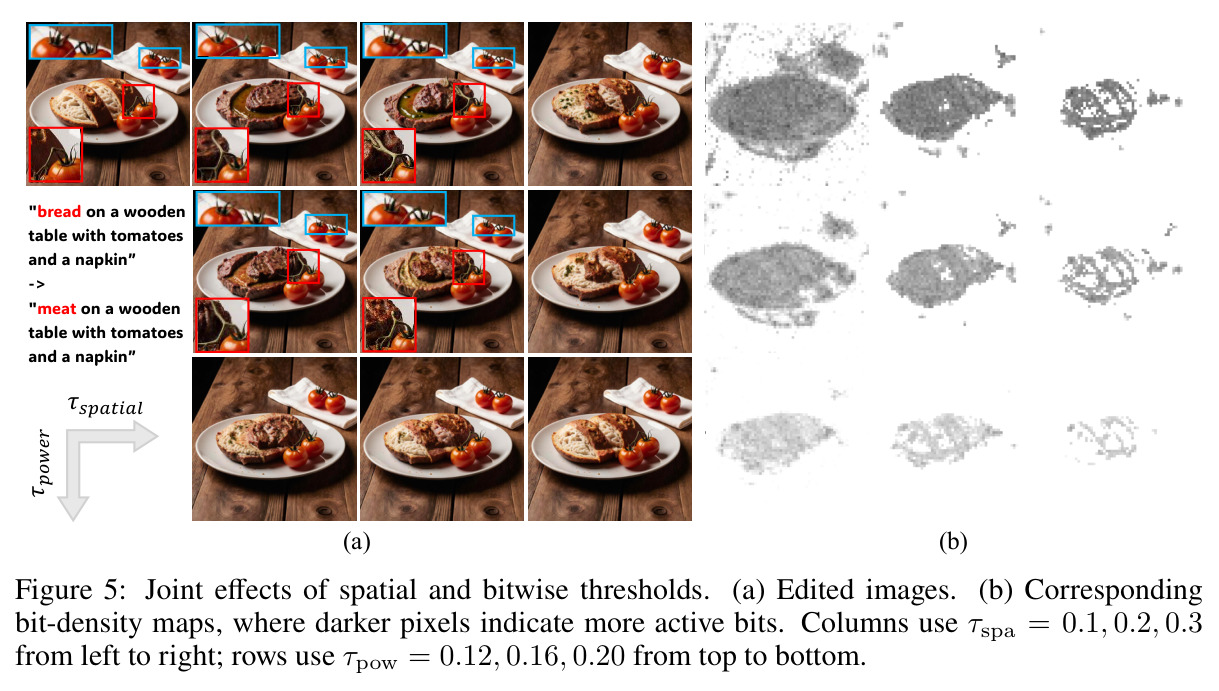
直觉上,RefineEdit 是“在同一条生成轨迹上分叉”:先让 GRN 按源提示词把随机二值噪声精炼到中间状态,此时粗略布局已显现;再从该状态派生编辑分支,两条分支各自用源/编辑提示词、共享同一份随机码 $Z$ 与精炼日程并行推进;每一步对比两分支在同一坐标上的比特概率,编辑分支越是不同意源比特,该处越是候选编辑位置。技术路线为:在切换步 $t_s$ 令 $Y^e_{t_s}=Y^s_{t_s}$ 分支;每步用冻结的 GRN Transformer 并行预测全部 $N\times D$ 个坐标的概率 $P^s_t$、$P^e_t$,对源分支采样出的比特计算有符号差 $\Delta_{t,n,d}$;对 $D$ 个比特取均值得到空间分数并与阈值 $\tau_{spa}$ 比较生成空间掩码,$\Delta$ 与 $\tau_{pow}$ 比较生成比特级掩码;随后按掩码做源锚定路由——选中坐标取编辑分支的提议值,其余坐标复制源状态。AdaSF 与 FBL 两个稳定化机制进一步分别抑制掩码扩张和比特权限中断。全程无训练、无外部掩码、无注意力操控。
核心创新是把编辑定位与内容生成耦合为同一个过程:用两条仅在提示词上不同的分支在同一二值坐标上的概率分歧作为“编辑证据”,并让证据随精炼动态更新。与已有方法的本质区别有三点。其一,扩散系编辑的空间控制(掩码/注意力/特征注入)是外挂且相对静态的,一旦不准就会编辑不足或越界;而 RefineEdit 的定位每一步由当前预测重新计算,可随图像演化而收缩或转移。其二,AR 编辑虽也利用 token 分布差定位,但受固定因果顺序约束,早期决策无法回改;GRN 的全局可复精炼则允许任何坐标反复重选。其三,控制粒度细化到比特级——每个空间位置有 $D=256$ 个比特,可在同一位置内只放开部分比特,实现比 token/区域更细的编辑强度控制;未被选中的坐标被“锚定”到不断演化的源轨迹而非冻结的原图,使背景在保持的同时仍能随精炼自然细化。
方法步骤详情
流程分七步。(1) 从每比特等概率的伯努利分布采样固定随机码 $Z$;源分支按源提示词逐步预测全部比特并采样,再按保留掩码与随机码混合推进,保留率沿余弦日程升到峰值 0.95,图像由噪声走向完整。(2) 到切换步 $t_s$,编辑分支复制源状态,此后两分支共享随机码与日程、仅提示词不同。(3) 每步对两分支并行预测,在源分支采样出的比特上计算有符号概率差 $\Delta_{t,n,d}=P^s_t-P^e_t$:正值说明编辑分支不倾向保留该源比特,构成编辑证据。(4) 对 $D$ 个比特取均值得空间分数,与阈值 $\tau_{spa}$ 比较得空间掩码;逐比特再与阈值 $\tau_{pow}$ 比较得比特级掩码。(5) AdaSF 检查切换步的平均超出响应 $r$:若 $r\ge\tau_{frz}=2\tau_{spa}$,说明初始编辑响应足够强,随即冻结空间掩码以防外溢。(6) FBL 对最近 $K=4$ 步的瞬时激活做逻辑或,保住近期被选中比特的编辑权限,避免概率波动打断精炼。(7) 路由:被掩码选中的坐标取编辑提议,其余复制当步源状态;末步对路由后的预测直接解码成图。
技术新颖性
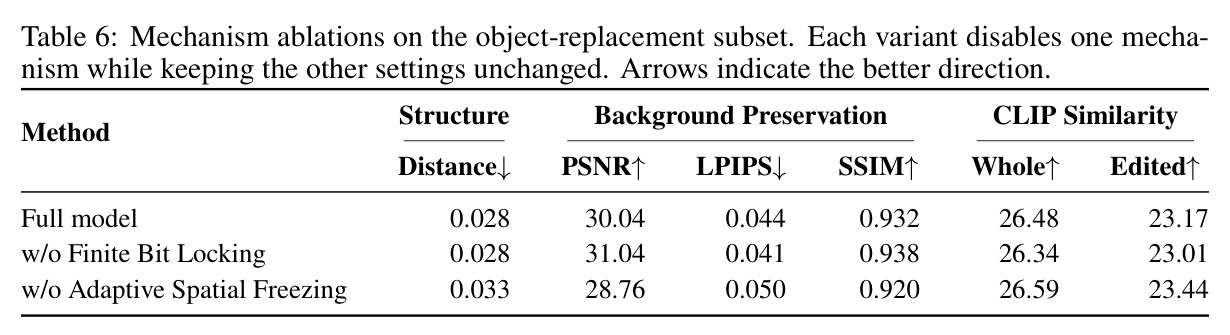
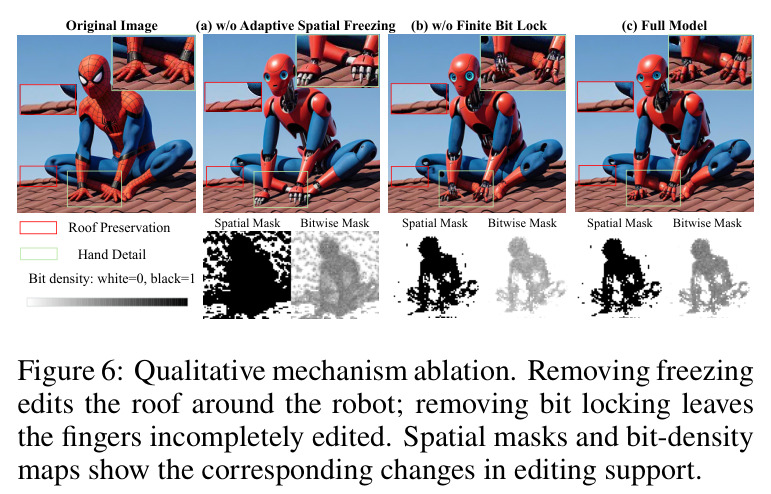
技术新颖性体现在四个层面。范式层面:这是 GRN 的第一个免训练编辑应用,开辟了继扩散、流、AR 之后的“GRN 系”编辑骨架,并证明精炼过程天然可当编辑器用。证据来源层面:两分支共享初始随机码、精炼日程与输入状态,只在提示词上不同,因此概率差可归因于语义意图差异而非噪声——这种“对齐轨迹对比”是扩散/流方法难以直接复制的。控制粒度与可修订性层面:比特级掩码加每步重算,使定位能随精炼演化,这在静态控制的扩散与固定顺序的 AR 中都无法实现。稳定化算子层面:AdaSF 与 FBL 是针对二值精炼特有问题(掩码向无关区域扩张、已选比特权限被瞬时波动中断)的新机制,直接作用于二值码而非特征图且完全免训练。消融证实两者互补:去掉 AdaSF 掩码蔓延至屋顶背景(PSNR 30.04→28.76、Structure 0.028→0.033),去掉 FBL 则手指等细节编辑不完整(CLIP 编辑区 23.17→23.01)。
实验结果
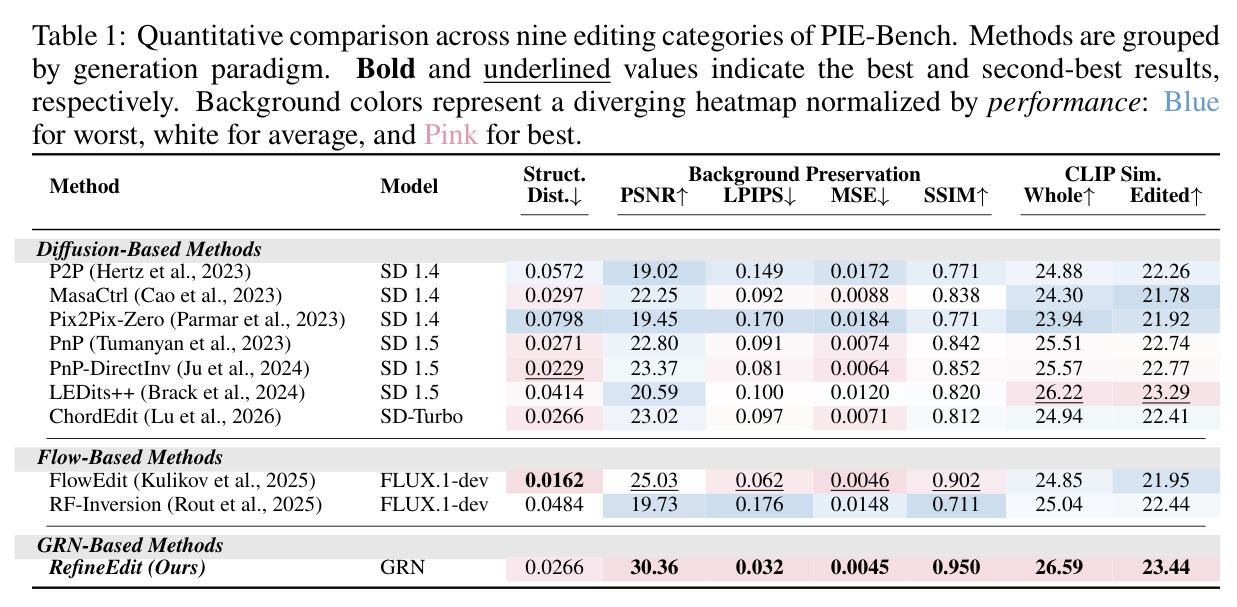
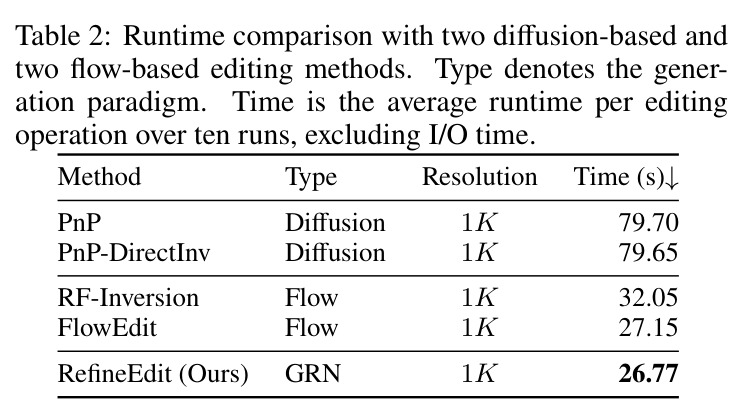
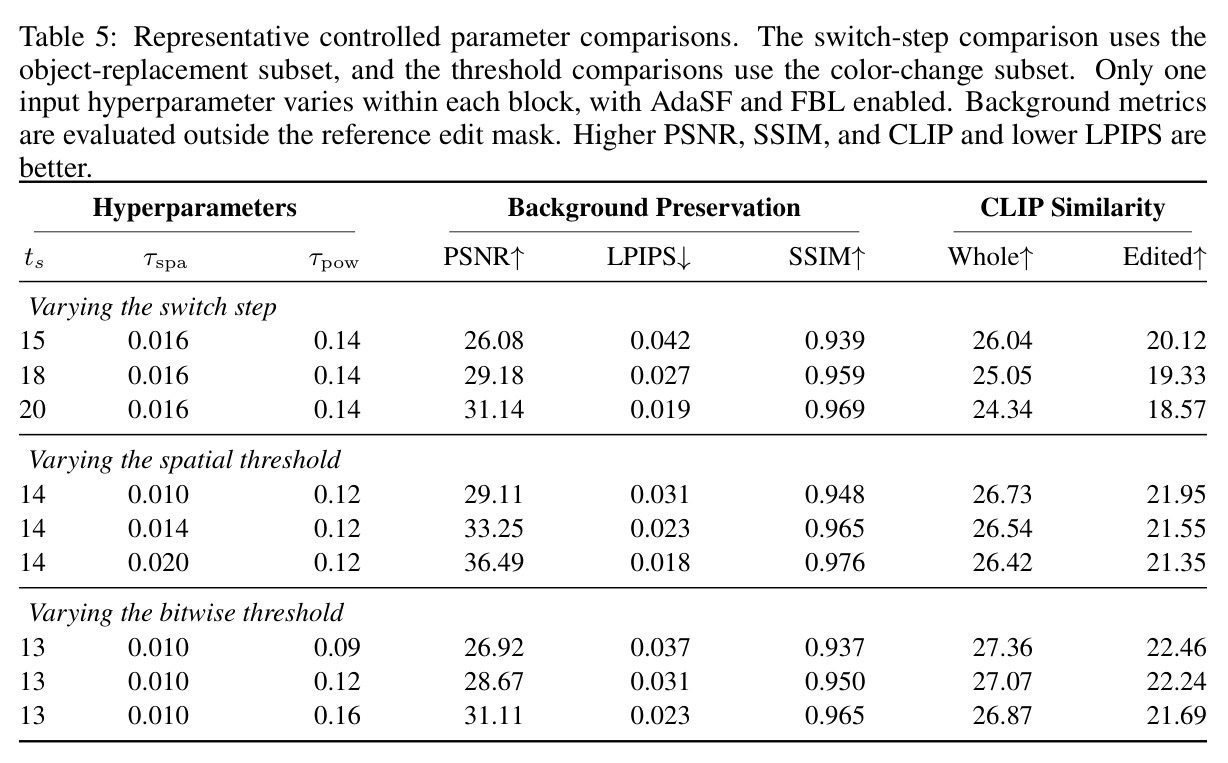
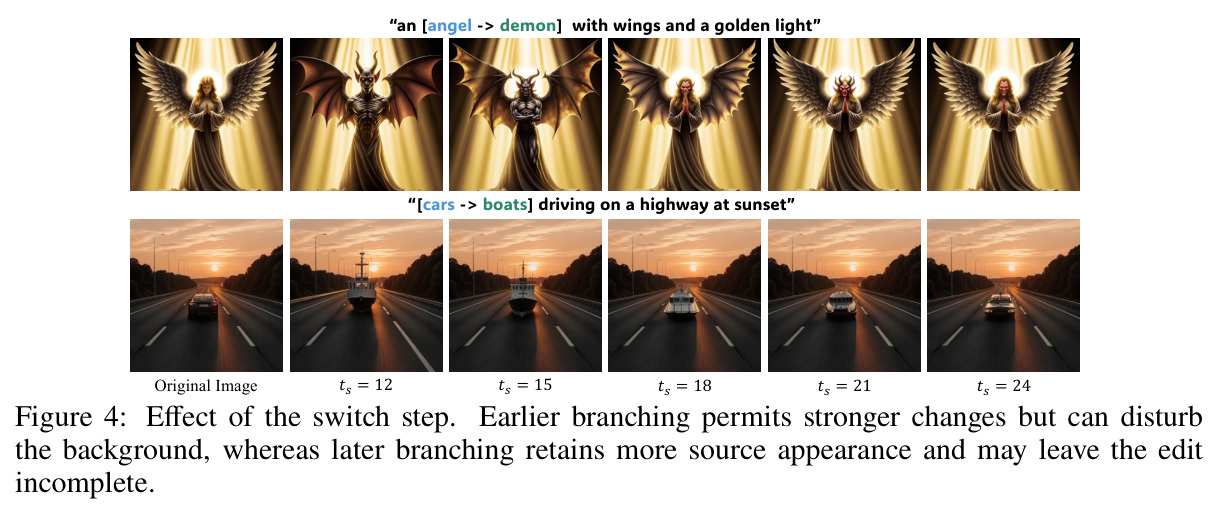
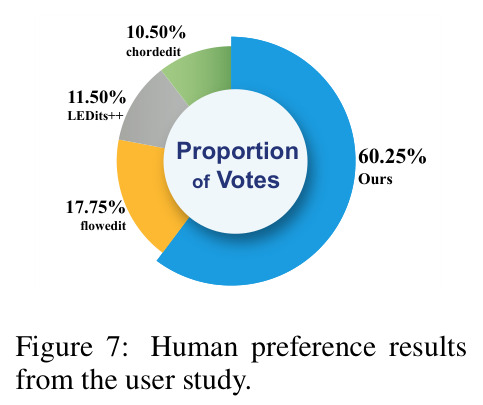
在 PIE-Bench 九类编辑共 560 对提示词上,RefineEdit 全面领先。背景保持四项全部第一:PSNR 30.36 dB,比次优 FlowEdit 的 25.03 高出 5.33 dB;LPIPS 0.032 约为 FlowEdit 0.062 的一半;MSE 0.0045、SSIM 0.950 也优于 FlowEdit 的 0.0046、0.902。语义对齐同样第一:CLIP 全图 26.59、编辑区 23.44,超过 LEDits++ 的 26.22 与 23.29。唯一落后的是结构一致性:Structure Distance 0.0266 逊于 FlowEdit 的 0.0162,说明整体结构改动仍大于流方法。定性上替换蜘蛛侠为机器人可保持蹲姿与屋顶结构。效率上单张 A100 每次编辑 26.77 秒,与 FlowEdit 的 27.15 秒相当,比 PnP 约 79.7 秒快三倍。超参分析显示保持与编辑此消彼长:切换步从 15 推迟到 20,PSNR 由 26.08 升至 31.14,但 CLIP 编辑区由 20.12 降到 18.57。机制消融中去 AdaSF 掩码蔓延、PSNR 从 30.04 降到 28.76;去 FBL 手指编辑不完整、CLIP 编辑区从 23.17 降到 23.01。20 人 400 票的用户研究中本方法获 60.25% 偏好,远超 FlowEdit 的 17.75%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 背景保持(PIE-Bench 九类) | PSNR↑ | 30.36 | FlowEdit 25.03(次优);P2P 19.02 | +5.33 dB(对比次优) |
| 背景保持 | LPIPS↓ | 0.032 | FlowEdit 0.062 | 约减半 |
| 背景保持 | MSE↓ | 0.0045 | FlowEdit 0.0046 | 微弱领先 |
| 背景保持 | SSIM↑ | 0.950 | FlowEdit 0.902 | +0.048 |
| 语义对齐 | CLIP Whole↑ | 26.59 | LEDits++ 26.22 | +0.37 |
| 语义对齐 | CLIP Edited↑ | 23.44 | LEDits++ 23.29 | +0.15 |
| 结构一致性 | Structure Distance↓ | 0.0266 | FlowEdit 0.0162 | 落后(FlowEdit 更优) |
| 推理效率(1024×1024,单张 A100) | 每张编辑耗时↓ | 26.77 s | FlowEdit 27.15 s;PnP 79.70 s | 与 FlowEdit 持平,较 PnP 提速约 3× |
| 人类偏好(20 人、400 票) | 偏好票占比↑ | 60.25% | FlowEdit 17.75% / LEDits++ 11.50% / ChordEdit 10.50% | +42.5 个百分点 |
局限与改进
作者承认并可观察到的局限:(1) Structure Distance 0.0266 明显逊于 FlowEdit 的 0.0162,说明全局结构一致性仍有差距;MSE(0.0045 vs 0.0046)与两项 CLIP 的领先幅度也很小(+0.15/+0.37),优势主要集中在背景保持。(2) 三个核心超参 $t_s$、$\tau_{spa}$、$\tau_{pow}$ 按编辑类别逐一在 PIE-Bench 评测分数上挑选,附录 A.3 明言没有单独的调参划分,存在对基准过拟合的风险。(3) 评测协议是“生成到编辑”:源图由 GRN 从源提示词生成而非真实照片,基线输出 512×512 而 RefineEdit 原生 1024×1024 再统一缩放评测,骨干与分辨率的差异可能影响公平性。(4) 超参逐类别设定(如风格迁移 $t_s=6$、材质修改 $t_s=16$),实际使用需要手动选择。(5) 方法绑定 GRN 的全局可复二值精炼特性,无法迁移到扩散/流模型;用户研究规模较小(20 人、400 票、20 组样本)。
独立分析的弱点
独立分析的几点弱点。其一,超参敏感性构成落地障碍:$t_s$ 差几步就会在“编辑不完整”与“背景受损”之间摇摆(Fig.4 中 12→24 的对比),逐类别手调在小基准可行,面对开放用户输入缺乏自动选择机制;改进方向是利用切换步响应 $r$ 的分布在线估计阈值,或学习轻量定位头。其二,真实图像编辑缺失:源图必须经 HBQ 编码成二值码,量化损失与编码误差对真实照片的影响未评估,而编辑用户照片恰是最常见的应用场景;应补充“真实图→HBQ 编码→编辑”实验。其三,比特级权限虽细,但连续属性(颜色深浅、材质光泽)依赖大量比特协同,$\tau_{pow}$ 过严会让色彩编辑不到位(Table 5 中 CLIP 编辑区随 $\tau_{pow}$ 从 0.09 升到 0.16 单调下降 22.46→21.69),可研究感知驱动的软掩码或自适应比特预算。其四,FBL 的 $K=4$ 与 $\tau_{frz}=2\tau_{spa}$ 是固定启发式,未随编辑幅度自适应。其五,评价中“背景保持”在背景替换任务上实际度量的是前景,指标语义随类别漂移,可能高估整体优势。
未来方向
作者明确提出把“精炼即编辑”这一洞察推广到 GRN 之外。顺着成果可延伸的方向包括:(1) 真实图像编辑:研究 HBQ 反演/编码的保真度,让 RefineEdit 直接服务用户照片而非仅 GRN 自生成图像;(2) 视频编辑:GRN 已有视频 token 化基础,把比特路由扩展到时空体,可实现免训练视频编辑(对照需要训练的前作);(3) 自动超参与多轮交互编辑:GRN 全局可复的特性格外适合连续多轮修改,可设计会话式编辑界面,让 $t_s$ 与阈值随上一轮结果自适应;(4) 与语义先验结合:用 Grounded-SAM 等外部掩码作为可选先验进一步约束路由(本文刻意不使用外部掩码);(5) 骨干迁移:在其它可修订的离散生成范式(masked diffusion、bitwise AR 变体)上验证概率差定位的普适性;(6) 更大规模 GRN 与蒸馏加速,把 26.77 秒/张的延迟压到交互级。
复现评估
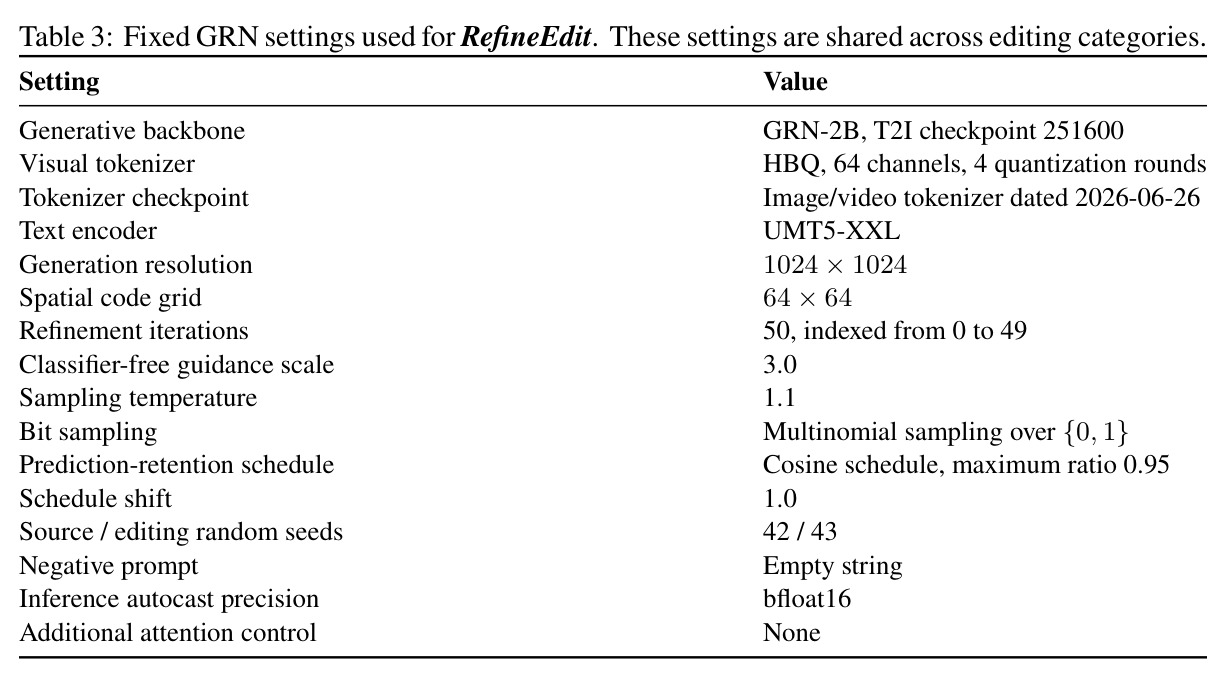
复现条件较为透明:代码开源于 github.com/mura1n/RefineEdit;使用冻结的 GRN-2B(T2I checkpoint 251600)、HBQ tokenizer(64 通道、4 轮量化)与 UMT5-XXL 文本编码器;共享推理设置(CFG 3.0、温度 1.1、50 步余弦保留日程峰值 0.95、bfloat16、种子 42/43)在 Table 3 完整给出,九类超参在 Table 4 完整给出;数据直接用公开的 PIE-Bench 提示词(560 对),评测掩码由 Grounded-SAM 生成,无需自建标注。算力要求低:单张 A100、约 27 秒一张。主要风险是 GRN-2B 权重可得性——该架构 2026 年才提出,若 checkpoint 不公开则无法复现;且超参在评测集上直接调优、无验证划分,复现论文数字可行,但在新数据或真实照片上的表现需自行验证。总体难度中等,前提是能拿到 GRN 权重。
论文图表
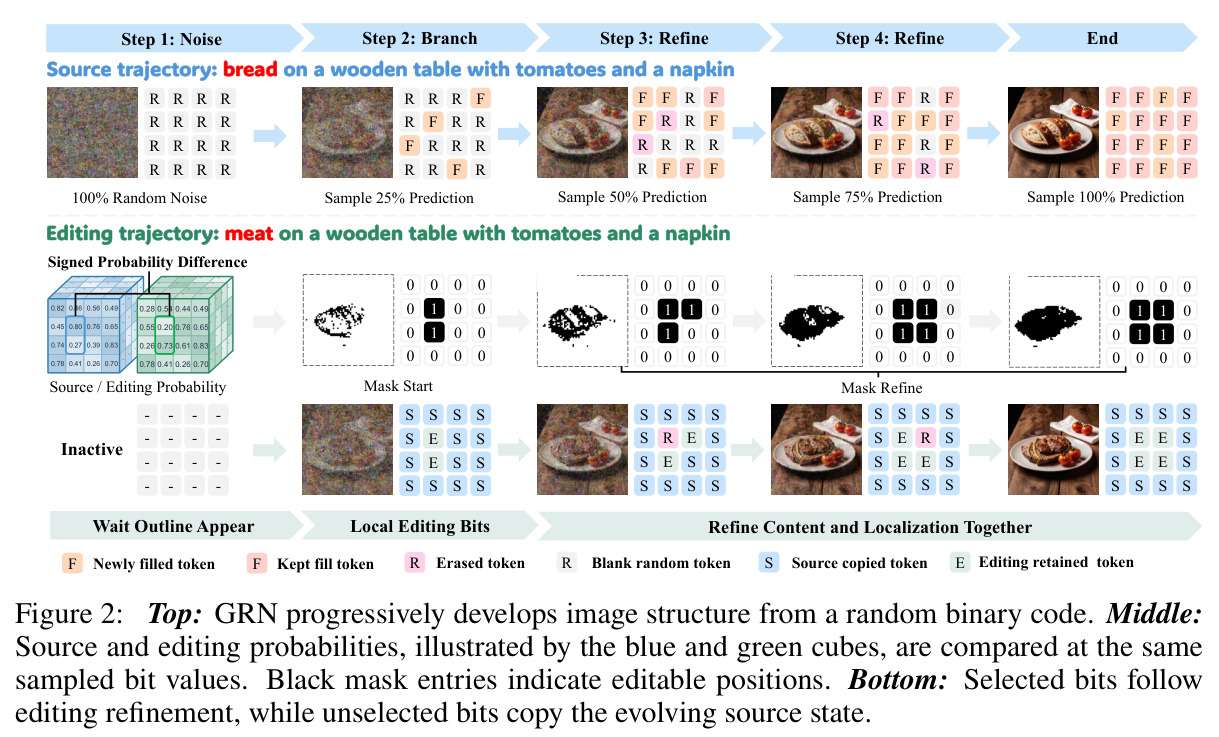
以“面包→肉”为例展示核心观察:上方 GRN 从随机噪声逐步精炼出图像结构(R/F 标记新填充/擦除的 token);中间两分支对同一采样比特的概率(蓝/绿方块)之差构成编辑证据,黑色掩码项标出可编辑位置;下方被选中的比特跟随编辑分支精炼,其余比特复制不断演化的源状态。
这是全文中心论点“精炼即编辑”的图解,解释了概率差证据、掩码选择与源锚定三者的关系,是理解方法的入口。
九个类别的图片数与超参:如物体替换 80 张、$t_s=15$、$\tau_{spa}=0.013$、$\tau_{pow}=0.20$;风格迁移 $t_s=6$;材质修改 $t_s=16$;所有类别 $K=4$、$\tau_{frz}=2\tau_{spa}$。
揭示超参需逐类别设定这一重要局限,同时是完整复现主结果的必要参数表。