多个正确答案,一条训练样本:去除LLM推荐器GRPO中的回答者噪声 Many Right Answers, One Training Example: Removing Responder Noise from GRPO for LLM Recommenders
RL应训练请求而非单个回答:合并回答者奖励的ReMaRk用一半算力达到同等召回
前置知识
GRPO(组相对策略优化)
一种无需价值网络的 LLM 强化学习算法:对同一提示采样一组(G 个)输出,用组内平均奖励作基线、组内标准差做归一化,得到每个输出的优势 $A_{gk}=(R_{gk}-\bar{R}_k)/\sigma_k$,再做 PPO 式裁剪代理目标更新并附 KL 惩罚。它省去了 critic,被 DeepSeekMath 等工作普及,是当前 LLM 后训练最常用的 RL 算法之一。
本文完全建立在 GRPO 框架上,只改动奖励与采样单元;理解其组内归一化机制才能看懂命题 2 为何表明分数奖励会被放大。
Rank-GRPO
训练对话推荐器的 SOTA 方法(Zhu et al., ICLR 2026):先 SFT 再 RL。模型为每个 Reddit 请求生成 20 行「标题 (年份)」列表,按行(rank 位置)计算奖励与优势——每个位置在组内 8 个列表间做组归一化后落到该行的 token 上;奖励定义为生成的标题是否命中标注者提到的条目(标题规范化匹配、年份差 ≤2)。
ReMaRk 是对 Rank-GRPO 的最小改动,流水线与超参完全一致,读懂 Rank-GRPO 才能精确定位改动点在哪。
Rao–Blackwellization
统计估计中的经典方差缩减技术:若把估计量对某个冗余随机变量取条件期望,其期望不变而方差不会增大。本文把「随机抽到哪个回答者」视为数据收集方式带来的冗余变量,证明对回答者取期望后 GRPO 的期望更新不变、方差项 $\mathbb{E}\|\sum_i \hat{p}_i(1-\hat{p}_i)U_i\|^2$ 恰好消失。
这是全文的理论骨架(命题 1),直接解释了为什么「把回答者合并成一条样本」能加速训练。
Recall@K / NDCG@K 与逐行-逐请求两种口径
R@K 衡量生成的 top-K 列表覆盖了多少真实条目,N@K 进一步给靠前的命中更高权重。本文数据里每个请求对应多个回答者,因此有两种平均方式:逐行(每个(请求,回答者)对算一次,天然偏向多回答者请求)与逐请求(先在请求内平均再对请求平均)。显著性用 2,000 次 bootstrap 重采样的配对 95% CI 报告。
论文所有结论都以 R@20/N@20 的百分点差加 CI 表述,分不清两种口径会误读增益的大小与来源。
研究动机
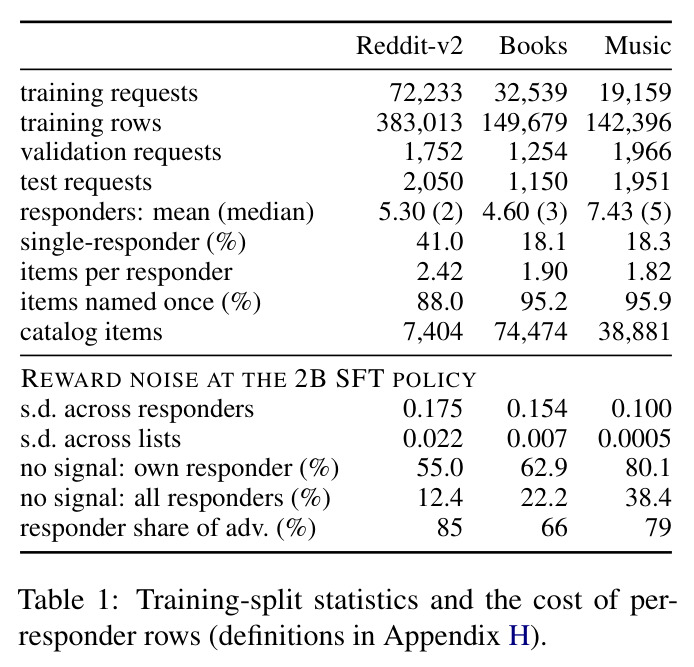
在 Reddit 这类社区里,一个求推荐请求(如「想要《降临》那样烧脑的科幻片,不要动作片」)平均收到 5.3 个用户的回答(Reddit-v2 数据集;新构建的 Books 为 4.6 个、Music 为 7.4 个)。SOTA 方法 Rank-GRPO 先 SFT 再用 RL 改进,但它把每个(请求,回答者)对当成一条独立训练行,生成的列表只按「是否命中被抽中的那个回答者提到的条目」打分。问题在于回答者之间很少一致:Reddit-v2 中 88% 的条目只被一人提到(Books 95.2%、Music 95.9%),同一列表得高分还是低分几乎取决于随机抽到谁——就像考试时从多份都正确的答案 key 里随机抽一份来批卷。论文量化了这种噪声:在 2B SFT 策略上,回答者抽签贡献了优势方差的 85%(Books 66%、Music 79%);回答者间的奖励标准差 0.175 远大于列表间的 0.022;每步 8 个列表的比较中,55% 的位置上所有列表得分全同(Music 高达 80.1%),模型从这些组学不到任何东西。回答者分歧本是合法的标注变异,这个估计量却把它变成了梯度噪声。
本文的目标是论文主张 RL 应该训练在「请求」上,而不是训练在每个「回答」上,并给出可检验的目标:在完全继承 Rank-GRPO 的流水线、超参数和 0/1 奖励形式的前提下,只改奖励的聚合方式与训练行的采样单元,就能(1)在全部 10 个骨干×数据集设置中,用 25–53% 的 RL 步数达到基线 2,000 步的验证 R@20;(2)在同等 2,000 步预算下按约 1.5 个点的 per-row R@20 全面领先;(3)训练到双方都不再提升时,测试集上从不显著落后,且 7 对中的 4 对用 18–63% 的 GPU 时数就达到 Rank-GRPO 的最好水平。此外还要回答归因问题:收益究竟来自「合并回答者」,还是仅仅来自换了聚合后的目标函数。
与已有工作不同的是,多参考答案联合打分在机器翻译多参考训练、CIDEr 自 critic 训练与众包软标签中是常识,监督学习里也早已证明多标注者软标签能提升稳定性。但作者抓住了被忽视的一点:GRPO 类推荐器的通行做法把「一个请求」拆成「每个回答者一行」,让标注者抽签成为优势方差的主导来源;对策略自身采样做平均的 GRPO 变体很多,对人参考答案做边缘化的却没有。更关键的新观察是与 GRPO 逐组归一化的相互作用:把回答者平均后,奖励落在间距 $1/n_x$ 的网格上,逐组除以标准差会把单个人的票放大 $n_x$ 倍(命题 2),因此正确做法不是直接平均,而是保持 0/1 的有界并集奖励。与 Mult-DPO(离线集合级损失)和 Xu et al.(用 LLM 生成额外正例)不同,ReMaRk 只利用人类已经给出的标签,且在 RL 奖励内部完成合并。
核心方法
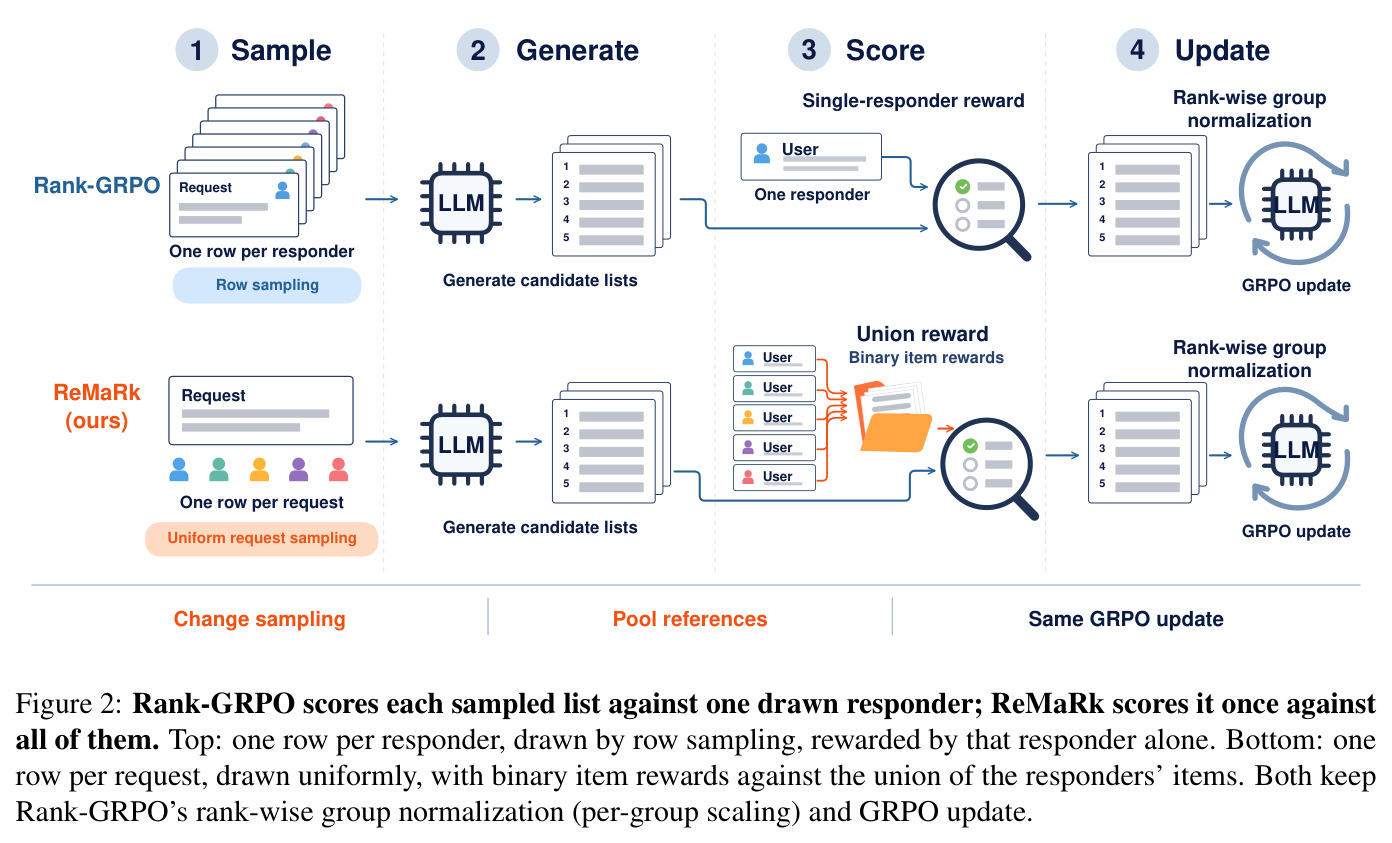
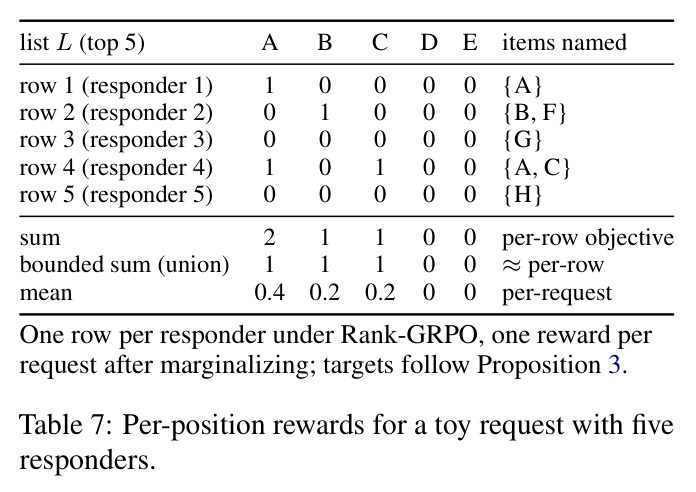
直觉:与其抽签决定用哪份答案 key 批卷,不如把所有回答者的条目合并成一个并集,列表命中并集中任何一个条目就得一分。技术路线:ReMaRk(Responder-Marginalized Rank-level RL)对 Rank-GRPO 只改两处——奖励与采样,其余(G=8 列表/请求、逐位置组归一化、裁剪代理目标 + KL 惩罚、全部超参)原封不动。任务形式化:请求 $x$ 是到推荐轮为止的对话文本,策略生成 20 行「标题 (年份)」列表 $L$,第 $k$ 行的合格性指示 $e_k(L;x)\in\{0,1\}$(能解析、在目录中、不重复、不点名请求里已有的条目);请求有 $n_x\ge 1$ 个回答者,回答者 $r$ 提到的条目集合记为 $S_r$。Rank-GRPO 的逐位置奖励是 $q_k(L;S_r)=e_k(L;x)\,\mathbf{1}\{L_k\in S_r\}$;ReMaRk 把 $S_r$ 换成全部回答者条目的并集,即 0/1 的有界和 $\min(c_i,1)$($c_i$ 为提到条目 $i$ 的回答者数),并把「每个回答者抽一次行」改成「每个请求均匀采样一次」。直觉上,去掉奖励对抽签的依赖就降低了梯度方差,同样的终点可用少得多的 RL 算力到达。
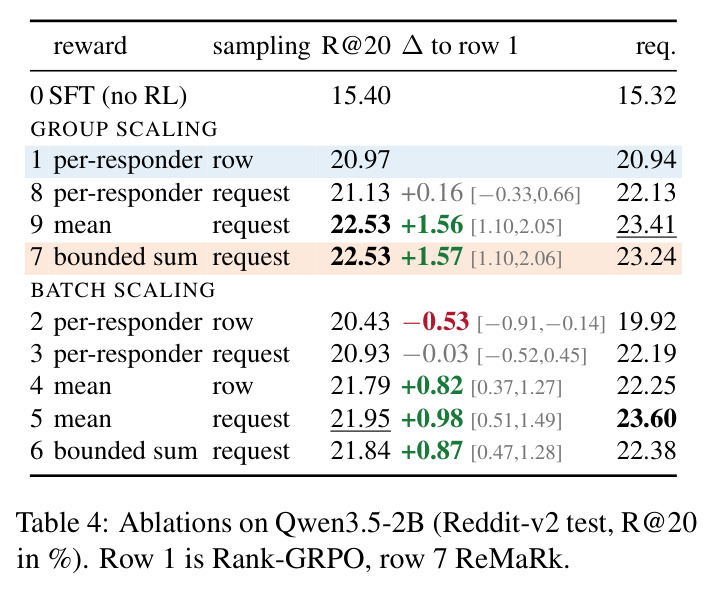
核心创新是把回答者当作数据收集的 nuisance 变量并对它做 Rao–Blackwell 边缘化。命题 1:以 $\hat{p}_i=c_i/n_x$ 记条目 $i$ 的经验提及率,回答者均匀抽签时期望奖励为 $\mathbb{E}_r[q_k]=e_k(L;x)\hat{p}_{L_k}$,即 $n_x$ 行折叠成一条与抽签无关的训练样本;固定优势尺度下期望更新不变、方差项消失。但直接用平均奖励不行——命题 2 证明 0/1 奖励下逐组缩放因子至多波动 1.51 倍,而 $1/n_x$ 网格上的分数会被除以极小的组标准差:8 列表中 7 个同分、1 个高出 $\delta$ 时优势达 $(2.47,-0.35,\dots)$ 个满命中,放大倍数 $1/\delta$,即一个人的票被放大 $n_x$ 倍(实测 Llama-3.2-3B 上 KL 从 0.6 涨到 47)。ReMaRk 因此保留 0/1 奖励:用并集 $\min(c_i,1)$ 而非平均 $\hat{p}$。并集严格说不是命题 1 的边缘(它把被一人提到的条目与被所有人提到的等同,改变了目标),但消融显示 2B 上均值与并集打平(−0.08,三种子):收益来自「合并」而非「聚合」。
方法步骤详情
完整流程(Algorithm 1):(1) 输入带回答者集合的请求池,每步均匀抽 $B'=48$ 个请求(Rank-GRPO 按回答者数加权抽行)。(2) 每个请求在温度 1 下采 $G=8$ 个候选列表,非空行依次占据 rank 位置,解析失败的行记零奖励缺位。(3) 打分:每个位置按并集给 0/1 奖励 $q_{gk}=e_{gk}\,\mathbf{1}\{L_{gk}\in\bigcup_r S_r\}$;Rank-GRPO 则用单个回答者的 $S_r$。(4) 优势:$A_{gk}=(q_{gk}-\bar{q}_k)/(\sigma_k+10^{-4})$,$\bar{q}_k,\sigma_k$ 为组内 8 列表同位置的均值与标准差(消融臂改用批内 384 列表的 batch 缩放)。(5) 把 $A_{gk}$ 放到第 $k$ 行 token 上,加长度控制:第 20 行结束 +0.1、提前停止 −0.1、溢出每 token −0.1,按各 run 平均优势尺度归一;补全上限 320 token(Books 384)。(6) 用 TRL 的裁剪代理目标 + KL 系数 $10^{-3}$ 做 on-policy 更新(lr $10^{-6}$ 常数),训练 2,000 步、每 250 步验证选点,选中 checkpoint 只测一次。所有臂从同一 SFT checkpoint 出发(Qwen3.5 五个尺寸与两个 Llama),每 run 用 4 张 B200。
技术新颖性
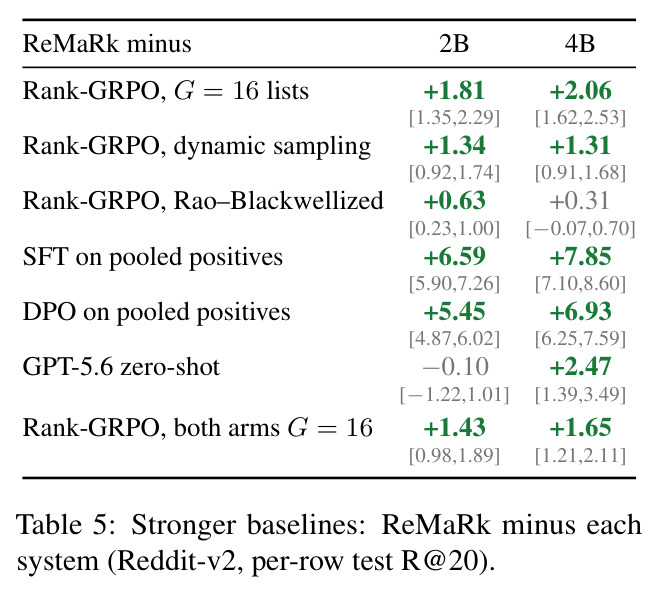
与已有技术的具体区别:(1) 对人参考答案(而非策略自身采样)做策略梯度的 Rao–Blackwell 化是新的——VeriFree 与 Tang et al. 边缘化的是采样的答案,本文边缘化的是回答者;(2) 相比 Mult-DPO 用离线集合级 DPO 直接以并集为正例(落后 ReMaRk 5.5–6.9 个点),ReMaRk 在在线 GRPO 奖励内部合并,保留 rank 级 credit assignment;(3) 相比 ShapE-GRPO 在单个输出的候选之间分配 credit,本文在参考答案之间去除方差,两者可以复合;(4) 命题 2 给出 0/1 奖励与分数奖励在逐组缩放下的分离界(1.51 倍 vs $n_x$ 倍放大),解释了为何「平均奖励 + 组归一化」此前会失稳;(5) 改动只是训练行的构建与打分方式,可即插即用于任何「每个标注者一行」的 GRPO 数据;而 Xu et al. (2025) 需要用 LLM 造新正例、A2Search 的 F1 奖励不区分标注者,本文只用现成的人类标签。
实验结果
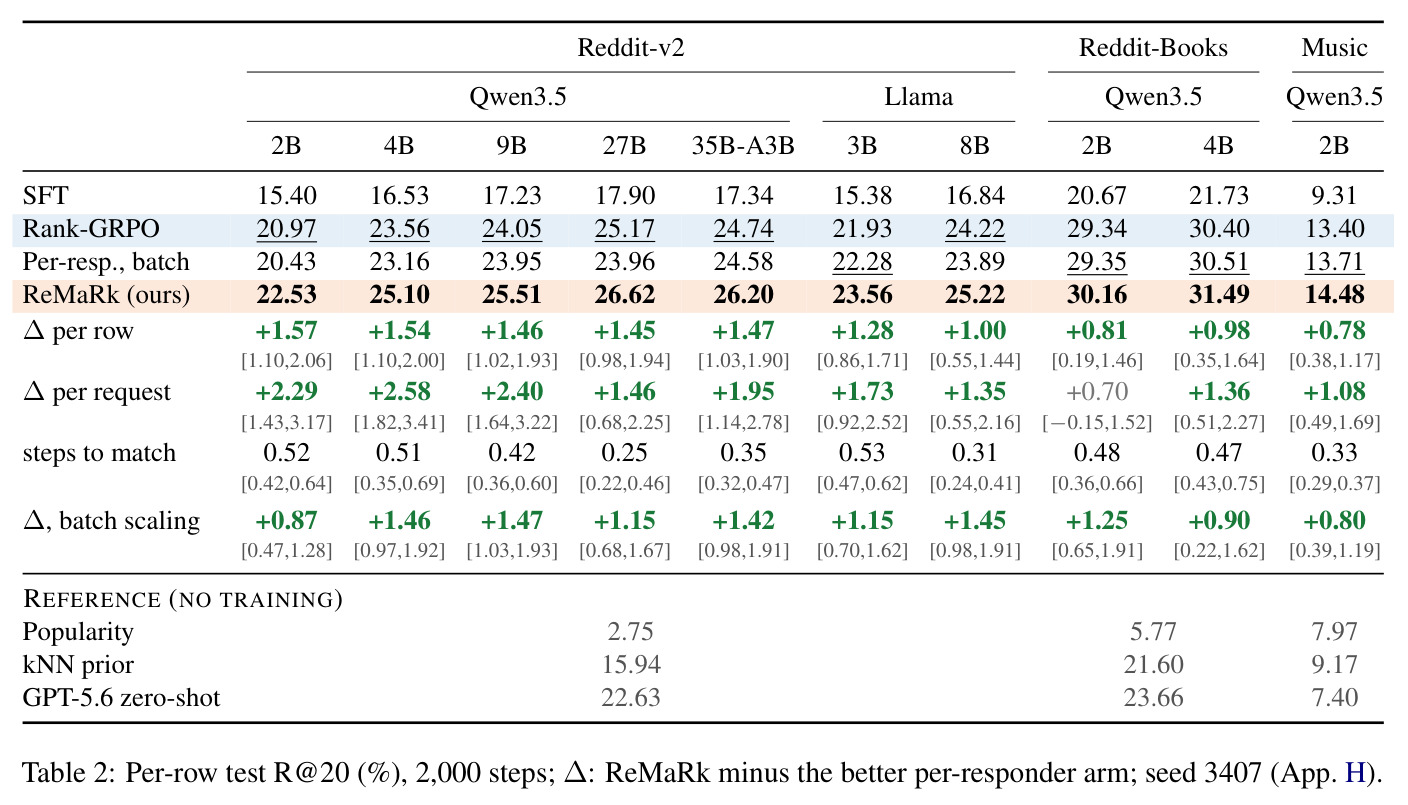
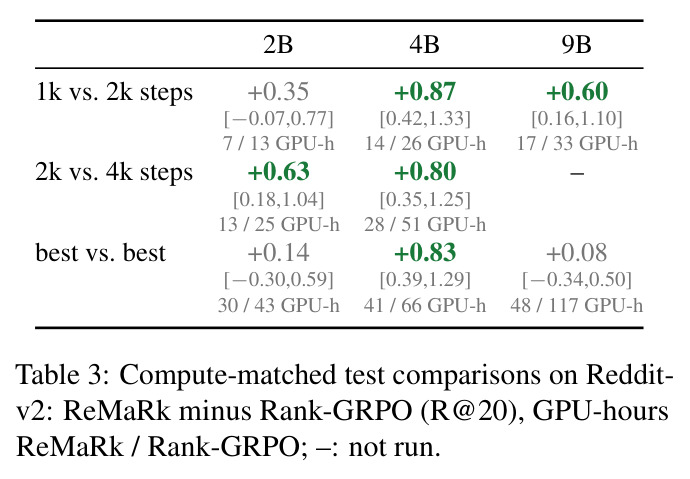
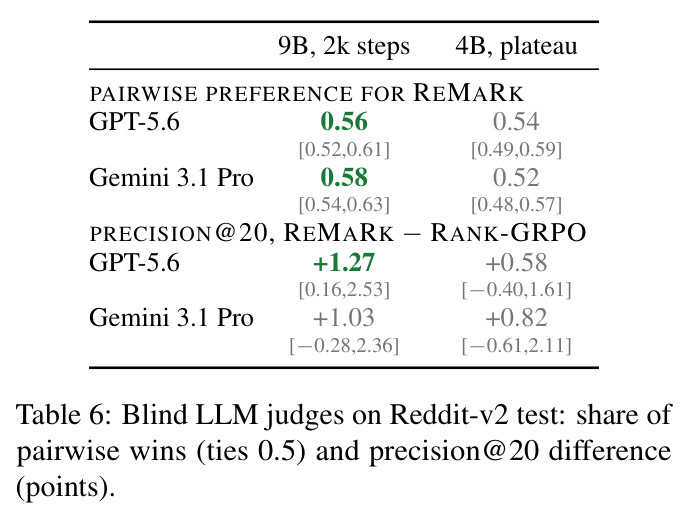
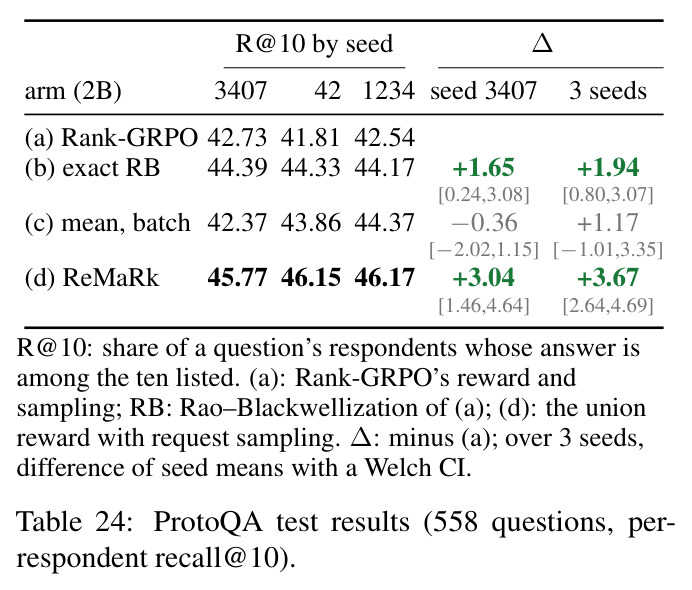
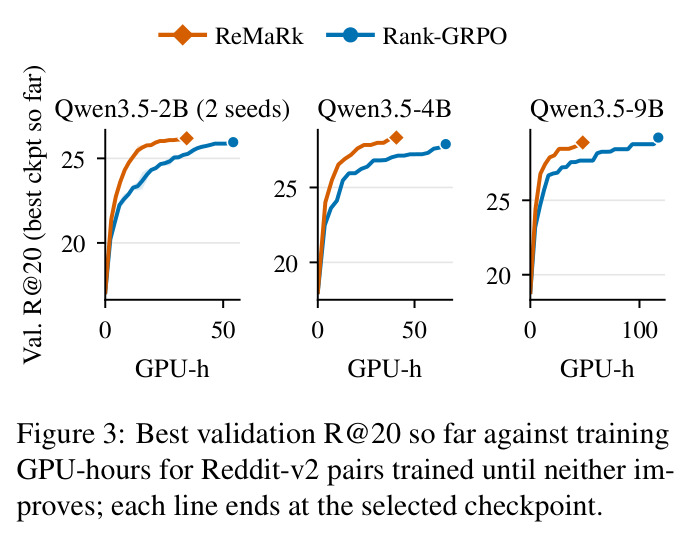
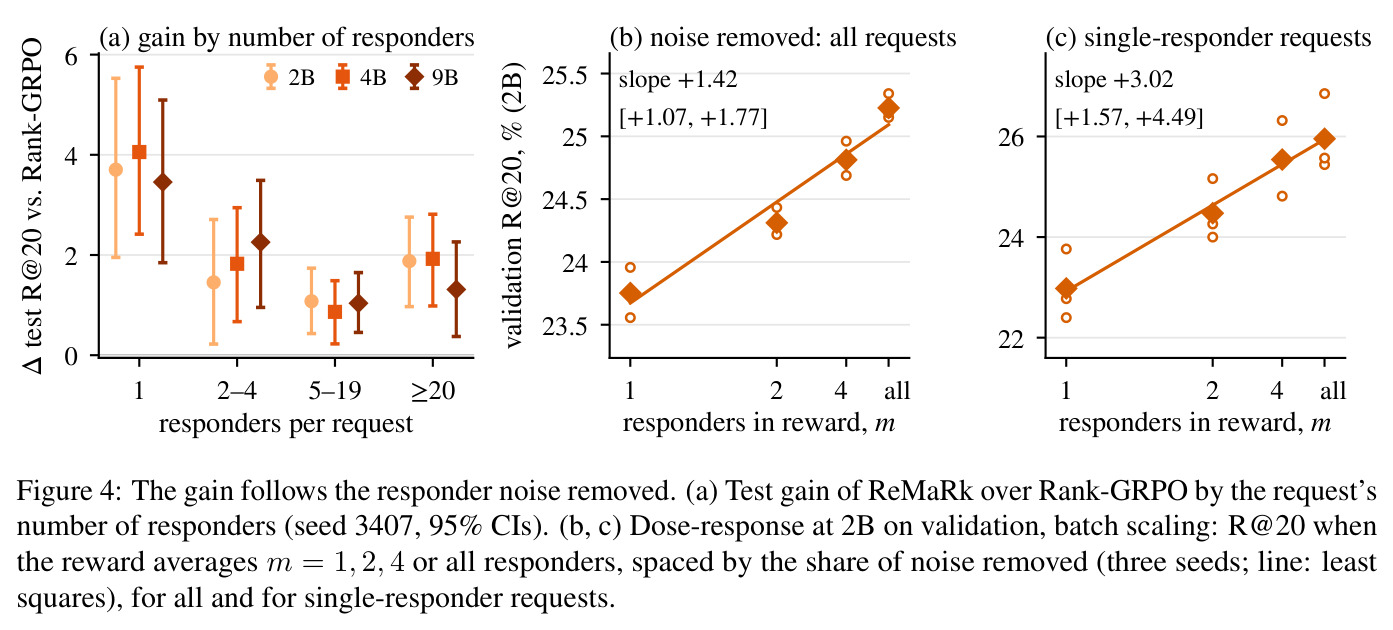
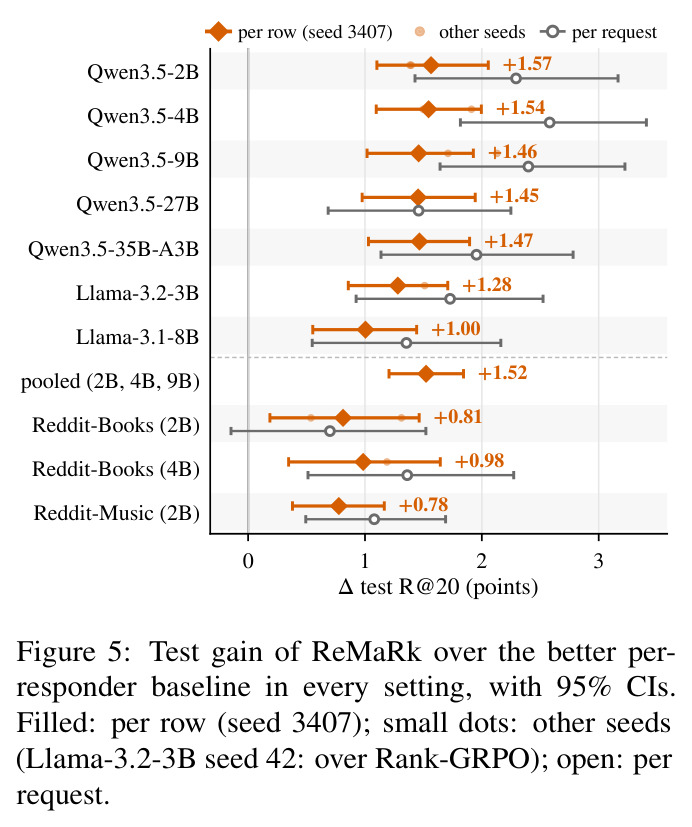
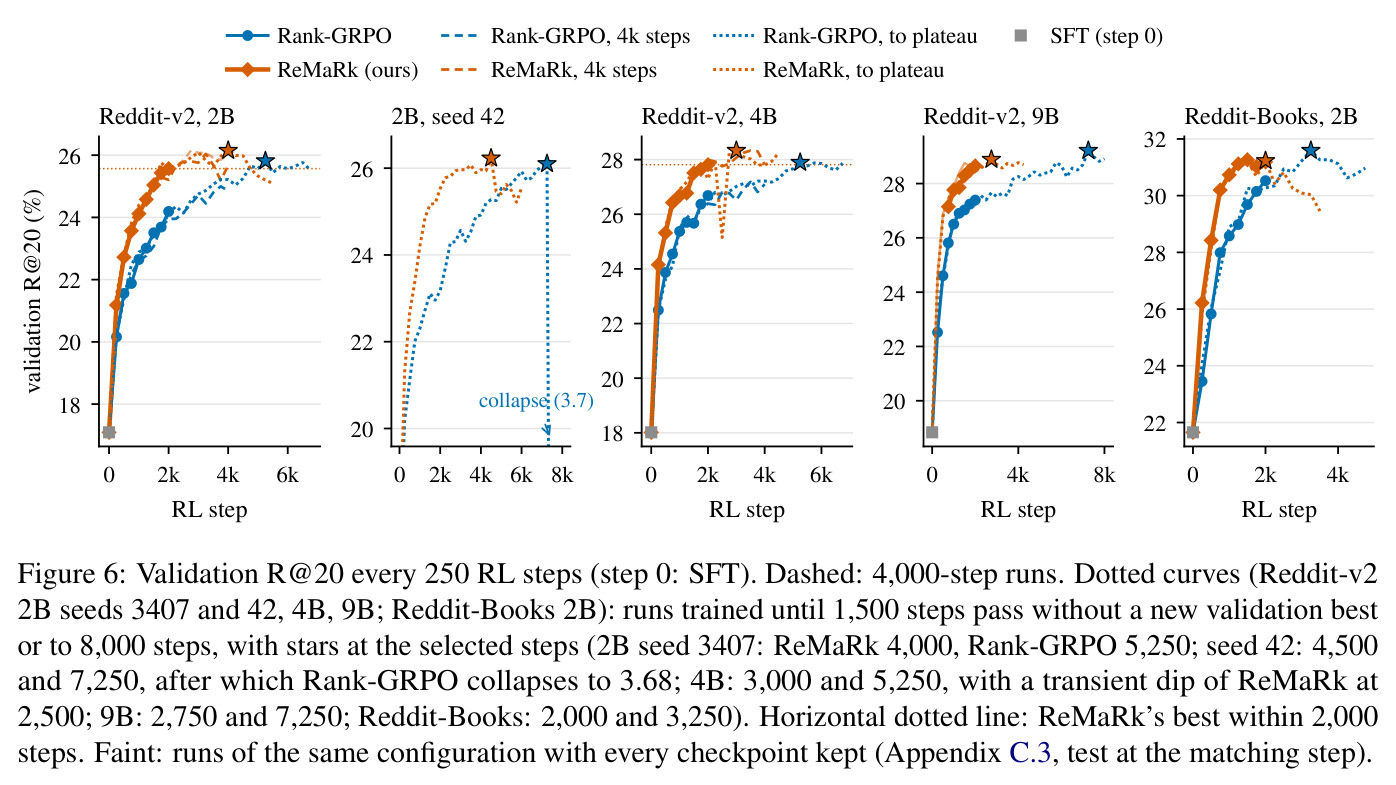
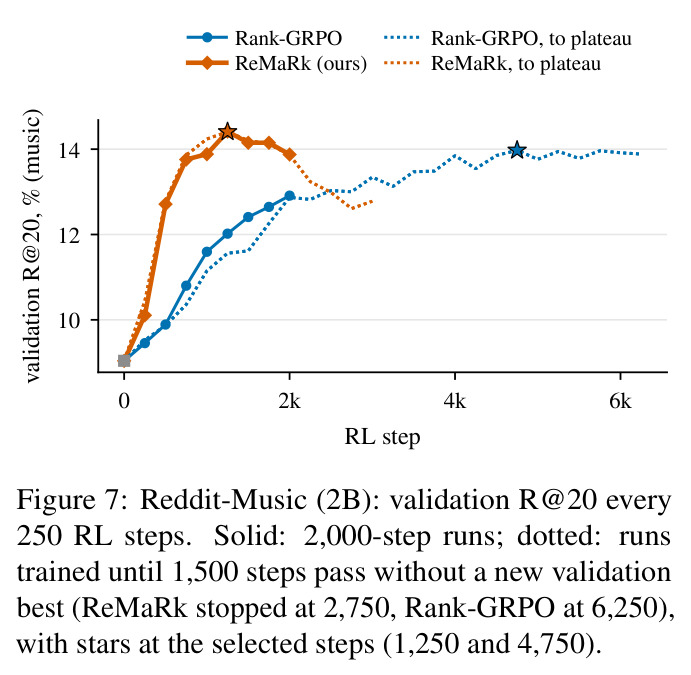
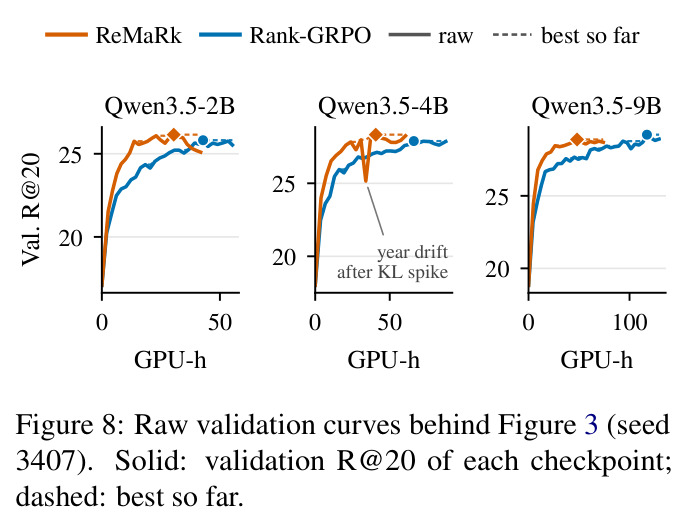
核心发现分四组。(1) 同等质量更省算力:全部 10 个(骨干×数据集)设置中,ReMaRk 用 25–53% 的步数达到基线 2,000 步的验证 R@20(27B 只需 0.25 倍);2,000 步时 per-row R@20 领先 +0.78~+1.57 点(Reddit-v2 2B:22.53 vs 20.97,+1.57 [1.10, 2.06];9B:25.51 vs 24.05;Books 4B:31.49 vs 30.51;Music 2B:14.48 vs 13.71)。训练到平台期:7 对中 4 对用 18–63% GPU 时数达到 Rank-GRPO 最好水平;GPU 匹配下,半程步数的 ReMaRk 在 2B 持平(+0.14,CI 含零)、4B/9B 领先(+0.87/+0.60)。(2) 归因:并集与均值三种子打平(−0.08),收益来自合并而非聚合;对 Rank-GRPO 更新做精确 Rao–Blackwell 化 +0.93 [+0.83, +1.04];固定尺度下剂量-反应斜率 +1.38 [+0.97, +1.78];单回答者请求增益最大(2B +3.70),来自请求采样。(3) 更强基线无法缩小差距:G=16(20.72/23.04,反而下降)、DAPO 式动态采样(21.19)、SFT 级并集正例(15.94)、DPO 级并集正例(17.08)都远低于 2B ReMaRk 的 22.53;GPT-5.6 zero-shot 22.63 与 2B 打平但落后更大模型。(4) 泛化与副作用:ProtoQA(约 100 人/题)上 +3.67 [+2.64, +4.69] 每回答者 R@10;盲评裁判偏好 9B ReMaRk(胜率 0.56/0.58)且 precision@20 不降(+1.27/+1.03);记忆探针显示增益在「基模型可复现」与「不可复现」分层内都显著;head 条目增益大于 tail(+3.36 vs +0.46),热度偏置需注意。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 对话推荐(Reddit-v2, Qwen3.5-2B, 2000步) | 测试 R@20(per row, %) | ReMaRk 22.53 | Rank-GRPO 20.97 | +1.57 [1.10, 2.06] |
| 对话推荐(Reddit-v2, Qwen3.5-9B, 2000步) | 测试 R@20(per row, %) | ReMaRk 25.51 | Rank-GRPO 24.05 | +1.46 [1.02, 1.93] |
| 对话推荐(Reddit-Books, Qwen3.5-4B) | 测试 R@20(per row, %) | ReMaRk 31.49 | per-responder batch 30.51 | +0.98 [0.35, 1.64] |
| 对话推荐(Reddit-Music, Qwen3.5-2B) | 测试 R@20(per row, %) | ReMaRk 14.48 | per-responder batch 13.71 | +0.78 [0.38, 1.17] |
| 达到基线 2000 步验证 R@20 所需步数(10 个设置) | steps to match | 25%–53% | Rank-GRPO 100%(2000 步) | 最高节省 75% RL 步数 |
| 平台期达到 Rank-GRPO 最佳验证分(7 对中 4 对) | GPU 时数占比 | 18%–63% | Rank-GRPO 100% | 最多省 82% GPU 时数 |
| ProtoQA 众包常识问答(Qwen3.5-2B, 250 步) | per-respondent recall@10 | 45.77–46.17(三种子) | 逐回答者 Rank-GRPO 41.81–42.73 | +3.67 [2.64, 4.69] |
| 盲评偏好(Reddit-v2 9B 平台期) | 成对胜率(GPT-5.6 / Gemini 3.1 Pro) | 0.56 / 0.58 | Rank-GRPO 0.44 / 0.42 | 两家族裁判均显著偏好,且 precision@20 +1.27 / +1.03 |
局限与改进
作者承认的局限:方法价值随「多回答者请求占比」增长,单回答者数据集(ReDial、INSPIRED)上退化为 Rank-GRPO;三个数据集全来自 Reddit,Books/Music 依赖 LLM 抽取与目录对齐(精度 0.966–0.997);评估指标与奖励共享同一批回答者,存在「对谁优化就对谁评估」的循环性,双家族 LLM 裁判只部分缓解;算力匹配只到 2,000 步而双臂仍在上升,9B 与 Reddit-Books 上 Rank-GRPO 的验证峰值还高 0.08–0.36 点(不显著);长训不稳定(崩溃、KL 尖峰),省算力的结论依赖验证集选点;部分骨干只有单种子;命题 1/3 不覆盖实际使用的逐组缩放。我的补充:并集丢弃共识强度信息(40 人中 20 人提到与 1 人提到同分),而朴素共识加权($c_i\ge 2$ 加 0.25)无效甚至略伤 tail(−0.36);Llama 骨干上 exact-20 列表比例漂移(3B ReMaRk 测试时仅 85.2%),长度控制在部分模型上失效;union 对长尾曝光的热度放大只有初步分析。
独立分析的弱点
独立分析四点弱点。其一,目标循环性:奖励与评估都用同一批 Reddit 回答者,模型学的是「模仿众数并集」而非真实用户满意度——若并集有系统性遗漏(无人提及的合理推荐永远拿不到奖励),RL 只能强化已见模式;改进方向是引入独立信号(目录共现、检索相似度、裁判模型)做部分奖励或噪声校正。其二,热度偏置:Table 13 显示 2B 增益 head +3.36 而 tail 仅 +0.46,Reddit-Books 上 head 甚至为 −0.09~−0.11,union 奖励天然偏向热门条目,会加剧曝光集中;可用逆倾向得分加权、tail 配额或多样性奖励对冲。其三,理论不完备:实际使用的逐组缩放不被命题 1/3 覆盖,且并集本身改变了目标函数,「为什么 group-scaled union 恰好有效」缺少证明,换数据集只能重新消融;可发展覆盖组内非线性缩放的方差分析。其四,工程脆弱性:省算力依赖每 250 步验证选点,长训有崩溃实例(seed 42 在 2B 上验证跌至 3.68),无干净验证集的线上场景难以复现该收益;可研究鲁棒早停或 KL 熔断。
未来方向
作者点明的延伸:任何「每个标注者一行」的 GRPO 数据都能直接套用这一原则(reward the answers jointly);与 Rank-GRPO 之上的其他改进(模拟用户、其他奖励设计)正交可组合;与 ShapE-GRPO 的候选间 credit 分配可以叠加。基于成果可延伸的方向:把聚合从 0/1 并集推广到保留共识信息的校准权重 $f(c_i)$(如 $\sqrt{c_i}$ 或经验证集选择的单调函数),因为朴素的二值共识加权已被证明无效;对 $n_x$ 有限导致的 $\hat{p}$ 采样误差显式建模;把回答者边缘化推广到 RLHF 多标注者偏好、众包 QA 等更广的多参考 RL 场景;研究针对长尾条目的去偏 union 奖励;补齐逐组缩放下的理论;在真实线上 A/B 中检验 per-request 指标提升是否转化为用户满意度。
复现评估
复现条件良好但需要相当算力。项目页 lixin.ai/ReMaRk 提供代码与数据说明;Reddit-v2 公开,Reddit-Books/Music 以提交与评论 ID 加条目标签发布(Reddit 条款不允许再分发文本,需自行从 Arctic Shift 归档重建),Goodreads 图谱限学术使用,MusicBrainz 为 CC0,ProtoQA 为 CC BY 4.0。实现基于 TRL 1.14.0 + vLLM 0.17.1,与 released Rank-GRPO trainer 做过单元测试对齐。算力:每个 Qwen3.5 run 用 4 张 B200,2B 训 2,000 步约 13–14 GPU 时、9B 约 117,论文总计 ≥4,423 B200 GPU 时(156 个 run);验证每 250 步一次(2B 约 4 分钟)。单点复现(2B + 消融)在 4×A100/H100 量级可承受,7 骨干全矩阵加三种子则是论文级投入。超参全部继承 Rank-GRPO 且未调,改学习率不改变排序,对复现友好。总体难度:中等——工程量在数据重建与 trainer 对齐,而非算法本身。
论文图表
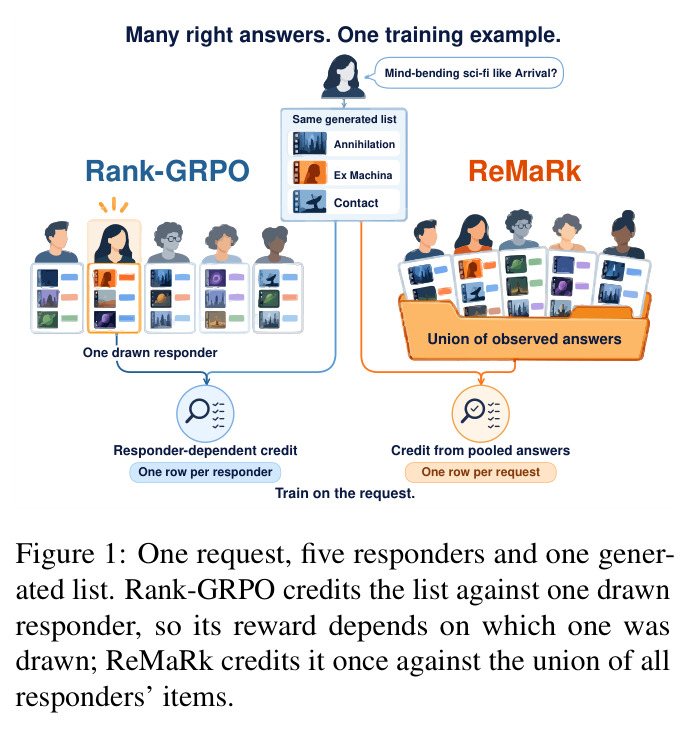
同一个求推荐请求有五个回答者,各自给出不同片名(如 Arrival、Annihilation、Ex Machina)。同一个生成列表在 Rank-GRPO 下按随机抽到的那个回答者打分,得分随抽签波动;ReMaRk 则把五个人的条目并成一个并集,只打一次分。
一图点题:回答者抽签是奖励噪声的来源、并集打分是解法,是理解全文动机与方法的入口。