超越策略采样:面向 LLM RLVR 的锚定噪声嵌入空间定向探索 Beyond Policy Rollouts: Embedding-Space Directional Exploration with Anchored Noise for LLM RLVR
锚定噪声扰动输入嵌入,小部分扰动 rollout 即可显著提升 GRPO 探索与推理
前置知识
RLVR(可验证奖励强化学习)
RLVR 指用可自动验证的奖励(如数学答案比对、单元测试通过)对 LLM 做强化学习后训练的方法族,代表算法有 PPO、RLOO、GRPO、DAPO。相比人类反馈奖励,验证器奖励可靠且廉价,使大规模推理训练成为可能,也是本文全部实验的设定(二值奖励:答对 1、答错 0)。
本文的方法与所有实验都建立在 RLVR 的组采样与二值奖励之上,不懂它就无法理解探索瓶颈为何出现、组相对信号为何坍缩。
GRPO(组相对策略优化)
GRPO 是无 critic 的策略梯度算法:每个 prompt 采样 $G$ 条轨迹,用组内奖励标准化 $A_i=(r_i-\mu_q)/\sigma_q$ 作为该轨迹所有 token 共享的优势,替代 PPO 需要学习的价值网络,再配合裁剪代理目标和可选的 KL 正则。它已成为 LLM 可验证奖励后训练的主流选择。
EDEN 直接构建在 GRPO 之上:混合组归一化、优势筛选、$\gamma$ 降权全部作用在组相对优势这个量上,不熟悉 GRPO 就看不懂算法设计。
零优势组与组相对信号坍缩
组内标准化后,若 $G$ 条轨迹奖励全部相同(全对或全错),则 $\mu_q=r_i$ 且 $\sigma_q\to 0$(数值稳定器兜底),所有优势退化为 0,该 prompt 对梯度没有任何贡献。论文用「零优势组占比」来量化训练信号的枯竭程度,是解释 EDEN 收益的核心指标。
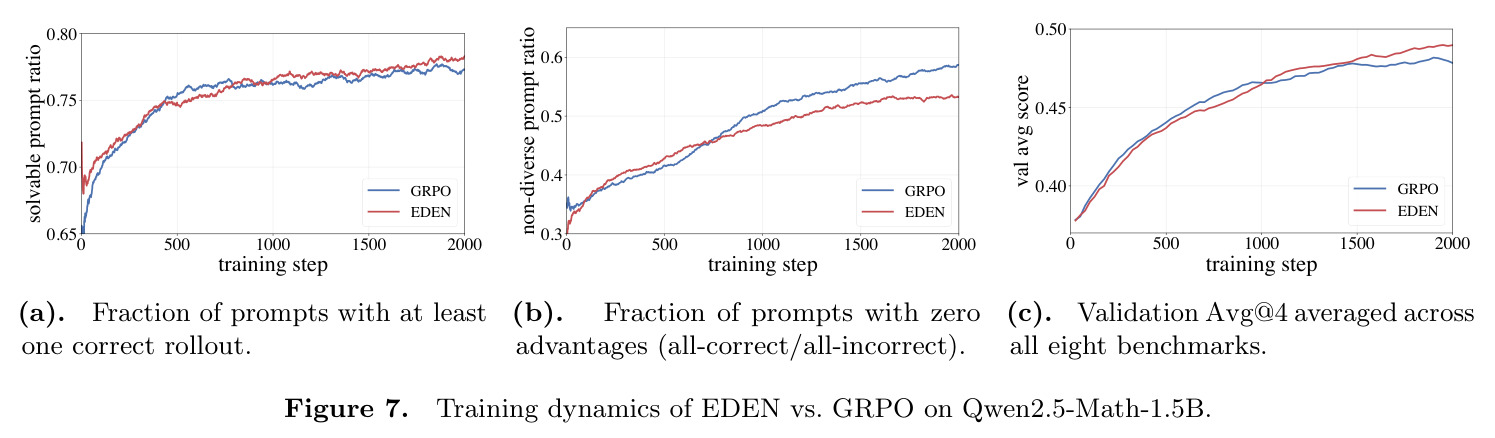
EDEN 的一个关键卖点就是把更多退化组重新变成有非零信号的学习样本(Fig. 7b),理解这个指标才能读懂其机制分析。
熵坍缩
RL 训练中策略分布逐渐集中、策略熵持续下降的现象,通常在几百步内发生。熵过低使采样趋于确定性输出,组内轨迹高度趋同、探索枯竭,pass@k 在大 $k$ 时甚至退化。常见对抗手段包括熵奖励、Clip-Higher、Clip-Cov/KL-Cov 正则等。
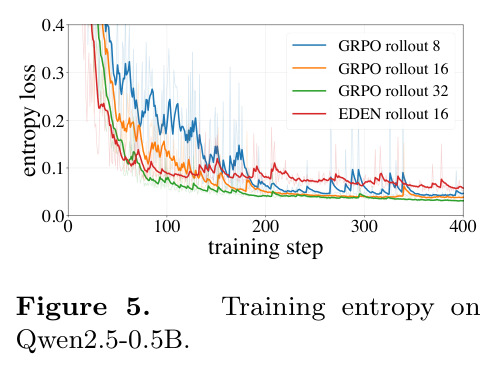
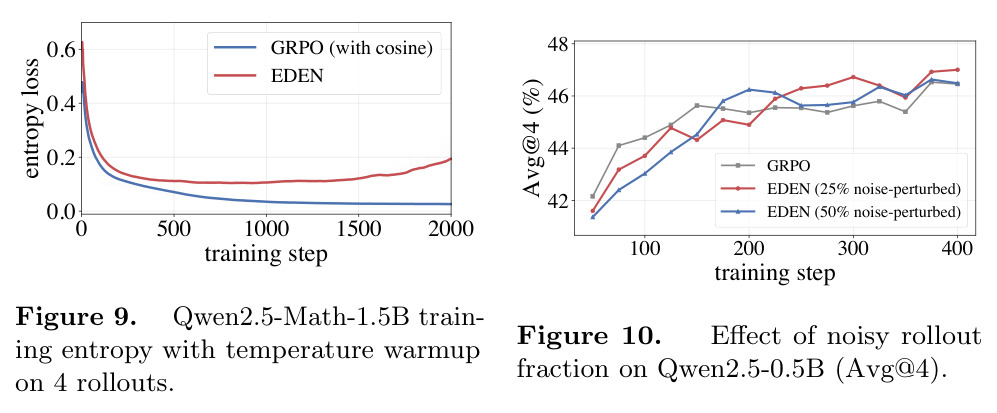
论文用熵曲线论证:单纯加大 GRPO rollout 数(8/16/32)都会在约 200 步内熵坍缩,而 EDEN 在预热后维持更高熵,这是其探索更持久的证据。
Pass@k
对每道题采样 $k$ 条候选、只要有一条答对即记分的指标,衡量策略在预算 $k$ 下的解空间覆盖率。Pass@k 随 $k$ 增长的斜率反映正确解的多样性:斜率越大说明策略掌握的正确解法越多,而不只是把单一解法打磨得更准。
EDEN 的核心主张是「扩大正确轨迹覆盖」,其证据链正是 Pass@1/8/256 的梯度式差距,评测设置(温度 0.6、top-p 0.95)也围绕该指标。
嵌入空间输入扰动
把连续噪声直接加到输入 token 的嵌入向量上(而非离散 token、logits 或策略权重),并利用自回归条件化把单点扰动放大为整条轨迹的分布偏移。相关工作包括软提示、Soft Tokens 的逐步软 token 干预、REFT 的首 token 多样化等。
EDEN 的全部操作发生在嵌入空间:锚是词表 token 嵌入,噪声按锚的范数缩放,只有理解嵌入几何(范数、夹角、高维噪声近似正交)才能理解方法与消融。
研究动机
RLVR 已成为推理 LLM 后训练的标准配方(PPO、RLOO、GRPO、DAPO 等),共同骨干是组采样:每个 prompt 采 $G$ 条轨迹、用可验证奖励的组内相对优势驱动更新。由于 rollout 生成昂贵,实际训练每组只有 8–16 条轨迹,同一策略反复采样极易产生高度相似的轨迹,组内奖励方差随之收缩;一旦组内奖励全同,组相对优势 $A_i=(r_i-\mu_q)/\sigma_q$ 归零,GRPO 在该 prompt 上的梯度信号完全消失,DAPO 因此被迫引入 Dynamic Sampling 过滤这类退化组。训练动力学同样恶化:策略熵可在数百步内坍缩,pass@k 在大 $k$ 时甚至会退化到低于基座模型。现有补救手段——提高采样温度、熵奖励、Clip-Higher 非对称裁剪、Clip-Cov/KL-Cov 正则、加大 rollout 预算——要么改变采样分布、要么修改更新目标,都不触及 rollout 的输入条件,难以突破「同分布反复采样」的多样性天花板。
本文的目标是论文要回答的问题是:能否用一个最小的输入嵌入干预,实现有用的轨迹级探索,同时保留标准离散解码、不改动模型架构、测试时推理完全不变?具体而言,EDEN 在不增加 rollout 总预算的前提下,把每个 prompt 组内 16 条 rollout 中的 4 条替换为「同一策略在 prompt 后附加一个扰动嵌入位置」条件下生成的轨迹:扰动从第一个解码步起通过自回归条件化影响整条 rollout;再通过优势门控筛选与降权,把最有信息量的扰动轨迹吸收进 GRPO 更新。最终目标是在数学推理基准上同时提升 Pass@1 与 Pass@k 覆盖率,并让更多 prompt 组保留非零的组相对学习信号。
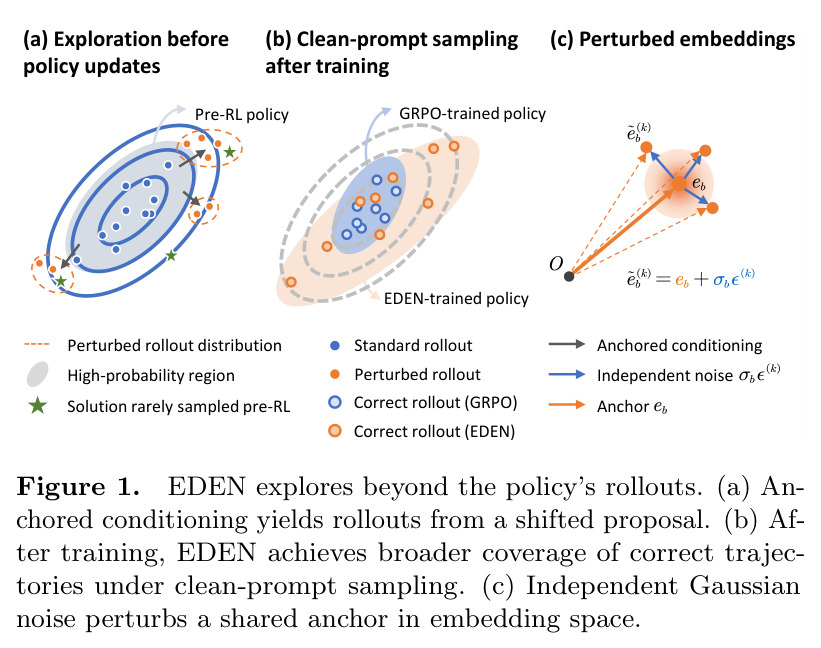
与已有工作不同的是,各类探索方法的杠杆点不同:温度、熵奖励、非对称裁剪与 KL/Cov 正则作用于采样分布或目标函数;Dynamic Sampling、CPPO、GRESO 做轨迹或提示的选择筛选;树搜索从中间状态分支;Soft Tokens 需在每个 CoT 步扰动输入并用软 token 解码,PSN-GRPO 扰动策略权重,QeRL 借用量化噪声,SofT-GRPO 对 logits 做 Gumbel 扰动且需软解码。EDEN 的独特切入是「rollout 源头」:只在 prompt 之后追加单个嵌入位置,用从词表嵌入中筛选出的锚提供组内共享的条件化方向,叠加各向同性高斯噪声制造局部变化,实现方向性输入扰动——组内共享方向、组间探索不同方向;离散解码、模型架构与推理路径全都不动,可与 GRPO/DAPO 生态即插即用地组合。
核心方法
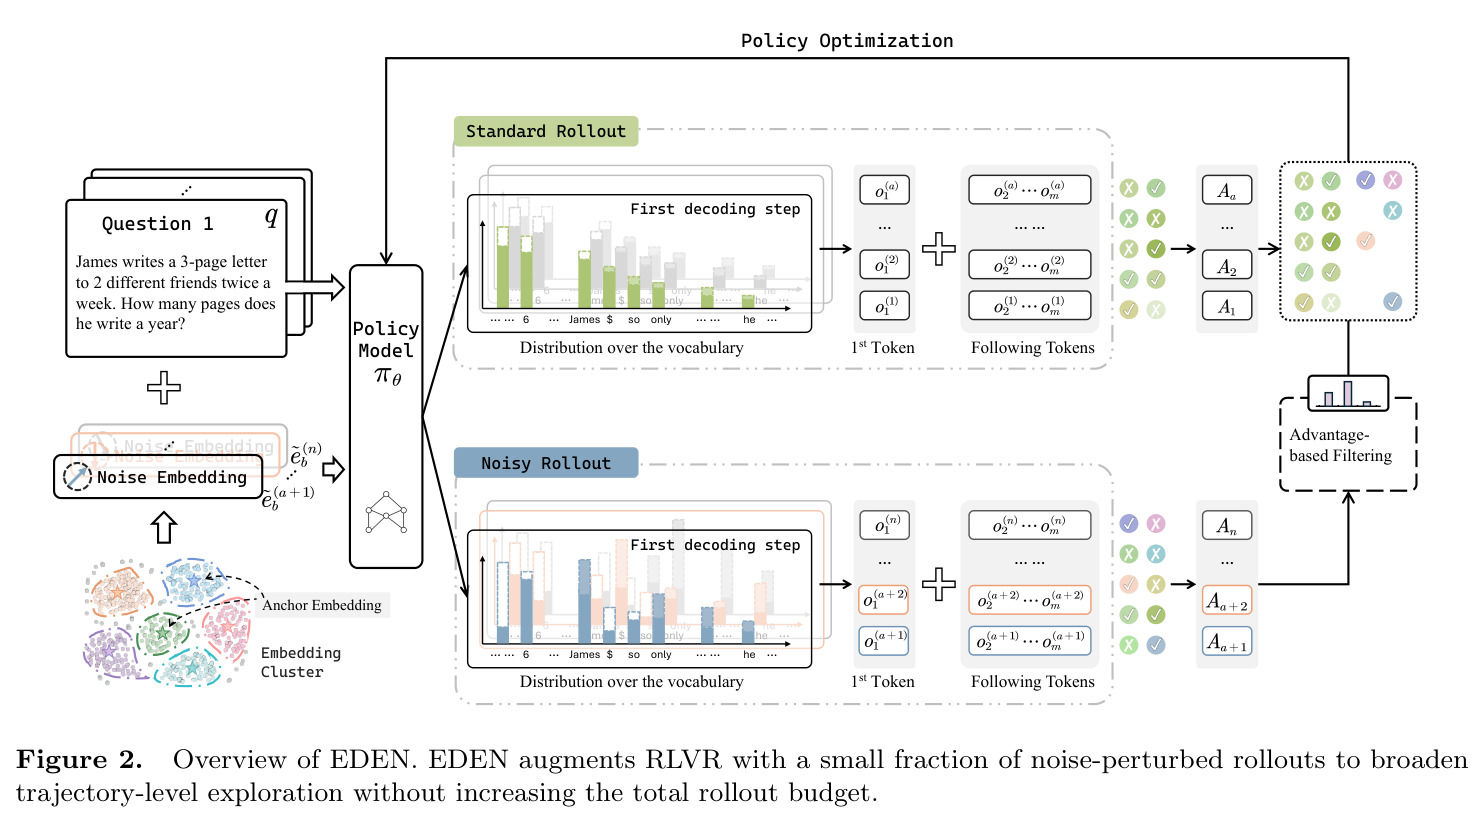
直觉上,与其在输出端加热度或多采样,不如改变一部分 rollout 的生成条件:给 prompt 追加一个连续扰动向量,让自回归解码从第一步就进入标准采样难以覆盖的区域。EDEN 分三部分。Perturb:从训练前固定、含 $K$ 个词表嵌入的噪声库 $\mathcal{B}$ 中为每个 prompt 均匀抽一个锚 $e_b$,把 prompt 末尾新增的嵌入位置设为 $\tilde{e}_b = e_b + \rho\lVert e_b\rVert_2\epsilon/\sqrt{d}$,$\epsilon\sim\mathcal{N}(0,I)$,按升温温度采 $K_n=4$ 条噪声 rollout,同时常规温度采 $K_r=12$ 条标准 rollout。Regulate:用范数相对噪声尺度 $\rho$、余弦温度预热 $\tau_n(s)$ 和锚库共同控制探索强度。Absorb:在混合组上做组相对优势归一化,按批保留 $|\mathcal{A}|$ 居前 $p$ 比例的噪声轨迹并将其优势乘以 $\gamma\in(0,1]$ 降权;更新时移除扰动位置、在干净 prompt 下评估全部 token,用带非对称裁剪、KL 与熵奖励的 GRPO 式目标更新,无需重要性采样校正。
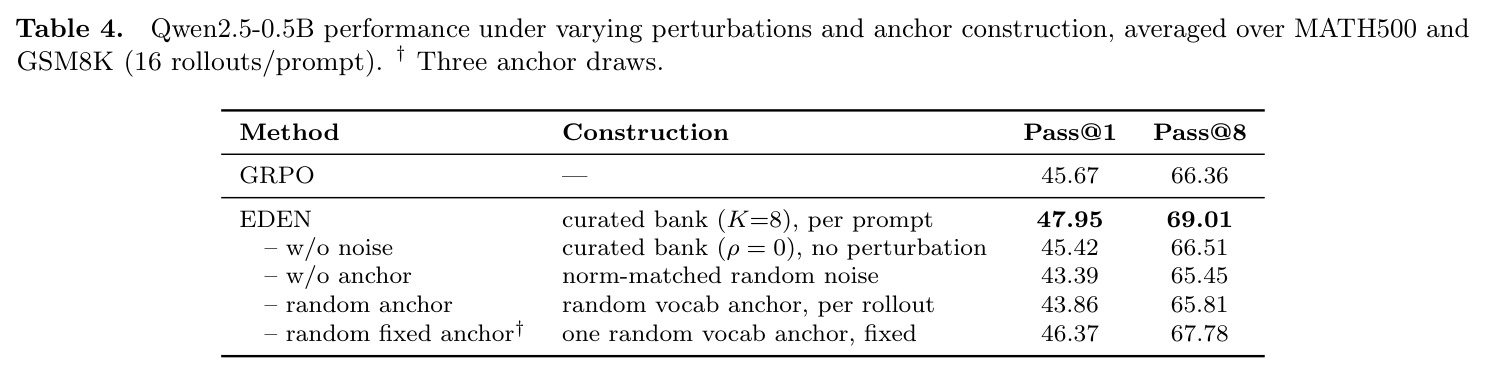
核心创新是「锚定噪声」这一输入端探索原语。高斯噪声本身无方向,但在高维空间中缩放噪声近似正交于锚,扰动向量与锚的夹角约为 $\arctan\rho$;同一 prompt 组的全部 $K_n$ 条扰动 rollout 共享同一个锚,形成共同的嵌入空间条件化方向,局部变化由独立噪声提供,而不同组抽取不同锚,实现「组内方向一致、组间方向多样」。这与已有方法的本质区别在于:Soft Tokens 要在每个 CoT 步扰动并用软解码,SofT-GRPO 需对 logits 做 Gumbel 扰动加软解码,PSN-GRPO 动策略权重,QeRL 依赖量化噪声;EDEN 只动一个附加嵌入位置,离散解码、架构与推理路径都不变。消融证明噪声与锚缺一不可:去掉噪声($\rho=0$)回落到 GRPO 水平(45.42 vs 47.95),去掉锚的范数匹配纯噪声更差(43.39),逐 rollout 换随机锚破坏组内一致性(43.86),而固定单一随机锚也能恢复部分收益(46.37),说明「共享锚」本身就有价值。
方法步骤详情
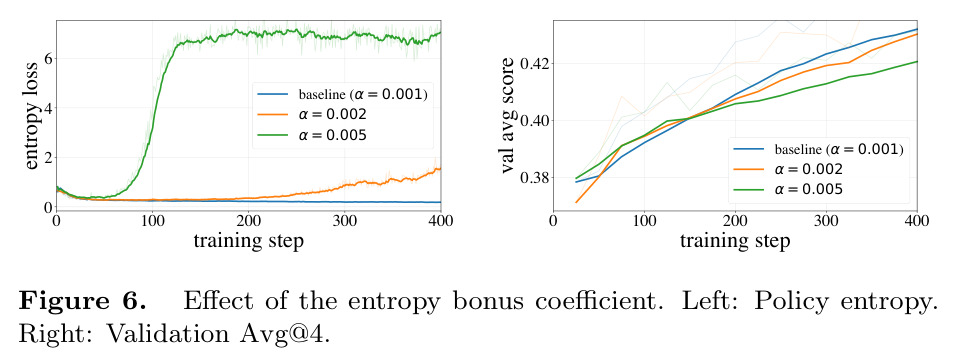
按 Algorithm 1:(1) 预构建噪声库:用 200 条训练 prompt 从词表嵌入中筛选 $K=8$ 个「生成可行且方向互补」的锚,训练期间固定;(2) 每步采样 prompt 批(batch=128),每个 prompt 先按温度 $\tau_r$ 抽 12 条标准 rollout,再从库中均匀抽一个锚 $e_b$,附加扰动嵌入 $\tilde{e}_b$ 后按预热温度 $\tau_n(s)$ 抽 4 条噪声 rollout,$\rho$ 按模型取 0.12 或 0.18;(3) 计算二值奖励,在 16 条混合组上做组相对优势归一化;(4) 以批为单位保留 $|\mathcal{A}|$ 排名前 $p$ 比例的噪声轨迹,使稀有且能改变组内信号的偏差优先入选;(5) 保留轨迹优势乘 $\gamma$ 降权,标准轨迹不变;(6) 移除扰动位置,在干净 prompt 下按 GRPO 式裁剪目标更新 $\theta$($\beta=0$,$\alpha=0.001$);(7) 循环至训练结束。流程嵌入 verl+vLLM,每 prompt 总 rollout 数保持 16。
技术新颖性
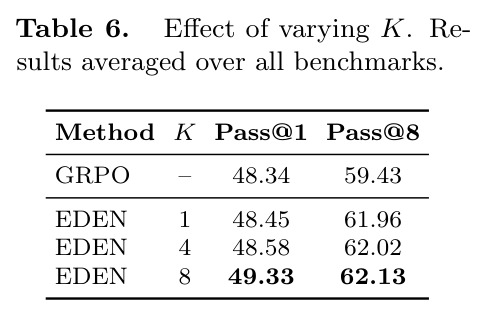
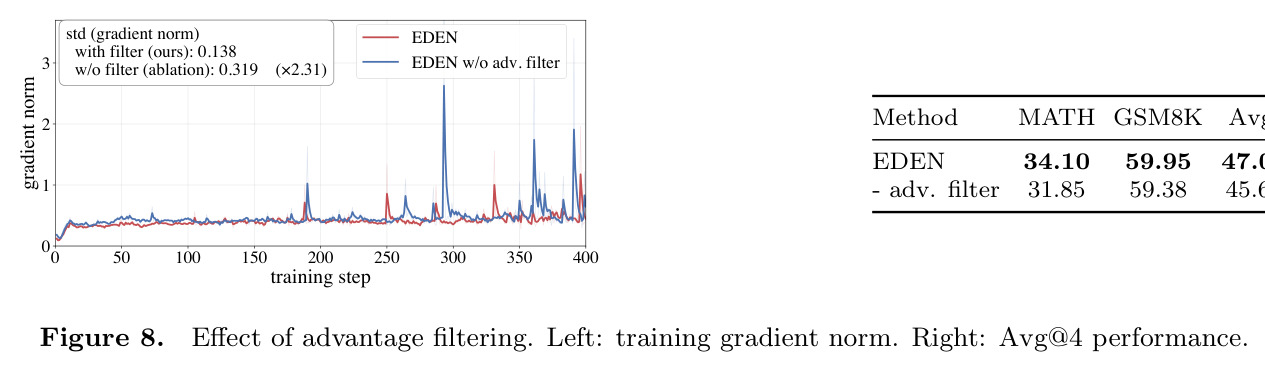
技术新颖性有四点。其一,把探索的干预点从「采样分布/更新目标」移到「输入条件化」,用单个附加嵌入位置实现轨迹级多样化,开销几乎为零且完全不触碰推理路径。其二,锚-噪声分解:锚提供共享方向、噪声提供局部散布,消融(Table 4)证明二者互补,库($K=8$)相对单锚主要提升贪心 Pass@1(49.33 vs 48.45,Table 6),而 Pass@8 增益单锚即可恢复大半。其三,处理生成-更新条件失配的方式非常克制:不做重要性采样校正,而用 $|\mathcal{A}|$ 门控加 $\gamma$ 降权「吸收」扰动轨迹,消融显示去掉过滤器后梯度范数标准差从 0.138 升到 0.319(×2.31),训练明显不稳(Fig. 8)。其四,与 GRPO/DAPO 生态完全兼容:只用二值奖励与标准混合组归一化,仅替换组内 4/16 的 rollout 来源,且三个模型规模、8 个基准上一致有效,说明该原语可迁移而非过拟合单一设置。
实验结果
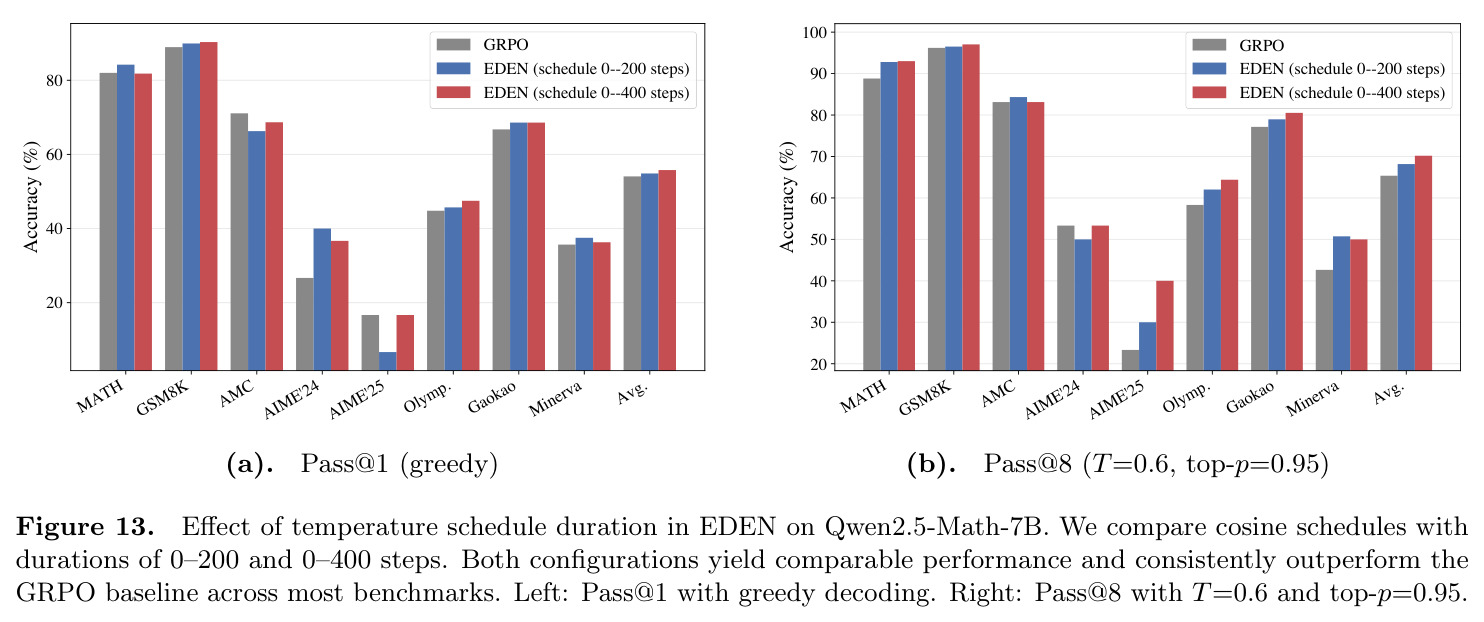
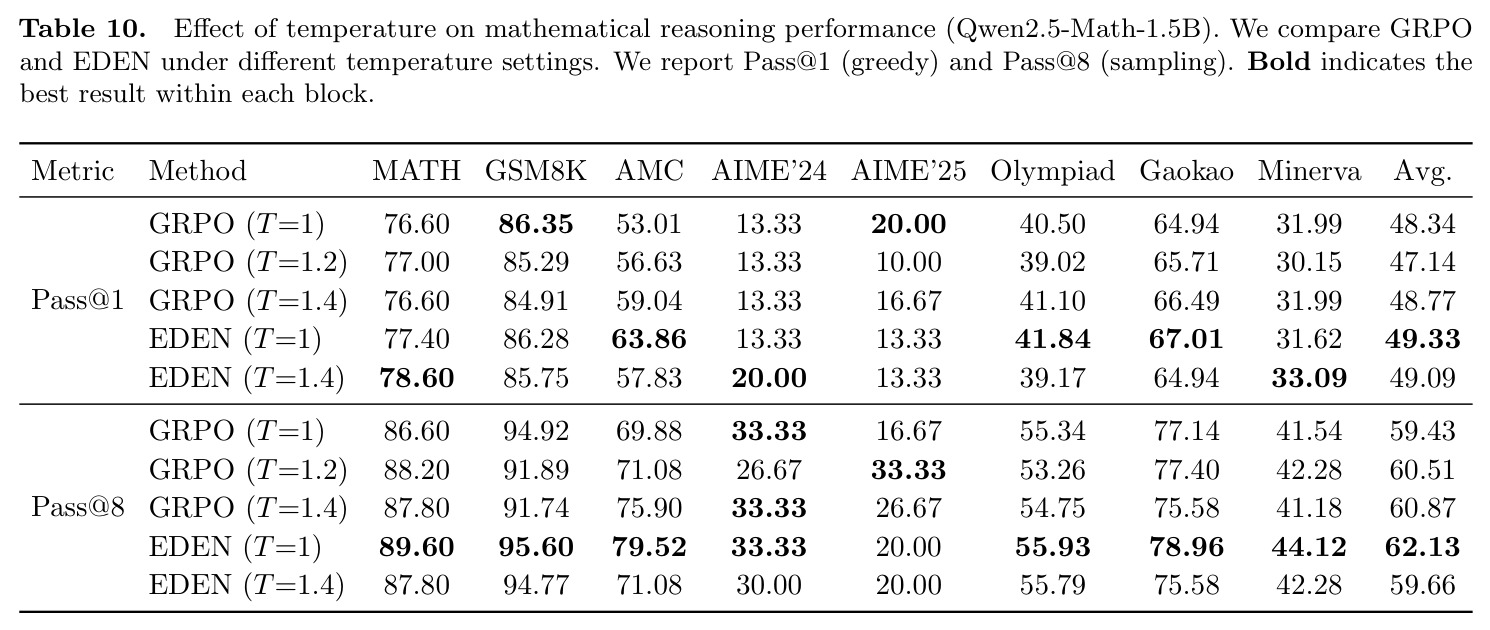
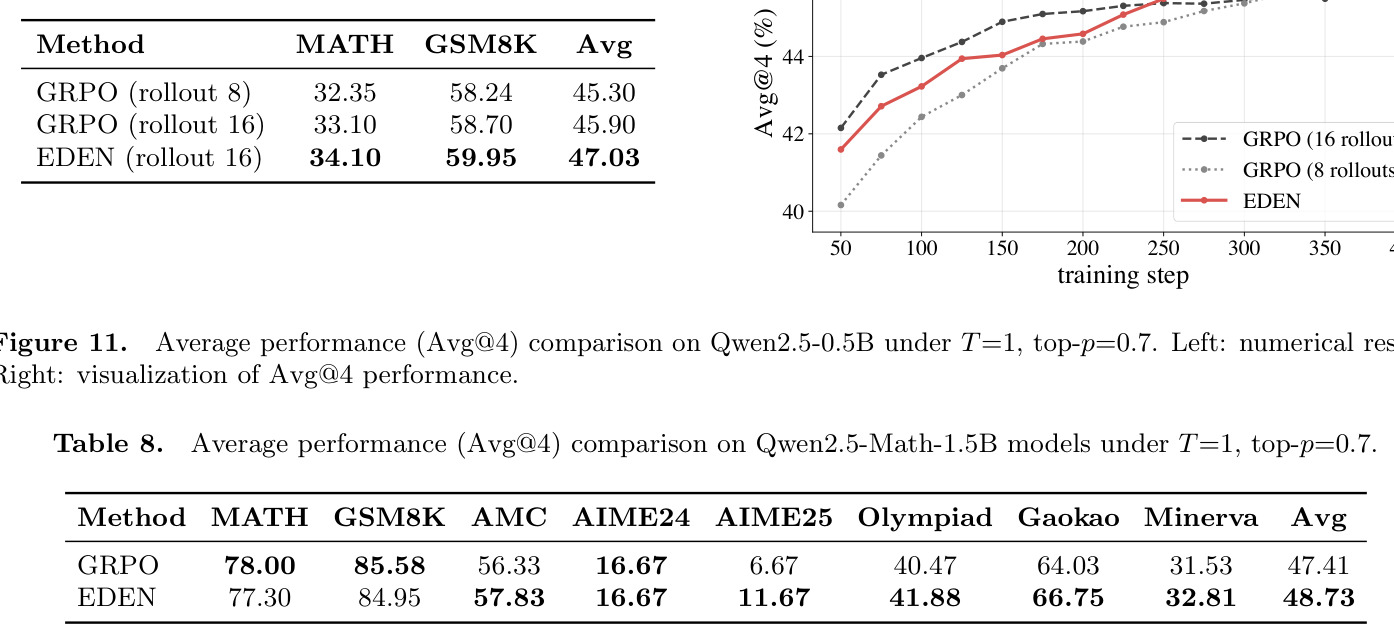
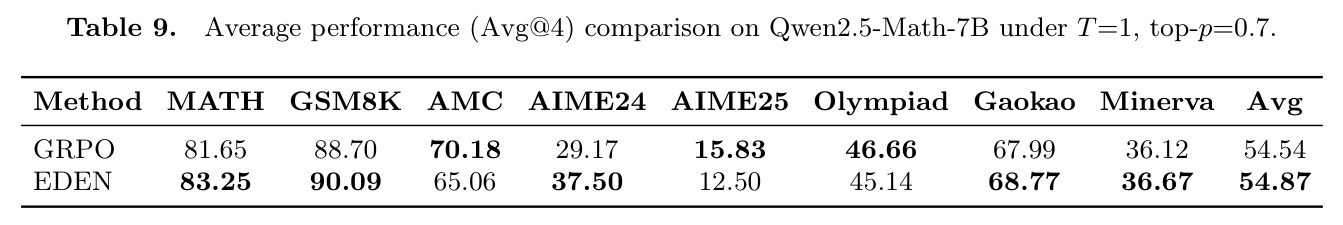
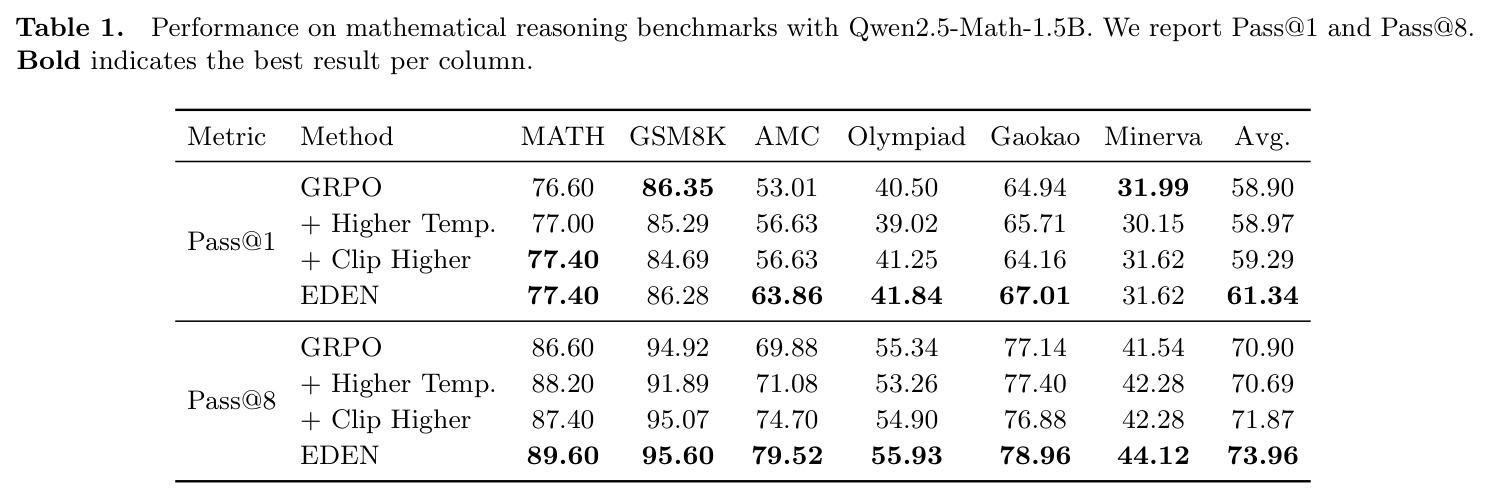
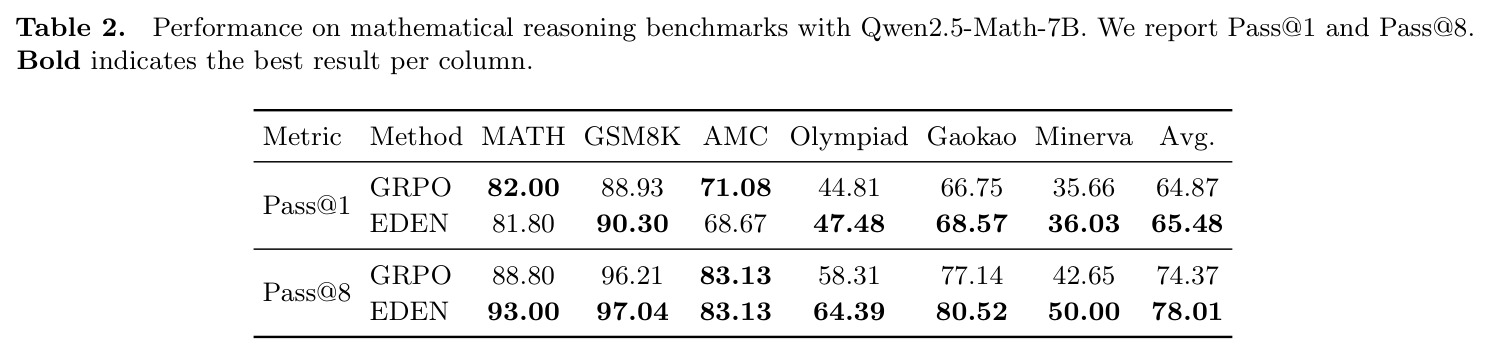
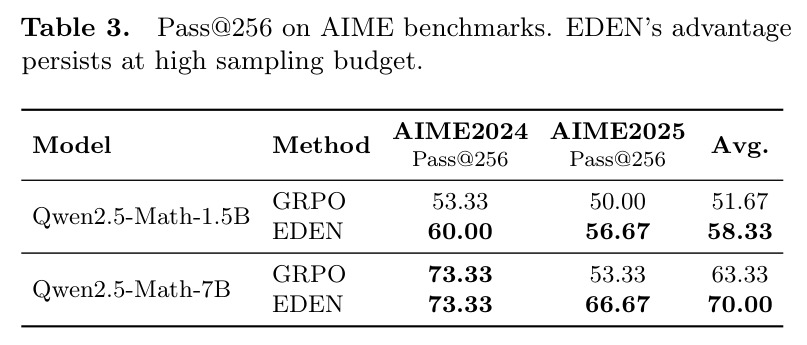
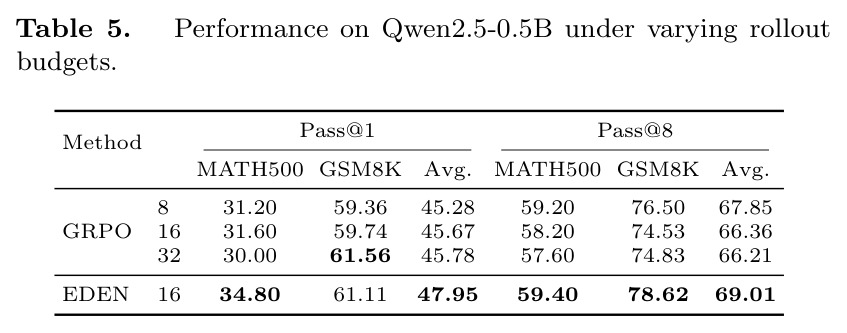
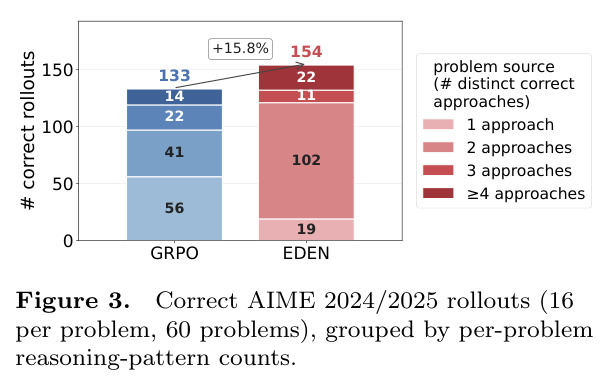
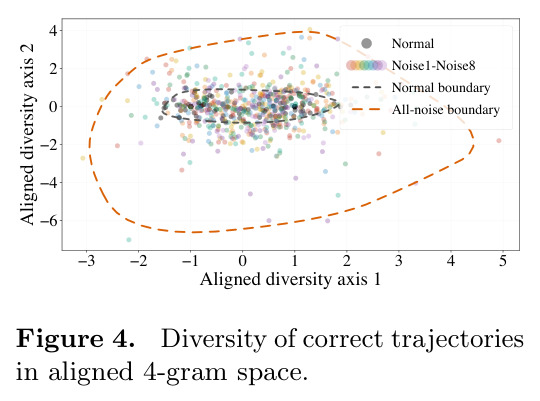
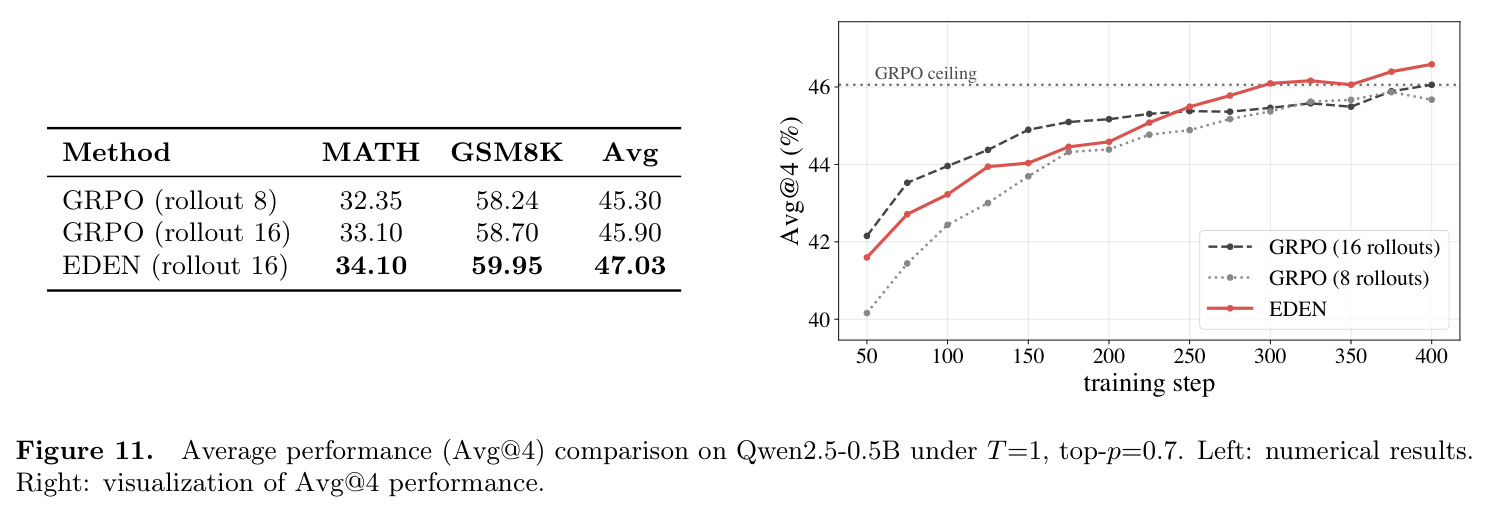
主实验覆盖 Qwen2.5-0.5B/1.5B/7B。1.5B(Table 1):Pass@1 均值 61.34 vs GRPO 58.90(+2.44),Pass@8 73.96 vs 70.90(+3.06),AMC Pass@1 53.01→63.86;对照 Higher Temp(58.97)与 Clip Higher(59.29)均远不及。7B:Pass@1 65.48 vs 64.87,Pass@8 78.01 vs 74.37(+3.64)。Table 3:AIME Pass@256 平均 1.5B 70.00 vs 63.33、7B 58.33 vs 51.67(+6.67,单项最大 +13.33)。Fig. 3:正确 AIME rollout 中来自「≥4 种解法」问题的数量 133→154(+15.8%)。Table 5:GRPO 预算 8→32 仅使 Pass@1 均值 45.28→45.78 且 Pass@8 略降,EDEN@16 达 47.95/69.01;各 GRPO 配置约 200 步内熵坍缩,EDEN 熵更高(Fig. 5)。机制上:EDEN 约 750 步起零优势组占比 0.53 vs 0.58(Fig. 7b);训练前扰动正确轨迹的 4-gram RMS 半径约为标准 rollout 的 1.6 倍(Fig. 4)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 六基准平均(MATH/GSM8K/AMC/OlympiadBench/Gaokao/MinervaMath,Qwen2.5-Math-1.5B) | Pass@1 | 61.34(EDEN) | 58.90(GRPO) | +2.44 |
| 六基准平均(Qwen2.5-Math-1.5B) | Pass@8 | 73.96(EDEN) | 70.90(GRPO) | +3.06 |
| 八基准平均(Qwen2.5-Math-7B) | Pass@1 | 65.48(EDEN) | 64.87(GRPO) | +0.61 |
| 八基准平均(Qwen2.5-Math-7B) | Pass@8 | 78.01(EDEN) | 74.37(GRPO) | +3.64 |
| AIME 2024+2025 平均(1.5B / 7B) | Pass@256 | 70.00 / 58.33 | 63.33 / 51.67(GRPO) | 平均 +6.67,AIME'25 单项最大 +13.33 |
| AMC(Qwen2.5-Math-1.5B) | Pass@1 | 63.86(EDEN) | 53.01(GRPO) | +10.85 |
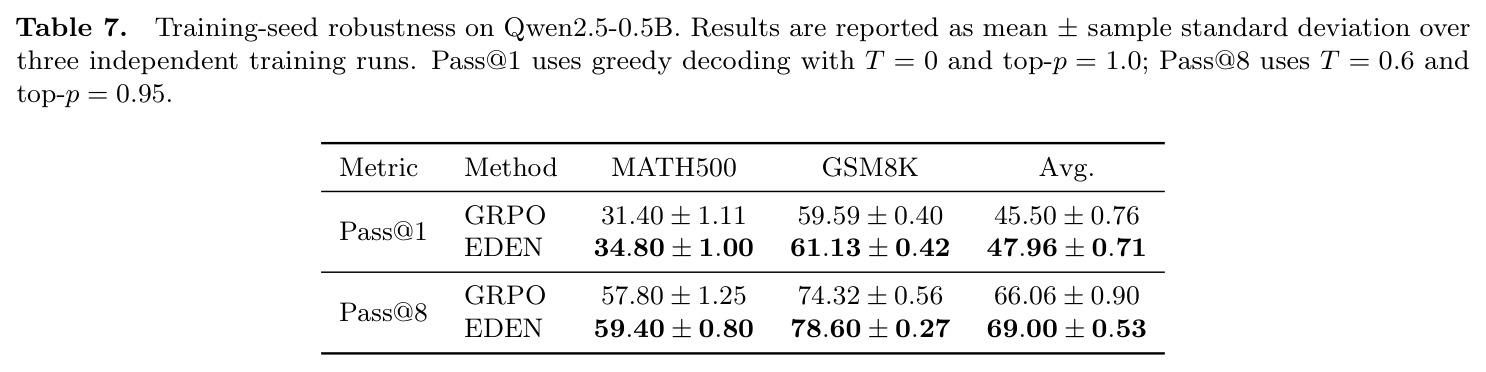
| Qwen2.5-0.5B(MATH500+GSM8K 平均) | Pass@1 / Pass@8 | 47.95 / 69.01 | 45.67 / 66.36(GRPO) | +2.28 / +2.65 |
局限与改进
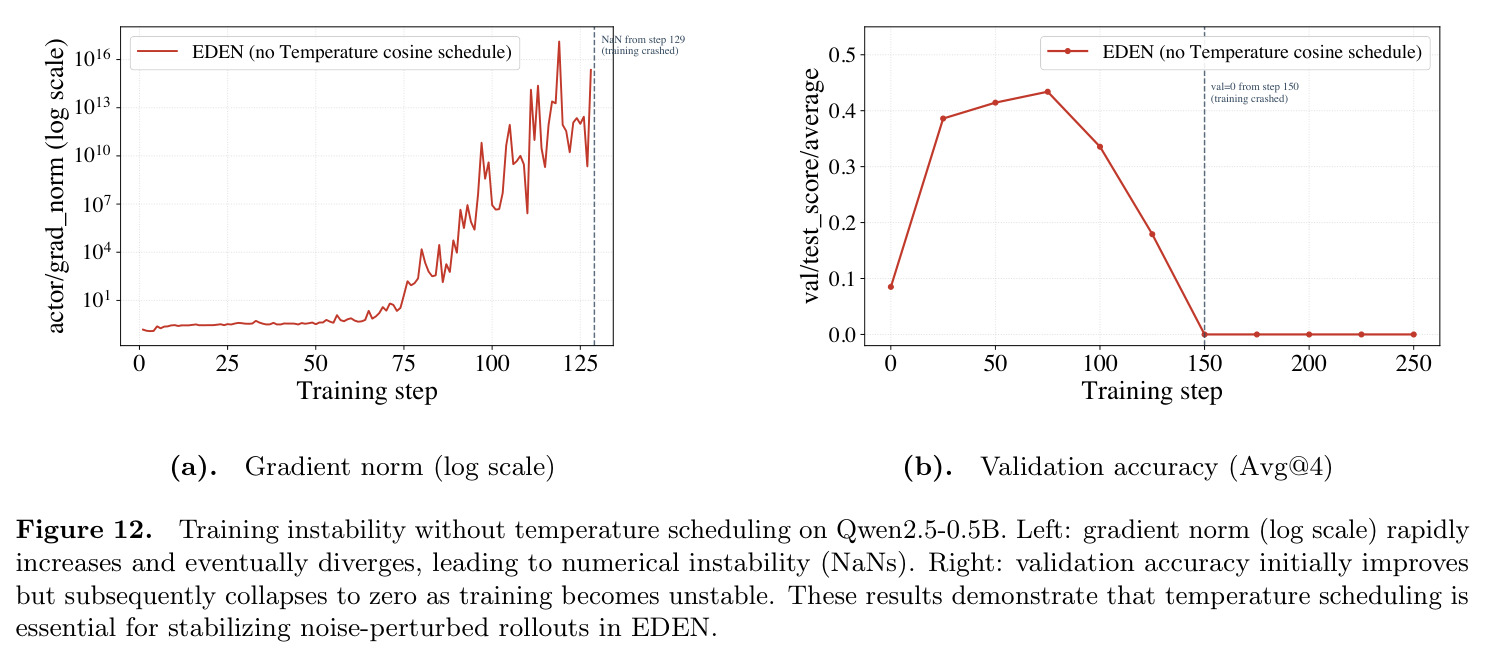
作者承认的局限:噪声库是从词表嵌入静态筛选的固定集合,尚未自适应或可学习;噪声为各向同性高斯,缺少各向异性或任务相关的方向;实验仅限数学推理与 Qwen2.5 系列(0.5B–7B),未验证代码、智能体等更广任务。我的补充观察:其一,扰动轨迹在扰动条件下生成、却在干净 prompt 下优化,且无重要性采样校正,梯度存在系统性偏差,论文只用 $\gamma$ 降权和 $|\mathcal{A}|$ 门控来「压制」而非「校正」失配;其二,7B 的 Pass@1 提升很小(+0.61),个别单项甚至回落(MATH 81.80 vs 82.00、AMC 68.67 vs 71.08),收益主要在 Pass@8/256 覆盖率,对贪心解码部署的直接增益有限;其三,批级 $|\mathcal{A}|$ 筛选使某 prompt 保留的噪声轨迹数依赖同批其他 prompt,引入批间耦合与实现复杂度;其四,超参较多且需按模型调节($\rho$=0.12/0.18、预热长度、锚库构造),附录显示极端温度会破坏训练稳定性。
独立分析的弱点
第一,生成-更新失配无 IS 校正:当 $\rho$ 较大或锚偏离 prompt 语义时,$\pi_\theta(\cdot\mid E(q))$ 对扰动轨迹的概率可能很低,策略梯度仍会推高其干净条件概率,可能奖励「离题但侥幸答对」的解。改进:给保留轨迹加基于干净 prompt 对数似然的截断重要性权重,或约束 $\tilde{e}_b$ 与 prompt 嵌入的余弦距离上界。第二,固定词表锚库与任务无关,可能长期重复探索同一批方向。改进:把锚选择做成以 prompt 或历史失败轨迹嵌入为条件的动态策略,甚至与策略参数联合优化。第三,二值奖励下 $|\mathcal{A}|$ 筛选天然偏向少数派结果,遇到部分得分或过程奖励时该准则是否仍最优未知,需在更细粒度奖励下重新推导。第四,噪声比例敏感:25% 最佳、50% 退化到 GRPO 水平(Fig. 10),多样性-信号权衡尖锐,可按题目难度或批内零优势比例在线自适应 $K_n$。第五,覆盖到精度的转化不足(7B Pass@1 仅 +0.61),可在推理侧结合拒绝采样或验证器重排,把 Pass@k 覆盖变现为单次答案准确率。
未来方向
作者提出的方向:更自适应或可学习的噪声库构造,例如随训练动态选择锚、或与策略联合优化;更结构化的扰动方案,如各向异性噪声或任务相关方向,以更好覆盖轨迹空间。基于本文成果还可延伸:把锚定噪声搬到代码生成、agentic RLVR 等其他可验证任务,检验锚的语义相关性是否跨域成立;让锚从失败 rollout 的嵌入簇中学习,形成「定向补盲区」的课程式探索;与树搜索结合,把锚当作分支条件而非中间状态分支;从理论上刻画无 IS 校正下的梯度偏差界并给出 $\gamma$ 的最优选择;在 32B+ 模型上验证规模律;将 $\rho$、$\gamma$ 与温度预热纳入统一元控制器,按批级零优势比例在线调节探索强度,替代手工调度。
复现评估
复现要素基本齐全:模型公开(Qwen2.5-0.5B/1.5B/7B 及 Math 版),训练与评测数据全部公开(GSM8K、MATH/DAPO-Math、AMC、AIME 2024/2025、OlympiadBench、Gaokao、MinervaMath),框架为 verl+vLLM,超参详尽($K$=8、$\rho$=0.12/0.18、batch 128、lr $10^{-6}$、$\beta=0$、$\alpha=0.001$、训练 6/10 epochs、Pass@8 评测温度 0.6/top-p 0.95、每 prompt 16 rollouts=12+4),锚库筛选流程在附录 C(用 200 条训练 prompt),并附种子鲁棒性实验(Table 7)。原文未给出开源代码链接。算力门槛高:需 8×H100 训练最多 10 epochs。实现难点集中在三处:在 verl 中注入附加嵌入位置(更新时移除)、批级 $|\mathcal{A}|$ 筛选、干净 prompt 下的对数概率重评估;熟悉 verl 的团队预计一到两周可复现主要结果。
论文图表