以寄存器令牌驱动世界动作模型的动作生成 Acting Through Registers
用非空间寄存器与观测流匹配监督抑制空间离群点,并将其浓缩为高效动作条件接口
前置知识
世界动作模型(WAM)
把视频生成模型改造成机器人策略的范式:Video DiT 编码当前场景与可能的演化,产生的视觉表征经 K/V 缓存条件化一个 Action DiT,由后者迭代去噪生成动作块。代表工作包括 FastWAM、Faster-WAM 等;本文分析的 FastWAM 基于 Wan2.2 视频骨干,输入分辨率对应 7×14=98 个空间令牌。
论文全部分析和改动都发生在 WAM 的“视觉表征→动作条件”这条链路上,不了解该架构就看不懂寄存器插在哪里、FM 损失加在什么之上。
流匹配(Flow Matching, FM)
一类生成建模训练目标:学习一个速度场,把噪声分布沿近似直线的轨迹输运到数据分布,损失通常是预测速度与目标速度的均方误差。WAM 用它同时训练未来帧预测(视频生成)和动作块去噪,并可按噪声水平构造腐蚀样本 $x_\sigma=(1-\sigma)x+\sigma\epsilon$。
本文的两个关键组件——观测 FM 损失与加噪观测 FM 损失——都是把 FM 目标移接到观测令牌上,不熟悉 FM 就无法理解这两个监督信号的含义与作用位置。
寄存器令牌(register tokens)
源自 Darcet 等人的 ViT registers:在图像 patch 令牌之外拼接若干可学习、不对应任何图像区域的“额外槽位”,与空间令牌共同参与自注意力,为模型提供不绑定空间位置的计算与存储容量,用于吸收全局信息或伪影。
RegisterWAM 的核心正是把寄存器从“吸收伪影的辅助令牌”升级为直接条件化动作模型的世界—动作接口,这也是论文标题的由来。
高范数离群点与 attention sink
Transformer 中少数令牌的隐状态范数远超其余令牌的现象。attention sink 指注意力质量过度集中于个别令牌(常见于序列首个令牌);本文讨论的离群点与之不同——关注的是隐状态幅度及其功能角色,且其动作相关性在幅度被归一化抹平后依然存在。
论文的第一个贡献就是论证这些离群点不是数值伪影而是功能信号;分清它与 attention sink 的区别,才能理解作者论证的精确边界。
DiT 与 K/V 缓存条件机制
Diffusion Transformer(DiT)用 Transformer 骨干执行扩散去噪。在 FastWAM 中,Video DiT 各层输出经 LayerNorm 与线性投影生成键/值(K/V)并缓存,供 Action DiT 的注意力在整个动作去噪过程中反复读取,这是两个 DiT 之间唯一的信息通道。
作者正是沿着“隐状态→归一化→K/V 投影→动作注意力”逐级追踪离群点,并在这个接口上做屏蔽干预来定义动作敏感性 $I_j$。
LIBERO-Plus 基准
在 LIBERO 基础上系统施加 7 类分布偏移(相机、机器人本体、语言、光照、背景、噪声、布局)的机器人操作评测集,共 10,030 条测试轨迹;本文所有对比模型只在原始 LIBERO 数据上训练,以检验对分布偏移的鲁棒性。
主结果表(Table 1)的所有数字都在该基准上产生,分类别成功率是判断方法强弱边界(尤其是相机偏移短板)的关键证据。
研究动机
World Action Model(WAM)把视频生成模型改造成机器人策略:Video DiT 编码当前场景并预测其演化,产生的空间表征通过 K/V 缓存去条件化 Action DiT 生成动作。这条路线能让策略继承大规模视频预训练和物理动力学的预测表征,但“视频表征在 WAM 内部如何组织动作相关信息”几乎是个黑箱。作者在 FastWAM(基于 Wan2.2)中系统检查各层空间令牌的隐状态范数,发现中后层会稳定出现少数高范数离群点:以最大范数与中位数之比 $S_{\text{out}}=\max_j\|h_j^l\|_2/\mathrm{median}_j\|h_j^l\|_2$ 衡量,离群点的范数约为其余令牌的一个数量级(约 10 倍),且高范数位置在不同观测间反复出现;而在未做动作适配的预训练 Wan2.2 与 Cosmos3-Nano 中,类似离群点更弱、更不一致。核心疑问随之而来:这些离群点只是数值伪影,还是真实参与了动作生成?答案直接决定 WAM 的表征设计该往哪里走。
本文的目标是本文目标分两层。诊断层:搞清高范数空间离群点的功能地位——追踪它们穿过连接 Video DiT 与 Action DiT 的视觉 K/V 缓存,用令牌级干预(在动作注意力中屏蔽某个视觉位置)测量其对预测动作的改变量(作者定义为动作敏感性 action sensitivity),回答“极端范数是否、以及如何影响动作生成”。设计层:既然分析表明空间令牌承担了超出局部空间编码的角色,就为世界模型显式提供“无空间身份”的表征容量——在 Video DiT 中加入少量可学习的非空间寄存器(registers),让它们直接充当动作条件接口;再用观测流匹配(FM)损失把高范数响应从空间令牌迁移到寄存器;并引入加噪观测 FM 损失,把当前场景建模变成一个从损坏输入恢复的去噪辅助任务。最终目标是在不加具身预训练数据、不引入额外基础模型或几何/语义教师的前提下,在 LIBERO-Plus 与 RoboTwin 2.0 上全面超过 FastWAM/Faster-WAM 系列。
与已有工作不同的是,切入角度的独特性在于把“可解释性发现”与“架构改造”闭环。已有寄存器工作(Darcet 等人的 ViT registers、像素空间 DiT 的寄存器研究)把寄存器当作吸收伪影的工具;attention sink 文献关注注意力质量分布;而本文聚焦 WAM 特有的问题——离群点的动作相关性在范数异常被 K/V 投影抹平后依然存在。技术上,作者用带掩码的因果干预 $I_j=(A(K,V;M)-A(K,V;M^{(-j)}))/2$ 度量每个视觉令牌对动作的贡献(含注意力归一化项),发现离群点在 98 个空间令牌中稳定排在约第 15 名,而非任意背景令牌,由此提出“令牌功能与空间位置部分解耦”的假设,再用“寄存器 + 观测 FM 监督”这组受控实验验证。另一条意外发现——不加寄存器、仅加观测 FM 监督也能把 LIBERO-Plus 子集成功率从 53.64% 提到 58.07%——进一步催生了把观测升级为辅助建模目标的加噪观测去噪损失,这是以往 WAM 设计中不存在的监督形式。
核心方法
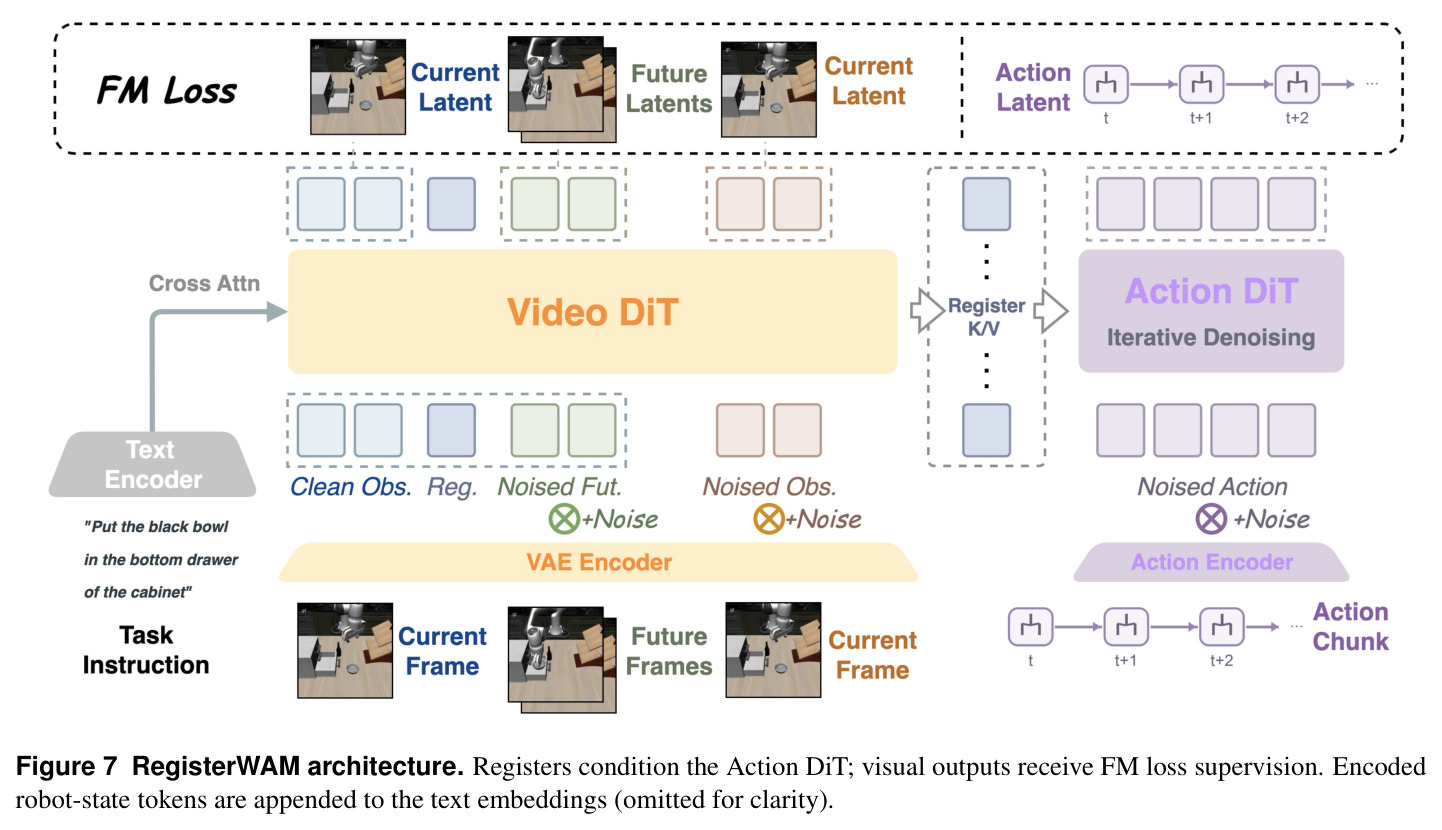
方法遵循“诊断—设计”两步逻辑。诊断确认:FastWAM 中后层的空间离群点范数约为中位数的 10 倍,但经 LayerNorm 与 K/V 投影后,键/值的范数已回到普通令牌区间,即极端幅度并不直接传给动作模型;而屏蔽干预显示其动作相关性仍在(排名约 15/98)。设计上,RegisterWAM 把当前观测编码为 VAE 潜变量得到 98 个空间令牌,再拼接 $M=8$ 个可学习寄存器构成输入 $Z=[H;R]$,与未来令牌(训练和推理时均为纯高斯噪声)一起送入 Video DiT;对稠密干净观测令牌的输出施加零噪声($\sigma=0$)观测 FM 损失,把高范数响应压入寄存器;动作侧只用寄存器状态构建逐层 K/V 缓存去条件化 Action DiT。总损失为 $\mathcal{L}=\lambda_a\mathcal{L}_{action}+\lambda_v\mathcal{L}_{obs}+\mathcal{L}_{future}+\lambda_n\mathcal{L}_{noised\text{-}obs}$,其中加噪观测分支按 $x_\sigma=(1-\sigma)x+\sigma\epsilon$($\sigma=0.5$)构造。推理时 Video DiT 只前向一次构建寄存器 K/V 缓存,供 Action DiT 的 10 步去噪全程复用,无需迭代视频生成。
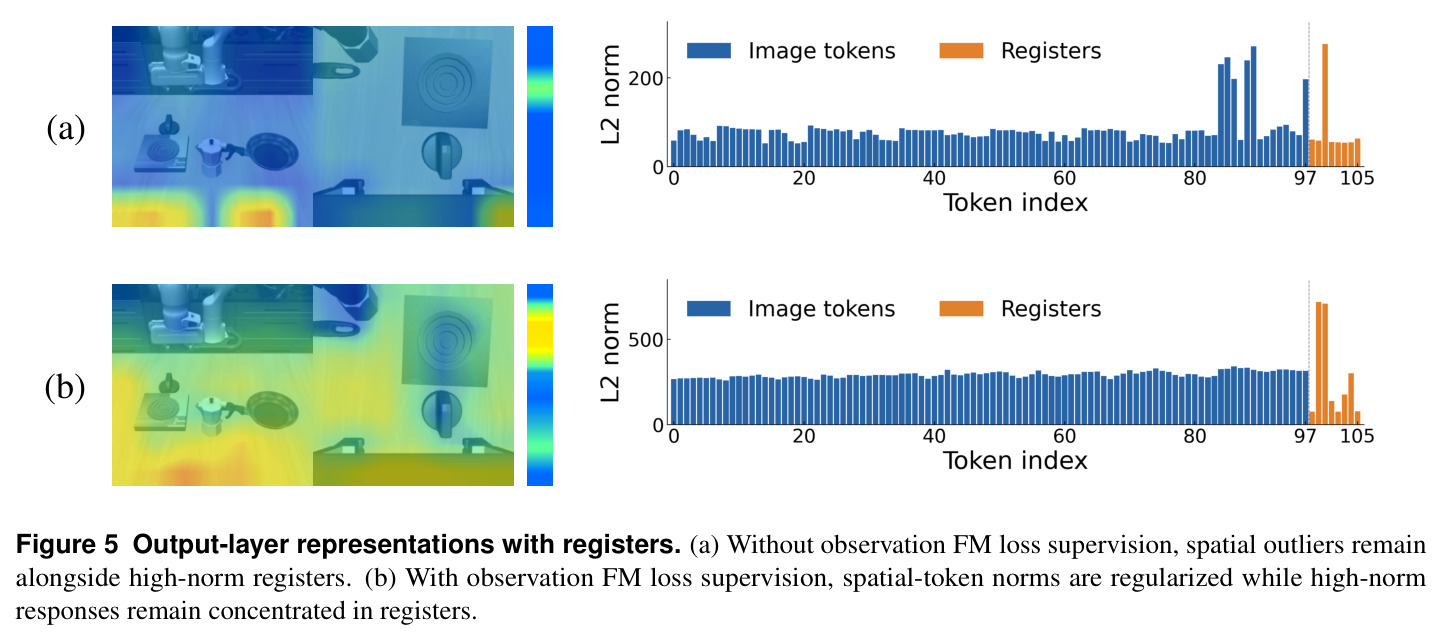
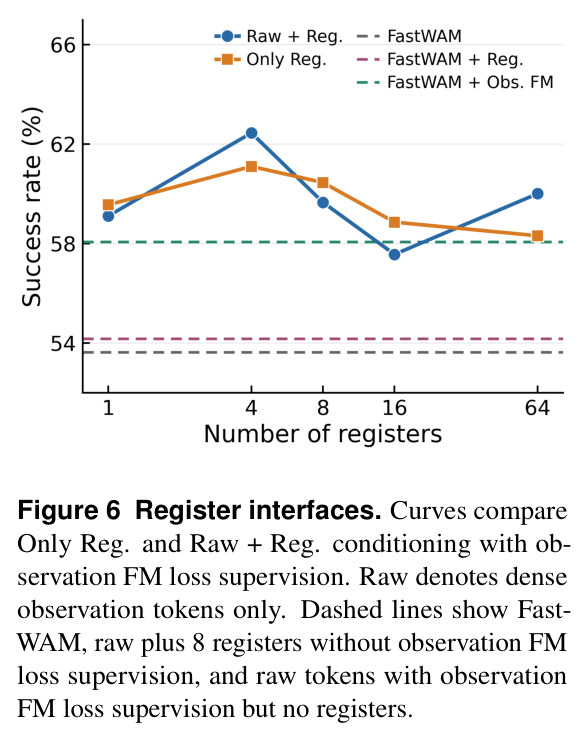
核心洞察有两条。第一,寄存器单独加并不够:仅加 8 个寄存器虽压低了中间层峰值,但输出层空间离群点仍在(Appendix A),朴素的“原始令牌+寄存器”条件化只有 54.18%,对比 FastWAM 的 53.64% 几乎无增益——说明单纯提供非空间槽位并不能约束空间令牌如何被使用。真正关键的是配对设计:对稠密干净观测令牌施加观测 FM 监督,迫使空间令牌保持“可预测视觉观测”的本职,把无需空间定位的信息留给寄存器;两者结合后空间离群点消失、高范数响应集中于寄存器,寄存器状态本身成为有效动作条件(如 4 寄存器 register-only 达 61.11%,高于同监督下原始令牌 58.07% 的参考线)。第二,观测 FM 监督的价值溢出到离群点重组之外——即使不加寄存器也带来约 4.4 个百分点的提升,作者顺势把当前观测从条件输入升级为辅助建模目标,提出加噪观测 FM 损失:要求模型从 $x_\sigma=(1-\sigma)x+\sigma\epsilon$ 的损坏输入中预测恢复方向,为世界模型提供额外语义梯度而非给动作模型增加新的条件流。这与以往把观测仅当作条件输入的 WAM 设计有本质区别。
方法步骤详情
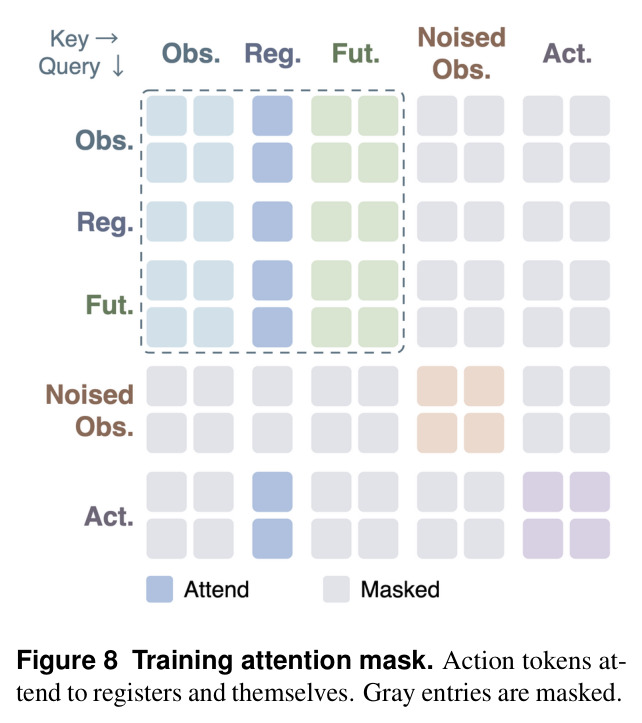
第一步,输入构造:当前观测经 VAE 编码为 7×14 网格的 98 个空间令牌 $H$,拼接 $M=8$ 个可学习寄存器得到 $Z=[H;R]$;未来帧输入在训练与推理时均为纯高斯噪声,编码后的未来帧只作未来 FM 损失的目标。第二步,Video DiT 前向:空间令牌、寄存器、未来令牌共同参与自注意力;语言指令编码为文本嵌入并追加机器人状态令牌,经交叉注意力注入。第三步,三路视觉监督(均排除寄存器令牌):对干净观测令牌输出加零噪声观测 FM 损失 $\mathcal{L}_{obs}$;对未来令牌加最大噪声 FM 损失 $\mathcal{L}_{future}$;对按 $x_\sigma=(1-\sigma)x+\sigma\epsilon$($\sigma=0.5$)加噪的观测副本加 $\mathcal{L}_{noised\text{-}obs}$,注意力掩码把该分支隔离,梯度只回传给 Video DiT。第四步,动作条件构建:取各层寄存器状态 $R^\ell$ 做 K/V 投影形成寄存器 K/V 缓存。第五步,联合训练:Action DiT 在寄存器条件下做动作块去噪,$\mathcal{L}=\lambda_a\mathcal{L}_{action}+\lambda_v\mathcal{L}_{obs}+\mathcal{L}_{future}+\lambda_n\mathcal{L}_{noised\text{-}obs}$,$\lambda_a=0.2$。第六步,推理:Video DiT 单次前向构建缓存,Action DiT 以 10 步去噪全程复用。
技术新颖性
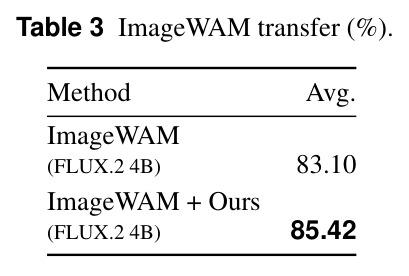
新颖性体现在四个层面。其一,诊断方法新:以往对离群点/attention sink 的分析多停留在统计观察,本文设计了包含注意力归一化贡献的因果干预(屏蔽 K/V 位置后测量动作变化),并首次在 WAM 中证明“幅度异常”与“功能相关性”可以解耦——范数差在接口处消失,动作相关性却保留(排名约 15/98)。其二,架构结论反直觉:寄存器必须与观测 FM 监督配对才能完成离群点的空间迁移(Figure 5),单一组件都无效或收效甚微(54.18% 对 53.64%),这修正了“加寄存器即可吸收伪影”的流行做法。其三,把观测从条件输入升级为辅助建模目标:加噪观测 FM 损失以去噪恢复的形式为世界模型提供额外监督,而非给动作模型增加新的条件流。其四,通用性验证:同一设计迁移到基于 FLUX.2 图像编辑骨干的 ImageWAM,LIBERO-Plus 平均成功率从 83.10% 提到 85.42%,说明结论不绑定 Wan2.2 视频骨干;且全程不用具身预训练与额外教师模型,在公平资源设定下刷新了 LIBERO-Plus 的纯训练上限。
实验结果
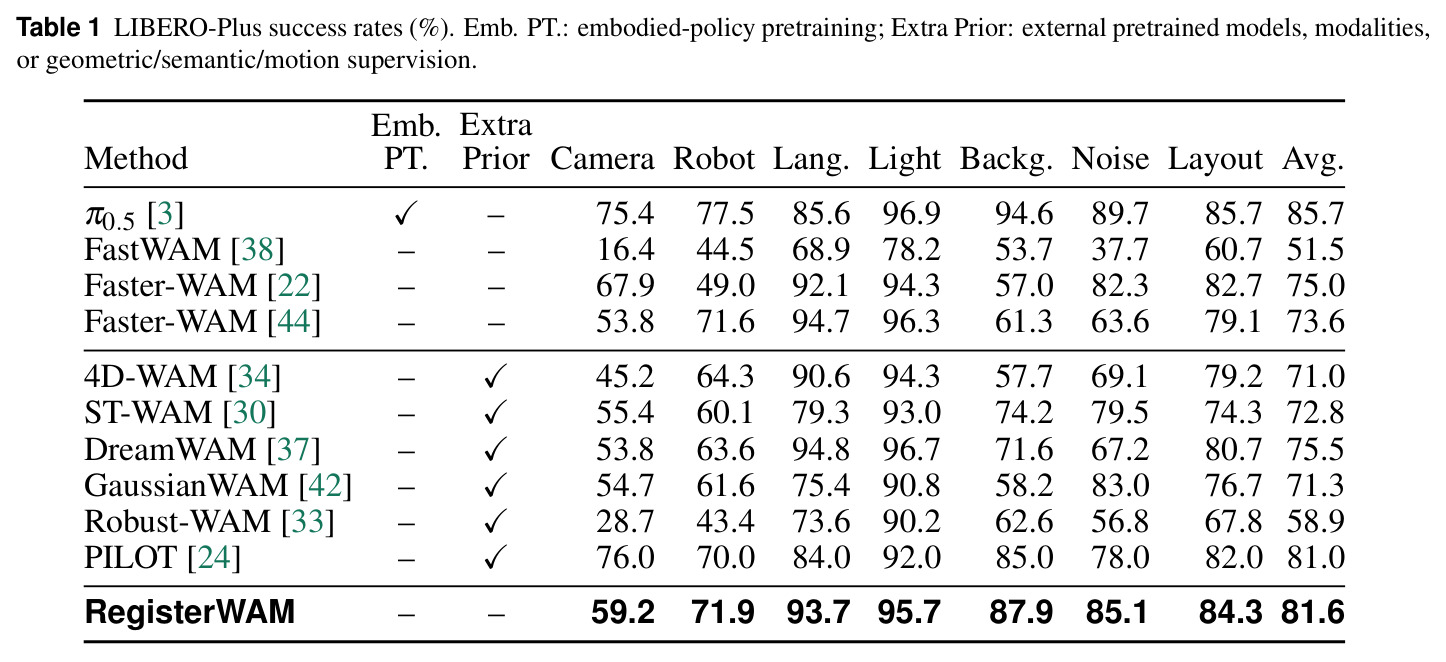
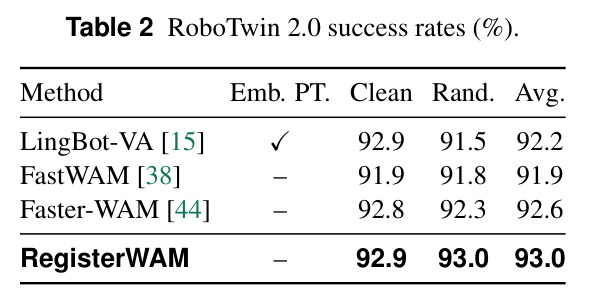
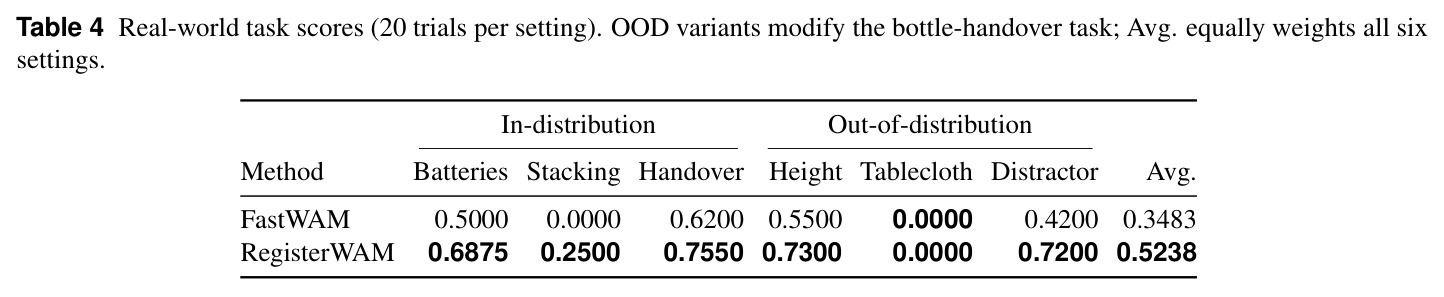
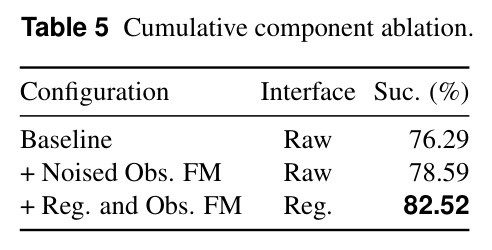
LIBERO-Plus 全测试集(10,030 条轨迹、7 类偏移):平均成功率 81.64%,超同骨干 FastWAM(51.5%)与 Faster-WAM(75.0%/73.6%),也超带额外先验的 4D-WAM(71.0%)、ST-WAM(72.8%)、DreamWAM(75.5%)、GaussianWAM(71.3%)、Robust-WAM(58.9%),与 PILOT(81.0%)持平;语言 93.7%、光照 95.7%、背景 87.9% 最强,相机偏移 59.2% 最弱。RoboTwin 2.0:clean 92.9%、随机化 93.0%,平均 93.0%,超 FastWAM 91.9% 与 Faster-WAM 92.6%。真实世界 6 个设置(各 20 次试验):平均得分 0.3483→0.5238——电池 0.50→0.6875、堆叠 0→0.25、传递 0.62→0.755、桌高 0.55→0.73、干扰盘 0.42→0.72,桌布场景两法均为 0。消融(20% 子集,完整模型 82.52%):Raw 基线 76.29% → +加噪观测 FM 78.59% → +寄存器与观测 FM 82.52%;寄存器数 4/8/16 为 78.49%/82.52%/81.03%;σ=0.25/0.5/0.75 为 76.14%/82.52%/80.98%。接口研究:register-only 在 1/4/8/16/64 寄存器为 59.56%/61.11%/60.46%/58.86%/58.32%,Raw+Reg 为 59.11%/62.45%/59.66%/57.57%/60.01%;不加寄存器仅观测 FM 即从 53.64% 升到 58.07%。跨骨干迁移:ImageWAM(FLUX.2 4B)83.10%→85.42%(+2.32 个百分点)。
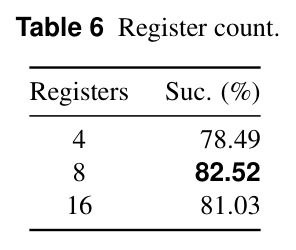
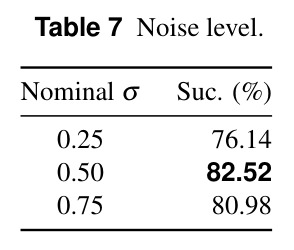
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LIBERO-Plus 全测试集(10,030 条轨迹,7 类分布偏移) | 平均成功率 | 81.64%(语言 93.7 / 光照 95.7 / 背景 87.9 / 噪声 85.1 / 布局 84.3 / 机器人 71.9 / 相机 59.2) | FastWAM 51.5%;Faster-WAM 75.0 与 73.6;带额外先验的 PILOT 81.0 | 较 FastWAM +30.14 个百分点,较最强 Faster-WAM +6.6 个百分点,与 PILOT 持平且不用额外先验 |
| RoboTwin 2.0(clean / 随机化) | 平均成功率 | 93.0%(clean 92.9%,随机化 93.0%) | FastWAM 91.9%;Faster-WAM 92.6%;带具身预训练的 LingBot-VA 92.2 | 较 FastWAM +1.1 个百分点,较 Faster-WAM +0.4 个百分点 |
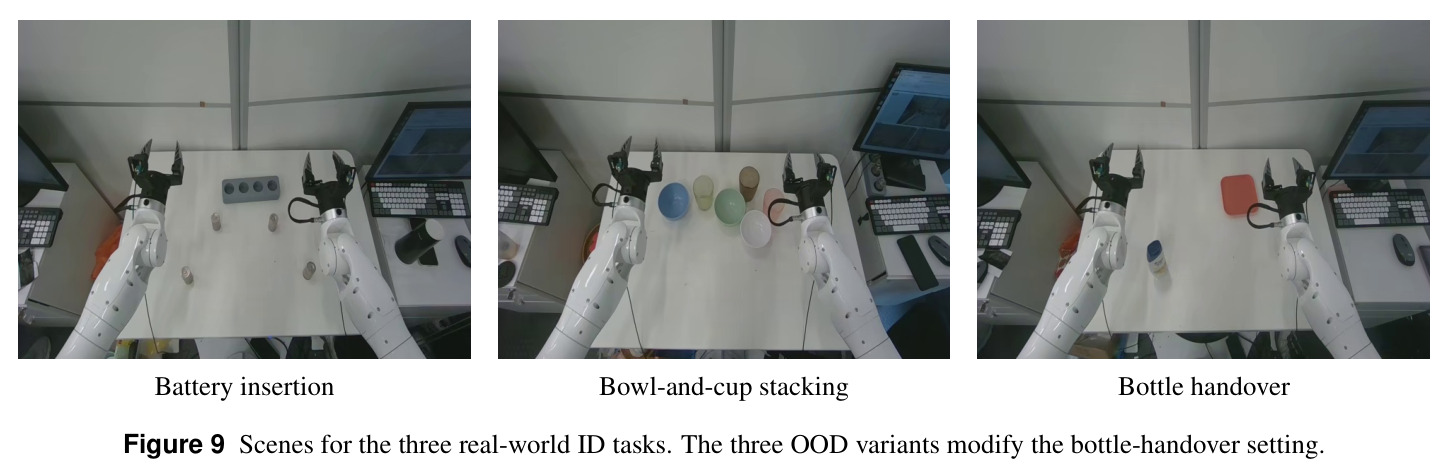
| 真实世界双臂平台 6 个任务设置(3 ID + 3 OOD,各 20 次试验) | 分步任务得分(等权平均) | 0.5238(电池 0.6875 / 堆叠 0.2500 / 传递 0.7550 / 桌高 0.7300 / 桌布 0.0000 / 干扰盘 0.7200) | FastWAM 0.3483(电池 0.5000 / 堆叠 0.0000 / 传递 0.6200 / 桌高 0.5500 / 桌布 0.0000 / 干扰盘 0.4200) | +0.1755,6 个设置中 5 个提升,仅桌布场景持平于 0 |
| ImageWAM 迁移(FLUX.2 4B 图像编辑骨干,LIBERO-Plus) | 平均成功率 | 85.42% | 原始 ImageWAM 83.10% | +2.32 个百分点,证明设计可跨生成骨干迁移 |
| LIBERO-Plus 20% 消融子集(累积组件消融) | 成功率 | 82.52%(寄存器 + 观测 FM,register 接口) | 未来条件 Raw 基线 76.29%;+加噪观测 FM 后 78.59% | 较基线 +6.23 个百分点;仅加噪观测 FM 一项即 +2.30 个百分点 |
局限与改进
作者承认并可观察到的局限:第一,分布偏移下的鲁棒性不均衡——LIBERO-Plus 相机偏移只有 59.2%,是最弱类别,明显低于语言/光照的 93.7%/95.7%;真实世界桌布(外观剧变)场景中 FastWAM 与 RegisterWAM 均为 0 分,堆叠任务也只有 0.25,说明方法并未解决外观层面的泛化。第二,与使用具身预训练的 π0.5(85.7%)相比仍有约 4 个百分点差距,纯数据训练路线的上限尚不清楚。第三,机理解释偏保守:作者明确不声称任何单个寄存器有固定语义,高范数响应为何会被 FM 监督压入寄存器、离群点最初为何形成,都缺少理论刻画。第四,超参敏感:寄存器数从 8 增到 16 性能下降(82.52%→81.03%),σ 从 0.5 降到 0.25 大幅掉点(76.14%),且调度器的时间步相关损失加权使 σ 同时改变腐蚀强度与有效损失权重,存在混杂变量。第五,主要实验绑定 Wan2.2 骨干与 LIBERO/RoboTwin 数据分布,消融仅在 20% 测试子集上进行。
独立分析的弱点
独立分析几点弱点。其一,视角鲁棒性:相机偏移 59.2% 是明显短板,而寄存器本身不携带几何信息,改进方向是引入多视角数据增强、深度/几何一致性监督,或在寄存器之外保留少量原始令牌做互补(Raw+Reg 在 4/64 寄存器时已显示互补增益,62.45%/60.01%)。其二,外观漂移:桌布场景 0 分暴露纹理级泛化缺失,可引入外观域随机化预训练或在线适应机制。其三,可解释性停在现象层:论文只证明高范数响应迁入寄存器,未回答寄存器内部如何编码动作信息,可用线性探测、注意力归因或逐寄存器消融进一步解剖。其四,σ 与损失权重混杂(调度器时间步加权),应解耦腐蚀水平与损失系数后重新扫描,找到真正的最优腐蚀强度。其五,接口是静态的:推理时寄存器 K/V 缓存固定,无法随任务阶段调整,可探索按去噪步动态加权或稀疏寄存器选择。其六,register-only 接口把动作去噪要处理的视觉上下文从 98 个令牌压缩到 8 个,理应带来推理加速,但论文只定性提及,缺少与 Raw 接口的延迟/显存对比数据。
未来方向
可延伸方向包括:理论上,为“观测 FM 监督为何把高范数响应集中到寄存器”建立分析模型,并解释 FastWAM 离群点形成的训练动力学(例如动作损失与视觉表征学习的相互作用),这也能回答寄存器究竟是机制还是只是“现象搬家”。工程上,把寄存器接口与具身预训练(如 π0.5 的数据规模)结合,检验两种增益是否可叠加,冲击 LIBERO-Plus 85% 以上;将设计移植到 4D-WAM、ST-WAM 等带几何/语义额外监督的变体,观察与外部先验的兼容性。方法上,寄存器语义解剖(每个寄存器是否隐式分工)、寄存器数量随任务复杂度自适应、以及把加噪观测 FM 推广为多步潜在滚动预测(预测未来多帧的恢复方向),都值得尝试。应用上,8 令牌的固定接口天然适合高频控制与边缘部署,可做系统级的延迟—成功率 Pareto 分析;加噪观测去噪目标作为通用正则项,也可能迁移到视频预测类世界模型中改善表征质量。
复现评估
复现条件中等偏上。开源情况:代码在 GitHub 公开(Z1zyw/RegisterWAM),世界模型基于开源 Wan2.2,动作侧沿用 FastWAM 的 Action DiT 设计;论文给出关键超参(8 个寄存器、σ=0.5、λa=0.2、10 步去噪、7×14 潜变量网格、寄存器与原始令牌互斥的 FM 监督范围)。数据:训练只用 LIBERO 数据(公开),评测用 LIBERO-Plus(10,030 条,仅测试)与 RoboTwin 2.0(公开基准),这两部分在单机多卡上可以尝试复现。难点:Video DiT(Wan2.2 级别生成模型)与 Action DiT 的联合训练算力需求大,论文未披露 GPU 数量与训练时长,需要自行估计;真实世界部分依赖天玑双臂平台和 300/60/300 条演示数据,普通实验室难以复制,但论文报告了逐设置 20 次试验的逐步得分,可用仿真基准对齐验证。整体而言,仿真结论的可复现性较好(超参完整、代码开放),真实机器人结论属于“信任型”证据。
论文图表
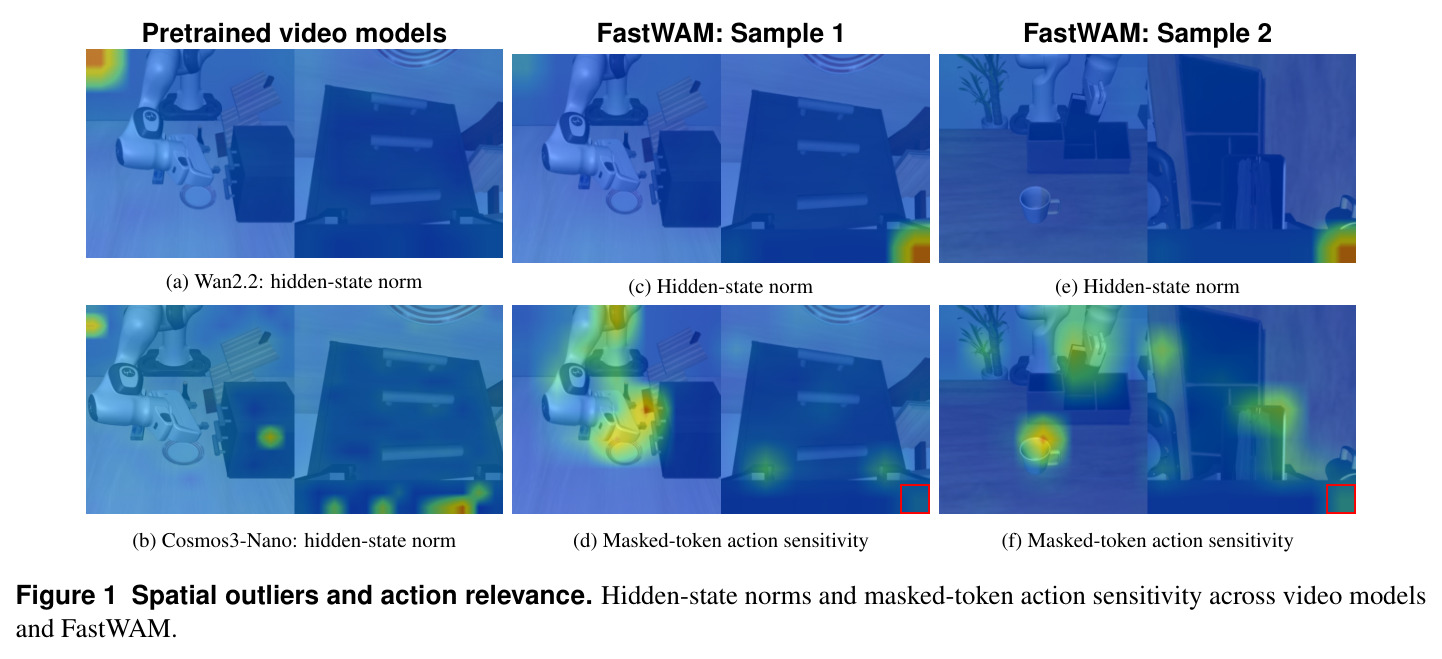
对比预训练视频模型(Wan2.2、Cosmos3-Nano)与 FastWAM 在不同样本下的隐状态范数热图与掩码令牌动作敏感性图:FastWAM 中后层出现显著且跨样本稳定的高范数离群点,且这些离群点保持非平凡的动作敏感性。
一图定调:同时呈现“离群点存在”与“离群点与动作相关”两大核心证据,是全文动机的视觉起点。
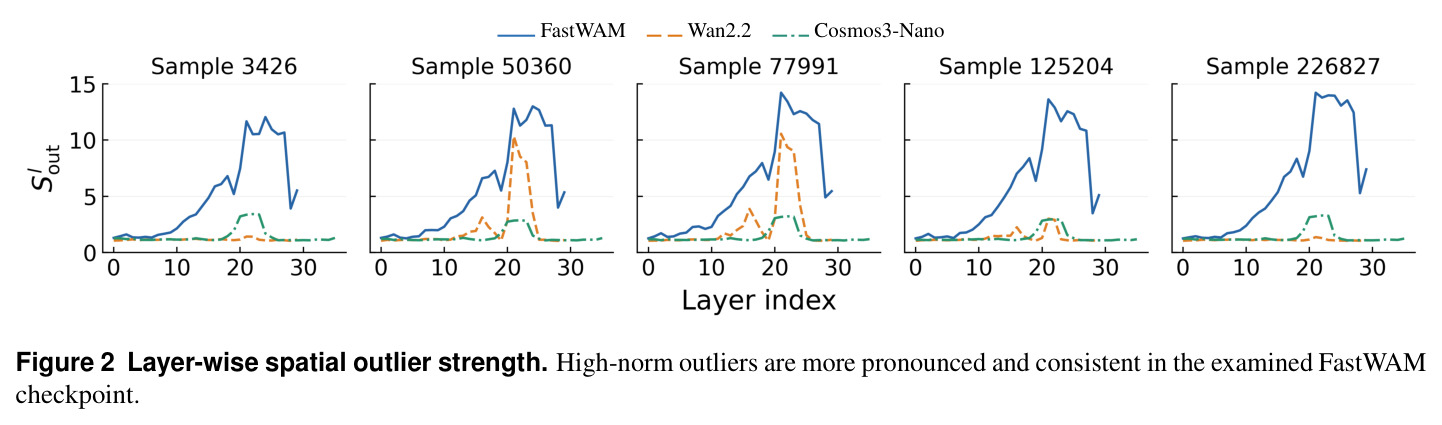
逐层绘制最大/中位范数比 $S_{\text{out}}$,比较 FastWAM、Wan2.2 与 Cosmos3-Nano:FastWAM 中后层比值急剧上升且跨观测一致,预训练模型中则更弱、更不稳定。
量化“离群点是 WAM 动作适配的产物而非预训练固有现象”这一关键对照,支撑第 2.1 节的论断。
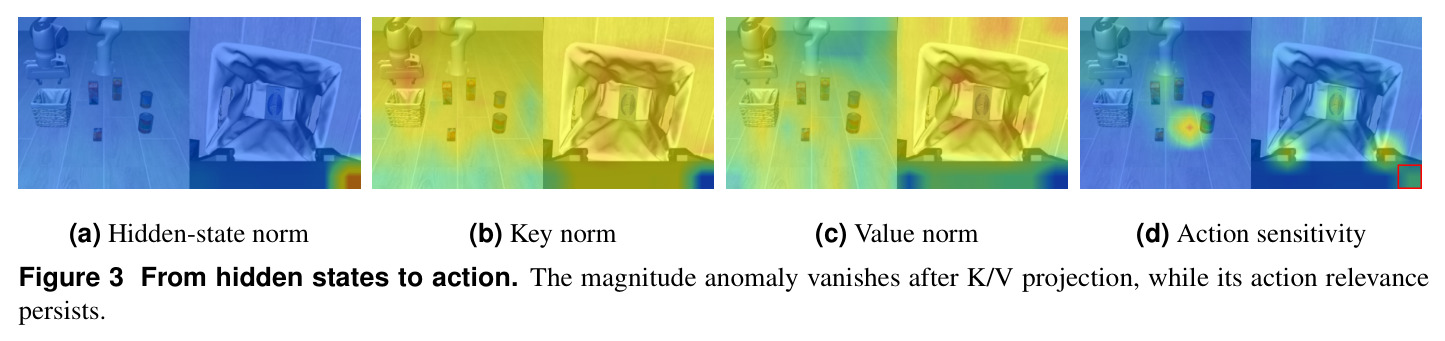
同一观测下并排展示隐状态范数、键范数、值范数与动作敏感性四张热图:幅度异常在 K/V 投影后消失,而动作相关性保留。
直接证明“幅度”与“功能”解耦,是排除“离群点靠大范数影响动作”这一最简单解释的核心证据。
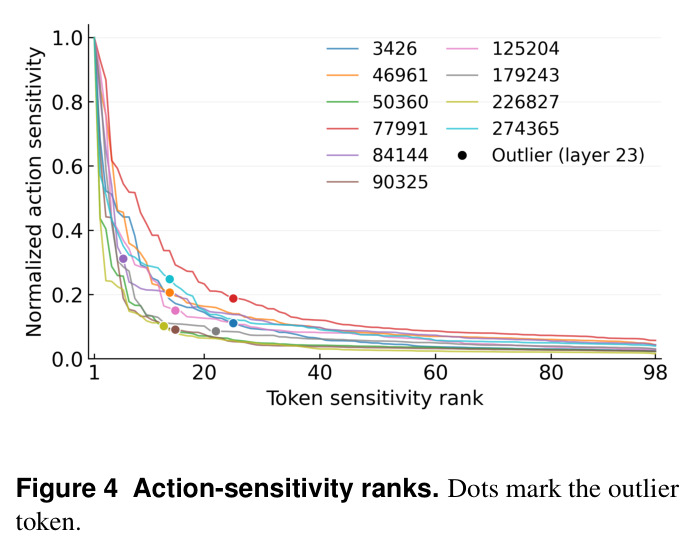
统计离群令牌在 98 个空间令牌中的动作敏感性排名分布:稳定集中在约第 15 名附近,而非背景令牌式的随机排名。
给出“持续但非主导”的动作相关性的定量刻画,支撑论文对离群点的保守解释。