OSWAM:单步动作生成的高效世界动作模型 OSWAM: An Effective World Action Model with One-Step Action Generation
用想象令牌替代随机噪声初始化,把世界动作模型的动作生成压缩到一步扩散
前置知识
流匹配(Flow Matching)
一类扩散生成范式:训练网络预测把噪声插值样本 $a_t=(1-t)a+t\epsilon$ 变回数据所需的速度场 $v_\theta\approx\epsilon-a$,推理时从 $t=1$(纯噪声)沿欧拉法积分到 $t=0$(数据)。步数越少,单次欧拉更新要覆盖的距离越大、误差越难控制,这正是动作生成难以压到一步的根本困难。
OSWAM 的动作 DiT 就是一个流匹配模型,本文全部讨论——多步依赖、单步更新式 $\hat{a}=a_t-tv_\theta(a_t,t)$、再加噪时刻 $\sigma_r$ 的选择——都建立在这个框架之上。
世界动作模型(WAM)
把预训练视频生成模型与动作预测结合的物理智能框架,模型在共享骨干里同时建模未来视觉状态与动作。按推理方式分三类:imagine-then-execute(先生成未来视频再反推动作)、joint(视频动作联合生成)、direct-policy(视频预测只作训练目标、推理时直接从当前观测出动作)。direct-policy 免除测试时视频 rollout,比前两类快约 3 倍以上。
OSWAM 是 direct-policy WAM 的延伸,理解它与 Fast-WAM、SimWAM、LingBot-VA 等方法的谱系关系,以及为什么保持「首帧观测接口」是设计约束,必须先懂这个分类。
DiT 与 MoT 架构
Diffusion Transformer(DiT)用 Transformer 替代 U-Net 作为扩散模型主干,Wan2.2-5B 等视频生成模型采用它。Mixture-of-Transformer(MoT)指视频块与动作块组成混合结构但共享注意力,使视频 token 与动作 token 在同一注意力空间交互;动作 DiT 由视频 DiT 权重插值降采样初始化。
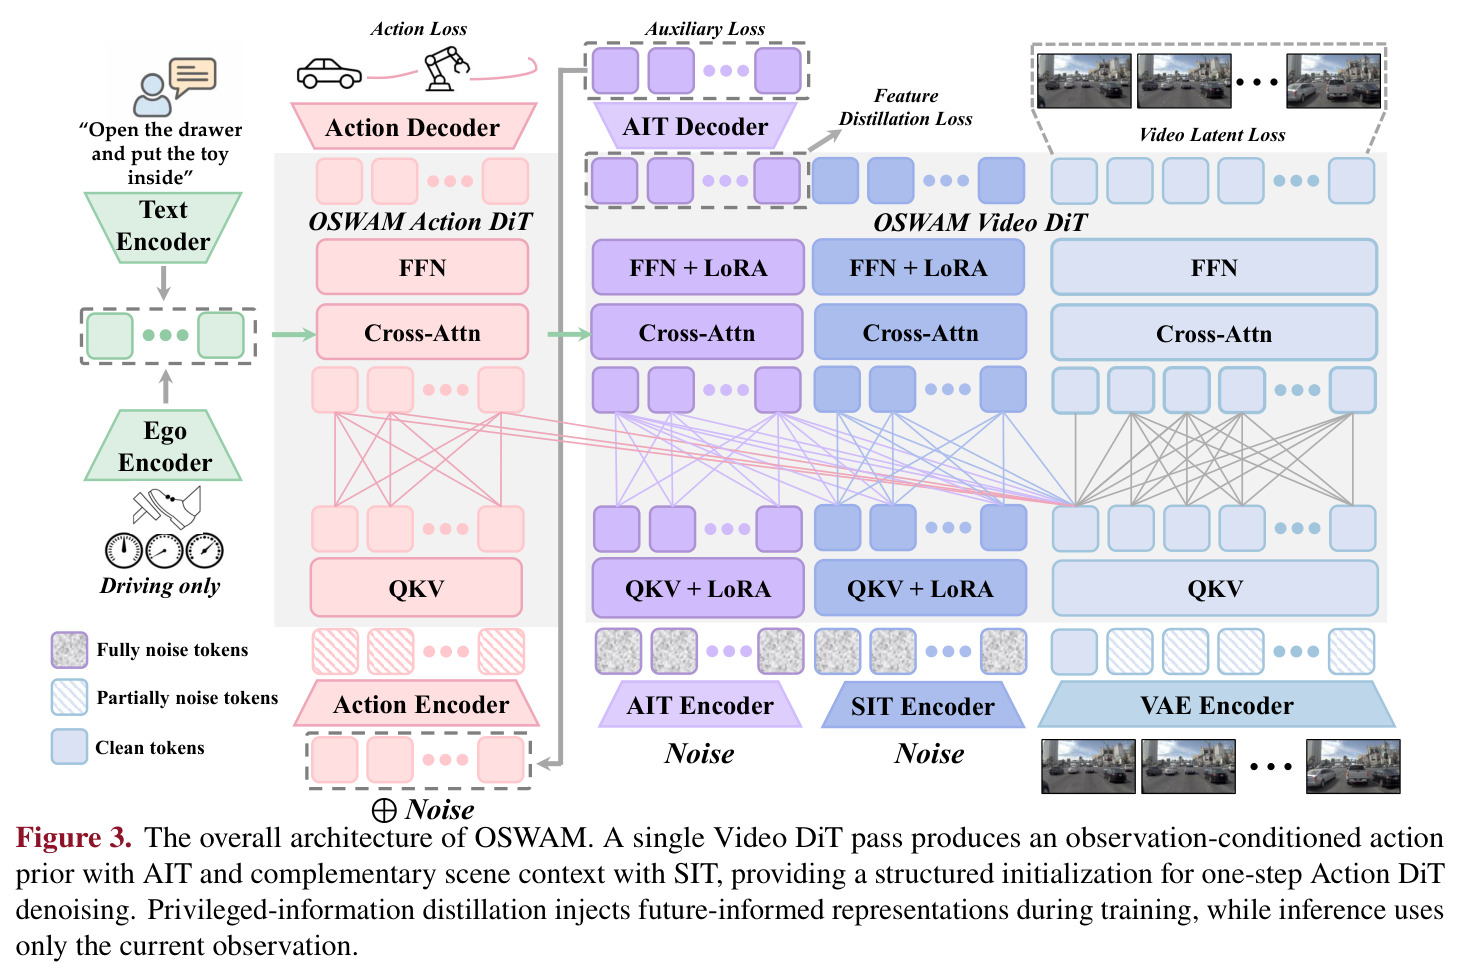
本文的想象令牌(AIT/SIT)是插入视频 DiT 的额外 latent token,动作 DiT 通过 LoRA 与共享注意力接收它们,不懂这个骨干结构就无法理解 Figure 3 的数据流。
特权信息蒸馏
训练时让教师模型访问部署时拿不到的「特权」信息(此处为完整未来视频帧 $f_1\ldots f_h$),学生只能用当前首帧;通过在若干中间层对齐师生特征 $\mathcal{L}_{dist}=\|h^{stu}_j-\mathrm{sg}(h^{tea}_j)\|_2^2$ 把特权知识迁移给学生。推理时教师被丢弃,不增加任何计算。
OSWAM 靠它把长时程未来上下文压进想象令牌,同时不破坏「推理只用首帧」的直接策略接口,是三大核心组件之一。
RoPE 与 Role-aware 3D RoPE
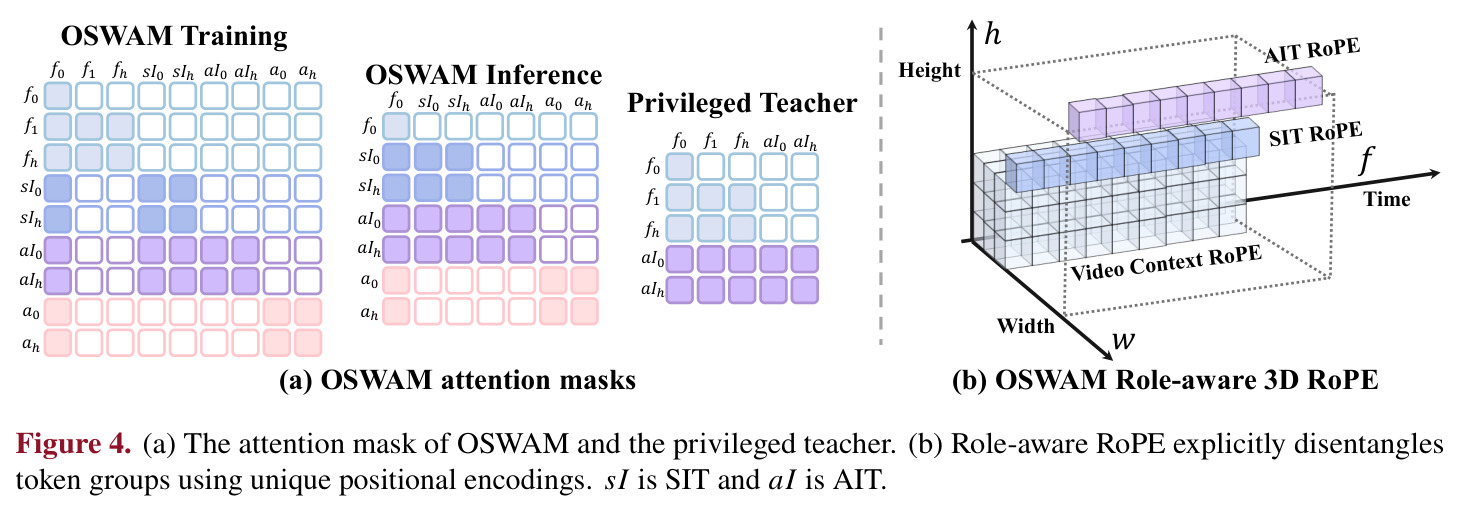
旋转位置编码用旋转矩阵把绝对位置转成相对注意力偏置。本文扩展到 3D(时间、高、宽)并按角色区分坐标:视频 token 用原始时空坐标 $(t,h,w)$,AIT 放到视频网格外 $(t_n,H_v,W_v)$,SIT 锚定网格中心 $((H_v-1)/2,(W_v-1)/2)$,动作时间坐标按 $t_n=ns_a/(s_v d_t)$ 折算到视频潜时间轴。
三组 token 共享一个注意力空间时,位置编码承担了区分角色、保持时间对齐的职责,看不懂它就无法理解 Figure 4 与注意力掩码设计。
NAVSIM 与 PDMS 指标
NAVSIM 是真实驾驶数据基准(2Hz 采样,8 相机 360 度环视 + LiDAR,1192 训练场景/136 测试场景),其预测驾驶员模型分数 $PDMS=NC\times DAC\times(5EP+5TTC+2C)/12$,由无责碰撞 NC、可行驶区域合规 DAC、自车进度 EP、时效性 TTC 与舒适度 C 加权而成,是比开环 L2 误差更接近闭环表现的规划指标。
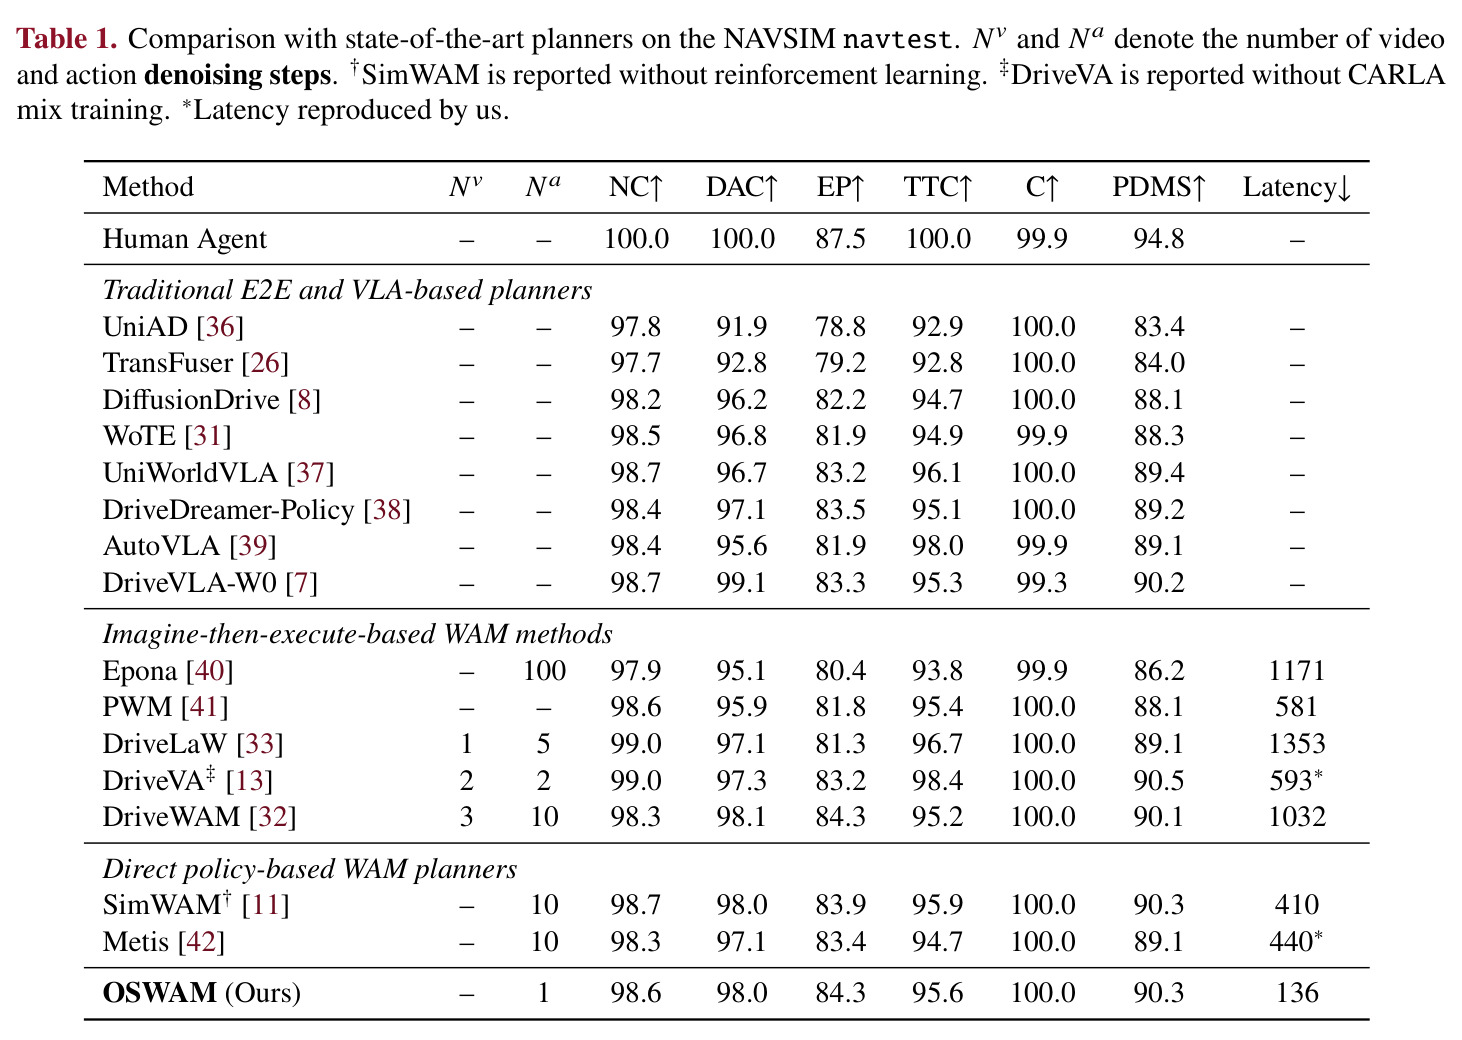
它是论文自动驾驶实验的主指标,Table 1、Figure 1、Figure 2 以及所有驾驶消融全部围绕 PDMS 展开。
研究动机
直接策略型世界动作模型(Fast-WAM、SimWAM 等)虽然去掉了测试时的视频生成,但动作输出仍依赖流匹配的迭代去噪,通常需要 10 步左右才能达到有竞争力的动作质量,在 H20 GPU 上延迟高达 397-410ms,难以满足自动驾驶等实时性要求。更关键的是,这种多步依赖无法靠简单削减步数绕过:论文 Figure 2 显示,把去噪步数降到 1 时,NAVSIM 上的 PDMS 从约 89 掉到 71.04(相对损失约 20%),RoboTwin 上的成功率从约 91.83% 跌到 57.38%/55.80%(损失约 40%)。作者把根因归结为:随机高斯噪声初始化里不含任何结构化动作先验,多步去噪可以逐步施加时间与物理一致性约束,而单步生成必须在一次更新里凭空恢复整段连贯动作序列。此外,直接策略 WAM 训练推理都只用首帧接口,把全部未来信息压缩进单个首帧表征,未来感知能力也受限。
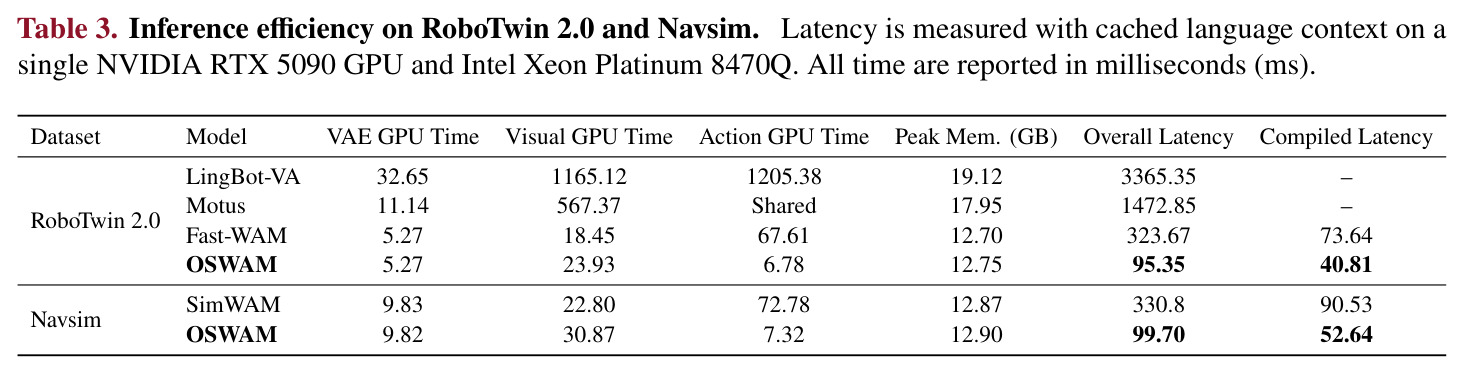
本文的目标是本文的目标是在保持直接策略型 WAM 推理接口(只用当前帧观测、不生成未来视频)的前提下,把动作生成压缩到单步扩散去噪,且不出现质量崩塌。量化目标包括:NAVSIM 的 PDMS 保持在与多步基线 SimWAM(90.3)相当的水平;RoboTwin 2.0 上 50 个双臂操作任务的平均成功率接近 Fast-WAM 的 91.83%;整体推理延迟从约 400ms 降到 100ms 量级,并用 torch.compile 与 CUDA Graph 在 RTX 5090 上压到 40-53ms,支持 10Hz 以上闭环控制;同时新增模块的开销要小到可以忽略——目标只是增加约 5ms 级别的视觉计算时间、峰值显存基本不变。
与已有工作不同的是,已有的少步加速思路(步数蒸馏如 Flash-WAM、轨迹矫正如 rectified flow)都仍然从高斯噪声出发,只是让去噪轨迹更「直」,并没有解决「起点缺少动作结构」这一根本问题;另一路 Light-WAM 干脆用轻量融合头替换生成式动作专家,却在 RoboTwin 上掉到 76.40%。OSWAM 的独特切入点是换掉初始化本身:从视频 DiT 中学习一小撮想象令牌(AIT/SIT),让它们先与当前帧视觉特征交互、形成带物理依据的观察条件化动作先验,再把这个先验加噪到中间时刻 $t<1$,使单步欧拉更新就足够落到高质量动作。同时用特权信息蒸馏把教师看到的完整未来上下文蒸馏进 AIT,推理时完全不引入未来相关特征。
核心方法
OSWAM 沿用 Fast-WAM 的骨干配置:以 Wan2.2-5B 视频 DiT 为基础,配预训练 T5 文本编码器和视频 VAE;动作 DiT 由视频 DiT 权重插值降采样初始化,隐层维度缩减到 1024;整体采用视频块与动作块共享注意力的 MoT 结构,视频预测只作训练信号、推理不 rollout。在此之上引入两组噪声初始化的想象令牌:动作想象令牌 AIT 与场景想象令牌 SIT,通过 LoRA(rank 8,$\alpha=4$)适配进视频 DiT。训练时 AIT 编码动作噪声并固定在 $t_{max}=1000$,在视频 DiT 内与首帧视觉 token 交互后,经辅助解码器得到动作速度 $\hat{v}_A$,构成结构化先验 $\bar{a}=\epsilon-\hat{v}_A$;随后对该先验做梯度截断并在 $\tau_r=500$($\sigma_r=0.5$)处重新加噪,交给动作 DiT 单步解码。配套设计还有特权信息蒸馏与 Role-aware 3D RoPE。
核心洞察是:一步生成失败不是因为去噪轨迹弯,而是因为起点是纯噪声、没有任何动作结构。OSWAM 不去「把弯路走直」(蒸馏/矫正流的做法),而是给扩散过程一个「知情」的起点——想象令牌。AIT 在视频 DiT 的一次前向中与首帧视觉特征交叉积累物理上下文,其输出直接充当动作 DiT 的中间时刻初始化,替代随机噪声;由于 AIT+SIT 的 token 数远小于首帧视觉输入,几乎不增加推理开销(视觉 GPU 时间仅从 18.45ms 增至 23.93ms)。第二层创新是特权信息蒸馏:教师模型的 AIT 能看到完整未来视频段,学生推理时只看首帧,通过在多个 Video DiT 块({8,16,24,30})对齐 AIT 特征,把长时程未来上下文蒸馏进学生,且推理时教师直接丢弃——这保留了直接策略型 WAM 的首帧接口,又获得了未来感知能力。SIT 则作为场景上下文的 latent 槽位,供 AIT 交叉注意。
方法步骤详情
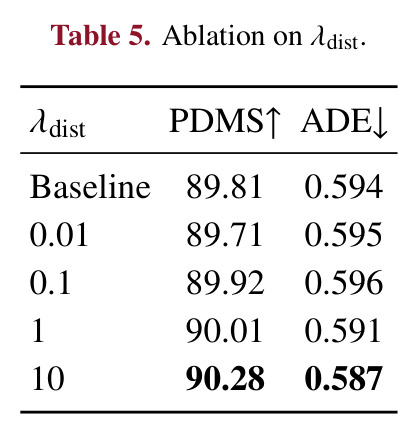
训练:(1) 视频 token 按标准扩散加随机噪声,AIT 由动作噪声编码并固定在 $t_{max}=1000$,SIT 独立噪声初始化;掩码规定 AIT 看首帧视觉、SIT 和其他 AIT,SIT 只看首帧和其他 SIT。(2) 辅助解码器把 AIT 特征映射为动作速度,用 $L_{AIT}=\mathbb{E}\|\hat{v}_A-(\epsilon-a_{gt})\|_2^2$ 监督,得先验 $\bar{a}=\epsilon-\hat{v}_A$。(3) 对先验梯度截断后按式 (5) $a_{init}^{\tau_r}=(1-\sigma_r)\mathrm{sg}(\bar{a})+\sigma_r\epsilon$ 重新加噪,$\sigma_r=0.5$。(4) 动作 DiT 单步解码 $\hat{a}=a_{init}^{\tau_r}-\sigma_r\hat{v}_{act}$,目标 $\sigma_r^{-1}(a_{init}^{\tau_r}-a_{gt})$ 保证一步欧拉更新落到真值。(5) 总损失 $L=L_{vid}+L_{AIT}+\lambda_{dist}L_{dist}+L_{act}$:教师在 $\tau_v^T=200$ 噪声化未来帧上提特征,在块 {8,16,24,30} 对齐学生 AIT,$\lambda_{dist}=10$。推理:单次视频 DiT 前向产出 AIT 先验,加噪后动作 DiT 一步解码,教师丢弃。NAVSIM 单前视相机、2Hz 预测 8 路点;RoboTwin 三视角拼图、动作块 32 步。
技术新颖性
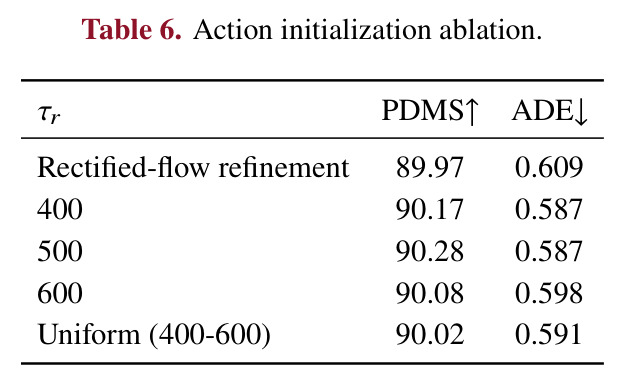
技术上,本文把「少步扩散」的研究焦点从轨迹形态转移到初始化分布上。与 Flash-WAM(把联合视频-动作扩散蒸馏成每模态单步,但推理仍要合成未来视频,单步版本 RoboTwin 只有 81.41%)相比,OSWAM 完全免除测试时视频 rollout;与 Light-WAM(轻量头一次前向出动作但成功率仅 76.40%)相比,它保留生成式动作专家的表达力,靠结构化初始化弥补单步损失;与 rectified-flow refinement(Table 6 中 PDMS 89.97)相比,对结构化先验加噪到固定中间时刻 $\tau_r=500$ 显著更优(90.28)。想象令牌本身也新颖:用极少量可学习 latent slot 承担「想象」职责,AIT 输出动作先验、SIT 聚合场景上下文供 AIT 交叉注意,两者靠辅助损失与蒸馏间接学习,梯度经由注意力连接传播。Role-aware 3D RoPE 在同一坐标系里用空间锚点区分三种角色 token,保时间对齐的同时给角色专属位置线索。
实验结果
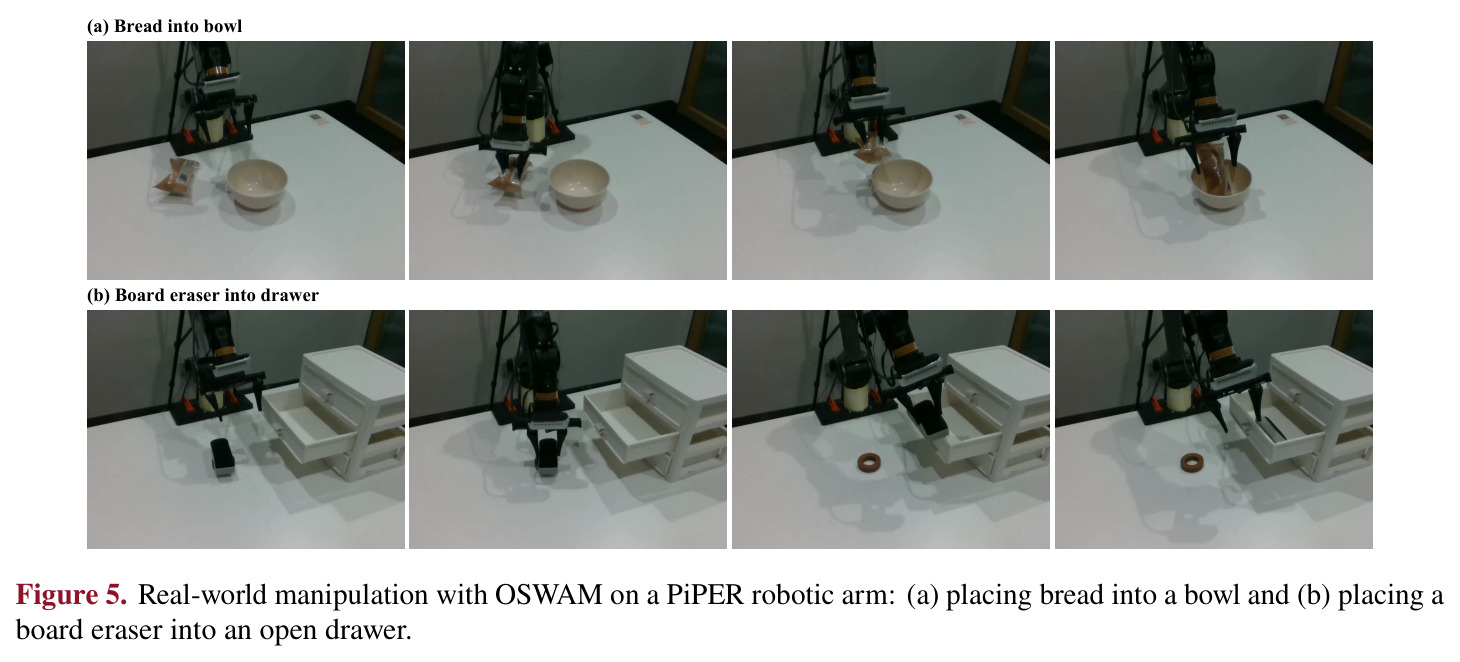
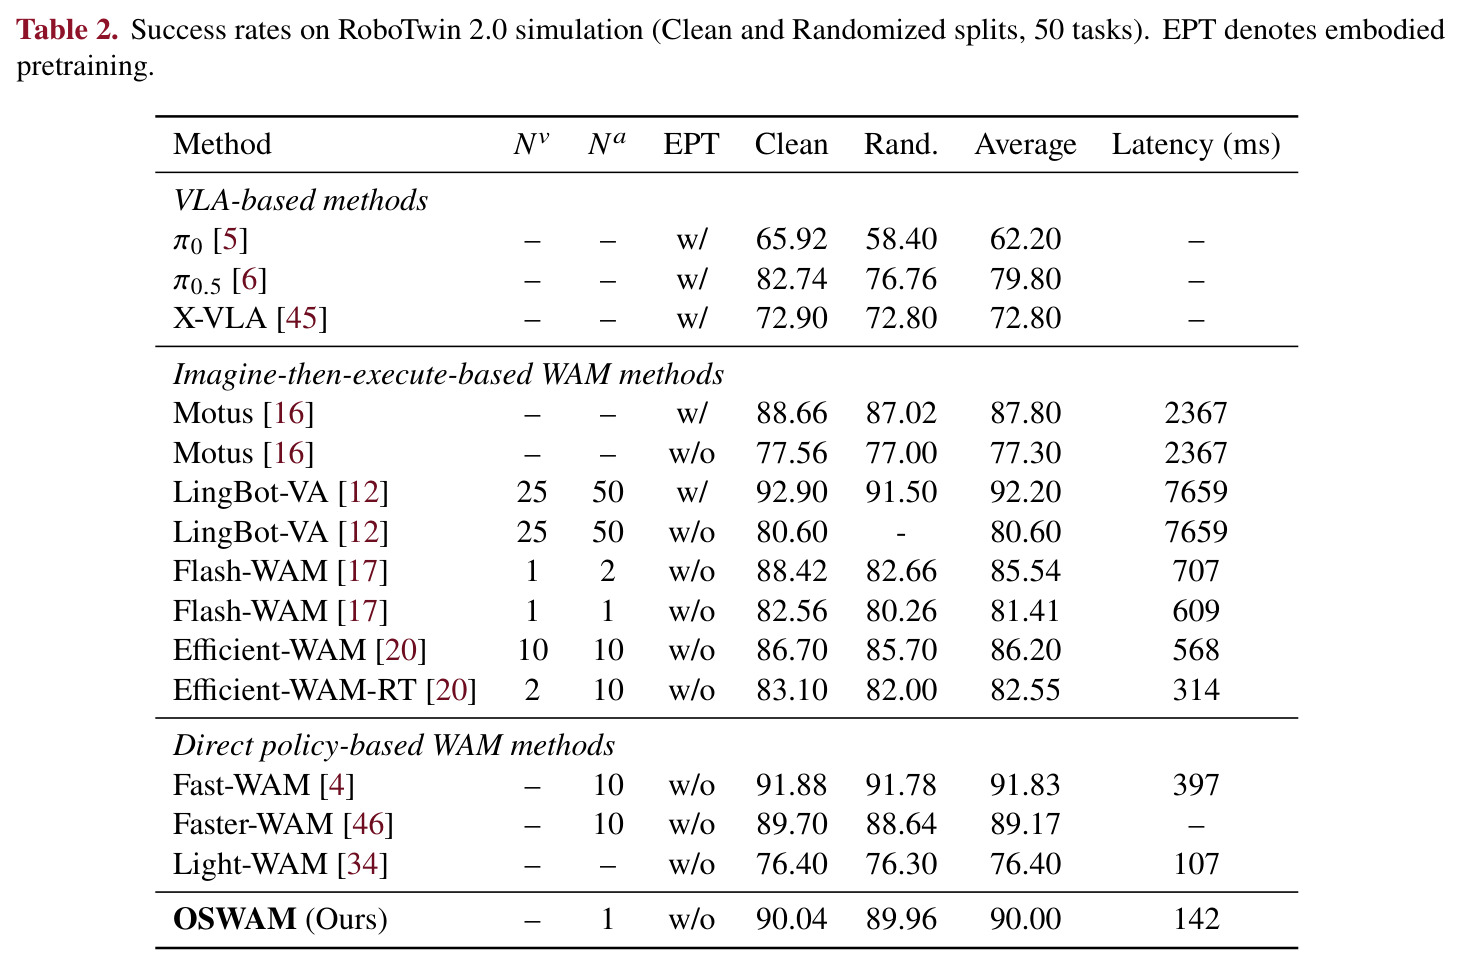
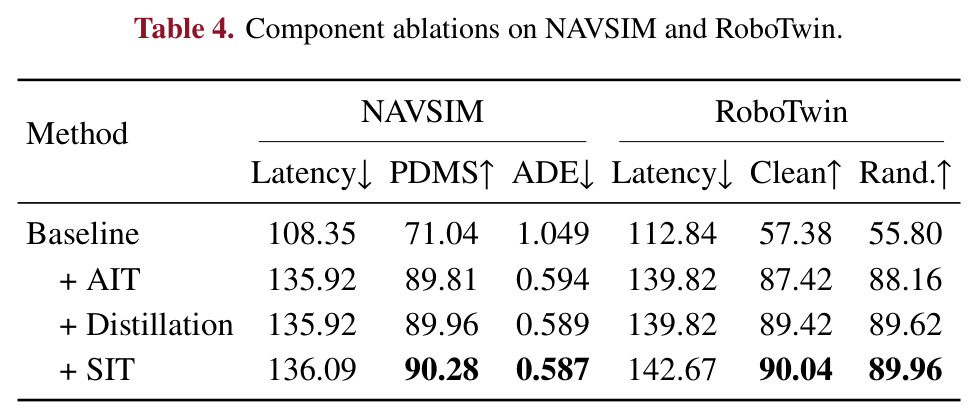
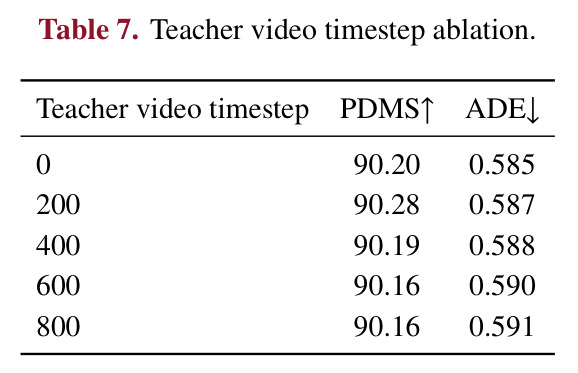
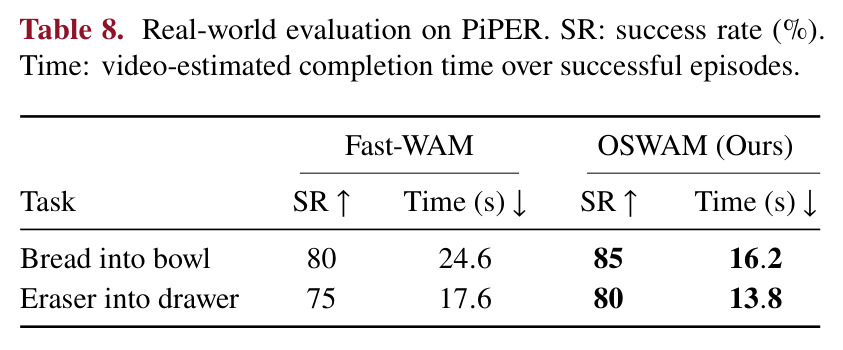
NAVSIM(Table 1):单步动作去噪取得 PDMS 90.3、延迟 136ms,与 10 步的 SimWAM(90.3、410ms)持平但快 3.01 倍;比 Metis(89.1)高 1.2 PDMS 且快 3.24 倍;比 DriveVA(90.5、593ms)快 4.36 倍仅低 0.2。RoboTwin 2.0(Table 2):50 任务平均成功率 90.00%(Clean 90.04/Rand 89.96),较 Fast-WAM 的 91.83% 只降 1.83 个百分点却快 2.80 倍;比同为单步的 Flash-WAM(81.41%)高 8.59 个百分点且快 4.29 倍;远超 Light-WAM 的 76.40%。效率(Table 3,RTX 5090):动作 GPU 时间从 67.61ms 降到 6.78ms,RoboTwin 总延迟 323.67→95.35ms(3.39 倍)、NAVSIM 330.8→99.70ms;编译后分别 40.81ms 和 52.64ms,峰值显存几乎不变。消融(Table 4):单步基线仅 71.04 PDMS / 57.38%、55.80%,+AIT 跃升至 89.81 / 87.42%、88.16%,+蒸馏到 89.96,+SIT 达 90.28 / 90.04%、89.96%。Table 5-7 显示 $\lambda_{dist}=10$、$\tau_r=500$ 最优,教师时间步 0-800 间仅波动约 0.12 PDMS。真机(Table 8,PiPER):面包入碗 85% 对 80%、完成 16.2s 对 24.6s(快 34.2%);板擦入抽屉 80% 对 75%、13.8s 对 17.6s(快 21.8%)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| NAVSIM navtest 端到端规划 | PDMS | 90.3(1 步动作去噪,延迟 136ms) | SimWAM 90.3(10 步,410ms);Metis 89.1(440ms) | 与 SimWAM 持平但快 3.01 倍;比 Metis 高 1.2 PDMS 且快 3.24 倍 |
| RoboTwin 2.0 双臂操作(50 任务平均) | 平均成功率 | 90.00%(Clean 90.04%,Rand 89.96%),延迟 142ms | Fast-WAM 91.83%(10 步,397ms);单步 Flash-WAM 81.41% | 对 Fast-WAM 仅 -1.83pp 但快 2.80 倍;对单步 Flash-WAM +8.59pp 且快 4.29 倍 |
| RoboTwin 2.0 推理效率(RTX 5090) | 整体延迟 / 编译后延迟 | 95.35ms / 40.81ms(动作 GPU 时间 6.78ms) | Fast-WAM 323.67ms / 73.64ms(动作 GPU 时间 67.61ms) | 整体 3.39 倍加速,峰值显存基本不变(12.75 vs 12.70GB) |
| NAVSIM 推理效率(RTX 5090) | 整体延迟 / 编译后延迟 | 99.70ms / 52.64ms | SimWAM 330.8ms / 90.53ms | 3.32 倍加速,支持 10Hz 以上实时推理 |
| PiPER 真机操作:面包入碗 / 板擦入抽屉 | 成功率 / 完成时间 | 85%、16.2s / 80%、13.8s | Fast-WAM 80%、24.6s / 75%、17.6s | 成功率各 +5pp,完成时间分别缩短 34.2% 与 21.8% |
局限与改进
作者自己承认:工作只聚焦于学习动作 DiT 的结构化初始化,SIT 与特权蒸馏尚未直接用于增强动作专家本身,这是明确的留白。我的补充观察:(1) RoboTwin 上仍与 Fast-WAM 有 1.83 个百分点的差距,说明结构化先验不能完全补偿多步迭代逐步施加的一致性约束;(2) $\tau_r=500$、对齐块 {8,16,24,30} 等超参靠网格搜索得到,跨任务、跨骨干的迁移性未验证;(3) 蒸馏需要先单独训练一个能看到完整未来的教师模型,训练成本接近翻倍;(4) 真机评估只有 2 个桌面任务、各 20 次试验、各 50 条演示,统计功效有限;NAVSIM 实验只用单前视相机 384×672 输入,与官方 8 相机全环视设定不同,结论对多相机场景的外推性存疑;(5) 单步生成天然丢失多步扩散对动作分布多模态的采样能力,Table 2 显示 Randomized 场景成功率(89.96%)略低于 Clean(90.04%),暗示分布偏移下鲁棒性可能更弱。
独立分析的弱点
独立分析几点弱点。第一,特权蒸馏的教师-学生管线使训练流程复杂化:要先训教师(与 OSWAM 同设置但 AIT 看全段未来),再冻结蒸馏,总算力开销大约是单模型训练的 2 倍以上,对小团队不友好;改进方向是研究无需单独教师的自蒸馏或在线教师方案。第二,结构化先验由辅助解码器从 AIT 特征回归得出,本质是回归均值,单步解码容易塌缩到多模态动作分布的中心;在需要绕障等强多模态决策的场景下可能吃亏,改进方向是让先验头保留随机性、支持多样本采样再择优。第三,固定 $\tau_r=500$ 是全数据集调出的折中,不同动作时域(NAVSIM 8 路点 vs RoboTwin 32 步动作块)可能需要不同噪声水平,改进方向是学习任务自适应的 $\tau_r$ 或推理时小范围搜索。第四,Table 7 显示教师即便看纯噪声未来($\tau_v^T=800$)也有 90.16 PDMS,暗示蒸馏信号可能主要来自教师权重结构而非真实未来信息,特权蒸馏的实际作用机制值得进一步剖析。
未来方向
作者明确提出:把 SIT 的场景上下文条件化与特权监督直接扩展到动作专家(Action DiT),而不仅停留在初始化阶段。基于本文成果还可延伸:(1) 把结构化初始化思想推广回 imagine-then-execute 范式,用想象令牌先验加速联合视频-动作生成,也许能让 Flash-WAM 式的一步蒸馏不掉点;(2) 与 SimWAM 路线的强化学习微调结合,检验一步生成的确定性会降低 RL 探索效率,还是因低延迟支持更高频闭环采样而受益;(3) 把 AIT/SIT 思想迁移到通用视频生成与世界模型的少步推理(如交互式世界模型、游戏引擎式仿真);(4) 系统扫描令牌数量与作用范围,例如让 AIT 同时为视频 DiT 提供未来锚点;(5) 在车载嵌入式平台(而非 RTX 5090)上做量化部署,并在真机上验证长时程、动态障碍与多人场景。
复现评估
复现门槛中等偏上但条件明确。论文提供项目页与代码入口,骨干是公开的 Wan2.2-5B(含 T5 编码器与视频 VAE),两个基准均公开:NAVSIM(1192 训练/136 测试场景)与 RoboTwin 2.0(50+ 任务,2500 条干净演示 + 25000 条强随机化演示),Fast-WAM 基线设定也有公开配置可对齐。超参披露充分:LoRA rank 8/$\alpha=4$,AdamW 学习率 $10^{-4}$、权重衰减 0.01、cosine 衰减加 5% warmup,NAVSIM 40000 步 batch 256,RoboTwin 29335 步 batch 1024,蒸馏从 500 步后线性升权,$\lambda_{dist}=10$、$\tau_r=500$、教师时间步 200、对齐块 {8,16,24,30}。难点在算力:batch 1024 加 Wan2.2-5B 视频骨干意味着多卡高端 GPU 训练数天,教师单独训练再加蒸馏使总成本翻倍。消融结论(尤其 Table 4 中 +AIT 的巨大提升)相对稳妥可复现,但真机部分需自备 PiPER 机械臂并自采演示数据。
论文图表
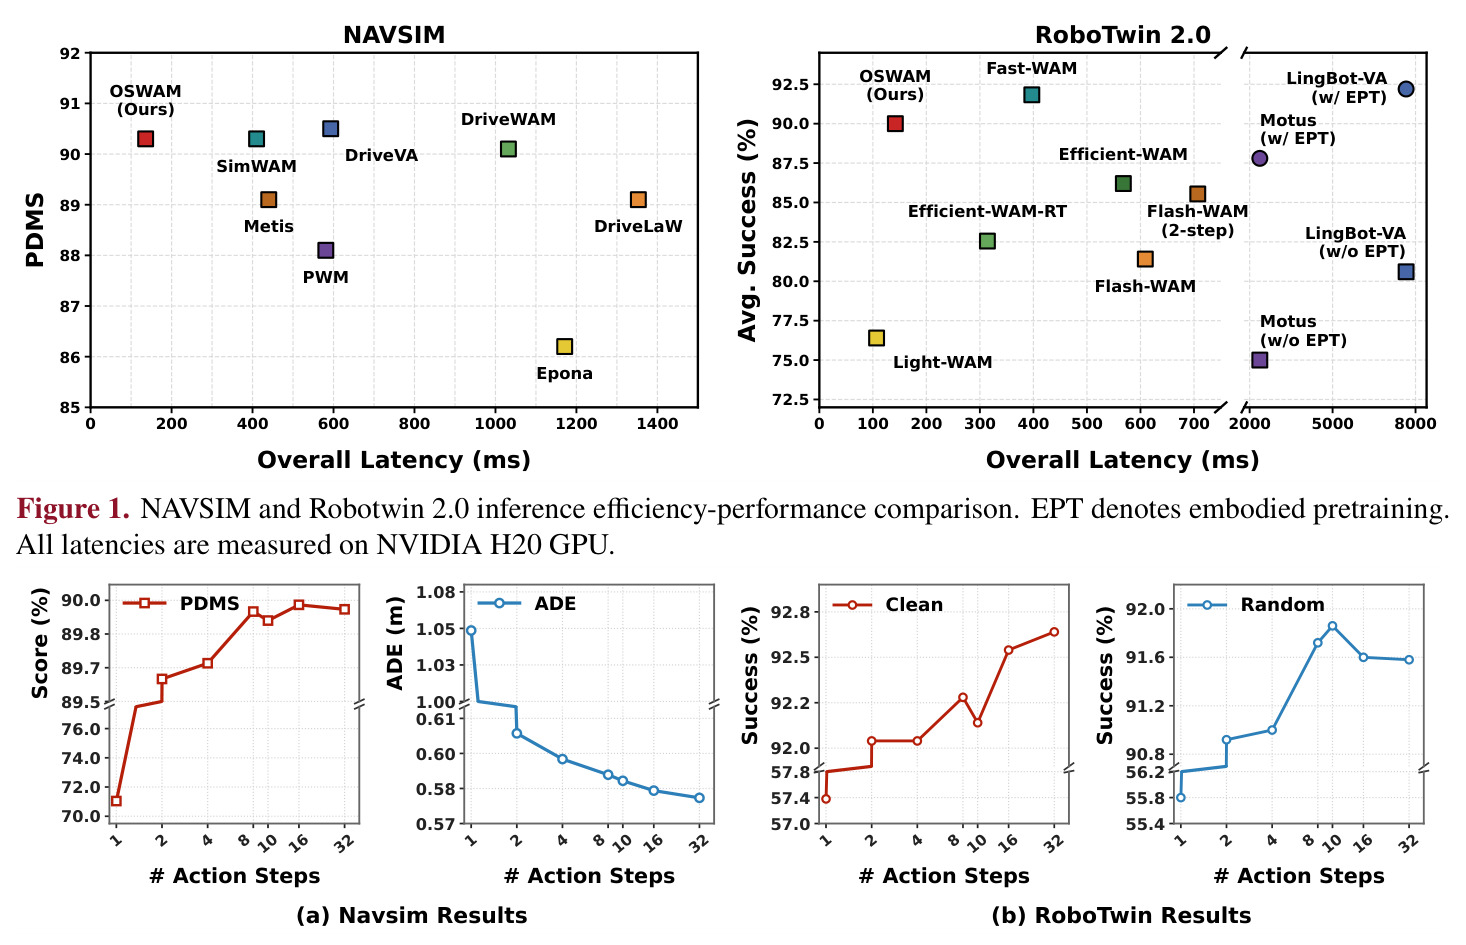
两张散点图分别以整体延迟(ms)为横轴、NAVSIM PDMS 或 RoboTwin 平均成功率为纵轴,把 OSWAM 与 DriveWAM、DriveVA、Metis、SimWAM、Fast-WAM、Efficient-WAM、Flash-WAM、Motus、LingBot-VA 等方法放在同一延迟-性能平面上,OSWAM 位于左上角(延迟最低、性能最高档)。
一眼看出本文定位:在两个基准上同时把延迟压到最低档并保持最高一档的性能,是论文效率主张的总览图。
四条曲线分别展示 NAVSIM 的 PDMS/ADE 与 RoboTwin 的 Clean/Random 成功率随去噪步数(1、2、4、8、10、16、32)的变化:步数越少性能越差,单步时 NAVSIM PDMS 掉约 20%(至 71.04),RoboTwin 掉约 40%(至 57.38%/55.80%)。
这是动机的核心证据:直接证明「砍步数」行不通,从而引出必须改变初始化的思路。
两组成功 rollout 的帧序列,展示从抓取、搬运到最终放置的全过程,验证放置后物体停留在目标容器内。
证明方法不只是仿真数字,能在真实机械臂上以单步去噪完成需要抓取-运输-放置协调的物理任务。