CineRecon:面向智能体电影级视频三维重建的前沿模型基准 CineRecon: Benchmarking Frontier Models for Agentic Cinematic Reconstruction
用50段真实视频与360个标注片段考核12个前沿模型以智能体方式重建可编辑动态3D场景的能力
前置知识
编码智能体与 Agent Harness
指以大模型为核心、通过 CLI(如 Codex CLI、Claude Code、Qwen Code)驱动并在循环中调用工具的自主编程系统:模型读取任务指令后自行决定调用哪些工具(读写文件、执行 shell、检查媒体),根据工具返回的反馈继续推理和修改,直到产出最终交付物。Harness 提供交互循环、上下文管理和原生工具,是模型能力的"载体"。
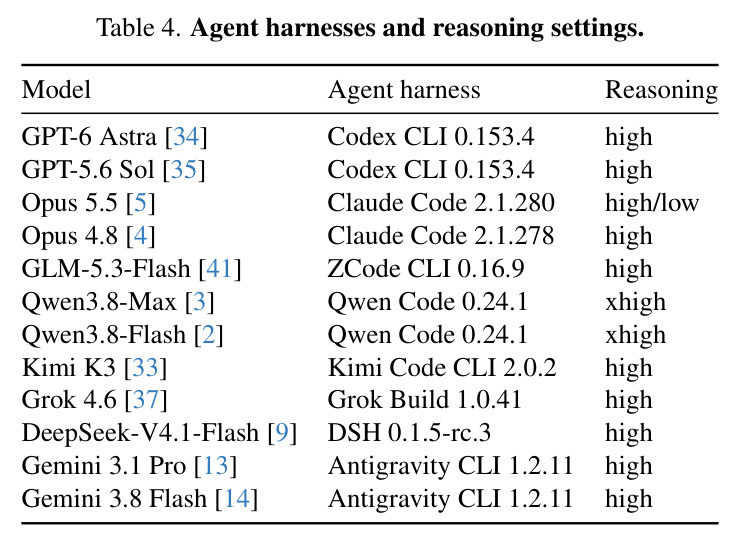
本文评测的对象不是单个模型的一次问答,而是"模型+对应原生 harness"的完整智能体系统:每个模型用自己的 harness 在 Blender 里写代码、渲染、看反馈、改代码。理解这一点才能看懂实验设置与结果归因的讨论。
Blender MCP
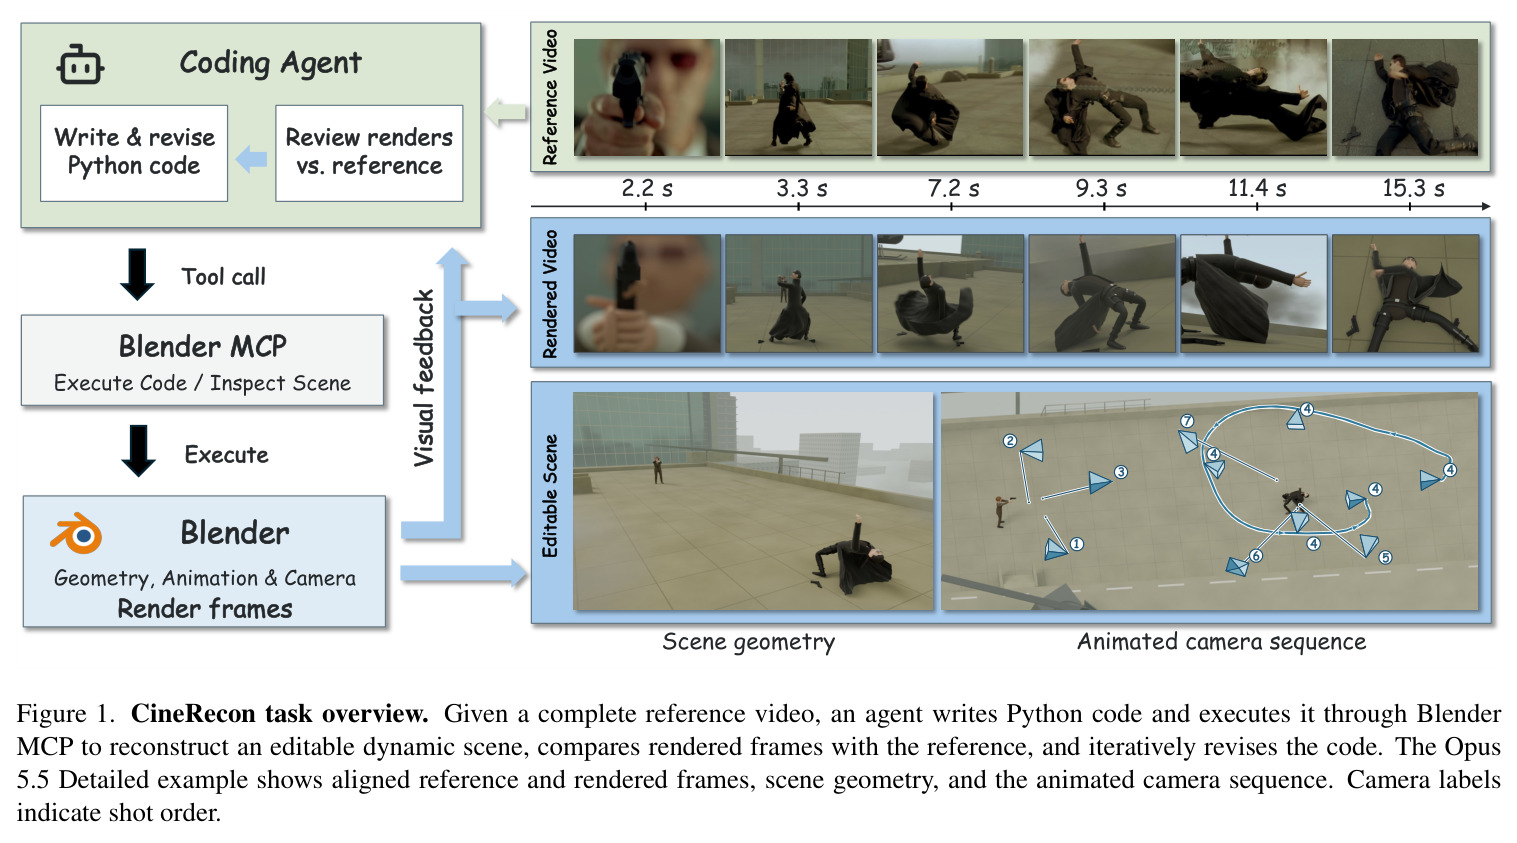
MCP(Model Context Protocol)是连接大模型与外部工具的标准协议;Blender MCP 是其面向三维软件 Blender 的实现,向智能体暴露三类能力:场景检查、在 Blender 内执行 Python、视口截图。智能体由此可以程序化地创建几何体与材质、配置灯光和相机、给物体及关节部件做关键帧动画,并保存可编辑的 .blend 工程文件。
CineRecon 要求产出"可编辑的 Blender 动态场景",Blender MCP 是智能体操控 Blender 的唯一通道,也是"重建—渲染—反馈—修改"整条工作流的执行底座。
逆向图形学(Inverse Graphics)
正向图形学是给定场景几何、材质、相机与动画后渲染出图像;逆向图形学反其道而行:从观测图像或视频推断出可渲染、可编辑的场景表示(几何、外观、相机轨迹、物体运动参数)。近年工作让多模态大模型以写代码的方式实现逆向图形,把"看懂视频"转化为"写出能重演出该视频的图形程序"。
CineRecon 本质上是一次大规模逆向图形学能力测试:智能体必须从视频反推场景结构、主体动作和相机参数。理解这一框架才能明白任务为何困难、为何用渲染结果与参考逐帧对比来评分。
VLM 裁判(VLM-as-Judge)
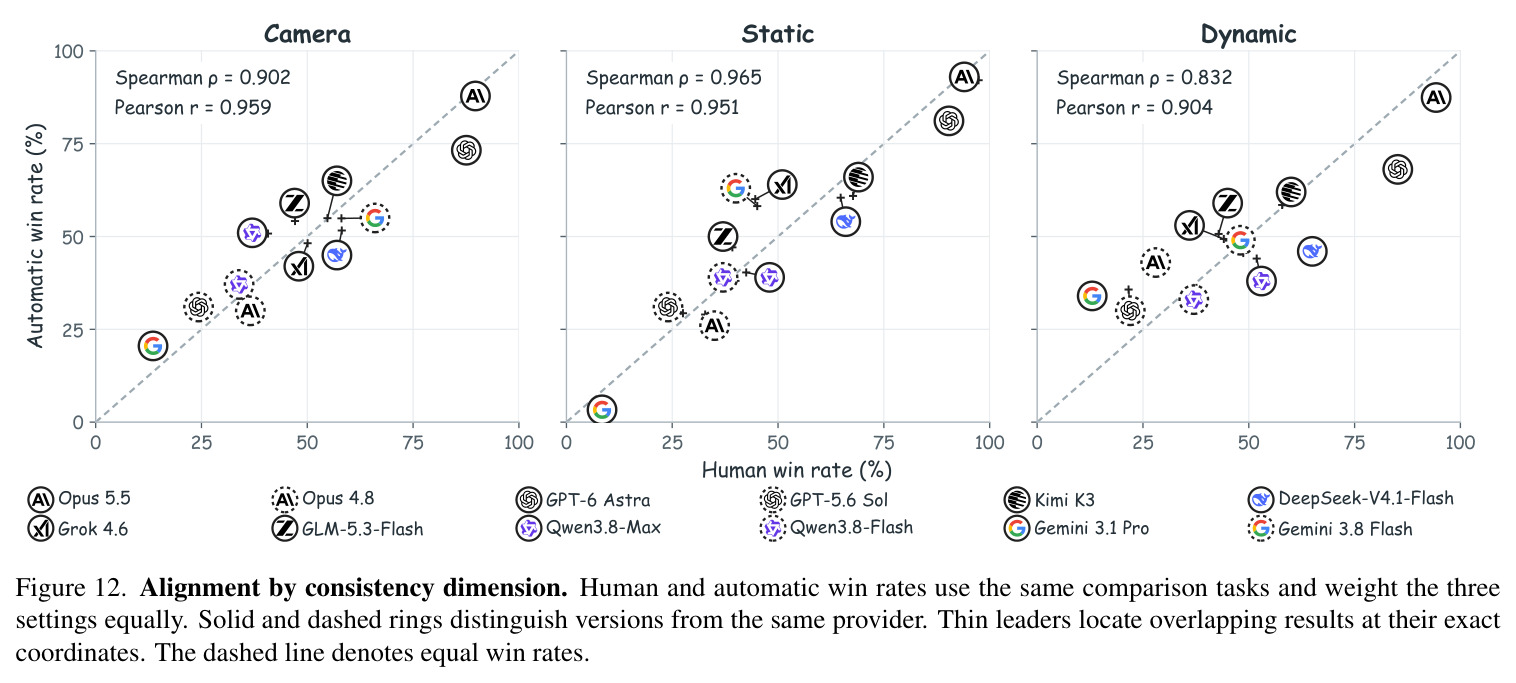
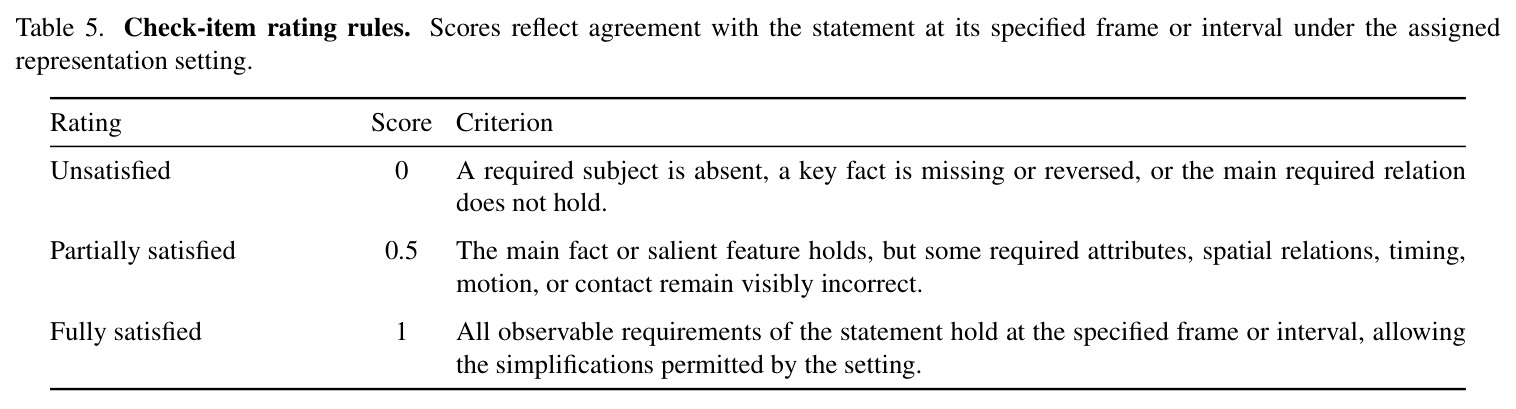
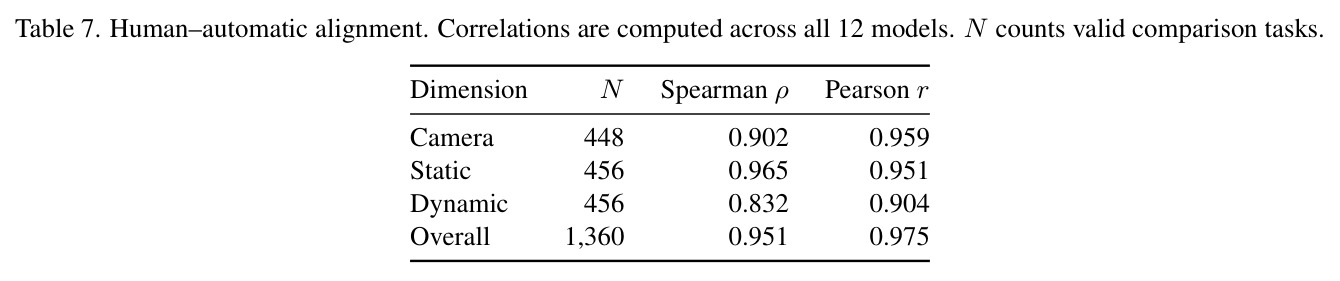
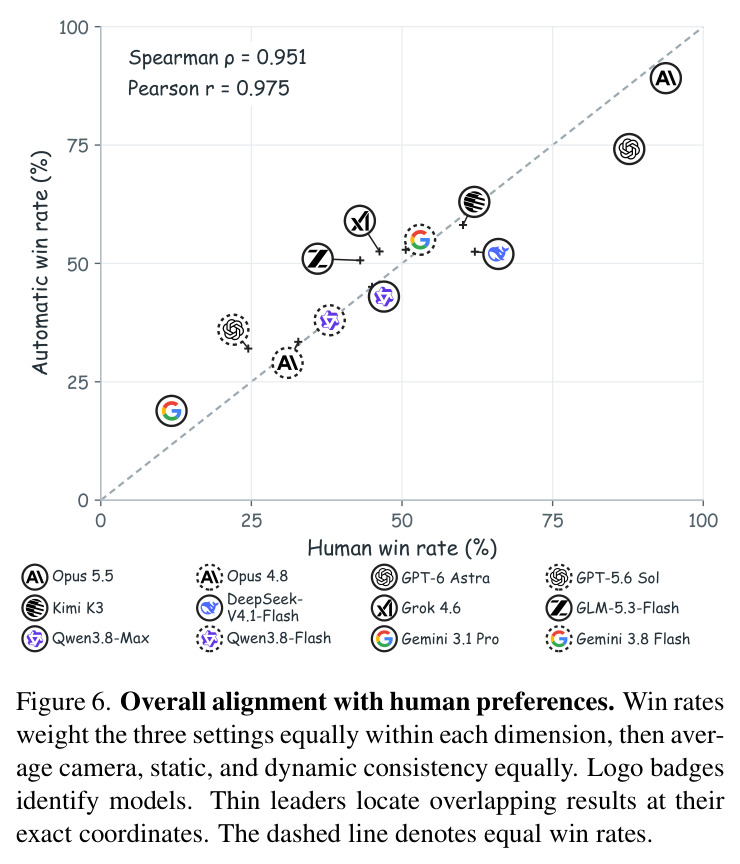
用视觉语言模型替代人工评分:把时间对齐的参考帧与重建帧、参考实体表和检查单一起交给裁判模型,让其逐条判断检查项是否满足,输出不满意/部分满足/完全满意三档,分别计 0/0.5/1 分。本文用高推理努力的 GPT-5.6 Sol 作裁判,并用 1,440 次人工两两比较验证其与人类偏好的相关性(总体 Spearman ρ=0.951、Pearson r=0.975)。
论文所有定量结论都建立在 VLM 裁判之上,裁判的评分规则、帧选择和聚合公式决定了分数的含义,也直接影响你对结果可信度与局限的判断。
实体-时间绑定的检查单评测
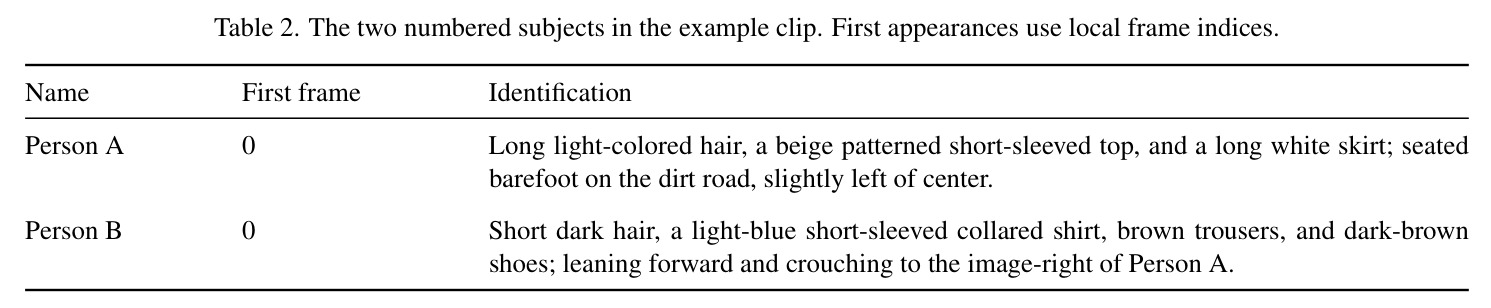
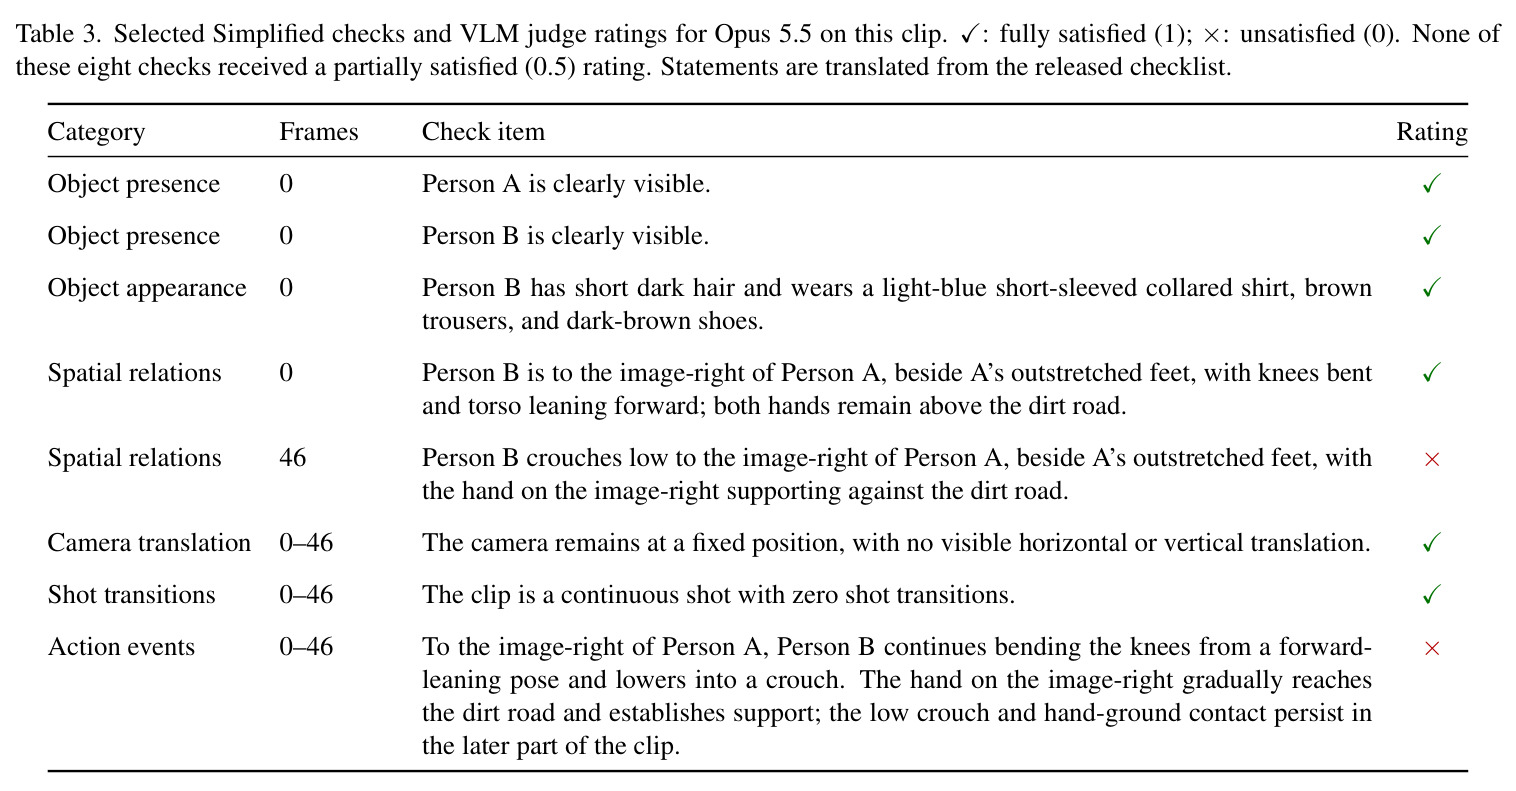
把"重建得像不像"拆成一条条与具体实体、具体时间绑定的可判定陈述,例如"第 46 帧时 Person B 蹲在 Person A 画面右侧、右手撑地"。检查项按 11 个类别组织成相机/静态/动态三个一致性维度,先在片段内对检查项取平均,再跨片段等权平均,三个维度等权合成 0–100 总分。
检查单是本文评测协议的核心:它让分数可解释(能定位是支撑关系还是动作时序出错),也是三档表示设置能够跨设定严格比较的前提。
胜率与秩相关校验
为验证自动评分是否可靠,作者把人工两两偏好和自动分数都换算成胜率(平局各计半胜),再在模型层面计算 Spearman 秩相关与 Pearson 线性相关。本文总体达到 ρ=0.951、r=0.975,说明自动评测在模型排名层面与人类判断高度一致;但动态一致性维度只有 ρ=0.832,是三个维度中最弱的。
读懂这一验证逻辑,才能判断哪些维度的分数可以放心引用、哪些维度(尤其是动态一致性)需要保留不确定性。
研究动机
把参考视频重建成可编辑的动态 3D 场景,是可控视频生成走向电影制作的关键路径:创作者需要在场景布局、主体动作、镜头行为上有明确的修改抓手,渲染输出则作为视觉代理(visual proxy)去引导视频生成。但这要求忠实复现视频中的动态过程——例如镜头跟随一个人走向另一人并握手,智能体必须同时协调人物移动、握手时机和相机轨迹,让交互在正确的时间、正确的地点发生。现有评测能力却明显跟不上:IR3D-Bench 与 3DCodeBench 只测图像到场景或程序化物体建模;BVB 局限在室内真实视频;4DCodeBench 研究形变、流体、断裂等物理动态但相机运动极少;SceneActBench 直接提供资产和参考相机且用合成数据;VisPhyWorld 只用合成物理场景的两帧关键帧且相机固定。换言之,此前没有基准要求智能体在"完整真实视频、无资产、无相机参数"的条件下,联合复现场景内容、主体动作与交互、相机运动和镜头切换这四类耦合能力。
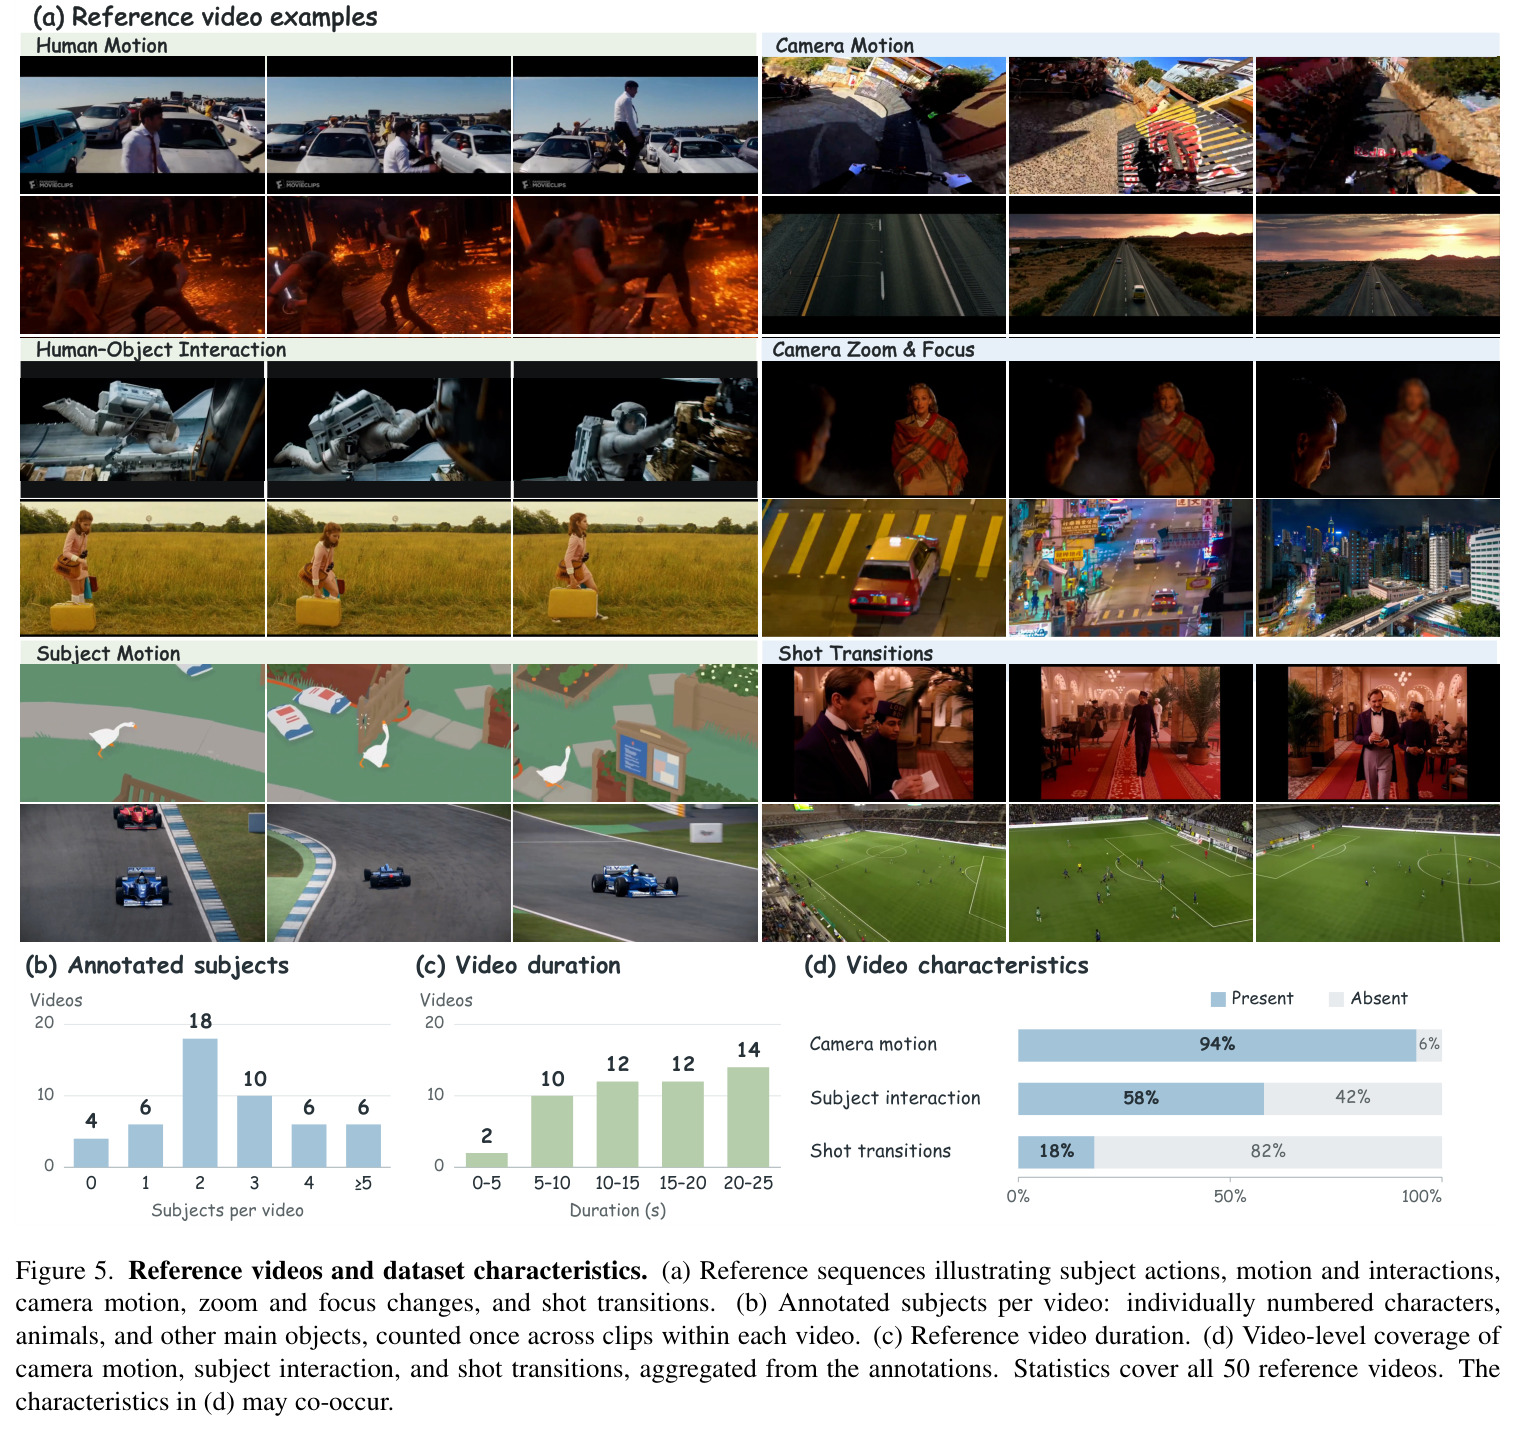
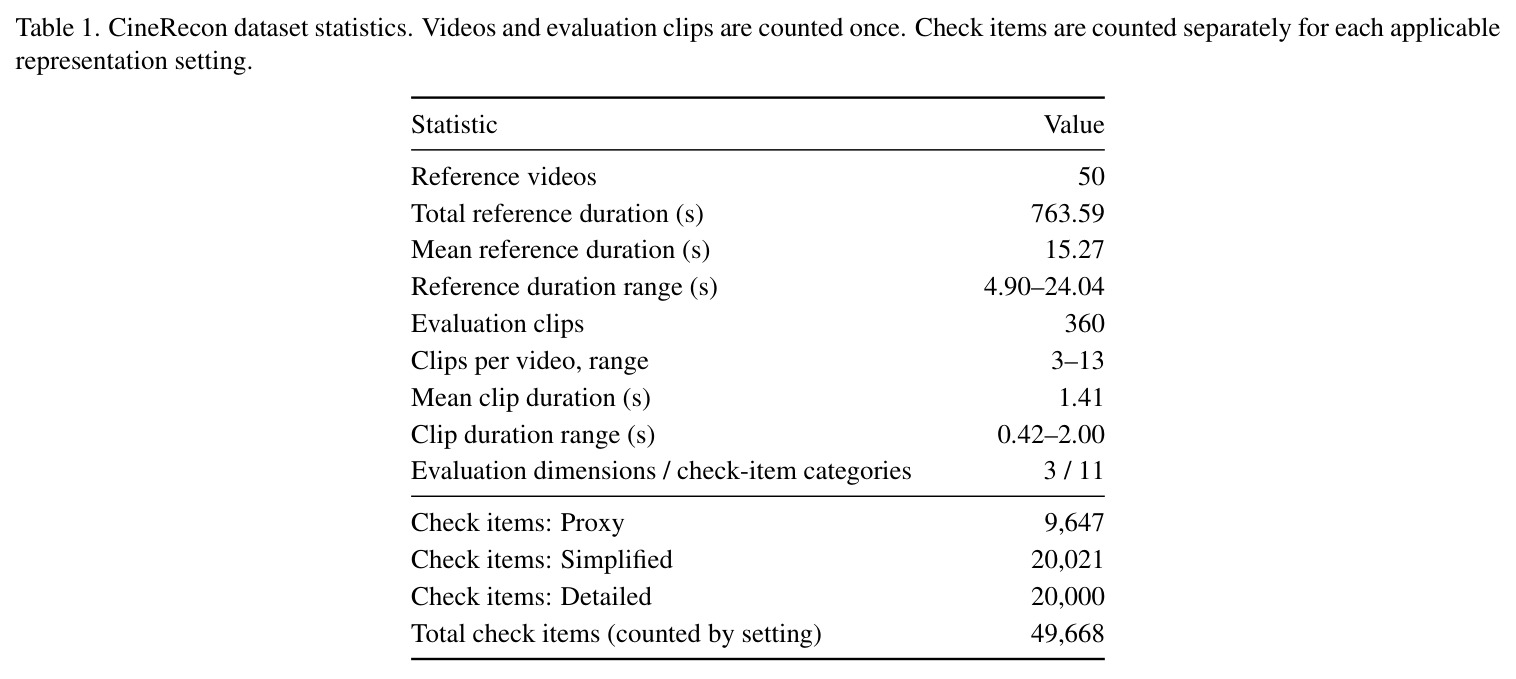
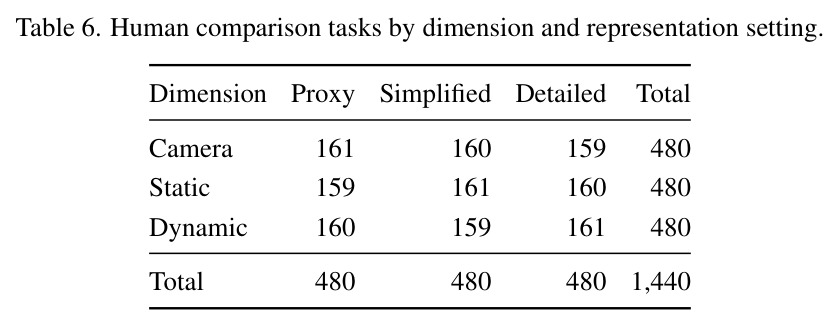
本文的目标是本文的目标是建立 CineRecon:一个评测智能体把完整动态视频重建成可编辑 Blender 场景能力的基准。具体包括:收集 50 段来自电影、体育与第一人称实录、航拍、游戏和赛车的参考视频,总时长 763.59 秒(平均 15.27 秒,范围 4.90–24.04 秒),其中 94% 含相机运动、58% 含主体交互、18% 含镜头切换;标注 360 个评测片段(每个不超过 2 秒、平均 1.41 秒,可重叠、可跨镜头),每个片段配一份把可观测属性/事件与具体实体、具体时间绑定的结构化检查单,共 49,668 个设定专属检查项(Proxy 9,647、Simplified 20,021、Detailed 20,000),覆盖 11 个类别、相机/静态/动态三个一致性维度;定义 Proxy/Simplified/Detailed 三档表示设置以解耦几何外观要求与时空动态要求;在此之上系统评测 12 个多模态编程模型(13 个配置),并建设 VLM 裁判自动评测与 1,440 次人工两两比较的双轨验证。
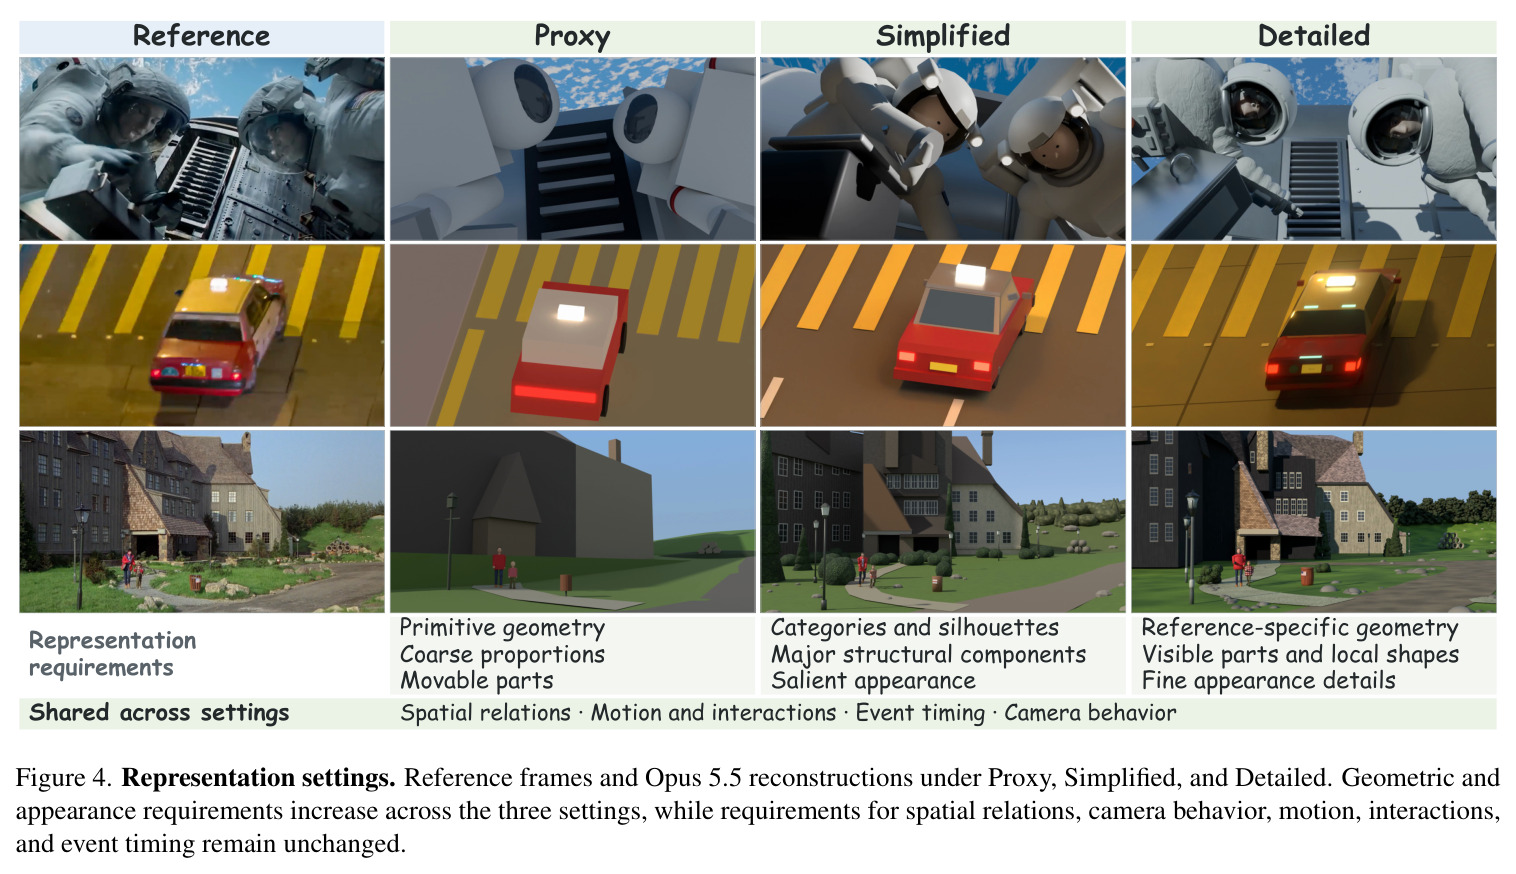
与已有工作不同的是,本文的独特切入角度有三点。第一,任务定义面向"电影级重建":输入是完整视频而非图像或关键帧,输出必须是可编辑、可渲染的 Blender 场景而非一次性视频或不可控的 4D 表示,且主协议禁止外部资产、资产生成服务,以及把参考图像当背景或投影贴图的取巧手段。第二,也是最关键的设计:三档表示设置在保持空间关系、主体运动与交互、事件时序、相机行为要求完全一致的前提下,只递增几何与外观要求(Proxy 允许几何体块、Simplified 要求可识别类别与轮廓、Detailed 要求实例级细节),相机与动态检查跨设定共享相同的类别、主体与时间区间,从而第一次能做干净的对照实验——"把外观要求降下来,动态重建能力会被释放吗?"第三,评测采用实体-时间绑定的检查单而非整体相似度或感知指标,失败可以定位到具体检查项(比如"手-地支撑关系未建立"),而不是一个含糊的感知分数。
核心方法
任务可形式化为:给定完整参考视频 $V$ 和表示设置 $r \in \{\text{Proxy}, \text{Simplified}, \text{Detailed}\}$,智能体 $\mathcal{A}$ 构建可编辑场景 $\mathcal{B} = \mathcal{A}(V, r)$,渲染器 $\mathcal{R}$ 沿时间轴渲染出 $\hat{V} = \mathcal{R}(\mathcal{B})$,输出须匹配参考的分辨率、帧率、帧数与时长,多镜头还须复现切换。直觉上,这是让模型当三维动画师:看片、建模、绑骨、做动画、渲染、对照参考帧挑毛病、改代码、再渲染。技术上,各模型通过原生 harness 运行,配 Blender 5.2 与 Blender MCP(场景检查、Python 执行、视口截图),迭代轮数自主决定,渲染用 Cycles + CUDA 去噪。评测由 GPT-5.6 Sol 作 VLM 裁判,对 360 个片段按检查单逐项打 0/0.5/1 分,片段内平均后跨片段等权平均,三维度等权合成总分。
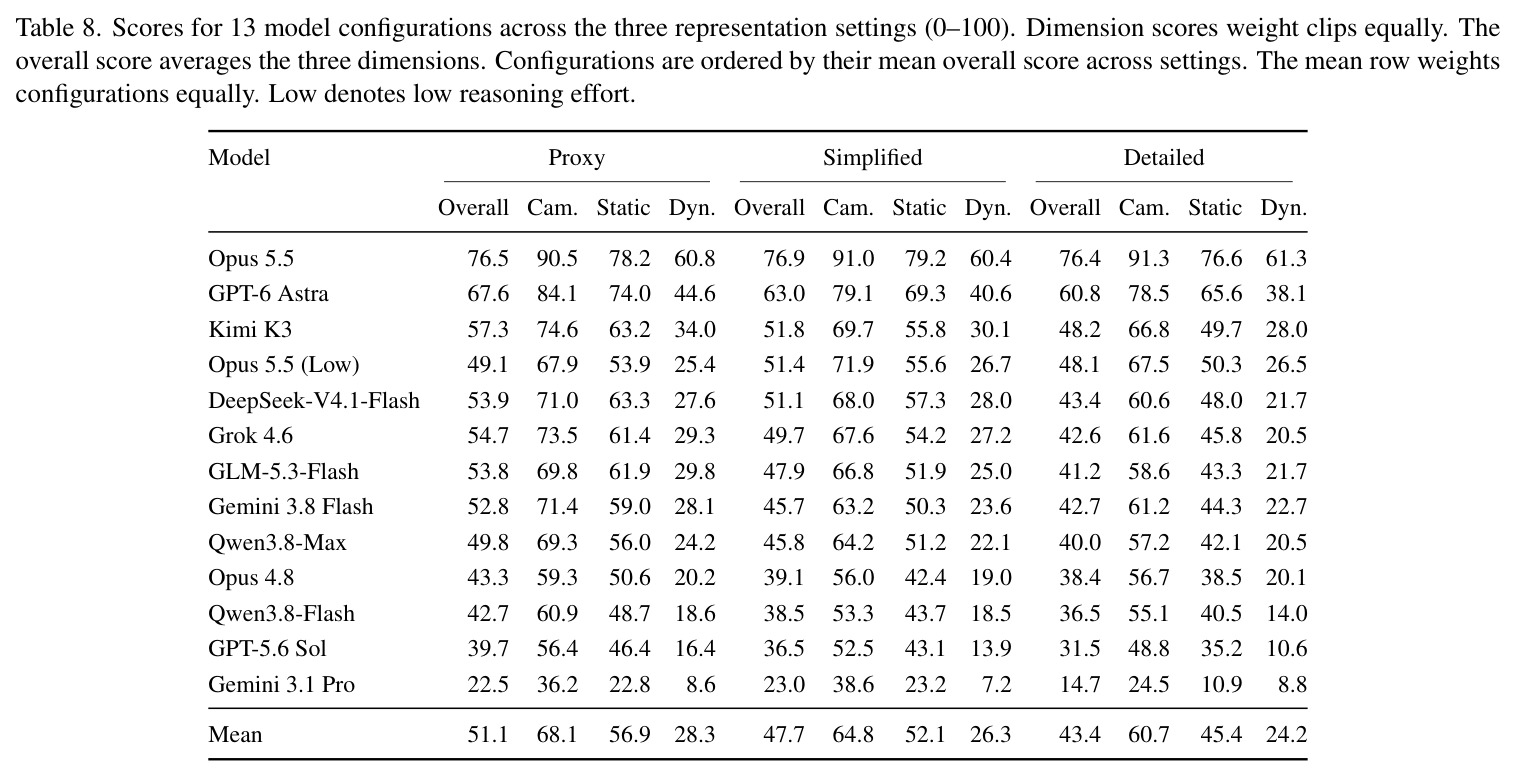
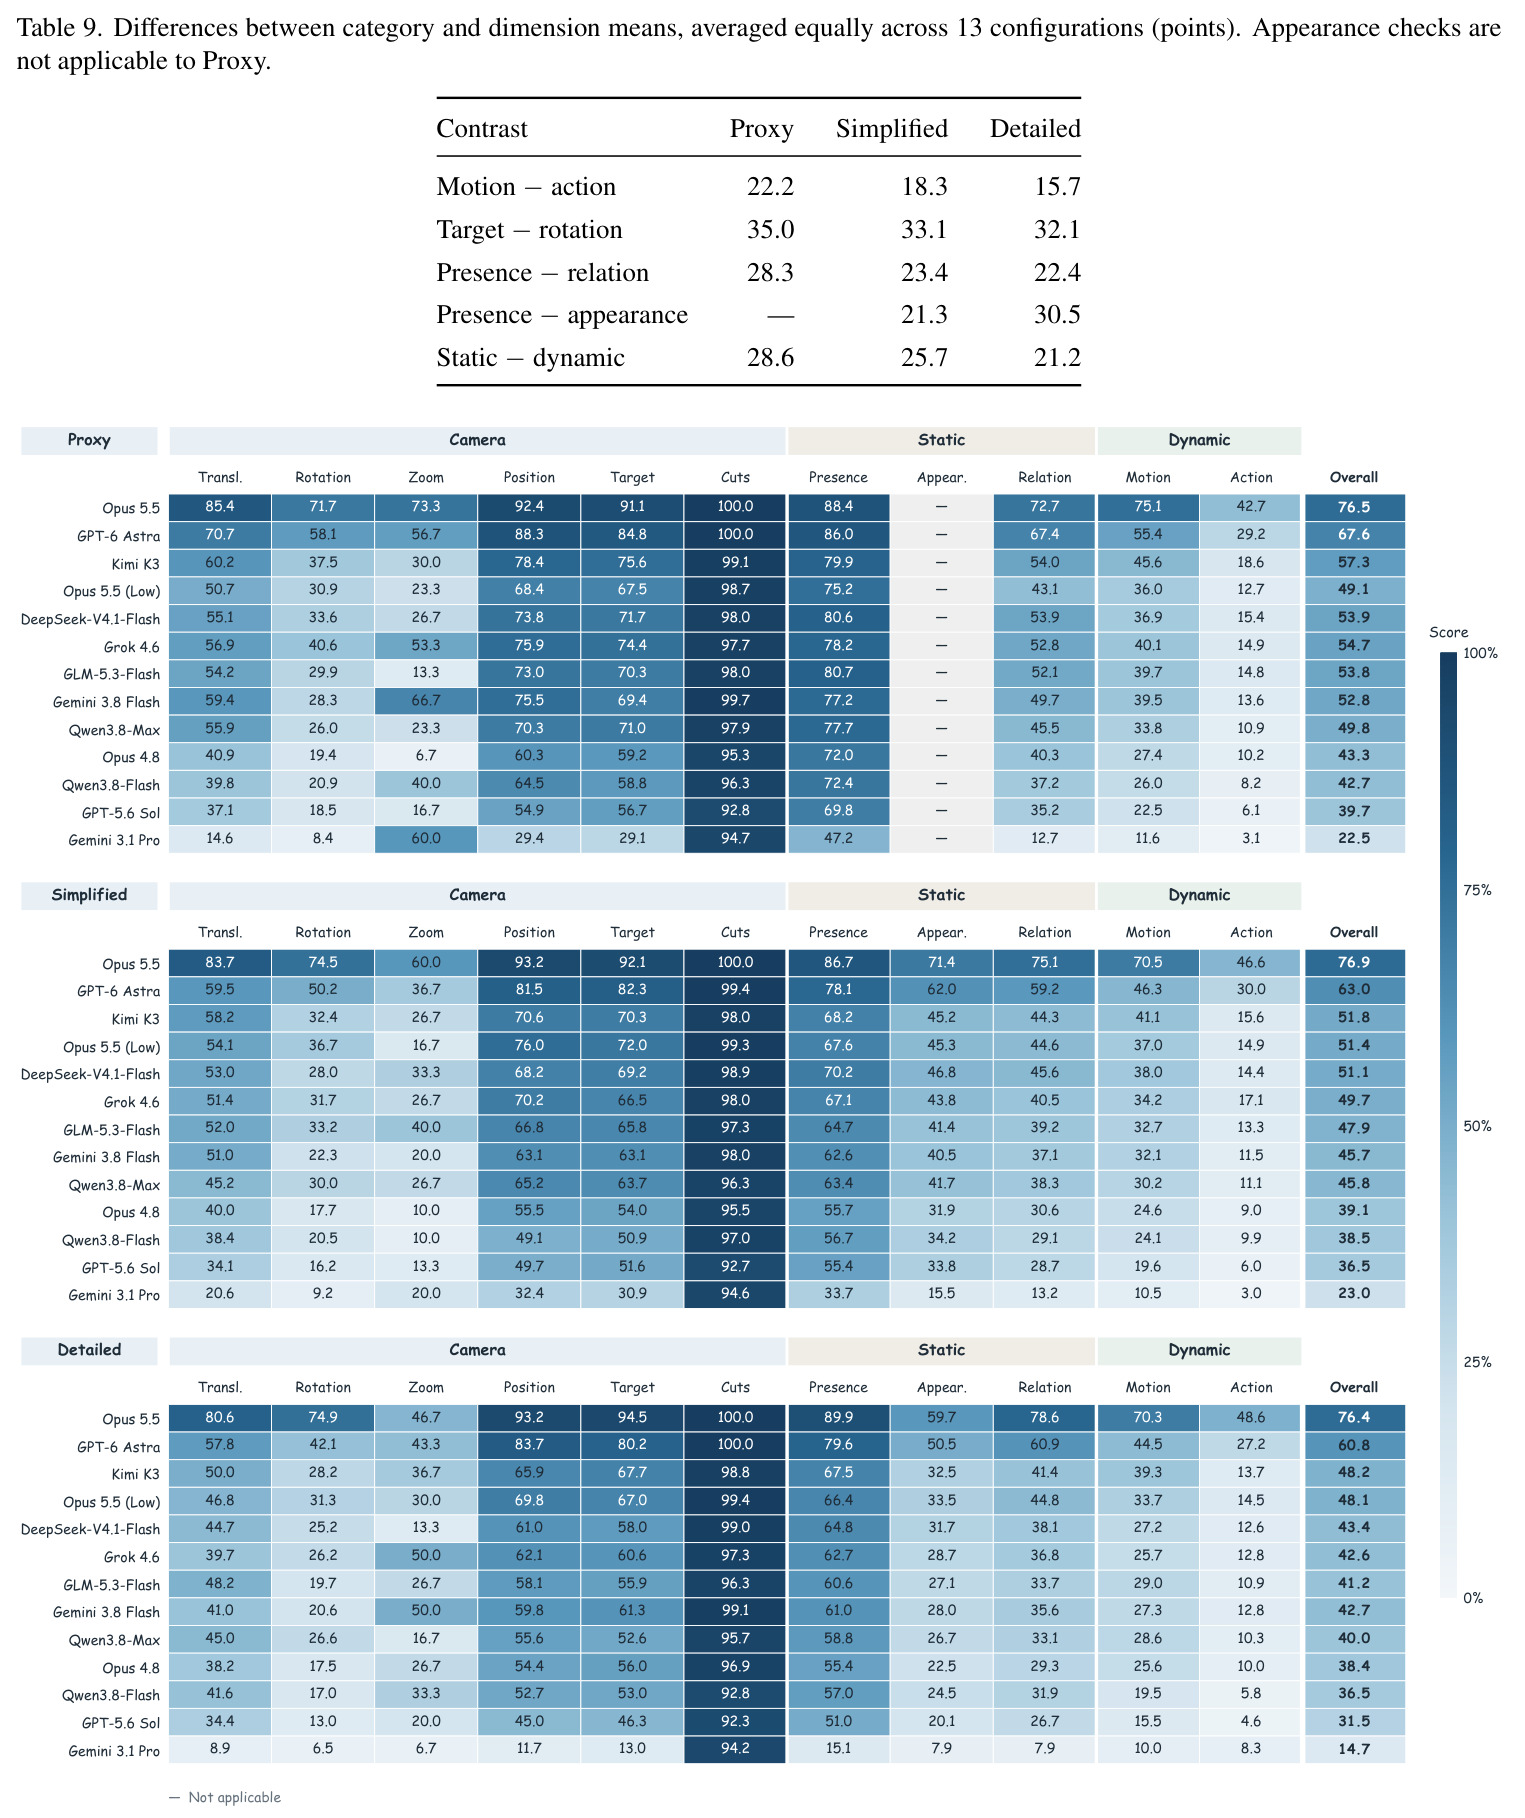
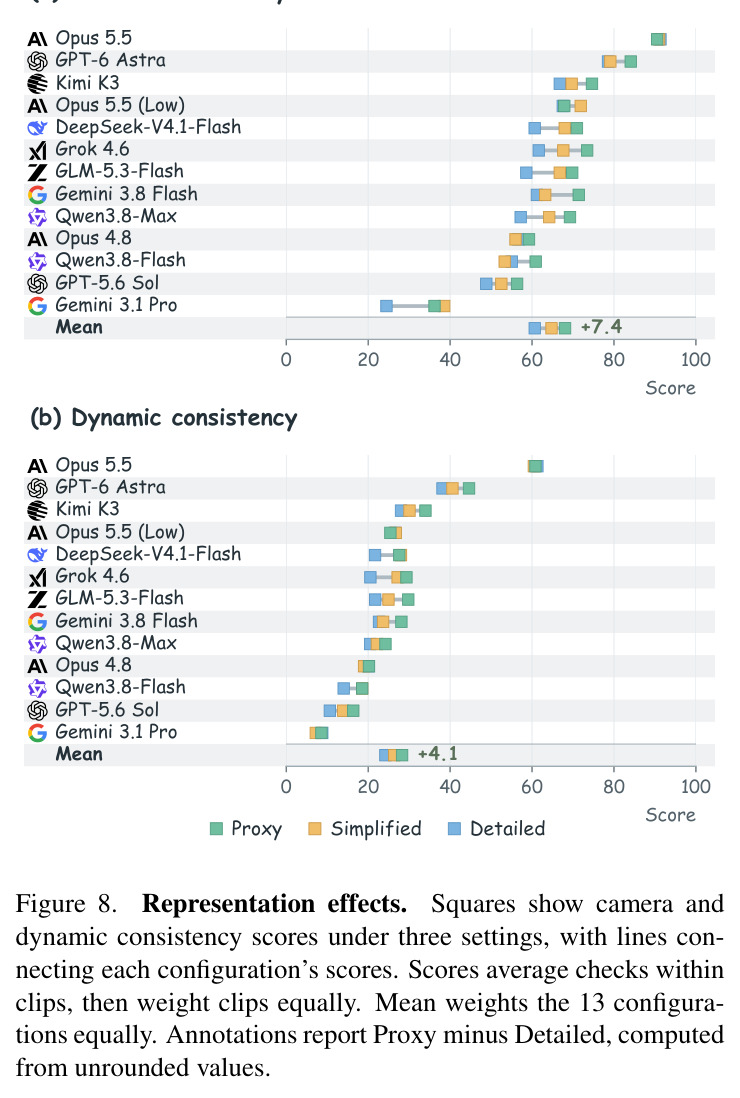
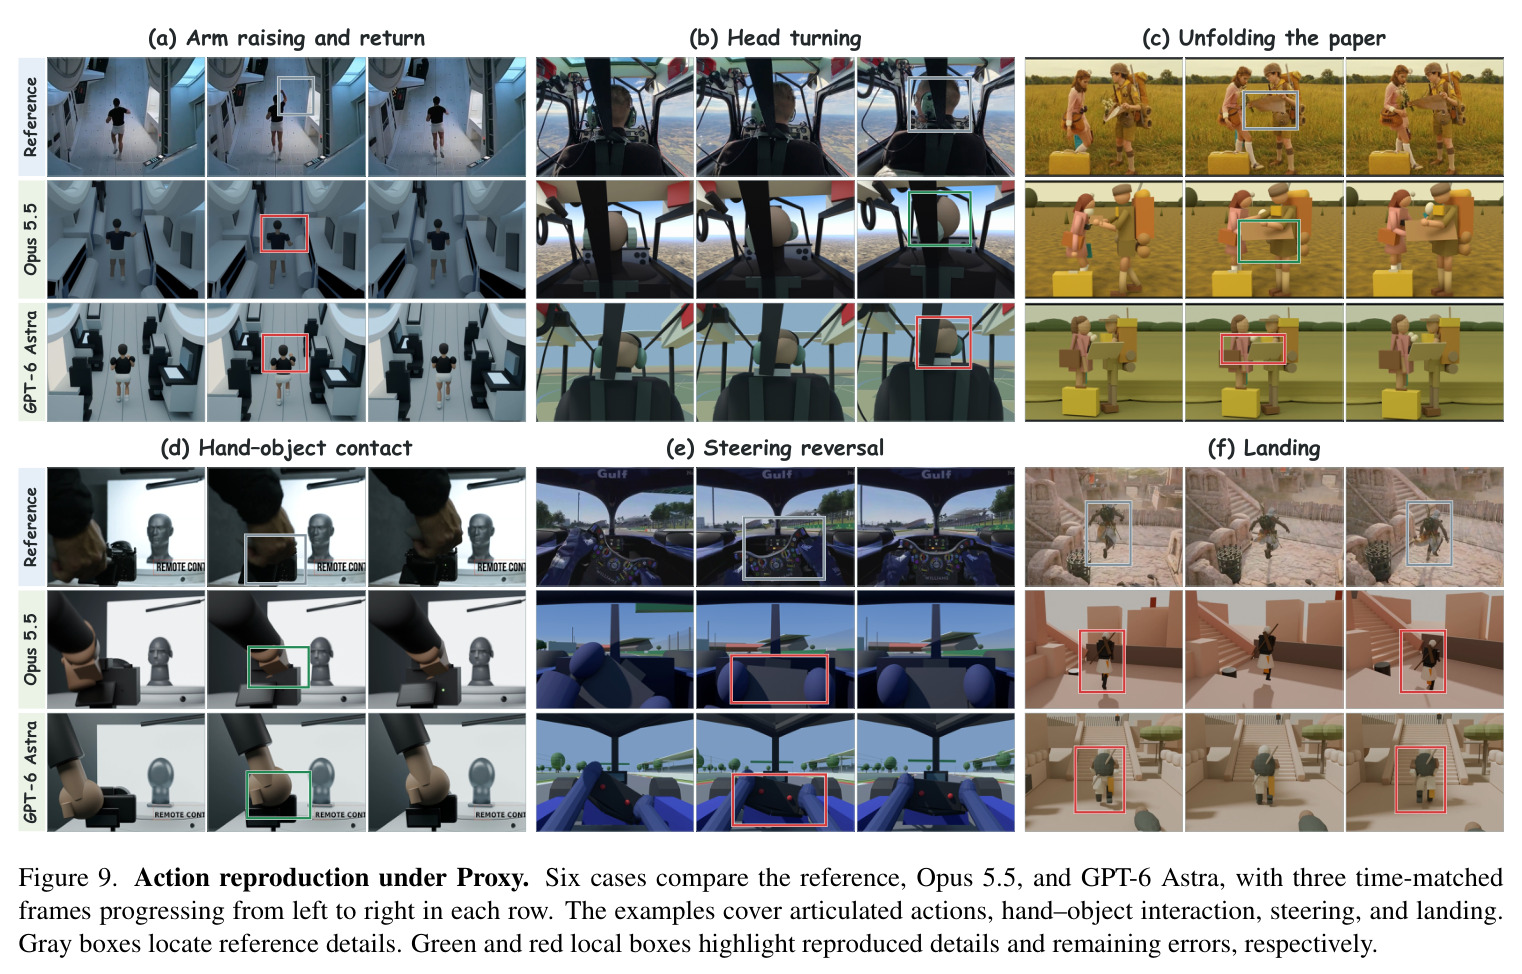
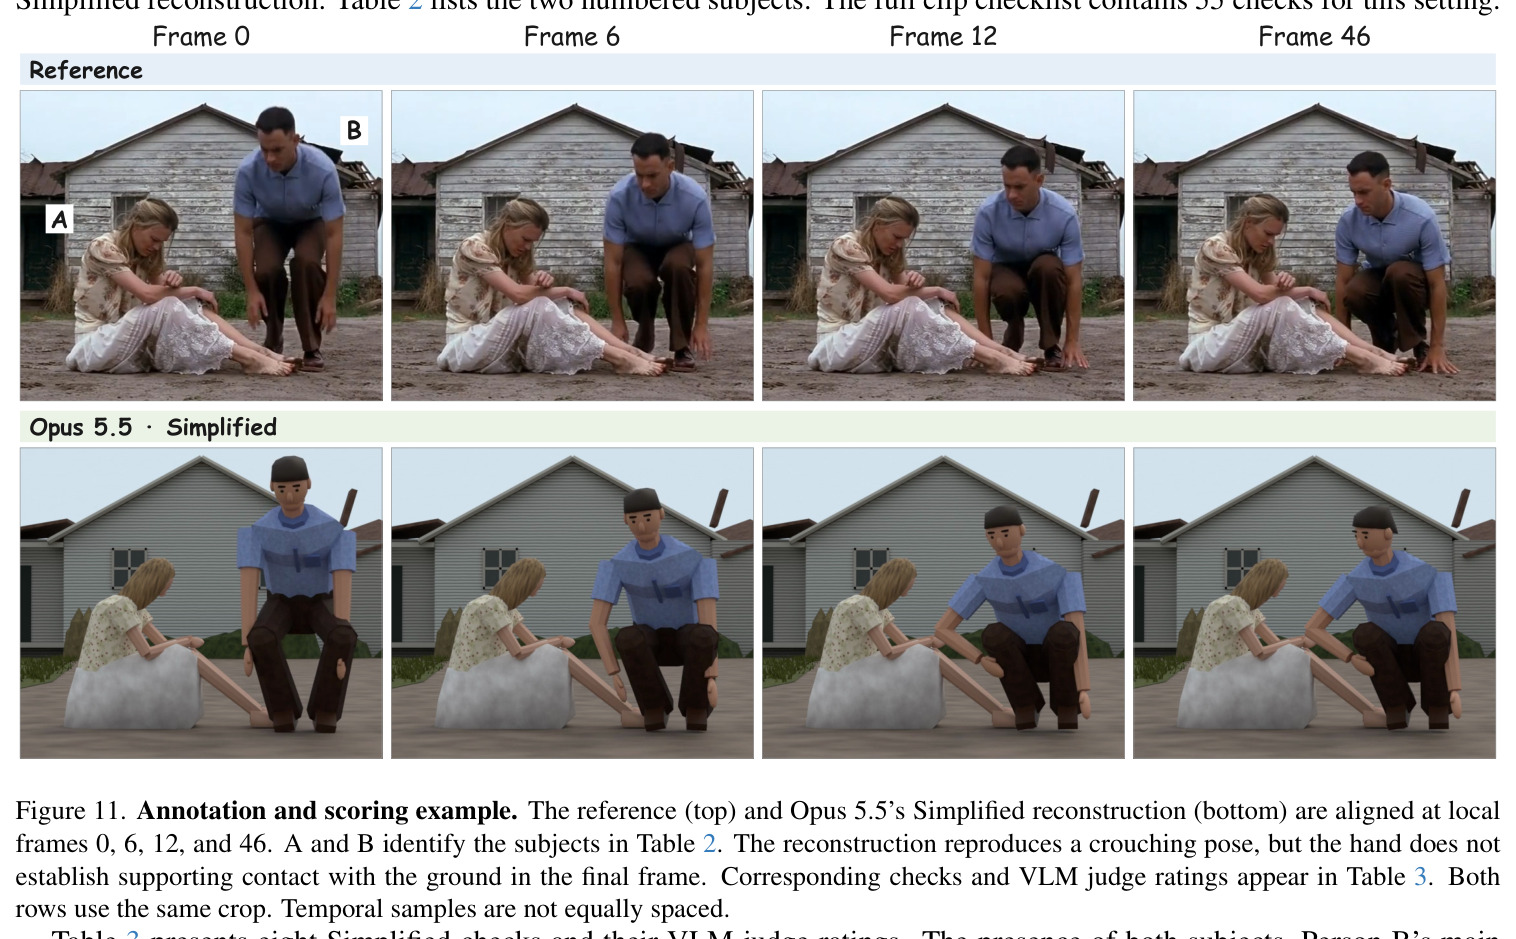
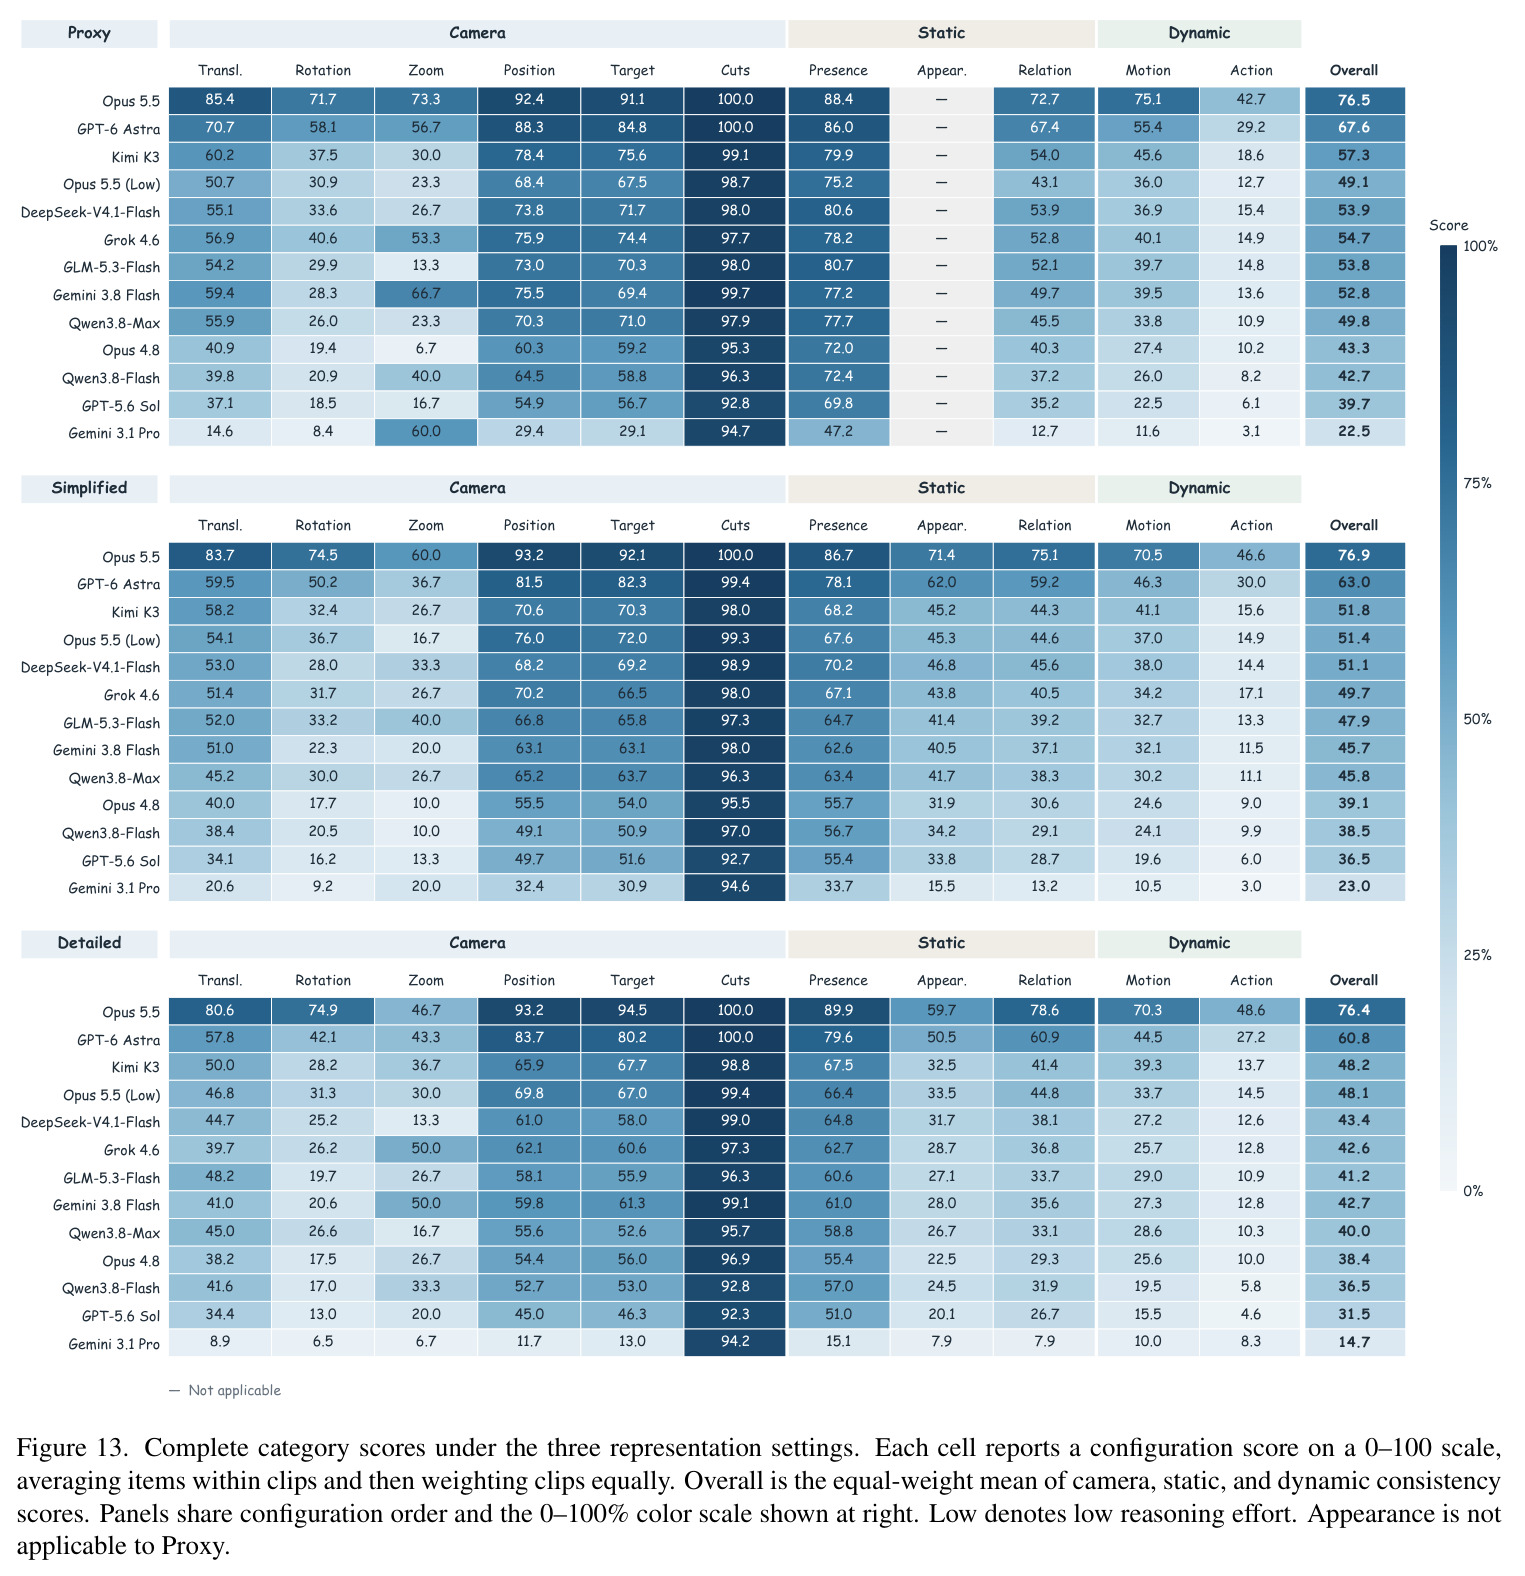
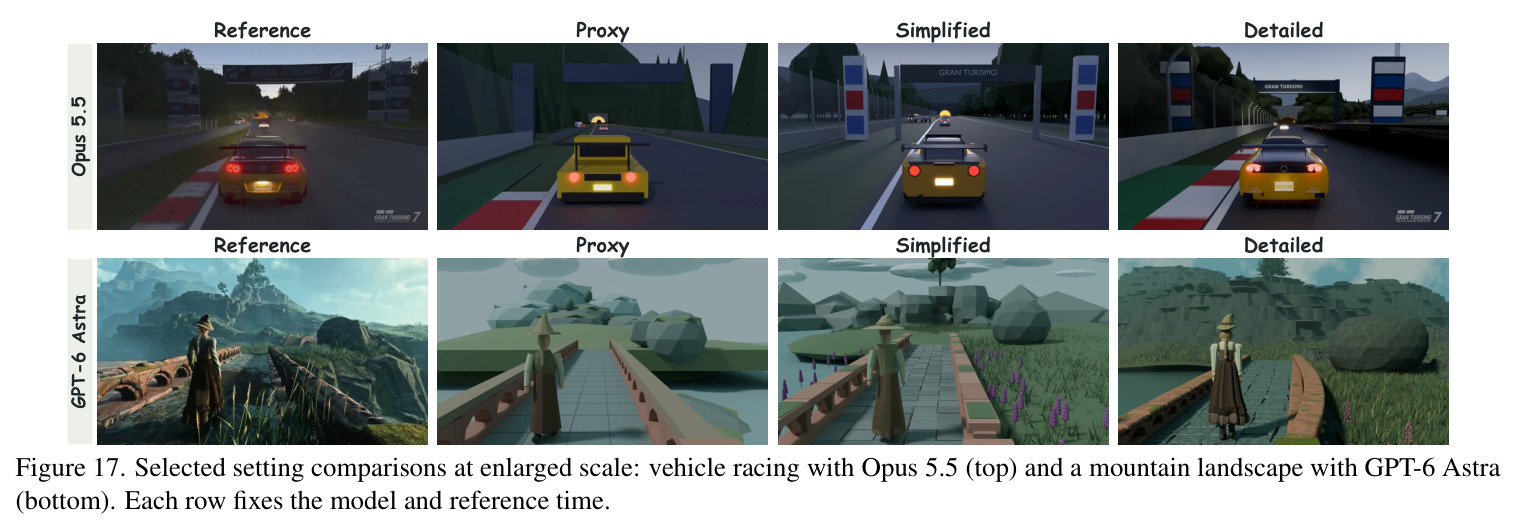
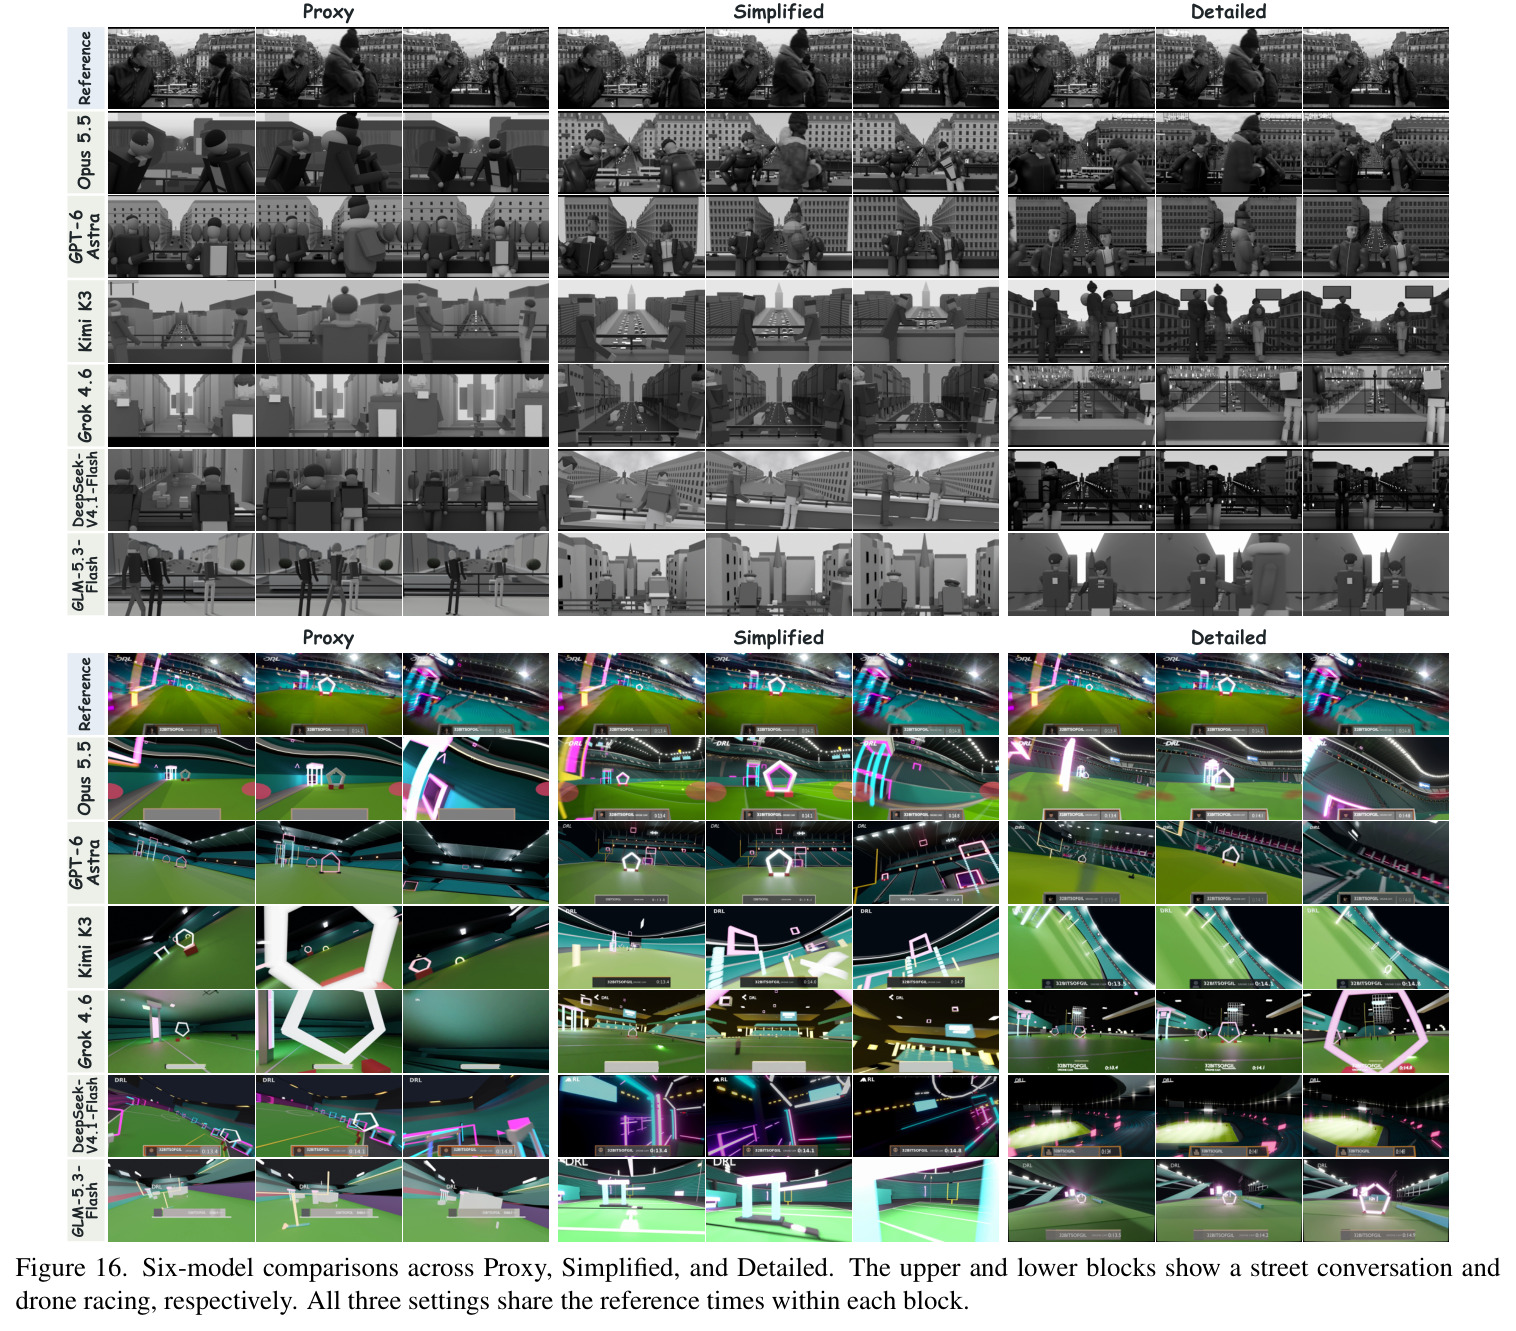
核心创新是"表示设置"这一实验设计。以往视频重建评测把"像不像"当成不可分的整体目标,本文把要求正交分解:几何/外观要求沿 Proxy→Simplified→Detailed 递增(体块比例→类别轮廓与主要结构→实例级局部形状与细节),而空间关系、运动与交互、事件时序、相机行为的要求在三档间逐字不变——相机与动态检查在每档使用相同的类别、主体和时间区间(每档 2,376 个相机检查、703 个动态检查)。这样任何跨设定的分数差异都可归因于外观要求的变化。作者据此得到关键发现:12/13 个配置的相机一致性在 Proxy 下高于 Detailed(均值 +7.4 分),10/13 的动态一致性更高(+4.1 分);但即便在 Proxy 下,GPT-6 Astra 动态也只有 44.6、Opus 5.5 只有 60.8,且 Opus 5.5 跨设定几乎不动(相机 −0.8、动态 −0.5)——简化外观能救相机,救不了动作时序。第二个关键设计是检查单与实体表、帧区间绑定(如示例片段中"手撑地建立支撑"的检查),使失败可归因、可解释,并明确规定设定允许的简化不扣分。
方法步骤详情
流程分五步。第一步数据构建:收集 50 段电影、体育、航拍、游戏等来源的视频,由 GPT-6 Astra 驱动的 Codex 初始标注、多轮人工审核;切出 360 个不超过 2 秒的评测片段,实体表为主体指定固定名字与首现帧。第二步检查单构造:每条检查记录类别、适用设定、涉及主体、起止帧和可判定要求,共 11 类,合计 49,668 项。第三步智能体重建:输入完整视频与设定专属提示词(评测片段与检查单等全部扣留),智能体用 Blender MCP 检查场景、写 Python 建模绑定、配置相机动画、测试渲染、对比参考并修改,交付可编辑工程与重建视频。第四步自动评测:按 $t_c(f) = (o_c + f)/r$ 时间对齐,每请求最多 50 对对齐帧,裁判逐项打 0/0.5/1,聚合先算 $q_{m,s,c,d} = \frac{1}{|I_{s,c,d}|}\sum_{i} y_{m,s,c,i}$,再得维度分 $S_{m,s,d} = \frac{100}{|C_{s,d}|}\sum_{c} q_{m,s,c,d}$。第五步人工验证:1,440 个两两比较、3 人多数投票。
技术新颖性
与最近相关工作相比,新颖性体现在四个层面。任务层面:BVB 只做室内场景,4DCodeBench 研究相机运动极少的物理动态(形变/流体/断裂),SceneActBench 提供资产和参考相机,VisPhyWorld 只给两个关键帧且相机固定——CineRecon 是首个要求从完整真实视频、零资产、零相机参数出发,联合复现场景、动作交互、相机与镜头切换的基准。实验设计层面:三档表示设置把外观要求与动态要求解耦,这种对照机制在同类基准中是首创的,直接产出"简化外观可部分释放相机/动态能力、但动作时序依然失败"的因果性结论。评测协议层面:检查单绑定实体与时间区间、允许的简化不扣分、截断或无效响应记为评测失败而非零分、视觉失败与执行失败分开记录,这些细节大幅提高可复现性与可信度;时间对齐(公式 (2))与帧选择(强制帧+最远点采样、上限 50 对)也有明确算法。验证层面:用 1,440 次人工比较证明裁判与人类在模型排名层面高度一致(总体 ρ=0.951),而不是直接信任单一 VLM 裁判。
实验结果
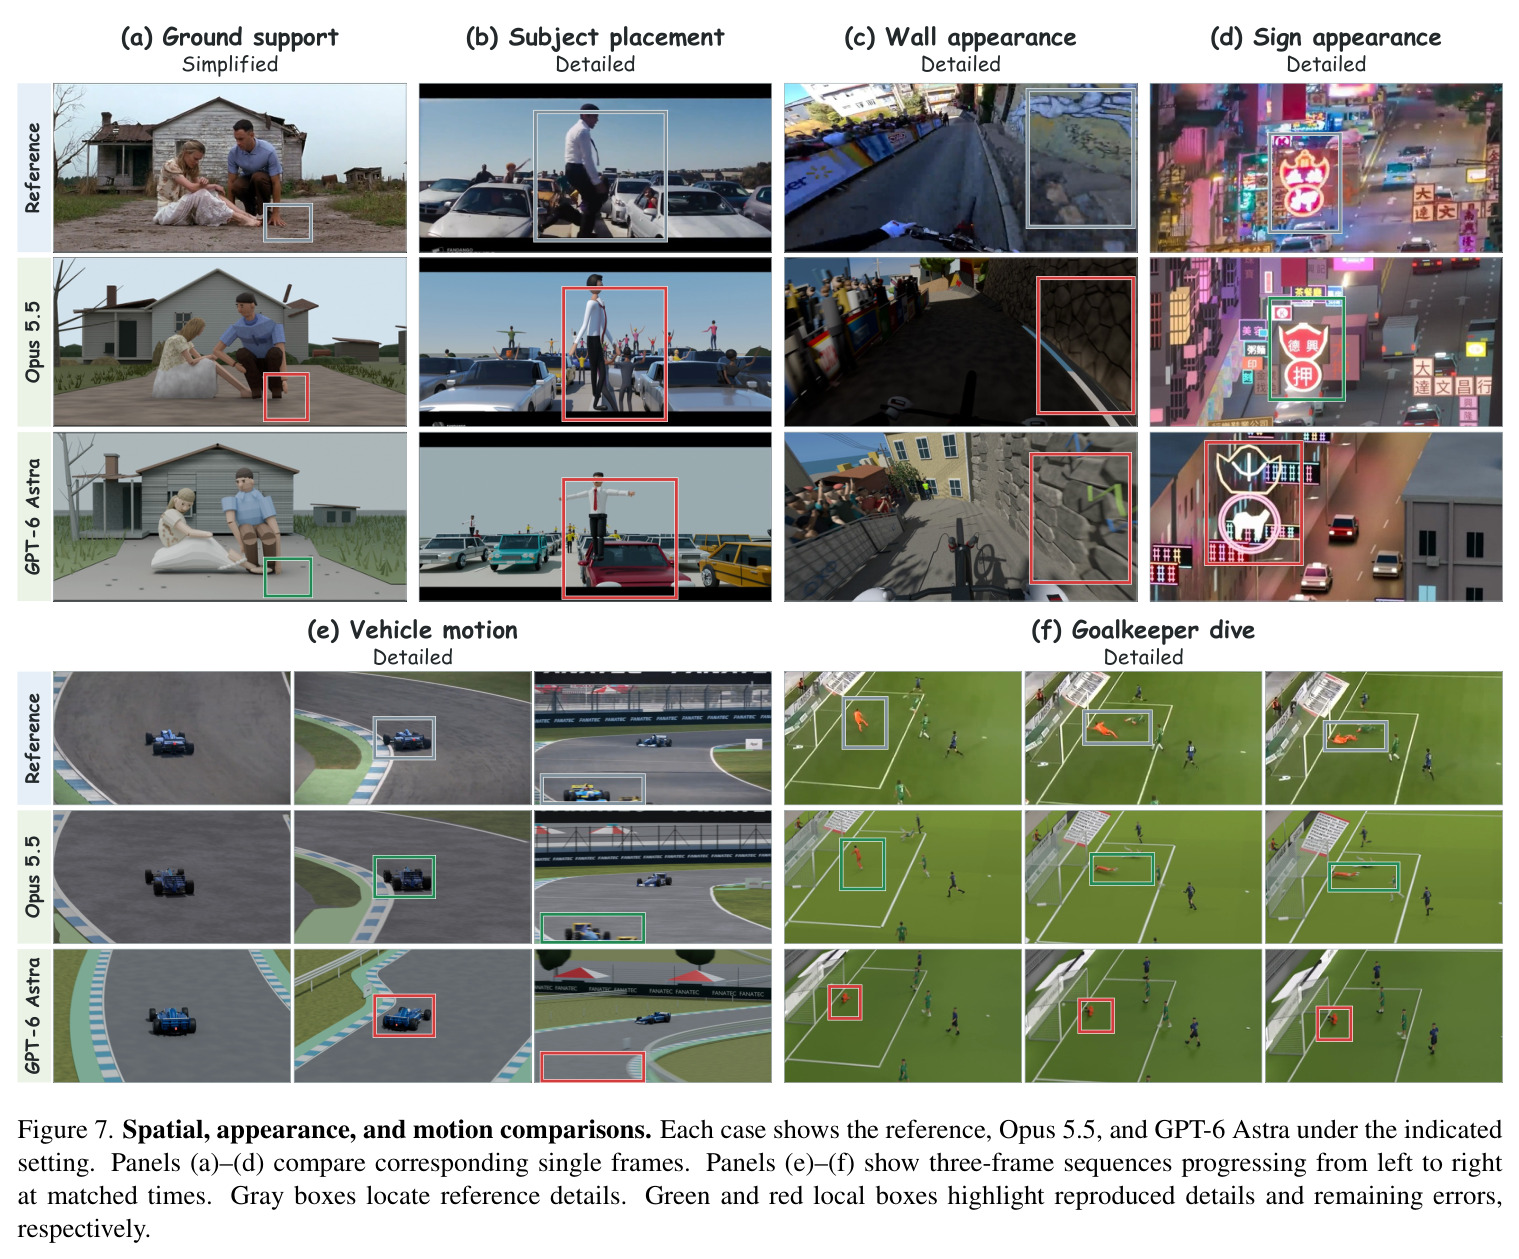
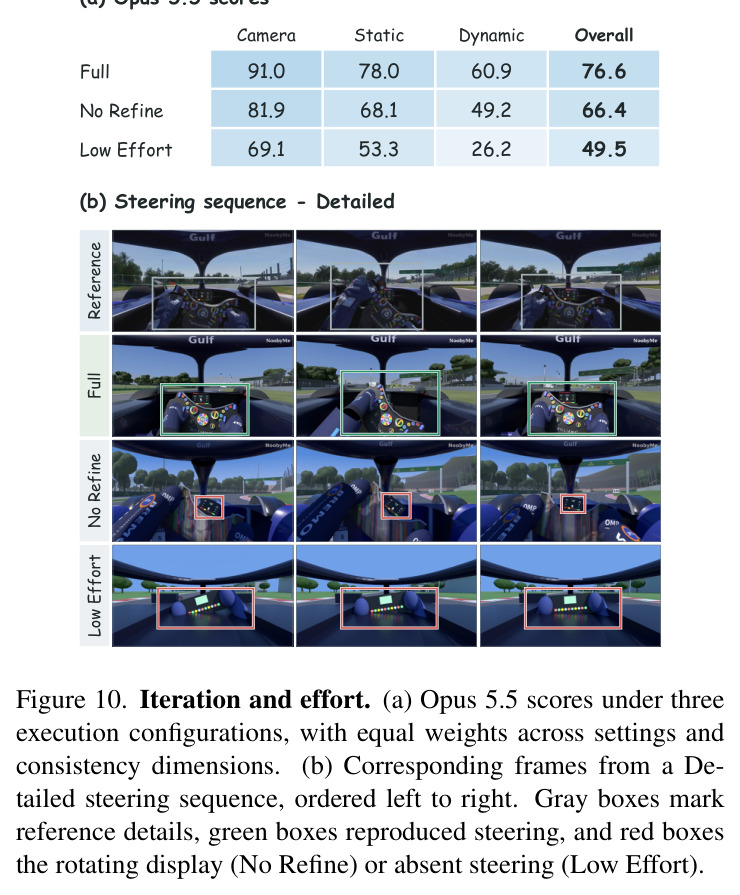
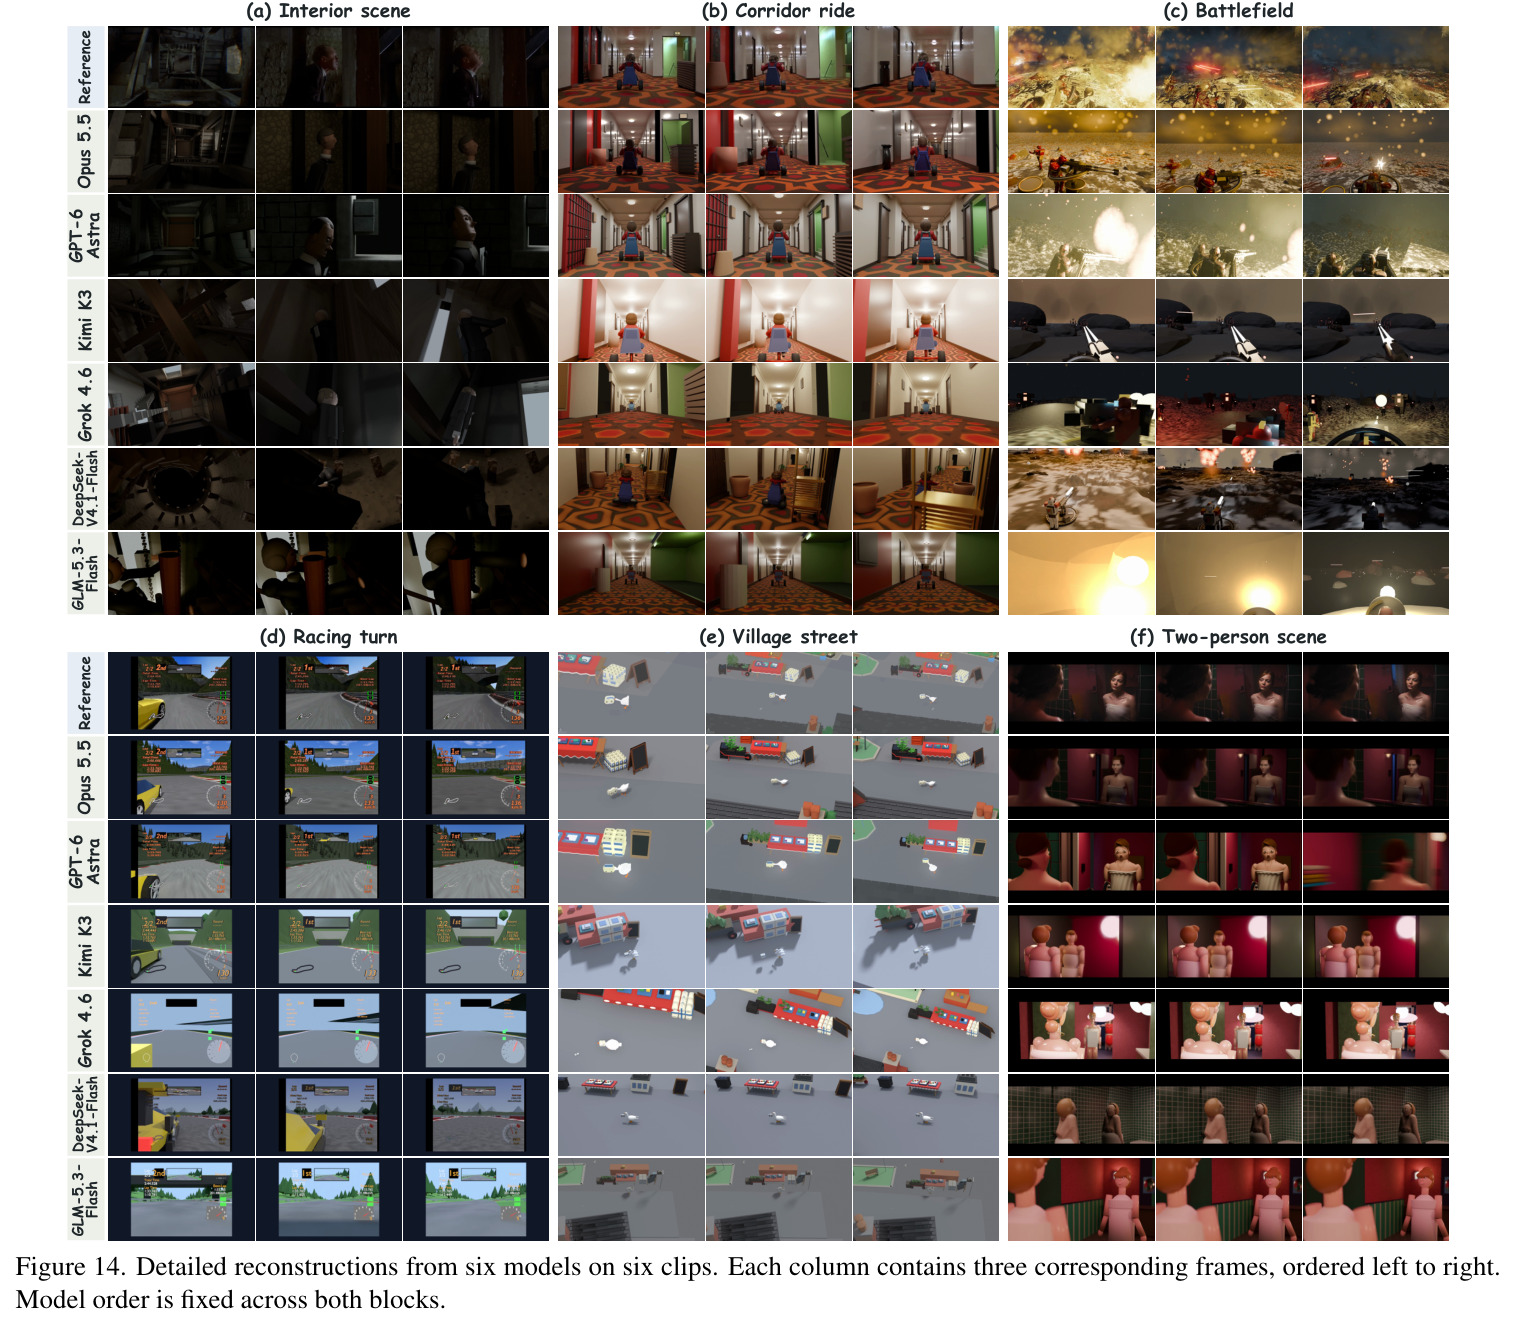
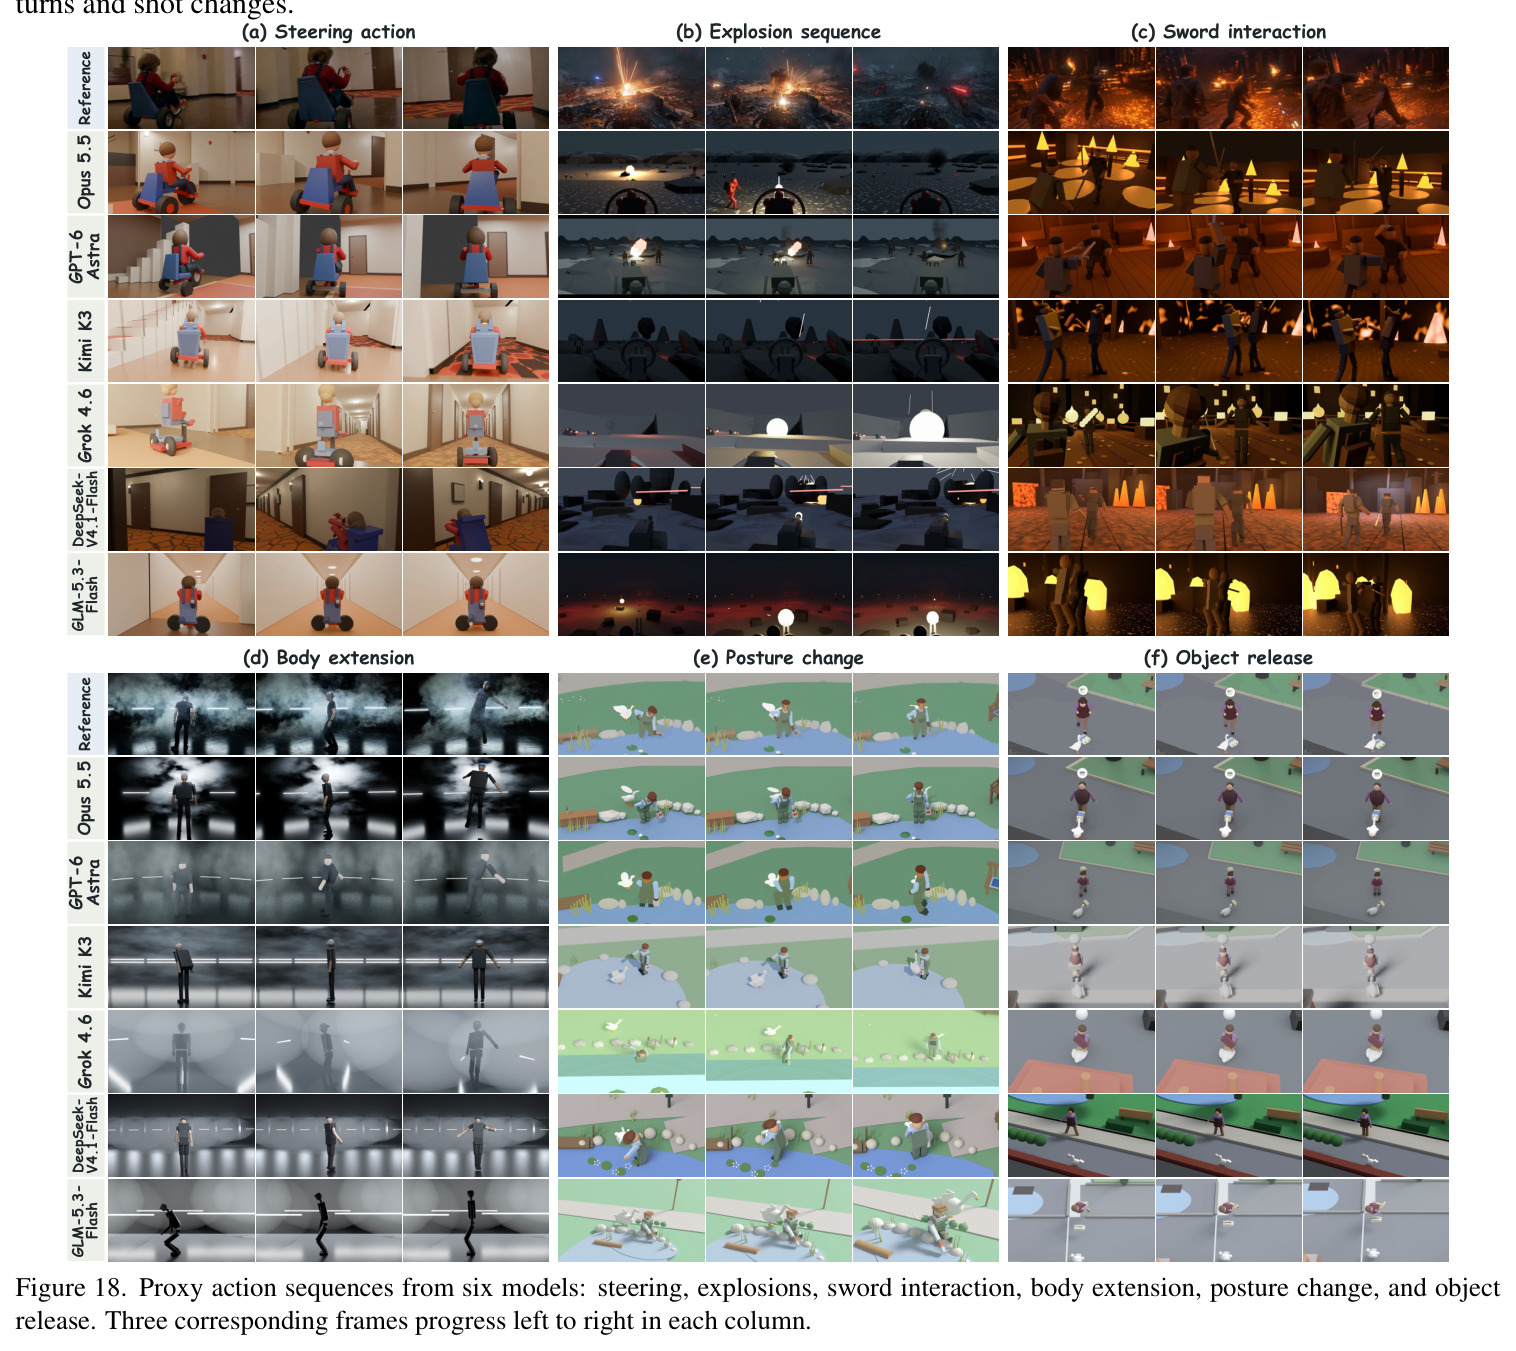
核心发现有五点。其一,排名断层:Opus 5.5 以 Overall 76.6 领先 GPT-6 Astra 的 63.8(+12.8),Gemini 3.1 Pro 垫底仅 20.1。其二,共同短板系统性存在:所有配置都是主体运动高于动作事件(分差 22.2/18.3/15.7)、对象存在高于空间关系(28.3/23.4/22.4)、相机目标高于旋转(35.0/33.1/32.1);动作事件最高分仅 42.7/46.6/48.6,最强模型也无法完整复现具体动作。其三,表示效应:12/13 配置相机一致性 Proxy 高于 Detailed(均值 +7.4),10/13 动态更高(+4.1);GPT-6 Astra 动态从 44.6 降到 38.1,Opus 5.5 几乎不变且 Proxy 动态也仅 60.8——简化外观救得了相机,救不了动态。其四,Detailed 档分化惊人:相机旋转中位数 25.2 vs 最高 74.9,主体运动中位数 27.3 vs 最高 70.3;Opus 5.5 领先 GPT-6 Astra 集中在旋转(74.9 vs 42.1)与动作(48.6 vs 27.2)。其五,迭代与努力是主引擎:去掉修订掉 10.2 分、降低努力掉 27.1 分。人机对齐总体 ρ=0.951,动态维度最低(ρ=0.832)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 完整视频→可编辑场景重建(三设定等权总评) | Overall(0–100,VLM 裁判+人工校验) | Opus 5.5:76.6 | 次优 GPT-6 Astra:63.8 | +12.8 分(约 +20%) |
| 相机一致性(三设定平均) | 维度分(0–100) | Opus 5.5:90.9 | GPT-6 Astra:80.6 | +10.3 分 |
| 动态一致性(三设定平均) | 维度分(0–100) | Opus 5.5:60.8 | GPT-6 Astra:41.1 | +19.7 分(约 +48%) |
| 动作事件复现(Detailed 设定) | 类别分(0–100) | Opus 5.5:48.6 | GPT-6 Astra:27.2 | +21.4 分 |
| 迭代与推理努力消融(Opus 5.5) | Overall(0–100) | Full(高努力+迭代):76.6 | No Refine:66.4;Low Effort:49.5 | +10.2 / +27.1 分 |
| 表示设置效应(13 配置均值) | Proxy 减 Detailed 分差 | 相机 +7.4;动态 +4.1 | 仅 1/13 配置相机例外、3/13 动态例外 | 绝对多数配置在 Proxy 下更高 |
局限与改进
作者承认:即使降到 Proxy 设置,动作时序、接触关系和主体间协调运动仍大量出错,简化外观救不了动态保真;重建对下游视频生成的增益也未验证(原文称 evaluating their effect on downstream generation is a next step)。我的观察有五点:第一,单裁判 GPT-5.6 Sol 评所有模型,包括同门 GPT-6 Astra 的输出,存在潜在供应商偏好,且动态维度人机相关仅 ρ=0.832,动态分数应谨慎引用;第二,检查单由 GPT-6 Astra 驱动的 Codex 初始生成,虽经多轮人工审核,仍可能带入先验偏差;第三,规模有限:50 段视频、360 片段、每档仅 703 个动态检查(相机有 2,376 个),样本稀疏本身解释了相关系数偏低;第四,结果绑定 Blender+MCP 生态和各家原生 harness,分数混合了模型能力与工具链质量,Opus 5.5 的领先有多少来自 Claude Code 难以剥离;第五,可编辑性只通过交付 .blend 隐式保证,未度量编辑迁移能力;视频均短于 24 秒,长视频与群戏未覆盖。
独立分析的弱点
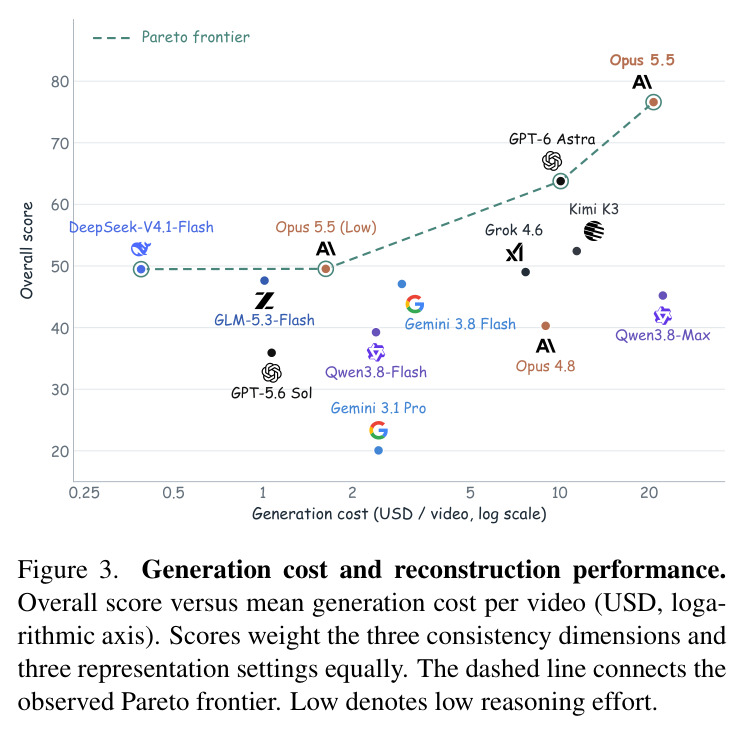
独立分析四个弱点。弱点一:单裁判且存在同源偏置——GPT-5.6 Sol 同时评审 GPT-6 Astra 的输出。改进:采用 3–5 个异源 VLM 裁判集成,报告裁判间一致性,并对同门裁判做留出或加权去偏。弱点二:动态维度证据密度低(每档仅 703 个动态检查,相机有 2,376 个),导致 ρ 只有 0.832、分数方差大。改进:扩充动作密集型视频,把动态检查密度提到与相机同量级,并为动作事件引入更细的相位与时序子项。弱点三:模型与 harness 混杂,Opus 5.5 的领先无法区分是模型强还是 Claude Code 工具链强。改进:增加统一 harness 对照组(所有模型跑同一套最小循环),分离工具链贡献与模型能力。弱点四:可编辑性未被度量——基准声称产出 editable scene,却没有测试编辑质量。改进:增加第二阶段评测,给智能体已重建场景加编辑指令(换相机轨迹、改动作时机、替换主体),度量编辑后重渲染的保真度。另外成本报告偏粗:Figure 3 只有 Pareto 散点,缺少各配置 token 消耗与渲染时长明细。
未来方向
作者明确提出的下一步是评测重建场景对下游视频生成的实际增益,即把 CineRecon 分数当作可控生成的中间指标。基于成果还可延伸:其一,把检查单得分作为奖励信号训练重建智能体——检查项天然稠密、可判定,适合做强化学习或自我反思式迭代优化,尤其针对动作时序(当前最高仅 48.6 分)这一最弱项;其二,引入物理仿真与接触求解器,让支撑/接触关系从视觉模仿变成物理可行解,这正对应 Figure 9 与 Figure 15 中反复出现的手-地、手臂-栏杆接触失败;其三,向长视频、多主体群戏、音画同步扩展,测试事件编排能力;其四,建设统一 harness 与开源 Blender 基线智能体(固定迭代轮数的参考实现),剥离工具链效应并降低复现门槛;其五,把"Codex 初标+人工审核"的检查单生成管线开源并半自动化,以数量级扩大基准规模;其六,与端到端 4D 重建、神经辐射场类方法对比,检验"代码化的可编辑场景"是否是比隐式神经表示更适合可控生成的中间表示。
复现评估
复现难度中等偏上,但协议文档非常完整。论文给出项目主页 cinerecon.github.io,附录 A–E 覆盖数据统计(50 视频、763.59 秒、360 片段、49,668 检查项、合并后 35,836 条记录)、标注规范、三档任务提示词全文、各模型 harness 及精确版本(Codex CLI 0.153.4、Claude Code 2.1.280/2.1.278 等)、裁判提示词、帧选择算法、聚合公式和完整分数表。环境要求:Linux GPU worker、Xvfb 下运行图形化 Blender 5.2、Cycles CUDA 渲染,单卡即可。主要成本在 API:Figure 3 显示单视频生成成本约 0.25–20 美元(对数轴),完整评测为 13 配置 × 3 设定 × 50 视频 = 1,950 次重建,外加裁判调用与 1,440 次人工标注,总预算在数千美元量级。主要难点是重新实现智能体编排与时间对齐评测管线;若作者发布数据集与检查单,可跳过标注只复跑评测,难度大幅下降。
论文图表
(a) 参考序列示例覆盖人体运动、人-物交互、相机运动、变焦对焦、镜头切换;(b) 每视频标注主体数分布(最多 ≥5);(c) 视频时长分布 0–25 秒;(d) 视频级覆盖统计:相机运动 94%、主体交互 58%、镜头切换 18%。
完整展示数据集构成与难度来源,说明基准确实覆盖了动态、交互与运镜的多样性。
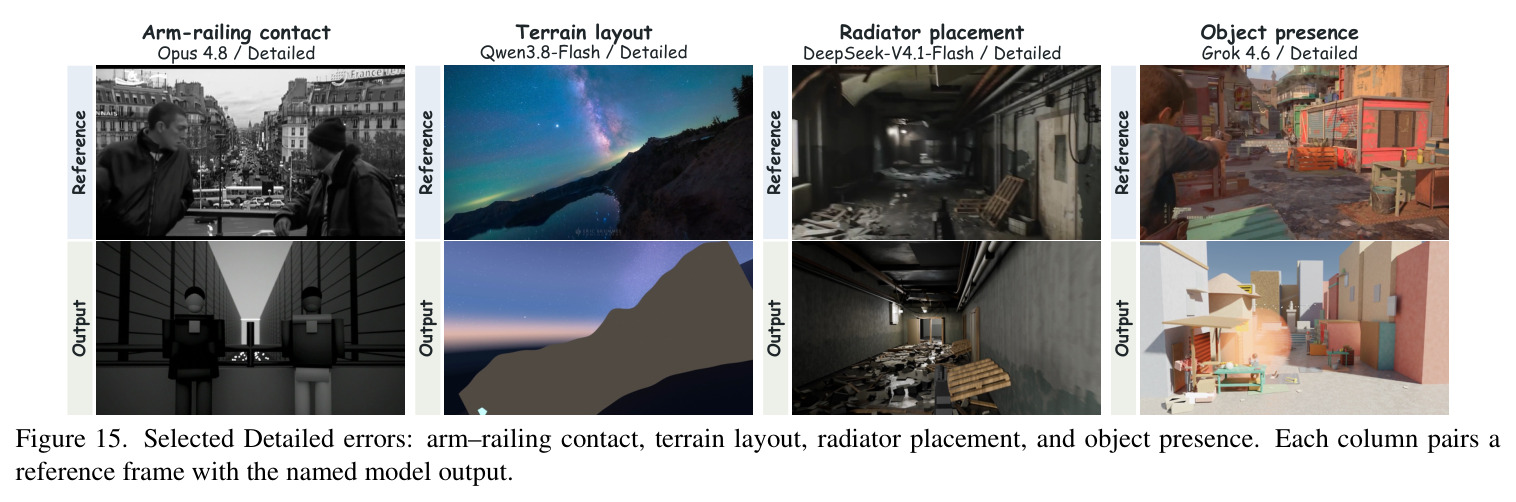
四个 Detailed 典型错误:手臂-栏杆接触失败、地形布局错误、暖气片位置错误、对象存在性缺失,每列给出参考帧与指定模型输出。
集中展示具体失败模式,说明即使最强模型在接触关系和空间布局上仍有硬伤,是局限性分析的证据。
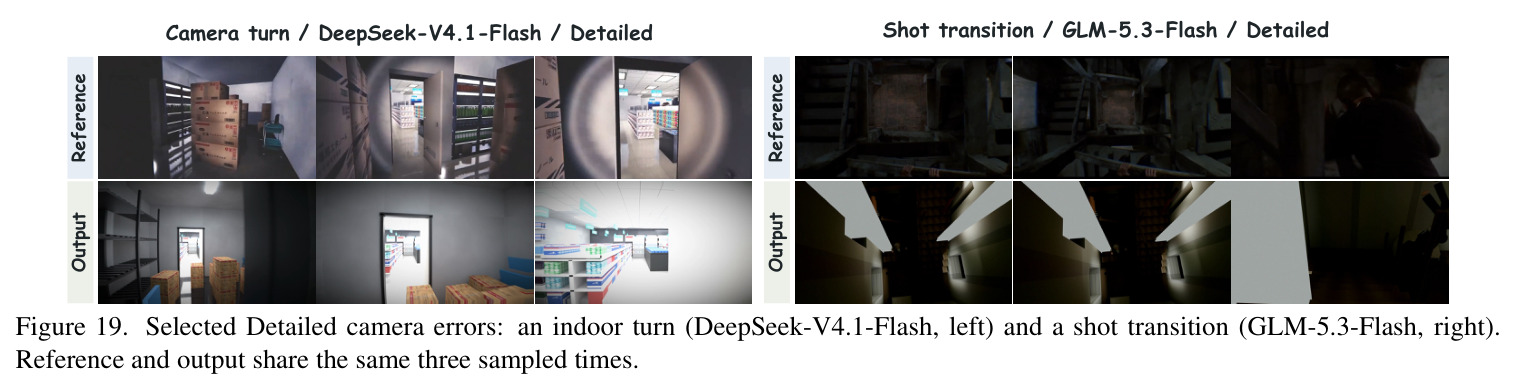
两个 Detailed 相机错误案例:室内转身(DeepSeek-V4.1-Flash)与镜头切换(GLM-5.3-Flash),参考与输出共享三个采样时刻。
说明相机旋转与镜头切换虽整体分数尚可,但特定模型仍有明显失败,细化对相机一致性的理解。