一日十年:从人类软件演化中合成智能体原生接口 A Decade in a Day: Synthesizing Agent-Native Interfaces from Human-Oriented Software Evolution
用软件演化找出智能体友好接口三属性,自动合成接口使成功率升、token省73%
前置知识
LLM 智能体(Agent)
以大语言模型为核心、通过调用工具循环决策的系统:模型接收任务指令,生成行动(执行代码、调用 API 等),观察环境返回结果,再决定下一步,直至完成任务。其能力高度依赖工具接口是否清晰、可发现、可验证,每次试错都消耗 token 与时间预算。
本文研究的正是接口性质对智能体表现的影响,理解智能体的试错循环与 token 成本结构,才能读懂为什么可发现性和可观测性如此重要。
GUI / SDK / CLI 三类接口
GUI(图形界面)面向人类用户,靠视觉定位控件并解读连续视觉反馈;SDK(软件开发包)面向开发者,暴露对象模型与底层函数,要求读文档、写代码、调试低层调用;CLI(命令行)以任务级结构化命令封装功能。三者抽象层级递增,但大多数桌面应用只提供前两类且 CLI 覆盖面窄。
论文的核心论点是这些接口都为人类而非智能体设计,三者的抽象层级对比是理解问题动机与 ANIS 原子命令/目标级命令设计的基础。
执行式验证(artifact verifier)
用确定性脚本检查智能体最终保存的产物文件(文档、幻灯片、3D 场景、矢量图等)是否满足任务要求,返回通过或失败;可以是结构化产物检查,也可以是固定容差下的像素级比较。区别于依赖提示词、判定不稳定且难复现的 LLM-as-judge。
DeskIF-Bench 每个任务都自带这种校验器,它是跨版本比较的前提,也是 ANIS 判断命令是否产生持久效果(保存重开产物)的基石。
pass@k 评估指标
每个任务从相同初始状态独立尝试 k 次(本文 k=3),只要至少一次通过产物校验即计为该任务成功,整体成功率按任务数加权聚合。用于降低智能体运行随机性对结论的干扰,是智能体评测的常用口径。
本文所有成功率数字(如 68.5%、74.5%)均为 pass@3 口径,理解该指标才能正确解读各实验表格之间的比较。
软件演化与版本迭代
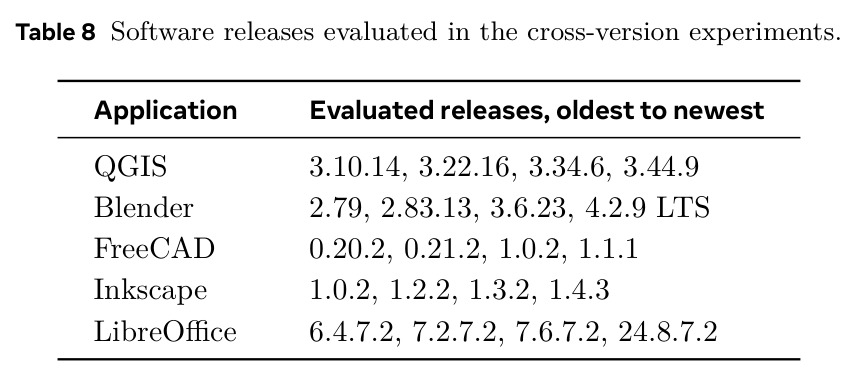
应用随时间持续发布新版本:核心功能相对稳定,但界面因人因工程压力和新特性而不断被重塑,例如 QGIS 的处理工具箱从 272 个算子增长到 440 个,FreeCAD 1.0 引入 App::VarSet 显式参数对象。历史版本因此构成一组真实的接口变体。
本文把版本历史当作天然实验场:固定任务、智能体与校验器,只改软件版本,即可把性能变化归因于有文档可查的接口改动,这是全文方法论的核心假设。
MCP(Model Context Protocol)
让模型发现和调用外部工具的标准协议,相关生态工作集中在改进已有操作的 schema 描述、参数校验、工具选择与按需加载,使智能体更容易浏览并调用既有功能,但不改变操作本身的抽象层级。
论文在相关工作部分与 MCP 路线对比,并强调 ANIS 生成的原子命令与传输无关,可以通过 CLI 或 MCP 暴露,理解这一定位有助于区分两条技术路线。
研究动机
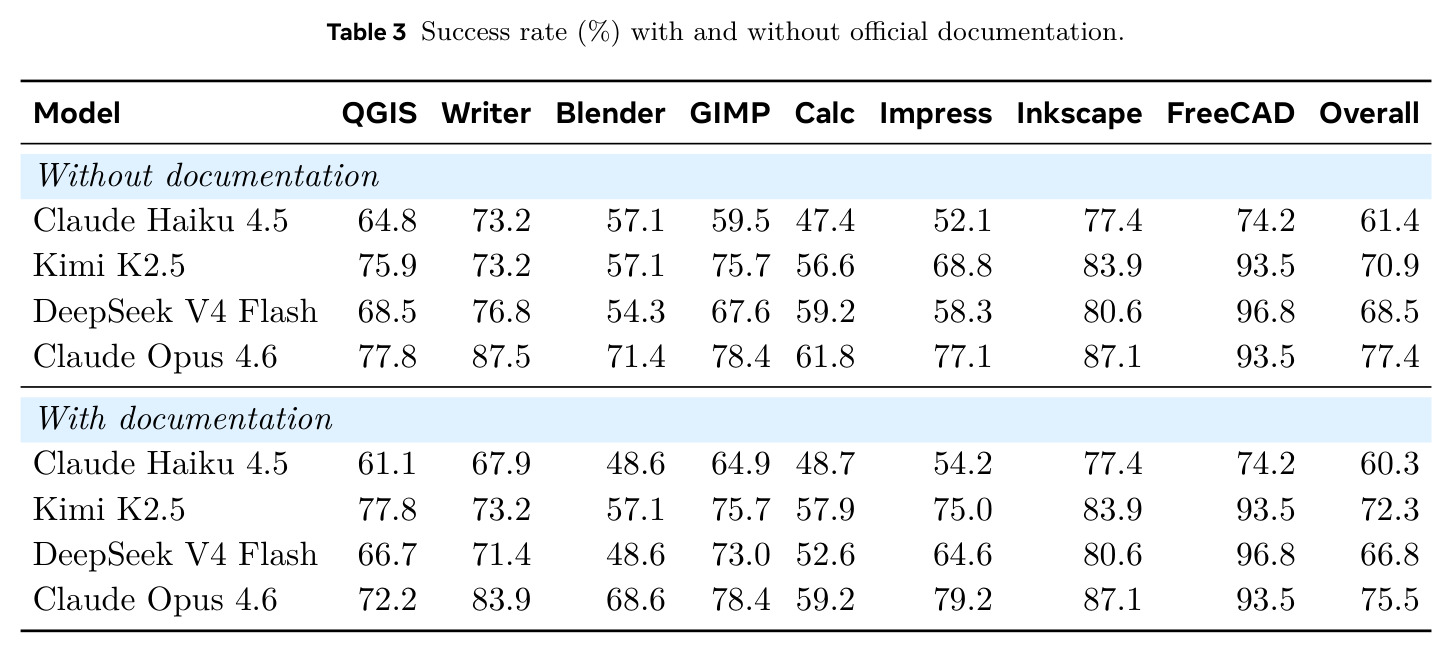
LLM 智能体正成为桌面软件的一类新用户,但现有接口都不是为它们设计的。GUI 假设用户能看图定位控件、解读连续的视觉反馈;SDK 假设开发者会查文档、理解对象模型、写代码并调试底层调用;大多数桌面应用又没有覆盖完整功能的 CLI。论文用 QGIS 举例:让智能体在 QGIS 3.10 里制作一张按固定宽度分级的各国 GDP 地图,它必须读取 177 个 GDP 值、自己推导 11 个分级区间、逐个拼装渲染器调用,结果在 33 轮、66.2 万输入 token 后因 addClassRange() 参数类型错误而失败。轨迹分析显示智能体把 24.1%(Kimi K2.5)到 36.2%(Claude Haiku 4.5)的输入 token 花在探索、查参考和试探接口上。更糟的是,附带官方文档并无稳定收益:四个骨干模型中三个(Haiku、DeepSeek、Opus 4.6)成绩反而分别下降 1.1、1.7、1.9 个百分点。此外对 581 条“智能体自认完成但产物未通过校验”的轨迹审计表明,接口普遍缺乏让智能体读回并自查结果的手段。
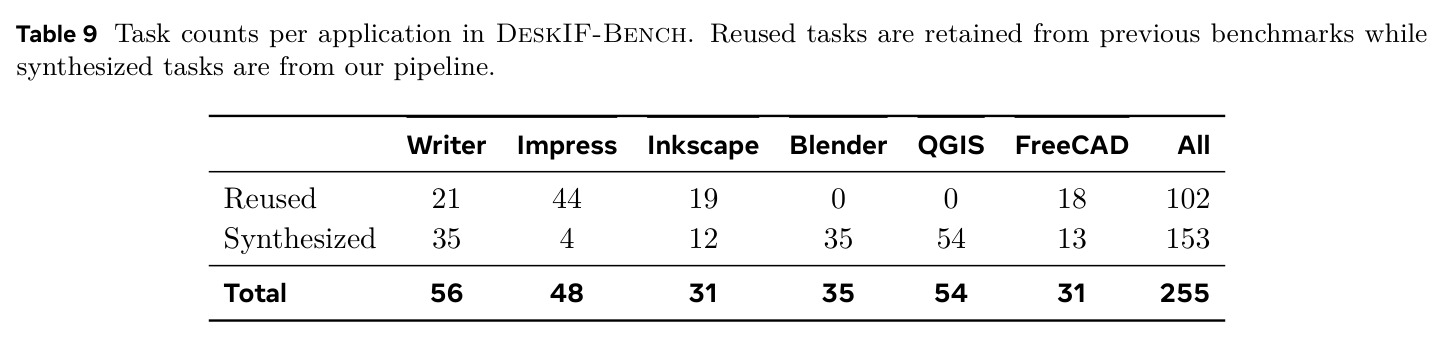
本文的目标是论文要回答一个根本问题:什么样的接口才算对智能体友好?为此设定两个目标。第一,建立受控实验把“接口”本身隔离为实验变量:构建 DeskIF-Bench,含 255 个带可执行校验脚本的任务,覆盖 Writer、Impress、Inkscape、Blender、QGIS、FreeCAD 六款应用和办公、2D 图形、3D 建模、地理信息、CAD 五个领域,每应用至少 30 个任务;任务全部指定应用产物级别的结果(而非缩放比例、窗口状态这类瞬时界面状态),并对每个评估版本做可行性筛查,使同一任务能原封不动地跨版本复用。第二,把实验发现的接口规律自动化:设计 ANIS 框架,在不改动应用本身的前提下,为任意已安装应用自动合成满足这些性质的接口,并在扩展到 368 任务、8 应用的基准上与原生 SDK 和 CLI-Anything 正面对比,目标是在成功率和 token 成本上同时超越现有接口。
与已有工作不同的是,已有工作的切入角度要么是“固定接口、改进智能体”:OSWorld、Windows Agent Arena 等基准考察计算机使用智能体的能力,Agent S 等系统优化同屏操作、快捷方式与记忆;要么是“包装现有接口”:MCP 生态改进已有操作的 schema 与检索,CLI-Anything 直接把应用包装成命令行。这些路线都没有回答“接口本身的哪些性质影响智能体表现”。本文的独特之处有二。其一,把软件演化当作自然实验:同一应用跨版本核心功能稳定而界面被真实的可用性压力持续重塑,固定任务、智能体脚手架与校验器、只改安装版本,就能把性能变化归因于有据可查的接口改动,避免手工构造变体时夹带作者自己的偏见。其二,不止于分析还动手合成:从运行中的应用自动挖掘能力、经应用自身验证后重构为智能体原生命令,把“等软件用几十年慢慢进化”变成“一天之内合成”,这也是标题“一日十年”的含义。
核心方法
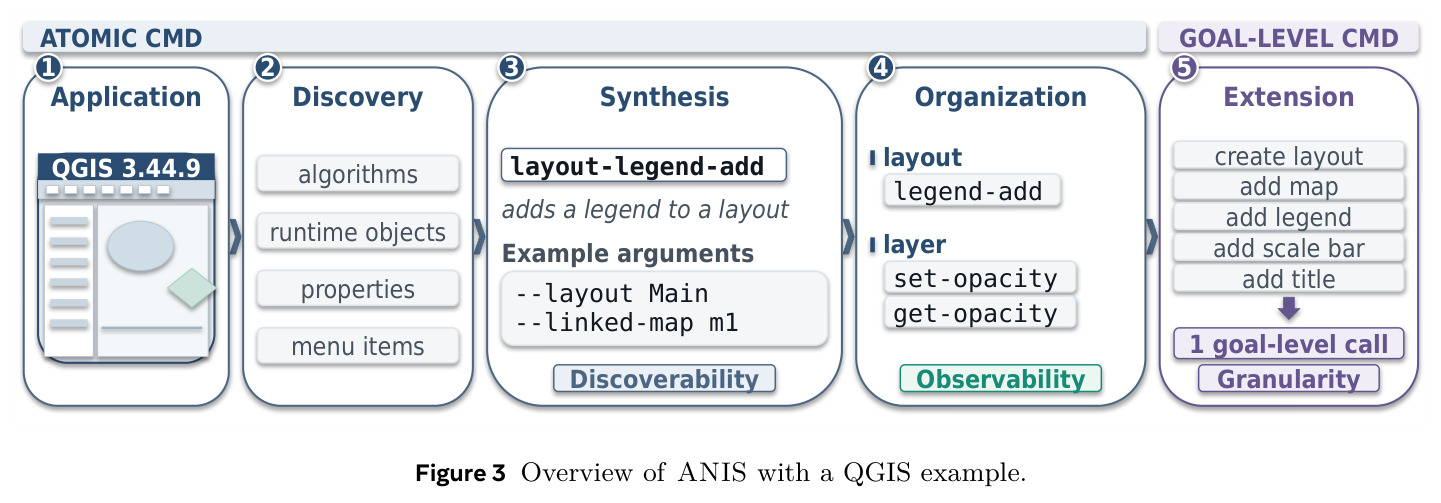
论文的工作分三步。第一步构基准:DeskIF-Bench 的任务来自两路——从 OSWorld 与 OpenComputer 过滤复用 102 个(剔除只改界面呈现或瞬时状态的任务),另用作者智能体流水线合成 153 个;作者智能体配备应用专属技能和特权库(如用 trimesh 为 Blender 构造参考产物),被评估的智能体则没有这些特权,形成能力不对称以保证基准难度与区分度。每个任务绑定确定性脚本校验器(结构化产物检查或固定容差像素比较),且必须接受参考产物、拒绝任务相关扰动。第二步做实验:用开源、模型无关的 OpenCode 脚手架,配 Claude Haiku 4.5 与 DeepSeek V4 Flash 两个骨干,在每款应用的 4 个历史版本上按 pass@3 口径(每任务独立试 3 次、任一次通过即成功)评测,共 12 个模型×应用序列。第三步建 ANIS:构建期做能力发现(注册算子、对象内省、菜单三源合并)与命令合成(只保留保存重开后效果可验证的能力),按产物对象组织原子命令;运行期把至少复现 3 次的命令子序列升级为经重放验证的目标级命令。
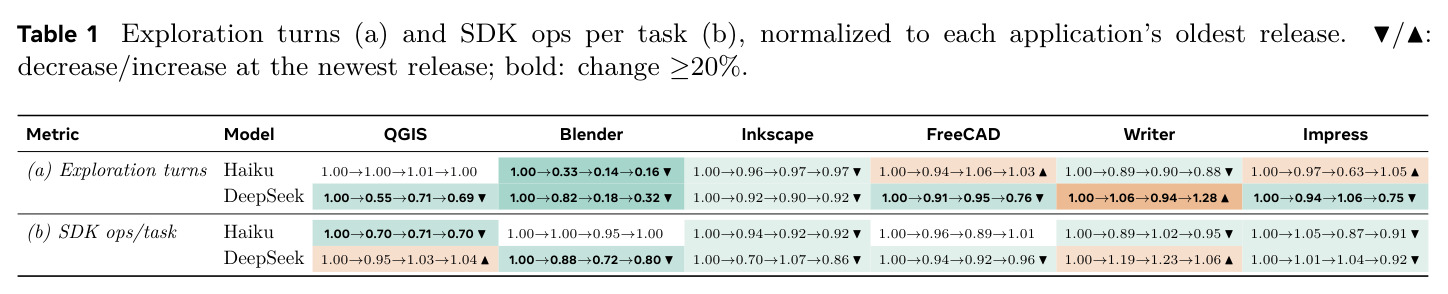
核心创新是把“接口”从实验常量变成实验变量和一等设计对象。直觉是:人类用户是软件几十年演化的产物,而智能体刚出现,接口欠它的债可以用工程一次性还清。论文从版本演化中提炼出三个性质:可发现性(运行时可枚举操作、语义与参数描述清楚,QGIS 3.10 到 3.44 每个函数的运行时描述平均增长 20%)、粒度(操作对齐常见用户目标,QGIS 处理工具箱从 272 个算子涨到 440 个,Haiku 平均调用链从 30.4 降到 21.2)、可观测性(能以修改时的抽象层级读回产物状态——这是所有版本都欠缺的,581 条失败轨迹中 26.9% 缺乏独立的产物读回)。与依赖文档的路线本质不同,ANIS 的能力发现完全以运行中的应用为准,每条命令的实现都先在真实应用上执行过、且保存重开产物可验证效果后才发布;每个可写属性尽量配一个读命令;目标级命令不预先设计,而是从真实使用流中按需合成,并用干净产物副本重放校验后才上线。
方法步骤详情
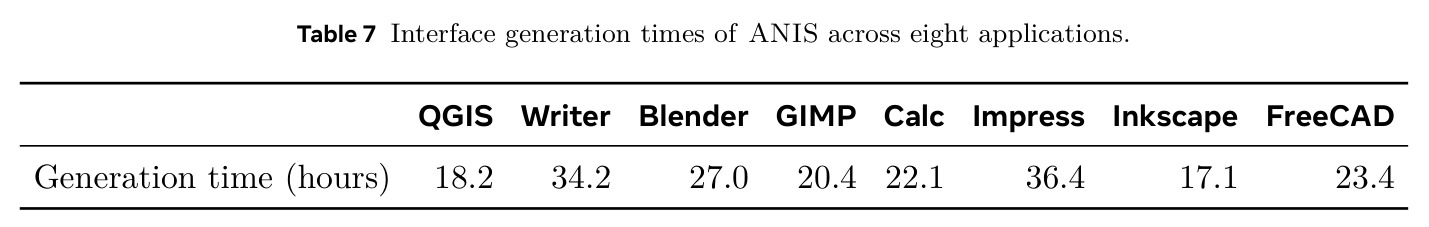
第一步任务构建:作者智能体从官方教程与社区讨论提炼应用级目标,写出指令、构造参考产物与校验器;只保留产物级结果的任务并去重;逐版本做可行性筛查,剔除因功能缺陷而非接口限制导致无法完成的提案。第二步跨版本实验:固定 OpenCode 脚手架、种子文件、工具权限、时间预算与校验器,只改安装版本(如 QGIS 3.10.14→3.44.9),pass@3 聚合成功率;轨迹指标只在四版本全成功的模型×任务对上统计。第三步 ANIS 构建期:注册算子、对象内省、菜单三源合并收集候选能力(召回优先),经实际执行区分“持久修改产物/暴露状态”与“瞬态机制”类能力;LLM 依据运行时参数、类型与默认值构造候选调用,执行通过且保存重开后效果可验的才固化为原子命令(读属性/写属性/调用操作),按产物对象命名分组、先摘要后规格,单应用生成需 17.1–36.4 小时。第四步运行期:记录原子命令序列,子序列在至少 3 个请求复现且共享产物级子目标时,由模型命名并参数化为目标级命令,先在干净副本上重放验证再发布。
技术新颖性
技术新颖性体现在四个对比上。对比 OSWorld 类工作:它们固定接口改智能体,本文固定智能体改接口,首次把接口设计隔离为受控实验变量,并归纳出可操作的三性质。对比 MCP 工具链:MCP 是让已有操作更容易被发现和调用,ANIS 则合成经应用自身验证的原子操作、为可写属性单独暴露读状态命令、返回可行动的错误信息,且产物与传输无关(可走 CLI 或 MCP 发布)。对比 CLI-Anything:在双方都覆盖的应用上 ANIS 暴露的命令多 20 倍以上,CLI-Anything 失败任务的 98.7% 源于缺命令、仅 1.3% 是有命令可用时的智能体失误,说明接口覆盖与验证才是成败关键而非命令行形态本身。对比手工接口适配:ANIS 不需要任何先验的应用 API 知识,全部证据来自运行时;目标级命令按需合成的设计也避免了枚举所有组合(那只会产生大量无人需要的序列),只从使用流中提炼复现至少 3 次且共享产物级子目标的组合,发布前还有重放验证兜底。
实验结果
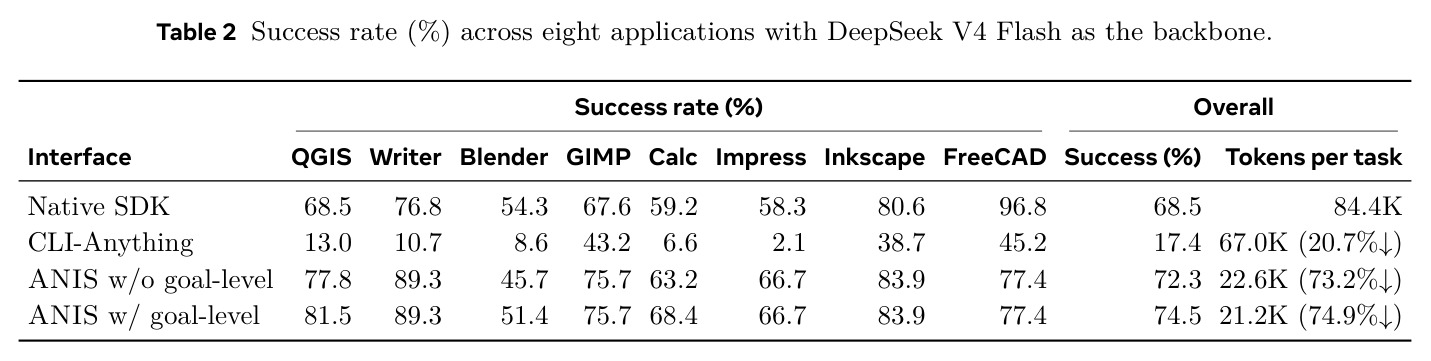
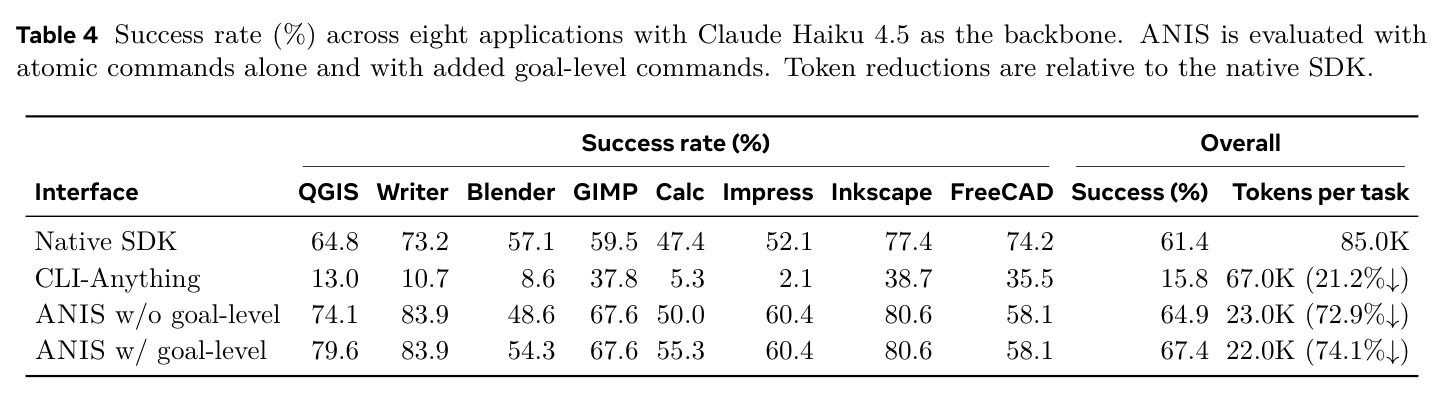
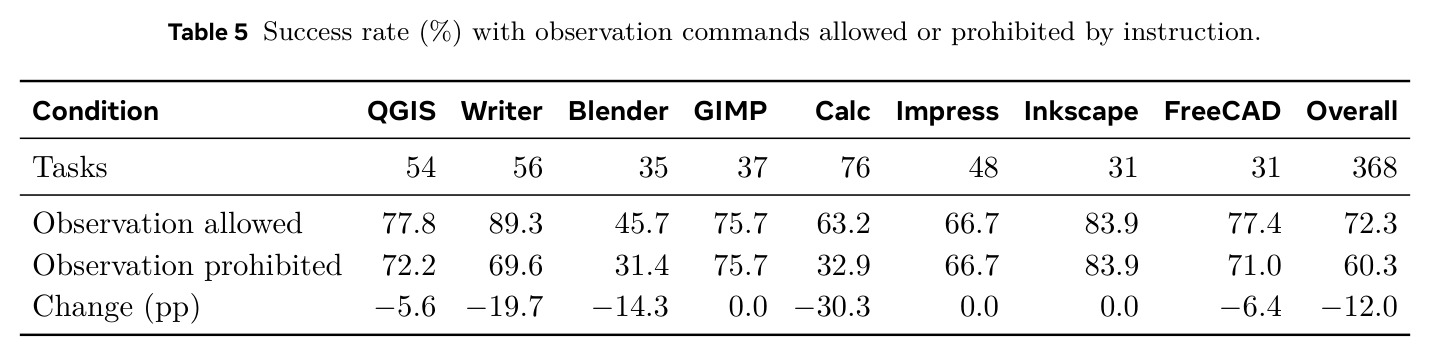
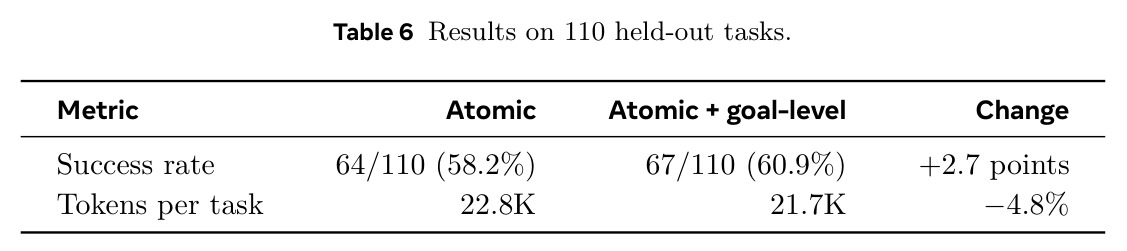
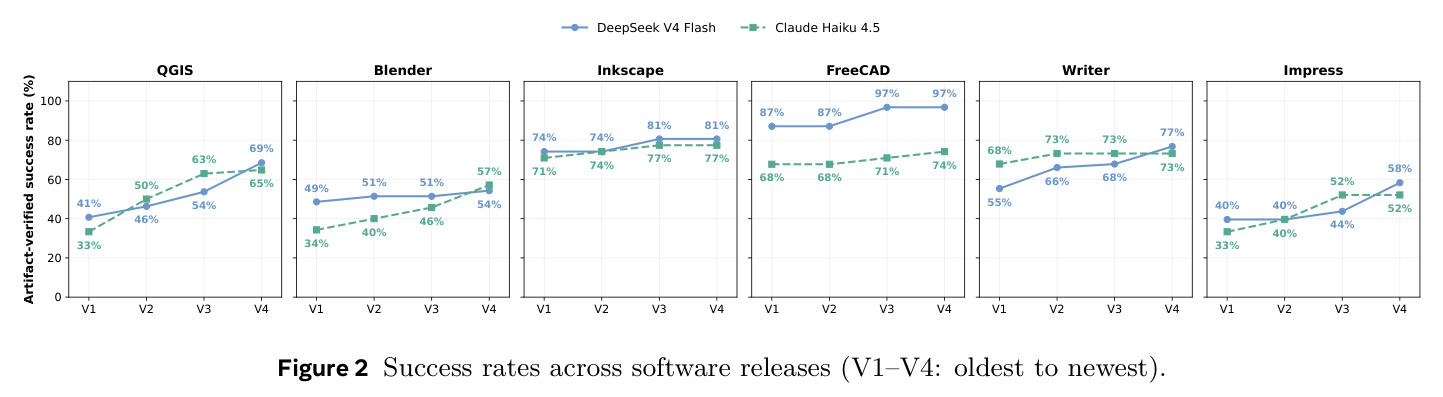
跨版本实验:2 骨干 × 6 应用共 12 个序列中最新版本全部胜出。QGIS 提升最大,Haiku 33%→65%、DeepSeek 41%→69%;Impress 33%/40%→52%/58%;Haiku 在 QGIS 的平均调用链从 30.4 降到 21.2,Inkscape 多页导出从 101 轮 180 万 token 降到 30 轮 11.9 万。ANIS 主实验(368 任务、8 应用、pass@3,DeepSeek):原生 SDK 68.5%,原子命令 72.3%(+3.8pp),加目标级命令 74.5%;CLI-Anything 仅 17.4%;每任务 token 从 84.4K 降到 22.6K/21.2K,即 $(84.4-21.2)/84.4 \approx 74.9\%$ 的降幅。Haiku 同序:61.4%→64.9%→67.4%,token 85.0K→22.0K,证明增益来自接口而非模型。消融:禁用观测命令使成功率 72.3%→60.3%(−12.0pp),其中 Calc −30.3、Writer −19.7、Blender −14.3。目标级命令留出评测:7:3 划分后 110 个留出任务 58.2%→60.9%(+2.7pp),token 再降 4.8%。例外:FreeCAD(77.4% vs 原生 96.8%)与 Blender(45.7% vs 54.3%)低于原生 SDK,因隐式前置条件导致部分能力未通过验证门槛。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| DeskIF-Bench 扩展评测(368 任务、8 应用) | pass@3 成功率(%,DeepSeek V4 Flash) | 74.5(ANIS 含目标级命令) | 68.5(原生 SDK)/ 17.4(CLI-Anything) | 较原生 SDK +6.0pp,较 CLI-Anything +57.1pp |
| DeskIF-Bench 扩展评测(368 任务、8 应用) | pass@3 成功率(%,Claude Haiku 4.5) | 67.4(ANIS 含目标级命令) | 61.4(原生 SDK)/ 15.8(CLI-Anything) | 较原生 SDK +6.0pp |
| 每任务在线输入 token 成本 | 平均 token/任务 | 22.6K(原子)/ 21.2K(含目标级) | 84.4K(原生 SDK) | 降低约 73.2%–74.9% |
| 跨版本演化实验(QGIS,4 个版本) | pass@3 成功率 | 最新版 65%(Haiku)/ 69%(DeepSeek) | 最老版 33%(Haiku)/ 41%(DeepSeek) | +32pp / +28pp(12 个序列中新版全胜) |
| 观测命令消融(368 任务) | pass@3 成功率 | 72.3%(允许观测) | 60.3%(禁止观测命令) | 观测命令贡献 +12.0pp |
| 目标级命令留出评测(110 个留出任务) | pass@3 成功率 | 60.9%(原子+目标级) | 58.2%(仅原子命令) | +2.7pp,token 降 4.8% |
局限与改进
作者承认的局限:其一,ANIS 在 FreeCAD 和 Blender 上低于原生 SDK(77.4% vs 96.8%、51.4% vs 54.3%),原因是能力发现虽穷尽、但验证会拒绝前置条件隐式的操作——FreeCAD 依赖关联草图与建模特征、Blender 依赖场景对象、选区与编辑模式的协同,28.6% 的 FreeCAD 失败源于缺少必需命令。其二,目标级命令规模很小(8 应用仅合成 10 条),因为命令从使用流中来,初期轨迹池有限。其三,轨迹指标只在四版本全成功的任务对上统计,失败轨迹的轮数与链长不可比。我自己的观察:主研究仅 2 个骨干模型(附录扩到 4 个),且都经 SDK 型接口评估,视觉类产物仅以固定容差像素比较间接覆盖;255 个任务中 153 个由 LLM 合成,校验器质量依赖“接受参考、拒绝扰动”的双重检验,仍可能存在判据偏差;pass@3 会掩盖运行间方差;单应用接口生成 17.1–36.4 小时且应用升级后需重新验证,维护成本未被讨论。
独立分析的弱点
独立分析几个弱点。第一,验证门槛与隐式前置条件的冲突是结构性的:ANIS 靠“先执行后验证”保证命令可靠,但 FreeCAD/Blender 这类对象关系隐式的应用会因此丢失能力,改进方向是让合成器学习常见对象构造模板(如先建草图再建特征、先设编辑模式再操作),自动补齐依赖前置链。第二,可观测性承诺打了折扣:只有当应用本身存在读访问器时 ANIS 才能配对读命令,QGIS 的 setAngle 没有 angle() 读器时它同样无能为力,可探索用保存前后的产物快照 diff 作为通用观测通道。第三,目标级命令挖掘有冷启动问题:论文用已解任务轨迹模拟请求流,真实部署初期没有流量可用,可考虑用任务集先验或人机协作提议来 bootstrap。第四,CLI-Anything 基线由更强的 Opus 4.8 经 Claude Code 构建,虽对双方一致,但缺其他基线实现与 GUI 智能体(如 OSWorld 风格视觉操作)对照。第五,benchmark 大量任务由 LLM 生成并自验,若参考产物与扰动集覆盖不全,可能高估或低估任务难度。
未来方向
论文明确提出的后续方向:目标级命令序列目前只用于评估、尚未正式发布,作者计划以传输无关的方式(CLI 或 MCP)公开这一层。基于成果可延伸的方向包括:一是自动合成缺失的读访问器,例如通过产物快照对比或符号执行为写操作生成观测命令,彻底关闭可观测性缺口;二是接口的增量维护机制,应用升级后只对受影响命令重验证,把 17–36 小时的生成成本摊薄成持续集成式的例行检查;三是把可发现性、粒度、可观测性三性质推广为 Web 服务与移动 App 接口的审计清单;四是把 ANIS 原子命令层与 GUI 智能体结合成混合控制器——状态不确定时读产物、命令可用时直调、否则回退视觉操作;五是目标级层的在线持续学习,随真实请求增长自动扩充命令库并做回归测试;六是研究接口性质与模型能力的交互:更强模型是否更需要高粒度命令,弱模型是否更依赖可观测性。
复现评估
复现条件总体较好。代码、DeskIF-Bench 全部任务及校验器、评估脚本开源在 github.com/co-evolve-lab/ANIS,数据集在 huggingface.co/datasets/SimAlan/DeskIF-Bench;校验器全部是确定性脚本,判定可人工审计,避免了 LLM 裁判的不可复现性;脚手架 OpenCode 开源且版本可固定。成本方面:接口生成每应用需 17.1–36.4 小时墙钟时间(由编码智能体驱动,论文未公布 ANIS 生成所用模型;两个基线接口统一用 Claude Code 加 Opus 4.8 生成);主实验需为 6 款应用各安装 4 个历史版本,并跑 pass@3(255 任务 ×3 次 ×4 版本 ×2 模型),再加 368 任务的接口对比与消融,token 与 API 花费可观,估计需要数十到数百美元预算和可容器化的多版本桌面软件沙箱。整体难度中等:环境搭建最费时,核心管线有附录 J 的命令组织与目标级构造细节可供对照。
论文图表
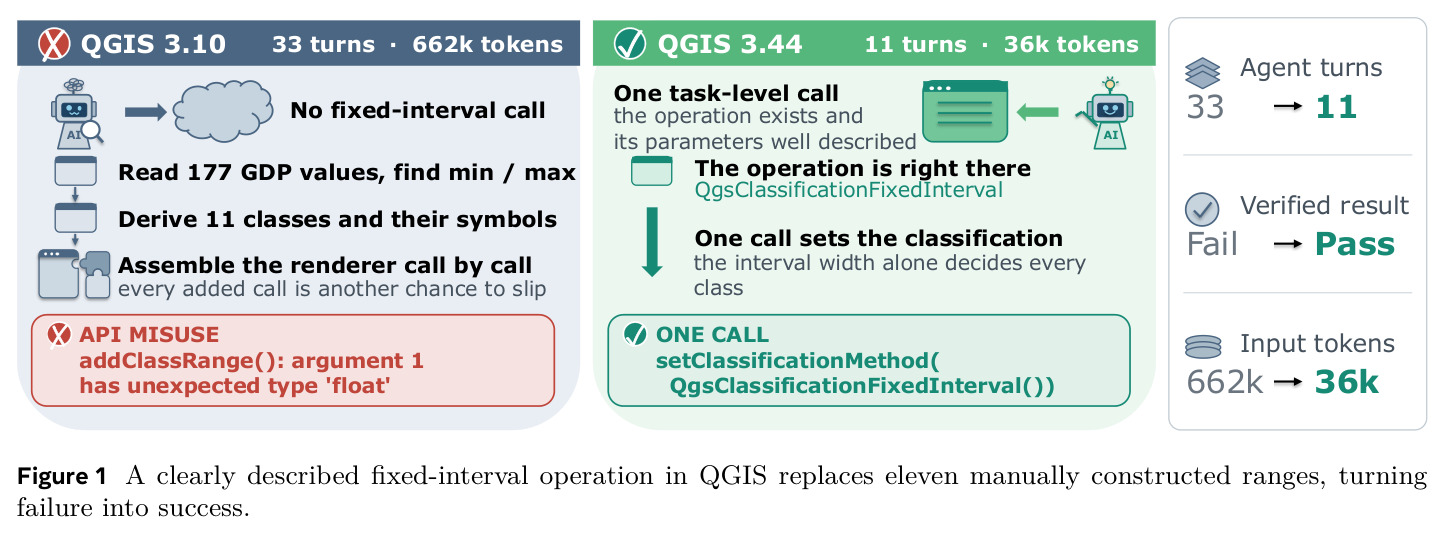
对比 QGIS 3.10 与 3.44 上同一个 GDP 固定宽度分级制图任务:旧版没有固定间隔分类调用,智能体要读 177 个 GDP 值求极值、推导 11 个分级与符号、逐调用拼装渲染器,33 轮、66.2 万输入 token 后因 addClassRange() 参数类型错误(argument 1 has unexpected type 'float')失败;新版提供任务级的 QgsClassificationFixedInterval 操作且参数描述清晰,一次调用即完成,11 轮、3.6 万 token 通过校验。
这是全文动机的具象化:同一智能体、同一任务,仅接口不同就翻转成败,直观支撑“接口是智能体成败的一等变量”这一核心论点。
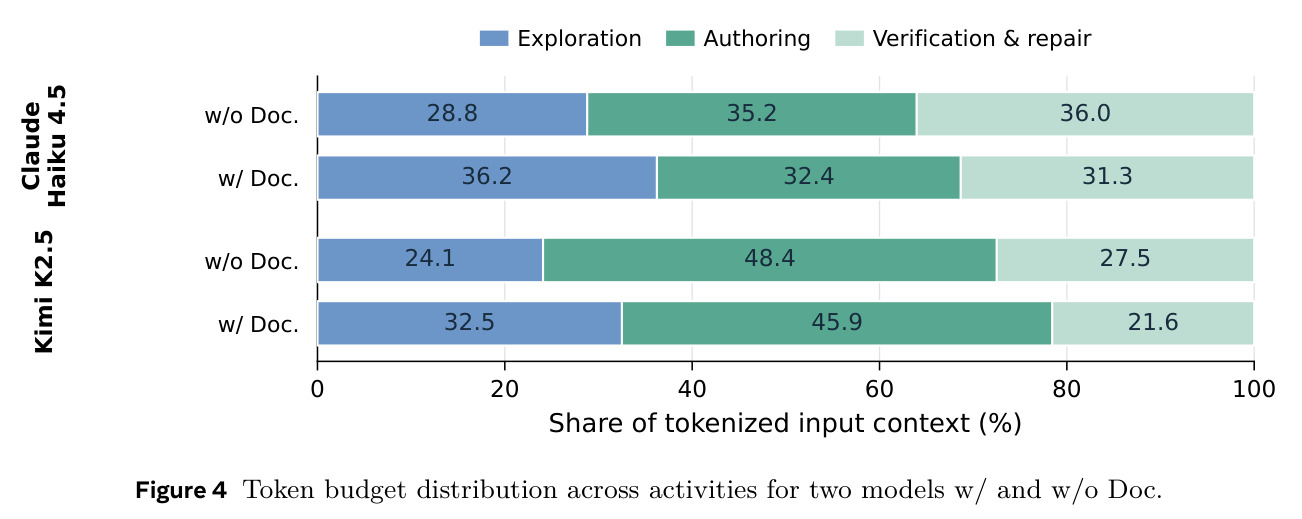
Haiku 与 Kimi K2.5 的输入 token 在探索、编写、校验修复三类活动上的占比:不带文档时探索占 28.8%(Haiku)与 24.1%(Kimi),附带文档库并强制查阅后升至 36.2% 与 32.5%,但整体成功率并未一致提升(见表 3)。两模型的预算分配风格也不同:Kimi 更侧重写代码,Haiku 在实现与检查修复间分布更均匀。
量化可发现性问题的真实代价(两到四成 token 花在探索上),并论证“堆文档”不是解法,直接引出 ANIS 运行时能力发现的设计动机。