KV4-RL:用 INT4 KV 缓存量化为 RLVR 异步 Rollout 提速 KV4-RL: Unlocking Faster Asynchronous Rollouts for RLVR with INT4 KV Cache Quantization
INT4 KV缓存量化加选择性INT8保护,异步RLVR rollout提速1.8倍且精度不掉点
前置知识
RLVR 与 GRPO
RLVR(可验证奖励强化学习)用可自动判分的奖励(如数学答案对错)训练推理模型。GRPO 对每个 prompt 采样 $G$ 条响应,用组内归一化得到优势 $\hat{A}_i=(R_i-\bar{R})/(s_R+\delta)$,整条响应共享该优势,配合 PPO 式裁剪目标与参考 KL 正则更新策略。
本文的 rollout 加速直接服务于 GRPO 训练循环;采样分布失真如何影响组内相对优势与策略更新,是全文问题意识的根基。
KV 缓存与 decode 瓶颈
自回归解码每步只算一个新 token,但注意力要对全部历史做 QK 与 PV 运算,历史 K/V 以缓存形式复用。decode 阶段每生成一个 token 需读取约 $\kappa\bar{\ell}$ 量级的缓存字节($\kappa$ 为每位置存储字节数),是典型的 memory-bound 操作。
理解 KV 读取是 decode 的主导成本,才能理解为什么在高并发异步 rollout 下量化 KV 缓存比量化权重/激活更有效。
分组仿射 KV 量化
把连续的 K/V 向量按固定长度(本文 128 维 token-head 向量一组)分组,每组用 $b$ bit 整数码 $c$ 加 scale $\Delta$、offset $m$ 近似:$\hat{x}=\Delta c+m$,元数据存 FP16。key 侧常配合 Hadamard 旋转打散离群通道后再量化,因为 $QH(HK)^\top=QK^\top$,旋转不改变注意力分数。
KV4-RL 的缓存表示、4.25 bit/元素的开销核算,以及把 scale/offset 延迟到点积之后应用的技巧,全部建立在这一量化形式上。
重要性采样与 TIS
当生成样本的采样分布与训练所用策略不一致时,用概率比 $\pi_{old}(y|h)/q_{i,j}$ 修正目标函数以消除偏差。token 级截断重要性采样(TIS)把该比值截断在 $C$(本文 $C=5$)以内,再按 token 平均,防止极端比值引爆梯度。
TIS 是低精度 rollout 的标准补救手段,而论文的关键论点恰恰是 TIS 不足以挽救 INT4 KV 的采样失真,这是提出选择性 INT8 保护的直接动因。
异步与 partial rollout
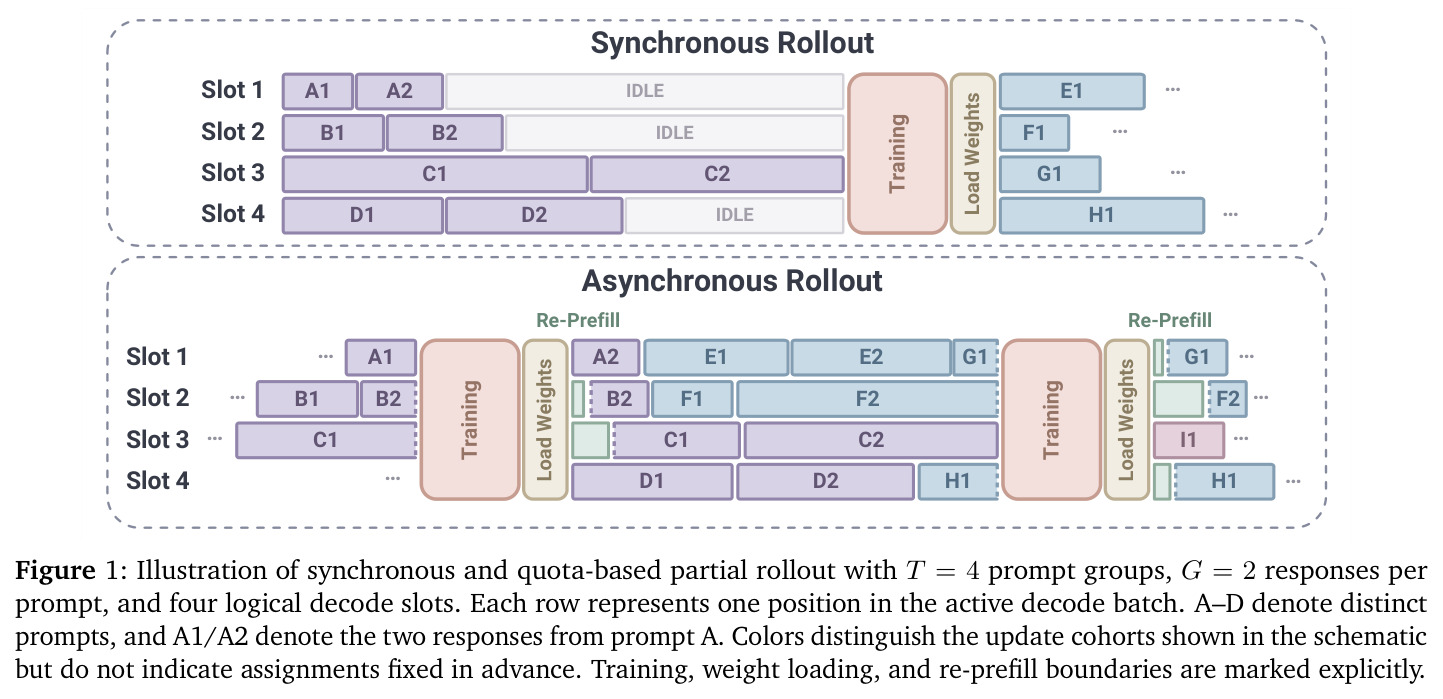
异步 rollout 维持超订请求池,解码槽位一空出就放入新请求,消除同步 wave 式采集的长尾空闲;partial rollout 允许未完成响应跨策略更新携带 token 前缀继续生成,恢复解码前用新策略对旧前缀 re-prefill 重建 KV 缓存(不重采样,保留原记录概率供 TIS 使用)。
正是这种持续补位调度造成 KV concentration(KV 工作量集中),是本文识别出的全部加速机会与问题来源。
Attention sink
大量 softmax 注意力质量会持续流向序列开头少数 token(sink 位置),这些位置的 KV 对下游 token 分布的影响异常大且贯穿整个生成过程,因此推理系统常对开头若干位置保留高精度或不做淘汰。
KV4-RL 的 INT8 保护窗一半给了 sink(前 $s=16$ 个位置),另一半给最近上下文,这是其采样保真度恢复的来源之一。
研究动机
RLVR 训练(如 GRPO)每个 prompt 要采样多条长推理响应,rollout 生成是主要训练成本。传统 wave 式同步采集中,短响应先完成、少数超长响应拖尾,活跃 batch 不断萎缩,GPU 解码能力大量闲置;异步采集虽能持续填满槽位,但作者发现它把同样的 KV 处理压缩到更少的 decode 步里(称为 KV concentration):在匹配的 Qwen3-4B-Base 轨迹上,异步采集平均活跃 batch 大 8.27 倍、每轮采集 decode 调用少 8.35 倍,代价是平均驻留 KV 体积增大 7.82 倍、单步 decode 延迟增加 4.52 倍,decode 吞吐只净赚 1.83 倍;到训练后期 8B checkpoint,受 KV 容量限制,异步吞吐甚至降至同步的 0.98 倍。而现有量化加速研究集中在权重(W4A16)或权重-激活(W8A8)上,在匹配负载回放里几乎不超过 BF16——在这种高并发长上下文负载下,此前的工作选错了优化目标。
本文的目标是本文要回答两个问题:异步 rollout 负载下哪种量化目标能带来最大加速?激进的 INT4 KV 缓存能否在不损害策略学习质量的前提下落地?具体目标分三层:一是形式化并实证刻画 KV concentration,说明它是连续补位调度的结构性必然后果而非实现偶然;二是用匹配负载回放证明 KV 缓存量化才是该负载的主导瓶颈对策,KV4 可带来 1.53 倍至 1.86 倍的 decode 加速;三是解决 INT4 KV rollout 伤害学习的难题——在同样带 token 级 TIS 的 GRPO 配方下,8B 模型 KV4 最终在 MATH-500 上比 BF16 rollout 低 5.24 个百分点——要求在恢复采样器保真度的同时保住 INT4 的执行与容量收益,最终实现 rollout 累计 1.80 倍加速且最终精度与 BF16 rollout 训练相差 0.5pp 以内。
与已有工作不同的是,本文的独特切入有三点。其一,视角新:先前异步/partial rollout 工作研究的是调度如何减少空闲,作者则研究调度的系统侧副作用——持续并发把上下文处理集中到更少更贵的 decode 步,并给出 Proposition 4.1 证明连续补位下驻留 KV 体积按 $E[M_B]/E[L]$ 放大,这是检查悖论式的长度偏倚。其二,对象新:据作者所知是首个 sub-8-bit KV 缓存量化用于 RLVR rollout 的研究,此前量化 RL 只动权重和激活。其三,问题定位深:作者指出 rollout 不同于普通推理——生成结果是后续训练的样本,数值扰动会改变采样器访问的前缀、组内相对优势 $\hat{A}_i$ 以至整个策略,而 TIS 只能在已采样的前缀处修正概率比,无法改变访问了哪些前缀;因此提出与上下文长度无关的有界选择性 INT8 保护(sink 加 recent 共 144 个位置),用最小精度预算换取采样保真度,而不是全场提精度。
核心方法
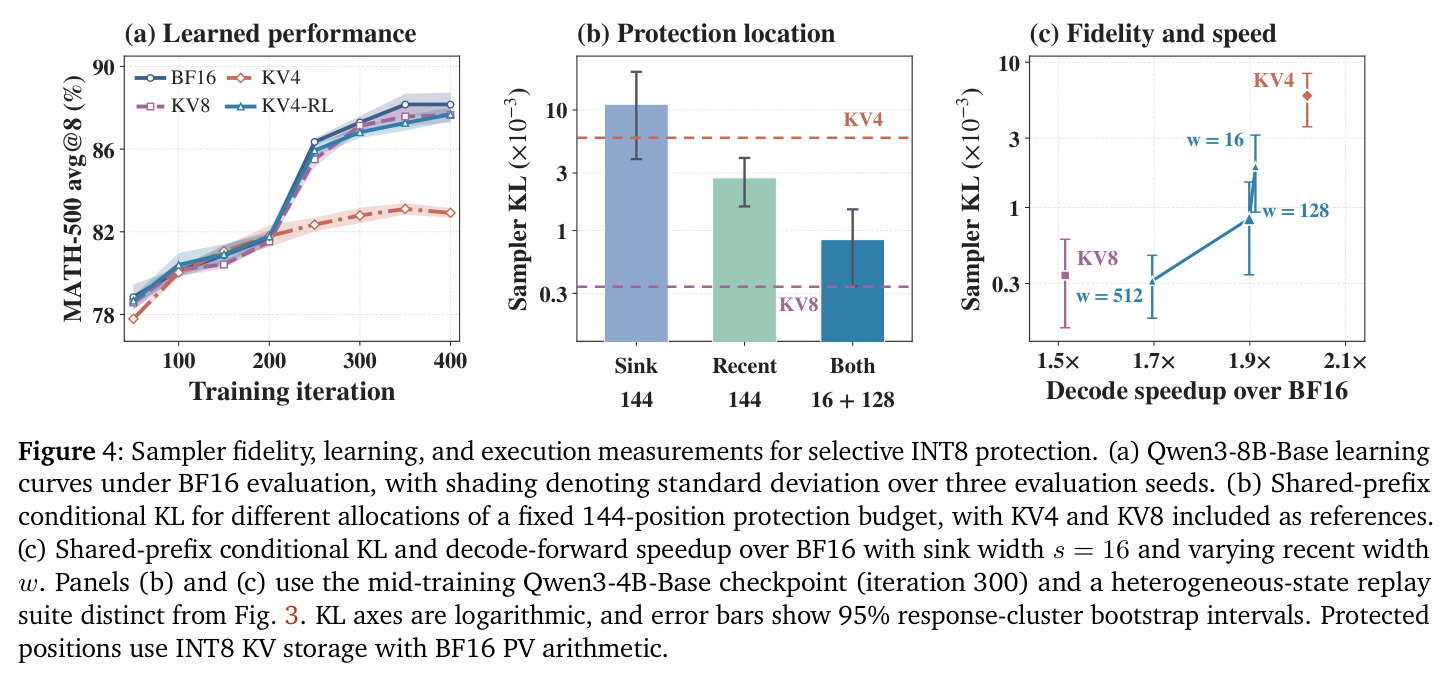
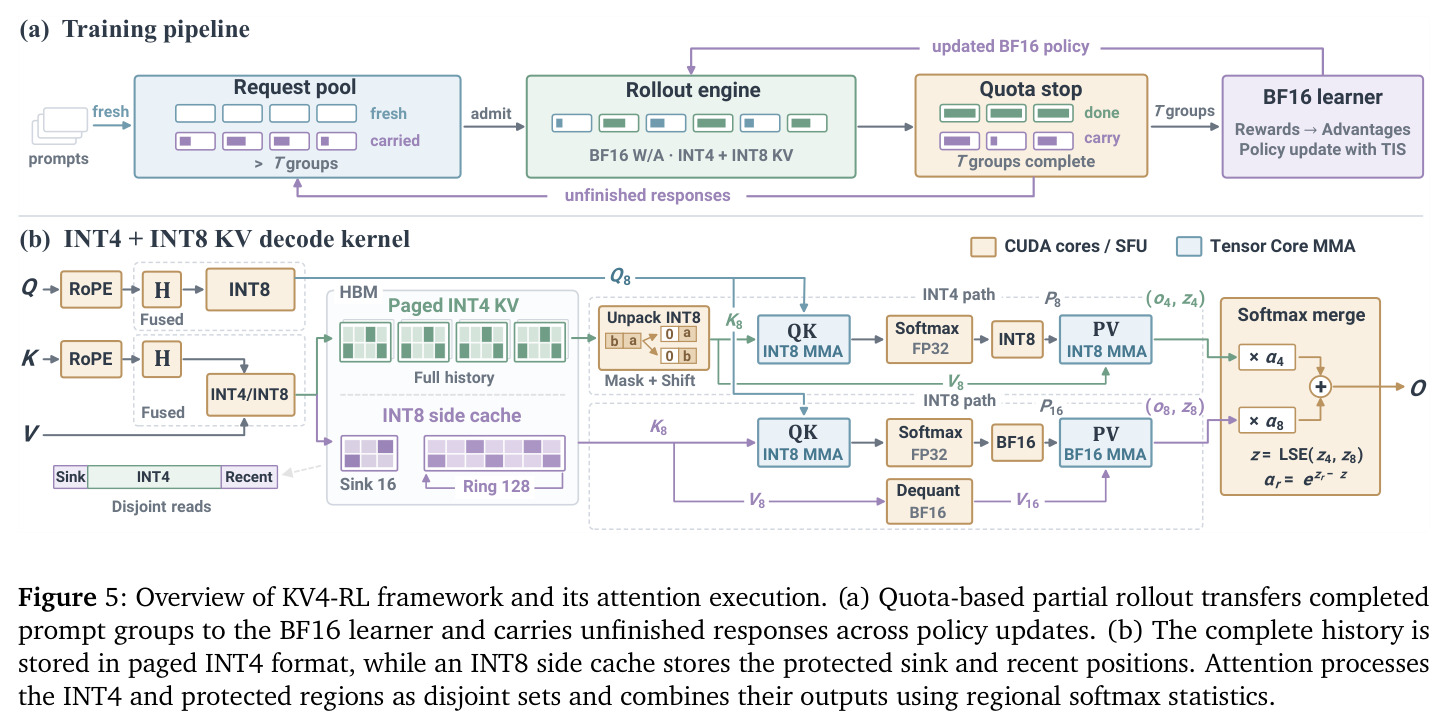
KV4-RL 的整体思路是'全场 INT4 + 少数位置 INT8 保护 + 无损合并的混合注意力执行'。直觉上 INT4 缓存带来双重收益:decode 时 KV 读取量约减为四分之一,加速计算;同样 HBM 预算能驻留更多上下文,支撑更高并发。但全 INT4 会扭曲采样分布,于是只对两处公认敏感的位置保留 INT8 高保真副本:开头的 attention sink(前 $s=16$ 个位置)和最近上下文(最近 $w=128$ 个缓存位置),保护预算 $s+w=144$ 与上下文长度无关。技术上,K/V 按 128 维 token-head 向量分组仿射 INT4 量化,scale $\Delta$ 与 offset $m$ 以 FP16 存储并在生成时在线计算(免校准、跟随策略演化),key 在 RoPE 后做 Hadamard 旋转以压制离群通道;注意力按'保护路径(INT8 QK + BF16 PV、FP32 累加)'与'INT4 主路径(INT8 query + 整数 QK/PV)'分区域并行,再用精确 softmax 合并。实测 1.90 倍 decode-forward 加速、保留 KV4 约 94% 吞吐,条件 KL 降低 7.0 倍。
核心创新是'有界选择性精度保护'设计以及对 KV concentration 的识别。与已有工作的本质区别有三。第一,推理场景的 KV 压缩只需保证单请求输出质量,而 RL rollout 的输出是后续策略更新的训练样本,误差会沿轨迹累积并改变学到的策略——作者实证表明 token 级 TIS 不足以补救 INT4 KV 失真:KV8 训练轨迹贴近 BF16,KV4 早期跟随、后期掉队,8B 最终六基准均值低 4.6 个百分点。第二,提升全缓存保真度的常规手段(更细分组、误差补偿)开销随上下文线性增长,会吃掉 4-bit 收益;KV4-RL 只固定保护 $s+w=144$ 个位置,额外存储与计算严格有界,且 Fig. 4(b) 显示 16 sink + 128 recent 的分配比把预算全给 sink 或全给 recent 都更好(条件 KL 相对 KV4 降 7.0 倍),证明两类位置作用互补。第三,执行上 INT4 paged 缓存与 INT8 side cache 独立共存,位置滑出 recent 窗口时无需重写(INT4 条目本就存在),两区域输出用 log-sum-exp 精确合并,不引入额外近似误差。
方法步骤详情
方法分五步。第一步,quota-based partial rollout:维护超订请求池,槽位空闲即放入新响应,未完成响应跨策略更新携带 token 前缀,凑满 $T$ 个完整 prompt 组即停止采集,携带前缀在权重更新后用新策略 re-prefill 重建 KV(不重采样,原记录概率 $q_{i,j}$ 保留供 TIS)。第二步,构建免校准 KV4 表示:K/V 独立量化,每 128 维 token-head 向量一组仿射 INT4,scale $\Delta$、offset $m$ 在生成时在线计算并以 FP16 存储(合 4.25 bit/元素),key 存旋转基(RoPE 后 Hadamard),query 在注意力前做同样旋转,保证 $QK^\top$ 不变。第三步,选择性保护:前 $s=16$ 个 sink 位置与最近 $w=128$ 个位置额外写 INT8 副本进定容 side buffer,保护路径 PV 用 BF16/FP32 计算;位置滑出窗口直接复用已有 INT4 条目。第四步,混合注意力执行:INT4 路径把旋转后 query 量化为 INT8,解包 INT4 码本做整数 QK/PV;保护路径复用同一 INT8 query 对 INT8 side key 做 QK;两路径各产出区域输出与 log-normalizer,用精确 softmax 合并。第五步,BF16 learner 用 FSDP2 做全参 GRPO 更新,DAPO 式 token 级平均,TIS 截断 $C=5$,参考 KL 系数 0.001。
技术新颖性
技术新颖性体现在四个层面。概念层:首次把'异步调度的负载结构变化'与'量化目标选择'联系起来——高并发下权重读取按 batch 摊薄($\text{W bytes}/B$ 项变小),KV 读取随上下文线性增长($\kappa\bar{\ell}$ 项主导),roofline 分析显示 KV 读取是理想化服务时间的最大项,这在先前量化 RL 文献中未被讨论。理论层:Proposition 4.1 用检查悖论刻画连续补位的长度偏倚,证明 $\mathcal{C}_{KV}=E[M_B]/E[L]\ge 1$ 且随槽数 $B$ 单调不减,结论是结构性的而非经验性的。系统层:免校准在线量化避免训练中反复离线校准;INT4 与 INT8 双缓存独立共存、区域 softmax 精确合并的 kernel 设计,让高保真区间的开销严格有界且与上下文长度无关。实证层:首个 sub-8-bit KV 量化 RLVR rollout 的完整研究,覆盖保真度诊断(共享前缀条件 KL $\mathcal{D}_{sampler}$)、学习曲线与端到端计时三层证据,附录还给出与 NVFP4/MXFP4 的对比及旋转方式、分组大小的消融。
实验结果
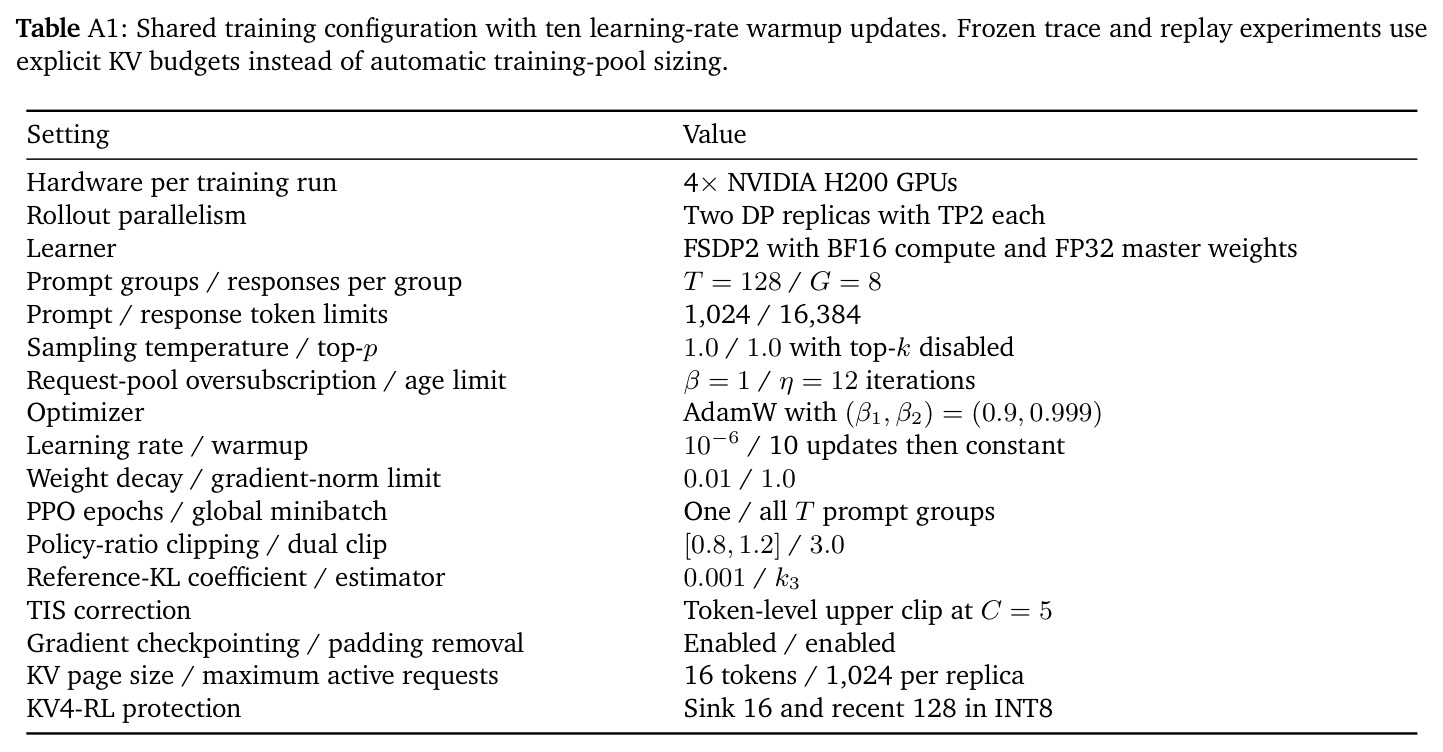
核心发现逐一列出。(1) KV concentration 实证(Fig. 2):匹配的 Qwen3-4B-Base 轨迹上,异步采集维持 8.27 倍更大的平均活跃 batch、每轮 decode 调用少 8.35 倍,平均驻留 KV 体积增 7.82 倍、单步延迟增 4.52 倍,decode 吞吐仅 1.83 倍;理论 $\mathcal{C}_{KV}=E[M_B]/E[L]>1$(Prop. 4.1)。(2) 量化目标对比(Fig. 3):KV4 在早/中/晚 checkpoint 加速 decode-forward 1.53/1.71/1.86 倍,KV8 为 1.30 至 1.41 倍,W4A16 与 W8A8 基本不快于 BF16;8B 上 KV4 达 1.44 至 1.97 倍。(3) 裸 KV4 伤害学习:有 TIS 下 8B KV4 最终六基准均值 47.8%,比 BF16 的 52.4% 低 4.6pp(MATH-500 低 5.24pp),且响应长度萎缩、参考 KL 持续升高;KV8 贴近 BF16。(4) 选择性保护有效(Fig. 4):16 sink + 128 recent 把条件 KL 降 7.0 倍,默认配置 1.90 倍 decode 加速、保留 KV4 约 94% 吞吐,MATH-500 达 87.68% 对 BF16 的 88.16%。(5) 端到端(Fig. 6):8B 400 迭代累计 rollout 加速 1.80 倍、全迭代 1.27 倍,最后 50 迭代 rollout 加速达 1.97 倍且随响应变长而增长;4B 600 迭代为 1.57/1.17 倍。(6) 精度(Table 1):8B 均值 52.8% 对 BF16 rollout 52.4%,4B 46.6% 对 47.0%,均差 0.5pp 内。(7) 加速后 learner 占迭代时间 60.5%,成为新瓶颈。
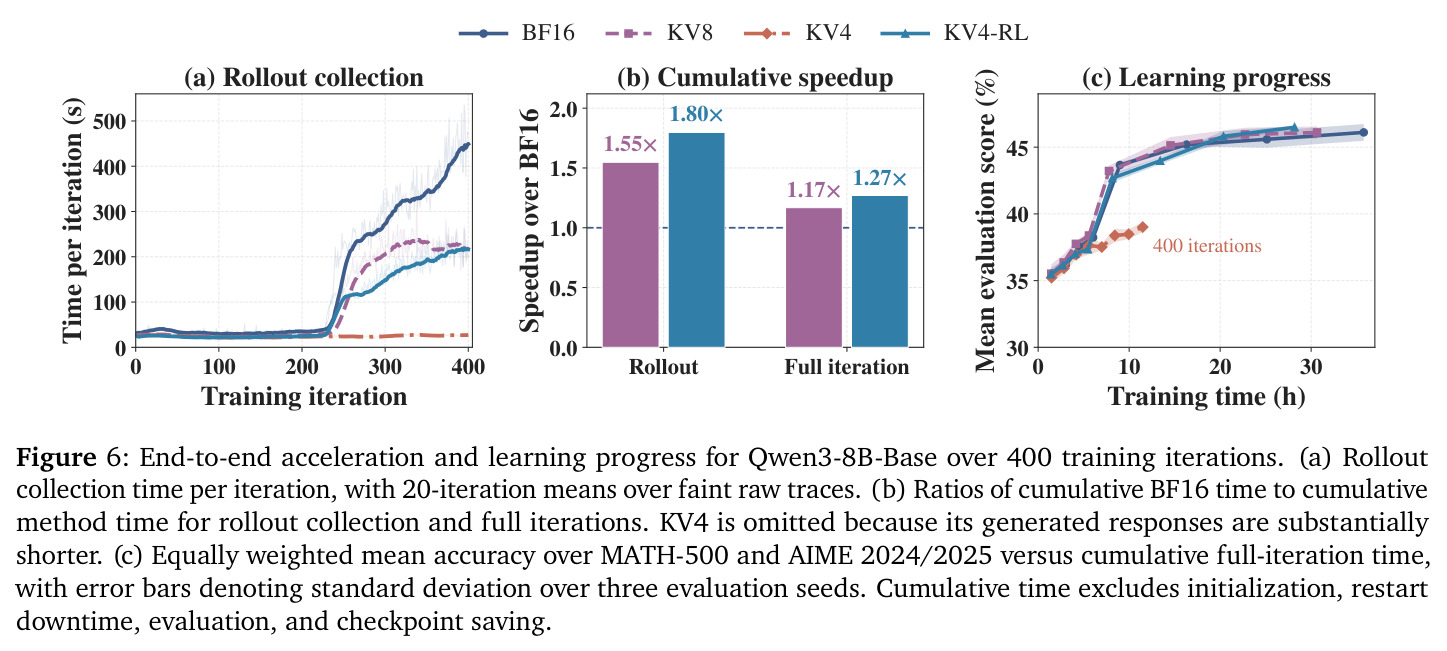
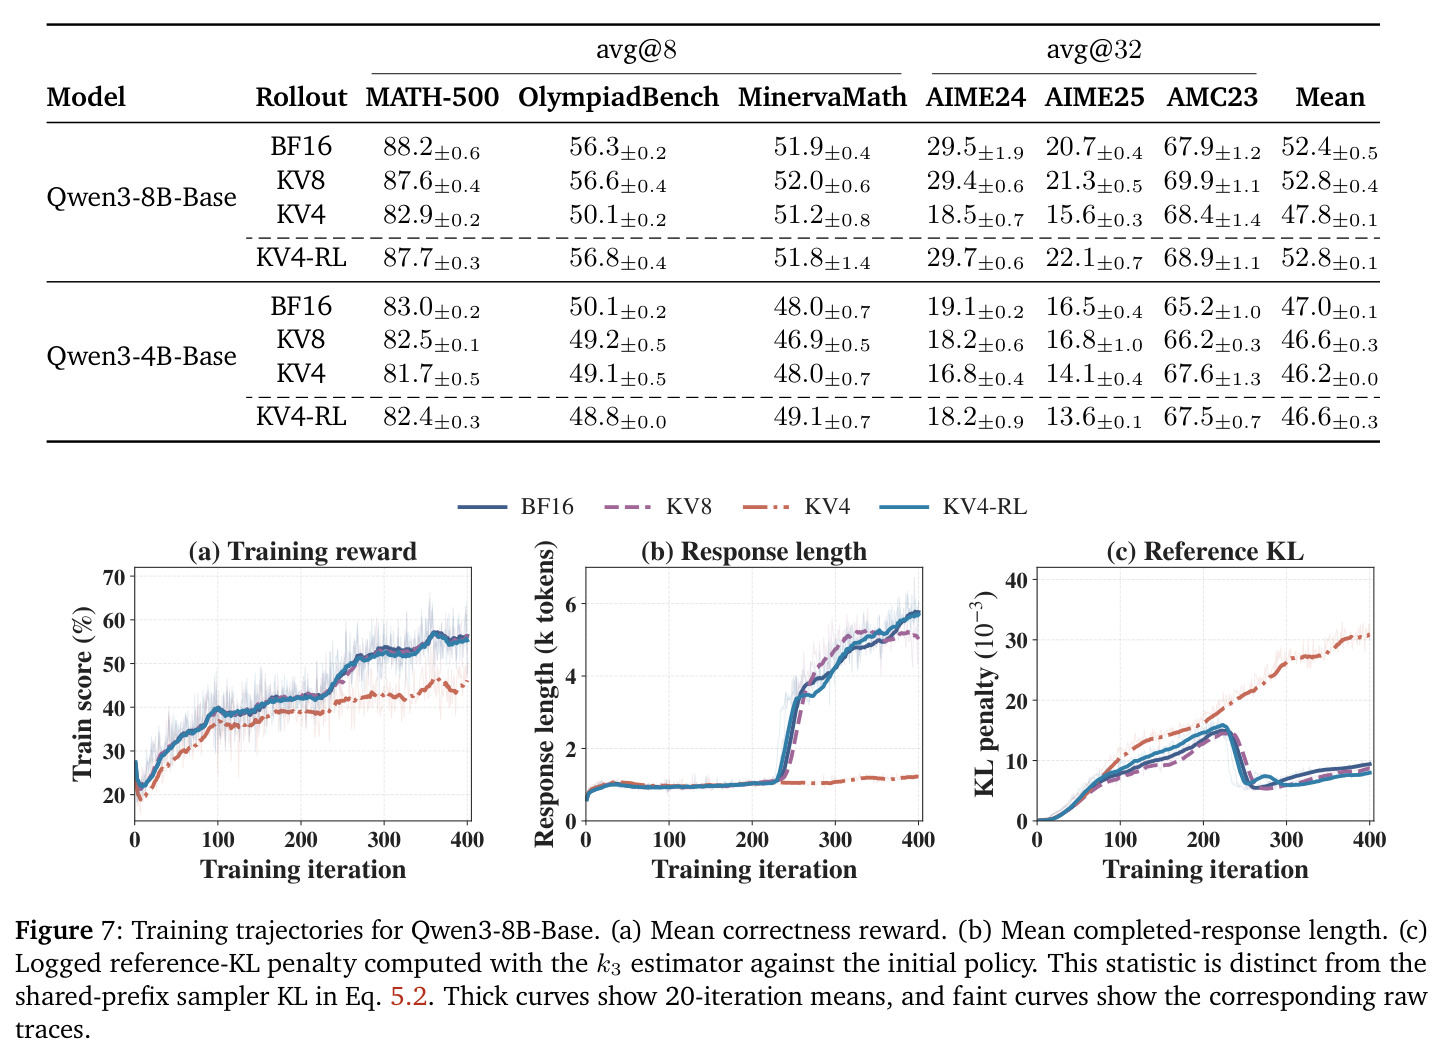
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Qwen3-8B-Base 六基准均值(MATH-500/OlympiadBench/MinervaMath/AIME24/AIME25/AMC23) | BF16 评测最终平均准确率(等权) | 52.8%±0.1(KV4-RL,400 迭代) | BF16 rollout 52.4%±0.5;KV8 52.8%±0.4;KV4 47.8%±0.1 | 与 BF16 rollout 差 0.4pp(0.5pp 内),同时 rollout 提速 1.80 倍;比裸 KV4 高 5.0pp |
| Qwen3-4B-Base 六基准均值 | BF16 评测最终平均准确率(等权) | 46.6%±0.3(KV4-RL,600 迭代) | BF16 rollout 47.0%±0.1;KV8 46.6%±0.3;KV4 46.2%±0.0 | 与 BF16 rollout 差 0.4pp(0.5pp 内),rollout 提速 1.57 倍 |
| 异步 rollout 采集(Qwen3-8B-Base,400 迭代) | 累计 rollout 加速比(BF16 时间/方法时间) | 1.80 倍(最后 50 迭代达 1.97 倍) | BF16 rollout(FlashInfer Tensor Core) | 1.80 倍;全迭代累计加速 1.27 倍 |
| 完整训练迭代(Qwen3-8B-Base) | 累计全迭代加速比 | 1.27 倍(KV4-RL) | BF16 rollout 训练 | 1.27 倍;4B 上为 1.17 倍 |
| decode-forward 固定负载回放(4B 中期 checkpoint) | 对 BF16 的加速比 | KV4-RL 1.90 倍(保留 KV4 约 94% 吞吐) | KV4 约 2.0 倍;KV8 1.30 至 1.41 倍;W4A16/W8A8 约等于或低于 BF16 | 以约 5% 吞吐代价换取条件 KL 降 7.0 倍 |
| 共享前缀条件 KL(采样器失真诊断) | $\mathcal{D}_{sampler}$(对 BF16 路径的 $D_{KL}$) | 比 KV4 低 7.0 倍(16 sink + 128 recent) | KV4(无保护) | 7.0 倍降低,且优于把 144 位置预算全给 sink 或全给 recent |
| MATH-500(Qwen3-8B-Base) | avg@8,BF16 评测 | 87.7%±0.3(KV4-RL) | BF16 88.2%±0.6;KV8 87.6%±0.4;KV4 82.9%±0.2 | 比裸 KV4 高 4.8pp,恢复 BF16 的后期学习改进 |
局限与改进
作者承认的局限:评测只覆盖两个 dense Qwen3 模型、数学推理 workload、colocated 异步 GRPO 配置,未验证 MoE、混合注意力架构、disaggregated rollout 系统以及 agentic/多轮 RLVR;定量收益随架构、注意力结构、调度器和部署位置变化。我的补充观察:其一,计时高度依赖自研整数 paged-attention kernel 与 H200/TP2 环境,KV4 的 1.53 至 1.86 倍加速换一套 kernel 实现可能明显不同;其二,每个 rollout 配置只训练一次,最终精度差异(尤其 4B 上 AIME25 从 16.5% 掉到 13.6%,靠其他任务涨分拉回均值)可能部分来自训练随机性;其三,$s=16$、$w=128$ 是在 4B 中期 checkpoint 离线回放上选出的经验值,对其他模型的长度分布未必最优;其四,KV4 响应变短、参考 KL 持续升高说明量化误差通过某种未被解释的机制改变了策略行为,论文只报告现象未给机理;其五,Prop. 4.1 假设 i.i.d. 长度、固定 prompt 与理想 continuous refill,与真实 quota 采集的有限请求池、KV 页预算有差距。
独立分析的弱点
独立分析出的弱点及改进方向:(1) 保护区是静态的 sink+recent 启发式,在 agentic/多轮 RL 中关键信息(工具返回、环境观测)常出现在上下文中部,固定窗口会漏保护——可按注意力熵或 KL 贡献动态选择保护位置。(2) $(s,w)$ 权衡在单一 checkpoint 的离线回放上调定,训练中最优值可能随长度分布漂移,可做成在线自适应。(3) 端到端收益受 learner 封顶:rollout 加速后 learner 占迭代时间 60.5%,不配合 learner 侧低精度的话,全迭代加速上限约 2 倍出头。(4) 携带响应跨更新的 re-prefill 成本未单独量化,长前缀占比高的 agentic 场景可能被吃掉部分收益。(5) 训练侧样本量 $n=1$:'0.5pp 内'的结论缺乏对训练方差的控制,应多种子重复或给出训练侧置信区间。(6) KV4 响应变短加参考 KL 升高的失效机制不明,若能定位(如量化误差导致特定推理链断裂)可能催生更便宜精准的补救手段。
未来方向
作者提出的方向:在 MoE 与混合注意力架构上验证(注意力结构决定 KV 负载形态,结论应可迁移但幅度未知);在 disaggregated rollout 系统中检验(其 rollout worker 同样驻留大量长前缀);扩展到 agentic、多轮工具调用等长 horizon RLVR workload。可延伸的方向:(1) 更低精度与新数值格式——附录 D.4 已与 NVFP4/MXFP4 对比,后续可在原生 FP4 硬件上做 KV4 变体,或探索 KV3/KV2 配更大保护窗的极端权衡;(2) 动态/学习型保护策略,把 $s$、$w$ 从静态超参变为按请求、按步自适应;(3) 与 learner 侧低精度(如 FP8-RL 训练栈)组合,打破 60.5% learner 时间瓶颈,把全迭代加速推向 2 倍以上;(4) 利用 KV 压缩解锁的容量支撑更长 rollout 与更大并发,研究 KV-aware 的 RLVR scaling 行为;(5) 把 selective protection 加精确 softmax merge 的执行结构推广到投机解码与长上下文推理服务。
复现评估
复现评估:论文工程细节披露充分(Appendix A 完整训练与引擎配置、Appendix B trace/评测/计时协议、Appendix C 证明、Appendix D 消融),数据集 open-r1/DAPO-Math-17k-Processed 英文划分与 Qwen3-4B/8B-Base 权重公开,但正文未提及训练框架或 kernel 开源。主要门槛在系统实现:需要自研整数 paged-attention kernel(INT4 主路径 + INT8 side cache + log-sum-exp 区域合并)、CUDA graph、连续批处理与 TP 通信,不在 vLLM/FlashInfer 现成功能里;cache-representation 消融部分(量化后重建 BF16 再注意力)可用现有框架近似复现,先验证保真度结论。算力方面:每配置 4 张 H200(2 个 TP2 rollout 副本 + FSDP2 learner),每迭代 128 组乘 8 响应、响应上限 16384 token,8B 训 400 迭代、4B 训 600 迭代,从 Fig. 6 计时粗估单个 BF16 基线 run 在数十 GPU·天量级,四个 rollout 配置乘两个模型规模的完整复现成本很高。综合难度:高,建议先在 4B 上少量迭代复现条件 KL 诊断与 Fig. 4 曲线,验证核心机制后再全量训练。
论文图表
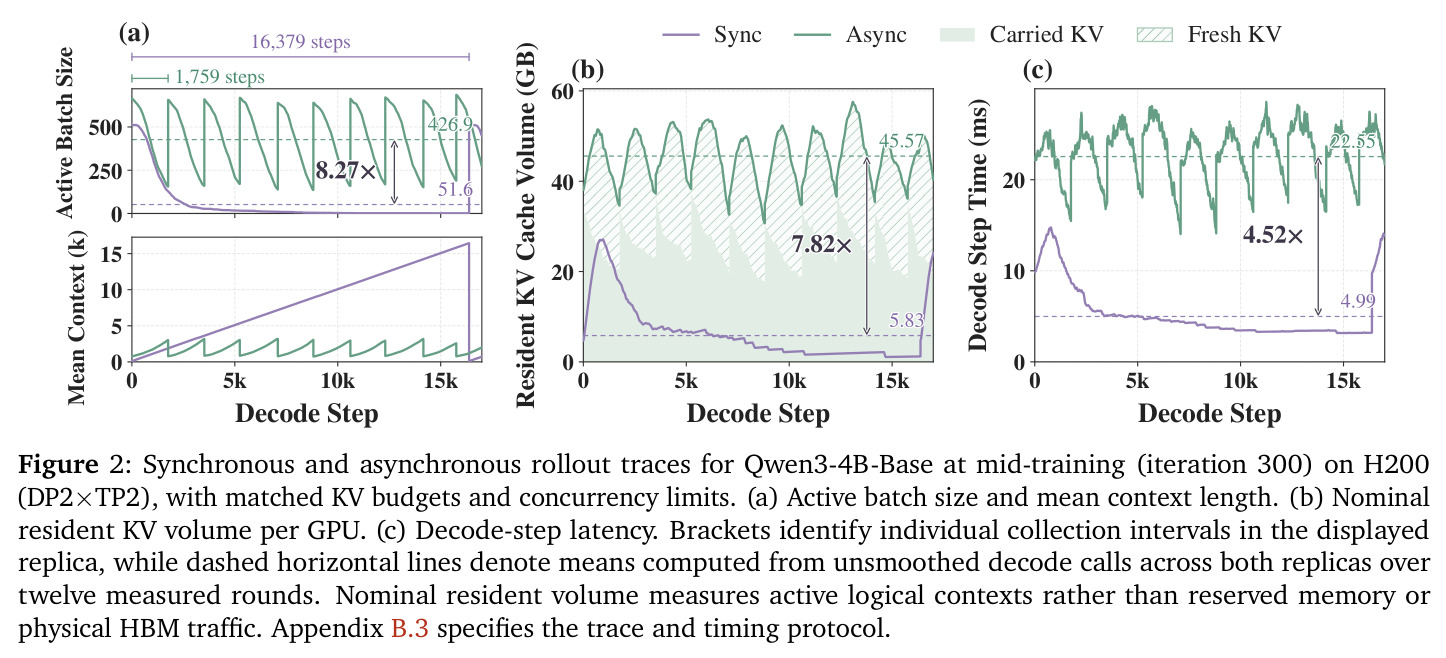
三个子图分别是:(a) 活跃 batch 大小与平均上下文长度——同步 batch 随响应完成不断萎缩并进入由超长生成主导的长尾,异步则持续补位;(b) 每卡标称驻留 KV 体积——异步全程维持高水位(均值大 7.82 倍);(c) 单步 decode 延迟——异步单步更贵(均值高 4.52 倍)。另给出异步平均活跃 batch 大 8.27 倍、decode 调用少 8.35 倍、decode 服务吞吐高 1.83 倍。
KV concentration 概念的实证核心:它证明了异步调度在消除空闲尾巴的同时把负载推向 KV 侧,是全文选择 KV 量化作为加速目标的出发点。
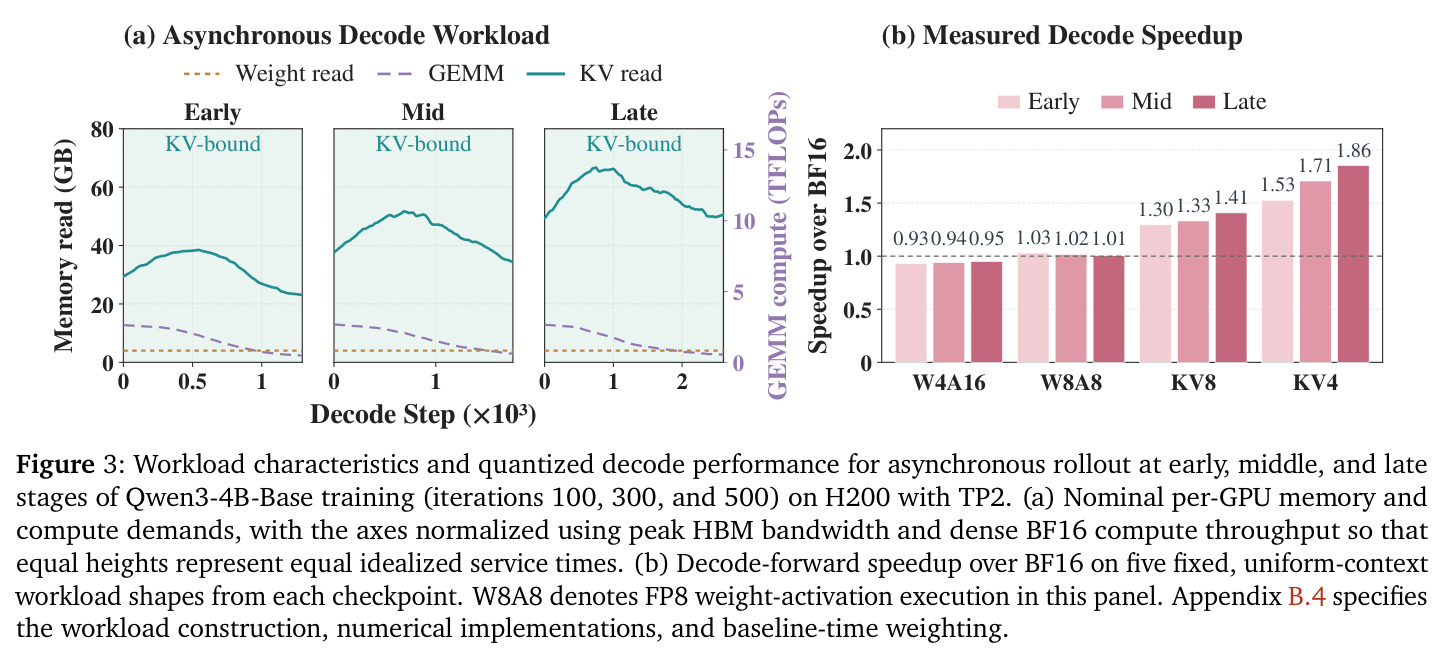
(a) 显示异步 decode 的理想化内存与计算需求:KV 读取在三个阶段都是最大项且随训练推进增长,而权重读取与 GEMM 计算基本持平。(b) 在五个固定负载形状上回放各配置的 decode-forward 加速:KV4 为 1.53/1.71/1.86 倍,KV8 为 1.30 至 1.41 倍,W4A16 与 W8A8 接近或低于 1 倍。
直接回答'为什么量化 KV 而不是权重/激活'这一关键问题,是论文论证量化目标选择的核心实验证据。