← 返回 2026-09-18

DeepSeek-V4.1-Flash:把 KV 缓存压缩推向极限 DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression

DeepSeek-AI, Anyi Xu, B. Li, Bangcai Lin, Bing Xue, BingCheng Xian, Bingzheng Xu, Bochao Wu, Bowei Zhang, Boyi Deng, C. C. Yu, Chao Jin, Chaofan Lin, Chen Dong, Chenbing Wang, Chenfan Feng, Chengda Lu, Chenggang Zhao, Chengqi Deng, Chengyuan Zhang, Chenhao Xu, Chenqi Zhao, Chenze Shao, Chuhao Wang, Chuqi Zhang, Damai Dai, Dejian Yang, Deli Chen, Di Huang, Di Wu, Donghao Li, Erhang Li, Eric Fu, F. Zhou, Fangwei Zhou, Fangyun Lin, Fangzhou Yuan, Feiyu Xia, Fucong Dai, Guangbo Hao, Guanglin Li, Guanting Chen, Guoai Cao, Guofan Fan, Guolai Meng, Guowei Li, Haichuan Zhang, Haiyang Ma, Haiyang Shen, Han Li, Han Yu, Han Zhang, Hangyuan Deng, Hanwei Xu, Hanxiang Xu, Hanxun Zhong, Hao Guo, Hao Jiang, Hao Li, Hao Qin, Haodong Wen, Haofen Liang, Haofeng Huang, Haohua Liu, Haoling Zhang, Haoming Luo, Haoran Yang, Haotian Xu, Haotian Yuan, Haoting Huang, Haowen Luo, Haoyang Cai, Haoyu Chen, Haozhe Ji, Hengran Zhang, Hengrui Wang, Hengxu Wu, Honghui Ding, Hongxuan Tang, Huadong Wang, Huanqi Cao, Huazuo Gao, Hui Qu, Hui Zeng, J. Yang, J. H. Jin, J. H. Zhang, J. X. Zou, Jia Yu, Jiahui Zhou, Jiajun Chen, Jialiang Huang, Jialin Zhao, Jiamin Tang, Jian Zhou, Jianan Tong, Jianwen Li, Jiaqi Zhu, Jiarui Wang, Jiasheng Ye, Jiashi Li, Jiaxin Xu, Jiaying Ding, Jibai Lu, Jiewen Hu, Jin Yan, Jincheng Zhai, Jingchang Chen, Jingcheng Hu, Jingli Zhou, Jingsheng Xu, Jingting Xiang, Jingyan Yun, Jingyang Yuan, Jingyuan Cheng, Jinhua Zhu, Jinpeng Wang, Jinyi Chen, Jinyi Hu, Jiping Yu, Jueliang Guo, Junbo Pei, Junbo Sun, Junguang Jiang, Junjie Qiu, Junkang Zhou, Junqi Liu, Junren Li, Junxian Li, Junxiao Song, Junyi Guo, Kai Dong, Kaifeng Chen, Kaige Gao, Kang Guan, Kangdong Yuan, Ke Hong, Ke Xu, Kefan Zhao, Kexin Ji, Kexin Zhang, Kexing Zhou, Kuai Yu, Lan Zhang, Lean Wang, Lecong Zhang, Lei Wang, Letian Gao, Liang Zhao, Liansheng Xu, Lihua Guo, Lingxiao Luo, Lingyue Fu, Litao Deng, Litong Wang, Liyue Zhang, Longhao Chen, Lu Chen, Luotian Huang, Luyao Ma, Luyao Wang, M. S. Di, Max Mei, Menghao Ye, Miao Cui, Mingchuan Zhang, Minghua Zhang, Minghui Tang, Mingjing Zhang, Mingqi Wei, Mingshu Chen, Mingxing Liu, Mingxu Zhou, Mingyu Xu, Mingyu Yang, Mingze Wang, Muyang Chen, Ni Shentu, Ning Wang, Niufang Ning, Panpan Huang, Peixin Cong, Peiyi Wang, Peiyuan Xin, Pengfei Ren, Pengfei Yan, Pengle Zhang, Qi Kang, Qi Tang, Qiancheng Wang, Qiang Li, Qihao Zhu, Qingyang Li, Qinyu Chen, Qiushi Du, Qizhou Guo, Rongxian Xu, Rui Ding, Rui Hu, Rui Tian, Rui Yu, Ruidong Zhu, Ruifan Xu, Ruihan Yang, Ruihang Xia, Ruijie Lu, Ruilin Geng, Ruipeng Hong, Ruiqi Ge, Ruisong Zhang, Ruize Sun, Ruizhe Pan, Runji Wang, Runqian Chen, Runxin Xu, Ruohong Tian, Ruomeng Shen, Ruoyu Zhang, Ryan X., S. H. Liu, Shanghao Lu, Shangyan Zhou, Shanhuang Chen, Shaofei Cai, Shaoheng Nie, Shaoyuan Chen, Shengding Hu, Shengkai Lin, Shengwen Ran, Shengyu Liu, Shengyuan Jia, Shi Bai, Shi Feng, Shicheng Xu, Shichun Liu, Shiqiang Hu, Shirong Ma, Shiyu Wang, Shiyuan Feng, Shufan Gong, Shuhan Lin, Shuiping Yu, Shunfeng Zhou, Shuo Yang, Shuomeng Wang, Shuting Guo, Shuting Pan, Shuying Yu, Sinuo Cao, Siyi Lin, Sizhe Chen, Songyang Chen, Songyang Zhou, Tao Ni, Tao Yun, Tian Jin, Tian Pei, Tian Ye, Tianle Lin, Tianran Ji, Tianyi Cui, Tianyuan Yue, Tingting Yu, Tongrui Xiong, Wangding Zeng, Wei Liu, Wei Zhang, Weibin Xu, Weihao Zeng, Weilin Zhao, Wen Liu, Wenfeng Liang, Wenjie Pang, Wenjing Luo, Wenjing Yao, Wenjun Gao, Wenkai Shao, Wenkai Yang, Wenli Zhang, Wenlu Wang, Wenlve Huang, Wenqian Yan, Wentao Zhang, Xi Gao, Xiang He, Xiang Li, Xiangli Li, Xiangwen Wang, Xiangying Zhang, Xiankui Wei, Xiao Bi, Xiaodong Liu, Xiaohan Wang, Xiaojian Qu, Xiaokang Chen, Xiaokang Zhang, Xiaotao Nie, Xiaoyao Zou, Xiaoyuan Li, Xicheng Guo, Xieting Chu, Xin Cheng, Xin Liu, Xin Xie, Xinbo Xu, Xingchao Liu, Xingchen Liu, Xingkai Yu, Xingyou Li, Xintong Yao, Xinyang Chen, Xinyong Jiang, Xinyu Yang, Xu Chen, Xuanyu Wang, Xubei Zhong, Xuecheng Su, Xuejie Liu, Xuheng Lin, Xujie Fan, Xuncheng Zhao, Xuwei Fu, Y. C. Yan, Y. H. Jiang, Y. T. Wu, Y. W. M., Y. Z. Wang, Yafei Gao, Yang Yang, Yang Zhang, Yanru Ma, Yanwen Huang, Yao Li, Yao Meng, Yao Zhao, Yaofeng Sun, Yaohui Wang, Yaoyang Ye, Yehang Yin, Yexinrui Wu, Yi Qian, Yi Tao, Yi Yu, Yichao Zhang, Yichen Jiang, Yicheng Wang, Yifan Ding, Yifan Shi, Yifeng Peng, Yifeng Zhai, Yijia Wu, Yiliang Xiong, Yilun Wang, Ying He, Ying Zhou, Yingjia Luo, Yinmin Zhong, Yiping Wang, Yisong Wang, Yixiang Zhang, Yixiao Chen, Yixuan Tan, Yixuan Wei, Yiyang Ma, Yiyao Yang, Yiyuan Liu, Yizai Cai, Yizhen Wei, Yizhi Wang, Yonglun Yang, Yongqi Zhuo, Yongqiang Guo, Yongtong Wu, Yu Wu, Yu Zhang, Yuan Bian, Yuan Cheng, Yuan Ou, Yuan Sun, Yuanfan Xu, Yuanhang Sun, Yuanhao Li, Yuchen Liu, Yuchen Yao, Yudong Han, Yuduan Wang, Yuhan Wu, Yuhao Meng, Yuheng Zou, YuKun Li, Yunchuan Wang, Yunfan Xiao, Yunfan Xiong, Yupeng Chen, Yuqian Cao, Yuqian Wang, Yuqing Chen, Yushun Zhang, Yutong Lin, Yuwei Xiao, Yuxian Gu, Yuxiang Chen, Yuxiang Huang, Yuxiang Luo, Yuxiang You, Yuxin Chen, Yuxin Xiang, Yuxuan Liu, Yuxuan Zhou, Yuyang Zhou, Yuzhe Guo, Yuzhen Huang, Yuzhuo Bai, Z. Y. Z., Zanlin Ni, Zehao Wang, Zehua Zhao, Zehui Ren, Zejun Zhao, Zhangli Sha, Zhanying Wang, Zhaochen Zhang, Zhaoshuai Du, Zhe Fu, Zhean Xu, Zhenda Xie, Zheng Liu, Zhengyan Zhang, Zhenhua Dong, Zhewen Hao, Zhibang Wang, Zhibin Gou, Zhicheng Ma, Zhihao Li, Zhihong Shao, Zhihuan Huang, Zhijie Li, Zhirui Lu, Zhixian Huang, Zhixuan Chen, Zhixuan Pan, Zhiyu Wu, Zhizhou Ren, Zhu He, Zhuoshu Li, Zhuping Zhang, Zian Xu, Zihao Wang, Zihui Gu, Zijia Zhu, Zili Zhang, Zilin Li, Zilong Hou, Zilong Lyu, Ziqiao Wang, Ziwei Xie, Ziya Zhang, Ziyi Gao, Zizheng Pan, Zonglin Li, Zongqing Yao, Zui Chen, Zuofan Wu, Chenchen Ling, Chengyu Hou, Chong Chen, D. Li, Di Qi, Dongjie Ji, Fang Wei, Fanyi Xia, Fei Xie, Feiyi Tan, Hailong Guo, Haiyan Zhai, Hui Zhou, Huihui Tan, Huijie Li, Jia Luo, Jia Song, Jialu Cai, Jian Liang, Jiangting Zhou, Jiaqi Gao, Jiayi Shao, Jie Chen, Jieyu Yang, Jin Chen, Jingde Zhang, Jingzi Zhou, Jinqian Wang, Jinyang Liu, JinZhao Sun, Junhua Ling, Junmin Zheng, Kaicheng Yang, Le Su, Leyi Xia, Liangfeng Ding, Lin Zhuo, Linwang Ma, Linyan Zhu, Liyu Cai, Luqi Yao, M. K. Zhang, Meng Li, Miao Lin, Miaojun Wang, Min Zhang, Mingming Li, Mingming Wang, Mingze Yin, Minmin Han, Nan Cao, Ningxin Ma, Panpan Wang, Peihan Lin, Peng Sun, Peng Zhang, Qian Ying, Qiang Xiang, Qiao Wang, Qingmiao Mao, Qiwei Jiang, Rongli Jin, Ruyi Chen, Sha Tao, Shangmian Sun, Shaoqing Wu, Shichao Zou, Si Lei, Tianyang Zhang, Tianyu Sun, Tingting Yin, W. L. Xiao, Wei An, Wei Li, Wei Wang, Weiwei Lin, Wenqing Hou, X. Lin, Xiangfei Meng, Xianzhu Huang, Xiao Peng, Xiaoqian Li, Xiaoting Zhang, Xiaowen Sun, Xiaoxiang Wang, Xiaoyu Ye, Xinrou Zhang, Xinyu Zhang, Xue Cao, Xueyin Chen, Yanan Zhou, Yanhong Xu, Yao Xia, Yao Xu, Yi Shao, Yihong Zhang, Yiling Ma, Ying Tang, Yining Lou, Yiru Chen, Yishi Piao, Yixuan Chen, Yong Xiong, Yuchen Xuan, Yuehan Yang, Yuer Xu, Yukun Zha, Yunxian Ma, Yuping Lin, Yuting Yan, Yutong Xie, Yuwen Sheng, Yuxuan Zhu, Zekai Zhang, Zhe Ju, Zhenzhen Lin, Zheren Gao, Zheyang Sun, Zhigang Yan, Zhongyu Wu, Zi Wang, Zihua Qu, Ziling Yan, Ziyi Wan 📅 2026-09-17 👍 214 2026-11-02 18:30
FP4量化 KV缓存压缩 强化学习 推测解码 智能体训练 混合专家MoE 稀疏注意力 长上下文

跨层复用+FP4量化+有界重放三管齐下,将KV缓存压至前代1/4至1/8且性能更强

前置知识

KV 缓存

自回归 Transformer 生成时,为避免每一步重算历史注意力,会把每层的 Key/Value 投影缓存下来,其体积与上下文长度、层数、头维成正比。长上下文推理中,KV 缓存同时占用 HBM(热数据)、SSD 与主存(持久化前缀缓存)以及互联带宽,是推理成本的三大瓶颈之一。

本文的核心目标就是把每 token 全局 KV 从数千字节压到 890 字节,所有架构、精度与部署设计都围绕这一指标展开,不理解 KV 缓存就无法理解压缩的动机与收益。

MoE(混合专家)

MoE 把 Transformer 的 FFN 替换为路由器加大量专家,每个 token 只激活少数专家,从而在总参数巨大时保持每 token 计算量小。本文模型骨干 552B 参数,每层 1 个共享专家 + 384 个路由专家,每 token 激活 6 个,prefill 激活 8B、decode 激活 16B 参数。

理解模型为何能在 552B 规模下保持低推理成本,以及 CED 设计带来的 prefill/decode 激活参数不对称(8B vs 16B)为何对 input-heavy 智能体负载特别划算。

稀疏注意力与 Top-K 索引器

让每个 query 不再 attend 全部历史 token,而是用轻量索引器(indexer Q/K)给压缩后的 KV 条目打分,只选 Top-$k$ 条目参与核心注意力;同时每 $m$ 个 token 被压缩成一条主 KV。注意力在「压缩主 KV + 局部滑窗 KV」的并集上进行,兼顾全局检索与局部精确交互。

CSA2 正是这套机制(源自 DeepSeek-V4 的 CSA)的升级版,其 Full/Reindex/Reuse 三种复用模式完全建立在「主 KV、索引 K、Top-K 索引三者可分离」的概念之上。

滑动窗口注意力(SWA)

每层保留一条只看最近 $n_{win}$ 个 token 的局部注意力分支,其 KV 存储量与序列长度无关(本文 $n_{win}=128$)。当序列足够长时,全局分支的 KV 主导内存占用,SWA 则负责相邻 token 的精确交互,两者构成 V4 系列的基本混合注意力结构。

SWA Bounded Replay 与持久缓存策略都依赖「SWA 依赖只在局部、跨层逐层累积」这一性质,这是部署侧压缩正确性的前提。

YOCO 与因果编码器-解码器(CED)

YOCO(You Only Cache Once)让上层 Transformer 直接复用下层生成的 KV 缓存,从而把 prefill 计算近似砍半。本文 CED 是其改进版:前 20 层为因果编码器正常计算,后 20 层解码器的全局 KV 不由自身隐状态生成,而是从第 $L/2$ 层隐状态经逐层投影 $C^l = H^{L/2} W^l_{KV}$ 得到。

CED 是 prefill 计算减半(复杂度从 $O(NL)$ 降到约 $O(NL/2)$)、以及 prefill 与 decode 激活参数解耦的基础,是本文效率故事的架构支柱。

FP4 量化与量化感知训练(QAT)

FP4 用 4 位浮点(如 E2M1)加分组缩放因子(每 16 通道一个 E4M3 scale,即 NVFP4 风格)表示张量,存储量约为 FP8 的一半。QAT 在训练或后训练中插入模拟量化操作,让模型参数适应低精度带来的数值误差,而不是事后直接压精度。

本文在 RoPE 之后对主 KV 缓存做 FP4 QAT(SWA KV 因对量化敏感保留 FP8),是全局 KV 足迹压到 1/4 的关键一环。

推测解码

用小型 drafter 先快速草拟多个候选 token,再由大模型一次前向并行验证,被接受的 token 直接复用,从而在不改变输出分布的前提下加速解码。本文的 DSpark 用 3 个滑窗(窗口 128)的 Transformer 块半自回归地一次草拟 5 个位置,并用置信度头预测接受概率来动态调度验证长度。

DSpark 是 decode 效率优化的组成部分,与 KV 压缩共同决定实际服务成本;它与 V3 的 MTP 不同,在骨干预训练完成后单独训练。

RLVR 与异步 RL 基础设施

可验证奖励的强化学习(RLVR)用程序检查、测试用例等自动信号奖励智能体轨迹;GRPO 在同一 prompt 的采样组内做组相对优势估计。异步训练让 rollout 与训练共存共享 GPU,用样本级派发维持并发、缓解长尾样本等待,并配合 token 级中断与状态持久化实现无缝续跑。

本文后训练明确声明「无算法创新,全部增益来自数据与环境管线」,理解这套 RL 流程才能看懂任务合成、DSec 沙箱与推理力度控制的设计动机。

研究动机

长程智能体(agent)工作负载高度 input-heavy:频繁的工具调用产生大量 prefill 请求,一旦前缀 KV 缓存未命中就要重新计算整个上下文,计算开销巨大。即便 DeepSeek-V4 已用 CSA/HCA 稀疏注意力大幅压低长序列计算成本,存储与传输随即成为新瓶颈:全局分支的 main KV 与 indexer K 常驻 HBM,容量直接限制并发路数与上下文长度;用于前缀复用的持久化 KV 缓存放在 SSD 和主存上,其中 SWA KV 约占一半容量,而其访问模式是会话内分钟级的窄窗口,与持久缓存 72 小时的长驻留策略严重错配。V4 技术报告提出的 Zero SWA Caching 需要精确重建 SWA 状态,即重放 $L \times n_{win}$ 个 token($L$ 为层数、$n_{win}=128$ 为窗口大小),生产环境中代价过高。计算、存储、带宽三者叠加,限制了智能体在更长任务时域上的部署规模、吞吐与成本。

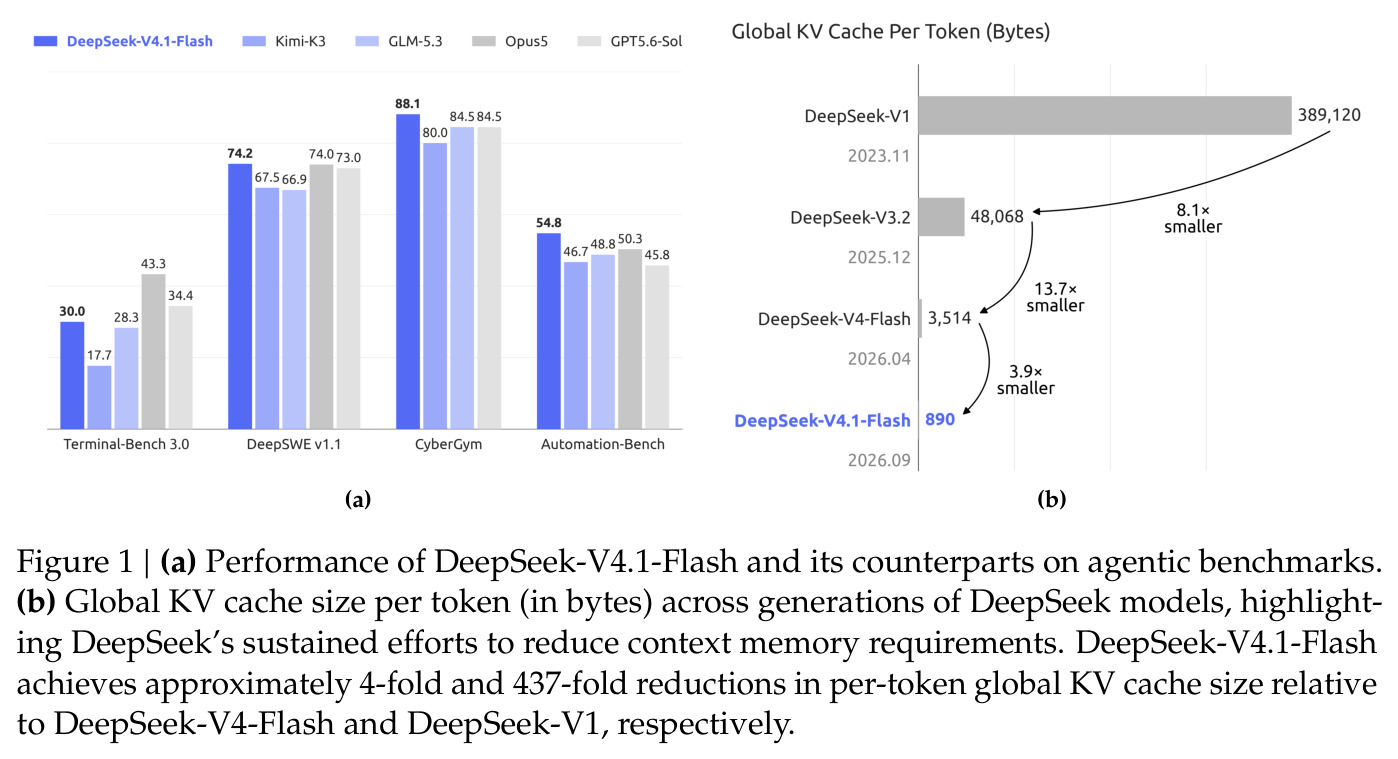
本文的目标是本文的目标是把 KV 缓存压缩推到极限,同时不牺牲甚至提升模型能力,具体量化为:把常驻 HBM 的全局 KV 缓存降到每 token 890 字节,约为 DeepSeek-V4-Flash 的 1/4、DeepSeek-V1 的 1/437;把 SSD/主存上的持久化 KV 缓存降到 V4-Flash 的约 1/8;让 prefill 每 token 只激活 8B 参数(decode 为 16B),prefill 计算近似减半;并使单 token decode FLOPs 在上下文从 4K 扩到 1M(256 倍)时只增加 1/4。这些指标共同指向一个实际目标:缓解 HBM/SSD 容量与 I/O 带宽压力,显著降低长程智能体的部署成本,使大规模服务成为可能。

与已有工作不同的是,已有 KV 压缩工作只覆盖三个乘性维度之一:条目维度有 GQA/MLA(减少 KV 头数或跨头共享低秩隐变量),序列维度有 CSA/HCA(每 $m$ 个 token 压成一条),层维度有 IndexCache(跨层复用 Top-K 索引)、YOIO(全网共享一次稀疏路由)、HySparse(稀疏层复用稠密层 KV)——但只复用索引省不下 main KV 存储、全网共享路由损害性能、混合架构仍保留全注意力层,没有工作同时覆盖三个维度。本文的独特切入有二:一是把层维度的 KV 复用与索引复用解耦成 Full/Reindex/Reuse 三种静态模式,与前两个维度自由组合;二是用部署侧「近似重建换免存储」的 SWA Bounded Replay——只重放最近 $n_{win}$ 个 token 而非 $L \times n_{win}$ 个——开辟新的存储-计算权衡,这是此前工作完全未触及的角度。

核心方法

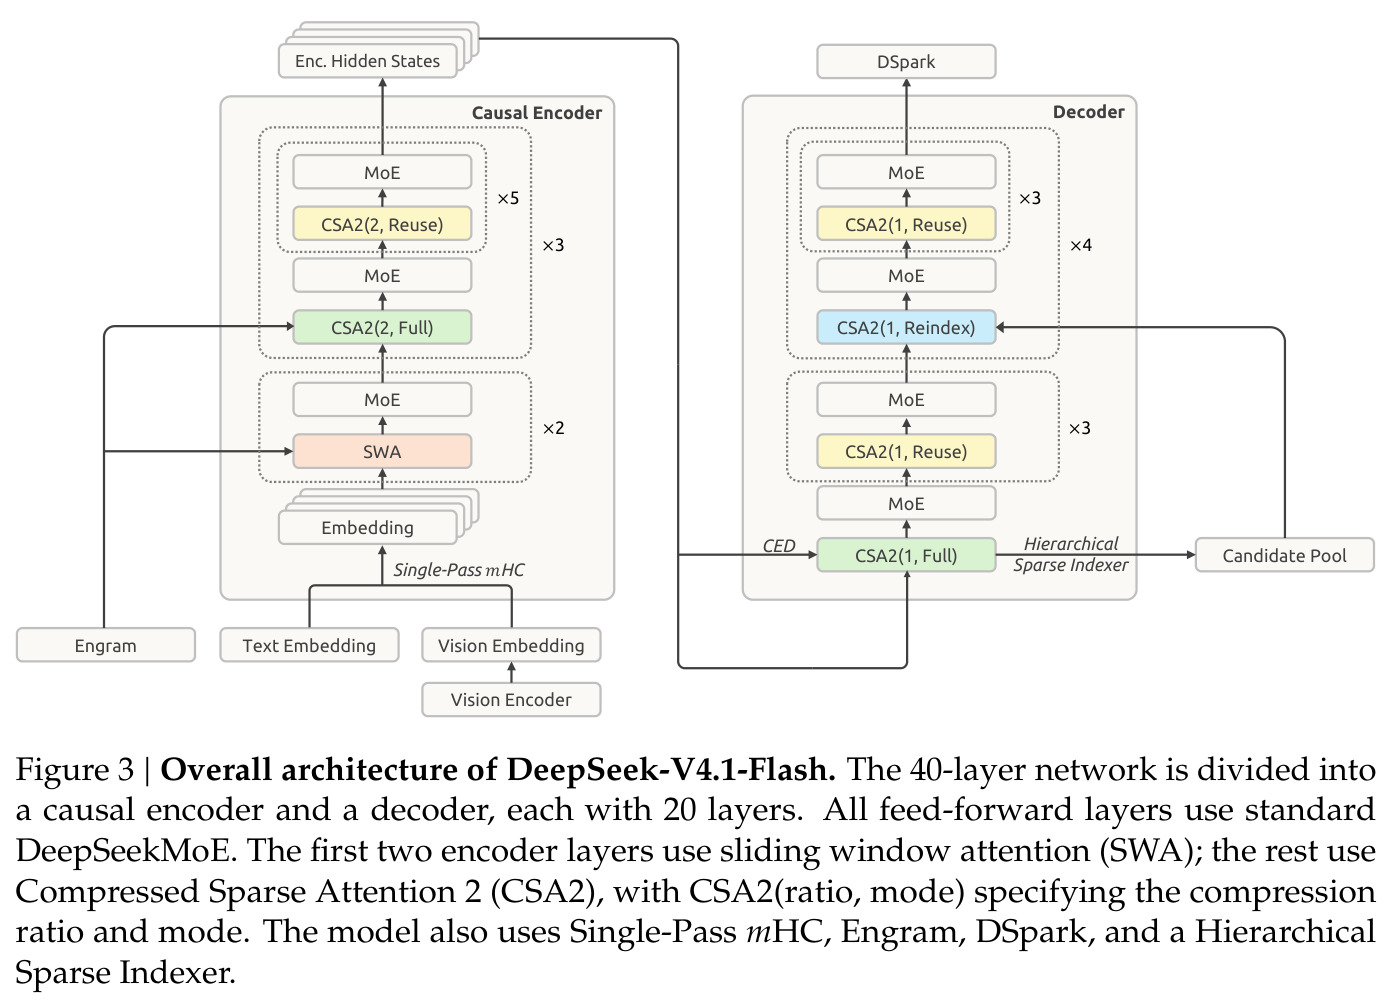
直觉上,DeepSeek-V4 可看成「SWA 局部处理主干 + 少量压缩的全局上下文」,因此压缩的着力点是简化全局分支、保留局部注意力。本文沿三条正交路线推进:架构上,用 CED 把 40 层拆成 20 层因果编码器 + 20 层解码器,解码器全局 KV 直接从编码器末端隐状态投影得到,prefill 只跑前一半层;用 CSA2 在层间共享 main KV 与 indexer K,按 Full/Reindex/Reuse 三种模式复用 Top-K 索引,并以层次化稀疏索引器把后续索引器打分范围缩到 16,384 个候选位置。精度上,主 KV 缓存用量化感知训练压到 FP4(RoPE 后量化,SWA KV 保留 FP8)。部署上,SWA KV 彻底移出持久缓存,未命中时用 SWA Bounded Replay 只重放最后 128 个 token 近似重建。再叠加 Single-Pass mHC、Engram 条件记忆(196B 参数)、DSpark 推测解码,模型在 45T token 多模态语料上从零预训练,稀疏注意力从 64K 直接开训、34T token 处扩到 1M。

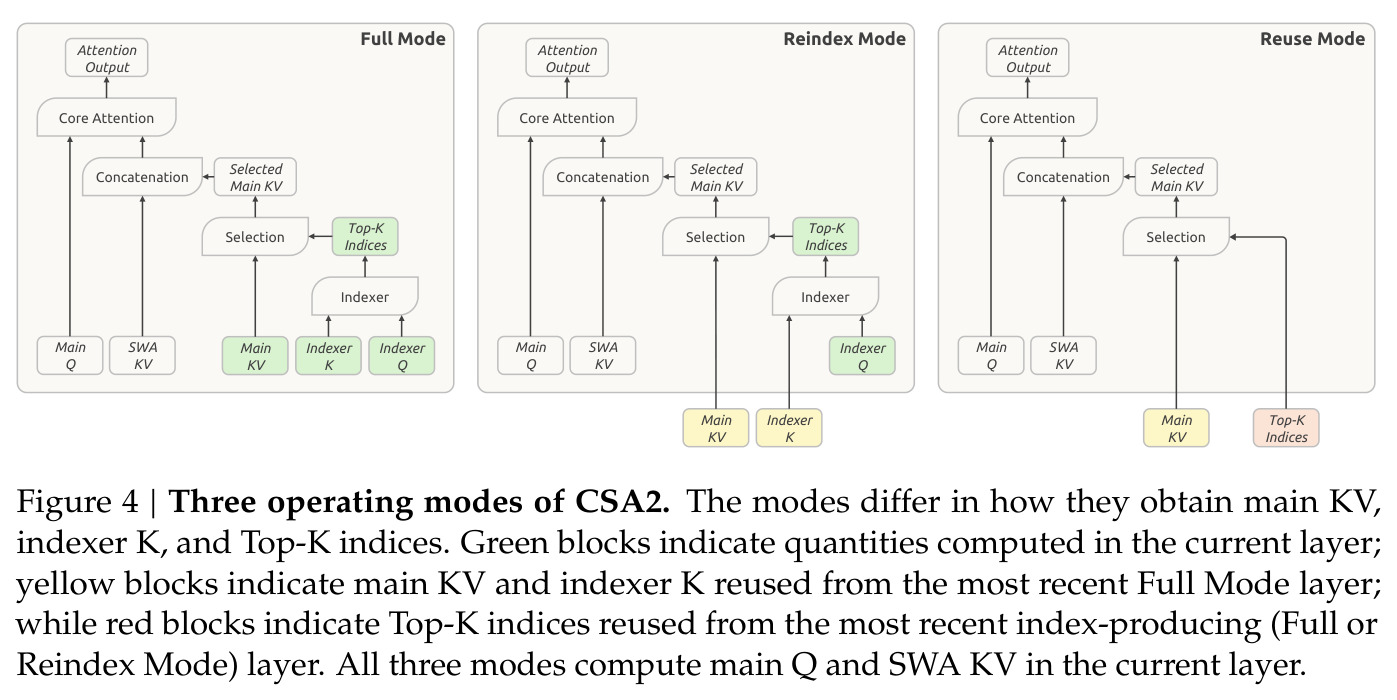
核心创新是把「缓存共享」与「索引复用」解耦:每个 CSA2 层都自算自己的 query 和 SWA KV,但 main KV、indexer K、Top-K 索引三件套可以分别向前层借用。Full 模式自产三件套并执行完整索引;Reindex 模式只借 KV 和 indexer K,用自己的 indexer Q 重新打分选出新的 Top-K(稀疏选择可以逐层变化);Reuse 模式连 Top-K 也借,直接做稀疏注意力、连索引器都不用跑。这与 YOCO(上层整体共享下层 KV)、IndexCache(只复用索引)、YOIO(全网一次路由)都不同:它同时吃到层维度(复用)、序列维度(压缩比 $m$)与条目维度(MLA 式低秩 + FP4)三个乘性维度的收益,而 Reindex 模式保证了「共享存储但不共享选择」的表达力。另一个关键想法是 SWA Bounded Replay:实验证明只重放最近 $n_{win}=128$ 个 token 的近似重建几乎不损质量,从而让 SWA KV 完全退出持久缓存,把「灾难性缓存未命中」变成「廉价的 graceful 退化」。

方法步骤详情

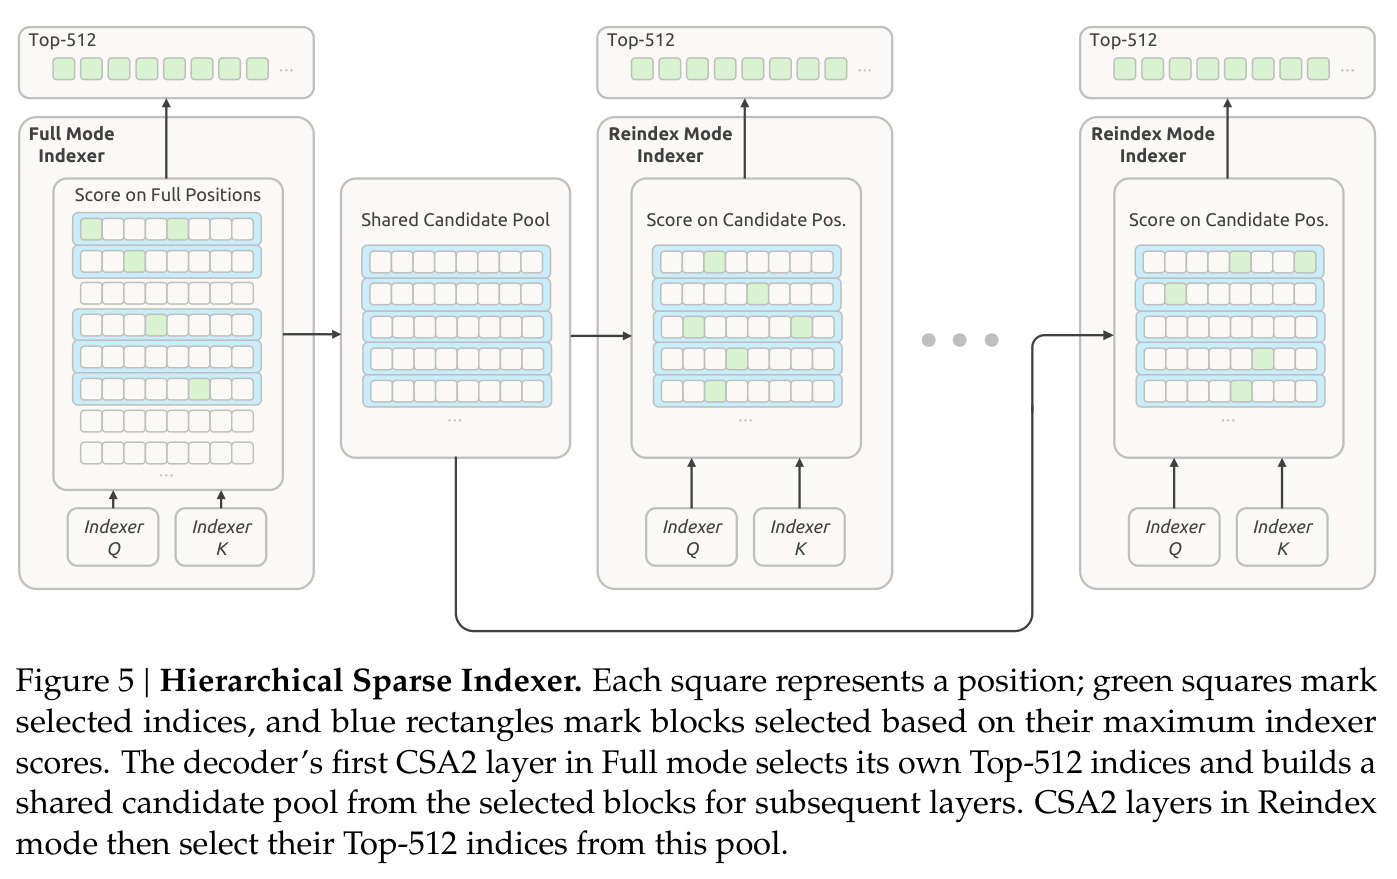
第一步,配置:40 层(维 5120),前 2 层纯 SWA(窗口 128);编码器其余 18 层为 CSA2 $m=2$(每组 1 Full + 5 Reuse);解码器 20 层为 CSA2 $m=1$(首组 1 Full + 3 Reuse,其余各 1 Reindex + 3 Reuse)。第二步,CED 前向:编码器逐层生成全局 KV;解码器全局 KV 按 $C^l = H^{L/2} W^l_{KV}$ 从编码器末端隐状态投影,SWA KV 逐层计算。第三步,层次化索引:首个 Full 层在全上下文选 Top-512,按块最大分选 2,048 块 × 8 位置 = 16,384 个候选构成共享池,Reindex 层只在池内选 Top-512。第四步,FP4 主 KV:E2M1 配每 16 通道一个 E4M3 scale,RoPE 后量化 QAT。第五步,部署:全局 KV 留持久缓存(≥72h),SWA KV 移入 10% 主存池(TTL 几分钟),未命中只重放 128 个 token 重建;prefill 对解码器亦重放,复杂度从 $O(NL)$ 降至约 $O(NL/2)$。

技术新颖性

新颖性有四。其一,CSA2 把层维度复用做成「main KV、indexer K、Top-K 三件套分别可借」的模式矩阵,并证明 KV 复用与索引复用可解耦组合——此前的 IndexCache/YOIO/HySparse 各只做一环;同时 CSA2 简化了 CSA 压缩器(去掉 $2m$ 重叠源与绝对位置嵌入,indexer K 改由 main KV 投影)。其二,层次化稀疏索引器利用解码器分层结构:浅层索引器的块级分数免费充当深层索引器的候选域,每 query 打分成本从线性降为常数(16,384),且训练感知地在后训练同步施加。其三,FP4 主 KV:经 RMSNorm 与 RoPE 范数分析证明可省去二级全局 scale(KV 潜变量范数上界约 $\sqrt{512} \approx 22.6$,训练实测最大约 10,格式上界 2688),缓存布局更简。其四,Single-Pass mHC 把混合系数错位一个块($X^{l+1} = B^l X^l + C^l F^l(A^{l-1} X^l)$),Mega-mHC 以 $(2n+2)d$ 访存达到理论下界,激活流量减半。
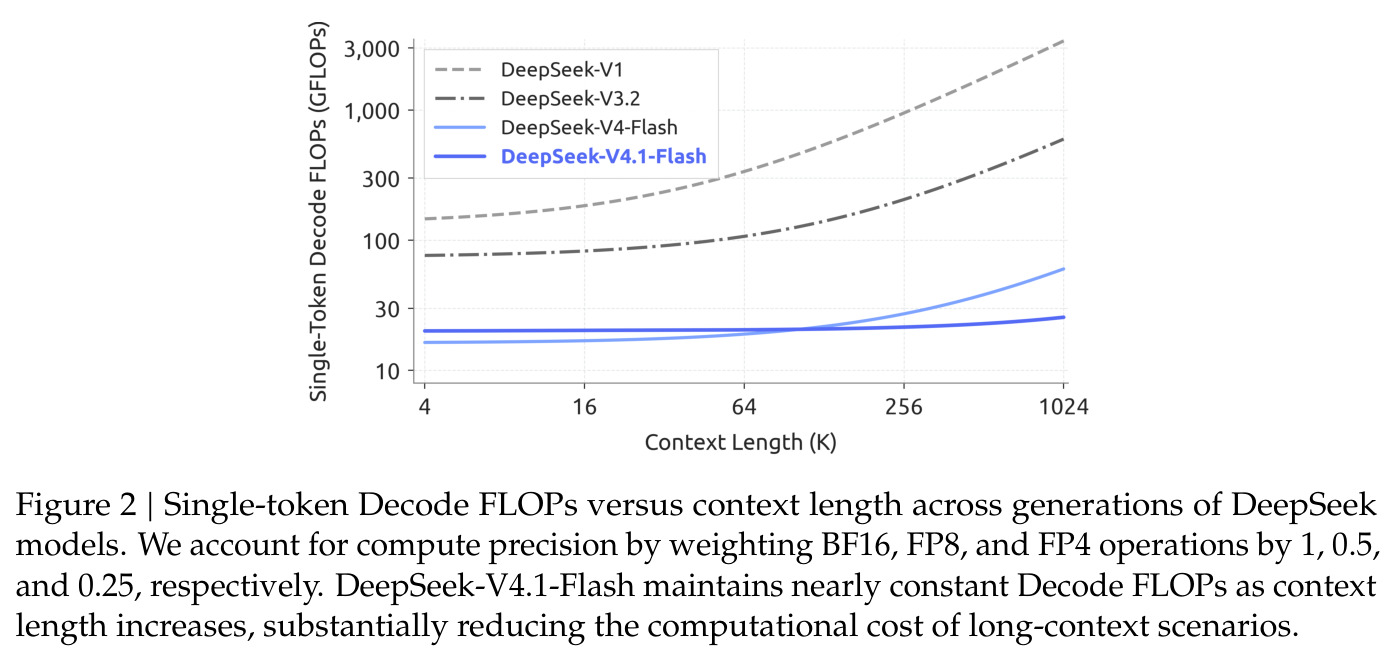
Single-token Decode FLOPs versus context length across generations of DeepSeek models.
Figure 2: Single-token Decode FLOPs versus context length across generations of DeepSeek models.
Overall architecture of DeepSeek-V4.1-Flash.
Figure 3: Overall architecture of DeepSeek-V4.1-Flash.
Three operating modes of CSA2.
Figure 4: Three operating modes of CSA2.
Hierarchical Sparse Indexer.
Figure 5: Hierarchical Sparse Indexer.

实验结果

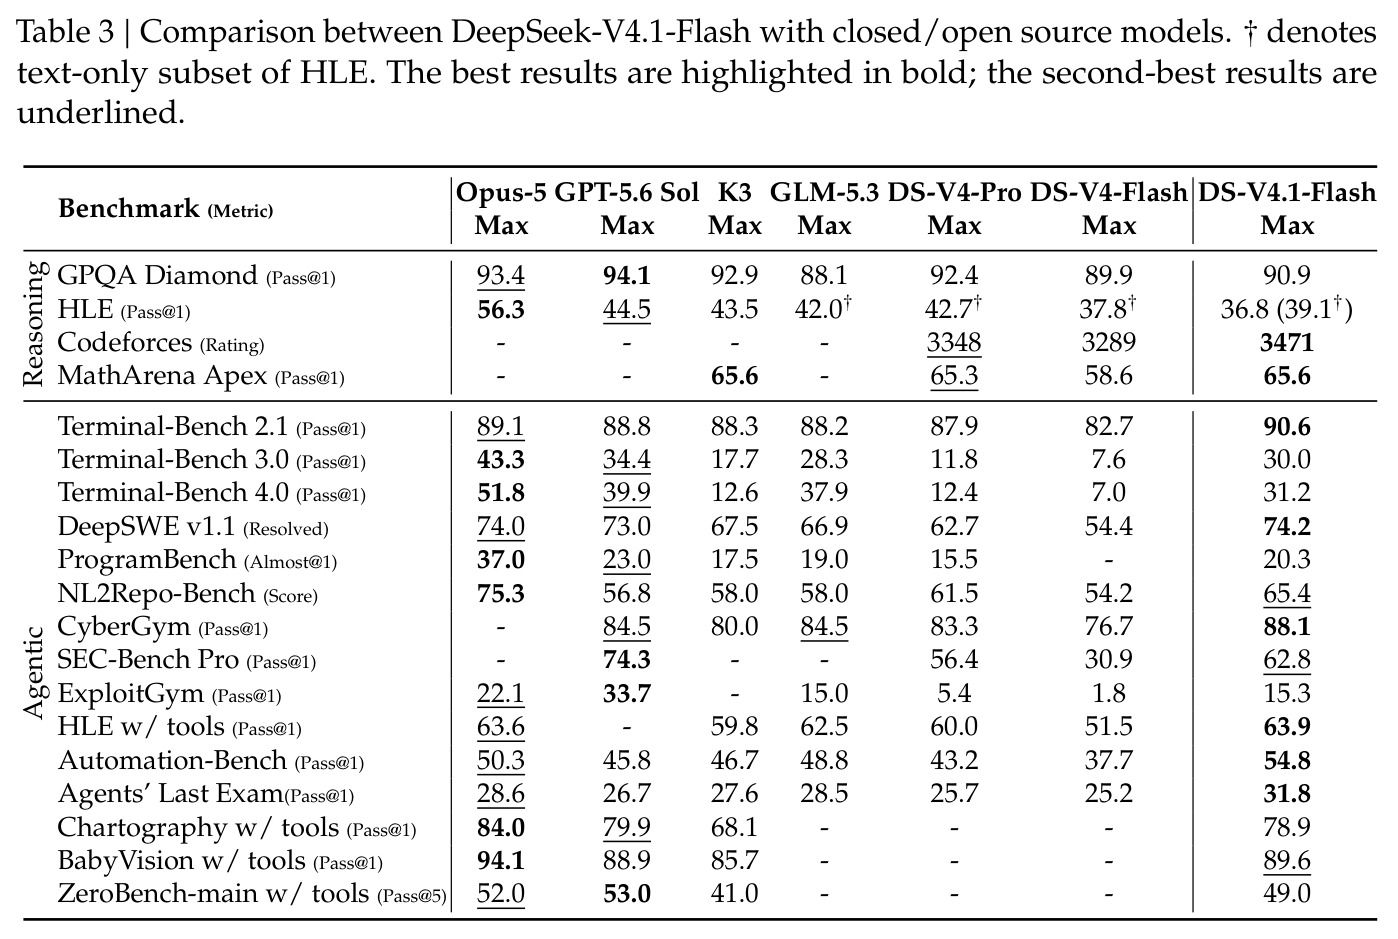
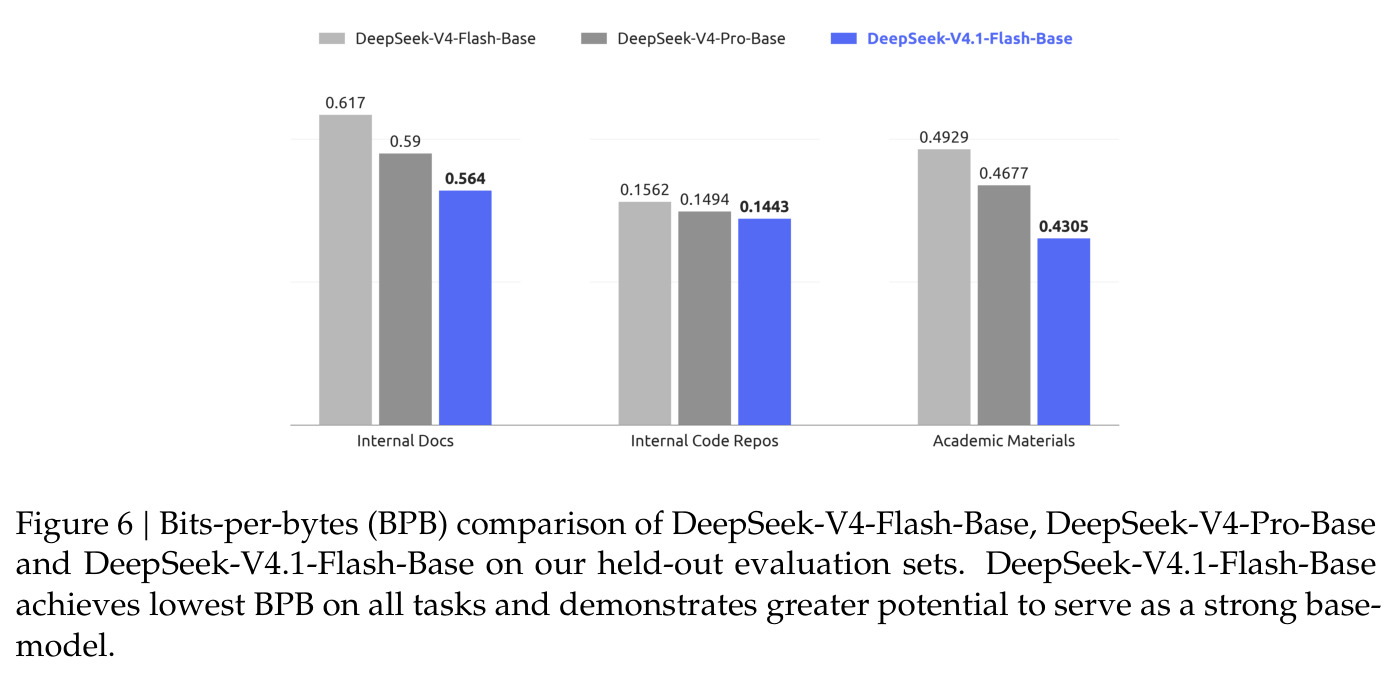
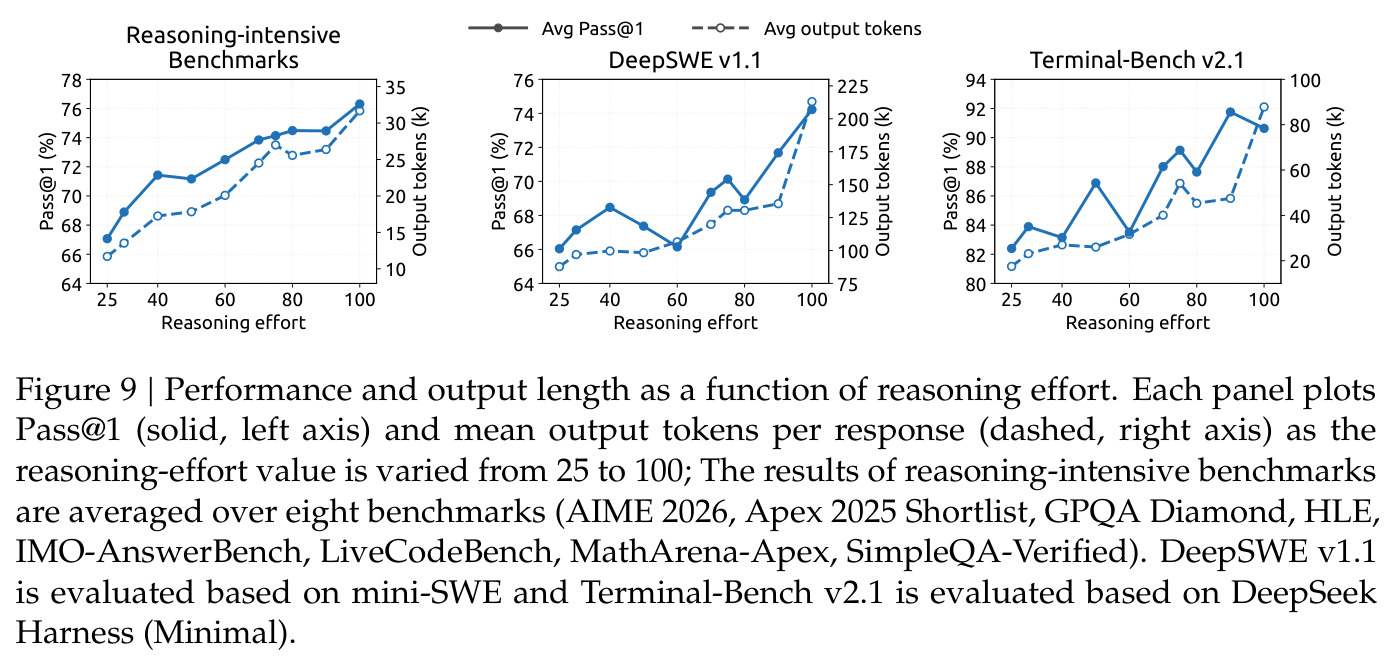
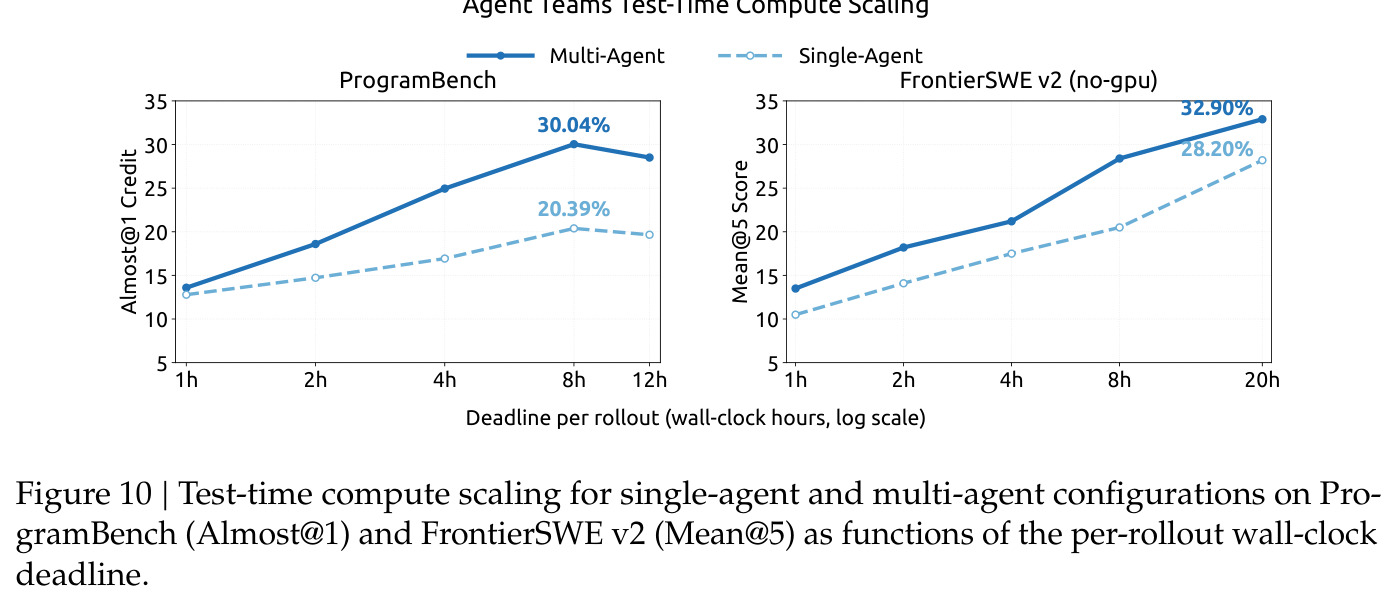
基座层面:552B 总参/8B 激活(V4-Pro-Base:1.6T/49B),MMLU-Pro 74.1(超 V4-Pro 的 73.5)、HumanEval 79.4 领先,内部 BPB 评测全任务最优,1/3 总参、1/4 激活换来 5%–10% 提升。对话层面:Codeforces 3471 超 V4-Pro(3348);DeepSWE v1.1 达 74.2%(前代 54.4%,超 Opus-5 74.0%),TB2.1 达 90.6%(Opus-5 89.1%),CyberGym 等亦最高;但 HLE 仅 36.8%(Opus-5 56.3%)、TB4.0 仅 31.2%(51.8%)。效率层面:全局 KV 890 字节/token(V4-Flash 的 1/4、V1 的 1/437),持久缓存为前代 1/8,上下文 4K→1M 时解码 FLOPs 仅增 1/4。可控力度 25→100 使 8 个推理基准均值 67.1%→76.3%(2.5 倍 token);多智能体在 ProgramBench 8 小时 Almost@1 达 30.04%(单 20.39%)。
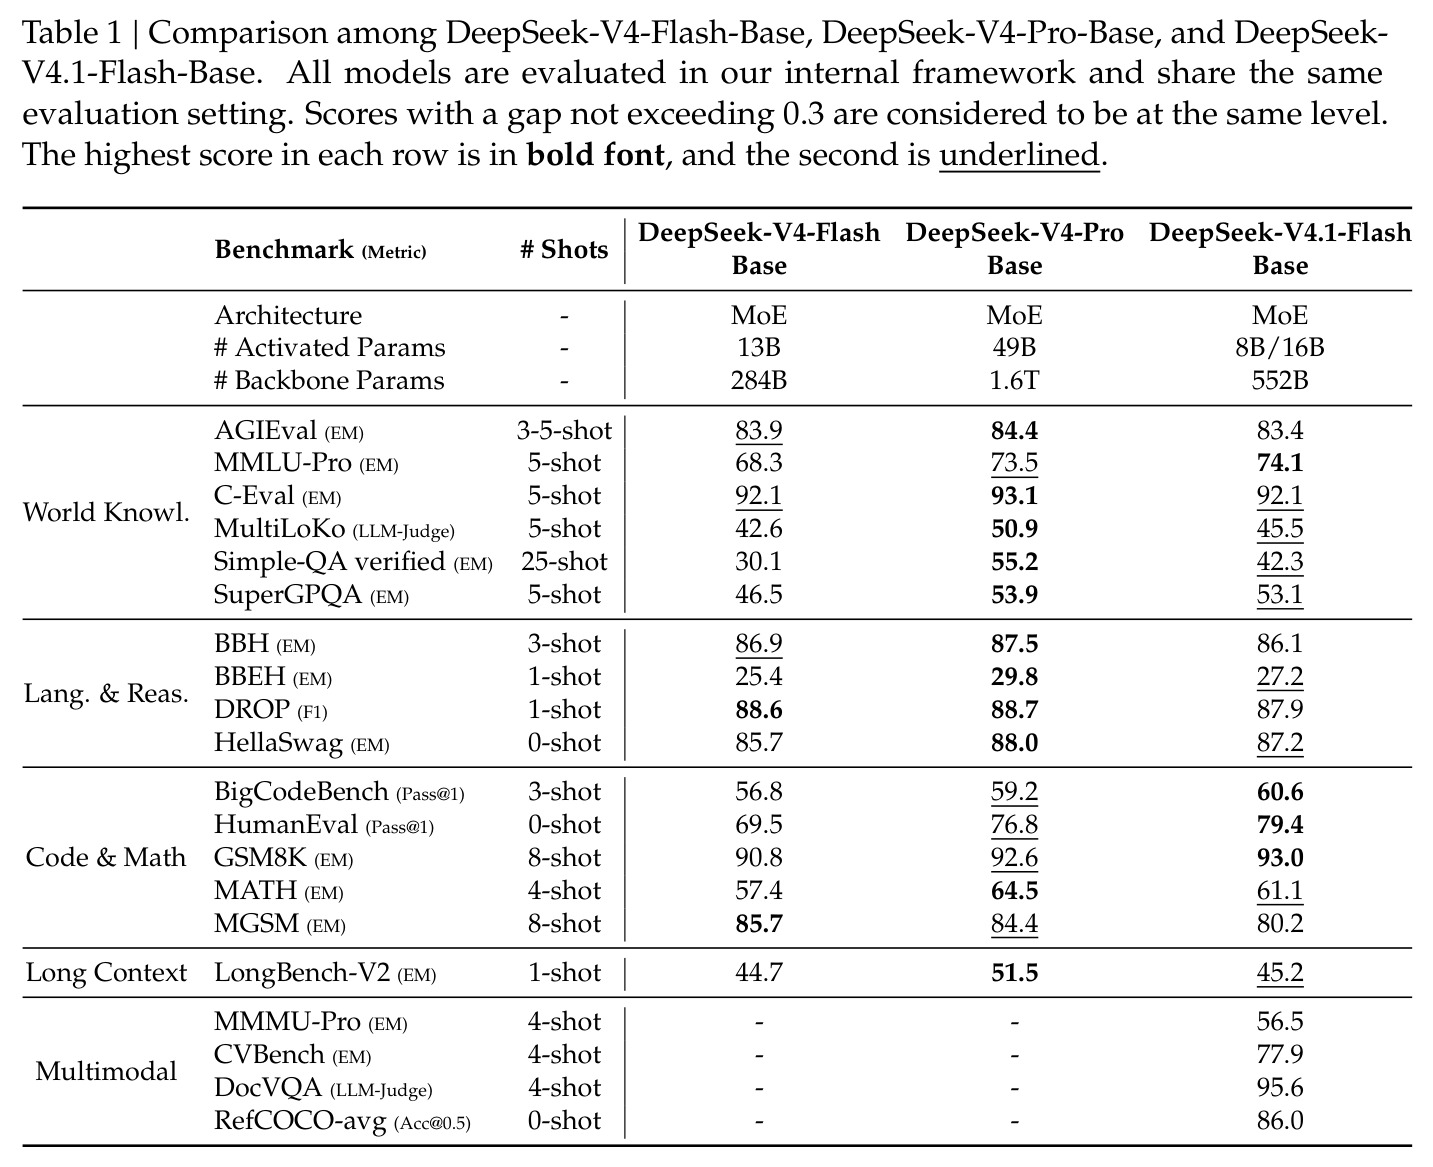
Comparison among DeepSeek-V4-Flash-Base, DeepSeek-V4-Pro-Base, and DeepSeek-V4.1-Flash-Base.
Table 1: Comparison among DeepSeek-V4-Flash-Base, DeepSeek-V4-Pro-Base, and DeepSeek-V4.1-Flash-Base.
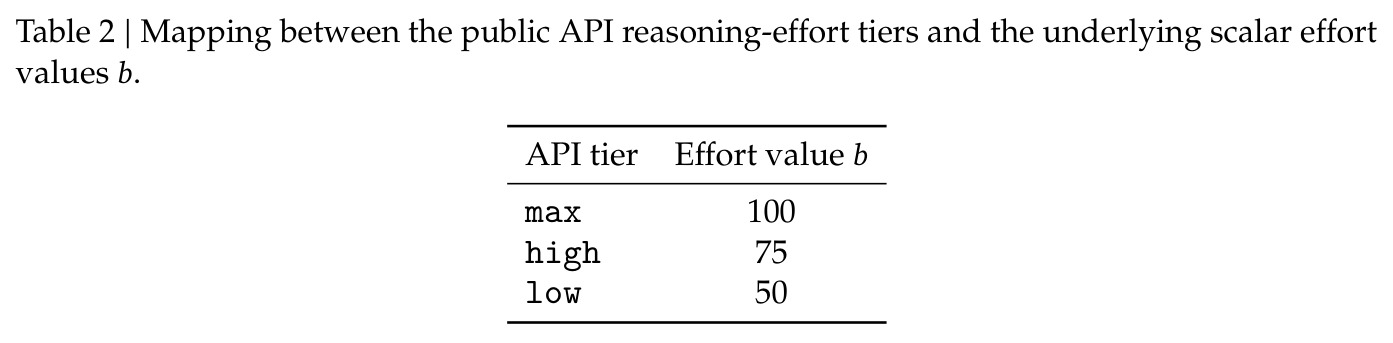
Mapping between the public API reasoning-effort tiers and the underlying scalar effort values b.
Table 2: Mapping between the public API reasoning-effort tiers and the underlying scalar effort values b.
Comparison between DeepSeek-V4.1-Flash with closed/open source models.
Table 3: Comparison between DeepSeek-V4.1-Flash with closed/open source models.
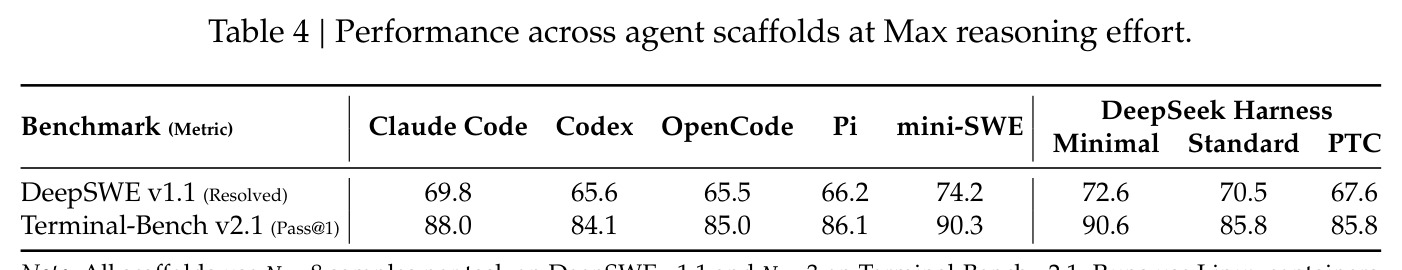
Performance across agent scaffolds at Max reasoning effort.
Table 4: Performance across agent scaffolds at Max reasoning effort.
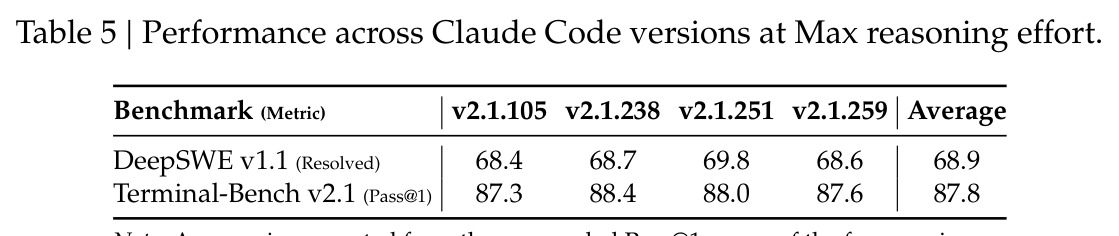
Performance across Claude Code versions at Max reasoning effort.
Table 5: Performance across Claude Code versions at Max reasoning effort.
Bits-per-bytes (BPB) comparison of DeepSeek-V4-Flash-Base, DeepSeek-V4-Pro-Base and DeepSeek-V4.1-Flash-Base on our held-out evaluation sets.
Figure 6: Bits-per-bytes (BPB) comparison of DeepSeek-V4-Flash-Base, DeepSeek-V4-Pro-Base and DeepSeek-V4.1-Flash-Base on our held-out evaluation sets.
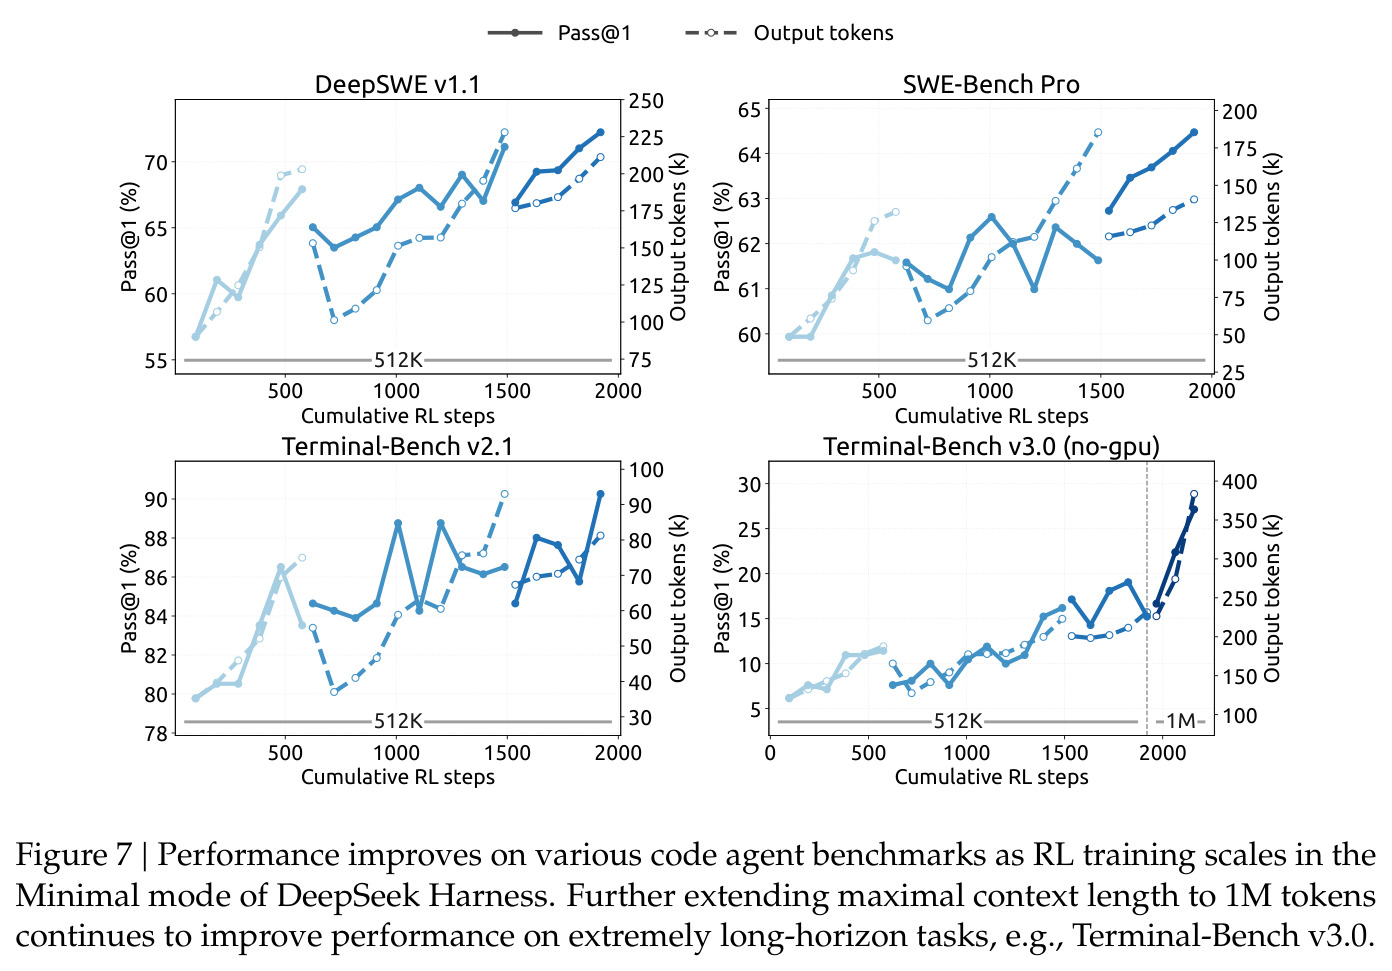
Performance improves on various code agent benchmarks as RL training scales in the Minimal mode of DeepSeek Harness.
Figure 7: Performance improves on various code agent benchmarks as RL training scales in the Minimal mode of DeepSeek Harness.
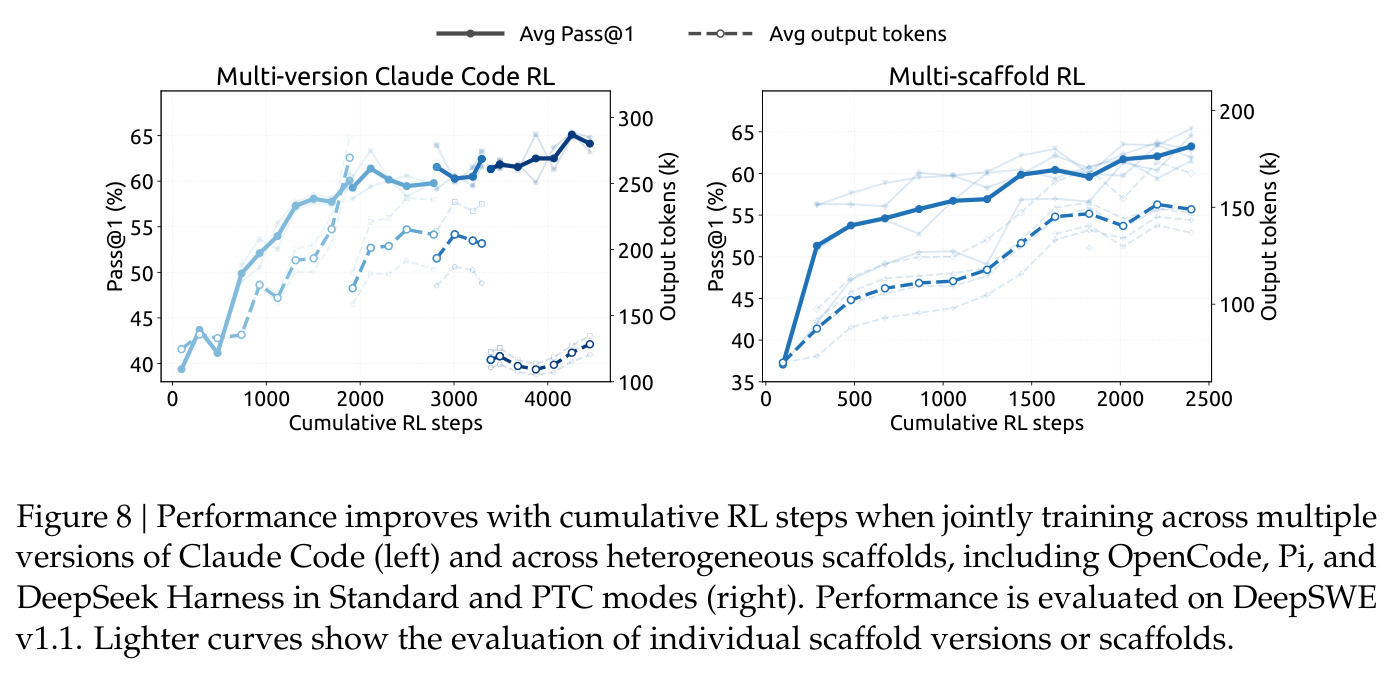
Performance improves with cumulative RL steps when jointly training across multiple versions of Claude Code (left) and across heterogeneous scaffolds, including OpenCode, Pi, and DeepSeek Harness in Standard and PTC modes (right).
Figure 8: Performance improves with cumulative RL steps when jointly training across multiple versions of Claude Code (left) and across heterogeneous scaffolds, including OpenCode, Pi, and DeepSeek Harness in Standard and PTC modes (right).
Performance and output length as a function of reasoning effort.
Figure 9: Performance and output length as a function of reasoning effort.
Test-time compute scaling for single-agent and multi-agent configurations on ProgramBench (Almost@1) and FrontierSWE v2 (Mean@5) as functions of the per-rollout wall-clock deadline.
Figure 10: Test-time compute scaling for single-agent and multi-agent configurations on ProgramBench (Almost@1) and FrontierSWE v2 (Mean@5) as functions of the per-rollout wall-clock deadline.
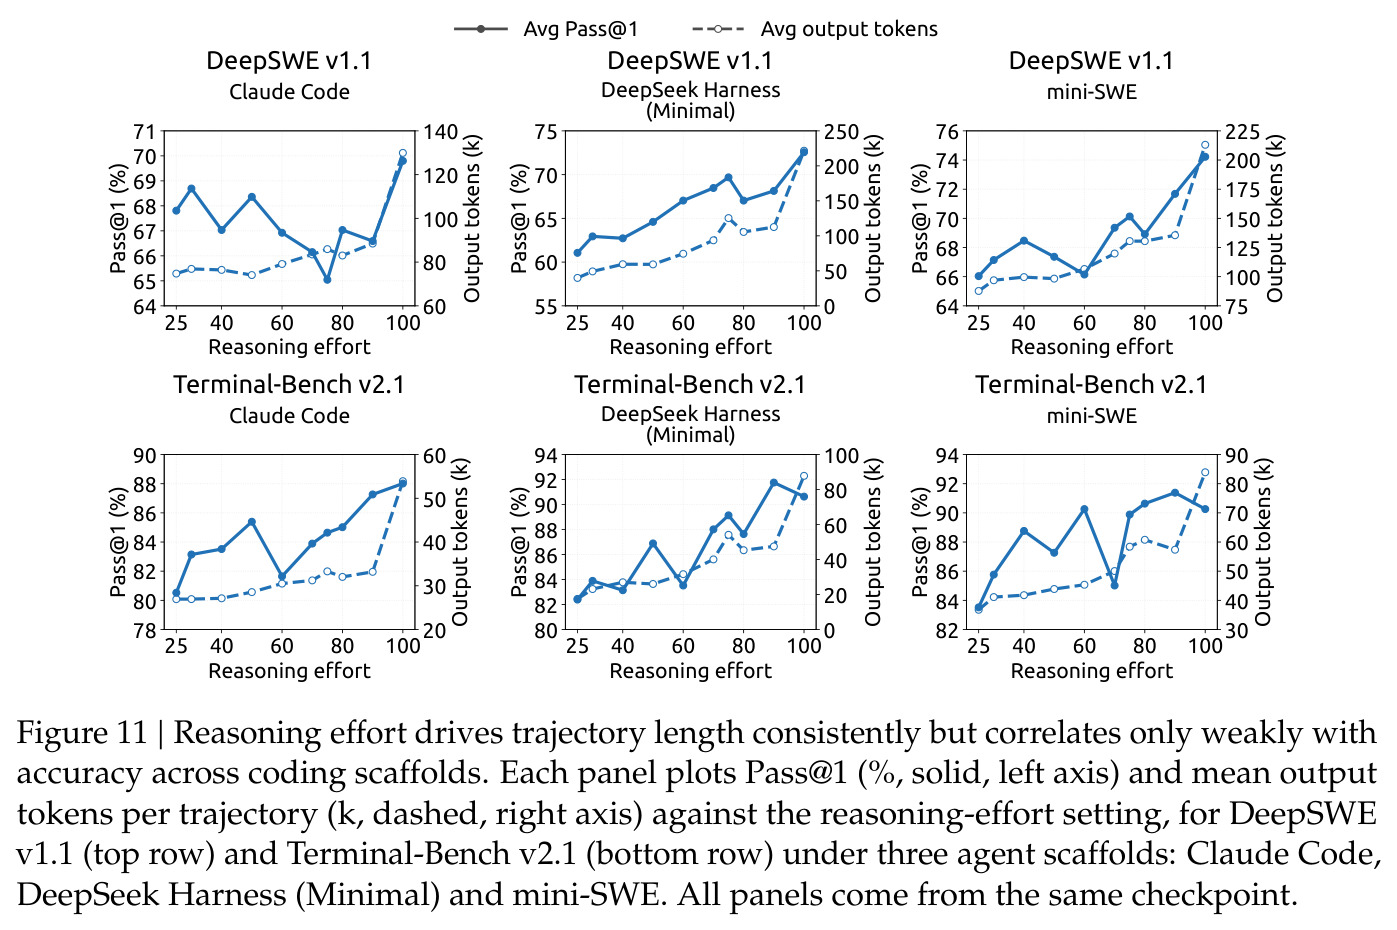
Reasoning effort drives trajectory length consistently but correlates only weakly with accuracy across coding scaffolds.
Figure 11: Reasoning effort drives trajectory length consistently but correlates only weakly with accuracy across coding scaffolds.
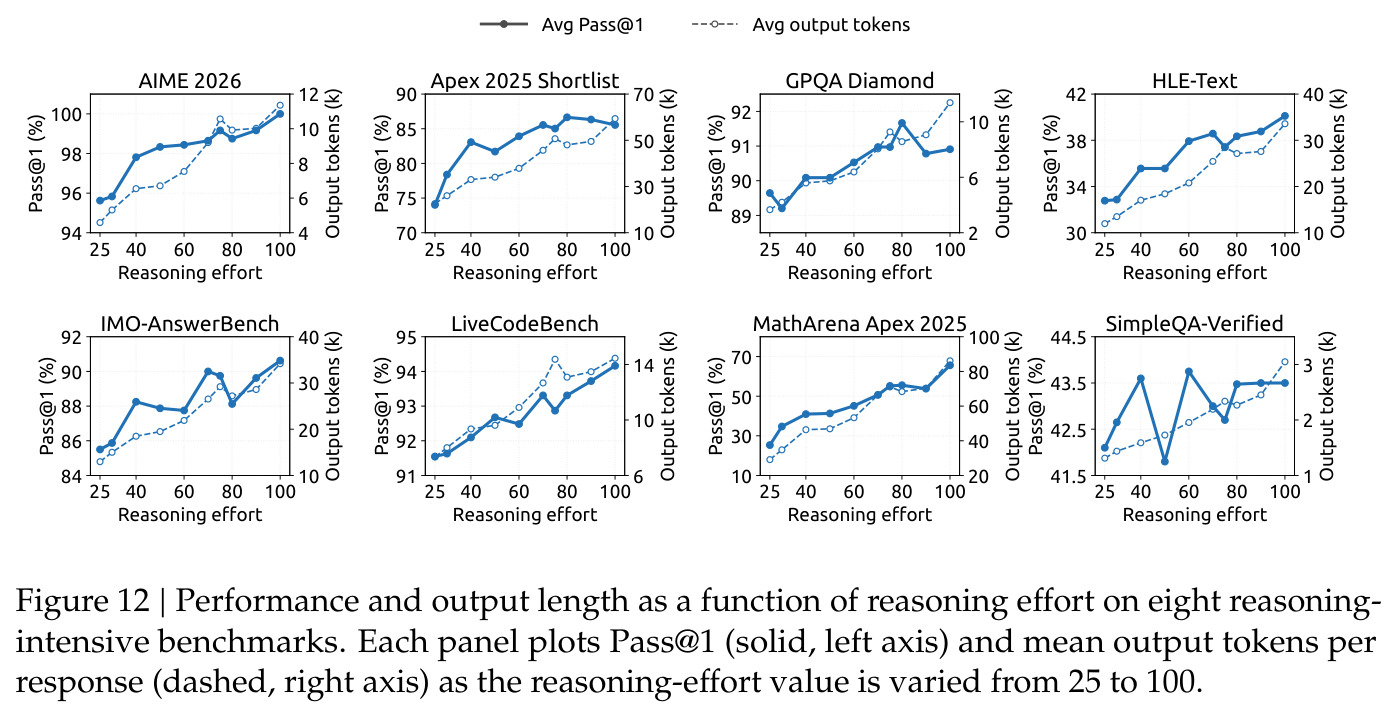
Performance and output length as a function of reasoning effort on eight reasoning-intensive benchmarks.
Figure 12: Performance and output length as a function of reasoning effort on eight reasoning-intensive benchmarks.
查看结构化数据
任务指标本文基线提升
全局 KV 缓存足迹(常驻 HBM) 字节/token 890 DeepSeek-V4-Flash(约 4 倍于本文) 约 1/4;相对 DeepSeek-V1 约 1/437
持久化 KV 缓存足迹(SSD/主存) 相对前代体积 约 1/8 DeepSeek-V4-Flash 减少约 7/8
DeepSWE v1.1(代码智能体) Resolved % 74.2 Opus-5 74.0;V4-Flash 54.4 较前代 +19.8
Terminal-Bench 2.1(终端智能体) Pass@1 % 90.6 Opus-5 89.1;V4-Flash 82.7 全场最高,较前代 +7.9
Codeforces(竞技编程) Rating 3471 V4-Pro 3348;V4-Flash 3289 较 V4-Pro +123
CyberGym(网络安全) Pass@1 % 88.1 GPT-5.6 Sol / Kimi-K3 84.5 +3.6,开源模型新 SOTA
Automation-Bench(通用智能体) Pass@1 % 54.8 Opus-5 50.3;V4-Flash 37.7 全场最高,较前代 +17.1
MMLU-Pro(基座世界知识) EM % 74.1 V4-Pro-Base 73.5(1.6T/49B);V4-Flash-Base 68.3 以 1/3 总参、1/4 激活反超
单 token decode FLOPs(4K→1M 上下文) 精度加权 FLOPs 增幅 约 +25% DeepSeek-V4-Flash 随长度显著增长 近乎恒定的解码成本
Humanity's Last Exam(最难推理) Pass@1 % 36.8(纯文本子集 39.1) Opus-5 56.3 落后 19.5 分,作者如实承认的差距

局限与改进

作者承认的局限:一是新架构带来尚未完全刻画的鲁棒性边界——CSA2 的稀疏选择错误与 SWA Bounded Replay 的近似重建在未测试的极端输入下可能造成能力退化;二是在最难任务上与最大闭源系统差距可见(HLE 36.8% vs Opus-5 56.3%,TB4.0 31.2% vs 51.8%,视觉智能体落后);三是评测基础设施(Docker、校验脚本)易被强模型钻空子,作者在 CyberGym 观察到模型反编译 Ubuntu 包找漏洞的行为。我的补充:压缩配置($m$、模式分布、候选池 16,384)全部静态写死,无法按任务自适应;第一个 Full 层仍需全上下文线性扫描,1M 上下文首次索引代价可观;基座评测依赖内部 held-out 语料与内部框架,外部无法核验;890 字节/token 仍随长度线性增长,1M 单请求约 0.9GB,成本压力只是缓解而非消除。

独立分析的弱点

独立分析四点弱点。其一,Reuse 模式连续 3–5 层共享同一 Top-K 选择,多层注意力检索同质化,在需要逐层检索不同证据的多跳推理或长文档精确引用任务上可能退化——可探索让相邻 Reuse 组借用不同父层的选择,或按索引分数熵动态决定是否升级为 Reindex。其二,SWA 窗口 128 加有界重放的近似重建,对「长文件跨窗口精确编辑」「代码仓库中长距离符号引用」这类强局部精确依赖场景的影响未单独量化,论文只报告总体基准分——建议增加针对性的缓存恢复边界压力测试并公开失败案例分布。其三,FP4 主 KV 对极端幅值的鲁棒性论证依赖训练期观察(最大幅值约 10,格式上界 2688),但检索类任务(大海捞针、数值精确匹配)的量化误差累积没有单独报告——可在敏感层回退 FP8 或引入逐条目异常值保护。其四,多智能体测试时扩展依赖墙钟截止时间口径,且收益(30.04% vs 20.39%)伴随成倍的容器与协调开销,性价比边界没有给出——应补充同等 token 预算下的单/多智能体对照实验。

未来方向

作者提出的方向:继续扩大压力测试与评测栈,重点刻画长上下文稀疏检索与缓存恢复边界处的 SWA 状态重建失败模式;以数据、模型容量与 RL 的协同扩展推进智能上限,而非单点算法创新;推进模型–harness 协同设计让模型与智能体框架共同演化;持续降低成本,使高能力智能体更易部署到更广行业场景。基于本文成果可自然延伸的方向:把 CSA2 的静态模式分配改为可学习或输入自适应(按上下文混乱度动态调整 Reindex/Reuse 比例);把层次化候选池推广为多级池并随上下文长度伸缩;将 SWA Bounded Replay「近似重建换免存储」的思想推广到其他有状态算子(如局部卷积缓存、线性注意力状态);探索 FP4 之下的 KV 压缩(FP3、乘积量化、语义去重);以及把可控推理力度与 KV/上下文预算联动,形成「上下文预算 + 思考预算」的统一成本控制接口。

复现评估

开源情况:基座与对话模型权重已在 HuggingFace 发布(deepseek-ai/DeepSeek-V4.1-Flash)。论文对架构超参(40 层、隐藏维 5120、top-$k$=512、窗口 128、压缩比与 Full/Reindex/Reuse 模式分布)、训练超参(批量 100.6M token、峰值学习率 $2.6 \times 10^{-4}$ 及衰减日程、Muon/AdamW/Sinkhorn 三套优化器配置)和评测 scaffold 配置(附录 B 给出各 harness 版本号与采样设置)的披露相当详尽,因此推理与评测层面的复现可行性较高——8B/16B 激活配合 FP4 KV 对设备要求虽不低但可达。但训练复现基本不可能:45T token 多模态预训练算力未披露,后训练依赖的百万级 DSec 沙箱、内部员工工作流数据、40+ 教师模型的在线蒸馏、内部 held-out BPB 评测集均未公开。对研究者而言:可以复现推理与基准结论、可基于开源权重做微调与机制分析;无法复现预训练/后训练全流程。难度评级:推理复现中等,端到端复现极高。

相似论文推荐