MixTok:融合全局一维令牌与稀疏二维精修的自适应视觉分词器 MixTok: Adaptive Visual Tokenization with Global 1D Tokens and Sparse 2D Refinement
用紧凑一维全局令牌加内容自适应稀疏二维令牌精修,兼得压缩率与局部细节。
前置知识
视觉分词器
把连续图像压缩成离散 token 序列的模型,典型代表是 VQ-VAE/VQGAN:编码器把图像变成潜在特征,向量量化器把每个特征替换为码本中最近的条目得到离散索引,解码器再从量化特征重建图像。分词器为自回归或掩码式图像生成器提供建模空间,其 token 数量与保真度直接决定生成质量和计算成本。
MixTok 本身就是一个视觉分词器,全部设计围绕如何更高效地分配 token 容量展开,读懂方法必须先理解分词器的工作方式。
1D 与 2D 分词
2D 分词(如 VQGAN、LlamaGen VQ-16)把 256×256 图像编成 16×16=256 个与空间位置一一对应的 token 网格,保留局部结构但数量多;1D 分词(如 TiTok)用少量可学习查询把整图聚合成 32~128 个无显式空间对应的全局 token,紧凑但易丢失局部细节。两者代表紧凑性与局部保真之间的根本权衡。
MixTok 的核心就是把这两种范式以'全局基座+稀疏精修'的方式组合起来,理解各自的优劣是理解论文动机的前提。
MaskGIT 与 Halton 掩码生成
MaskGIT 是掩码式并行解码生成器:训练时随机掩码部分 token 让 Transformer 预测,推理时从全掩码开始,每轮按置信度并行揭示一批 token,几轮到几十轮即可生成整图。Halton-MaskGIT 用 Halton 序列确定揭示顺序替代随机掩码调度,进一步提升并行解码质量。
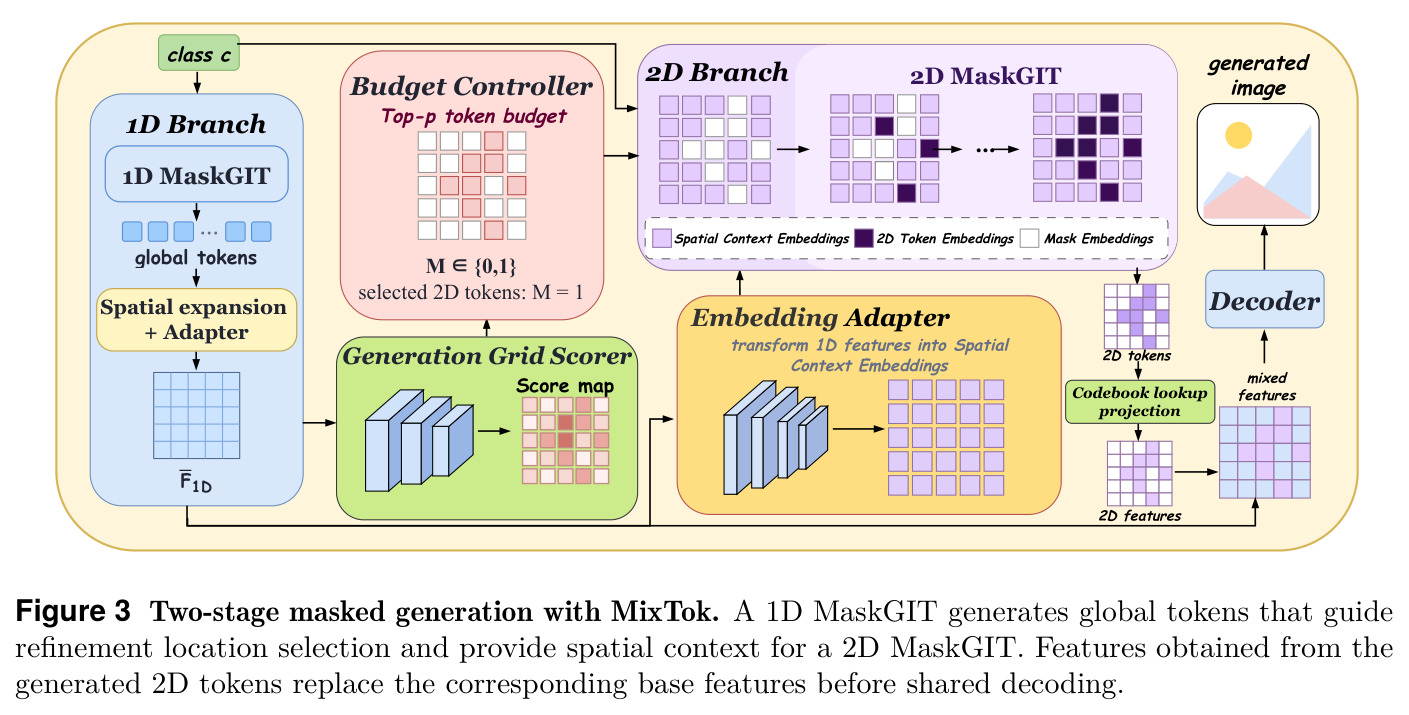
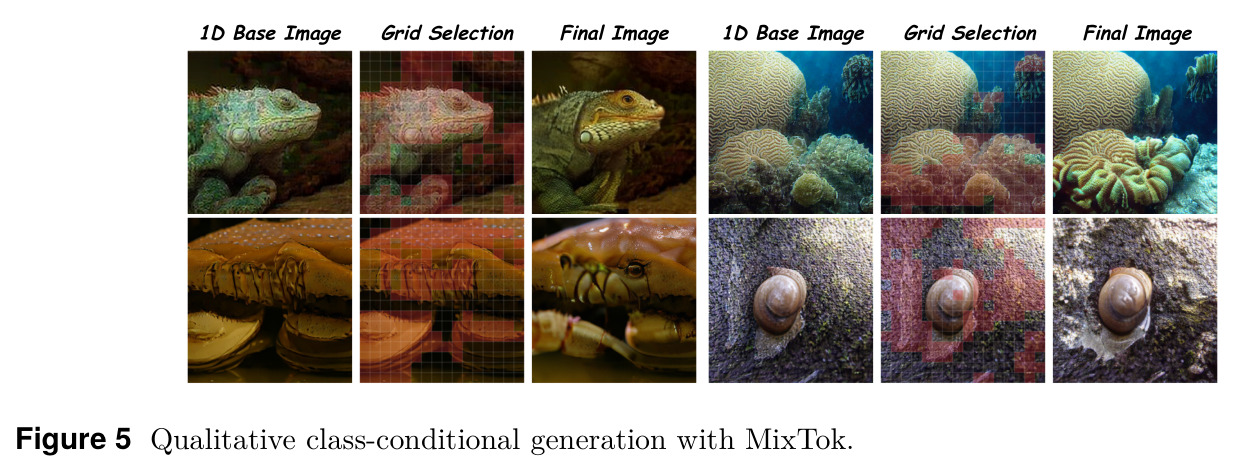
MixTok 的生成阶段是两级 MaskGIT:先生成 1D token,再在选中位置稀疏生成 2D token,采样轮数 8+8,不熟悉这一框架就无法理解生成流程。
rFID 与 gFID
FID 用 Inception 网络特征衡量两个图像集合的分布距离,越低越好。rFID 比较原始图像与重建图像的集合,衡量分词器的重建保真度;gFID 比较真实图像与生成图像(本文用 ADM 评测器,每个种子 5 万张类平衡样本),衡量端到端生成质量。二者分别对应表示质量与生成能力。
论文所有量化结论都以这两个指标报告(rFID 1.1950、gFID 1.9511),理解其含义才能正确解读实验结果。
top-p 采样
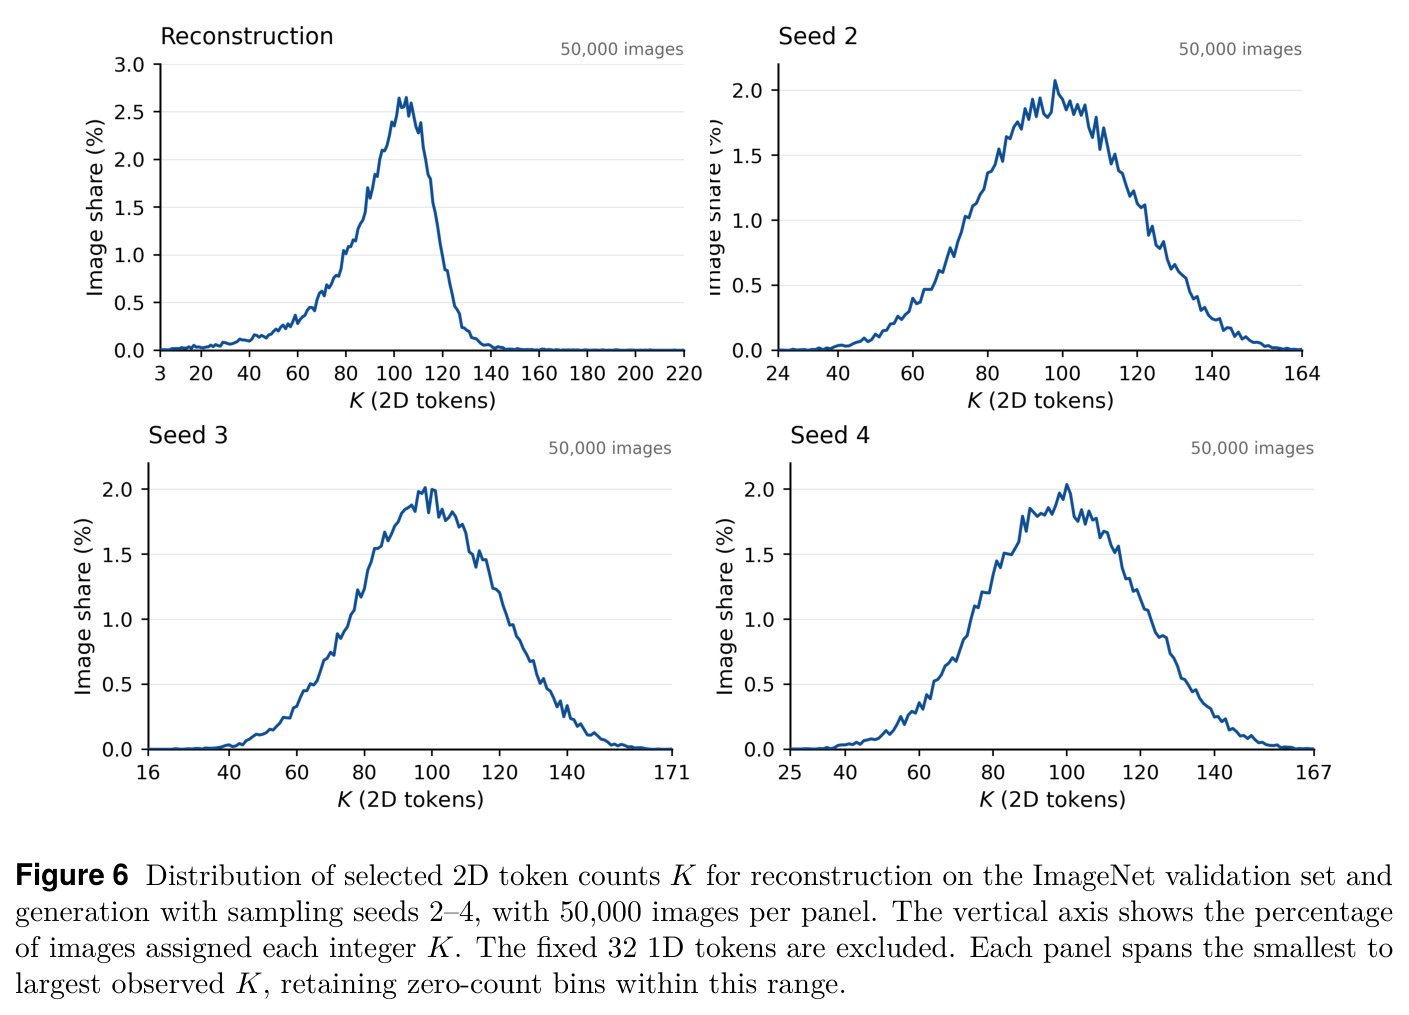
源自语言模型解码的策略:把候选按概率从高到低排序,取累计概率首次超过阈值 $p$ 的最短前缀。本文将其借用到空间选择:打分器输出的位置分数经温度 $T$ 的 softmax 归一化为概率分布 $q_i$,选累计概率达到 $p$ 的前 $K(x)$ 个位置,使 token 数随分数分布的集中程度自动变化。
top-p 预算控制器是 MixTok 实现'每图 token 数自适应'的关键机制,直接决定核心公式 $K(x)$ 的含义。
感知与对抗损失
LPIPS 用预训练网络特征衡量两图像的感知差异,比逐像素 MSE 更符合人眼判断;对抗损失(GAN)用判别器促使重建图像的纹理分布接近真实图像。二者与 L1 重建损失加权组合是自 VQGAN 以来图像分词器训练的标准配方。
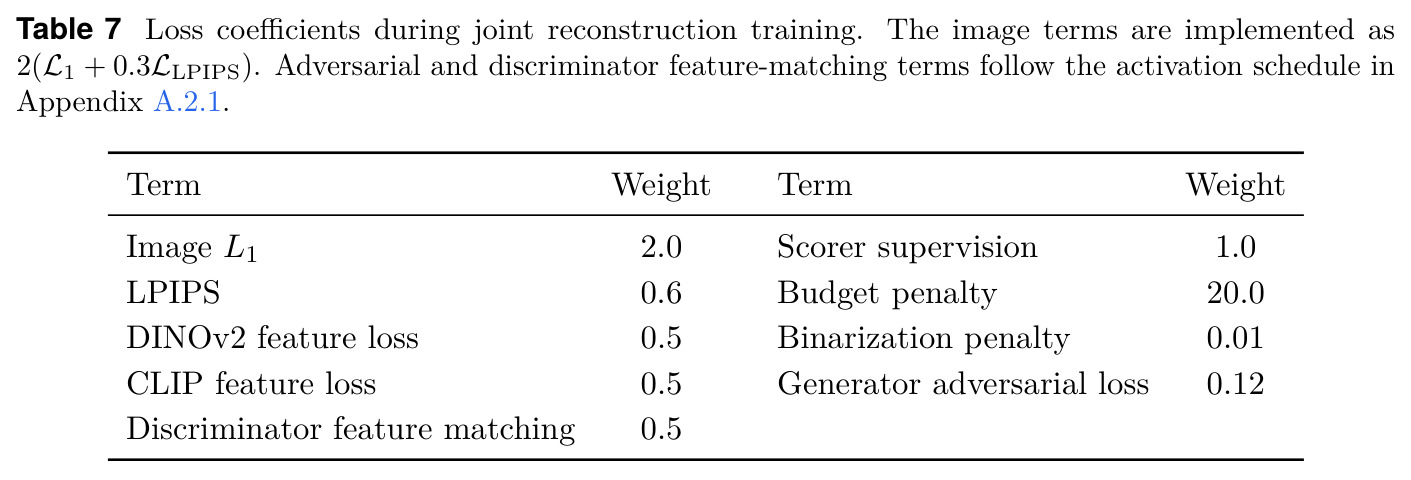
MixTok 的训练目标 $\mathcal{L}=\lambda_{rec}\|x-\hat{x}\|_1+\lambda_{per}L_{LPIPS}+\lambda_{adv}L_{GAN}$ 延续该配方,附录还加入 DINOv2/CLIP 特征损失,理解这些才能看懂训练细节。
研究动机
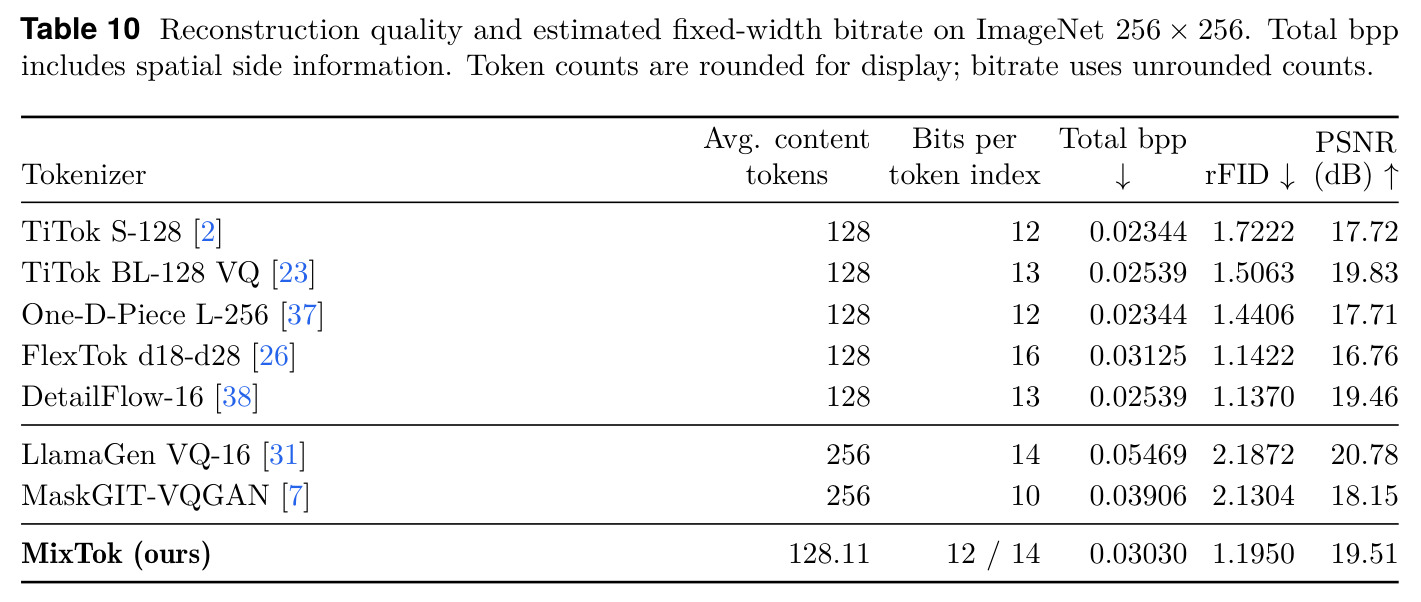
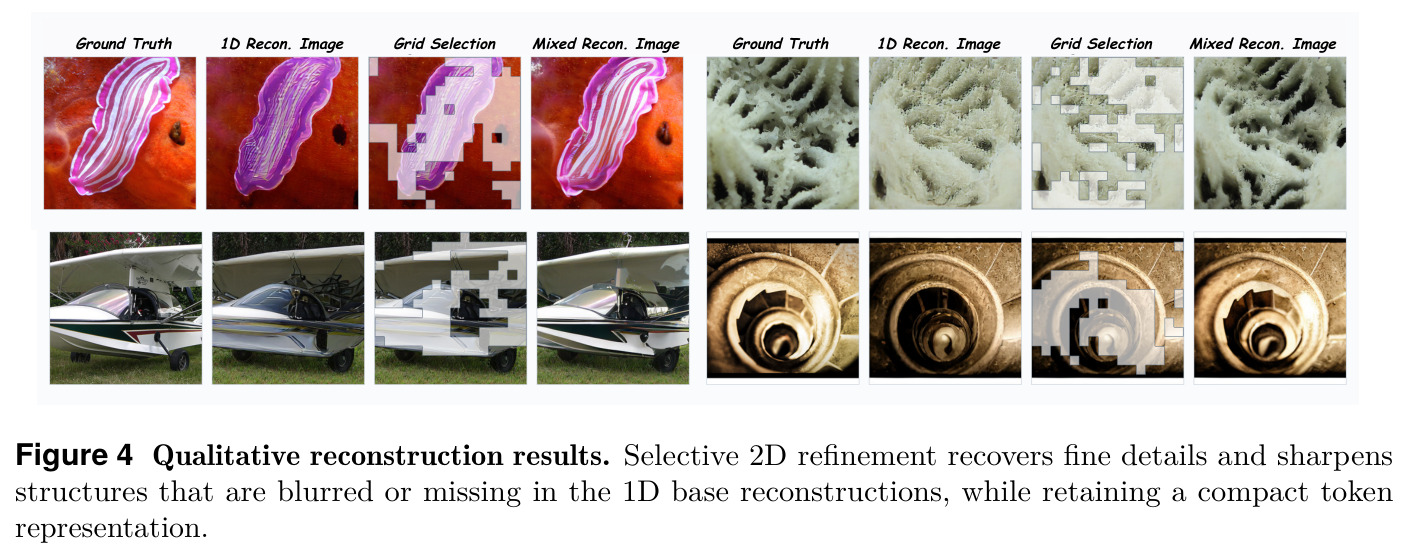
现有视觉分词器的容量分配方式与图像内容的非均匀复杂度不匹配。以 LlamaGen VQ-16 为代表的 2D 网格分词器把 256×256 图像编成 16×16=256 个 token,天空、水面等平滑区域与精细纹理区域获得完全相同的 token 密度,造成容量浪费(其 rFID 仅 2.1872);以 TiTok 为代表的 1D 分词器把整图压成 32~128 个全局 token,紧凑但难保留局部细节,TiTok S-128 的 rFID 只有 1.7222、PSNR 17.72 dB,条纹、曲线边界等常被模糊掉。此外,绝大多数分词器对同分辨率的所有图像使用固定 token 数,不随内容复杂度调整,导致简单图像被过度编码、复杂图像细节受限,这两类问题共同构成了本文的出发点。
本文的目标是本文目标是设计一个混合视觉分词器 MixTok:以少量 1D 全局 token(32 个)作为基础表示,再由内容自适应路由器决定在哪些空间位置、以及为每张图像额外分配多少个 2D token 做局部精修,并约束在目标平均 token 预算下(重建约 128 个、生成约 131 个内容 token)。定量目标是在 ImageNet 256×256 上同时取得高保真重建(rFID 约 1.2)与高质量类条件生成(gFID 约 2),且不显著增加采样轮数与延迟;同时方法要能建立在现成的 TiTok、LlamaGen 等预训练分词器之上,并可迁移到其他骨干。
与已有工作不同的是,已有的自适应分词工作只解决一半问题:FlexTok、ALIT、CAT 调整每张图的 token 数量但不决定空间位置;DQ-VAE、GPSToken 做空间自适应分配但不调整图级预算,且它们都需从头训练分词器。MixTok 的独特切入是联合回答'在哪里精修'与'每图需要多少'两个问题:用可学习的网格打分器对 256 个候选位置排序,用 top-p 预算控制器从分数分布中自动导出每图 token 数 $K(x)$,并把阈值 $p$ 在训练子集上校准到目标平均预算。更关键的是它直接面向生成任务设计了两阶段 MaskGIT 流水线,让精修位置在生成时可被预测和生成,而非仅服务于重建。
核心方法
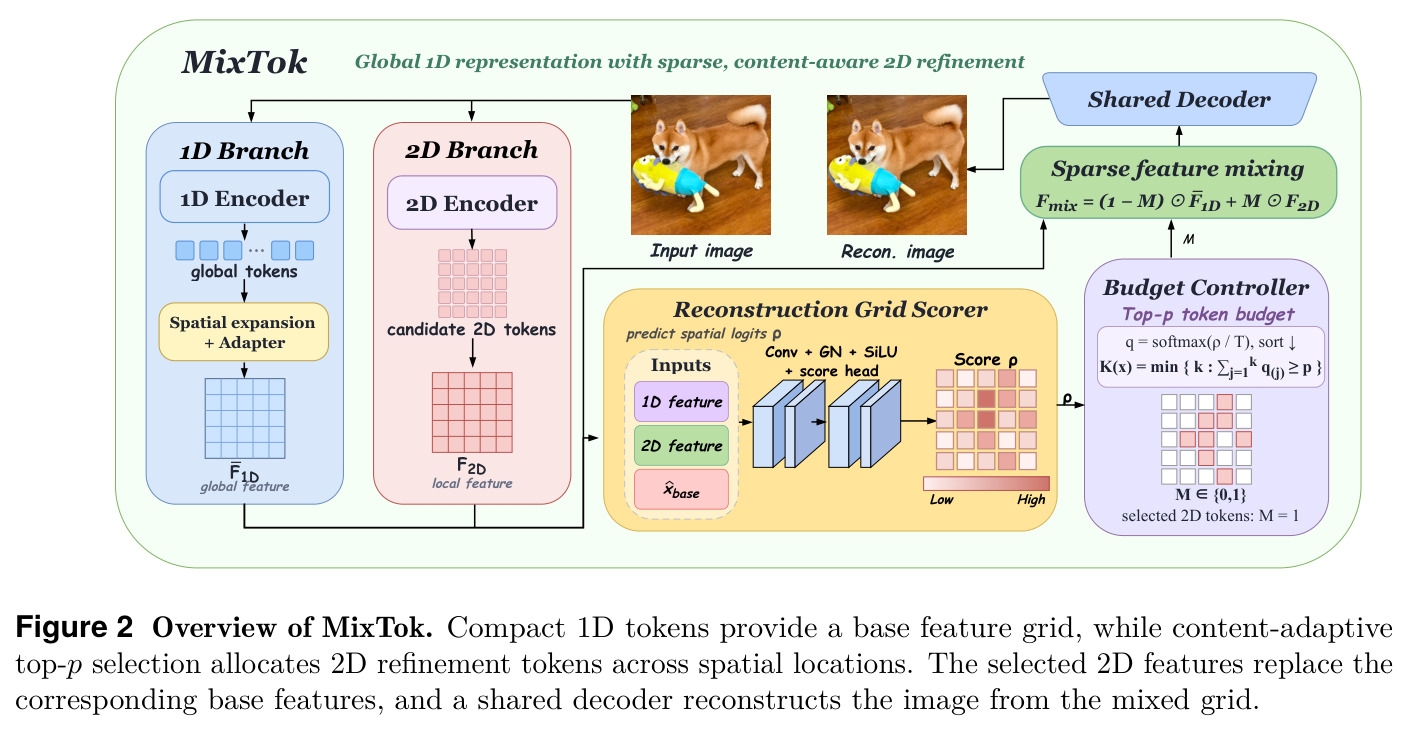
直觉上,一张图像的大部分内容可以由极少的 1D token 概括,只有少数局部区域真正需要高分辨率细节。MixTok 冻结 TiTok-L-32 提供 32 个 1D token 作为全局骨架,把其量化特征经空间扩展模块 $G_{1D}$ 展开成 16×16 基础特征网格,再由特征适配器 $P_{1D}$ 投影到与 LlamaGen VQ-16 解码器对齐的 256 通道空间。重建网格打分器 $\Phi^{rec}_{grid}$ 综合基础网格 $\bar{F}_{1D}$、2D 特征 $F_{2D}$ 与基础重建图 $\hat{x}^{base}$,为每个位置预测精修优先分数 $\rho$;预算控制器对分数做温度 $T$ 的 softmax 归一化后用 top-p 规则选出 $K(x)$ 个位置,将对应 2D 特征替换进基础网格得到 $F_{mix}=(1-M)\odot\bar{F}_{1D}+M\odot F_{2D}$,共享解码器从混合特征重建图像。生成阶段由两级 MaskGIT 先生成 1D token,再在选中位置稀疏生成 2D token 后共享解码。
核心创新是内容自适应路由器同时决定'哪里'与'多少'。打分器以两分支重建误差之差作为代理监督:$g_i=\max(0,\mathrm{Avg}_{\Omega_i}[\mathrm{MSE}(\hat{x}^{base})-\mathrm{MSE}(\hat{x}^{2D})])$,即该位置的 2D 特征能减少多少重建误差,误差减少最多的 37.5% 单元标为正样本;预算控制器用 top-p 选择 $K(x)=\min\{k:\sum_{j\le k}q_{\pi_j}\ge p\}$,概率质量集中于少数位置时自动少选、分散时多选。与固定 top-K 不同,$p$ 在训练子集上校准到目标平均预算(约 96 个 2D token)后推理时固定,允许逐图变化。与 SelfBootTok 从全局 token 预测细节不同,MixTok 保留真实 2D token 并通过稀疏特征替换+共享解码器在同一特征空间融合,细节无需被硬压缩进短序列。
方法步骤详情
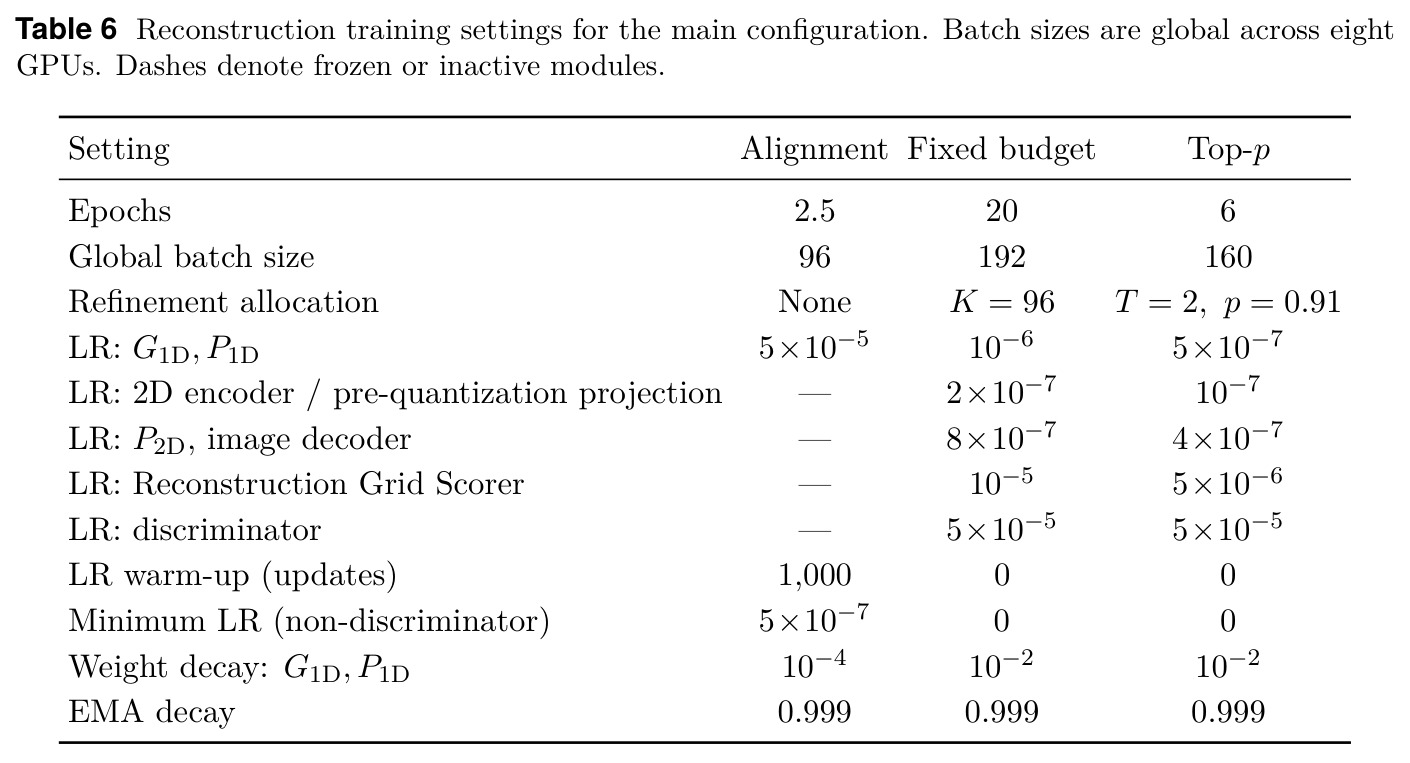
(1) 编码:图像经冻结 TiTok-L-32(4096 词表)得 $L{=}32$ 个 1D token,经 LlamaGen VQ-16(16384 词表)得 16×16=256 个 2D token。(2) 对齐:$G_{1D}$ 把 1D 特征展成 16×16 网格,$P_{1D}$ 投到 256 通道解码器空间得 $\bar{F}_{1D}$,$P_{2D}$ 同理对齐 2D 特征。(3) 三阶段重建训练:对齐 2.5 epoch;固定预算 20 epoch($K{=}96$,0.5 epoch 先训打分器,1.5 epoch 起加对抗);top-p 微调 6 epoch($T{=}2,p{=}0.91$)。(4) 损失:重建+LPIPS+对抗为主,辅以 DINOv2/CLIP 特征损失、打分器 BCE 与预算/二值化惩罚,选择用温度 0.01 的 sigmoid 可微代理反传。(5) 推理:softmax($T{=}1$) 后 top-p 得 $K(x)$,平均约 96 个 2D token,共约 128 个。(6) 生成:MaskGIT 8 轮出 1D token;蒸馏的生成打分器打分并 top-p($p{=}0.75$)选位;适配器 $A$ 供上下文嵌入;Halton-MaskGIT 再 8 轮只在选中位置生成 2D token,共享解码器出图。
技术新颖性
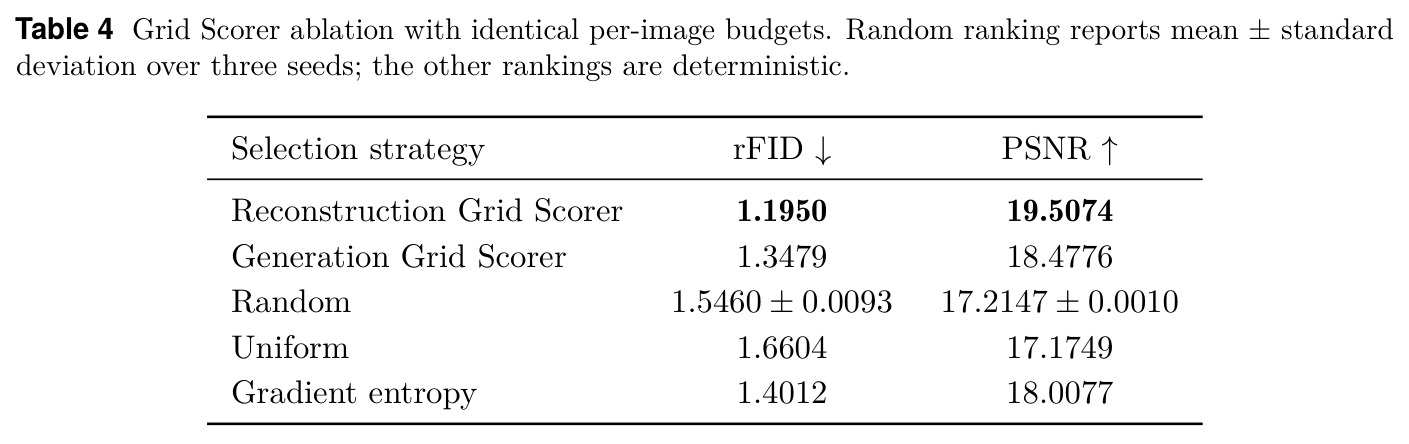
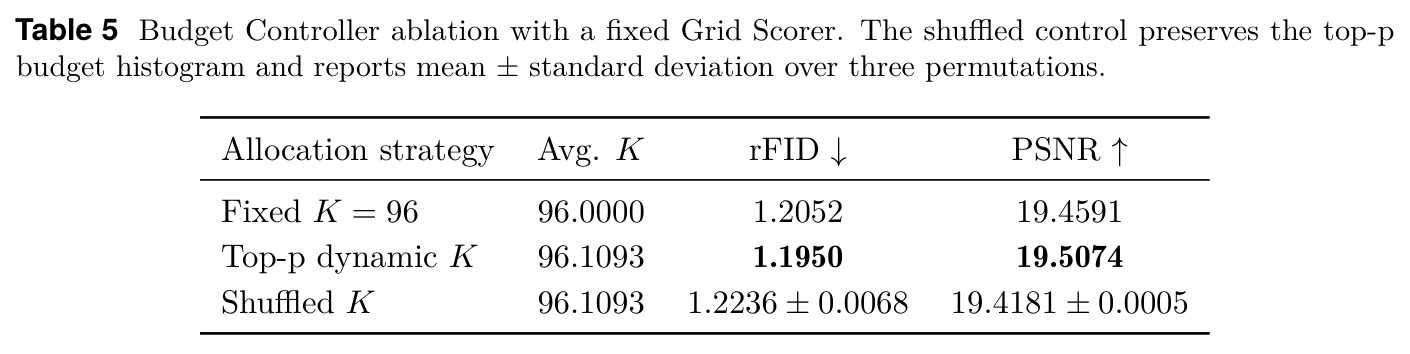
技术新颖性体现在三点。其一,混合表示+稀疏特征替换:不像 VQGAN 全网格编码,也不像 TiTok 把全部信息压进短序列,MixTok 让 1D 分支提供基座、2D 分支只在打分出的位置以特征替换方式介入,两个现成分支通过 $G_{1D}$、$P_{1D}$、$P_{2D}$ 对齐到共享解码器空间,无需重训分词器。其二,双重自适应:打分器解决空间选择(消融中优于随机、均匀和 Sobel 梯度熵启发式),top-p 控制器解决图级预算(消融证明内容依赖的预算优于打乱预算),两者联合是此前 FlexTok/ALIT 或 DQ-VAE/GPSToken 单独不具备的。其三,可生成的混合表示:生成打分器通过蒸馏从 1D token 预测精修位置,嵌入适配器把 1D 基座变成 2D 生成器的连续上下文条件,使 Halton-MaskGIT 能只在选中位置稀疏生成,这是该混合表示能用于生成而非仅重建的关键。
实验结果
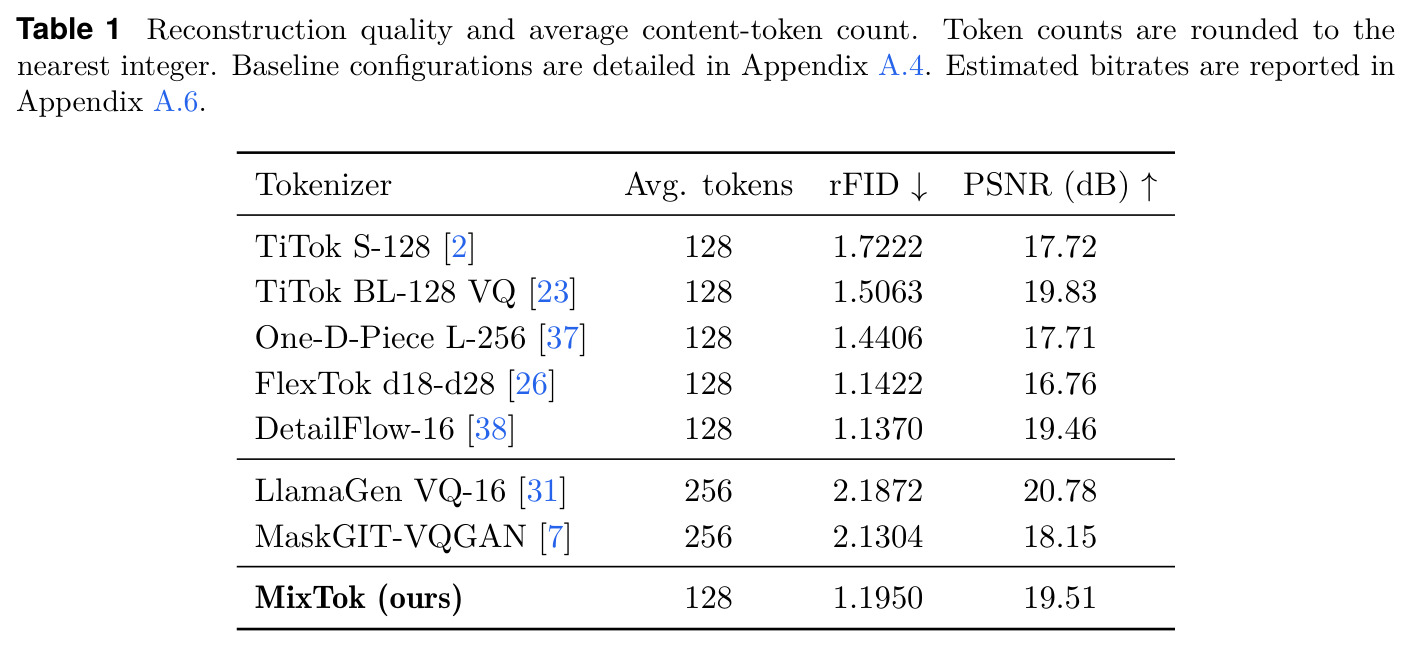
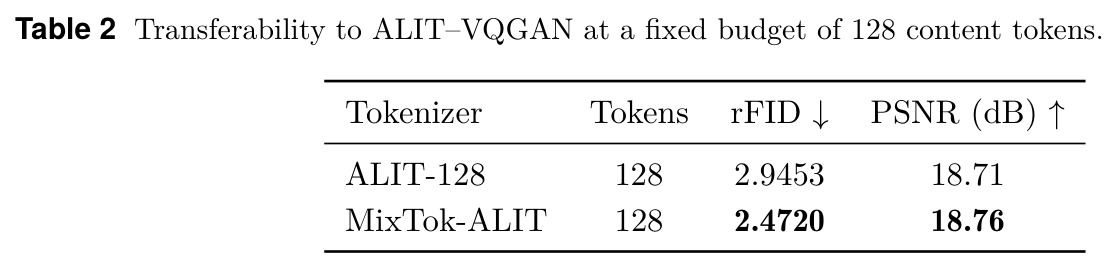
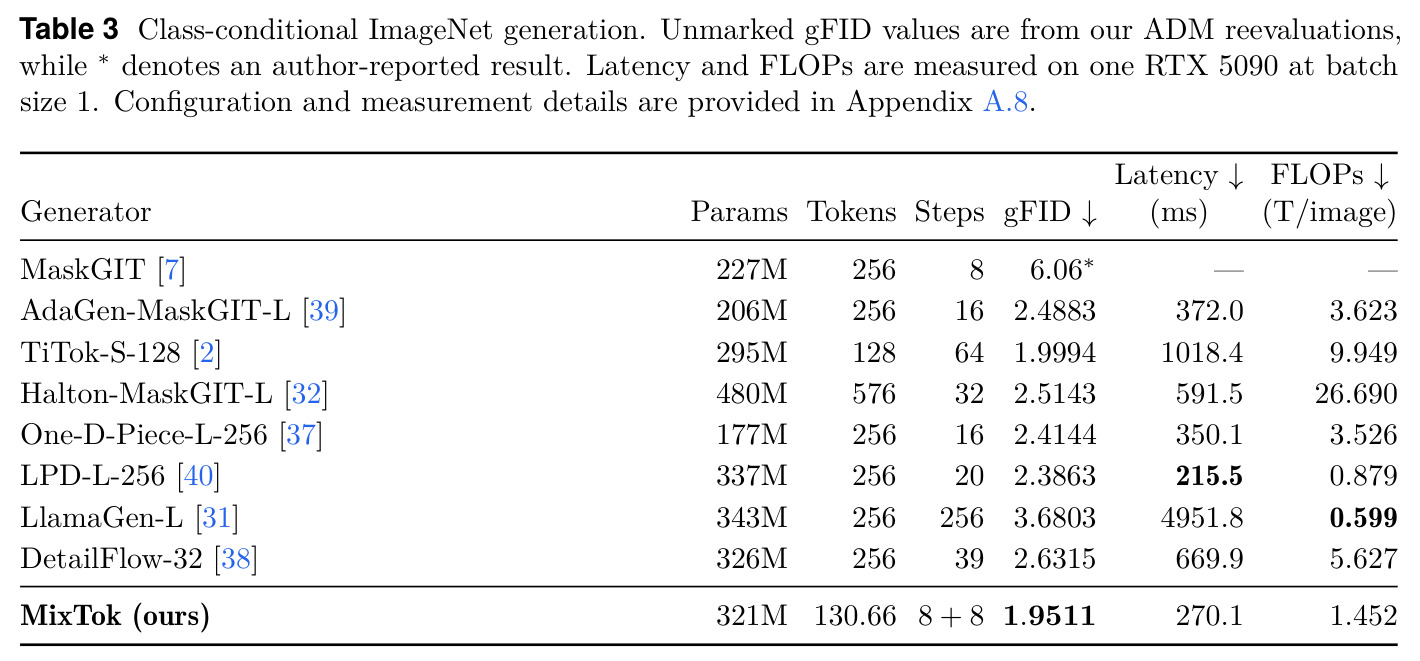
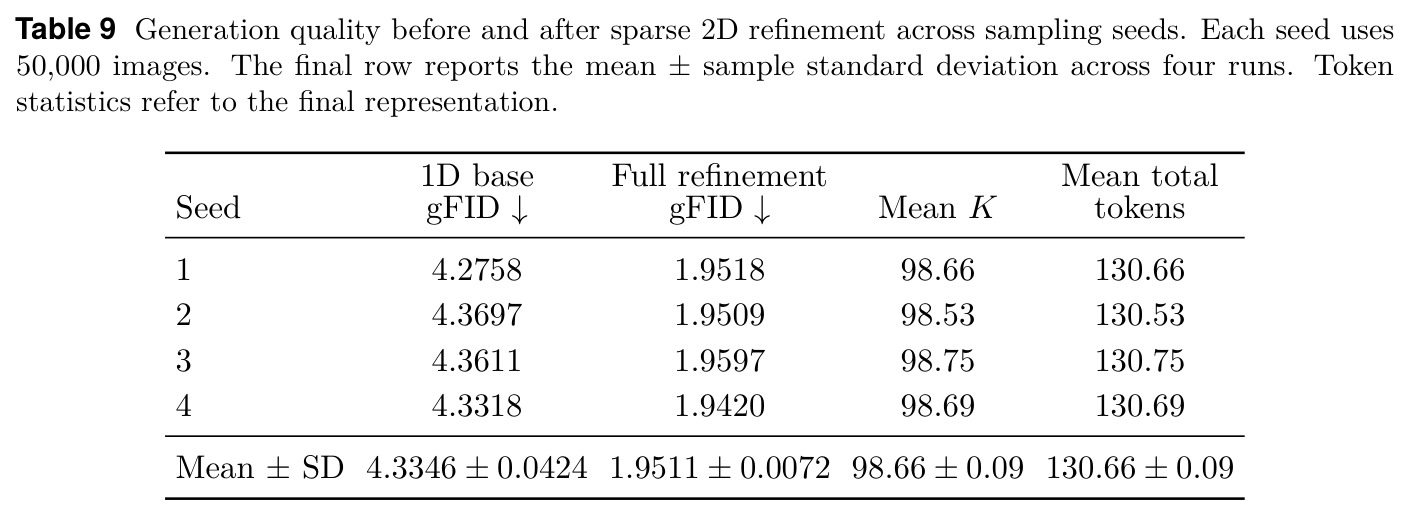
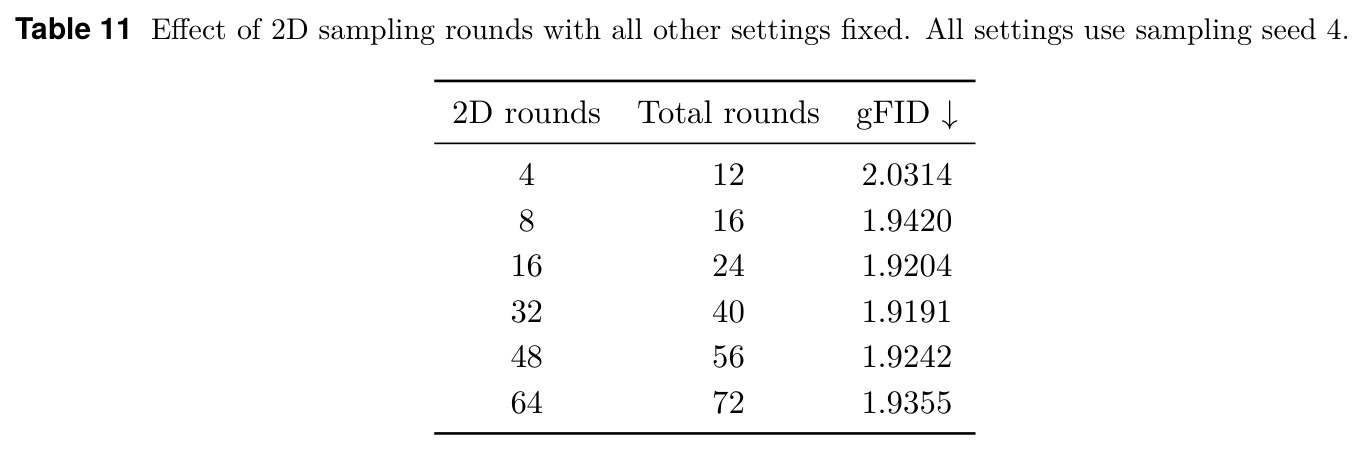
重建(Table 1):约 128 token 预算下 rFID 1.1950、PSNR 19.51 dB,优于 TiTok S-128(1.7222)与 One-D-Piece(1.4406),接近 FlexTok(1.1422)与 DetailFlow-16(1.1370),但 FlexTok 的 PSNR 仅 16.76;并以一半 token 超过 LlamaGen VQ-16(2.1872)。迁移(Table 2):换 ALIT 骨干,rFID 从 2.9453 降至 2.4720。生成(Table 3):gFID 1.9511、约 131 token、8+8 轮、270.1 ms、1.452 TFLOPs,比 TiTok-S-128(1.9994、64 轮、1018.4 ms)快 3.77 倍且更优,比 DetailFlow-32(2.6315)快 2.48 倍。消融:重建打分器 1.1950 最优、生成打分器 1.3479,优于梯度熵 1.4012、随机 1.5460、均匀 1.6604(Table 4);top-p 1.1950 优于固定 K=96 的 1.2052 与打乱预算 1.2236(Table 5)。2D 精修把基座 gFID 从 4.3346 提至 1.9511,仅加 8 轮与约 99 个 2D token(Table 9);40 轮时最优 1.9191 后饱和(Table 11);码率 0.03030 bpp(Table 10)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ImageNet 256×256 图像重建(128 token 预算) | rFID ↓ | 1.1950(平均约 128 内容 token) | TiTok S-128: 1.7222;TiTok BL-128 VQ: 1.5063;One-D-Piece L-256: 1.4406 | 较 TiTok S-128 降低约 30.6%,在同等 token 预算下全面超越 TiTok 系列与 One-D-Piece |
| ImageNet 256×256 图像重建 | PSNR (dB) ↑ | 19.51 | FlexTok d18-d28: 16.76;One-D-Piece: 17.71 | 比 FlexTok 高 2.75 dB,比 One-D-Piece 高 1.80 dB |
| ImageNet 256×256 类条件图像生成 | gFID ↓ | 1.9511(约 131 token,8+8 轮) | TiTok-S-128: 1.9994;DetailFlow-32: 2.6315;Halton-MaskGIT-L: 2.5143 | 超过所有对比方法,同时把采样轮数从 64 降到 16 |
| 生成效率(RTX 5090,batch 1) | 端到端时延 (ms) ↓ | 270.1(1.452 TFLOPs/图) | TiTok-S-128: 1018.4(9.949T);DetailFlow-32: 669.9(5.627T) | 分别加速 3.77 倍与 2.48 倍,FLOPs 降至约 1/7 与 1/4 |
| 迁移到 ALIT–VQGAN 骨干(128 token 固定预算) | rFID ↓ | 2.4720(MixTok-ALIT) | ALIT-128: 2.9453 | 降低 0.4733,PSNR 同时从 18.71 升至 18.76 dB |
| 固定宽度码率估计(重建) | bpp ↓ | 0.03030(含 256 bit 位置掩码) | FlexTok: 0.03125;MaskGIT-VQGAN: 0.03906 | 码率更低且 rFID 优于 MaskGIT-VQGAN 达 0.9354 |
局限与改进
作者承认的局限:尽管保留了更少的离散内容 token,重建仍需对全图做稠密 2D 编码,编码端计算并未稀疏化;第二阶段生成器仍在完整 16×16 空间序列上运行,只是把预测目标与 token 更新限制在选中集合 $R$ 内;评测仅覆盖 ImageNet 256×256 与较窄的平均 token 预算范围。我的补充观察:纯重建 rFID 略逊于 FlexTok(1.1422)与 DetailFlow-16(1.1370),卖点主要是效率与 PSNR/感知的折中;生成打分器只能依赖蒸馏自 1D 基座的特征,当 1D 生成质量较差(基座 gFID 4.33)时位置选择的可靠性存疑,存在两阶段误差级联风险;位置信息以固定 256 bit 掩码存储,在低预算场景下边信息开销占比大;评测限于类条件生成,未验证文本生成图像或更高分辨率;训练管线涉及多个冻结/可调模块与三阶段调度,工程复杂度偏高。
独立分析的弱点
弱点一:训练与部署复杂。方法堆叠了 $G_{1D}$、$P_{1D}$、$P_{2D}$、打分器、嵌入适配器、判别器等多个模块,采用对齐/固定预算/top-p 三阶段训练(2.5+20+6 epoch)与大量超参(Table 6、7),复现与调参成本高;改进方向是把对齐与路由训练合并为单阶段端到端优化,或用特征蒸馏简化多投影头。弱点二:打分器监督是代理目标——以 MSE 误差减少的前 37.5% 单元为正样本,与真实感知质量或下游生成需求未必一致;可改为以 LPIPS/DINO 特征差甚至生成后 gFID 作为监督。弱点三:推理预算需离线校准 $p$(评估时用 $T{=}1,p{=}0.994897$),换数据分布须重新校准;可引入率失真目标实现在线自适应。弱点四:位置信息以 256 bit 稠密掩码存储,低预算场景低效,可改用熵编码或游程编码。弱点五:两阶段生成轮数固定为 8+8,未对一、二阶段做联合调度优化,而 Table 11 显示 24~40 轮仍有约 0.02 的 gFID 余量可挖掘。
未来方向
作者提出的方向包括:引入稀疏计算,使 2D 编码与第二阶段生成器真正只在选中区域计算;把自适应全局-局部 token 分配扩展到更宽的预算区间、更高分辨率和更多样的视觉数据。基于本文成果还可延伸:(1) 把同一路由思想推广到视频,按时空块的内容复杂度分配 token;(2) 将 top-p 路由与率失真优化结合,做成可伸缩编码器——Table 11 显示轮数在 24~40 间饱和,存在明确的质量-算力可调工作点;(3) 将混合 token 接入扩散或自回归大模型,检验在文本生成图像中的缩放规律;(4) 打分器与分割、检测等下游任务联合训练,让精修位置服务于感知任务而非仅重建;(5) 分析 $K(x)$ 与语义类别的关联,实现类别感知或语义引导的预算分配。
复现评估
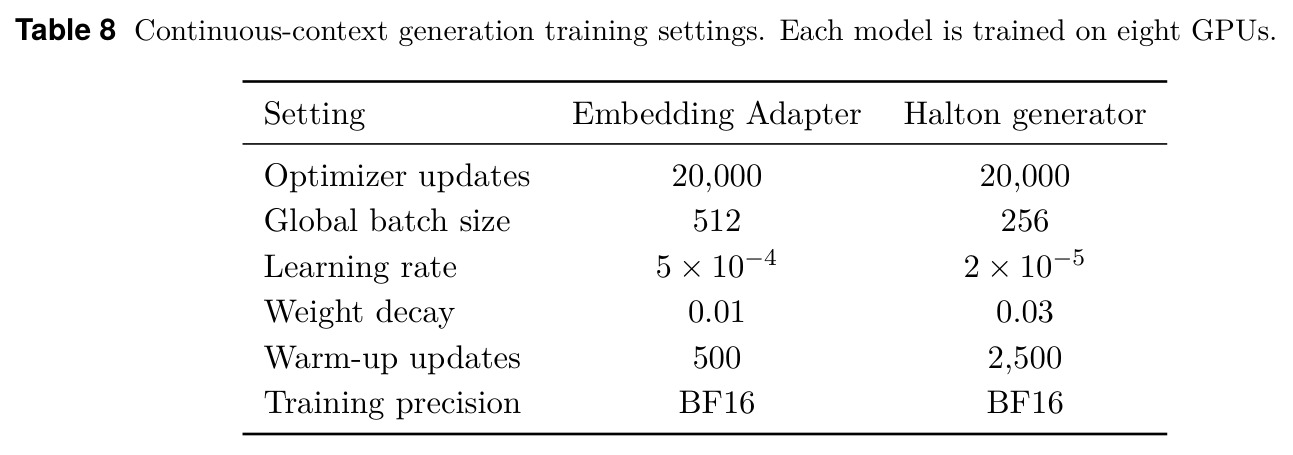
复现条件较好。代码与配置已在 GitHub(LCGLiChenge/MixTok)开源,项目页提供可视化;依赖的全部外部资产均为公开预训练模型(TiTok-L-32、LlamaGen VQ-16、Halton-MaskGIT)与 ImageNet。论文附录完整披露了训练日程(Table 6:三阶段 2.5/20/6 epoch,全局 batch 96~192,8 卡 GPU)、全部损失权重(Table 7)、生成训练设置(Table 8:各 2 万步,batch 512/256)、采样配置(guidance 4.5/3.0、8+8 轮、$T{=}2,p{=}0.75$)与评测协议(ADM evaluator、4 个种子各 5 万张、RTX 5090 单卡计时)。算力需求为 8 卡 GPU,重建约 28.5 epoch、生成约 4 万步更新,规模属中等偏大。难点在三阶段管线与多模块初始化顺序较繁琐,但作者连 AI 辅助声明与码率核算公式($R_{MixTok}$ 的逐项推导)都给出,透明度很高,按附录认真执行应可复现。
论文图表
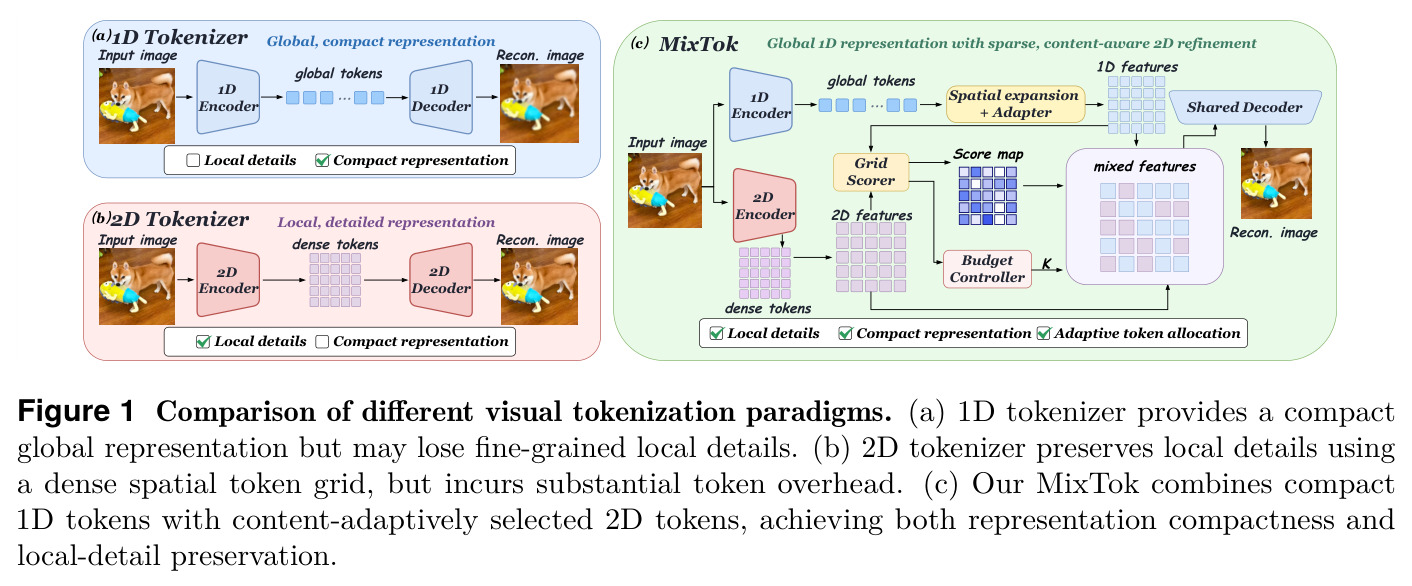
三栏对比:(a) 1D 分词器输出紧凑的全局 token 但丢失细粒度局部细节;(b) 2D 分词器用稠密空间 token 网格保留局部细节但 token 开销巨大;(c) MixTok 用紧凑 1D token 加内容自适应挑选的稀疏 2D token,兼顾表示紧凑性与细节保留。
一图说明论文要解决的核心权衡(紧凑 vs 细节)以及混合方案的定位,是理解研究动机的最佳入口。