BudgetPix:面向像素空间图像扩散的计算自适应分词框架 BudgetPix: Compute-Adaptive Tokenization for Pixel-Space Image Diffusion
让像素扩散模型按画面复杂度动态增减 token,单个检查点即可在推理时自由调节算力预算。
前置知识
像素空间扩散 vs 潜空间扩散
主流文生图模型(如 SD)在预训练 VAE 的潜空间里做扩散,用空间压缩换算力,代价是重建上限和两阶段训练;像素空间扩散(JiT、MiniT2I、PixelDiT)直接在原始 RGB 像素上去噪,架构更纯粹、无重建瓶颈,但 token 数随分辨率暴涨,计算成本成为核心瓶颈。
本文的全部动机建立在像素空间模型的算力困境上:统一 tokenization 使推理成本被训练时的网格分辨率硬编码,BudgetPix 正是为解开这个束缚而生。
Diffusion Transformer 与 patch tokenization
DiT 把图像切成 $p \times p$ 的 patch,每个 patch 经线性嵌入变成一个 token,再用 Transformer(自注意力 + AdaLN 条件注入)建模 token 序列。自注意力开销随 token 数 $N$ 二次增长($O(N^2)$),因此 token 数直接决定每步去噪的计算量。
BudgetPix 的本质是把固定的 patch 网格换成可变的多尺度 token 序列,理解 token 化与注意力开销的关系才能理解'预算'到底省在哪里。
流匹配与 x 预测目标
流匹配(flow matching)构造线性插值路径 $z_t = t\,x + (1-t)\,\epsilon$,训练网络直接预测干净图像 $\hat{x}$(x 预测)或速度场,损失形如 $\mathcal{L}(\theta) = \mathbb{E}\, w(t)\lVert x - \hat{x}\rVert_2^2$,$w(t)$ 是噪声调度权重。相比经典 DDPM 的噪声预测,x 预测让中间步的 $\hat{x}$ 本身就是一张可读的图像。
BudgetPix 推理时正是利用中间步的 $\hat{x}$ 来计算熵布局;x 预测公式化是'从模型自身预测估计布局'这一核心机制的技术前提。
图像熵与四叉树
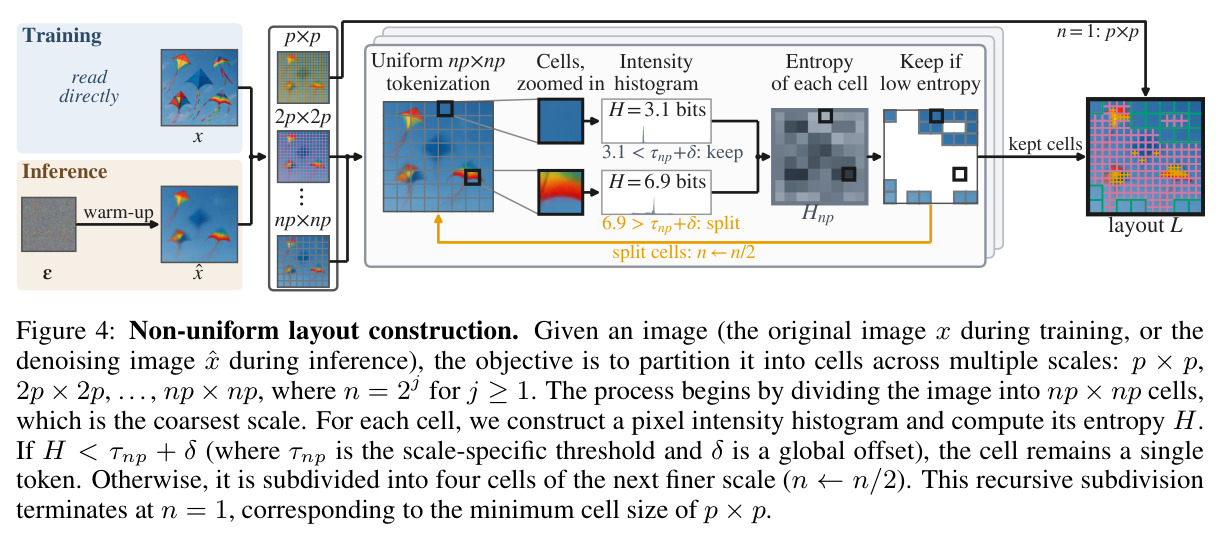
香农熵 $H(R) = -\sum_k q_k \log_2 q_k$ 度量一个区域内像素强度直方图的不确定性:平坦天空熵低(约 3 bits),纹理密集区熵高(约 7 bits)。四叉树递归把图像四等分:熵低于阈值就停止(成为一个大 token),否则继续细分,最终形成大小不一的多尺度网格。
熵四叉树是 BudgetPix 决定'哪里省算力、哪里多花算力'的全部依据,也是训练与推理统一的布局语言。
Classifier-Free Guidance (CFG)
推理时同时运行条件与无条件前向,将两者外推组合 $\epsilon_{cfg} = \epsilon_{uncond} + s\,(\epsilon_{cond} - \epsilon_{uncond})$($s$ 为引导系数),在不重训的条件下大幅提升生成质量与文本一致性,代价是每步双倍前向。
所有评测的采样器(Heun 50 步、Euler 100 步、DPM-Solver++ 等)都以固定 guidance 运行,理解 CFG 才能读懂论文的公平比较协议——所有方法共享求解器、步数与引导设置。
研究动机
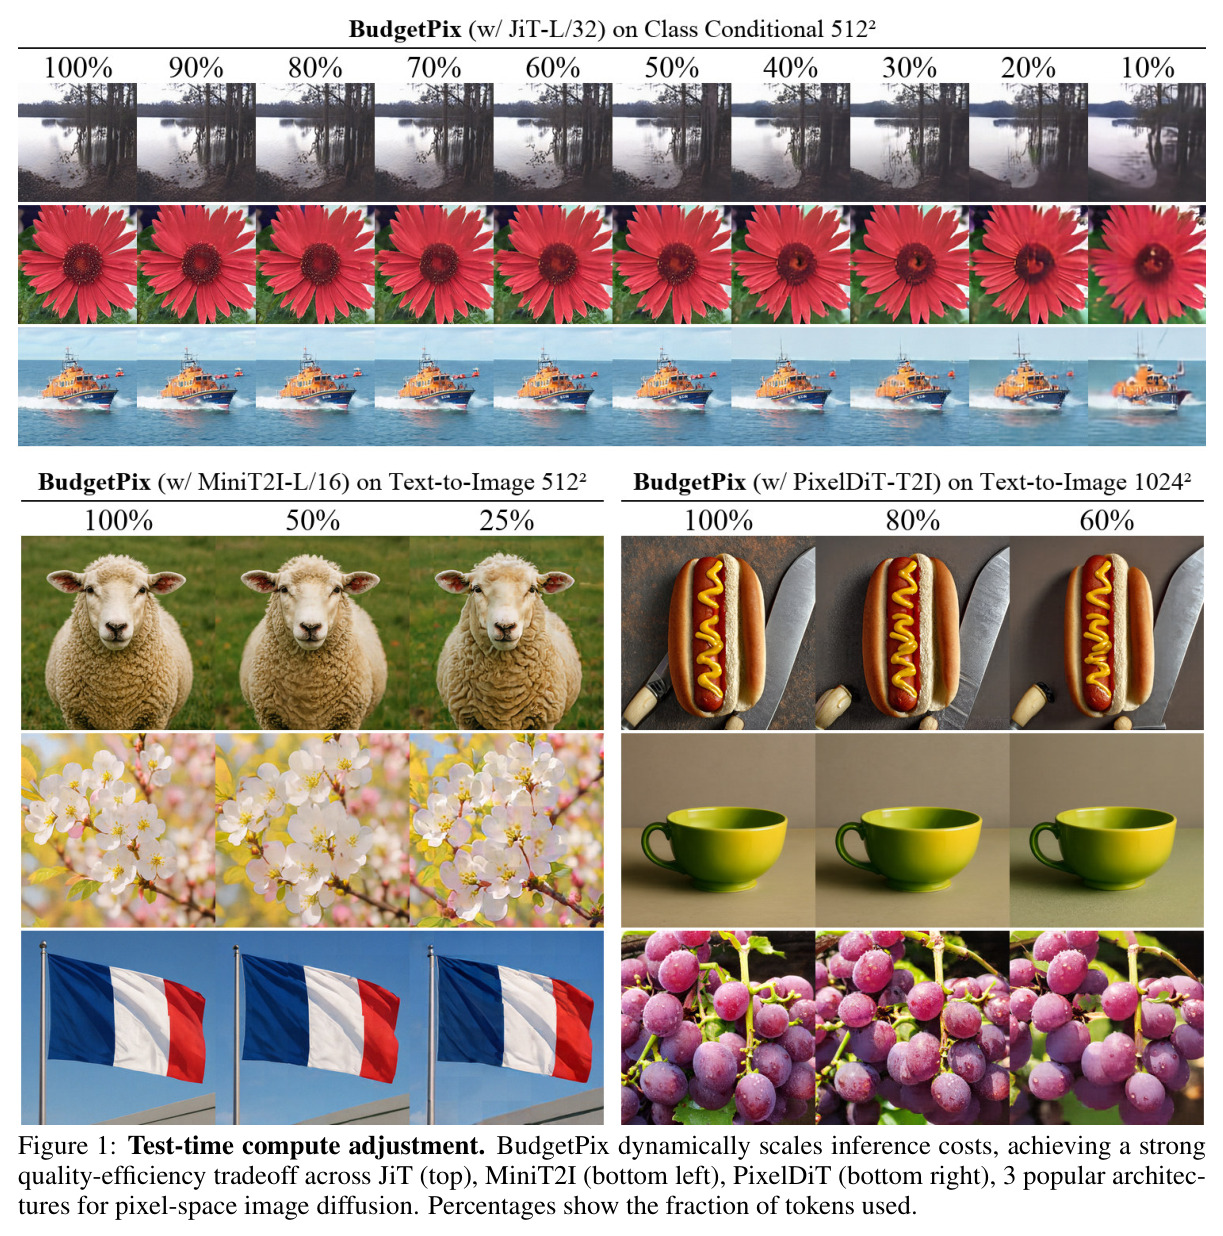
主流文生图模型大多在预训练自编码器的潜空间里做扩散,虽然省算力,却受制于重建上限且依赖两阶段训练;JiT、MiniT2I、PixelDiT 等新一代像素空间扩散 Transformer 直接对原始像素去噪,摆脱了 VAE 瓶颈,却引入一个更僵硬的问题——统一 tokenization。它们把图像切成固定大小的 patch(JiT-L/32 在 $512^2$ 下是 32×32 像素一块、共 256 个 token;PixelDiT 在 $1024^2$ 下要处理 4096 个 token),自注意力开销随 token 数二次增长,而网格分辨率在训练时被硬编码,推理算力因此完全固定:部署时既无法迁就资源受限的边缘设备,也不能动态响应用户的延迟需求,除非为每一档算力单独重新训练。更本质的浪费在于视觉信息密度极不均匀——无云的天空几乎没有信息,纹理密布的物体却需要保留高频细节,统一网格却对两者一视同仁。论文给出的例子很直观:MiniT2I 用 1024 个 token 去渲染开阔天空上的一面简单旗帜,而内容自适应方案只需 307 个;一张菠萝蜜在标准 JiT 中严格占用 256 个 token,其实一半(127 个)就足以匹配视觉质量。平坦背景上被白白消耗的算力,正是这类模型在端侧部署与实时场景中寸步难行的根源。
本文的目标是本文的目标是把任意已发布的像素空间扩散 Transformer 改造为'算力可调'的生成器:一次微调后,同一个检查点能在推理时按需运行于从约 10% 到 100% 原始 token 预算的任意档位——高预算下与原模型质量持平,低预算下优雅退化而非灾难崩溃。具体要求有三:其一,token 布局必须依据画面的视觉复杂度与空间结构自适应分配,让平坦区域用大块粗 token、细节区域保留细粒度 token,且多尺度 token 必须恰好铺满全图;其二,变长输入不能破坏预训练权重的知识,微调起点必须严格等于原发布模型,理想情况下 100% 预算的质量不降反升;其三,方案要能即插即用地集成到 JiT、MiniT2I、PixelDiT、MeanFlow 等异构架构,覆盖类条件与文生图、$256^2$ 到 $1024^2$ 分辨率、多步与单步生成,并以真实墙钟时间和人类/VLM 主观评估给出可信的质量-效率权衡。
与已有工作不同的是,内容自适应 tokenization 在判别式视觉模型中早已成熟:ToMe 的特征相似度 token 合并、DynamicViT 的 token 剪枝、FlexiViT/APT 的灵活 patch 尺寸与动态多尺度表示都在分类任务上验证过。但直接搬到生成模型会遇到'先有鸡还是先有蛋'的困境:判别模型面对的是已经给出的完整图像,可以先分析再分配 token;而生成式去噪器必须在图像内容尚未成形时就决定布局。此前的自适应加速大多绕开输入网格——沿去噪轨迹做特征缓存或逐步合并、对全图统一放大 patch 尺寸、或重训一个潜空间 tokenizer;并发的 RTI 则用 LoRA 在冻结的像素模型外挂区域 token 适配器。BudgetPix 的独特切入有三点:布局不取自模型内部特征,而是取自模型自己对干净图像的预测 $\hat{x}$——先在均匀网格上跑几个 warm-up 步让构图成形,再从预测图像估计熵布局;encoder/decoder 外完全微调整个检查点,从第一个 block 起就接受变长输入,而不是在冻结权重上贴补丁;所有附加模块零初始化,保证训练起点严格等于发布模型,微调即插即用。
核心方法
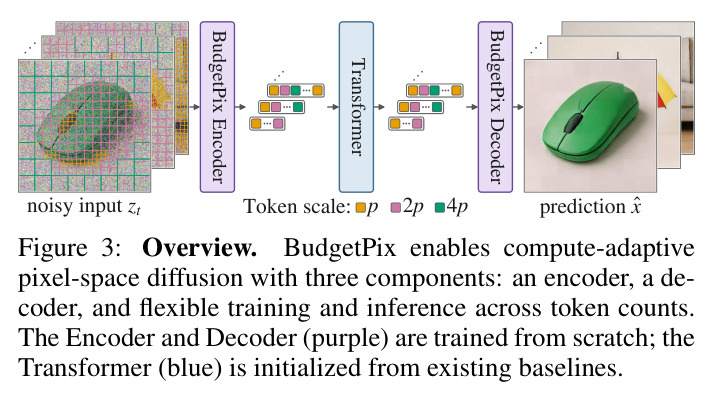
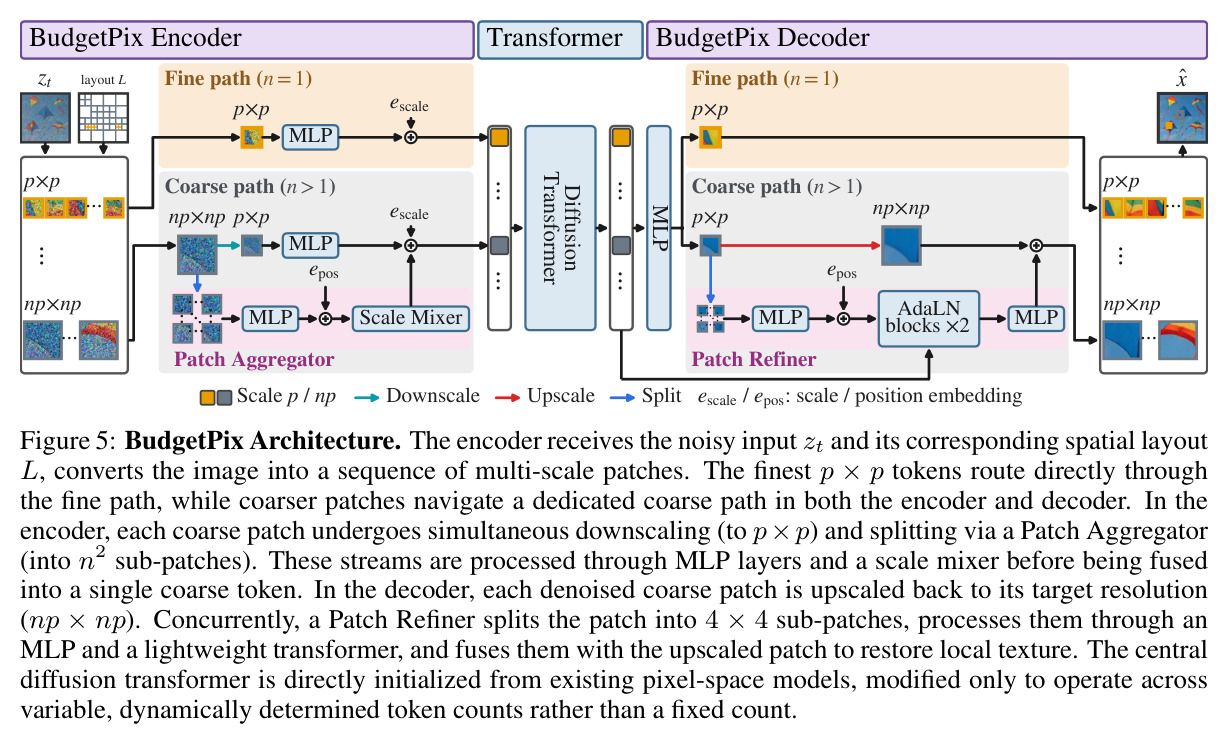
直觉上,BudgetPix 把'生成一张图'变成'在一张预算可调的画布上作画':天空、墙面用大块马赛克概括,人脸、纹理用小块精雕,块的大小由局部视觉复杂度决定。技术路线分三大件。第一件是自适应编码器:用熵引导四叉树把图像递归划分成多尺度 patch——从最粗的 $np \times np$ 网格开始,逐格计算像素强度直方图的香农熵,低于阈值就保留为一个粗 token,高于阈值就四等分继续评估,最细到基模型原生的 $p \times p$,保证多尺度 token 无缝铺满全图。第二件是把非均匀 patch 嵌入为等长向量序列:细粒度小块走预训练 patch embedder 的原路,粗粒度大块走'下采样嵌入 + Patch Aggregator 高频修正'的双路径,中央扩散 Transformer 从预训练检查点初始化,仅改造成可处理变长序列。第三件是尺度感知解码器:镜像地把每个 token 还原成其对应尺度的像素 patch,粗 token 经上采样加 Patch Refiner 补回高频纹理,最后所有 patch 拼接成固定分辨率图像。训练沿用基模型的流匹配 x 预测目标,配合均匀/随机/内容自适应三种布局的增强策略;推理时先在均匀网格上 warm-up 几步,再从模型自身的预测估计布局,之后每 5 步更新一次,整个流程对 JiT、MiniT2I、PixelDiT、MeanFlow 透明集成。
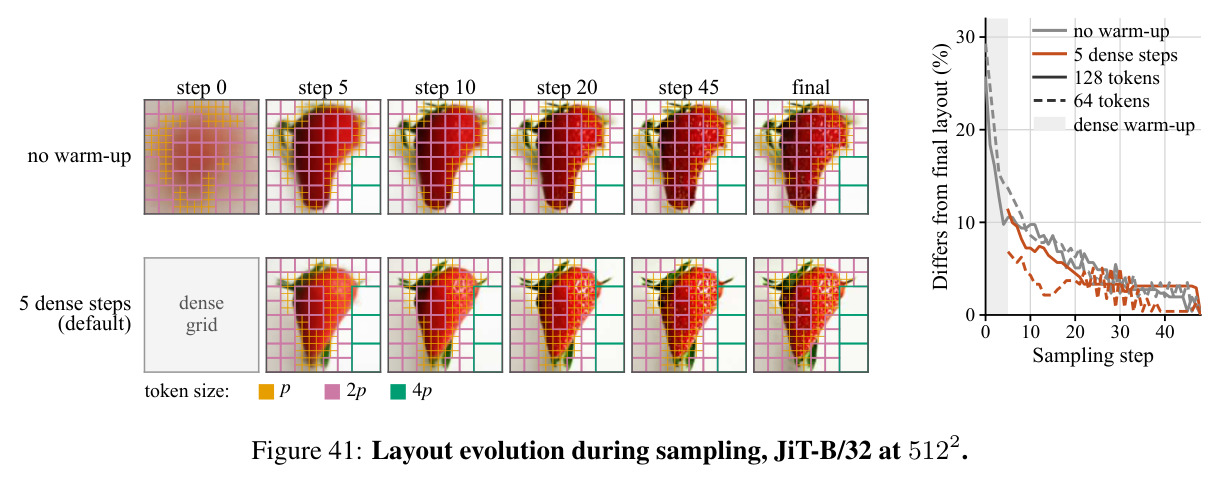
核心创新是解决了'布局从哪来'这个生成式自适应的根本矛盾。BudgetPix 不用任何外部显著性模型,也不读模型内部特征,而是让去噪器在 warm-up 步中对即将生成的图像做出预测 $\hat{x}$,从这张'半成品'计算熵四叉树布局,之后每 $m=5$ 步用最新预测重建一次布局——布局随生成内容逐步收敛,同一套机制统一了训练(真值图像的熵)与推理(预测图像的熵)。第二个关键设计是三种训练布局的增强:概率 $a=0.15$ 用均匀网格锚定预训练知识、防止灾难性漂移;概率 $b=0.1$ 用随机熵图构造布局——故意让粗 token 覆盖高细节区域,堵死模型学'粗 token 只代表平坦背景'这条捷径,模拟低预算推理的苛刻条件;其余概率用真值熵布局,配合逐图逐步随机采样的偏移 $\delta \sim U(0,2)$,让单个检查点在约 25%–100% 的连续 token 范围内都游刃有余。第三个关键是双路径 encoder/decoder 加零初始化:细粒度路径原封不动复用预训练 embedder 与解码头,粗粒度路径用下采样+聚合、上采样+精修补偿信息损失,所有新增参数零初始化,实测七个模型初始输出与发布模型之差仅 $10^{-6}$ 量级(PixelDiT 最大 $9.6\times10^{-4}$),训练严格从原模型出发。
方法步骤详情
完整流程分五步。第一步,布局构建:图像转 luma 并做 512-bin 直方图;patch 尺度为 $s = 2^j p$($j = 0,1,\dots,N-1$)。从最粗的 $np \times np$ 网格开始,对每个 cell $R$ 计算熵 $H(R) = -\sum_{k=1}^{K} q_k(R)\log_2 q_k(R)$;若 $H(R) \le \tau_s + \delta$ 则保留为单 token,否则四等分递归细分,直到最细的 $p \times p$。阈值取 $\tau_{2p}=6.0$、$\tau_{4p}=4.0$ bits(沿用 APT 不调参),$\delta$ 逐图逐步随机。训练时熵来自真值图 $x$;推理时前 $n_w$ 个 warm-up 步(JiT 用 5 或 10 步)跑均匀网格,之后从当前预测 $\hat{x}$ 估计布局,每 $m=5$ 步重建;'预算模式'下对 $\delta$ 做二分搜索,硬性保证每图 token 数不超过预算。第二步,编码:尺度 $s=np$ 的 patch $P_i$ 在 $n=1$ 时直接 $x_i = E(P_i) + e_{\text{scale}}(s)$;$n>1$ 时 $x_i = E(\text{resize}_p(P_i)) + e_{\text{scale}}(s) + P_{As}(\text{split}(P_i))$,其中 Patch Aggregator 把大 patch 切成 $n^2$ 个子块分别过 embedder $E$、加 patch 内相对位置编码 $e_{pos}$,再经卷积+MLP 的 scale mixer 融合成高频修正向量。第三步,中央 Transformer:用预训练权重初始化,位置编码(RoPE)放在 token 中心的全局坐标系,照常处理变长序列。第四步,解码:$n=1$ 时用预训练头直接输出 $p\times p$ patch;$n>1$ 时先解码再双线性上采样到 $np\times np$,Patch Refiner 把预测块切成 4×4 子块、经两层自注意力(AdaLN 以该 token 的隐状态 $h_i$ 为条件)产生高频残差,即 $\hat{P}_i^{(s)} = \text{resize}_{np}\big(\hat{P}_i + P_{Rs}(\text{split}(\hat{P}_i), h_i)\big)$,最终所有 patch 拼成完整的 $\hat{x}$。第五步,训练与采样:损失 $\mathcal{L}(\theta) = \mathbb{E}_{x,y,L,t,\epsilon}\, w(t)\lVert x-\hat{x}\rVert_2^2$,$w(t)$ 沿用各基模型自身的调度权重;全模型微调,新增模块学习率为骨干的 8 倍,EMA 0.9999;采样时warm-up 后每 5 步重估布局,布局在期间冻结。
技术新颖性
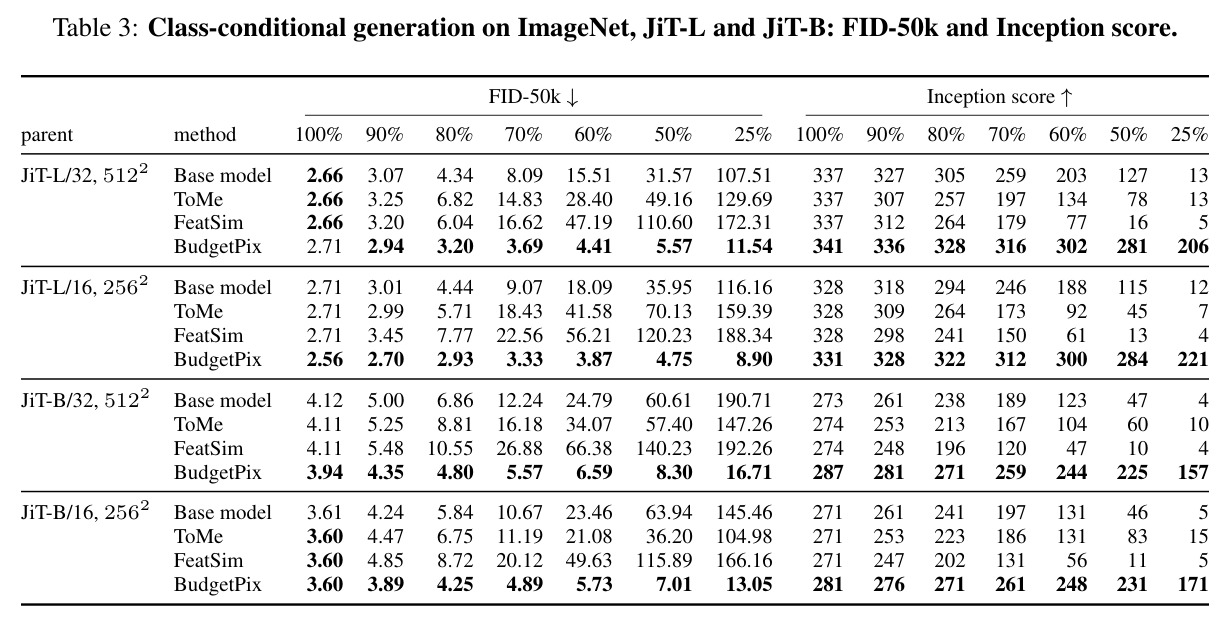
与推理时 token 合并(ToMe/FeatSim)的本质区别在于:合并方法在冻结权重上按特征相似度把 token 粗暴平均,模型从未被训练过去'读'粗 token,预算一降就系统性崩溃(JiT-L/32 在 50% 预算下 FID 从 2.66 恶化到 49–110),而且合并操作本身有额外开销,实测 ToMe 的墙钟加速比反而低于直接截断;BudgetPix 通过微调让模型真正掌握多尺度 token 这门语言。与 FlexiDiT 等均匀变 patch 尺寸的方法相比:后者只能全图统一换粒度,无法在同一张图里同时保住平坦区与细节区。与并发工作 RTI 相比:RTI 用 LoRA 挂在冻结模型上消费 region token,BudgetPix 则完全微调、从第一个 block 起改变输入分布,且布局来自模型自身对干净图像的预测而非内部特征。与重训 latent tokenizer(如 CAT)相比:那些方法要整体替换 tokenizer,BudgetPix 保持像素空间架构的纯粹性,新增参数仅 2.26M–4.77M(约占骨干 1%)。工程上的新颖点还包括:零初始化保证训练起点严格等于发布模型;预算模式通过二分 $\delta$ 给出每图 token 上限的硬保证;Patch Refiner 只在单个粗 token 内部做短序列注意力,成本不随图像分辨率增长。
实验结果
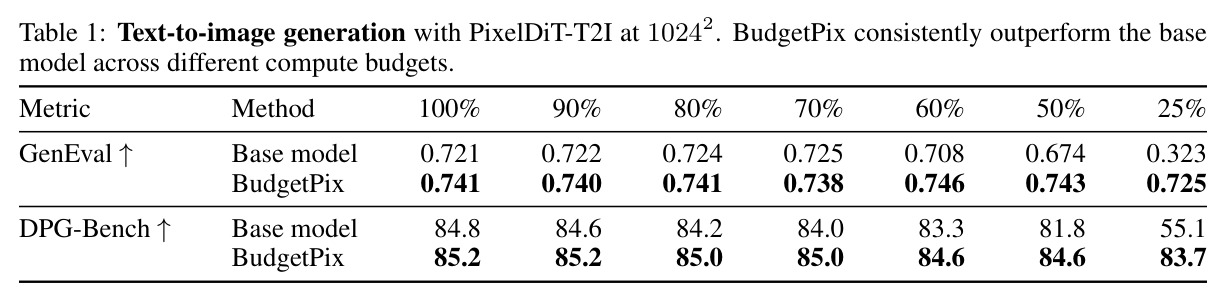
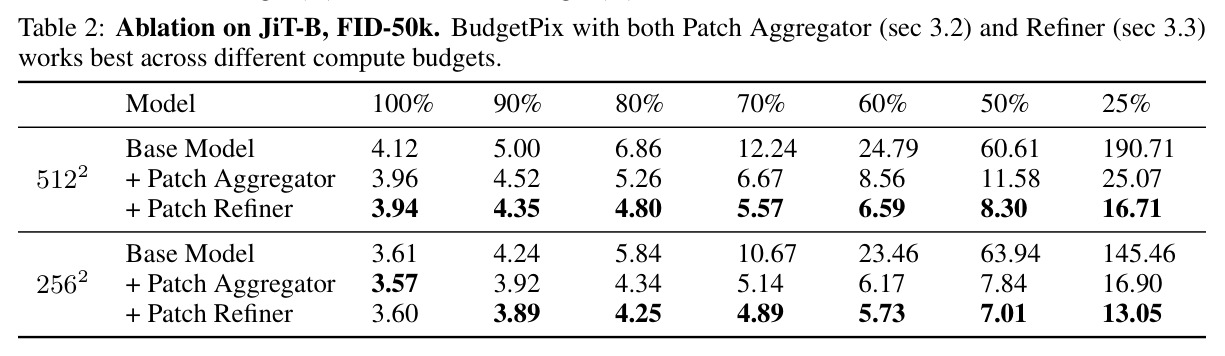
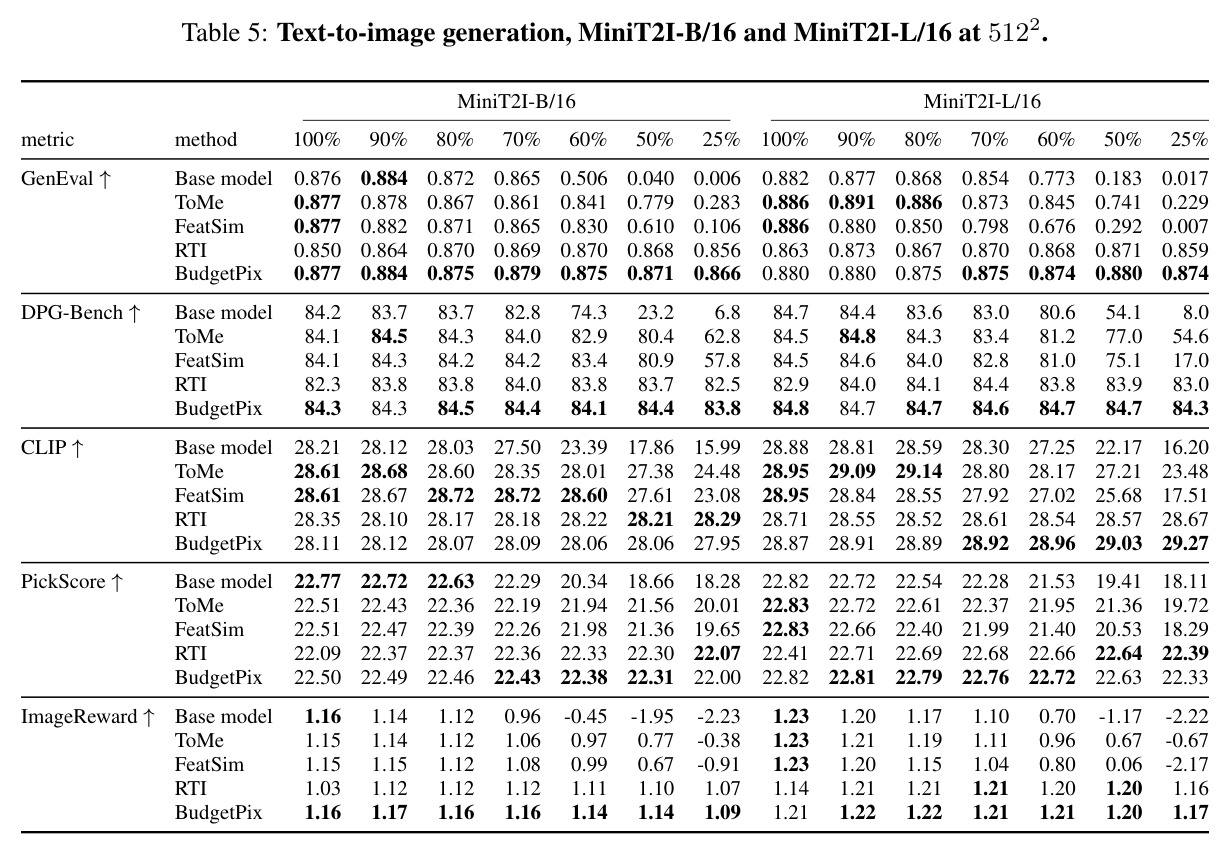
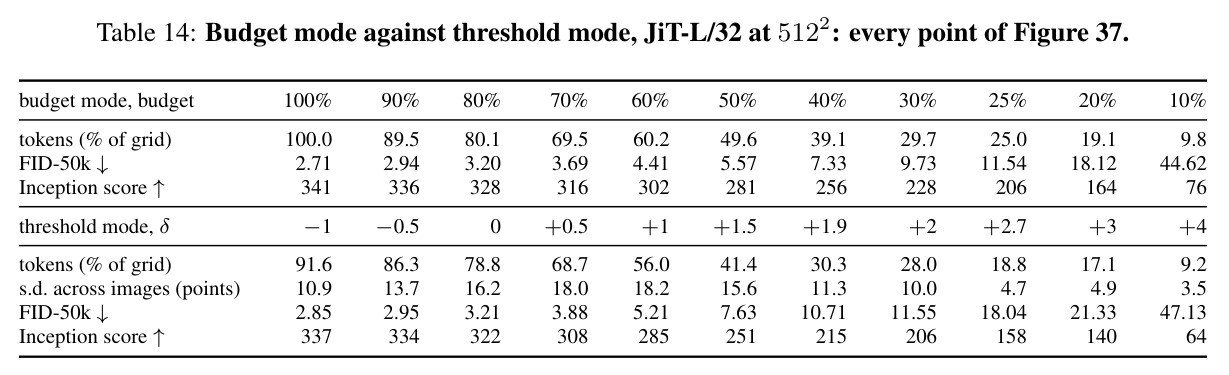
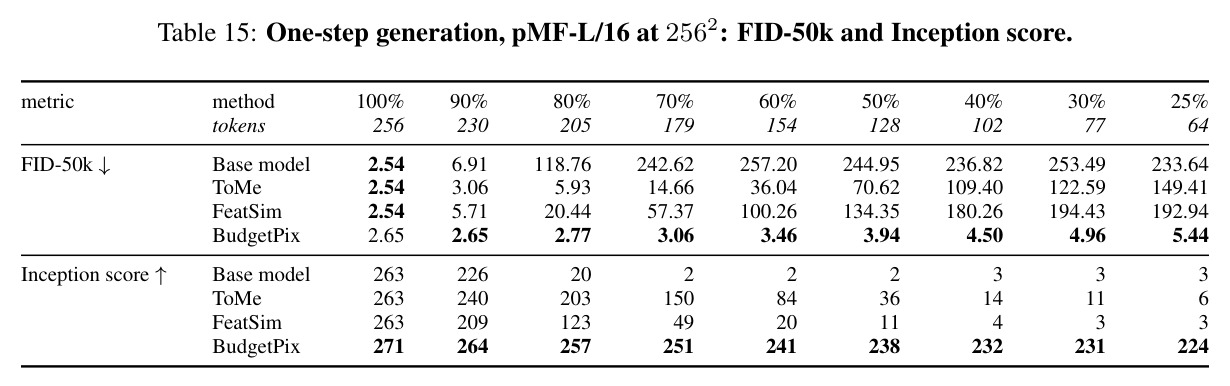
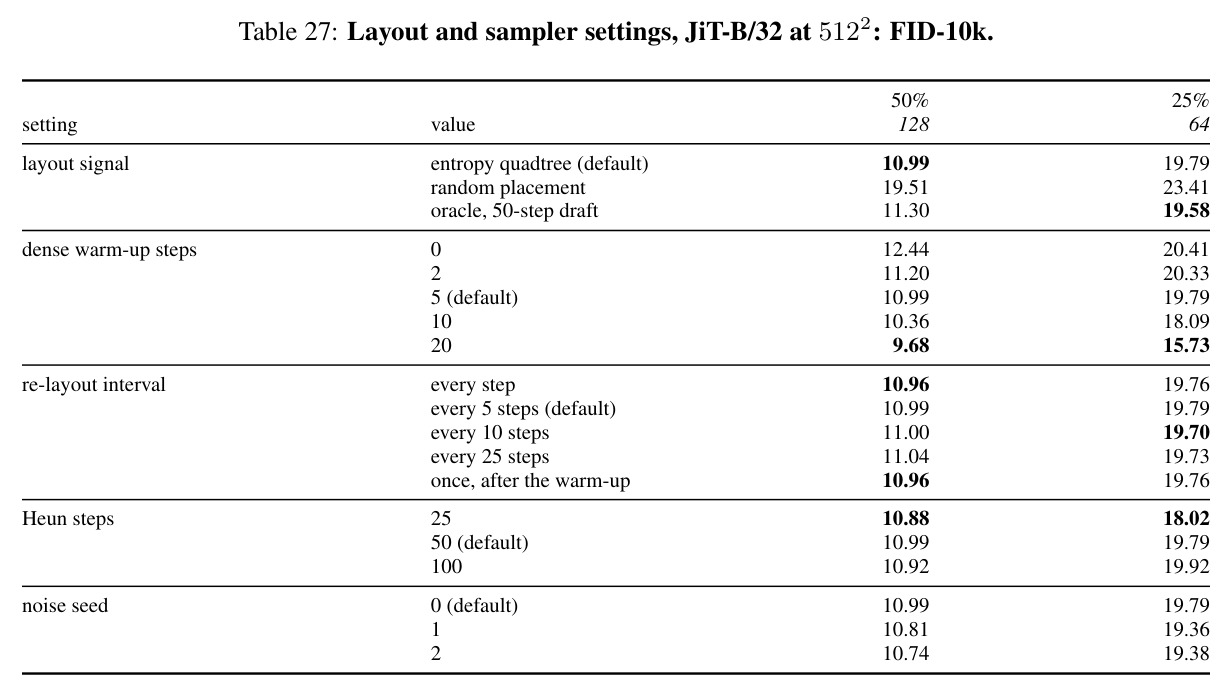
类条件生成(ImageNet,JiT-L/32@512²):BudgetPix 的 FID-50k 从 100% 预算的 2.71 平滑升至 50% 的 5.57、25% 的 11.54;基模型同预算下恶化到 31.57 和 107.51,ToMe 为 49.16/129.69,FeatSim 更是 110.60/172.31。IS 同趋势:BudgetPix 50% 预算仍保持 281(全预算 341),基模型只剩 127;在 JiT-L/16@256² 上 25% 预算 FID 8.90,基模型为 116.16。文生图(MiniT2I-L/16@512²):25% 预算时 GenEval 0.874、DPG-Bench 84.3,与全预算的 0.882/84.8 几乎持平,而基模型崩至 0.017/8.0——即用四分之一算力匹配原模型保真度;ImageReward 在 25% 预算仍达 1.17(基模型 -2.22)。PixelDiT-T2I@1024²:25% 预算 GenEval 0.725 vs 基模型 0.323,DPG 83.7 vs 55.1;60% 预算时 GenEval 0.746 甚至反超全预算的 0.741。单步生成(pMF-L/16,1-NFE):基模型在 80% 预算即崩溃(FID 118.76),BudgetPix 60% 预算 FID 仅 3.46(较全预算 2.65 只增 0.81),50% 时 3.94,25% 时 5.44。人类与 VLM 评估:50 人/表单的用户研究中,BudgetPix 可削减 52% 预算才被人眼首次察觉差异(基线最高为 RTI 的 38%);VLM 判官(Gemini 3.8 Flash,7193 次判定)为 36% vs 21%;与 RTI 正面对比,人类在全部四个预算(80/60/40/20%)都以 57%–64% 的比例偏好 BudgetPix。消融(JiT-B/32@512²,FID-50k@25%):基模型 190.71 → 加 Patch Aggregator 25.07 → 再加 Patch Refiner 16.71,说明聚合器承担主要功能、精修器贡献随预算下降而增大。布局信号消融(FID-10k@50%):熵四叉树 10.99 显著优于随机摆放 19.51,甚至略优于用 50 步稠密草稿的 oracle 11.30,说明熵信号已接近该框架的上限。墙钟时间:BudgetPix 加速比与直接截断几乎一致(MiniT2I-L 25% 预算 3.59×),而 ToMe 因合并开销仅 1.37×。熵阈值敏感性测试显示 $\tau$ 偏移 +0.5 到 +1.5 时 FID 几乎不变(10.95–10.97),方法对超参不敏感。
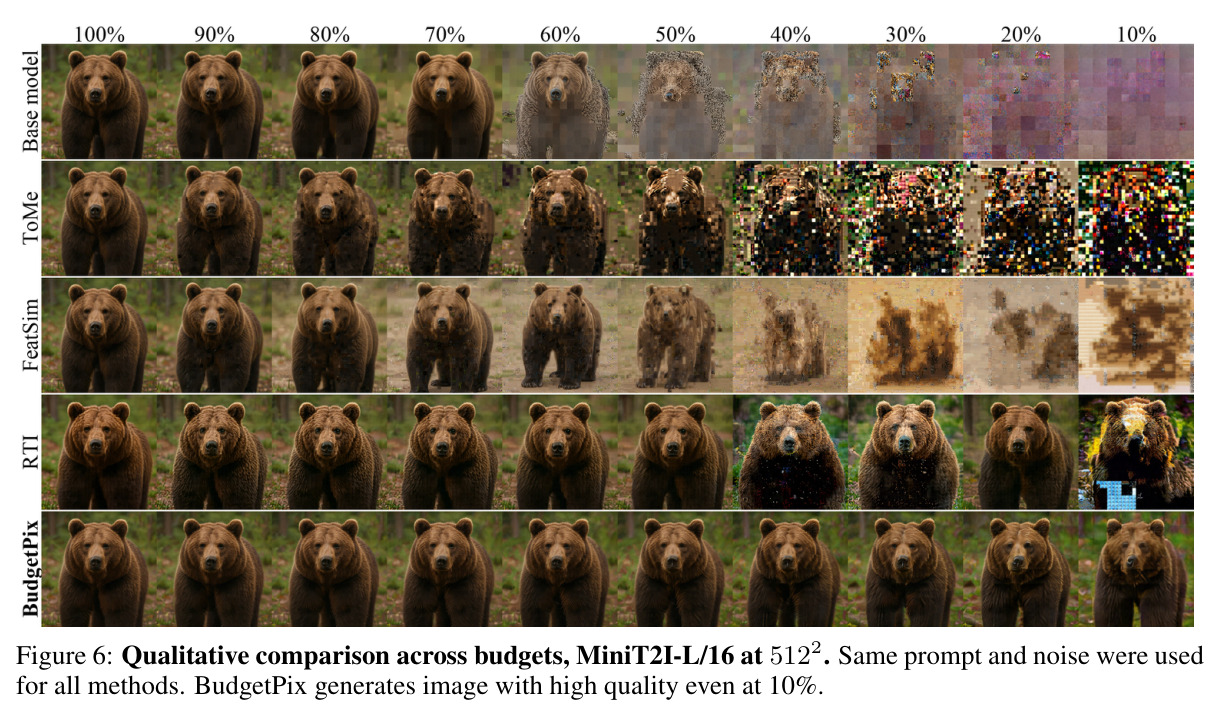
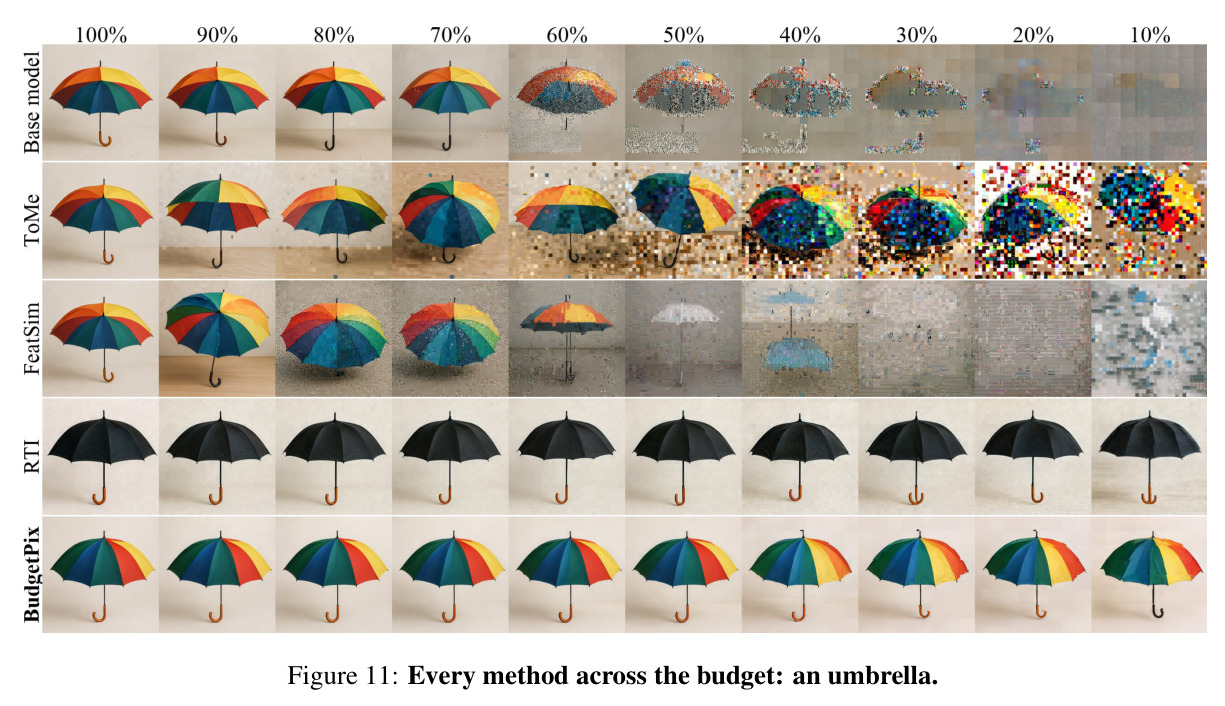
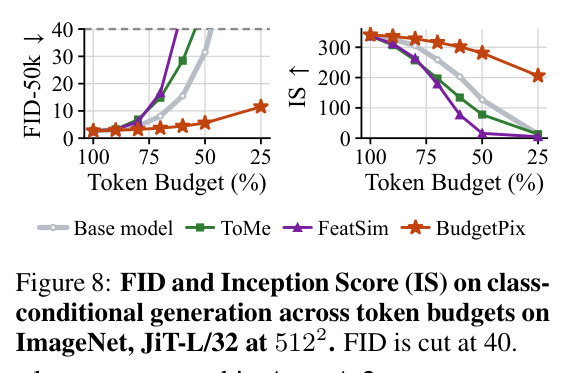
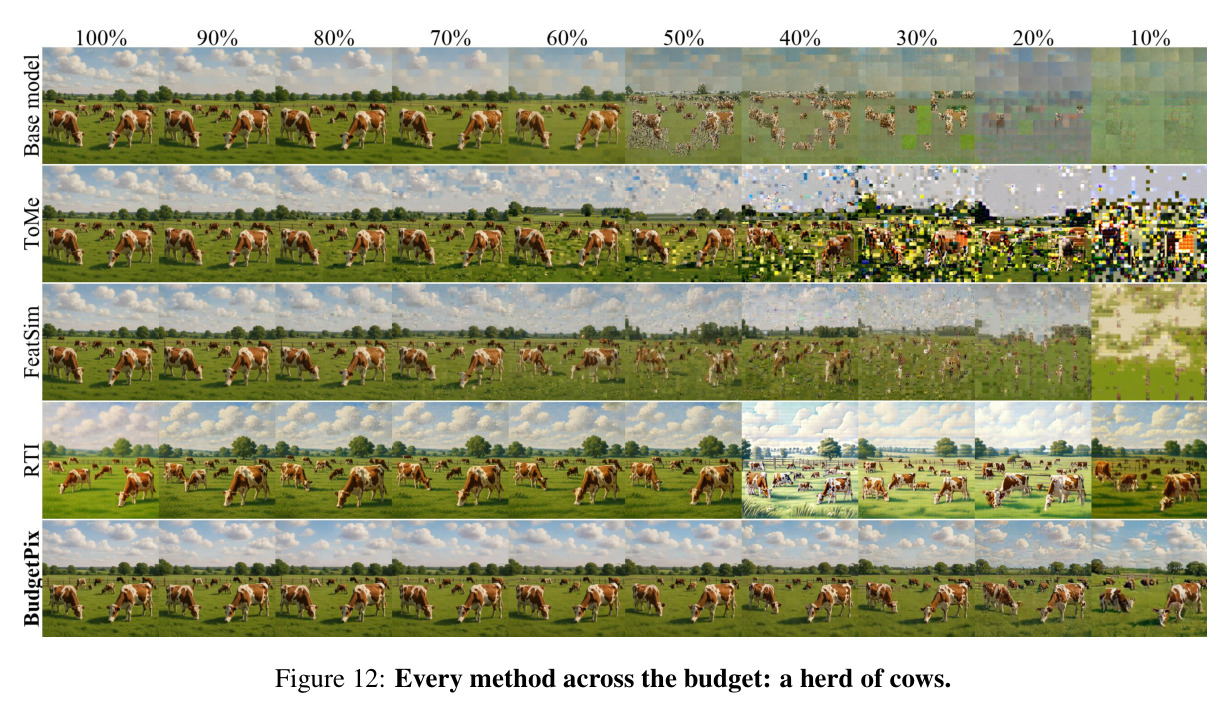
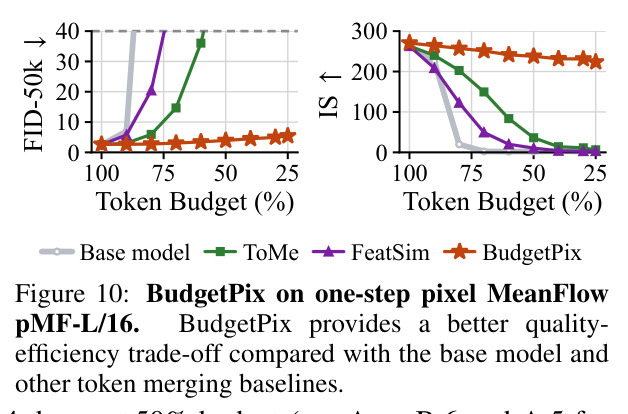
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 类条件生成(ImageNet 512²,JiT-L/32) | FID-50k @50% 预算 | 5.57 | 基模型 31.57;ToMe 49.16;FeatSim 110.60 | 较最佳基线降低约 82%,且 25% 预算时 11.54 vs 基模型 107.51 |
| 文生图(MiniT2I-L/16,512²) | GenEval @25% 预算 | 0.874 | 基模型 0.017;ToMe 0.229;FeatSim 0.007;RTI 0.859 | 以 25% 算力匹配全预算 0.882 的保真度,超过所有基线 |
| 文生图(PixelDiT-T2I,1024²) | GenEval @25% 预算 | 0.725 | 基模型 0.323 | +0.402;DPG-Bench 83.7 vs 55.1;60% 预算 0.746 反超全预算 0.741 |
| 单步生成(pMF-L/16,256²,1-NFE) | FID-50k @50% 预算 | 3.94 | 基模型 244.95;ToMe 70.62;FeatSim 134.35 | 基模型 80% 预算即崩溃(118.76),BudgetPix 到 25% 预算仍仅 5.44 |
| 墙钟加速(MiniT2I-L/16,512²,H100) | 加速比 @25% 预算 | 3.59× | ToMe 1.37×;FeatSim 2.20×;RTI 2.16× | 与理论截断上限持平,合并类基线因操作开销损失过半加速 |
| 人眼可察觉前的预算削减(用户研究,50 人) | 首次可见差异的削减比例 | 52% | RTI 38%;ToMe 32.5%;基模型 30.3%;FeatSim 23.3% | VLM 判官下同样领先:36% vs 最强基线 21% |
局限与改进
作者明确承认两点:其一,布局由模型的中间预测导出,若预测尚未显出某处细节,布局可能过早合并该区域导致细节永久丢失——这是'从预测估布局'这一设计的内生风险;其二,全分辨率阶段封顶了加速——PixelDiT 的像素级第二阶段在每个预算下都要解码全部像素,因此 25% 预算的实际墙钟加速只有 1.95×,远低于 token 数的削减比例。我补充几点观察:第一,25% 以下预算质量加速下滑(budget 模式 20% 预算 FID-50k 为 18.12、10% 时 44.62),方法并非无限压缩;第二,单步模型(MeanFlow)没有去噪轨迹可读布局,只能借用同类训练图像的熵布局再二分到预算,实质退化为按类别的先验布局,丢失了内容自适应的本义;第三,熵是像素级低阶统计量,对草地、布纹这类高熵低语义区域会过度保护,而对低熵但语义关键的区域(纯色墙上的小主体)可能过度合并——oracle 实验(11.30)仅与熵四叉树(10.99)打平,既说明熵信号接近上限,也暗示在框架内换更好的布局信号收益有限,可能需要从架构层面突破;第四,warm-up 步数与质量存在权衡(0 步 12.44 vs 20 步 9.68 @50% FID-10k),warm-up 与每 5 步的布局估计带来少量额外 forward(MiniT2I-L 为 199 次中的 21 次);第五,训练是全量微调(JiT-L 看到 6410 万张图像、50 epoch;MiniT2I-L 4 万步),并非 LoRA 级的轻量适配,迁移到新模型的成本不可忽略。
独立分析的弱点
弱点一:布局信号低级且与语义脱钩。像素强度熵无法区分'高熵但可牺牲的纹理'(草地、胶片噪点)与'低熵但承载主体的区域'(纯色墙上的一只猫),文生图场景下布局完全不感知文本提示——模型想画什么不影响算力往哪花。改进方向:引入可学习的布局头或语义显著性(DINO 特征、文本交叉注意力图)与熵联合打分。弱点二:warm-up 阶段的布局不稳与错误锁定。早期预测模糊时熵估计噪声大,Figure 41 显示无 warm-up 时布局与最终布局的差异比例可达 20–30%;构图复杂的场景可能在低细节阶段被错误布局锁定。改进:不确定性感知的布局更新(对预测做方差估计,高方差区域保守用细 token),或前若干步强制细节区域细粒度。弱点三:全分辨率阶段瓶颈。PixelDiT 的像素阶段只做条件修正而非结构性加速,改进方向是对像素级解码也做空间自适应采样,只对合并区域做轻量解码。弱点四:布局在 $m=5$ 步内冻结,而生成后期细节逐渐清晰,可能出现'该细分却没细分'的时间错配。改进:引入只分裂不合并的单向细化调度,或按噪声水平调整粒度。弱点五:单步模型退化为类别级布局先验,改进方向是在蒸馏目标中显式加入布局条件,或用本文的 random layout 增强训练单步模型使其对任意布局鲁棒。弱点六:批处理内每图同预算导致 GPU 利用率次优,论文 D.9 的 pooled budget 实验已显示批内共享预算能提升保真度(PSNR 26.35 vs 24.57 @70%),值得发展为默认调度器。
未来方向
作者明确提出方向:学习'在哪里放 token'——用可学习模块取代熵启发式,从数据中学出与语义和生成过程对齐的布局,这是最自然的下一步。基于本文成果可延伸的方向还包括:其一,视频与时空扩散——视频帧间背景高度冗余,熵四叉树可自然扩展为时间-空间联合自适应 tokenization,收益可能比图像更大;其二,与正交加速路线叠加——论文已证明 BudgetPix 与一步蒸馏(MeanFlow)兼容,还可继续与少步求解器、特征缓存、量化组合;其三,语义/条件感知布局——用文本嵌入或交叉注意力调制各区域的熵阈值,让'模型想画什么'决定'哪里多花算力';其四,批级预算调度——把 pooled budget 从消融实验变成产品特性,按批次动态分配 token 以提升硬件利用率;其五,迁移到其他像素空间任务——超分辨率、图像编辑、inpainting 的空间复杂度差异更大,自适应 tokenization 的收益可能更显著;其六,协同设计布局估计与少步采样器,降低 warm-up 开销;其七,探索布局随生成阶段演化的动态调度,让 token 在去噪后期按需分裂。
复现评估
复现条件相当好。论文有公开项目页(karaozgur.com/BudgetPix),所有基座模型(JiT、MiniT2I、PixelDiT、pMF)均为已发布权重;附录 C 给出罕见完整的训练配方:熵阈值($\tau_{2p}=6.0$、$\tau_{4p}=4.0$ bits,512-bin luma 直方图)、三种布局比例($a=0.15$、$b=0.1$)、逐模型的优化器设置(AdamW、骨干 lr 3.5e-5、新增模块 8 倍 lr、EMA 0.9999 fp32、bf16 autocast)、训练量(JiT-L 50 epoch/6410 万图像、MiniT2I-L 4 万步/1020 万图像、PixelDiT 3 万步)、数据混合(MiniT2I-L 用 BLIP3o-60k + DALL-E 3 + ShareGPT-4o-Image 共 12 万图;JiT 用 ImageNet-1k;PixelDiT 用 PD12M 20 万图)以及 Table 16 逐家列明的模块架构。新增参数仅 2.26M–4.77M。算力方面:微调多数模型用 4 GPU(pMF 用 7 GPU),评估计时在单张 H100 上完成,实验室级集群即可承受。主要不确定性是官方代码是否随项目页开放(论文正文未明说);若未开源,熵四叉树 + 双路径编解码器 + 变长序列注意力 + 预算模式二分约需 1–2 周工程实现,难度中等偏上;若开源则可直接复用其逐模型配置。评估协议(FID-50k、GenEval、DPG-Bench、PartiPrompts、用户研究与 VLM 判官提示词全文)在附录 C.5–C.7 中均可照做,复现门槛主要在工程而非科学。
论文图表
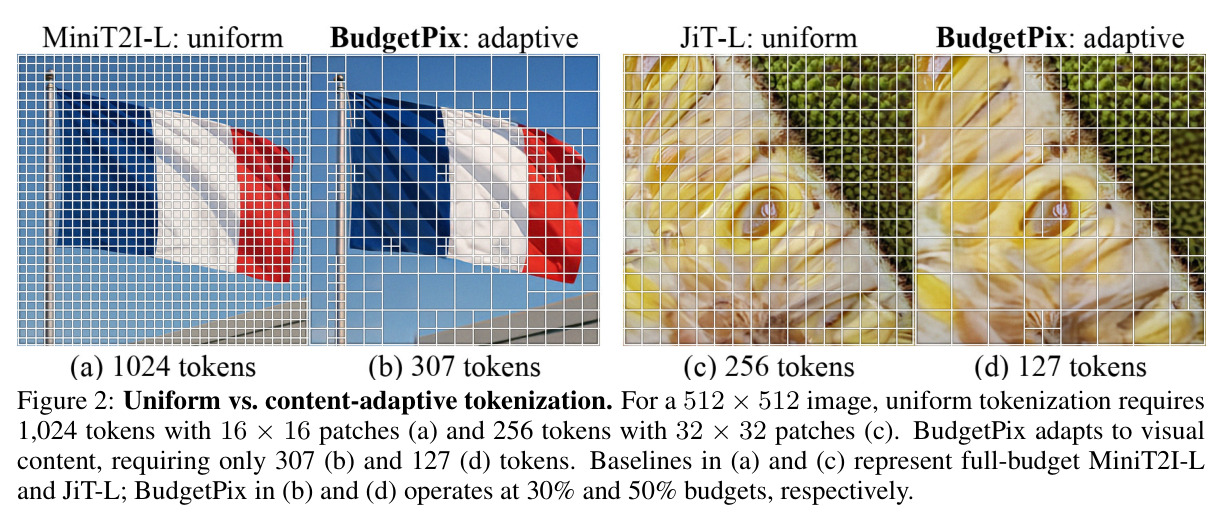
同一面旗帜+天空场景下,均匀 16×16 分块需 1024 个 token,而 BudgetPix 自适应布局仅需 307 个;菠萝蜜场景中标准 JiT 需 256 个 token,BudgetPix 用 127 个(50% 预算)即可匹配质量。
直观论证了统一 tokenization 的浪费本质与自适应布局的节省幅度,是动机部分最有说服力的定量示例。