QuadTok:面向自回归图像生成的四叉树视觉分词器 QuadTok: Quadtree Visual Tokenizer for Autoregressive Image Generation
用四叉树分词器按区域复杂度自适应分配视觉token,兼顾空间对应与自回归生成
前置知识
视觉分词器与向量量化(VQ-VAE/VQ-GAN)
视觉分词器把连续图像压缩成离散 token 序列,是自回归/掩码生成模型的前端。典型做法是编码器把图像映射为连续 latent,再经最近邻查找量化到可学习码本 $\mathrm{Quant}(z)=\arg\min_{e_k}\|z-e_k\|_2$,用重建损失加承诺损失训练,VQ-GAN 再引入 GAN 损失提升感知质量。
QuadTok 本质就是一个新型分词器,其编码-量化-解码流程、16384 码本与 d=8 码维的设计都建立在这套范式之上,不了解 VQ 无法理解它的表示方式。
自回归图像生成
把图像表示为离散 token 序列后,用 GPT 式 decoder-only Transformer 建模 $p(Y)=\prod_i p(y_i\mid y_{<i})$,训练用因果掩码,推断逐 token 采样并配合 classifier-free guidance 提升质量。LlamaGen 证明了该范式可以媲美扩散模型。
QuadTok 的生成器就是 LLaMA 式自回归模型,四叉树序列的 BFS 顺序与天然因果性正是论文宣称的核心优势,理解 AR 范式才能看懂生成实验。
四叉树
递归地把二维平面划分成四个象限的树结构:父节点覆盖整块区域,展开后四个子节点各覆盖其四分之一象限,可实现空间自适应的多分辨率划分,传统上广泛用于图像压缩与自适应计算。
QuadTok 的全部表示就建立在这棵树上:token 对应树节点,Kinship 掩码的亲缘规则、BFS 序列化的由粗到细顺序都直接源于四叉树的结构性质。
因果注意力掩码
Transformer 的自注意力可通过掩码矩阵禁止某些位置互相注意:标准因果掩码只允许每个 token 关注它之前的 token,是自回归模型训练的基础;任意自定义掩码则可以把结构先验(层级、空间关系)注入注意力计算。
Kinship Causal Mask 是本文两大核心机制之一,它按树亲缘关系定制注意力模式,理解掩码如何塑造信息流才能明白 token 与图像区域的绑定为何得以保留。
LPIPS 与 rFID/gFID
LPIPS 用预训练深度特征度量两张图像的感知差异,数值越小越相似;FID 基于 Inception 特征的均值与协方差距离衡量生成分布与真实分布的差距,rFID 用于评价重建、gFID 用于评价生成,均越低越好,常与 PSNR(像素保真度)互补使用。
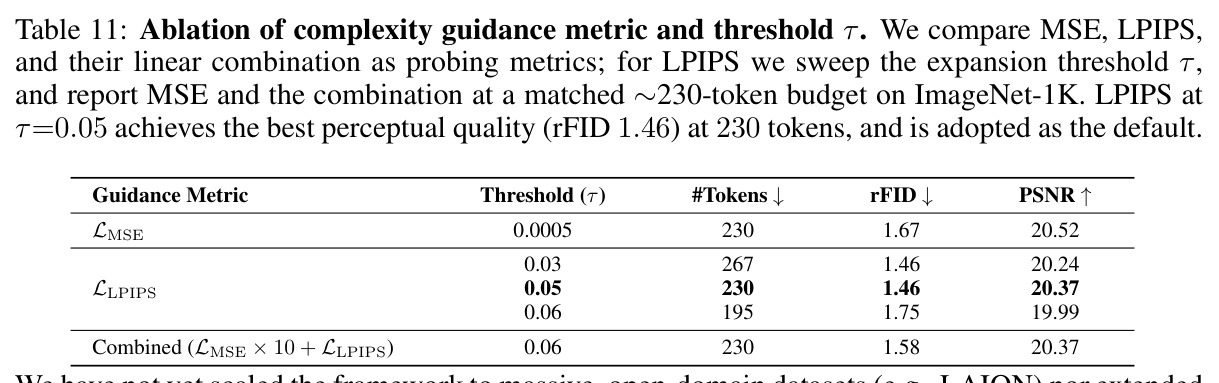
论文选树的信号就是空间 LPIPS 损失差,主要结论全部用 rFID/gFID/PSNR 表述,例如 230 token 达 rFID 1.46、生成 2.08 gFID,不懂这些指标就无法解读实验。
Classifier-Free Guidance(CFG)
训练时以一定概率随机丢弃条件输入(如类别标签),使模型同时学会条件与无条件生成;推断时用 $\tilde{y}=y_u+s\,(y_c-y_u)$ 的外推方式放大条件影响,以少量多样性代价换取样本质量与条件一致性。
QuadTok 生成器训练时以 0.1 概率丢弃类别条件,推断用动态 power-cosine CFG 调度(512 实验用 scale 16),采样设置直接影响 gFID 数值,比较不同表格外推时必须注意。
研究动机
自然图像的信息密度在空间上高度不均:纹理复杂、高频细节丰富的区域携带的信息远多于平坦均匀的区域。然而经典视觉分词器把图像压成固定预算的 token:VQ-GAN、LlamaGen 等用刚性 2D 网格,如 LlamaGen 在 256×256 图像上固定输出 256 个 token(f=16 下采样),均匀撒满全图,导致复杂区域欠表达、简单区域 token 冗余。另一条路线是 TiTok、FlexTok、One-D-Piece 等 1D 分词器,把图像编码为可变长序列以适配内容复杂度,但 token 分配沿序列维而非图像平面进行,基本丧失了 token 与图像块的显式空间对应:TiTok-S 用 128 个 token 重建 ImageNet 的 rFID 仅 1.71、PSNR 17.80,明显落后于同量级的网格方法,也不适合需要空间定位的下游任务。换言之,"空间绑定"与"长度灵活"这两个理想性质在现有方法中不可兼得。
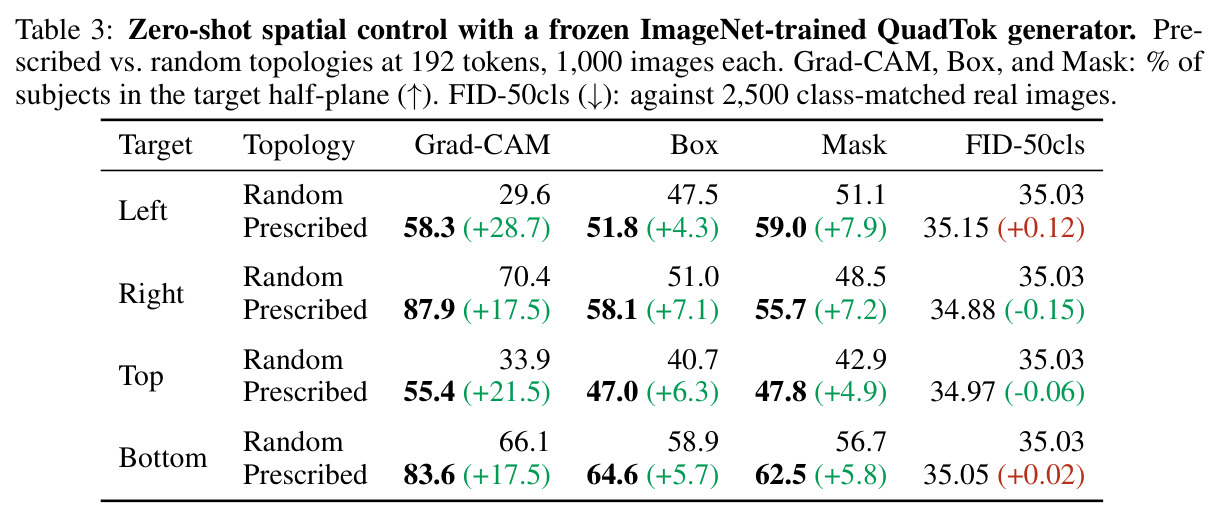
本文的目标是本文要设计一个同时满足三个条件的视觉分词器。其一,按局部视觉复杂度自适应分配 token:复杂区域细分为四个子节点、均匀区域保持粗粒度,相比固定 256 token 的网格在 ImageNet 上节省约 10% token、零样本迁移到 COCO 节省 9%,且重建保真度可比。其二,保留 token 与图像区域的显式空间对应,使重建可以层级化进行、单点扰动可以定位到局部 patch。其三,token 序列天然带有树结构的因果性,能被 GPT 式自回归模型直接用于图像生成。落地指标是在 ImageNet 256×256 类条件生成基准上用 947M 参数模型做到 2.08 gFID,并展示网格与 1D 分词器都难以提供的附加能力——在生成前给定拓扑即可零样本控制空间布局。
与已有工作不同的是,现有工作在"固定 2D 网格"与"可变长 1D 序列"之间二选一,QuadTok 的独特切入是用四叉树作为桥梁:树节点天然绑定 2D 空间区域,BFS 展平后又具备 1D 序列的长度灵活性。与 CAT 用 caption 分数选择整图压缩率的连续 VAE 路线不同,QuadTok 在单张图像内部按区域分配离散 token;与 DPAR 用熵模型动态分组 token 也不同,QuadTok 直接把区域表示为树节点并在先验拓扑下生成。作者进一步指出两个此前被忽视的关键问题:如何基于重建收益决定哪些区域值得细分(而非依赖启发式显著性),以及展平成序列后如何维持节点间的层级与空间关系。前者用 Region-Wise Complexity Guidance 解决,后者用 Kinship Causal Mask 解决,二者共同构成空间自适应 token 化的完整方案。
核心方法
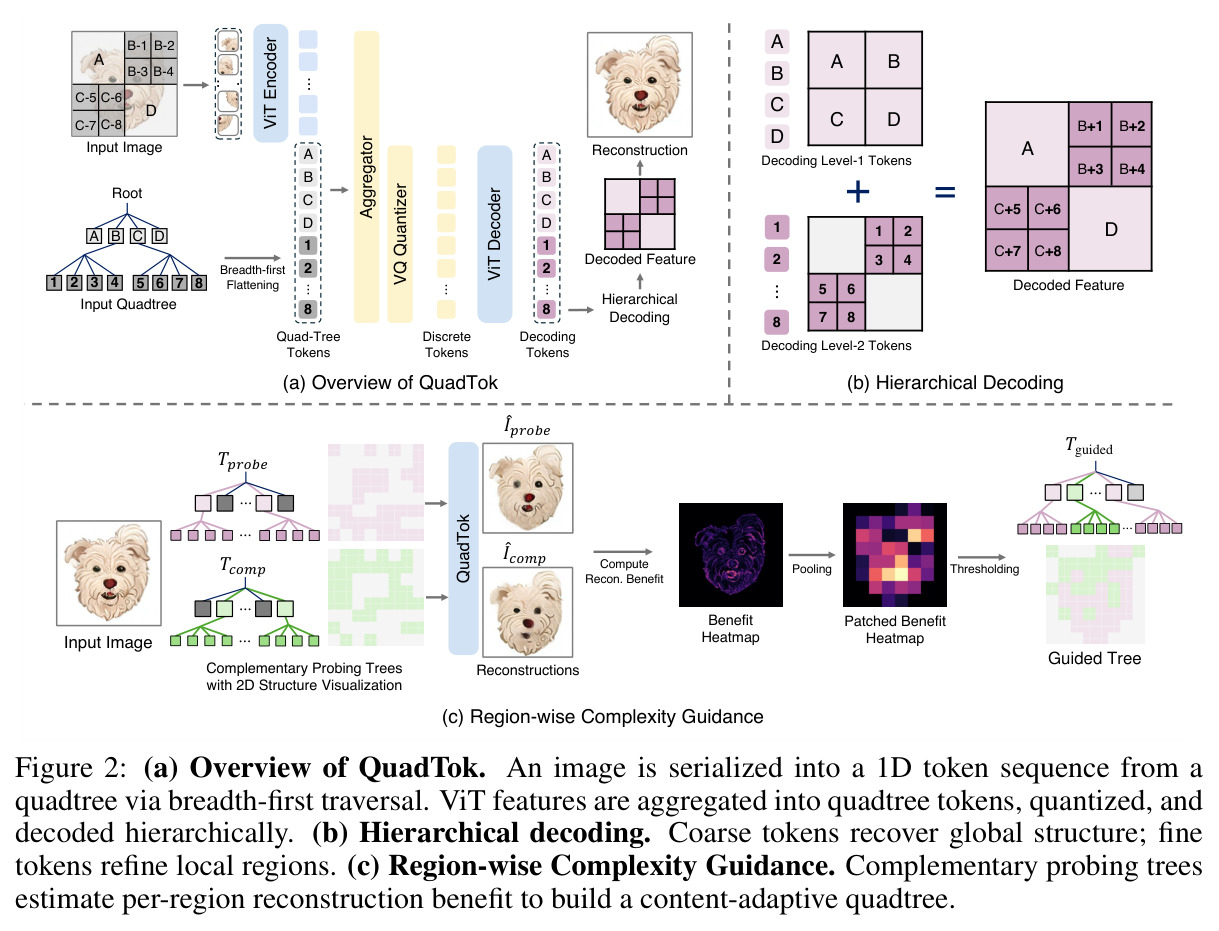
QuadTok 用两层级四叉树表示 256×256 图像:第一层是 8×8 粗网格(64 个 token),第二层是可选展开的 16×16 细网格,每个节点由属性 $(l,p)$ 标记层级与空间位置,按 BFS 展平成由粗到细的 1D 序列。编码时,ViT 提取稠密特征 $F$,与携带位置指令的可学习 token $Q$ 拼接送入 Aggregator:$[F'\|Z]=\mathrm{Aggregator}([F\|Q])$,指令 token 读取全局上下文形成各区域的连续表示 $Z$,再用容量 16384、码维 8 的共享码本量化:$\mathrm{Quant}(z_i)=\arg\min_{e_k\in C}\|z_i-e_k\|_2$。解码端把 $z_i=e_{y_i}+q_i$ 送入 Decoder,用层级专属 unpatching $U_l$ 投影回空间 patch,逐级残差上采样由粗到细重建出 RGB。生成器是 LLaMA 式 decoder-only Transformer,采样前给定树拓扑,按 BFS 顺序自回归预测码本索引。
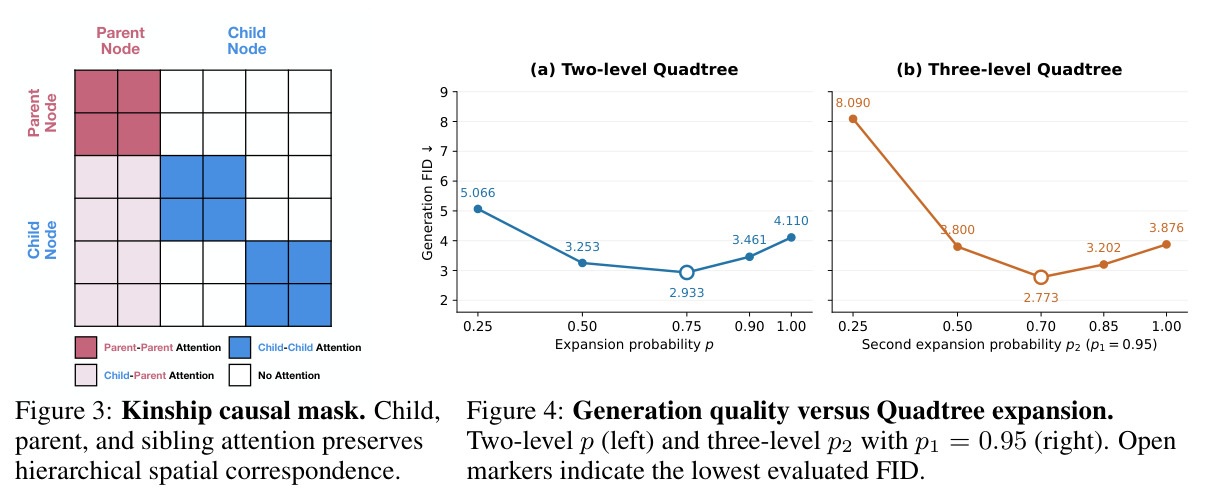
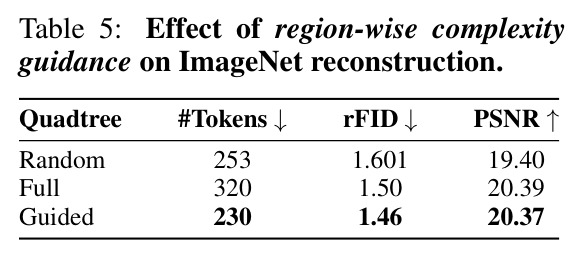
核心创新之一是 Region-Wise Complexity Guidance:为每张图构造一对互补的探测树——随机展开一半粗节点形成探测树,剩余节点展开形成其补树,使每个区域恰好在一次重建中处于展开态、另一次中处于收拢态;对两个重建结果分别与原图计算空间 LPIPS 损失图,区域 $r$ 的重建收益为 $b_r=\mathrm{AvgPool}_r(E^{collapsed}_r-E^{expanded}_r)$,仅当 $b_r>\tau$(默认 0.05)时展开该区域为四个子节点。这把"哪里需要更多 token"从启发式判断变成数据驱动的收益估计,且一对探测树即可同时估计全部区域,开销为常数次重建。其二是 Kinship Causal Mask:展平序列上的注意力被树结构约束——父节点之间双向注意力以建立全局布局;子节点可以看所有父节点,父节点不可看子节点;同层仅同胞节点互看。这强制了由粗到细的信息流,把细化限制在每个空间区域内,保住了 token 与图像区域的绑定,也是零样本空间控制的根基。
方法步骤详情
第一步:两层四叉树(8×8 粗层、16×16 细层)表示图像,节点属性 $(l,p)$ 标记层级与空间索引,BFS 展平。第二步:8 层 ViT(patch 16×16、隐藏维 512)提取特征 $F$,指令嵌入 $q_i=\mathrm{Emb}_{l_i}(p_i)$ 与 $F$ 拼接进入 Aggregator 输出节点表示 $Z$;树 token 可看全部 ViT token,反之不可。第三步:最近邻查找 16384×8 共享码本得离散索引。第四步:$z_i=e_{y_i}+q_i$ 经 8 层 Decoder,用层级专属 unpatching $U_l$ 投影成空间 patch,逐级残差聚合重建 RGB。第五步:分词器约 120M 参数,以 $\gamma=0.5$ 随机展开父节点采样树形;损失为 MSE、LPIPS、VQ、GAN 加权和,GAN 项 20 万步后启用。第六步:互补探测树估计区域收益 $b_r$,展开 $b_r>0.05$ 的区域。第七步:B/L/XL/XXL(111M/343M/697M/947M)训练 300 epochs、batch 1024、无 EMA,QK 归一化+SwiGLU+RoPE,CFG 丢弃 0.1,推断用 KV cache 与 power-cosine CFG。
技术新颖性
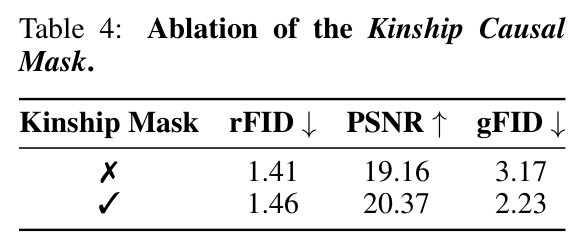
与 1D 分词器相比,本质区别在于可变长的来源:TiTok/FlexTok 的灵活性来自序列维度,token 与图像块没有对应关系;QuadTok 的灵活性来自空间维度的树分裂,每个 token 始终绑定一个矩形区域。消融实验直观证明了这种绑定:随机扰动一个细层 token,有 Kinship 掩码时重建差异局限于对应 patch,没有掩码时差异扩散至全图;去掉掩码 rFID 略降(1.46→1.41)但 PSNR 掉 1.21 点、下游 gFID 从 2.23 恶化到 3.17,说明空间结构对 AR 生成至关重要。与 CAT 相比,QuadTok 分配的是图像内部不同分辨率的离散 token 而非整图压缩率;与 DPAR 的动态 patchification 相比,QuadTok 用显式树节点表示区域并在先验拓扑下生成。互补探测树是方法学上的巧思:用一对互补充树把逐区域枚举的 $O(M)$ 次重建降为 2 次,使逐图自适应分配在预分词阶段切实可行。
实验结果
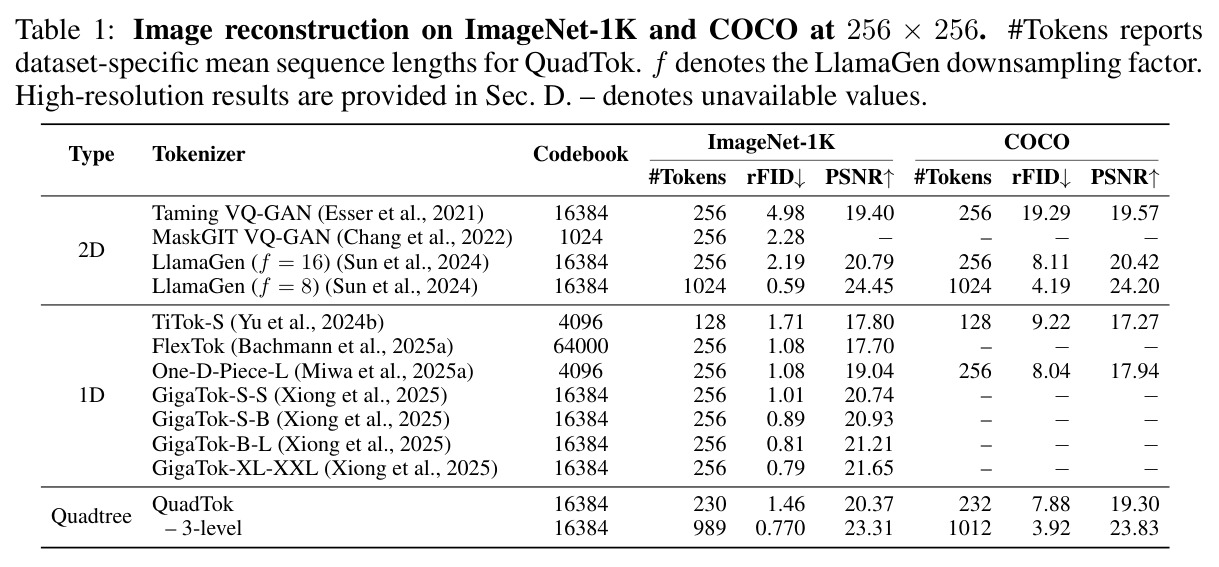
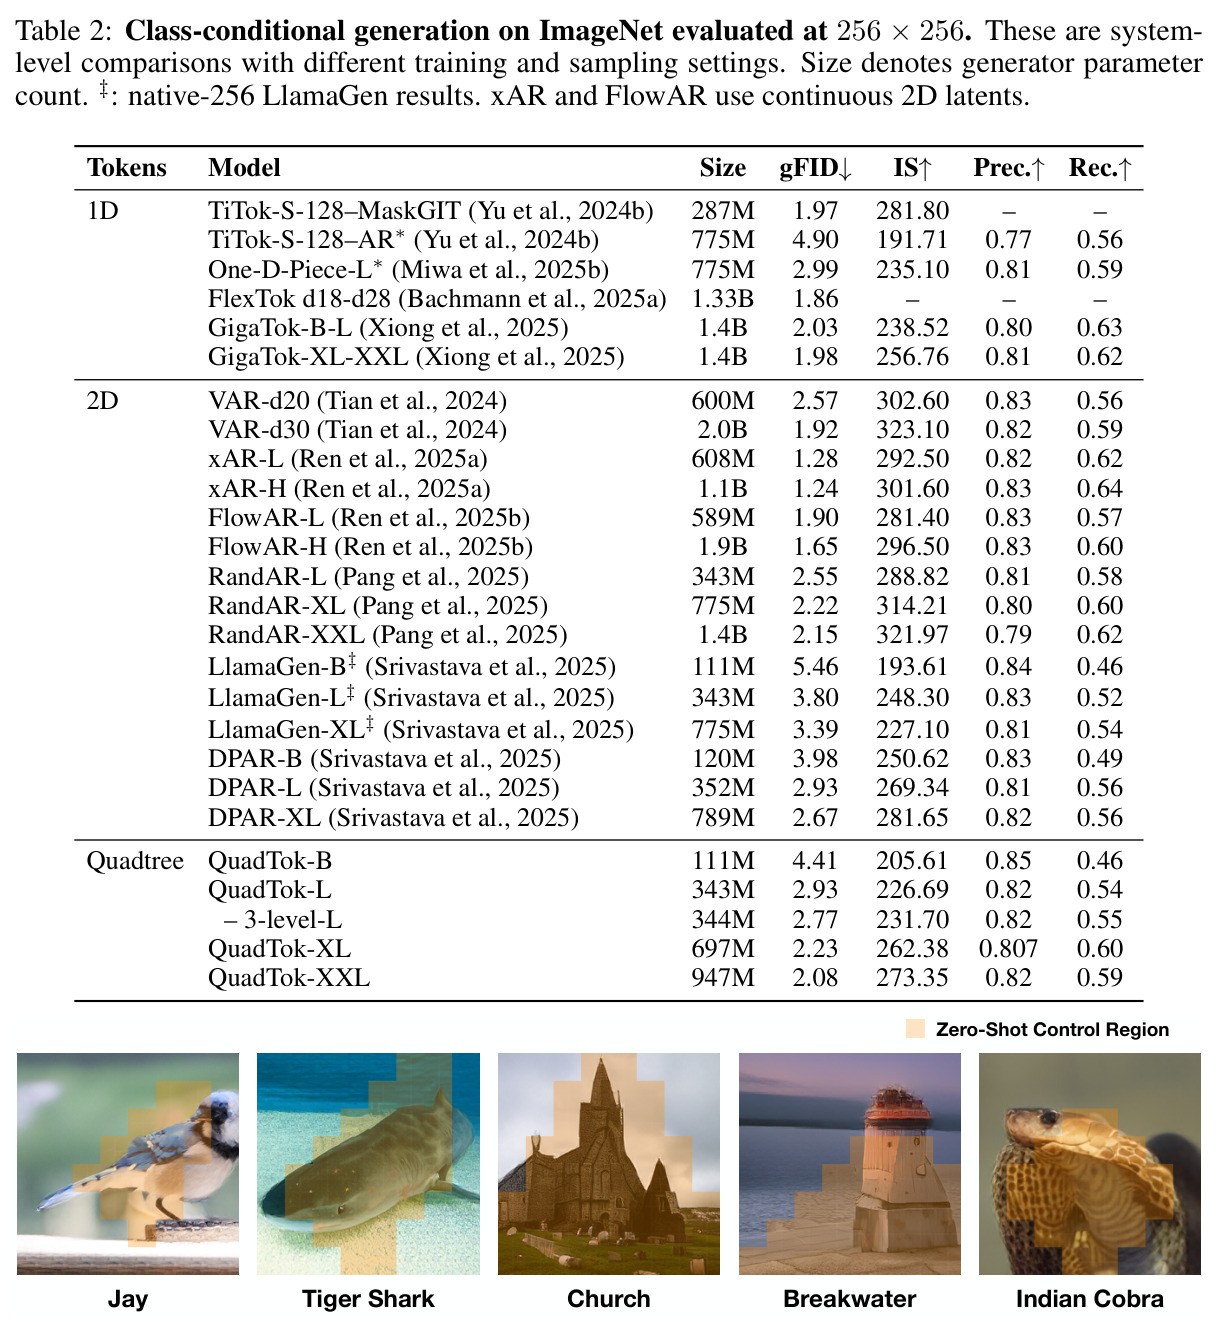
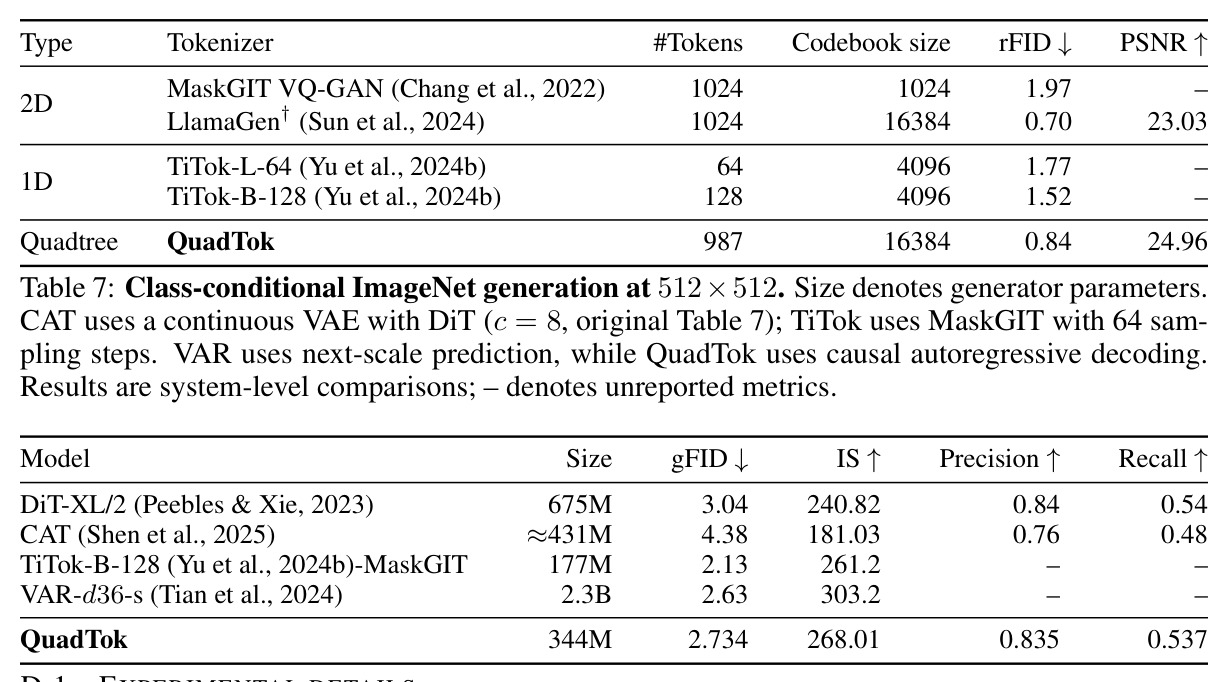
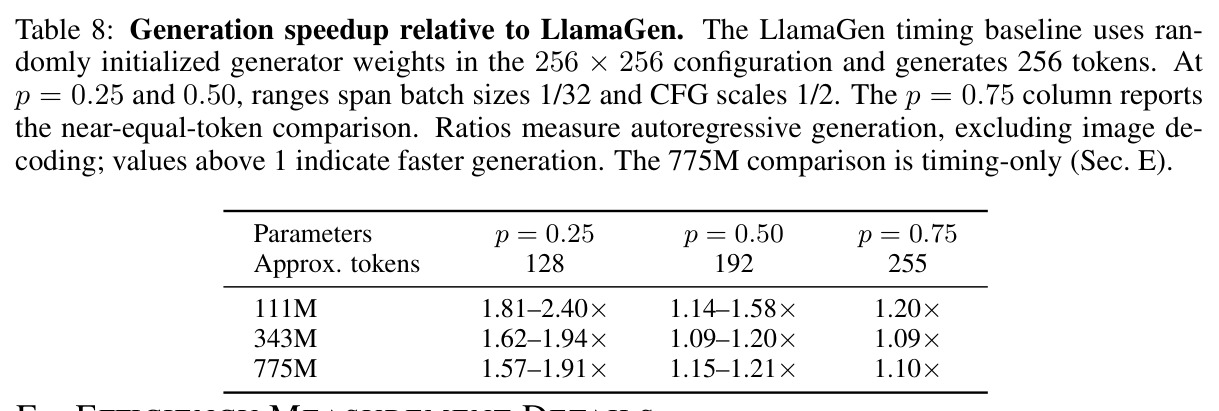
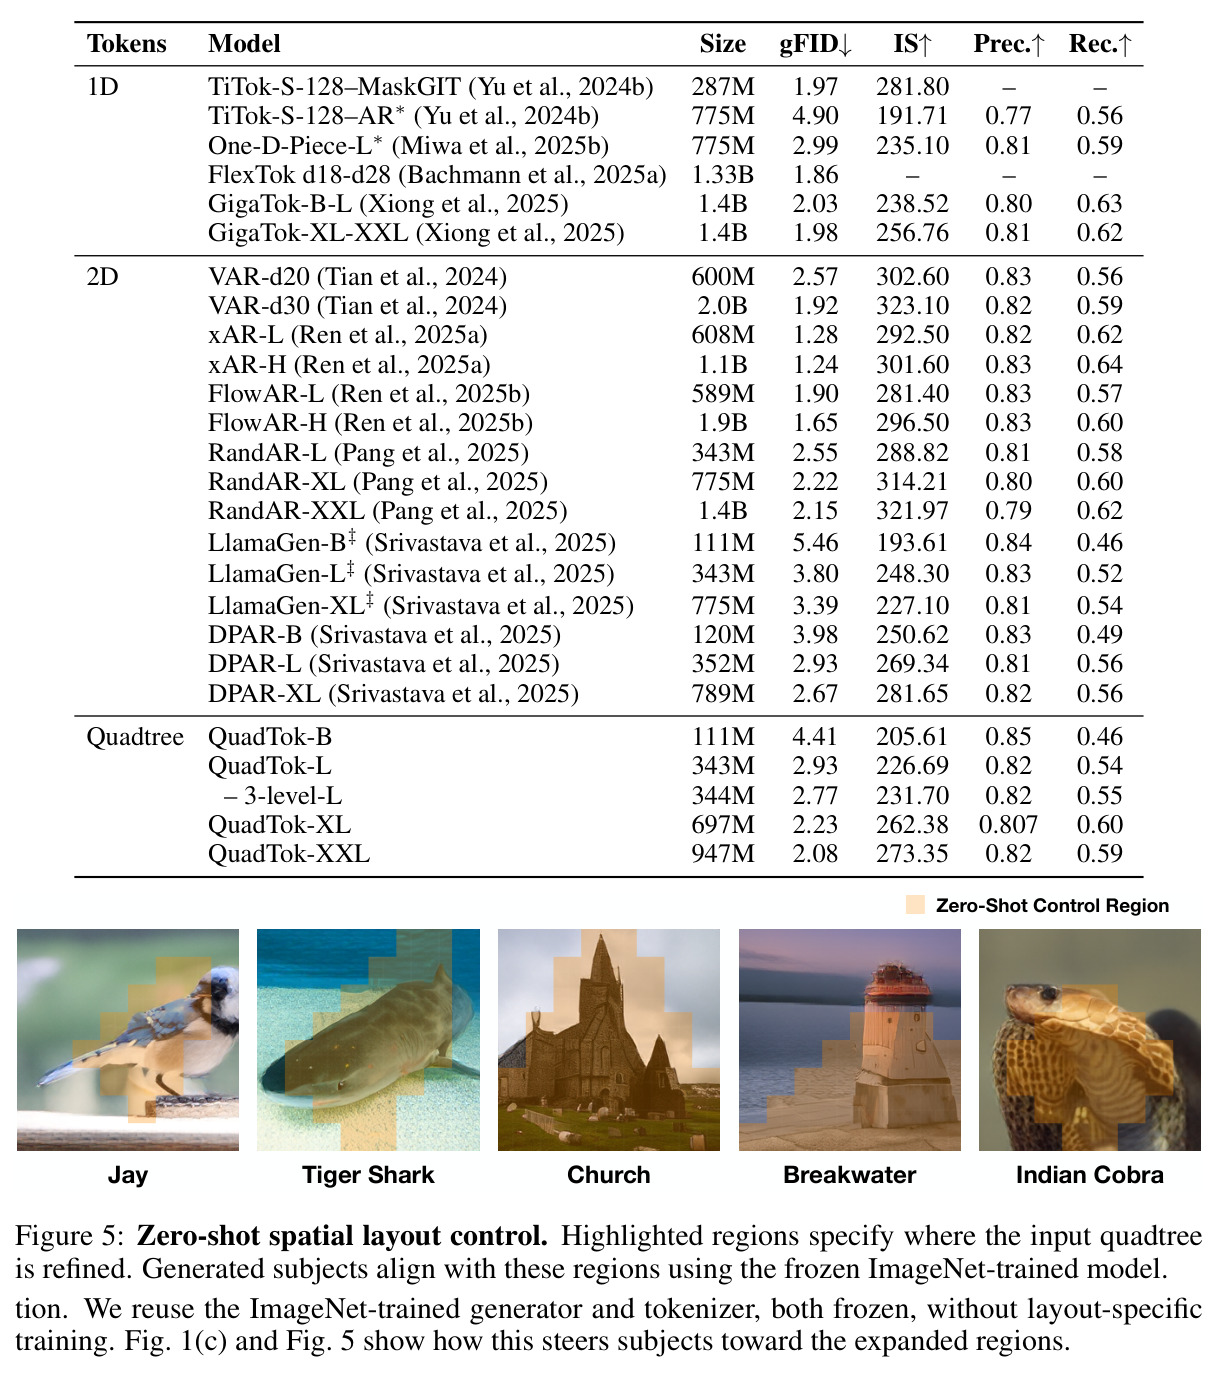
重建:ImageNet 256×256 上 QuadTok 平均 230 token 达 rFID 1.46、PSNR 20.37,优于 LlamaGen(f=16) 的 256 token(2.19/20.79);零样本迁移 COCO 用 232 token 达 7.88,好于 LlamaGen 的 8.11;三层版 ImageNet 达 0.770(989 token),512×512 重建 987 token 达 0.84。生成:947M XXL 在 ImageNet 256 达 gFID 2.08、IS 273.35,超过 1.4B RandAR-XXL 的 2.15;XL(697M)2.23;L(343M)2.93,三层版 2.77;344M 在 512×512 达 2.734,优于 675M DiT-XL/2 的 3.04。空间控制:指定左/右/上/下半平面后,Grad-CAM 命中率由 29.6/70.4/33.9/66.1 升至 58.3/87.9/55.4/83.6(最高 +28.7),FID-50cls 仅变化 −0.15~+0.12。消融:Kinship 掩码使 gFID 3.17→2.23;引导树 230 token 达 1.46,比 Full 树(320 token、1.50)省 28% 且更好;LPIPS+τ=0.05 的选树信号优于 MSE(1.67);p=0.25 时生成加速 1.81–2.40×。
局限与改进
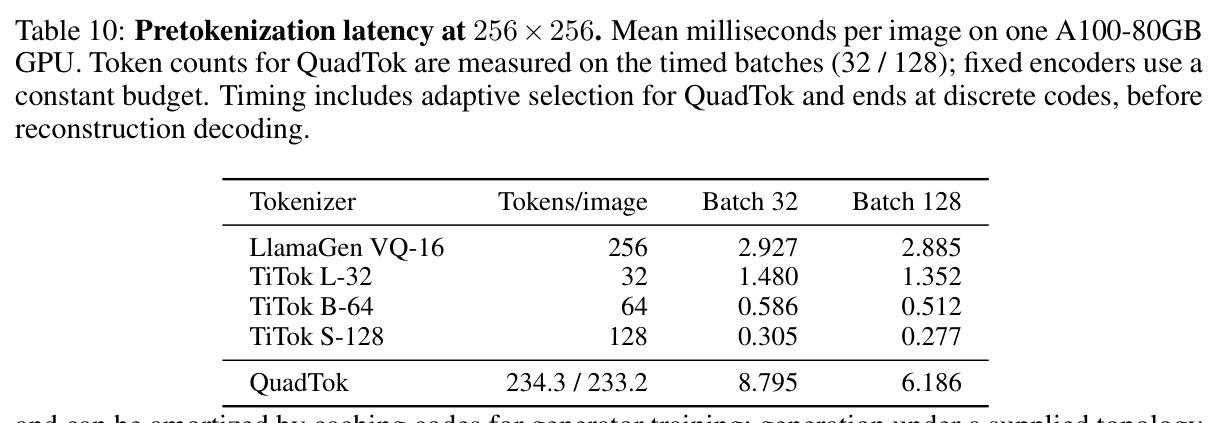
作者承认的局限有二:一是受算力约束只验证了 ImageNet 类条件生成,未扩展到 LAION 规模开放域与文本到图像合成,也未加入开放词表条件所需的交叉注意力;二是 ImageNet 偏向单主体、目标居中构图,限制了零样本布局控制的上限,复杂多物体关系场景仍困难。我的补充观察:其一,内容自适应树搜索只能在离线预分词时进行,延迟 8.795 ms/图(batch 32),约为 LlamaGen VQ-16(2.927 ms)的三倍,在线生成阶段享受不到自适应;其二,生成时拓扑必须在采样前给定,无条件场景只能随机采树(ImageNet 评测正是如此),模型并未学会"为内容预测好树",自适应只发生在分词器侧;其三,绝对生成质量仍逊于最强对手——TiTok-MaskGIT 1.97、GigaTok 1.98、VAR-d30 1.92、xAR-L 1.24,优势主要在效率与可控性;其四,PSNR 系统性低于网格基线(20.37 对 20.79),像素保真度有折损;三层实验中树深度与 token 预算同步增加,未解耦两者的独立贡献。
独立分析的弱点
第一,探测式选树需要两次额外重建加空间 LPIPS 计算,只适合离线预分词,在线或流式场景不可行;改进方向是训练一个轻量复杂度预测头,从 ViT 特征单次前向直接回归每区域收益 $b_r$,或用学习到的显著性图替代探测。第二,生成器对拓扑完全被动,树的质量取决于外部供给;可引入层级化生成:先用小模型自回归预测"哪些节点展开"的结构序列,再在此拓扑下生成视觉码,实现真正的内容自适应生成,这也与 DPAR 的熵分组形成有趣对照。第三,四叉树只能做轴对齐的矩形细分,对细长、斜向或曲面物体边界刻画粗糙,非矩形区域上的 token 利用率下降;可探索可变形分割、二叉树或与超像素结合。第四,Kinship 掩码禁止跨子树的细层交互,细层之间信息通道较窄,可能是 PSNR 偏低的原因之一;可尝试细层全局聚合或由细回粗的迭代精化解码。第五,三层实验同时加深树并增加 token,无法区分层级结构本身与纯粹 token 数量的贡献,需要 token 数严格对齐的对照实验。第六,零样本控制的评测局限于 ImageNet 类别内半平面布局,尚未在开放词表与复杂布局上验证。
未来方向
作者明确提出的方向:把 QuadTok 扩展到大规模开放域数据和文本到图像生成,引入交叉注意力实现开放词表文本条件;把零样本布局控制推广到场景级、多物体复杂数据集,突破 ImageNet 的构图偏差。基于本文成果还可延伸:其一,把四叉树拓扑作为多模态大模型的结构化输出接口,让 LLM 直接生成布局树驱动可控生成(论文已演示 LLM 指定区域的可行性);其二,迁移到视频,用时空八叉树做自适应时空 token 化;其三,树结构的由粗到细天然适合渐进式图像传输——先发粗层 token 快速出概览、按带宽逐步补细层;其四,与 VAR 的 next-scale 预测结合,探索树序与尺度序混合的生成顺序;其五,把互补探测树的收益估计思想推广到其他自适应计算场景,如自适应分辨率训练与 token 剪枝;其六,研究拓扑分布本身的学习与先验建模,替代推断时的随机采树。
复现评估
代码已开源(GitHub: myc634/QuadTok),附录给出完整配方:分词器为 8 层 ViT 编码器 + 8 层 Aggregator + 8 层 Decoder,隐藏维 512,约 120M 参数;ImageNet-1K 256×256 训练,树采样 $\gamma=0.5$,码本 16384、码维 8,损失权重沿用 One-D-Piece,GAN 项第 20 万步启用。生成器 B/L/XL/XXL 为 111M/343M/697M/947M,训练 300 epochs、全局 batch 1024、无 EMA,学习率 $4\times10^{-4}$ 恒定 250 epochs 后线性衰减到 $10^{-5}$,QK 归一化、SwiGLU、RoPE,条件丢弃 0.1。复现门槛中等偏高:需要 ImageNet-1K 全量数据与数十卡 A100 天级算力,预分词逐图树搜索在 A100 上约 161.66 img/s;空间控制评测还需 Grad-CAM、Grounding DINO、SAM 2 工具链。
论文图表
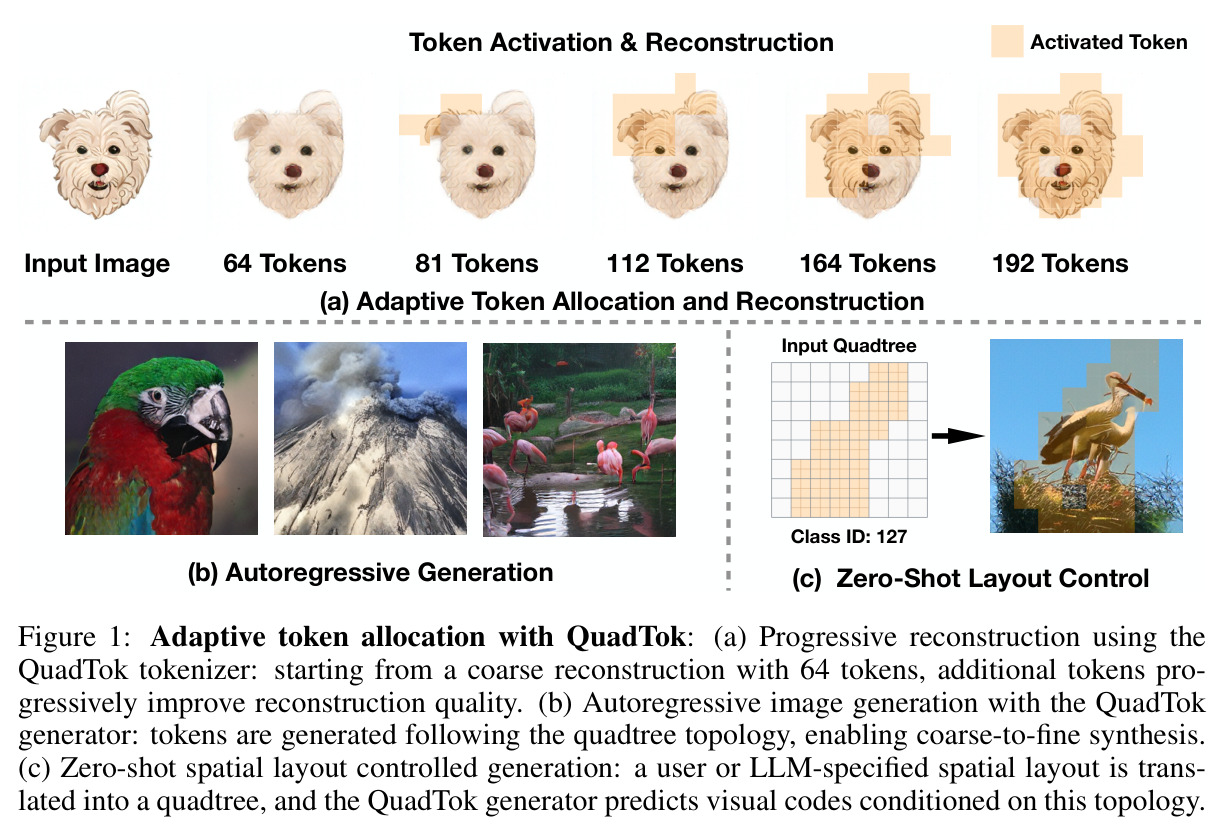
三联概览图: 为 64 到 192 token 的渐进重建,token 越多画质越高,展示分词器的自适应容量分配; 沿四叉树拓扑的自回归图像生成; 用户或 LLM 指定的空间布局被翻译成四叉树,生成器在该拓扑条件下完成零样本布局控制生成。
一图浓缩论文三大卖点——自适应 token 分配、树序自回归生成、零样本空间控制,是快速把握全文贡献的最佳导读。
512 分辨率下 QuadTok 用 987 token 达 rFID 0.84、PSNR 24.96,优于 1024 token 的 MaskGIT VQ-GAN(rFID 1.97)与 LlamaGen(0.70,经 resize 评测),也优于 64/128 token 的 TiTok-L/B。
验证空间自适应 token 化可以干净地扩展到更高分辨率,说明方法不局限于单一分辨率设置。
给出各配置的绝对延迟:如 111M 档 LlamaGen 5.440 s/批,QuadTok(p=0.25) 2.524 s/批(加速 2.16×);775M 档 LlamaGen 12.612 s,QuadTok(p=0.25) 6.587 s(1.91×),并区分纯自回归采样与含解码的总耗时。
为 Table 8 的加速比提供可核查的绝对数值与严格计时协议,便于读者判断收益的实际规模。