信息的价值与演化e-puck机器人中通信的涌现 The value of information and the emergence of communication in evolved e-puck robots
通信只有传递接收方无法自行获得的信息时才涌现,任务变难会筛选出指称信号
前置知识
GRU(门控循环单元)
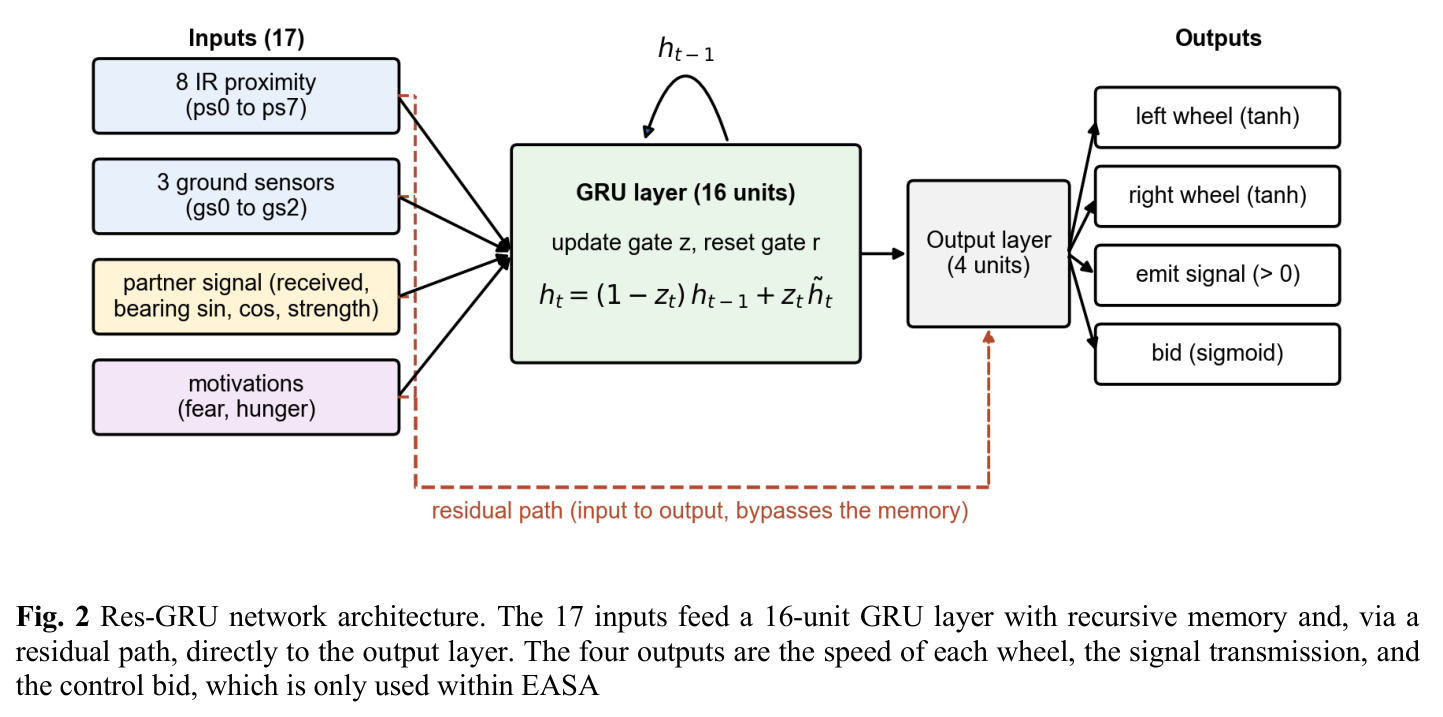
GRU是一种循环神经网络单元,用更新门 $z$ 和重置门 $r$ 控制记忆:候选状态由重置门加权上一时刻状态计算得到,最终状态按 $h(t)=(1-z)\,h(t-1)+z\,\tilde{h}(t)$ 混合旧状态与候选状态,从而用较少参数长期保留历史信息,适合需要记住'刚才发生过什么'的控制任务。
本文每台机器人的控制器就是一个16单元GRU加输入到输出残差通路的Res-GRU网络,信号能否被记住并影响行为完全依赖其递归记忆,不懂GRU无法理解控制器如何整合随时间到达的信号。
演化机器人学与遗传算法
演化机器人学不训练网络而是进化其参数:本文用种群48个体、150代的遗传算法,每代精英保留10个,从最优25个中随机均匀交叉产生后代,每个基因以0.2概率接受标准差0.12的高斯噪声变异;适应度即任务表现,无需梯度。
论文所有行为都由进化产生而非监督学习,适应度函数怎么设计直接决定'通信是自发涌现还是被奖励函数诱导'这一核心问题的答案是否可信。
基底神经节与行动选择
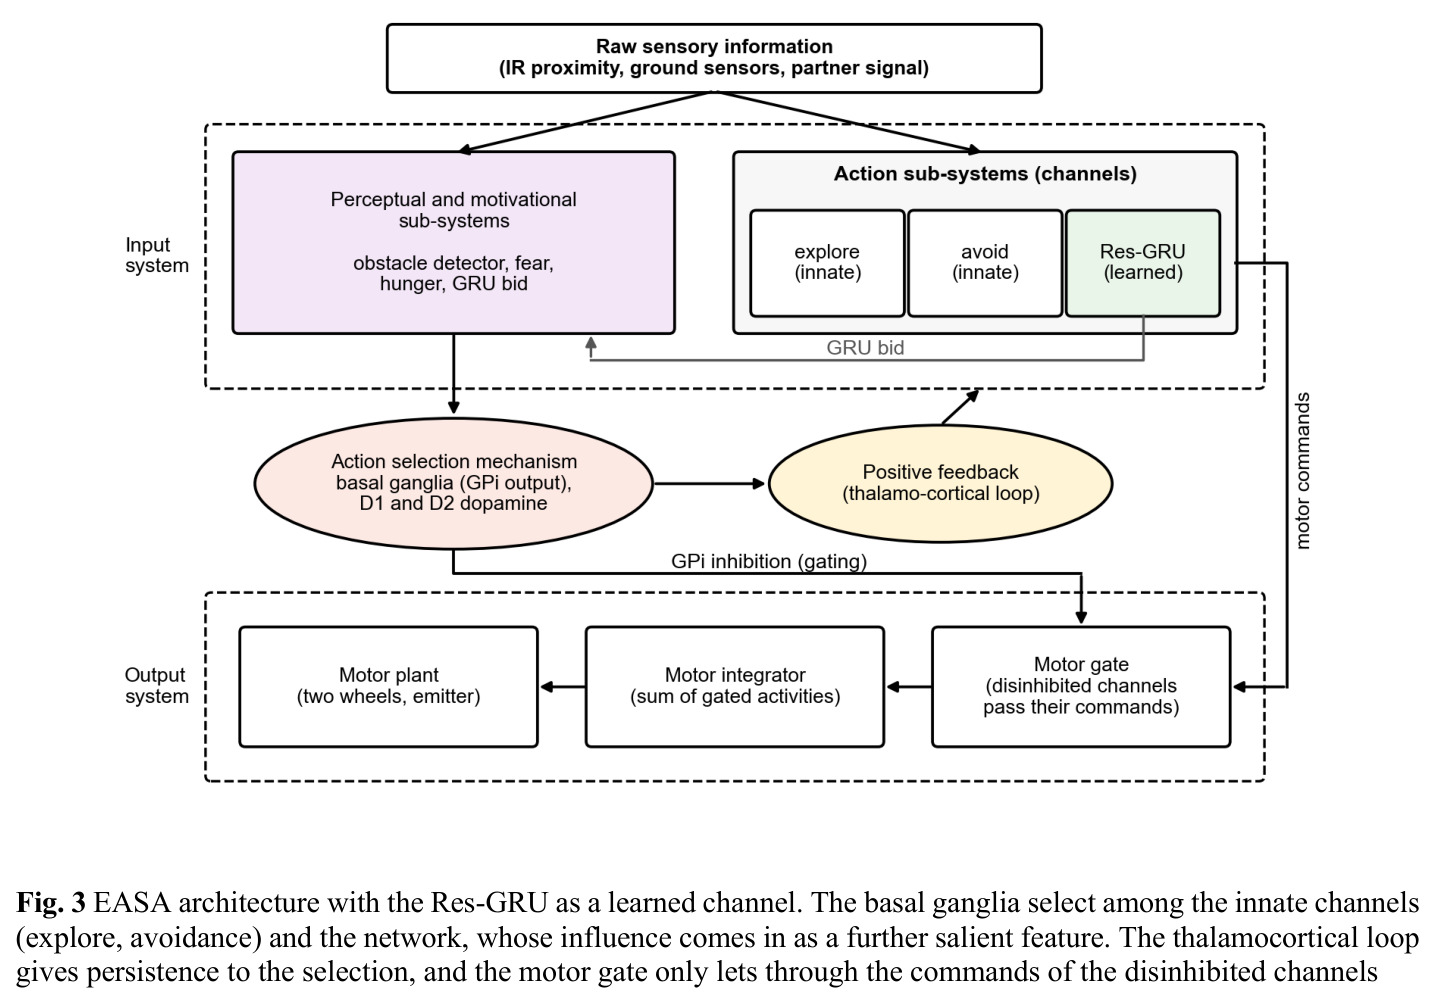
基底神经节是脊椎动物脑内仲裁竞争运动程序的核团。计算模型中每个行为通道有一个显著度(salience),通过去抑制机制让显著度最高的通道获得运动控制权,丘脑皮层回路为选择提供持续性以避免抖动切换,多巴胺经D1/D2通路调制选择与控制。
论文第二主问题是:把该模型的开源实现EASA作为先天脚手架套在学习网络外是否会妨碍社交任务,这需要理解其通道显著度、去抑制与持续性的工作机制。
隐式适应度函数
隐式适应度只度量任务最终结果(本文为机器人停留在食物区的时间比例,0到1),不奖励设计者指定的任何中间行为;显式适应度则给发信号、接近目标等子行为加分,容易把设计者预设的解决方案强加给进化过程。
本文刻意只用隐式适应度、不发任何'通信奖金',这保证了若信号被使用必然是自发涌现的,否则无法区分演化出的信号与被规则强加的信号。
涌现通信与信号消融检验
涌现通信研究信号系统如何在没有人工指定语义的情况下从进化中产生。检验信号是否真的承载信息,常用成对消融:在同一批测试回合上分别让信号正常工作、完全关闭、或保留发包但把方向随机化,再比较任务表现的统计差异。
论文的核心结论'通信随信息价值涌现'正是靠正常/关闭/随机方向三版本信号在同一百个回合上的配对Wilcoxon符号秩检验得出的,理解这套检验才能读懂证据强度。
研究动机
涌现通信领域已确认遗传相关性与群体级选择有利于可靠信号的演化,历史偶然性也会让相同初始条件的种群发展出不同信号策略,Scott-Phillips等人还证明'无通信状态'本身是演化稳定策略。但一个更基本的条件长期被忽视:只有当信号传递接收方无法独立获得的信息时它才有价值,否则信号冗余、维持它的选择压力消失。这个问题在实验设计中特别隐蔽——只要给控制器额外输入目标的方向或距离(许多机器人实验都这样做),进化确实更容易,但通信随之变得不必要;此时若想让机器人发信号,只能靠在适应度里加通信奖励或用规则强制发射,得到的信号究竟是演化出来还是被人为强加的,就难以区分。此外仿真与现实的差距是另一重风险:未经校验的机器人模型会让行为依赖仿真器伪影而非任务本身,作者此前的2D到3D协议迁移工作就只得到部分且不对称的迁移。
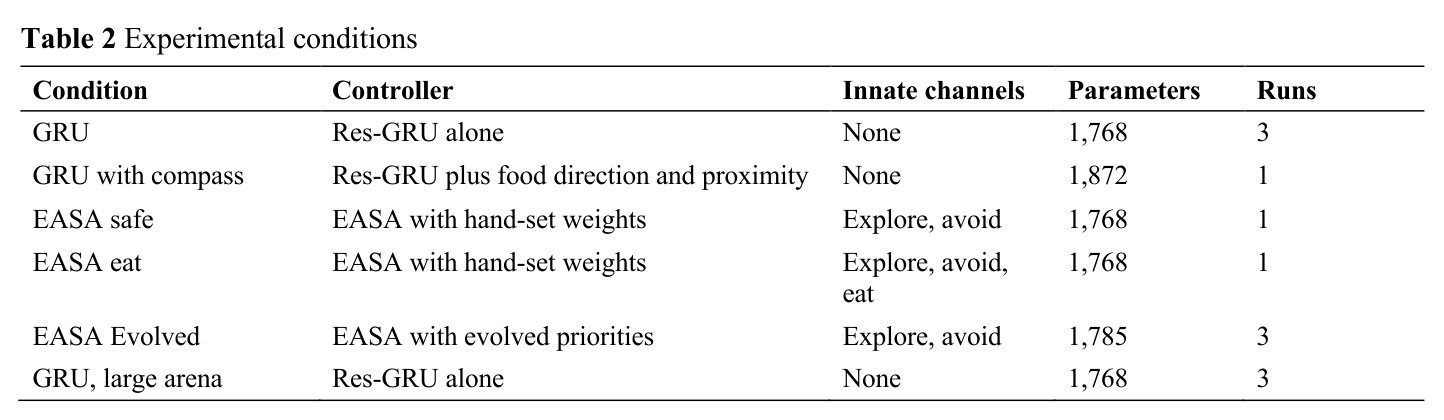
本文的目标是本文的目标是用一套从零搭建、经过量化验证的3D系统同时回答两个问题。第一,在不给机器人任何目标方位信息的前提下,通信究竟在什么条件下才会涌现:作者把官方Webots模型的e-puck机器人重建到PyBullet物理仿真中,两台机器人必须找到只有压过才能用底面传感器检测到的食物区,唯一的通信渠道是一个本身无内容的一比特信号,适应度只奖励停留在食物上的时间(隐式函数),然后通过'给指南针/不给指南针'与'小/大竞技场'两个因子操纵信号的信息价值。第二,先天行动选择架构在这个社交任务中是脚手架还是绊脚石:对比纯GRU网络与三种EASA基底神经节变体(手工安全权重、加进食反射、17个选择参数随网络共同进化),并检验进化如何调整先天反射的权重。
与已有工作不同的是,作者的独特切入是把'信号的信息价值'本身变成受控变量。文献推荐的有利条件(同质团队、团队级选择)被固定下来,从而隔离出信息价值这单一因素:指南针条件给网络增加食物方向与接近度两个输入,其余一切不变,直接观察信号是否消失;竞技场从1米扩到1.5米(回合从60秒延到90秒)则不改变通信是否出现,而改变各策略的相对价值,以此区分'通信出现频率'与'通信有用性'两个常被混淆的概念。另一方面,以往基底神经节机器人研究中被选通道全是手工设计行为,本文首次让被选择通道之一是靠进化习得行为的GRU网络、且任务需要同伴协调,从而能检验'先天脚手架利于社交任务'这一直觉假设。隐式适应度加成对消融(正常/关闭/随机方向)保证信号功能的判断不依赖设计者的主观解读。
核心方法
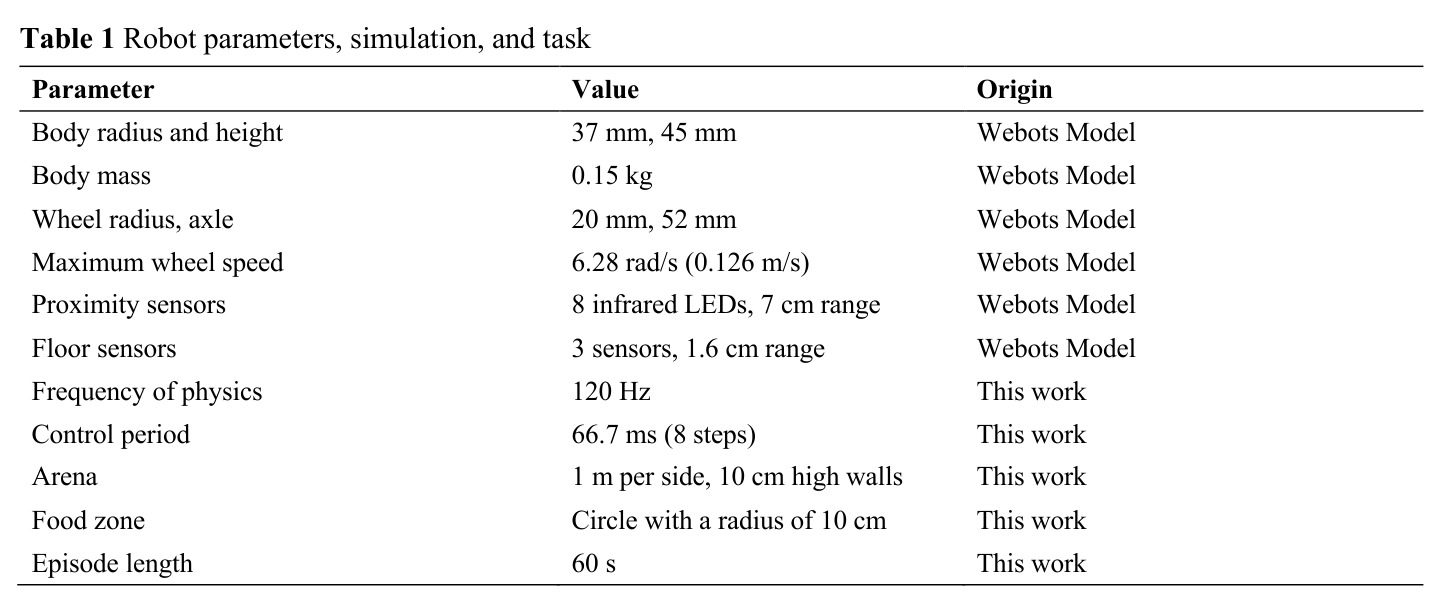
直觉上,要让通信'公平地'涌现,必须让信号成为获取信息的唯一途径,且奖励只看结果。技术路线上,作者从官方Webots模型逐尺寸重建e-puck(圆柱体半径37mm、高45mm、质量0.15kg、轮距52mm、最大轮速6.28 rad/s即0.126 m/s)到PyBullet,物理以120Hz运行,控制器每8步(66.7ms)决策一次;为适配PyBullet把底盘滑块换成前后两颗低摩擦小球,并把车轮碰撞半径缩至19mm以抵消碰撞引擎约1mm的圆柱边距导致5%超速。验证后直行速度实测0.1255 m/s对标称0.1256 m/s,原地转速率4.62 rad/s对标称4.83 rad/s(差异归因于轮子打滑),静止倾斜不超过1.1度。每台机器人由带残差通路的16单元GRU网络控制(17输入、4输出、1768参数),该网络既可单独工作,也可作为EASA基底神经节架构中的一个习得通道。进化采用种群48、150代的遗传算法,适应度为6个回合中两台机器人停留在食物上的时间比例均值(0到1)。全部实验在同一台Mac mini(M1)上用6进程并行完成,单次运行约6小时。
核心思想有两条主线。其一是把'信号的信息价值'作为可操纵变量:指南针条件下网络额外获得食物方向与接近度两个输入,其余条件完全相同,结果是信号在测试中彻底归零(种群发射率第65代起低于1.5%、第90代降为0,三种信号版本得分完全相同的0.928)——这是'通信随信息价值涌现'最直接的证据;而竞技场扩大并不提高通信出现频率(大竞技场三次运行仍是两通一不通),却改变了策略排序:指称信号0.551显著优于不通信的0.387,信标0.229反而比不通信更差。其二是检验先天脚手架假说:EASA用基底神经节的去抑制机制在探索、避障和习得网络三个通道间选择,若先天反射对孤立智能体有利,它应当加速社交任务的进化;实验却显示三种EASA变体(0.257至0.369)全部劣于纯GRU(0.587),且当17个选择参数允许进化时,三个独立运行一致地削弱避障反射(避障←障碍检测权重从0.9降到0.53-0.79)、减轻网络受障碍抑制(从-0.3升到-0.20至0.09)、降低饥饿驱动的探索(从0.6降到-0.19至0.48),进化主动把控制权交还给学习部分。
方法步骤详情
第一步,模型重建与验证:复制Webots模型全部参数,把底盘滑块换成两颗低摩擦小球、车轮碰撞半径缩至19mm以抵消碰撞引擎约1mm边距导致的5%超速,用仓库的test_step1_kinematics.py核对直行0.1255 m/s(标称0.1256)、原地转4.62 rad/s(标称4.83)。第二步,信号建模:每步由网络第三输出是否为正决定发射一比特信号,接收方感知4个输入——接收指示、方位角正弦/余弦与按 $1/r^2$ 衰减的强度,包下一帧到达、距离无限。第三步,控制器:8路红外取对数缩放到0-1,3路底面传感器缩放为0(地面约856)到1(食物约171,均值低于500即在食物上),加4路信号感知与2路动机(恐惧每步衰减0.1%,饥饿每步升0.5%、在食物上时降0.5%),GRU更新为 $h(t)=(1-z)\,h(t-1)+z\,\tilde{h}(t)$,输出双轮速度、发射位与EASA竞标。第四步,进化:48个体×150代,精英10个直通,从前25随机均匀交叉,后代每基因以0.2概率加标准差0.12高斯噪声,每代共用相同6个随机回合评估。第五步,评估:用12个验证回合从最后10代最优中选冠军,100回合测正常/关闭/随机方向三版本信号(Wilcoxon检验),30回合统计信号特异性与通道占用,50回合做未见条件鲁棒性测试。
技术新颖性
技术新颖性体现在四个层面。第一,开放的、量化验证的3D双e-puck平台:与常见'直接进仿真器'的做法不同,每项运动学指标都与Webots对标(直行误差在0.0001 m/s量级),并明确记录两处必要修改(滑块换低摩擦球、车轮碰撞半径19mm),使其他课题组可复现可扩展——这本身就是作者列出的第一项贡献。第二,一比特信道的设计哲学:信号本身不携带任何食物位置信息,语义完全留给进化,配合隐式适应度排除了'设计者把答案塞进奖励函数'的经典陷阱,使涌现与否的判断干净。第三,基底神经节架构的新用法:以往EASA类工作的被选通道都是手工行为,本文首次让被选择通道之一是进化习得的GRU网络且处于社交任务中,得出'先天脚手架在社交任务中反而碍事'的反直觉结论;让12个显著度权重、3个持续性权重和D1/D2多巴胺水平共17个选择参数与网络共同进化也是新的。第四,评估方法严谨:关闭信号与随机方向两种消融交叉印证,并明确提醒近常发射个体关闭信号时可能因输入突变而非信息缺失掉分,避免了过度解读。
实验结果
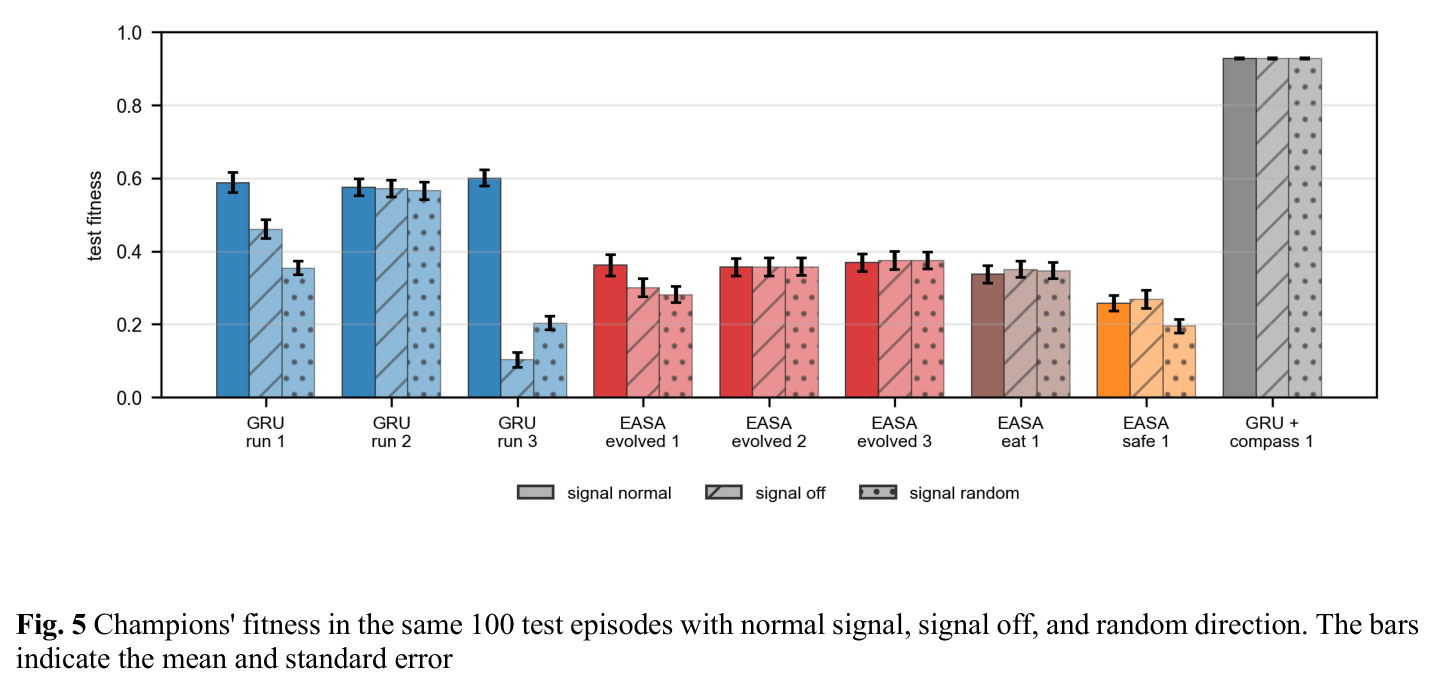
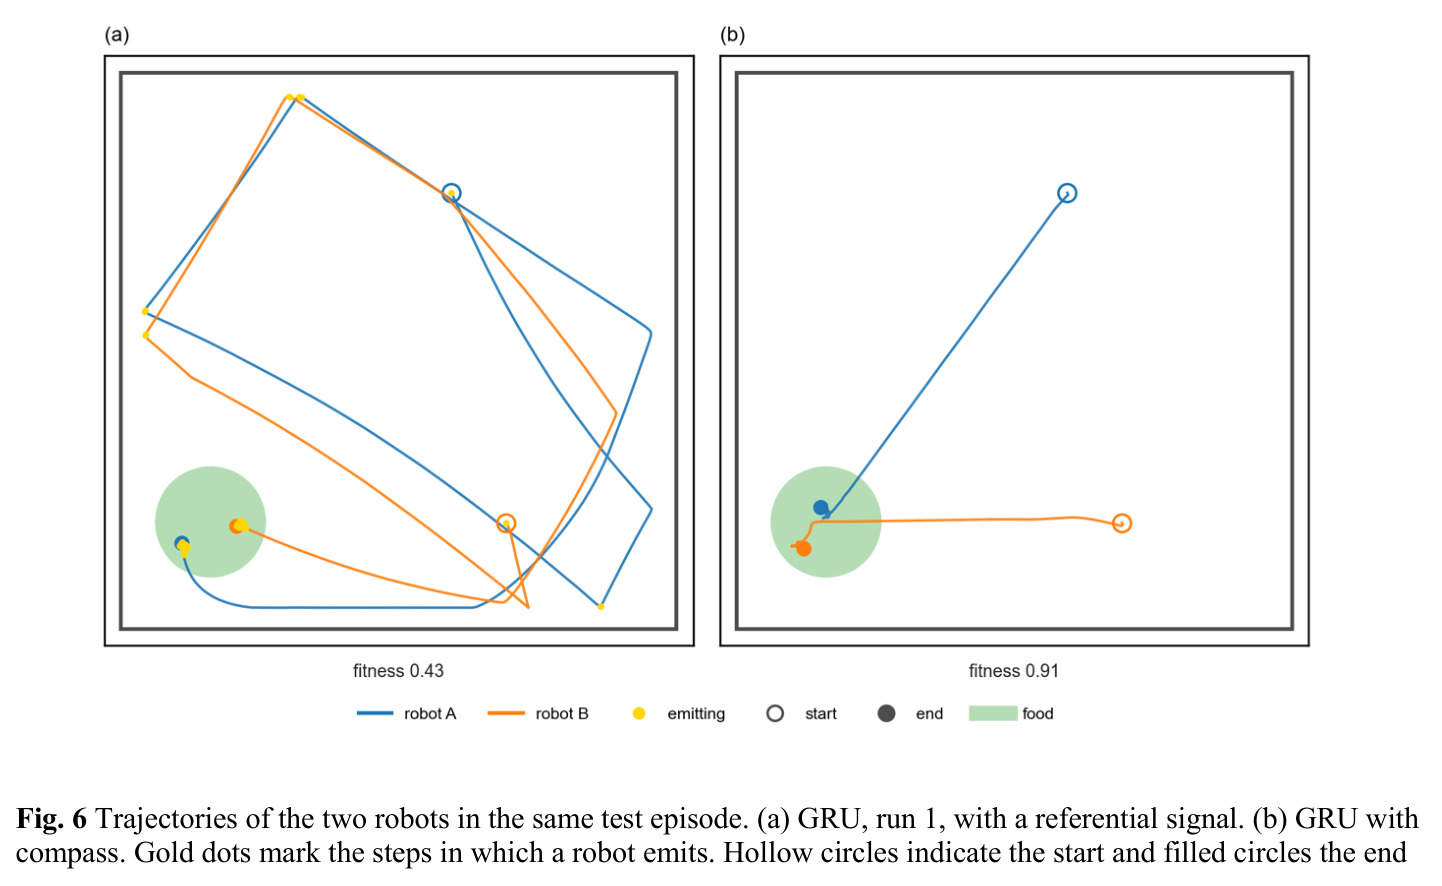
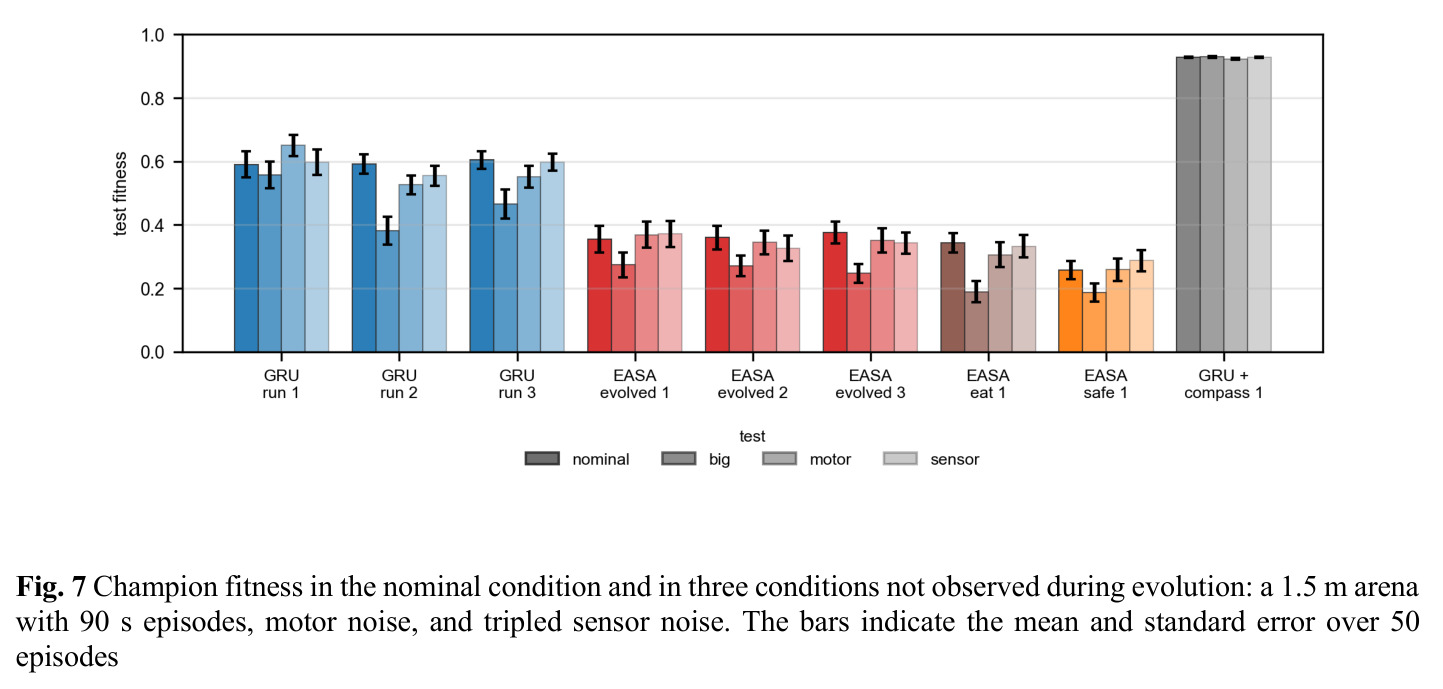
五组核心结果。其一,指南针效应:给网络食物方向与距离后,100测试回合适应度达0.928,双机100%回合同时到达、停留93%时间,种群发射率第90代归零,三种信号版本得分完全相同——信息有替代渠道时信号彻底消失。其二,小竞技场策略分化:GRU三次运行0.588/0.574/0.600(均值0.587±0.013,两两p>0.38),分别演化出指称信号(在食物上96.3%步数发射、离食物仅1.3%)、无信号独搜、信标(离食物发射99.8%)。消融显示关闭信号使运行1从0.588降至0.460(约7.7秒,p=1×10⁻⁷,双机同在比例86%→53%),随机方向进一步跌至0.353;运行3关闭信号暴跌至0.103,随机版0.203确认接收方依赖方位。其三,架构代价:EASA evolved三次0.362/0.356/0.369,GRU配对胜出0.225(约13.5秒,Wilcoxon p=5×10⁻¹¹,Welch p=0.0001),EASA safe 0.257最低。其四,先天反射碍事:EASA safe双机同在食物仅4.9%时间、每回合离开1.53次,避障在伙伴15cm内时于食物上12%步数被触发——把同伴当障碍;进化后离开降至0.20-0.93次/回合,三次运行一致把避障←障碍权重从0.9削到0.53-0.79。其五,大竞技场分离策略:直接演化仍两通一不通,但指称信号0.551比无信号0.387高0.165(p=0.0003),信标0.229更差(p=0.0004);小场冠军迁入大场,指称信号仅损5%,信标损23%,不通信损36%,噪声影响均<15%。
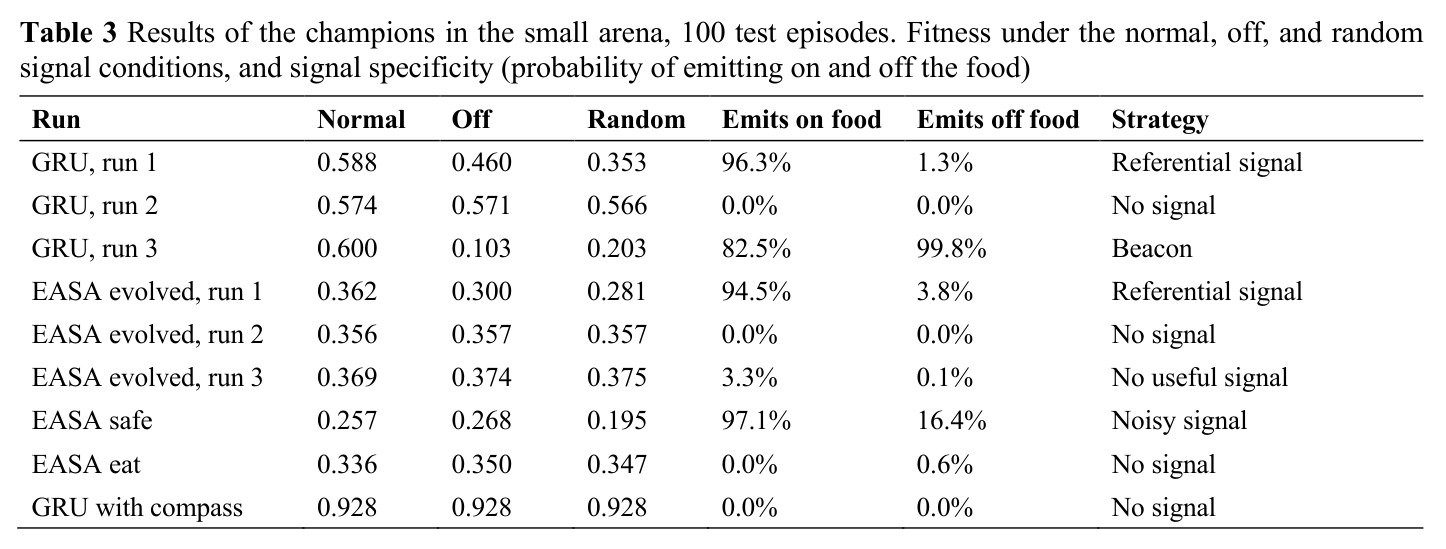
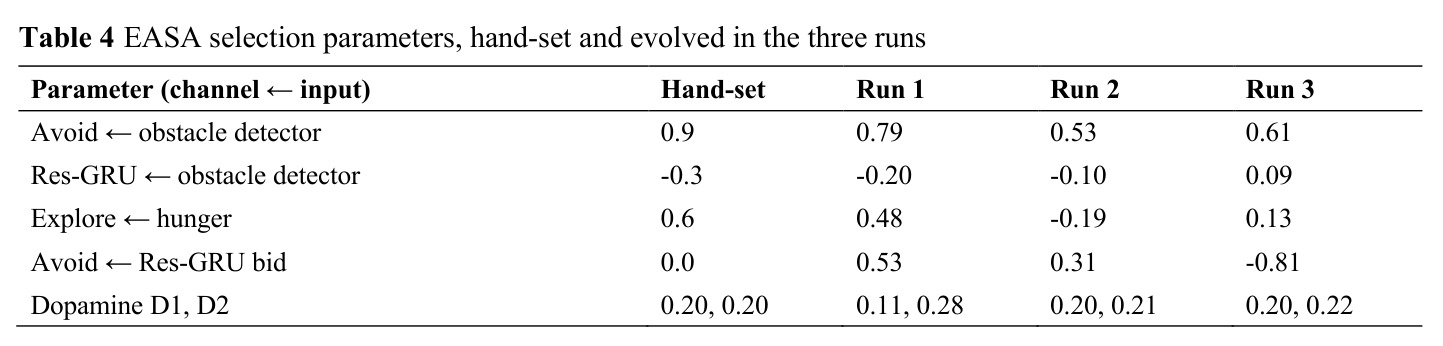
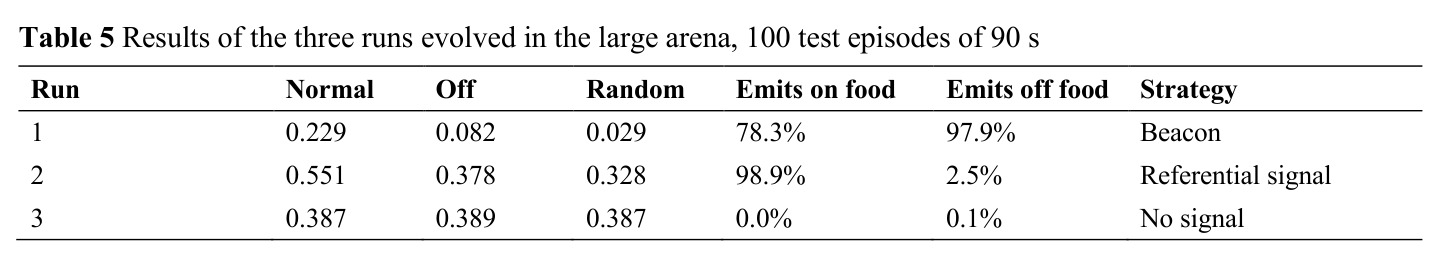
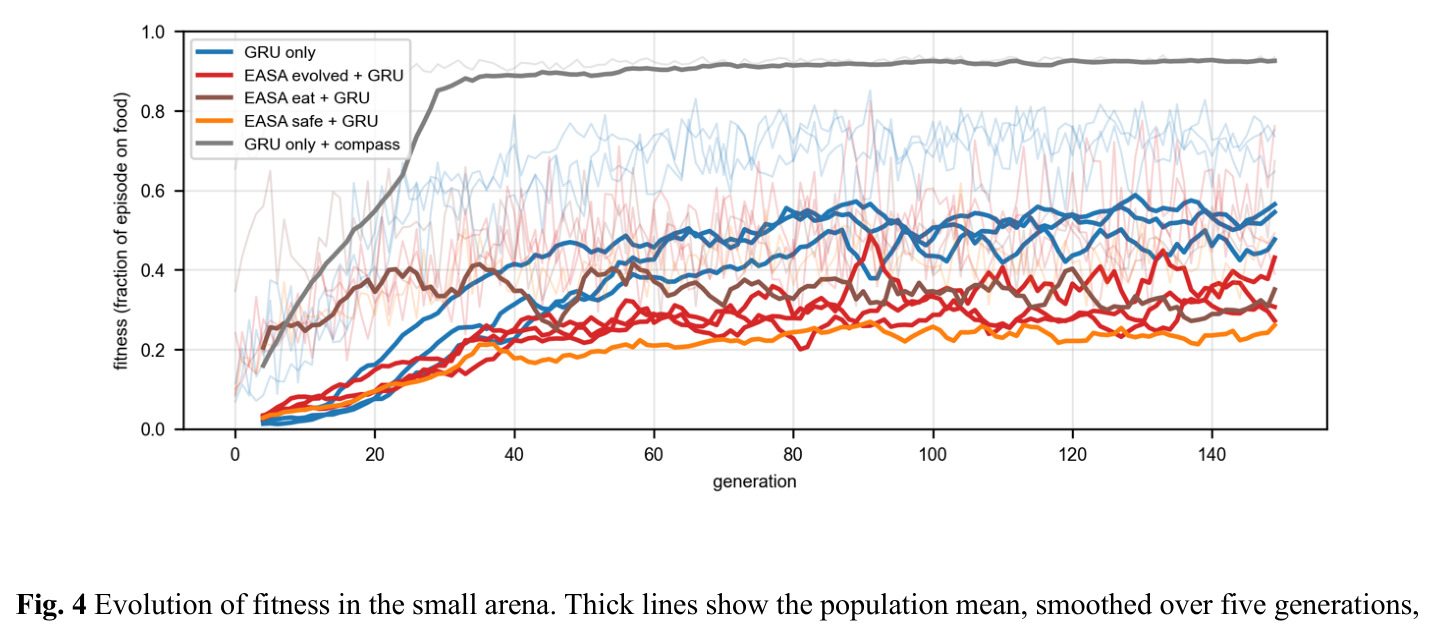
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 小竞技场觅食(无指南针,1米场60秒回合) | 100个测试回合平均适应度(停留在食物上的时间比例) | Res-GRU三次独立运行 0.588 / 0.574 / 0.600(均值 0.587±0.013) | EASA evolved(进化优先级)三次运行均值 0.362;EASA safe 0.257;EASA eat 0.336 | 比最强EASA变体高 0.225,约合每机器人多 13.5 秒在食物上(Wilcoxon p=5×10⁻¹¹,运行间 Welch p=0.0001) |
| 指南针觅食(额外获得食物方向与接近度输入) | 100个测试回合平均适应度 | 0.928,两台机器人100%回合同时到达食物、停留93%时间 | 无指南针 GRU 均值 0.587 | +0.341,且种群信号发射率第90代降为0,三种信号版本得分完全相同(信息替代效应) |
| 大竞技场直接演化(1.5米场、90秒回合) | 100个测试回合平均适应度 | 指称信号运行 0.551 | 无信号运行 0.387;信标运行 0.229 | 比无信号高 0.165(约15秒,p=0.0003);信标反而显著劣于不通信(p=0.0004) |
| 信号消融(GRU运行1,指称信号策略) | 同一批100回合上三种信号版本的适应度 | 正常 0.588 / 关闭 0.460 / 随机方向 0.353;双机同在食物 86%→53% | 随机方向保留发包但破坏方位信息 | 关闭信号损失 0.128(约7.7秒,p=1×10⁻⁷),随机方向损失更大,证明接收方依赖信号方位 |
| 鲁棒性迁移(小场演化冠军→1.5米大竞技场,50回合) | 相对名义条件的适应度损失 | 指称信号冠军仅 −5% | 无信号冠军 −36%;信标 −23%;EASA 各变体 −23%〜−45% | 指称信号在困难条件下保持价值,策略排序与直接在大场演化的结果一致;电机/传感器噪声影响均 <15% |
局限与改进
作者承认的限制:每个主条件只有三次独立运行,足以显示大而一致的差异,但无法精确估计每种通信策略出现的频率;行为结论只基于各运行的冠军个体而非整个种群;所有结果来自仿真(虽然经过Webots验证,且物理仿真跨机器不一致、全部运行固定在同一台Mac mini上完成);只用了单一任务、单一网络形态和单一进化算法,EASA也只探索了先天反射加习得网络这一种组合方式。我自己的观察:其一,信标策略的关闭信号消融(0.600→0.103)存在作者自己指出的混淆——近常发射使关闭信号等价于输入突变,随机版0.203虽部分澄清,但仍无法完全量化接收方对方位的依赖程度;其二,指南针条件只跑了1次,'信号完全消失'这一关键结论缺乏多次运行的统计支撑;其三,一比特信道过于简单,结论对多比特或连续信道是否成立未知;其四,'信息价值'只是被二值操纵(有/无指南针),没有构造连续的信息价值梯度来定量验证'通信强度正比于信息价值'这一标题级论断,两场对比也只覆盖了两个尺度。
独立分析的弱点
第一,样本量问题:通信出现频率是本文核心命题之一,但每条件3次运行无法给出频率的置信区间,'两通一不通'与真实频率0.2或0.8在统计上无法区分;改进方向是每条件扩展到10次以上运行,或用种群级指标(各代平均信号特异性)代替冠军级结论。第二,EASA整合方式过于受限:先天通道以显著度权重压制网络,网络只能以单一竞标争取控制权,结构上不利于需要持续接近同伴的社交行为;改进方向是作者自己提出的'皮层提案-基底神经节选择'模式,让多个习得网络作为竞争提案。第三,冠军选择偏差:每代最优仅由6回合选出(估计向上偏),行为诊断也只看冠军;改进方向是对top-k个体做行为聚类,报告策略在种群中的分布。第四,指南针条件单次运行:0.928高分和信号归零很有说服力,但单次运行无法排除该次进化恰好早熟的偶然性,至少应3次重复并报告方差。第五,仿真到实物缺口仍未闭合:模型虽经验证,纸张摩擦、真实电机差异等在PyBullet中仍被理想化;改进方向是按作者前作的迁移协议在真实e-puck上测试最鲁棒的指称信号策略。
未来方向
作者明确提出两个方向:一是测试'基底神经节在多个习得提案间选择'的架构,更接近脊椎动物'皮层提议、纹状体选择'的组织方式;二是用物理机器人验证仿真结论。在此基础上可延伸:第一,把信息价值从二值(有/无指南针)变成连续梯度,例如逐步衰减指南针输入的精度或加大其噪声,定量检验'通信涌现程度随信息价值增长'的函数关系,甚至用信号与食物位置的互信息来度量信息价值;第二,操纵遗传相关性(同质团队→异质团队→亲属选择),检验信息价值与选择层次的交互作用——本文刻意固定了团队级选择,两个因子的组合效应未知;第三,把一比特信道扩展为内容量可进化的信道,观察语义复杂度如何随任务需求增长;第四,用课程学习逐步扩大竞技场,研究指称信号策略能否被稳定引导而非依赖运气(本文显示直接在大场演化也不提高通信频率);第五,加入捕食者或信号成本做行为生态学对照,检验信息价值框架下信号在利益冲突时是否退化为信息隐藏,呼应Floreano的毒药-食物范式。
复现评估
复现条件相当友好。作者声明模型开源并附运动学验证脚本test_step1_kinematics.py,全部实验在同一台Mac mini(M1)上用6个并行进程完成,单次150代运行在小竞技场约6小时——整篇论文共12次进化运行(GRU×3、指南针×1、EASA safe×1、EASA eat×1、EASA evolved×3、大竞技场×3)在一台无GPU的桌面机器上数天内即可完成。Webots官方e-puck模型文件公开,PyBullet本身开源,遗传算法是教科书式的标准配置。复现者需注意的坑:两处PyBullet适配修改(滑块换两颗低摩擦小球、车轮碰撞半径19mm以抵消约1mm碰撞边距)必须照做,否则速度会偏差5%;物理仿真跨机器不完全一致,所有对比必须在同一机器上完成;随机种子与回合生成细节论文未完全说明,需阅读代码。总体难度中等偏低:难点不在算力而在仿真细节的忠实重建、行为诊断(信号特异性、通道占用统计)代码的复刻,以及对EASA常数与连接的精确对齐(作者报告其实现与原版最大差异5×10⁻¹⁵)。
论文图表
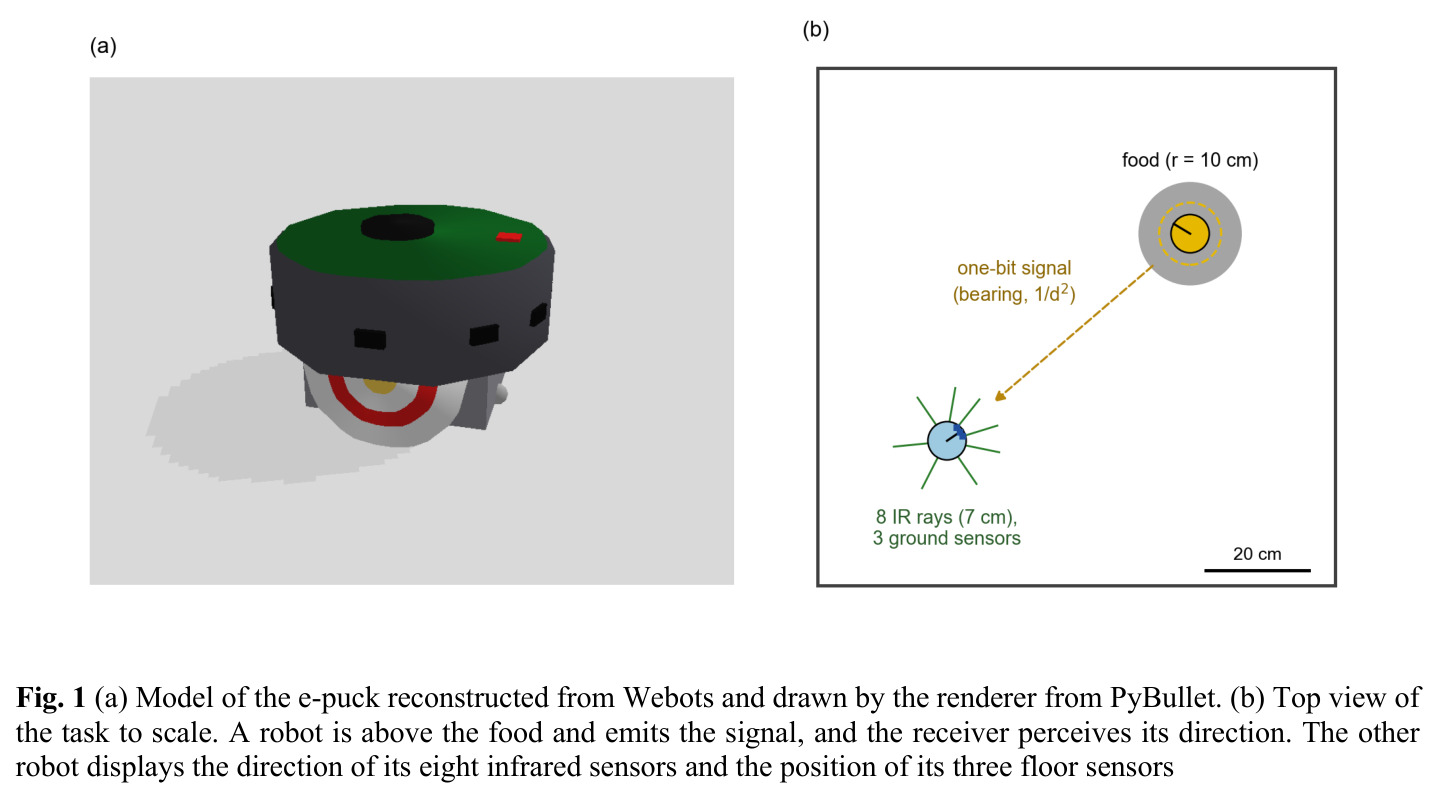
左半展示重建后的机器人三维外观(圆柱体加双轮),右半是任务俯视示意:金色圆盘为半径10cm的食物区,两台机器人随机初始摆放,位于食物上的那台发射信号,接收方按信号到达的方向感知发射者方位,同时可见自身红外与底面传感器的几何布局。
一图看懂整个实验的物理设定:食物只能靠底面传感器压过才发现、信号本身不含食物位置只含发射者方位、机器人传感器如何配置,这是理解后续所有实验与'信息价值'论证的物理基础。