RoboValue:面向机器人价值模型统一评测的仿真-现实细粒度基准 RoboValue: A Fine-Grained Sim-and-Real Benchmark for Unified Evaluation of Robotic Value Models
首个覆盖四维能力的仿真-现实细粒度基准,系统诊断机器人价值模型的反馈可靠性
前置知识
机器人价值模型(Value/Reward Model)
一类从视觉观测与任务指令出发、输出标量分数来评估机器人执行好坏的学习型评判器,记作 $v(A; l) = f_\theta(A, l) \in \mathbb{R}$。不同模型的输出语义各异:有的输出任务完成度评分,有的估计绝对进度或到完成的时间距离,有的只输出两段轨迹的相对优劣 $c(A_1, A_2; l)$。它们被广泛用于策略训练的数据筛选与重加权、强化学习的奖励信号、推理时的动作排序,以及执行监控与失败检测。
本文评测对象就是这类模型。理解其接口(标量分数、成对比较、文本子任务描述)与语义差异,是读懂为什么需要适配器、共享指标和四维能力框架的前提。
Spearman 秩相关与进展相关性(VOC)
Spearman 秩相关系数 $\rho_S$ 衡量两组数值排序的一致性,对单调变换不敏感。GVL 等工作用它检验价值模型预测值 $v_i$ 是否与归一化时间戳 $t_i/T$ 的顺序一致,即模型是否认为轨迹越往后任务进展越大。它不要求价值数值标定或与时间呈线性关系,是衡量密集进展信号的常用指标。
本文的 VOC、Cycle-VOC、Memory-VOC 三个指标都建立在秩相关之上,理解它才能看懂论文如何设计前向-回放序列来暴露时间戳捷径。
视觉-语言模型骨干(VLM Backbone)
Qwen3-VL 等大型视觉-语言模型是当前机器人价值模型的主流骨干,将多帧图像与文本指令编码后输出评分或比较结果。部分骨干(如 Qwen3-VL)在视频对齐时显式使用文本时间戳,模型可能据此走捷径——按视频推进时间单调抬升预测值,而非真正读取画面中的任务状态。
论文把 TOPReward 的高 VOC、低 Cycle-VOC 现象归因于时间戳依赖,并分析了骨干选择与模型规模对各能力的影响,这些分析都以 VLM 骨干的工作方式为背景。
Zero-Shot / One-Shot / Full-Shot 评测轨道
Zero-Shot 指直接用已发布权重评测,不做任何任务特定适配、也不提供参考演示;One-Shot 为每个任务提供一条专家演示,按模型机制用作推理时条件或参数微调;Full-Shot 允许在完整训练集(3,500 条演示)上训练或微调。三条轨道共享同一测试集与指标,分开排名。
这是论文实验设计的骨架。各模型在哪个轨道、用什么适配方式(如 ProcVLM 的任务微调、VLAC 的演示条件化)直接决定其得分与对比结论。
诊断式轨迹(Diagnostic Trajectories)
不是普通的成功/失败演示,而是经过专门设计、用来隔离某个特定歧义的对照轨迹:如同一画面配不同指令的反事实变体、视觉状态重复出现但历史不同的长时程轨迹、共享同一初始失败但走向不同结局的三分支恢复轨迹,以及子任务顺序可互换的多解轨迹。
诊断式轨迹是本文方法的核心创新载体。四个能力维度下的 10 个指标,全部依赖这些对照结构才能把总分背后的细粒度缺陷拆解出来。
Sim-and-Real 与 OOD 泛化设定
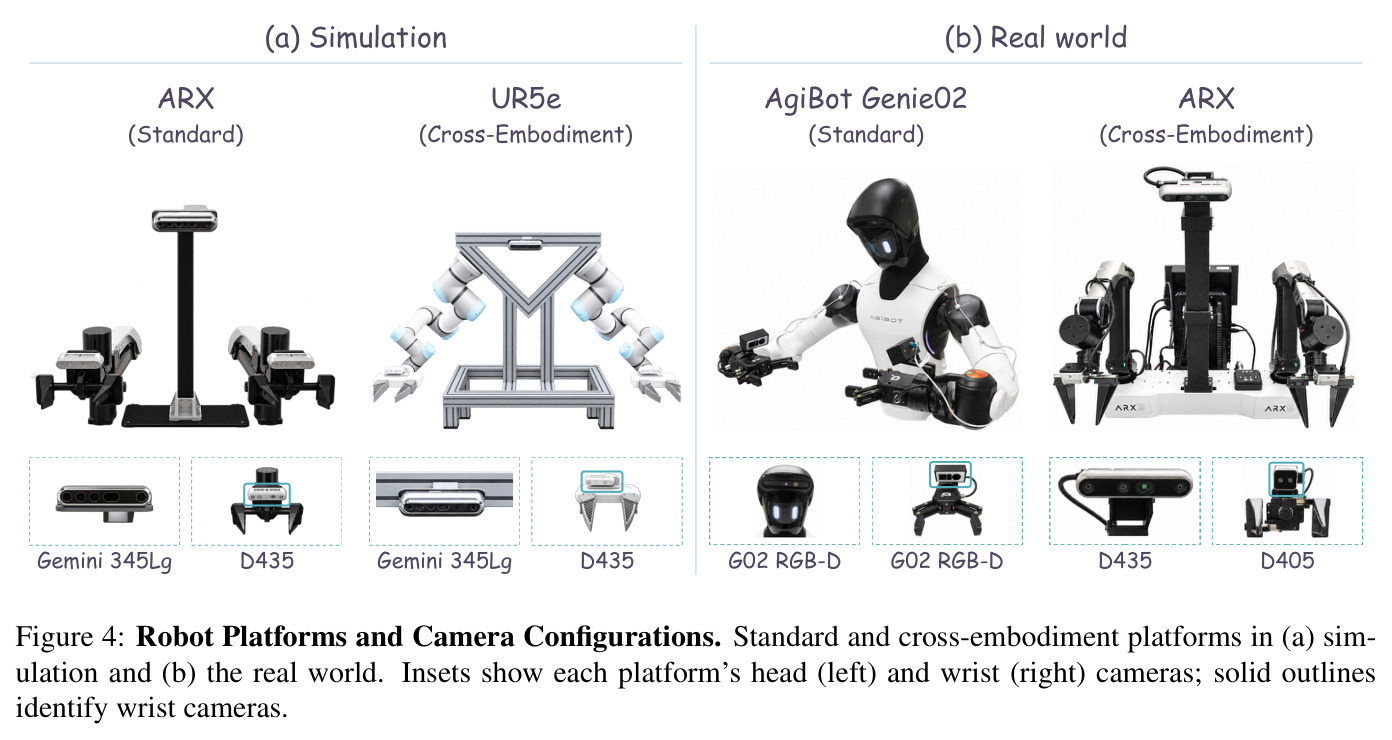
基准同时覆盖仿真(RoboDojo,基于 NVIDIA Isaac Sim)与真实环境,各设一个标准域内(ID)设定和两个域外(OOD)设定:跨本体(更换机器人平台,如 ARX 换 UR5e 或 AgiBot Genie02 换双臂 ARX)与跨环境(改变场景外观、光照与杂乱度)。两者分开报告,互不混淆。
论文关于泛化的关键结论——环境迁移的退化远大于本体迁移——正来自这套分离式的 OOD 设计,理解设定划分才能正确解读 Table 4。
研究动机
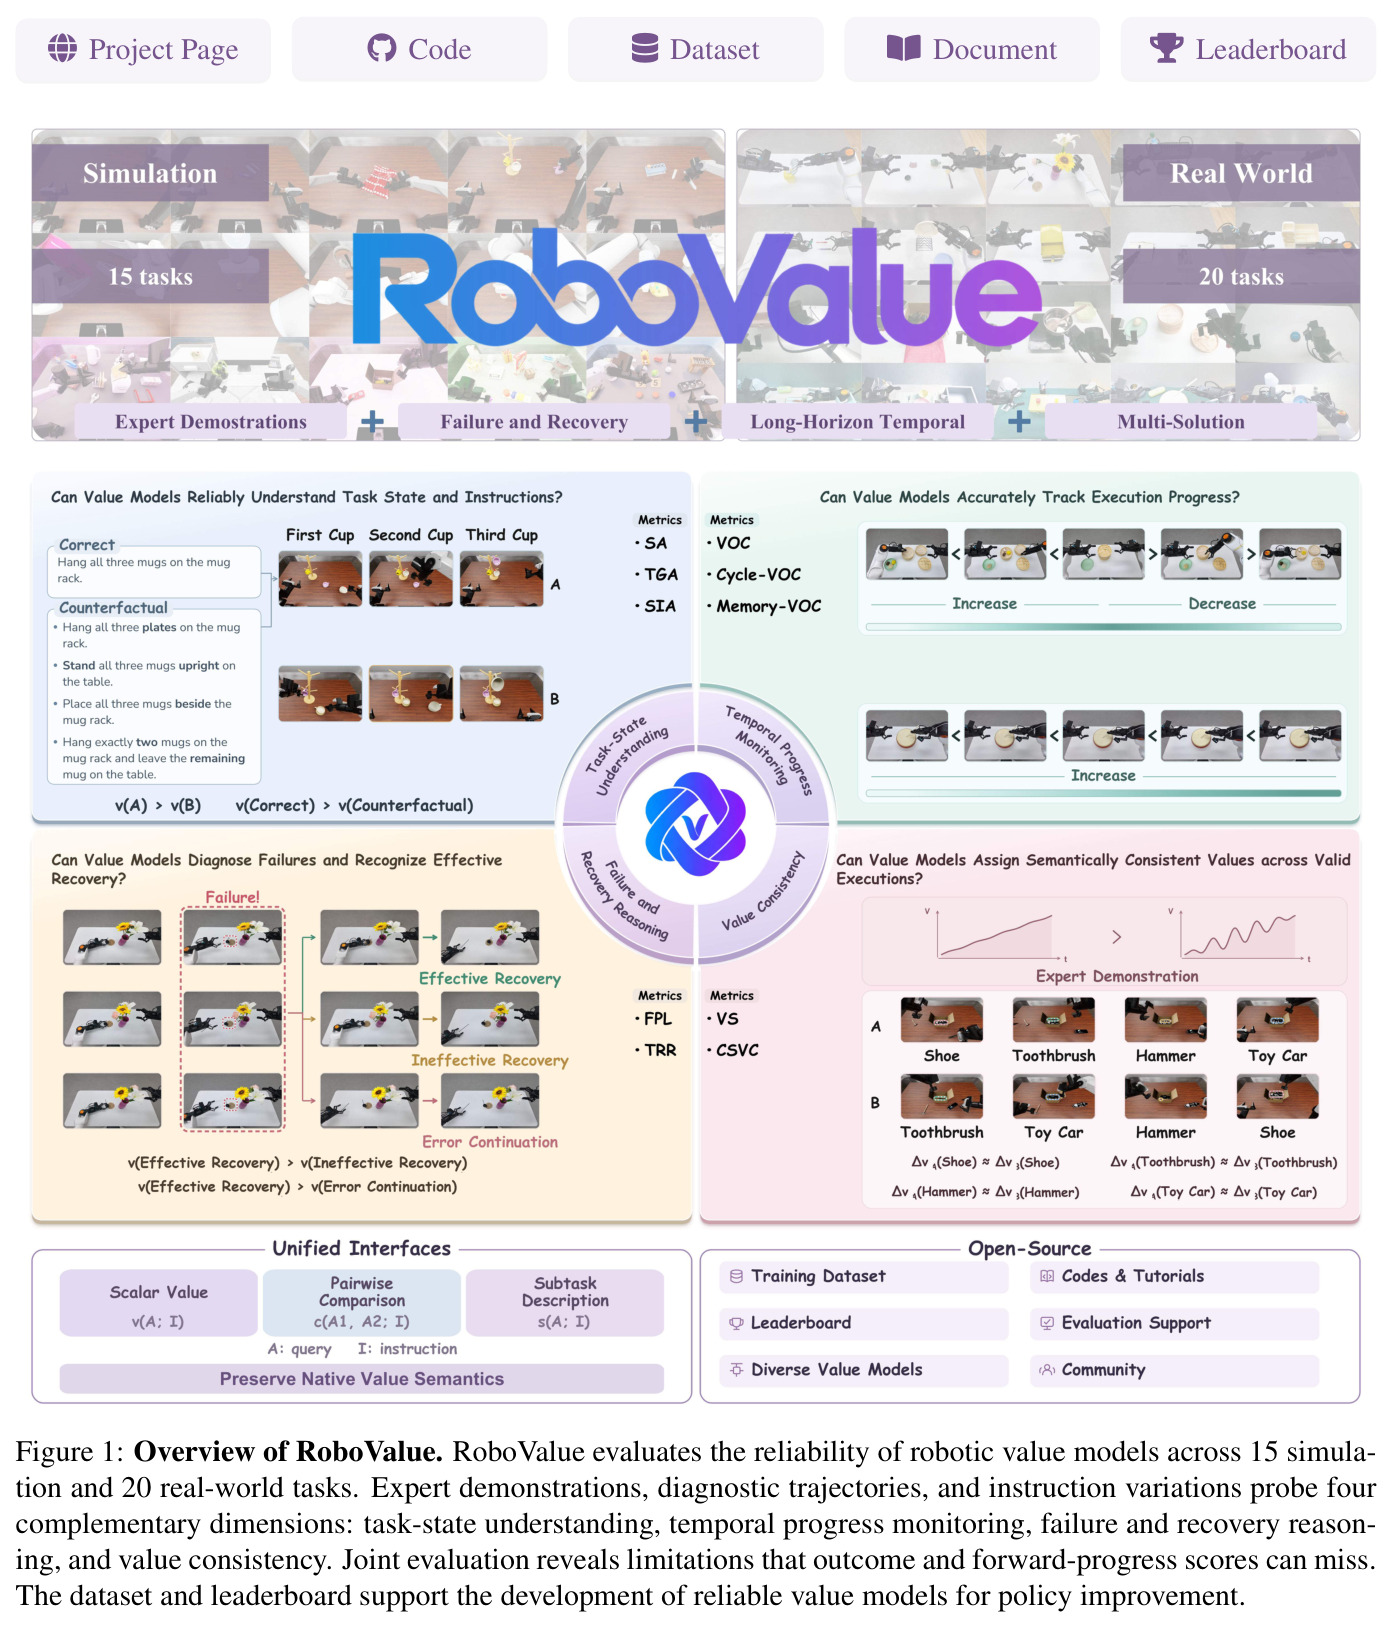
通用机器人价值模型正在成为策略学习的核心部件:它们为模仿学习筛选数据、为强化学习提供奖励与优势信号、在推理时引导规划并监控执行,其预测错误会直接传播到下游策略。但现有评测只覆盖执行的少数侧面——RoboRewardBench 测完成度评分、GVL/OpenGVL 测时间顺序相关性、Progress-Bench 测演示条件下的进度估计、AHA/REFLECT/FailSafe 关注失败解释——没有任何一个框架把「结果判别、进展追踪、失败与恢复、反馈一致性」放在同一协议下联合检验。更关键的是,强结果准确率或强前向进展相关性可能掩盖中间价值判断的错误:论文Figure 2展示了价值在倒放时上升、无效恢复后反弹、相似状态重复时无法反映累积进度等真实失败案例。若把这类有缺陷的反馈用作学习信号,会强化无效的继续执行、无效的纠正或遗漏必需子任务;近期研究也证实具身奖励模型会给糟糕执行虚增奖励、学会捷径行为。
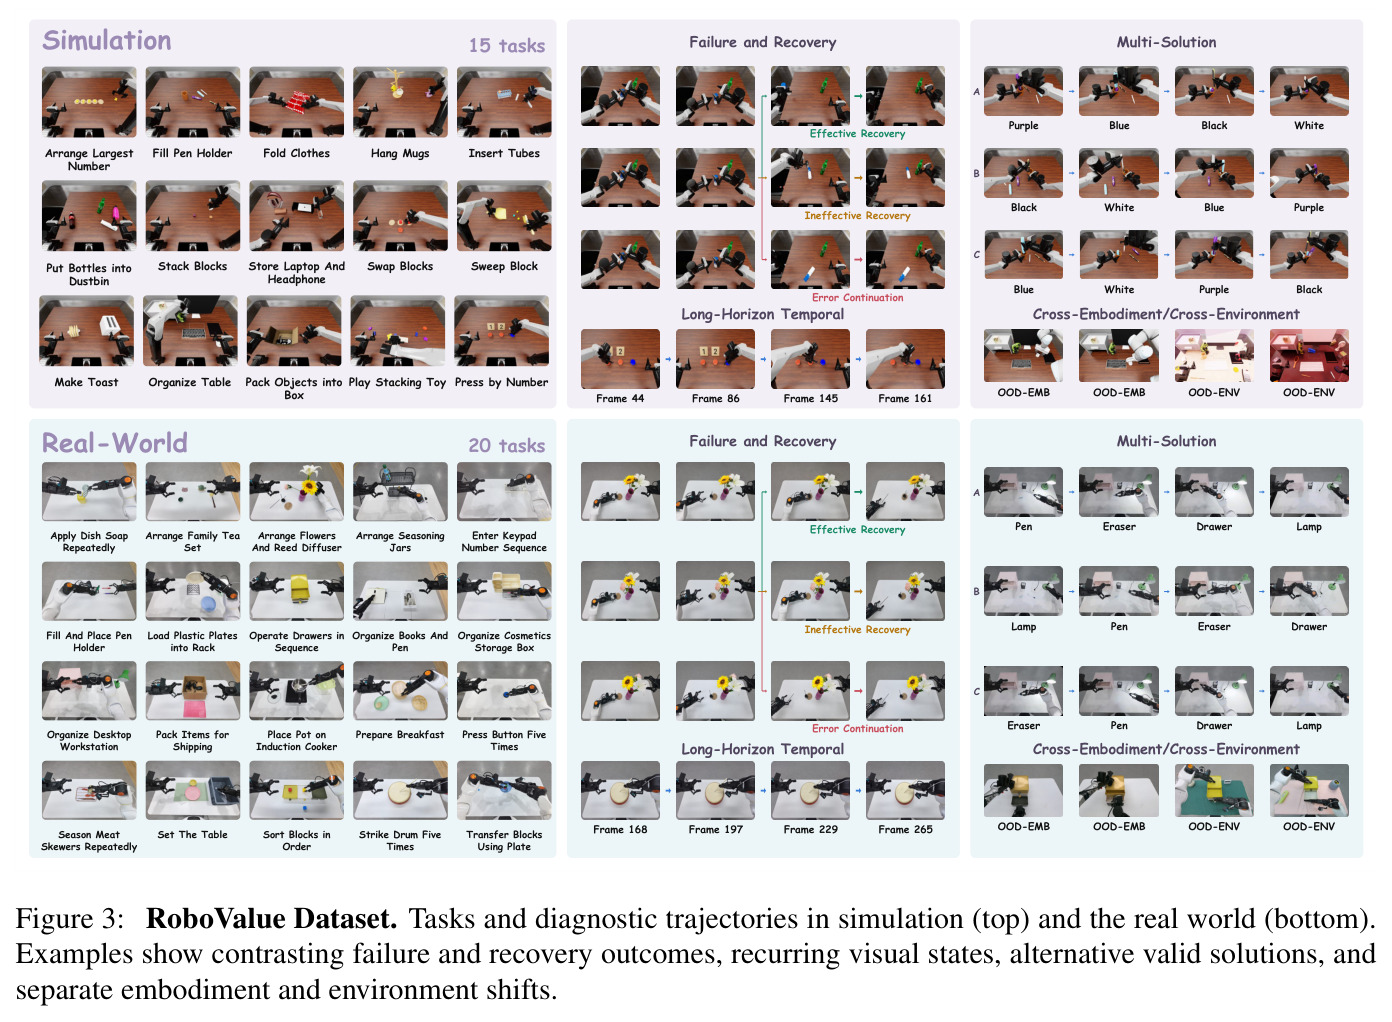
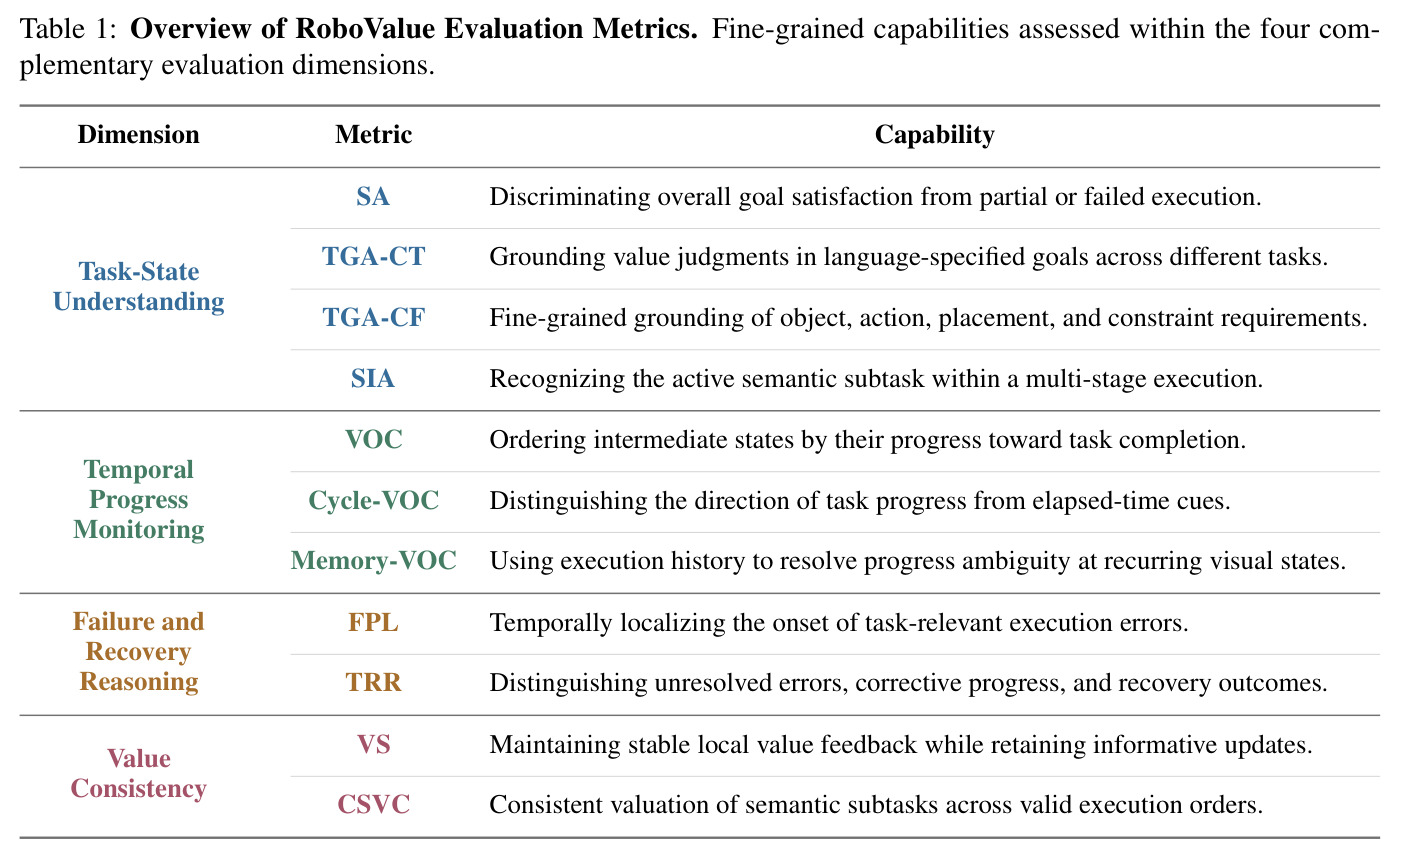
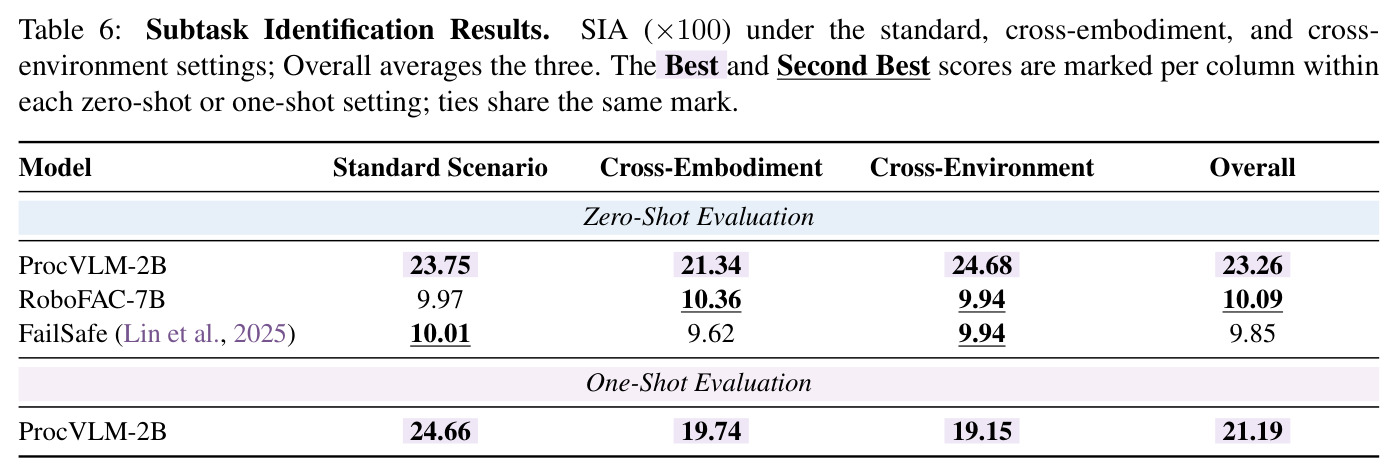
本文的目标是本文要构建一个细粒度、仿真与现实统一的机器人价值模型评测体系,回答「价值反馈是否在执行的全程忠实反映任务需求的满足程度」这一中心问题。具体包括:其一,提出四个互补的能力维度——任务状态理解、时序进展监控、失败与恢复推理、价值一致性——并为其设计 10 个可量化指标(SA、TGA-CT、TGA-CF、SIA、VOC、Cycle-VOC、Memory-VOC、FPL、TRR、VS、CSVC);其二,构建 RoboValue-Dataset,覆盖 15 个仿真任务与 20 个真实双臂操作任务,含 3,500 条专家演示(每任务 100 条)用于训练、2,792 条带精细标注的测试轨迹用于评测;其三,通过共享接口与模型专属适配器统一比较异构模型,建立公开排行榜,为价值监督的改进给出具体靶点。
与已有工作不同的是,与既有评测各自测量单一侧面不同,本文的独特切入是以「诊断」而非「排名」为第一目标:通过专门构造的诊断轨迹与指令变体,把价值判断中的特定歧义逐个隔离出来测试。反事实指令保持画面执行完全不变、只改变目标要求,检验语言接地;重复出现的视觉状态强制模型依赖执行历史消歧;同一初始失败下的三条分支(错误延续、有效恢复、无效恢复)把「纠正动作本身」与「恢复是否成功」解耦;语义子任务相同但顺序不同的多解轨迹检验价值增益的跨解一致性。此外,它用共享接口加模型专属适配器的方式在保留各模型原生价值语义的前提下实现跨模型比较,并把本体迁移与环境迁移拆成两个独立 OOD 设定分别评测——这些都是现有基准(如只测偏好或只测进展相关的工作)没有同时做到的。
核心方法
直觉上,可靠的价值反馈必须满足四件事:判断锚定在指令目标上、利用历史正确追踪进展与回退、把未解决的错误与成功恢复区分开、在同类子任务上给出一致信号。RoboValue 将其转化为四个能力维度与 10 个指标,用统一的仿真-现实协议检验。数据层构建 RoboValue-Dataset:35 个双臂操作任务(15 个改编自 RoboDojo 的仿真任务、20 个真实任务),训练集 3,500 条专家演示(每任务 100 条),测试集 2,792 条带标注轨迹,覆盖标准、跨本体、跨环境三种设定;轨迹经 VR 遥操作采集,含头部与双腕共三个 RGB-D 相机。评测层定义 Zero-Shot / One-Shot / Full-Shot 三条轨道,用共享接口(标量 $v(A;l)$、成对 $c(A_1,A_2;l)$、子任务描述 $s(A;l)$)配合模型专属适配器统一比较。指标层用成功对判别(SA)、指令增益对比(TGA)、LLM 判官评分(SIA)、秩相关(VOC 系)、ZigZag 定位(FPL)、阶段趋势判定(TRR)、效率比(VS)与跨解增益偏差比(CSVC)量化各能力。
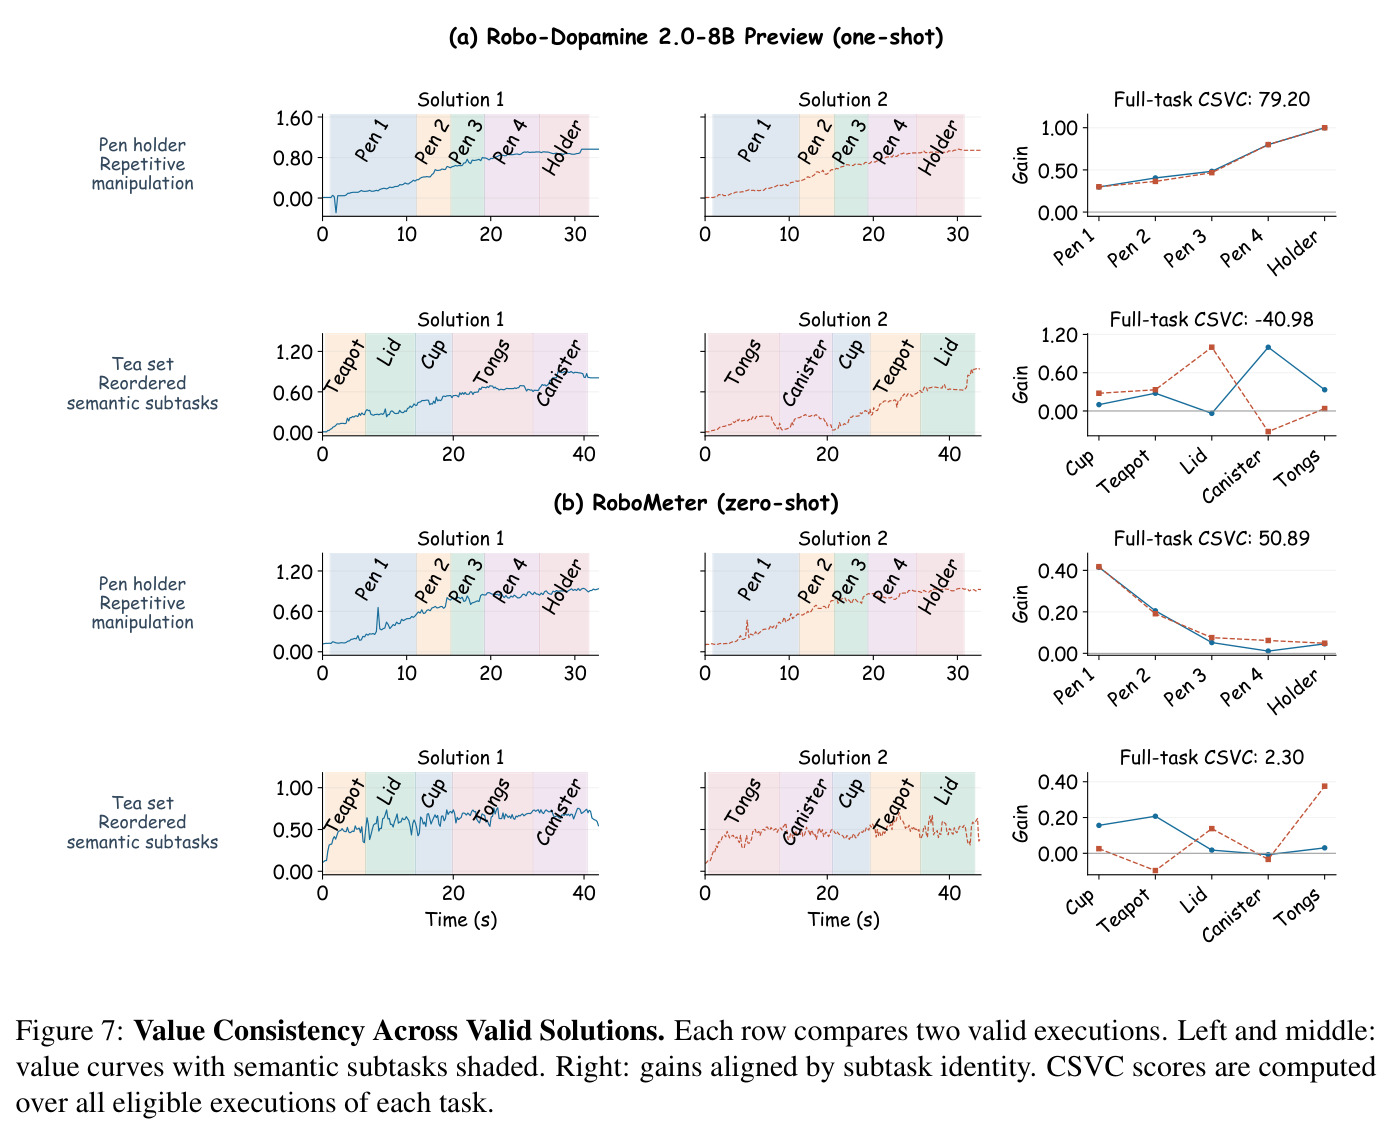
核心创新是用受控对照结构把价值判断的每种典型失败模式变成可测量的实验。区别于既有方法的四个新诊断:其一,Cycle-VOC 把成功轨迹先正放再倒放拼成共享转折点的序列,分别与正放递增、倒放递减的进展顺序做 Spearman 相关——只会随播放时间抬升数值的时间戳捷径模型会在倒放半段失分(TOPReward 即 VOC 94.29 而 Cycle-VOC 仅 13.50)。其二,Memory-VOC 用含重复视觉状态的长时程轨迹检验历史利用:当前画面相同但已完成子任务不同,单帧无法判断累积进度。其三,TRR 用共享同一初始失败的匹配三分支(错误延续 CE、成功恢复 SR、失败恢复 FR),把轨迹切成失败、延续、尝试、结果四个阶段并要求趋势方向全部正确,从而把「纠正活动」与「恢复结果」解耦。其四,CSVC 按语义身份对齐不同合法解中的同一子任务,用中位增益的幅度 $G$ 与偏差 $D$ 之比 $(G-D)/(G+D)$ 首次量化价值反馈的跨解一致性。
方法步骤详情
第一步,数据构建:在 RoboDojo/Isaac Sim 采集 15 个仿真任务(ARX 标准本体、双臂 UR5e 跨本体),真实世界采集 20 个任务(AgiBot Genie02 标准、双臂 ARX 跨本体);六类轨迹归为四类——专家演示、失败与恢复三分支(错误延续/有效/无效恢复)、长时程时序(重复动作、状态重现)、多解(合法子任务顺序互换)。第二步,标注:成功轨迹记录子任务起止时间戳;恢复轨迹标注失败阶段起止及「恢复结果可观测」时刻,分离尝试与结局。第三步,协议:按模型输入构造查询 $A_t$,输出经适配器映射到共享接口,无原生成对输出时用 $c(A_1,A_2;l)=v(A_2;l)-v(A_1;l)$。第四步,指标:SA 取轨迹末尾 2% 预测均值统计成功配对胜率;TGA 计算指令增益 $\Delta_e(l')$、要求正确指令胜过全部负例(CT/CF 两变体);SIA 由 LLM 判官打分取几何平均;FPL 用阈值 $\alpha=0.2$ 的 ZigZag 滤波取最大下降前峰值对标注起点的归一化误差;TRR 每阶段补足 $K=10$ 样本、按时长加权趋势 $D_s$ 判方向、全对才得分;VS 用效率比乘非平坦覆盖率;CSVC 取子任务中位增益计算 $(G-D)/(G+D)$。第五步,聚合:先按任务在仿真与真实内部平均,再两域等权聚合成能力分。
技术新颖性
新颖性有五点。第一,统一性:现有基准各测一隅(RoboRewardBench 只测完成度判别、GVL 只测时间排序、AHA/REFLECT 只做失败解释),本文首次把结果判别、进展追踪、失败恢复、反馈一致性纳入同一共享协议,能展示总分相近但能力画像迥异的现象。第二,诊断构造的因果性:反事实指令、正放-倒放拼接、重复视觉状态、三分支恢复、多解对齐,每个对照精确隔离一个混淆变量(指令语义、时间捷径、历史依赖、纠正与结果、执行位置),而非笼统相关性统计。第三,指标方法学贡献:Cycle-VOC 的正反拼接、TRR 的时长加权阶段趋势与全分支判定、FPL 的 ZigZag 定位加 32% 随机基线、CSVC 的语义对齐中位增益比,均为本文原创或首次用于价值模型评测。第四,语义保真的跨模型比较:通过适配器而非强制统一输出格式,让 12 个异构模型(2B 到 32B、评分/时距/成对比较各异)保留原生价值语义参与排名。第五,仿真-现实加双重 OOD 的完整性:同一协议下分别迁移本体与环境,首次系统量化出「环境迁移退化更广」的结论。
实验结果
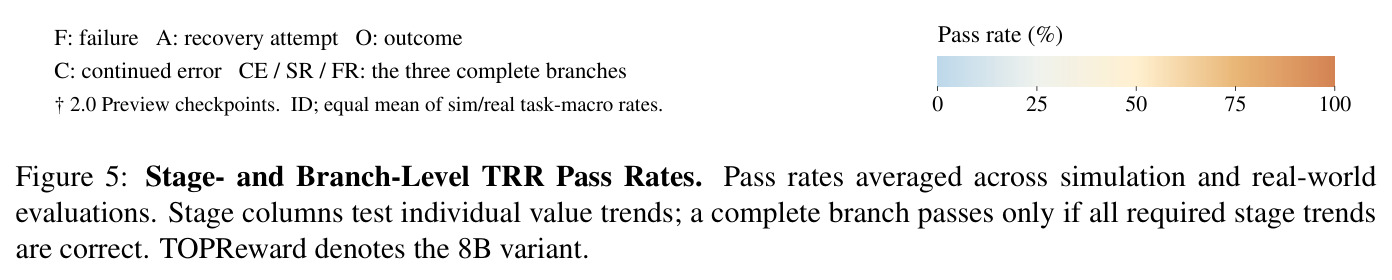
发现一:强结果判别不等于指令接地。RynnValue-4B 的 SA 达 82.12 但 TGA-CF 仅 56.01;Robo-Dopamine 2.0-8B Preview 的 SA 86.36 而 TGA-CF 仅 1.23,价值锚定在演示而非指令。Table 5 进一步区分两类错误:Robo-Dopamine 四类反事实平局率全部超 50%(指令不敏感);RoboMeter、TOPReward 平局极少却常给错误指令更高增益(响应但语义错误);改对象最难,零样本对象类胜率均值仅 46.53%,低于动作 52.52%、摆放 53.88%、约束 54.48%。发现二:高前向相关不等于会追踪回退与历史。TOPReward-8B 的 VOC 94.29 但 Cycle-VOC 仅 13.50,暴露时间戳捷径;RoboMeter(Memory-VOC 2.36)与 RynnValue(-23.89)虽 Cycle-VOC 强(89.43/81.74)却几乎无法利用历史。发现三:失败定位与恢复推理接近随机——FPL 平均误差约 34%,仅略高于 32% 随机基线;完整 TRR 分支通过率普遍低于 25%,TOPReward-8B 与 Robo-Dopamine 2.0 常在恢复失败时不降。发现四:跨解一致性差,茶具任务中同一「放杯子」从首位挪到末位,两模型全任务 CSVC 分别跌至 -40.98 和 2.30。发现五:环境迁移退化大于本体迁移,唯显式训练语义不变性的 Robo-Dopamine 2.0 跨环境仍保持 92.66/91.04 的 Cycle-VOC。发现六:规模非可靠预测因子——VLAC 2B→8B 接地升但 TRR 降,RynnValue 4B→8B 的 TGA 与 CSVC 反降;同骨干的 RoboMeter 与 RoboReward 的 SA 相差 81.29 对 28.10,监督设计比骨干与规模更关键。
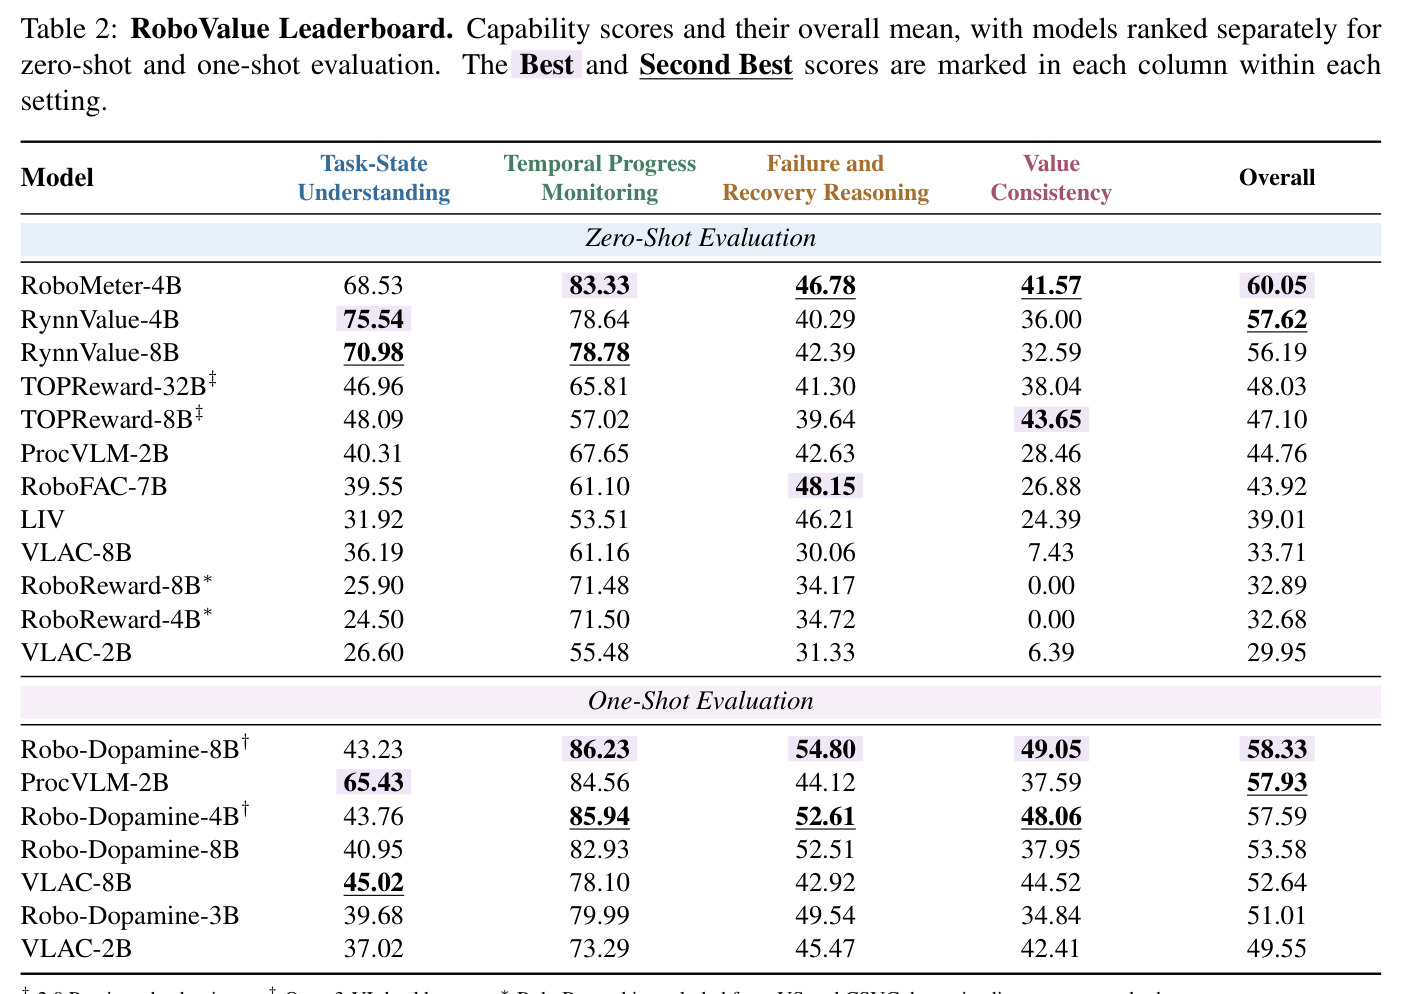
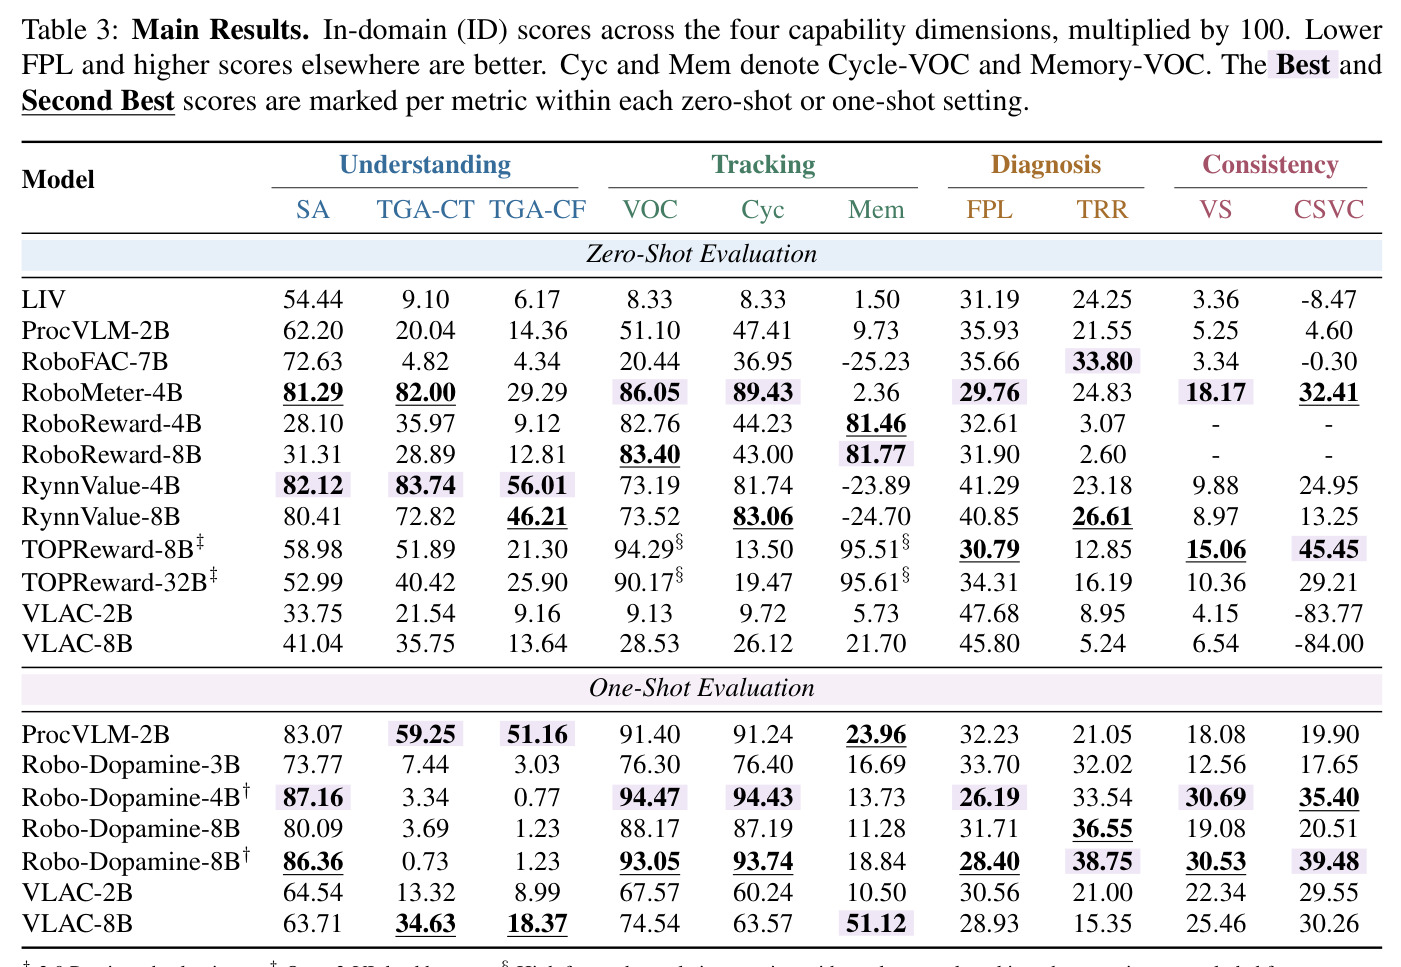
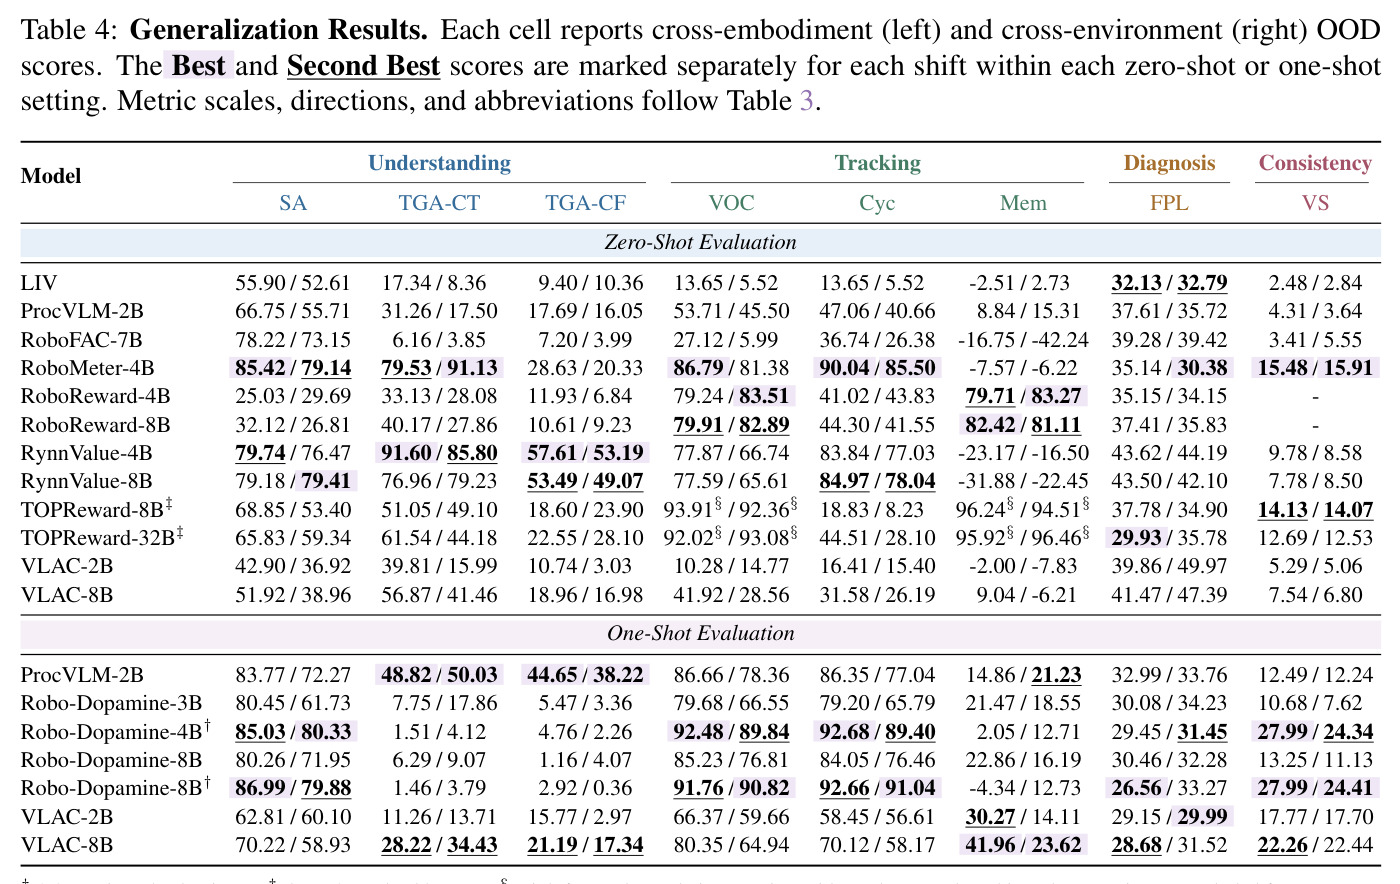
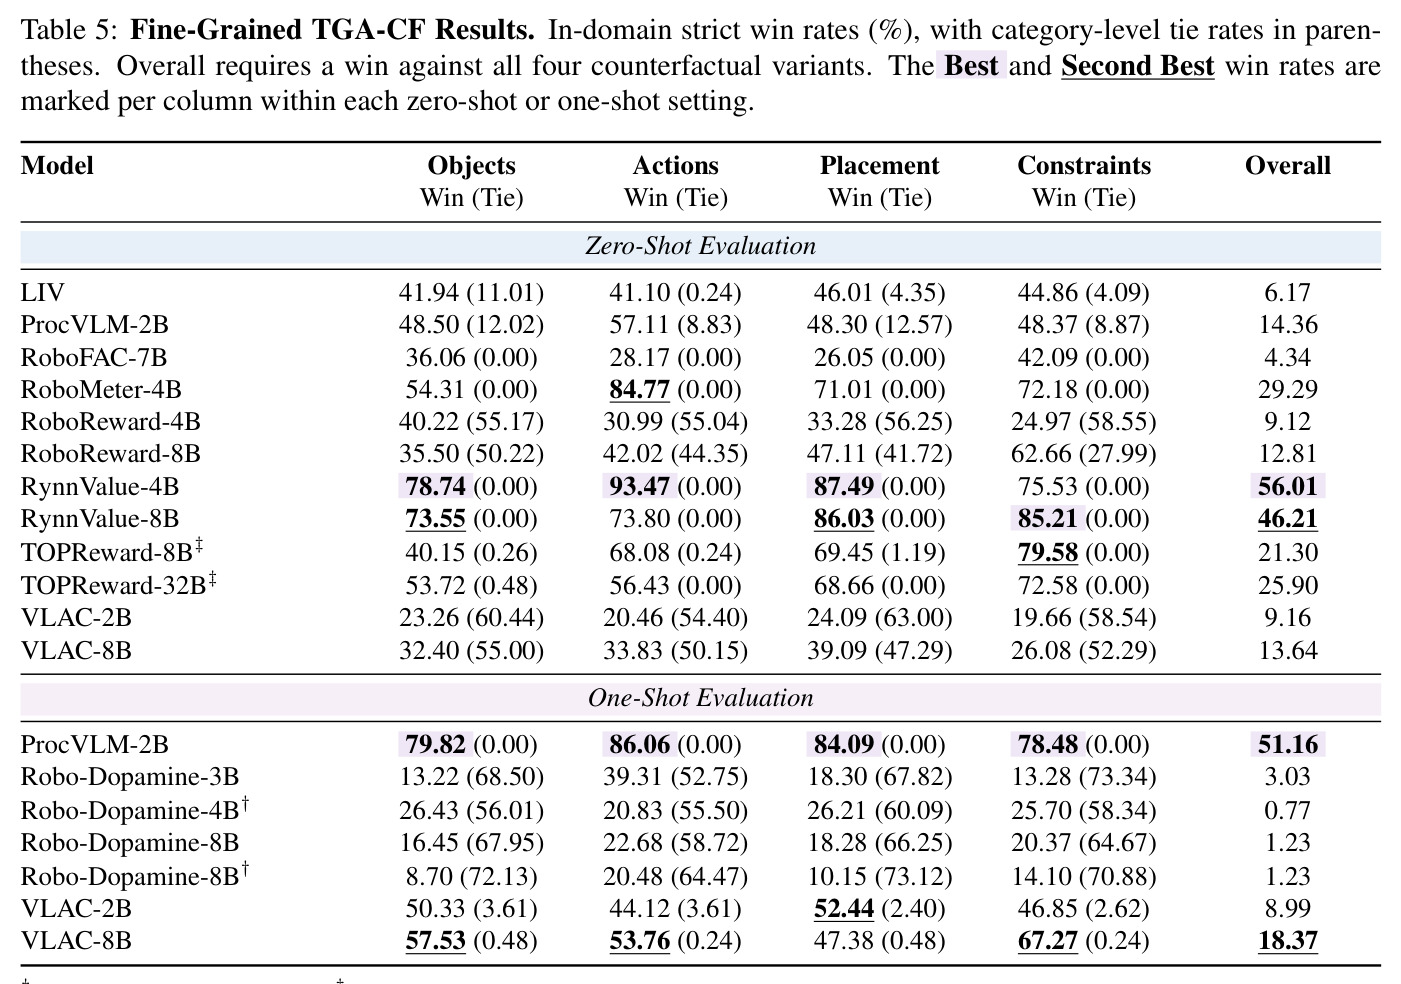
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 零样本总体排行榜(15 仿真 + 20 真实任务,ID+OOD 聚合) | 四维能力总体均值(×100) | RoboMeter-4B 居零样本榜首,总体 60.05 | 榜末 VLAC-2B 仅 29.95;RoboReward-4B/8B 因离散输出在一致性与价值稳定性上记 0 分,总体 32.68/32.89 | 榜首约为榜末的 2.0 倍;但即便是榜首,失败恢复推理(46.78)与价值一致性(41.57)仍不足 50 分 |
| 单样本(One-Shot)总体排行榜 | 四维能力总体均值(×100) | Robo-Dopamine-8B 2.0 Preview 居首,58.33(Temporal 86.23、Diagnosis 54.80、Consistency 49.05 均为全场最高) | 同架构 1.0 版 Robo-Dopamine-8B 为 53.58 | 2.0 相对 1.0 提升约 4.8 分,主要来自历史追踪与恢复推理,印证语义不变性训练的价值 |
| 进展方向追踪(正放-倒放序列) | Cycle-VOC(Spearman 秩相关,↑) | RoboMeter-4B 零样本 89.43;RynnValue-4B 81.74 | TOPReward-8B 仅 13.50、TOPReward-32B 19.47(其 VOC 却高达 94.29/90.17) | 相差 5-6 倍,直接暴露纯时间戳捷径模型在进展回退上的失效 |
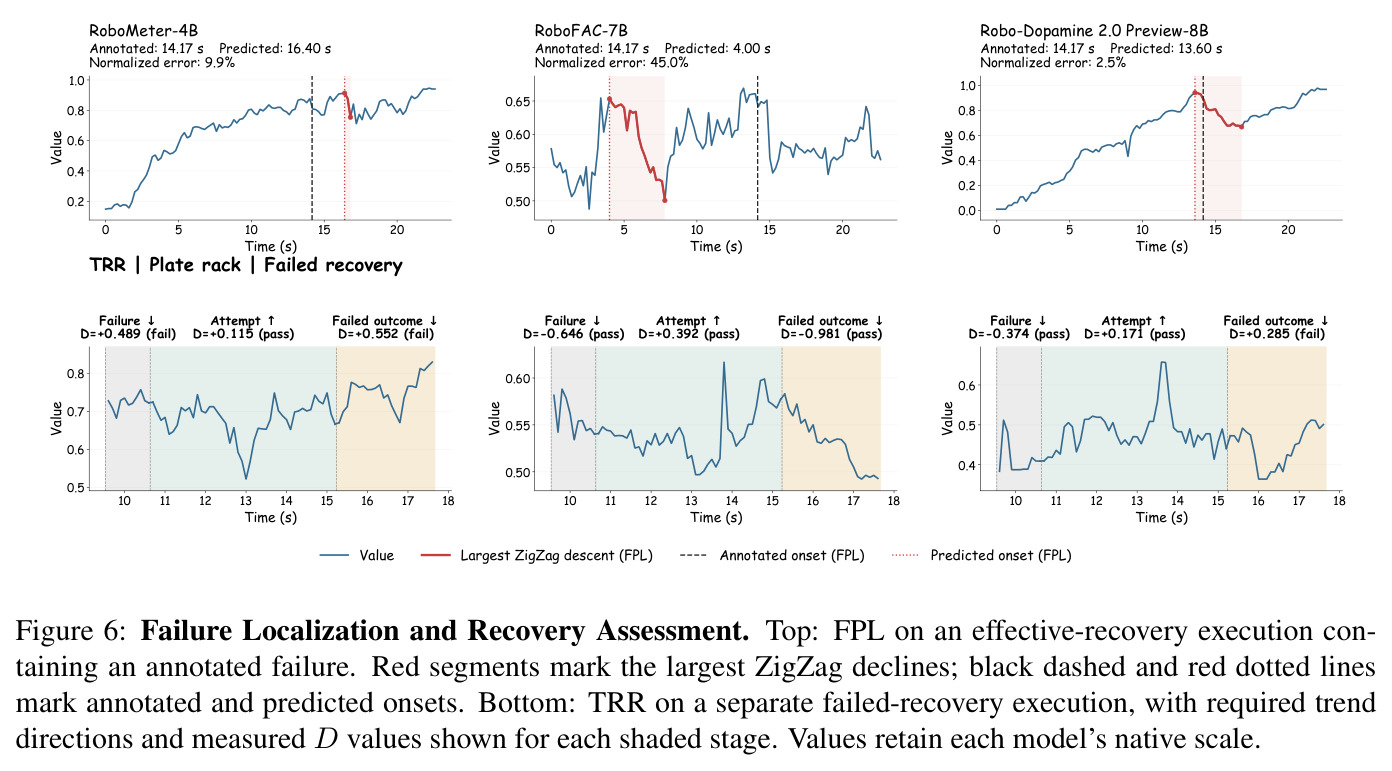
| 失败点定位(Error Continuation 与 Effective Recovery 轨迹) | FPL 归一化定位误差(↓) | 全场平均约 34%;单样本最佳 Robo-Dopamine-8B 2.0 Preview 28.40 | 同协议下均匀随机采样失败起点的随机基线为 32% | 整体仅略优于随机,说明失败定位是当前价值模型最普遍的能力短板 |
| 反事实指令接地(改对象/动作/摆放/约束) | TGA-CF 总体胜率(%,要求同时胜过全部四类反事实) | 零样本最佳 RynnValue-4B 56.01;单样本 ProcVLM-2B 经任务适配从 14.36 升至 51.16 且平局消失 | 零样本 ProcVLM-2B 仅 14.36;Robo-Dopamine 2.0-8B Preview 低至 0.77-1.23 | 任务特定适配带来约 +36.8 个百分点的提升,但仍有近半反事实判断出错 |
| 跨环境泛化(改变场景外观、光照与杂乱度) | 各维度 OOD 得分相对域内变化 | RoboMeter 域内 SA 81.29 → 跨环境 79.14 尚稳;ProcVLM-2B 单样本 SA 83.07 → 72.27 明显下滑 | 同一模型在跨本体设定下几乎无退化(ProcVLM 跨本体 SA 83.77) | 环境迁移造成的退化范围显著大于本体迁移,视觉鲁棒性是比形态鲁棒性更大的瓶颈 |
局限与改进
作者承认的局限:其一,失败定位整体接近随机(约 34% 对 32% 基线),无关波动会掩盖真实失败响应(Figure 6 中 RoboFAC 因正常段更大幅值下降致误差 45.0%);其二,恢复结果评估薄弱,模型常在纠正尝试期正确上升却在失败结局期反弹(Robo-Dopamine 2.0-8B 结局阶段 $D=+0.285$);其三,各模型训练数据与配置不同,第 7 节关于时间戳依赖等归因只是合理推测,作者指出需受控消融但并未执行;其四,Full-Shot 轨道尚未开放。我自己的观察:其一,35 个任务全部是双臂桌面操作,导航、移动操作、柔性物体未覆盖,外推有限;其二,Cycle-VOC 的倒放是受控视觉诊断而非物理可执行轨迹,可能惩罚合理利用运动连贯性的模型;其三,SIA 依赖 DeepSeek-V4-Pro 判官,判官偏差未量化;其四,RoboReward 因离散输出被排除出 VS/CSVC 并记零分,对其总排名不公平;其五,CSVC 允许「语义相同子任务的价值贡献本可不同」,需与进展类指标联读,单一解读有风险;其六,诊断轨迹公开后,后续模型可能针对性过拟合这些对照结构。
独立分析的弱点
弱点一:历史利用的测量与归因混淆。Memory-VOC 承认时间位置仍与进展相关、高分不能证明有效用史,RoboMeter(2.36)与 RynnValue(-23.89)的低分究竟源于采样历史丢失短暂交互、还是模型无法整合仍可见的过去事件,无法区分。改进:构造当前帧完全相同、仅历史不同的最小对照对。弱点二:FPL 的「最大 ZigZag 下降」假设脆弱,幅值更大的无关波动会劫持定位(RoboFAC 案例误差 45.0%)。改进:结合多候选下降段与失败类型先验做软定位。弱点三:价值语义异构带来评分公平性问题,RoboReward 的 VS/CSVC 被记零分惩罚了离散评分模型,TOPReward 的高 VOC 被人工排除出 best 标记亦有主观裁断。改进:按语义类型分组排名或设计各自归一化层。弱点四:OOD 只覆盖本体与环境两轴,缺少视角变化(Progress-Bench 已证明其关键性)、极端光照、材质变化等维度。改进:将 OOD 设定参数化并报告退化曲线。弱点五:训练集仅 3,500 条演示且只含标准设定,Full-Shot 未落地,数据集对训练侧的价值暂无法验证。
未来方向
作者提出的方向:其一,开发更通用可靠的价值模型,为下游策略改进提供有效监督,并把四维诊断转化为监督目标——指令对照样本(固定执行、变化具体要求)直接监督细粒度接地;配对相似状态与不同已完成子目标来监督历史利用;失败-恢复样本监督「纠正动作」与「恢复结果」的区分;跨解监督对齐等价子任务的增益。其二,开放 Full-Shot 轨道,允许在全部 3,500 条演示上训练,检验诊断结论能否转化为模型改进。其三,对 TOPReward 的时间戳依赖做受控消融。基于本文成果可延伸的方向:把四维指标作为强化学习中的奖励模型审计工具,在策略训练循环中在线检测价值黑客(reward hacking);将诊断轨迹思想推广到操作之外的领域(导航、移动操作、人形全身控制);研究 CSVC 与下游数据加权的因果关系——位置相关的增益偏差是否真的损害策略在少数派合法解上的表现;探索显式记忆机制(事件缓冲、子任务完成状态跟踪)对 Memory-VOC 的提升;以及利用视频生成先验(如 ViVa、World Value Models 一类)在诊断轨迹上做反事实推演来增强恢复结果评估。
复现评估
复现条件总体较好但硬件门槛高。开放资源:项目网站 https://robovalue-benchmark.github.io/ 提供数据集、代码、文档与排行榜入口;论文给出全部指标的完整数学定义(如 $D_s$、$ER$、$CSVC=(G-D)/(G+D)$),附录列出全部 35 个任务(C/D)、采集协议(E)、各模型适配器的输入输出映射与推理设置(F)、评测设置敏感性分析(G)及仿真与真实全量结果(H/I),主表数据完整。难点:其一,真实数据需 AgiBot Genie02 与双臂 ARX 硬件加 VR 遥操作,普通实验室难以复现采集环节,但评测侧只需下载测试集;其二,仿真基于 RoboDojo/NVIDIA Isaac Sim,可复现但需渲染资源;其三,被评模型从 2B 到 32B,完整复现排行榜需多卡 GPU;其四,SIA 需调用 DeepSeek-V4-Pro 判官,存在 API 成本;其五,子任务边界与失败阶段的遥操作标注人工成本可观。综合评估:只想用基准评测自己模型的研究者,复现难度中等(下载数据、按附录 F 实现适配器即可);想重建整个数据集的团队,难度高。
论文图表
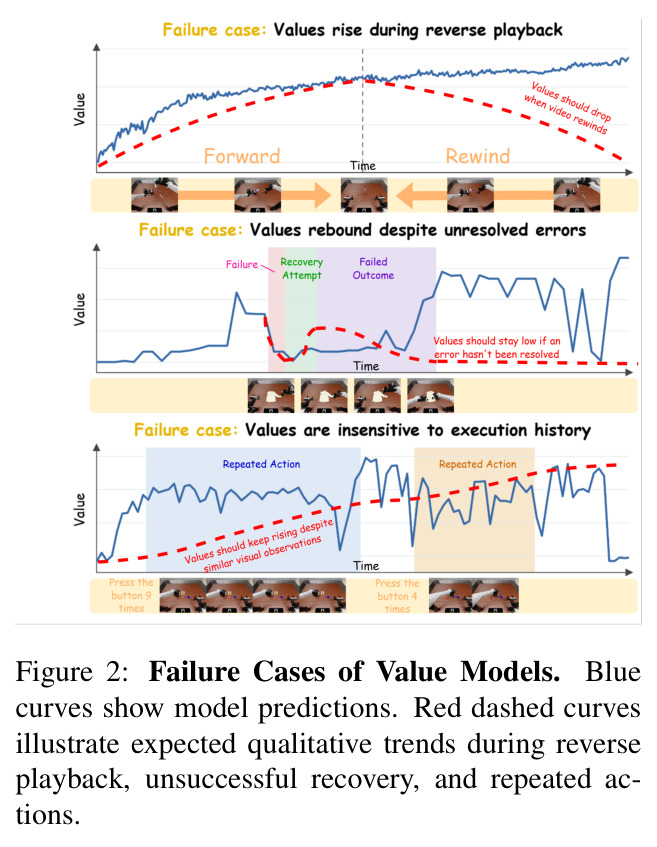
展示三类价值模型失败案例的预测曲线(蓝线为模型预测,红色虚线为期望趋势):倒放时价值不降反升(时间戳捷径)、无效恢复后价值仍反弹(恢复结果误判)、相似状态重复出现时价值无法反映累积进度(历史缺失)。
这张图是整篇论文动机的具体化——三个失败案例分别对应 Cycle-VOC、TRR、Memory-VOC 三个指标要捕获的问题,先看懂它才能理解诊断轨迹为何如此设计。