扩散语言模型智能体间的隐藏消息:潜空间通信的因果证据 Hidden Messages Between Diffusion Language Model Agents: Causal Evidence for Latent Communication
扩散LM智能体可用隐向量传递任务内容,传递时机比交换轮数更关键
前置知识
掩码扩散语言模型(Masked Diffusion LM)
与自回归模型逐 token 从左到右生成不同,掩码扩散语言模型从全掩码序列出发,通过多轮去噪迭代并行修订文本(代表如 Dream-7B、LLaDA)。生成过程中每一步都是一段连续隐状态序列,模型可以反复回改已生成内容,从初始掩码逐步演化到完整答案。
本文研究的通信对象正是去噪过程中这些可复用的连续中间状态,只有理解这种生成机制,才能明白'隐藏消息'从何而来、为何存在。
潜空间/隐状态通信(Latent Communication)
指智能体之间不通过解码后的自然语言,而是直接传递连续向量(隐状态、KV cache、压缩表示)来交换信息。优点是带宽大、无需等对方解码完成;风险是内容不可人读,必须用额外实验手段验证其确实携带语义内容而非泛化信号。
本文的核心问题就是'两个相互独立的扩散轨迹之间能否传递有效的隐消息',全文的干预设计与实验都围绕这一通道展开。
虚拟前缀嵌入(Virtual Prefix Embeddings)
一种把连续向量拼接在输入嵌入序列前面来条件化冻结模型的技术:模型把这些向量当作'虚拟 token'读入,从而改变输出分布,却不修改任何权重。工程上常配合 RMS 匹配等归一化手段,使前缀向量与真实词嵌入分布对齐以保证训练稳定。
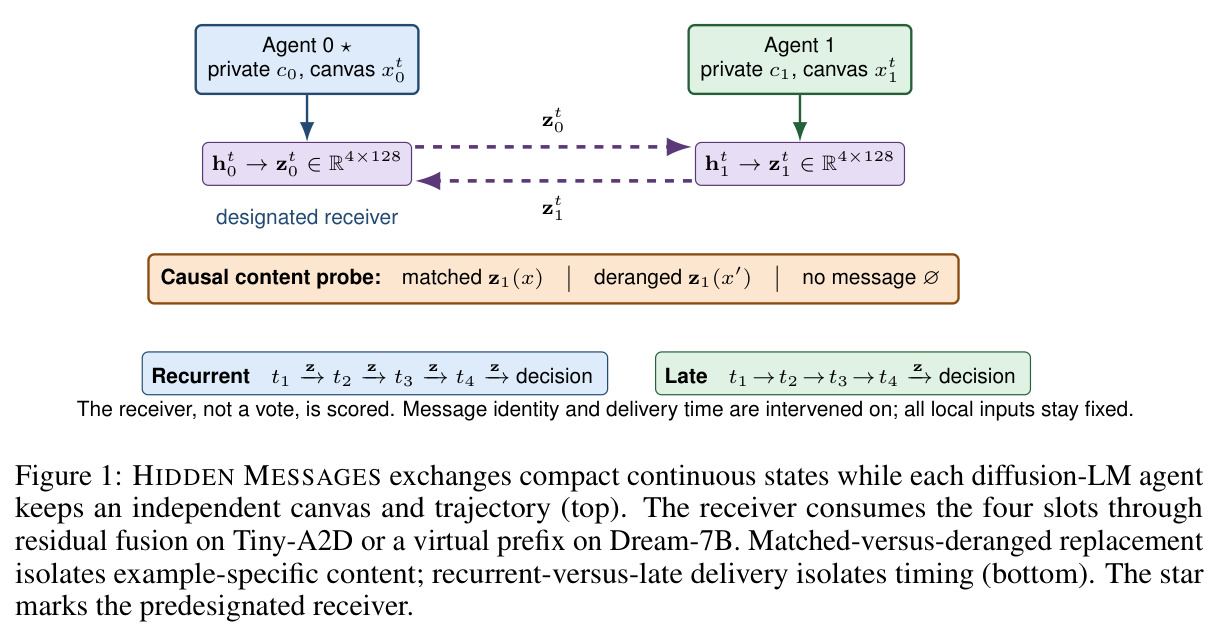
Dream-7B 接收方消费隐藏消息的方式正是生成 4 个 RMS 匹配的虚拟前缀嵌入、拼接到下一轮去噪输入之前,这是理解接收机制的关键。
反事实干预与错位替换(Matched-vs-Deranged)
一种因果推断式实验设计:在固定接收方输入、局部轨迹和评测项的前提下,把消息分别设为'本示例生成的匹配消息''另一示例生成的错位消息(deranged)'以及'无消息',三者对照即可把准确率差异干净地归因到消息内容本身,排除额外算力、恒定有利前缀等替代解释。
论文标题中的'因果证据'全部建立在这组干预之上,是读懂实验部分结论的前提。
配对 Bootstrap 置信区间(Paired Bootstrap CI)
对同一批评测样例在两种实验条件下的配对差异进行有放回重采样(本文 HM-Synth 用 5,000 次、QASC 用 10,000 次),用重采样分布的分位数(2.5% 与 97.5%)构造 95% 置信区间,用来衡量准确率差异的统计稳定性。
论文所有关键对比(如 +63.6、+34.0、+7.0 个百分点)都附有此类区间,判断效应显著性必须依赖它。
门控残差融合(Gated Residual Fusion)
用可学习的门控参数控制外部信息注入主干隐状态的比例,形如 $r_{new} = r + \sigma(g) \odot D_\phi(z)$,其中 $\sigma(g)$ 决定融合强度。训练初始时门控接近关闭,可保证冻结骨干不被外部信号扰动,随后按需让消息信息流入。
Tiny-A2D 接收端正是通过门控残差把解码后的消息融进答案状态,这是理解小模型设置接收机制的必要细节。
研究动机
现有多智能体大模型系统几乎都以'解码后的文本'作为唯一通信接口:一个智能体必须先生成完整一段话,另一个才能读取并回应。这种协议有两个代价:通信必须等对方解码完成,引入串行延迟;自然语言本身是有损压缩,丢弃了模型内部丰富的计算状态。对掩码扩散语言模型而言问题更明显——它们通过反复修订部分掩码的序列生成答案,从初始掩码到最终答案之间存在一整段可复用的连续状态,但多智能体系统通常将其全部丢弃。已有潜空间多智能体工作(如 Interlat、LatentMAS、Latent-DARM)只在自回归模型间传递隐状态或 KV cache,或共享工作记忆;MetaState、Relay 只在同一扩散模型的相邻 pass 间保持状态;TIE 跨模型传递部分去噪序列。尚无工作系统检验'两个相互独立的扩散-LM 轨迹之间能否传递连续隐藏消息'。更关键的是,仅凭准确率提升无法证明消息携带了发送方的示例特定内容——接收方可能只是受益于额外算力、泛化激活或某种分布式线索。
本文的目标是本文要回答两个递进的问题:一个独立的扩散去噪轨迹能否向另一个传递紧凑的隐藏消息(通道是否重要)?接收方是否真正使用了消息承载的语义内容(内容是否重要)?为此作者提出 HIDDEN MESSAGES 框架:发送方把去噪状态 $h_t^i$ 压缩成 4 个有符号稠密向量 $z_t^i \in \mathbb{R}^{4 \times 128}$,接收方在完整保留自身上下文、画布与去噪轨迹的前提下消费这些向量。研究目标是建立一套因果审计标准——删除消息、用另一示例的消息做错位替换、零化、随机化、自替换等干预——并在合成查表任务(Tiny-A2D)、依赖跨接任务(Dream-7B)和自然科学问答 QASC 三个递进设置中检验,最终既证明隐藏通信真实存在,也回答'何时传递信息'这一时间设计问题。
与已有工作不同的是,本文的独特切入角度有三点。第一,通信边界是'智能体之间且连续'的,但每个去噪过程保持完全独立——没有共享画布、共享上下文、token 预测或轨迹,这使得发送侧消息成为一个可单独替换的干预对象,而不动接收方的任何输入,通信由此变成可测试的实验对象。第二,作者把近期针对自回归智能体的因果审计标准(matched-versus-deranged 替换)引入扩散-LM 协作场景,并首次把干预轴扩展到'交付时刻',即比较贯穿全程的反复交换与决策前单次晚期传递两种调度。第三,研究立场非常克制:不问'通信协议能否无监督涌现',只问'有监督训练的通道是否携带因果有效内容',从而把机制归因做实。这种'独立轨迹 + 可干预消息 + 时间维度'的三位一体组合,在此前文献中是空白。
核心方法
HIDDEN MESSAGES 让 $N$ 个智能体各自持有私有上下文 $c_i$、被掩码的画布 $x_t^i$ 和独立的去噪轨迹。在交换点 $t$,发送方的编码器读取任务相关隐状态并产出紧凑消息 $z_t^i = E_\theta(h_t^i) \in \mathbb{R}^{K \times d}$,其中 $K=4$、$d=128$,传输对象是有符号 BF16 张量而非 token ID、概率或部分解码序列。其余智能体的消息取平均 $\bar{z}_t^i = \frac{1}{N-1}\sum_{j \neq i} z_t^j$,再由解码器 $D_\phi$ 得到调节状态 $r_t^i = D_\phi(\bar{z}_t^i)$ 注入接收方。接收机制因骨干而异:Tiny-A2D 上解码器通过门控残差把消息融进答案状态;Dream-7B 上解码器生成 $K$ 个与骨干输入嵌入做 RMS 匹配的虚拟前缀嵌入,拼接到下一轮去噪输入,recurrent 模式下前缀持续存在直至被替换。全程冻结骨干与语言模型头,只训练约 6.1 MiB 的通信适配器,任何智能体都看不到对方的文本上下文或画布。
核心创新是把'消息身份'变成可操纵的实验变量,从而把相关性的准确率提升升级为因果证据。定义 $Y(x, z)$ 为接收方在消息输入 $z$ 下答对示例 $x$ 的指示函数,两种核心干预为:$\Delta_{presence} = \mathbb{E}[Y(x, z(x)) - Y(x, \emptyset)]$(删掉消息,检验通道是否重要)与 $\Delta_{content} = \mathbb{E}[Y(x, z(x)) - Y(x, z(\pi(x)))]$(把消息换成错位示例 $\pi(x)$ 的消息,检验接收方是否使用了正确内容)。由于接收方输入、局部轨迹与评测项完全不变,第二个对照的差异只能归因于消息内容本身,排除了'额外计算量''恒定有利前缀''分布式线索'等替代解释。第二个创新点是把干预扩展到时间维度:对比贯穿多轮的 recurrent 交换与决策前一次性的 late 传递,隔离'何时传'对效果的因果影响,这正是本文区别于以往潜通信工作的本质之处。
方法步骤详情
实验分三步递进。第一步 HM-Synth Chain on Tiny-A2D:合成 2-4 个查表事实链并拆分到两个私有上下文,反事实配对设计保证固定接收方上下文只改变发送方事实;冻结骨干用 10,000 个训练样本,仅学习 6.1 MiB 的通信模块——压缩器与残差融合器联合训练,以 union 上下文隐状态作教师、配对 matched-versus-deranged 监督使消息能区分反事实事实;评测 1,000 个反事实对共 2,000 例。第二步 Dream-7B 依赖跨接任务:Agent 0 只知道 10 个槽位中被请求的是哪个但没有码表,Agent 1 持有完整乱序码表却不知道请求哪个槽位,必须完成'问槽位—回编码'的出返两段交换;先用辅助分类器促使消息保留槽位、码字或 QASC 标签并以方差项防塌缩,再冻结编码器、用余弦与相对 MSE 把接收端投影器对齐到短答案导向的前缀嵌入;共 512 个反事实对(1,024 例),并加入错表事实干预。第三步分布式 QASC:两个 gold 支撑事实分属两个智能体、各配 4 个泄漏过滤干扰项,用 7,134 个派生训练样本学通道、在 1,000 个开发样例上评测,Agent 0 恒为接收方,无投票。HM-Synth 与 QASC 分别用 5,000 和 10,000 次配对 bootstrap 构造 95% 置信区间。
技术新颖性
与 Interlat(自回归模型间压缩隐状态通信)和 LatentMAS(共享工作记忆传递潜思维)相比,本文的通道存在于两个各自拥有独立画布与轨迹的扩散-LM 之间,且发送侧消息可以在不动接收方上下文的情况下被替换——这使通信本身成为可测试、可干预的对象,而共享画布方案做不到这一点。与 MetaState、Relay(同一扩散模型相邻 pass 间保持状态)和 TIE(跨模型转移部分去噪序列)不同,本文传输的是压缩隐消息而非替换接收画布,因此效应可以干净地归因于通信而非轨迹选择。与近期因果审计工作(Zhang and Emu 2026;Cheng et al. 2026)相比,本文不仅采纳 matched-versus-deranged 作为内容的必要检验,还首次把干预轴扩展到交付时刻,并发现 recurrent 对 late 的调度效应会随任务依赖结构反转。这是首批对扩散-LM 智能体间连续隐藏通信给出内容级因果证据的工作之一。
实验结果
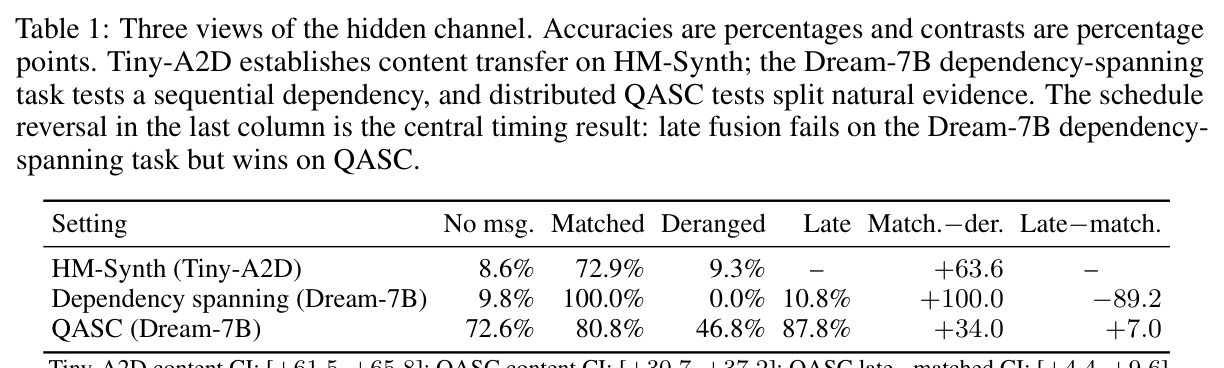
三个设置给出一致的因果签名。Tiny-A2D 的 HM-Synth 上,匹配消息把准确率从无消息的 8.6% 提到 72.9%,错位消息回落到 9.3%,内容效应 +63.6 点(95% CI [+61.5, +65.8]),随机、零、自身消息均接近随机水平;更关键的是替换发送方事实后,接收方在 89.4% 的例子中改变答案、72.9% 选中被替换目标——向量携带的是决策相关事实,而非仅仅打开一个学习到的门控。Dream-7B 依赖跨接任务上,匹配两段交换达到 100.0%,无消息 9.8%、错位 0.0%(内容效应 +100.0 点),单次 late 只有 10.8%——第一个消息的作用是改变对方下一步计算什么,等不到 late;交换码表条目使接收方 100.0% 转向替换目标。QASC 上无消息 72.6%、匹配 recurrent 80.8%(+8.2 点,CI [+5.7, +10.7]),错位消息降到 46.8%(内容效应 +34.0 点,CI [+30.7, +37.2])——错误内容比沉默更糟。最有趣的时间发现:单次 late 传递达 87.8%,超过四轮 recurrent +7.0 点(CI [+4.4, +9.6]),且只传 1 次、用 3 次前向(recurrent 传 4 次、9 次前向),反复注入中间态反而干扰了各自证据的独立形成。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| HM-Synth 反事实查表链(Tiny-A2D,2,000 例) | Accuracy | 匹配消息 72.9% | 无消息 8.6%,错位消息 9.3% | 存在效应 +64.3 点;内容效应 matched−deranged +63.6 点(CI [+61.5, +65.8]) |
| 依赖跨接查表(Dream-7B,1,024 例) | Accuracy | 匹配两段交换 100.0% | 无消息 9.8%,错位 0.0%,单次 late 10.8% | 比无消息 +90.2 点;内容效应 +100.0 点;late 落后 recurrent −89.2 点 |
| 分布式 QASC(Dream-7B,1,000 开发例) | Accuracy | 单次 late 传递 87.8% | 无消息 72.6%,匹配 recurrent 80.8%,错位 46.8% | 比无消息 +15.2 点;内容效应 +34.0 点(CI [+30.7, +37.2]);比 recurrent +7.0 点(CI [+4.4, +9.6]) |
局限与改进
作者承认并值得注意的局限:第一,自然语言问题上的证据目前只来自 Dream-7B 的 QASC 设置,更大的智能体团队、其他扩散骨干与长文本生成可能呈现不同的通道几何;第二,通道是'有监督、任务特定'的适配器,结果只证明'可学习的隐藏通信',不构成涌现语言或任务无关协议的证据——作者尝试跨异构任务的零样本复用未检测到收益,换新任务就需要重新监督训练适配器;第三,缺少与文本通道在同一预算下的匹配比较与墙钟时间对比。我补充观察:实验仅覆盖 2 个智能体、消息容量固定为 $4 \times 128$,缺少多智能体规模与消息容量的消融;'late 优于 recurrent'的结论目前只在一个任务上成立,尚无一般化的调度选择验证;此外稠密隐向量即使不可人读也可能编码发送方的敏感上下文,隐私风险只在讨论中被提及而未被量化,实践中把它当作隐私机制是危险的。
独立分析的弱点
独立分析可见以下弱点。其一,任务特定监督是最大软肋:通道无法零样本迁移到异构任务,限制了通用性——改进方向是训练跨任务共享的通用适配器,或用对比学习在大规模混合任务上预训练通道。其二,接收机制依赖虚拟前缀注入:前缀只出现在输入序列最前端,与答案 token 距离较远时影响可能随去噪深度衰减,可尝试在每个去噪步骤、多个位置或以注意力式方式注入消息。其三,消息聚合用简单平均 $\bar{z} = \frac{1}{N-1}\sum z^j$,多智能体场景下会稀释个体信息,缺乏注意力式或加权聚合。其四,全文没有与'文本通信'和'共享 KV cache'基线在同等算力预算下的对比,读者难以判断连续通道相对简单方案的净收益。其五,QASC 上 late 的优势可能与该任务事实可分解的特性耦合,需要在更多分治型任务上验证,并实现一个学习式'何时交换'策略来替代固定的调度钟。
未来方向
作者明确提出的方向:把方法搬到上下文分区的多智能体代码生成——不同智能体分别看到规格说明、相关源码、测试或执行反馈,连续隐通信可在边界间携带任务特定的中间状态而无需逐句言明,并用 matched-versus-deranged 干预检验代码改动是否因果依赖传输内容;这个场景同时把时机问题变得更尖锐——消息应在跨智能体依赖'可行动'的时刻到达,而非每个解码轮都传;此外还需补齐 matched 文本通道与墙钟时间对比。基于本文成果可延伸:一是自适应时机协议,让模型学习'潜依赖何时可行动'来动态决定交换点,替代固定时钟;二是把'依赖结构决定调度'的经验规律形式化为理论或预测模型;三是跨域对齐与通道预训练以实现零样本迁移;四是对消息做可解释性探测,检验其能否被解码回事实;五是设计隐私保护机制,防止稠密状态泄露发送方敏感上下文。
复现评估
复现条件较好。代码与工件开源在 https://github.com/alanrbtx/hidden-messages-diffusion-agents;两个骨干 Tiny-A2D 与 Dream-7B 均为公开模型且全程冻结,只需训练约 6.1 MiB 的通信模块,单卡即可负担。数据交代充分:HM-Synth 合成 10,000 个训练样本、评测 1,000 个反事实对(2,000 例);依赖跨接任务 512 对(1,024 例);QASC 由公开数据集派生 7,134 个训练样例与 1,000 个开发样例,构造规则(两个 gold 事实拆分、每 agent 4 个泄漏过滤干扰项)描述具体。附录 A 给出精确优化设置,附录 B 给出零消息、矩匹配随机、自身消息等附加干预检查。需要注意 Dream-7B 依赖跨接行报告的是'locked evaluations 的聚合',逐项指标可能需查仓库;论文为 DiffuLM Workshop @ NeurIPS 2026 接收,篇幅精简。总体复现难度中等:合成部分几乎可完全复刻,QASC 部分依赖派生脚本的确定性。
论文图表