Reflex:视觉驱动的反应式人形机器人全身控制 Reflex: Visually Grounded Reactive Humanoid Control
三阶段解耦训练,让人形机器人仅凭机载RGB-D视觉实时接住人类抛来的纸箱
前置知识
PPO(近端策略优化)
PPO 是最常用的 on-policy 强化学习算法,通过裁剪重要性采样比率的代理目标函数限制每次策略更新的步长,兼顾样本利用率与训练稳定性。本文在 Isaac Lab 仿真器中用 4096 个并行环境以约 28k 步/秒的速度跑 PPO 训练接箱策略,并采用非对称 actor-critic:critic 可以看到无噪声的全身姿态和箱子真值状态,actor 只能拿到与部署一致的运动观测。
论文三个阶段中前两个阶段的控制器都靠 PPO 训练和精调,奖励消融、初始化对比等核心实验也都是围绕 PPO 展开的,不理解它就看不懂训练流程。
AMP(对抗运动先验)
AMP 训练一个判别器来区分「策略自己走出来的运动」和「真实人体动作捕捉数据」,再把判别器得分当作风格奖励加进 RL 目标,使策略在完成任务的同时保持人类式的自然动作风格。本文把人类接物、持物的动作捕捉数据重定向到 29 自由度的 Unitree G1 上,与参考轨迹跟踪奖励配合使用。
消融实验(Table III)显示同时去掉跟踪奖励和 AMP 会导致训练彻底崩溃,它们是 Stage 1 能学出协调全身接物姿态的关键,也是「像人一样接球」观感的来源。
特权学习与 DAgger
特权学习指先用仿真器内部真值(如物体的精确位姿、速度)训练一个教师策略,再让学生策略从部署时可得的传感器输入模仿教师。DAgger 是其标准搭档:让学生自己开环滚出状态分布,由教师在学生访问到的状态上打标签并聚合进训练集,从而缓解模仿学习的分布漂移。RMA 是该思路在足式机器人上的代表作:冻结动作解码器,只训练视觉/适应模块预测教师的隐变量。
本文 Stage 2 用教师动作标签做 DAgger 聚合,Stage 3 用特权编码器给视觉控制器访问的状态标 latent 标签,两轮数据聚合都是这套机制。
域随机化与延迟随机化
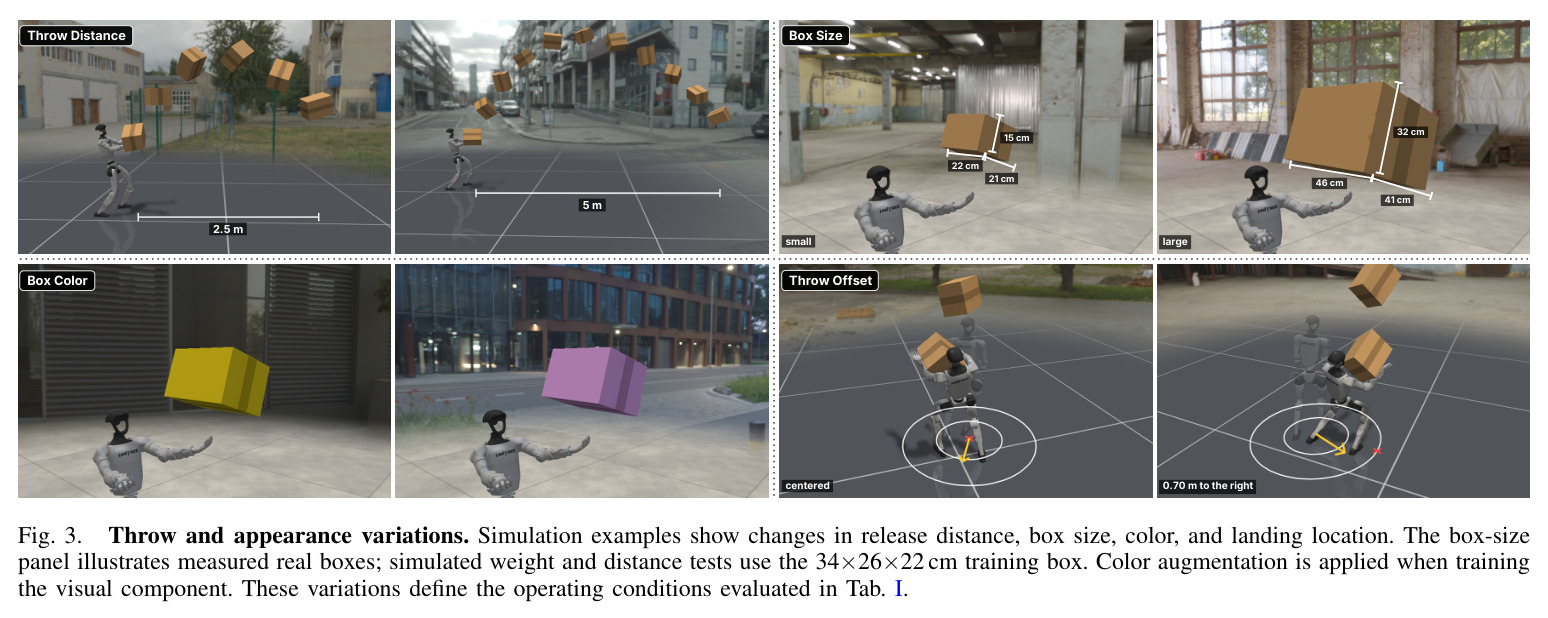
Sim-to-Real 的标准做法是在训练时随机化仿真参数(抛掷初速与落点、接触摩擦、箱子颜色尺寸、观测噪声、丢帧),让策略学到对建模误差鲁棒的行为。本文更进一步随机化感知延迟:Stage 2 每回合从 1–3 个控制步(20–60 ms)中抽样观测延迟,让控制器学会补偿它被训练时的那档延迟。
消融显示延迟随机化在每个测试延迟上带来 5–11 个百分点的提升,而且真机硬件延迟中位数高达 69 ms,这个技巧直接决定了真机成败。
自中心视觉与自运动(ego-motion)
相机安装在机器人躯干上随机身一起运动,因此图像中观察到的运动等于物体真实运动与相机自运动的叠加;而且接近接触瞬间,机器人自己的手臂会越来越多地遮挡目标。本文显式地把 9 维自运动向量与从图像抽出的几何特征一起送入 GRU,让模型在视角剧烈变化和间歇性漏检下仍能推断物体运动。
视觉编码器消融(Table V)证明去掉自运动输入会损失 10.4–22.6 个百分点,去掉时序历史更损失 35.6–39.8 个百分点,这两个输入是视觉接地成败的分水岭。
研究动机
人能在约一秒内预判来物并用整个身体接住它——守门员侧扑、工人接住卡车上抛下的纸箱、伸手扶住坠落的水杯。人形机器人难以复制,因为三重难题耦合在一起:其一,29 自由度全身协调,脚步站位、躯干姿态、双臂拦截、冲击吸收与平衡必须同时完成;其二,反射式实时反应,真机测试中纸箱从抛出到抵达约一秒,而本文检测器管线的相机到控制延迟中位数达 69.1 ms(p95 为 90.2 ms),机器人不能只对最新观测做反应,必须在接触前推断轨迹并提前 commitment;其三,自中心视觉,相机随机身运动导致图像运动是物体运动与自运动的叠加,接近接触时手臂遮挡加剧。现有系统只覆盖了问题的一部分:机械臂接物回避了全身平衡与冲击吸收;人形守门员踢球、双手接篮球依赖动作捕捉或反光标记物而非机载视觉;轮式人形和四足接物同样靠外部定位;并行的 RGB 方案则没有报告真机成功率。任务本身也极难:三名人类接球手静止站立接 7 m 抛来的纸箱,成功率也只有 28.3%。
本文的目标是本文的目标是让 29 自由度的 Unitree G1 仅仅依靠躯干上的自中心 RGB-D 相机,接住并稳稳保住人类徒手抛来的普通无标记纸箱:身体要移到来箱路径上,用前臂贴住胸口形成支撑面,吸收箱子的动量并在不摔倒的前提下保住它。评估指标分三层:拦截(箱子在躯干附近减速到 1 m/s 以下,不要求保住)、接住成功(胸口区域支撑、双腕位于箱子两侧、不依赖头肩、保持低速 0.6 秒)、以及单独统计的躯干晃动(发射到回合结束时躯干俯仰是否达到 38°)与摔倒。量化期望是:仿真中视觉输入的成功率接近特权输入(论文最终做到 85.7% 对 87.9%),真机上接近人类接箱水平(2.5 m 和 5 m 分别达到人类的 76% 和 59%),并且接住的箱子能无缝交给下游的搬运-递交-返回控制器形成完整演示。
与已有工作不同的是,本文的独特切入是把「视觉反应式全身控制」拆解成三种能力,并用一个 8 维物体动力学隐变量(latent)串起来,而不是做端到端像素到动作的 RL。作者分析了端到端视觉 RL 的两难:每个 on-policy rollout 都需要高吞吐 RGB-D 渲染,而接箱奖励只在接触和保持之后才出现、信号极其稀疏,策略必须同时在巨大的视觉空间和 29 维动作空间里探索,感知表征学习与运动技能发现互相纠缠,感知模块一改就得重训控制器。此前的特权学习学生只需感知静态地形或慢速移动物体,从未在真机上处理过「快速穿越视野的物体 + 移动相机」的组合。Reflex 沿 RMA 的思路冻结动作解码器、只做 latent 回归,但更进一步:latent 本身由 PPO 塑形成「控制器恰好需要知道的东西」,实验证明回归这个学习出的 latent 比回归完整 26 维特权状态高 18.7–19.5 个百分点。此外,时序视觉历史与相机自运动这两个被许多流水线忽视的输入,被证明是性能的决定性因素。
核心方法
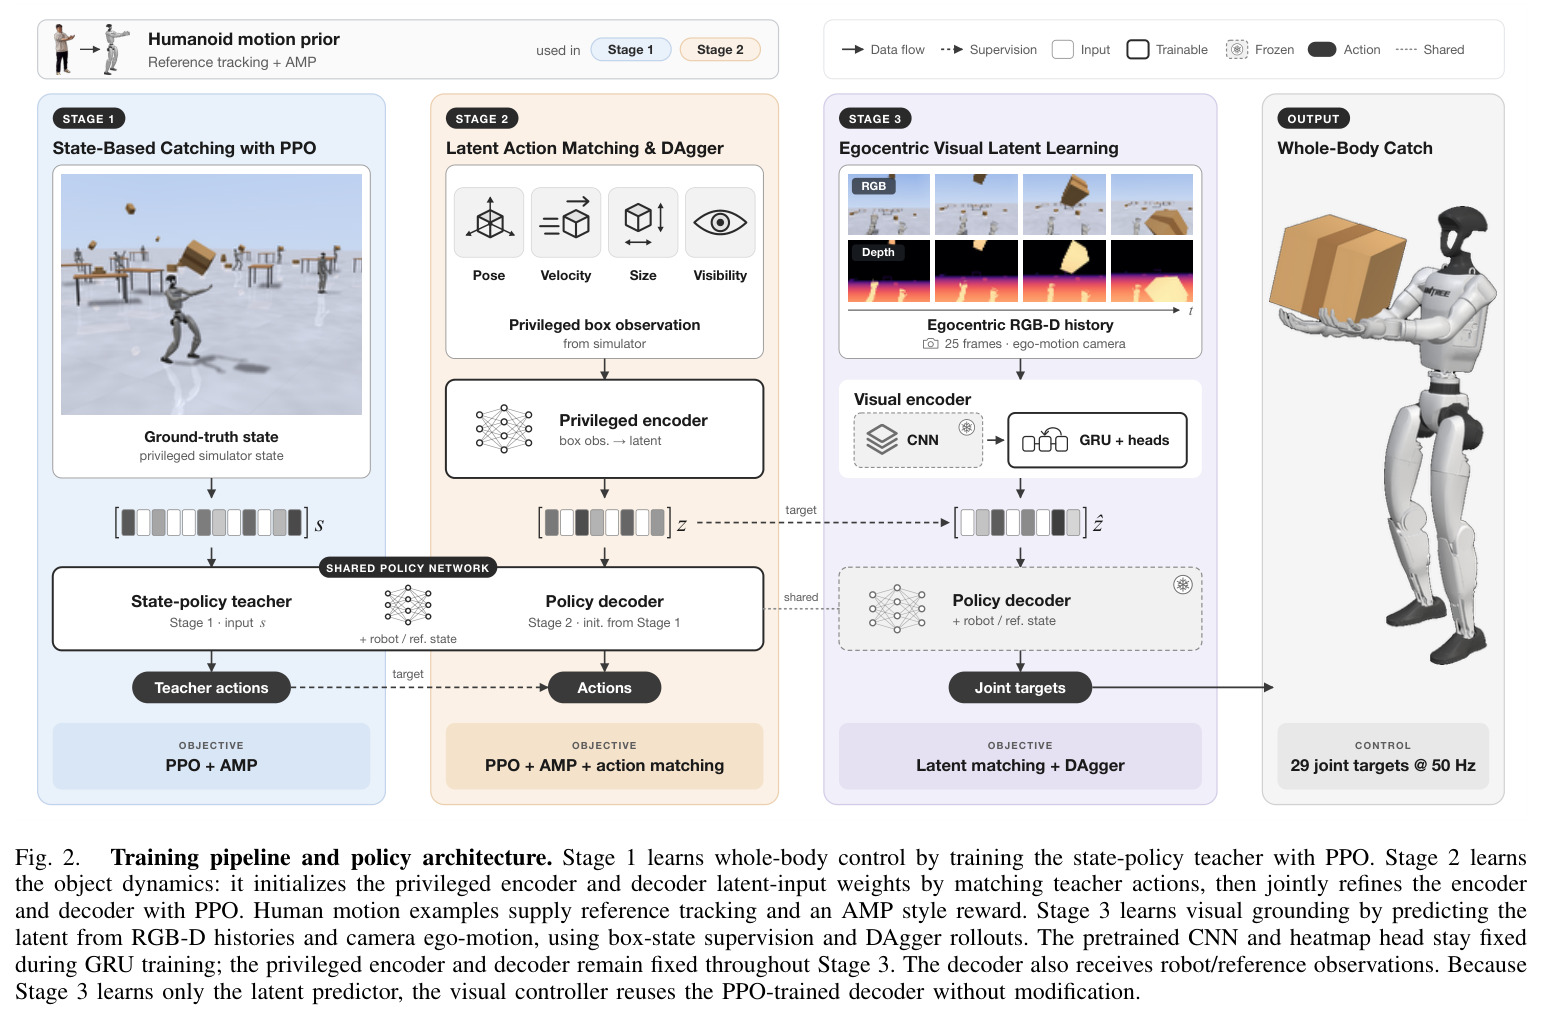
直觉上,Reflex 像在培养一名棒球捕手:先在「蒙眼」状态下练好接球的身体功夫(Stage 1,用特权仿真状态),再教他一套压缩版球路语言——系统只传给他 8 个数来描述来球动力学(Stage 2),最后拿掉他的特权眼睛,让他用自己的视力把这 8 个数实时看出来(Stage 3)。技术上:Stage 1 用 PPO 从特权状态学全身接箱,辅以重定向人类动捕的参考跟踪奖励与 AMP 风格奖励;Stage 2 训练特权编码器 $E_\phi$ 把 26 维延迟箱体观测压缩为 8 维 latent $z_t=E_\phi(p_t)\in[-1,1]^8$,通过可见性加权的动作匹配行为克隆初始化、DAgger 式数据聚合、再联合 PPO 精调编码器与解码器;Stage 3 训练视觉编码器 $V_\psi$,从 25 帧 192×144 RGB-D 历史和相机自运动回归出 $\hat{z}_t$,此时解码器 $\pi_\theta$ 完全冻结,以 50 Hz 输出 29 维关节位置目标。整个流水线把昂贵的 RGB-D 渲染隔离在 Stage 3 的监督学习里(仅约 160 万步),RL 阶段完全无渲染,因此 Stage 2 的 5900 万步 PPO 只需约 35 分钟。
核心创新是以「RL 塑形的动力学 latent」为接口的感知-控制解耦。与端到端视觉 RL 和传统师生蒸馏(直接回归物体状态)的本质区别有三点。第一,latent 的内容由强化学习决定:Stage 2 的 PPO 与动作匹配共同塑造 $z_t$,岭回归探针显示它主要编码延迟观测下箱体的位置与速度($R^2$ 分别 0.94–0.99 和 0.90–0.99),且部分补偿了观测延迟——对 80 ms 以上的旧观测,从 $z_t$ 能以 0.33 m / 1.5 m/s 的 RMSE 预测箱子当前状态,明显优于延迟观测本身的 0.6–0.7 m / 3.4 m/s;而尺寸、朝向、角速度几乎不编码($R^2\le 0.13$),因为解码器用不上它们。第二,解码器冻结:Stage 3 只训练视觉编码器,控制器一行不改即可换上视觉输入,这把视觉学习的代价压到最低,也让「改感知不必重训运动技能」成为可能。第三,「学什么」比「学多少」重要:26 维特权状态里包含解码器几乎不消费的朝向、角速度、尺寸等维度,强迫视觉模型回归它们会浪费容量并放大视觉误差,latent 回归因此比状态回归高 18.7–19.5 个百分点。
方法步骤详情
Stage 1(全身控制):输入 170 维状态观测(机器人/参考状态加 10 维箱体通道:骨盆系位置与线速度各 3 维、观测年龄 1 维、抖动/新鲜/冻结三个指示位),经硬件同款卡尔曼滤波并注入噪声、丢帧和延迟;MLP(512-256-128)输出 29 维动作,经 $q_t^{\text{nom}}=q^0+s\odot a_t$ 映射为关节目标;奖励含接近塑形、持握塑形、持续接住奖励、人类参考跟踪与 AMP,惩罚躯干晃动、指令突变和摔倒。Stage 2(动力学 latent):特权编码器 $E_\phi$ 把 26 维箱体观测(相机系位置 3、相对线速度 3、半尺寸 3、长短轴各 6 维朝向、角速度 3、可见性 1、归一化年龄 1)压到 8 维 latent;先用可见性加权(可见样本权重 5)的动作匹配 BC 初始化 latent 通路,再用 DAgger 聚合 latent 控制器访问的状态并由冻结教师打动作标签,最后联合 PPO 精调编码器与解码器,观测延迟每回合随机取 20–60 ms。Stage 3(视觉接地):CNN 预测箱体定位热图,固定几何层抽出 8 维特征(归一化图像坐标 2、两邻域局部最小深度 2、热图峰值分数 1、针孔反投影 3D 点 3),与 9 维自运动一起进两层 128 单元 GRU,输出 $\hat{z}_t$ 与辅助位置/速度;损失 $\mathcal{L}_V=\mathbb{E}[\omega_t(\ell_z+\lambda_{\text{aux}}\ell_{\text{state}})]$,其中 $\ell_z$ 按解码器敏感度权重 $\alpha_j$ 与训练集标准差 $\sigma_j$ 归一化各 latent 维度,$\lambda_{\text{aux}}=0.5$,近距样本 8 倍加权;再做 2–3 轮视觉 DAgger。部署时以 50 Hz 输出 29 维关节目标,下游接 SONIC 步行控制器完成抱箱行走与递交,MuJoCo 部署孪生负责切换检查。
技术新颖性
与已有工作的具体区别:(1)对接物研究,早期固定基座机械臂接物、冲击感知双臂接物、灵巧手接物都回避了全身平衡;人形守门员和接篮球系统依赖动捕或反光标记;轮式人形、四足接物以及并行的 RGB 方案要么不用机载视觉、要么没报告真机成功率——Reflex 首次在真机人形上用纯机载 RGB-D 完成全身接箱并给出成功率与人类对照。(2)对特权学习谱系:RMA 类学生的感知对象是静态地形,本文处理快速运动物体加移动相机加近距遮挡的三重困难,并把学生的回归目标从「物体状态」改为「RL 塑形的 latent」,这是对 RMA 范式的实质性推进而非套用。(3)训练工程上,把渲染彻底隔离出 RL 环路,使 59M 步 PPO 从约 11 小时压缩到 35 分钟,整个项目单张 RTX 3090 即可完成。(4)各训练技巧都有严格消融背书:动作匹配初始化 +5.2 点、延迟随机化 +5–11 点、热图监督 +7.4–10.9 点;作者同样诚实报告了 DAgger 与辅助状态损失在仿真中无可测增益,这种实证纪律在系统类论文中值得称道。
实验结果
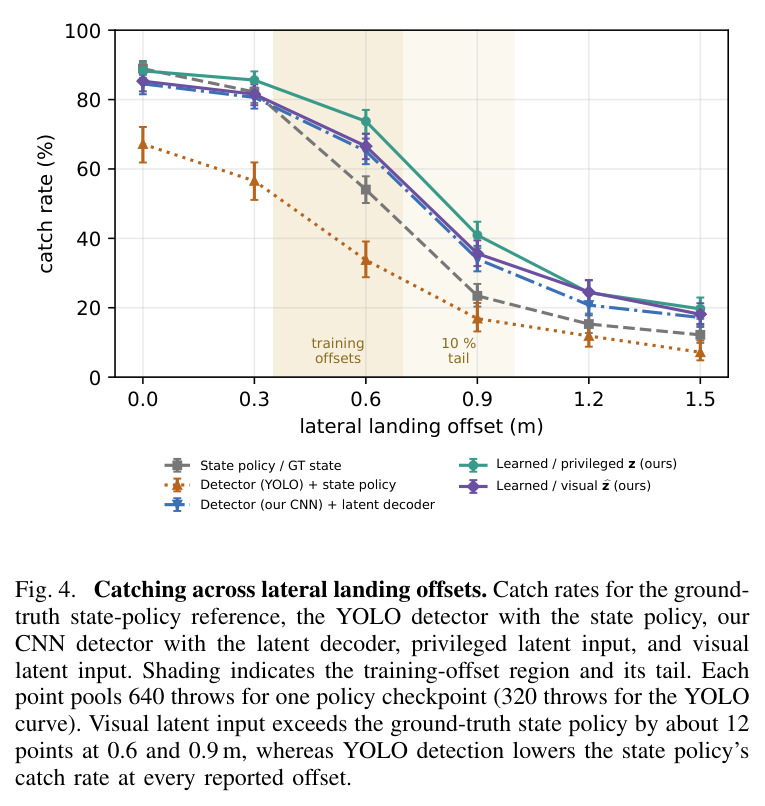
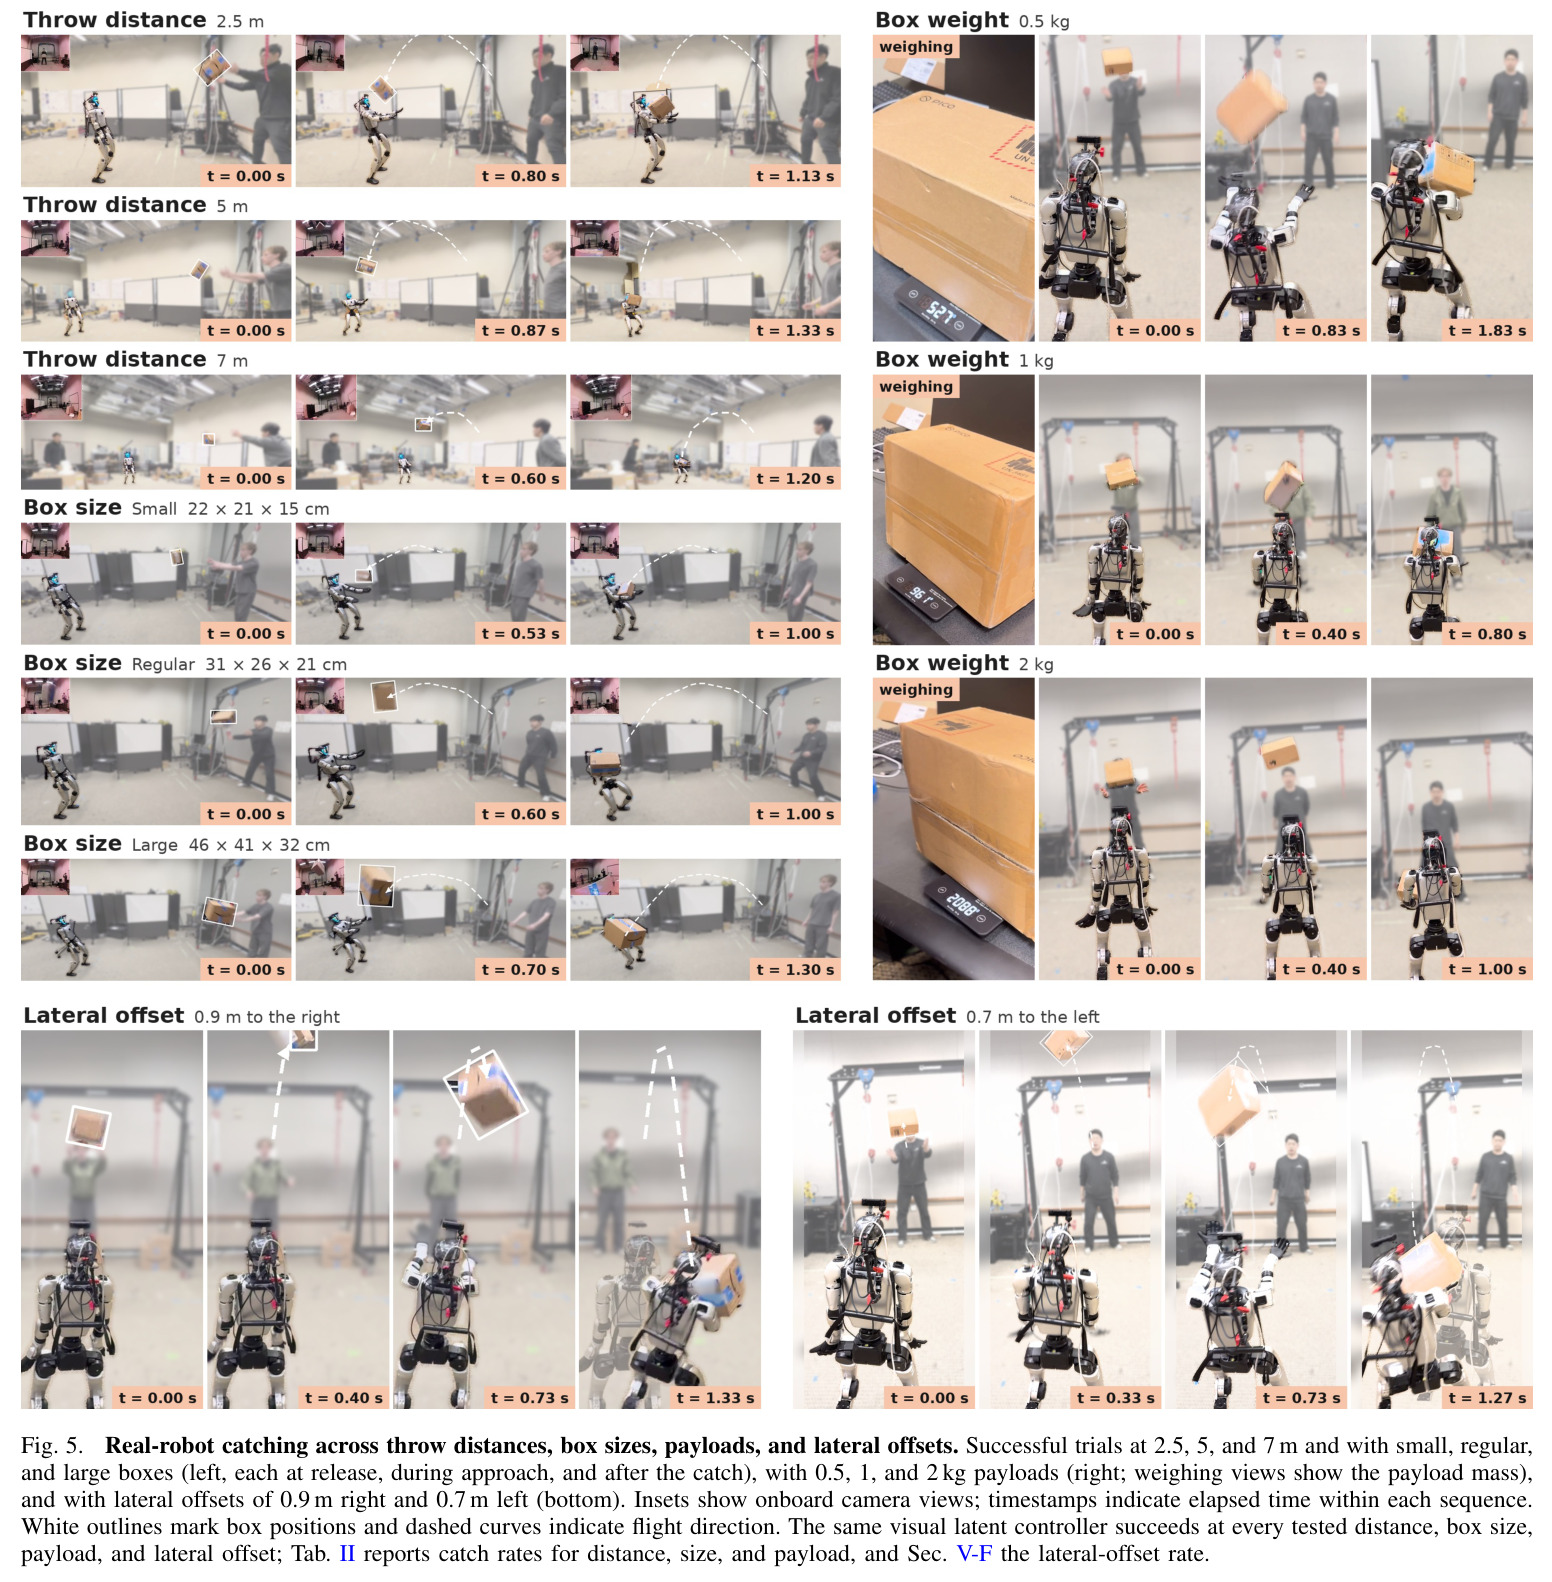
仿真(Q1):视觉版 Reflex 在 3840 次抛掷中接住 3290 次(85.7%),特权 latent 输入同一解码器为 87.9%,视觉化仅损失 2.2 点。逐因素扫描(Table I):常规箱 88.8%,0.5/1/2 kg 载荷 91.2%/89.7%/77.7%,与状态策略持平;但小箱/大箱仅 25.5%/39.7%,对应拦截率却高达 58.1%/86.1%,暴露「尺寸失明」——身体到位却保不住。侧向偏移(Fig. 4)最亮眼:0.6/0.9 m 偏移下视觉成功率 66.6%/35.6%,反超真值状态策略的 54.1%/23.4% 约 12 点,证明收益来自 Stage 2 PPO 精调而非 Stage 1 上限。真机(Table II):常规箱 2.5/5/7 m 成功率 65%/40%/15%,人类参照 85.0%/68.3%/28.3%,即达到人类的 76% 和 59%;小/常规/大箱 20%/65%/45%;载荷 0.5/1/2 kg 为 45%/60%/30%;两侧偏抛 20 次接住 8 次。全身控制消融(Table III):完整目标 88.6%/76.1%(居中/偏移),去掉持握塑形偏移跌至 50.8%,任务奖励全去只剩 33.7%/2.7%,跟踪与 AMP 同去则训练崩溃,从零 PPO 仅 6.7%/0.2%。动力学学习(Q3):动作匹配初始化 +5.2 点(Table VII);延迟随机化在每个延迟档 +5–11 点,60 ms 处 72.7% 对 65.8%(Table IV)。视觉接地(Table V):单帧编码器 -35.6/-39.8 点,去自运动 -10.4/-22.6 点,状态回归替代 latent 回归 -18.7/-19.5 点;颜色增广把蓝/黑箱从 60.2%/61.2% 提到 88.0%/88.8%(Table VI)。同检测器对比中,学习 latent 在 13 个条件上全胜「检测+卡尔曼滤波」5.0–15.6 点。下游链路 20 次试验:接住 65%、搬运后 35%、递交后 30%、返回后 25%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 仿真接箱(3.0–3.5 m,常规箱,3840 抛掷) | 接住成功率 | 85.7%(自中心 RGB-D 视觉输入) | 87.9%(特权 latent 输入同一解码器) | 视觉化仅损失 2.2 个百分点,接近无损 |
| 真机接箱(Unitree G1,2.5 m,20 试/条件) | 接住成功率 | 65% | 人类三人参照 85.0% | 达到人类水平的 76% |
| 真机接箱(Unitree G1,5 m / 7 m) | 接住成功率 | 40% / 15% | 人类参照 68.3% / 28.3% | 分别达到人类的 59%(7 m 处约 53%),7 m 为双方共同瓶颈 |
| 仿真侧向偏移 0.6 m 接箱 | 接住成功率 | 66.6%(视觉 latent) | 54.1%(真值状态策略)/ 33.8%(YOLO 检测+状态策略) | 反超真值策略约 12 个百分点 |
| 视觉编码器消融(居中 / 0.6 m 偏移) | 接住成功率 | 完整编码器 85.2% / 66.6% | 单帧编码器 49.6% / 26.8% | 时序历史贡献 35.6 / 39.8 个百分点 |
| 感知延迟 60 ms(仿真注入) | 接住成功率 | 72.7%(延迟随机化训练) | 65.8%(无随机化训练) | +6.9 个百分点(全部延迟档 +5–11 点) |
| 颜色鲁棒性(蓝色 / 黑色箱) | 接住成功率 | 88.0% / 88.8%(颜色增广后) | 60.2% / 61.2%(无增广) | +27.8 / +27.6 个百分点 |
| Stage 2 初始化方式对比(六控制器均值) | 视觉接住成功率 | 85.7%(动作匹配初始化) | 80.5%(权重映射初始化) | +5.2 个百分点 |
局限与改进
作者承认的局限:长距离视觉接地是主要瓶颈——5 m 抛掷既超出 Stage 3 的 3.0–3.5 m 训练数据,速度又快于任何训练抛掷(训练初速上限约 8.5 m/s,评估放到约 12 m/s),仿真成功率从特权输入的 79.7% 跌到 43.0%,真机 5/7 m 只有 40%/15%;把远抛数据加进 Stage 3 后仿真 5 m 可升至 75.8%,但尚未在硬件上验证。其次,只有单一任务、每条件仅 20 次真机试验,95% Wilson 置信区间宽达约 ±20 个百分点;控制器对箱子尺寸失明,小箱常被拦下却保不住;硬件延迟只在检测器管线上测量且中位数 69 ms 超过了训练随机化的 20–60 ms 范围;渲染未建模运动模糊与自动曝光动态。我的补充观察:部分训练出的检查点躯干晃动高达 72%(虽然该检查点接住率 91.7%),说明奖励并未显式约束姿态稳定,长期真机运行存在机械疲劳与安全隐患;下游链路成功率从 65% 逐级衰减到 25%,系统级可用性仍取决于衔接工程而非接箱本身;另外人类基线只有 3 人且「静止站立到抛出为止」,对真实运动中的人类水平估计偏保守。
独立分析的弱点
(1)远距离感知塌陷:Stage 3 只见过 3.0–3.5 m 抛掷,5 m 外的纸箱在 192×144 图像中只占十几个像素,热图定位与几何特征都退化,5 m 仿真掉到 43.0%。改进方向:距离课程学习加多尺度/局部裁剪渲染,或干脆按作者验证过的做法把 2.5–7 m 抛掷直接纳入 Stage 3 数据并上真机。(2)尺寸失明:$z_t$ 不编码尺寸,小箱拦截率 58.1% 但接住率仅 25.5%——身体到了、支撑面却合不拢。改进方向:在特权观测和 latent 中加入尺寸通道,或在接触瞬间用关节力矩/触觉在线估计并调整持握姿态。(3)真机评估统计功效弱:20 次/条件、±20 点区间,0.5 kg 对 1 kg 的差异(Fisher p=0.53)完全无法区分。改进方向:自动抛箱机加半自动评分,把每条件提到 50–100 次。(4)延迟预算错配:训练随机化 20–60 ms,真机检测器管线中位 69 ms、p95 90.2 ms,已落在训练范围之外。改进方向:把随机化上限提到 100 ms 以上,或换更轻的检测头、事件相机来压缩曝光到控制的延迟。(5)姿态稳定未约束:不同种子训练出的检查点躯干晃动从 1% 到 72% 不等,随缘性太强。改进方向:把躯干晃动作为 PPO 约束项(拉格朗日方法)或在奖励中显式惩罚。(6)下游衔接脆弱:65%→35%→30%→25% 的衰减主要发生在交接瞬间。改进方向:联合训练「接住-持握-步行」的切换策略,或让 SONIC 读取接箱控制器内部的保持状态作为共享接口。
未来方向
作者明确提出的方向:把「感知-动力学-控制」三段分解推广到更广的视觉反应式全身技能族——拦截、躲避、交接、物理辅助(如扶住倾倒的物体),latent 接口让换任务只需换控制器而保留已学好的感知模块。基于本文成果可以延伸:(1)把远抛数据纳入 Stage 3 并真机验证 5–7 m 场景(仿真已显示 5 m 可回升到 75.8%);(2)让 $z_t$ 从「描述当前动力学」升级为「显式预测未来轨迹与落点」,从而支持脚步的预规划而不只是手臂反射,这对 7 m 快速球是刚需;(3)物体泛化:把专用热图检测换成开放词汇检测器,测试 latent 接口对球、瓶等任意几何体的迁移能力;(4)感知端引入事件相机或音频线索进一步压缩延迟;(5)用视频生成或世界模型合成多样化抛掷来增广 Stage 3 数据,替代人工抛掷的数据瓶颈;(6)把躯干稳定、最小冲击力等人机共存安全指标写进目标函数,走向仓库抛接件、递送交接这类真实作业。整体看,这篇论文给出的「latent 接口 + 冻结解码器」是一个可以横向复用的骨架,值得在其他全身技能上验证其通用性。
复现评估
算力门槛出人意料地低:全部训练在单张 RTX 3090 上完成。渲染无关的 Stage 2 PPO 以约 28k 步/秒运行,5900 万步只需约 35 分钟;真正昂贵的 RGB-D 渲染只出现在 Stage 3(约 160 万步,1.5k 步/秒);热图 CNN 预训练 20 epochs(batch 32,lr 3e-4),时序 GRU 用 AdamW 训 60 epochs(batch 512,最大 lr 2e-3)。仿真基于 Isaac Lab(物理 200 Hz、控制 50 Hz、4096 并行环境),抛掷、尺寸(25×19×13 / 34×26×22 / 42×32×27 cm 三档)、延迟随机化的设置在论文中给出得相当细。硬件部分需要一台 29 自由度 Unitree G1、躯干安装的 RGB-D 相机,以及能稳定抛箱的人类实验员(人类基线为 3 人 × 每距离 20 次);下游还需 SONIC 步行控制器和一个人体检测模块。需要注意的是:论文正文未提及代码、模型或抛掷数据集的开源,真机复现者需自建抛掷与评分协议——好在接住/拦截/躯干晃动的判据在文中定义得很细(胸口支撑、双腕对侧、0.6 s 低速保持等),可操作性强。总体评估:仿真管线复现难度中等(主要门槛是 Isaac Lab 与 AMP 动作重定向的工程经验),真机复现难度高。
论文图表
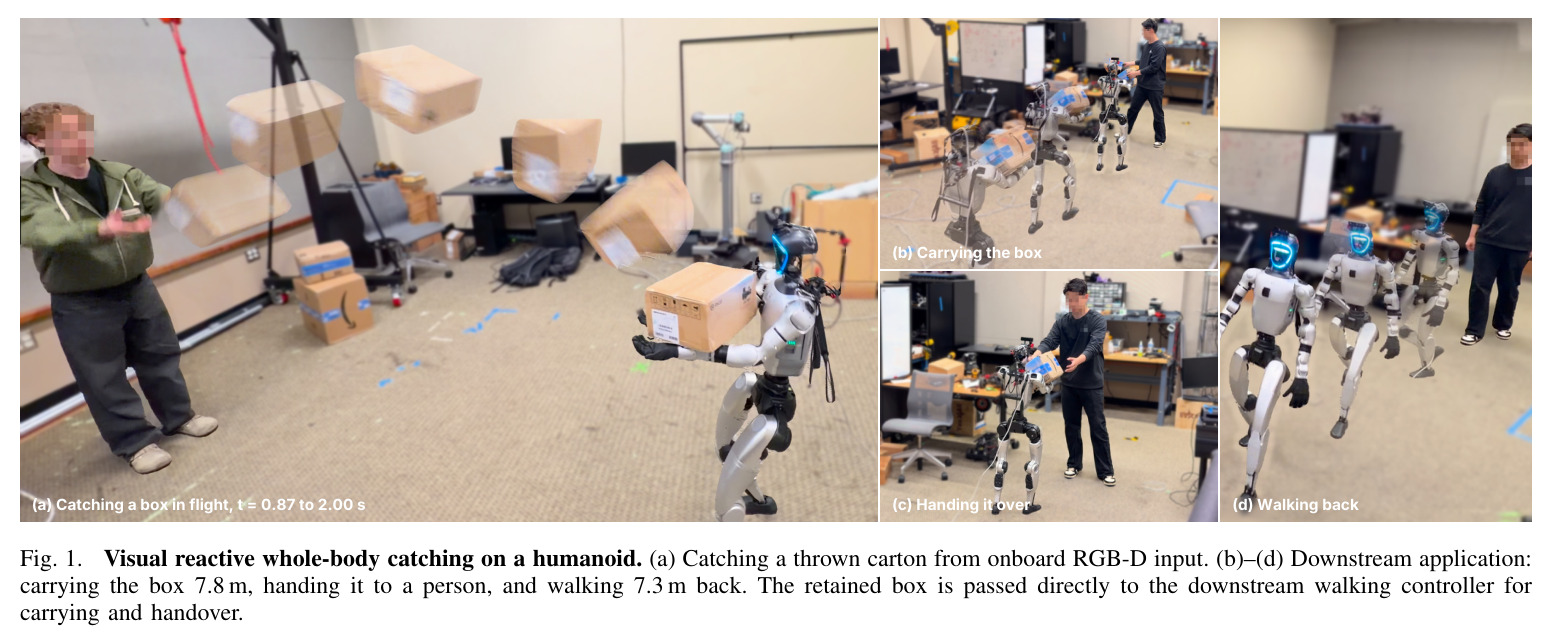
展示完整任务闭环:(a) 机器人从机载 RGB-D 输入接住抛来的纸箱(t=0.87 到 2.00 s);(b)–(d) 下游应用——抱着箱子走 7.8 m、把箱子递给一个人、再走 7.3 m 返回。接住的箱子被直接传给下游步行控制器。
这是论文的定场图:一眼看清「接住-搬运-递交-返回」的完整任务定义和真实效果,也界定了 Reflex 控制器与下游 SONIC 控制器的分工边界。
逐因素扫描七个控制器配置的接住率与拦截率(每条件 640 次抛掷):特权箱态输入(Stage 1 真值 / Stage 2 特权 latent)与机载 RGB-D 输入(YOLO 检测、自有 CNN 检测、latent 解码器、本文视觉 latent)。本文视觉版在常规箱 88.8%、0.5–2 kg 载荷 77.7–91.2%,小箱/大箱 25.5%/39.7%(拦截 58.1%/86.1%),5/7 m 43.0%/13.3%。
这是仿真鲁棒性的主表:既能看出视觉版接近特权输入的整体水平,也能精确定位两个失效模式——尺寸失明(拦截与接住率的巨大差距)和远距离塌陷,是后续讨论的数据来源。
真机 20 次试验/条件的接住率对比:G1 在小/常规/大箱为 20%/65%/45%,0.5/1/2 kg 载荷为 45%/60%/30%,2.5/5/7 m 为 65%/40%/15%;人类参照(3 人、每条件 60 次)为 75%/85%/78.3%、85%/86.7%/76.7%、85%/68.3%/28.3%。G1 达到人类成功率的 76% 和 59%(2.5/5 m),95% Wilson 区间约 ±20 点。
这是论文的旗舰结果表:首次给出真机人形用机载视觉接箱的量化成功率,并以人类抛接表现为参照系,让「接近人类水平」这一说法有据可查。
从共享初始化出发移除 Stage 2 PPO 的各奖励组:完整目标 88.6%/76.1%(居中/0.6 m 偏移);仅初始化不 PPO 为 75.3%/44.2%;去掉成功奖励 87.8%/71.8%,去掉接近塑形 82.8%/68.2%,去掉持握塑形 83.9%/50.8%,三个任务组全去 33.7%/2.7%;去掉跟踪或 AMP 单项损失 4–5 点(不显著),同时去掉则训练崩溃;从零开始 PPO 仅 6.7%/0.2%。
它精确刻画了「会接箱」这件事由哪些奖励成分支撑:持握塑形主导偏移场景的保持能力,任务奖励组缺一不可,运动先验是训练不崩溃的前提,回答了 Q2 的前半部分。
上半部分为硬件延迟实测(1274 次箱体测量、约 33000 控制节拍):相机曝光到 YOLO 输入 p50 50.1 ms,YOLO 推理 8.2 ms,曝光到控制节拍 p50/p95/p99 = 69.1/90.2/94.1 ms,控制周期 20 ms。下半部分为仿真注入额外延迟的接住率:延迟随机化版在 0–160 ms 为 88.4/87.2/83.0/72.7/60.9/32.3/19.7%,无随机化版全面低 5–11 点。
延迟是反应式控制的核心约束:它量化了真机感知管线的时间预算,并证明「训练时随机化延迟」让控制器学会补偿它被训练的那档延迟,直接支撑了真机 65% 成功率的可信度。
视觉编码器消融(居中/0.6 m):特权 latent 参照 87.9/74.3;完整视觉 85.2/66.6;去掉自运动 74.8/44.0;单帧(无时序历史)49.6/26.8;只用教师滚出(无 DAgger)86.2/67.6;去掉箱态辅助损失 85.0/70.3;去掉热图监督 77.8/55.7;用状态回归替代 latent 回归 66.5/47.1。
回答 Q4 的核心证据表:时序历史(-35.6/-39.8 点)和自运动(-10.4/-22.6 点)是视觉接地的两大支柱,latent 回归优于状态回归,同时也诚实呈现了 DAgger 与辅助损失在仿真中无显著增益的阴性结果。
固定解码器,对比有无颜色增广时七种外观的接住率:蓝箱 60.2→88.0,黑箱 61.2→88.8,白箱 78.0→87.0,灰箱 78.8→88.9,红箱 87.3→88.8,绿箱 83.3→87.8,纸箱色 87.0→87.8。增广后七色全部收敛到 87.0–88.9% 区间。
直观展示视觉鲁棒性的一个具体杠杆:仅靠训练时的颜色增广就能消除对训练色(纸箱色)的严重过拟合,对任何做 sim-to-real 视觉的人都是直接可复用的结论。
对比两种 latent 初始化(各六控制器,均值±标准差):动作匹配初始化在特权输入下 87.9±3.2、视觉输入下 85.7±3.4;权重映射初始化为 82.8±3.2 与 80.5±2.9。动作匹配平均高出 5.2 点,且视觉增益在六个种子对中五个成立。
它验证了「先用教师动作把 latent 接口立起来、再做联合 PPO」这一初始化设计的必要性,是方法章中动作匹配 BC(Eq. 4)与其效果之间的关键证据链。