CoDance:从视频学习反应式与柔顺的人-人形机器人交互 CoDance: Learning Reactive and Compliant Human-Humanoid Interaction from Video
从一段双人舞视频学会让机器人跟随真人舞伴并柔顺共舞
前置知识
全身运动模仿与对抗运动先验(AMP)
运动模仿让机器人跟踪参考动作,常用指数核 $\exp(-e^2/\sigma^2)$ 惩罚跟踪误差(DeepMimic 一脉);AMP 则训练判别器区分策略 rollout 与专家的两帧转移,用对抗奖励复现动作风格。两者分别对应本文 whole-body tracker 与 decoupled 策略两种步法风格来源。
本文把“步法风格”显式解耦为可替换的 locomotion 目标,不懂这两种范式就看不懂 Table III 的对照实验设计。
阻抗控制与柔顺性(compliance)
机器人不对抗外部接触力,而是像弹簧一样让末端产生与力成正比的位移:$\delta = f/K$,刚度 $K$ 越小越柔顺。SoftMimic 把这种准静态柔顺求解引入学习框架,在参考动作上叠加采样的力事件生成“适应参考”。
本文的多连杆柔顺增广直接构建在 SoftMimic 之上,核心公式与刚度采样范围(10-1000 N/m)全部继承自这一思想。
PPO 与 GPU 并行仿真训练
近端策略优化(PPO)是人形机器人策略学习的主力算法,配合 MuJoCo 物理仿真与 mjlab 框架可在上万个并行环境中大规模采样,数小时收敛。
本文在 16384 个并行环境、50 Hz 控制率下训练,单张 L40S 上 29-37 小时收敛,理解该设置才能评估复现成本。
SMPL-X 人体恢复与运动重定向
SMPL-X 是带手部的参数化人体网格模型;PromptHMR 等方法能从单目视频恢复人体的 SMPL-X 运动序列,GMR 等重定向方法再把人体运动映射为特定人形机器人的关节参考轨迹。
这是 CoDance 数据管线第一步:两位舞者的运动分别重建、分别重定向,才能拆成机器人参考与舞伴代理两个角色。
Sim-to-real 与域随机化
在仿真中随机化躯干质心偏移(x ±0.025 m、y/z ±0.05 m)、脚底摩擦(0.3-1.2)、关节编码器偏置(±0.01 rad)与观测噪声,使策略部署到真机时对模型误差鲁棒。
论文真机零摔倒的结果依赖这套随机化(Table VII),它是理解训练设置与部署差距的关键。
研究动机
现有人形机器人运动模仿几乎都面向「单机器人」场景:跟踪一条运动参考或速度指令,把外部接触当作扰动来抵抗。但与人共舞是持续的双向物理耦合——两位舞者通过观察和双手接触不断交换力,机器人必须协调脚步跟随移动的舞伴、响应通过手传递的交互力,同时保持平衡与自然的步法风格,这与「偏差即跟踪误差」的传统目标直接冲突。已有舞蹈机器人各有硬伤:Ms DanceR(2003)靠全向底盘的力传感跟随,模型方法靠接触力做 box step,学习方法要么只生成单人舞蹈动作、要么在速度指令下手拉手跳舞;柔顺控制方面 SoftMimic 只扰动单个连杆、GentleHumanoid 只学上半身引导力,都不覆盖「跟随移动舞伴 + 持续双手接触 + 保留步法风格」这一完整问题。
本文的目标是本文目标是提出 CoDance 框架:只给一段约 9.7 秒、两个人跳舞的视频,让 Unitree G1 人形机器人学会与真人伙伴持续共舞。具体有三层要求:其一,反应式跟随——脚步与观察到的舞伴协调(对方进我退、对方退我进),不依赖任何预设速度或轨迹指令;其二,柔顺交互——双手保持连续接触,在指令刚度下对交互力产生恰当的腕部位移与力响应;其三,风格保持——复现视频示范的步法,并在正反方向反复切换的长时程舞蹈中不摔倒、不跟丢。评估上要在仿真中用脚误差、成功率、腕位移比、力误差、下半身跟踪误差等指标分别量化这三个能力,并在真机上验证可持续的双手共舞。
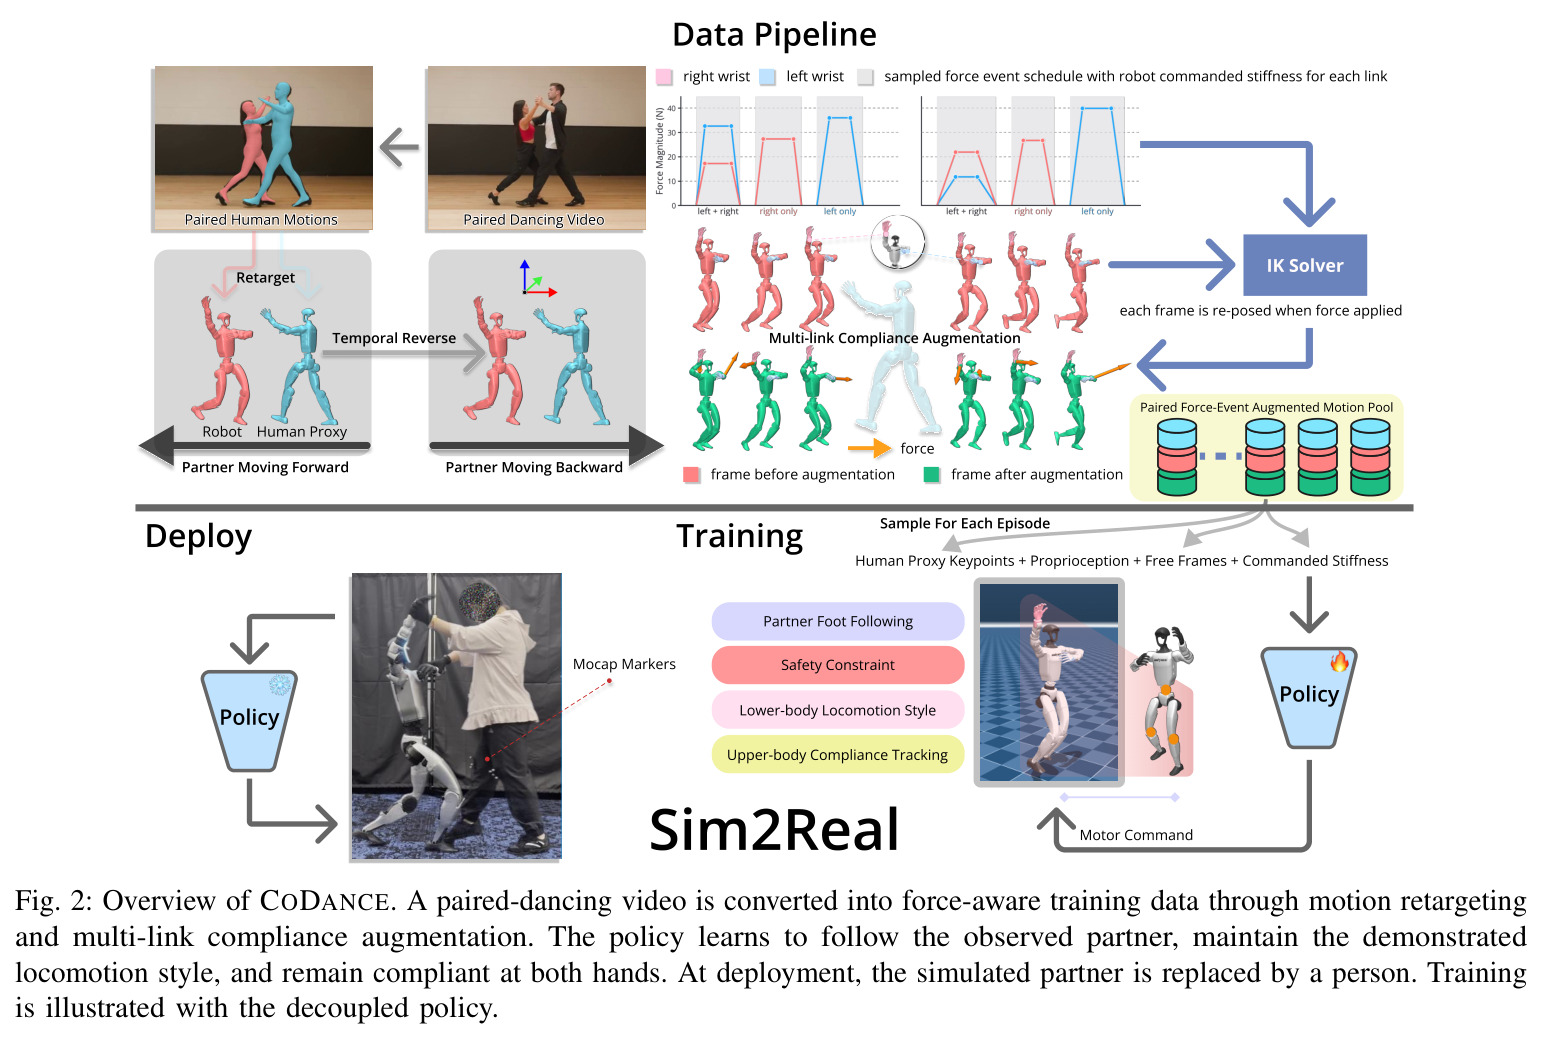
与已有工作不同的是,本文的独特切入点有二。第一是「把一段双人舞视频拆成两个角色」:用 PromptHMR 恢复两位舞者的 SMPL-X 运动后分别重定向,一人作为机器人参考、另一人作为训练中的移动舞伴代理,从而让「跟随谁」与「学什么风格」同时来自同一段真实人类交互数据,而非人工编排的轨迹。第二是「视频只给运动不给力」:作者提出多连杆柔顺增广,在双手腕上按 ramp-hold-release 曲线注入结构化力事件,用全身逆运动学把无力的运动学示范改写成力感知训练数据,且力方向由舞伴速度引导、力大小受质心平衡预算约束。这使柔顺性第一次直接服务于双人步法协同,而不是像 SoftMimic 那样仅把单连杆扰动当作抗扰训练。
核心方法
直觉上,想让机器人会共舞,训练数据里就必须包含「被舞伴施力时如何让步」的经验,而视频无法提供力。CoDance 分三阶段解决。阶段一(数据管线):输入一段 9.7 秒双人舞视频,PromptHMR 输出两位舞者的 SMPL-X 运动,GMR 分别重定向到 Unitree G1;一位舞者作机器人参考、另一位作舞伴代理,并把片段时间反演以覆盖前进和后退两个方向。阶段二(多连杆柔顺增广):在双手腕上采样力事件,腕部位移 $\delta=f/K$,刚度 $K$ 在 10-1000 N/m 对数均匀采样、力上限 140 N、位移上限 0.15 m,用全身逆运动学生成适应参考;最终得到 400 条片段(200 条含力事件、200 条无力),各带力时刻表。阶段三(策略训练与部署):PPO 在 MuJoCo/mjlab 中以 16384 个并行环境、50 Hz 控制率训练,奖励由舞伴跟随、柔顺、步法风格与正则化四项组成,单张 L40S 上约 29-37 小时收敛,随后直接部署到真机,无需微调。
核心创新是「舞伴感知的多连杆柔顺增广」加「无速度指令的跟随目标」。与 SoftMimic 对单个腕施加独立扰动不同,这里每个力事件先采样交互意图——单手、双手同向、镜像张开、对向扭转、双向推拉——决定接触哪些腕以及位移如何耦合,再由舞伴平滑速度(0.4 s 窗口、下限 0.1 m/s)设定推力方向(85% 概率沿舞伴运动方向),配合方向抖动 0.4;最后事件整体缩放,使质心偏移不超过 0.10 m 的平衡预算。跟随目标也不同:不给予速度指令,而是奖励每只脚靠近舞伴对侧脚后方 0.5 m 的目标点 $r_{foot}=\sum_{s\in\{L,R\}}\exp(-\|x^t_s-\bar{c}^t_s-o\|^2/\sigma_f^2)$,步法完全由稀疏舞伴关键点(骨盆+双膝)驱动。此外风格与交互解耦:对抗式 AMP 或下半身参考跟踪都可作为 $r_{style}$,同一数据训练出两种策略,证明框架与具体策略设计无关。
方法步骤详情
第一步,视频到成对片段:PromptHMR 从双人舞视频重建两位舞者 SMPL-X 运动,GMR 分别重定向为 G1 参考运动;因分别重定向不保留相对位置,训练时以固定偏置摆放舞伴代理,并把 9.7 s 片段时间反演。第二步,柔顺增广:每 0.5-1.5 s 采样事件,交互意图决定接触腕与位移耦合;每腕采样刚度 $K$ 与位移 $\delta\sim U(0.03,0.15)$ m,$f=K\delta$ 不超 140 N,方向由舞伴速度引导;随后解全身 IK(脚固定、质心约束),不可行则腕力朝外或缩小重解,产出 400 条带力时刻表片段。第三步,策略训练:actor 观察本体感知、过去 1 s 舞伴骨盆与双膝、每腕指令刚度,不观察适应参考与施加力;总奖励 $r_t=r_{partner}+r_{comp}+r_{style}+r_{reg}$,其中上肢柔顺项 $r_{arm}$ 以躯干为锚跟踪肩、肘、腕的适应参考,消除全局位移影响;链式拼接支持 20 s 长时程。第四步,部署:G1 以 50 Hz 运行、200 Hz 下发目标,Vicon 提供舞伴骨盆与双膝,腕刚度 140 N/m。
技术新颖性
新颖性有四点。第一,数据层面把柔顺性变成可自动生成的属性:不依赖任何带力传感器的人机演示,用准静态柔顺求解($\delta=f/K$)把无力的视频示范批量转成力感知数据,400 条片段全流程自动产出,这是从 SoftMimic 单连杆扰动到「耦合多连杆、舞伴引导方向、平衡预算约束」的实质推广。第二,跟随目标设计:用对侧脚 0.5 m 偏置的脚-脚奖励取代速度/轨迹指令,策略只靠 9 维舞伴关键点决定步法,消融显示遮蔽舞伴后成功率从 99.6% 跌至 0%,证明跟随确实由观察驱动而非回放参考。第三,风格与交互解耦:同一数据同时训出 AMP 风格策略与参考跟踪策略,二者跟随与柔顺指标几乎一致(力误差 7.8 对 7.7 N),表明框架与策略设计正交。第四,片段链式拼接让 9.7 秒短片撑起 20 秒跨方向长时程训练,无该机制时成功率从 97.6% 降至 48.0%。
实验结果
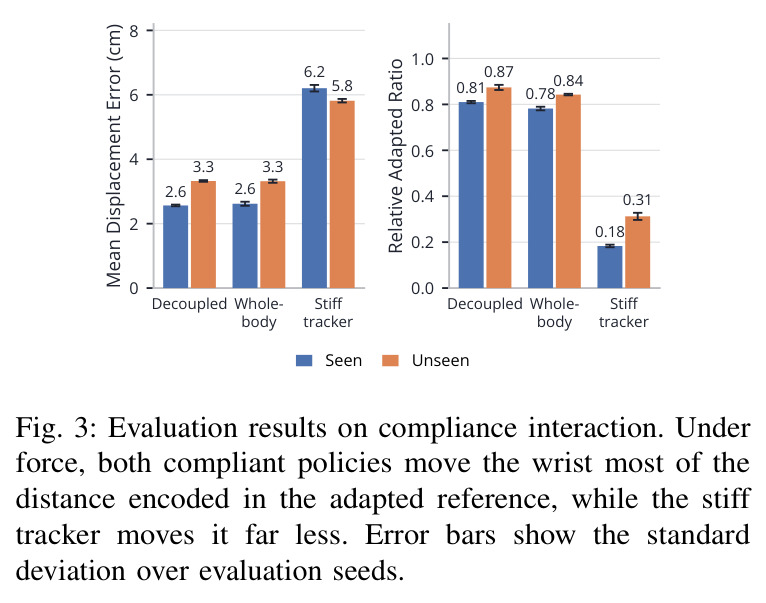
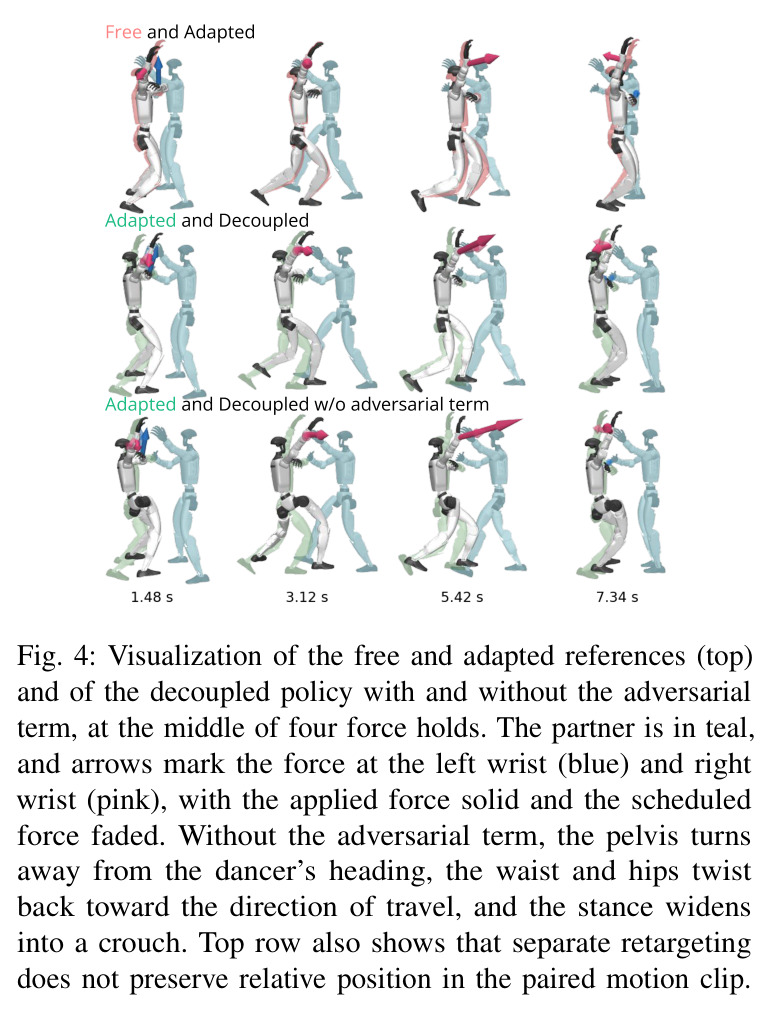
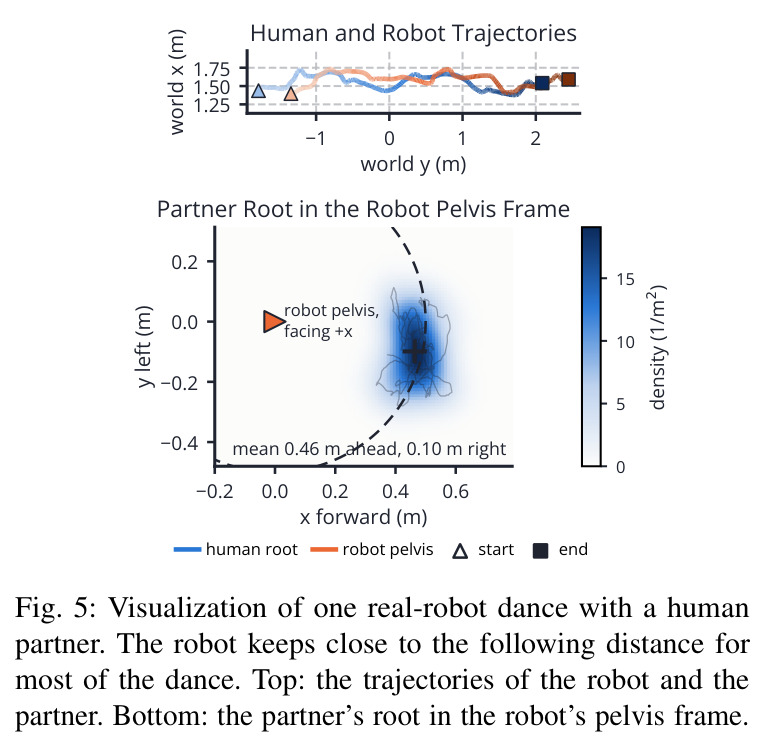
跟随(Table II):Decoupled 观察正常时脚误差 0.057 m、成功率 99.6%;遮蔽舞伴后 0.421 m、0%;反演后 0.267 m、28.6%;Whole-body 类似(0.072 m/99.7%,反演 0.255 m/24.3%);去脚约束误差升至 0.179 m(约 2.5 倍)。柔顺(Fig. 3):两柔顺策略腕位移达适应参考约 80%(seen 比值 0.84/0.81、误差 2.6 cm),刚性基线仅约 20%(0.18、5.8 cm);unseen 上柔顺误差仅增不到 1 cm。风格(Table III):whole-body 下半身跟踪最佳(R-MPKPE 0.069 m、R-MPKRE 0.197 rad),去 AMP 后旋转误差扩 2.6 倍(0.587 rad),而脚/力误差几乎不变(0.072 m、7.8 对 8.8 N)。链式拼接(Table IV):成功率 97.6% 对 48.0%。真机:G1 三次共舞零摔倒,两次 38.9 s 往返中根距离 93%/83%/73% 时间保持 0.5 m±0.1 m,行程约 3.8 m。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 舞伴跟随(仿真,Table II) | 1 秒脚误差 / 片段成功率 | Decoupled 0.057 m / 99.6%;Whole-body 0.072 m / 99.7% | 无脚约束 Whole-body 0.179 m / 99.6%;遮蔽舞伴 0.421-0.430 m / 0% | 脚误差约为无约束基线的 1/3,且证明跟随完全依赖舞伴观察 |
| 柔顺腕部交互(仿真,Fig. 3) | 相对适应参考位移比 / 平均位移误差 | 两个柔顺策略 seen 约 0.84/0.81,误差 2.6 cm;unseen 误差 3.3 cm | 刚性跟踪器 0.18,误差 5.8 cm(seen) | 位移比约提升 4 倍,位移误差降低约 55% |
| 下半身步法风格(Table III,有力片段) | R-MPKPE / R-MPKRE | Whole-body 0.069 m / 0.197 rad;Decoupled 0.089 m / 0.225 rad | Decoupled 去掉 AMP 项 0.143 m / 0.587 rad | 位置误差降至约 1/2,旋转误差降至 1/2.6 |
| 长时程正反方向切换(Table IV) | 双片段链成功率 | 带链式训练 Decoupled 97.6%(Whole-body 96.2%) | 无链式训练 48.0% | +49.6 个百分点,且脚误差基本不变(0.073 对 0.076 m) |
| 真机双手共舞(Unitree G1 + 真人) | 根距离保持 0.5 m±0.1 m 的时间比例 / 摔倒次数 | 三次运行 93%/83%/73%,零摔倒,行程约 3.8 m(12.8 s 与两次 38.9 s) | 无直接可比基线(首批从单视频学习的人形双手共舞演示) | 首次在真机验证了视频学习 + 柔顺增广的可行性 |
局限与改进
作者承认的局限:目前只用 1 段视频、1 种舞步;仿真舞伴只会回放固定运动,交互力全部来自增广而非真实测量;策略仍依赖参考片段,舞伴反向移动时仅约四分之一试验能完成片段(Table II 反演条件 24.3-28.6%);脚跟随目标把机器人固定在舞伴单方向 0.5 m 偏置处,尚未覆盖升降、转身与 box step。我的补充观察:第一,真机感知依赖 Vicon 动捕标记提供舞伴骨盆与双膝关键点,缺少视觉闭环,离「随便找个人共舞」还有距离;第二,固定偏置意味着机器人只能被动跟随、不能领舞或变换队形;第三,真机仅 3 次运行,样本量小、统计意义有限;第四,数据生成假设准静态柔顺($\delta=f/K$),忽略动态惯量与接触瞬态,快速交互下适应参考可能失真;第五,腕部力用弹簧模型 $f_t=K_{env}(x^*_t-x_t)$ 回放,与真人手部真实力-位移特性的差距未被单独量化。
独立分析的弱点
弱点一:舞伴感知依赖 Vicon 动捕。真机实验靠 Vicon 提供舞伴骨盆与双膝关键点,实际使用必须换相机实时人体估计,遮挡与延迟会直接破坏跟随(训练时仅加了 ±0.25 的观测噪声)。改进方向:用 PromptHMR 类模型蒸馏实时关键点估计器,并在训练中系统性加入遮挡与延迟增强。弱点二:反向跟随能力薄弱。反演条件下成功率仅 24-29%,说明策略学的是「参考+舞伴」联合分布而非纯粹反应式跟随。改进方向:扩充多方向、多相对位姿的训练视频,或将参考相位显式条件化以支持重定时。弱点三:固定 0.5 m 偏置与单方向行进,舞蹈形态受限,且未探索角色切换。改进方向:把偏置与朝向做成可指定参数,引入领舞-跟随切换机制。弱点四:准静态力模型。$\delta=f/K$ 忽略惯性,接触快速变化时适应参考可能不可行。改进方向:在增广中改用动态接触仿真替代 IK 位移,或对事件加入速度/加速度约束。弱点五:工程链路复杂,需要 16384 并行环境、单卡 29-37 h 训练加上动捕与真人舞伴,复现门槛高,不利于社区快速迭代。
未来方向
作者提出的方向:研究升降、转身与 box step 等更复杂舞步;把柔顺增广扩展到任意可选连杆,覆盖更一般的人-人形物理交互。基于本文成果可延伸的方向:其一,用实时视觉人体估计替换 Vicon,并加入对舞伴意图(提速、停顿、变向)的预测——补充视频已展示人类中途暂停时的行为,值得系统量化;其二,学习可变的相对位姿与角色切换,让机器人也能「领舞」而不仅是固定偏置跟随;其三,把多连杆柔顺增广推广到遥操作、协作搬运等 loco-manipulation 任务,因为「从无力视频生成力感知数据」的思路对所有持续接触任务通用;其四,混合多段视频、多舞种训练,检验风格可控性(同一框架下切换不同舞步风格);其五,把每腕固定指令刚度(真机 140 N/m)推广为在线估计的可变柔顺参数,自动适应不同舞伴的力量与习惯;其六,探索多机器人编队共舞,检验跟随目标的可扩展性。
复现评估
复现难度较高。论文未声明开源代码或数据,仅有项目页 https://generalroboticslab.com/CoDance 与补充视频。硬件上需要 Unitree G1 人形机器人和 Vicon 动捕系统(提供舞伴与机器人骨盆、双膝关键点),这是最大门槛。算力方面仿真部分实验室级即可承担:PPO + MuJoCo/mjlab,16384 并行环境、50 Hz 控制,单张 NVIDIA L40S 上 Decoupled 约 37 h、Whole-body 约 29 h。软件栈全为公开组件:PromptHMR(SMPL-X 重建)、GMR(重定向);增广算法在 Algorithm 1 与 Table I 中给出完整超参数($K\in[10,1000]$ N/m、力上限 140 N、平衡预算 0.10 m、每方向 100 条有力 + 100 条无力片段),Table V-VII 详列奖励权重、观测维度与随机化设置,细节披露相当充分。总体评估:仿真复现中等偏难(需自行拼装数据管线并训练两个策略),真机复现困难(人形硬件 + 动捕 + 真人舞伴缺一不可),适合作为方法参考而非直接复跑目标。
论文图表
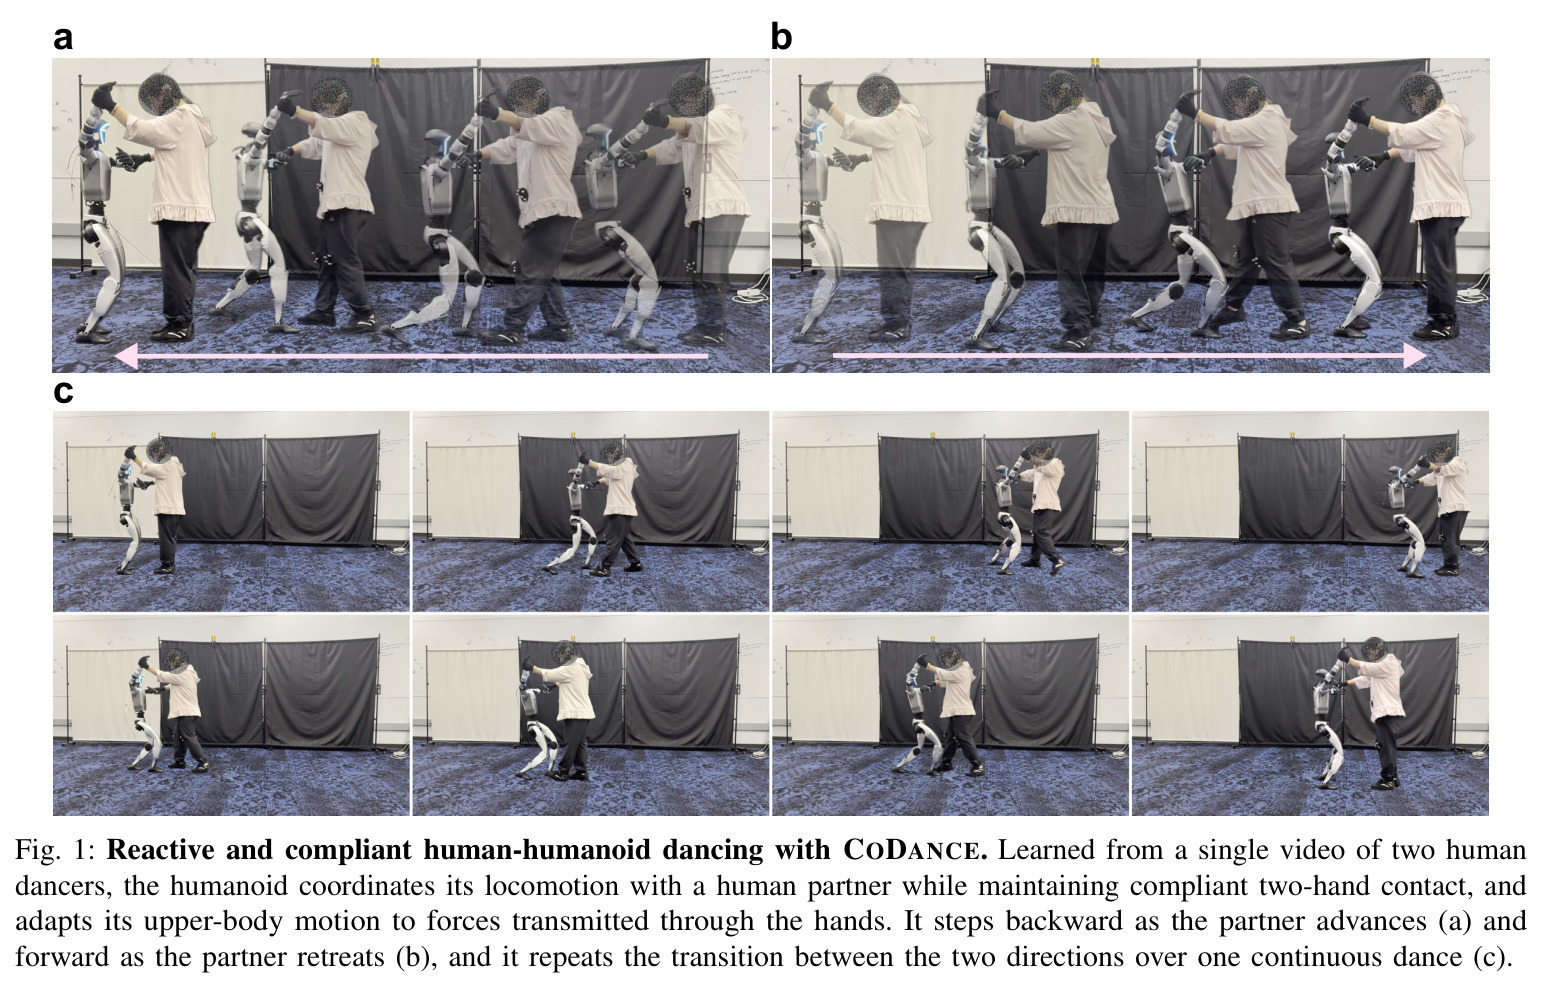
真机演示图:从仅一段双人舞视频学习后,人形机器人与人类舞伴双手相扣共舞,舞伴前进时机器人后退(a)、舞伴后退时前进(b),并在一段连续舞蹈中重复正反方向切换(c),手臂随交互力柔顺调整。
一张图定义了任务本身:反应式跟随 + 柔顺双手接触 + 长时程方向切换,是读者建立直觉和判断结果价值的第一入口。
柔顺增广全部超参数:刚度 K 对数均匀 10-1000 N/m、力上限 140 N、位移上限 0.15 m、平衡预算 0.10 m、五种交互意图概率(single 0.25、oppose 0.075、along/open/twist 各 0.225)、推力概率 0.85、方向抖动 0.4、ramp/hold 时长分布等。
复现数据生成的关键清单,配合 Algorithm 1 可以完整重建力感知数据管线。
舞伴观察(正常/遮蔽/反演)与脚约束消融:Decoupled 观察时脚误差 0.057 m、成功率 99.6%;遮蔽后 0.421 m、0%;反演后 0.267 m、28.6%;无脚约束 whole-body 误差 0.179 m 但成功率仍 99.6%。
证明跟随由观察到的舞伴驱动且脚-脚奖励必要,是「反应式跟随」主张的核心消融证据。
三种运动目标的下半身/上半身跟踪误差、力误差、脚误差与根距离对比:whole-body 下半身 R-MPKPE 0.069 m 最佳,去 AMP 后下半身旋转误差 0.587 rad,而三者的脚误差(约 0.072 m)、力误差(7.7-8.8 N)、上肢误差几乎相同。
证明步法风格来自 locomotion 目标且可替换,而跟随与柔顺对其不敏感,支撑框架与策略设计解耦的主张。
片段链式拼接消融:带链式训练的 Decoupled 成功率 97.6%、脚误差 0.073 m;无链式仅 48.0%、脚误差 0.076 m;whole-body 带链式 96.2%。
量化链式机制对长时程方向切换的价值:不损失跟随精度的情况下成功率翻倍。
两个策略的完整奖励表:跟随(脚-脚 0.5 m 偏置、air-time)、上肢柔顺(位置/姿态/力矩匹配)、下半身(AMP 判别器或参考跟踪)、正则化(动作速率、关节限位、自碰、舞伴身体接触 -25 等),含各项权重与参数。
奖励设计是本文可复现性的核心,表中权重和 σ 值可直接用于复现训练。
两个策略共享的观测表:本体感知(5 步历史)、过去 1 s 的舞伴骨盆与双膝(9 维、50 步历史、噪声 ±0.25)、每腕指令刚度、参考锚点与关节状态等,并区分 actor/critic 可见项;网络为 512/256/128 MLP。
说明 actor 刻意不观察适应参考与施加力,只能靠指令刚度和本体感受响应外力——这是理解柔顺泛化机制的关键。
域随机化(躯干质心偏移、脚摩擦 0.3-1.2、编码器偏置 ±0.01 rad)、力回放(环境弹簧、setpoint 帧)、episode 设置(20 s、50 Hz、16384 环境、终止条件:锚点高度低于 0.3 m、朝向偏差超 1.2 rad、脚偏离目标 1.2 m)。
Sim-to-real 成功的训练配置全在此表,是评估复现成本和仿真-真机差距的依据。