真实性与准确性之争:生成建模视角下的事件序列预测 Realism VS Accuracy: Event Sequence Forecasting from a Generative Modeling Perspective
首个兼顾准确性与真实感的事件序列预测基准,揭示二者权衡并用BaryBooster转化SoTA精度
前置知识
时间点过程(TPP)
时间点过程建模事件在连续时间轴上的随机到达:用强度函数 $\lambda(t)$ 描述事件发生的瞬时概率,模型学习历史条件下强度的演化,从而生成未来的时间戳序列。带标记(marked)变体还会预测每个事件的单一离散类型。神经 Hawkes 过程等长期主导这一领域,EasyTPP/HoTPP 等基准都建立在其上。
本文任务是 TPP 向异构特征的泛化,先懂 TPP 才能看清它不覆盖数值+多类别特征这一研究空白。
扩散模型与潜在扩散模型(LDM)
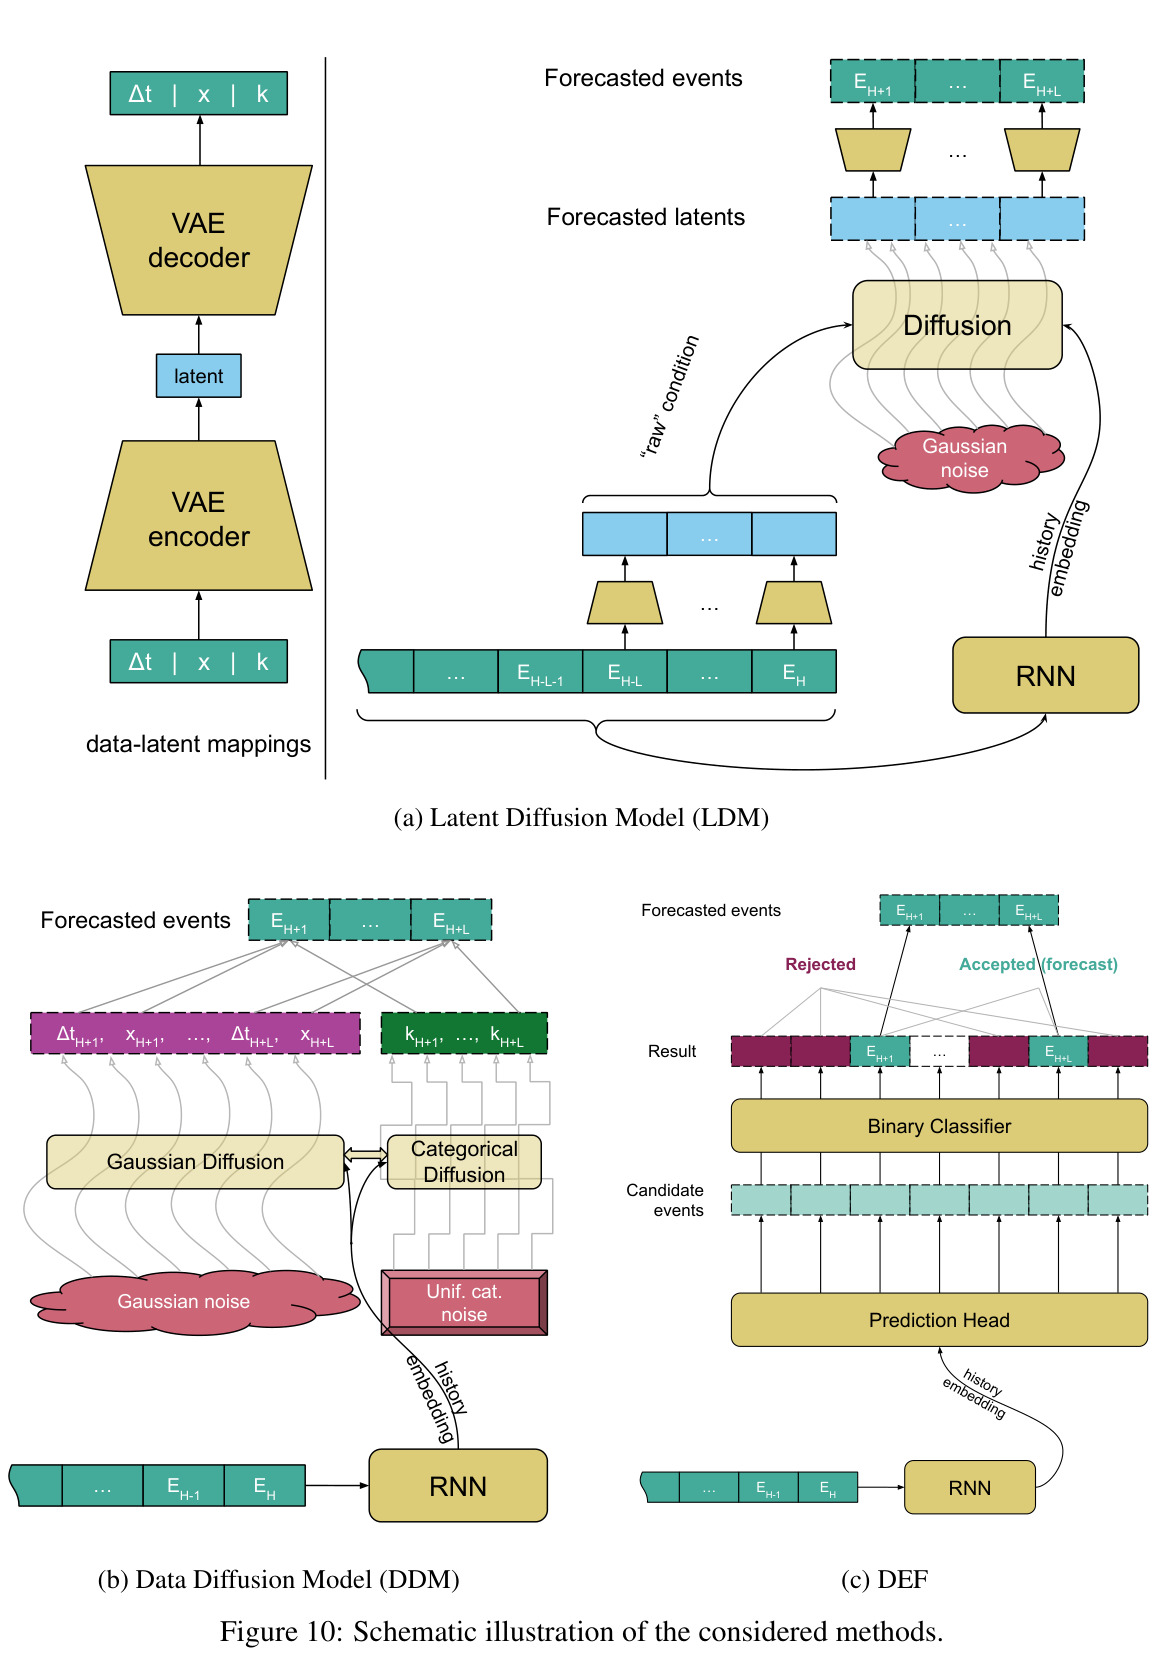
扩散模型通过逐步给数据加噪、再训练网络学习反向去噪,从高斯噪声采样出数据。数据空间扩散(DDM)直接在原始特征上运行;潜在扩散先训练 β-VAE 等自编码器把数据压到低维潜空间,再在潜空间做扩散以提效率。本文的 LDM 由 TabSyn 改造而来,DDM 由 CDiff 改造而来。
LDM 与 DDM 是基准里仅有的高真实感生成模型,也是 BaryBooster 的采样来源,不看懂它们就看不懂主结果。
分类器双样本检验(C2ST)
C2ST 训练一个判别器来区分两组样本:若判别器无法把真实分布的样本与生成分布的样本分开(准确率接近随机猜测 0.5),就认为两个分布相近;判别准确率是分布距离的代理指标。它对任意数据类型都适用,是生成模型真实感评估的经典工具。
本文真实感指标 cDFS 就是 C2ST 的条件化变体:$\mathrm{cDFS}=2(1-\mathrm{AUROC})$,理解 C2ST 才能读懂真实感这一轴。
最优传输与 Wasserstein 重心
最优传输研究把一个分布的质量搬运到另一个分布所需的最小代价,Wasserstein 距离是其量化形式;Wasserstein 重心是一组分布的『平均分布』,即到各分布传输代价之和最小的那个分布。本文把离散样本间的 TMS 传输代价类比重心问题,据此设计 BaryBooster。
『重心≈最居中的样本』这一直觉是理解『为何聚合 N 条生成轨迹能得到更准点预测』的关键。
MASE 与技能分数
平均绝对标度误差(MASE)把模型的 MAE 除以一个朴素基线(如历史均值/复读)的 MAE,得到无量纲分数:等于 1 表示追平基线,小于 1 更准,大于 1 更差。这种基线重标定让金额、时间等量纲不同的特征能放到同一尺度比较,本文 TMS 的每个数值特征分数正是一个 MASE 式技能分数。
TMS 是本文的准确性主指标,不懂基线重标定就看不懂它的定义与数值含义。
研究动机
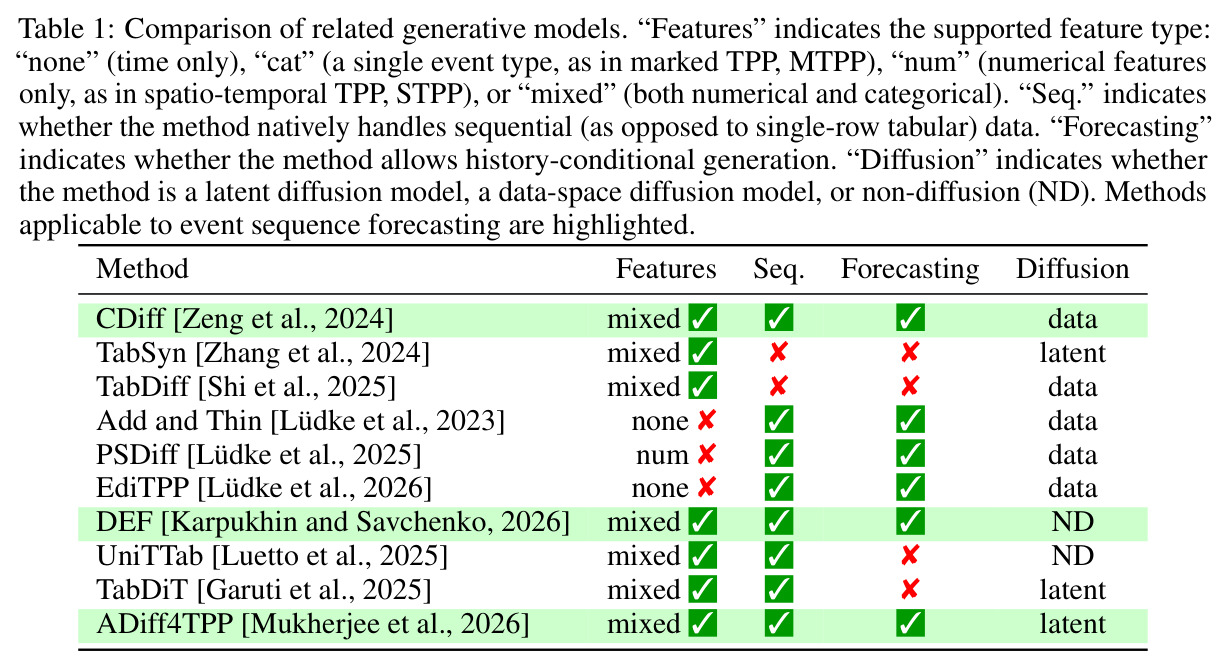
现实世界中大量高风险决策依赖对『事件链』的建模:银行卡的下几笔消费(金额+商户类别码)、患者的下一组诊疗记录、玩家的下一步操作。每个事件由时间戳加一组异构特征——数值特征(如交易金额)与类别特征(如 MCC 码)共同描述。现有最接近的方法族时间点过程(TPP)只能建模事件时间戳,带标记变体也至多支持单一离散事件类型,原生无法处理数值+多类别的异构特征;表格生成模型如 TabSyn、TabDiff 虽能生成异构行数据,却不处理序列结构与历史条件;时空 TPP 只支持数值特征。评估端的问题同样严重:传统指标(时间 MAE、标记准确率、next-event NLL)只衡量单步预测,且被证明与长时程预测质量相关性弱;OTD 依赖手工设定的编辑代价、对排名敏感且无法扩展到数值特征;更根本的是,此前几乎所有评估只问『预测离真实未来有多近』(准确性),完全忽略『预测像不像一个可能真实发生的未来』(真实感)。Figure 1 的赌局例子一针见血:把更可能链的类别与平均金额拼在一起的预测能最小化 MSE、拿到最佳准确性分数,却会输出『乘巴士花 $18』这类两条真实链中都不存在的事件。
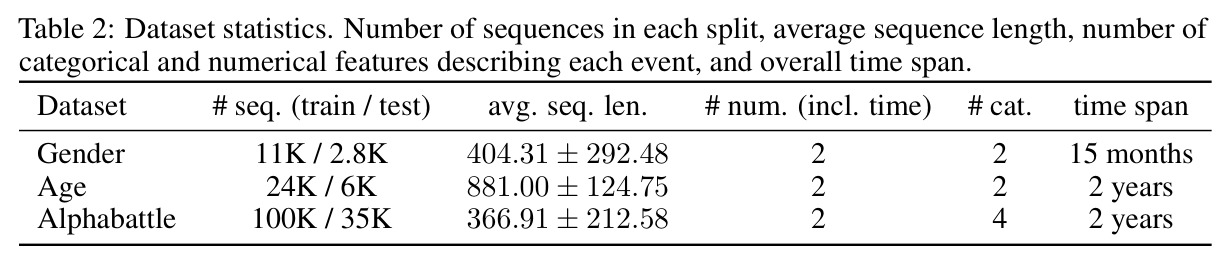
本文的目标是本文的目标是把一般事件序列(含任意数量数值+类别特征)的多时程预测(long-horizon forecasting)形式化为条件生成问题,并建立第一个把『预测准确性』与『分布真实感』同时当作一等公民的评测基准。具体包括:(1) 构建覆盖两种质量维度的指标体系——准确性指标 TMS 与真实感指标 cDFS,弥补 OTD、T-mAP 与经典 C2ST 在异构特征+历史条件设定下的空白;(2) 汇集三个经筛选满足长度、规模、无伪影要求的真实银行卡交易数据集(Gender、Age、Alphabattle),每个事件含时间戳、金额与 MCC 码;(3) 把三类生成范式——潜在扩散(LDM)、数据空间扩散(DDM)、非扩散 SoTA(DEF)——连同统计基线与 GPT 式方法统一适配到该任务上;(4) 在固定 horizon $L\in\{4,16,32,64\}$(主结果 $L=32$)下系统测量准确性与真实感之间的权衡;(5) 提出 Wasserstein BaryBooster,证明生成模型的真实感可以免训练地兑换成 SoTA 级预测准确性。
与已有工作不同的是,最接近的三项基准各有缺口:EasyTPP 与 HoTPP 都限于 marked TPP(单一离散事件类型),且几乎只评准确性;EBES 采用异构事件数据但做的是序列级分类而非预测。生成模型文献中,CDiff 虽支持混合特征+条件预测,却从未在一般事件序列上被系统评测;TabSyn 流行的 Shape/Trend 分数只审计生成行的边际与低阶依赖、忽略时间结构;C2ST 从未以条件于历史的方式用于事件序列。本文的独特切入在于把『真实感』提升为与『准确性』并列的评价轴——在此之前,TPP 及更广事件序列社区的评估几乎完全被准确性指标垄断。作者进一步洞察到,准确性与真实感不是同一目标的两种噪声,而是存在结构性权衡:图 1 所示的『平均化预测』之所以赢得准确性指标,恰恰因为它放弃了分布意义——这正是生成式视角能看见、判别式视角看不见的盲区。抓住『没人同时评这两个维度』的空白,配上『把真实感兑换成准确性』的 BaryBooster,构成了本文区别于所有先前工作的立场。
核心方法
直觉上,『预测未来』其实是两个问题:这条预测离实际发生的未来近不近(准确性),以及它像不像从数据分布中抽出的真实轨迹(真实感)。本文把预测形式化为条件生成:给定历史 $S_{1:H}=(E_1,\dots,E_H)$,其中事件 $E_i=(t_i,x_i,k_i)$ 含时间戳、数值与类别特征,模型生成未来 $L$ 个事件 $S_{H+1:H+L}$。基准从五个方向取代表方法:(1) 统计基线 Repeat(复读最后 $L$ 个事件)、HistSampler(从历史均匀重采样)、Mode(历史众数/中位数);(2) GPT 式解码器 AR(自回归逐步预测)与 MT(一次前向并行输出 $L$ 个事件);(3) 潜在扩散 LDM——β-VAE 把单事件编码到 $R^d$,对 $L$ 事件窗口的潜向量串做高斯扩散,以 RNN 历史嵌入加末 $L$ 个事件潜码为条件;(4) 数据空间扩散 DDM——CDiff 式,数值/时间通道高斯扩散、类别通道均匀类别扩散;(5) 非扩散 SoTA DEF——生成超量候选事件+存在概率,按 Horizon Matching Loss 训练、按 top-$L$ 选择。最后用后处理 BaryBooster 把生成模型的多条采样聚合成一条预测,在 3 个银行卡交易数据集上以 horizon $L=32$ 为主评测。
核心创新有二。第一是评估框架的双轴化:cDFS 用条件化 C2ST——判别器除看候选延续外还可拼接末 $H'$ 个历史事件,因此能抓出『孤立看合理、但与前文矛盾』的生成结果,指标 $\mathrm{cDFS}=2(1-\mathrm{AUROC})$,判别器越能识破越接近 0,完全无法区分则为 1。TMS 则抛弃 OTD 的手工编辑代价:每个数值特征取 MASE 式技能分数 $R^1_m = 1-\text{MAE}/\text{基线MAE}$,每个类别特征取宏 F1,再在 $L\times L$ 特征平均代价矩阵上用匈牙利算法求全体特征共享的最优置换 $\sigma$——时间也参与匹配,顺序对不上自动受罚。第二是 Wasserstein BaryBooster:生成模型给出的是整个未来分布,而点预测只奖励一个样本,这一错配正是图 1 病理的根源。BaryBooster 从基础模型采 $N=30$ 条轨迹,返回 TMS 传输代价的重心 $$\hat{S}^{\star}=\arg\min_{\hat{S}}\sum_{n=1}^{N} d_{\mathrm{TMS}}(\hat{S},\hat{S}_n)$$,把 LDM 的真实感免训练地兑换成 SoTA 准确性。它与普通 reranking 的本质区别在于聚合目标是全体 $N$ 条样本成对距离之和的最小化(离散 Wasserstein 重心),而非按外部打分挑单条最优。
方法步骤详情
方法落地分五步。第一步,问题设定:数据集按时间切分 train/test,horizon $L\in\{4,16,32,64\}$ 固定。第二步,算 TMS:对每个数值特征(含时间)计算 $R^1_m(\sigma)=1-\text{配对MAE}/\text{基线MAE}$(1 为完美、0 追平基线),对每个类别特征计算宏 F1 $F^1_n(\sigma)$,把 $L\times L$ 特征平均代价矩阵交给匈牙利算法求联合 $\sigma$,$TMS$ 取 $\max_\sigma$ 下各类分数的平均——『内容对但顺序错』被时间通道惩罚。第三步,算 cDFS:每个测试样本配对真延续与生成延续,训练判别器(可选输入末 $H'$ 个历史事件)输出真假,$\mathrm{cDFS}=2(1-\mathrm{AUROC})$,分数落在 $[0,1]$;换判别器架构后排名稳定。第四步,训练三族模型:LDM 先训 β-VAE 编码单事件,再训潜空间扩散,以 RNN 历史嵌入+末 $L$ 事件潜码为条件(classifier-free guidance);DDM 保留 CDiff 的高斯扩散+类别均匀扩散,一次预测 $L$ 事件;DEF 生成多于 $L$ 的候选并联合训练 Horizon Matching Loss 与存在概率,推理选 top-$L$。第五步,BaryBooster:采 $N=30$ 条样本,计算两两 TMS 传输代价 $d_{\mathrm{TMS}}(A,B)=\min_\sigma\sum_i \bar{C}(i,\sigma(i))$,返回代价和最小的样本作为最终预测,全程无需再训练。
技术新颖性
与已有技术的区别体现在四处。(1) 指标层面:OTD 依赖手工编辑代价且不扩展到数值特征,T-mAP 只支持时间+单标记;TMS 用基线重标定把任意多个异构特征放到同一尺度,用匈牙利匹配替代编辑对齐,且所有特征共享一个 $\sigma$ 而非各评各的——它是单一匹配分数而非独立诊断的平均。(2) 真实感层面:经典 C2ST 无条件于历史,cDFS 的判别器能看到历史,因此能识别『与前文不一致』的生成结果,这对预测任务至关重要。(3) 基准层面:首次同时把准确性与真实感当一等公民,并首次将数据扩散、潜在扩散、非扩散 SoTA 与统计基线统一适配到一般异构事件序列预测——此前没有任何工作系统研究过这一任务。(4) 方法层面:BaryBooster 是离散 Wasserstein 重心的直接应用,作为推理时后处理不改训练目标、与基座无关,理论上任何可采样生成器都能受益;实验证实扩散模型获益最大、DEF 几乎无收益,反过来印证了『真实感是可转化资产』这一核心论点。
实验结果
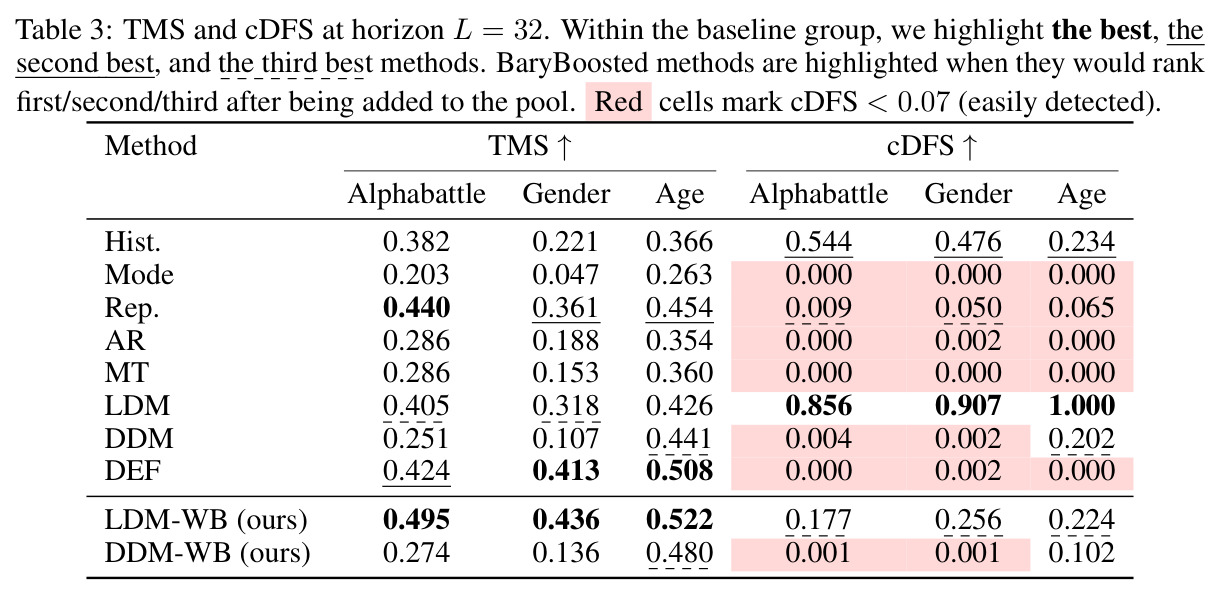
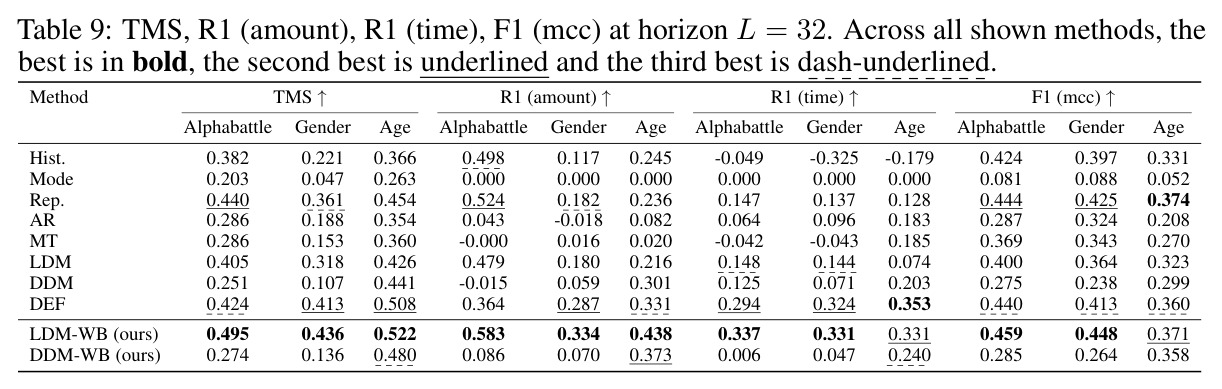
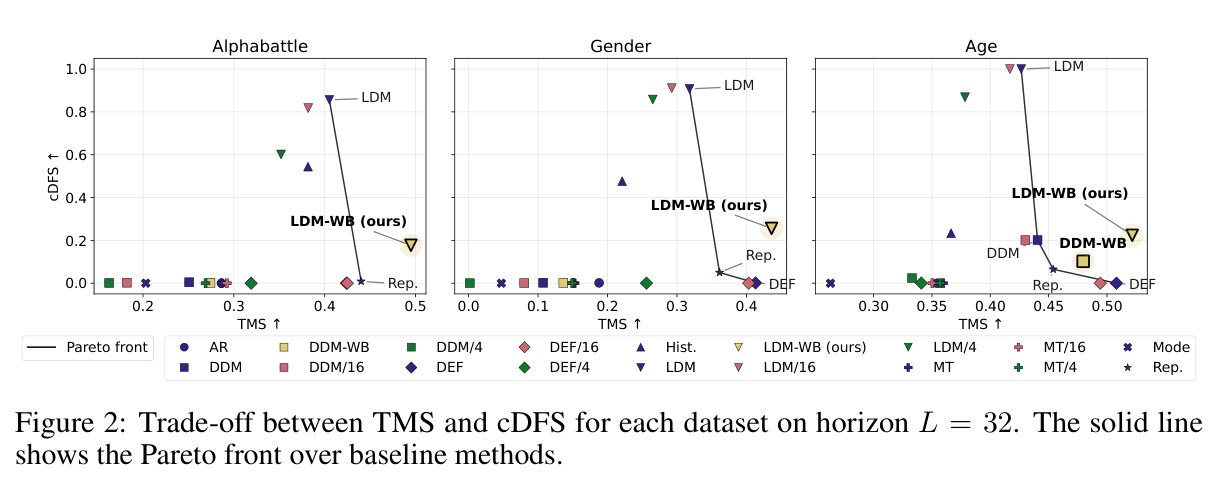
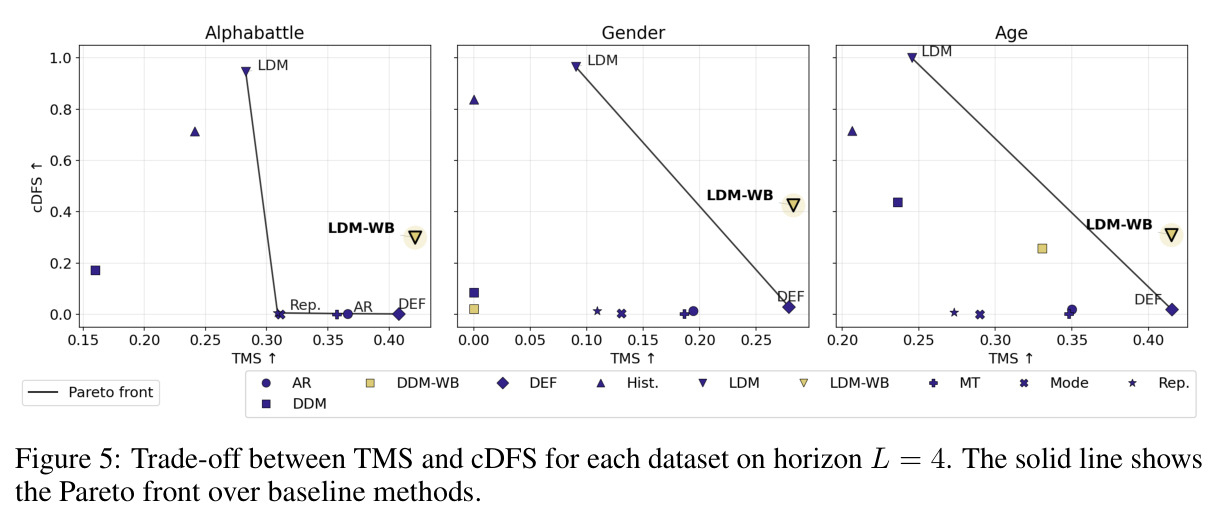
核心发现是一个尖锐的分裂:没有方法能同时赢下 TMS 与 cDFS。在 horizon $L=32$ 的主表(Table 3)中,LDM 是唯一拿到非平凡 cDFS 的生成模型——Alphabattle 0.856、Gender 0.907、Age 1.000,判别器几乎无法把它的延续与真数据区分开;其余学习模型都坍缩到近零(DEF 0.000/0.002/0.000,AR/MT 大多 0.000,DDM 仅 Age 上 0.202),HistSampler(0.544/0.476/0.234)是 LDM 之外最接近真实感的基线。准确性侧是另一幅图景:DEF 在 Gender/Age 上最优(0.413/0.508),但 Repeat 在 Alphabattle 上以 0.440 超过所有学习方法;AR/MT 连 HistSampler 都不如,数值特征坍缩到条件中位数,正是 Figure 1 病理的重现;跨 horizon rollout 几乎从不优于一次性预测。BaryBoosting 改写了排名:LDM-WB 拿下最高 TMS(0.495/0.436/0.522),同时保留非平凡 cDFS(0.177/0.256/0.224),把帕累托前沿整体外推(Figure 2);DDM-WB 增益有限、对 DEF 几乎无效。增益还泛化到未优化指标:Table 4 中 LDM→LDM-WB 使 Alphabattle 的 $R^1$(amount) 0.479→0.583、$R^1$(time) 0.148→0.337、F1(mcc) 0.400→0.459。成本方面 $N=5$ 保留约 75% 的 TMS 增益、采样成本仅 1/6;短 horizon(Figure 5,$L=4$)下提升最剧烈。迁移实验在 Retweet、Amazon 两个小语料上重复出同样结论;cDFS 排名对判别器扰动稳定(Spearman $\rho\ge0.91$)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 事件序列预测(Alphabattle,L=32) | TMS ↑ | LDM-WB 0.495 | Repeat 0.440 / DEF 0.424 | +0.055(较最强基线)/ +0.071(较最强非扩散模型) |
| 事件序列预测(Gender,L=32) | TMS ↑ | LDM-WB 0.436 | DEF 0.413 | +0.023 |
| 事件序列预测(Age,L=32) | TMS ↑ | LDM-WB 0.522 | DEF 0.508 | +0.014 |
| 分布真实感(三数据集,L=32) | cDFS ↑ | LDM 0.856 / 0.907 / 1.000 | DEF ≈0.000–0.002;HistSampler 0.544 / 0.476 / 0.234 | 唯一被判别器『无法识破』的学习模型,其余学习模型 cDFS 坍缩至近零 |
| 附带预测指标(Alphabattle,L=32) | R1(amount) ↑ | LDM-WB 0.583 | LDM 0.479 | +0.104(另 R1(time) +0.189,F1(mcc) +0.059) |
局限与改进
作者明确承认三点局限:其一,实证只用 3 个数据集且全部是银行卡交易——审查后未找到同时满足规模、长度、结构要求的非金融公开语料,根源是银行/医疗等行业的隐私限制(附录 K 列出被拒语料);其二,BaryBooster 推理开销可观,需 $N=30$ 次采样加迭代重心求解,延迟敏感部署难以承受(缓解手段是 $N=5$ 保留约 75% 增益、采样可并行);其三,cDFS 的绝对值依赖判别器,只能做相对排名比较。我的补充观察:TMS 的联合置换 $\sigma$ 允许重排事件顺序,虽有时间通道惩罚,但评测口径按『事件数』而非物理时间定义 horizon,与『预测未来一周』这类业务需求仍有偏差;权衡结论主要在金融交易上得出,向 healthcare、e-commerce 的迁移仅在两个极小的 TPP 语料上初步验证;BaryBooster 依赖真实感强的基础生成器,而现实中最易得的准确模型(DEF 类判别式方法)恰恰不是好生成器,适用前提苛刻;此外数据全为个人消费行为,合成高真实感交易存在被用于规避欺诈检测的滥用风险。
独立分析的弱点
独立分析出五个弱点。第一,领域覆盖窄:三个数据集全为卡交易、事件只有时间+金额+MCC,『一般事件序列』的主张有待 healthcare(如 MIMIC 诊疗流)、业务流程日志上的验证,改进方向是接入脱敏多域语料并报告跨域方差。第二,BaryBooster 的推理成本:$N=30$ 次扩散采样对在线服务不友好,改进方向包括把聚合结果蒸馏回单模型(一次前向近似重心)、学习摊销式重心网络、或提前终止采样。第三,LDM 的历史条件较弱:RNN 嵌入可能丢失近期细节(作者靠拼接末 $L$ 个事件潜码补救),Repeat 基线如此之强正说明长程条件建模仍有大量空间,可尝试 Transformer in-context 条件或检索增强历史。第四,评估协议按固定事件数 $L$ 切分,忽略事件率随时间变化的数据集场景,改进是增加时间窗协议并在两种口径下交叉验证结论。第五,cDFS 只用单一判别器族,改进方向是集成多种判别器并报告指标方差,压缩『骗过单一判别器』的过拟合空间;同时 cDFS 与 TMS 的联合优化目标之间如何显式权衡,也缺乏训练层面的探索。
未来方向
作者展望的核心是事件序列基础模型:训练一次生成模型,即可同时服务需要真实感的应用(合成数据、多场景探索、风险分析)与需要点预测的任务(经 BaryBooster 聚合),实现『同一个生成模型、多种下游任务』。基于本文成果可自然延伸的方向包括:(1) 把重心聚合蒸馏为单次前向,消除推理开销,走向实用的在线预测;(2) 将 TMS+cDFS 双轴评测协议移植到医疗事件流、网络安全日志等新域,检验权衡的普适性;(3) 在训练目标中显式平衡两轴(如对抗正则或多目标优化),而非仅靠推理时聚合,尝试推进帕累托前沿本身;(4) 研究高真实感合成交易在反欺诈数据增广中的受控使用与滥用防护;(5) 将重心聚合思想推广到时间序列预测、文本生成等其他生成任务的点估计;(6) 在更大规模数据上探索跨客户泛化的序列基础模型与上下文学习。
复现评估
复现条件良好。代码完整开源(github.com/xaosina/event-sequence-forecasting),单仓库 PyTorch 实现了全部方法、指标与辅助工具。三个数据集均可公开获取:Gender 与 Age 来自 Kaggle/ODS 竞赛数据,Alphabattle 为 Kaggle 公开数据集;论文附录 H 给出预处理与切分细节,附录 I 给出各模型实现细节及与 ADiff4TPP 的结构对比,附录 J 报告运行时间与 GPU 显存,附录 D 给出 cDFS 判别器细节与稳定性实验,附录 F 给出 BaryBooster 优化流程。主要成本在扩散模型训练与 BaryBooster 的 $N=30$ 次采样(可并行,$N=5$ 即可保留约 75% 增益);判别器为标准分类网络,门槛不高。综合评估复现难度中等:有 GPU 的团队可在数天内复现主表,BaryBooster 部分需仔细对齐 TMS 代价矩阵与迭代优化;风险点主要是 cDFS 判别器训练的随机性与数据预处理细节对齐。
论文图表
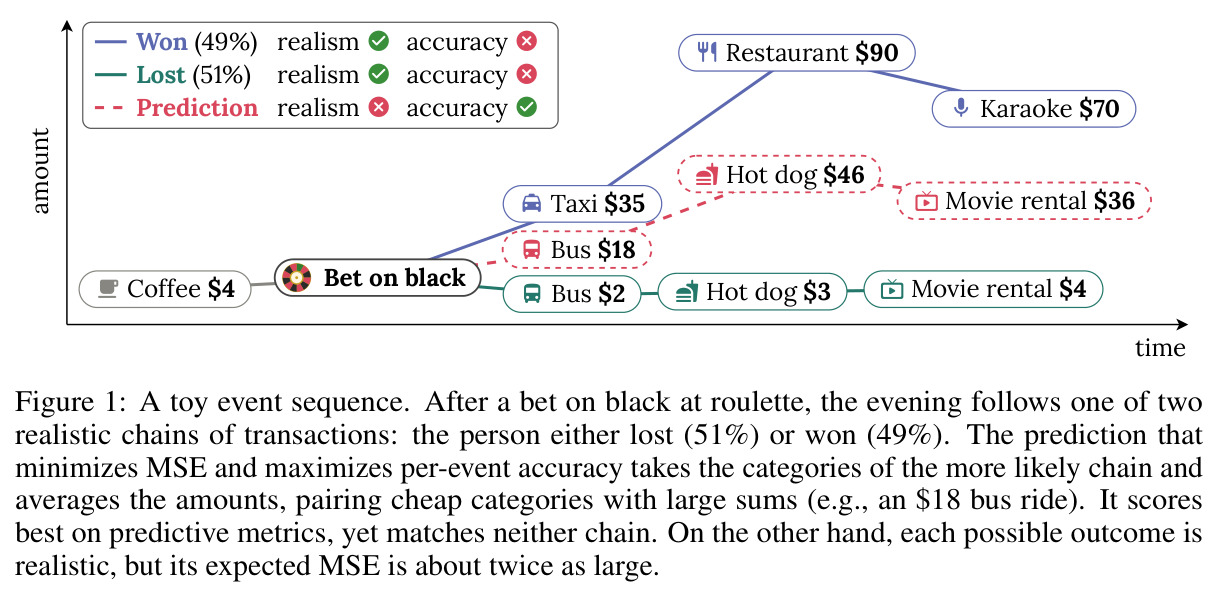
以轮盘赌后的消费链为例:同一历史有两条都真实的未来——输(51%)或赢(49%)。把更可能链的类别与平均金额拼接的预测(如乘巴士花 $18、热狗 $46)在 MSE 和逐事件准确率上得分最高,却与哪条真实链都不匹配;而每条真实链自身的期望 MSE 约翻倍。
这是全文的问题宣言:准确性指标的最优解可以完全不真实,直观建立了 accuracy-realism 权衡的存在性,是理解 cDFS/TMS 双轴评测和 BaryBooster 动机的钥匙。