SEER:面向时间序列预测的自演化事件推理与检索 SEER: Self-Evolving Event Reasoning and Retrieval for Time Series Forecasting
SEER:把预测误差变成检索记忆与因果知识,闭环自演化地优化事件驱动的时序预测
前置知识
检索增强生成(RAG)
在语言模型生成答案前,先从外部语料(新闻、文档等)检索相关文本并拼进提示词作为证据,使模型基于最新外部信息而非仅凭参数记忆作答。标准实现依赖向量相似度检索,检索质量直接决定最终效果。
本文批判的对象正是『静态 RAG 用于时序预测』的范式,理解其低信噪比、缺乏因果推理、开环无反馈三大缺陷,才能领会 SEER 的改进动机。
自反思与经验记忆(Reflexion 式智能体)
智能体完成任务后,把执行轨迹与结果反馈给 LLM 做语言化反思,将教训存入记忆库供后续任务参考,实现不更新参数的经验学习。ReasoningBank 等工作进一步把原始轨迹蒸馏成结构化的可迁移策略知识。
SEER 的双反馈机制(检索记忆 + 因果知识库)正是这一思想在时序预测上的特化,理解它才能分清 SEER 与通用智能体记忆方法的异同。
回看窗口与预测视界
时序预测中模型可观测的历史长度称为回看窗口 $L$(如 14 天),需要预测的未来长度称为视界 $H$(如 7 天或 9 个月)。训练与测试按时间切分,且学习阶段只使用满足 $t+H \le \tau$ 的完整轨迹。
SEER 的所有符号($x_t$、$\hat{y}_t$、$\ell$)与回测协议都建立在这两个概念上,不熟悉会导致无法理解其防泄露设计。
前视偏差与数据泄露
回测中若使用了截断点之后才可得的信息(如未来新闻、修订后数据),评估结果会系统性虚高。防范手段包括严格按时间切分训练/测试、只索引截止时刻前的事件、对事件时间戳做事实核查。
事件检索天然容易『偷看未来』,SEER 借助 LEAF 事实核查强制所有事件时间 $\le t$,这是其结论可信度的关键,也是评估此类论文的核心关注点。
Brier 分数
衡量概率预测准确性的指标,$BS = \frac{1}{N}\sum_t (p_t - o_t)^2$,其中 $p_t$ 是预测概率、$o_t \in \{0,1\}$ 是实际结果,数值越低越好,同时惩罚过度自信与校准不足。
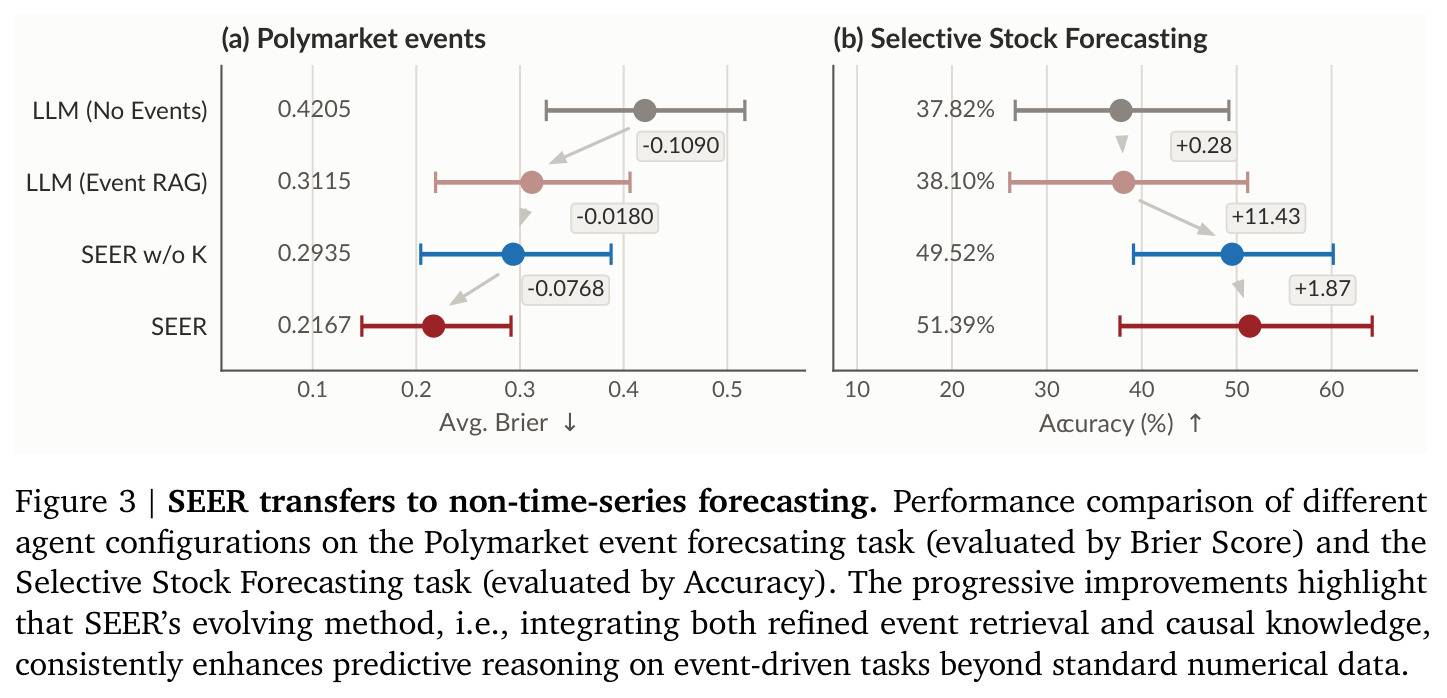
SEER 在 Polymarket 事件预测任务上以 Brier 分数评估(0.2167 对基线 0.3115),理解该指标才能正确解读图 3 的泛化实验。
时间序列基础模型(TSFM)
在海量跨域时序数据上预训练的大模型(如 TimesFM 3.0、Chronos-2),可对任意新序列做零样本预测,无需任务微调,是当前纯数值预测的最强通用基线家族。
表 2 中 SEER 需要同时战胜监督深度模型、LLM 预测器和 TSFM 三大基线家族,了解 TSFM 的定位才能理解这组对比实验的分量。
研究动机
现实世界的时间序列很少是封闭系统:内存/SSD 价格会因关税与供应链事件跳变,电力需求受天气与政策冲击,股价受财报和地缘政治驱动。仅依赖历史数值的深度模型(Autoformer、PatchTST 等)与零样本基础模型(TimesFM 3.0、Chronos-2)在这种非平稳状态下会系统性失效,因为决定未来轨迹的信号根本不在数值序列之内。为了引入外生信号,近期工作用语言模型做检索增强生成(RAG),把新闻文本拼进提示词,但作者指出标准 RAG 有三大失效模式:其一,原始新闻流充满无关、冗余甚至误导的报道,信噪比极低;其二,检索依赖语义相似度而非因果归因,模型无法判断『事件到价格』的传导逻辑;其三,开环架构不会利用预测误差修正后续检索,静态知识库也无法从历史错误中学习。表 2 量化了这一点:LLM (Event RAG) 虽已优于纯数值模型,但在 Memory 6 个月任务上 MAE 仍高达 287.9 USD,远未吃透事件驱动的真实波动。
本文的目标是本文的目标是把『事件条件化』从一次性的静态检索任务,改造成随预测表现不断进化的闭环过程。具体而言,SEER 希望在冻结主干语言模型、不更新任何参数的前提下,通过纯文本形式的上下文优化来提升预测精度:一是让系统学会主动构造检索查询并过滤噪声事件,二是把历史预测失败蒸馏成可跨目标迁移的因果领域知识。同时,整个框架必须严格遵守时间边界——所有记忆与知识只能使用截止时刻 $t$ 之前可得的事件,杜绝前视偏差与数据泄露,从而在严格的回测协议下验证性能。作者期望在六个高波动、事件驱动的基准(内存/SSD 价格、电力需求、气温、股票方向、预测市场概率)上,全面超越监督深度模型、LLM 预测器与 TSFM 三大基线家族。
与已有工作不同的是,已有工作的切入角度要么把 LLM 当预测器(Time-LLM、PromptCast 等将数值序列转成文本再微调),要么叠加静态 RAG;自演化智能体研究(Reflexion、ReasoningBank)虽提出经验记忆,但停留在任务轨迹归档层面,没有针对『检索质量不足』与『推理逻辑缺陷』这两类完全不同的失败源做区分处理。SEER 的独特之处有三:第一,把预测残差当作训练信号,定义了在文本空间中最小化 $\min_{\mathcal{M},\mathcal{K}} \mathbb{E}[\sum_t \ell(y_t, \hat{y}_t)]$ 的上下文优化问题,等价于『用误差训练提示词』而非训练参数;第二,将反馈解耦为检索记忆 $\mathcal{M}$(修正『找错了证据』)与持久因果知识 $\mathcal{K}$(修正『推错了逻辑』),避免两类信号互相干扰;第三,借助 LEAF 事实核查机制在事件层面强制时间约束(经人工专家审计验证),这是此前把新闻直接塞进提示词的 RAG 时序预测工作普遍缺失的严谨性。
核心方法
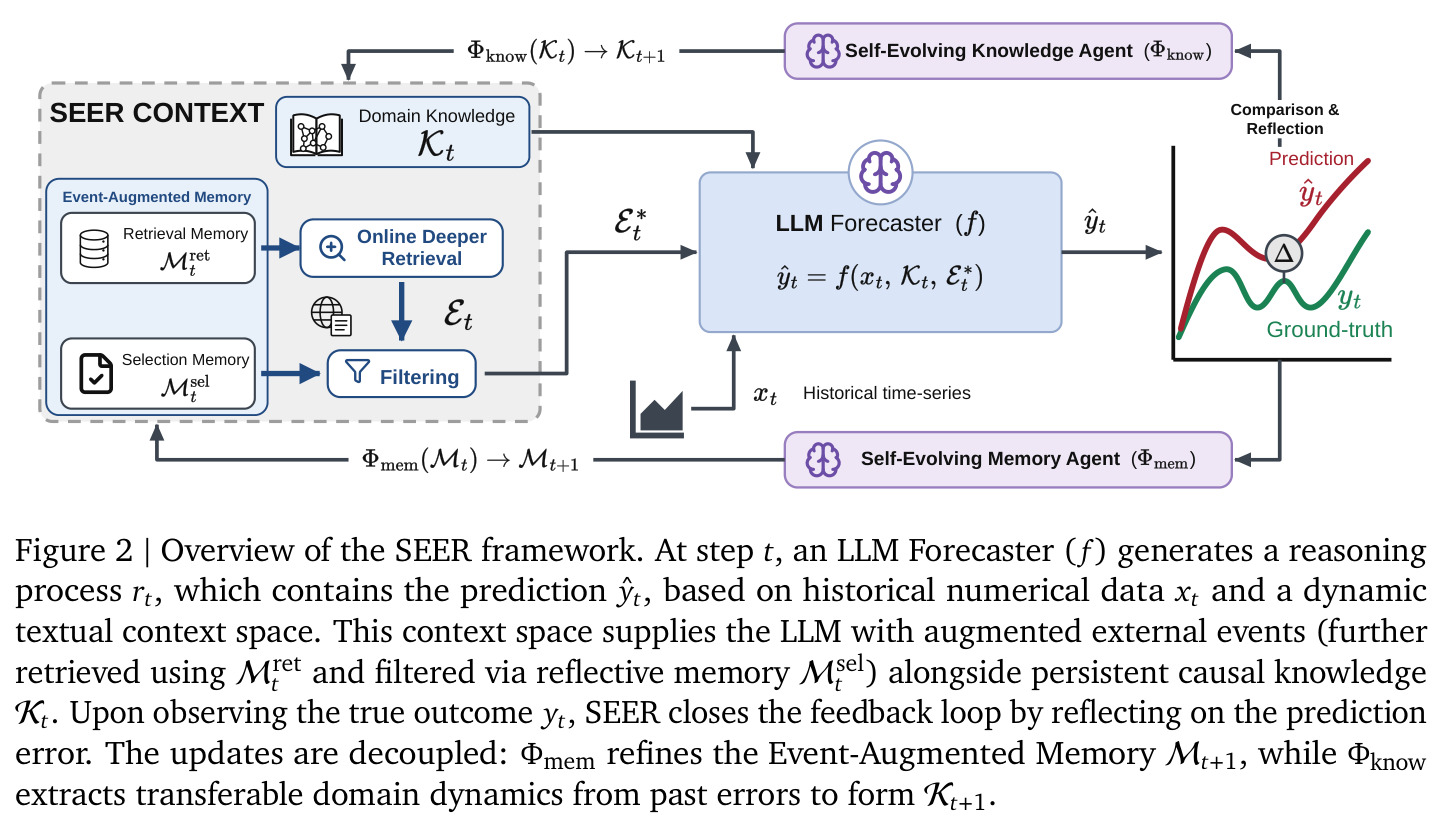
SEER 的直觉是:预测错了不一定是模型不行,更可能是『没看到关键事件』或『看到了但没想对』,与其微调模型,不如让环境本身进化。技术上,SEER 把预测建模为智能体在结构化文本上下文上的推理:查询 $x_t$ 包含实体描述、预测视界 $H$ 和回看窗口 $[t-L, t]$ 内的数值序列;上下文空间为 $\Omega_t = (\mathcal{E}_t, \mathcal{K}_t)$,$\mathcal{E}_t$ 是局部事件池,$\mathcal{K}_t$ 是从历史预测蒸馏的因果知识。冻结的语言模型 $\mathcal{F}$ 生成预测 $\hat{y}_t = \mathcal{F}(x_t, R(\mathcal{E}_t, \mathcal{K}_t, \mathcal{M}_t))$,其中上下文构造算子 $R(\mathcal{E}_t, \mathcal{K}_t, \mathcal{M}_t) = (\rho_{\mathcal{M}^{sel}_t} \circ \sigma_{\mathcal{M}^{ret}_t}(\mathcal{E}_t),\ \mathcal{K}_t)$:先用检索记忆主动发起搜索扩展事件池,再用选择记忆过滤噪声,最后附上因果知识交给 LLM。真值 $y_t$ 公布后,反思算子比较推理轨迹 $r_t$ 与真值,把诊断结论分别写回 $\mathcal{M}$ 和 $\mathcal{K}$,形成预测-观察-反思的闭环。
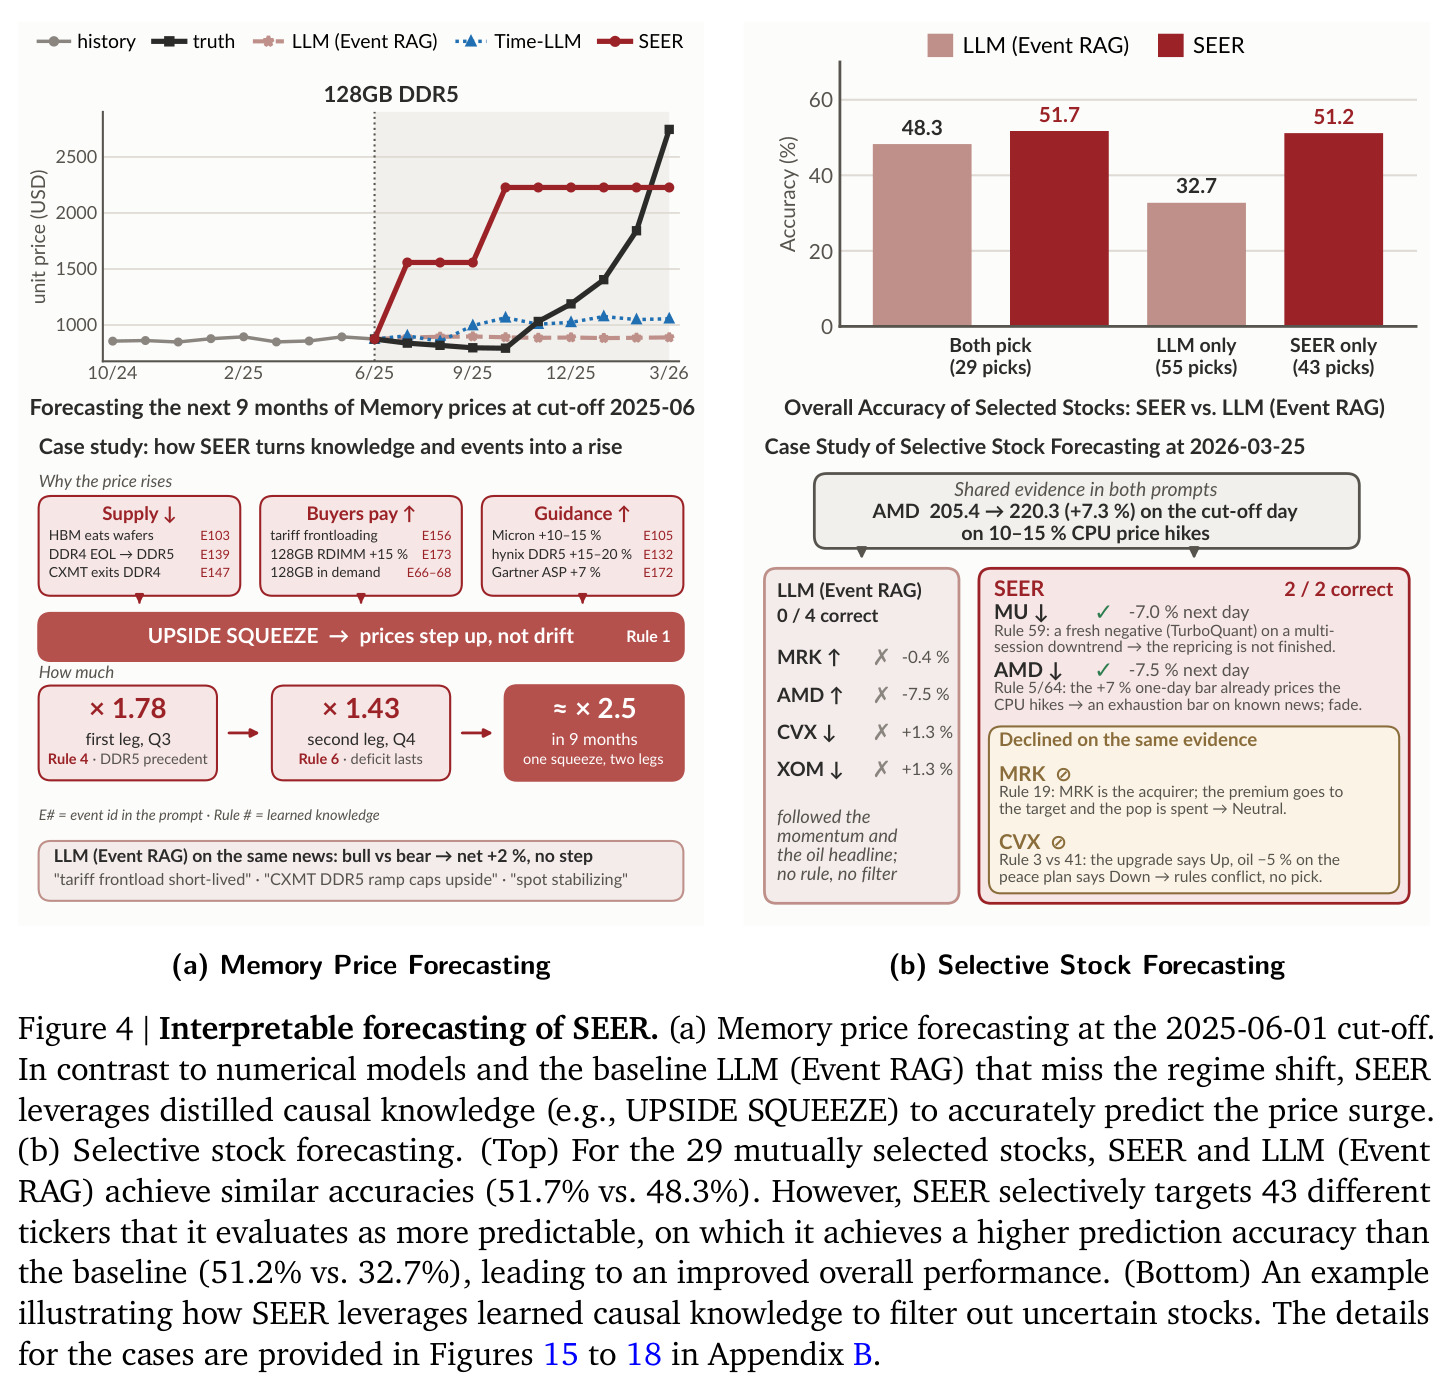
核心创新是把『从预测误差中学习』拆成两个解耦的文本反馈通道,并用误差驱动地优化检索本身。与静态 RAG 的本质区别:静态 RAG 只做一次语义检索,好坏全凭运气;SEER 的反射记忆 $\mathcal{M}$ 显式记录『过去的查询是否命中了真正的驱动事件』——检索记忆 $\mathcal{M}^{ret}$ 指导扩张算子 $\sigma$ 构造新查询、补齐缺失的外生信息,选择记忆 $\mathcal{M}^{sel}$ 指导过滤算子 $\rho$ 剔除虚假关联。与 Reflexion 式轨迹归档的区别在于因果知识库 $\mathcal{K}$:它把一次性预测失败抽象成可跨目标迁移的领域规律,如内存案例中的『UPSIDE SQUEEZE』阶梯上涨规则和『HBM 挤占产能』机制。更新公式为 $\mathcal{M}_{t+1} = \mathcal{C} \circ \Phi_{mem}(\xi_t, \mathcal{M}_t)$、$\mathcal{K}_{t+1} = \mathcal{C} \circ \Phi_{know}(\xi_t, \mathcal{K}_t)$,凝算子 $\mathcal{C}$ 在接近容量上限时合并相似条目、压缩冗余文本,保证库始终精炼。
方法步骤详情
第一步,问题设置:在截断点 $t=1,\dots,T$ 上顺序预测,按时间切成训练段($t \le \tau$)与测试段($t > \tau$),学习只用 $t+H \le \tau$ 的已完成轨迹。第二步,构建初始事件池:对每个截断点做两轮通用定向搜索得到 $\mathcal{E}_t$。第三步,上下文构造:用 $\mathcal{M}^{ret}$ 发起一轮引导搜索补充事件,再用 $\mathcal{M}^{sel}$ 过滤,连同 $\mathcal{K}$ 交给冻结 LLM;数值输入窗口为天气/电力/股票 14 天、组件价格 9 个月。第四步,预测与观察:LLM 输出推理过程 $r_t$(含 $\hat{y}_t$),与真值 $y_t$ 组成轨迹 $\xi_t$。第五步,双通道反思:$\Phi_{mem}$ 诊断检索缺陷并更新 $\mathcal{M}$,$\Phi_{know}$ 提炼普适因果规则更新 $\mathcal{K}$,随后 $\mathcal{C}$ 压缩去重。第六步,循环迭代:学习窗口内逐样本『预测-观察-反思』,域内上下文跨目标共享(股票/事件域分 6/3 个子域),等效优化 $\min_{\mathcal{M},\mathcal{K}} \mathbb{E}[\sum_t \ell(y_t, \hat{y}_t)]$。第七步,回测:测试段冻结记忆与知识,所有事件经 LEAF 事实核查约束在截断点之前,杜绝前视偏差。
技术新颖性
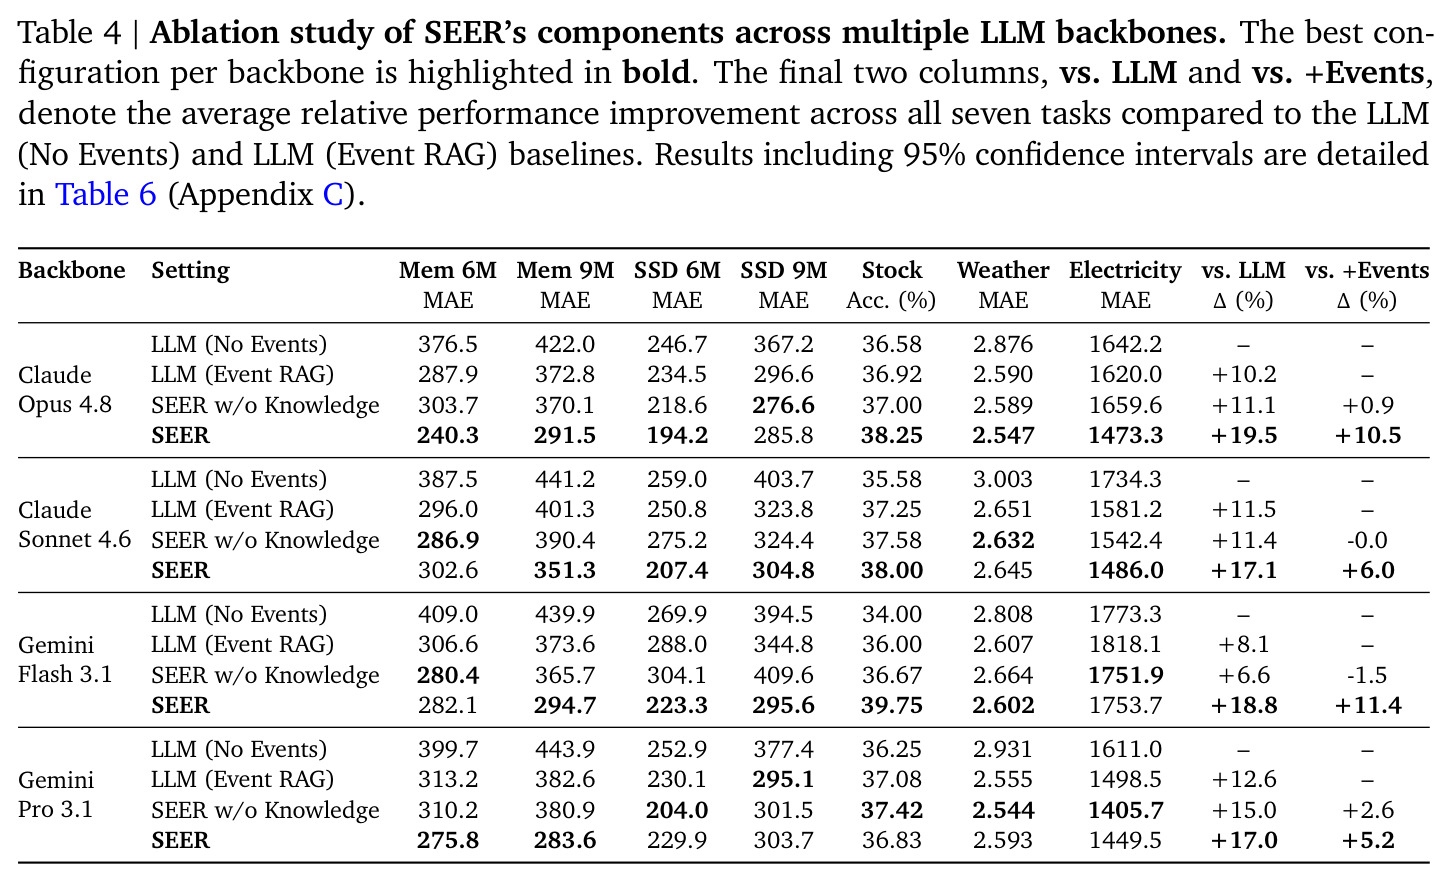
技术新颖性体现在四个层面。其一,优化对象的转移:主流范式优化模型参数或适配器,SEER 优化的是自然语言构成的记忆与知识库,主干完全冻结,这与上下文工程、智能体记忆的最新方向(ReasoningBank、经验蒸馏)接轨,但首次系统性地应用于时序预测的事件条件化。其二,解耦式错误归因:把『检索不足』和『推理错误』分流到 $\Phi_{mem}$ 与 $\Phi_{know}$ 两个算子;消融(表 4)证明仅用记忆检索的 SEER w/o Knowledge 在多个骨干上并不稳定(Gemini Flash 3.1 上相对 Event RAG 为 -1.5%、Sonnet 4.6 上 -0.0%),而加上因果知识后才全面超越,说明两种知识互补而非冗余。其三,时间安全性设计:事件级事实核查加严格按分辨时间的切分,比同类工作严谨得多。其四,跨任务泛化:同一框架无需修改即可迁移到 Polymarket 概率预测与选择性股票任务,证明其本质是一种与任务无关的『误差驱动上下文学习』机制,而非时序专用的提示工程。
实验结果
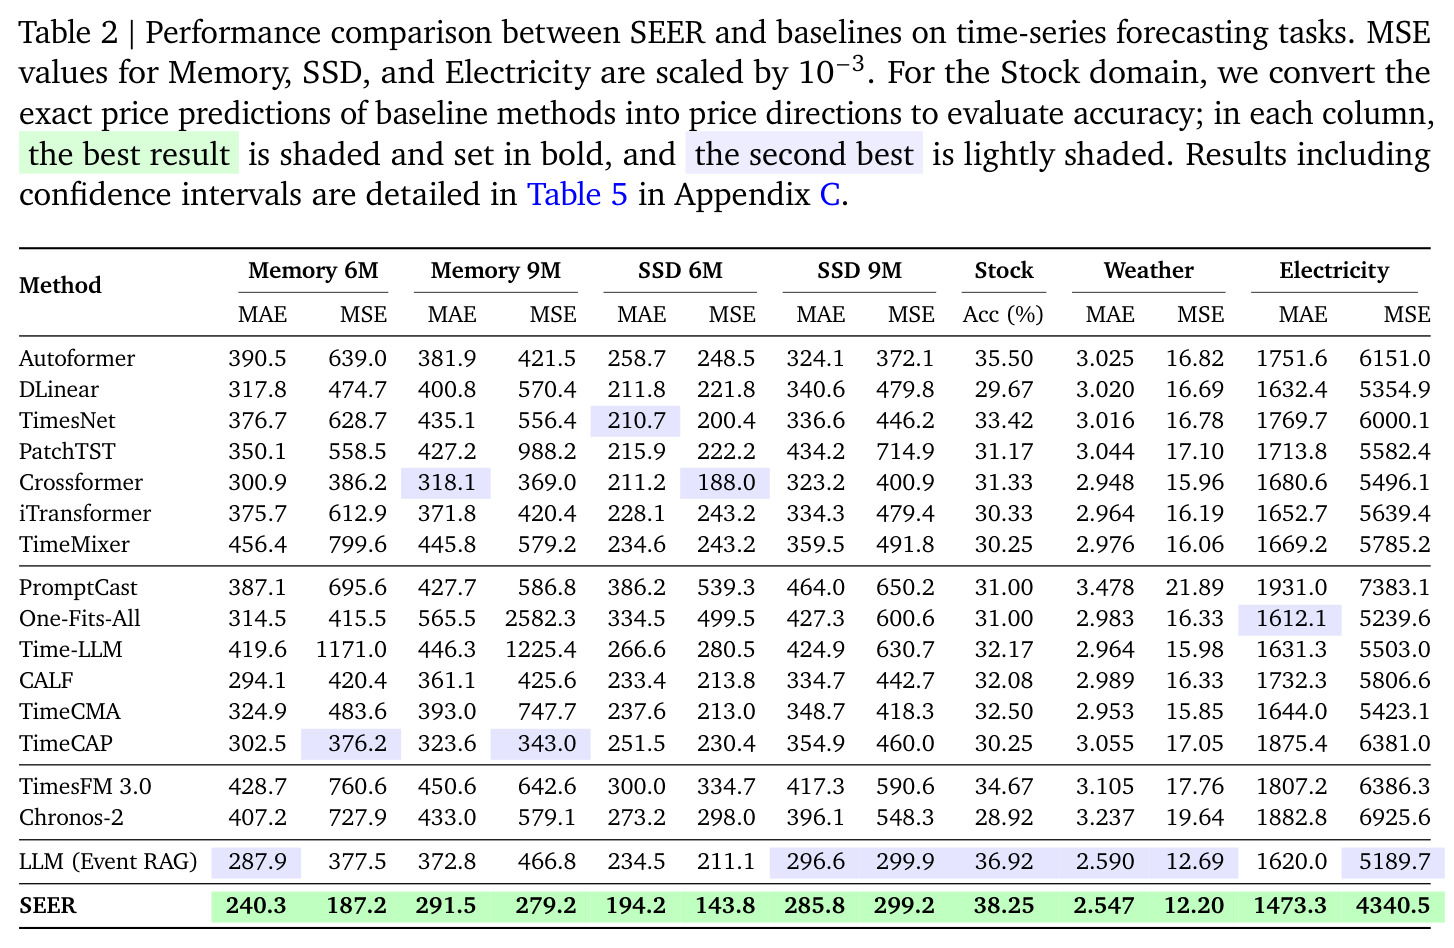
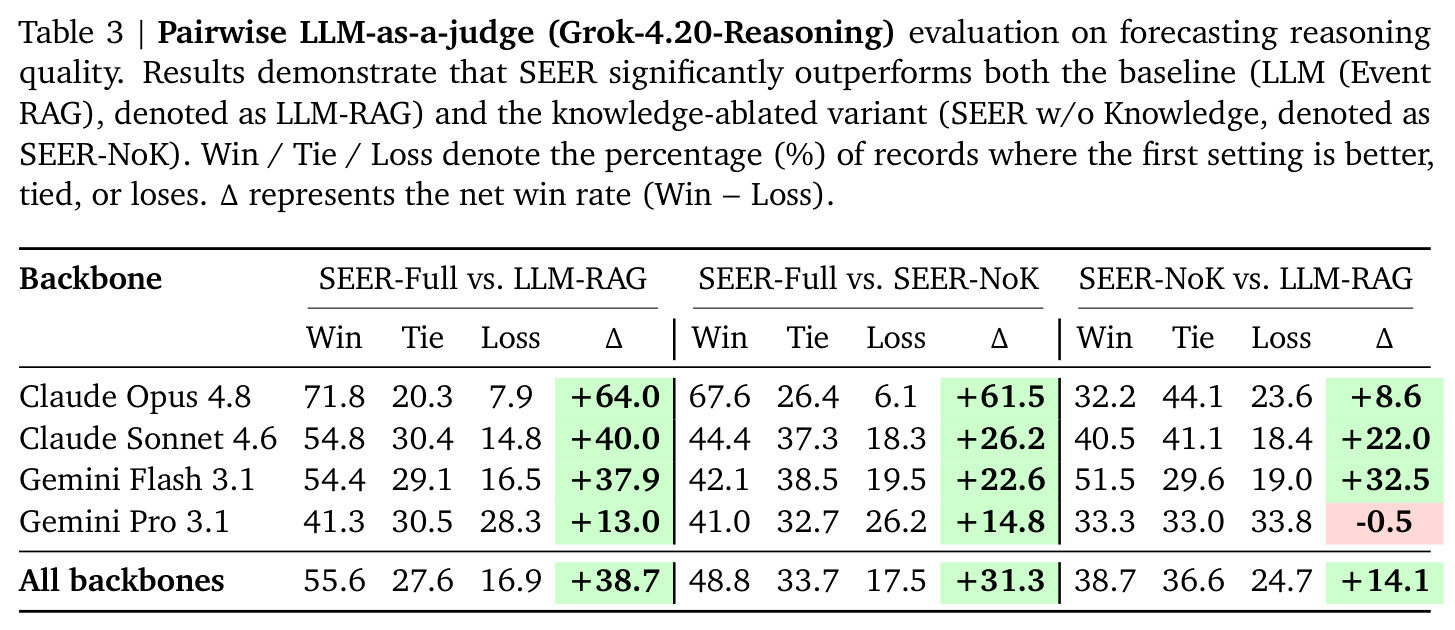
主实验(表 2)上,SEER 在五个数值任务全面击败 15 个基线:Memory 6 个月 MSE 187.2(最佳基线 TimeCAP 为 376.2),降 50.2%;SSD 6 个月 MAE 194.2 / MSE 143.8;长视界优势更明显:Memory 9 个月 MSE 279.2 较最佳深度模型 Crossformer(369.0)降 24.3%,SSD 9 个月 299.2 较 Autoformer(372.1)降 19.6%;电力 MSE 4340.5 较 Event RAG(5189.7)降 16.4%;天气 MAE 2.547°C;股票方向准确率 38.25%,高于 Event RAG 的 36.92% 与 Chronos-2 的 28.92%。MSE 降幅普遍大于 MAE,说明 SEER 主要消除事件突变导致的极端误差。消融(表 4):完整 SEER 相对无事件 LLM 平均提升 +19.5%(Opus 4.8)、+17.1%(Sonnet)、+18.8%(Flash)、+17.0%(Pro),相对 Event RAG 提升 +5.2% 至 +10.5%,四骨干全部受益。推理质量(表 3):Grok-4.20 裁判成对比较中 SEER-Full 对 LLM-RAG 平均净胜率 +38.7%(Opus 上 +64.0%),对无知识版 +31.3%。泛化(图 3):Polymarket Brier 从 0.3115 降至 0.2167(无事件 0.4205);选择性股票准确率 38.10% 升至 51.39%,收益主要来自学到的弃权规则:SEER 自选 43 只准确率 51.2%,基线 55 只仅 32.7%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 内存组件价格预测(6 个月视界,20 个组件,246 样本) | MAE / MSE(MSE ×10⁻³,USD) | SEER:MAE 240.3 / MSE 187.2 | 最佳基线 TimeCAP:MAE 302.5 / MSE 376.2;LLM (Event RAG):MAE 287.9 / MSE 377.5 | MSE 较最佳基线降低 50.2%,MAE 较 Event RAG 降低 16.5% |
| 电力需求预测(7 天视界,3 个实体,66 样本) | MAE / MSE(MSE ×10⁻³,MW) | SEER:MAE 1473.3 / MSE 4340.5 | LLM (Event RAG):MAE 1620.0 / MSE 5189.7;最佳纯数值基线 One-Fits-All:MSE 5239.6 | MSE 降低 16.4% |
| 美股次日价格方向预测(50 只股票,1250 样本) | Accuracy (%) | SEER:38.25% | LLM (Event RAG):36.92%;最佳深度模型 Autoformer:35.50%;Chronos-2:28.92% | 较最强基线提升 1.33 个百分点 |
| Polymarket 真实世界事件概率预测(146 题,276 样本) | Brier Score(越低越好) | SEER:0.2167 | LLM (Event RAG):0.3115;LLM (No Events):0.4205;SEER w/o Knowledge:0.2935 | 较 Event RAG 降低约 30% |
| 选择性股票预测(每日从 50 只中至多选 6 只,可弃权) | Accuracy (%) | SEER:51.39% | LLM (Event RAG):38.10%;LLM (No Events):37.82%;SEER w/o Knowledge:49.52% | 较 Event RAG 提升 13.29 个百分点 |
| SSD 价格预测(9 个月长视界,10 个组件,164 样本) | MAE / MSE(MSE ×10⁻³,USD) | SEER:MAE 285.8 / MSE 299.2 | 最佳深度学习基线 Autoformer:MAE 324.1 / MSE 372.1;LLM (Event RAG):MAE 296.6 / MSE 299.9 | MSE 较最佳深度基线降低 19.6% |
局限与改进
作者承认并可从数据中观察到的局限:第一,股票任务上 SEER 绝对准确率仅 38.25%,虽优于基线但距离三分类天花板仍远,说明公开股价方向的可用信号依旧微弱,只能靠『选择性弃权』改善校准;第二,记忆与知识在测试段被冻结,无法继续利用测试期的预测误差在线进化,回测协议与真实持续运行场景存在差距;第三,框架依赖两轮通用搜索加一轮引导搜索、四个前沿 LLM(Gemini 3.1 Pro/Flash、Claude 4.6 Sonnet/4.8 Opus)以及 LEAF 事实核查,单样本推理成本远高于 PatchTST 等轻量模型;第四,事件检索质量受外部新闻可得性约束,对小众、私有或未被报道的驱动因素无能为力;第五,LLM-as-a-judge 使用 Grok-4.20-Reasoning 裁判,裁判与参赛模型同源风险虽低,但裁判偏好仍可能系统性影响胜率;第六,知识库在同一域内跨目标共享,若实体间因果关系异质(如个股差异极大),共享知识可能引入偏差。
独立分析的弱点
独立分析几个弱点。其一,成本与延迟:每个训练样本都要经历多轮搜索、一次预测和两次反思调用,以天气 220 个截断点、Memory 246 个样本计,训练一个域需要数千次前沿 LLM 调用;改进方向是用小模型执行反思或把检索策略蒸馏成轻量模块。其二,反思信号的噪声:预测错误未必源于检索或推理,也可能源于数据噪声本身(论文提到评估窗口存在缺失价格),框架未显式建模『不可预测样本』,可能把纯噪声误蒸馏成伪因果规则;可引入不确定性估计来过滤低置信反思。其三,凝算子 $\mathcal{C}$ 的有损压缩:合并相似条目可能抹掉罕见但关键的早期教训,论文也未报告 $\mathcal{K}$ 随迭代增长的质量曲线与容量阈值敏感性。其四,选择性股票任务的评估:不同模型弃权策略不同会导致选中集合分布差异,整体准确率的可比性部分依赖于弃权校准而非纯预测力,可补充风险调整收益或覆盖率指标。其五,对搜索 API 与数据源(Meteostat、Grid Status、Pangoly)的强依赖使复现易受数据修订与非确定性检索结果影响。
未来方向
作者方向上:把闭环机制扩展到更多事件驱动域(大宗商品、汇率、宏观数据);结合世界模型与代码驱动的环境合成来增广训练事件(呼应其相关工作讨论中的 EnvHarness、GenEnv 思路);探索记忆的层次化组织与跨域迁移。基于本文成果可延伸的研究包括:第一,在线终身版本——在测试段也允许受控的记忆更新,系统研究其与回测严格性之间的权衡;第二,把因果知识库形式化为可验证的规则图,用因果推断工具检验蒸馏规则的可靠性并剔除伪相关;第三,与 TSFM 融合,让 SEER 的文本上下文用于修正 TimesFM、Chronos-2 等数值模型的残差而非直接出预测;第四,研究 $\mathcal{K}$ 的负迁移问题——何时应为子域维护独立知识库、何时共享;第五,成本感知的自演化,让智能体自主决定何时值得反思、何时跳过,以降低单位精度提升的推理开销;第六,把解耦反思机制移植到其他需要外部证据的决策任务(医疗诊断、法律检索)。
复现评估
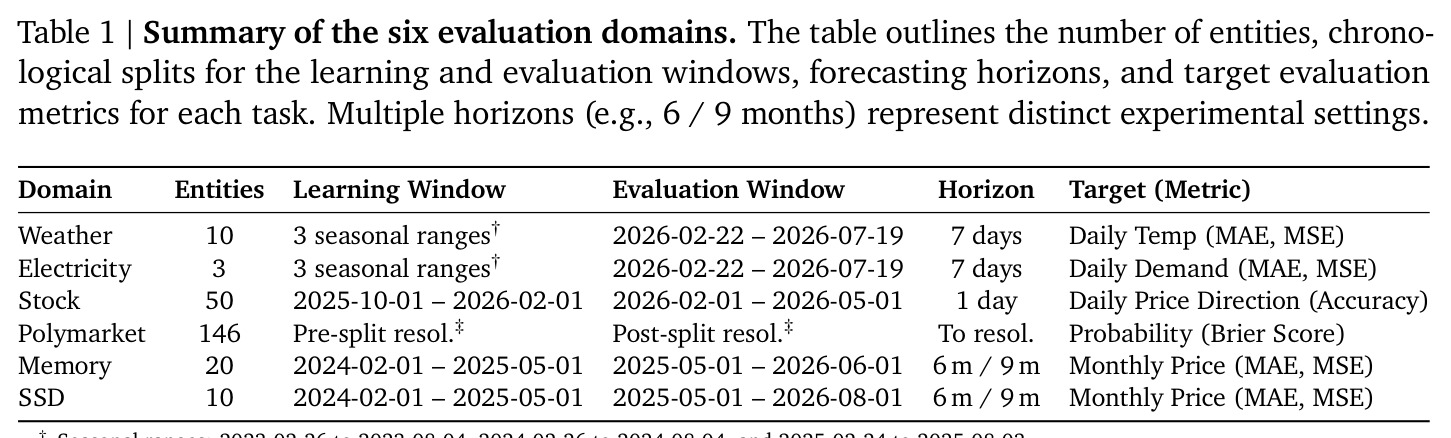
代码已在 GitHub 开源(BennyTMT/SEER),这是复现的最大利好。数据方面全部来自公开渠道:天气用 Meteostat API、电力用 Grid Status API、内存/SSD 价格来自 Pangoly 与 PCPartPicker、事件预测题取自 ForecastBench 的 Polymarket 子集,附录 A 给出了具体城市与股票清单,表 1 明确了各域的时间切分。主要成本在 LLM 与搜索 API:需要调用 Gemini 3.1 Pro/Flash 与 Claude 4.6 Sonnet/4.8 Opus 四个前沿模型并执行网络搜索,六个基准合计约 2400 个测试样本加训练期多轮反思,API 费用估计在数百美元量级;LEAF 事实核查模块的可用性也需确认。总体复现难度中等:开源代码加公开数据大幅降低工程门槛,但高昂的 API 成本、网络搜索的非确定性以及 LLM 版本迭代都会导致与论文数值的偏差,建议先用单一小域(如 SSD,仅 164 样本)验证整条流水线再全量复现。
论文图表
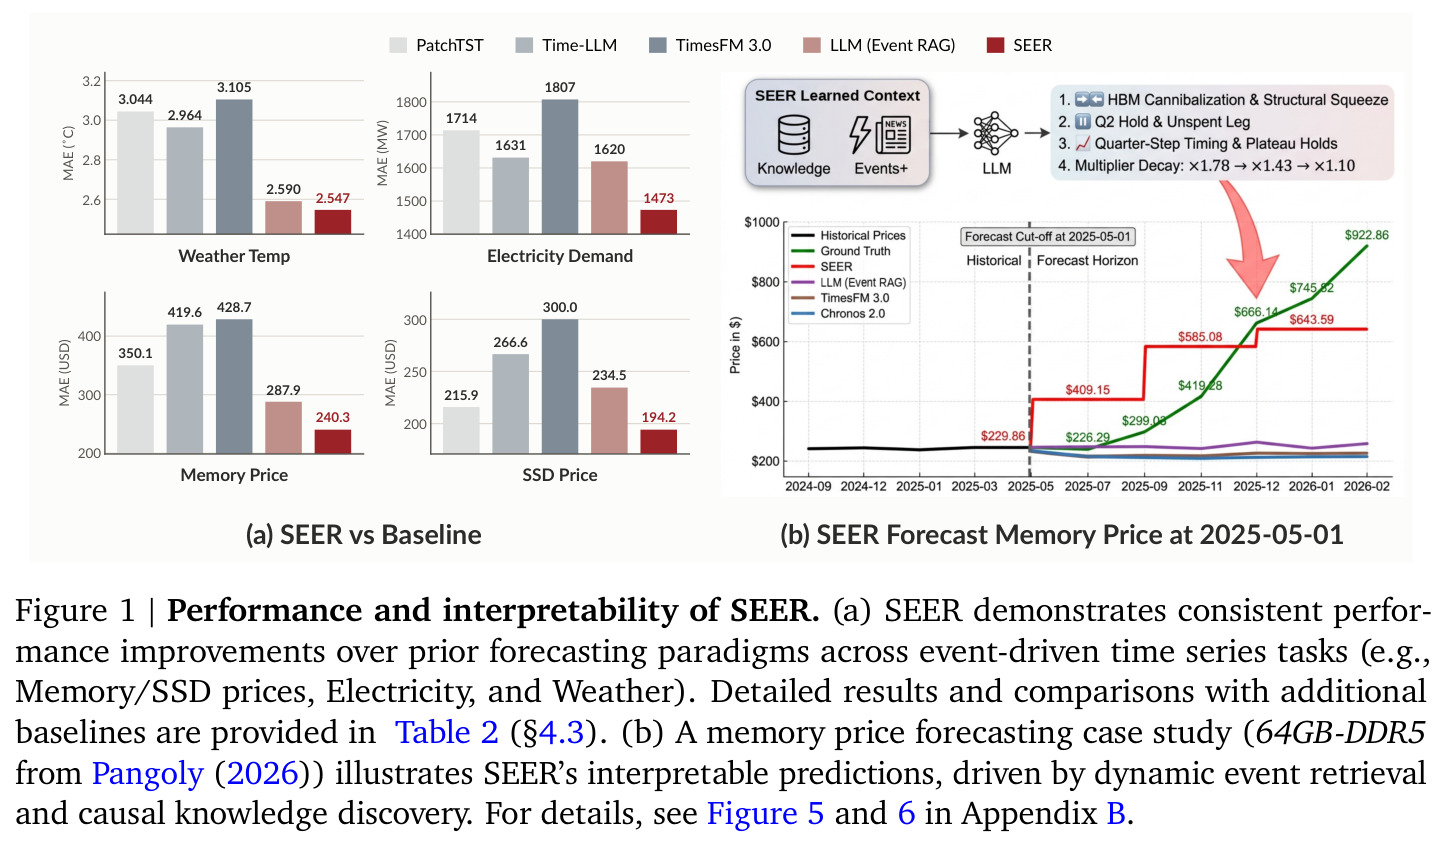
(a) 用柱状图展示四个事件驱动任务上的 MAE 对比:天气气温上 SEER 2.547°C 优于 PatchTST 3.044、TimesFM 3.0 的 3.105 与 LLM (Event RAG) 的 2.590;电力需求上 SEER 1473 MW 显著低于 TimesFM 3.0 的 1807;内存价格上 SEER 240.3 USD 对 Time-LLM 的 419.6;SSD 价格上 SEER 194.2 对 LLM (Event RAG) 的 234.5。(b) 以 64GB-DDR5 内存价格为例展示 SEER 凭借动态事件检索与因果知识给出的可解释预测曲线。
一张图同时呈现『赢了多少』与『为什么可信』两个卖点,是读者建立第一印象、判断论文分量与适用场景的入口。