OuroWorld:把任意3D世界唤醒为多样、无限循环的3D影像 OuroWorld: Bringing Any 3D World Alive as Diverse, Endlessly Looping 3D Cinemagraphs
免掩码框架把任意静态3DGS场景变成任意视角下生动无缝循环的动态3D影像
前置知识
3D Gaussian Splatting(3DGS)
3DGS 是一种显式三维场景表示:场景由数十万级各向异性高斯组成,每个高斯带位置 $\mathbf{x}$、旋转四元数 $\mathbf{q}$、尺度 $\mathbf{s}$、不透明度 $\sigma$ 与球谐颜色系数 $\mathbf{c}$,通过可微光栅化投影到图像并用光度损失优化。它训练快、能实时渲染,已是重建与生成 3D 场景的主流表示。
本文的输入与输出都是 3DGS:静态 3DGS 作为规范表示,方法为其叠加随时间变化的属性偏移。理解高斯参数化,才能理解形变场和漂移场到底在驱动什么。
周期形变场与傅里叶级数
傅里叶级数把光滑周期函数写成 $\mathbf{a}_0 + \sum_{k=1}^{K}[\mathbf{a}_k\cos(2\pi k t/T)+\mathbf{b}_k\sin(2\pi k t/T)]$,天然满足 $f(t+T)=f(t)$。本文用它参数化高斯属性随时间的偏移,使输出在数学上精确循环闭合,而不依赖从数据中拟合出的近似周期。
这是论文 looping by construction 的核心:生成视频只是近似周期,直接拟合会在循环接缝处跳变;傅里叶参数化从表示层面消除了这一误差来源。
视频扩散模型与图生视频(I2V)
视频扩散模型通过迭代去噪从文本/图像条件合成视频,能生成丰富真实的动态。图生视频以首帧图像为条件;本文进一步令首帧与末帧都等于参考图,并由 VLM 撰写动态提示词控制内容,从而得到近似循环的参考视频。
论文用视频生成模型取代人工欧拉流先验作为动力学来源,这是方法免掩码、动态多样的根本原因,也带来近似周期与跨视角不一致两大新问题。
欧拉流与 3D 影像(3D cinemagraph)
3D cinemagraph 指可从任意视角观看、含无缝循环动态的 3D 场景。已有方法用欧拉视角的逐像素速度场驱动场景,类似流体仿真,擅长烟雾、水面等流体运动,但难以表达一般形变、物体运动与光照变化,且都需掩码指定哪里动。
理解欧拉流的局限才能读懂本文动机:作者用视频先验加周期形变场替换欧拉流,从而支持火焰、星尘、船体起伏等一般动态。
LPIPS 感知损失与 SDEdit 式扩散精炼
LPIPS 用预训练网络特征衡量两图感知差异,比逐像素 $\ell_1$ 更贴近人眼判断。SDEdit 式精炼把当前渲染加噪后,以生成帧为引导用扩散模型去噪,得到既含目标动态又忠于当前场景的精炼图,避免把生成帧的缺陷逐像素复制进场景。
论文的场景-视角一致优化正是这样处理不可靠的生成帧:可靠帧用 $\ell_1$ 监督,不可靠帧经 SD v1.5 精炼后再用 LPIPS 监督。
KVD/FVD 视频分布距离
FVD 在 I3D 视频特征上计算两组视频集合的 Fréchet 距离,衡量生成结果与参照分布的差距。本文用 Kinetics-400 I3D 特征计算 KVD,以另一家视频生成模型 MiniMax H3 输出的 780 条视频为参照分布,度量渲染结果的自然程度。
该任务没有真值,论文提出免真值评测;理解 KVD 才能读懂 Naturalness 指标为何如此构造,以及为何刻意选用非自家视频模型作参照。
研究动机
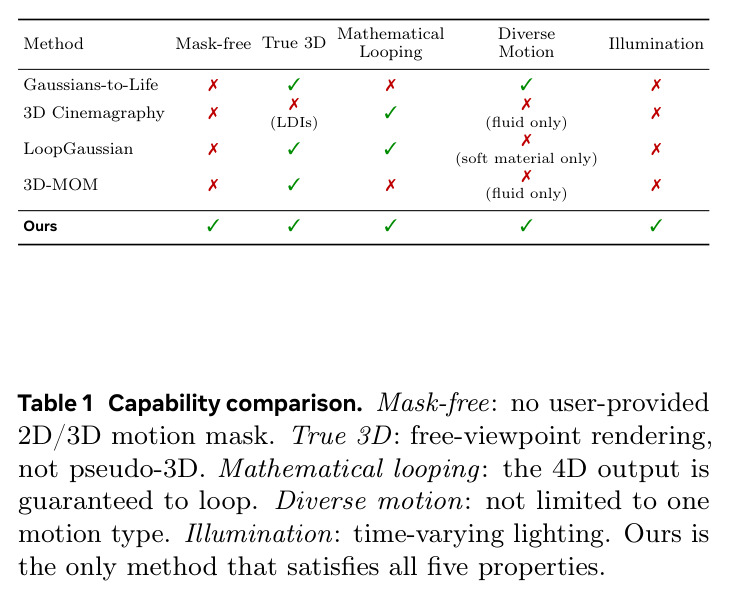
近年 3D 世界模型(HY-World 2.0、Marble、Lyra 2.0)已能生成照片级真实、可自由探索的 3D 场景,但这些世界被冻结在时间里:树叶不摇、雾不飘、灯不闪。2D 端的 cinemagraph(会动的照片)早已实现无缝循环动态,其 3D 扩展却严重受限:多平面/分层深度(LDI)方法是伪 3D,可动视角范围很小;LoopGaussian 与 3D-MOM 虽基于 3DGS,却依赖欧拉流(逐像素速度场),只能表达烟雾、水面这类流体式运动,无法处理一般形变、物体运动和光照变化;而且所有现有方法都需要用户提供或网络预测的运动掩码,无法自主决定场景哪里该动、怎么动。作者用 Table 1 总结为五个维度——免掩码、真 3D、数学保证循环、动态多样、支持光照变化——没有任何已有方法能同时满足,缺口明确。
本文的目标是本文要构建一个免掩码框架:输入任意来源(重建或世界模型生成)的静态 3DGS 场景,自动输出一个 3D cinemagraph——动态生动多样、可从任意视角渲染、且由表示本身数学保证无限无缝循环的场景,能表达火焰闪烁、水面涟漪、雾气漂移、灯光变化等超越流体的一般动态。由于该任务天然没有真值(无法采集同一场景的正确动态作为标注),作者同时提出一套覆盖生动性、自然性、循环接缝一致性与场景质量的免真值评测体系,并在 39 个场景(9 个 Mip-NeRF 360 重建场景 + 各 10 个 HY-World 2.0、Marble、Lyra 2.0 生成场景)上与 4 个基线对比,辅以 30 人用户研究验证自动指标与人类感知的对齐程度。
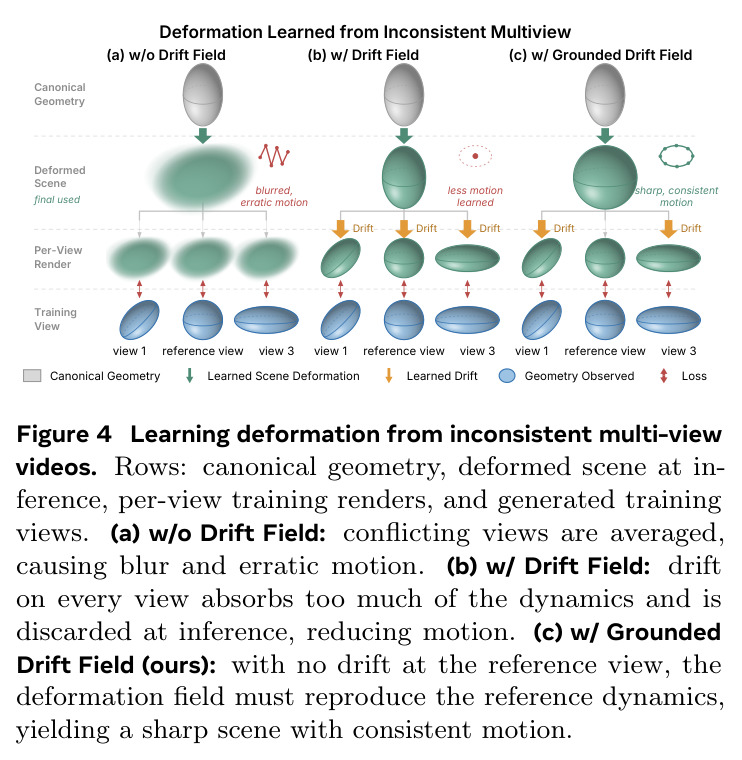
与已有工作不同的是,独特切入点是把动态从哪来外包给视频生成模型,把如何保证循环与跨视角一致外包给表示设计。直接用视频模型做监督面临两个已知难点:(1) 生成视频只是近似周期,直接拟合会在循环接缝留下可见跳变;(2) 单个视角无法约束完整 4D 场景,而生成的多视角视频彼此不一致,直接拟合会模糊场景并产生杂乱运动。与 Video-to-World 用 ICP 在几何上估计逐帧漂移不同,本文让漂移场与 4D 场景联合学习、覆盖位置/旋转/尺度/颜色全部属性,并以参考视角接地:参考视角不含漂移项,迫使共享形变场独自复现参考动态,漂移只吸收各视角相对参考的残差,推理时整体丢弃。评测上则放弃只覆盖流体或物体级数据的传统真值评测,转向与用户研究对齐的免真值指标体系。
核心方法
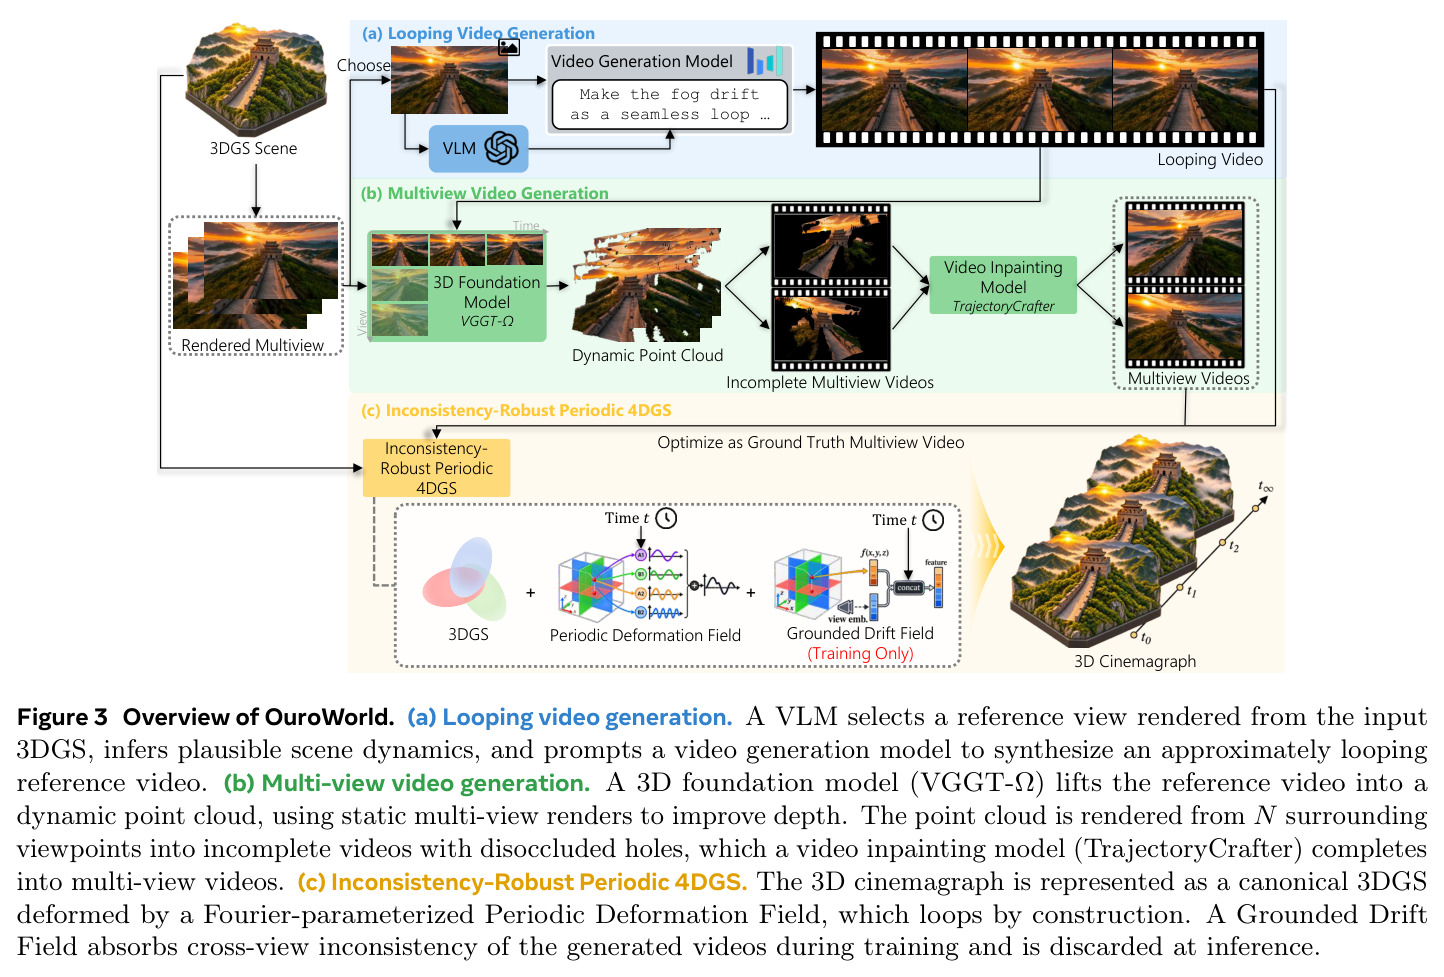
直觉上,方法要回答三个问题:场景该怎样动?多视角监督从哪来?如何在不可靠监督下学出保证循环的 4D 场景?流程分三阶段(Figure 3)。(a) 循环视频生成:从输入 3DGS 渲染参考图 $I_{ref}$(1280×720),GPT-5.5 观察图像推断合理动态并撰写提示词,Seedance 2.0 以 $I_{ref}$ 同时作为首帧和末帧生成 10 秒、720p、24FPS 的参考视频 $V_{ref}$,VLM 再过滤掉不自然结果。(b) 多视角视频生成:VGGT-Ω 一次前向接收 45 张图(21 张 $t=0$ 静态渲染 + 24 帧视频帧)估计逐帧动态点云,再从 ±20° 偏航内 N=20 个训练视角渲染出不完整视频,TrajectoryCrafter 以 672×384 分辨率补全遮挡空洞。(c) 不一致鲁棒周期 4DGS:以损失 $\mathcal{L} = \lambda_1 \mathcal{L}_1 + \lambda_p \mathcal{L}_p$ 优化规范 3DGS + 周期形变场 + 接地漂移场三件套。全部实验在单张 RTX 4090 上完成。
核心创新有两个。其一,周期形变场 $P$:在规范位置 $\mathbf{x}$ 查询 triplane 得到特征并拆成傅里叶系数,构造时间特征 $f(\mathbf{x},t)=\mathbf{a}_0+\sum_{k=1}^{K}[\mathbf{a}_k\cos\frac{2\pi kt}{T}+\mathbf{b}_k\sin\frac{2\pi kt}{T}]$,再由 MLP 解码出属性偏移;因 $f(\mathbf{x},t+T)=f(\mathbf{x},t)$,无论优化结果如何输出都精确循环,循环性从拟合出的性质变成表示的构造性质。其二,接地漂移场:$\Delta_v(\mathbf{x},t)=\mathrm{MLP}_\Delta[\mathbf{F}_\Delta(\mathbf{x}),\gamma(t),\mathbf{e}_v]$ 为各视角预测专属属性偏移,吸收生成视频的跨视角不一致;接地条件规定参考视角不加漂移($G_{t,v}=G+P$),其余视角为 $G+P+\Delta_v$,推理时丢弃 $\Delta$,否则漂移会抢走场景动态,推理时画面呆板。
方法步骤详情
所有场景先统一为 SH 阶数 3。第一步,GPT-5.5 拿到 1280×720 参考图与固定指令,输出循环动态英文提示词;Seedance 2.0 据此生成首末帧相同的 10 秒 24FPS 视频,VLM 过滤不自然结果。第二步,VGGT-Ω(1B 参数)一次前向处理 45 张图(21 张静态渲染 + 24 帧时序帧),每帧丢弃置信度最低的 10% 点,对齐到输入 3DGS 坐标系。第三步,回投参考视线一点得到 pivot,在 ±20° 偏航、半径 $r=\|\mathbf{o}_{ref}-\mathbf{p}\|$ 处取 N=20 相机渲染动态点云,TrajectoryCrafter 以 50 步采样、引导尺度 6.0 补全成 672×384 视频。第四步,优化 4DGS:triplane 分辨率 64、时间带宽 K=4、MLP 宽 128、周期 T=10 秒;参考视频与 $t=0$ 渲染用 $\ell_1$ 损失监督,其余生成帧先经 SD v1.5 五步精炼再以 LPIPS 监督,$\lambda_1=1$、$\lambda_p=0.2$。
技术新颖性
新颖性体现在四个层面。第一,这是首个免掩码 3D cinemagraph 框架:VLM 描述动态、视频模型实现动态,而 Gaussians-to-Life、3D Cinemagraphy、3D-MOM、LoopGaussian 都需要人工或网络提供 2D/3D 运动掩码。第二,循环性从拟合出的性质变成表示的构造性质:把形变限制在傅里叶级数内,消融显示把基函数周期从 $T$ 改成 $2T$(容量不变)后 Seam SSIM 从 0.9965 跌到 0.9783,证明循环保证确实来自周期参数化本身。第三,接地漂移场与 Video-to-World 的 ICP 漂移不同:ICP 只对齐几何、漏掉尺度/颜色漂移且假设静态场景,本文漂移场联合学习、覆盖全部属性,并以参考视角接地避免其吸收本应属于场景的动态。第四,提出首个面向任意场景的免真值 3D cinemagraph 评测(Vividness/KVD/MALF/Seam SSIM),其中 MALF 被刻意设计成静态视频得 0 分,防止靠不动换取无缝的作弊解。
实验结果
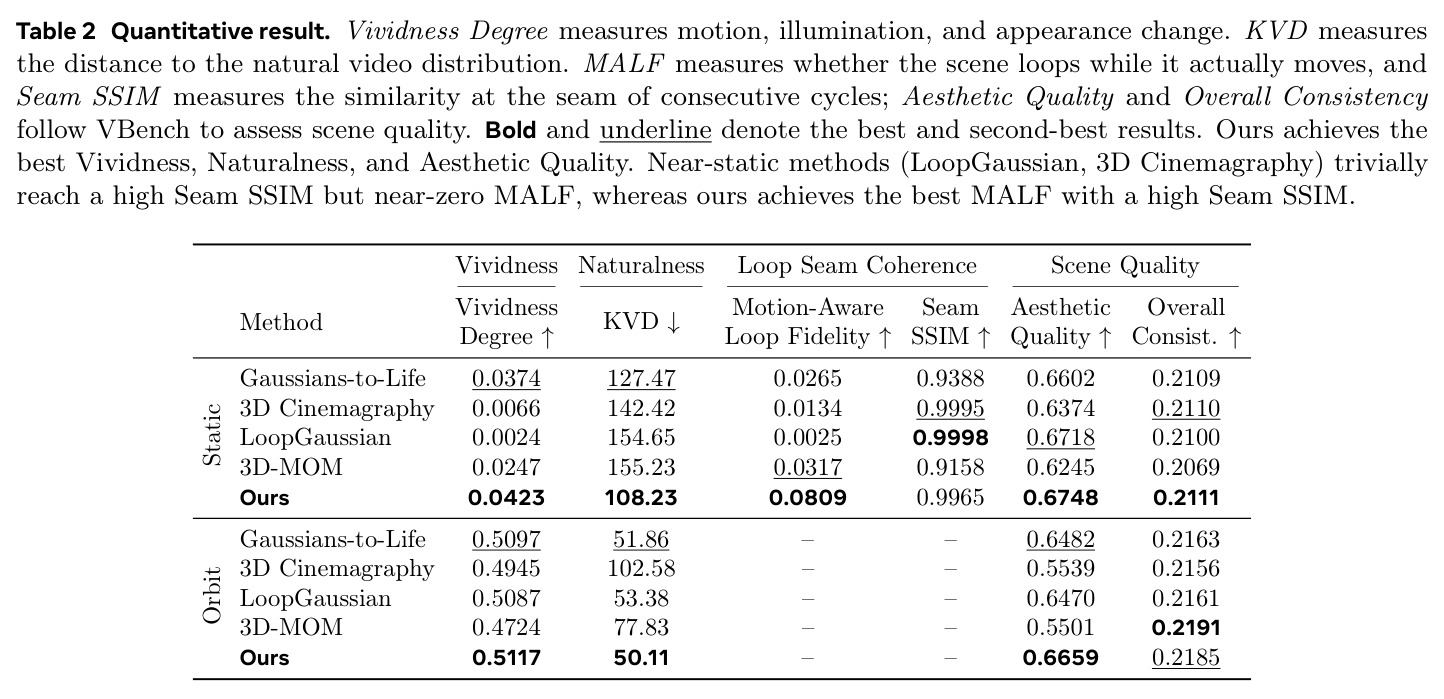
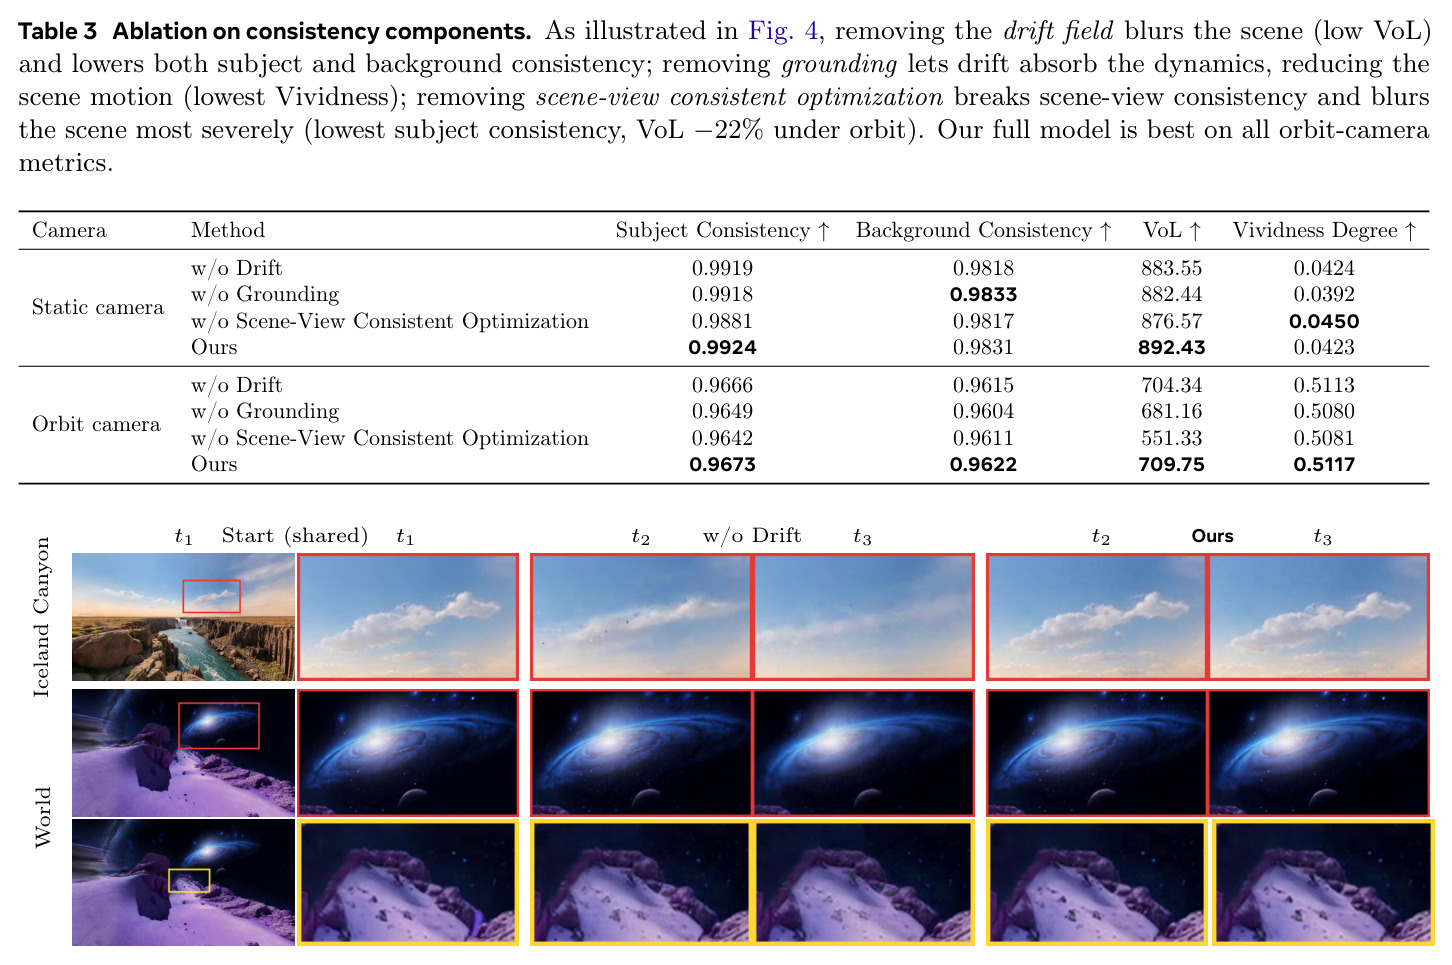
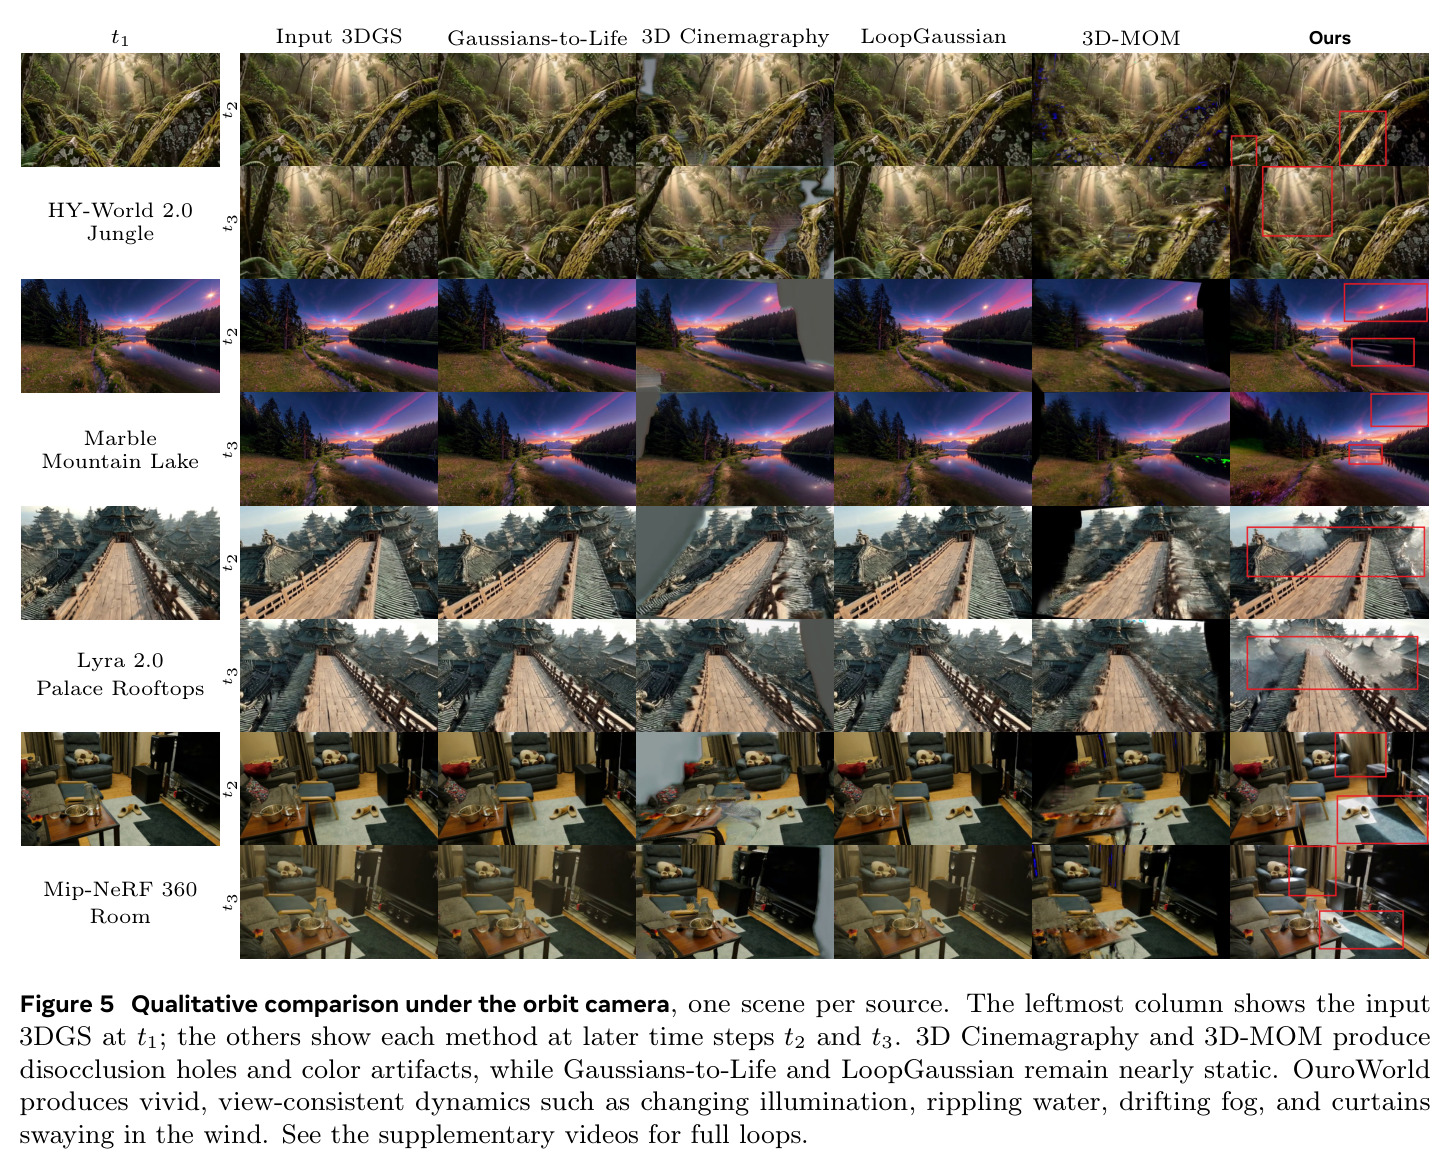
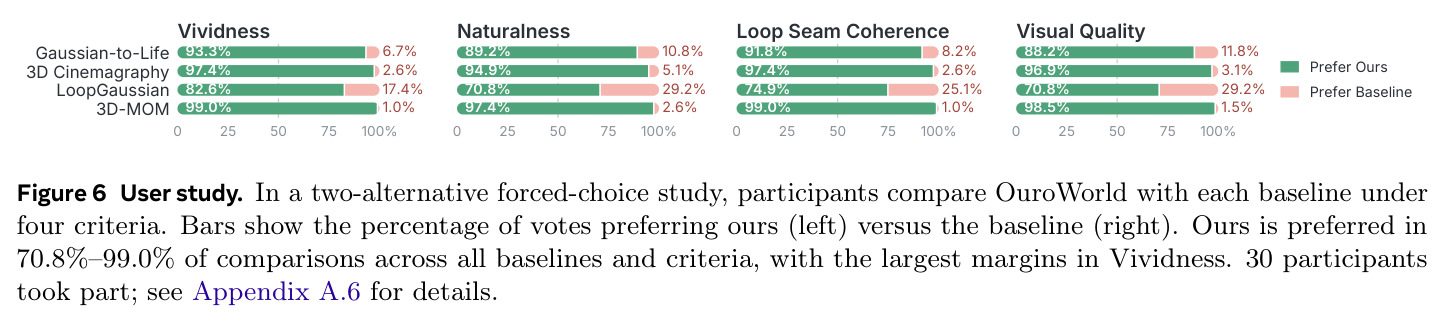
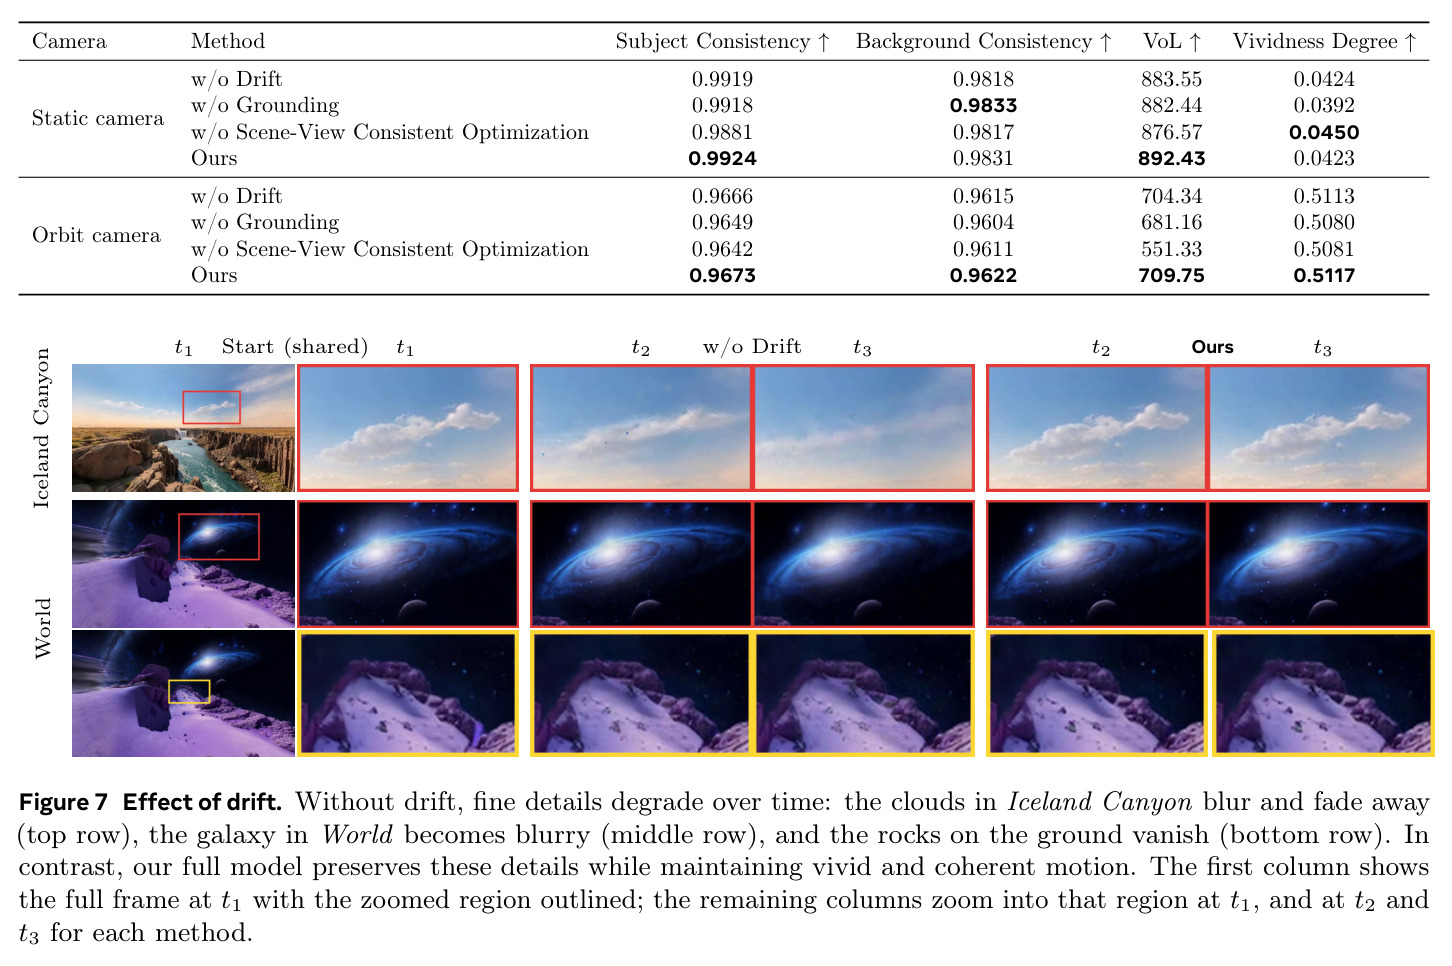
39 场景、双相机、600 帧评测(Table 2):静态相机上本文 Vividness 0.0423 最高(次优 0.0374),KVD 108.23 最低最自然(基线 127–155),MALF 0.0809 约为次名 3D-MOM 0.0317 的 2.6 倍,且 Seam SSIM 保持 0.9965,动得多且接缝无缝;环绕相机上 Vividness 0.5117、KVD 50.11、Aesthetic 0.6659 全部第一。本文光照分量 IV 0.0518 远超基线(≤0.0248,Table A.3)。用户研究(Figure 6)中本文获 70.8%–99.0% 偏好:Naturalness 对 LoopGaussian 最低 70.8%,Vividness 对 3D-MOM 最高 99.0%。消融(Table 3)中去掉接地 Vividness 跌至最低 0.0392,去掉场景-视角一致优化环绕 VoL 暴跌 22% 至 551.33;周期消融中 Seam SSIM 0.9965→0.9783 而 MALF 几乎不变(0.0788),退化集中在循环边界。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 静态相机·动态生动性 | Vividness Degree(越高越好) | 0.0423 | Gaussians-to-Life 0.0374(次优);LoopGaussian 仅 0.0024 | 较次优 +13.1%,较 LoopGaussian 提升约 17.6 倍 |
| 静态相机·自然性 | KVD(越低越好) | 108.23 | Gaussians-to-Life 127.47;最差 3D-MOM 155.23 | 较次优降低约 15.1% |
| 静态相机·循环保真 | MALF(越高越好)+ Seam SSIM | MALF 0.0809,Seam SSIM 0.9965 | 3D-MOM MALF 0.0317;LoopGaussian Seam SSIM 0.9998 但近静止 | MALF 提升约 2.6 倍,同时接缝保持无缝,兼得动与环 |
| 环绕相机·动态生动性与自然性 | Vividness Degree / KVD | 0.5117 / 50.11 | Gaussians-to-Life 0.5097 / 51.86 | 双指标第一,IV 光照分量 0.1146 亦为全场最高 |
| 用户研究(4 标准 × 4 基线) | 二选一偏好率(30 人、780 次投票) | 70.8%–99.0% | 各基线对应偏好率 1.0%–29.2% | Vividness 优势最大(对 3D-MOM 达 99.0%) |
局限与改进
作者承认两点局限:动态质量受视频生成先验的上限约束,不合理的生成会传导进最终场景(VLM 过滤只能缓解);从单一参考视频补全全部视角,在更宽视角范围下遮挡空洞与不一致会加剧,从不同视角生成多条参考视频是可能的补救。我的补充观察:其一,管线深度依赖 GPT-5.5、Seedance 2.0、MiniMax H3、SAM 3 等闭源模型,成本、可用性与可复现性都受制于外部 API;其二,循环周期固定为 $T=10$ 秒,由视频模型的时长决定,慢速场景(云、冰川)与快节奏场景共用同一周期可能节奏失配;其三,Naturalness 用另一个视频生成模型当参照分布,存在生成模型自证的循环偏置;其四,pivot 与参考视角仍需人工选择,训练相机仅覆盖 ±20° 偏航,所谓任意视角目前只在较小锥角内成立。
独立分析的弱点
弱点一:单参考视频加 20 视角补全的流水线误差链很长——VLM 提示、视频生成、点云提升、视频修补每一环的缺陷都会累积到 4D 优化;改进方向是从多个参考视角并行生成视频并施加跨视频一致性约束。弱点二:漂移场只在训练期使用、推理时整体丢弃,各视角的残差误差并未被真正建模,宽基线视角下输出缺乏监督信号;可以探索推理期的多视角一致性正则或测试时自适应。弱点三:MALF 与 Seam SSIM 只在静态相机、单条接缝上计算,跨多周期的缓慢相位滑动可能被低估,可增加多周期接缝统计。弱点四:Vividness 的阈值(光流 0.3%×min(H,W)、亮度变化 20%)为经验设定,跨分辨率、跨内容类型的泛化性未验证。弱点五:优化迭代次数需按场景人工调整,缺少自动停止准则,也未见训练时间与显存的完整报告。
未来方向
作者提出的最直接延伸是从不同视角生成多条参考视频,以扩大有效视角范围、减少宽基线下的遮挡与不一致。在此基础上的自然延伸包括:把扩散精炼从 SD v1.5 单帧模型升级为视频扩散模型,实现时序一致的跨视角精炼;把傅里叶级数从单一全局周期扩展为逐高斯或分区域基频(例如 2 秒的水波叠加 10 秒的光照周期),表达多尺度周期运动;向用户开放 VLM 提示词编辑与区域指定,实现指哪动哪的可控生成;用前馈网络把整条管线蒸馏为一次前向推断,摆脱对闭源 API 的依赖;以及把该框架嵌入世界模型的生成循环,让生成的世界天生自带动态,形成生成-唤醒-再生成闭环。
复现评估
复现难度中等偏高。项目页 ouroworld.userwei.com 公开并附补充视频,但正文未明确承诺开源代码。数据基本可复现:39 个场景全部来自公开源——Mip-NeRF 360 官方数据加官方 3DGS 代码重建、Marble 与混元画廊直接下载、Lyra 2.0 用官方代码生成(附录 A.1 给出完整重建配方:64 关键帧、VGGT-Ω 初始化、gsplat 30k 迭代,NVPSNR 22.1dB/SSIM 0.71)。算力友好:全部实验在单张 RTX 4090 上完成。主要障碍在闭源依赖:GPT-5.5(写提示词与过滤)、Seedance 2.0(参考视频)、MiniMax H3(KVD 参照分布)、SAM 3(基线掩码),且掩码需人工逐一核验、pivot 与参考视角需人工选择。超参数在 Table A.1 给得很全(triplane 64、K=4、MLP 宽 128、$T=10$s、$\lambda_1=1$、$\lambda_p=0.2$、修补 50 步/引导 6.0/seed 43),复现主要成本在 API 调用与人工环节。
论文图表
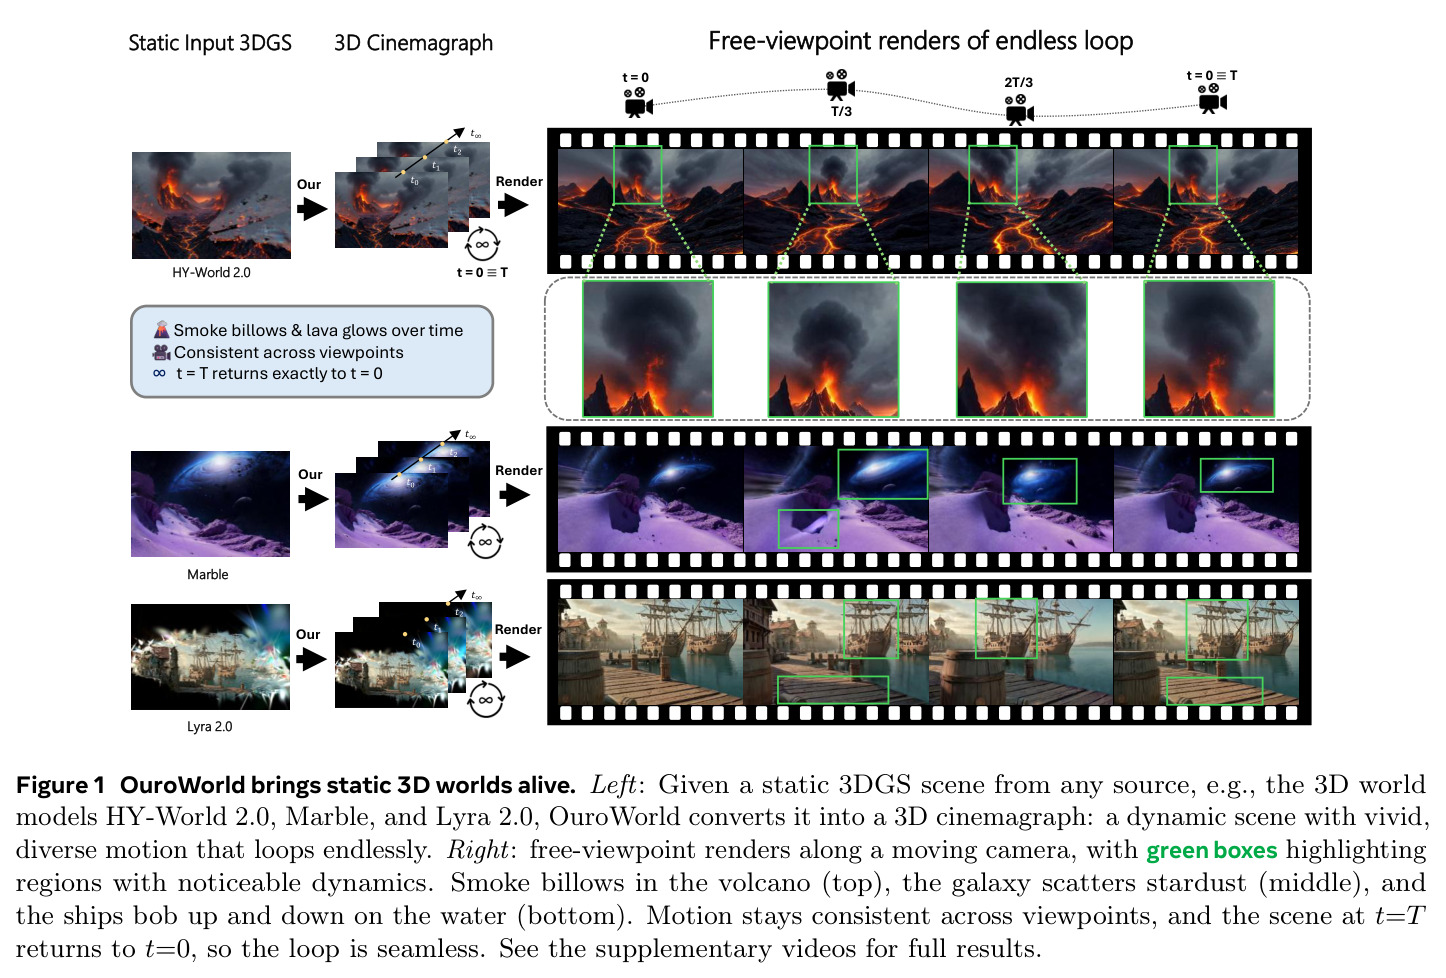
左图展示来自 HY-World 2.0、Marble、Lyra 2.0 三个世界模型的静态 3DGS 场景经本文方法转换为 3D 影像;右侧展示沿移动相机的自由视角渲染,绿框标出动态区域:火山冒烟发光、星系散落星尘、船只在水面起伏,t=T 时场景精确回到 t=0,跨视角保持一致。
一图看懂任务定义与最终效果,是理解 3D cinemagraph 概念的入口。
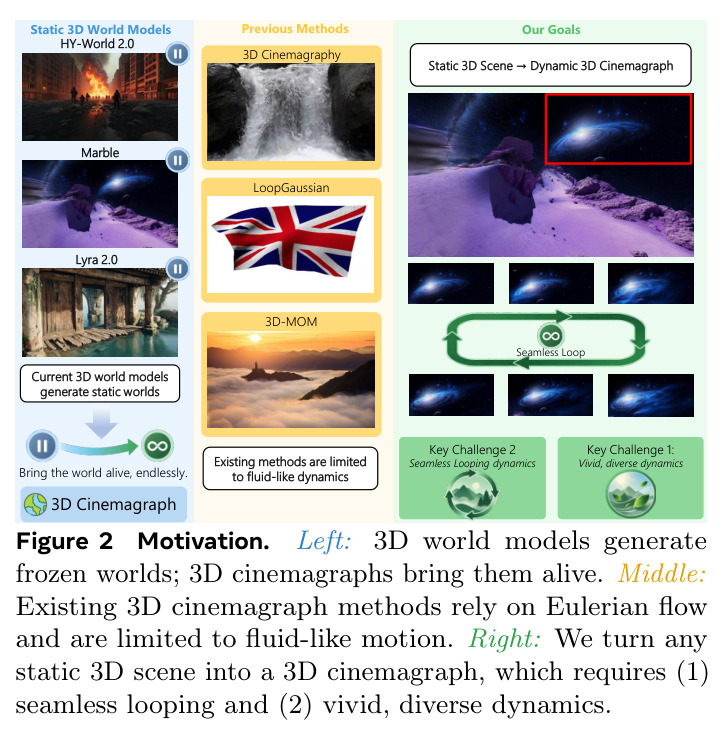
左列展示 3D 世界模型(HY-World 2.0、Marble、Lyra 2.0)只能生成静态世界;中间列出已有 3D 影像方法(3D Cinemagraphy、LoopGaussian、3D-MOM)局限于流体动态,并给出两大关键挑战:生动多样动态与无缝循环;右列展示把静态场景变为动态影像的目标。
清晰呈现研究动机与两大核心挑战,是理解论文问题设定的框架图。
列出三阶段全部关键设置:GPT-5.5/Seedance 2.0、1280×720、10s/24FPS;提升阶段 21 静态渲染+24 时序帧、512×288、丢弃 10% 低置信点;多视角阶段 20 视角、±20°、672×384、50 步采样/引导 6.0;IRP-4DGS 的 triplane 64、时间带宽 K=4、MLP 宽 128、周期 T=10s、损失权重 λ1/λp=1/0.2。
复现该方法所需的最完整超参数清单,附录中最实用的一张表。
五种方法的场景输入(3DGS 或单图)、运动输入(3D 掩码+文本 / 2D 掩码 / 无)与原生周期:Gaussians-to-Life 0.5s(不循环)、3D Cinemagraphy 2.4s、3D-MOM 与 LoopGaussian 2.0s、本文 10s。评测保留各方法原生周期并重复填充 20 秒。
解释评测协议中保留原生周期的公平性设定,也是各方法输入需求差异的一览表。
静态相机下 Gaussians-to-Life 的 MV/VV 最高(0.0588/0.0364,0.5s 短周期所致)但 MALF 极低,本文 IV 0.0518 远超所有基线(≤0.0248);环绕相机下各方法 MV 相近(被相机运动主导,约 0.91–0.94),差异主要来自 IV,本文 0.1146 最高。
细分指标揭示本文优势主要来自光照动态这一关键结论,只看 Vividness 总分看不到。
指令要求 VLM 描述多处自然运动(方向/时机/强度可不同)、主运动必须正常播放速度下明显可见且渐入、禁止新增物体或让物体穿过相机、保持相机固定并形成无缝循环;若场景无自然运动可添加光照/阴影变化;输出单一简洁英文提示词。
免掩码能力的核心一环——VLM 如何替用户决定场景怎么动,且该提示词同时提供给所有基线以保证公平。
为需要掩码的基线,从 GPT-5.5 提示词中用规则解析器提取运动实体名词,用 SAM 3 文本概念分割得到 2D 掩码(置信度≥0.45、过滤覆盖全图的退化预测、去除小于 0.08% 的碎块),再经深度反投影选出深度区间内的高斯得到 3D 掩码,典型场景约含 14% 高斯。
展示输入对齐策略——让所有基线获得与本文同等信息量的输入,保证对比公平,这是实验设计严谨性的体现。
每个 trial 展示同一场景两个方法的渲染视频(左右随机),参与者按 Vividness/Naturalness/Loop Seam Coherence/Visual Quality 四个问题分别投票;39 场景 × 4 基线 = 156 对,每对 5 人、共 780 次投票,30 名参与者每人评判 26 对。
说明用户研究协议的完整性与统计功效,支撑自动指标与人类感知对齐的论断。