LEGO:免三维提升的外中心到自我中心视频生成框架 LEGO: A Lifting-Free Approach for Exocentric-to-Egocentric Video Generation
用学习式视图合成器替代点云重建,以先对齐后锐利的条件驱动扩散模型生成第一人称视频
前置知识
外中心/自我中心视频
外中心(exocentric)指第三人称相机拍摄的视频,如架在场景中的固定摄像机;自我中心(egocentric)指头戴设备(如 Project Aria 眼镜的鱼眼相机)拍摄的第一人称视频。两个视角的画面重叠极少,目标视角的大部分内容在源视角中未被观测,因此该转换是新视角合成中的极端情形。
本文任务就是把单条外中心视频转换为目标自我中心轨迹下的视频,理解两种视角的几何差异与相机模型(pinhole vs 鱼眼)是理解全文动机和方法设计的前提。
视频扩散模型与条件机制
扩散模型通过逐步去噪生成数据,视频扩散模型(如 Wan2.1-I2V-14B)以噪声潜变量为输入,接受文本、参考图像、控制信号等条件。条件决定生成内容的结构:条件里有什么,模型就倾向生成什么;条件中的错误会直接传播到输出,而条件缺失的细节可由模型先验补全。
论文的中心问题是“该给视频扩散模型什么样的条件”。LEGO 的全部设计围绕条件展开:替换条件内容并在采样时施加引导,完全不改动生成器本身。
点云提升与重投影
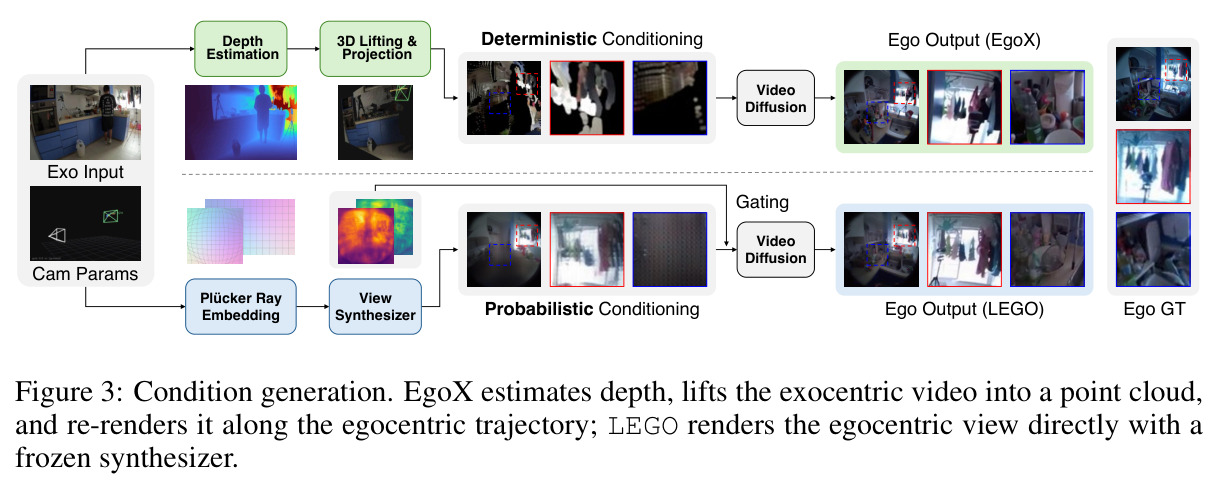
显式3D重建路线:先用单目深度估计把每帧像素反投影成带深度的3D点云,再沿目标相机轨迹把点云重投影渲染成目标视角图像。这是确定性的逐像素映射,深度估计误差会直接变成内容放错位置,且遮挡区域留下空洞。现有最先进方法 EgoX 即以此渲染作为扩散模型的条件。
论文出发点是论证这种“锐利但可能错位”的条件劣于“模糊但对齐”的条件,点云管线与学习式合成器的对比是贯穿全文的论证主线。
Plücker 射线嵌入
用六维向量 $r(u)=(d(u),\, o\times d(u))\in\mathbb{R}^6$ 表示像素 $u$ 对应的相机光线,其中 $d$ 是单位方向向量,$o$ 是相机中心,$o\times d$ 是光线的矩。当所有位姿表示在外中心相机系中时,矩分量携带两相机间的米制基线。把射线图作为通道输入,几何信息即以纯输入形式进入网络。
LEGO 的视图合成器只通过射线图接收几何,因此鱼眼相机适配、跨数据集迁移都无需改架构,这是“免提升”设计能成立的关键表示。
LVSM 与前馈式视图合成
LVSM 是纯 transformer 的前馈新视角合成模型:带姿态的源视角图像编码为源 token,目标视角的射线编码为 query token,用交叉注意力直接回归目标视角图像,绕过显式3D表示。其内部注意力权重天然构成源-目标位置间的软对应分布,这是无需对应监督就涌现几何的机制。
LEGO 微调 LVSM 作为视图合成器 F,并从其最后 L 层注意力的跨头平均中提取对应分布 $p_u(v)$,进而导出逐区域置信度,这是门控与 ARC 引导的信号来源。
Flow matching 与去噪轨迹
生成器用流匹配训练:构造噪声潜变量 $z_\sigma=(1-\sigma)z_0+\sigma\epsilon$,网络预测速度 $v\approx\epsilon-z_0$,采样沿 $\sigma_0=1>\sigma_1>\cdots>\sigma_n=0$ 的调度推进。每步可由当前速度恢复干净估计 $\hat{z}_0=z_i-\sigma_i v$,该估计决定这一步的前进方向,布局在高噪声早期步成形、细节在后期补全。
ARC 引导正是在干净估计上做置信度加权混合再反推修正速度,理解流匹配的采样几何(式 5-7)是看懂 ARC 推导的基础。
研究动机
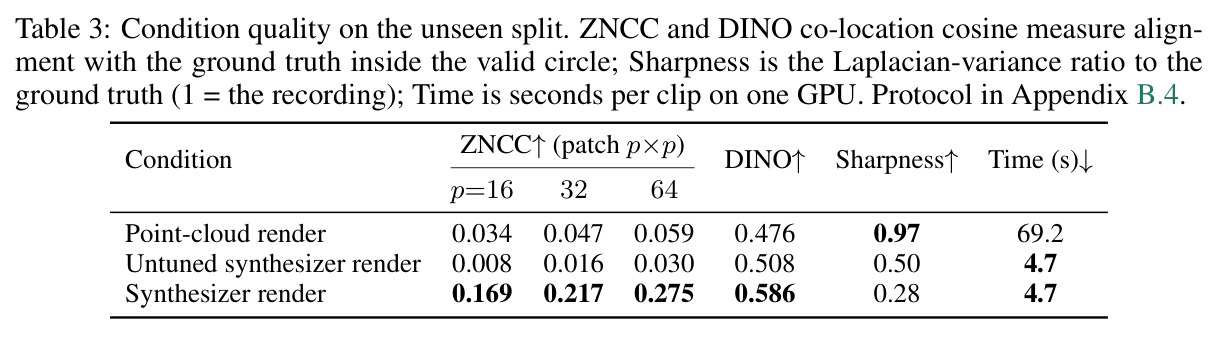
自我中心(第一人称)数据稀缺而外中心(第三人称)视频极为丰富,把后者转换成前者有很高的应用价值,但两者视角重叠极少,大量目标区域必须凭空合成。现有方法分两类:早期方法依赖特权输入(环绕多相机、丰富多模态观测或真实的自我中心首帧),或仅隐式条件在外中心特征上;当前最先进的 EgoX(Kang et al., 2026)走显式重建路线——用视频位姿引擎估计深度,把外中心视频提升为点云,沿自我中心轨迹重渲染后作为 Wan2.1-I2V-14B 视频扩散模型的条件,并在训练中加入深度导出的跨视角注意力偏置 GGA。这条确定性管线的问题在于:每个像素被指派到唯一的重投影位置,深度误差直接以“内容放错位置”的形式进入条件,画面锐利却毫无出错信号;实验数据显示点云渲染在有效圆内的覆盖率仅 53.4%,且深度估计加点云渲染每个 clip 需 69.2 秒,而学习视角变化又恰恰在这种极端场景下让单目深度最不可靠。
本文的目标是论文追问一个更根本的问题:视频扩散模型到底应该接收什么样的条件?作者的目标是构建一个免提升(lifting-free)的 exo→ego 生成框架:全程不做深度估计、不建点云、不做重投影,而是微调一个 LVSM 式学习视图合成器直接渲染自我中心视角,用其渲染替代点云渲染作为条件;同时利用合成器内部对应分布的集中程度导出逐区域置信度,一方面对低置信区域做门控置灰,另一方面在推理时引导早期去噪步骤(ARC)。整个过程中扩散生成器及其训练完全不变,与 EgoX 使用相同的骨干、LoRA 配置、画布和训练配方,从而把性能差异干净地归因于条件输入与采样方式的改变。
与已有工作不同的是,本文的独特切入是把“条件的失败方式”本身作为设计准则。显式点云映射是确定性的:每个目标像素对应唯一源像素,纹理保持锐利,但深度误差原样转化为错位内容,统计上这是偏置(bias)。学习式合成器的映射是概率性的:每个区域按学习到的对应分布 $p_u$ 对候选源位置取平均,纹理被模糊但内容保持在对的位置,统计上这是方差(variance)。作者论证这两种失败代价不对等——去噪训练使扩散模型天然擅长从模糊输入恢复细节(超分辨率、SDEdit、级联扩散都证明了这一点),而纠正“锐利但错位”的条件需要专门的放松机制。由此得出“条件应先对齐、后锐利”的原则:条件负责说清东西在哪,外观细节交给生成器。这一视角把合成器的模糊从缺陷变成特性,且置信度是从对应分布免费获得的副产品,无需任何额外网络或标注。
核心方法
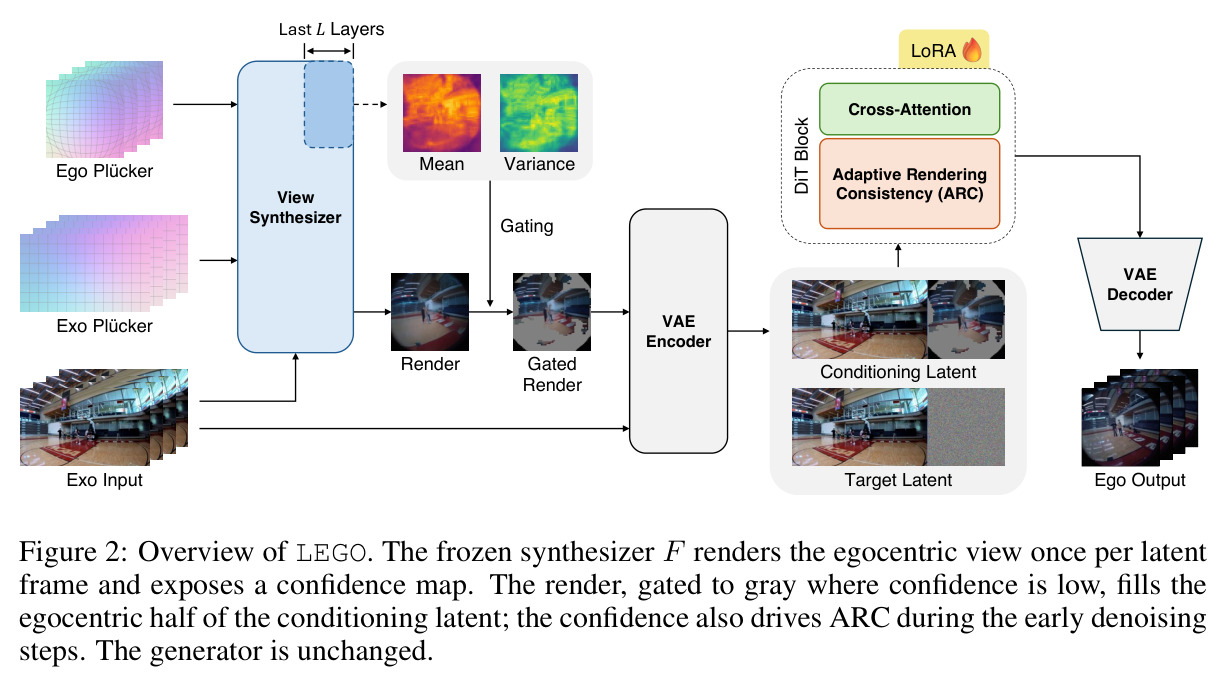
直觉上,与其让几何重建硬性决定每个像素从哪来,不如让见过大量 exo-ego 配对数据的网络软性解决对应问题,并把它有多大把握显式告诉生成器。技术路线分三步。第一步训练视图合成器 F:LVSM 架构(24 层 transformer、宽 768),输入外中心帧与两视角 Plücker 射线图 $r(u)=(d,o\times d)$,直接回归自我中心帧,仅用真实 ego 帧做 $\ell_2$+LPIPS 监督,无深度或对应标签;鱼眼射线由标定模型逐像素牛顿迭代反投影得到。第二步置信度门控:从 F 最后 8 层注意力跨头平均得到对应分布 $p_u(v)$,取 top-16 概率质量为置信度 $c(u)$,低于 $\tau=0.3$ 处置为中性灰,门控渲染填入条件潜变量的 ego 半边。第三步 ARC 免训练引导:推理时在前 80% 去噪步把干净估计的 ego 部分替换为 $\hat{z}'_0=(1-c^2)\odot\hat{z}_0+c^2\odot E$($E$ 为未门控渲染潜码),反推修正速度交给求解器。F 全程冻结,渲染与置信度每 clip 只预计算一次。
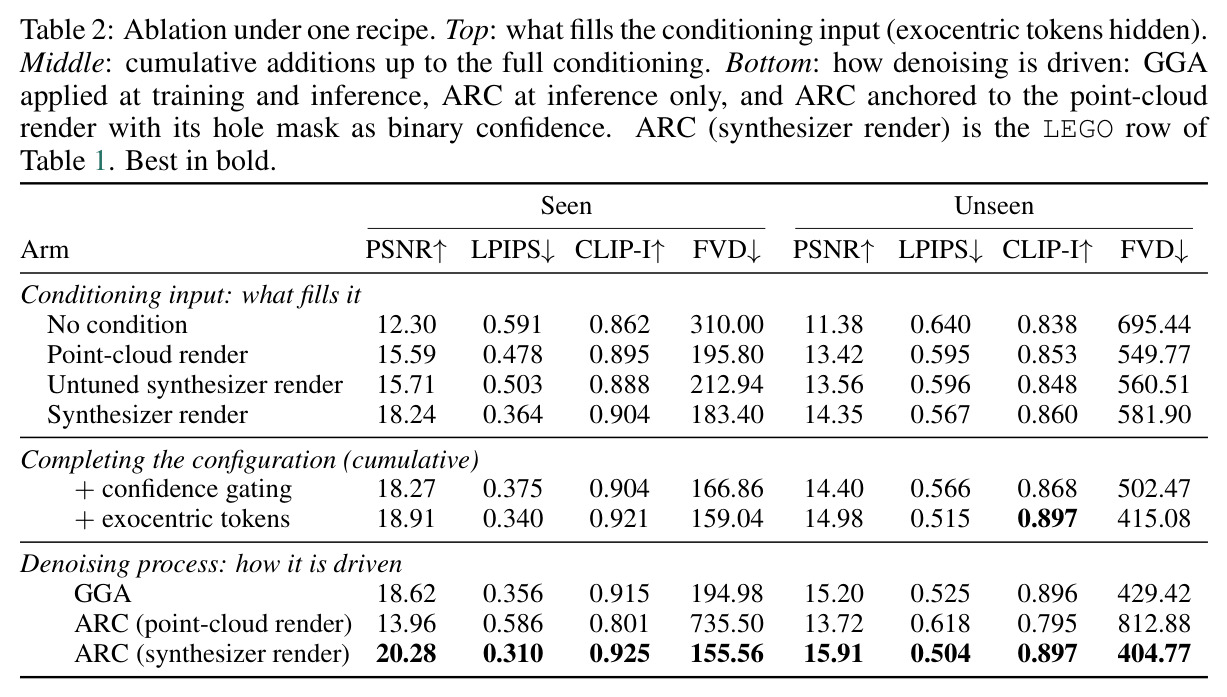
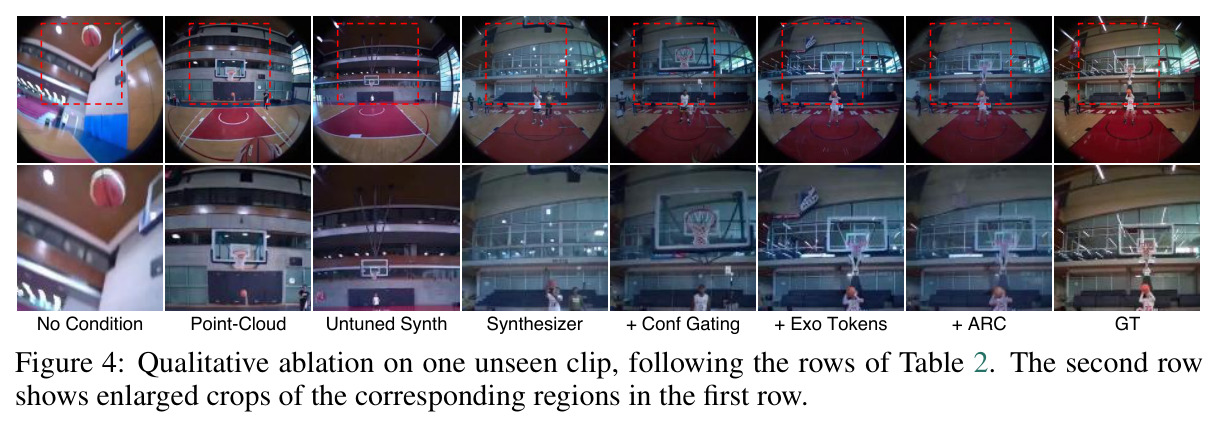
核心创新是“用概率映射替换确定性映射”的条件替换哲学。与 EgoX 的深度-点云-重渲染显式管线不同,LEGO 让合成器在渲染目标内部隐式学习跨视角对应:像素级近似为 $\hat{I}^{ego}(u)\approx\sum_v p_u(v)\,I^{exo}(v)$,即对所有候选源位置按对应分布加权平均,深度误差不再变成错位内容而是变成可被扩散模型修复的模糊。第二个关键是同一对应分布的浓度免费充当置信度:概率映射不像点云渲染那样留下几何空洞、无法自动“放弃”无证据区域,于是用 top-$k$ 质量门控显式恢复放弃能力,把低置信位置交还给生成器先验;ARC 则把该置信度复用为推理时引导,仅在决定布局的早期高噪声步起作用,替代 EgoX 必须训练的 GGA 注意力偏置。消融还给出一个重要反例:把 ARC 锚定在点云渲染(以空洞掩码为二值置信度)反而崩溃(seen PSNR 13.96、FVD 735.50,远差于不引导),证明引导必须锚定在对齐的渲染与可信的置信度上——这从反面印证了条件选择原则。
方法步骤详情
输入设定同 EgoX:单条带标定的外中心视频加目标自我中心轨迹;外中心按 pinhole 处理,ego 射线按 Aria 鱼眼模型逐像素牛顿迭代求逆。第 1 步合成器微调:从 LVSM 公开权重初始化,在 Ego-Exo4D 上以 448×448 ego、448×784 exo 分辨率训练 10k 步(4×H200 约 3.5 小时),学习率 $2\times10^{-5}$、batch 16,随后冻结。第 2 步条件构建:每 clip 预计算渲染与置信度图(最后 8 层、头平均、softmax 限于 exo 键、2×2 池化),$k=16$、$\tau=0.3$ 门控置灰后经 VAE 编码,填入 49×448×1232 画布的 ego 半边,exo 半边保留 exo tokens。第 3 步生成器训练:Wan2.1-I2V-14B 加 LoRA(rank 256、$\alpha=256$),20k 步、bf16、4×H200、seed 42。第 4 步推理:50 步、CFG 5.0、UniPC 求解器;前 80% 步施加 ARC:$\hat{z}'^{ego}_0=(1-c^2)\odot\hat{z}^{ego}_0+c^2\odot E$,$v'=v-c^2\odot(E-\hat{z}^{ego}_0)/\sigma_i$($\sigma$ 下限 0.05),其后各步不受约束。
技术新颖性
技术新颖性体现在四层。第一,条件类型创新:首次把学习式视图合成器的渲染作为视频扩散模型的条件用于 exo→ego 任务,替代“深度估计+点云+重投影”的显式重建,且合成器只通过渲染和置信度进入管线,可随更强的前馈合成器即插即用。第二,置信度的免费来源:置信度直接读自对应分布的 top-$k$ 概率质量,不需要额外置信度网络或不确定性建模,一个信号同时驱动条件门控与采样引导。第三,训练无关的引导:ARC 作用于流匹配采样轨迹的干净估计上,每步仅 2.7 毫秒,而 EgoX 的 GGA 偏置要在每个 transformer 块、每次前向重建 252 毫秒的稠密注意力偏置且必须参与训练;ARC 仅在前 80% 步生效的“早期布局引导”设计也与训练时全程施加之类方法不同。第四,论证层面的贡献:论文用统计学的 bias/variance 语言解释了显式与学习式条件的失败模式差异,并用 ZNCC 对齐度、Laplacian 锐度、输出锐度恢复实验系统验证“先对齐后锐利”原则,为条件化扩散模型的设计提供了一个可迁移的判断标准。
实验结果
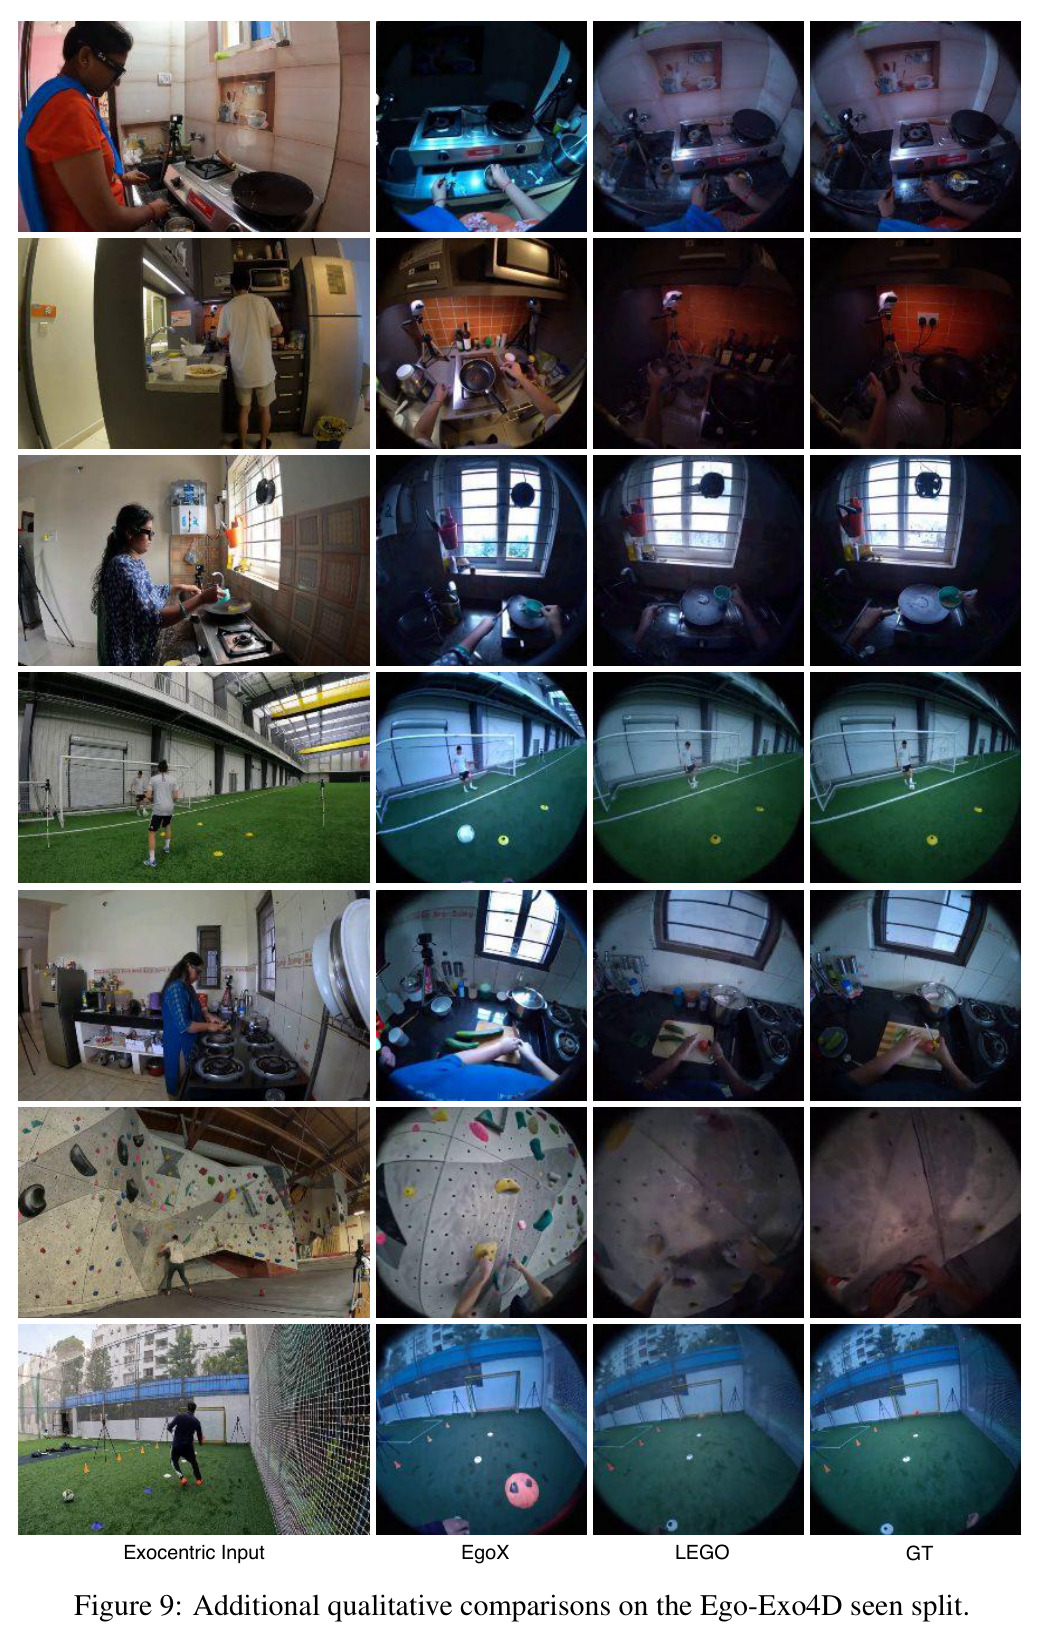
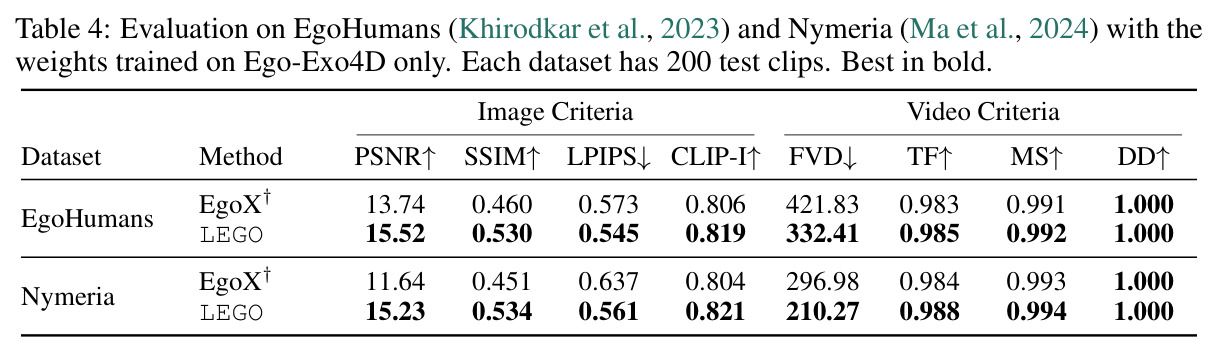
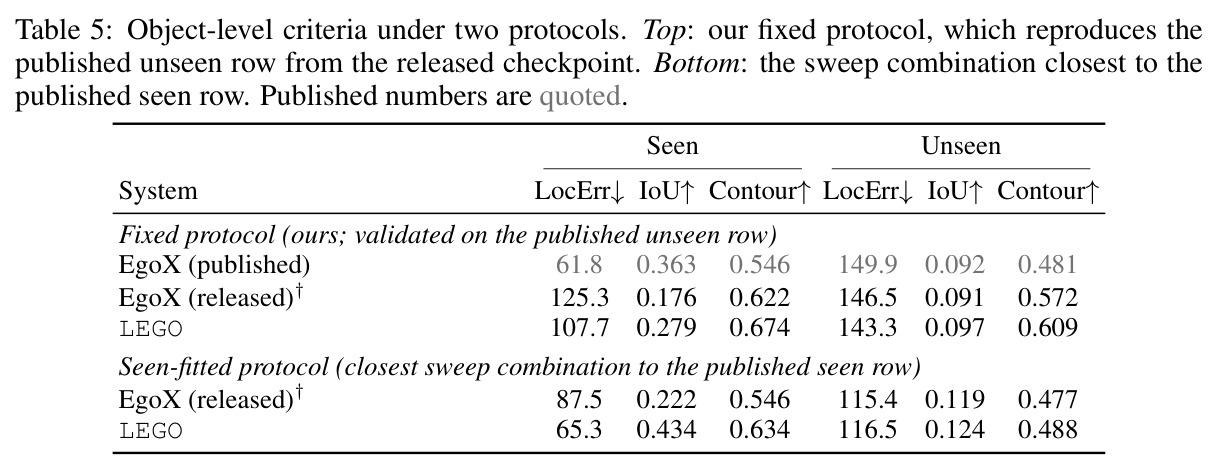
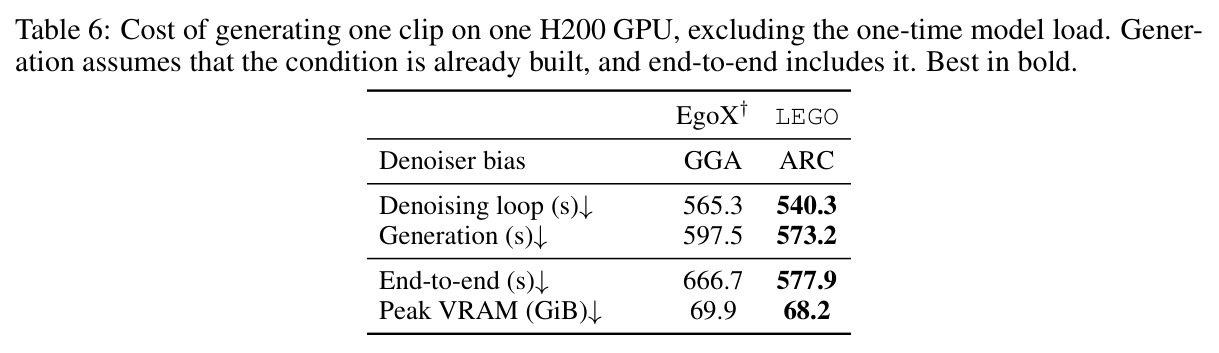
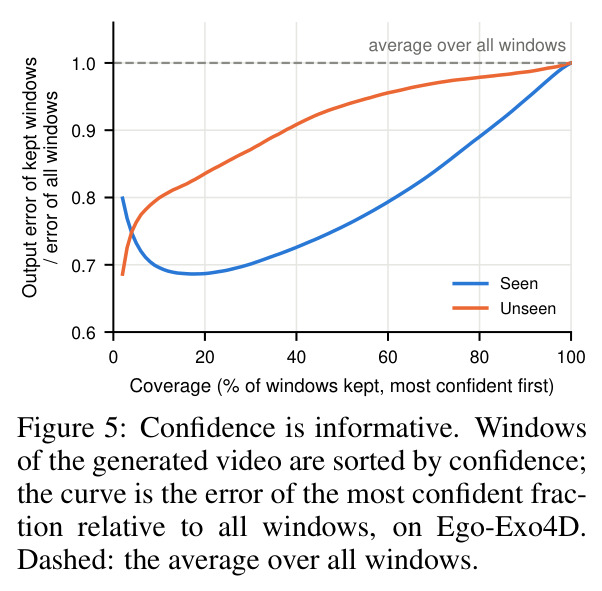
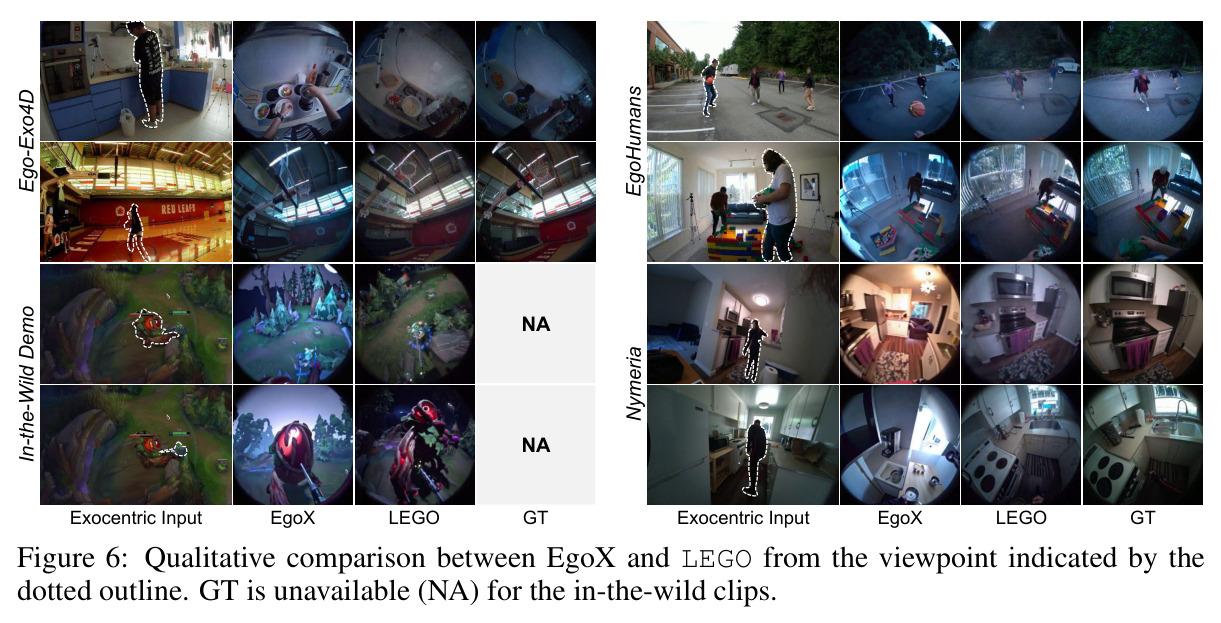
Table 1:Ego-Exo4D seen 上 LEGO 达 PSNR 20.28、LPIPS 0.310、FVD 155.56,优于 EgoX 发表值 16.05/0.498/184.47;unseen 上 PSNR 15.91、FVD 404.77 对 14.38、440.64。Table 2 消融:微调合成器渲染 seen PSNR 18.24 优于点云 15.59,未微调版 15.71 与点云打平,说明增益来自鱼眼相机适配;置信度门控使 FVD 降至 166.86/502.47,加 exo tokens 后达 18.91、415.08;ARC 锚定合成器渲染达 20.28/155.56,锚定点云则崩溃至 735.50。Table 3:合成器渲染最模糊(锐度 0.28 对 0.97)但对齐最好(ZNCC@64 0.275 对 0.059,有效圆内高 4.2 dB),耗时 4.7 秒对 69.2 秒。Table 4 零样本迁移:EgoHumans 15.52/332.41 对 13.74/421.83,Nymeria 15.23/210.27 对 11.64/296.98。Table 5 物体级固定协议下 LEGO 全胜(seen LocErr 107.7 对 125.3)。Figure 5 显示高置信窗口误差恒低于全体平均;附录 C.2 证明条件模糊不会留在输出(输出锐度 1.04 对 1.10),但色度受条件影响(0.45 对 0.82);Table 6 端到端 577.9 对 666.7 秒。
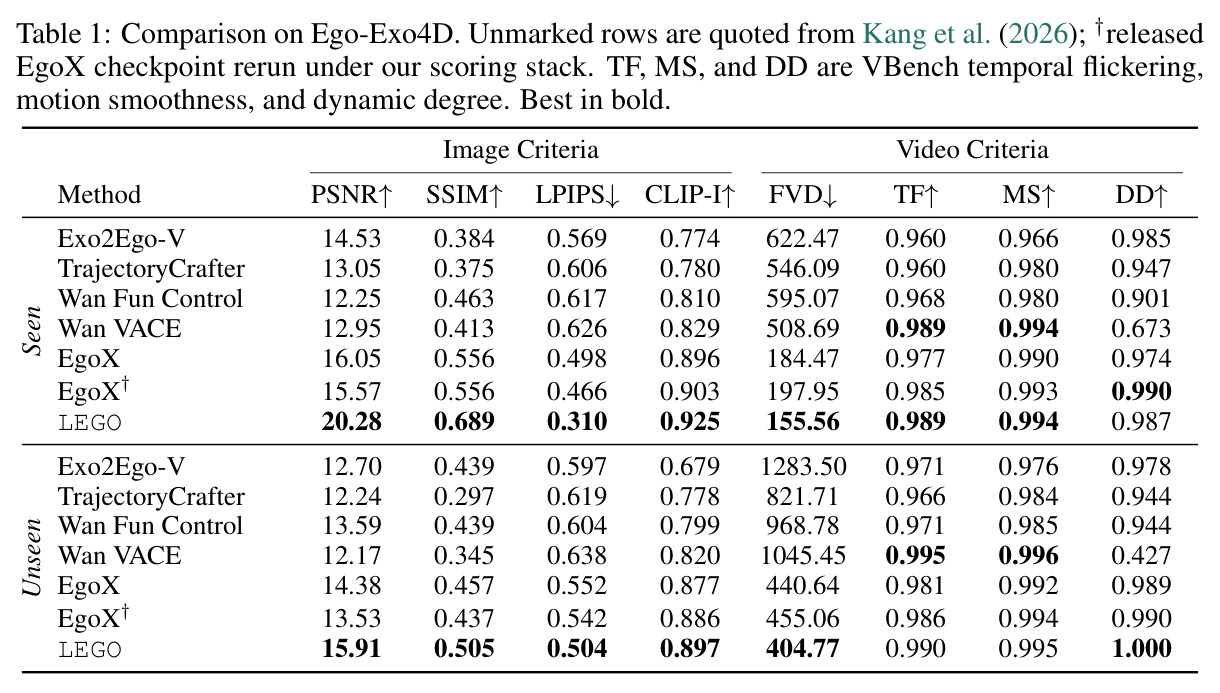
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Ego-Exo4D seen 视频生成 | PSNR (dB) | 20.28 | EgoX 16.05(EgoX† 重跑 15.57) | +4.23 dB |
| Ego-Exo4D seen 视频生成 | FVD | 155.56 | EgoX 184.47 | 降低 15.7% |
| Ego-Exo4D unseen 视频生成 | PSNR (dB) / LPIPS | 15.91 / 0.504 | EgoX 14.38 / 0.552 | +1.53 dB / -0.048 |
| Ego-Exo4D unseen 视频生成 | FVD | 404.77 | EgoX 440.64 | 降低 8.1% |
| EgoHumans 零样本迁移(200 clips) | PSNR (dB) / FVD | 15.52 / 332.41 | EgoX† 13.74 / 421.83 | +1.78 dB / FVD 降低 21.2% |
| Nymeria 零样本迁移(200 clips) | PSNR (dB) / FVD | 15.23 / 210.27 | EgoX† 11.64 / 296.98 | +3.59 dB / FVD 降低 29.2% |
| 条件构建开销(每 clip,单 GPU) | 时间 (秒) | 4.7(合成器渲染) | 69.2(EgoX 深度估计+点云渲染) | 快约 14.7 倍 |
局限与改进
作者承认的局限:合成器 F 逐帧独立、仅以单帧外中心图像为条件,无法恢复该帧未展示的内容(Figure 8);对应不确定处渲染模糊;陌生场景上色彩坍缩——回归模型趋向条件均值,合成器渲染色度仅 0.41,输出降至 0.45,门控只能恢复到 0.62;管线虽免提升但仍需两个视角的相机位姿标定与目标轨迹。我的补充观察:其一,相机适配成本被低估——F 必须在目标头显的鱼眼数据上微调(未微调版在有效圆外溢出 95.9% 内容且对齐最差),更换硬件需重训;其二,ARC 超参($h=0.8$、$c^2$ 加权、$\tau=0.3$、$k=16$)在 unseen split 上选择,因 Ego-Exo4D 无独立验证集,存在评测集过拟合风险;其三,EgoX 评测代码不公开,本文指标为自实现并靠校准,物体级协议甚至无法复现 EgoX 的 seen 发表行,跨论文可比性有限;其四,消融显示合成器渲染在 unseen split 的 FVD(581.90)差于点云(549.77),最终优势依赖 exo tokens 与 ARC 叠加,最陌生场景下的稳健性存疑。
独立分析的弱点
第一,单帧逐帧渲染是结构性短板:F 不利用时序信息,帧间一致性完全依赖扩散模型,遮挡与快速运动下条件缺失或模糊;改进方向是引入多帧/滑动窗口条件或轻量记忆模块。第二,回归式合成的色彩坍缩(色度 0.41)会传染给输出(0.45);改进方向是生成器训练时对条件做噪声/退化增强(附录 C.2 指出这是图像到视频模型的标准疗法),或把合成器改为可采样的生成式头。第三,硬门控丢弃低置信区域全部条件信息,色度仅恢复到 0.62;改进方向是把置信度作为附加通道软加权输入而非二值置灰。第四,超参在评测 unseen split 上选择且评测代码自实现;改进方向是建立独立验证集并公开统一评测工具。第五,依赖双视角相机标定,限制了在无标定互联网视频上的应用;改进方向是把位姿估计仅用于输入端,或直接从视频推断射线图。第六,50 步去噪约 540 秒、条件构建每 clip 4.7 秒,对长视频和实时应用仍偏重;改进方向是蒸馏采样步数与增量渲染。
未来方向
作者指出的方向:合成器是冻结的即插即用模块,更强的前馈视图合成器(如前馈 3D Gaussian、triplane 类模型)出现时可直接替换而不改扩散模型与 ARC;对应分布还隐含可解释的跨视角语义对应,可用于结构级编辑。基于本文成果可延伸的研究:其一,把“先对齐后锐利”的条件原则推广到其他条件化生成任务(深度条件、可控重打光、姿态驱动人体视频),系统研究条件锐度/对齐度与生成器修复能力的最优分工;其二,把 ARC 的早期布局引导与训练时引导结合,研究两者在不同噪声区间的互补性;其三,将置信度引导扩展为多模态置信场,融合文本提示与外中心观测的可靠性估计;其四,流式长视频场景下的滑动窗口合成与条件缓存;其五,把对应分布 $p_u$ 用于主动视角规划——告诉拍摄者哪个第三方机位对第一人称重建最有信息量;其六,针对色彩坍缩问题研究条件退化增强与色度保持损失的组合。
复现评估
复现条件较好但门槛偏高。开源情况:论文承诺发表后放出代码、配置、权重、预计算渲染与置信度图及测试 clip 列表(已给 GitHub/HuggingFace 链接占位),实际发布需跟踪验证。数据:Ego-Exo4D(训练+评测)、EgoHumans 与 Nymeria(仅评测,各 200 clips)均公开,预处理细节在附录 B.5。算力:合成器微调 4×H200 约 3.5 小时,成本很低;生成器 LoRA 训练 4×H200 约 4 天;推理单卡约 68 GiB 显存、每 clip 578 秒,实际需 80GB 级 A100/H100。协议透明度:附录 A 给出全部超参与固定 seed 42,附录 B.1 逐参数对照 EgoX 官方配置并公开两处差异(训练时长与自实现评测),B.3/B.4 详细定义指标。主要风险是 EgoX 评测代码不公开导致的校准依赖,以及物体级协议对 SAM2+DINOv3 管线与匹配阈值的敏感性。综合看:主结果链路超参完整、组件相互独立,复现难度中等;严格复现对比结论需较高算力投入。
论文图表
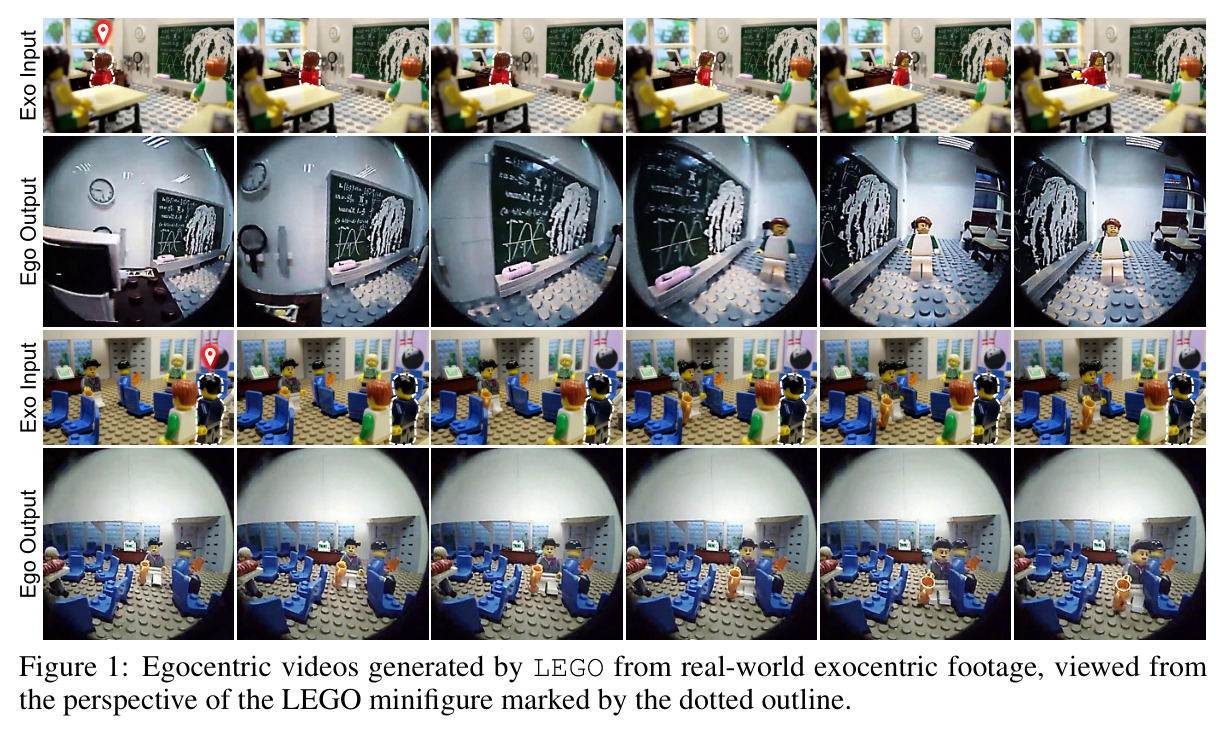
展示 LEGO 从真实世界外中心视频生成的第一人称画面,视角取自图中虚线轮廓标出的乐高小人:每行左侧为外中心输入(Exo),右侧为沿指定自我中心轨迹生成的输出(Ego),覆盖 2026 年 10 月等真实拍摄场景。
论文门面图,直观定义了任务设定(单条外中心视频+目标轨迹→自我中心视频),并第一眼展示生成质量与泛化到训练数据之外域的能力,帮助读者在读方法前建立直觉。
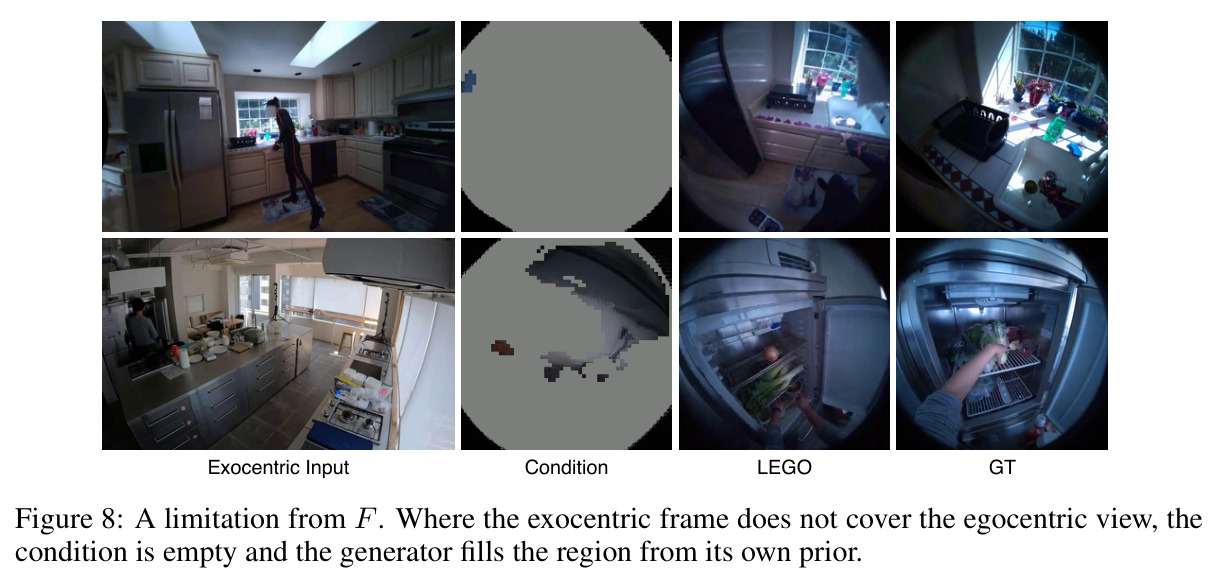
展示方法边界:当外中心帧未覆盖自我中心视角的某区域时,条件在该处为空,生成器只能依靠自身先验填充,结果可能与真实场景不符。
作者主动给出的失效案例,界定了条件管线的上限由合成器可观测性决定,对评估方法适用范围和后续改进方向(多帧/多机位条件)很重要。