Ego2Act:评测第一人称视频生成中的目标导向多步操作 Ego2Act: Evaluating Goal-Directed Manipulation in Egocentric Video Generation
首个评测视频模型能否以第一人称视角完成多步目标导向物理操作的基准与无参考自动评测管线。
前置知识
视频世界模型
把视频生成模型当作环境模拟器使用的范式:给定当前场景与动作或目标,模型生成“接下来会发生什么”的视频,用于合成机器人训练演示(如 DreamGen)或预演动作后果以支持规划(如 UniPi、VLP)。它要求生成内容不仅视觉逼真,还要在功能上正确——中间状态变化符合物理、动作序列真正达成目标。
本文的全部动机是检验视频世界模型能否胜任这一角色,理解该范式才能明白为什么“任务完成度+物理合理性”是核心评测维度,而画面质量是次要的。
第一人称视角
相机佩戴于头部的第一人称视频:画面主体是操作者的双手与眼前场景,伴随走路、转头引起的剧烈相机运动。与第三人称固定机位相比,物体被手频繁遮挡、视角持续变化,对物体身份持久性和细粒度交互的时空一致性要求高得多。
第一人称是具身智能体最自然的感知视角,也是本文选它的原因:手部遮挡与动态相机会让模型的持久性建模和精细操作缺陷充分暴露,第三人称基准测不出这些失败。
无参考评估
评测生成结果时不与任何 ground-truth 参考视频对比,而是直接依据规则或评判模型输出质量分数。在目标导向任务中这是必需的:达成同一目标存在多条合法路径,任何参考视频都会不公平地惩罚与参考不同但同样成功的执行。
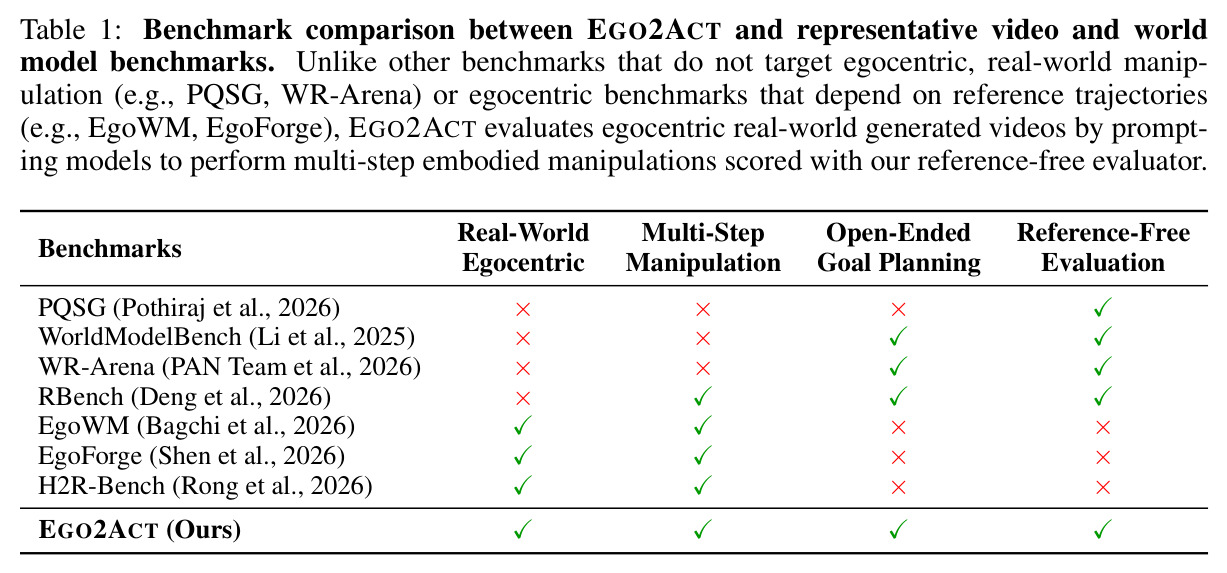
EGO2ACTJUDGE 的整个设计——先规划子目标、再门控检查——都是为了在无参考条件下逼近人类判断,这是理解本文方法创新与表 1 对比定位的前提。
Rubric 门控评分
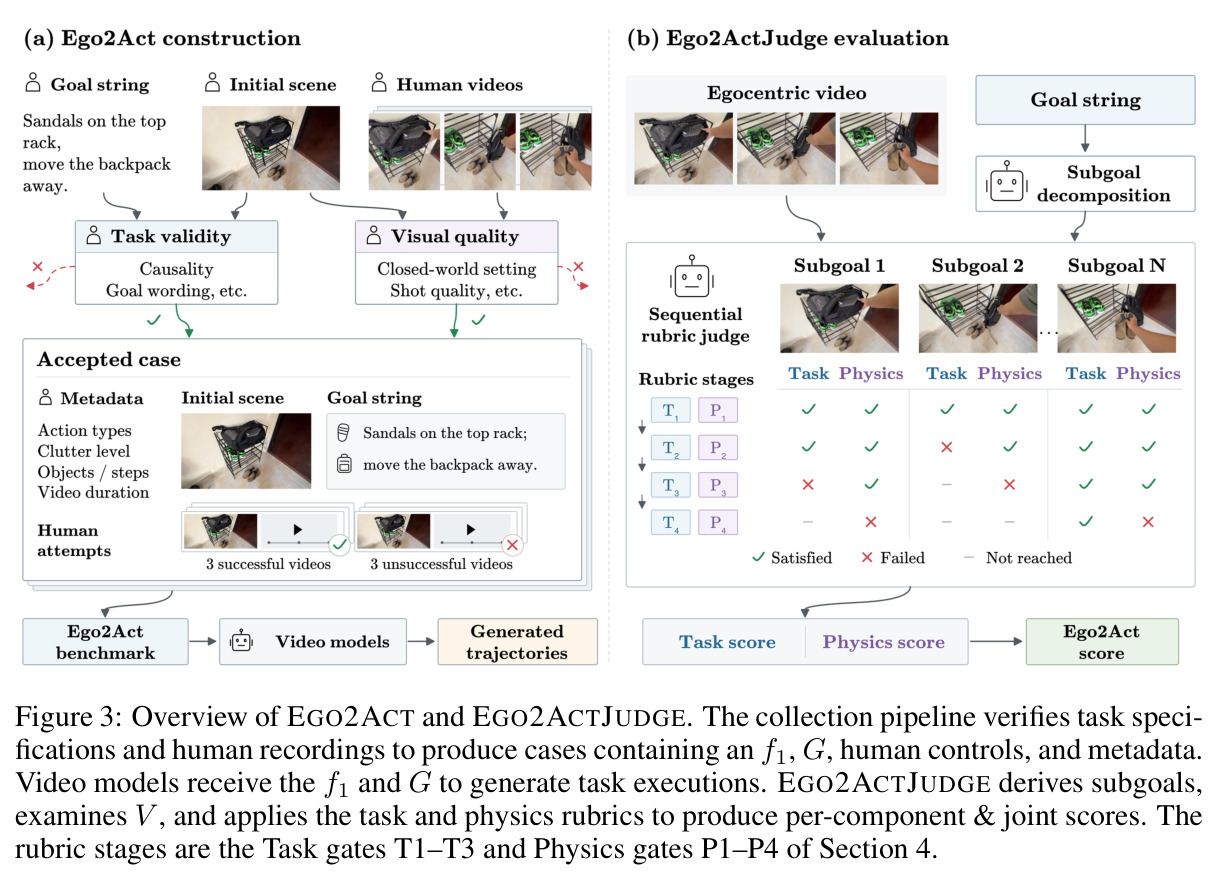
把复杂判断拆成按顺序排列的二元检查项,逐项评测并在首次失败处早停。本文任务轴设 T1 发起/T2 过程/T3 终态三门,物理轴设 P1 连续性/P2 因果/P3 交互/P4 持续四门,子目标得分为通过的门数。顺序门控阻止“用后面较易通过的检查给已失败的动作送分”。
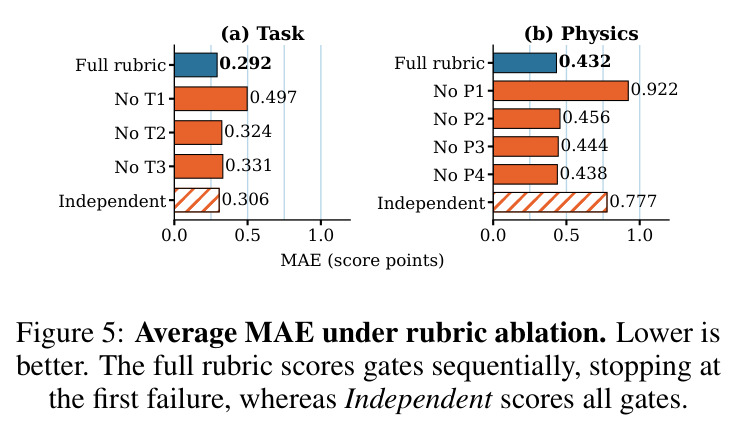
论文用消融证明门控结构是评测可靠性的关键来源(去掉 T1 或 P1 使 MAE 大幅恶化),读懂门控才能理解分数含义和各消融实验的设计逻辑。
标注者一致性指标
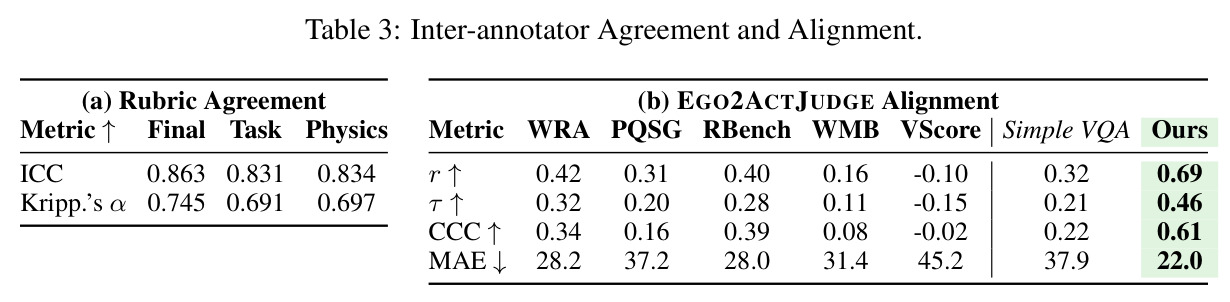
衡量多人评分可靠性的统计量:ICC 反映总变异中真实差异的占比,Krippendorff's α 是容忍缺失数据的通用一致性系数,Pearson r 只测线性相关,CCC 同时惩罚相关不足与系统偏置,MAE 是平均绝对误差。评测器研究通常组合使用多个指标互相印证。
本文所有“评测器好不好”的结论都建立在这些指标上:ICC=0.863 证明 rubric 本身可靠,CCC 从 0.62 跌到 0.51 则量化了独立门控消融的代价。
几何平均聚合
形如 $S=\sqrt{a\cdot b}$ 的聚合方式。与算术加权平均不同,它对称对待两个维度且不允许一轴高分补偿另一轴零分:任一轴为 0 则总分为 0,两轴越失衡总分被拉得越低,两轴相等时 $S(x,x)=x$ 保持不变。
本文用几何平均耦合任务分与物理分 $S=\sqrt{T\cdot P}$,理解它才能正确解读 Final 分数,以及“物理连贯但放错容器”这类视频的得分行为。
研究动机
视频生成模型正被快速推向“具身世界模拟器”的角色:为机器人训练合成操作演示(DreamGen),或预测动作结果以支持具身规划(UniPi、VLP)。这对生成质量提出了远超“画面好看”的要求——视频展开必须在功能上有效:动作最终达成目标,且每一步都伴随正确的物理状态变化。难点在于目标导向提示只陈述终态(例如“把盖好盖的牙膏和折好的牙刷装进旅行盒并合上”),不规定中间步骤,而达成同一目标有多条合法路径(先盖牙膏盖或先折牙刷都行),评测因此无法依赖参考视频,还必须在多种可能性下校验物理约束。现有基准覆盖不了这个场景:PQSG、WR-Arena、WorldModelBench 等在第三人称或非具身设置下评测单一短动作,绕过了第一人称特有的手部遮挡与动态视角;EgoWM、EgoForge、H2R-Bench 虽面向第一人称,但要么用参考视频算保真度而非目标完成度,要么依赖逐步指令提示。第一人称场景还叠加细粒度物体状态跟踪、频繁手部遮挡和动态相机运动,使错误更隐蔽,连人工检查都难以规模化。
本文的目标是论文围绕两个研究问题展开。RQ1(目标导向第一人称操作能力):最先进的视频生成模型能在多大程度上从一张初始场景图出发,自主规划并生成物理成立的第一人称操作视频以达成高层目标?为此作者构建 EGO2ACT:110 个真实世界任务案例、共 2640 段视频(660 段人类录像 + 1980 段模型生成),覆盖 5 个日常领域、3 档杂乱程度和 9 类动作家族,任务平均需要 5 步以上、人类成功执行的中位时长 20.4 秒;每个案例配 3 段走不同动作序列的成功录像和 3 段失败对照录像。RQ2(无参考可扩展评测):如何在没有参考视频的前提下自动化评测开放式执行并与人类判断保持一致?作者提出 EGO2ACTJUDGE——基于 rubric 的免训练评测管线,在 600 视频人类对照面板上达到与人类共识 $r=0.69$ 的相关性、超过全部六个被测基线,从而把评测扩展到全部 2563 段待评视频,并系统分析模型失败模式。
与已有工作不同的是,本文的独特切入角度有三点。第一,评测对象是“目标”而非“轨迹”:提示只给终态和初始场景图,奖励任何一条物理合理、最终达成目标的执行路径;这与 EgoForge 等用参考视频对比保真度的做法有本质区别——参考式评测天然惩罚不同于参考但同样合法的路线。第二,把“任务完成”与“物理合理”拆成两个独立评分轴,再用几何平均 $S=\sqrt{T\cdot P}$ 耦合:一个物理连贯但把物体放错容器的视频可以物理满分而任务失败,反之亦然,这种解耦能精确定位失败类型,而 VideoScore 等感知类指标对正确/错误人类录像几乎给出相同分数。第三,评测器设计上不信任大模型的单次整体判断:先只看目标和初始图规划子目标(此时不看视频),再按 T1–T3、P1–P4 严格顺序门控 early-exit 评分——作者用消融实验证明顺序门控是防止分数膨胀的关键;此外还引入人类正确/错误对照录像和物理篡改负对照来实证评测器自身的区分度与盲区,这种把“评测器当作被验证对象”的元评测思路在同类基准工作中相当少见。
核心方法
整体思路可以先用直觉理解再谈技术。人类专家判断一段第一人称操作视频是否成功时,会先把目标拆成若干子目标(开盖、倒入、合盖……),逐个检查每个子目标是否被启动、是否实质执行、是否达成终态,同时独立审视每个交互窗口的物理过程是否成立;并且一旦前置步骤失败,后面的检查不再给分。EGO2ACTJUDGE 把这套评分逻辑工程化为四阶段管线:给定目标 $G$ 与初始场景图 $f_1$(尚未观看视频),先分解出最小可观测子目标集 $\mathcal{G}=\{g_1,\dots,g_N\}$,每个子目标含一个源物体、至多一个目标和一种动作;任务轴对每个子目标依次过 T1(动作发起)、T2(实质执行)、T3(终态达成)三道门,早停得 $t_i\in\{0,1,2,3\}$,$T=\frac{1}{N}\sum_i t_i$;物理轴独立按 P1(连续性)、P2(因果触发)、P3(交互过程)、P4(结果持续)四道门评分得 $p_i\in\{0,1,2,3,4\}$,仅对可评子目标集 $J$ 取均值 $P=\frac{1}{|J|}\sum_{i\in J}p_i$(未尝试的子目标记 N/A 不计入);最后映射到 0–100($100T/3$、$100P/4$)并取几何平均 $S=\sqrt{T\cdot P}$,完全未尝试的视频直接记 $S=0$。基准本体由 110 个真实案例构成,每案例含初始图、高层目标、6 段人类录像(3 成功 + 3 失败对照)和 6 个模型 × 3 个种子共 18 段生成视频。
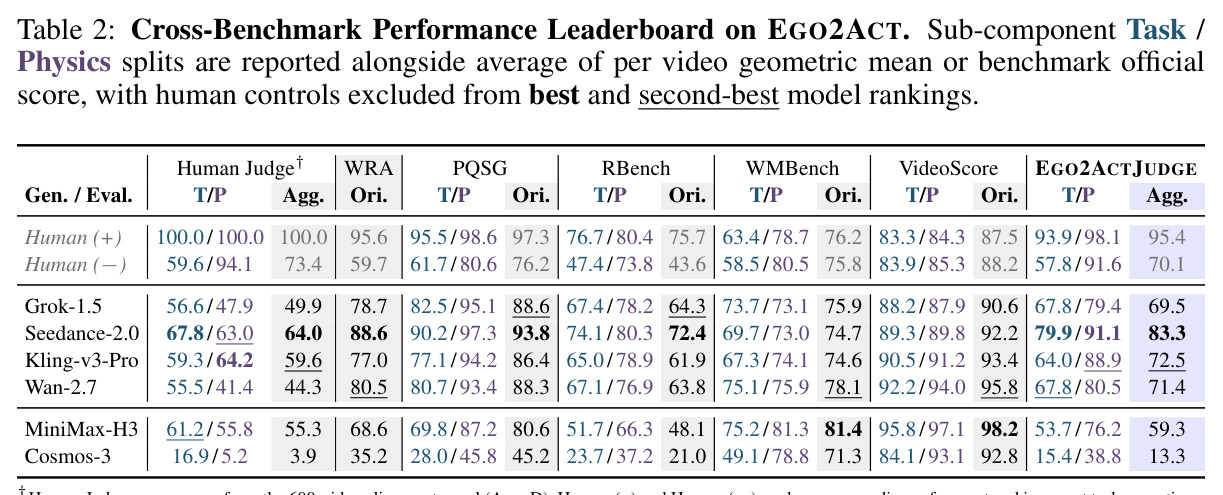
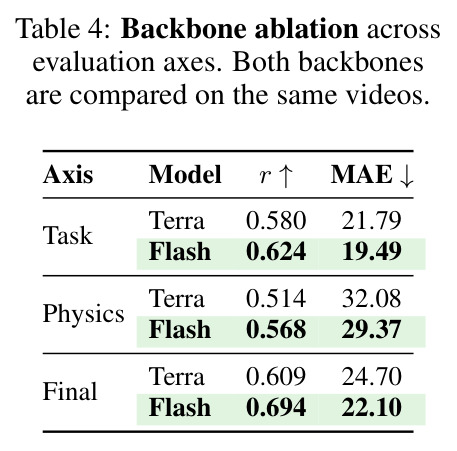
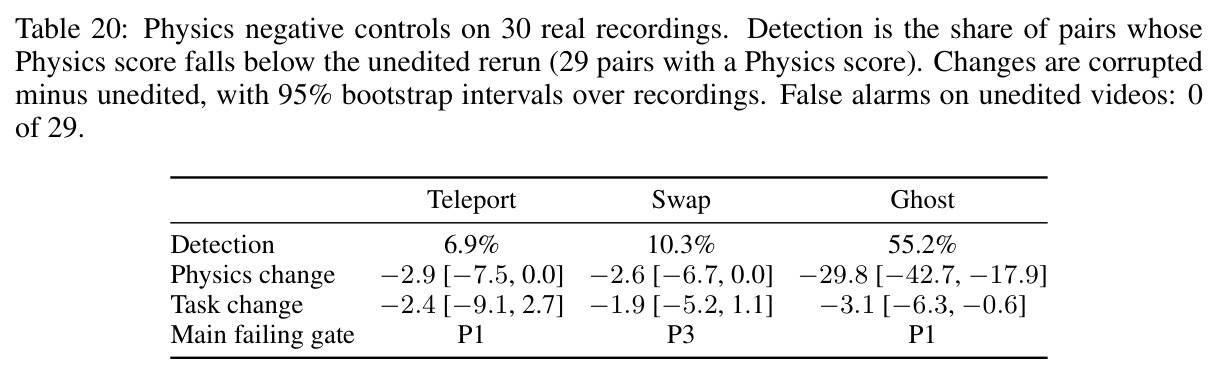
核心创新是与“参考轨迹评测”彻底切割,并证明评分结构(严格顺序门控)本身决定 VLM 评测的可靠性。与 EgoForge、EgoWM、H2R-Bench 等需要参考视频或逐步指令的第一人称评测不同,EGO2ACTJUDGE 的每份 rubric 都从目标与初始图独立推导、无需任何 ground-truth 执行,模型可以自由选择执行顺序——表 1 的对比矩阵显示它是唯一同时满足“真实世界第一人称 + 多步操作 + 开放式目标规划 + 无参考评测”四项的基准。第二个关键发现是门控结构的作用:把所有门控独立打分,会让模型“路过式”地通过已经失败的后续检查,导致 Final 分数虚高 6.8 分、与人类的一致性从 CCC 0.62 跌到 0.51;人类试点标注同样如此——去掉发起门 T1 使任务轴 MAE 从 0.292 恶化到 0.497,去掉连续性门 P1 使物理轴 MAE 从 0.432 恶化到 0.922。第三个创新是把评测器本身当被验证对象:用人类正确/错误对照录像检查区分度(EGO2ACTJUDGE 给 95.4 对 70.1,VideoScore 则给出 87.5 对 88.2 完全无区分),用 teleport/swap/ghost 三类物理篡改负对照量化灵敏度边界(ghost 检出 55%,teleport 仅 6.9%),并以 5 折交叉验证选骨干、测试-重测检验稳定性。
方法步骤详情
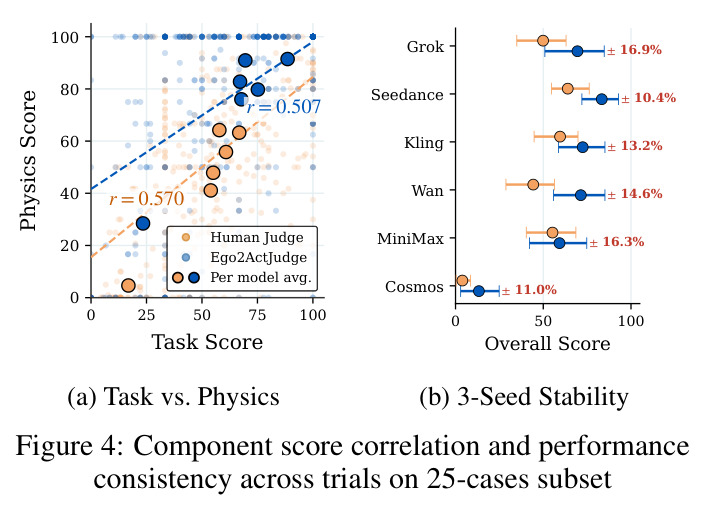
方法分数据构建与评测执行两部分。数据构建:9 名标注者按 5 个领域(厨房食品 24、家务收纳 28、办公 25、个人护理 21、其他 12)提出任务,逐条通过构建 rubric——真实可行的日常任务、终态明确且不规定步骤、至少 3 条结构性不同的执行序列(差异体现在子动作顺序、工具选择或中间状态)、封闭世界假设(不得引入新物体)、单手操作、物体引用以可见属性无歧义标识——再由第二名标注者复核;每案例拍摄 3 段成功录像和 3 段失败对照,第一人称视角,场景图长边 512 像素,视频统一 480p;另用 VLM 辅助标注轨迹描述、子动作数、时长、涉及物体(均值 5.16 个)与 9 类动作家族(每案例均值 2.71 类)。生成阶段:6 个模型(Grok Imagine 1.5、Seedance 2.0、Cosmos 3、Kling v3 Pro、MiniMax H3、Wan 2.7)收到逐字相同的 prompt 模板(“动作模拟器”角色加单手、封闭世界、物理合法三条约束),480p、最长 15 秒(Wan 2.7 仅 10 秒)、种子 101/202/303,共 1980 段。评测执行:EGO2ACTJUDGE 以 Gemini-3.7-Flash 为骨干(OpenRouter 调用、低推理档、4096 输出 token、约 $0.04/视频),任务轴均匀抽 8 帧、物理轴 24 帧起步,每道门可调用检查工具指定时间窗与 ROI 换回 12 帧;每个存活子目标须引用证据帧回答 yes/no/unresolved,出现 unresolved 则该轴分数 withheld(最终 98.7% 视频有 Final 分);任务与物理作为两条独立分阶段管线运行,最后按几何平均聚合。
技术新颖性
技术新颖性体现在四个层面。其一,问题形式化新:首个把“多步目标导向 + 第一人称 + 无参考评测”三要素合在一起的生成基准,填补了第三人称物理评测(PQSG、RBench、WR-Arena)与参考依赖的第一人称评测(EgoForge、EgoWM)之间的生态位空缺。其二,rubric 工程精细:子目标定义(一源一目标一动作,把“够取/抓握/搬运/释放”并入高层动作)、门控早停、unattempted/N/A/unresolved 三种非失败状态的严格区分、几何平均聚合与 $S=0$ 规则,每条设计决策都有对应消融或论证支撑(附录 B.4 专门论证为何不用算术加权平均)。其三,评测器构建流程可迁移:先规划后观看、工具增强的按需抽帧、强制证据帧引用、unresolved 即弃权的处理,这套机制不绑定领域知识,可直接移植到其他操作评测任务。其四,验证方法学新:ICC=0.863 证明 rubric 本身可靠;对 judge 做测试-重测(Final $r=0.89$)与物理篡改负对照(29 段未编辑视频零误报);5 折交叉验证选骨干(Flash 每折均胜出),避免“在评测集上调评测器”的循环论证。这与常见的“拍脑袋设计 rubric 加单一相关性数字”的做法形成鲜明对比,附录 G 还总结出五条可复用的 VLM judge 设计原则。
实验结果
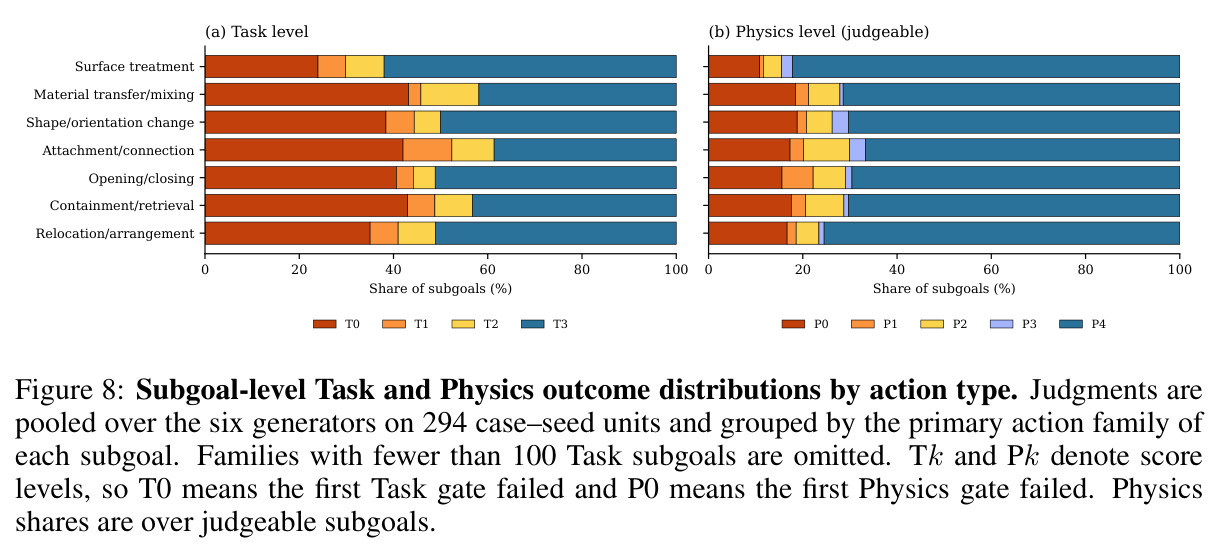
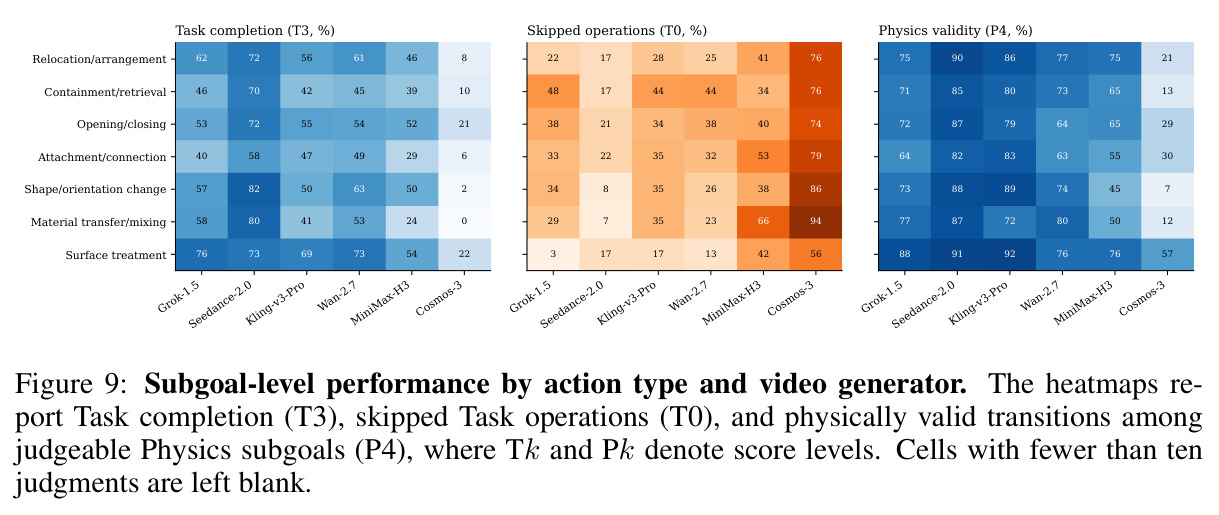
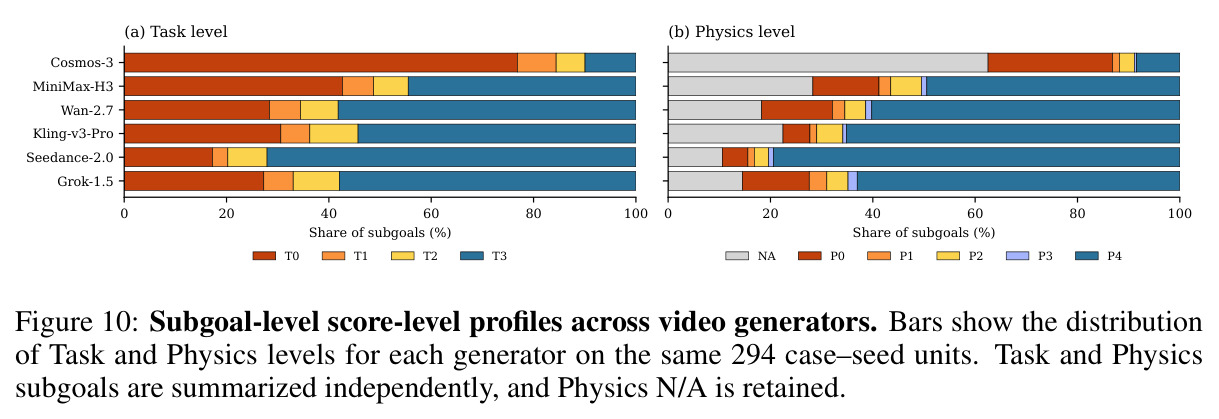
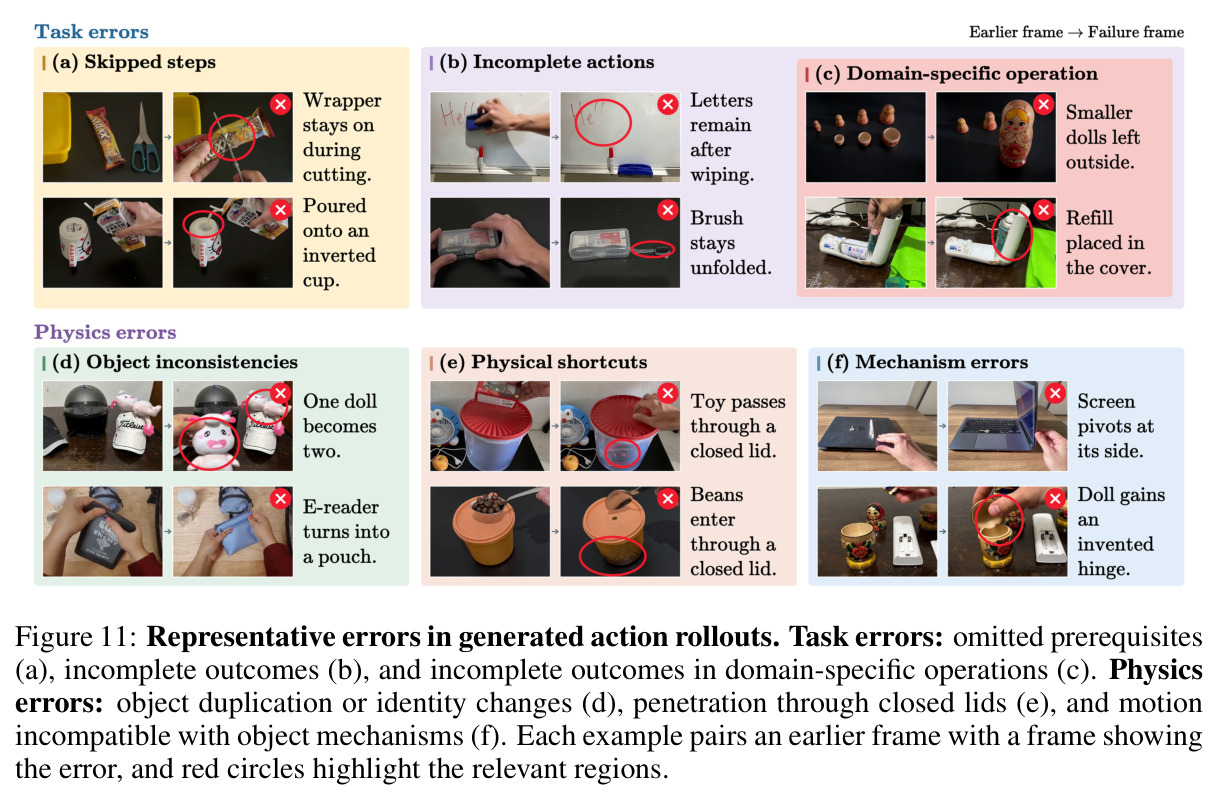
核心发现分四块。模型能力(RQ1):人机差距巨大——在 25 案例 600 视频的人类评测中,最高分 Seedance-2.0 仅 64.0/100(任务 67.8、物理 63.0),开源 MiniMax-H3 55.3、Kling 59.6、Wan 2.7 44.3、Grok 49.9,Cosmos 3 只有 3.9;EGO2ACTJUDGE 全基准排名一致(Seedance 83.3、Kling 72.5、Wan 71.4、Grok 69.5、MiniMax 59.3、Cosmos 13.3)。失败模式高度结构化:跳步(T0)占所有子目标判定的 35–43%,失败任务判定中“跳步+未达成终态”(T0+T2)合计 88.7%;物理侧 N/A+连续性失败+交互违规合计 93.4%,即模型要么不做前置步骤,要么做了但物理穿帮。动作类型是最强难度因子:attachment/connection 子目标仅 38.6% 任务完成率与 66.7% 物理有效率,relocation 为 51.1%/75.5%,surface treatment 最容易 62.0%/82.2%,且 attachment 难于 relocation 的排序在全部 6 个模型上成立(任务轴差 1.6–21.3 个百分点)。任务时长与得分仅弱负相关(Spearman $\rho=-0.29$),15 秒预算内任务 68.6% 对更长任务 54.8%。评测质量(RQ2):EGO2ACTJUDGE 与人类共识 $r=0.69$、$\tau=0.46$、CCC=0.61、MAE=22.0,全面优于 WR-Arena(0.42)、RBench(0.40)、PQSG(0.31)、WorldModelBench(0.16)、Simple VQA(0.32),VideoScore 甚至为 -0.10(给正确与错误人类录像打 87.5 对 88.2);模型排名与人类几乎一致($\rho=0.94$,仅 Grok 与 MiniMax 相邻互换)。评测器盲区:物理轴偏置 +24.1 分;帧内可见的 ghost 复制检出 55.2%(物理降 29.8 分),帧间的 1.5 秒删帧(teleport)与片段倒放(swap)仅 6.9% 和 10.3% 检出。此外任务轴与物理轴相关仅中等($r\approx0.51$–$0.57$),种子间生成方差达 ±10.4%(Seedance)到 ±16.9%(Grok),单次采样不可靠。
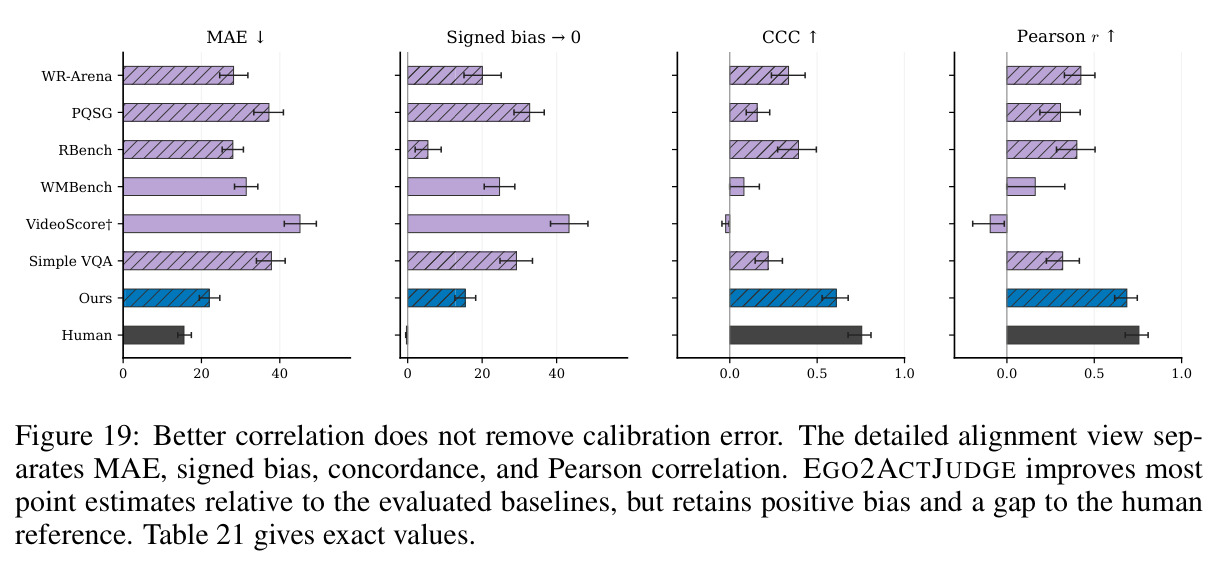
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 目标导向第一人称操作视频生成(综合,25 案例人类评测面板) | Final score(0–100,人类 judge 几何平均) | 最佳模型 Seedance-2.0 得 64.0 | 人类执行 100.0;同面板最差模型 Cosmos 3 仅 3.9 | 最佳模型仍落后人类 36 分,暴露巨大人机差距 |
| 自动评测器与人类共识的一致性(600 视频面板) | Pearson r(Final 分数) | EGO2ACTJUDGE r = 0.69(CCC 0.61,MAE 22.0) | 最强基线 WR-Arena 0.42、RBench 0.40、Simple VQA 0.32、VideoScore -0.10 | 较最强基线提升 0.27,MAE 降低 6 分(28.0→22.0) |
| 分轴一致性:任务完成 / 物理合理 | Pearson r | 任务 0.63 / 物理 0.55 | RBench 任务 0.47 / 物理 0.37;PQSG 任务 0.44 / 物理 0.23 | 两轴均领先最强基线 0.16 与 0.18 |
| 评测器区分度(人类正确 vs 错误对照录像) | Final 分差 | EGO2ACTJUDGE:95.4 vs 70.1(差 25.3 分) | VideoScore:87.5 vs 88.2(无区分甚至反向) | 从完全无区分到 25 分有效区分 |
| 动作类型难度分析(子目标级,294 案例种子单元) | 任务完成率 T3 / 物理有效率 P4 | attachment/connection 38.6% / 66.7%(最难) | relocation/arrangement 51.1% / 75.5%;surface treatment 62.0% / 82.2%(最易) | 难-易差距 23.4 / 15.5 个百分点,且排序跨 6 个模型稳定 |
| 物理篡改负对照(30 段真实录像 × 3 类篡改) | 检出率(物理分下降) | ghost 复制 55.2%(-29.8 分);零误报(0/29) | teleport 删帧 6.9%(-2.9)、swap 倒放 10.3%(-2.6) | 揭示帧内违规可检、帧间违规是盲区的灵敏度边界 |
局限与改进
作者承认的局限:一是评测的是“视频里可见的正确性”,不验证通过的 rollout 是否真正有益于下游规划或策略学习,只视之为必要的第一步;二是人类研究只覆盖 25/110 案例(600 视频),代表性有限;三是所有生成为单段 15 秒内直出,未用 ComfyUI 等延长工作流,长任务结论受原生生成时长约束;四是对基线做了统一适配(共享 Gemini 骨干、输出映射、RBench 提示从机械臂改写为第一人称),可能不是各方法的最优用法,EgoForge 与 EgoTV 因范式不兼容未被纳入;五是供应商内部 prompt 扩写无法控制——附录 E.4 显示扩写提示能把 Wan 2.7 从 70.4 提到 84.9(15 对中 13 对改善)而 Cosmos 3 纹丝不动(25.2 持平)。我的补充观察:物理分是乐观估计(帧间违规几乎检不出、偏置 +24.1),模型真实物理水平可能比报告更低;特征难度分析统计功效不足——部分动作族仅 3 个案例、所有特征关联经 Benjamini–Hochberg 校正后均不显著(最强者 $q=0.086$),“attachment 最难”虽有跨模型一致性佐证,但缺乏受控干预;judge 单视频运行方差约 ±10 分(物理轴 ±16),单视频分数不可比且推高复评成本;仅 6 个模型、480p 分辨率与固定 prompt 模板也可能不利于部分模型发挥。
独立分析的弱点
独立分析的弱点与改进方向。弱点一:物理评测的时间分辨率不足。负对照显示均匀 24 帧采样下 teleport/swap 检出率不足 11%,而这恰是视频模型最常见的造假方式;改进方向是用帧差/光流能量引导非均匀采样,或在检查工具中引入变化检测预筛,把帧预算集中在高变化区间——论文已观察到 judge 主动检查篡改区间时 ghost 检出率升至 13 中 10。弱点二:系统性正向偏置(Final +15.4,物理 +24.1)。门控把“不可观测”与“未违规”区分开,但把不可观测当作不扣分实际是宽容假设;改进方向是按证据密度加权,或对未经检查工具核实的关键门施加保守惩罚。弱点三:难度因子分析是观察性的且功效不足,无法区分“attachment 难”是动作本身难,还是它常与封闭容器等前置步骤耦合所致;改进方向是设计单动作族最小对照任务做干预实验,并扩案例量做多重检验校正。弱点四:基准绑定“单手、封闭世界、15 秒”设定,测不到错误恢复、工具替代、开放世界物品引入和双手协同等真实具身能力。弱点五:约 $0.04/视频的 judge 成本对全基准尚可(千美元量级),但用作强化学习反馈信号时成本会乘上采样量,需要蒸馏出轻量专用 judge;同时 judge 每次重推导子目标计划引入噪声(计划数变化解释约五分之一的 run-to-run 任务分方差),可按案例缓存计划降噪。
未来方向
作者明确提出的方向:把 EGO2ACTJUDGE 作为反馈信号用于自我改进闭环,例如借鉴 VQQA 用视频批判迭代优化 prompt,或对 rollout 排序筛选训练数据,把“评测”升级为“改进”;扩大基准规模与领域覆盖、随原生生成时长增长引入更长任务;与被比较方法的原作者合作做方法特定适配,并发展无参考的第一人称评测器以纳入 EgoForge 等。基于本文成果可自然延伸的方向:其一,闭环世界模型训练——用 judge 分数作为奖励或数据过滤器做 rejection sampling 式微调,并验证下游机器人策略增益,补上“评测↔效用”缺口;其二,多感官与长时程评测:加入音频一致性检查、支持跨剪辑的持续世界状态跟踪,以覆盖 ComfyUI 式延长生成的场景;其三,评测器轻量化与开源化:把 Gemini-3.7-Flash 流程蒸馏为专用开源 VLM judge,降低边际成本并消除 API 版本漂移;其四,把子目标计划从每次重推导改为案例级缓存并允许人工修订,可再压低约五分之一的 run-to-run 方差;其五,向更难的物理维度进军——流体、柔性体、多体接触动力学恰是本文失败样本最集中、负对照检不出的区域,值得结合可微物理仿真做混合验证。
复现评估
复现条件评估:透明度非常高。论文承诺发布全部基准资产(初始场景、目标、660 段人类录像、1980 段生成视频)、judge 代码与逐字 prompt(附录 B.5–B.6 完整给出所有分解、门控与响应协议提示词)、人类标注与 rubric 指南、分析脚本;所有报告数字均可由存储的评测输出复算,无需额外模型调用。关键超参完备:Gemini-3.7-Flash via OpenRouter、低推理档、4096 输出 token、180 秒超时、每视频约 $0.04(上限 $2)、任务 8 帧/物理 24 帧起步、检查工具默认返回 12 帧;生成侧种子 101/202/303、480p、统一 prompt 模板逐字附上。主要复现风险:一是 6 个生成模型均为商业 API,可用性与内部 prompt 重写随时间漂移,绝对分数不可精确复现(作者也只能保证同代快照可比);二是 judge 绑定 Gemini-3.7-Flash,API 涨价或下线需换骨干——消融显示换 GPT-5.6-Terra 相关性降到 0.61、MAE 升到 24.7;三是 judge 单次运行 Final SD 约 10.4、物理轴约 15.7,严格复现表格数字需多样本平均;四是人类对照研究需 3 名盲评标注者与校准流程,人力成本不小。综合判断属于“流程完全可复现、绝对数值受 API 因素影响”的类型,复现难度中等偏低。
论文图表
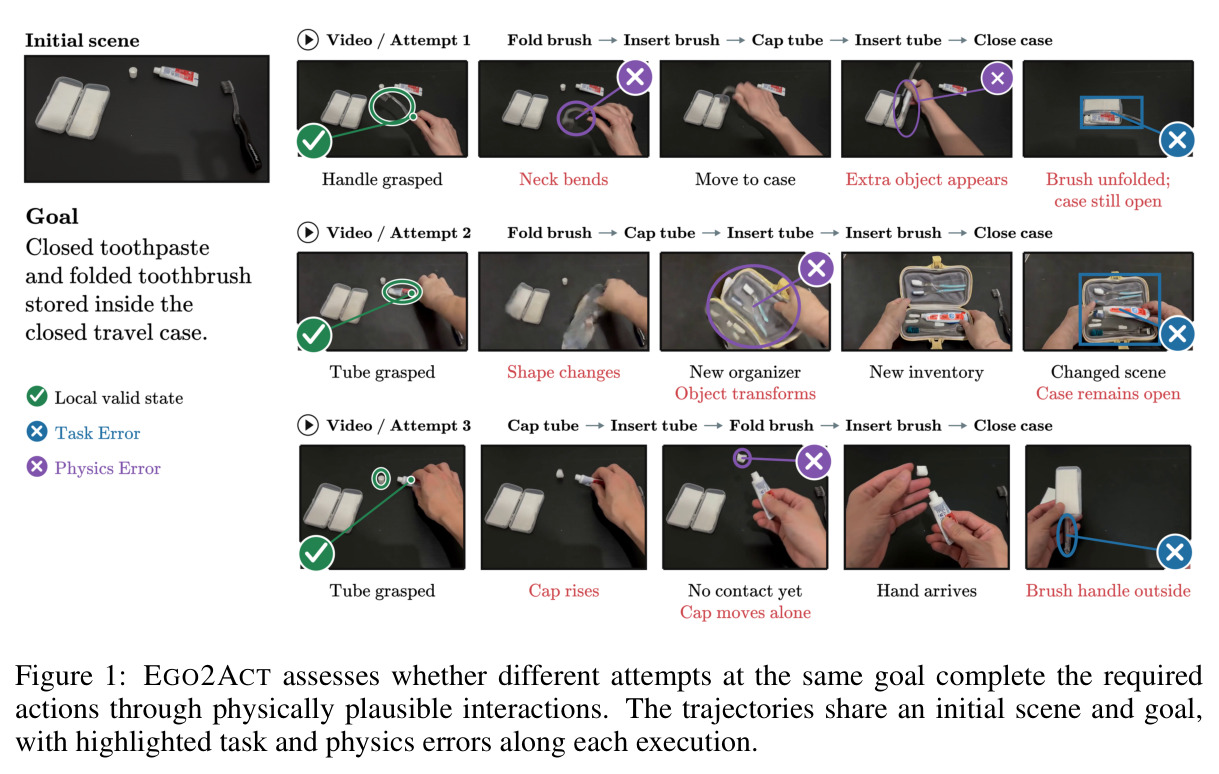
以“把盖好盖的牙膏和折好的牙刷装进旅行盒”为例,展示同一初始场景与目标下的多条执行轨迹,并沿轨迹高亮各自出现的任务错误与物理错误。
开篇直观定义了“目标导向评测”的含义:多条合法路径都应被接受,评测关注的是每条路径上的步骤完成度与物理合理性,是理解全文问题设定的钥匙。
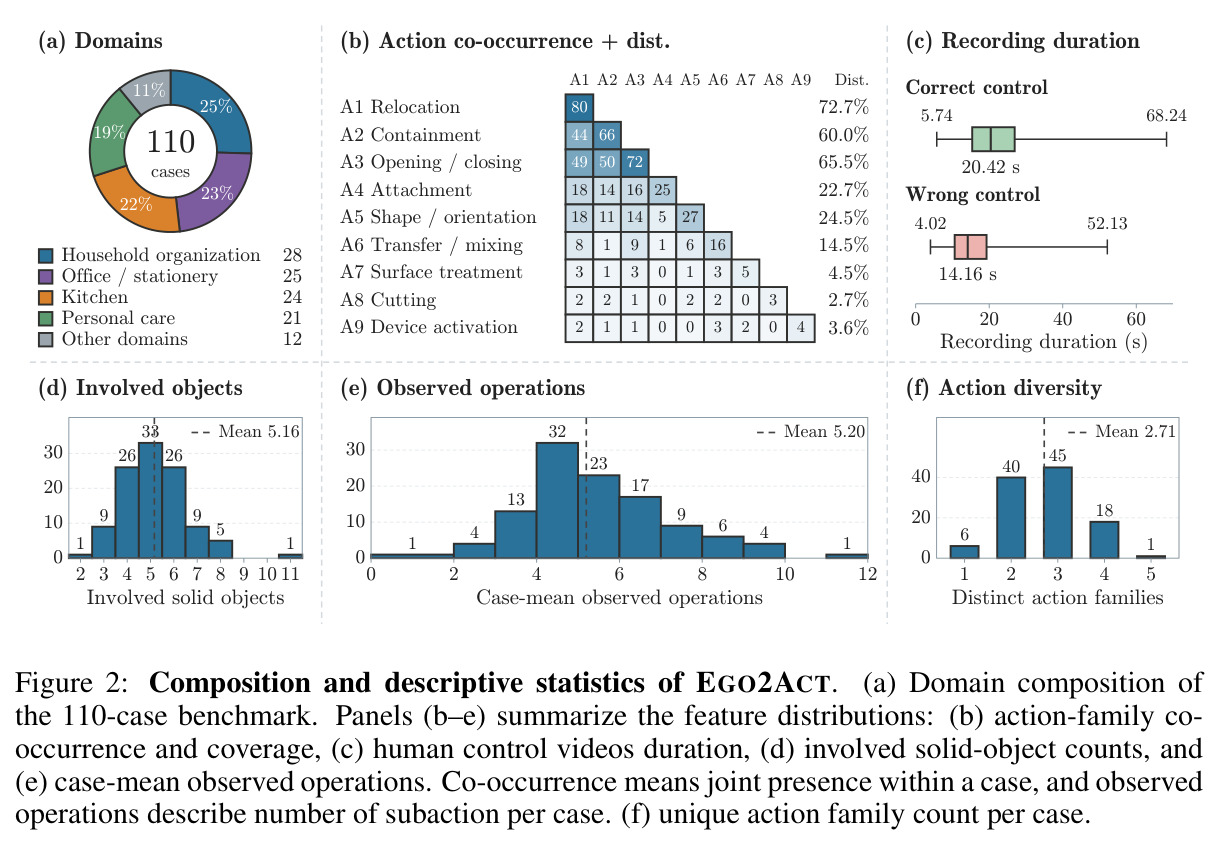
六联图展示基准构成:领域分布(家务 28/办公 25/厨房 24/个人护理 21/其他 12)、9 类动作家族共现与覆盖、人类录像时长(正确对照中位 20.42 秒、错误对照 14.16 秒)、涉及物体数(均值 5.16)、每案例观测操作数(均值 5.20)、动作家族多样性(均值 2.71)。
量化了基准的多样性与复杂度,说明任务平均超过 5 步且多动作族交织,是论证“该基准能测出短时程设置漏掉的失败”的数据基础。